


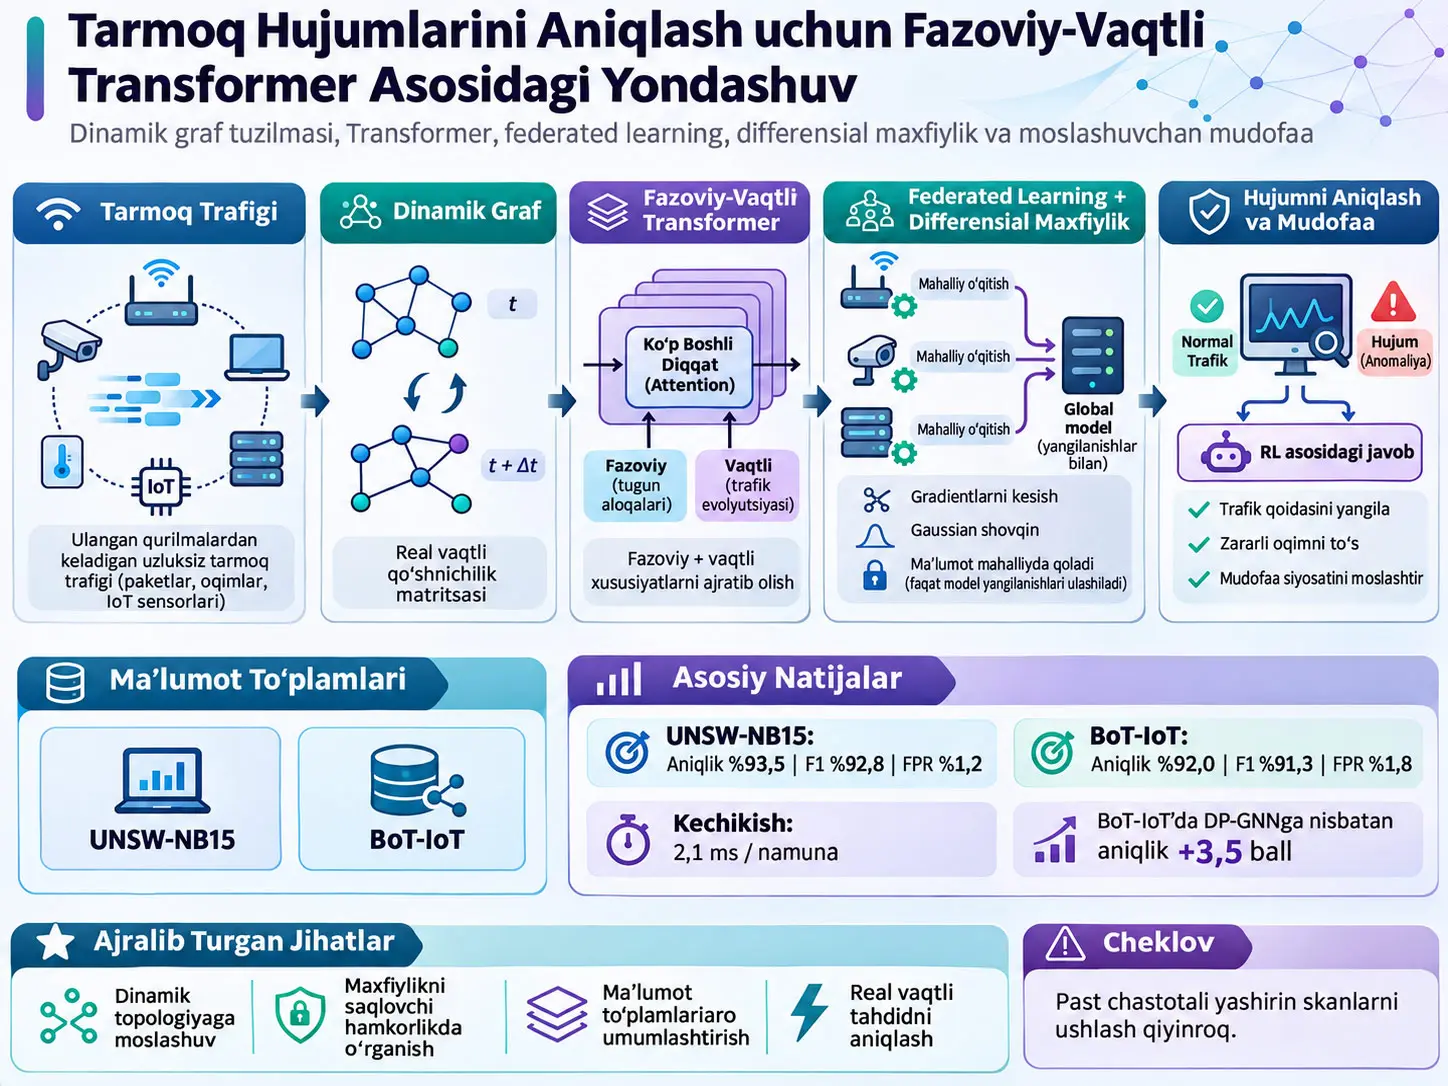
Adaptiv fazoviy-vaqtli Transformer asosidagi tarmoq hujumlarini aniqlash doirasi tarmoq tugunlari o‘rtasidagi o‘zgaruvchan aloqa munosabatlarini dinamik grafik sifatida modellashtiradigan, vaqt bog‘liqliklarini Transformer bilan, fazoviy/topologik bog‘liqliklarni graph convolution bilan qayta ishlaydigan, mahalliy ma’lumotlarni qurilmadan chiqarmasdan federated learning va differential privacy dan foydalanadigan hamda hujumdan keyin reinforcement learning yordamida mudofaa qarorini ishlab chiqishni maqsad qiladigan network attack detection va response yondashuvidir. Tadqiqot UNSW-NB15 va BoT-IoT benchmark ma’lumotlar to‘plamlarida baholangan; taklif etilgan usul UNSW-NB15 da %93,5 ± %0,2 accuracy va %92,8 ± %0,3 F1, BoT-IoT da esa %92,0 ± %0,4 accuracy va %91,3 ± %0,5 F1 ga erishgan. Biroq tadqiqot nazorat qilinadigan ma’lumotlar to‘plamlariga asoslanadi; ushbu natijalar haqiqiy V2X, IoT yoki ishlab chiqarish tarmog‘idagi uzoq muddatli amaliy maydon muvaffaqiyati sifatida talqin qilinmasligi kerak.
Doiraning birinchi komponenti joriy vaqt oynasidagi tarmoq tugunlarining aloqa chastotalari va trafik xususiyatlari o‘xshashligidan dinamik qo‘shnichilik matritsasini hosil qiladi. Zaif bog‘lanishlar chegaralash bilan kesiladi; shu orqali har bir tugun tarmoqdagi barcha tugunlarga ulanadigan zich tuzilma o‘rniga siyrakroq va dolzarb aloqa munosabatlarini ifodalovchi grafik hosil qilish ko‘zda tutiladi. Vaqt bog‘liqliklari multi-head self-attention dan foydalanuvchi Transformer bilan, topologik bog‘liqliklar esa graph convolution bilan qayta ishlanadi.
Ikkinchi komponent federated learning va differential privacy ni birlashtiradi. Mahalliy qurilmalar xom trafik ma’lumotlarini markaziy serverga yuborish o‘rniga o‘z modellarini mahalliy ravishda yangilaydi; markaziy server model parametrlarini birlashtiradi. Manba differential privacy jarayonida gradient clipping va Gaussian noise dan foydalanadi; tajriba sozlamalarida noise multiplier qiymatini \(\sigma=0.1\), umumiy maxfiylik byudjetini 100 epoch yakunida taxminan \(\epsilon=2.4\) va \(\delta=10^{-5}\) deb qayd etadi.
Uchinchi komponent faqat “hujum bor/yo‘q” qaroriga qaratilmaydi. Deep Q-Network asosidagi reinforcement learning qatlami trafik tezligi, protokol taqsimoti va anomaly score kabi ko‘rsatkichlardan tashkil topgan network state dan foydalanib, trafikni cheklash yoki ma’lumotlarni filtrlash kabi mudofaa harakatlari orasidan tanlashni maqsad qiladi. Ablation natijalari reinforcement-learning komponentining classification accuracy ga qo‘shgan hissasi atigi taxminan 0,3 foiz punkt ekanini; uning asosiy roli hujumga beriladigan dinamik javob ekanini ko‘rsatadi.
Taklif etilgan usulning eng muhim unumdorlik yutug‘i adaptiv grafik hosil qilish va spatio-temporal Transformer komponentlaridan keladi. BoT-IoT da adaptiv grafik hosil qilish olib tashlanganda F1 %91,3 dan %87,9 gacha, Transformer GCN+LSTM bilan almashtirilganda esa %86,5 gacha pasayadi. Aksincha, federated differential privacy mexanizmini markazlashtirilgan o‘qitish bilan almashtirish F1 da taxminan 0,8 foiz punkt farq hosil qiladi.
Manba, shuningdek, to‘g‘ridan-to‘g‘ri cross-dataset transfer tajribasini qayd etadi: model UNSW-NB15 da o‘qitilgan va BoT-IoT da fine-tuning qilinmasdan sinovdan o‘tkazilgan. Mualliflar ushbu sharoitda proposed model F1 qiymatini %91 dan yuqori saqlaganini va BoT-IoT da RustGraph dan 2,1 foiz punkt yuqori natija ko‘rsatganini bildiradilar.
Tadqiqotning muhim cheklovi ultra-past chastotali hujumlardir. Manbada keltirilgan past tezlikdagi port skanerlash misolida hujumchi 30 daqiqada atigi beshta probe yaratgan, paket tezligi 0,8 packet/s darajasida qolgan va normal IoT heartbeat trafigining 0,7–1,1 packet/s oralig‘i bilan katta darajada ustma-ust tushgan. Model bu namunani %62,3 confidence bilan normal xatti-harakat sifatida tasniflagan. Mualliflar ushbu muvaffaqiyatsizlikni federated learning dagi cheklangan mahalliy ko‘rinish va differential-privacy shovqinining zaif anomaly gradient larini bostirishi bilan bog‘laydilar.
Manbaning abstract bo‘limi bir xil privacy budget sharoitida membership inference hujumlarining muvaffaqiyat darajasi sezilarli ravishda kamayganini bildiradi. Biroq asosiy usul va natijalar bo‘limlarida membership-inference hujumi uchun miqdoriy muvaffaqiyat darajasi, alohida tajriba jadvali yoki batafsil test protokoli berilmagan. Shu sababli bu da’vo sifat jihatidagi manba bayonoti sifatida saqlanishi, manbada mavjud bo‘lmagan sonlar bilan kengaytirilmasligi kerak.
Tadqiqot muammosi nima?
Network Attack Detection (NAD) tarmoq trafigidagi normal xatti-harakat bilan zararli xatti-harakatni ajratishni maqsad qiladi. Ushbu tadqiqot muammoni matematik jihatdan binary classification ko‘rinishida quradi: \(y_i=0\) normal trafikni, \(y_i=1\) esa hujum trafikini ifodalaydi.
Tadqiqot hal qilishga urinayotgan qiyinchilik faqat to‘g‘ri tasniflash emas. IoT, Internet of Vehicles va Vehicle-to-Everything kabi muhitlarda qaysi qurilmalar bir-biri bilan aloqa qilishi vaqt o‘tishi bilan o‘zgarishi mumkin. Shu bilan birga ma’lumotlarni markaziy serverga yuborish maxfiylik xavfini keltirib chiqarishi va hujum aniqlangandan keyin qaysi mudofaa harakati qo‘llanishi ham alohida muammo bo‘lishi mumkin.
Shu sababli manba uchta muammoni bitta doira ichida ko‘rib chiqadi:
- Dinamik tarmoq topologiyasidagi fazoviy va vaqt munosabatlarini modellashtirish.
- Xom ma’lumotlarni markaziy tizimga ko‘chirmasdan umumiy modelni o‘qitish va differential privacy ni qo‘llash.
- Aniqlashdan keyin reinforcement learning yordamida dinamik mudofaa qarorini ishlab chiqish.
Muammoni formulalash
Manba tarmoq trafigi ma’lumotlarini \(X\), har bir trafik namunasini \(x_i\), ikkilik sinf yorlig‘ini esa \(y_i\) bilan ifodalaydi. O‘qitish va test to‘plamlari bir xil feature tuzilmasidan foydalanadi.
Ideal optimallashtirish maqsadi kutilayotgan xavfni kamaytirishdir:
\[ \mathcal{L}(f)= \mathbb{E}_{(x,y)} \left[ \ell(f(x),y) \right] \tag{1} \]
Tenglama 1 nimani hisoblaydi? Modelning ma’lumotlar taqsimoti bo‘yicha kutilayotgan xato xarajatini ifodalaydi.
\(f(x)\): Modelning \(x\) trafik namunasi uchun chiqargan bashoratidir.
\(y\): Haqiqiy yorliqdir.
\(\ell(f(x),y)\): Bashorat bilan haqiqiy yorliq orasidagi farqni o‘lchaydigan loss funksiyasidir.
Matematik rol: O‘qitish jarayoni barcha mumkin bo‘lgan tarmoq trafigining kutilayotgan xavfini bevosita hisoblay olmaydi; mavjud training samples orqali shu maqsadga yaqinlashishga harakat qiladi.
Dinamik Qo‘shnichilik Matritsasi Ushbu Tadqiqotda Nima Vazifa Bajaradi?
Dinamik qo‘shnichilik matritsasi ma’lum bir vaqt oynasida qaysi tarmoq tugunlari bir-biri bilan mazmunli aloqa munosabatiga ega ekanini feature similarity va aloqa tuzilmasidan kelib chiqib spatio-temporal graph ni yangilaydi; zaif bog‘lanishlarni chegaralash modelning barcha tugunlar orasida zich va shovqinli bog‘lanishlar qurishi o‘rniga vaqt o‘tishi bilan o‘zgaradigan muhim topologik munosabatlarni qayta ishlashini maqsad qiladi.
Dinamik graph yaratish
Manbaning qo‘shnichilik matritsasi tenglamasi:
\[ A_{ij}^{(t)} = \operatorname{ReLU} \left( \frac{x_i(x_j)^T}{\sqrt{d}} - \epsilon \right) \tag{2} \]
\(A_{ij}^{(t)}\): \(t\) vaqtda \(i\) va \(j\) tugunlari orasidagi bog‘lanish vaznidir.
\(x_i\) va \(x_j\): Tegishli tugunlarning feature vector laridir.
\(d\): Feature o‘lchami bilan bog‘liq masshtablash hadidir.
\(\epsilon\): Zaif bog‘lanishlarni kesish uchun ishlatiladigan chegaradir.
ReLU: Chegara ayirilgandan keyin manfiy qiymatlarni nolga tushirib, zaif munosabatlarning adjacency matrix da bog‘lanishga aylanishini oldini oladi.
Tenglamada feature-vector o‘xshashligi \(\sqrt{d}\) bilan masshtablanadi va \(\epsilon\) ayiriladi. O‘xshashlik chegaradan kichik bo‘lsa ReLU natijasi nol bo‘ladi; chegaradan katta bo‘lsa bog‘lanish musbat vazn oladi.
Manba adjacency matrix \(K\) o‘lchamli sliding temporal window ichida hisoblanishini bildiradi, biroq \(K\) ning sonli qiymatini qayd etmaydi.
Zich barcha-tugun taqqoslashining nazariy xarajati:
\[ O(N^2) \]
sifatida berilgan bo‘lsa, sparse pruning dan keyin amaliy murakkablik:
\[ O(N\cdot deg_{avg}) \]
darajasigacha tushirilishi aytiladi. Bu yerda \(N\) tugunlar sonini, \(deg_{avg}\) esa o‘rtacha node degree qiymatini ifodalaydi.
Manba usul bo‘limida \(\epsilon\) ni “learnable threshold” deb ta’riflaydi. Keyingi sensitivity analysis esa \(\epsilon=0.5\) ni tanlangan operating point sifatida taqdim etadi. Nashr etilgan matn ushbu ikki ta’rifni alohida muvofiqlashtirmagani sababli Verianla ularning birini ikkinchisining o‘rniga qo‘ymaydi.
Chegara sezgirligi
| Chegara sharti | Manba natijasi | Izoh |
|---|---|---|
| \(\epsilon \in [0.4,0.6]\) | F1 > %91 | Model yuqori F1 darajasini saqlaydi. |
| Pastroq chegaralar | Aniq son berilmagan. | Manba ko‘proq shovqinli bog‘lanishlar paydo bo‘lishini bildiradi. |
| \(\epsilon > 0.7\) | F1 taxminan %86,5 | Graph fragmentation yuzaga kelishi qayd etiladi. |
| Tanlangan qiymat | \(\epsilon=0.5\) | Shovqinni filtrlash bilan structural integrity o‘rtasidagi eng maqbul muvozanat sifatida manba tomonidan tanlangan. |
Transformer self-attention nima qiladi?
Vaqt encoder ining asosiy attention tenglamasi:
\[ Attention(Q,K,V) = softmax \left( \frac{QK^T}{\sqrt{d_k}} \right)V \tag{3} \]
\(Q\): Query matritsasi.
\(K\): Key matritsasi.
\(V\): Value matritsasi.
\(d_k\): Key vector o‘lchamidir.
\(QK^T\) turli vaqt/tugun ifodalari orasidagi munosabat ballarini hosil qiladi. \(\sqrt{d_k}\) bilan masshtablash katta ichki ko‘paytmalarning softmax ni haddan tashqari keskinlashtirishini cheklash uchun ishlatiladi. Softmax natijalari attention weights bo‘ladi va bu vaznlar \(V\) ga qo‘llanadi.
Tadqiqotda sakkizta attention head ishlatadigan olti qatlamli Transformer mavjud. Hidden dimension 512. Multi-head tuzilma modelning turli representation quyi fazolarida turli munosabatlarni bir vaqtning o‘zida ko‘rib chiqishini maqsad qiladi.
Graph convolution nima qiladi?
Spatial encoder uchun manba quyidagi tenglamani beradi:
\[ h_i' = \sigma \left( \sum_{j\in\mathcal{N}(i)} \frac{1}{c_{ij}} W h_j \right) \tag{4} \]
\(h_i'\): \(i\) tugunining yangilangan representation idir.
\(\mathcal{N}(i)\): \(i\) tugunining qo‘shnichilik to‘plamidir.
\(h_j\): Qo‘shni tugun \(j\) ning joriy representation idir.
\(W\): O‘rganiladigan transformatsiya matritsasidir.
\(c_{ij}\): Manba tenglamasidagi normalization hadidir; maqola uning batafsil ta’rifini alohida bermaydi.
\(\sigma\): Nonlinear activation funksiyasidir.
Bu amal tugunning representation ini nafaqat o‘z ma’lumoti bilan, balki dinamik graph dagi qo‘shnilarining ma’lumoti bilan ham yangilaydi.
Federated Differential Privacy Ushbu Doirada Qanday Himoya Ta’minlaydi?
Federated differential privacy xom tarmoq trafigini markaziy serverga ko‘chirmasdan har bir qurilmaning modelni o‘z mahalliy ma’lumotlari ustida yangilashiga, faqat model yangilanishlarining aggregation uchun ulashilishiga va gradient clipping hamda Gaussian noise yordamida bitta training sample ning model yangilanishiga ta’sirini cheklashga asoslanadi; manbada \(\sigma=0.1\), taxminan \(\epsilon=2.4\) va \(\delta=10^{-5}\) qiymatlari qayd etilgan.
Feature decoupling
Manba mahalliy gradient ni ikki komponent sifatida ko‘rib chiqadi:
- Structural component: \(\nabla_{\theta}^{str}\), graph/topology ma’lumotini tashuvchi komponent.
- Task component: \(\nabla_{\theta}^{tsk}\), classification vazifasiga aloqador komponent.
Mualliflar structural komponentga kattaroq clipping threshold qo‘llash muhim topological features ni saqlashga, task komponentida esa qattiqroq clipping qo‘llash privacy himoyasiga yordam berishini bildiradilar. Manba ushbu ikki threshold ning aniq sonli qiymatlarini bermaydi.
Tenglama 5: Mahalliy model yangilanishi
\[ \theta_i = \theta_i - \eta\nabla_{\theta}\mathcal{L}(\theta_i) \tag{5} \]
\(\theta_i\): \(i\). qurilmaning mahalliy model parametrlaridir.
\(\eta\): Learning rate.
\(\nabla_{\theta}\mathcal{L}(\theta_i)\): Mahalliy loss ning parametrlarga nisbatan gradient idir.
Har bir qurilma o‘z lokal training data sidan gradient hisoblab, o‘z modelini yangilaydi.
Tenglama 6: Global model aggregation
\[ \theta_{global} = \frac{1}{N} \sum_{i=1}^{N} \theta_i \tag{6} \]
Manba markaziy serverda local model parameters ning oddiy arifmetik o‘rtachasini ko‘rsatadi. \(N\) aggregation da qatnashayotgan device/client sonini ifodalaydi.
Manba client sample soniga qarab alohida vaznlangan aggregation formulasini Tenglama 6 da bermaydi.
Tenglama 7: Noise injection
\[ \theta_i^{priv} = \theta_i + \mathcal{N}(0,\sigma^2) \tag{7} \]
Ushbu ifoda local update ga nol o‘rtachali Gaussian noise qo‘shilishini ko‘rsatadi. Manba ushbu tenglama atrofidagi izohda adaptive clipping ni ham tilga oladi; clipping ning batafsilroq matematik ko‘rinishi keyinroq Tenglama 12 da beriladi.
DP-SGD clipping bosqichi
Manba gradient normasini \(C\) threshold bilan cheklaydi:
\[ \hat{g}_t = \frac{g_t} {\max\left(1,\frac{\lVert g_t\rVert_2}{C}\right)} \]
Agar \(\lVert g_t\rVert_2\leq C\) bo‘lsa, maxrajdagi maksimum 1 bo‘ladi va gradient o‘zgarmaydi. Gradient normasi \(C\) dan oshsa, gradient ayni yo‘nalishda saqlanib, kattaligi cheklanadi.
Tenglama 12: Clipping dan keyingi noisy parameter update
\[ \theta_{t+1} = \theta_t - \eta\cdot Adam \left( \hat{g}_t+ \mathcal{N}(0,\sigma^2 C^2 I) \right) \tag{12} \]
Manba tajriba sozlamalarida:
- \(\eta=1\times10^{-4}\),
- \(\sigma=0.1\),
- \(\epsilon\approx2.4\),
- \(\delta=10^{-5}\),
- privacy-accounting horizon = 100 training epoch
qiymatlarini beradi.
\(\epsilon\) va \(\delta\) differential privacy parametrlaridir. Umumiy talqinda kichikroq privacy budget kuchliroq maxfiylikni anglatishi mumkin; biroq ushbu tadqiqotda unumdorlik/maxfiylik baholashi faqat manbada berilgan sharoitlar doirasida ko‘rib chiqilishi kerak.
Abstract da membership inference hujumlari ayni privacy budget ostida pastroq muvaffaqiyat darajasiga erishgani aytiladi. Biroq asosiy natijalar bo‘limida membership-inference success rate uchun alohida sonli jadval yoki test tafsiloti berilmagani sababli bu da’voni miqdoriy jihatdan kengaytirib bo‘lmaydi.
Gradient compression
Abstract, discussion va efficiency baholashi federated gradient compression strategiyalarini tilga oladi. Biroq nashr etilgan usul matni compression operator ning shakli, compression ratio yoki qo‘llangan quantization/sparsification algoritmini alohida tenglama bilan qayd etmaydi. Shu sababli gradient compression ning exact implementation i manbada batafsil qayta yaratish mumkin bo‘lgan holatda emas.
Hujumni aniqlashdan mudofaa qaroriga o‘tish
Tadqiqotda network state \(s\) joriy vaqt oynasidan chiqarilgan trafik tezliklari, protocol distributions va anomaly scores kabi ko‘rsatkichlarni o‘z ichiga oladi. Spatio-temporal Transformer ushbu state representation ni hosil qiladi va reinforcement-learning agent mudofaa harakatini tanlaydi.
Tenglama 8: Q-learning yangilanishi
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+ \gamma \max_{a'}Q(s',a') - Q(s,a) \right] \tag{8} \]
\(s\): Joriy network state.
\(a\): Tanlangan defense action.
\(r\): Harakatdan keyingi reward.
\(s'\): Keyingi network state.
\(\alpha\): Q-learning update koeffitsiyentidir; manba ushbu tenglama uchun sonli \(\alpha\) qiymatini bermaydi.
\(\gamma\): Kelajakdagi reward larni bugungi qiymatga keltiruvchi discount factor. DQN loss bo‘limida manba \(\gamma=0.9\) dan foydalanadi.
Reward funksiyasi
\[ r= w_1\cdot \mathbf{1}(\mathrm{Correct\ Response}) - \left( w_2 L+w_3F \right) \]
\(\mathbf{1}(\mathrm{Correct\ Response})\): Hujumni muvaffaqiyatli to‘sish holatini ko‘rsatuvchi indicator.
\(L\): Response latency.
\(F\): False-positive cost.
\(w_1,w_2,w_3\): Security requirement ga qarab sozlanadigan giperparametrlardir. Manba ushbu vaznlarning sonli qiymatlarini qayd etmaydi.
Bu reward tuzilmasi faqat hujumni to‘sish muvaffaqiyatini mukofotlamaydi; yuqori response latency va false-positive xarajatini ham jazo sifatida hisobga oladi.
Global multi-objective loss
\[ \mathcal{L}(\theta) = \mathcal{L}_{CE}(\theta) + \lambda_{Defense} \mathcal{L}_{Defense}(\theta) + \lambda_{reg} \mathcal{L}_{reg}(\theta) \tag{9} \]
Manba:
\[ \lambda_{Defense}=0.5 \]
va
\[ \lambda_{reg}=1\times10^{-4} \]
qiymatlaridan foydalanadi.
\(\mathcal{L}_{CE}\) attack-detection classification error ni, \(\mathcal{L}_{Defense}\) reinforcement-learning defense loss ni, \(\mathcal{L}_{reg}\) esa overfitting ni cheklaydigan regularization hadini ifodalaydi.
Tenglama 10: Binary cross-entropy
\[ \mathcal{L}_{CE}(\theta) = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log(\hat{y}_i) + (1-y_i)\log(1-\hat{y}_i) \right] \tag{10} \]
\(y_i\in\{0,1\}\) haqiqiy yorliqni, \(\hat{y}_i\) modelning hujum ehtimolini, \(N\) esa batch size ni ifodalaydi.
Haqiqiy hujumga past attack probability yoki haqiqiy normal namunaga yuqori attack probability berilganda loss ortadi.
Tenglama 11: DQN Temporal Difference loss
\[ \mathcal{L}_{Defense}(\theta) = \mathbb{E}_{(s,a,r,s')} \left[ \left( r+ \gamma \max_{a'} Q(s',a';\theta^-) - Q(s,a;\theta) \right)^2 \right] \tag{11} \]
\(\theta\): Current Q-network parametrlaridir.
\(\theta^-\): Muayyan oraliqlarda muzlatiladigan target network parametrlaridir.
\(\gamma=0.9\): Discount factor.
Loss joriy Q-value bilan Bellman target orasidagi Temporal Difference xatosining kvadratini kamaytirishni maqsad qiladi.
Tadqiqot Usuli va Natijalari
Ma’lumotlar to‘plamlari va preprocessing
| Ma’lumotlar to‘plami | Kontekst | Feature o‘lchami | Table 1 train / validation / test | Preprocessing |
|---|---|---|---|---|
| UNSW-NB15 | Umumiy network-attack detection; manba 9 attack type ni o‘z ichiga olishini bildiradi. | d = 42 | 50k / 5k / 10k | Standardization |
| BoT-IoT | IoT/IIoT tarmoq trafigi; DDoS, DoS, scanning va boshqa attack types | d = 10 core network feature | 100k / 10k / 20k | Min-Max normalization |
Manba model vazifasini normal/hujum ko‘rinishidagi binary classification sifatida belgilaydi. Shu sababli ma’lumotlar to‘plamlarida bir nechta hujum oilalari bo‘lsa-da, asosiy objective va Tenglama 10 binary label tuzilmasidan foydalanadi.
UNSW-NB15 uchun usul matni training/validation/testing nisbatlarini mos ravishda %50/%10/%40 deb ham ko‘rsatadi. Biroq Table 1 da berilgan 50k/5k/10k sonlari ushbu foizlarga mos kelmaydi. Verianla ushbu ikki xil manba ifodasidan birini yashirincha tuzatmaydi.
Table 1 ning “Source / Acquisition Method” ustunida UNSW-NB15 va BoT-IoT qatorlarida ayni BoT-IoT loyiha manzili ko‘rinishi ham manba jadvalining o‘z taqdimot xususiyatidir. Verianla buni UNSW-NB15 ning haqiqiy manba manzili sifatida qayta bermaydi.
Manual feature selection ishlatilganmi?
Yo‘q. Manba har ikki ma’lumotlar to‘plami spatio-temporal encoder ga berilishidan oldin qo‘shimcha manual feature selection qo‘llanmaganini bildiradi. Maqsad modelning end-to-end feature extraction salohiyatini baholashdir.
Model va apparat
| Element | Manba qiymati |
|---|---|
| GPU | NVIDIA GeForce RTX 3080, 10 GB VRAM |
| Framework | PyTorch 1.10 |
| CUDA | 11.2 |
| Transformer qatlami | 6 |
| Hidden dimension | 512 |
| Attention head | 8 |
| Optimizer | Adam |
| Initial learning rate | \(1\times10^{-4}\) |
| \(\lambda_{Defense}\) | 0.5 |
| \(\lambda_{reg}\) | \(1\times10^{-4}\) |
| DP noise multiplier | \(\sigma=0.1\) |
| Random seed | 42 |
Experimental Setup bo‘limi robustness testing uchun Gaussian noise standard deviation qiymatini 0.05 deb beradi. Keyingi robustness validation esa noise standard deviation ni 0 dan 0.2 gacha oshiradigan kengroq sweep ni qayd etadi.
Takrorlash sonidagi manba ichki farq
Experimental Setup oxirida manba “results are reported as the mean ± standard deviation over 5 runs” iborasidan foydalanadi. Quantitative Results bo‘limida esa “all experiments were repeated 10 times” deyiladi. Table 4 sarlavhasi ham aniq n=10 deb ko‘rsatadi.
Shu sababli takrorlash sonini barcha tajribalar uchun yagona aniq son sifatida qayta yozish xavfsiz emas. Table 3–4 da ko‘rinadigan mean ± standard deviation qiymatlari manbada nashr etilgan shaklda saqlangan.
Baholash metriklari
Manba Accuracy, Precision, Recall va F1-Score dan foydalanadi:
\[ Accuracy= \frac{TP+TN} {TP+TN+FP+FN} \]
\[ Precision= \frac{TP}{TP+FP} \]
\[ Recall= \frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
TP to‘g‘ri hujum aniqlanishlarini, TN to‘g‘ri normal trafik qarorlarini, FP normal trafik uchun noto‘g‘ri hujum ogohlantirishini, FN esa o‘tkazib yuborilgan haqiqiy hujumlarni ifodalaydi.
Baseline usullari
- LSTM-IDS: Vaqt dependency larini modellashtiruvchi recurrent baseline.
- FedIDS: Federated-learning asosidagi intrusion-detection baseline.
- DP-GNN: Differential privacy bilan graph convolution ni birlashtiruvchi privacy-preserving baseline.
- RustGraph: Dynamic graph anomaly detection uchun structural-temporal dependency ni modellashtiruvchi baseline.
Asosiy unumdorlik taqqoslanishi
| Usul | Ma’lumotlar to‘plami | Accuracy | FPR | F1 | Training Time | p-value |
|---|---|---|---|---|---|---|
| LSTM-IDS | UNSW-NB15 | 87.2% ± 0.6% | 5.2% ± 0.3% | 86.4% ± 0.5% | 1200 ± 120 s | <0.001 |
| LSTM-IDS | BoT-IoT | 84.5% ± 0.8% | 6.8% ± 0.4% | 83.9% ± 0.7% | 1500 ± 150 s | <0.001 |
| FedIDS | UNSW-NB15 | 89.5% ± 0.5% | 3.8% ± 0.2% | 88.7% ± 0.6% | 1300 ± 130 s | 0.002 |
| FedIDS | BoT-IoT | 87.0% ± 0.7% | 4.5% ± 0.3% | 86.2% ± 0.8% | 1600 ± 160 s | 0.001 |
| DP-GNN | UNSW-NB15 | 90.3% ± 0.4% | 3.1% ± 0.2% | 89.5% ± 0.5% | 1400 ± 140 s | 0.005 |
| DP-GNN | BoT-IoT | 88.5% ± 0.6% | 3.9% ± 0.3% | 87.8% ± 0.7% | 1700 ± 170 s | 0.003 |
| RustGraph | UNSW-NB15 | 91.2% ± 0.3% | 2.4% ± 0.1% | 90.5% ± 0.4% | 1500 ± 150 s | 0.01 |
| RustGraph | BoT-IoT | 90.0% ± 0.5% | 3.0% ± 0.2% | 89.2% ± 0.6% | 1800 ± 180 s | 0.008 |
| Proposed Method | UNSW-NB15 | 93.5% ± 0.2% | 1.2% ± 0.1% | 92.8% ± 0.3% | 1100 ± 110 s | — |
| Proposed Method | BoT-IoT | 92.0% ± 0.4% | 1.8% ± 0.2% | 91.3% ± 0.5% | 1400 ± 140 s | — |
Proposed Method har ikki ma’lumotlar to‘plamida ham manba jadvalidagi eng yuqori accuracy va F1 qiymatlarini, shu bilan birga eng past FPR qiymatlarini beradi.
BoT-IoT da proposed accuracy %92,0, DP-GNN accuracy %88,5 bo‘lgani uchun farq:
\[ 92.0-88.5=3.5 \]
3,5 foiz punktdir. Bu ifoda relative percentage increase emas, ikki accuracy foizi orasidagi mutlaq percentage-point farqidir.
Table 3 p-value ustunida baseline lar uchun qiymatlar beriladi va significance level 0.05 deb ko‘rsatiladi. Biroq manba qo‘llangan exact statistical test nomini va p-value ustunidagi exact null hypothesis ni batafsil qayd etmaydi. Shu sababli p-qiymatlari qaysi testdan hosil qilingani Verianla tomonidan taxmin qilinmagan.
Convergence natijasi
Manba Figure 5 da proposed method UNSW-NB15 da taxminan 80. epoch da %90 accuracy darajasiga yetganini, RustGraph ning o‘xshash darajaga yetishi 92 epoch dan ko‘proq davom etganini bildiradi.
Manba bu tezroq convergence xatti-harakatini adaptive graph structure va spatio-temporal attention ning redundant connections orqali gradient propagation ni kamaytirishi bilan bog‘laydi. Ushbu mexanizm talqini mualliflarning izohidir.
Efficiency natijalari
| Usul | Parametr (M) | FLOPs (G) | Training Time (s/epoch) | Inference Latency (ms/sample) |
|---|---|---|---|---|
| LSTM-IDS | 2.1 ± 0.0 | 4.8 ± 0.1 | 15.0 ± 0.8 | 1.2 ± 0.1 |
| FedIDS | 3.4 ± 0.1 | 7.2 ± 0.3 | 16.3 ± 0.9 | 1.8 ± 0.2 |
| DP-GNN | 5.7 ± 0.2 | 12.5 ± 0.5 | 17.5 ± 1.0 | 2.5 ± 0.3 |
| RustGraph | 6.9 ± 0.3 | 15.0 ± 0.6 | 18.8 ± 1.1 | 3.0 ± 0.2 |
| Proposed Method | 7.2 ± 0.2 | 14.8 ± 0.5 | 13.8 ± 0.7 | 2.1 ± 0.2 |
Proposed Method parametrlar soni bo‘yicha eng katta model: 7,2 million parametr. Shunga qaramay, RustGraph ning 18,8 s/epoch training time iga qarshi 13,8 s/epoch va 3,0 ms/sample inference latency siga qarshi 2,1 ms/sample beradi.
Manba RustGraph ga nisbatan training time taxminan %26,6, inference latency esa %30 past ekanini bildiradi. GNN asosidagi baseline hidden dimensions o‘xshash parameter scale ni ta’minlaydigan tarzda standardize qilingani ham qayd etiladi.
2,1 ms Inference Kechikishi Real Vaqtdagi Amaliy Maydon Muvaffaqiyatini Isbotlaydimi?
Yo‘q. Manba 2,1 ± 0,2 ms/sample qiymati dynamic graph construction, feature extraction va Transformer forward pass ni qamrab oladigan o‘zining tajribaviy end-to-end inference o‘lchovi ekanini va taxminan 500 traffic sample/s qayta ishlash quvvatiga mos kelishini bildiradi; biroq o‘lchov RTX 3080 GPU da benchmark ma’lumotlari bilan bajarilgan va haqiqiy edge qurilmasi, V2X transport vositasi yoki ishlab chiqarish tarmog‘idagi uzoq muddatli dala deployment i emas.
Matematik jihatdan:
\[ \frac{1}{0.0021\;s} \approx476\;sample/s \]
bo‘ladi. Manbaning “nearly 500 traffic samples per second” iborasi ushbu taxminiy qiymatga mos keladi.
Biroq manba discussion bo‘limida adaptive graph construction juda resource-constrained micro-IoT node larda qo‘shimcha computation overhead keltirib chiqarishini va optimallashtirish zarurligini ochiq tan oladi.
Muvaffaqiyatli sifat misoli
Manba “UNSW-NB15 – DoS Hulk” yorlig‘i bilan bergan misolda 28–32. soniyalar orasidagi attack window da maqsad host ga yangi ulanishlar soni baseline o‘rtacha 24,3 connection/s darajasidan 3872 connection/s peak qiymatigacha oshganini bildiradi.
Normal fluctuation oralig‘i taxminan ±2σ ≈ 60 deb berilgan. Proposed Method hujumni %96,7 confidence bilan DoS sifatida tasniflagan.
t=30 s paytida attention vaznlari:
| Feature | Attention weight |
|---|---|
| Connection burstiness | 0.42 |
| Destination port diversity | 0.38 |
LSTM-IDS ayni namunani %58,1 confidence bilan normal trafik sifatida noto‘g‘ri tasniflagan.
Manba nomlash izohi: Maqola ushbu holatni aniq “UNSW-NB15 – DoS Hulk Attack Detection” deb ataydi. Nashr etilgan matn ushbu hujum nomlanishining ma’lumotlar to‘plami taksonomiyasi bilan aloqasini alohida tushuntirmaydi. Verianla manba yorlig‘ini o‘zgartirmaydi va yetishmayotgan izohni o‘ylab topmaydi.
Ultra-Past Chastotali Skanerlashda Model Nega Muvaffaqiyatsiz Bo‘ldi?
Manbada berilgan past tezlikdagi port-scan misolida hujum signali normal IoT heartbeat trafigiga juda yaqin bo‘lgani, federated clients faqat cheklangan mahalliy ko‘rinishga ega bo‘lgani va \(\sigma=0.1\) differential-privacy noise zaif anomaly gradient larini bostirgani sababli dynamic graph mazmunli anomaly edge larini hosil qila olmagan va model hujumni normal trafik sifatida tasniflagan.
| Element | Manba qiymati |
|---|---|
| Probe chastotasi | 6 daqiqada 1 probe |
| Jami kuzatuv | 30 daqiqa |
| Jami probe | 5 |
| Hujum packet rate | 0.8 pkt/s |
| Normal IoT heartbeat oralig‘i | 0.7–1.1 pkt/s |
| Adjacency matrix sparsity | 99.6% |
| Model qarori | Normal registration behavior |
| Confidence | 62.3% |
| DP noise | \(\sigma=0.1\) |
Manba kelajakda cross-device meta-event correlations yoki unsupervised anomaly priors kabi mexanizmlar ushbu information-scarcity muammosiga yordam berishi mumkinligini taklif qiladi. Bular joriy tajribada tasdiqlangan natijalar emas.
Noise robustness
Input feature larga Gaussian noise qo‘shilganda standard deviation 0 dan 0.2 gacha oshirilgan. Proposed Method accuracy qiymati %93,5 dan %89,3 gacha tushgan, RustGraph %83,2, DP-GNN esa %84,6 darajasigacha pasaygan.
| Usul | Boshlang‘ich / referens | Noise std = 0.2 sharoitidagi natija |
|---|---|---|
| Proposed Method | 93.5% accuracy | 89.3% accuracy |
| RustGraph | Manba bu jumlada boshlang‘ich qiymatni qayta bermaydi. | 83.2% accuracy |
| DP-GNN | Manba bu jumlada boshlang‘ich qiymatni qayta bermaydi. | 84.6% accuracy |
Manba Figure 7 egri chizig‘ining barcha oraliq numeric nuqtalarini jadval sifatida bermagani uchun Verianla oraliq qiymatlarni interpolatsiya qilmaydi.
Manba, shuningdek, “spatial attention module” olib tashlanganda accuracy %83,5 gacha tushganini bildiradi. Ushbu ibora Table 5 dagi modul nomlanishidan alohida robustness izohida keltirilgan.
Cross-Dataset To‘g‘ridan-To‘g‘ri Transfer Qanday Sinovdan O‘tkazildi?
Cross-dataset generalization tajribasi proposed model UNSW-NB15 da o‘qitilib, BoT-IoT da hech qanday fine-tuning qilinmasdan bevosita sinovdan o‘tkazilishi orqali bajarilgan; manba proposed model har ikki tomonda F1 qiymatini %91 dan yuqori saqlaganini va maqsad BoT-IoT da RustGraph dan 2,1 foiz punkt yuqori natija berganini qayd etadi.
Ushbu tajriba standart ayni-dataset train/test baholashidan kuchliroq distribution-shift sinovidir, chunki model maqsad ma’lumotlar to‘plamiga qayta moslashtirilmagan.
Manba maqsad BoT-IoT da hybrid DDoS kabi unseen attack variants mavjudligini bildiradi. Proposed Method ning dynamic graph structure va local-global federated modeling kombinatsiyasi ushbu distribution shift ga moslashishda rol o‘ynashi mualliflar tomonidan ilgari suriladi.
Biroq cross-dataset natijasi real dunyodagi har bir tarmoq muhiti uchun universal generalization isboti emas. U faqat manbada sinovdan o‘tkazilgan UNSW-NB15 → BoT-IoT transfer shartini qo‘llab-quvvatlaydi.
Ablation tahlili
| Model varianti | UNSW-NB15 | BoT-IoT |
|---|---|---|
| Full Model | 93.5 / 92.8 | 92.0 / 91.3 |
| Adaptive Spatio-Temporal Graph Generation olib tashlandi | 90.1 / 89.4 | 88.7 / 87.9 |
| Federated Differential Privacy olib tashlandi; Centralized Training | 92.8 / 92.0 | 91.2 / 90.5 |
| Reinforcement Learning Dynamic Defense Module olib tashlandi | 93.2 / 92.5 | 91.7 / 91.0 |
| Spatio-Temporal Transformer o‘rniga GCN+LSTM | 89.6 / 88.7 | 87.4 / 86.5 |
| Base GNN Only | 87.3 / 86.1 | 84.9 / 83.8 |
BoT-IoT F1 bo‘yicha full model %91,3. Adaptive graph olib tashlanganda %87,9 gacha tushib, 3,4 percentage-point yo‘qotish yuz beradi. Spatio-temporal Transformer GCN+LSTM bilan almashtirilganda %86,5 gacha tushadi; yo‘qotish 4,8 percentage point.
Federated differential privacy mexanizmi centralized training bilan almashtirilganda BoT-IoT F1 %91,3 dan %90,5 gacha tushadi; farq 0,8 percentage point.
RL dynamic-defense module olib tashlanganda BoT-IoT F1 atigi %91,3 dan %91,0 gacha tushadi. Manba bu kichik classification farqini kutilgan natija deb talqin qiladi, chunki reinforcement-learning qatlamining asosiy vazifasi classification emas, hujumdan keyingi response strategy ni tanlashdir.
Base GNN Only tuzilmasi BoT-IoT da %83,8 F1 bilan eng zaif variantdir. Ushbu natija manbada graph representation ning o‘zi yetarli emasligini va spatio-temporal attention ning muhim hissasini qo‘llab-quvvatlovchi ablation topilmasi sifatida talqin qilinadi.
Privacy–utility trade-off
Ablation federated differential privacy mexanizmini olib tashlash accuracy/F1 da boshqa markaziy arxitektura komponentlaridek katta farq keltirib chiqarmaganini ko‘rsatadi. Manba buni privacy protection pastroq utility yo‘qotishi bilan qo‘llanishi mumkinligining dalili sifatida talqin qiladi.
Biroq privacy mexanizmi uchun membership-inference success rate asosiy natija jadvallarida miqdoriy berilmagani sababli privacy–utility baholashi asosan differential-privacy parametrlari, detection metrics va ablation natijalari orqali kuzatiladi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Adaptiv spatio-temporal graph va Transformer kombinatsiyasi ishlatilgan ikki benchmark da baseline lardan yuqoriroq accuracy va F1 hosil qilgan.
- Proposed Method UNSW-NB15 da %93,5 ± %0,2 accuracy va %92,8 ± %0,3 F1 ga erishgan.
- Proposed Method BoT-IoT da %92,0 ± %0,4 accuracy va %91,3 ± %0,5 F1 ga erishgan.
- BoT-IoT da proposed accuracy DP-GNN dan 3,5 percentage point yuqori.
- FPR UNSW-NB15 da %1,2 ± %0,1, BoT-IoT da %1,8 ± %0,2 deb qayd etilgan.
- UNSW-NB15 → BoT-IoT direct-transfer tajribasi fine-tuning siz bajarilgan.
- Adaptive graph va Transformer ablation lari model unumdorligidagi eng katta pasayishlarni yuzaga keltirgan.
- Federated differential privacy mexanizmini centralized training bilan almashtirish full model ga nisbatan %1 dan kam F1 farqini yuzaga keltirgan.
- RTX 3080 tajriba muhitida end-to-end inference latency 2,1 ± 0,2 ms/sample deb o‘lchangan.
- Input noise std 0,2 gacha oshirilganda proposed accuracy %89,3 gacha pasaygan, biroq manbada taqqoslangan baselines dan yuqori qolgan.
- Ultra-low-frequency scanning misoli modelning muhim muvaffaqiyatsizlik chegarasini ko‘rsatadi.
Tadqiqot qo‘llab-quvvatlamaydigan yoki yetishmay qoldirgan natijalar
- Haqiqiy V2X avtomobil tarmog‘i yoki tijoriy IoT deployment ida uzoq muddatli dala unumdorligi ko‘rsatilmagan.
- 2,1 ms natijasi barcha micro-IoT apparatlarida ayni latency olinishi kafolatini bermaydi.
- UNSW-NB15 → BoT-IoT transfer natijasi har bir noma’lum tarmoq ma’lumotlar domenida ayni generalization yuz berishini isbotlamaydi.
- Ultra-low-frequency stealth attacks hal qilinmagan.
- Membership inference hujumlarining muvaffaqiyat darajasidagi pasayish abstract da bildirilsada, asosiy matnda miqdoriy qiymat va batafsil protokol berilmagan.
- Gradient-compression algoritmining exact implementation i, compression ratio va operator tafsilotlari qayd etilmagan.
- Sliding temporal window size \(K\) ning sonli qiymati qayd etilmagan.
- Structural va task gradient clipping threshold qiymatlari alohida qayd etilmagan.
- Reward weights \(w_1,w_2,w_3\) sonli berilmagan.
- Table 3 dagi p-value larni hosil qilgan statistical test ning exact nomi qayd etilmagan.
- Manbada 5 run va 10 repeat iboralari o‘rtasida nomuvofiqlik mavjud.
- UNSW-NB15 uchun yozilgan %50/%10/%40 nisbati Table 1 dagi 50k/5k/10k sonlariga mos kelmaydi.
Cheklovlar va kelajakdagi tadqiqot
Manba eng muhim cheklov extremely low-frequency stealth attacks ekanini bildiradi. Federated learning client larining cheklangan local views ga ega bo‘lishi va differential-privacy noise ning past-amplitude anomaly gradients ni bostirishi ayniqsa siyrak hujumlarda detection ni qiyinlashtiradi.
Adaptive graph construction 2,1 ms overall latency ichida ishlashiga qaramay, severely resource-constrained micro-IoT node larda qo‘shimcha energy/computation overhead hosil qilishi mumkinligi bildiriladi.
Taklif etilgan kelajakdagi ishlar orasida client lar o‘rtasida lightweight meta-event summary ulashish, Secure Multi-Party Computation yoki highly aggregated statistics dan foydalanish, event-driven sparse graph updates, fully unsupervised yoki open-set anomaly detection hamda micro-embedded devices uchun graph-construction optimallashtirish mavjud.
Manba va Usul Haqida Izoh
Original sarlavha: A Spatio-Temporal Transformer-Based Approach for Network Attack Detection
Mualliflar va tartib: Xin Liu; Xiang Liu.
Corresponding author: Xin Liu; manbada yulduzcha bilan ko‘rsatilgan.
Xin Liu muassasasi: School of Advanced Engineering, University of Science and Technology Beijing, Beijing 100083, China.
Xin Liu e-pochta: u202341641@xs.ustb.edu.cn
Xiang Liu muassasasi: School of International Education, Beijing University of Chemical Technology, Beijing 102203, China.
Xiang Liu e-pochta: 2024090034@mail.buct.edu.cn
Teng hissa / teng birinchi mualliflik: Manbada teng hissa bayonoti mavjud emas.
Jurnal: Journal of Universal Computer Science.
Qisqartma: J.UCS.
Jild / son: Volume 32, Number 9.
Sahifalar: 1375–1398.
Nashr yili: 2026.
Submitted: 23 Yanvar 2026.
Accepted: 7 Iyul 2026.
Appeared / Published: 14 Sentabr 2026.
DOI: 10.3897/jucs.207303.
Rasmiy DOI havolasi: https://doi.org/10.3897/jucs.207303
Manba turi: Nashr etilgan original tadqiqot maqolasi.
Taqriz holati: Journal of Universal Computer Science taqrizli jurnaldir; jurnalning joriy rasmiy profilida single-blind review va kamida ikki editorial-board reviewer ko‘rsatilgan.
Maqola litsenziyasi: CC BY 4.0; maqola PDF ining birinchi sahifasida aniq ko‘rsatilgan.
Asosiy muammo: Dynamic network topology sharoitida yuqori accuracy, privacy preservation va past-latency attack detection/response maqsadlarini bitta framework ichida ko‘rib chiqish.
Vazifa formulasi: Binary classification; \(y=0\) normal, \(y=1\) malicious traffic.
Asosiy uch modul: Spatio-temporal feature extraction; federated differential-privacy protection; reinforcement-learning attack detection/defense.
Dynamic graph: Communication relationships va traffic-feature similarity asosidagi time-dependent adjacency matrix.
Graph threshold: Usul bo‘limida learnable \(\epsilon\); sensitivity analysis tanlangan qiymat sifatida \(\epsilon=0.5\) ni qayd etadi.
Threshold sensitivity: \(\epsilon\in[0.4,0.6]\) uchun F1 > %91; \(\epsilon>0.7\) uchun F1 taxminan %86,5.
Transformer: 6 layer, hidden dimension 512, 8-head multi-head attention.
Federated aggregation: Manba Tenglama 6 da local model parameters ning oddiy o‘rtachasini beradi.
Differential privacy: DP-SGD, gradient clipping va Gaussian noise.
DP noise multiplier: \(\sigma=0.1\).
Privacy budget: Taxminan \(\epsilon=2.4\), \(\delta=10^{-5}\), 100 epoch yakunida manbada qayd etilgan shart.
Feature decoupling: Structural gradient va task gradient komponentlariga ajratish; aniq clipping threshold sonlari qayd etilmagan.
Gradient compression: Manba tomonidan komponent sifatida ko‘rsatiladi; exact compression algorithm va nisbat qayd etilmagan.
Reinforcement learning: Q-learning / Deep Q-Network.
DQN discount factor: \(\gamma=0.9\).
Defense actions: Manba misol sifatida traffic limiting va data filtering ni beradi.
Reward: Correct response mukofotini latency va false-positive cost jazosi bilan birlashtiradi; \(w_1,w_2,w_3\) qiymatlari qayd etilmaydi.
Global loss: Binary cross-entropy + defense TD loss + regularization.
\(\lambda_{Defense}\): 0.5.
\(\lambda_{reg}\): \(1\times10^{-4}\).
Optimizer: Adam.
Initial learning rate: \(1\times10^{-4}\).
UNSW-NB15 features: d = 42, ID va labels dan tashqari.
BoT-IoT features: d = 10 core network features.
UNSW preprocessing: Standardization.
BoT-IoT preprocessing: Min-Max normalization.
Manual feature selection: Ishlatilmagan.
Table 1 sample split: UNSW-NB15 50k / 5k / 10k; BoT-IoT 100k / 10k / 20k.
Manba ichidagi partition farqi: Matn UNSW-NB15 uchun %50/%10/%40 nisbatini beradi; Table 1 dagi 50k/5k/10k bunga mos kelmaydi.
Apparat: NVIDIA GeForce RTX 3080 GPU, 10 GB VRAM.
Dasturiy ta’minot: PyTorch 1.10, CUDA 11.2.
Random seed: 42.
Manba ichidagi run-count farqi: Experimental Setup 5 run mean ± std deydi; Quantitative Results 10 repeat deydi va Table 4 n=10 ni ko‘rsatadi.
Significance level: 0.05.
Statistical-test chegarasi: Table 3 p-value beradi; exact statistical-test nomi va null-hypothesis tafsiloti asosiy matnda aniq ko‘rsatilmagan.
UNSW-NB15 asosiy natija: Accuracy 93.5% ± 0.2%; F1 92.8% ± 0.3%; FPR 1.2% ± 0.1%.
BoT-IoT asosiy natija: Accuracy 92.0% ± 0.4%; F1 91.3% ± 0.5%; FPR 1.8% ± 0.2%.
DP-GNN taqqoslanishi: BoT-IoT accuracy 88.5% ± 0.6%; proposed farqi +3.5 percentage point.
Inference latency: 2.1 ± 0.2 ms/sample.
Inference qamrovi: Dynamic graph construction + feature extraction + Transformer forward pass.
Proposed parameter count: 7.2 ± 0.2 million.
Proposed FLOPs: 14.8 ± 0.5 G.
Training time: Table 4 da 13.8 ± 0.7 s/epoch.
Cross-dataset test: UNSW-NB15 da training → BoT-IoT da fine-tuning siz direct testing.
Cross-dataset natijasi: Manba proposed F1 har ikki ma’lumotlar to‘plamida %91 dan yuqori qolganini va maqsad BoT-IoT da RustGraph dan 2.1 percentage point yuqori ekanini bildiradi.
Noise robustness: Gaussian feature noise std 0→0.2; proposed accuracy 93.5%→89.3%.
Muhim failure case: 6 daqiqada bir probe, 30 daqiqada 5 probe, 0.8 pkt/s; normal heartbeat 0.7–1.1 pkt/s; adjacency sparsity 99.6%; normal prediction confidence 62.3%.
Membership inference izohi: Abstract bir xil privacy budget ostida attack success rate sezilarli kamayganini bildiradi; asosiy matnda miqdoriy membership-inference success rate yoki batafsil tajriba protokoli mavjud emas.
Ablation natijasi: BoT-IoT F1 full model 91.3%; no adaptive graph 87.9%; centralized/no federated DP 90.5%; no RL defense 91.0%; GCN+LSTM replacement 86.5%; base GNN only 83.8%.
Moliyalashtirish: Ko‘rib chiqilgan PDF da alohida funding declaration bo‘limi mavjud emas.
Manfaatlar to‘qnashuvi: Ko‘rib chiqilgan PDF da alohida conflict-of-interest declaration mavjud emas.
Data Availability: Ko‘rib chiqilgan PDF da alohida Data Availability statement mavjud emas; tajriba bo‘limida UNSW-NB15 va BoT-IoT public datasets sifatida ta’riflangan.
Muallif hissalari / CRediT: Ko‘rib chiqilgan PDF da alohida author-contributions yoki CRediT bayonoti mavjud emas.
Asosiy tadqiqot chegarasi: Natijalar benchmark ma’lumotlar to‘plamlari va RTX 3080 asosidagi tajriba muhitiga tegishli; haqiqiy micro-IoT node, V2X fleet yoki production SOC da uzoq muddatli dala tasdig‘i emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan