


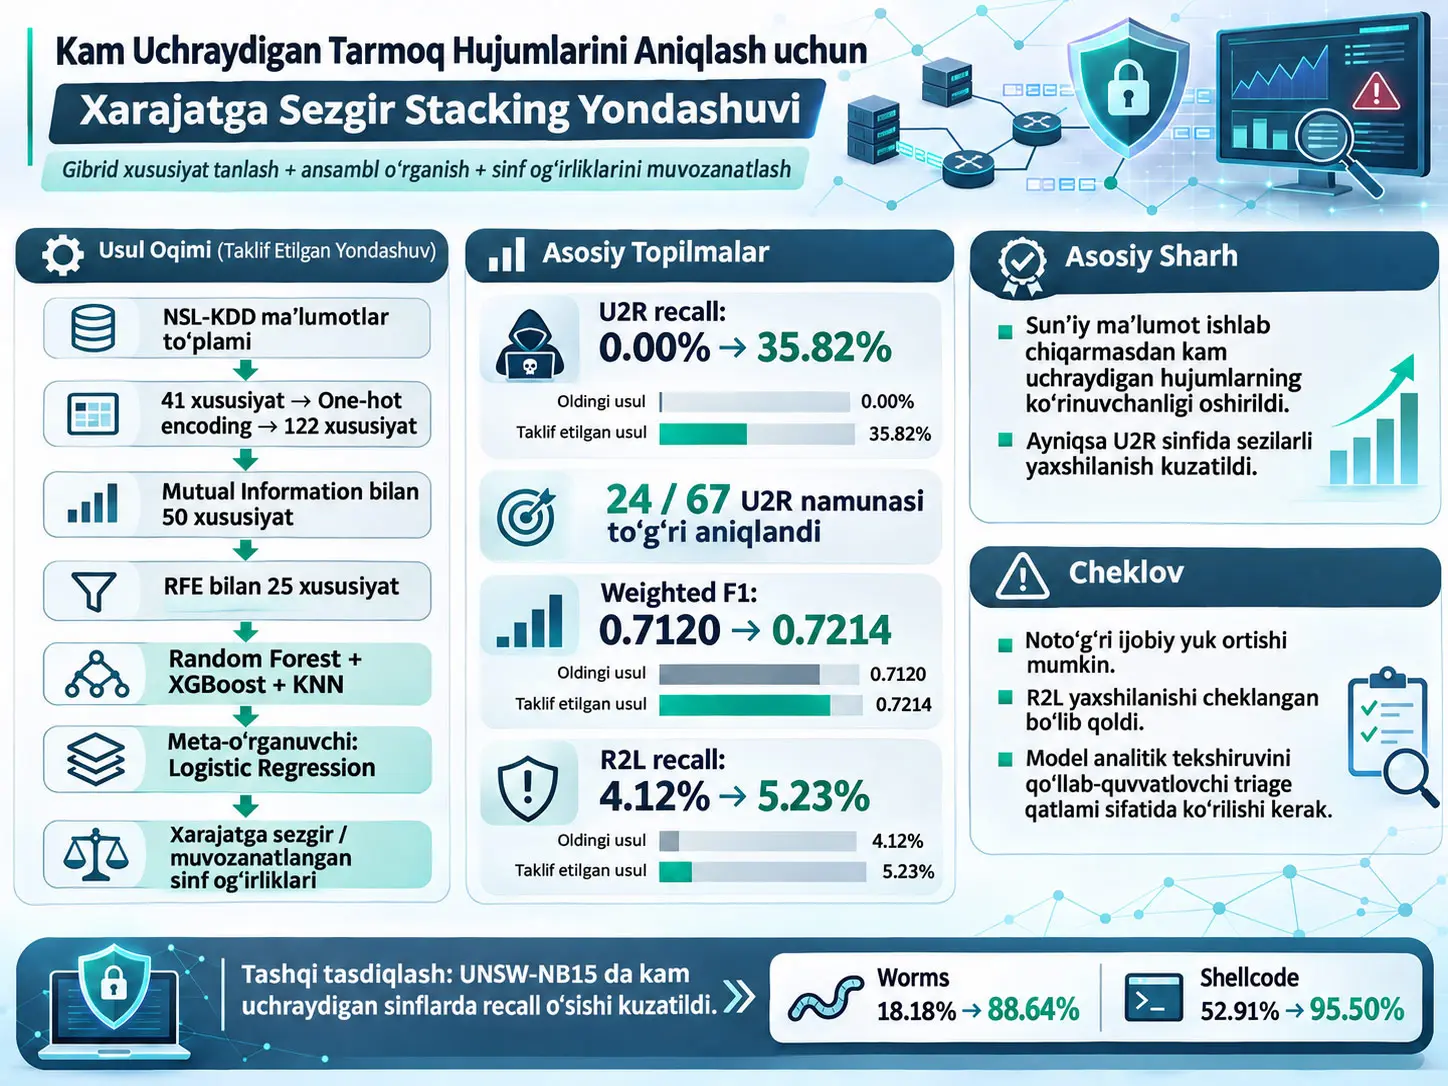
Xarajatga sezgir MI–RFE–stacking doirasi nomutanosib koʻp sinfli tarmoq hujumlarini aniqlashda kam uchraydigan hujumlarning koʻrinuvchanligini oshirish uchun Mutual Information (MI) va Recursive Feature Elimination (RFE) orqali xususiyat tanlash, geterogen stacking ensemble va sinfga bogʻliq xato xarajatlarini birlashtiradigan, ma’lumotlarni saqlovchi Network Intrusion Detection System (NIDS) baholash quvuridir. Tadqiqot yangi tasniflagich taklif qilmaydi; Random Forest, XGBoost, Support Vector Machine (SVM), K-Nearest Neighbors (KNN), Logistic Regression, MI, RFE va balanced class weighting kabi mavjud komponentlarning kam uchraydigan sinflarga yoʻnaltirilgan nazoratli va qayta takrorlanuvchi protokol ostida qanday ishlashini tekshiradi.
Asosiy baholash NSL-KDD benchmark’ida amalga oshirilgan. KDDTrain+ 125,973, KDDTest+ esa 22,544 ta tarmoq ulanish yozuvini oʻz ichiga oladi. Kategorik protocol_type, service va flag oʻzgaruvchilariga one-hot encoding qoʻllangandan soʻng 41 ta asl xususiyat 122 ta sonli xususiyatga kengaytirilgan; faqat oʻquv toʻplamiga moslashtirilgan Min-Max masshtablash qoʻllangan; soʻng MI boʻyicha eng yuqori ball olgan 50 ta xususiyat saqlanib, Random Forest asosidagi RFE bilan soni 25 taga tushirilgan.
Asosiy stacking ensemble Random Forest, XGBoost va KNN’dan base learner, Logistic Regression’dan esa meta-learner sifatida foydalanadi. Meta-learner uchun 3-fold out-of-fold bashoratlar hosil qilinadi. Sinf nomutanosibligi sintetik ma’lumot yaratmasdan, w_c = N/(C n_c) koʻrinishidagi balanced class weighting bilan boshqarilgan. NSL-KDD taqsimotida taxminiy sinf ogʻirliklari Normal uchun 0.37, DoS uchun 0.55, Probe uchun 2.16, R2L uchun 25.32 va U2R uchun 484.49.
Stacking ensemble’ning asosiy bir martalik natijasida U2R recall 0.00% dan 35.82% gacha koʻtarilgan; boshqacha aytganda baseline model 67 ta U2R namunadan birortasini toʻgʻri aniqlay olmagan boʻlsa, cost-sensitive tuzilma 24 tasini toʻgʻri aniqlagan. Weighted F1 0.7120 dan 0.7214 gacha koʻtarilgan, biroq accuracy 0.7542 dan 0.7342 gacha pasaygan. R2L recall esa atigi 4.12% dan 5.23% gacha, ya’ni 119/2887 toʻgʻri aniqlashdan 151/2887 gacha oshgan.
U2R natijasi qat’iy talqin chegarasini talab qiladi. Cost-sensitive hard-label stacking natijasida U2R uchun 24 true positive ga qarshi 1695 false positive qayd etilgani sababli precision atigi 0.0140. Alohida probability-threshold tahlilida ham U2R precision taxminan %1 darajasida qolgan. Shu sababli modelning U2R chiqishi tadqiqotning oʻz muhokamasiga koʻra avtonom yakuniy qaror emas, balki xavfsizlik tahlilchisining tekshiruvini ustuvorlashtiruvchi triage signalidir.
Tadqiqot, shuningdek, cost-sensitive yondashuv barcha muqobillardan ustun emasligini koʻrsatadi. Full-training resampling taqqoslashida ADASYN weighted F1 va R2L recall boʻyicha kuchliroq; keyingi exploratory baselines ichida Balanced Random Forest yuqoriroq U2R recall va pastroq U2R false-positive sonini ta’minlagan. Taklif etilgan yondashuvning farqlovchi afzalligi — sintetik ozchilik namunalarini yaratmasdan asl oʻquv kuzatuvlarini saqlashi va kam uchraydigan hujum xatti-harakatini ochiq nazorat qilishi.
UNSW-NB15 tashqi tekshiruvida ham kam uchraydigan sinflarning recall koʻrsatkichlari sezilarli oshgan; biroq Normal recall va weighted F1 kamaygan. Bu natijalar usul kam uchraydigan sinflarga koʻproq vazn berganda qaror chegaralarini haqiqatan oʻzgartirishini qoʻllab-quvvatlaydi, ammo zamonaviy ishlab chiqarish tarmoqlarida umumiy ustunlik yoki avtomatik deployment muvaffaqiyatini anglatmaydi.
Cost-Sensitive Oʻrganish Ushbu Tadqiqotda Nega Qoʻllanadi?
Cost-sensitive oʻrganish nomutanosib ma’lumotlar toʻplamidagi barcha tasniflash xatolarini teng deb qabul qilish oʻrniga, kam uchraydigan sinflardagi xatolarga yuqoriroq oʻqitish jazosi berib, qaror chegarasini ozchilik sinflarga nisbatan sezgirroq qiladi; ushbu tadqiqotdagi asosiy maqsad, ayniqsa U2R va R2L hujumlarining koʻpchilik sinflar orasida yoʻqolib ketishini kamaytirish bilan birga, asl oʻquv yozuvlarini sintetik namunalar bilan almashtirmaslikdir.
Kam uchraydigan hujumlar nega umumiy accuracy ichida yoʻqolib ketishi mumkin?
NSL-KDD beshta asosiy sinfdan foydalanadi: Normal, Denial of Service (DoS), Probe, Remote-to-Local (R2L) va User-to-Root (U2R). Oʻquv toʻplamida Normal va DoS birgalikda yozuvlarning taxminan %90 ini tashkil qilsa, U2R atigi 52 ta oʻquv namunadan iborat; bu taxminan %0.04 ulushdir. Bunday taqsimotda model koʻpchilik sinflarni yaxshi oʻrganib, kam uchraydigan sinfni deyarli butunlay e’tiborsiz qoldirgan holda ham nisbatan yuqori global accuracy olishi mumkin.
DoS maqsad xizmat yoki resursning mavjudligini buzishga qaratilgan hujum sinfidir. Probe tarmoq yoki tizim haqida ma’lumot toʻplash va mavjud nishonlarni izlash xatti-harakatlarini qamrab oladi. R2L uzoq manbadan mahalliy tizimga ruxsatsiz kirish olish bilan bogʻliq sinfdir. U2R esa foydalanuvchining yuqoriroq yoki administrator/root darajasidagi imtiyozga ega boʻlishi bilan bogʻliq, juda kam uchraydigan, ammo xavfsizlik nuqtai nazaridan muhim sinfdir.
Manbaning 4-rasmida 5000 ta KDDTest+ namunasi t-SNE bilan ikki oʻlchamli tarzda vizuallashtirilgan. Rasmda DoS va Normal namunalari ayrim ancha ajraladigan hududlarni hosil qilgan boʻlsa, R2L va U2R namunalari Normal trafik bilan kuchli ustma-ust tushishi koʻrsatilgan. t-SNE bu yerda tasniflagich emas; yuqori oʻlchamli feature space’ni vizual tekshirish uchun ikki oʻlchamga tushirishda qoʻllaniladigan usuldir. Rasmning xabari shuki, kam uchraydigan hujum muammosi faqat sinf sonidan emas, feature-space overlap’dan ham kelib chiqadi.
Balanced class weight formulasi
Manbada qoʻllanilgan asosiy xarajat ogʻirligi:
\[ w_c=\frac{N}{C\,n_c} \]
Formula nimani hisoblaydi? Har bir sinf uchun oʻqitish paytida ishlatiladigan nisbiy xato ogʻirligini hisoblaydi.
\(w_c\): \(c\) sinfining oʻlchovsiz ogʻirligidir.
\(N\): Jami oʻquv namunalari soni; NSL-KDD asosiy oʻquv toʻplamida 125,973.
\(C\): Sinflar soni; ushbu tadqiqotda 5.
\(n_c\): Tegishli sinfga mansub oʻquv namunalari soni.
Sinfdagi namuna soni kamaygan sari maxrajdagi \(n_c\) kichrayadi va \(w_c\) kattalashadi. Shu sababli U2R kabi juda kam uchraydigan sinfdagi notoʻgʻri tasniflash oʻqitish maqsadi uchun Normal sinfdagi xatoga qaraganda ancha yuqori jazoga ega boʻladi.
| Sinf | Taxminiy ogʻirlik | Algoritmik ma’no |
|---|---|---|
| Normal | 0.37 | Juda tez-tez uchraydigan sinf; xato jazosi nisbatan past. |
| DoS | 0.55 | Yuqori chastotali hujum sinfi. |
| Probe | 2.16 | Oʻrta chastotali sinf. |
| R2L | 25.32 | Kam uchraydigan sinf; notoʻgʻri tasniflash ogʻirroq jazolanadi. |
| U2R | 484.49 | Eng kam uchraydigan sinf; notoʻgʻri tasniflash juda yuqori nisbiy jazo oladi. |
Random Forest, SVM va Logistic Regression uchun class_weight = balanced qoʻllanilgan. XGBoost’da xuddi shu sinf-chastota formulasiga asoslangan namuna ogʻirliklari qoʻllangan. KNNning ishlatilgan standart formulirovkasida ayni class-weight mexanizmi yoʻqligi sababli KNN natijasi cost-sensitive bosqichida oʻzgarmaydi.
Nega toʻgʻridan-toʻgʻri SMOTE qoʻllanmagan?
Mualliflarning ma’lumotni saqlovchi tanlovining asosiy sababi U2R atigi 52 ta haqiqiy oʻquv namunaga ega boʻlishidir. Juda kichik real namunalardan koʻp sonli sintetik kuzatuvlar hosil qilinganda son jihatdan foydali, ammo haqiqiy hujum xatti-harakatini yetarlicha ifodalamaydigan sun’iy qaror hududlari paydo boʻlishi mumkin degan xavotir mavjud. Shu sababli asosiy framework oʻquv ma’lumotlarini koʻpaytirish oʻrniga loss/qaror xarajatini oʻzgartiradi.
Biroq tadqiqot bu asosni shunchaki taxmin sifatida qoldirmagan va SMOTE, Borderline-SMOTE, ADASYN hamda SMOTE-Tomek’ni ayni full-training protokolida bevosita baseline sifatida sinagan. Natijalar cost-sensitive yondashuv resampling’dan universal ravishda ustun emasligini koʻrsatadi.
Mutual Information nega birinchi xususiyat tanlash bosqichida ishlatiladi?
Mutual Information (MI) feature bilan maqsad sinf orasidagi statistik bogʻliqlikni baholovchi filter turidagi feature-selection usulidir. Tasniflagichni qayta-qayta oʻqitmasdan har bir feature uchun maqsad label bilan axborot bogʻliqligi hisoblanishi mumkinligi sababli dastlabki saralash bosqichida nisbatan past hisoblash xarajatini ta’minlaydi.
Tadqiqotda one-hot encoding’dan keyingi 122 ta xususiyat uchun MI hisoblangan va eng yuqori MI balliga ega 50 ta xususiyat saqlangan. Bu bosqich feature space’ni avval tezkor filter mexanizmi bilan toraytiradi.
Recursive Feature Elimination nima qiladi?
Recursive Feature Elimination (RFE) modelning feature-importance ma’lumotidan foydalanib, eng kam foydali koʻringan xususiyatlarni takroriy ravishda chiqarib tashlaydigan wrapper turidagi tanlash usulidir. Ushbu tadqiqotda 50 ta MI xususiyati Random Forest estimator bilan baholanib, eng kam muhim xususiyatlar chiqarilgan va 25 ta xususiyat qoldirilgan.
MI va RFE’ni birgalikda qoʻllash mantiqi MI’ning tez, modelga bogʻliq boʻlmagan dastlabki filtrlashini RFE’ning modelga sezgir ikkinchi saralashi bilan birlashtirishdir. Manbaning 3-rasmida ikki tanlash mexanizmi 22 ta xususiyatda umumiy boʻlgani, uchta xususiyat faqat MI va uchta xususiyat faqat RFE tomonida boʻlgani koʻrsatilgan.
Yakuniy 25 ta xususiyat
Tadqiqotda ishlatilgan 25 ta xususiyat quyidagilar: src_bytes, diff_srv_rate, same_srv_rate, dst_host_diff_srv_rate, dst_host_srv_count, count, dst_host_same_srv_rate, dst_host_serror_rate, serror_rate, flag_SF, dst_host_srv_serror_rate, flag_S0, srv_serror_rate, logged_in, dst_host_srv_diff_host_rate, dst_host_same_src_port_rate, dst_host_count, srv_count, service_private, dst_host_rerror_rate, dst_host_srv_rerror_rate, rerror_rate, service_eco_i, protocol_type_icmp va service_ecr_i.
Mualliflar bu 25 ta xususiyat barcha NIDS muammolari uchun universal optimal ekanini da’vo qilmaydi. Ushbu roʻyxat faqat nazoratli NSL-KDD MI→RFE pipeline’ining natijasidir.
Tasniflagich giperparametrlari
| Model | Manbadagi sozlama | Muhim metod izohi |
|---|---|---|
| Random Forest | 200 daraxt; maximum depth = 20; internal split uchun minimum 5 namuna | MI’dan keyin RFE estimator sifatida ham qoʻllangan. |
| XGBoost | 200 daraxt; maximum depth = 8; learning rate = 0.1; satr va ustun subsampling = 0.8 | Cost-sensitive holatda per-instance weight qoʻllangan. |
| SVM | RBF kernel; C = 10; gamma = scale | Hisoblash xarajati sabab 30,000 namunali stratified oʻquv quyi toʻplami ishlatilgan. |
| KNN | k = 5; inverse-distance weighting | Standart qoʻllashda class weight ishlatilmagani sabab cost-sensitive natija oʻzgarmaydi. |
| Stacking | RF + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold OOF | Meta-learner leakage’ni kamaytirish uchun out-of-fold predictions bilan oʻqitiladi. |
Manba stacking ichidagi base modellar uchun hisoblash samaradorligi maqsadida “reduced hyperparameters” qoʻllanganini bildiradi, ammo bu qisqartirilgan stacking ichki giperparametrlarining barcha sonli qiymatlarini oʻsha joyning oʻzida ochiq roʻyxatlamaydi. Shu sababli yuqoridagi individual model sozlamalari stacking ichidagi base modellarda aynan bir xil deb taxmin qilinmasligi kerak.
Oʻqitish va test protokoli
Barcha asosiy modellar KDDTrain+ da oʻqitilib, mustaqil KDDTest+ da baholangan. KDDTest+ qayta boʻlinmagan, resample qilinmagan va cross-validation oʻqitishiga kiritilmagan. Bu ajratish test toʻplamiga axborot sizib chiqishini oldini olish va asl NSL-KDD train-test distribution shift’ini saqlash uchun muhim.
Qoʻshimcha repeated-seed, resampling, feature-sensitivity va ablation tajribalari toʻliq 125,973 yozuvli KDDTrain+ bilan bajarilgan. SVM 30,000 namunali oʻqitish cheklovi sabab ushbu qoʻshimcha taqqoslashlardan chiqarilgan.
Dasturiy ta’minot va apparat
| Komponent | Versiya / muhit |
|---|---|
| Python | 3.13.5 |
| scikit-learn | 1.8.0 |
| XGBoost | 3.1.3 |
| imbalanced-learn | 0.14.1 |
| NumPy | 2.3.5 |
| pandas | 2.2.3 |
| Ishlash muhiti | Linux x86_64, CPU-only |
| CPU | Container uchun mavjud 56 logical CPU core |
| RAM | Taxminan 4.3 GB |
| GPU | Qoʻllanmagan |
Dastlabki 1000 KDDTest+ namunasi ustida inference latency alohida oʻlchangan: Random Forest 0.2609 ms/sample, XGBoost 0.1081 ms/sample, KNN 1.6117 ms/sample va Stacking Ensemble 2.0925 ms/sample. Mualliflar bu vaqtlar apparatga bogʻliq ekanini va faqat nisbiy computational behavior’ni tavsiflash uchun bildirilganini ta’kidlaydi.
Manba ichidagi inference-latency nomuvofiqligi
Metod boʻlimida yuqoridagi inference latency qiymatlari aniq qayd etilganiga qaramay, Section 5.3 cheklovlar boʻlimida tadqiqot hali “runtime memory usage, inference latency yoki end-to-end integration” ni oʻz ichiga olmaydi deb yozilgan. Har ikki bayonot ayni nashr qilingan manbada birgalikda mavjud boʻlgani uchun Verianla ulardan birini sukut bilan olib tashlamaydi. Eng xavfsiz talqin — dastlabki 1000 test namunada cheklangan deployment-oriented latency oʻlchovi mavjud, ammo toʻliq ishlab chiqarish pipeline’i uchun runtime/memory/end-to-end ishlash bahosi oʻtkazilmagan. Oxirgi jumla manba ichidagi ikki bayonotni birgalikda talqin qilishdir, yangi tajriba natijasi emas.
Baholash metrikalarini qanday oʻqish kerak?
Manba metrika nomlarini ishlatadi, ammo asosiy precision/recall/F1 tenglamalarini qayta keltirib chiqarmaydi. Quyidagi tenglamalar tadqiqotning yangi natijasi emas, bildirilgan metrikalarning oʻquv maqsadidagi standart ta’riflaridir.
\[ Recall=\frac{TP}{TP+FN} \]
Recall aslida tegishli sinfga mansub boʻlgan namunalar qancha darajada toʻgʻri aniqlanganini oʻlchaydi. U2R kabi yuqori ta’sirli kam uchraydigan hujumda past recall koʻplab hujumlar false negative sifatida oʻtkazib yuborilganini anglatadi.
\[ Precision=\frac{TP}{TP+FP} \]
Precision model tegishli sinf deb chiqargan ogohlantirishlarning qanchasi haqiqatda shu sinfga mansubligini oʻlchaydi. U2R recall oshib, precision juda past qolsa analyst alert burden jiddiy ortishi mumkin.
\[ F1=2\frac{Precision\cdot Recall}{Precision+Recall} \]
F1 precision va recall’ni garmonik oʻrtacha orqali birlashtiradi. Komponentlardan biri juda past boʻlsa, F1 ham cheklanadi.
\[ MacroF1=\frac{1}{C}\sum_{c=1}^{C}F1_c \]
Macro-F1 barcha sinflarga teng ogʻirlik beradi. Shu sababli kam uchraydigan sinflardagi yomon natijalarni majority-class muvaffaqiyati ortida yashirishga weighted F1 ga qaraganda kamroq moyil.
\[ WeightedF1=\sum_{c=1}^{C}\frac{n_c}{N}F1_c \]
Weighted F1 har bir sinfning F1 qiymatini sinf tayanchi bilan ogʻirlashtiradi. Normal va DoS kabi katta sinflar natijaga koʻproq ta’sir qilgani sabab kam uchraydigan sinf muammosini yolgʻiz tushuntirish uchun yetarli emas.
Shu sababli tadqiqot weighted F1 bilan birga macro-F1, balanced accuracy, macro PR-AUC, macro false-positive rate, macro false-negative rate, sinf boʻyicha recall, mutlaq TP/FP sonlari va Wilson 95% confidence interval dan foydalanadi.
U2R Recall 0.00% dan 35.82% gacha Koʻtarilishi Nimani Anglatadi?
U2R recall 0.00% dan 35.82% gacha koʻtarilishi asosiy stacking tajribasida 67 ta haqiqiy U2R test namunasidan baseline model birortasini aniqlamagan, cost-sensitive model esa 24 tasini toʻgʻri aniqlaganini anglatadi; biroq ayni tuzilma juda koʻp U2R false positive ishlab chiqargani sabab natijani “U2R muammosi hal qilindi” deb talqin qilib boʻlmaydi.
Mutlaq son nega foizdan muhimroq?
| Sinf | Test namunasi | TP Baseline | TP Cost-Sensitive | Baseline Recall, %95 GA | Cost-Sensitive Recall, %95 GA |
|---|---|---|---|---|---|
| R2L | 2887 | 119 | 151 | 4.12% [3.46%, 4.91%] | 5.23% [4.48%, 6.10%] |
| U2R | 67 | 0 | 24 | 0.00% [0.00%, 5.42%] | 35.82% [25.40%, 47.78%] |
U2R uchun 35.82% katta foizli oʻsishdek koʻrinadi, ammo test toʻplamida atigi 67 ta U2R namuna bor. 24 ta toʻgʻri aniqlash shu sababli keng Wilson confidence interval bilan birga qayd etilgan. Wilson oraligʻi, ayniqsa namuna kichik boʻlganda, kuzatilgan nisbat noaniqligini bitta foiz koʻrsatishdan koʻra toʻgʻriroq ifodalaydi.
R2L tomonda test namuna soni ancha katta. Shunga qaramay, cost-sensitive tuzilma atigi 32 ta qoʻshimcha R2L namunani toʻgʻri tasniflay olgan. Shu sababli R2L oʻsishi repeated-seed testida statistik jihatdan ahamiyatli koʻrinsa ham, operatsion hajmi cheklangan.
U2R false-positive yuki
| Sozlama | Sinf | TP | FP | FN | Precision | Recall |
|---|---|---|---|---|---|---|
| Baseline | R2L | 119 | 4 | 2768 | 0.9675 | 0.0412 |
| Cost-sensitive | R2L | 151 | 9 | 2736 | 0.9438 | 0.0523 |
| Baseline | U2R | 0 | 0 | 67 | 0.0000 | 0.0000 |
| Cost-sensitive | U2R | 24 | 1695 | 43 | 0.0140 | 0.3582 |
Cost-sensitive stacking endi U2R’ni butunlay e’tiborsiz qoldirmaydi; ammo 24 ta toʻgʻri U2R ogohlantirishiga qarshi 1695 false-positive paydo boʻlishi precision’ni 1.4% darajaga tushiradi. Shu sababli manba modelning U2R ogohlantirishidan analyst triage uchun foydalanishni, yakuniy avtonom hujum qarori sifatida ishlatmaslikni tavsiya qiladi.
R2L nega hanuz muvaffaqiyatsiz?
Failure analysis baseline stacking’da 2887 ta R2L namunadan 2764 tasi Normal deb bashorat qilinganini koʻrsatadi. Class weighting’dan soʻng Normal ga ketadigan son 2269 ga tushadi; ammo 463 ta R2L namuna bu safar toʻgʻri R2L oʻrniga U2R deb tasniflanadi. Shunday qilib model kam uchraydigan hujumlarga sezgirroq boʻlsa ham, yetarlicha aniq R2L decision region oʻrgana olmaydi.
| Sozlama | Sinf | Jami | Normal bashorati | R2L bashorati | U2R bashorati | FNR |
|---|---|---|---|---|---|---|
| Baseline stacking | R2L | 2887 | 2764 | 119 | 0 | 0.959 |
| Baseline stacking | U2R | 67 | 65 | 2 | 0 | 1.000 |
| Cost-sensitive stacking | R2L | 2887 | 2269 | 151 | 463 | 0.948 |
| Cost-sensitive stacking | U2R | 67 | 40 | 3 | 24 | 0.642 |
25 Xususiyatli MI–RFE Tuzilmasi Eng Yaxshi Bashorat Natijasini Beradimi?
Yoʻq. Manbaning feature-subset sensitivity tahlili 50 xususiyatli va 122 xususiyatli konfiguratsiyalar 25 xususiyatli MI–RFE konfiguratsiyasini weighted F1, R2L recall va U2R recall boʻyicha ortda qoldirishini koʻrsatadi; 25 xususiyatli tuzilmaning asoslanishi bashorat ustunligi emas, pastroq oʻlcham, qisqaroq hisoblash vaqti va ixchamlikdir.
| Xususiyat sozlamasi | Tanlash usuli | Weighted F1 | R2L Recall | U2R Recall | Training Time (s) |
|---|---|---|---|---|---|
| 10 xususiyat | Dastlabki 10 tanlangan xususiyat | 0.7053 | 0.0173 | 0.1194 | 110.2 |
| 25 xususiyat | MI + RFE | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| 50 xususiyat | MI top 50 | 0.7668 | 0.1888 | 0.5075 | 160.5 |
| 122 xususiyat | Feature selection yoʻq | 0.7625 | 0.1753 | 0.5224 | 243.5 |
50 xususiyatli tuzilma weighted F1 va R2L recall boʻyicha eng yaxshi natijani bergan boʻlsa, 122 xususiyatli tuzilma U2R recall boʻyicha ozgina farq bilan eng yuqori qiymatni beradi. 25 xususiyatli tuzilma 50 xususiyatli tuzilmaga qaraganda atigi taxminan 9.7 soniya qisqaroq training time bersa ham, uchala asosiy koʻrsatkichda ham zaifroq. Shu sababli manba hisoblash byudjeti imkon bersa, 50 xususiyatni kuchliroq operating point deb belgilaydi.
Tadqiqot Usuli va Natijalari
Baseline model natijalari
| Model | Accuracy | Weighted Precision | Weighted Recall | Weighted F1 | Time (s) |
|---|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7739 | 0.7544 | 0.7055 | 1.4 |
| XGBoost | 0.7504 | 0.8088 | 0.7504 | 0.7039 | 2.9 |
| SVM | 0.7183 | 0.7028 | 0.7183 | 0.6717 | 3.3 |
| KNN | 0.7409 | 0.7815 | 0.7409 | 0.6988 | 0.8 |
| Stacking Ensemble | 0.7542 | 0.8149 | 0.7542 | 0.7120 | 11.7 |
Random Forest eng yuqori baseline accuracy qiymatiga, stacking ensemble esa eng yuqori weighted precision va weighted F1 qiymatiga ega. Shunga qaramay, baseline confusion matrix’lar R2L va U2R koʻpincha Normal deb bashorat qilinishini koʻrsatadi. Shu sababli tadqiqotning asosiy argumenti “stacking allaqachon kuchli” emas, balki aggregate ballar kam uchraydigan sinf muvaffaqiyatsizligini yashirishi mumkinligidir.
Cost-sensitive learning model boʻyicha nimani oʻzgartirdi?
| Model | Accuracy Baseline | Accuracy CW | F1 Baseline | F1 CW |
|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7533 | 0.7055 | 0.7074 |
| XGBoost | 0.7504 | 0.7648 | 0.7039 | 0.7237 |
| SVM | 0.7183 | 0.7611 | 0.6717 | 0.7423 |
| KNN | 0.7409 | 0.7409 | 0.6988 | 0.6988 |
| Stacking Ensemble | 0.7542 | 0.7342 | 0.7120 | 0.7214 |
SVM weighted F1 boʻyicha eng katta global yutuqni koʻrsatadi: 0.6717 dan 0.7423 gacha, ya’ni 7.06 percentage point oʻsish. Biroq SVM toʻliq KDDTrain+ da emas, computational feasibility sabab 30,000 namunali stratified subset da oʻqitilgan. Shu bois SVM natijasi toʻliq ma’lumot bilan ishlaydigan stacking/resampling tajribalari bilan uslubiy jihatdan toʻliq teng emas.
Stacking ensemble’ning accuracy qiymati 0.7542 dan 0.7342 gacha tushgan boʻlsa-da, weighted F1 0.7120 dan 0.7214 gacha oshishi class weighting koʻpchilik sinfdagi ayrim toʻgʻri qarorlarni qurbon qilib, kam uchraydigan sinflarga koʻproq qaror maydoni ochganini koʻrsatadi.
Stacking ensemble sinf boʻyicha qanday oʻzgardi?
| Sinf | Baseline Recall | Cost-Sensitive Recall | Oʻzgarish |
|---|---|---|---|
| DoS | 79.24% | 80.17% | +0.93% |
| Normal | 97.15% | 91.45% | −5.69% |
| Probe | 63.57% | 62.66% | −0.91% |
| R2L | 4.12% | 5.23% | +1.11% |
| U2R | 0.00% | 35.82% | +35.82% |
U2R koʻrinuvchanligi oshganda Normal recall 5.69 percentage point kamayadi. Bu trade-off xato emas, class weighting qaror chegarasini ongli ravishda oʻzgartirishining natijasidir. Xavfsizlik nuqtai nazaridan bu maqbul yoki yoʻqligi oʻtkazib yuborilgan privilege-escalation hodisasi xarajati bilan qoʻshimcha false-positive tekshiruv xarajatini taqqoslashga bogʻliq.
Cost-Sensitive Learning Resampling Usullaridan Yaxshiroqmi?
Yoʻq; tadqiqot cost-sensitive learning barcha imbalance usullaridan ustun ekanini koʻrsatmaydi. Ayni 125,973 namunali KDDTrain+ protokolida ADASYN eng yuqori weighted F1 va R2L recall qiymatlarini ishlab chiqargan, cost-sensitive weighting esa ushbu taqqoslashda eng yuqori U2R recall qiymatini va oʻquv taqsimotini sintetik ma’lumot bilan oʻzgartirmaslik afzalligini ta’minlagan.
| Usul | Ma’lumot darajasidagi oʻzgarish | Weighted F1 | R2L Recall | U2R Recall | Total Time (s) |
|---|---|---|---|---|---|
| Baseline | Yoʻq | 0.7120 | 0.0412 | 0.0000 | 155.8 |
| Cost-sensitive weights | Sintetik ma’lumot yoʻq | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| SMOTE | Sintetik oversampling | 0.7083 | 0.0450 | 0.0597 | 740.9 |
| Borderline-SMOTE | Boundary-focused oversampling | 0.7273 | 0.0551 | 0.0448 | 686.4 |
| ADASYN | Adaptive synthetic oversampling | 0.7478 | 0.0901 | 0.1343 | 680.2 |
| SMOTE-Tomek | Oversampling + Tomek cleaning | 0.7065 | 0.0433 | 0.0597 | 654.0 |
Bu taqqoslashda ADASYN weighted F1 = 0.7478 va R2L recall = 0.0901 bilan cost-sensitive stacking’dan ustun. Buning evaziga cost-sensitive stacking U2R recall = 0.3582 bilan ushbu toʻrtta resampling usulidan kuchliroq va training distribution’ni sintetik namunalar bilan oʻzgartirmaydi.
Kengroq exploratory baseline’lar
| Usul | W-F1 | Macro-F1 | Balanced Accuracy | PR-AUC | R2L Recall | U2R Recall | U2R FP |
|---|---|---|---|---|---|---|---|
| Cost-sensitive stacking | 0.7214 | 0.5023 | 0.5507 | 0.5787 | 0.0523 | 0.3582 | 1695 |
| Balanced Random Forest | 0.7268 | 0.5455 | 0.5927 | 0.6469 | 0.2123 | 0.4627 | 427 |
| XGBoost threshold calibration | 0.7466 | 0.5603 | 0.5692 | 0.6900 | 0.1493 | 0.2537 | 188 |
| Focal-loss MLP | 0.7339 | 0.5640 | 0.5981 | 0.6105 | 0.2224 | 0.3134 | 429 |
Ushbu kengaytirilgan taqqoslash asosiy da’vo chegarasini yanada aniq koʻrsatadi. Cost-sensitive stacking baseline’ga nisbatan U2R koʻrinuvchanligini oshiradi; biroq Balanced Random Forest ham U2R recall, ham R2L recall boʻyicha kuchliroq va U2R false-positive soni ancha past. XGBoost threshold calibration esa eng past U2R false-positive sonini 188 gacha tushiradi, U2R recall esa 0.2537 da qoladi. Shu sababli tadqiqot “taklif qilingan tuzilma barcha muqobillardan yaxshiroq” degan xulosani qoʻllab-quvvatlamaydi.
Repeated-seed statistik testlari
Stoxastik oʻzgaruvchanlik bitta random seed natijasiga bogʻlanib qolmasligi uchun 10 ta seed ishlatilgan: {0, 1, 2, 3, 4, 5, 10, 21, 42, 100}. Baseline va cost-sensitive stacking uchun paired taqqoslashlarda Wilcoxon signed-rank, bir nechta model oilalari uchun Friedman testi qoʻllangan. Ahamiyatlilik chegarasi p < 0.05.
| Taqqoslash | Metrika | Test | p-value | Manba talqini |
|---|---|---|---|---|
| Cost-sensitive stacking vs baseline | Weighted F1 | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | U2R recall | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | R2L recall | Wilcoxon | 0.0039 | Significant |
| Barcha cost-sensitive model oilalari | Weighted F1 | Friedman | 0.0018 | Significant |
Bu yerdagi “statistically significant” iborasi farq kattaligi operatsion jihatdan yetarli degani emas. R2L misoli buni yaqqol koʻrsatadi: repeated-seed testida farq statistik ahamiyatli, ammo asosiy sharoitda recall atigi 4.12% dan 5.23% gacha va TP 119 dan 151 gacha koʻtarilgan. Statistik ahamiyatlilik bilan amaliy xavfsizlik ta’siri turli savollardir.
Component ablation nimani koʻrsatadi?
| Variant | W-F1 | Macro-F1 | Balanced Accuracy | Macro PR-AUC | R2L Recall | U2R Recall |
|---|---|---|---|---|---|---|
| Baseline stack, class weighting yoʻq | 0.712 | 0.492 | 0.488 | 0.608 | 0.041 | 0.000 |
| CW-only XGBoost | 0.752 | 0.594 | 0.571 | 0.750 | 0.091 | 0.209 |
| Stacking, feature selection yoʻq | 0.763 | 0.577 | 0.642 | 0.694 | 0.175 | 0.522 |
| MI-only XGBoost | 0.743 | 0.595 | 0.570 | 0.720 | 0.086 | 0.284 |
| RFE-only XGBoost | 0.711 | 0.510 | 0.500 | 0.670 | 0.044 | 0.075 |
| Stacking olib tashlandi | 0.715 | 0.509 | 0.501 | 0.674 | 0.037 | 0.060 |
| Toʻliq 25-feature framework | 0.721 | 0.502 | 0.551 | 0.579 | 0.052 | 0.358 |
Ablation’ning eng muhim natijasi — U2R visibility oʻsishining asosiy harakatlantiruvchisi class weighting. Class weighting olib tashlansa U2R recall yana nolga tushadi. Shu bilan birga feature reduction tekin emas: feature selection qilinmagan stacking varianti weighted F1, balanced accuracy, R2L recall va U2R recall boʻyicha toʻliq 25-feature framework’dan ustun.
Shu sababli gibrid feature selection’ning ilmiy roli “yuqori accuracy yaratish” emas, balki kichikroq va hisoblash jihatdan samaraliroq feature space olish deb talqin qilinishi kerak.
Weighted F1 nega yolgʻiz yetarli emas?
| Sozlama | Accuracy | Weighted F1 | Macro-F1 | Balanced Accuracy | Macro FPR | Macro FNR | R2L | U2R |
|---|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.754 | 0.712 | 0.492 | 0.488 | 0.084 | 0.512 | 0.041 | 0.000 |
| Cost-sensitive stacking | 0.734 | 0.721 | 0.502 | 0.551 | 0.080 | 0.449 | 0.052 | 0.358 |
Macro FNR 0.512 dan 0.449 gacha tushishi kam uchraydigan sinf koʻrinuvchanligining ortishi bilan mos, ammo 0.449 hanuz yuqori oʻtkazib yuborish nisbatidir. Manba buni production NIDS nuqtai nazaridan hal qilingan muammo deb baholamaydi.
PR-AUC nega alohida hisoblangan?
Precision–Recall Area Under the Curve (PR-AUC), ayniqsa musbat sinf juda kam uchraydigan muammolarda modelning turli qaror threshold’larida precision va recall orasidagi tartiblashini baholashga yordam beradi. U2R’ning KDDTest+ ichidagi prevalence qiymati atigi 0.0030 boʻlgani sababli hard-label recall yolgʻiz ehtimollik tartiblash sifatini tushuntirmaydi.
| Sinf | Baseline | Cost-Sensitive |
|---|---|---|
| DoS | 0.9448 | 0.9636 |
| Normal | 0.9541 | 0.8066 |
| Probe | 0.8034 | 0.7660 |
| R2L | 0.3280 | 0.3449 |
| U2R | 0.0092 | 0.0126 |
U2R PR-AUC 0.0092 dan 0.0126 gacha oshgan. Manba buni prevalence baseline’dan taxminan 3.1 va 4.2 baravar deb ifodalaydi. Shunga qaramay, 0.0126 mutlaq qiymatda juda past ranking-quality darajasidir; mualliflar ham U2R’ni tadqiqotning markaziy qiyinchiliklaridan biri sifatida qoldiradi.
U2R threshold oʻzgartirilganda nima boʻladi?
| Threshold τ | U2R TP / 67 | U2R Recall | U2R FP | Precision |
|---|---|---|---|---|
| 0.05 | 59 | 0.881 | 6608 | 0.0088 |
| 0.10 | 45 | 0.672 | 3796 | 0.0117 |
| 0.30 | 24 | 0.358 | 2180 | 0.0109 |
| 0.50 | 14 | 0.209 | 1666 | 0.0083 |
| 0.70 | 11 | 0.164 | 1312 | 0.0083 |
| 0.90 | 11 | 0.164 | 953 | 0.0114 |
Threshold pasaytirilganda koʻproq U2R aniqlanadi, biroq false-positive soni minglab darajaga chiqadi. Threshold oshirilganda ogohlantirish yuki kamayadi, lekin recall ham tushadi. U2R precision koʻrsatilgan barcha operating point’larda taxminan %1 atrofida.
Table 14 dagi hard-label cost-sensitive U2R natijasi 24 TP va 1695 FP boʻlsa, threshold table’dagi \(\tau=0.30\) natijasi ayni 24 TP uchun 2180 FP. Bu ikki son qarama-qarshi emas: hard-label model odatiy multi-class qaroridan foydalansa, threshold experiment U2R ehtimoli belgilangan \(\tau\) qiymatidan oshganda sinfni majburan U2R qilib tayinlaydigan boshqa operating rule’dan foydalanadi.
Alert-budget tahlili
| Tahlilchi ogohlantirish byudjeti | Aniqlangan haqiqiy U2R / 67 |
|---|---|
| Top 100 ogohlantirish | 4 |
| Top 500 ogohlantirish | 6 |
| Top 1000 ogohlantirish | 11 |
Bu natija modelning U2R bali analyst prioritization nuqtai nazaridan ma’lum axborot olib yurishini, ammo yolgʻiz holda yuqori ishonchli avtomatik qaror uchun yetarli precision bermasligini koʻrsatadi.
UNSW-NB15 Tashqi Tekshiruvi Nimani Koʻrsatadi?
UNSW-NB15 tashqi tekshiruvi dataset’ga xos tuning qilinmasdan ayni preprocessing, MI→RFE, stacking va balanced class-weighting mantiqi toʻrtta kam uchraydigan hujum kategoriyasining recall qiymatlarini keskin oshirishi mumkinligini; biroq bu Normal recall va weighted F1 yoʻqotilishi hisobiga yuz berishini koʻrsatadi. Demak, tashqi tekshiruv kam-sinf trade-off’i boshqa ma’lumot toʻplamiga ham oʻtishini qoʻllab-quvvatlaydi, ammo ishlab chiqarish tarmoqlarida umumiy ustunlikni isbotlamaydi.
Tashqi ma’lumotlar toʻplami protokoli
UNSW-NB15 ning rasmiy training partition’i 175,341, testing partition’i 82,332 yozuvdan iborat va standart oʻn sinfli taxonomy ishlatilgan. Ishlatilgan public mirror’da record identifier bilan sttl, dttl va oltita ct_* connection-counter xususiyati chiqarilgan; qolgan 31 numeric va uch categorical xususiyat ayni pipeline bilan ishlangan.
proto, service va state one-hot encode qilingan; Min-Max scaler faqat training partition’ga fit qilingan; MI bilan 50 ta xususiyat saqlangan; RFE bilan 25 taga tushirilgan va ayni stacking architecture balanced class weights bilan qoʻllangan. Manba ayniqsa UNSW-specific tuning qilinmaganini ta’kidlaydi.
| Konfiguratsiya | Weighted F1 | Macro-F1 | Balanced Accuracy | Analysis Recall | Backdoor Recall | Shellcode Recall | Worms Recall |
|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.8096 | 0.5007 | 0.4856 | 0.0000 | 0.0583 | 0.5291 | 0.1818 |
| Cost-sensitive stacking | 0.7509 | 0.4780 | 0.6696 | 0.2496 | 0.6930 | 0.9550 | 0.8864 |
| Cost-sensitive XGBoost | 0.7488 | 0.5137 | 0.6392 | 0.1300 | 0.5798 | 0.9233 | 0.7273 |
Cost-sensitive stacking bilan Worms 18.18% dan 88.64% gacha oshadi va 44 ta Worms namunadan 39 tasi toʻgʻri aniqlanadi. Shellcode 52.91% dan 95.50% gacha, Backdoor 5.83% dan 69.30% gacha, Analysis esa 0.00% dan 24.96% gacha koʻtariladi.
Buning evaziga Normal recall 91.74% dan 64.22% gacha va weighted F1 0.8096 dan 0.7509 gacha tushadi. Balanced accuracy 0.4856 dan 0.6696 gacha oshadi. Bu tadqiqotning asosiy xavfsizlik trade-off’ining boshqa ma’lumotlar toʻplamidagi koʻrinishidir: majority-class umumiy muvaffaqiyati tushar ekan, kam ifodalangan hujumlar koʻproq koʻrinadi.
Cost-sensitive modelning class-level PR-AUC qiymati Worms uchun 0.5903, Shellcode uchun 0.3939 deb qayd etilgan. Bular NSL-KDD U2R PR-AUC = 0.0126 qiymatiga qaraganda ancha kuchli rare-class ranking xatti-harakatini koʻrsatadi.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- Balanced class weighting asl training observations oʻzgartirilmasdan ayrim kam uchraydigan hujum sinflarining recall qiymatini oshira olgan.
- NSL-KDD asosiy tajribasida stacking U2R recall 0.00% dan 35.82% gacha koʻtarilgan.
- Weighted F1, U2R recall va R2L recall oʻsishlari repeated-seed paired Wilcoxon testlarida
p < 0.05darajasida ahamiyatli. - R2L natijasi statistik jihatdan oʻzgarsa-da, mutlaq operatsion yaxshilanish cheklangan.
- Class weighting U2R visibility’ning asosiy harakatlantiruvchi komponentidir.
- 25-feature MI–RFE tuzilma ixchamlik beradi, ammo maksimal bashorat natijasini bermaydi.
- ADASYN ayrim global va R2L metrikalarida cost-sensitive stacking’dan ustun.
- Balanced Random Forest kengaytirilgan taqqoslashda U2R va R2L recall boʻyicha cost-sensitive stacking’dan kuchliroq.
- UNSW-NB15 tashqi tekshiruvi kam uchraydigan sinf recall oʻsishi boshqa benchmark’da ham yuz berishini koʻrsatadi.
- Kam uchraydigan sinf recall oʻsishi majority-class recall, weighted F1 yoki false-positive yukida xarajat keltirishi mumkin.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
- Framework barcha kam uchraydigan hujumlarni ishonchli yechadigan umumiy NIDS emas.
- R2L muammosi hal qilinmagan.
- U2R uchun 35.82% recall yuqori-precision avtonom hujum aniqlashni anglatmaydi.
- 25 xususiyatli feature set barcha ma’lumotlar toʻplamlarida yoki barcha hujum turlarida optimal ekani koʻrsatilmagan.
- Cost-sensitive learning SMOTE, ADASYN, Balanced Random Forest, focal loss yoki threshold calibration’dan universal ravishda ustun ekani koʻrsatilmagan.
- NSL-KDD va UNSW-NB15 natijalari zamonaviy encrypted, cloud-native va IoT ishlab chiqarish trafigining barchasini ifodalamaydi.
- Jonli SOC yoki production packet/flow collector ustida end-to-end deployment tekshiruvi qilinmagan.
- Explainability uchun SHAP yoki counterfactual analysis mavjud framework’ga qoʻllanmagan.
- CICIDS2017/2018 va TON_IoT da ushbu tadqiqotda yakunlangan validation mavjud emas.
- Statistik ahamiyatlilikning oʻzi operatsion usefulness yoki mos alert budget kafolati emas.
Cheklovlar
Benchmark yoshi: NSL-KDD nazoratli taqqoslash uchun foydali, ammo zamonaviy encrypted traffic, cloud workloads, IoT protocols va hozirgi hujum kampaniyalarini toʻliq ifodalamaydi.
R2L overlap: R2L bilan Normal oʻrtasidagi feature-space oʻxshashligi class weighting bilan hal qilinmagan.
SVM oʻqitish cheklovi: SVM faqat 30,000 stratified training namunada ishlatilgan; toʻliq KDDTrain+ bilan ishlaydigan modellar bilan taqqoslashda bu cheklov hisobga olinishi kerak.
False-positive yuki: U2R koʻrinuvchanligi oshganda precision juda past boʻlib qolishi mumkin. Ishlab chiqarish muhitida threshold calibration va analyst capacity juda muhim boʻladi.
Explainability: SHAP yoki counterfactual analysis kabi tushuntirish qatlami qoʻshilmagan.
External validity: UNSW-NB15 tashqi tekshiruvi bitta-ma’lumot-toʻplami muammosini kamaytirgan, ammo butunlay yoʻqotmagan.
Jonli deployment: End-to-end live flow collector, SOC integratsiyasi va production network xatti-harakati sinovdan oʻtkazilmagan.
Manba ichidagi latency bayonoti: Metod boʻlimida cheklangan inference-latency oʻlchovi boʻlishiga qaramay, cheklovlar boʻlimida inference latency hali baholanmagan degan bayonot saqlanib qolgan.
Kelajakdagi tadqiqot yoʻnalishlari
Manba kelajakda CICIDS2017, CSE-CIC-IDS2018 va TON_IoT da ayni ablation va confidence-interval protokolini qoʻllash; adaptive cost schedule, probability calibration, held-out validation bilan threshold calibration, SHAP asosidagi interpretability, focal-loss modellarini controlled false-positive budget ostida taqqoslash va Balanced Random Forest/EasyEnsemble kabi usullarni baholashni taklif qiladi.
Shuningdek, CICFlowMeter yoki Zeek kabi flow collector’lar bilan real-time deployment tekshiruvi tavsiya etiladi. Bular mavjud tadqiqotning yakunlangan natijalari emas, kelajak tadqiqot takliflaridir.
Manba va Usul Haqida Izoh
Asl sarlavha: Cost-Sensitive Stacking Ensemble with Hybrid Feature Selection for Rare Attack Detection in Network Intrusion Detection Systems
Mualliflar va tartib: Ioan Corneliu Salisteanu; Iulian Udroiu; Andrei Cosmin Gheorghe; Ionut Adrian Tudoroiu; Emil Mihai Diaconu.
Corresponding author: Andrei Cosmin Gheorghe.
Corresponding e-mail: andrei.gheorghe@valahia.ro
Muassasa: Faculty of Electrical Engineering, Electronics and Information Technology, University “Valahia” of Targoviste, 130004 Targoviste, Romania.
Teng hissa / teng birinchi mualliflik: Manbada teng hissa bayonoti yoʻq.
Academic Editor: Emre Tokgoz.
Jurnal: Electronics.
Nashriyot: MDPI, Basel, Switzerland.
ISSN: 2079-9292.
Jild / son: Volume 15, Issue 14.
Maqola raqami: 3094.
Nashr yili: 2026.
Maqola turi: Article; nazoratli benchmark asosidagi eksperimental mashinali oʻrganish/NIDS baholash tadqiqoti.
DOI: 10.3390/electronics15143094.
Rasmiy havola: https://doi.org/10.3390/electronics15143094
Received: 2 Iyun 2026.
Revised: 10 Iyul 2026.
Accepted: 13 Iyul 2026.
Published: 14 Iyul 2026.
Peer-review holati: Electronics MDPI ning rasmiy qaydida international, peer-reviewed va open-access journal sifatida ta’riflangan.
Litsenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint holati: Koʻrib chiqilgan manba nashr etilgan jurnal maqolasidir; PDF alohida preprint identifikatorini koʻrsatmaydi.
Asosiy tadqiqot muammosi: Umumiy accuracy kuchli class imbalance sharoitida rare/high-impact attack muvaffaqiyatsizligini yashirishi mumkinligi.
Metodologik hissa chegarasi: MI, RFE, stacking yoki balanced class weighting komponentlari alohida holda yangi algoritmlar emas. Tadqiqotning hissasi ularni rare-class-focused, statistically audited va data-preserving baholash protokolida nazoratli integratsiya qilishdir.
Asosiy ma’lumotlar toʻplami: NSL-KDD; KDDTrain+ = 125,973 yozuv, KDDTest+ = 22,544 yozuv.
External validation: UNSW-NB15; official train = 175,341, test = 82,332 yozuv; dataset-specific tuning qilinmagan.
NSL-KDD sinflari: Normal, DoS, Probe, R2L va U2R.
Preprocessing: protocol_type, service va flag uchun one-hot encoding; 41 asl attribute → 122 sonli feature; training-fit Min-Max scaling [0,1]; difficulty_level chiqarilgan.
Feature selection: MI bilan 122 → 50, Random Forest asosidagi RFE bilan 50 → 25.
Feature-selection talqin chegarasi: 25-feature tuzilma eng yuqori natija nuqtasi emas; 50-feature va ayrim no-feature-selection variantlari yuqoriroq bashorat metrikalarini bergan.
Individual modellar: Random Forest, XGBoost, SVM va KNN.
Stacking: Random Forest + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold out-of-fold prediction.
SVM chegarasi: 30,000 stratified training namuna; boshqa full-training qoʻshimcha tajribalar bilan toʻgʻridan-toʻgʻri teng emas.
Cost-sensitive formula: \(w_c=N/(C n_c)\).
Approximate class weights: Normal 0.37; DoS 0.55; Probe 2.16; R2L 25.32; U2R 484.49.
Resampling asosiy framework’da qoʻllanganmi? Yoʻq. Asosiy cost-sensitive framework original training observations’ni saqlaydi. SMOTE, Borderline-SMOTE, ADASYN va SMOTE-Tomek alohida experimental baseline’lardir.
Random seeds: 0, 1, 2, 3, 4, 5, 10, 21, 42, 100.
Statistical tests: Wilcoxon signed-rank va Friedman; significance threshold p < 0.05.
Asosiy U2R natijasi: 0/67 → 24/67; recall 0.00% → 35.82%; Wilson %95 GA 25.40%–47.78% cost-sensitive holatda.
Asosiy R2L natijasi: 119/2887 → 151/2887; recall 4.12% → 5.23%.
Asosiy weighted-F1 natijasi: Stacking 0.7120 → 0.7214.
Asosiy accuracy trade-off: Stacking 0.7542 → 0.7342.
U2R hard-label precision: Cost-sensitive stacking 24 TP, 1695 FP, precision 0.0140.
U2R probability-level natijasi: PR-AUC 0.0092 → 0.0126; prevalence 0.0030.
Repeated-seed p-values: Weighted F1 p = 0.0020; U2R recall p = 0.0020; R2L recall p = 0.0039; Friedman weighted-F1 comparison p = 0.0018.
25-feature sensitivity: Weighted F1 = 0.7214; R2L = 0.0523; U2R = 0.3582; training time = 150.8 s.
50-feature sensitivity: Weighted F1 = 0.7668; R2L = 0.1888; U2R = 0.5075; training time = 160.5 s.
122-feature sensitivity: Weighted F1 = 0.7625; R2L = 0.1753; U2R = 0.5224; training time = 243.5 s.
Software: Python 3.13.5; scikit-learn 1.8.0; XGBoost 3.1.3; imbalanced-learn 0.14.1; NumPy 2.3.5; pandas 2.2.3.
Apparat/muhit: Linux x86_64, CPU-only, 56 logical CPU core available to container, taxminan 4.3 GB RAM; GPU qoʻllanmagan.
Dastlabki 1000 KDDTest+ inference latency: Random Forest 0.2609 ms/sample; XGBoost 0.1081 ms/sample; KNN 1.6117 ms/sample; Stacking 2.0925 ms/sample. Manba bularni hardware-dependent relative computational values sifatida cheklaydi.
Manba ichidagi latency izohi: Section 3.6 inference latency qiymatlarini bergan boʻlsa-da, Section 5.3 inference latency hali kiritilmaganini aytadi. Har ikki bayonot manbada birga mavjud boʻlgani sabab bu farq saqlangan.
External-validation trade-off: UNSW-NB15 da cost-sensitive stacking balanced accuracy 0.4856 → 0.6696 oshgan boʻlsa, weighted F1 0.8096 → 0.7509 va Normal recall 91.74% → 64.22% kamaygan.
UNSW rare-class recall: Analysis 0.00% → 24.96%; Backdoor 5.83% → 69.30%; Shellcode 52.91% → 95.50%; Worms 18.18% → 88.64%.
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Data Availability: NSL-KDD ochiq benchmark. Manba, shuningdek, preprocessing, MI–RFE feature selection, training, imbalance baselines, statistical tests va figure generation uchun Python script’larini oʻz ichiga olgan supplementary reproducibility package mavjudligini bildiradi. Tijoriy yoki xususiy production network trace ishlatilmagan.
Muallif hissalari: Conceptualization — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe, Ioan Corneliu Salisteanu va Iulian Udroiu; methodology — Ioan Corneliu Salisteanu, Andrei Cosmin Gheorghe va Iulian Udroiu; software — Ionut Adrian Tudoroiu va Andrei Cosmin Gheorghe; validation — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe va Emil Mihai Diaconu; formal analysis — Andrei Cosmin Gheorghe; investigation — Emil Mihai Diaconu; resources va data curation — Ionut Adrian Tudoroiu; original draft — Ionut Adrian Tudoroiu; review/editing — Andrei Cosmin Gheorghe; visualization — Ioan Corneliu Salisteanu va Iulian Udroiu; supervision — Ioan Corneliu Salisteanu, Iulian Udroiu va Andrei Cosmin Gheorghe.
Manfaatlar toʻqnashuvi: Mualliflar manfaatlar toʻqnashuvi yoʻqligini bildiradi.
Asosiy metodologik chegara: Natijalar nazoratli NSL-KDD va UNSW-NB15 benchmark tahlilidir; real SOC, production network yoki jonli flow collector ustidagi end-to-end tekshiruv emas.
Kelajakdagi tekshiruv: CICIDS2017, CSE-CIC-IDS2018, TON_IoT, threshold/probability calibration, SHAP, controlled false-positive budgets, Balanced Random Forest/EasyEnsemble va live CICFlowMeter/Zeek integratsiyasi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan