


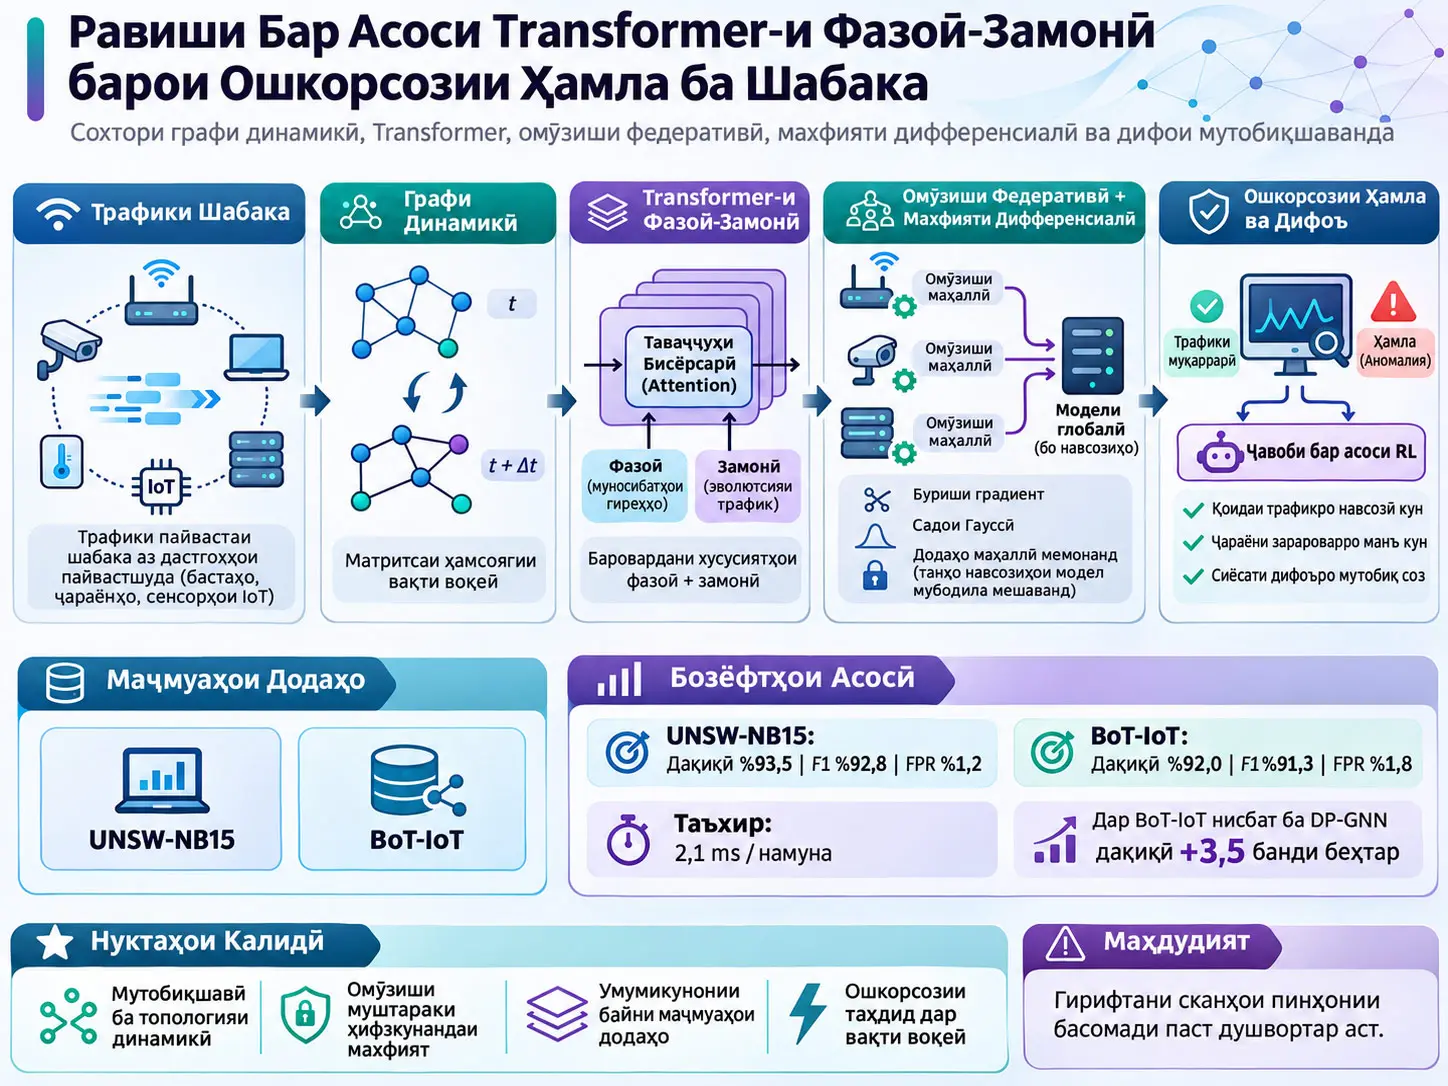
Чаҳорчӯбаи мутобиқшавандаи ошкорсозии ҳамла ба шабака дар асоси Transformer-и фазоӣ-замонӣ равиши network attack detection ва response мебошад, ки муносибатҳои тағйирёбандаи иртиботӣ байни гиреҳҳои шабакаро ҳамчун графи динамикӣ модел мекунад, вобастагиҳои замониро бо Transformer ва вобастагиҳои фазоӣ/топологиро бо graph convolution коркард мекунад, бе хориҷ кардани додаҳои маҳаллӣ аз дастгоҳ federated learning ва differential privacy-ро истифода мебарад ва ҳадаф дорад пас аз ҳамла бо reinforcement learning қарори дифоӣ тавлид кунад. Таҳқиқот дар маҷмӯаҳои benchmark-и UNSW-NB15 ва BoT-IoT арзёбӣ шудааст; усули пешниҳодшуда дар UNSW-NB15 %93,5 ± %0,2 accuracy ва %92,8 ± %0,3 F1, дар BoT-IoT бошад %92,0 ± %0,4 accuracy ва %91,3 ± %0,5 F1 ба даст овардааст. Бо вуҷуди ин, таҳқиқот ба маҷмӯаҳои додаҳои назоратшаванда асос ёфтааст; ин натиҷаҳо набояд ҳамчун муваффақияти дарозмуддати саҳроӣ дар шабакаи воқеии V2X, IoT ё истеҳсолӣ шарҳ дода шаванд.
Ҷузъи якуми чаҳорчӯба аз басомади иртиботи гиреҳҳои шабака ва монандии хусусиятҳои трафик дар равзанаи вақти ҷорӣ матритсаи динамикии ҳамсоягиро тавлид мекунад. Пайвастҳои заиф бо остонагузорӣ бурида мешаванд; бо ин роҳ ба ҷойи сохтори зиче, ки ҳар гиреҳ ба ҳамаи гиреҳҳои шабака пайваст аст, кӯшиш мешавад графе сохта шавад, ки муносибатҳои иртиботии камзичтар ва ҷориро ифода мекунад. Вобастагиҳои замонӣ бо Transformer-и истифодакунандаи multi-head self-attention ва вобастагиҳои топологӣ бо graph convolution коркард мешаванд.
Ҷузъи дуюм federated learning ва differential privacy-ро муттаҳид мекунад. Дастгоҳҳои маҳаллӣ ба ҷойи фиристодани додаҳои хоми трафик ба сервери марказӣ моделҳои худро ба таври маҳаллӣ нав мекунанд; сервери марказӣ параметрҳои моделро муттаҳид мекунад. Манбаъ ҳангоми differential privacy аз gradient clipping ва Gaussian noise истифода мебарад; дар танзимоти таҷриба noise multiplier-ро \(\sigma=0.1\), буҷети умумии махфиятро баъд аз 100 epoch тақрибан \(\epsilon=2.4\) ва \(\delta=10^{-5}\) гузориш мекунад.
Ҷузъи сеюм танҳо ба қарори “ҳамла ҳаст/нест” тамаркуз намекунад. Қабати reinforcement learning дар асоси Deep Q-Network бо истифода аз network state, ки аз нишондиҳандаҳое чун суръати трафик, тақсимоти протокол ва anomaly score иборат аст, ҳадаф дорад байни амалҳои дифоӣ ба монанди маҳдудсозии трафик ё филтркунии додаҳо интихоб кунад. Натиҷаҳои ablation нишон медиҳанд, ки саҳми ҷузъи reinforcement-learning ба classification accuracy танҳо тақрибан 0,3 банди фоизӣ аст; нақши асосии он ҷавоби динамикӣ ба ҳамла мебошад.
Муҳимтарин афзоиши самаранокии усули пешниҳодшуда аз сохтани графи мутобиқшаванда ва ҷузъҳои spatio-temporal Transformer меояд. Дар BoT-IoT ҳангоми хориҷ кардани сохтани графи мутобиқшаванда F1 аз %91,3 ба %87,9 ва ҳангоми иваз кардани Transformer бо GCN+LSTM ба %86,5 паст мешавад. Дар муқобил, иваз кардани механизми federated differential privacy бо омӯзиши марказонидашуда дар F1 тақрибан 0,8 банди фоизӣ фарқ ба вуҷуд меорад.
Манбаъ инчунин таҷрибаи мустақими cross-dataset transfer-ро гузориш мекунад: модел дар UNSW-NB15 омӯзонида шуда, дар BoT-IoT бе fine-tuning санҷида шудааст. Муаллифон мегӯянд, ки дар ин шароит proposed model арзиши F1-ро болотар аз %91 нигоҳ дошта, дар BoT-IoT аз RustGraph 2,1 банди фоизӣ баландтар будааст.
Маҳдудияти муҳими таҳқиқот ҳамлаҳои ultra-low-frequency мебошанд. Дар намунаи port scan-и суръати паст, ки манбаъ медиҳад, ҳамлагар дар 30 дақиқа танҳо панҷ probe тавлид кардааст, суръати бастаҳо дар сатҳи 0,8 packet/s мондааст ва бо диапазони 0,7–1,1 packet/s-и трафики муқаррарии IoT heartbeat то андозаи зиёд ҳампӯшӣ доштааст. Модел ин намунаро бо %62,3 confidence ҳамчун рафтори муқаррарӣ тасниф кардааст. Муаллифон ин нокомиро ба диди маҳдуди маҳаллӣ дар federated learning ва фурӯ нишондани anomaly gradient-ҳои заиф аз ҷониби садои differential-privacy мепайванданд.
Бахши abstract-и манбаъ мегӯяд, ки дар ҳамон privacy budget сатҳи муваффақияти ҳамлаҳои membership inference ба таври назаррас коҳиш ёфтааст. Аммо дар бахшҳои асосии усул ва натиҷаҳо барои ҳамлаи membership-inference сатҳи миқдории муваффақият, ҷадвали алоҳидаи таҷриба ё протоколи муфассали санҷиш дода нашудааст. Аз ин рӯ ин иддао бояд ҳамчун баёнияи сифатии манбаъ нигоҳ дошта шавад ва бо рақамҳое, ки дар манбаъ нестанд, васеъ карда нашавад.
Масъалаи таҳқиқот чист?
Network Attack Detection (NAD) ҳадаф дорад рафтори муқаррарӣ ва рафтори зарароварро дар трафики шабака аз ҳам ҷудо кунад. Ин таҳқиқот масъаларо аз нигоҳи математикӣ ҳамчун binary classification месозад: \(y_i=0\) трафики муқаррарӣ ва \(y_i=1\) трафики ҳамларо ифода мекунад.
Мушкилоте, ки таҳқиқот мехоҳад ҳал кунад, танҳо таснифи дуруст нест. Дар муҳитҳое чун IoT, Internet of Vehicles ва Vehicle-to-Everything дастгоҳҳое, ки бо ҳам иртибот мекунанд, метавонанд бо мурури вақт тағйир ёбанд. Ҳамзамон фиристодани додаҳо ба сервери марказӣ метавонад хатари махфият эҷод кунад ва баъд аз ошкор шудани ҳамла интихоби кадом амали дифоӣ низ масъалаи алоҳида аст.
Аз ин рӯ манбаъ се масъаларо дар як чаҳорчӯба баррасӣ мекунад:
- Моделсозии муносибатҳои фазоӣ ва замонӣ дар топологияи динамикии шабака.
- Омӯзиши модели муштарак бе интиқоли додаҳои хом ба системаи марказӣ ва татбиқи differential privacy.
- Тавлиди қарори динамикии дифоӣ бо reinforcement learning баъд аз ошкорсозӣ.
Формулировкаи масъала
Манбаъ додаҳои трафики шабакаро бо \(X\), ҳар як намунаи трафикро бо \(x_i\), ва нишонаи бинарии синфро бо \(y_i\) нишон медиҳад. Маҷмӯаҳои омӯзиш ва санҷиш аз ҳамон сохтори feature истифода мекунанд.
Ҳадафи идеалии оптимизатсия кам кардани хатари интизоршаванда аст:
\[ \mathcal{L}(f)= \mathbb{E}_{(x,y)} \left[ \ell(f(x),y) \right] \tag{1} \]
Муодилаи 1 чиро ҳисоб мекунад? Хароҷоти хатои интизоршавандаи моделро дар тақсимоти додаҳо ифода мекунад.
\(f(x)\): Пешгӯиест, ки модел барои намунаи трафики \(x\) тавлид мекунад.
\(y\): Нишонаи воқеӣ.
\(\ell(f(x),y)\): Функсияи loss, ки фарқи байни пешгӯӣ ва нишонаи воқеиро чен мекунад.
Нақши математикӣ: Раванди омӯзиш наметавонад хатари интизоршавандаи тамоми трафики имконпазири шабакаро мустақим ҳисоб кунад; он кӯшиш мекунад тавассути training samples-и мавҷуда ба ин ҳадаф наздик шавад.
Матритсаи Динамикии Ҳамсоягӣ Дар Ин Таҳқиқот Чӣ Нақш Дорад?
Матритсаи динамикии ҳамсоягӣ бо баровардани он ки кадом гиреҳҳои шабака дар равзанаи муайяни вақт аз рӯйи feature similarity ва сохтори иртибот муносибати маънодори иртиботӣ доранд, spatio-temporal graph-ро нав мекунад; остонагузории пайвастҳои заиф ҳадаф дорад, ки модел ба ҷойи сохтани пайвастҳои зич ва пурғавғо байни ҳамаи гиреҳҳо, муносибатҳои муҳими топологии бо вақт тағйирёбандаро коркард кунад.
Сохтани graph-и динамикӣ
Муодилаи матритсаи ҳамсоягии манбаъ:
\[ A_{ij}^{(t)} = \operatorname{ReLU} \left( \frac{x_i(x_j)^T}{\sqrt{d}} - \epsilon \right) \tag{2} \]
\(A_{ij}^{(t)}\): Дар вақти \(t\), ин вазни пайваст байни гиреҳҳои \(i\) ва \(j\) мебошад.
\(x_i\) ва \(x_j\): Feature vector-ҳои гиреҳҳои дахлдор.
\(d\): Аъзои миқёсгузорӣ вобаста ба андозаи feature.
\(\epsilon\): Остонае, ки барои буридани пайвастҳои заиф истифода мешавад.
ReLU: Пас аз кам кардани остона арзишҳои манфиро ба сифр мерасонад ва монеъ мешавад, ки муносибатҳои заиф дар adjacency matrix ба пайваст табдил ёбанд.
Дар муодила монандии feature-vector бо \(\sqrt{d}\) миқёсгузорӣ шуда, \(\epsilon\) кам карда мешавад. Агар монандӣ аз остона паст бошад, натиҷаи ReLU сифр мешавад; агар аз остона баланд бошад, пайваст вазни мусбат мегирад.
Манбаъ мегӯяд, ки adjacency matrix дар дохили sliding temporal window-и андозаи \(K\) ҳисоб мешавад, аммо арзиши рақамии \(K\)-ро гузориш намекунад.
Хароҷоти назариявии муқоисаи зичи ҳамаи гиреҳҳо:
\[ O(N^2) \]
дода мешавад, дар ҳоле ки пас аз sparse pruning гуфта мешавад мураккабии амалӣ ба:
\[ O(N\cdot deg_{avg}) \]
коҳиш меёбад. Дар ин ҷо \(N\) шумораи гиреҳҳо ва \(deg_{avg}\) арзиши миёнаи node degree-ро ифода мекунад.
Манбаъ дар бахши усул \(\epsilon\)-ро ҳамчун “learnable threshold” муайян мекунад. Sensitivity analysis-и баъдӣ бошад \(\epsilon=0.5\)-ро ҳамчун operating point-и интихобшуда пешниҳод мекунад. Азбаски матни нашршуда ин ду таърифро алоҳида мувофиқ намекунад, Verianla яке аз онҳоро ба ҷойи дигаре намегузорад.
Ҳассосияти остона
| Шарти остона | Натиҷаи манбаъ | Шарҳ |
|---|---|---|
| \(\epsilon \in [0.4,0.6]\) | F1 > %91 | Модел сатҳи баланди F1-ро нигоҳ медорад. |
| Остонаҳои пасттар | Рақами дақиқ дода нашудааст. | Манбаъ мегӯяд, ки пайвастҳои пурғавғои бештар ба вуҷуд меоянд. |
| \(\epsilon > 0.7\) | F1 тақрибан %86,5 | Гуфта мешавад graph fragmentation ба вуҷуд меояд. |
| Арзиши интихобшуда | \(\epsilon=0.5\) | Аз ҷониби манбаъ ҳамчун тавозуни беҳтарин байни филтркунии ғавғо ва structural integrity интихоб шудааст. |
Transformer self-attention чӣ кор мекунад?
Муодилаи асосии attention-и encoder-и замонӣ:
\[ Attention(Q,K,V) = softmax \left( \frac{QK^T}{\sqrt{d_k}} \right)V \tag{3} \]
\(Q\): Матритсаи Query.
\(K\): Матритсаи Key.
\(V\): Матритсаи Value.
\(d_k\): Андозаи Key vector.
\(QK^T\) холҳои муносибатро байни намоишҳои гуногуни вақт/гиреҳ тавлид мекунад. Миқёсгузорӣ бо \(\sqrt{d_k}\) барои маҳдуд кардани он истифода мешавад, ки ҳосили дохилии калон softmax-ро аз ҳад тез накунад. Натиҷаҳои Softmax attention weights мешаванд ва ин вазнҳо ба \(V\) татбиқ мегарданд.
Дар таҳқиқот Transformer-и шашқабата бо ҳашт attention head мавҷуд аст. Hidden dimension 512 аст. Сохтори Multi-head ҳадаф дорад, ки модел дар зерфазоҳои гуногуни representation муносибатҳои гуногунро ҳамзамон баррасӣ кунад.
Graph convolution чӣ кор мекунад?
Барои Spatial encoder манбаъ муодилаи зеринро медиҳад:
\[ h_i' = \sigma \left( \sum_{j\in\mathcal{N}(i)} \frac{1}{c_{ij}} W h_j \right) \tag{4} \]
\(h_i'\): Representation-и навшудаи гиреҳи \(i\).
\(\mathcal{N}(i)\): Маҷмӯаи ҳамсоягии гиреҳи \(i\).
\(h_j\): Representation-и ҷории гиреҳи ҳамсояи \(j\).
\(W\): Матритсаи табдилёбии омӯзишпазир.
\(c_{ij}\): Аъзои normalization дар муодилаи манбаъ; мақола таърифи муфассали онро алоҳида намедиҳад.
\(\sigma\): Функсияи Nonlinear activation.
Ин амал representation-и гиреҳро на танҳо бо маълумоти худи он, балки бо маълумоти ҳамсояҳояш дар graph-и динамикӣ низ нав мекунад.
Federated Differential Privacy Дар Ин Чаҳорчӯба Чӣ Гуна Ҳифз Таъмин Мекунад?
Federated differential privacy ба он асос меёбад, ки ҳар дастгоҳ бидуни интиқоли трафики хоми шабака ба сервери марказӣ моделро дар додаҳои маҳаллии худ нав мекунад, танҳо навсозиҳои модел барои aggregation мубодила мешаванд ва бо истифода аз gradient clipping ва Gaussian noise таъсири як training sample ба навсозии модел маҳдуд мегардад; дар манбаъ \(\sigma=0.1\), тақрибан \(\epsilon=2.4\) ва \(\delta=10^{-5}\) гузориш шудаанд.
Feature decoupling
Манбаъ gradient-и маҳаллиро ҳамчун ду ҷузъ баррасӣ мекунад:
- Structural component: \(\nabla_{\theta}^{str}\), ҷузъе, ки маълумоти graph/topology-ро интиқол медиҳад.
- Task component: \(\nabla_{\theta}^{tsk}\), ҷузъи марбут ба вазифаи classification.
Муаллифон мегӯянд, ки татбиқи clipping threshold-и калонтар ба structural component барои нигоҳ доштани topological features-и муҳим ва clipping-и сахттар дар task component барои ҳифзи privacy кӯмак мекунад. Манбаъ арзишҳои дақиқи рақамии ин ду threshold-ро намедиҳад.
Муодилаи 5: Навсозии модели маҳаллӣ
\[ \theta_i = \theta_i - \eta\nabla_{\theta}\mathcal{L}(\theta_i) \tag{5} \]
\(\theta_i\): Параметрҳои модели маҳаллии дастгоҳи \(i\).
\(\eta\): Learning rate.
\(\nabla_{\theta}\mathcal{L}(\theta_i)\): Gradient-и loss-и маҳаллӣ нисбат ба параметрҳо.
Ҳар дастгоҳ аз training data-и маҳаллии худ gradient ҳисоб карда, модели худро нав мекунад.
Муодилаи 6: Global model aggregation
\[ \theta_{global} = \frac{1}{N} \sum_{i=1}^{N} \theta_i \tag{6} \]
Манбаъ дар сервери марказӣ миёнаи арифметикии одии local model parameters-ро нишон медиҳад. \(N\) шумораи device/client-ҳои иштироккунанда дар aggregation-ро ифода мекунад.
Манбаъ дар Муодилаи 6 формулаи ҷудогонаи aggregation-и вазндор аз рӯйи шумораи client sample-ҳоро намедиҳад.
Муодилаи 7: Noise injection
\[ \theta_i^{priv} = \theta_i + \mathcal{N}(0,\sigma^2) \tag{7} \]
Ин ифода илова шудани Gaussian noise-и миёнааш сифр ба local update-ро нишон медиҳад. Манбаъ дар шарҳи атрофи ин муодила adaptive clipping-ро низ зикр мекунад; шакли муфассалтари математикии clipping баъдтар дар Муодилаи 12 дода мешавад.
Қадами DP-SGD clipping
Манбаъ нормаи gradient-ро бо threshold-и \(C\) маҳдуд мекунад:
\[ \hat{g}_t = \frac{g_t} {\max\left(1,\frac{\lVert g_t\rVert_2}{C}\right)} \]
Агар \(\lVert g_t\rVert_2\leq C\) бошад, максимуми махраҷ 1 мешавад ва gradient тағйир намеёбад. Агар нормаи gradient аз \(C\) гузарад, gradient дар ҳамон самт нигоҳ дошта шуда, бузургиаш маҳдуд мегардад.
Муодилаи 12: Noisy parameter update баъд аз clipping
\[ \theta_{t+1} = \theta_t - \eta\cdot Adam \left( \hat{g}_t+ \mathcal{N}(0,\sigma^2 C^2 I) \right) \tag{12} \]
Манбаъ дар танзимоти таҷриба:
- \(\eta=1\times10^{-4}\),
- \(\sigma=0.1\),
- \(\epsilon\approx2.4\),
- \(\delta=10^{-5}\),
- privacy-accounting horizon = 100 training epoch
арзишҳоро медиҳад.
\(\epsilon\) ва \(\delta\) параметрҳои differential privacy мебошанд. Дар тафсири умумӣ privacy budget-и хурдтар метавонад маънои махфияти қавитарро дошта бошад; аммо дар ин таҳқиқот арзёбии самаранокӣ/махфият танҳо дар доираи шароитҳои додаи манбаъ бояд баррасӣ шавад.
Дар Abstract гуфта мешавад, ки ҳамлаҳои membership inference дар ҳамон privacy budget ба сатҳи пасттари муваффақият расидаанд. Бо вуҷуди ин, азбаски дар бахши асосии натиҷаҳо барои membership-inference success rate ҷадвали алоҳидаи рақамӣ ё тафсилоти санҷиш дода нашудааст, ин иддаоро ба таври миқдорӣ васеъ кардан мумкин нест.
Gradient compression
Abstract, discussion ва арзёбии efficiency аз стратегияҳои federated gradient compression ёд мекунанд. Аммо матни нашршудаи усул шакли compression operator, compression ratio ё алгоритми quantization/sparsification-и истифодашударо бо муодилаи ҷудогона гузориш намекунад. Аз ин рӯ exact implementation-и gradient compression дар манбаъ ба таври муфассал дубора тавлидшаванда нест.
Гузариш аз ошкорсозии ҳамла ба қарори дифоӣ
Дар таҳқиқот network state \(s\) нишондиҳандаҳое чун суръати трафик, protocol distributions ва anomaly scores-ро, ки аз равзанаи вақти ҷорӣ гирифта шудаанд, дар бар мегирад. Spatio-temporal Transformer ин state representation-ро тавлид мекунад ва reinforcement-learning agent амали дифоиро интихоб мекунад.
Муодилаи 8: Навсозии Q-learning
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+ \gamma \max_{a'}Q(s',a') - Q(s,a) \right] \tag{8} \]
\(s\): Network state-и ҷорӣ.
\(a\): Defense action-и интихобшуда.
\(r\): Reward баъд аз амал.
\(s'\): Network state-и баъдӣ.
\(\alpha\): Коэффисиенти Q-learning update; манбаъ барои ин муодила арзиши рақамии \(\alpha\)-ро намедиҳад.
\(\gamma\): Discount factor, ки арзиши имрӯзаи reward-ҳои ояндаро муайян мекунад. Дар бахши DQN loss манбаъ \(\gamma=0.9\)-ро истифода мебарад.
Функсияи Reward
\[ r= w_1\cdot \mathbf{1}(\mathrm{Correct\ Response}) - \left( w_2 L+w_3F \right) \]
\(\mathbf{1}(\mathrm{Correct\ Response})\): Indicator, ки ҳолати бомуваффақият пешгирӣ шудани ҳамларо нишон медиҳад.
\(L\): Response latency.
\(F\): False-positive cost.
\(w_1,w_2,w_3\): Гиперпараметрҳое, ки мувофиқи Security requirement танзим мешаванд. Манбаъ арзишҳои рақамии ин вазнҳоро гузориш намекунад.
Ин сохтори reward танҳо муваффақияти пешгирии ҳамларо мукофот намедиҳад; response latency-и баланд ва false-positive cost-ро низ ҳамчун ҷазо ба ҳисоб мегирад.
Global multi-objective loss
\[ \mathcal{L}(\theta) = \mathcal{L}_{CE}(\theta) + \lambda_{Defense} \mathcal{L}_{Defense}(\theta) + \lambda_{reg} \mathcal{L}_{reg}(\theta) \tag{9} \]
Манбаъ:
\[ \lambda_{Defense}=0.5 \]
ва
\[ \lambda_{reg}=1\times10^{-4} \]
арзишҳоро истифода мебарад.
\(\mathcal{L}_{CE}\) attack-detection classification error, \(\mathcal{L}_{Defense}\) reinforcement-learning defense loss ва \(\mathcal{L}_{reg}\) аъзои regularization-ро, ки overfitting-ро маҳдуд мекунад, ифода мекунанд.
Муодилаи 10: Binary cross-entropy
\[ \mathcal{L}_{CE}(\theta) = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log(\hat{y}_i) + (1-y_i)\log(1-\hat{y}_i) \right] \tag{10} \]
\(y_i\in\{0,1\}\) нишонаи воқеӣ, \(\hat{y}_i\) эҳтимоли ҳамлаи модел ва \(N\) batch size-ро ифода мекунад.
Вақте ба ҳамлаи воқеӣ attack probability-и паст ё ба намунаи воқеан муқаррарӣ attack probability-и баланд дода мешавад, loss меафзояд.
Муодилаи 11: DQN Temporal Difference loss
\[ \mathcal{L}_{Defense}(\theta) = \mathbb{E}_{(s,a,r,s')} \left[ \left( r+ \gamma \max_{a'} Q(s',a';\theta^-) - Q(s,a;\theta) \right)^2 \right] \tag{11} \]
\(\theta\): Параметрҳои Current Q-network.
\(\theta^-\): Параметрҳои target network, ки дар фосилаҳои муайян собит карда мешаванд.
\(\gamma=0.9\): Discount factor.
Loss ҳадаф дорад квадрати хатои Temporal Difference байни Q-value-и ҷорӣ ва Bellman target-ро кам кунад.
Усул ва Натиҷаҳои Таҳқиқот
Маҷмӯаҳои додаҳо ва preprocessing
| Маҷмӯаи додаҳо | Контекст | Андозаи Feature | Table 1 train / validation / test | Preprocessing |
|---|---|---|---|---|
| UNSW-NB15 | Network-attack detection-и умумӣ; манбаъ мегӯяд 9 attack type дорад. | d = 42 | 50k / 5k / 10k | Standardization |
| BoT-IoT | Трафики шабакаи IoT/IIoT; DDoS, DoS, scanning ва дигар attack types | d = 10 core network feature | 100k / 10k / 20k | Min-Max normalization |
Манбаъ вазифаи моделро ҳамчун binary classification-и муқаррарӣ/ҳамла муайян мекунад. Аз ин рӯ, гарчанде дар маҷмӯаҳои додаҳо чанд оилаи ҳамла вуҷуд дошта бошад, objective-и асосӣ ва Муодилаи 10 сохтори binary label-ро истифода мекунанд.
Барои UNSW-NB15 матни усул инчунин таносуби training/validation/testing-ро мутаносибан %50/%10/%40 нишон медиҳад. Аммо рақамҳои 50k/5k/10k дар Table 1 бо ин фоизҳо мувофиқат намекунанд. Verianla яке аз ин ду ифодаи гуногуни манбаъро хомӯшона ислоҳ намекунад.
Дар сутуни “Source / Acquisition Method”-и Table 1 дар сатрҳои UNSW-NB15 ва BoT-IoT як суроғаи лоиҳаи BoT-IoT намоён аст; ин ҳам хусусияти пешниҳоди худи ҷадвали манбаъ мебошад. Verianla онро ҳамчун суроғаи воқеии манбаи UNSW-NB15 дубора пешниҳод намекунад.
Оё manual feature selection истифода шудааст?
Не. Манбаъ мегӯяд, ки пеш аз ворид кардани ҳар ду маҷмӯаи додаҳо ба spatio-temporal encoder ягон manual feature selection-и иловагӣ истифода нашудааст. Ҳадаф арзёбии қобилияти end-to-end feature extraction-и модел мебошад.
Модел ва таҷҳизот
| Унсур | Арзиши манбаъ |
|---|---|
| GPU | NVIDIA GeForce RTX 3080, 10 GB VRAM |
| Framework | PyTorch 1.10 |
| CUDA | 11.2 |
| Қабати Transformer | 6 |
| Hidden dimension | 512 |
| Attention head | 8 |
| Optimizer | Adam |
| Initial learning rate | \(1\times10^{-4}\) |
| \(\lambda_{Defense}\) | 0.5 |
| \(\lambda_{reg}\) | \(1\times10^{-4}\) |
| DP noise multiplier | \(\sigma=0.1\) |
| Random seed | 42 |
Бахши Experimental Setup барои robustness testing арзиши Gaussian noise standard deviation-ро 0.05 медиҳад. Robustness validation-и баъдӣ бошад sweep-и васеътареро гузориш мекунад, ки noise standard deviation-ро аз 0 то 0.2 зиёд мекунад.
Фарқи дохилии манбаъ дар шумораи такрор
Дар охири Experimental Setup манбаъ ибораи “results are reported as the mean ± standard deviation over 5 runs”-ро истифода мекунад. Дар бахши Quantitative Results бошад “all experiments were repeated 10 times” гуфта мешавад. Сарлавҳаи Table 4 низ ба таври возеҳ n=10 нишон медиҳад.
Аз ин рӯ дубора навиштани шумораи такрор ҳамчун як рақами дақиқ барои ҳамаи таҷрибаҳо бехатар нест. Арзишҳои mean ± standard deviation, ки дар Table 3–4 дида мешаванд, ҳамон гуна ки дар манбаъ нашр шудаанд, нигоҳ дошта шудаанд.
Метрикаҳои арзёбӣ
Манбаъ Accuracy, Precision, Recall ва F1-Score-ро истифода мебарад:
\[ Accuracy= \frac{TP+TN} {TP+TN+FP+FN} \]
\[ Precision= \frac{TP}{TP+FP} \]
\[ Recall= \frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
TP ошкорсозии дурусти ҳамла, TN қарори дурусти трафики муқаррарӣ, FP огоҳии нодурусти ҳамла барои трафики муқаррарӣ ва FN ҳамлаҳои воқеии аз дастрафтаро ифода мекунад.
Усулҳои Baseline
- LSTM-IDS: Recurrent baseline, ки temporal dependency-ҳоро модел мекунад.
- FedIDS: Intrusion-detection baseline дар асоси federated-learning.
- DP-GNN: Privacy-preserving baseline, ки differential privacy ва graph convolution-ро муттаҳид мекунад.
- RustGraph: Baseline, ки барои dynamic graph anomaly detection structural-temporal dependency-ро модел мекунад.
Муқоисаи асосии самаранокӣ
| Усул | Маҷмӯаи додаҳо | Accuracy | FPR | F1 | Training Time | p-value |
|---|---|---|---|---|---|---|
| LSTM-IDS | UNSW-NB15 | 87.2% ± 0.6% | 5.2% ± 0.3% | 86.4% ± 0.5% | 1200 ± 120 s | <0.001 |
| LSTM-IDS | BoT-IoT | 84.5% ± 0.8% | 6.8% ± 0.4% | 83.9% ± 0.7% | 1500 ± 150 s | <0.001 |
| FedIDS | UNSW-NB15 | 89.5% ± 0.5% | 3.8% ± 0.2% | 88.7% ± 0.6% | 1300 ± 130 s | 0.002 |
| FedIDS | BoT-IoT | 87.0% ± 0.7% | 4.5% ± 0.3% | 86.2% ± 0.8% | 1600 ± 160 s | 0.001 |
| DP-GNN | UNSW-NB15 | 90.3% ± 0.4% | 3.1% ± 0.2% | 89.5% ± 0.5% | 1400 ± 140 s | 0.005 |
| DP-GNN | BoT-IoT | 88.5% ± 0.6% | 3.9% ± 0.3% | 87.8% ± 0.7% | 1700 ± 170 s | 0.003 |
| RustGraph | UNSW-NB15 | 91.2% ± 0.3% | 2.4% ± 0.1% | 90.5% ± 0.4% | 1500 ± 150 s | 0.01 |
| RustGraph | BoT-IoT | 90.0% ± 0.5% | 3.0% ± 0.2% | 89.2% ± 0.6% | 1800 ± 180 s | 0.008 |
| Proposed Method | UNSW-NB15 | 93.5% ± 0.2% | 1.2% ± 0.1% | 92.8% ± 0.3% | 1100 ± 110 s | — |
| Proposed Method | BoT-IoT | 92.0% ± 0.4% | 1.8% ± 0.2% | 91.3% ± 0.5% | 1400 ± 140 s | — |
Proposed Method дар ҳар ду маҷмӯаи додаҳо баландтарин арзишҳои accuracy ва F1 ва ҳамзамон пасттарин арзишҳои FPR-ро дар ҷадвали манбаъ медиҳад.
Азбаски дар BoT-IoT proposed accuracy %92,0 ва DP-GNN accuracy %88,5 аст, фарқ:
\[ 92.0-88.5=3.5 \]
3,5 банди фоизӣ мебошад. Ин ифода relative percentage increase нест, балки фарқи мутлақи percentage-point байни ду фоизи accuracy мебошад.
Дар сутуни p-value-и Table 3 барои baseline-ҳо арзишҳо дода шудаанд ва significance level 0.05 нишон дода мешавад. Аммо манбаъ номи exact statistical test ва exact null hypothesis-и сутуни p-value-ро ба таври муфассал гузориш намекунад. Аз ин рӯ Verianla тахмин накардааст, ки p-арзишҳо аз кадом санҷиш гирифта шудаанд.
Натиҷаи Convergence
Манбаъ дар Figure 5 мегӯяд, ки proposed method дар UNSW-NB15 тақрибан дар epoch-и 80 ба сатҳи %90 accuracy мерасад, дар ҳоле ки расидани RustGraph ба сатҳи монанд бештар аз 92 epoch тӯл мекашад.
Манбаъ ин рафтори тезтари convergence-ро ба он мепайвандад, ки adaptive graph structure ва spatio-temporal attention gradient propagation-ро тавассути redundant connections коҳиш медиҳанд. Ин шарҳи механизм аз ҷониби муаллифон аст.
Натиҷаҳои Efficiency
| Усул | Параметр (M) | FLOPs (G) | Training Time (s/epoch) | Inference Latency (ms/sample) |
|---|---|---|---|---|
| LSTM-IDS | 2.1 ± 0.0 | 4.8 ± 0.1 | 15.0 ± 0.8 | 1.2 ± 0.1 |
| FedIDS | 3.4 ± 0.1 | 7.2 ± 0.3 | 16.3 ± 0.9 | 1.8 ± 0.2 |
| DP-GNN | 5.7 ± 0.2 | 12.5 ± 0.5 | 17.5 ± 1.0 | 2.5 ± 0.3 |
| RustGraph | 6.9 ± 0.3 | 15.0 ± 0.6 | 18.8 ± 1.1 | 3.0 ± 0.2 |
| Proposed Method | 7.2 ± 0.2 | 14.8 ± 0.5 | 13.8 ± 0.7 | 2.1 ± 0.2 |
Proposed Method аз рӯйи шумораи параметрҳо бузургтарин модел аст: 7,2 миллион параметр. Бо вуҷуди ин, дар муқобили training time-и 18,8 s/epoch-и RustGraph он 13,8 s/epoch ва дар муқобили inference latency-и 3,0 ms/sample он 2,1 ms/sample медиҳад.
Манбаъ мегӯяд, ки нисбат ба RustGraph training time тақрибан %26,6 ва inference latency %30 пасттар аст. Ҳамчунин гузориш шудааст, ки GNN-based baseline hidden dimensions тавре standardize шудаанд, ки parameter scale-и монанд диҳанд.
Оё Таъхири 2,1 ms Inference Муваффақияти Реалии Саҳроиро Дар Вақти Воқеӣ Исбот Мекунад?
Не. Манбаъ мегӯяд, ки арзиши 2,1 ± 0,2 ms/sample ченаки таҷрибавии end-to-end inference-и худи таҳқиқот аст, ки dynamic graph construction, feature extraction ва Transformer forward pass-ро дар бар мегирад ва ба иқтидори коркарди тақрибан 500 traffic sample/s мувофиқат мекунад; аммо ченкунӣ дар GPU-и RTX 3080 бо додаҳои benchmark анҷом дода шудааст ва deployment-и дарозмуддати саҳроӣ дар дастгоҳи воқеии edge, воситаи V2X ё шабакаи истеҳсолӣ нест.
Аз нигоҳи математикӣ:
\[ \frac{1}{0.0021\;s} \approx476\;sample/s \]
мешавад. Ифодаи “nearly 500 traffic samples per second”-и манбаъ ба ин арзиши тақрибӣ мувофиқат мекунад.
Аммо манбаъ дар бахши discussion ба таври возеҳ эътироф мекунад, ки adaptive graph construction дар micro-IoT node-ҳои сахт resource-constrained computation overhead-и иловагӣ эҷод мекунад ва оптимизатсия лозим аст.
Намунаи сифатии муваффақ
Дар мисоле, ки манбаъ бо нишони “UNSW-NB15 – DoS Hulk” медиҳад, шумораи пайвастҳои нави host-и ҳадаф дар attack window-и байни сонияҳои 28–32 аз миёнаи baseline-и 24,3 connection/s ба peak-и 3872 connection/s боло рафтааст.
Диапазони normal fluctuation тақрибан ±2σ ≈ 60 дода шудааст. Proposed Method ҳамларо бо %96,7 confidence ҳамчун DoS тасниф кардааст.
Дар t=30 s вазнҳои attention:
| Feature | Attention weight |
|---|---|
| Connection burstiness | 0.42 |
| Destination port diversity | 0.38 |
LSTM-IDS ҳамон намунаро бо %58,1 confidence ҳамчун трафики муқаррарӣ нодуруст тасниф кардааст.
Ёддошти номгузории манбаъ: Мақола ин ҳолатро ба таври возеҳ “UNSW-NB15 – DoS Hulk Attack Detection” меномад. Матни нашршуда муносибати ин номгузории ҳамларо бо таксономияи маҷмӯаи додаҳо алоҳида шарҳ намедиҳад. Verianla нишони манбаъро тағйир намедиҳад ва шарҳи норасоро аз худ намесозад.
Чаро Модел Дар Сканкунии Ultra-Low-Frequency Ноком Шуд?
Дар мисоли port-scan-и суръати паст, ки манбаъ медиҳад, азбаски сигнали ҳамла ба трафики муқаррарии IoT heartbeat хеле наздик буд, federated clients танҳо диди маҳдуди маҳаллиро медиданд ва \(\sigma=0.1\) differential-privacy noise anomaly gradient-ҳои заифро фурӯ менишонд, dynamic graph натавонист anomaly edge-ҳои маънодор созад ва модел ҳамларо ҳамчун трафики муқаррарӣ тасниф кард.
| Унсур | Арзиши манбаъ |
|---|---|
| Басомади Probe | 6 дақиқада 1 probe |
| Мушоҳидаи умумӣ | 30 дақиқа |
| Probe-и умумӣ | 5 |
| Attack packet rate | 0.8 pkt/s |
| Диапазони normal IoT heartbeat | 0.7–1.1 pkt/s |
| Adjacency matrix sparsity | 99.6% |
| Қарори модел | Normal registration behavior |
| Confidence | 62.3% |
| DP noise | \(\sigma=0.1\) |
Манбаъ пешниҳод мекунад, ки дар оянда механизмҳое чун cross-device meta-event correlations ё unsupervised anomaly priors метавонанд ба ин information-scarcity problem кӯмак кунанд. Инҳо натиҷаҳои дар таҷрибаи ҷорӣ тасдиқшуда нестанд.
Noise robustness
Ҳангоми илова кардани Gaussian noise ба input feature-ҳо standard deviation аз 0 то 0.2 зиёд карда шудааст. Арзиши accuracy-и Proposed Method аз %93,5 ба %89,3 коҳиш ёфта, RustGraph ба %83,2 ва DP-GNN ба %84,6 поён рафтаанд.
| Усул | Оғоз / истинод | Натиҷа дар шароити Noise std = 0.2 |
|---|---|---|
| Proposed Method | 93.5% accuracy | 89.3% accuracy |
| RustGraph | Манбаъ дар ин ҷумла арзиши оғозро дубора намедиҳад. | 83.2% accuracy |
| DP-GNN | Манбаъ дар ин ҷумла арзиши оғозро дубора намедиҳад. | 84.6% accuracy |
Азбаски манбаъ ҳамаи нуқтаҳои numeric-и мобайнии каҷи Figure 7-ро ҳамчун ҷадвал намедиҳад, Verianla интерполятсияи арзишҳои мобайниро анҷом намедиҳад.
Манбаъ инчунин мегӯяд, ки ҳангоми хориҷ кардани “spatial attention module” accuracy то %83,5 паст мешавад. Ин ифода дар шарҳи robustness-и ҷудогона аз номгузории модулҳо дар Table 5 омадааст.
Cross-Dataset Direct Transfer Чӣ Гуна Санҷида Шуд?
Таҷрибаи cross-dataset generalization бо омӯзонидани proposed model дар UNSW-NB15 ва санҷидани мустақими он дар BoT-IoT бе ягон fine-tuning анҷом дода шудааст; манбаъ гузориш мекунад, ки proposed model дар ҳар ду тараф арзиши F1-ро болотар аз %91 нигоҳ дошта ва дар BoT-IoT-и ҳадаф аз RustGraph 2,1 банди фоизӣ баландтар будааст.
Ин таҷриба нисбат ба арзёбии стандартии same-dataset train/test санҷиши қавитари distribution-shift мебошад, зеро модел ба маҷмӯаи додаҳои ҳадаф дубора мутобиқ карда нашудааст.
Манбаъ мегӯяд, ки дар BoT-IoT-и ҳадаф unseen attack variants ба монанди hybrid DDoS мавҷуданд. Муаллифон пешниҳод мекунанд, ки омезиши dynamic graph structure ва local-global federated modeling-и Proposed Method дар мутобиқшавӣ ба ин distribution shift нақш дорад.
Аммо натиҷаи cross-dataset далели universal generalization барои ҳар муҳити шабакавии воқеӣ нест. Он танҳо шарти transfer-и UNSW-NB15 → BoT-IoT-ро, ки дар манбаъ санҷида шудааст, дастгирӣ мекунад.
Таҳлили Ablation
| Варианти модел | UNSW-NB15 | BoT-IoT |
|---|---|---|
| Full Model | 93.5 / 92.8 | 92.0 / 91.3 |
| Adaptive Spatio-Temporal Graph Generation хориҷ шуд | 90.1 / 89.4 | 88.7 / 87.9 |
| Federated Differential Privacy хориҷ шуд; Centralized Training | 92.8 / 92.0 | 91.2 / 90.5 |
| Reinforcement Learning Dynamic Defense Module хориҷ шуд | 93.2 / 92.5 | 91.7 / 91.0 |
| Ба ҷойи Spatio-Temporal Transformer GCN+LSTM | 89.6 / 88.7 | 87.4 / 86.5 |
| Base GNN Only | 87.3 / 86.1 | 84.9 / 83.8 |
Аз нигоҳи BoT-IoT F1, full model %91,3 аст. Ҳангоми хориҷ кардани Adaptive graph он ба %87,9 паст шуда, 3,4 percentage-point талаф ба вуҷуд меояд. Вақте Spatio-temporal Transformer бо GCN+LSTM иваз мешавад, он ба %86,5 меафтад; талаф 4,8 percentage point аст.
Ҳангоми иваз кардани механизми Federated differential privacy бо centralized training, BoT-IoT F1 аз %91,3 ба %90,5 паст мешавад; фарқ 0,8 percentage point аст.
Ҳангоми хориҷ кардани RL dynamic-defense module, BoT-IoT F1 танҳо аз %91,3 ба %91,0 паст мешавад. Манбаъ ин фарқи хурди classification-ро натиҷаи интизоршаванда мешуморад, зеро вазифаи асосии қабати reinforcement-learning classification нест, балки интихоби response strategy баъд аз ҳамла мебошад.
Сохтори Base GNN Only бо %83,8 F1 дар BoT-IoT заифтарин вариант аст. Ин натиҷа дар манбаъ ҳамчун finding-и ablation шарҳ дода мешавад, ки graph representation танҳо кофӣ нест ва саҳми spatio-temporal attention муҳим аст.
Privacy–utility trade-off
Ablation нишон медиҳад, ки хориҷ кардани механизми federated differential privacy дар accuracy/F1 мисли дигар ҷузъҳои марказии меъморӣ фарқи калон ба вуҷуд намеорад. Манбаъ инро ҳамчун далеле шарҳ медиҳад, ки privacy protection метавонад бо utility loss-и камтар татбиқ шавад.
Аммо азбаски membership-inference success rate барои механизми privacy дар ҷадвалҳои асосии натиҷаҳо ба таври миқдорӣ дода нашудааст, арзёбии privacy–utility асосан тавассути параметрҳои differential-privacy, detection metrics ва натиҷаҳои ablation пайгирӣ мешавад.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Омезиши adaptive spatio-temporal graph ва Transformer дар ду benchmark-и истифодашуда accuracy ва F1-и баландтар аз baseline-ҳо тавлид кардааст.
- Proposed Method дар UNSW-NB15 %93,5 ± %0,2 accuracy ва %92,8 ± %0,3 F1 ба даст овардааст.
- Proposed Method дар BoT-IoT %92,0 ± %0,4 accuracy ва %91,3 ± %0,5 F1 ба даст овардааст.
- Дар BoT-IoT proposed accuracy аз DP-GNN 3,5 percentage point баландтар аст.
- FPR дар UNSW-NB15 %1,2 ± %0,1 ва дар BoT-IoT %1,8 ± %0,2 гузориш шудааст.
- Таҷрибаи UNSW-NB15 → BoT-IoT direct-transfer бе fine-tuning анҷом дода шудааст.
- Ablation-ҳои Adaptive graph ва Transformer бузургтарин коҳишҳои самаранокии моделро ба вуҷуд овардаанд.
- Иваз кардани механизми Federated differential privacy бо centralized training нисбат ба full model фарқи F1-и камтар аз %1 ба вуҷуд овардааст.
- Дар муҳити таҷрибавии RTX 3080 end-to-end inference latency 2,1 ± 0,2 ms/sample чен шудааст.
- Ҳангоми зиёд кардани Input noise std то 0,2 proposed accuracy ба %89,3 коҳиш ёфта, вале аз baseline-ҳои муқоисашуда дар манбаъ баландтар мондааст.
- Намунаи Ultra-low-frequency scanning ҳадди муҳими нокомии моделро нишон медиҳад.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад ё норасо мегузорад
- Самаранокии дарозмуддати саҳроӣ дар шабакаи воқеии V2X ё deployment-и тиҷоратии IoT нишон дода нашудааст.
- Натиҷаи 2,1 ms кафолат намедиҳад, ки дар ҳамаи таҷҳизоти micro-IoT ҳамон latency ба даст меояд.
- Натиҷаи transfer-и UNSW-NB15 → BoT-IoT исбот намекунад, ки дар ҳар домени номаълуми додаҳои шабака ҳамон generalization ба вуҷуд меояд.
- Ultra-low-frequency stealth attacks ҳал нашудаанд.
- Гарчанде коҳиши сатҳи муваффақияти ҳамлаҳои membership inference дар abstract гузориш шудааст, дар матни асосӣ арзиши миқдорӣ ва протоколи муфассал дода нашудааст.
- Exact implementation, compression ratio ва тафсилоти operator-и алгоритми gradient-compression гузориш нашудаанд.
- Арзиши рақамии sliding temporal window size \(K\) гузориш нашудааст.
- Арзишҳои structural ва task gradient clipping threshold алоҳида гузориш нашудаанд.
- Reward weights-и \(w_1,w_2,w_3\) ба таври рақамӣ дода нашудаанд.
- Exact номи statistical test, ки p-value-ҳои Table 3-ро тавлид кардааст, гузориш нашудааст.
- Дар манбаъ байни ифодаҳои 5 run ва 10 repeat номувофиқатӣ ҳаст.
- Таносуби %50/%10/%40, ки барои UNSW-NB15 навишта шудааст, бо рақамҳои 50k/5k/10k дар Table 1 мувофиқат намекунад.
Маҳдудиятҳо ва таҳқиқоти оянда
Манбаъ мегӯяд, ки назаррастарин маҳдудият extremely low-frequency stealth attacks аст. Доштани local views-и маҳдуд аз ҷониби federated learning client-ҳо ва фурӯ нишондани low-amplitude anomaly gradients аз ҷониби differential-privacy noise махсусан detection-ро дар ҳамлаҳои камбасомад душвор мекунад.
Гуфта мешавад, ки гарчанде adaptive graph construction дар дохили 2,1 ms overall latency кор мекунад, он метавонад дар micro-IoT node-ҳои сахт resource-constrained energy/computation overhead-и иловагӣ эҷод кунад.
Дар байни корҳои ояндаи пешниҳодшуда мубодилаи lightweight meta-event summary байни client-ҳо, истифодаи Secure Multi-Party Computation ё highly aggregated statistics, event-driven sparse graph updates, fully unsupervised ё open-set anomaly detection ва оптимизатсияи graph-construction барои micro-embedded devices ҳастанд.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: A Spatio-Temporal Transformer-Based Approach for Network Attack Detection
Муаллифон ва тартиб: Xin Liu; Xiang Liu.
Corresponding author: Xin Liu; дар манбаъ бо аломати ситора нишон дода шудааст.
Муассисаи Xin Liu: School of Advanced Engineering, University of Science and Technology Beijing, Beijing 100083, China.
Почтаи электронии Xin Liu: u202341641@xs.ustb.edu.cn
Муассисаи Xiang Liu: School of International Education, Beijing University of Chemical Technology, Beijing 102203, China.
Почтаи электронии Xiang Liu: 2024090034@mail.buct.edu.cn
Саҳми баробар / ҳаммуаллифии якуми баробар: Дар манбаъ баёнияи саҳми баробар вуҷуд надорад.
Журнал: Journal of Universal Computer Science.
Ихтисора: J.UCS.
Ҷилд / шумора: Volume 32, Number 9.
Саҳифаҳо: 1375–1398.
Соли нашр: 2026.
Submitted: 23 Январ 2026.
Accepted: 7 Июл 2026.
Appeared / Published: 14 Сентябр 2026.
DOI: 10.3897/jucs.207303.
Пайванди расмии DOI: https://doi.org/10.3897/jucs.207303
Навъи манбаъ: Мақолаи аслии таҳқиқотии нашршуда.
Вазъи рецензия: Journal of Universal Computer Science маҷаллаи рецензияшаванда аст; дар профили расмии ҷории маҷалла single-blind review ва ҳадди ақал ду editorial-board reviewer зикр шудааст.
Литсензияи мақола: CC BY 4.0; дар саҳифаи аввали PDF-и мақола ба таври возеҳ нишон дода шудааст.
Масъалаи асосӣ: Баррасии ҳадафҳои accuracy-и баланд, privacy preservation ва attack detection/response бо latency-и паст дар як framework зери dynamic network topology.
Формулировкаи вазифа: Binary classification; \(y=0\) normal, \(y=1\) malicious traffic.
Се модули асосӣ: Spatio-temporal feature extraction; federated differential-privacy protection; reinforcement-learning attack detection/defense.
Dynamic graph: Time-dependent adjacency matrix дар асоси communication relationships ва traffic-feature similarity.
Graph threshold: Дар бахши усул learnable \(\epsilon\); sensitivity analysis ҳамчун арзиши интихобшуда \(\epsilon=0.5\)-ро гузориш мекунад.
Threshold sensitivity: Барои \(\epsilon\in[0.4,0.6]\), F1 > %91; барои \(\epsilon>0.7\), F1 тақрибан %86,5.
Transformer: 6 layer, hidden dimension 512, 8-head multi-head attention.
Federated aggregation: Манбаъ дар Муодилаи 6 миёнаи одии local model parameters-ро медиҳад.
Differential privacy: DP-SGD, gradient clipping ва Gaussian noise.
DP noise multiplier: \(\sigma=0.1\).
Privacy budget: Тақрибан \(\epsilon=2.4\), \(\delta=10^{-5}\), шарте, ки манбаъ баъд аз 100 epoch гузориш мекунад.
Feature decoupling: Ҷудокунӣ ба structural gradient ва task gradient; рақамҳои дақиқи clipping threshold гузориш нашудаанд.
Gradient compression: Манбаъ онро ҳамчун ҷузъ зикр мекунад; exact compression algorithm ва таносуб гузориш нашудааст.
Reinforcement learning: Q-learning / Deep Q-Network.
DQN discount factor: \(\gamma=0.9\).
Defense actions: Манбаъ ҳамчун мисол traffic limiting ва data filtering-ро медиҳад.
Reward: Мукофоти Correct response-ро бо ҷазои latency ва false-positive cost муттаҳид мекунад; арзишҳои \(w_1,w_2,w_3\) гузориш намешаванд.
Global loss: Binary cross-entropy + defense TD loss + regularization.
\(\lambda_{Defense}\): 0.5.
\(\lambda_{reg}\): \(1\times10^{-4}\).
Optimizer: Adam.
Initial learning rate: \(1\times10^{-4}\).
UNSW-NB15 features: d = 42, ба истиснои ID ва labels.
BoT-IoT features: d = 10 core network features.
UNSW preprocessing: Standardization.
BoT-IoT preprocessing: Min-Max normalization.
Manual feature selection: Истифода нашудааст.
Table 1 sample split: UNSW-NB15 50k / 5k / 10k; BoT-IoT 100k / 10k / 20k.
Фарқи partition дар дохили манбаъ: Матн барои UNSW-NB15 таносуби %50/%10/%40-ро медиҳад; 50k/5k/10k дар Table 1 бо ин мувофиқат намекунад.
Таҷҳизот: NVIDIA GeForce RTX 3080 GPU, 10 GB VRAM.
Нармафзор: PyTorch 1.10, CUDA 11.2.
Random seed: 42.
Фарқи run-count дар дохили манбаъ: Experimental Setup 5 run mean ± std мегӯяд; Quantitative Results 10 repeat мегӯяд ва Table 4 n=10 нишон медиҳад.
Significance level: 0.05.
Маҳдудияти Statistical-test: Table 3 p-value медиҳад; exact statistical-test ва тафсилоти null-hypothesis дар матни асосӣ ба таври возеҳ зикр нашудааст.
Натиҷаи асосии UNSW-NB15: Accuracy 93.5% ± 0.2%; F1 92.8% ± 0.3%; FPR 1.2% ± 0.1%.
Натиҷаи асосии BoT-IoT: Accuracy 92.0% ± 0.4%; F1 91.3% ± 0.5%; FPR 1.8% ± 0.2%.
Муқоисаи DP-GNN: BoT-IoT accuracy 88.5% ± 0.6%; фарқи proposed +3.5 percentage point.
Inference latency: 2.1 ± 0.2 ms/sample.
Доираи Inference: Dynamic graph construction + feature extraction + Transformer forward pass.
Proposed parameter count: 7.2 ± 0.2 million.
Proposed FLOPs: 14.8 ± 0.5 G.
Training time: Дар Table 4, 13.8 ± 0.7 s/epoch.
Cross-dataset test: Training дар UNSW-NB15 → direct testing дар BoT-IoT бе fine-tuning.
Натиҷаи Cross-dataset: Манбаъ мегӯяд proposed F1 дар ҳар ду маҷмӯаи додаҳо болотар аз %91 мондааст ва дар BoT-IoT-и ҳадаф аз RustGraph 2.1 percentage point баландтар аст.
Noise robustness: Gaussian feature noise std 0→0.2; proposed accuracy 93.5%→89.3%.
Failure case-и муҳим: Ҳар 6 дақиқа як probe, дар 30 дақиқа 5 probe, 0.8 pkt/s; normal heartbeat 0.7–1.1 pkt/s; adjacency sparsity 99.6%; normal prediction confidence 62.3%.
Ёддошти Membership inference: Abstract мегӯяд, ки дар ҳамон privacy budget attack success rate ба таври назаррас коҳиш ёфтааст; дар матни асосӣ membership-inference success rate-и миқдорӣ ё протоколи муфассали таҷриба вуҷуд надорад.
Натиҷаи Ablation: BoT-IoT F1 full model 91.3%; no adaptive graph 87.9%; centralized/no federated DP 90.5%; no RL defense 91.0%; GCN+LSTM replacement 86.5%; base GNN only 83.8%.
Маблағгузорӣ: Дар PDF-и баррасишуда бахши алоҳидаи funding declaration вуҷуд надорад.
Ихтилофи манфиатҳо: Дар PDF-и баррасишуда conflict-of-interest declaration-и алоҳида вуҷуд надорад.
Data Availability: Дар PDF-и баррасишуда Data Availability statement-и алоҳида вуҷуд надорад; дар бахши таҷриба UNSW-NB15 ва BoT-IoT ҳамчун public datasets муайян шудаанд.
Саҳми муаллифон / CRediT: Дар PDF-и баррасишуда author-contributions ё CRediT statement-и алоҳида вуҷуд надорад.
Ҳадди асосии таҳқиқот: Натиҷаҳо ба маҷмӯаҳои benchmark ва муҳити таҷрибавии RTX 3080 дахл доранд; ин тасдиқи дарозмуддати саҳроӣ дар micro-IoT node-и воқеӣ, V2X fleet ё production SOC нест.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд