


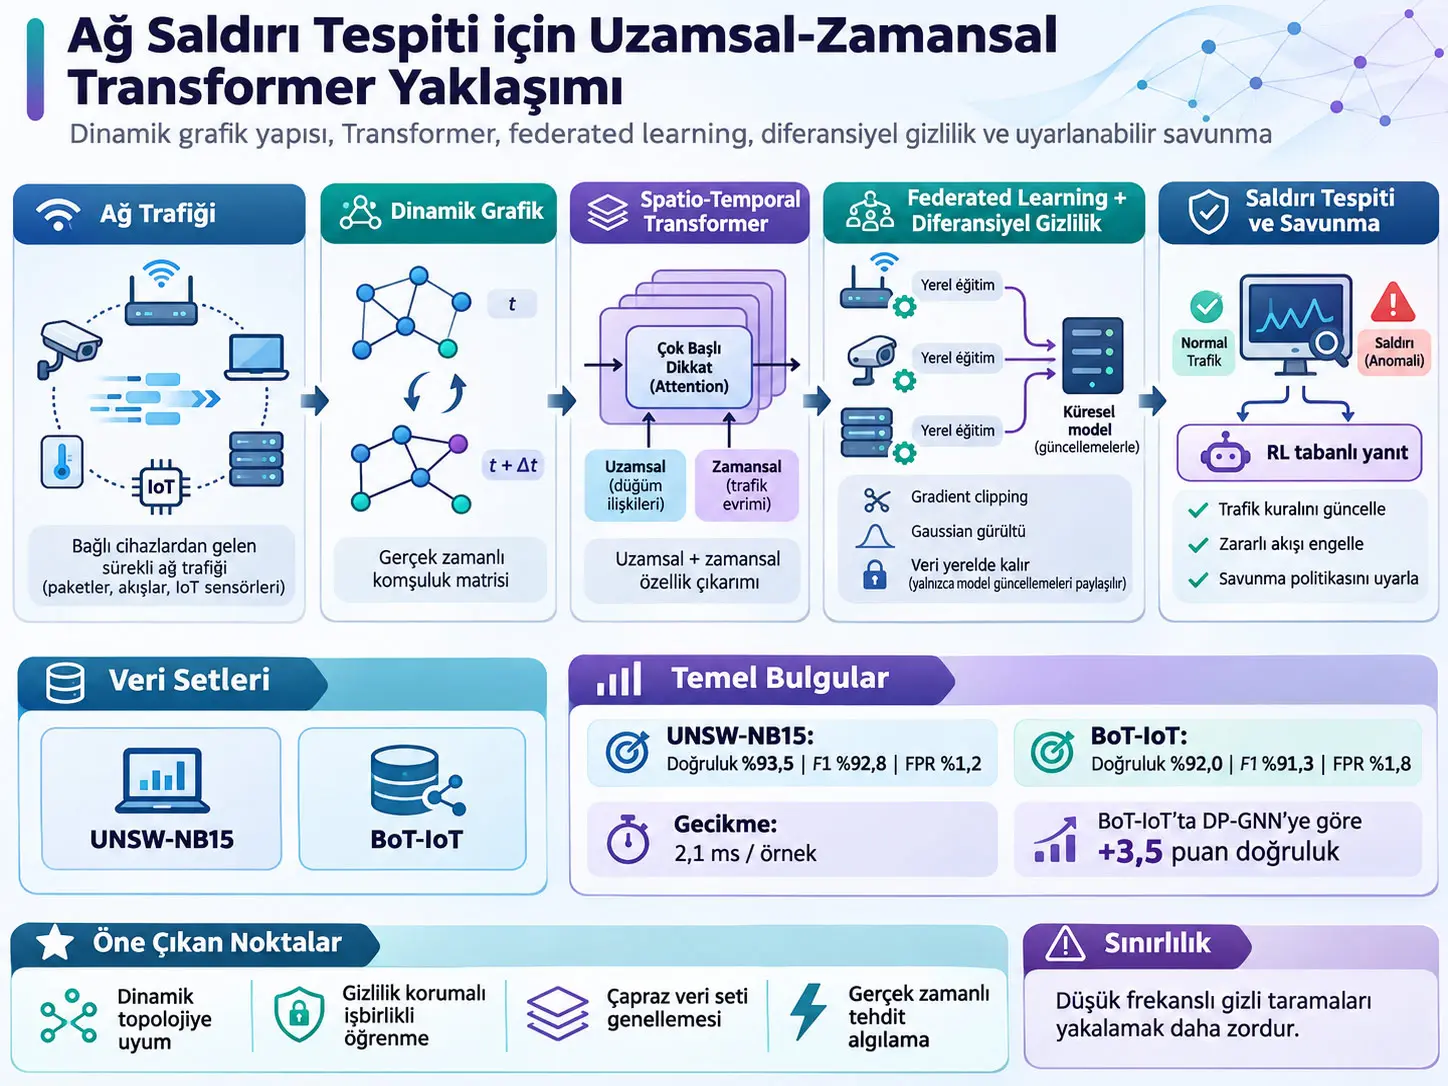
Adaptif uzamsal-zamansal Transformer tabanlı ağ saldırı tespit çerçevesi, ağ düğümleri arasındaki değişen iletişim ilişkilerini dinamik bir grafik olarak modelleyen, zaman bağımlılıklarını Transformer ile, uzamsal/topolojik bağımlılıkları grafik evrişimiyle işleyen, yerel veriyi cihazdan çıkarmadan federated learning ve differential privacy kullanan ve saldırı sonrasında reinforcement learning ile savunma kararı üretmeyi amaçlayan bir network attack detection ve response yaklaşımıdır. Çalışma UNSW-NB15 ve BoT-IoT benchmark veri setleri üzerinde değerlendirilmiş; önerilen yöntem UNSW-NB15'te %93,5 ± %0,2 accuracy ve %92,8 ± %0,3 F1, BoT-IoT'ta ise %92,0 ± %0,4 accuracy ve %91,3 ± %0,5 F1 elde etmiştir. Bununla birlikte çalışma kontrollü veri setlerine dayanmaktadır; bu sonuçlar gerçek V2X, IoT veya üretim ağı üzerinde uzun dönem saha başarısı olarak yorumlanmamalıdır.
Çerçevenin ilk bileşeni, mevcut zaman penceresindeki ağ düğümlerinin iletişim sıklıkları ve trafik özelliklerinin benzerliğinden dinamik komşuluk matrisi üretir. Zayıf bağlantılar eşikleme ile budanır; böylece her düğümün ağın bütün düğümlerine bağlandığı yoğun bir yapı yerine daha seyrek ve güncel iletişim ilişkilerini temsil eden bir grafik elde edilmeye çalışılır. Zaman bağımlılıkları multi-head self-attention kullanan Transformer ile, topolojik bağımlılıklar graph convolution ile işlenir.
İkinci bileşen federated learning ve differential privacy'yi bir araya getirir. Yerel cihazlar ham trafik verisini merkezi sunucuya göndermek yerine kendi modellerini yerel olarak günceller; merkezi sunucu model parametrelerini birleştirir. Kaynak, differential privacy sırasında gradient clipping ve Gaussian noise kullanmakta; deney ayarlarında noise multiplier değerini \(\sigma=0.1\), toplam gizlilik bütçesini 100 epoch sonunda yaklaşık \(\epsilon=2.4\) ve \(\delta=10^{-5}\) olarak raporlamaktadır.
Üçüncü bileşen yalnız “saldırı var/yok” kararına odaklanmaz. Deep Q-Network tabanlı reinforcement learning katmanı, trafik hızı, protokol dağılımı ve anomaly score gibi göstergelerden oluşan network state'i kullanarak trafik sınırlama veya veri filtreleme gibi savunma eylemleri arasında seçim yapmayı amaçlar. Ablasyon sonuçları reinforcement-learning bileşeninin classification accuracy üzerindeki katkısının yalnız yaklaşık 0,3 yüzde puanı olduğunu; asıl rolünün saldırıya verilecek dinamik yanıt olduğunu göstermektedir.
Önerilen yöntemin en önemli performans kazanımı adaptif grafik oluşturma ile spatio-temporal Transformer bileşenlerinden gelmektedir. BoT-IoT'ta adaptif grafik oluşturma kaldırıldığında F1 %91,3'ten %87,9'a, Transformer GCN+LSTM ile değiştirildiğinde %86,5'e düşmektedir. Buna karşılık federated differential privacy mekanizmasının merkezi eğitimle değiştirilmesi F1'de yaklaşık 0,8 yüzde puanlık fark oluşturur.
Kaynak ayrıca doğrudan cross-dataset transfer deneyi raporlamaktadır: model UNSW-NB15 üzerinde eğitilmiş ve BoT-IoT üzerinde fine-tuning yapılmadan test edilmiştir. Yazarlar bu koşulda proposed modelin F1 değerini %91'in üzerinde tuttuğunu ve BoT-IoT'ta RustGraph'ı 2,1 yüzde puanı geçtiğini bildirmektedir.
Çalışmanın önemli sınırlılığı ultra-düşük frekanslı saldırılardır. Kaynakta verilen düşük hızlı port taraması örneğinde saldırgan 30 dakikada yalnız beş probe üretmiş, paket hızı 0,8 packet/s düzeyinde kalmış ve normal IoT heartbeat trafiğinin 0,7–1,1 packet/s aralığıyla büyük ölçüde örtüşmüştür. Model bu örneği %62,3 confidence ile normal davranış olarak sınıflandırmıştır. Yazarlar bu başarısızlığı federated learning'deki sınırlı yerel görünüm ve differential-privacy gürültüsünün zayıf anomaly gradient'lerini bastırmasıyla ilişkilendirmektedir.
Kaynağın abstract bölümü aynı privacy budget altında membership inference saldırılarının başarı oranının anlamlı biçimde azaltıldığını bildirmektedir. Ancak ana yöntem ve sonuç bölümlerinde membership-inference saldırısı için nicel başarı oranı, ayrı deney tablosu veya ayrıntılı test protokolü verilmemektedir. Bu nedenle bu iddia nitel bir kaynak beyanı olarak korunmalı, kaynakta bulunmayan sayılarla genişletilmemelidir.
Araştırma problemi nedir?
Network Attack Detection (NAD), ağ trafiğindeki normal davranış ile kötü amaçlı davranışı ayırmayı amaçlar. Bu çalışma problemi matematiksel olarak binary classification şeklinde kurmaktadır: \(y_i=0\) normal trafiği, \(y_i=1\) saldırı trafiğini ifade eder.
Çalışmanın çözmeye çalıştığı zorluk yalnız doğru sınıflandırma değildir. IoT, Internet of Vehicles ve Vehicle-to-Everything gibi ortamlarda hangi cihazların birbirleriyle iletişim kurduğu zaman içinde değişebilir. Aynı zamanda verilerin merkezi bir sunucuya gönderilmesi gizlilik riski oluşturabilir ve saldırı tespit edildikten sonra hangi savunma eyleminin uygulanacağı da ayrı bir problemdir.
Bu nedenle kaynak üç problemi tek çatı altında ele almaktadır:
- Dinamik ağ topolojisindeki uzamsal ve zamansal ilişkileri modellemek.
- Ham veriyi merkezi sisteme taşımadan ortak model eğitimi yapmak ve differential privacy uygulamak.
- Tespit sonrasında reinforcement learning ile dinamik savunma kararı üretmek.
Problem formülasyonu
Kaynak ağ trafiği verisini \(X\), her bir trafik örneğini \(x_i\), ikili sınıf etiketini ise \(y_i\) ile göstermektedir. Eğitim ve test kümeleri aynı feature yapısını kullanmaktadır.
İdeal optimizasyon hedefi beklenen riski azaltmaktır:
\[ \mathcal{L}(f)= \mathbb{E}_{(x,y)} \left[ \ell(f(x),y) \right] \tag{1} \]
Denklem 1 neyi hesaplar? Modelin veri dağılımı üzerindeki beklenen hata maliyetini ifade eder.
\(f(x)\): Modelin \(x\) trafik örneği için ürettiği tahmindir.
\(y\): Gerçek etikettir.
\(\ell(f(x),y)\): Tahmin ile gerçek etiket arasındaki farkı ölçen loss fonksiyonudur.
Matematiksel rol: Eğitim süreci doğrudan bütün olası ağ trafiğinin beklenen riskini hesaplayamaz; mevcut training samples üzerinden bu hedefe yaklaşmaya çalışır.
Dinamik Komşuluk Matrisi Bu Çalışmada Ne İşe Yarıyor?
Dinamik komşuluk matrisi, belirli bir zaman penceresinde hangi ağ düğümlerinin birbirleriyle anlamlı iletişim ilişkisine sahip olduğunu feature similarity ve iletişim yapısından türeterek spatio-temporal graph'ı günceller; zayıf bağlantıların eşiklenmesi modelin bütün düğümler arasında yoğun ve gürültülü bağlantılar kurması yerine zamanla değişen önemli topolojik ilişkileri işlemesini amaçlar.
Dinamik graph oluşturma
Kaynağın komşuluk matrisi denklemi:
\[ A_{ij}^{(t)} = \operatorname{ReLU} \left( \frac{x_i(x_j)^T}{\sqrt{d}} - \epsilon \right) \tag{2} \]
\(A_{ij}^{(t)}\): \(t\) zamanında \(i\) ve \(j\) düğümleri arasındaki bağlantı ağırlığıdır.
\(x_i\) ve \(x_j\): İlgili düğümlerin feature vector'leridir.
\(d\): Feature boyutuyla ilişkili ölçekleme terimidir.
\(\epsilon\): Zayıf bağlantıları budamak için kullanılan eşiktir.
ReLU: Eşik çıkarıldıktan sonra negatif değerleri sıfıra indirerek zayıf ilişkilerin adjacency matrix'te bağlantıya dönüşmesini engeller.
Denklemde feature-vector benzerliği \(\sqrt{d}\) ile ölçeklenir ve \(\epsilon\) çıkarılır. Benzerlik eşikten küçükse ReLU sonucu sıfır olur; eşikten büyükse bağlantı pozitif ağırlık kazanır.
Kaynak, adjacency matrix'in \(K\) boyutlu sliding temporal window içinde hesaplandığını belirtmekte, fakat \(K\)'nın sayısal değerini raporlamamaktadır.
Yoğun bütün-düğüm karşılaştırmasının teorik maliyeti:
\[ O(N^2) \]
olarak verilirken sparse pruning sonrasında pratik karmaşıklığın:
\[ O(N\cdot deg_{avg}) \]
düzeyine indirildiği belirtilmektedir. Burada \(N\) düğüm sayısını, \(deg_{avg}\) ortalama node degree değerini temsil eder.
Kaynak yöntem bölümünde \(\epsilon\)'ı “learnable threshold” olarak tanımlar. Daha sonraki sensitivity analysis ise \(\epsilon=0.5\)'i seçilmiş operating point olarak sunar. Yayımlanmış metin bu iki tanımı ayrıca uzlaştırmadığından Verianla bunlardan birini diğerinin yerine geçirmemektedir.
Eşik duyarlılığı
| Eşik koşulu | Kaynak sonucu | Yorum |
|---|---|---|
| \(\epsilon \in [0.4,0.6]\) | F1 > %91 | Model yüksek F1 düzeyini korur. |
| Daha düşük eşikler | Kesin sayı verilmemiştir. | Kaynak daha fazla gürültülü bağlantı oluştuğunu belirtir. |
| \(\epsilon > 0.7\) | F1 yaklaşık %86,5 | Graph fragmentation oluştuğu belirtilir. |
| Seçilen değer | \(\epsilon=0.5\) | Gürültü filtreleme ile structural integrity arasında kaynak tarafından en uygun denge olarak seçilmiştir. |
Transformer self-attention ne yapıyor?
Zamansal encoder'ın temel attention denklemi:
\[ Attention(Q,K,V) = softmax \left( \frac{QK^T}{\sqrt{d_k}} \right)V \tag{3} \]
\(Q\): Query matrisi.
\(K\): Key matrisi.
\(V\): Value matrisi.
\(d_k\): Key vector boyutudur.
\(QK^T\) farklı zaman/düğüm temsilleri arasındaki ilişki skorlarını üretir. \(\sqrt{d_k}\) ile ölçekleme büyük iç çarpımların softmax'ı aşırı keskinleştirmesini sınırlamak için kullanılır. Softmax sonuçları attention weights olur ve bu ağırlıklar \(V\) üzerinde uygulanır.
Çalışmada sekiz attention head kullanan altı katmanlı Transformer bulunmaktadır. Hidden dimension 512'dir. Multi-head yapı, modelin farklı representation alt uzaylarında farklı ilişkileri aynı anda incelemesini amaçlar.
Graph convolution ne yapıyor?
Spatial encoder için kaynak şu denklemi verir:
\[ h_i' = \sigma \left( \sum_{j\in\mathcal{N}(i)} \frac{1}{c_{ij}} W h_j \right) \tag{4} \]
\(h_i'\): \(i\) düğümünün güncellenmiş representation'ıdır.
\(\mathcal{N}(i)\): \(i\) düğümünün komşuluk kümesidir.
\(h_j\): Komşu düğüm \(j\)'nin mevcut representation'ıdır.
\(W\): Öğrenilebilir dönüşüm matrisidir.
\(c_{ij}\): Kaynak denklemindeki normalization terimidir; makale bunun ayrıntılı tanımını ayrıca vermemektedir.
\(\sigma\): Nonlinear activation fonksiyonudur.
Bu işlem, bir düğümün representation'ını yalnız kendi bilgisiyle değil, dinamik graph üzerindeki komşularının bilgileriyle de günceller.
Federated Differential Privacy Bu Çerçevede Nasıl Koruma Sağlıyor?
Federated differential privacy, ham ağ trafiğini merkezi sunucuya taşımadan her cihazın modeli yerel verisi üzerinde güncellemesine, yalnız model güncellemelerinin aggregation için paylaşılmasına ve gradient clipping ile Gaussian noise kullanılarak tek bir training sample'ın model güncellemesine olan etkisinin sınırlandırılmasına dayanır; kaynakta \(\sigma=0.1\), yaklaşık \(\epsilon=2.4\) ve \(\delta=10^{-5}\) değerleri raporlanmıştır.
Feature decoupling
Kaynak yerel gradient'i iki bileşen olarak ele almaktadır:
- Structural component: \(\nabla_{\theta}^{str}\), graph/topology bilgisini taşıyan bileşen.
- Task component: \(\nabla_{\theta}^{tsk}\), classification göreviyle ilgili bileşen.
Yazarlar structural bileşene daha büyük bir clipping threshold uygulanmasının önemli topological features'ı korumaya, task bileşeninde daha sıkı clipping uygulanmasının ise privacy korumasına yardımcı olduğunu belirtmektedir. Kaynak bu iki threshold'un kesin sayısal değerlerini vermemektedir.
Denklem 5: Yerel model güncellemesi
\[ \theta_i = \theta_i - \eta\nabla_{\theta}\mathcal{L}(\theta_i) \tag{5} \]
\(\theta_i\): \(i\). cihazın yerel model parametreleridir.
\(\eta\): Learning rate'tir.
\(\nabla_{\theta}\mathcal{L}(\theta_i)\): Yerel loss'un parametrelere göre gradient'idir.
Her cihaz kendi lokal training data'sından gradient hesaplayıp kendi modelini günceller.
Denklem 6: Global model aggregation
\[ \theta_{global} = \frac{1}{N} \sum_{i=1}^{N} \theta_i \tag{6} \]
Kaynak merkezi sunucuda local model parameters'ın basit aritmetik ortalamasını göstermektedir. \(N\) aggregation'a katılan device/client sayısını temsil eder.
Kaynak, client sample sayısına göre ayrı ağırlıklı bir aggregation formülünü Denklem 6'da vermemektedir.
Denklem 7: Noise injection
\[ \theta_i^{priv} = \theta_i + \mathcal{N}(0,\sigma^2) \tag{7} \]
Bu ifade local update'e sıfır ortalamalı Gaussian noise eklenmesini gösterir. Kaynak bu denklemin çevresindeki açıklamada adaptive clipping'den de söz etmektedir; clipping'in daha ayrıntılı matematiksel biçimi daha sonra Denklem 12'de verilmektedir.
DP-SGD clipping adımı
Kaynak gradient normunu \(C\) threshold'u ile sınırlar:
\[ \hat{g}_t = \frac{g_t} {\max\left(1,\frac{\lVert g_t\rVert_2}{C}\right)} \]
Eğer \(\lVert g_t\rVert_2\leq C\) ise paydadaki maksimum 1 olur ve gradient değişmez. Gradient normu \(C\)'yi aşarsa gradient aynı yönde tutulup büyüklüğü sınırlandırılır.
Denklem 12: Clipping sonrası noisy parameter update
\[ \theta_{t+1} = \theta_t - \eta\cdot Adam \left( \hat{g}_t+ \mathcal{N}(0,\sigma^2 C^2 I) \right) \tag{12} \]
Kaynak deney ayarlarında:
- \(\eta=1\times10^{-4}\),
- \(\sigma=0.1\),
- \(\epsilon\approx2.4\),
- \(\delta=10^{-5}\),
- privacy-accounting horizon = 100 training epoch
değerlerini verir.
\(\epsilon\) ve \(\delta\) differential privacy parametreleridir. Genel yorumda daha küçük privacy budget daha güçlü gizlilik anlamına gelebilir; ancak bu çalışmada performans/gizlilik değerlendirmesi yalnız kaynakta verilen koşullar bağlamında ele alınmalıdır.
Abstract'ta membership inference saldırılarının aynı privacy budget altında daha düşük başarı oranına ulaştığı ifade edilir. Buna karşın ana sonuç bölümünde membership-inference success rate için ayrı sayısal tablo veya test ayrıntısı verilmediğinden bu iddia nicel olarak genişletilemez.
Gradient compression
Abstract, discussion ve efficiency değerlendirmesi federated gradient compression stratejilerinden söz etmektedir. Bununla birlikte yayımlanmış yöntem metni compression operator'ının biçimini, compression ratio'sunu veya kullanılan quantization/sparsification algoritmasını ayrı bir denklemle raporlamamaktadır. Bu nedenle gradient compression'ın exact implementation'ı kaynakta ayrıntılı olarak yeniden üretilebilir durumda değildir.
Saldırı tespitinden savunma kararına geçiş
Çalışmada network state \(s\), mevcut zaman penceresinden çıkarılan trafik hızları, protocol distributions ve anomaly scores gibi göstergeleri içerir. Spatio-temporal Transformer bu state representation'ını üretir ve reinforcement-learning agent savunma eylemi seçer.
Denklem 8: Q-learning güncellemesi
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+ \gamma \max_{a'}Q(s',a') - Q(s,a) \right] \tag{8} \]
\(s\): Mevcut network state.
\(a\): Seçilen defense action.
\(r\): Eylem sonrası reward.
\(s'\): Sonraki network state.
\(\alpha\): Q-learning update katsayısıdır; kaynak bu denklem için sayısal \(\alpha\) değeri vermemektedir.
\(\gamma\): Gelecekteki reward'ların bugünkü değerini belirleyen discount factor'dır. DQN loss bölümünde kaynak \(\gamma=0.9\) kullanmaktadır.
Reward fonksiyonu
\[ r= w_1\cdot \mathbf{1}(\mathrm{Correct\ Response}) - \left( w_2 L+w_3F \right) \]
\(\mathbf{1}(\mathrm{Correct\ Response})\): Başarılı saldırı engelleme durumunu gösteren indicator'dır.
\(L\): Response latency'dir.
\(F\): False-positive cost'tur.
\(w_1,w_2,w_3\): Security requirement'a göre ayarlanan hiperparametrelerdir. Kaynak bu ağırlıkların sayısal değerlerini raporlamamaktadır.
Bu reward yapısı yalnız saldırıyı engelleme başarısını ödüllendirmez; yüksek response latency ve false-positive maliyetini de ceza olarak hesaba katar.
Global multi-objective loss
\[ \mathcal{L}(\theta) = \mathcal{L}_{CE}(\theta) + \lambda_{Defense} \mathcal{L}_{Defense}(\theta) + \lambda_{reg} \mathcal{L}_{reg}(\theta) \tag{9} \]
Kaynak:
\[ \lambda_{Defense}=0.5 \]
ve
\[ \lambda_{reg}=1\times10^{-4} \]
değerlerini kullanmaktadır.
\(\mathcal{L}_{CE}\) attack-detection classification error'ını, \(\mathcal{L}_{Defense}\) reinforcement-learning defense loss'unu, \(\mathcal{L}_{reg}\) ise overfitting'i sınırlayan regularization terimini temsil eder.
Denklem 10: Binary cross-entropy
\[ \mathcal{L}_{CE}(\theta) = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log(\hat{y}_i) + (1-y_i)\log(1-\hat{y}_i) \right] \tag{10} \]
\(y_i\in\{0,1\}\) gerçek etiketi, \(\hat{y}_i\) modelin saldırı olasılığını, \(N\) batch size'ı temsil eder.
Gerçek saldırıya düşük attack probability veya gerçek normal örneğe yüksek attack probability verildiğinde loss artar.
Denklem 11: DQN Temporal Difference loss
\[ \mathcal{L}_{Defense}(\theta) = \mathbb{E}_{(s,a,r,s')} \left[ \left( r+ \gamma \max_{a'} Q(s',a';\theta^-) - Q(s,a;\theta) \right)^2 \right] \tag{11} \]
\(\theta\): Current Q-network parametreleridir.
\(\theta^-\): Belirli aralıklarla dondurulan target network parametreleridir.
\(\gamma=0.9\): Discount factor.
Loss, mevcut Q-value ile Bellman target arasındaki Temporal Difference hatasının karesini küçültmeyi amaçlar.
Çalışmanın Yöntemi ve Bulguları
Veri setleri ve preprocessing
| Veri seti | Bağlam | Feature boyutu | Table 1 train / validation / test | Preprocessing |
|---|---|---|---|---|
| UNSW-NB15 | Genel network-attack detection; kaynak 9 attack type içerdiğini belirtir. | d = 42 | 50k / 5k / 10k | Standardization |
| BoT-IoT | IoT/IIoT ağ trafiği; DDoS, DoS, scanning ve başka attack types | d = 10 core network feature | 100k / 10k / 20k | Min-Max normalization |
Kaynak model görevini normal/saldırı şeklinde binary classification olarak tanımlar. Dolayısıyla veri setlerinde birden fazla saldırı ailesi bulunsa da ana objective ve Denklem 10 binary label yapısı kullanmaktadır.
UNSW-NB15 için yöntem metni ayrıca training/validation/testing oranını sırasıyla %50/%10/%40 olarak ifade etmektedir. Fakat Table 1'de verilen 50k/5k/10k sayıları bu yüzdelerle uyuşmamaktadır. Verianla bu iki farklı kaynak ifadesinden birini sessizce düzeltmemektedir.
Table 1'in “Source / Acquisition Method” sütununda UNSW-NB15 ve BoT-IoT satırlarında aynı BoT-IoT proje adresinin göründüğü de kaynak tablosunun kendi sunum özelliğidir. Verianla bunu UNSW-NB15'in gerçek kaynak adresi gibi yeniden üretmemektedir.
Manuel feature selection kullanıldı mı?
Hayır. Kaynak, her iki veri kümesinin spatio-temporal encoder'a verilmesinden önce ek manuel feature selection uygulanmadığını belirtmektedir. Amaç, modelin end-to-end feature extraction kapasitesini değerlendirmektir.
Model ve donanım
| Öğe | Kaynak değeri |
|---|---|
| GPU | NVIDIA GeForce RTX 3080, 10 GB VRAM |
| Framework | PyTorch 1.10 |
| CUDA | 11.2 |
| Transformer katmanı | 6 |
| Hidden dimension | 512 |
| Attention head | 8 |
| Optimizer | Adam |
| Initial learning rate | \(1\times10^{-4}\) |
| \(\lambda_{Defense}\) | 0.5 |
| \(\lambda_{reg}\) | \(1\times10^{-4}\) |
| DP noise multiplier | \(\sigma=0.1\) |
| Random seed | 42 |
Experimental Setup bölümü robustness testing için Gaussian noise standard deviation değerini 0.05 olarak verir. Daha sonraki robustness validation ise noise standard deviation'ı 0'dan 0.2'ye kadar artıran daha geniş bir sweep raporlar.
Tekrar sayısındaki kaynak-içi fark
Experimental Setup sonunda kaynak “results are reported as the mean ± standard deviation over 5 runs” ifadesini kullanır. Quantitative Results bölümünde ise “all experiments were repeated 10 times” denir. Table 4 başlığı da açıkça n=10 belirtir.
Bu nedenle tekrar sayısını bütün deneyler için tek bir kesin sayı olarak yeniden yazmak güvenli değildir. Table 3–4'te görünen mean ± standard deviation değerleri kaynakta yayımlandığı biçimde korunmuştur.
Değerlendirme metrikleri
Kaynak Accuracy, Precision, Recall ve F1-Score kullanmaktadır:
\[ Accuracy= \frac{TP+TN} {TP+TN+FP+FN} \]
\[ Precision= \frac{TP}{TP+FP} \]
\[ Recall= \frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
TP doğru saldırı tespitlerini, TN doğru normal trafik kararlarını, FP normal trafik için yanlış saldırı alarmını, FN ise kaçırılan gerçek saldırıları temsil eder.
Baseline yöntemleri
- LSTM-IDS: Zamansal dependency'leri modelleyen recurrent baseline.
- FedIDS: Federated-learning tabanlı intrusion-detection baseline.
- DP-GNN: Differential privacy ile graph convolution'ı birleştiren privacy-preserving baseline.
- RustGraph: Dynamic graph anomaly detection için structural-temporal dependency modelleyen baseline.
Ana performans karşılaştırması
| Yöntem | Veri seti | Accuracy | FPR | F1 | Training Time | p-value |
|---|---|---|---|---|---|---|
| LSTM-IDS | UNSW-NB15 | 87.2% ± 0.6% | 5.2% ± 0.3% | 86.4% ± 0.5% | 1200 ± 120 s | <0.001 |
| LSTM-IDS | BoT-IoT | 84.5% ± 0.8% | 6.8% ± 0.4% | 83.9% ± 0.7% | 1500 ± 150 s | <0.001 |
| FedIDS | UNSW-NB15 | 89.5% ± 0.5% | 3.8% ± 0.2% | 88.7% ± 0.6% | 1300 ± 130 s | 0.002 |
| FedIDS | BoT-IoT | 87.0% ± 0.7% | 4.5% ± 0.3% | 86.2% ± 0.8% | 1600 ± 160 s | 0.001 |
| DP-GNN | UNSW-NB15 | 90.3% ± 0.4% | 3.1% ± 0.2% | 89.5% ± 0.5% | 1400 ± 140 s | 0.005 |
| DP-GNN | BoT-IoT | 88.5% ± 0.6% | 3.9% ± 0.3% | 87.8% ± 0.7% | 1700 ± 170 s | 0.003 |
| RustGraph | UNSW-NB15 | 91.2% ± 0.3% | 2.4% ± 0.1% | 90.5% ± 0.4% | 1500 ± 150 s | 0.01 |
| RustGraph | BoT-IoT | 90.0% ± 0.5% | 3.0% ± 0.2% | 89.2% ± 0.6% | 1800 ± 180 s | 0.008 |
| Proposed Method | UNSW-NB15 | 93.5% ± 0.2% | 1.2% ± 0.1% | 92.8% ± 0.3% | 1100 ± 110 s | — |
| Proposed Method | BoT-IoT | 92.0% ± 0.4% | 1.8% ± 0.2% | 91.3% ± 0.5% | 1400 ± 140 s | — |
Proposed Method iki veri setinde de kaynak tablosundaki en yüksek accuracy ve F1 değerlerini, aynı zamanda en düşük FPR değerlerini üretmektedir.
BoT-IoT'ta proposed accuracy %92,0, DP-GNN accuracy %88,5 olduğundan fark:
\[ 92.0-88.5=3.5 \]
3,5 yüzde puanıdır. Bu ifade relative percentage increase değil, iki accuracy yüzdesi arasındaki mutlak percentage-point farkıdır.
Table 3 p-value sütununda baseline'lar için değerler verilmektedir ve significance level 0.05 olarak belirtilmektedir. Ancak kaynak kullanılan exact statistical test'in adını ve p-value sütunundaki exact null hypothesis'i ayrıntılı biçimde raporlamamaktadır. Bu nedenle p-değerlerinin hangi testten üretildiği Verianla tarafından tahmin edilmemiştir.
Convergence sonucu
Kaynak Figure 5'te proposed method'in UNSW-NB15 üzerinde yaklaşık 80. epoch'ta %90 accuracy düzeyine ulaştığını, RustGraph'ın benzer seviyeye ulaşmasının 92 epoch'tan fazla sürdüğünü belirtmektedir.
Kaynak bu daha hızlı convergence davranışını adaptive graph structure ve spatio-temporal attention'ın redundant connections üzerinden gradient propagation'ı azaltmasıyla ilişkilendirmektedir. Bu mekanizma yorumu yazarların açıklamasıdır.
Efficiency sonuçları
| Yöntem | Parametre (M) | FLOPs (G) | Training Time (s/epoch) | Inference Latency (ms/sample) |
|---|---|---|---|---|
| LSTM-IDS | 2.1 ± 0.0 | 4.8 ± 0.1 | 15.0 ± 0.8 | 1.2 ± 0.1 |
| FedIDS | 3.4 ± 0.1 | 7.2 ± 0.3 | 16.3 ± 0.9 | 1.8 ± 0.2 |
| DP-GNN | 5.7 ± 0.2 | 12.5 ± 0.5 | 17.5 ± 1.0 | 2.5 ± 0.3 |
| RustGraph | 6.9 ± 0.3 | 15.0 ± 0.6 | 18.8 ± 1.1 | 3.0 ± 0.2 |
| Proposed Method | 7.2 ± 0.2 | 14.8 ± 0.5 | 13.8 ± 0.7 | 2.1 ± 0.2 |
Proposed Method parametre sayısı açısından en büyük modeldir: 7,2 milyon parametre. Buna rağmen RustGraph'ın 18,8 s/epoch training time'ına karşı 13,8 s/epoch ve 3,0 ms/sample inference latency'sine karşı 2,1 ms/sample üretmektedir.
Kaynak RustGraph'a göre training time'ın yaklaşık %26,6, inference latency'nin %30 düşük olduğunu belirtir. GNN tabanlı baseline hidden dimensions'ın benzer parameter scale sağlayacak biçimde standardize edildiği de raporlanmaktadır.
2,1 ms Inference Gecikmesi Gerçek Zamanlı Saha Başarısını Kanıtlar mı?
Hayır. Kaynak 2,1 ± 0,2 ms/sample değerinin dynamic graph construction, feature extraction ve Transformer forward pass'i kapsayan kendi deneysel uçtan uca inference ölçümü olduğunu ve yaklaşık 500 traffic sample/s işlem kapasitesine karşılık geldiğini belirtmektedir; ancak ölçüm RTX 3080 GPU üzerinde benchmark verileriyle yapılmıştır ve gerçek edge cihazı, V2X aracı veya üretim ağı üzerinde uzun dönem saha deployment'ı değildir.
Matematiksel olarak:
\[ \frac{1}{0.0021\;s} \approx476\;sample/s \]
olur. Kaynağın “nearly 500 traffic samples per second” ifadesi bu yaklaşık değere karşılık gelir.
Ancak kaynak discussion bölümünde adaptive graph construction'ın ciddi biçimde resource-constrained micro-IoT node'larda ek computation overhead oluşturduğunu ve optimizasyon gerektiğini açıkça kabul etmektedir.
Başarılı nitel örnek
Kaynak “UNSW-NB15 – DoS Hulk” etiketiyle verdiği örnekte 28–32. saniyeler arasındaki attack window'da hedef host'a yeni bağlantı sayısının baseline ortalaması 24,3 connection/s düzeyinden 3872 connection/s peak değerine yükseldiğini bildirmektedir.
Normal fluctuation aralığı yaklaşık ±2σ ≈ 60 olarak verilmiştir. Proposed Method saldırıyı %96,7 confidence ile DoS olarak sınıflandırmıştır.
t=30 s anında attention ağırlıkları:
| Feature | Attention weight |
|---|---|
| Connection burstiness | 0.42 |
| Destination port diversity | 0.38 |
LSTM-IDS aynı örneği %58,1 confidence ile normal trafik olarak yanlış sınıflandırmıştır.
Kaynak adlandırma notu: Makale bu vakayı açıkça “UNSW-NB15 – DoS Hulk Attack Detection” olarak adlandırmaktadır. Yayımlanmış metin bu saldırı adlandırmasının veri seti taksonomisiyle ilişkisini ayrıca açıklamamaktadır. Verianla kaynak etiketini değiştirmemekte ve eksik açıklamayı uydurmamaktadır.
Ultra-Düşük Frekanslı Taramada Model Neden Başarısız Oldu?
Kaynakta verilen düşük hızlı port-scan örneğinde saldırı sinyali normal IoT heartbeat trafiğine çok yakın olduğu, federated clients yalnız sınırlı yerel görünüm gördüğü ve \(\sigma=0.1\) differential-privacy noise zayıf anomaly gradient'lerini bastırdığı için dynamic graph anlamlı anomaly edge'leri oluşturamamış ve model saldırıyı normal trafik olarak sınıflandırmıştır.
| Öğe | Kaynak değeri |
|---|---|
| Probe sıklığı | 6 dakikada 1 probe |
| Toplam gözlem | 30 dakika |
| Toplam probe | 5 |
| Saldırı packet rate | 0.8 pkt/s |
| Normal IoT heartbeat aralığı | 0.7–1.1 pkt/s |
| Adjacency matrix sparsity | 99.6% |
| Model kararı | Normal registration behavior |
| Confidence | 62.3% |
| DP noise | \(\sigma=0.1\) |
Kaynak gelecekte cross-device meta-event correlations veya unsupervised anomaly priors gibi mekanizmaların bu information-scarcity problemine yardımcı olabileceğini önermektedir. Bunlar mevcut deneyde doğrulanmış sonuçlar değildir.
Noise robustness
Input feature'lara Gaussian noise eklendiğinde standard deviation 0'dan 0.2'ye çıkarılmıştır. Proposed Method accuracy değeri %93,5'ten %89,3'e düşerken RustGraph %83,2, DP-GNN %84,6 seviyesine gerilemiştir.
| Yöntem | Başlangıç / referans | Noise std = 0.2 koşulundaki sonuç |
|---|---|---|
| Proposed Method | 93.5% accuracy | 89.3% accuracy |
| RustGraph | Kaynak bu cümlede başlangıç değerini tekrar vermemektedir. | 83.2% accuracy |
| DP-GNN | Kaynak bu cümlede başlangıç değerini tekrar vermemektedir. | 84.6% accuracy |
Kaynak Figure 7 eğrisinin bütün ara numeric noktalarını tablo olarak vermediği için Verianla ara değer interpolasyonu yapmamaktadır.
Kaynak ayrıca “spatial attention module” kaldırıldığında accuracy'nin %83,5'e düştüğünü belirtir. Bu ifade Table 5'teki modül isimlendirmesinden ayrı bir robustness açıklaması içinde geçmektedir.
Cross-Dataset Doğrudan Transfer Nasıl Test Edildi?
Cross-dataset generalization deneyi, proposed modelin UNSW-NB15 üzerinde eğitilip BoT-IoT üzerinde herhangi bir fine-tuning yapılmadan doğrudan test edilmesiyle gerçekleştirilmiştir; kaynak proposed modelin her iki tarafta F1 değerini %91'in üzerinde tuttuğunu ve hedef BoT-IoT'ta RustGraph'ı 2,1 yüzde puanı geçtiğini raporlamaktadır.
Bu deney standart aynı-dataset train/test değerlendirmesinden daha güçlü bir distribution-shift sınamasıdır, çünkü model hedef veri setine yeniden ayarlanmamıştır.
Kaynak hedef BoT-IoT'ta hybrid DDoS gibi unseen attack variants bulunduğunu belirtir. Proposed Method'in dynamic graph structure ve local-global federated modeling kombinasyonunun bu distribution shift'e uyum sağlamada rol oynadığı yazarlar tarafından ileri sürülmektedir.
Ancak cross-dataset sonucu gerçek dünyadaki her ağ ortamına evrensel generalization kanıtı değildir. Yalnız kaynakta test edilen UNSW-NB15 → BoT-IoT transfer koşulunu destekler.
Ablasyon analizi
| Model varyantı | UNSW-NB15 | BoT-IoT |
|---|---|---|
| Full Model | 93.5 / 92.8 | 92.0 / 91.3 |
| Adaptive Spatio-Temporal Graph Generation kaldırıldı | 90.1 / 89.4 | 88.7 / 87.9 |
| Federated Differential Privacy kaldırıldı; Centralized Training | 92.8 / 92.0 | 91.2 / 90.5 |
| Reinforcement Learning Dynamic Defense Module kaldırıldı | 93.2 / 92.5 | 91.7 / 91.0 |
| Spatio-Temporal Transformer yerine GCN+LSTM | 89.6 / 88.7 | 87.4 / 86.5 |
| Base GNN Only | 87.3 / 86.1 | 84.9 / 83.8 |
BoT-IoT F1 açısından full model %91,3'tür. Adaptive graph kaldırıldığında %87,9'a düşerek 3,4 percentage-point kayıp oluşur. Spatio-temporal Transformer GCN+LSTM ile değiştirildiğinde %86,5'e düşer; kayıp 4,8 percentage point'tir.
Federated differential privacy mekanizması centralized training ile değiştirildiğinde BoT-IoT F1 %91,3'ten %90,5'e iner; fark 0,8 percentage point'tir.
RL dynamic-defense module kaldırıldığında BoT-IoT F1 yalnız %91,3'ten %91,0'a iner. Kaynak bu küçük classification farkını beklenen sonuç olarak yorumlar çünkü reinforcement-learning katmanının temel işi classification değil, saldırı sonrası response strategy seçmektir.
Base GNN Only yapı BoT-IoT'ta %83,8 F1 ile en zayıf varyanttır. Bu sonuç kaynakta graph representation'ın tek başına yeterli olmadığını ve spatio-temporal attention'ın önemli katkısını destekleyen ablation bulgusu olarak yorumlanmaktadır.
Privacy–utility trade-off
Ablasyon, federated differential privacy mekanizmasının kaldırılmasının accuracy/F1 üzerinde diğer merkezi mimari bileşenleri kadar büyük bir fark oluşturmadığını gösterir. Kaynak bunu privacy protection'ın daha düşük utility kaybıyla uygulanabildiğinin kanıtı olarak yorumlamaktadır.
Ancak privacy mekanizması için membership-inference success rate ana sonuç tablolarında nicel olarak verilmediği için privacy–utility değerlendirmesi esas olarak differential-privacy parametreleri, detection metrics ve ablation sonuçları üzerinden izlenebilir durumdadır.
Çalışmanın desteklediği sonuçlar
- Adaptif spatio-temporal graph ve Transformer kombinasyonu iki kullanılan benchmark'ta baseline'lardan daha yüksek accuracy ve F1 üretmiştir.
- Proposed Method UNSW-NB15'te %93,5 ± %0,2 accuracy ve %92,8 ± %0,3 F1 elde etmiştir.
- Proposed Method BoT-IoT'ta %92,0 ± %0,4 accuracy ve %91,3 ± %0,5 F1 elde etmiştir.
- BoT-IoT'ta proposed accuracy DP-GNN'den 3,5 percentage point yüksektir.
- FPR UNSW-NB15'te %1,2 ± %0,1, BoT-IoT'ta %1,8 ± %0,2 olarak raporlanmıştır.
- UNSW-NB15 → BoT-IoT direct-transfer deneyi fine-tuning olmadan yapılmıştır.
- Adaptive graph ve Transformer ablasyonları model performansında en büyük düşüşleri oluşturmuştur.
- Federated differential privacy mekanizmasını centralized training ile değiştirmek full model'e göre %1'in altında F1 farkı oluşturmuştur.
- RTX 3080 deney ortamında end-to-end inference latency 2,1 ± 0,2 ms/sample olarak ölçülmüştür.
- Input noise std 0,2'ye kadar artırıldığında proposed accuracy %89,3'e gerilemiş fakat kaynakta karşılaştırılan baselines'dan daha yüksek kalmıştır.
- Ultra-low-frequency scanning örneği modelin önemli bir başarısızlık sınırını göstermektedir.
Çalışmanın desteklemediği veya eksik bıraktığı sonuçlar
- Gerçek V2X araç ağı veya ticari IoT deployment'ında uzun dönem saha performansı gösterilmemiştir.
- 2,1 ms sonucu bütün micro-IoT donanımlarında aynı latency'nin elde edileceğini garanti etmez.
- UNSW-NB15 → BoT-IoT transfer sonucu her bilinmeyen ağ veri alanında aynı generalization'ın oluşacağını kanıtlamaz.
- Ultra-low-frequency stealth attacks çözülmüş değildir.
- Membership inference saldırılarının başarı oranındaki azalma abstract'ta bildirilmiş olsa da ana gövdede nicel değer ve ayrıntılı protokol verilmemektedir.
- Gradient-compression algoritmasının exact implementation'ı, compression ratio'su ve operator ayrıntıları raporlanmamaktadır.
- Sliding temporal window size \(K\)'nın sayısal değeri raporlanmamaktadır.
- Structural ve task gradient clipping threshold değerleri ayrı ayrı raporlanmamaktadır.
- Reward weights \(w_1,w_2,w_3\) sayısal olarak verilmemektedir.
- Table 3'teki p-value'ları üreten statistical test'in exact adı raporlanmamaktadır.
- Kaynakta 5 run ile 10 repeat ifadeleri arasında tutarsızlık vardır.
- UNSW-NB15 için yazılan %50/%10/%40 oranı Table 1'deki 50k/5k/10k sayılarıyla uyuşmamaktadır.
Sınırlılıklar ve gelecek çalışma
Kaynak en belirgin sınırlılığın extremely low-frequency stealth attacks olduğunu belirtmektedir. Federated learning client'larının sınırlı local views'a sahip olması ve differential-privacy noise'un düşük-amplitude anomaly gradients'i bastırması özellikle seyrek saldırılarda detection'ı zorlaştırmaktadır.
Adaptive graph construction'ın 2,1 ms overall latency içinde çalışmasına rağmen severely resource-constrained micro-IoT node'larda ek energy/computation overhead oluşturabileceği belirtilmektedir.
Önerilen gelecek çalışmalar arasında client'lar arasında lightweight meta-event summary paylaşımı, Secure Multi-Party Computation veya highly aggregated statistics kullanımı, event-driven sparse graph updates, fully unsupervised veya open-set anomaly detection ve micro-embedded devices için graph-construction optimizasyonu bulunmaktadır.
Kaynak ve Yöntem Notu
Özgün başlık: A Spatio-Temporal Transformer-Based Approach for Network Attack Detection
Yazarlar ve sıra: Xin Liu; Xiang Liu.
Corresponding author: Xin Liu; kaynakta yıldız işaretiyle belirtilmiştir.
Xin Liu kurumu: School of Advanced Engineering, University of Science and Technology Beijing, Beijing 100083, China.
Xin Liu e-posta: u202341641@xs.ustb.edu.cn
Xiang Liu kurumu: School of International Education, Beijing University of Chemical Technology, Beijing 102203, China.
Xiang Liu e-posta: 2024090034@mail.buct.edu.cn
Eşit katkı / eş birinci yazarlık: Kaynakta eşit katkı beyanı bulunmamaktadır.
Dergi: Journal of Universal Computer Science.
Kısaltma: J.UCS.
Cilt / sayı: Volume 32, Number 9.
Sayfalar: 1375–1398.
Yayın yılı: 2026.
Submitted: 23 Ocak 2026.
Accepted: 7 Temmuz 2026.
Appeared / Published: 14 Eylül 2026.
DOI: 10.3897/jucs.207303.
Resmî DOI bağlantısı: https://doi.org/10.3897/jucs.207303
Kaynak türü: Yayımlanmış özgün araştırma makalesi.
Hakemlik durumu: Journal of Universal Computer Science hakemli bir dergidir; derginin güncel resmî profilinde single-blind review ve en az iki editorial-board reviewer belirtmektedir.
Makale lisansı: CC BY 4.0; makale PDF'sinin ilk sayfasında açıkça belirtilmiştir.
Ana problem: Dynamic network topology altında yüksek accuracy, privacy preservation ve düşük-latency attack detection/response hedeflerini aynı framework içinde ele almak.
Görev formülasyonu: Binary classification; \(y=0\) normal, \(y=1\) malicious traffic.
Ana üç modül: Spatio-temporal feature extraction; federated differential-privacy protection; reinforcement-learning attack detection/defense.
Dynamic graph: Communication relationships ve traffic-feature similarity temelinde time-dependent adjacency matrix.
Graph threshold: Yöntem bölümünde learnable \(\epsilon\); sensitivity analysis seçilmiş değer olarak \(\epsilon=0.5\) raporlamaktadır.
Threshold sensitivity: \(\epsilon\in[0.4,0.6]\) için F1 > %91; \(\epsilon>0.7\) için F1 yaklaşık %86,5.
Transformer: 6 layer, hidden dimension 512, 8-head multi-head attention.
Federated aggregation: Kaynak Denklem 6'da local model parameters'ın basit ortalaması.
Differential privacy: DP-SGD, gradient clipping ve Gaussian noise.
DP noise multiplier: \(\sigma=0.1\).
Privacy budget: Yaklaşık \(\epsilon=2.4\), \(\delta=10^{-5}\), 100 epoch sonunda kaynakta raporlanan koşul.
Feature decoupling: Structural gradient ve task gradient bileşenlerine ayrım; kesin clipping threshold sayıları raporlanmamaktadır.
Gradient compression: Kaynak tarafından bileşen olarak belirtilmektedir; exact compression algorithm ve oran raporlanmamaktadır.
Reinforcement learning: Q-learning / Deep Q-Network.
DQN discount factor: \(\gamma=0.9\).
Defense actions: Kaynak örnek olarak traffic limiting ve data filtering verir.
Reward: Correct response ödülü ile latency ve false-positive cost cezasını birleştirir; \(w_1,w_2,w_3\) değerleri raporlanmaz.
Global loss: Binary cross-entropy + defense TD loss + regularization.
\(\lambda_{Defense}\): 0.5.
\(\lambda_{reg}\): \(1\times10^{-4}\).
Optimizer: Adam.
Initial learning rate: \(1\times10^{-4}\).
UNSW-NB15 features: d = 42, ID ve labels hariç.
BoT-IoT features: d = 10 core network features.
UNSW preprocessing: Standardization.
BoT-IoT preprocessing: Min-Max normalization.
Manual feature selection: Kullanılmamıştır.
Table 1 sample split: UNSW-NB15 50k / 5k / 10k; BoT-IoT 100k / 10k / 20k.
Kaynak-içi partition farkı: Metin UNSW-NB15 için %50/%10/%40 oranını verir; Table 1'deki 50k/5k/10k bununla uyuşmaz.
Donanım: NVIDIA GeForce RTX 3080 GPU, 10 GB VRAM.
Yazılım: PyTorch 1.10, CUDA 11.2.
Random seed: 42.
Kaynak-içi run-count farkı: Experimental Setup 5 run mean ± std der; Quantitative Results 10 repeat der ve Table 4 n=10 belirtir.
Significance level: 0.05.
Statistical-test sınırı: Table 3 p-value verir; exact statistical-test adı ve null-hypothesis ayrıntısı ana metinde açıkça belirtilmemektedir.
UNSW-NB15 ana sonuç: Accuracy 93.5% ± 0.2%; F1 92.8% ± 0.3%; FPR 1.2% ± 0.1%.
BoT-IoT ana sonuç: Accuracy 92.0% ± 0.4%; F1 91.3% ± 0.5%; FPR 1.8% ± 0.2%.
DP-GNN karşılaştırması: BoT-IoT accuracy 88.5% ± 0.6%; proposed farkı +3.5 percentage point.
Inference latency: 2.1 ± 0.2 ms/sample.
Inference kapsamı: Dynamic graph construction + feature extraction + Transformer forward pass.
Proposed parameter count: 7.2 ± 0.2 million.
Proposed FLOPs: 14.8 ± 0.5 G.
Training time: Table 4'te 13.8 ± 0.7 s/epoch.
Cross-dataset test: UNSW-NB15 üzerinde training → BoT-IoT üzerinde fine-tuning olmadan direct testing.
Cross-dataset sonucu: Kaynak proposed F1'in iki veri setinde %91 üzerinde kaldığını ve hedef BoT-IoT'ta RustGraph'tan 2.1 percentage point yüksek olduğunu bildirir.
Noise robustness: Gaussian feature noise std 0→0.2; proposed accuracy 93.5%→89.3%.
Önemli failure case: 6 dakikada bir probe, 30 dakikada 5 probe, 0.8 pkt/s; normal heartbeat 0.7–1.1 pkt/s; adjacency sparsity 99.6%; normal prediction confidence 62.3%.
Membership inference notu: Abstract aynı privacy budget altında attack success rate'in anlamlı biçimde azaltıldığını belirtmektedir; ana metinde nicel membership-inference success rate veya ayrıntılı deney protokolü bulunmamaktadır.
Ablasyon sonucu: BoT-IoT F1 full model 91.3%; no adaptive graph 87.9%; centralized/no federated DP 90.5%; no RL defense 91.0%; GCN+LSTM replacement 86.5%; base GNN only 83.8%.
Finansman: İncelenen PDF'de ayrı bir funding declaration bölümü bulunmamaktadır.
Çıkar çatışması: İncelenen PDF'de ayrı bir conflict-of-interest declaration bulunmamaktadır.
Data Availability: İncelenen PDF'de ayrı bir Data Availability statement bulunmamaktadır; deney bölümünde UNSW-NB15 ve BoT-IoT public datasets olarak tanımlanmaktadır.
Yazar katkıları / CRediT: İncelenen PDF'de ayrı bir author-contributions veya CRediT beyanı bulunmamaktadır.
Temel çalışma sınırı: Sonuçlar benchmark veri setleri ve RTX 3080 tabanlı deney ortamına aittir; gerçek micro-IoT node, V2X fleet veya production SOC üzerinde uzun dönem saha doğrulaması değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir