


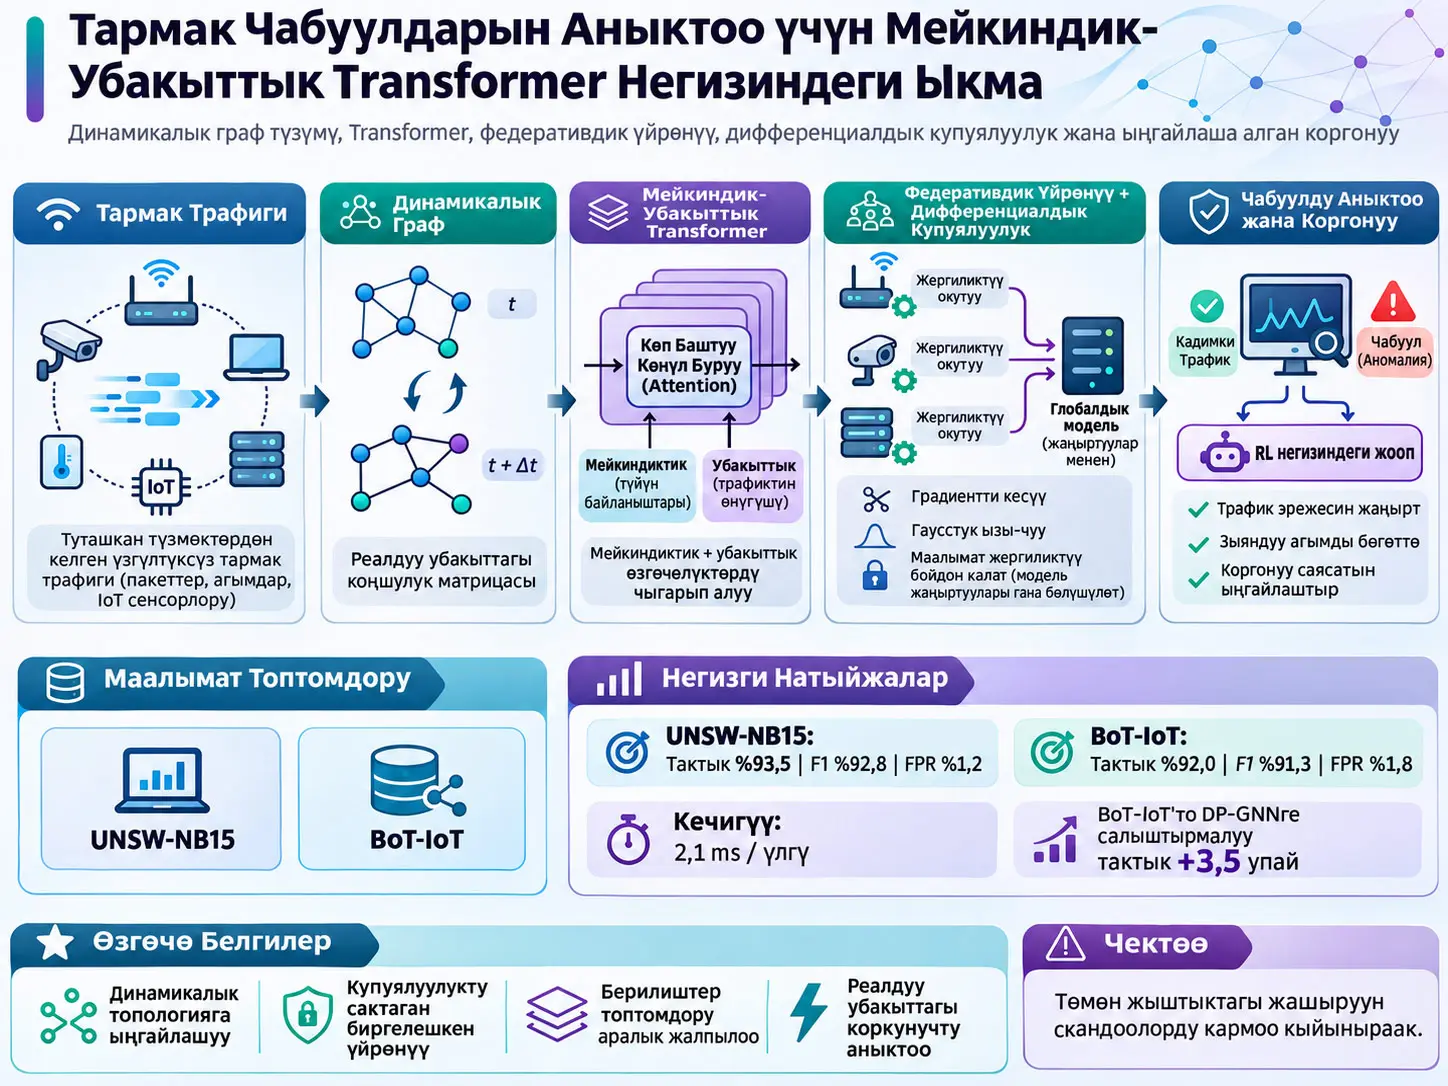
Адаптивдүү мейкиндик-убакыттык Transformer негизиндеги тармак чабуулдарын аныктоо алкагы тармак түйүндөрүнүн ортосундагы өзгөрүп туруучу байланыш мамилелерин динамикалык граф катары моделдеген, убакыттык көз карандылыктарды Transformer менен, мейкиндиктик/топологиялык көз карандылыктарды graph convolution аркылуу иштеткен, жергиликтүү маалыматты түзмөктөн чыгарбай federated learning жана differential privacy колдонгон жана чабуулдан кийин reinforcement learning аркылуу коргонуу чечимин чыгарууну көздөгөн network attack detection жана response ыкмасы. Изилдөө UNSW-NB15 жана BoT-IoT benchmark маалымат топтомдорунда бааланган; сунушталган ыкма UNSW-NB15 де %93,5 ± %0,2 accuracy жана %92,8 ± %0,3 F1, ал эми BoT-IoT то %92,0 ± %0,4 accuracy жана %91,3 ± %0,5 F1 алган. Ошол эле учурда изилдөө көзөмөлдөнгөн маалымат топтомдоруна негизделет; бул жыйынтыктар чыныгы V2X, IoT же өндүрүш тармагындагы узак мөөнөттүү талаа ийгилиги катары түшүндүрүлбөшү керек.
Алкактын биринчи компоненти учурдагы убакыт терезесиндеги тармак түйүндөрүнүн байланышуу жыштыгы жана трафик өзгөчөлүктөрүнүн окшоштугунан динамикалык кошуналык матрицасын түзөт. Алсыз байланыштар босого коюу аркылуу кесилет; мунун натыйжасында ар бир түйүн тармактын бардык түйүндөрүнө туташкан тыгыз түзүмдүн ордуна сейрек жана учурдагы байланыш мамилелерин чагылдырган граф түзүүгө аракет жасалат. Убакыттык көз карандылыктар multi-head self-attention колдонгон Transformer менен, топологиялык көз карандылыктар graph convolution аркылуу иштетилет.
Экинчи компонент federated learning менен differential privacy ни бириктирет. Жергиликтүү түзмөктөр чийки трафик маалыматын борбордук серверге жөнөтүүнүн ордуна өз моделдерин жергиликтүү түрдө жаңылайт; борбордук сервер модель параметрлерин бириктирет. Булак differential privacy учурунда gradient clipping жана Gaussian noise колдонот; эксперименттик жөндөөлөрдө noise multiplier маанисин \(\sigma=0.1\), жалпы купуялуулук бюджетин 100 epoch соңунда болжол менен \(\epsilon=2.4\) жана \(\delta=10^{-5}\) деп билдирет.
Үчүнчү компонент “чабуул бар/жок” деген чечимге гана көңүл бурбайт. Deep Q-Network негизиндеги reinforcement learning катмары трафик ылдамдыгы, протокол бөлүштүрүлүшү жана anomaly score сыяктуу көрсөткүчтөрдөн турган network state ти колдонуп, трафикти чектөө же маалыматты чыпкалоо сыяктуу коргонуу аракеттеринин арасынан тандоону максат кылат. Ablation жыйынтыктары reinforcement-learning компонентинин classification accuracy га кошкон салымы болгону болжол менен 0,3 пайыздык пункт экенин; анын негизги ролу чабуулга динамикалык жооп берүү экенин көрсөтөт.
Сунушталган ыкманын эң маанилүү натыйжалуулук утушу адаптивдүү граф түзүү жана spatio-temporal Transformer компоненттеринен келет. BoT-IoT то адаптивдүү граф түзүү алынып салынганда F1 %91,3 төн %87,9 га, Transformer GCN+LSTM менен алмаштырылганда %86,5 ке төмөндөйт. Ал эми federated differential privacy механизмин борборлоштурулган окутуу менен алмаштыруу F1 де болжол менен 0,8 пайыздык пункт айырма жаратат.
Булак ошондой эле түз cross-dataset transfer экспериментин билдирет: модель UNSW-NB15 те окутулуп, BoT-IoT то fine-tuning жүргүзүлбөстөн текшерилген. Авторлор бул шартта proposed model F1 маанисин %91 ден жогору сактап, BoT-IoT то RustGraph тан 2,1 пайыздык пункт жогору болгонун билдиришет.
Изилдөөнүн маанилүү чектөөсү ultra-low-frequency чабуулдар. Булактагы төмөн ылдамдыктагы port scan мисалында чабуулчу 30 мүнөттө болгону беш probe жараткан, пакет ылдамдыгы 0,8 packet/s деңгээлинде калган жана кадимки IoT heartbeat трафигинин 0,7–1,1 packet/s аралыгы менен чоң өлчөмдө дал келген. Модель бул үлгүнү %62,3 confidence менен кадимки жүрүм-турум катары классификациялаган. Авторлор бул ийгиликсиздикти federated learning деги чектелген жергиликтүү көрүнүш жана differential-privacy ызы-чуусунун алсыз anomaly gradient терин басышы менен байланыштырышат.
Булактын abstract бөлүмү ошол эле privacy budget шартында membership inference чабуулдарынын ийгилик деңгээли олуттуу азайганын билдирет. Бирок негизги ыкма жана жыйынтык бөлүмдөрүндө membership-inference чабуулу үчүн сандык ийгилик көрсөткүчү, өзүнчө эксперимент таблицасы же деталдуу тест протоколу берилбейт. Ошондуктан бул доомат сапаттык булак билдирүүсү катары сакталып, булакта жок сандар менен кеңейтилбеши керек.
Изилдөө маселеси эмне?
Network Attack Detection (NAD) тармак трафигиндеги кадимки жүрүм-турум менен зыяндуу жүрүм-турумду айырмалоону максат кылат. Бул изилдөө маселени математикалык түрдө binary classification катары түзөт: \(y_i=0\) кадимки трафикти, \(y_i=1\) чабуул трафигин билдирет.
Изилдөө чечүүгө аракет кылган кыйынчылык туура классификация гана эмес. IoT, Internet of Vehicles жана Vehicle-to-Everything сыяктуу чөйрөлөрдө кайсы түзмөктөр бири-бири менен байланышары убакыттын өтүшү менен өзгөрүшү мүмкүн. Ошондой эле маалыматтарды борбордук серверге жөнөтүү купуялуулук коркунучун жаратышы мүмкүн жана чабуул аныкталгандан кийин кайсы коргонуу аракети колдонулары да өзүнчө маселе.
Ошондуктан булак үч маселени бир алкакта карайт:
- Динамикалык тармак топологиясындагы мейкиндиктик жана убакыттык мамилелерди моделдөө.
- Чийки маалыматты борбордук системага көчүрбөстөн биргелешкен моделди окутуу жана differential privacy колдонуу.
- Аныктоодон кийин reinforcement learning аркылуу динамикалык коргонуу чечимин чыгаруу.
Маселенин формулировкасы
Булак тармак трафиги маалыматын \(X\), ар бир трафик үлгүсүн \(x_i\), экилик класс энбелгисин болсо \(y_i\) менен көрсөтөт. Окутуу жана тест топтомдору бирдей feature түзүмүн колдонот.
Идеалдуу оптималдаштыруу максаты күтүлгөн тобокелдикти азайтуу:
\[ \mathcal{L}(f)= \mathbb{E}_{(x,y)} \left[ \ell(f(x),y) \right] \tag{1} \]
Теңдеме 1 эмнени эсептейт? Моделдин маалымат бөлүштүрүлүшүндөгү күтүлгөн ката чыгымын билдирет.
\(f(x)\): Моделдин \(x\) трафик үлгүсү үчүн чыгарган божомолу.
\(y\): Чыныгы энбелги.
\(\ell(f(x),y)\): Божомол менен чыныгы энбелгинин ортосундагы айырманы өлчөгөн loss функциясы.
Математикалык ролу: Окутуу процесси бардык мүмкүн болгон тармак трафигинин күтүлгөн тобокелдигин түз эсептей албайт; учурдагы training samples аркылуу бул максатка жакындаганга аракет кылат.
Динамикалык Кошуналык Матрицасы Бул Изилдөөдө Эмне Үчүн Керек?
Динамикалык кошуналык матрицасы белгилүү бир убакыт терезесинде кайсы тармак түйүндөрү бири-бири менен маанилүү байланыш мамилесине ээ экенин feature similarity жана байланыш түзүмүнөн чыгарып, spatio-temporal graph ты жаңылайт; алсыз байланыштарды босого менен кесүү моделдин бардык түйүндөрдүн ортосунда тыгыз жана ызы-чуулуу байланыштарды түзүшүнүн ордуна убакыт менен өзгөргөн маанилүү топологиялык мамилелерди иштетүүсүн максат кылат.
Динамикалык graph түзүү
Булактын кошуналык матрицасынын теңдемеси:
\[ A_{ij}^{(t)} = \operatorname{ReLU} \left( \frac{x_i(x_j)^T}{\sqrt{d}} - \epsilon \right) \tag{2} \]
\(A_{ij}^{(t)}\): \(t\) убактысында \(i\) жана \(j\) түйүндөрүнүн ортосундагы байланыш салмагы.
\(x_i\) жана \(x_j\): Тиешелүү түйүндөрдүн feature vector лору.
\(d\): Feature өлчөмүнө байланыштуу масштабдоо мүчөсү.
\(\epsilon\): Алсыз байланыштарды кесүү үчүн колдонулган босого.
ReLU: Босого алынгандан кийин терс маанилерди нөлгө түшүрүп, алсыз мамилелердин adjacency matrix ичинде байланышка айланышына жол бербейт.
Теңдемеде feature-vector окшоштугу \(\sqrt{d}\) менен масштабдалып, \(\epsilon\) алынат. Окшоштук босогодон төмөн болсо ReLU натыйжасы нөл болот; босогодон жогору болсо байланыш оң салмак алат.
Булак adjacency matrix \(K\) өлчөмүндөгү sliding temporal window ичинде эсептелерин айтат, бирок \(K\) нын сандык маанисин билдирбейт.
Бардык түйүндөрдү тыгыз салыштыруунун теориялык чыгымы:
\[ O(N^2) \]
деп берилсе, sparse pruning ден кийин практикалык татаалдык:
\[ O(N\cdot deg_{avg}) \]
деңгээлине түшөрү айтылат. Бул жерде \(N\) түйүндөрдүн санын, \(deg_{avg}\) орточо node degree маанисин билдирет.
Булак ыкма бөлүмүндө \(\epsilon\) ды “learnable threshold” деп аныктайт. Кийинки sensitivity analysis болсо \(\epsilon=0.5\) ти тандалган operating point катары берет. Жарыяланган текст бул эки аныктаманы өзүнчө шайкеш келтирбегендиктен, Verianla алардын бирин экинчисинин ордуна койбойт.
Босого сезгичтиги
| Босого шарты | Булак жыйынтыгы | Түшүндүрмө |
|---|---|---|
| \(\epsilon \in [0.4,0.6]\) | F1 > %91 | Модель жогорку F1 деңгээлин сактайт. |
| Төмөнүрөөк босоголор | Так сан берилген эмес. | Булак көбүрөөк ызы-чуулуу байланыш түзүлөрүн билдирет. |
| \(\epsilon > 0.7\) | F1 болжол менен %86,5 | Graph fragmentation пайда болору айтылат. |
| Тандалган маани | \(\epsilon=0.5\) | Ызы-чууну чыпкалоо менен structural integrity ортосунда булак тандаган эң ылайыктуу тең салмак. |
Transformer self-attention эмне кылат?
Убакыттык encoder дин негизги attention теңдемеси:
\[ Attention(Q,K,V) = softmax \left( \frac{QK^T}{\sqrt{d_k}} \right)V \tag{3} \]
\(Q\): Query матрицасы.
\(K\): Key матрицасы.
\(V\): Value матрицасы.
\(d_k\): Key vector өлчөмү.
\(QK^T\) ар башка убакыт/түйүн көрсөтмөлөрүнүн ортосундагы байланыш упайларын чыгарат. \(\sqrt{d_k}\) менен масштабдоо чоң ички көбөйтүүлөр softmax ты ашыкча курчутушун чектөө үчүн колдонулат. Softmax натыйжалары attention weights болуп, бул салмактар \(V\) ге колдонулат.
Изилдөөдө сегиз attention head колдонгон алты катмарлуу Transformer бар. Hidden dimension 512. Multi-head түзүм моделдин ар башка representation ички мейкиндиктеринде түрдүү мамилелерди бир убакта карашын максат кылат.
Graph convolution эмне кылат?
Spatial encoder үчүн булак төмөнкү теңдемени берет:
\[ h_i' = \sigma \left( \sum_{j\in\mathcal{N}(i)} \frac{1}{c_{ij}} W h_j \right) \tag{4} \]
\(h_i'\): \(i\) түйүнүнүн жаңыртылган representation ы.
\(\mathcal{N}(i)\): \(i\) түйүнүнүн кошуналык топтому.
\(h_j\): Кошуна түйүн \(j\) нин учурдагы representation ы.
\(W\): Үйрөнүлүүчү өзгөртүү матрицасы.
\(c_{ij}\): Булак теңдемесиндеги normalization мүчөсү; макала мунун деталдуу аныктамасын өзүнчө бербейт.
\(\sigma\): Nonlinear activation функциясы.
Бул операция түйүндүн representation ын өз маалыматы менен гана эмес, динамикалык graph тагы кошуналарынын маалыматы менен да жаңылайт.
Federated Differential Privacy Бул Алкакта Кантип Коргоо Камсыз Кылат?
Federated differential privacy чийки тармак трафигин борбордук серверге ташыбастан ар бир түзмөктүн моделди өзүнүн жергиликтүү маалыматынын үстүндө жаңыртуусуна, aggregation үчүн модель жаңыртуулары гана бөлүшүлүшүнө жана gradient clipping менен Gaussian noise колдонуу аркылуу бир training sample дын модель жаңыртууга тийгизген таасирин чектөөгө негизделет; булакта \(\sigma=0.1\), болжол менен \(\epsilon=2.4\) жана \(\delta=10^{-5}\) маанилери билдирилген.
Feature decoupling
Булак жергиликтүү gradient ти эки компонент катары карайт:
- Structural component: \(\nabla_{\theta}^{str}\), graph/topology маалыматын алып жүргөн компонент.
- Task component: \(\nabla_{\theta}^{tsk}\), classification тапшырмасына байланышкан компонент.
Авторлор structural компонентке чоңураак clipping threshold колдонуу маанилүү topological features ты сактоого, task компонентинде катуураак clipping колдонуу болсо privacy коргоого жардам берерин билдиришет. Булак бул эки threshold дун так сандык маанилерин бербейт.
Теңдеме 5: Жергиликтүү модель жаңыртуусу
\[ \theta_i = \theta_i - \eta\nabla_{\theta}\mathcal{L}(\theta_i) \tag{5} \]
\(\theta_i\): \(i\). түзмөктүн жергиликтүү модель параметрлери.
\(\eta\): Learning rate.
\(\nabla_{\theta}\mathcal{L}(\theta_i)\): Жергиликтүү loss тун параметрлерге карата gradient и.
Ар бир түзмөк өзүнүн жергиликтүү training data сынан gradient эсептеп, өз моделин жаңыртат.
Теңдеме 6: Global model aggregation
\[ \theta_{global} = \frac{1}{N} \sum_{i=1}^{N} \theta_i \tag{6} \]
Булак борбордук серверде local model parameters дын жөнөкөй арифметикалык орточосун көрсөтөт. \(N\) aggregation га катышкан device/client санын билдирет.
Булак client sample санына жараша өзүнчө салмакталган aggregation формуласын Теңдеме 6 да бербейт.
Теңдеме 7: Noise injection
\[ \theta_i^{priv} = \theta_i + \mathcal{N}(0,\sigma^2) \tag{7} \]
Бул туюнтма local update ке нөл орточолуу Gaussian noise кошуларын көрсөтөт. Булак бул теңдеменин айланасындагы түшүндүрмөдө adaptive clipping жөнүндө да айтат; clipping дин деталдуу математикалык формасы кийин Теңдеме 12 де берилет.
DP-SGD clipping кадамы
Булак gradient нормасын \(C\) threshold менен чектейт:
\[ \hat{g}_t = \frac{g_t} {\max\left(1,\frac{\lVert g_t\rVert_2}{C}\right)} \]
Эгер \(\lVert g_t\rVert_2\leq C\) болсо, бөлүмдөгү максимум 1 болуп, gradient өзгөрбөйт. Gradient нормасы \(C\) ден ашса, gradient ошол эле багытта калып, чоңдугу чектелет.
Теңдеме 12: Clipping ден кийинки noisy parameter update
\[ \theta_{t+1} = \theta_t - \eta\cdot Adam \left( \hat{g}_t+ \mathcal{N}(0,\sigma^2 C^2 I) \right) \tag{12} \]
Булак эксперименттик жөндөөлөрдө:
- \(\eta=1\times10^{-4}\),
- \(\sigma=0.1\),
- \(\epsilon\approx2.4\),
- \(\delta=10^{-5}\),
- privacy-accounting horizon = 100 training epoch
маанилерин берет.
\(\epsilon\) жана \(\delta\) differential privacy параметрлери. Жалпы чечмелөөдө кичирээк privacy budget күчтүүрөөк купуялуулукту билдириши мүмкүн; бирок бул изилдөөдө натыйжалуулук/купуялуулук баалоосу булакта берилген шарттардын контекстинде гана каралышы керек.
Abstract та membership inference чабуулдары ошол эле privacy budget шартында төмөнүрөөк ийгилик деңгээлине жеткени айтылат. Бирок негизги жыйынтык бөлүмүндө membership-inference success rate үчүн өзүнчө сандык таблица же тест деталдары берилбегендиктен, бул доомат сандык жактан кеңейтилбейт.
Gradient compression
Abstract, discussion жана efficiency баалоосу federated gradient compression стратегиялары жөнүндө айтат. Бирок жарыяланган ыкма тексти compression operator формасын, compression ratio же колдонулган quantization/sparsification алгоритмин өзүнчө теңдеме менен билдирбейт. Ошондуктан gradient compression дун exact implementation ы булакта деталдуу кайра жаратууга мүмкүн болгон абалда эмес.
Чабуул аныктоодон коргонуу чечимине өтүү
Изилдөөдө network state \(s\) учурдагы убакыт терезесинен алынган трафик ылдамдыктары, protocol distributions жана anomaly scores сыяктуу көрсөткүчтөрдү камтыйт. Spatio-temporal Transformer бул state representation ды чыгарат жана reinforcement-learning agent коргонуу аракетин тандайт.
Теңдеме 8: Q-learning жаңыртуусу
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+ \gamma \max_{a'}Q(s',a') - Q(s,a) \right] \tag{8} \]
\(s\): Учурдагы network state.
\(a\): Тандалган defense action.
\(r\): Аракеттен кийинки reward.
\(s'\): Кийинки network state.
\(\alpha\): Q-learning update коэффициенти; булак бул теңдеме үчүн сандык \(\alpha\) маанисин бербейт.
\(\gamma\): Келечектеги reward тардын бүгүнкү маанисин аныктаган discount factor. DQN loss бөлүмүндө булак \(\gamma=0.9\) колдонот.
Reward функциясы
\[ r= w_1\cdot \mathbf{1}(\mathrm{Correct\ Response}) - \left( w_2 L+w_3F \right) \]
\(\mathbf{1}(\mathrm{Correct\ Response})\): Чабуулду ийгиликтүү токтотуу абалын көрсөткөн indicator.
\(L\): Response latency.
\(F\): False-positive cost.
\(w_1,w_2,w_3\): Security requirement ке жараша жөндөлгөн гиперпараметрлер. Булак бул салмактардын сандык маанилерин билдирбейт.
Бул reward түзүмү чабуулду токтотуу ийгилигин гана сыйлабайт; жогорку response latency жана false-positive чыгымын да жаза катары эсепке алат.
Global multi-objective loss
\[ \mathcal{L}(\theta) = \mathcal{L}_{CE}(\theta) + \lambda_{Defense} \mathcal{L}_{Defense}(\theta) + \lambda_{reg} \mathcal{L}_{reg}(\theta) \tag{9} \]
Булак:
\[ \lambda_{Defense}=0.5 \]
жана
\[ \lambda_{reg}=1\times10^{-4} \]
маанилерин колдонот.
\(\mathcal{L}_{CE}\) attack-detection classification error ды, \(\mathcal{L}_{Defense}\) reinforcement-learning defense loss ту, \(\mathcal{L}_{reg}\) болсо overfitting ти чектеген regularization мүчөсүн билдирет.
Теңдеме 10: Binary cross-entropy
\[ \mathcal{L}_{CE}(\theta) = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log(\hat{y}_i) + (1-y_i)\log(1-\hat{y}_i) \right] \tag{10} \]
\(y_i\in\{0,1\}\) чыныгы энбелгини, \(\hat{y}_i\) моделдин чабуул ыктымалдыгын, \(N\) болсо batch size ды билдирет.
Чыныгы чабуулга төмөн attack probability же чыныгы кадимки үлгүгө жогорку attack probability берилгенде loss өсөт.
Теңдеме 11: DQN Temporal Difference loss
\[ \mathcal{L}_{Defense}(\theta) = \mathbb{E}_{(s,a,r,s')} \left[ \left( r+ \gamma \max_{a'} Q(s',a';\theta^-) - Q(s,a;\theta) \right)^2 \right] \tag{11} \]
\(\theta\): Current Q-network параметрлери.
\(\theta^-\): Белгилүү аралыкта тоңдурулган target network параметрлери.
\(\gamma=0.9\): Discount factor.
Loss учурдагы Q-value менен Bellman target ортосундагы Temporal Difference катасынын квадратын азайтууну максат кылат.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Маалымат топтомдору жана preprocessing
| Маалымат топтому | Контекст | Feature өлчөмү | Table 1 train / validation / test | Preprocessing |
|---|---|---|---|---|
| UNSW-NB15 | Жалпы network-attack detection; булак 9 attack type камтарын билдирет. | d = 42 | 50k / 5k / 10k | Standardization |
| BoT-IoT | IoT/IIoT тармак трафиги; DDoS, DoS, scanning жана башка attack types | d = 10 core network feature | 100k / 10k / 20k | Min-Max normalization |
Булак модель тапшырмасын кадимки/чабуул түрүндөгү binary classification катары аныктайт. Ошондуктан маалымат топтомдорунда бир нече чабуул үй-бүлөсү болсо да, негизги objective жана Теңдеме 10 binary label түзүмүн колдонот.
UNSW-NB15 үчүн ыкма тексти training/validation/testing катышын тиешелүүлүгүнө жараша %50/%10/%40 деп да билдирет. Бирок Table 1 деги 50k/5k/10k сандары бул пайыздарга туура келбейт. Verianla бул эки башка булак билдирүүсүнүн бирин үнсүз оңдобойт.
Table 1 дин “Source / Acquisition Method” мамычасында UNSW-NB15 жана BoT-IoT саптарында ошол эле BoT-IoT долбоор дареги көрүнүшү да булак таблицасынын өзүнүн көрсөтүү өзгөчөлүгү. Verianla муну UNSW-NB15 тин чыныгы булак дареги катары кайра чыгарбайт.
Manual feature selection колдонулганбы?
Жок. Булак эки маалымат топтому spatio-temporal encoder ге берилерден мурун кошумча manual feature selection колдонулбаганын билдирет. Максат моделдин end-to-end feature extraction жөндөмүн баалоо.
Модель жана жабдуу
| Элемент | Булак мааниси |
|---|---|
| GPU | NVIDIA GeForce RTX 3080, 10 GB VRAM |
| Framework | PyTorch 1.10 |
| CUDA | 11.2 |
| Transformer катмары | 6 |
| Hidden dimension | 512 |
| Attention head | 8 |
| Optimizer | Adam |
| Initial learning rate | \(1\times10^{-4}\) |
| \(\lambda_{Defense}\) | 0.5 |
| \(\lambda_{reg}\) | \(1\times10^{-4}\) |
| DP noise multiplier | \(\sigma=0.1\) |
| Random seed | 42 |
Experimental Setup бөлүмү robustness testing үчүн Gaussian noise standard deviation маанисин 0.05 деп берет. Кийинки robustness validation болсо noise standard deviation ды 0 дон 0.2 ге чейин көбөйткөн кеңири sweep билдирет.
Кайталоо санындагы булак ичиндеги айырма
Experimental Setup аягында булак “results are reported as the mean ± standard deviation over 5 runs” деген сөз айкашын колдонот. Quantitative Results бөлүмүндө болсо “all experiments were repeated 10 times” деп айтылат. Table 4 аталышы да ачык n=10 деп көрсөтөт.
Ошондуктан кайталоо санын бардык эксперименттер үчүн бир так сан катары кайра жазуу коопсуз эмес. Table 3–4 тө көрүнгөн mean ± standard deviation маанилери булакта жарыяланган түрүндө сакталган.
Баалоо метрикалары
Булак Accuracy, Precision, Recall жана F1-Score колдонот:
\[ Accuracy= \frac{TP+TN} {TP+TN+FP+FN} \]
\[ Precision= \frac{TP}{TP+FP} \]
\[ Recall= \frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
TP туура чабуул аныктоолорун, TN туура кадимки трафик чечимдерин, FP кадимки трафик үчүн жалган чабуул сигналын, FN болсо өткөрүп жиберилген чыныгы чабуулдарды билдирет.
Baseline ыкмалары
- LSTM-IDS: Убакыттык dependency лерди моделдеген recurrent baseline.
- FedIDS: Federated-learning негизиндеги intrusion-detection baseline.
- DP-GNN: Differential privacy менен graph convolution ды бириктирген privacy-preserving baseline.
- RustGraph: Dynamic graph anomaly detection үчүн structural-temporal dependency моделдеген baseline.
Негизги натыйжалуулукту салыштыруу
| Ыкма | Маалымат топтому | Accuracy | FPR | F1 | Training Time | p-value |
|---|---|---|---|---|---|---|
| LSTM-IDS | UNSW-NB15 | 87.2% ± 0.6% | 5.2% ± 0.3% | 86.4% ± 0.5% | 1200 ± 120 s | <0.001 |
| LSTM-IDS | BoT-IoT | 84.5% ± 0.8% | 6.8% ± 0.4% | 83.9% ± 0.7% | 1500 ± 150 s | <0.001 |
| FedIDS | UNSW-NB15 | 89.5% ± 0.5% | 3.8% ± 0.2% | 88.7% ± 0.6% | 1300 ± 130 s | 0.002 |
| FedIDS | BoT-IoT | 87.0% ± 0.7% | 4.5% ± 0.3% | 86.2% ± 0.8% | 1600 ± 160 s | 0.001 |
| DP-GNN | UNSW-NB15 | 90.3% ± 0.4% | 3.1% ± 0.2% | 89.5% ± 0.5% | 1400 ± 140 s | 0.005 |
| DP-GNN | BoT-IoT | 88.5% ± 0.6% | 3.9% ± 0.3% | 87.8% ± 0.7% | 1700 ± 170 s | 0.003 |
| RustGraph | UNSW-NB15 | 91.2% ± 0.3% | 2.4% ± 0.1% | 90.5% ± 0.4% | 1500 ± 150 s | 0.01 |
| RustGraph | BoT-IoT | 90.0% ± 0.5% | 3.0% ± 0.2% | 89.2% ± 0.6% | 1800 ± 180 s | 0.008 |
| Proposed Method | UNSW-NB15 | 93.5% ± 0.2% | 1.2% ± 0.1% | 92.8% ± 0.3% | 1100 ± 110 s | — |
| Proposed Method | BoT-IoT | 92.0% ± 0.4% | 1.8% ± 0.2% | 91.3% ± 0.5% | 1400 ± 140 s | — |
Proposed Method эки маалымат топтомунда тең булак таблицасындагы эң жогорку accuracy жана F1 маанилерин, ошол эле учурда эң төмөн FPR маанилерин берет.
BoT-IoT то proposed accuracy %92,0, DP-GNN accuracy %88,5 болгондуктан айырма:
\[ 92.0-88.5=3.5 \]
3,5 пайыздык пункт. Бул сөз relative percentage increase эмес, эки accuracy пайызынын ортосундагы абсолюттук percentage-point айырмасы.
Table 3 p-value мамычасында baseline дар үчүн маанилер берилет жана significance level 0.05 деп көрсөтүлөт. Бирок булак колдонулган exact statistical test тин атын жана p-value мамычасындагы exact null hypothesis ти деталдуу билдирбейт. Ошондуктан p-маанилер кайсы тесттен алынганы Verianla тарабынан божомолдонгон эмес.
Convergence жыйынтыгы
Булак Figure 5 те proposed method UNSW-NB15 те болжол менен 80. epoch та %90 accuracy деңгээлине жеткенин, RustGraph окшош деңгээлге жетиши 92 epoch тан көп убакыт алганын билдирет.
Булак бул тезирээк convergence жүрүм-турумун adaptive graph structure жана spatio-temporal attention redundant connections аркылуу gradient propagation ды азайтышы менен байланыштырат. Бул механизм түшүндүрмөсү авторлордун чечмелөөсү.
Efficiency жыйынтыктары
| Ыкма | Параметр (M) | FLOPs (G) | Training Time (s/epoch) | Inference Latency (ms/sample) |
|---|---|---|---|---|
| LSTM-IDS | 2.1 ± 0.0 | 4.8 ± 0.1 | 15.0 ± 0.8 | 1.2 ± 0.1 |
| FedIDS | 3.4 ± 0.1 | 7.2 ± 0.3 | 16.3 ± 0.9 | 1.8 ± 0.2 |
| DP-GNN | 5.7 ± 0.2 | 12.5 ± 0.5 | 17.5 ± 1.0 | 2.5 ± 0.3 |
| RustGraph | 6.9 ± 0.3 | 15.0 ± 0.6 | 18.8 ± 1.1 | 3.0 ± 0.2 |
| Proposed Method | 7.2 ± 0.2 | 14.8 ± 0.5 | 13.8 ± 0.7 | 2.1 ± 0.2 |
Proposed Method параметр саны боюнча эң чоң модель: 7,2 миллион параметр. Ошого карабастан RustGraph тын 18,8 s/epoch training time ына каршы 13,8 s/epoch жана 3,0 ms/sample inference latency сине каршы 2,1 ms/sample берет.
Булак RustGraph ка салыштырмалуу training time болжол менен %26,6, inference latency болсо %30 төмөн экенин билдирет. GNN негизиндеги baseline hidden dimensions окшош parameter scale камсыз кыла тургандай standardize кылынганы да айтылат.
2,1 ms Inference Кечигүүсү Реалдуу Убакыттагы Талаа Ийгилигин Далилдейби?
Жок. Булак 2,1 ± 0,2 ms/sample мааниси dynamic graph construction, feature extraction жана Transformer forward pass камтыган өзүнүн эксперименттик end-to-end inference өлчөөсү экенин жана болжол менен 500 traffic sample/s иштетүү жөндөмүнө туура келерин билдирет; бирок өлчөө RTX 3080 GPU да benchmark маалыматтары менен жүргүзүлгөн жана чыныгы edge түзмөгүндө, V2X унаасында же өндүрүш тармагында узак мөөнөттүү талаа deployment эмес.
Математикалык түрдө:
\[ \frac{1}{0.0021\;s} \approx476\;sample/s \]
болот. Булактын “nearly 500 traffic samples per second” деген сөзү ушул болжолдуу мааниге туура келет.
Бирок булак discussion бөлүмүндө adaptive graph construction өтө resource-constrained micro-IoT node дордо кошумча computation overhead жаратарын жана оптималдаштыруу керек экенин ачык кабыл алат.
Ийгиликтүү сапаттык мисал
Булак “UNSW-NB15 – DoS Hulk” энбелгиси менен берген мисалда 28–32. секунддардагы attack window учурунда максаттуу host ка жаңы туташуулардын саны baseline орточо 24,3 connection/s деңгээлинен 3872 connection/s peak маанисине көтөрүлгөнүн билдирет.
Кадимки fluctuation аралыгы болжол менен ±2σ ≈ 60 деп берилген. Proposed Method чабуулду %96,7 confidence менен DoS катары классификациялаган.
t=30 s учурунда attention салмактары:
| Feature | Attention weight |
|---|---|
| Connection burstiness | 0.42 |
| Destination port diversity | 0.38 |
LSTM-IDS ошол эле үлгүнү %58,1 confidence менен кадимки трафик деп туура эмес классификациялаган.
Булак аталышы боюнча эскертүү: Макала бул учурду ачык “UNSW-NB15 – DoS Hulk Attack Detection” деп атайт. Жарыяланган текст бул чабуул аталышынын маалымат топтомунун таксономиясы менен байланышын өзүнчө түшүндүрбөйт. Verianla булак энбелгисин өзгөртпөйт жана жетишпеген түшүндүрмөнү ойлоп таппайт.
Ultra-Low-Frequency Скандоодо Модель Эмне Үчүн Ийгиликсиз Болду?
Булакта берилген төмөн ылдамдыктагы port-scan мисалында чабуул сигналы кадимки IoT heartbeat трафигине абдан жакын болгондуктан, federated clients чектелген жергиликтүү көрүнүштү гана көргөндүктөн жана \(\sigma=0.1\) differential-privacy noise алсыз anomaly gradient терин баскандыктан dynamic graph маанилүү anomaly edge терин түзө алган эмес жана модель чабуулду кадимки трафик деп классификациялаган.
| Элемент | Булак мааниси |
|---|---|
| Probe жыштыгы | 6 мүнөттө 1 probe |
| Жалпы байкоо | 30 мүнөт |
| Жалпы probe | 5 |
| Чабуул packet rate | 0.8 pkt/s |
| Кадимки IoT heartbeat аралыгы | 0.7–1.1 pkt/s |
| Adjacency matrix sparsity | 99.6% |
| Модель чечими | Normal registration behavior |
| Confidence | 62.3% |
| DP noise | \(\sigma=0.1\) |
Булак келечекте cross-device meta-event correlations же unsupervised anomaly priors сыяктуу механизмдер бул information-scarcity көйгөйүнө жардам бериши мүмкүн экенин сунуштайт. Булар учурдагы экспериментте ырасталган жыйынтыктар эмес.
Noise robustness
Input feature ларга Gaussian noise кошулганда standard deviation 0 дон 0.2 ге чейин көбөйтүлгөн. Proposed Method accuracy мааниси %93,5 тен %89,3 ке түшсө, RustGraph %83,2, DP-GNN %84,6 деңгээлине төмөндөгөн.
| Ыкма | Баштапкы / шилтеме | Noise std = 0.2 шартындагы жыйынтык |
|---|---|---|
| Proposed Method | 93.5% accuracy | 89.3% accuracy |
| RustGraph | Булак бул сүйлөмдө баштапкы маанини кайра бербейт. | 83.2% accuracy |
| DP-GNN | Булак бул сүйлөмдө баштапкы маанини кайра бербейт. | 84.6% accuracy |
Булак Figure 7 ийри сызыгынын бардык аралык numeric чекиттерин таблица түрүндө бербегендиктен, Verianla аралык маанилерди интерполяция кылбайт.
Булак ошондой эле “spatial attention module” алынып салынганда accuracy %83,5 ке түшөрүн билдирет. Бул сөз Table 5 теги модул аталышынан өзүнчө robustness түшүндүрмөсүндө өтөт.
Cross-Dataset Түз Transfer Кантип Сыналды?
Cross-dataset generalization эксперименти proposed model UNSW-NB15 те окутулуп, BoT-IoT то эч кандай fine-tuning жүргүзүлбөстөн түз текшерилгенде аткарылган; булак proposed model эки тарапта тең F1 маанисин %91 ден жогору сактап, максаттуу BoT-IoT то RustGraph тан 2,1 пайыздык пункт жогору болгонун билдирет.
Бул эксперимент стандарттык бир-dataset train/test баалоосуна караганда күчтүүрөөк distribution-shift сыноосу, анткени модель максаттуу маалымат топтомуна кайра ылайыкташтырылган эмес.
Булак максаттуу BoT-IoT то hybrid DDoS сыяктуу unseen attack variants бар экенин билдирет. Proposed Method тин dynamic graph structure жана local-global federated modeling айкалышы бул distribution shift ке ылайыкташууда роль ойнойт деп авторлор сунушташат.
Бирок cross-dataset жыйынтыгы реалдуу дүйнөдөгү ар бир тармак чөйрөсүнө универсалдуу generalization далили эмес. Ал булакта сыналган UNSW-NB15 → BoT-IoT transfer шартын гана колдойт.
Ablation анализи
| Модель варианты | UNSW-NB15 | BoT-IoT |
|---|---|---|
| Full Model | 93.5 / 92.8 | 92.0 / 91.3 |
| Adaptive Spatio-Temporal Graph Generation алынып салынды | 90.1 / 89.4 | 88.7 / 87.9 |
| Federated Differential Privacy алынып салынды; Centralized Training | 92.8 / 92.0 | 91.2 / 90.5 |
| Reinforcement Learning Dynamic Defense Module алынып салынды | 93.2 / 92.5 | 91.7 / 91.0 |
| Spatio-Temporal Transformer ордуна GCN+LSTM | 89.6 / 88.7 | 87.4 / 86.5 |
| Base GNN Only | 87.3 / 86.1 | 84.9 / 83.8 |
BoT-IoT F1 боюнча full model %91,3. Adaptive graph алынып салынганда %87,9 га түшүп, 3,4 percentage-point жоготуу болот. Spatio-temporal Transformer GCN+LSTM менен алмаштырылганда %86,5 ке түшөт; жоготуу 4,8 percentage point.
Federated differential privacy механизми centralized training менен алмаштырылганда BoT-IoT F1 %91,3 тен %90,5 ке түшөт; айырма 0,8 percentage point.
RL dynamic-defense module алынып салынганда BoT-IoT F1 болгону %91,3 тен %91,0 га түшөт. Булак бул кичине classification айырмасын күтүлгөн жыйынтык деп түшүндүрөт, анткени reinforcement-learning катмарынын негизги иши classification эмес, чабуулдан кийинки response strategy тандоо.
Base GNN Only түзүмү BoT-IoT то %83,8 F1 менен эң алсыз вариант. Бул жыйынтык булакта graph representation жалгыз өзү жетишсиз экенин жана spatio-temporal attention маанилүү салымын колдогон ablation табылгасы катары чечмеленет.
Privacy–utility trade-off
Ablation federated differential privacy механизмин алып салуу accuracy/F1 ге башка борбордук архитектура компоненттериндей чоң айырма жаратпаганын көрсөтөт. Булак муну privacy protection азыраак utility жоготуусу менен колдонулушу мүмкүн экенинин далили катары чечмелейт.
Бирок privacy механизми үчүн membership-inference success rate негизги жыйынтык таблицаларында сандык түрдө берилбегендиктен, privacy–utility баалоосу негизинен differential-privacy параметрлери, detection metrics жана ablation жыйынтыктары аркылуу байкалат.
Изилдөө колдогон жыйынтыктар
- Адаптивдүү spatio-temporal graph жана Transformer айкалышы колдонулган эки benchmark та baseline дардан жогорку accuracy жана F1 берген.
- Proposed Method UNSW-NB15 те %93,5 ± %0,2 accuracy жана %92,8 ± %0,3 F1 алган.
- Proposed Method BoT-IoT то %92,0 ± %0,4 accuracy жана %91,3 ± %0,5 F1 алган.
- BoT-IoT то proposed accuracy DP-GNN ден 3,5 percentage point жогору.
- FPR UNSW-NB15 те %1,2 ± %0,1, BoT-IoT то %1,8 ± %0,2 деп билдирилген.
- UNSW-NB15 → BoT-IoT direct-transfer эксперименти fine-tuning жок жүргүзүлгөн.
- Adaptive graph жана Transformer ablation дары модель натыйжалуулугунда эң чоң төмөндөөлөрдү жараткан.
- Federated differential privacy механизмин centralized training менен алмаштыруу full model ге салыштырмалуу %1 ден төмөн F1 айырмасын жараткан.
- RTX 3080 эксперимент чөйрөсүндө end-to-end inference latency 2,1 ± 0,2 ms/sample деп өлчөнгөн.
- Input noise std 0,2 ге чейин көбөйтүлгөндө proposed accuracy %89,3 ке төмөндөп, бирок булакта салыштырылган baselines дан жогору калган.
- Ultra-low-frequency scanning мисалы моделдин маанилүү ийгиликсиздик чегин көрсөтөт.
Изилдөө колдобогон же жетишсиз калтырган жыйынтыктар
- Чыныгы V2X унаа тармагында же коммерциялык IoT deployment та узак мөөнөттүү талаа натыйжалуулугу көрсөтүлгөн эмес.
- 2,1 ms жыйынтыгы бардык micro-IoT жабдууларында ошол эле latency алынарын кепилдебейт.
- UNSW-NB15 → BoT-IoT transfer жыйынтыгы ар бир белгисиз тармак маалымат доменинде ошол эле generalization жараларын далилдебейт.
- Ultra-low-frequency stealth attacks чечилген эмес.
- Membership inference чабуулдарынын ийгилик деңгээлинин азайышы abstract та билдирилсе да, негизги текстте сандык маани жана деталдуу протокол жок.
- Gradient-compression алгоритминин exact implementation ы, compression ratio су жана operator деталдары билдирилбейт.
- Sliding temporal window size \(K\) нын сандык мааниси билдирилбейт.
- Structural жана task gradient clipping threshold маанилери өз-өзүнчө билдирилбейт.
- Reward weights \(w_1,w_2,w_3\) сандык түрдө берилбейт.
- Table 3 төгү p-value ларды чыгарган statistical test тин exact аты билдирилбейт.
- Булакта 5 run менен 10 repeat сөздөрүнүн ортосунда дал келбестик бар.
- UNSW-NB15 үчүн жазылган %50/%10/%40 катышы Table 1 деги 50k/5k/10k сандарына туура келбейт.
Чектөөлөр жана келечектеги изилдөө
Булак эң көрүнүктүү чектөө extremely low-frequency stealth attacks экенин билдирет. Federated learning client тарынын чектелген local views ка ээ болушу жана differential-privacy noise төмөн-amplitude anomaly gradients ти басышы өзгөчө сейрек чабуулдарда detection ды кыйындатат.
Adaptive graph construction 2,1 ms overall latency ичинде иштегени менен severely resource-constrained micro-IoT node дордо кошумча energy/computation overhead жаратышы мүмкүн экени айтылат.
Сунушталган келечектеги иштерге client тар арасында lightweight meta-event summary бөлүшүү, Secure Multi-Party Computation же highly aggregated statistics колдонуу, event-driven sparse graph updates, fully unsupervised же open-set anomaly detection жана micro-embedded devices үчүн graph-construction оптималдаштыруу кирет.
Булак жана Ыкма Жөнүндө Эскертүү
Оригинал аталышы: A Spatio-Temporal Transformer-Based Approach for Network Attack Detection
Авторлор жана ирети: Xin Liu; Xiang Liu.
Corresponding author: Xin Liu; булакта жылдызча менен белгиленген.
Xin Liu мекемеси: School of Advanced Engineering, University of Science and Technology Beijing, Beijing 100083, China.
Xin Liu e-mail: u202341641@xs.ustb.edu.cn
Xiang Liu мекемеси: School of International Education, Beijing University of Chemical Technology, Beijing 102203, China.
Xiang Liu e-mail: 2024090034@mail.buct.edu.cn
Тең салым / тең биринчи авторлук: Булакта тең салым тууралуу билдирүү жок.
Журнал: Journal of Universal Computer Science.
Кыскартылышы: J.UCS.
Том / сан: Volume 32, Number 9.
Барактар: 1375–1398.
Жарыяланган жыл: 2026.
Submitted: 23 Январь 2026.
Accepted: 7 Июль 2026.
Appeared / Published: 14 Сентябрь 2026.
DOI: 10.3897/jucs.207303.
Расмий DOI шилтемеси: https://doi.org/10.3897/jucs.207303
Булак түрү: Жарыяланган оригиналдуу изилдөө макаласы.
Рецензия абалы: Journal of Universal Computer Science рецензияланган журнал; журналдын учурдагы расмий профили single-blind review жана кеминде эки editorial-board reviewer бар экенин көрсөтөт.
Макала лицензиясы: CC BY 4.0; макаланын PDF файлынын биринчи бетинде ачык көрсөтүлгөн.
Негизги маселе: Dynamic network topology шартында жогорку accuracy, privacy preservation жана төмөн-latency attack detection/response максаттарын бир framework ичинде кароо.
Тапшырма формулировкасы: Binary classification; \(y=0\) кадимки, \(y=1\) malicious traffic.
Негизги үч модуль: Spatio-temporal feature extraction; federated differential-privacy protection; reinforcement-learning attack detection/defense.
Dynamic graph: Communication relationships жана traffic-feature similarity негизиндеги time-dependent adjacency matrix.
Graph threshold: Ыкма бөлүмүндө learnable \(\epsilon\); sensitivity analysis тандалган маани катары \(\epsilon=0.5\) деп билдирет.
Threshold sensitivity: \(\epsilon\in[0.4,0.6]\) үчүн F1 > %91; \(\epsilon>0.7\) үчүн F1 болжол менен %86,5.
Transformer: 6 layer, hidden dimension 512, 8-head multi-head attention.
Federated aggregation: Булак Теңдеме 6 да local model parameters дын жөнөкөй орточосун берет.
Differential privacy: DP-SGD, gradient clipping жана Gaussian noise.
DP noise multiplier: \(\sigma=0.1\).
Privacy budget: Болжол менен \(\epsilon=2.4\), \(\delta=10^{-5}\), 100 epoch соңунда булакта билдирилген шарт.
Feature decoupling: Structural gradient жана task gradient компоненттерине ажыратуу; так clipping threshold сандары билдирилбейт.
Gradient compression: Булак тарабынан компонент катары көрсөтүлөт; exact compression algorithm жана катышы билдирилбейт.
Reinforcement learning: Q-learning / Deep Q-Network.
DQN discount factor: \(\gamma=0.9\).
Defense actions: Булак мисал катары traffic limiting жана data filtering берет.
Reward: Correct response сыйлыгын latency жана false-positive cost жазасы менен бириктирет; \(w_1,w_2,w_3\) маанилери билдирилбейт.
Global loss: Binary cross-entropy + defense TD loss + regularization.
\(\lambda_{Defense}\): 0.5.
\(\lambda_{reg}\): \(1\times10^{-4}\).
Optimizer: Adam.
Initial learning rate: \(1\times10^{-4}\).
UNSW-NB15 features: d = 42, ID жана labels тышкары.
BoT-IoT features: d = 10 core network features.
UNSW preprocessing: Standardization.
BoT-IoT preprocessing: Min-Max normalization.
Manual feature selection: Колдонулган эмес.
Table 1 sample split: UNSW-NB15 50k / 5k / 10k; BoT-IoT 100k / 10k / 20k.
Булак ичиндеги partition айырмасы: Текст UNSW-NB15 үчүн %50/%10/%40 катышын берет; Table 1 деги 50k/5k/10k буга туура келбейт.
Жабдуу: NVIDIA GeForce RTX 3080 GPU, 10 GB VRAM.
Программалык камсыздоо: PyTorch 1.10, CUDA 11.2.
Random seed: 42.
Булак ичиндеги run-count айырмасы: Experimental Setup 5 run mean ± std дейт; Quantitative Results 10 repeat дейт жана Table 4 n=10 деп көрсөтөт.
Significance level: 0.05.
Statistical-test чеги: Table 3 p-value берет; exact statistical-test аты жана null-hypothesis деталдары негизги текстте ачык көрсөтүлгөн эмес.
UNSW-NB15 негизги жыйынтык: Accuracy 93.5% ± 0.2%; F1 92.8% ± 0.3%; FPR 1.2% ± 0.1%.
BoT-IoT негизги жыйынтык: Accuracy 92.0% ± 0.4%; F1 91.3% ± 0.5%; FPR 1.8% ± 0.2%.
DP-GNN салыштыруусу: BoT-IoT accuracy 88.5% ± 0.6%; proposed айырмасы +3.5 percentage point.
Inference latency: 2.1 ± 0.2 ms/sample.
Inference камтуусу: Dynamic graph construction + feature extraction + Transformer forward pass.
Proposed parameter count: 7.2 ± 0.2 million.
Proposed FLOPs: 14.8 ± 0.5 G.
Training time: Table 4 тө 13.8 ± 0.7 s/epoch.
Cross-dataset test: UNSW-NB15 те training → BoT-IoT то fine-tuning жок direct testing.
Cross-dataset жыйынтыгы: Булак proposed F1 эки маалымат топтомунда тең %91 ден жогору калганын жана максаттуу BoT-IoT то RustGraph тан 2.1 percentage point жогору болгонун билдирет.
Noise robustness: Gaussian feature noise std 0→0.2; proposed accuracy 93.5%→89.3%.
Маанилүү failure case: 6 мүнөттө бир probe, 30 мүнөттө 5 probe, 0.8 pkt/s; normal heartbeat 0.7–1.1 pkt/s; adjacency sparsity 99.6%; normal prediction confidence 62.3%.
Membership inference эскертүүсү: Abstract ошол эле privacy budget шартында attack success rate олуттуу азайганын билдирет; негизги текстте сандык membership-inference success rate же деталдуу эксперимент протоколу жок.
Ablation жыйынтыгы: BoT-IoT F1 full model 91.3%; no adaptive graph 87.9%; centralized/no federated DP 90.5%; no RL defense 91.0%; GCN+LSTM replacement 86.5%; base GNN only 83.8%.
Каржылоо: Каралган PDF де өзүнчө funding declaration бөлүмү жок.
Кызыкчылыктардын кагылышы: Каралган PDF де өзүнчө conflict-of-interest declaration жок.
Data Availability: Каралган PDF де өзүнчө Data Availability statement жок; эксперимент бөлүмүндө UNSW-NB15 жана BoT-IoT public datasets деп аныкталат.
Авторлордун салымы / CRediT: Каралган PDF де өзүнчө author-contributions же CRediT билдирүүсү жок.
Негизги изилдөө чеги: Жыйынтыктар benchmark маалымат топтомдоруна жана RTX 3080 негизиндеги эксперимент чөйрөсүнө тиешелүү; чыныгы micro-IoT node, V2X fleet же production SOC үстүндө узак мөөнөттүү талаа текшерүүсү эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген