


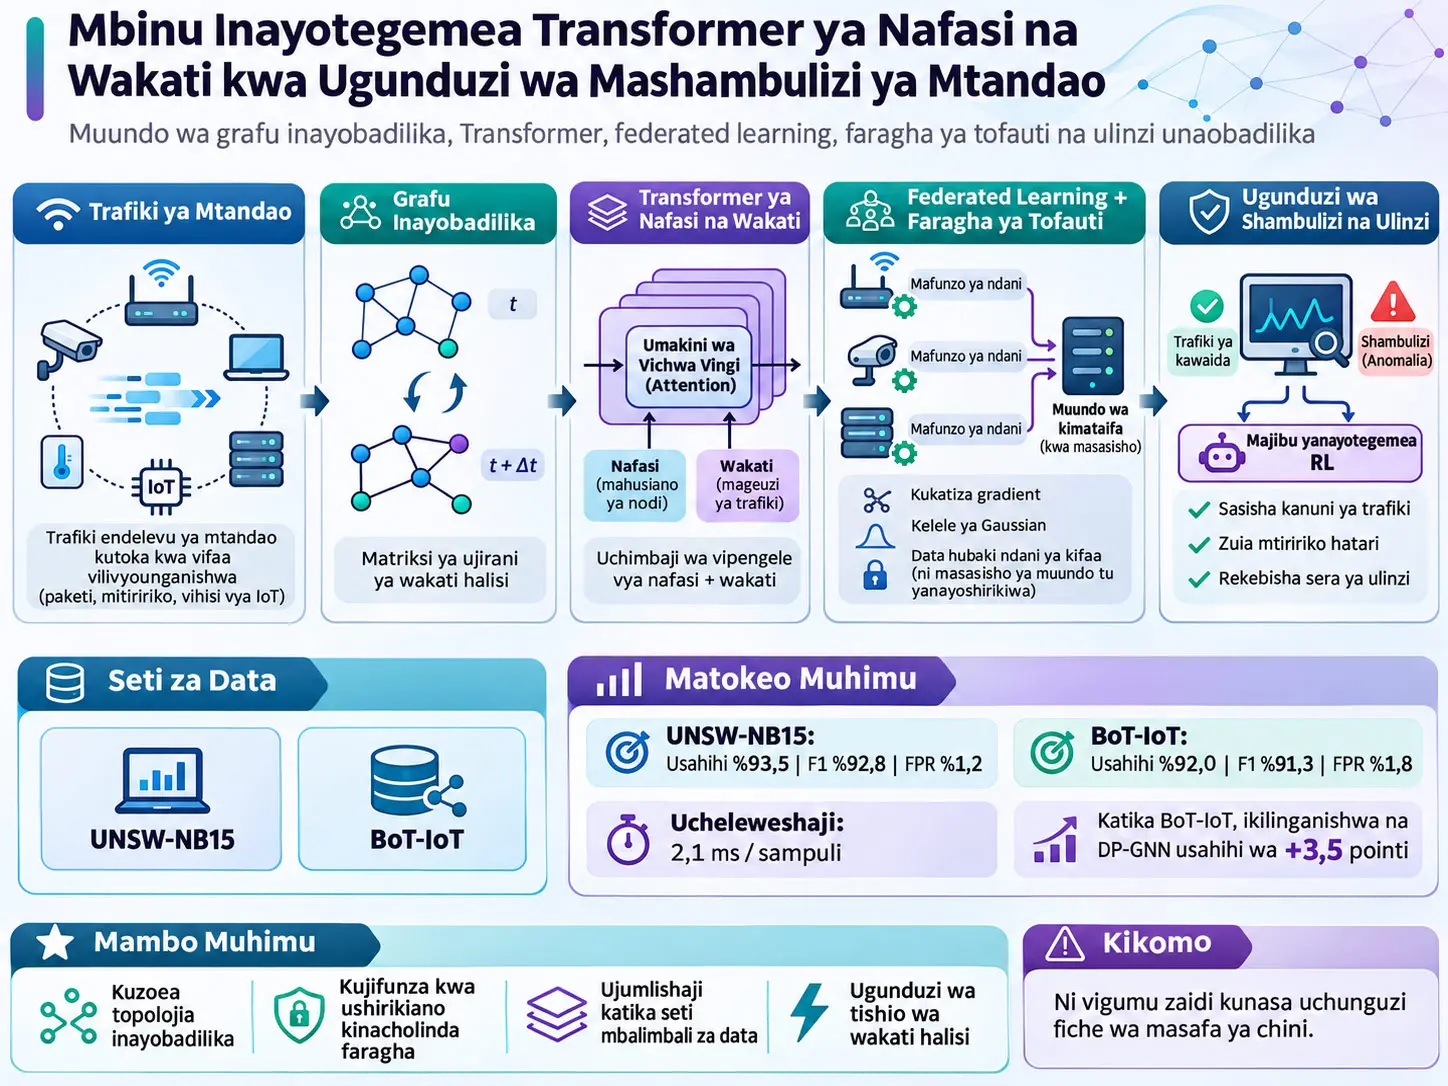
Mfumo wa kugundua mashambulizi ya mtandao unaotegemea Transformer ya nafasi na wakati inayojirekebisha ni mbinu ya network attack detection na response inayolenga kuwakilisha mahusiano ya mawasiliano yanayobadilika kati ya nodi za mtandao kama grafu inayobadilika, kuchakata utegemezi wa wakati kwa Transformer, utegemezi wa nafasi/topolojia kwa graph convolution, kutumia federated learning na differential privacy bila kutoa data ya ndani kutoka kwenye kifaa, na kutoa uamuzi wa ulinzi baada ya shambulizi kwa reinforcement learning. Utafiti ulitathminiwa kwenye seti za data benchmark za UNSW-NB15 na BoT-IoT; mbinu iliyopendekezwa ilipata %93,5 ± %0,2 accuracy na %92,8 ± %0,3 F1 kwenye UNSW-NB15, na %92,0 ± %0,4 accuracy pamoja na %91,3 ± %0,5 F1 kwenye BoT-IoT. Hata hivyo, utafiti unategemea seti za data zinazodhibitiwa; matokeo haya hayapaswi kufasiriwa kama mafanikio ya muda mrefu ya uwanjani kwenye V2X, IoT au mtandao halisi wa uzalishaji.
Kipengele cha kwanza cha mfumo huunda matriksi ya ujirani inayobadilika kutokana na masafa ya mawasiliano ya nodi za mtandao na ufanano wa sifa za trafiki katika dirisha la wakati la sasa. Miunganisho dhaifu hukatwa kwa kuweka kizingiti; hivyo hulengwa kupata grafu inayowakilisha mahusiano ya mawasiliano yaliyo machache zaidi na ya sasa badala ya muundo msongamano ambamo kila nodi imeunganishwa na nodi zote za mtandao. Utegemezi wa wakati huchakatwa kwa Transformer inayotumia multi-head self-attention, huku utegemezi wa kitopolojia ukichakatwa kwa graph convolution.
Kipengele cha pili huunganisha federated learning na differential privacy. Badala ya kutuma data ghafi ya trafiki kwa seva kuu, vifaa vya ndani husasisha modeli zao ndani ya kifaa; seva kuu huunganisha vigezo vya modeli. Chanzo hutumia gradient clipping na Gaussian noise wakati wa differential privacy; katika mipangilio ya majaribio kinaripoti noise multiplier ya \(\sigma=0.1\), bajeti ya jumla ya faragha ya takriban \(\epsilon=2.4\) baada ya 100 epoch na \(\delta=10^{-5}\).
Kipengele cha tatu hakilengi tu uamuzi wa “kuna/hakuna shambulizi”. Tabaka la reinforcement learning linalotegemea Deep Q-Network linalenga kuchagua kati ya hatua za ulinzi kama kupunguza trafiki au kuchuja data kwa kutumia network state inayojumuisha viashiria kama kasi ya trafiki, usambazaji wa itifaki na anomaly score. Matokeo ya ablation yanaonyesha kuwa mchango wa kipengele cha reinforcement-learning kwenye classification accuracy ni takriban pointi 0,3 tu za asilimia; jukumu lake kuu ni mwitikio unaobadilika kwa shambulizi.
Faida kubwa zaidi ya utendaji wa mbinu iliyopendekezwa inatokana na uundaji wa grafu unaojirekebisha na vipengele vya spatio-temporal Transformer. Kwenye BoT-IoT, F1 hushuka kutoka %91,3 hadi %87,9 uundaji wa grafu unaojirekebisha unapoondolewa, na hadi %86,5 Transformer inapobadilishwa na GCN+LSTM. Kwa upande mwingine, kubadilisha utaratibu wa federated differential privacy na mafunzo ya kati huleta tofauti ya takriban pointi 0,8 za asilimia katika F1.
Chanzo pia kinaripoti jaribio la moja kwa moja la cross-dataset transfer: modeli ilifundishwa kwenye UNSW-NB15 na kujaribiwa kwenye BoT-IoT bila fine-tuning. Waandishi wanaripoti kwamba katika hali hii proposed model ilidumisha F1 juu ya %91 na kuizidi RustGraph kwa pointi 2,1 za asilimia kwenye BoT-IoT.
Kizuizi muhimu cha utafiti ni mashambulizi ya masafa ya chini sana. Katika mfano wa uchunguzi wa port wa kasi ndogo uliotolewa kwenye chanzo, mshambulizi alitoa probe tano tu ndani ya dakika 30, kasi ya pakiti ikabaki katika kiwango cha 0,8 packet/s na ikaingiliana kwa kiasi kikubwa na safu ya 0,7–1,1 packet/s ya trafiki ya kawaida ya IoT heartbeat. Modeli iliainisha mfano huu kama tabia ya kawaida kwa %62,3 confidence. Waandishi wanahusisha kushindwa huku na mwonekano mdogo wa ndani katika federated learning pamoja na differential-privacy noise inayokandamiza anomaly gradient dhaifu.
Sehemu ya abstract ya chanzo inaripoti kuwa kiwango cha mafanikio ya mashambulizi ya membership inference kilipunguzwa kwa kiasi kikubwa chini ya privacy budget ileile. Hata hivyo, katika sehemu kuu za mbinu na matokeo hakuna kiwango cha mafanikio cha kiasi, jedwali tofauti la majaribio au itifaki ya kina ya majaribio kwa shambulizi la membership-inference. Kwa hiyo dai hili linapaswa kuhifadhiwa kama tamko la ubora kutoka chanzo na halipaswi kupanuliwa kwa namba ambazo hazipo kwenye chanzo.
Tatizo la utafiti ni nini?
Network Attack Detection (NAD) inalenga kutofautisha tabia ya kawaida na tabia hasidi katika trafiki ya mtandao. Utafiti huu huunda tatizo kihisabati kama binary classification: \(y_i=0\) inawakilisha trafiki ya kawaida, na \(y_i=1\) inawakilisha trafiki ya shambulizi.
Changamoto ambayo utafiti unajaribu kutatua si uainishaji sahihi pekee. Katika mazingira kama IoT, Internet of Vehicles na Vehicle-to-Everything, ni vifaa gani vinawasiliana vinaweza kubadilika kadri muda unavyopita. Wakati huohuo, kutuma data kwa seva kuu kunaweza kuunda hatari ya faragha, na baada ya shambulizi kugunduliwa ni tatizo tofauti kuamua ni hatua gani ya ulinzi itatumika.
Kwa hiyo chanzo kinashughulikia matatizo matatu chini ya mfumo mmoja:
- Kuunda modeli ya mahusiano ya nafasi na wakati katika topolojia ya mtandao inayobadilika.
- Kufundisha modeli ya pamoja bila kuhamisha data ghafi kwenda mfumo wa kati na kutumia differential privacy.
- Kutoa uamuzi wa ulinzi unaobadilika kwa reinforcement learning baada ya ugunduzi.
Uundaji wa tatizo
Chanzo kinawakilisha data ya trafiki ya mtandao kwa \(X\), kila sampuli ya trafiki kwa \(x_i\), na lebo ya binary class kwa \(y_i\). Seti za mafunzo na majaribio hutumia muundo uleule wa feature.
Lengo bora la uboreshaji ni kupunguza hatari inayotarajiwa:
\[ \mathcal{L}(f)= \mathbb{E}_{(x,y)} \left[ \ell(f(x),y) \right] \tag{1} \]
Mlinganyo 1 unahesabu nini? Unaeleza gharama ya kosa inayotarajiwa ya modeli juu ya usambazaji wa data.
\(f(x)\): Ni utabiri unaotolewa na modeli kwa sampuli ya trafiki \(x\).
\(y\): Ni lebo halisi.
\(\ell(f(x),y)\): Ni loss function inayopima tofauti kati ya utabiri na lebo halisi.
Jukumu la kihisabati: Mchakato wa mafunzo hauwezi kuhesabu moja kwa moja hatari inayotarajiwa ya trafiki yote inayowezekana ya mtandao; hujaribu kukaribia lengo hili kupitia training samples zilizopo.
Matriksi ya Ujirani Inayobadilika Inafanya Kazi Gani katika Utafiti Huu?
Matriksi ya ujirani inayobadilika husasisha spatio-temporal graph kwa kubaini, kutokana na feature similarity na muundo wa mawasiliano, ni nodi zipi za mtandao zilizo na mahusiano ya mawasiliano yenye maana ndani ya dirisha maalum la wakati; kuweka kizingiti kwenye miunganisho dhaifu hulenga kufanya modeli ichakate mahusiano muhimu ya kitopolojia yanayobadilika kwa wakati badala ya kuunda miunganisho mingi na yenye kelele kati ya nodi zote.
Uundaji wa graph inayobadilika
Mlinganyo wa matriksi ya ujirani wa chanzo ni:
\[ A_{ij}^{(t)} = \operatorname{ReLU} \left( \frac{x_i(x_j)^T}{\sqrt{d}} - \epsilon \right) \tag{2} \]
\(A_{ij}^{(t)}\): Katika wakati \(t\), ni uzito wa muunganisho kati ya nodi \(i\) na \(j\).
\(x_i\) na \(x_j\): Ni feature vector za nodi husika.
\(d\): Ni kipengele cha kuweka kiwango kinachohusiana na ukubwa wa feature.
\(\epsilon\): Ni kizingiti kinachotumiwa kukata miunganisho dhaifu.
ReLU: Baada ya kuondoa kizingiti, hupeleka thamani hasi hadi sifuri na hivyo kuzuia mahusiano dhaifu kugeuka kuwa miunganisho kwenye adjacency matrix.
Katika mlinganyo, ufanano wa feature-vector huwekwa kiwango kwa \(\sqrt{d}\) na \(\epsilon\) huondolewa. Ufanano ukiwa chini ya kizingiti, matokeo ya ReLU huwa sifuri; ukiwa juu ya kizingiti, muunganisho hupata uzito chanya.
Chanzo kinaeleza kuwa adjacency matrix huhesabiwa ndani ya sliding temporal window ya ukubwa \(K\), lakini hakiripoti thamani ya namba ya \(K\).
Gharama ya kinadharia ya ulinganisho mnene wa nodi zote hutolewa kama:
\[ O(N^2) \]
ilhali baada ya sparse pruning, ugumu wa vitendo huelezwa kupunguzwa hadi kiwango cha:
\[ O(N\cdot deg_{avg}) \]
Hapa \(N\) inawakilisha idadi ya nodi, na \(deg_{avg}\) inawakilisha thamani ya wastani ya node degree.
Katika sehemu ya mbinu, chanzo kinafafanua \(\epsilon\) kama “learnable threshold”. Sensitivity analysis ya baadaye, kwa upande mwingine, inawasilisha \(\epsilon=0.5\) kama operating point iliyochaguliwa. Kwa kuwa maandishi yaliyochapishwa hayapatanishi tafsiri hizi mbili kando, Verianla haitumii moja badala ya nyingine.
Unyeti wa kizingiti
| Hali ya kizingiti | Matokeo ya chanzo | Ufafanuzi |
|---|---|---|
| \(\epsilon \in [0.4,0.6]\) | F1 > %91 | Modeli hudumisha kiwango cha juu cha F1. |
| Vizingiti vya chini zaidi | Hakuna namba kamili iliyotolewa. | Chanzo kinaeleza kuwa miunganisho yenye kelele zaidi huundwa. |
| \(\epsilon > 0.7\) | F1 takriban %86,5 | Inaelezwa kuwa graph fragmentation hutokea. |
| Thamani iliyochaguliwa | \(\epsilon=0.5\) | Imechaguliwa na chanzo kama usawa unaofaa zaidi kati ya uchujaji wa kelele na structural integrity. |
Transformer self-attention inafanya nini?
Mlinganyo msingi wa attention wa encoder ya wakati ni:
\[ Attention(Q,K,V) = softmax \left( \frac{QK^T}{\sqrt{d_k}} \right)V \tag{3} \]
\(Q\): Matriki ya Query.
\(K\): Matriki ya Key.
\(V\): Matriki ya Value.
\(d_k\): Ni ukubwa wa Key vector.
\(QK^T\) huzalisha alama za uhusiano kati ya uwakilishi tofauti wa wakati/nodi. Kuweka kiwango kwa \(\sqrt{d_k}\) hutumiwa kupunguza uwezekano wa inner product kubwa kufanya softmax iwe kali kupita kiasi. Matokeo ya Softmax huwa attention weights na uzito huu hutumika juu ya \(V\).
Utafiti una Transformer ya tabaka sita inayotumia attention head nane. Hidden dimension ni 512. Muundo wa multi-head unalenga kuruhusu modeli kuchunguza kwa wakati mmoja mahusiano tofauti katika representation subspace tofauti.
Graph convolution inafanya nini?
Kwa spatial encoder, chanzo kinatoa mlinganyo ufuatao:
\[ h_i' = \sigma \left( \sum_{j\in\mathcal{N}(i)} \frac{1}{c_{ij}} W h_j \right) \tag{4} \]
\(h_i'\): Ni representation iliyosasishwa ya nodi \(i\).
\(\mathcal{N}(i)\): Ni seti ya ujirani ya nodi \(i\).
\(h_j\): Ni representation ya sasa ya nodi jirani \(j\).
\(W\): Ni matriki ya ugeuzaji inayoweza kujifunzwa.
\(c_{ij}\): Ni kipengele cha normalization katika mlinganyo wa chanzo; makala haitoi ufafanuzi wake wa kina kando.
\(\sigma\): Ni nonlinear activation function.
Operesheni hii husasisha representation ya nodi si kwa taarifa yake pekee, bali pia kwa taarifa za majirani zake kwenye graph inayobadilika.
Federated Differential Privacy Inatoaje Ulinzi katika Mfumo Huu?
Federated differential privacy inategemea kila kifaa kusasisha modeli juu ya data yake ya ndani bila kuhamisha trafiki ghafi ya mtandao kwenda seva kuu, kushiriki masasisho ya modeli pekee kwa aggregation, na kupunguza athari ya training sample moja kwenye sasisho la modeli kwa kutumia gradient clipping na Gaussian noise; chanzo kinaripoti \(\sigma=0.1\), takriban \(\epsilon=2.4\) na \(\delta=10^{-5}\).
Feature decoupling
Chanzo kinachukulia gradient ya ndani kama vipengele viwili:
- Structural component: \(\nabla_{\theta}^{str}\), kipengele kinachobeba taarifa ya graph/topology.
- Task component: \(\nabla_{\theta}^{tsk}\), kipengele kinachohusiana na kazi ya classification.
Waandishi wanaeleza kuwa kutumia clipping threshold kubwa zaidi kwa structural component husaidia kuhifadhi topological features muhimu, huku clipping kali zaidi katika task component ikisaidia ulinzi wa privacy. Chanzo hakitoi thamani kamili za namba za threshold hizi mbili.
Mlinganyo 5: Usasishaji wa modeli ya ndani
\[ \theta_i = \theta_i - \eta\nabla_{\theta}\mathcal{L}(\theta_i) \tag{5} \]
\(\theta_i\): Ni vigezo vya modeli ya ndani ya kifaa \(i\).
\(\eta\): Ni Learning rate.
\(\nabla_{\theta}\mathcal{L}(\theta_i)\): Ni gradient ya loss ya ndani kwa mujibu wa vigezo.
Kila kifaa huhesabu gradient kutoka local training data yake na kusasisha modeli yake.
Mlinganyo 6: Global model aggregation
\[ \theta_{global} = \frac{1}{N} \sum_{i=1}^{N} \theta_i \tag{6} \]
Chanzo kinaonyesha wastani rahisi wa kihesabu wa local model parameters kwenye seva kuu. \(N\) inawakilisha idadi ya device/client wanaoshiriki katika aggregation.
Chanzo hakitoi kwenye Mlinganyo 6 fomula tofauti ya aggregation yenye uzito kulingana na idadi ya client sample.
Mlinganyo 7: Noise injection
\[ \theta_i^{priv} = \theta_i + \mathcal{N}(0,\sigma^2) \tag{7} \]
Usemi huu unaonyesha kuongezwa kwa Gaussian noise yenye wastani sifuri kwenye local update. Chanzo pia kinataja adaptive clipping katika maelezo yanayozunguka mlinganyo huu; umbo la kihisabati lenye maelezo zaidi la clipping linatolewa baadaye katika Mlinganyo 12.
Hatua ya DP-SGD clipping
Chanzo kinazuia gradient norm kwa threshold \(C\):
\[ \hat{g}_t = \frac{g_t} {\max\left(1,\frac{\lVert g_t\rVert_2}{C}\right)} \]
Ikiwa \(\lVert g_t\rVert_2\leq C\), kiwango cha juu kwenye denominator huwa 1 na gradient haibadiliki. Ikiwa gradient norm inazidi \(C\), gradient hudumishwa katika mwelekeo uleule huku ukubwa wake ukipunguzwa.
Mlinganyo 12: Noisy parameter update baada ya clipping
\[ \theta_{t+1} = \theta_t - \eta\cdot Adam \left( \hat{g}_t+ \mathcal{N}(0,\sigma^2 C^2 I) \right) \tag{12} \]
Katika mipangilio ya majaribio chanzo kinatoa:
- \(\eta=1\times10^{-4}\),
- \(\sigma=0.1\),
- \(\epsilon\approx2.4\),
- \(\delta=10^{-5}\),
- privacy-accounting horizon = 100 training epoch
kama thamani zake.
\(\epsilon\) na \(\delta\) ni vigezo vya differential privacy. Kwa ujumla, privacy budget ndogo inaweza kumaanisha faragha yenye nguvu zaidi; hata hivyo, katika utafiti huu tathmini ya utendaji/faragha inapaswa kuzingatiwa tu katika muktadha wa masharti yaliyotolewa na chanzo.
Abstract inaeleza kuwa mashambulizi ya membership inference yalifikia kiwango cha chini zaidi cha mafanikio chini ya privacy budget ileile. Hata hivyo, kwa kuwa sehemu kuu ya matokeo haitoi jedwali tofauti la namba au maelezo ya majaribio ya membership-inference success rate, dai hili haliwezi kupanuliwa kwa kiasi.
Gradient compression
Abstract, discussion na tathmini ya efficiency zinataja mikakati ya federated gradient compression. Hata hivyo, maandishi yaliyochapishwa ya mbinu hayaripoti umbo la compression operator, compression ratio au algorithm ya quantization/sparsification iliyotumika kwa mlinganyo tofauti. Kwa hiyo exact implementation ya gradient compression haiwezi kuzalishwa tena kwa maelezo kamili kutoka chanzo.
Kutoka ugunduzi wa shambulizi hadi uamuzi wa ulinzi
Katika utafiti, network state \(s\) inajumuisha viashiria kama kasi za trafiki, protocol distributions na anomaly scores vinavyotolewa kutoka dirisha la wakati la sasa. Spatio-temporal Transformer huzalisha state representation hii na reinforcement-learning agent huchagua hatua ya ulinzi.
Mlinganyo 8: Usasishaji wa Q-learning
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+ \gamma \max_{a'}Q(s',a') - Q(s,a) \right] \tag{8} \]
\(s\): Network state ya sasa.
\(a\): Defense action iliyochaguliwa.
\(r\): Reward baada ya hatua.
\(s'\): Network state inayofuata.
\(\alpha\): Ni mgawo wa Q-learning update; chanzo hakitoi thamani ya namba ya \(\alpha\) kwa mlinganyo huu.
\(\gamma\): Ni discount factor inayoamua thamani ya sasa ya reward za baadaye. Katika sehemu ya DQN loss, chanzo kinatumia \(\gamma=0.9\).
Reward function
\[ r= w_1\cdot \mathbf{1}(\mathrm{Correct\ Response}) - \left( w_2 L+w_3F \right) \]
\(\mathbf{1}(\mathrm{Correct\ Response})\): Ni indicator inayoonyesha hali ya kuzuia shambulizi kwa mafanikio.
\(L\): Ni response latency.
\(F\): Ni false-positive cost.
\(w_1,w_2,w_3\): Ni hyperparameters zinazorekebishwa kulingana na security requirement. Chanzo hakiripoti thamani za namba za uzito huu.
Muundo huu wa reward hautoi tu tuzo kwa mafanikio ya kuzuia shambulizi; pia huhesabu response latency kubwa na false-positive cost kama adhabu.
Global multi-objective loss
\[ \mathcal{L}(\theta) = \mathcal{L}_{CE}(\theta) + \lambda_{Defense} \mathcal{L}_{Defense}(\theta) + \lambda_{reg} \mathcal{L}_{reg}(\theta) \tag{9} \]
Chanzo kinatumia:
\[ \lambda_{Defense}=0.5 \]
na
\[ \lambda_{reg}=1\times10^{-4} \]
kama thamani zake.
\(\mathcal{L}_{CE}\) inawakilisha attack-detection classification error, \(\mathcal{L}_{Defense}\) inawakilisha reinforcement-learning defense loss, na \(\mathcal{L}_{reg}\) inawakilisha regularization term inayopunguza overfitting.
Mlinganyo 10: Binary cross-entropy
\[ \mathcal{L}_{CE}(\theta) = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log(\hat{y}_i) + (1-y_i)\log(1-\hat{y}_i) \right] \tag{10} \]
\(y_i\in\{0,1\}\) inawakilisha lebo halisi, \(\hat{y}_i\) inawakilisha uwezekano wa shambulizi unaotolewa na modeli, na \(N\) inawakilisha batch size.
Loss huongezeka modeli inapotoa attack probability ndogo kwa shambulizi halisi au attack probability kubwa kwa sampuli halisi ya kawaida.
Mlinganyo 11: DQN Temporal Difference loss
\[ \mathcal{L}_{Defense}(\theta) = \mathbb{E}_{(s,a,r,s')} \left[ \left( r+ \gamma \max_{a'} Q(s',a';\theta^-) - Q(s,a;\theta) \right)^2 \right] \tag{11} \]
\(\theta\): Ni vigezo vya Current Q-network.
\(\theta^-\): Ni vigezo vya target network vinavyogandishwa kwa vipindi maalum.
\(\gamma=0.9\): Discount factor.
Loss inalenga kupunguza mraba wa kosa la Temporal Difference kati ya Q-value ya sasa na Bellman target.
Mbinu na Matokeo ya Utafiti
Seti za data na preprocessing
| Seti ya data | Muktadha | Ukubwa wa feature | Table 1 train / validation / test | Preprocessing |
|---|---|---|---|---|
| UNSW-NB15 | General network-attack detection; chanzo kinaeleza kuwa ina 9 attack type. | d = 42 | 50k / 5k / 10k | Standardization |
| BoT-IoT | Trafiki ya mtandao ya IoT/IIoT; DDoS, DoS, scanning na attack types nyingine | d = 10 core network feature | 100k / 10k / 20k | Min-Max normalization |
Chanzo kinafafanua kazi ya modeli kama binary classification ya kawaida/shambulizi. Kwa hiyo, ingawa seti za data zina familia nyingi za mashambulizi, objective kuu na Mlinganyo 10 hutumia muundo wa binary label.
Kwa UNSW-NB15, maandishi ya mbinu pia yanaeleza uwiano wa training/validation/testing kama %50/%10/%40 mtawalia. Hata hivyo, namba 50k/5k/10k zinazotolewa katika Table 1 hazilingani na asilimia hizi. Verianla haisahihishi kimya kimya moja ya taarifa hizi mbili tofauti za chanzo.
Kuonekana kwa anuani ileile ya mradi wa BoT-IoT katika mistari ya UNSW-NB15 na BoT-IoT kwenye safu ya “Source / Acquisition Method” ya Table 1 pia ni sifa ya namna jedwali la chanzo lilivyowasilishwa. Verianla haiizalishi tena kama anuani halisi ya chanzo cha UNSW-NB15.
Je, manual feature selection ilitumika?
Hapana. Chanzo kinaeleza kuwa hakuna manual feature selection ya ziada iliyotumika kabla ya seti zote mbili za data kuingizwa kwenye spatio-temporal encoder. Lengo ni kutathmini uwezo wa end-to-end feature extraction wa modeli.
Modeli na maunzi
| Kipengee | Thamani ya chanzo |
|---|---|
| GPU | NVIDIA GeForce RTX 3080, 10 GB VRAM |
| Framework | PyTorch 1.10 |
| CUDA | 11.2 |
| Tabaka la Transformer | 6 |
| Hidden dimension | 512 |
| Attention head | 8 |
| Optimizer | Adam |
| Initial learning rate | \(1\times10^{-4}\) |
| \(\lambda_{Defense}\) | 0.5 |
| \(\lambda_{reg}\) | \(1\times10^{-4}\) |
| DP noise multiplier | \(\sigma=0.1\) |
| Random seed | 42 |
Sehemu ya Experimental Setup inatoa Gaussian noise standard deviation ya 0.05 kwa robustness testing. Robustness validation ya baadaye inaripoti sweep pana zaidi inayoongeza noise standard deviation kutoka 0 hadi 0.2.
Tofauti ya ndani ya chanzo kuhusu idadi ya marudio
Mwishoni mwa Experimental Setup, chanzo kinatumia kauli “results are reported as the mean ± standard deviation over 5 runs”. Katika sehemu ya Quantitative Results, kwa upande mwingine, kinasema “all experiments were repeated 10 times”. Kichwa cha Table 4 pia kinaonyesha wazi n=10.
Kwa hiyo si salama kuandika upya idadi ya marudio kama namba moja ya uhakika kwa majaribio yote. Thamani za mean ± standard deviation zinazoonekana katika Table 3–4 zimehifadhiwa kama zilivyochapishwa kwenye chanzo.
Vipimo vya tathmini
Chanzo kinatumia Accuracy, Precision, Recall na F1-Score:
\[ Accuracy= \frac{TP+TN} {TP+TN+FP+FN} \]
\[ Precision= \frac{TP}{TP+FP} \]
\[ Recall= \frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
TP inawakilisha ugunduzi sahihi wa mashambulizi, TN maamuzi sahihi ya trafiki ya kawaida, FP tahadhari ya shambulizi isiyo sahihi kwa trafiki ya kawaida, na FN mashambulizi halisi yaliyokosa kugunduliwa.
Mbinu za baseline
- LSTM-IDS: Recurrent baseline inayounda modeli ya temporal dependencies.
- FedIDS: Intrusion-detection baseline inayotegemea federated-learning.
- DP-GNN: Privacy-preserving baseline inayounganisha differential privacy na graph convolution.
- RustGraph: Baseline inayounda modeli ya structural-temporal dependency kwa dynamic graph anomaly detection.
Ulinganisho mkuu wa utendaji
| Mbinu | Seti ya data | Accuracy | FPR | F1 | Training Time | p-value |
|---|---|---|---|---|---|---|
| LSTM-IDS | UNSW-NB15 | 87.2% ± 0.6% | 5.2% ± 0.3% | 86.4% ± 0.5% | 1200 ± 120 s | <0.001 |
| LSTM-IDS | BoT-IoT | 84.5% ± 0.8% | 6.8% ± 0.4% | 83.9% ± 0.7% | 1500 ± 150 s | <0.001 |
| FedIDS | UNSW-NB15 | 89.5% ± 0.5% | 3.8% ± 0.2% | 88.7% ± 0.6% | 1300 ± 130 s | 0.002 |
| FedIDS | BoT-IoT | 87.0% ± 0.7% | 4.5% ± 0.3% | 86.2% ± 0.8% | 1600 ± 160 s | 0.001 |
| DP-GNN | UNSW-NB15 | 90.3% ± 0.4% | 3.1% ± 0.2% | 89.5% ± 0.5% | 1400 ± 140 s | 0.005 |
| DP-GNN | BoT-IoT | 88.5% ± 0.6% | 3.9% ± 0.3% | 87.8% ± 0.7% | 1700 ± 170 s | 0.003 |
| RustGraph | UNSW-NB15 | 91.2% ± 0.3% | 2.4% ± 0.1% | 90.5% ± 0.4% | 1500 ± 150 s | 0.01 |
| RustGraph | BoT-IoT | 90.0% ± 0.5% | 3.0% ± 0.2% | 89.2% ± 0.6% | 1800 ± 180 s | 0.008 |
| Proposed Method | UNSW-NB15 | 93.5% ± 0.2% | 1.2% ± 0.1% | 92.8% ± 0.3% | 1100 ± 110 s | — |
| Proposed Method | BoT-IoT | 92.0% ± 0.4% | 1.8% ± 0.2% | 91.3% ± 0.5% | 1400 ± 140 s | — |
Proposed Method huzalisha accuracy na F1 za juu zaidi katika jedwali la chanzo kwenye seti zote mbili za data, na wakati huohuo FPR za chini zaidi.
Kwenye BoT-IoT, kwa kuwa proposed accuracy ni %92,0 na DP-GNN accuracy ni %88,5, tofauti ni:
\[ 92.0-88.5=3.5 \]
pointi 3,5 za asilimia. Usemi huu si relative percentage increase, bali ni tofauti kamili ya percentage-point kati ya asilimia mbili za accuracy.
Katika safu ya p-value ya Table 3 kuna thamani kwa baseline na significance level imeelezwa kuwa 0.05. Hata hivyo, chanzo hakiripoti kwa kina jina la exact statistical test iliyotumika wala exact null hypothesis ya safu ya p-value. Kwa hiyo Verianla haijakisia ni jaribio gani lililotumika kutengeneza p-values.
Matokeo ya convergence
Chanzo kinaeleza katika Figure 5 kwamba proposed method ilifikia kiwango cha takriban %90 accuracy kwenye UNSW-NB15 karibu na epoch ya 80, huku RustGraph ikihitaji zaidi ya 92 epoch kufikia kiwango kinachofanana.
Chanzo kinahusisha tabia hii ya convergence ya haraka zaidi na adaptive graph structure pamoja na spatio-temporal attention kupunguza gradient propagation kupitia redundant connections. Ufafanuzi huu wa utaratibu ni maelezo ya waandishi.
Matokeo ya efficiency
| Mbinu | Parameta (M) | FLOPs (G) | Training Time (s/epoch) | Inference Latency (ms/sample) |
|---|---|---|---|---|
| LSTM-IDS | 2.1 ± 0.0 | 4.8 ± 0.1 | 15.0 ± 0.8 | 1.2 ± 0.1 |
| FedIDS | 3.4 ± 0.1 | 7.2 ± 0.3 | 16.3 ± 0.9 | 1.8 ± 0.2 |
| DP-GNN | 5.7 ± 0.2 | 12.5 ± 0.5 | 17.5 ± 1.0 | 2.5 ± 0.3 |
| RustGraph | 6.9 ± 0.3 | 15.0 ± 0.6 | 18.8 ± 1.1 | 3.0 ± 0.2 |
| Proposed Method | 7.2 ± 0.2 | 14.8 ± 0.5 | 13.8 ± 0.7 | 2.1 ± 0.2 |
Proposed Method ndiyo modeli kubwa zaidi kwa idadi ya parameta: parameta milioni 7,2. Hata hivyo, ikilinganishwa na training time ya RustGraph ya 18,8 s/epoch, inatoa 13,8 s/epoch, na dhidi ya inference latency ya 3,0 ms/sample inatoa 2,1 ms/sample.
Chanzo kinaeleza kuwa, ikilinganishwa na RustGraph, training time ni takriban %26,6 chini na inference latency ni %30 chini. Pia kinaripoti kuwa GNN-based baseline hidden dimensions zilisawazishwa ili kutoa parameter scale inayofanana.
Je, Inference Latency ya 2,1 ms Inathibitisha Mafanikio ya Wakati Halisi Uwanjani?
Hapana. Chanzo kinaeleza kuwa thamani ya 2,1 ± 0,2 ms/sample ni kipimo chake cha majaribio cha end-to-end inference kinachojumuisha dynamic graph construction, feature extraction na Transformer forward pass, na kwamba inalingana na uwezo wa kuchakata takriban 500 traffic sample/s; hata hivyo, kipimo kilifanywa kwa data za benchmark kwenye RTX 3080 GPU na si deployment ya muda mrefu ya uwanjani kwenye kifaa halisi cha edge, gari la V2X au mtandao wa uzalishaji.
Kihisabati:
\[ \frac{1}{0.0021\;s} \approx476\;sample/s \]
hupatikana. Kauli ya chanzo ya “nearly 500 traffic samples per second” inalingana na thamani hii ya makadirio.
Hata hivyo, katika sehemu ya discussion chanzo kinakubali wazi kwamba adaptive graph construction huleta computation overhead ya ziada kwenye micro-IoT node zenye rasilimali zilizobanwa sana na kwamba uboreshaji unahitajika.
Mfano wa ubora uliofanikiwa
Katika mfano uliowekwa lebo “UNSW-NB15 – DoS Hulk”, chanzo kinaripoti kuwa ndani ya attack window ya sekunde 28–32 idadi ya miunganisho mipya kwenda target host iliongezeka kutoka baseline average ya 24,3 connection/s hadi peak ya 3872 connection/s.
Safu ya normal fluctuation imetolewa kama takriban ±2σ ≈ 60. Proposed Method iliainisha shambulizi kama DoS kwa %96,7 confidence.
Katika t=30 s, attention weights zilikuwa:
| Feature | Attention weight |
|---|---|
| Connection burstiness | 0.42 |
| Destination port diversity | 0.38 |
LSTM-IDS iliainisha kimakosa mfano huohuo kama trafiki ya kawaida kwa %58,1 confidence.
Dokezo la uainishaji wa chanzo: Makala inaita wazi kisa hiki “UNSW-NB15 – DoS Hulk Attack Detection”. Maandishi yaliyochapishwa hayaelezi kando uhusiano wa jina hili la shambulizi na taksonomia ya seti ya data. Verianla haibadilishi lebo ya chanzo wala kubuni maelezo yanayokosekana.
Kwa Nini Modeli Ilishindwa katika Uchunguzi wa Masafa ya Chini Sana?
Katika mfano wa low-speed port-scan uliotolewa na chanzo, kwa sababu ishara ya shambulizi ilikuwa karibu sana na trafiki ya kawaida ya IoT heartbeat, federated clients ziliona mwonekano mdogo tu wa ndani, na \(\sigma=0.1\) differential-privacy noise ilikandamiza anomaly gradient dhaifu, dynamic graph haikuweza kuunda anomaly edge zenye maana na modeli iliainisha shambulizi kama trafiki ya kawaida.
| Kipengee | Thamani ya chanzo |
|---|---|
| Masafa ya probe | probe 1 kila dakika 6 |
| Uangalizi wa jumla | dakika 30 |
| Probe jumla | 5 |
| Attack packet rate | 0.8 pkt/s |
| Safu ya kawaida ya IoT heartbeat | 0.7–1.1 pkt/s |
| Adjacency matrix sparsity | 99.6% |
| Uamuzi wa modeli | Normal registration behavior |
| Confidence | 62.3% |
| DP noise | \(\sigma=0.1\) |
Chanzo kinapendekeza kwamba katika siku zijazo taratibu kama cross-device meta-event correlations au unsupervised anomaly priors zinaweza kusaidia tatizo hili la information-scarcity. Haya si matokeo yaliyothibitishwa katika jaribio la sasa.
Noise robustness
Gaussian noise ilipoongezwa kwenye input features, standard deviation iliongezwa kutoka 0 hadi 0.2. Accuracy ya Proposed Method ilishuka kutoka %93,5 hadi %89,3, huku RustGraph ikishuka hadi %83,2 na DP-GNN hadi %84,6.
| Mbinu | Mwanzo / rejea | Matokeo katika hali ya Noise std = 0.2 |
|---|---|---|
| Proposed Method | 93.5% accuracy | 89.3% accuracy |
| RustGraph | Chanzo hakirudii thamani ya mwanzo katika sentensi hii. | 83.2% accuracy |
| DP-GNN | Chanzo hakirudii thamani ya mwanzo katika sentensi hii. | 84.6% accuracy |
Kwa kuwa chanzo hakitoi pointi zote za kati za namba za curve ya Figure 7 kama jedwali, Verianla haifanyi interpolation ya thamani za kati.
Chanzo pia kinaeleza kwamba accuracy ilishuka hadi %83,5 wakati “spatial attention module” ilipoondolewa. Kauli hii ipo katika maelezo tofauti ya robustness na uainishaji wa moduli wa Table 5.
Cross-Dataset Direct Transfer Ilijaribiwaje?
Jaribio la cross-dataset generalization lilifanywa kwa kufundisha proposed model kwenye UNSW-NB15 na kuijaribu moja kwa moja kwenye BoT-IoT bila fine-tuning yoyote; chanzo kinaripoti kwamba proposed model ilidumisha F1 juu ya %91 katika pande zote mbili na kuizidi RustGraph kwa pointi 2,1 za asilimia kwenye BoT-IoT lengwa.
Jaribio hili ni kipimo chenye nguvu zaidi cha distribution-shift kuliko tathmini ya kawaida ya train/test ndani ya dataset ileile, kwa sababu modeli haikurekebishwa upya kwa seti ya data lengwa.
Chanzo kinaeleza kuwa BoT-IoT lengwa ina unseen attack variants kama hybrid DDoS. Waandishi wanadai kwamba mchanganyiko wa dynamic graph structure na local-global federated modeling wa Proposed Method una jukumu katika kuzoea distribution shift hii.
Hata hivyo, matokeo ya cross-dataset si uthibitisho wa universal generalization kwa kila mazingira ya mtandao katika ulimwengu halisi. Yanaunga mkono tu hali ya transfer ya UNSW-NB15 → BoT-IoT iliyojaribiwa katika chanzo.
Uchambuzi wa ablation
| Toleo la modeli | UNSW-NB15 | BoT-IoT |
|---|---|---|
| Full Model | 93.5 / 92.8 | 92.0 / 91.3 |
| Adaptive Spatio-Temporal Graph Generation iliondolewa | 90.1 / 89.4 | 88.7 / 87.9 |
| Federated Differential Privacy iliondolewa; Centralized Training | 92.8 / 92.0 | 91.2 / 90.5 |
| Reinforcement Learning Dynamic Defense Module iliondolewa | 93.2 / 92.5 | 91.7 / 91.0 |
| GCN+LSTM badala ya Spatio-Temporal Transformer | 89.6 / 88.7 | 87.4 / 86.5 |
| Base GNN Only | 87.3 / 86.1 | 84.9 / 83.8 |
Kwa F1 ya BoT-IoT, full model ni %91,3. Adaptive graph inapoondolewa hushuka hadi %87,9, na hivyo kupoteza pointi 3,4 za percentage-point. Spatio-temporal Transformer inapobadilishwa na GCN+LSTM hushuka hadi %86,5; upotevu ni pointi 4,8 za percentage point.
Utaratibu wa federated differential privacy unapobadilishwa na centralized training, F1 ya BoT-IoT hushuka kutoka %91,3 hadi %90,5; tofauti ni pointi 0,8 za percentage point.
RL dynamic-defense module inapoondolewa, F1 ya BoT-IoT hushuka tu kutoka %91,3 hadi %91,0. Chanzo kinatafsiri tofauti hii ndogo ya classification kama matokeo yanayotarajiwa kwa sababu kazi kuu ya tabaka la reinforcement-learning si classification bali kuchagua response strategy baada ya shambulizi.
Muundo wa Base GNN Only ndio toleo dhaifu zaidi kwenye BoT-IoT kwa F1 ya %83,8. Chanzo kinatafsiri matokeo haya kama finding ya ablation inayounga mkono kwamba graph representation pekee haitoshi na kwamba spatio-temporal attention ina mchango muhimu.
Privacy–utility trade-off
Ablation inaonyesha kuwa kuondoa utaratibu wa federated differential privacy hakusababishi tofauti kubwa kwenye accuracy/F1 kama vipengele vingine vya kati vya usanifu. Chanzo kinatafsiri hili kama ushahidi kwamba privacy protection inaweza kutekelezwa kwa utility loss ndogo zaidi.
Hata hivyo, kwa kuwa membership-inference success rate ya utaratibu wa privacy haijatolewa kwa kiasi katika majedwali makuu ya matokeo, tathmini ya privacy–utility inaweza kufuatiliwa hasa kupitia differential-privacy parameters, detection metrics na matokeo ya ablation.
Matokeo yanayoungwa mkono na utafiti
- Mchanganyiko wa adaptive spatio-temporal graph na Transformer ulizalisha accuracy na F1 za juu kuliko baseline kwenye benchmark zote mbili zilizotumika.
- Proposed Method ilipata %93,5 ± %0,2 accuracy na %92,8 ± %0,3 F1 kwenye UNSW-NB15.
- Proposed Method ilipata %92,0 ± %0,4 accuracy na %91,3 ± %0,5 F1 kwenye BoT-IoT.
- Kwenye BoT-IoT, proposed accuracy ni pointi 3,5 za percentage point juu kuliko DP-GNN.
- FPR imeripotiwa kama %1,2 ± %0,1 kwenye UNSW-NB15 na %1,8 ± %0,2 kwenye BoT-IoT.
- Jaribio la UNSW-NB15 → BoT-IoT direct-transfer lilifanywa bila fine-tuning.
- Ablation za Adaptive graph na Transformer zilisababisha kushuka kubwa zaidi kwa utendaji wa modeli.
- Kubadilisha utaratibu wa federated differential privacy na centralized training kulisababisha tofauti ya F1 chini ya %1 ikilinganishwa na full model.
- Katika mazingira ya majaribio ya RTX 3080, end-to-end inference latency ilipimwa kuwa 2,1 ± 0,2 ms/sample.
- Input noise std ilipoongezwa hadi 0,2, proposed accuracy ilishuka hadi %89,3 lakini ikabaki juu kuliko baselines zilizolinganishwa katika chanzo.
- Mfano wa ultra-low-frequency scanning unaonyesha mpaka muhimu wa kushindwa kwa modeli.
Matokeo ambayo utafiti hauungi mkono au umeacha bila maelezo kamili
- Utendaji wa muda mrefu wa uwanjani katika mtandao halisi wa magari wa V2X au commercial IoT deployment haujaonyeshwa.
- Matokeo ya 2,1 ms hayahakikishi kwamba latency ileile itapatikana kwenye maunzi yote ya micro-IoT.
- Matokeo ya transfer ya UNSW-NB15 → BoT-IoT hayathibitishi kwamba generalization ileile itatokea katika kila eneo lisilojulikana la data ya mtandao.
- Ultra-low-frequency stealth attacks hazijatatuliwa.
- Ingawa kupungua kwa kiwango cha mafanikio ya mashambulizi ya membership inference kumeripotiwa kwenye abstract, hakuna thamani ya kiasi wala itifaki ya kina katika mwili mkuu.
- Exact implementation, compression ratio na maelezo ya operator ya gradient-compression algorithm hayajaripotiwa.
- Thamani ya namba ya sliding temporal window size \(K\) haijaripotiwa.
- Thamani za structural na task gradient clipping threshold hazijaripotiwa kando.
- Reward weights \(w_1,w_2,w_3\) hazijatolewa kwa namba.
- Jina exact la statistical test inayozalisha p-value za Table 3 halijaripotiwa.
- Chanzo kina kutolingana kati ya kauli za 5 run na 10 repeat.
- Uwiano wa %50/%10/%40 ulioandikwa kwa UNSW-NB15 haulingani na namba 50k/5k/10k za Table 1.
Mapungufu na kazi za baadaye
Chanzo kinaeleza kuwa kizuizi kinachoonekana zaidi ni extremely low-frequency stealth attacks. Kuwa na local views chache kwa federated learning clients na differential-privacy noise kukandamiza low-amplitude anomaly gradients hufanya detection kuwa ngumu hasa kwa mashambulizi ya nadra.
Inaelezwa kuwa, ingawa adaptive graph construction hufanya kazi ndani ya overall latency ya 2,1 ms, inaweza kuleta energy/computation overhead ya ziada kwenye micro-IoT node zenye rasilimali zilizobanwa sana.
Kazi za baadaye zinazopendekezwa ni pamoja na kushiriki lightweight meta-event summary kati ya clients, kutumia Secure Multi-Party Computation au highly aggregated statistics, event-driven sparse graph updates, fully unsupervised au open-set anomaly detection, na uboreshaji wa graph-construction kwa micro-embedded devices.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A Spatio-Temporal Transformer-Based Approach for Network Attack Detection
Waandishi na mpangilio: Xin Liu; Xiang Liu.
Corresponding author: Xin Liu; ameonyeshwa kwa alama ya nyota katika chanzo.
Taasisi ya Xin Liu: School of Advanced Engineering, University of Science and Technology Beijing, Beijing 100083, China.
Barua pepe ya Xin Liu: u202341641@xs.ustb.edu.cn
Taasisi ya Xiang Liu: School of International Education, Beijing University of Chemical Technology, Beijing 102203, China.
Barua pepe ya Xiang Liu: 2024090034@mail.buct.edu.cn
Mchango sawa / uandishi mwenza wa kwanza: Chanzo hakina tamko la mchango sawa.
Jarida: Journal of Universal Computer Science.
Kifupi: J.UCS.
Juzuu / namba: Volume 32, Number 9.
Kurasa: 1375–1398.
Mwaka wa uchapishaji: 2026.
Submitted: 23 Januari 2026.
Accepted: 7 Julai 2026.
Appeared / Published: 14 Septemba 2026.
DOI: 10.3897/jucs.207303.
Kiungo rasmi cha DOI: https://doi.org/10.3897/jucs.207303
Aina ya chanzo: Makala asili ya utafiti iliyochapishwa.
Hali ya mapitio ya kitaalamu: Journal of Universal Computer Science ni jarida linalopitiwa na wataalamu; wasifu rasmi wa sasa wa jarida unaeleza single-blind review na angalau editorial-board reviewer wawili.
Leseni ya makala: CC BY 4.0; imeelezwa wazi kwenye ukurasa wa kwanza wa PDF ya makala.
Tatizo kuu: Kushughulikia ndani ya framework moja malengo ya accuracy ya juu, privacy preservation na low-latency attack detection/response chini ya dynamic network topology.
Uundaji wa kazi: Binary classification; \(y=0\) kawaida, \(y=1\) malicious traffic.
Moduli kuu tatu: Spatio-temporal feature extraction; federated differential-privacy protection; reinforcement-learning attack detection/defense.
Dynamic graph: Time-dependent adjacency matrix inayotegemea communication relationships na traffic-feature similarity.
Graph threshold: Sehemu ya mbinu ina learnable \(\epsilon\); sensitivity analysis inaripoti \(\epsilon=0.5\) kama thamani iliyochaguliwa.
Threshold sensitivity: Kwa \(\epsilon\in[0.4,0.6]\), F1 > %91; kwa \(\epsilon>0.7\), F1 takriban %86,5.
Transformer: 6 layer, hidden dimension 512, 8-head multi-head attention.
Federated aggregation: Chanzo kinaonyesha wastani rahisi wa local model parameters katika Mlinganyo 6.
Differential privacy: DP-SGD, gradient clipping na Gaussian noise.
DP noise multiplier: \(\sigma=0.1\).
Privacy budget: Takriban \(\epsilon=2.4\), \(\delta=10^{-5}\), hali iliyoripotiwa na chanzo baada ya 100 epoch.
Feature decoupling: Mgawanyo katika structural gradient na task gradient; namba kamili za clipping threshold haziripotiwi.
Gradient compression: Imetajwa na chanzo kama kipengele; exact compression algorithm na uwiano haviripotiwi.
Reinforcement learning: Q-learning / Deep Q-Network.
DQN discount factor: \(\gamma=0.9\).
Defense actions: Chanzo kinatoa traffic limiting na data filtering kama mifano.
Reward: Huunganisha tuzo ya Correct response na adhabu za latency na false-positive cost; thamani za \(w_1,w_2,w_3\) haziripotiwi.
Global loss: Binary cross-entropy + defense TD loss + regularization.
\(\lambda_{Defense}\): 0.5.
\(\lambda_{reg}\): \(1\times10^{-4}\).
Optimizer: Adam.
Initial learning rate: \(1\times10^{-4}\).
UNSW-NB15 features: d = 42, bila ID na labels.
BoT-IoT features: d = 10 core network features.
UNSW preprocessing: Standardization.
BoT-IoT preprocessing: Min-Max normalization.
Manual feature selection: Haikutumika.
Table 1 sample split: UNSW-NB15 50k / 5k / 10k; BoT-IoT 100k / 10k / 20k.
Tofauti ya partition ndani ya chanzo: Maandishi yanatoa uwiano wa %50/%10/%40 kwa UNSW-NB15; namba 50k/5k/10k katika Table 1 hazilingani nao.
Maunzi: NVIDIA GeForce RTX 3080 GPU, 10 GB VRAM.
Programu: PyTorch 1.10, CUDA 11.2.
Random seed: 42.
Tofauti ya run-count ndani ya chanzo: Experimental Setup inasema 5 run mean ± std; Quantitative Results inasema 10 repeat na Table 4 inaonyesha n=10.
Significance level: 0.05.
Kikomo cha statistical-test: Table 3 inatoa p-value; jina exact la statistical-test na maelezo ya null-hypothesis hayajaelezwa wazi katika maandishi makuu.
Matokeo makuu ya UNSW-NB15: Accuracy 93.5% ± 0.2%; F1 92.8% ± 0.3%; FPR 1.2% ± 0.1%.
Matokeo makuu ya BoT-IoT: Accuracy 92.0% ± 0.4%; F1 91.3% ± 0.5%; FPR 1.8% ± 0.2%.
Ulinganisho wa DP-GNN: BoT-IoT accuracy 88.5% ± 0.6%; tofauti ya proposed +3.5 percentage point.
Inference latency: 2.1 ± 0.2 ms/sample.
Wigo wa inference: Dynamic graph construction + feature extraction + Transformer forward pass.
Proposed parameter count: 7.2 ± 0.2 million.
Proposed FLOPs: 14.8 ± 0.5 G.
Training time: 13.8 ± 0.7 s/epoch katika Table 4.
Cross-dataset test: Training kwenye UNSW-NB15 → direct testing kwenye BoT-IoT bila fine-tuning.
Matokeo ya cross-dataset: Chanzo kinaripoti kuwa proposed F1 ilibaki juu ya %91 kwenye seti zote mbili za data na ilikuwa pointi 2.1 za percentage point juu ya RustGraph kwenye BoT-IoT lengwa.
Noise robustness: Gaussian feature noise std 0→0.2; proposed accuracy 93.5%→89.3%.
Failure case muhimu: probe moja kila dakika 6, probe 5 ndani ya dakika 30, 0.8 pkt/s; normal heartbeat 0.7–1.1 pkt/s; adjacency sparsity 99.6%; normal prediction confidence 62.3%.
Dokezo la membership inference: Abstract inaeleza kuwa attack success rate ilipunguzwa kwa kiasi kikubwa chini ya privacy budget ileile; maandishi makuu hayana membership-inference success rate ya kiasi wala itifaki ya kina ya majaribio.
Matokeo ya ablation: BoT-IoT F1 full model 91.3%; no adaptive graph 87.9%; centralized/no federated DP 90.5%; no RL defense 91.0%; GCN+LSTM replacement 86.5%; base GNN only 83.8%.
Ufadhili: PDF iliyochunguzwa haina sehemu tofauti ya funding declaration.
Mgongano wa maslahi: PDF iliyochunguzwa haina conflict-of-interest declaration tofauti.
Data Availability: PDF iliyochunguzwa haina Data Availability statement tofauti; katika sehemu ya majaribio UNSW-NB15 na BoT-IoT zinafafanuliwa kama public datasets.
Michango ya waandishi / CRediT: PDF iliyochunguzwa haina author-contributions au CRediT declaration tofauti.
Kikomo msingi cha utafiti: Matokeo yanahusu seti za data benchmark na mazingira ya majaribio yanayotegemea RTX 3080; si uthibitishaji wa muda mrefu wa uwanjani kwenye micro-IoT node halisi, V2X fleet au production SOC.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *