


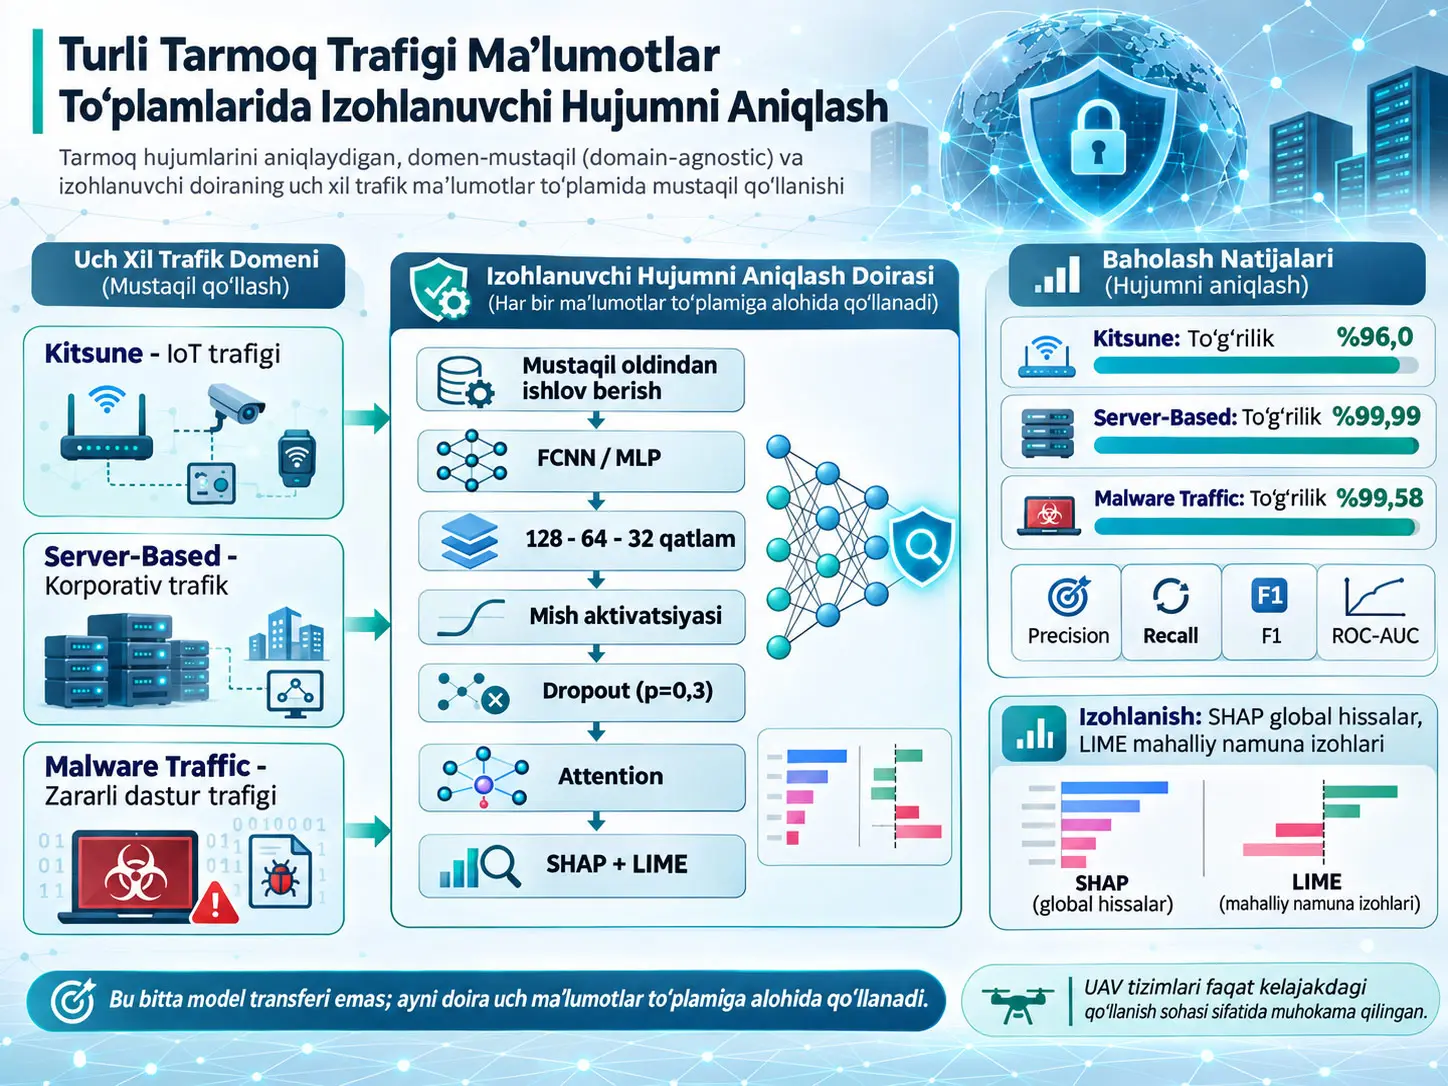
Domen-mustaqil izohlanuvchi tarmoq hujumlarini aniqlash doirasi, bir xil ma’lumot tayyorlash va Fully Connected Neural Network (FCNN) modellashtirish mantiqini IoT, korporativ server va zararli dastur trafigi kabi turli tarmoq ma’lumot domenlariga alohida qo‘llaydigan hamda model qarorlarini SHapley Additive exPlanations (SHAP) va Local Interpretable Model-Agnostic Explanations (LIME) yordamida tushuntirishni maqsad qilgan nazoratli tarmoq hujumlarini tasniflash yondashuvidir. Tadqiqotda Kitsune, Server-Based va Malware Traffic ma’lumotlar to‘plamlari mustaqil ravishda qayta ishlangan; sonli va kategorik xususiyatlar tayyorlangan; 128, 64 va 32 neyronli to‘liq bog‘langan qatlamlar, Mish aktivatsiyasi, dropout va attention o‘z ichiga olgan model qo‘llangan. Manba Kitsune uchun %96,0, Server-Based ma’lumotlar to‘plami uchun %99,99 va Malware Traffic uchun %99,58 accuracy haqida xabar beradi.
“Domain-agnostic” iborasi ushbu tadqiqotda bitta ma’lumotlar to‘plamida o‘qitilgan model boshqa ma’lumotlar to‘plamiga bevosita ko‘chirilganini anglatmaydi. Muallif xulosa bo‘limida cross-dataset transfer learning ko‘rsatilmaganini; bir xil modellashtirish pipeline’i uch xil tarmoq muhitiga mustaqil qo‘llanishi baholanganini ochiq aytadi. Shuning uchun tadqiqot umumiy usul arxitekturasining turli ma’lumot domenlarida qo‘llanishi mumkinligiga dalil beradi, biroq domenlar o‘rtasida qayta o‘qitmasdan bevosita model transferini tasdiqlamaydi.
Kitsune natijasi umumiy accuracy jihatidan kuchli bo‘lsa-da, sinflar kesimida bir xil emas. Table 3 da Class 2 uchun precision 0,72, recall 0,76 va F1 0,74; Class 4 uchun precision 0,75, recall 0,69 va F1 0,72 berilgan. Server-Based va Malware Traffic natijalari ancha yuqori ajralishni ko‘rsatadi. Shu sababli yuqori umumiy accuracy qiymatlari barcha hujum sinflari mukammal aniqlangan deb talqin qilinmasligi kerak.
SHAP tahlili belgilangan 100 validation namunasi ustida bajarilgan; LIME esa har bir ma’lumotlar to‘plamida faqat bitta vakillik validation namunasi va ko‘pi bilan 10 ta izohlovchi xususiyatga qo‘llangan. Manba bu izohlanuvchanlik vositalarini real vaqtda har bir paket uchun ishlaydigan inference komponenti sifatida emas, offline forensic analysis va post-incident investigation maqsadida joylashtiradi.
UAV xavfsizligi maqolaning haqiqiy tajriba sohasi emas. Tadqiqotda UAV telemetry, GPS o‘zgaruvchanligi, RF communication pattern yoki flight log ishlatilmagan. UAV tizimlari faqat kelajakda usul sinab ko‘rilishi mumkin bo‘lgan potensial qo‘llanish sohasi sifatida muhokama qilingan.
“Domain-Agnostic” Ushbu Tadqiqotda Nimani Anglatadi?
Ushbu tadqiqotda “domain-agnostic” bir xil umumiy preprocessing va FCNN asosidagi modellashtirish pipeline’ining Kitsune IoT trafigi, Server-Based korporativ trafik va Malware Traffic ma’lumotlariga ma’lumotlar to‘plamiga xos yangi model arxitekturasi loyihalanmasdan alohida-alohida qo‘llanishini anglatadi; tadqiqot bitta o‘qitilgan model turli ma’lumotlar to‘plamlari o‘rtasida transfer qilinganini yoki umumiy cross-dataset modelida test qilinganini ko‘rsatmaydi.
Tadqiqot muammosi
Tadqiqotning boshlang‘ich nuqtasi ikki muammodir. Birinchisi, intrusion detection modellarining ko‘pi bitta ma’lumotlar to‘plami va muayyan trafik taqsimotiga mos ishlab chiqilgani sababli boshqa tarmoq muhitlarida bir xil ishlash darajasini saqlay olmasligidir. Ikkinchisi, yuqori aniqlik beradigan chuqur o‘rganish tizimlarining nima uchun muayyan hujum qaroriga kelganini tushuntirishdagi qiyinchiligidir.
Bu ikki muammo ayniqsa xavfsizlik tahlilchilari faqat signal yorlig‘ini emas, qarorga qaysi trafik xususiyatlari ta’sir qilganini ham ko‘rishni istaydigan kritik tizimlarda muhimdir. Shu sababli tadqiqot tasniflash va post-hoc izohlanuvchanlikni bir xil baholash doirasida ko‘rib chiqadi.
Tadqiqotning uch ma’lumot domeni
| Ma’lumotlar to‘plami | Tarmoq domeni | Tajribada ishlatilgan namuna | Xususiyatlar soni | Sinflar soni |
|---|---|---|---|---|
| Kitsune | IoT tarmoq trafigi | 9.000; asl ma’lumot 20 milliondan ortiq namuna o‘z ichiga oladi | 115 | 9: 8 hujum + 1 benign |
| Server-Based | Korporativ/server trafigi | 225.398; ma’lumotlar to‘plamining barchasi | 27 | 3 |
| Malware Traffic | Zararli dastur aloqa trafigi | 644.602; asl ma’lumot 25 milliondan ortiq namuna o‘z ichiga oladi | 23 | 5 |
Kitsune ma’lumotlar to‘plami IoT asosidagi trafik va ARP spoofing, Mirai botnet hamda denial-of-service kabi hujum xatti-harakatlarini qamrab oladi. Manba 20 milliondan ortiq asl namunadan 9.000 namunali vakillik kichik to‘plami tanlanganini bildiradi. Biroq bu 9.000 namunaning aniq tanlash algoritmi yoki har sinf bo‘yicha aniq namuna olish tartibi batafsil berilmagan.
Malware Capture Facility manbali ma’lumot 25 milliondan ortiq yozuvdan iborat. Tadqiqotda 644.602 yozuv ishlatilgan. Bu ma’lumot command-and-control aloqasi, ransomware faoliyati va boshqa malware-driven network behavior namunalarini qamrab oladi.
Server-Based ma’lumotlar to‘plami 225.398 namuna, 27 xususiyat va uch sinfdan iborat. Manba bu yerda HTTP flooding, SSH brute-force va SQL injection kabi server tomonidagi hujum namunalarini tilga oladi.
Yetishmayotgan qiymatlar qanday to‘ldiriladi?
Sonli xususiyatlardagi yetishmayotgan qiymatlar tegishli ustunning o‘rtacha qiymati bilan to‘ldiriladi. Kategorik xususiyatlarda esa eng ko‘p uchraydigan kategoriya, ya’ni mode ishlatiladi. O‘rtacha qiymat bilan to‘ldirish sonli o‘zgaruvchining markaziy qiymatini saqlashga qaratilgan, mode bilan to‘ldirish esa kategorik o‘zgaruvchida eng keng tarqalgan sinfdan foydalanadi.
Bu usullar yetishmayotgan qiymatlar muammosini bartaraf etadi; biroq yetishmayotgan ma’lumot mexanizmi nega yuzaga kelganini modellashtirmaydi. Manba missingness mechanism uchun alohida tahlil bermaydi.
“Standard scaling bilan [0,1]” iborasini qanday talqin qilish kerak?
Manba sonli xususiyatlar “Standard scaling” yordamida [0,1] oralig‘iga o‘tkazilganini ikki alohida joyda aytadi. Verianla bu iborani sukut bilan boshqa scaler nomiga almashtirmaydi. Shuning uchun ishonchli xulosa faqat shuki: manba sonli xususiyatlar masshtablanganini va natija oralig‘ini [0,1] deb ta’riflaydi; ishlatilgan scaler’ning dasturiy darajadagi aniq sinfini chop etilgan matndan ishonchli qayta aniqlab bo‘lmaydi.
Kategorik xususiyatlar qanday kodlanadi?
Nominal va tabiiy tartibga ega bo‘lmagan kategoriyalar uchun one-hot encoding ishlatiladi. Bu jarayon har bir kategoriya uchun alohida binary feature yaratib, masalan, protokol turlari orasida sun’iy kattalik tartibi paydo bo‘lishining oldini oladi.
Manba binary va ordinal xususiyatlar label encoding orqali sonli kodlarga aylantirilishini bildiradi.
Sinflar nomutanosibligi qanday boshqariladi?
Metodologiya bo‘limida stratified sampling va class-weighted loss ishlatilgani yozilgan. Biroq manba har bir sinf uchun qo‘llangan sonli class weight qiymatlari yoki ularning formulasini bermaydi.
Denklem 8 esa standart multiclass cross-entropy ko‘rinishida berilgan va tenglamada ochiq sinf-og‘irlik hadi ko‘rsatilmagan. Shuning uchun class weighting’ning aniq loss implementatsiyasiga qanday qo‘llanganini manbada berilganidan batafsilroq taxmin qilish to‘g‘ri emas.
FCNN va Attention Mexanizmi Qanday Ishlaydi?
Tadqiqotdagi FCNN modeli kirish feature vector’ini 128, 64 va 32 o‘lchamli yashirin tasvirlarga aylantiruvchi to‘liq bog‘langan qatlamlar, Mish aktivatsiyasi va dropout bilan ishlaydi; manba bayoni va tenglamalarga ko‘ra oxirgi 32 o‘lchamli latent representation ustida attention og‘irliklari hisoblanadi va attention-weighted tasvir softmax qatlamida ko‘p sinfli hujum prognoziga aylantiriladi.
Kirish vektori
Manba kirish vektorini:
\[ \mathbf{x}\in\mathbb{R}^{d} \]
ko‘rinishida belgilaydi. \(d\) qayta ishlangan feature sonidir. Maqola misol sifatida \(d=120\) qiymatini beradi; biroq uch ma’lumotlar to‘plamining asl feature sonlari turlicha bo‘lgani uchun bu qiymat barcha to‘plamlar uchun doimiy va universal yakuniy o‘lcham sifatida talqin qilinmasligi kerak.
Denklem 1–3: Yashirin tasvirlar
\[ \mathbf{h}_1=\operatorname{Mish}(W_1\mathbf{x}+b_1), \qquad \mathbf{h}_1\in\mathbb{R}^{128} \tag{1} \]
Denklem 1 kirish xususiyatlarini dastlabki 128 o‘lchamli latent representation’ga aylantiradi. \(W_1\) o‘rganiladigan weight matrix, \(b_1\) bias vector va \(\mathbf{h}_1\) birinchi yashirin qatlam chiqishidir.
\[ \mathbf{h}_2=\operatorname{Mish}(W_2\mathbf{h}_1+b_2), \qquad \mathbf{h}_2\in\mathbb{R}^{64} \tag{2} \]
Denklem 2 birinchi yashirin tasvirni 64 o‘lchamga aylantiradi.
\[ \mathbf{h}_3=\operatorname{Mish}(W_3\mathbf{h}_2+b_3), \qquad \mathbf{h}_3\in\mathbb{R}^{32} \tag{3} \]
Denklem 3 oxirgi yashirin representation’ni 32 o‘lchamga kamaytiradi. Mish chiziqli bo‘lmagan aktivatsiya funksiyasidir. Manba Mish’ning analitik funksiya ta’rifini alohida bermagani uchun Verianla manbadan tashqari yangi tenglama qo‘shmaydi.
Denklem 4: Dropout
\[ \mathbf{h}^{drop}_i= Dropout(\mathbf{h}_i,p=0.3), \qquad i=1,2,3 \tag{4} \]
Dropout training vaqtida yashirin birliklarning bir qismini vaqtincha o‘chirib, modelning alohida latent units’ga haddan tashqari bog‘lanib qolishini kamaytirishga qaratilgan. Bu yerdagi \(p=0.3\) manbada berilgan dropout rate’dir.
Denklem 5: Attention og‘irliklari
\[ \boldsymbol{\alpha}= softmax(W_a\mathbf{h}_3+b_a) \tag{5} \]
Attention qatlami oxirgi yashirin representation ichidagi latent units uchun nisbiy og‘irlik hosil qiladi. Manbaning metodologiya bo‘limi bu mexanizm bevosita asl kirish feature’lari ustida emas, o‘rganilgan hidden representation ustida ishlashini aniq bildiradi.
Bu farq muhim: attention weight bilan SHAP feature attribution bir xil narsa emas. Attention model ichidagi latent representation’ga og‘irlik beradi; SHAP esa model prognoziga kirish xususiyatlari hissasini post-hoc usulda baholash uchun ishlatiladi.
Denklem 6: Attention-weighted tasvir
\[ z= \sum_{j=1}^{32} \alpha_j h_{3j} \tag{6} \]
Denklem 6 manbada shu ko‘rinishda berilgan. \(\alpha_j\), \(j\)-attention weight; \(h_{3j}\), oxirgi yashirin qatlamning \(j\)-komponentidir.
Manba yozuvida e’tibor berilishi kerak bo‘lgan notation muammosi bor: Denklem 6 dagi yig‘indi ifodasida \(z\) skalyar kattalikdek ko‘rinsa, keyingi Denklem 7 da \(w_i^Tz\) ko‘rinishidagi vektor inner-product yozuvi ishlatilgan. Manba bu o‘lcham munosabatini alohida tushuntirmaydi. Verianla tenglamani o‘zgartirmaydi va yetishmayotgan o‘lcham ma’lumotini taxmin bilan to‘ldirmaydi.
Denklem 7: Softmax sinf ehtimoli
\[ \hat{y}_i= \frac{\exp(w_i^{T}z+b_i)} {\sum_{j=1}^{C}\exp(w_j^{T}z+b_j)}, \qquad i=1,2,\ldots,C \tag{7} \]
Denklem 7 har bir sinf uchun normallashtirilgan prognoz ehtimolini hosil qiladi. \(C\) tegishli ma’lumotlar to‘plamidagi sinflar sonidir. Softmax maxraji barcha sinflarning exponentiated logit qiymatlarini yig‘ib, chiqishlarni umumiy ehtimollik taqsimotiga aylantiradi.
Denklem 8: Ko‘p sinfli cross-entropy
\[ L= -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{ic}\log(\hat{y}_{ic}) \tag{8} \]
\(N\) training sample sonini, \(C\) sinflar sonini, \(y_{ic}\) haqiqiy class indicator qiymatini va \(\hat{y}_{ic}\) model tegishli sinf uchun bashorat qilgan ehtimolni ifodalaydi. Loss o‘lchovsizdir.
Model haqiqiy sinfga past ehtimol berganda \(-\log(\hat{y}_{ic})\) kattalashadi va loss ortadi. O‘qitish optimizatsiyasi ushbu loss’ni kamaytiradigan weight tuzilmalarini o‘rganishni maqsad qiladi.
Arxitektura tavsifidagi manba ichki farqi
Metodologiya tavsifi 128, 64 va 32 neyronli uchta yashirin qatlamning har biridan keyin dropout borligini va attention mexanizmi oxirgi 32 o‘lchamli representation’ga qo‘llanishini bildiradi. Denklem 1–6 ham shu bayon bilan mos keladi.
Biroq Algorithm 1 model ketma-ketligini FC-128 → Dropout(0.3) → FC-64 → Dropout(0.3) → Attention → FC-32 → softmax ko‘rinishida beradi. Bu ketma-ketlikda attention FC-32 dan oldin ko‘rinadi va uchinchi dropout ochiq ko‘rsatilmagan.
Bu ikki taqdimot manba ichida to‘liq bir xil emas. Shu sababli Verianla Algorithm 1 qatorini yoki tenglamalar zanjirini sukut bilan boshqasiga moslab o‘zgartirmaydi.
O‘qitish sozlamalari
| Parametr | Manba qiymati | Izoh |
|---|---|---|
| Optimizer | AdamW | Weight yangilanishlari uchun ishlatiladigan optimizer. |
| Boshlang‘ich learning rate | 0.001 | Algorithm 1 da berilgan boshlang‘ich qiymat. |
| Learning-rate schedule | Cosine annealing | Manba schedule ishlatilganini bildiradi; batafsil schedule parametrlari berilmagan. |
| Batch size | 128 | Har bir mini-batch uchun training sample soni. |
| Maksimal epoch | 20 | Early stopping ertaroq to‘xtatishi mumkin. |
| Dropout | 0.3 | Manbaning Denklem 4 va usul tavsifida berilgan nisbat. |
| Weight initialization | Xavier | Boshlang‘ich weight dispersiyasini muvozanatda saqlash uchun. |
| Early stopping | Validation loss | Overtraining’ni cheklash maqsadida. |
| Monitoring | TensorBoard | Training ishlashini kuzatish uchun. |
Training, validation va test ajratilishi aniq qanday berilgan?
Algorithm 1 ma’lumotlar to‘plamlarini %70 training va %30 test qilib ajratganini yozadi va random_state=42 bilan deterministic stratified split ma’lumoti SHAP izohida ko‘rinadi.
Shu bilan birga, algoritmning keyingi qatorlarida “validation” metriklari va validation loss bo‘yicha early stopping ishlatiladi; SHAP tahlili ham “validation samples” ustida aniqlanadi. Manba alohida uchinchi validation partition hajmini ochiq bermaydi.
Shuning uchun chop etilgan matndan ishonchli olinadigan ma’lumot 70/30 stratified ajratish va validation sifatida ishlatilgan namunalar mavjudligidir; alohida train-validation-test nisbatlarini o‘zboshimchalik bilan yaratish to‘g‘ri emas.
SHAP va LIME Ushbu Tadqiqotda Nimani Tushuntiradi?
SHAP model bir nechta validation namunalarida feature contribution taqsimotlarini ko‘rish uchun, LIME esa bitta prediction atrofidagi mahalliy feature hissalarini ko‘rsatish uchun ishlatilgan; manba ikkala usulni ham real-time har paket uchun izoh emas, offline forensic analysis va post-incident investigation vositasi sifatida cheklaydi.
SHAP qo‘llanishi
Manba KernelSHAP yondashuvini shap.Explainer orqali, belgilangan 100 validation namunasidan iborat background ustida va CPU-side prediction wrapper yordamida qo‘llaganini bildiradi.
SHAP summary plot’lari feature’ning turli namunalarda model output’iga qaysi yo‘nalishda va qay darajada ta’sir qilishini ko‘rish uchun ishlatilgan.
Kitsune SHAP tahlilida feature_0, feature_3, feature_1 va feature_8 kabi bir nechta xususiyat sezilarli hissa ko‘rsatadi. Manba buni IoT trafikida qaror bitta ustun o‘zgaruvchiga bog‘liq emasligi bilan izohlaydi.
Server-Based ma’lumotlar to‘plamida SHAP taqsimoti zichroq va kamroq xususiyat atrofida jamlangan. Malware ma’lumotlar to‘plamida esa kengroq feature contribution taqsimoti kuzatiladi.
LIME qo‘llanishi
LIME har bir ma’lumotlar to‘plami uchun faqat bitta vakillik validation namunasiga qo‘llangan. Manba ishlatilgan namunani idx=0, tushuntirilgan feature sonini esa num_features=10 deb bildiradi.
Kitsune namunasida ts, service_http va resp_bytes ijobiy; service_dns va proto_tcp salbiy hissa ko‘rsatadigan feature namunalari sifatida berilgan.
Server-Based namunasida ts, proto va id.resp_h kuchli ijobiy hissa ko‘rsatsa, orig_bytes va resp_bytes salbiy yo‘nalishdagi hissa namunalari sifatida ko‘rsatilgan.
Malware namunasida feature_85, feature_86 va feature_107 ijobiy; feature_57 va feature_39 salbiy hissa namunalari qatorida.
Izohlanuvchanlik natijalarining chegarasi
Manba bir xil trained checkpoint va bir xil 100 validation namunasi ishlatilgani sababli SHAP rankings qayta bajarilganda o‘zgarmaganini bildiradi. Biroq tadqiqot modelni turli random seed’lar bilan boshidan qayta o‘qitib, SHAP ranking variance uchun statistik repeated-training experiment bermaydi.
Shuning uchun “bir xil checkpoint ostida izohni qayta ishlab chiqarish” bilan “turli o‘qitish sharoitlarida explanation stability” bir xil natija emas.
Architecture comparison SHAP nimani ko‘rsatadi?
Manba Figure 9 da proposed MLP + Attention, attention’siz MLP va Random Forest uchun SHAP feature rankings’ni sifat jihatdan taqqoslaydi. Malware ma’lumotlar to‘plamida feature_0, feature_1, feature_2, feature_3 va feature_8 uchala arxitekturaning top-10 reytingida ham ko‘rinadi.
Server-Based ma’lumotlar to‘plamida feature_1 taqqoslangan barcha modellarda birinchi o‘rinda; feature_7, feature_13, feature_15 va feature_16 ham arxitekturalar orasida qayta uchraydi.
Kitsune’da feature dimensionality va to‘qqiz sinfli tuzilma sabab ranking variation kattaroq; manba feature_13 va feature_65 ikkala MLP variantining top-10 ro‘yxatiga kirganini bildiradi.
Bu tahlil predictive-performance ablation emas. Attention modulini olib tashlash accuracy yoki F1 ni qanchaga o‘zgartirishini ko‘rsatadigan miqdoriy ablation table yo‘q; mualliflar to‘liq ablation tadqiqotlarini kelajakdagi ish sifatida ko‘rsatadi.
Tadqiqot Usuli va Natijalari
Asosiy ishlash natijalari
| Ma’lumotlar to‘plami | Domen | Accuracy | Talqin chegarasi |
|---|---|---|---|
| Kitsune | IoT trafigi | %96,0 | To‘qqiz sinf orasida Class 2 va Class 4 sezilarli darajada zaifroq. |
| Server-Based | Korporativ/server trafigi | %99,99 | Table 3 ikki o‘nlik formatda 1.00 ga yaxlitlaydi. |
| Malware Traffic | Malware aloqa trafigi | %99,58 | Table 3 accuracy ustunida 1.00 ko‘rinishida yaxlitlangan. |
%99,99 Accuracy Bitta Universal Model Muvaffaqiyatini Ko‘rsatadimi?
Yo‘q. %99,99 qiymati Server-Based ma’lumotlar to‘plamida alohida baholash sharoitida olingan eng yuqori accuracy natijasidir; tadqiqot bitta o‘qitilgan model Kitsune, Server-Based va Malware Traffic o‘rtasida transfer qilinganini ko‘rsatmagani uchun bu qiymat “uch domenda bitta universal model %99,99 aniqlik berdi” tarzida talqin qilinmasligi kerak.
Kitsune sinflar bo‘yicha natijalari
| Sinf | Precision | Recall | F1-score | Umumiy accuracy |
|---|---|---|---|---|
| Class 0 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 1 | 0.93 | 0.99 | 0.95 | 0.96 |
| Class 2 | 0.72 | 0.76 | 0.74 | 0.96 |
| Class 3 | 0.99 | 0.89 | 0.94 | 0.96 |
| Class 4 | 0.75 | 0.69 | 0.72 | 0.96 |
| Class 5 | 1.00 | 0.99 | 0.99 | 0.96 |
| Class 6 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 7 | 0.97 | 1.00 | 0.98 | 0.96 |
| Class 8 | 0.99 | 0.99 | 0.99 | 0.96 |
Class 2 va Class 4 natijalari %96 overall accuracy sinflar bo‘yicha ishlash farqlarini yashirishi mumkinligini aniq ko‘rsatadi. Class 4 recall = 0.69 bo‘lgani sababli haqiqiy Class 4 namunalarining taxminan uchdan biri tegishli sharoitda to‘g‘ri sinfga biriktirilmagan.
Server-Based va Malware natijalari
| Ma’lumotlar to‘plami | Sinf | Precision | Recall | F1 | Table 3 Accuracy |
|---|---|---|---|---|---|
| Server-Based | Class 0 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 1 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 0 | 0.99 | 0.99 | 0.99 | 1.00 |
| Malware | Class 1 | 0.99 | 1.00 | 1.00 | 1.00 |
| Malware | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 3 | 1.00 | 0.98 | 0.99 | 1.00 |
| Malware | Class 4 | 1.00 | 1.00 | 1.00 | 1.00 |
Table 3 ikki o‘nlik taqdimot sabab umumiy accuracy’ni Server-Based va Malware uchun 1.00 ko‘rsatadi. Abstract esa aniqroq qiymatlar sifatida mos ravishda %99,99 va %99,58 beradi. Verianla bu ikki taqdimotni ziddiyat sifatida yashirmaydi; Table 3 qiymatlarini yaxlitlangan jadval ko‘rinishi sifatida saqlaydi.
Confusion matrix’lar nimani ko‘rsatadi?
Kitsune confusion matrix’ida Class 0, 5, 6, 7 va 8 asosan diagonal bo‘ylab to‘g‘ri tasniflanadi, Class 2 va Class 4 da esa ko‘proq off-diagonal xato ko‘rinadi. Manba buni sinflar orasidagi feature overlap bilan bog‘laydi.
Server-Based confusion matrix deyarli to‘liq diagonaldir. Malware confusion matrix’ida ham yuqori diagonal dominance kuzatiladi, biroq Class 0 bilan Class 1 orasida oz miqdorda chalkashish bor.
ROC-AUC natijalari
Kitsune ROC tahlilida ko‘pchilik sinflarning AUC qiymati 1.00 ga yetadi; Class 2 va Class 4 uchun qiymatlar taxminan 0.99 darajasida berilgan.
Server-Based ma’lumotlar to‘plamidagi uch sinf uchun AUC = 1.00; Malware Traffic dagi besh sinf uchun ham AUC = 1.00 berilgan.
Bu natijalar tegishli train/test protokoli va foydalanilgan ma’lumotlar to‘plamlari sharoitida o‘lchangan. Boshqa tarmoqlarda, yangi hujum turlarida yoki vaqt o‘tishi bilan o‘zgaradigan production traffic distribution ostida xuddi shu AUC saqlanishi tadqiqot tomonidan tasdiqlanmagan.
O‘qitish egri chiziqlari
Kitsune o‘qitishida validation accuracy taxminan 15-epoch atrofida %95 dan oshadi. Training va validation egri chiziqlari boshida biroz ajraladi, keyingi epoch’larda barqarorroq bo‘ladi.
Server-Based modelida training va validation accuracy bir necha epoch ichida %99,5 dan oshadi. Malware Traffic’da ham accuracy juda erta bosqichda %100 ga yaqinlashadi.
Loss egri chiziqlari
Kitsune training loss taxminan 1,2 dan boshlanib 0,2 dan pastga tushar ekan, validation loss taxminan 0,08 gacha pasayadi.
Server-Based o‘qitishida training va validation loss bir necha epoch ichida taxminan 0,05 dan pastga tushadi. Malware modelida loss qiymatlari taxminan 0,03 yoki undan past darajada bo‘ladi.
Manba Malware validation loss ko‘p epoch’larda training loss dan past bo‘lishini kuchli regularization sababli yengil underfitting belgisi sifatida talqin qiladi. Bu muallif talqinidir; tadqiqot buning uchun alohida formal statistical test bermaydi.
Taqqoslovchi Table 4 qanday o‘qilishi kerak?
| Yondashuv | Best Accuracy (%) | Izohlanuvchanlik | Multi-dataset qo‘llab-quvvatlashi |
|---|---|---|---|
| Ref. 20 | 98.7 | Partial, SHAP | Hybrid Boosting |
| Ref. 11 | 97.9 | High, XAI survey | Review-based |
| Ref. 12 | 96.3 | Low | 2 datasets |
| Ref. 25 | 98.5 | Federated SHAP | Federated DL |
| Proposed model | 99.99 | SHAP visual + feature attribution | Kitsune + Server + Malware |
Table 4 dagi %99,99 taklif qilingan tizimning uch ma’lumotlar to‘plamidagi eng yuqori natijasi bo‘lgan Server-Based accuracy’dir. Jadval turli tadqiqotlarning turli ma’lumotlar to‘plamlari va usullaridagi “best achieved accuracy” qiymatlarini yonma-yon qo‘yadi. Shu sababli u nazoratli, bir xil test to‘plamiga asoslangan head-to-head benchmark sifatida talqin qilinmasligi kerak.
Cross-dataset transfer haqiqatan sinovdan o‘tkazildimi?
Yo‘q. Xulosa bo‘limining ochiq bayoniga ko‘ra tadqiqot cross-dataset transfer learning ko‘rsatmaydi. Umumiy pipeline uch network environment’ga mustaqil qo‘llangan.
Matnning oldingi qismida pipeline turli domain’larda “without requiring retraining or architectural modifications” ishlashi haqida kuchliroq ibora mavjud. Bunga qarshi, usul bo‘limi har bir ma’lumotlar to‘plami uchun training/test jarayonini ta’riflaydi va xulosa bo‘limi transfer learning qilinmaganini ochiq aytadi. Shu sababli Verianla xavfsiz talqin sifatida “architecture/pipeline customization talab qilmasdan mustaqil qayta qo‘llash” ma’nosini saqlaydi, “bitta trained model retraining’siz uch domain’da ishlatildi” degan da’vo yaratmaydi.
UAV’larda sinov qilinganmi?
Yo‘q. Maqolada UAV telemetry, RF signal, flight log yoki GPS variability mavjud bo‘lgan UAV-specific dataset ishlatilmagan. UAV intrusion detection faqat kelajakdagi potensial application domain sifatida muhokama qilingan.
Shuning uchun tadqiqot UAV’larda spoofing, jamming yoki boshqa hujumlarni real parvoz ma’lumotida aniqlaganini ko‘rsatmaydi.
Statistik noaniqlik va qayta ishlab chiqarish mumkinligi
Tadqiqot accuracy, precision, recall, F1-score va ROC-AUC haqida xabar beradi. Biroq ishlash natijalari uchun confidence interval, p-value, effect size yoki multiple-random-seed distribution berilmagan.
random_state=42 SHAP uchun ishlatilgan deterministic 70/30 split kontekstida ko‘rsatilgan. Bu mustaqil training runs orasidagi ishlash noaniqligi o‘lchanganini anglatmaydi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Bir xil umumiy preprocessing va FCNN modellashtirish yondashuvi uch xil network-data domenida alohida qo‘llanishi mumkin bo‘lgan.
- Kitsune’da %96,0, Server-Based’da %99,99 va Malware Traffic’da %99,58 accuracy berilgan.
- Kitsune’da ayrim sinflar boshqalaridan sezilarli zaif; ayniqsa Class 2 va Class 4 ning F1 qiymatlari mos ravishda 0,74 va 0,72.
- SHAP modelning feature contribution tuzilishini bir nechta validation namunasi orqali o‘rganish uchun ishlatilgan.
- LIME alohida predictions uchun local feature contribution izohini yaratish maqsadida qo‘llangan.
- Server-Based va Malware ma’lumotlar to‘plamlarida ROC-AUC qiymatlari xabar berilgan barcha sinflarda 1.00.
- Tadqiqot bir xil architectural pipeline heterogen ma’lumot domenlariga qo‘llanishi mumkinligini qo‘llab-quvvatlaydi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- Bitta trained model uch ma’lumotlar to‘plami o‘rtasida bevosita transfer qilinib, bir xil natijalarni bergani ko‘rsatilmagan.
- Cross-dataset transfer learning tasdiqlanmagan.
- UAV intrusion defence real UAV ma’lumotlari bilan tasdiqlanmagan.
- SHAP yoki LIME real-time packet-by-packet explanation sifatida sinovdan o‘tkazilmagan.
- Modelning production network’dagi throughput, latency, memory yoki long-term drift ishlashi berilmagan.
- Attention modulining predictive contribution’ini son jihatdan ajratib ko‘rsatadigan to‘liq performance ablation bajarilmagan.
- Confidence interval yoki repeated-seed performance distribution yo‘qligi sababli natijalarning training-run noaniqligi miqdoriy berilmagan.
- Server-Based %99,99 accuracy barcha ma’lumotlar to‘plamlarida %99,99 umumiy ishlashni anglatmaydi.
Manbadagi muhim metodologik noaniqliklar
| Mavzu | Manba bayoni A | Manba bayoni B | Verianla yondashuvi |
|---|---|---|---|
| Masshtablash | Standard scaling | [0,1] oralig‘i | Scaler turi tashqi ma’lumotga asoslanib o‘zgartirilmaydi. |
| Attention joylashuvi | Matn/tenglamalar: 32-neyronli h3 dan keyin attention | Algorithm 1: attention, FC-32 dan oldin | Farq ko‘rinadigan saqlanadi. |
| Dropout ketma-ketligi | Matn: uchta hidden layer’ning har biridan keyin dropout | Algorithm 1 ketma-ketligi uchinchi dropout’ni ko‘rsatmaydi | Yetishmayotgan qator taxmin bilan to‘ldirilmaydi. |
| Data split | Algorithm 1: 70% train / 30% test | Training matni validation loss va validation samples ishlatadi | Alohida uchinchi split nisbati o‘ylab topilmaydi. |
| Loss | Usul: class-weighted loss | Denklem 8: standart multiclass cross-entropy | Exact class-weight implementation noma’lum sifatida saqlanadi. |
| Domain generalisation | Oraliq matn: “without requiring retraining” | Conclusion: cross-dataset transfer qilinmagan, ma’lumotlar to‘plamlari mustaqil ishlangan | Bitta model transferi muvaffaqiyati da’vo qilinmaydi. |
| Accuracy ko‘rsatilishi | Abstract: 99,99% va 99,58% | Table 3: 1.00 va 1.00 | Table 3 qiymatlari yaxlitlangan ko‘rinish sifatida qabul qilinadi. |
Kelajakdagi tadqiqot yo‘nalishlari
Muallif kelajakdagi ishlar uchun UAV-specific dataset’lar va flight telemetry, GPS variability hamda communication-signal pattern kabi domain-relevant feature’larni qo‘shishni taklif qiladi.
Shuningdek, haqiqiy cross-dataset transfer experiments, ablation studies va classical machine-learning baselines bilan nazoratli taqqoslashlar o‘tkazish zarurligi aytiladi.
Bu ishlar hozirgi maqolaning yakunlangan natijalari emas.
Manba va Usul Haqida Izoh
Asl sarlavha: A domain-agnostic explainable framework for network attack detection across diverse traffic datasets
Muallif: Abed Alanazi.
Mualliflar soni: 1.
Teng hissa: Qo‘llanmaydi; tadqiqot bitta muallifga tegishli.
Corresponding author: Abed Alanazi.
E-pochta: ad.alanazi@psau.edu.sa
Muassasa: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam bin Abdulaziz University, Al-Kharj 11942, Saudi Arabia.
Jurnal: Scientific Reports.
Nashriyot/platforma: Nature Portfolio / Springer Nature.
Jild: 16.
Maqola raqami: 24512.
Nashr yili: 2026.
Nashr sanasi: 16 iyul 2026.
Received: 27 aprel 2026.
Accepted: 6 iyul 2026.
DOI: 10.1038/s41598-026-61637-w.
Rasmiy nashr sahifasi: Nature / Scientific Reports maqola qaydi; DOI orqali kirish mumkin.
Manba turi: Nashr etilgan original tadqiqot maqolasi.
Taqriz holati: Scientific Reports mutaxassis taqrizini qo‘llaydigan, taqrizdan o‘tuvchi Nature Portfolio jurnalidir.
Litsenziya: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Litsenziya va tasvirlardan foydalanish: NoDerivatives sharti sabab manba Figure 1–9 o‘zgartirilgan yoki moslashtirilgan shaklda Verianla maqolasiga ko‘chirilmagan. Maqoladagi SVG faqat manba matnida aniq bayon qilingan usul aloqalaridan mustaqil kompozitsiyada tayyorlangan.
Asosiy tadqiqot sohasi: Network intrusion detection, deep learning va Explainable Artificial Intelligence.
Asosiy model: Fully Connected Neural Network / Multi-Layer Perceptron asosidagi tasniflagich; Mish activation, dropout va latent-representation attention o‘z ichiga oladi.
Yashirin qatlamlar: 128, 64 va 32 neyron.
Dropout: p = 0.3.
Optimizer: AdamW.
Boshlang‘ich learning rate: 0.001.
Learning-rate scheduling: Cosine annealing; batafsil schedule parametrlari manbada berilmagan.
Batch size: 128.
Maksimal epoch: 20.
Early stopping: Validation loss bo‘yicha.
Weight initialization: Xavier initialization.
Loss: Multiclass cross-entropy. Usul matni, shuningdek, class-weighted loss ishlatilganini bildiradi; exact class-weight qiymatlari berilmagan.
Data split: Algorithm 1 da 70% training va 30% test. Validation loss va validation samples ham ishlatiladi; alohida validation partition nisbati aniq berilmagan.
Random state: SHAP izohida deterministic 70/30 stratified split uchun random_state = 42 ko‘rsatilgan.
Kitsune: 20 milliondan ortiq asl namunadan 9.000 namuna; 115 xususiyat; 9 sinf.
Server-Based: 225.398 namuna; 27 xususiyat; 3 sinf; ma’lumotlar to‘plamining barchasi ishlatilgan.
Malware Traffic: 25 milliondan ortiq asl namunadan 644.602 namuna; 23 xususiyat; 5 sinf.
Yetishmayotgan qiymatlarni to‘ldirish: Sonli feature’larda mean, kategorik feature’larda mode.
Kategorik encoding: Nominal feature’larda one-hot encoding; binary/ordinal feature’larda label encoding.
Scaling bo‘yicha manba bayoni: Manba “Standard scaling” va “[0,1]” iboralarini birga ishlatadi. Verianla scaler turini tashqi ma’lumotga qarab o‘zgartirmagan.
Asosiy accuracy natijalari: Kitsune %96,0; Server-Based %99,99; Malware Traffic %99,58.
Kitsune zaif sinflari: Class 2 F1 = 0,74; Class 4 F1 = 0,72.
ROC-AUC: Kitsune’da ko‘pchilik sinflar 1.00, Class 2 va Class 4 taxminan 0.99; Server-Based va Malware sinflarida 1.00 berilgan.
SHAP: Belgilangan 100 validation namuna; KernelSHAP / shap.Explainer; CPU-side prediction wrapper.
LIME: Har bir ma’lumotlar to‘plamiga bitta vakillik validation namunasi; idx = 0; num_features = 10.
XAI ishlash rejimi: Offline forensic analysis va post-incident investigation; real-time per-packet explanation emas.
Cross-architecture SHAP: Proposed MLP + Attention, attention’siz MLP va Random Forest izohlari sifat jihatdan taqqoslangan; bu taqqoslash predictive-performance ablation emas.
Cross-dataset transfer: Bajarilmagan. Conclusion bo‘limi bir xil pipeline turli ma’lumotlar to‘plamlariga mustaqil qo‘llanishini baholaganini aniq bildiradi.
UAV validation: Bajarilmagan. UAV telemetry, RF signals va flight logs mavjud ma’lumotda yo‘q.
Statistik testlar: Ishlash uchun p-value, confidence interval yoki effect size berilmagan.
Repeated-seed performance: Berilmagan.
Data availability: Kitsune, Malware Capture Facility va ishlatilgan server/network malware dataset manbada public dataset sifatida ko‘rsatilgan.
Muallif hissalari: Conceptualization, data curation, formal analysis, funding acquisition, investigation, methodology, project administration, validation va writing—review & editing vazifalarining barchasi Abed Alanazi tomonidan bajarilgan.
Moliyalashtirish: National Cybersecurity Authority, Kingdom of Saudi Arabia tomonidan CRPG-25-3295 raqamli qo‘llab-quvvatlash va Prince Sattam bin Abdulaziz University tomonidan PSAU/2026/R/1447 loyiha moliyalashtirishi berilgani bildirilgan.
Manfaatlar to‘qnashuvi: Muallif competing interests yo‘qligini bildiradi.
Asosiy metodologik chegara: Tadqiqot uchta ommaviy tarmoq xavfsizligi ma’lumotlar to‘plamida mustaqil tajribalardan iborat; production network dala validatsiyasi, cross-dataset transfer learning va UAV-specific validationni o‘z ichiga olmaydi.
Manba ichki arxitektura chegarasi: Matn/tenglamalar attention’ni h3 dan keyin ko‘rsatsa, Algorithm 1 attention’ni FC-32 dan oldin joylashtiradi; bu farq Verianla tomonidan sukut bilan tuzatilmagan.
Manba ichki split chegarasi: 70/30 train-test iborasi bilan birga validation loss va validation samples ishlatilgan, alohida validation nisbati aniq berilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan