


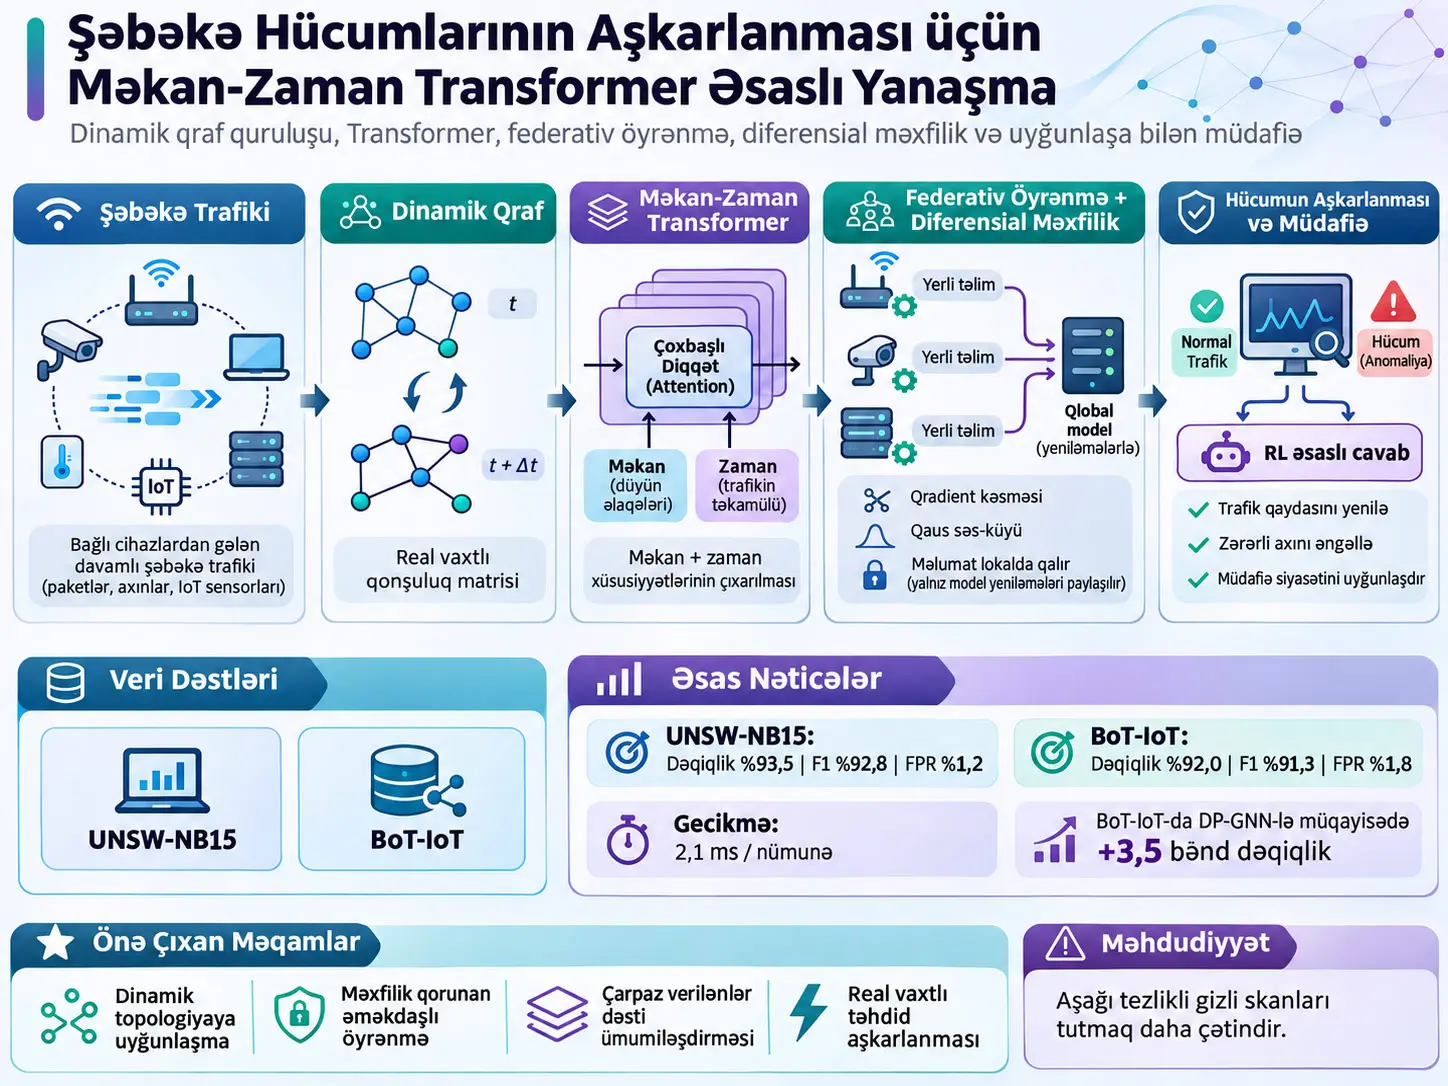
Adaptiv məkan-zaman Transformer əsaslı şəbəkə hücumlarının aşkarlanması çərçivəsi, şəbəkə düyünləri arasındakı dəyişən rabitə əlaqələrini dinamik qraf kimi modelləşdirən, zaman asılılıqlarını Transformer ilə, məkan/topoloji asılılıqları qraf konvolyusiyası ilə emal edən, lokal verilənləri cihazdan çıxarmadan federativ öyrənmə və differensial məxfilikdən istifadə edən və hücumdan sonra reinforcement learning ilə müdafiə qərarı yaratmağı hədəfləyən network attack detection və response yanaşmasıdır. Tədqiqat UNSW-NB15 və BoT-IoT benchmark verilənlər dəstləri üzərində qiymətləndirilmiş; təklif olunan üsul UNSW-NB15-də %93,5 ± %0,2 accuracy və %92,8 ± %0,3 F1, BoT-IoT-da isə %92,0 ± %0,4 accuracy və %91,3 ± %0,5 F1 əldə etmişdir. Bununla belə, tədqiqat nəzarət olunan verilənlər dəstlərinə əsaslanır; bu nəticələr real V2X, IoT və ya istehsal şəbəkəsində uzunmüddətli sahə uğuru kimi şərh edilməməlidir.
Çərçivənin birinci komponenti mövcud zaman pəncərəsində şəbəkə düyünlərinin rabitə tezlikləri və trafik xüsusiyyətlərinin oxşarlığından dinamik qonşuluq matrisi yaradır. Zəif əlaqələr eşikləmə ilə budanır; beləliklə hər düyünün şəbəkədəki bütün düyünlərə bağlandığı sıx struktur əvəzinə daha seyrək və aktual rabitə əlaqələrini təmsil edən qraf əldə edilməyə çalışılır. Zaman asılılıqları multi-head self-attention istifadə edən Transformer ilə, topoloji asılılıqlar isə graph convolution ilə emal olunur.
İkinci komponent federativ öyrənmə ilə differensial məxfiliyi birləşdirir. Lokal cihazlar xam trafik verilənlərini mərkəzi serverə göndərmək əvəzinə öz modellərini lokal şəkildə yeniləyir; mərkəzi server model parametrlərini birləşdirir. Mənbə differensial məxfilik zamanı gradient clipping və Gaussian noise istifadə edir; eksperiment parametrlərində noise multiplier dəyərini \(\sigma=0.1\), ümumi məxfilik büdcəsini 100 epoch sonunda təxminən \(\epsilon=2.4\) və \(\delta=10^{-5}\) kimi bildirir.
Üçüncü komponent yalnız “hücum var/yoxdur” qərarına fokuslanmır. Deep Q-Network əsaslı reinforcement learning qatı trafik sürəti, protokol paylanması və anomaly score kimi göstəricilərdən ibarət network state-dən istifadə edərək trafikin məhdudlaşdırılması və ya verilənlərin filtrlənməsi kimi müdafiə hərəkətləri arasında seçim etməyi hədəfləyir. Ablasiya nəticələri reinforcement-learning komponentinin classification accuracy üzərindəki töhfəsinin yalnız təxminən 0,3 faiz bəndi olduğunu; əsas rolunun hücuma veriləcək dinamik cavab olduğunu göstərir.
Təklif olunan üsulun ən mühüm performans qazancı adaptiv qrafın qurulması və spatio-temporal Transformer komponentlərindən gəlir. BoT-IoT-da adaptiv qraf qurulması çıxarıldıqda F1 %91,3-dən %87,9-a, Transformer GCN+LSTM ilə əvəz edildikdə isə %86,5-ə düşür. Bunun əksinə, federativ differensial məxfilik mexanizminin mərkəzləşdirilmiş təlimlə əvəz olunması F1-də təxminən 0,8 faiz bəndi fərq yaradır.
Mənbə həmçinin birbaşa cross-dataset transfer təcrübəsini bildirir: model UNSW-NB15 üzərində öyrədilmiş və BoT-IoT üzərində fine-tuning aparılmadan test edilmişdir. Müəlliflər bu şəraitdə proposed modelin F1 dəyərini %91-dən yuxarı saxladığını və BoT-IoT-da RustGraph-ı 2,1 faiz bəndi üstələdiyini bildirirlər.
Tədqiqatın mühüm məhdudiyyəti ultra-aşağı tezlikli hücumlardır. Mənbədə verilən aşağı sürətli port skanı nümunəsində hücumçu 30 dəqiqə ərzində yalnız beş probe yaratmış, paket sürəti 0,8 packet/s səviyyəsində qalmış və normal IoT heartbeat trafikinin 0,7–1,1 packet/s aralığı ilə böyük ölçüdə üst-üstə düşmüşdür. Model bu nümunəni %62,3 confidence ilə normal davranış kimi təsnif etmişdir. Müəlliflər bu uğursuzluğu federativ öyrənmədə məhdud lokal görünüş və differential-privacy səs-küyünün zəif anomaly gradient-lərini boğması ilə əlaqələndirirlər.
Mənbənin abstract bölməsi eyni privacy budget altında membership inference hücumlarının uğur nisbətinin əhəmiyyətli dərəcədə azaldıldığını bildirir. Lakin əsas metod və nəticələr bölmələrində membership-inference hücumu üçün kəmiyyət uğur nisbəti, ayrıca eksperiment cədvəli və ya ətraflı test protokolu verilmir. Buna görə bu iddia keyfiyyət xarakterli mənbə bəyanatı kimi qorunmalı, mənbədə olmayan rəqəmlərlə genişləndirilməməlidir.
Tədqiqat problemi nədir?
Network Attack Detection (NAD) şəbəkə trafikində normal davranışla zərərli davranışı ayırmağı hədəfləyir. Bu tədqiqat problemi riyazi olaraq binary classification şəklində qurur: \(y_i=0\) normal trafiki, \(y_i=1\) isə hücum trafikini ifadə edir.
Tədqiqatın həll etməyə çalışdığı çətinlik yalnız doğru təsnifat deyil. IoT, Internet of Vehicles və Vehicle-to-Everything kimi mühitlərdə hansı cihazların bir-biri ilə rabitə qurması zamanla dəyişə bilər. Eyni zamanda verilənlərin mərkəzi serverə göndərilməsi məxfilik riski yarada bilər və hücum aşkar edildikdən sonra hansı müdafiə hərəkətinin tətbiq ediləcəyi də ayrıca problemdir.
Buna görə mənbə üç problemi vahid çərçivədə nəzərdən keçirir:
- Dinamik şəbəkə topologiyasındakı məkan və zaman əlaqələrini modelləşdirmək.
- Xam verilənləri mərkəzi sistemə daşımadan ortaq model təlimi aparmaq və differensial məxfilik tətbiq etmək.
- Aşkarlamadan sonra reinforcement learning ilə dinamik müdafiə qərarı yaratmaq.
Problemin formullaşdırılması
Mənbə şəbəkə trafiki verilənlərini \(X\), hər bir trafik nümunəsini \(x_i\), ikili sinif etiketini isə \(y_i\) ilə göstərir. Təlim və test dəstləri eyni feature strukturundan istifadə edir.
İdeal optimallaşdırma hədəfi gözlənilən riski azaltmaqdır:
\[ \mathcal{L}(f)= \mathbb{E}_{(x,y)} \left[ \ell(f(x),y) \right] \tag{1} \]
Tənlik 1 nəyi hesablayır? Modelin verilənlərin paylanması üzərində gözlənilən xəta xərcini ifadə edir.
\(f(x)\): Modelin \(x\) trafik nümunəsi üçün verdiyi proqnozdur.
\(y\): Həqiqi etiketdir.
\(\ell(f(x),y)\): Proqnozla həqiqi etiket arasındakı fərqi ölçən loss funksiyasıdır.
Riyazi rol: Təlim prosesi bütün mümkün şəbəkə trafikinin gözlənilən riskini birbaşa hesablaya bilmir; mövcud training samples üzərindən bu hədəfə yaxınlaşmağa çalışır.
Dinamik Qonşuluq Matrisi Bu Tədqiqatda Nə İşə Yarayır?
Dinamik qonşuluq matrisi müəyyən zaman pəncərəsində hansı şəbəkə düyünlərinin bir-biri ilə mənalı rabitə əlaqəsinə malik olduğunu feature similarity və rabitə strukturundan çıxararaq spatio-temporal graph-ı yeniləyir; zəif əlaqələrin eşiklənməsi modelin bütün düyünlər arasında sıx və səs-küylü əlaqələr qurması əvəzinə zamanla dəyişən mühüm topoloji münasibətləri emal etməsini hədəfləyir.
Dinamik graph yaradılması
Mənbənin qonşuluq matrisi tənliyi:
\[ A_{ij}^{(t)} = \operatorname{ReLU} \left( \frac{x_i(x_j)^T}{\sqrt{d}} - \epsilon \right) \tag{2} \]
\(A_{ij}^{(t)}\): \(t\) zamanında \(i\) və \(j\) düyünləri arasındakı əlaqə çəkisidir.
\(x_i\) və \(x_j\): Müvafiq düyünlərin feature vector-larıdır.
\(d\): Feature ölçüsü ilə əlaqəli miqyaslama terminidir.
\(\epsilon\): Zəif əlaqələri budamaq üçün istifadə edilən eşikdir.
ReLU: Eşik çıxıldıqdan sonra mənfi dəyərləri sıfıra endirərək zəif münasibətlərin adjacency matrix-də əlaqəyə çevrilməsinin qarşısını alır.
Tənlikdə feature-vector oxşarlığı \(\sqrt{d}\) ilə miqyaslanır və \(\epsilon\) çıxılır. Oxşarlıq eşikdən kiçikdirsə ReLU nəticəsi sıfır olur; eşikdən böyükdürsə əlaqə müsbət çəki qazanır.
Mənbə adjacency matrix-in \(K\) ölçülü sliding temporal window daxilində hesablandığını bildirir, lakin \(K\)-nın sayısal dəyərini qeyd etmir.
Sıx bütün-düyün müqayisəsinin nəzəri xərci:
\[ O(N^2) \]
kimi verildiyi halda sparse pruning-dən sonra praktik mürəkkəbliyin:
\[ O(N\cdot deg_{avg}) \]
səviyyəsinə endirildiyi bildirilir. Burada \(N\) düyün sayını, \(deg_{avg}\) isə orta node degree dəyərini təmsil edir.
Mənbə metod bölməsində \(\epsilon\)-ı “learnable threshold” kimi müəyyən edir. Sonrakı sensitivity analysis isə \(\epsilon=0.5\)-i seçilmiş operating point kimi təqdim edir. Yayımlanmış mətn bu iki tərifi ayrıca uzlaşdırmadığı üçün Verianla onlardan birini digərinin yerinə keçirmir.
Eşik həssaslığı
| Eşik şərti | Mənbə nəticəsi | Şərh |
|---|---|---|
| \(\epsilon \in [0.4,0.6]\) | F1 > %91 | Model yüksək F1 səviyyəsini qoruyur. |
| Daha aşağı eşiklər | Dəqiq rəqəm verilməyib. | Mənbə daha çox səs-küylü əlaqə yarandığını bildirir. |
| \(\epsilon > 0.7\) | F1 təxminən %86,5 | Graph fragmentation yarandığı bildirilir. |
| Seçilmiş dəyər | \(\epsilon=0.5\) | Səs-küyün filtrlənməsi ilə structural integrity arasında mənbə tərəfindən ən uyğun tarazlıq kimi seçilmişdir. |
Transformer self-attention nə edir?
Zaman encoder-in əsas attention tənliyi:
\[ Attention(Q,K,V) = softmax \left( \frac{QK^T}{\sqrt{d_k}} \right)V \tag{3} \]
\(Q\): Query matrisidir.
\(K\): Key matrisidir.
\(V\): Value matrisidir.
\(d_k\): Key vector ölçüsüdür.
\(QK^T\) müxtəlif zaman/düyün təqdimatları arasındakı münasibət skorlarını yaradır. \(\sqrt{d_k}\) ilə miqyaslama böyük daxili hasilələrin softmax-ı həddən artıq kəskinləşdirməsini məhdudlaşdırmaq üçün istifadə olunur. Softmax nəticələri attention weights olur və bu çəkilər \(V\) üzərində tətbiq edilir.
Tədqiqatda səkkiz attention head istifadə edən altı qatlı Transformer var. Hidden dimension 512-dir. Multi-head struktur modelin müxtəlif representation alt fəzalarında fərqli münasibətləri eyni anda araşdırmasını hədəfləyir.
Graph convolution nə edir?
Spatial encoder üçün mənbə bu tənliyi verir:
\[ h_i' = \sigma \left( \sum_{j\in\mathcal{N}(i)} \frac{1}{c_{ij}} W h_j \right) \tag{4} \]
\(h_i'\): \(i\) düyününün yenilənmiş representation-ıdır.
\(\mathcal{N}(i)\): \(i\) düyününün qonşuluq çoxluğudur.
\(h_j\): Qonşu düyün \(j\)-nin mövcud representation-ıdır.
\(W\): Öyrənilə bilən çevirmə matrisidir.
\(c_{ij}\): Mənbə tənliyindəki normalization terminidir; məqalə bunun ətraflı tərifini ayrıca vermir.
\(\sigma\): Nonlinear activation funksiyasıdır.
Bu əməliyyat düyünün representation-ını yalnız öz məlumatı ilə deyil, dinamik graph üzərindəki qonşularının məlumatları ilə də yeniləyir.
Federated Differential Privacy Bu Çərçivədə Necə Qoruma Təmin Edir?
Federated differential privacy xam şəbəkə trafikini mərkəzi serverə daşımadan hər cihazın modeli öz lokal verilənləri üzərində yeniləməsinə, yalnız model yeniləmələrinin aggregation üçün paylaşılmasına və gradient clipping ilə Gaussian noise istifadə edilərək tək bir training sample-ın model yeniləməsinə təsirinin məhdudlaşdırılmasına əsaslanır; mənbədə \(\sigma=0.1\), təxminən \(\epsilon=2.4\) və \(\delta=10^{-5}\) dəyərləri bildirilmişdir.
Feature decoupling
Mənbə lokal gradient-i iki komponent kimi nəzərdən keçirir:
- Structural component: \(\nabla_{\theta}^{str}\), graph/topology məlumatını daşıyan komponent.
- Task component: \(\nabla_{\theta}^{tsk}\), classification tapşırığı ilə əlaqəli komponent.
Müəlliflər structural komponentə daha böyük clipping threshold tətbiq edilməsinin mühüm topological features-ı qorumağa, task komponentində daha sərt clipping tətbiq edilməsinin isə privacy qorunmasına kömək etdiyini bildirirlər. Mənbə bu iki threshold-un dəqiq sayısal dəyərlərini vermir.
Tənlik 5: Lokal model yenilənməsi
\[ \theta_i = \theta_i - \eta\nabla_{\theta}\mathcal{L}(\theta_i) \tag{5} \]
\(\theta_i\): \(i\). cihazın lokal model parametrləridir.
\(\eta\): Learning rate-dir.
\(\nabla_{\theta}\mathcal{L}(\theta_i)\): Lokal loss-un parametrlərə görə gradient-idir.
Hər cihaz öz lokal training data-sından gradient hesablayaraq öz modelini yeniləyir.
Tənlik 6: Global model aggregation
\[ \theta_{global} = \frac{1}{N} \sum_{i=1}^{N} \theta_i \tag{6} \]
Mənbə mərkəzi serverdə local model parameters-ın sadə arifmetik ortasını göstərir. \(N\) aggregation-da iştirak edən device/client sayını təmsil edir.
Mənbə client sample sayına görə ayrıca çəkili aggregation formulunu Tənlik 6-da vermir.
Tənlik 7: Noise injection
\[ \theta_i^{priv} = \theta_i + \mathcal{N}(0,\sigma^2) \tag{7} \]
Bu ifadə local update-ə sıfır orta dəyərli Gaussian noise əlavə edilməsini göstərir. Mənbə bu tənliyin ətrafındakı izahda adaptive clipping-dən də bəhs edir; clipping-in daha ətraflı riyazi forması daha sonra Tənlik 12-də verilir.
DP-SGD clipping addımı
Mənbə gradient normunu \(C\) threshold-u ilə məhdudlaşdırır:
\[ \hat{g}_t = \frac{g_t} {\max\left(1,\frac{\lVert g_t\rVert_2}{C}\right)} \]
Əgər \(\lVert g_t\rVert_2\leq C\) olarsa məxrəcdəki maksimum 1 olur və gradient dəyişmir. Gradient normu \(C\)-ni aşarsa gradient eyni istiqamətdə saxlanılır və böyüklüyü məhdudlaşdırılır.
Tənlik 12: Clipping-dən sonra noisy parameter update
\[ \theta_{t+1} = \theta_t - \eta\cdot Adam \left( \hat{g}_t+ \mathcal{N}(0,\sigma^2 C^2 I) \right) \tag{12} \]
Mənbə eksperiment parametrlərində:
- \(\eta=1\times10^{-4}\),
- \(\sigma=0.1\),
- \(\epsilon\approx2.4\),
- \(\delta=10^{-5}\),
- privacy-accounting horizon = 100 training epoch
dəyərlərini verir.
\(\epsilon\) və \(\delta\) differential privacy parametrləridir. Ümumi şərhdə daha kiçik privacy budget daha güclü məxfilik demək ola bilər; lakin bu tədqiqatda performans/məxfilik qiymətləndirilməsi yalnız mənbədə verilən şərtlər kontekstində nəzərdən keçirilməlidir.
Abstract-da membership inference hücumlarının eyni privacy budget altında daha aşağı uğur nisbətinə çatdığı bildirilir. Bununla belə, əsas nəticələr bölməsində membership-inference success rate üçün ayrıca sayısal cədvəl və ya test təfərrüatı verilmədiyinə görə bu iddia kəmiyyət baxımından genişləndirilə bilməz.
Gradient compression
Abstract, discussion və efficiency qiymətləndirməsi federated gradient compression strategiyalarından bəhs edir. Bununla belə, yayımlanmış metod mətni compression operator-un formasını, compression ratio-sunu və ya istifadə olunan quantization/sparsification alqoritmini ayrıca tənliklə bildirmir. Buna görə gradient compression-ın exact implementation-ı mənbədə ətraflı şəkildə təkrar istehsal edilə bilən vəziyyətdə deyil.
Hücumun aşkarlanmasından müdafiə qərarına keçid
Tədqiqatda network state \(s\), mövcud zaman pəncərəsindən çıxarılan trafik sürətləri, protocol distributions və anomaly scores kimi göstəriciləri ehtiva edir. Spatio-temporal Transformer bu state representation-ı yaradır və reinforcement-learning agent müdafiə hərəkətini seçir.
Tənlik 8: Q-learning yenilənməsi
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+ \gamma \max_{a'}Q(s',a') - Q(s,a) \right] \tag{8} \]
\(s\): Mövcud network state.
\(a\): Seçilmiş defense action.
\(r\): Hərəkətdən sonrakı reward.
\(s'\): Növbəti network state.
\(\alpha\): Q-learning update əmsalıdır; mənbə bu tənlik üçün sayısal \(\alpha\) dəyəri vermir.
\(\gamma\): Gələcək reward-ların bugünkü dəyərini müəyyən edən discount factor-dur. DQN loss bölməsində mənbə \(\gamma=0.9\) istifadə edir.
Reward funksiyası
\[ r= w_1\cdot \mathbf{1}(\mathrm{Correct\ Response}) - \left( w_2 L+w_3F \right) \]
\(\mathbf{1}(\mathrm{Correct\ Response})\): Hücumun uğurla qarşısının alınması vəziyyətini göstərən indicator-dur.
\(L\): Response latency-dir.
\(F\): False-positive cost-dur.
\(w_1,w_2,w_3\): Security requirement-a görə tənzimlənən hiperparametrlərdir. Mənbə bu çəkilərin sayısal dəyərlərini bildirmir.
Bu reward strukturu yalnız hücumun qarşısını alma uğurunu mükafatlandırmır; yüksək response latency və false-positive xərcini də cəza kimi nəzərə alır.
Global multi-objective loss
\[ \mathcal{L}(\theta) = \mathcal{L}_{CE}(\theta) + \lambda_{Defense} \mathcal{L}_{Defense}(\theta) + \lambda_{reg} \mathcal{L}_{reg}(\theta) \tag{9} \]
Mənbə:
\[ \lambda_{Defense}=0.5 \]
və
\[ \lambda_{reg}=1\times10^{-4} \]
dəyərlərindən istifadə edir.
\(\mathcal{L}_{CE}\) attack-detection classification error-ını, \(\mathcal{L}_{Defense}\) reinforcement-learning defense loss-u, \(\mathcal{L}_{reg}\) isə overfitting-i məhdudlaşdıran regularization terminini təmsil edir.
Tənlik 10: Binary cross-entropy
\[ \mathcal{L}_{CE}(\theta) = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log(\hat{y}_i) + (1-y_i)\log(1-\hat{y}_i) \right] \tag{10} \]
\(y_i\in\{0,1\}\) həqiqi etiketi, \(\hat{y}_i\) modelin hücum ehtimalını, \(N\) isə batch size-ı təmsil edir.
Həqiqi hücuma aşağı attack probability və ya həqiqi normal nümunəyə yüksək attack probability verildikdə loss artır.
Tənlik 11: DQN Temporal Difference loss
\[ \mathcal{L}_{Defense}(\theta) = \mathbb{E}_{(s,a,r,s')} \left[ \left( r+ \gamma \max_{a'} Q(s',a';\theta^-) - Q(s,a;\theta) \right)^2 \right] \tag{11} \]
\(\theta\): Current Q-network parametrləridir.
\(\theta^-\): Müəyyən aralıqlarla dondurulan target network parametrləridir.
\(\gamma=0.9\): Discount factor.
Loss mövcud Q-value ilə Bellman target arasındakı Temporal Difference xətasının kvadratını azaltmağı hədəfləyir.
Tədqiqatın Metodu və Nəticələri
Verilənlər dəstləri və preprocessing
| Verilənlər dəsti | Kontekst | Feature ölçüsü | Table 1 train / validation / test | Preprocessing |
|---|---|---|---|---|
| UNSW-NB15 | Ümumi network-attack detection; mənbə 9 attack type ehtiva etdiyini bildirir. | d = 42 | 50k / 5k / 10k | Standardization |
| BoT-IoT | IoT/IIoT şəbəkə trafiki; DDoS, DoS, scanning və digər attack types | d = 10 core network feature | 100k / 10k / 20k | Min-Max normalization |
Mənbə model tapşırığını normal/hücum şəklində binary classification kimi müəyyən edir. Buna görə verilənlər dəstlərində bir neçə hücum ailəsi olsa da, əsas objective və Tənlik 10 binary label strukturundan istifadə edir.
UNSW-NB15 üçün metod mətni training/validation/testing nisbətini müvafiq olaraq %50/%10/%40 kimi də ifadə edir. Lakin Table 1-də verilən 50k/5k/10k rəqəmləri bu faizlərlə uyğun gəlmir. Verianla bu iki fərqli mənbə ifadəsindən birini səssizcə düzəltmir.
Table 1-in “Source / Acquisition Method” sütununda UNSW-NB15 və BoT-IoT sətirlərində eyni BoT-IoT layihə ünvanının görünməsi də mənbə cədvəlinin öz təqdimat xüsusiyyətidir. Verianla bunu UNSW-NB15-in həqiqi mənbə ünvanı kimi yenidən istehsal etmir.
Manual feature selection istifadə olunub?
Xeyr. Mənbə hər iki verilənlər dəstinin spatio-temporal encoder-a verilməsindən əvvəl əlavə manual feature selection tətbiq edilmədiyini bildirir. Məqsəd modelin end-to-end feature extraction qabiliyyətini qiymətləndirməkdir.
Model və avadanlıq
| Element | Mənbə dəyəri |
|---|---|
| GPU | NVIDIA GeForce RTX 3080, 10 GB VRAM |
| Framework | PyTorch 1.10 |
| CUDA | 11.2 |
| Transformer qatı | 6 |
| Hidden dimension | 512 |
| Attention head | 8 |
| Optimizer | Adam |
| Initial learning rate | \(1\times10^{-4}\) |
| \(\lambda_{Defense}\) | 0.5 |
| \(\lambda_{reg}\) | \(1\times10^{-4}\) |
| DP noise multiplier | \(\sigma=0.1\) |
| Random seed | 42 |
Experimental Setup bölməsi robustness testing üçün Gaussian noise standard deviation dəyərini 0.05 kimi verir. Sonrakı robustness validation isə noise standard deviation-ı 0-dan 0.2-yə qədər artıran daha geniş sweep bildirir.
Təkrar sayındakı mənbədaxili fərq
Experimental Setup sonunda mənbə “results are reported as the mean ± standard deviation over 5 runs” ifadəsindən istifadə edir. Quantitative Results bölməsində isə “all experiments were repeated 10 times” deyilir. Table 4 başlığı da açıq şəkildə n=10 göstərir.
Buna görə təkrar sayını bütün eksperimentlər üçün vahid dəqiq rəqəm kimi yenidən yazmaq təhlükəsiz deyil. Table 3–4-də görünən mean ± standard deviation dəyərləri mənbədə yayımlandığı formada qorunmuşdur.
Qiymətləndirmə metrikləri
Mənbə Accuracy, Precision, Recall və F1-Score istifadə edir:
\[ Accuracy= \frac{TP+TN} {TP+TN+FP+FN} \]
\[ Precision= \frac{TP}{TP+FP} \]
\[ Recall= \frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
TP doğru hücum aşkarlamalarını, TN doğru normal trafik qərarlarını, FP normal trafik üçün yanlış hücum həyəcanını, FN isə qaçırılan həqiqi hücumları təmsil edir.
Baseline üsulları
- LSTM-IDS: Zaman dependency-lərini modelləşdirən recurrent baseline.
- FedIDS: Federated-learning əsaslı intrusion-detection baseline.
- DP-GNN: Differential privacy ilə graph convolution-ı birləşdirən privacy-preserving baseline.
- RustGraph: Dynamic graph anomaly detection üçün structural-temporal dependency modelləşdirən baseline.
Əsas performans müqayisəsi
| Üsul | Verilənlər dəsti | Accuracy | FPR | F1 | Training Time | p-value |
|---|---|---|---|---|---|---|
| LSTM-IDS | UNSW-NB15 | 87.2% ± 0.6% | 5.2% ± 0.3% | 86.4% ± 0.5% | 1200 ± 120 s | <0.001 |
| LSTM-IDS | BoT-IoT | 84.5% ± 0.8% | 6.8% ± 0.4% | 83.9% ± 0.7% | 1500 ± 150 s | <0.001 |
| FedIDS | UNSW-NB15 | 89.5% ± 0.5% | 3.8% ± 0.2% | 88.7% ± 0.6% | 1300 ± 130 s | 0.002 |
| FedIDS | BoT-IoT | 87.0% ± 0.7% | 4.5% ± 0.3% | 86.2% ± 0.8% | 1600 ± 160 s | 0.001 |
| DP-GNN | UNSW-NB15 | 90.3% ± 0.4% | 3.1% ± 0.2% | 89.5% ± 0.5% | 1400 ± 140 s | 0.005 |
| DP-GNN | BoT-IoT | 88.5% ± 0.6% | 3.9% ± 0.3% | 87.8% ± 0.7% | 1700 ± 170 s | 0.003 |
| RustGraph | UNSW-NB15 | 91.2% ± 0.3% | 2.4% ± 0.1% | 90.5% ± 0.4% | 1500 ± 150 s | 0.01 |
| RustGraph | BoT-IoT | 90.0% ± 0.5% | 3.0% ± 0.2% | 89.2% ± 0.6% | 1800 ± 180 s | 0.008 |
| Proposed Method | UNSW-NB15 | 93.5% ± 0.2% | 1.2% ± 0.1% | 92.8% ± 0.3% | 1100 ± 110 s | — |
| Proposed Method | BoT-IoT | 92.0% ± 0.4% | 1.8% ± 0.2% | 91.3% ± 0.5% | 1400 ± 140 s | — |
Proposed Method hər iki verilənlər dəstində mənbə cədvəlindəki ən yüksək accuracy və F1 dəyərlərini, eyni zamanda ən aşağı FPR dəyərlərini verir.
BoT-IoT-da proposed accuracy %92,0, DP-GNN accuracy %88,5 olduğuna görə fərq:
\[ 92.0-88.5=3.5 \]
3,5 faiz bəndidir. Bu ifadə relative percentage increase deyil, iki accuracy faizi arasındakı mütləq percentage-point fərqidir.
Table 3 p-value sütununda baseline-lar üçün dəyərlər verilir və significance level 0.05 kimi göstərilir. Lakin mənbə istifadə olunan exact statistical test-in adını və p-value sütunundakı exact null hypothesis-i ətraflı şəkildə bildirmir. Buna görə p-dəyərlərinin hansı testdən yarandığı Verianla tərəfindən təxmin edilməyib.
Convergence nəticəsi
Mənbə Figure 5-də proposed method-un UNSW-NB15 üzərində təxminən 80. epoch-da %90 accuracy səviyyəsinə çatdığını, RustGraph-ın oxşar səviyyəyə çatmasının 92 epoch-dan çox çəkdiyini bildirir.
Mənbə bu daha sürətli convergence davranışını adaptive graph structure və spatio-temporal attention-ın redundant connections üzərindən gradient propagation-ı azaltması ilə əlaqələndirir. Bu mexanizm şərhi müəlliflərin izahıdır.
Efficiency nəticələri
| Üsul | Parametr (M) | FLOPs (G) | Training Time (s/epoch) | Inference Latency (ms/sample) |
|---|---|---|---|---|
| LSTM-IDS | 2.1 ± 0.0 | 4.8 ± 0.1 | 15.0 ± 0.8 | 1.2 ± 0.1 |
| FedIDS | 3.4 ± 0.1 | 7.2 ± 0.3 | 16.3 ± 0.9 | 1.8 ± 0.2 |
| DP-GNN | 5.7 ± 0.2 | 12.5 ± 0.5 | 17.5 ± 1.0 | 2.5 ± 0.3 |
| RustGraph | 6.9 ± 0.3 | 15.0 ± 0.6 | 18.8 ± 1.1 | 3.0 ± 0.2 |
| Proposed Method | 7.2 ± 0.2 | 14.8 ± 0.5 | 13.8 ± 0.7 | 2.1 ± 0.2 |
Proposed Method parametr sayı baxımından ən böyük modeldir: 7,2 milyon parametr. Buna baxmayaraq, RustGraph-ın 18,8 s/epoch training time-ına qarşı 13,8 s/epoch və 3,0 ms/sample inference latency-sinə qarşı 2,1 ms/sample verir.
Mənbə RustGraph-a nisbətən training time-ın təxminən %26,6, inference latency-nin isə %30 daha aşağı olduğunu bildirir. GNN əsaslı baseline hidden dimensions-ın oxşar parameter scale təmin edəcək şəkildə standardize edildiyi də qeyd olunur.
2,1 ms Inference Gecikməsi Real Vaxt Sahə Uğurunu Sübut Edirmi?
Xeyr. Mənbə 2,1 ± 0,2 ms/sample dəyərinin dynamic graph construction, feature extraction və Transformer forward pass-i əhatə edən öz eksperimental uçdan-uca inference ölçümü olduğunu və təxminən 500 traffic sample/s emal gücünə uyğun gəldiyini bildirir; lakin ölçmə RTX 3080 GPU üzərində benchmark verilənləri ilə aparılmışdır və real edge cihazında, V2X vasitəsində və ya istehsal şəbəkəsində uzunmüddətli sahə deployment-ı deyil.
Riyazi olaraq:
\[ \frac{1}{0.0021\;s} \approx476\;sample/s \]
alınır. Mənbənin “nearly 500 traffic samples per second” ifadəsi bu təxmini dəyərə uyğundur.
Lakin mənbə discussion bölməsində adaptive graph construction-ın ciddi resource-constrained micro-IoT node-larda əlavə computation overhead yaratdığını və optimallaşdırma lazım olduğunu açıq şəkildə qəbul edir.
Uğurlu keyfiyyət nümunəsi
Mənbə “UNSW-NB15 – DoS Hulk” etiketi ilə verdiyi nümunədə 28–32. saniyələr arasındakı attack window-da hədəf host-a yeni bağlantı sayının baseline ortalaması 24,3 connection/s səviyyəsindən 3872 connection/s peak dəyərinə yüksəldiyini bildirir.
Normal fluctuation aralığı təxminən ±2σ ≈ 60 kimi verilmişdir. Proposed Method hücumu %96,7 confidence ilə DoS kimi təsnif etmişdir.
t=30 s anında attention çəkiləri:
| Feature | Attention weight |
|---|---|
| Connection burstiness | 0.42 |
| Destination port diversity | 0.38 |
LSTM-IDS eyni nümunəni %58,1 confidence ilə normal trafik kimi yanlış təsnif etmişdir.
Mənbə adlandırma qeydi: Məqalə bu halı açıq şəkildə “UNSW-NB15 – DoS Hulk Attack Detection” adlandırır. Yayımlanmış mətn bu hücum adlandırmasının verilənlər dəstinin taksonomiyası ilə əlaqəsini ayrıca izah etmir. Verianla mənbə etiketini dəyişmir və çatışmayan izahı uydurmur.
Ultra-Aşağı Tezlikli Skanda Model Niyə Uğursuz Oldu?
Mənbədə verilən aşağı sürətli port-scan nümunəsində hücum siqnalı normal IoT heartbeat trafikinə çox yaxın olduğu, federated clients yalnız məhdud lokal görünüş gördüyü və \(\sigma=0.1\) differential-privacy noise zəif anomaly gradient-lərini boğduğu üçün dynamic graph mənalı anomaly edge-ləri yarada bilməmiş və model hücumu normal trafik kimi təsnif etmişdir.
| Element | Mənbə dəyəri |
|---|---|
| Probe tezliyi | 6 dəqiqədə 1 probe |
| Ümumi müşahidə | 30 dəqiqə |
| Ümumi probe | 5 |
| Hücum packet rate | 0.8 pkt/s |
| Normal IoT heartbeat aralığı | 0.7–1.1 pkt/s |
| Adjacency matrix sparsity | 99.6% |
| Model qərarı | Normal registration behavior |
| Confidence | 62.3% |
| DP noise | \(\sigma=0.1\) |
Mənbə gələcəkdə cross-device meta-event correlations və ya unsupervised anomaly priors kimi mexanizmlərin bu information-scarcity probleminə kömək edə biləcəyini təklif edir. Bunlar mövcud eksperimentdə təsdiqlənmiş nəticələr deyil.
Noise robustness
Input feature-lara Gaussian noise əlavə edildikdə standard deviation 0-dan 0.2-yə artırılmışdır. Proposed Method accuracy dəyəri %93,5-dən %89,3-ə düşdüyü halda RustGraph %83,2, DP-GNN isə %84,6 səviyyəsinə geriləmişdir.
| Üsul | Başlanğıc / istinad | Noise std = 0.2 şərtində nəticə |
|---|---|---|
| Proposed Method | 93.5% accuracy | 89.3% accuracy |
| RustGraph | Mənbə bu cümlədə başlanğıc dəyərini təkrar vermir. | 83.2% accuracy |
| DP-GNN | Mənbə bu cümlədə başlanğıc dəyərini təkrar vermir. | 84.6% accuracy |
Mənbə Figure 7 əyrisinin bütün aralıq numeric nöqtələrini cədvəl şəklində vermədiyi üçün Verianla aralıq dəyər interpolasiyası aparmır.
Mənbə həmçinin “spatial attention module” çıxarıldıqda accuracy-nin %83,5-ə düşdüyünü bildirir. Bu ifadə Table 5-dəki modul adlandırmasından ayrıca robustness izahında keçir.
Cross-Dataset Birbaşa Transfer Necə Sınaqdan Keçirildi?
Cross-dataset generalization təcrübəsi proposed modelin UNSW-NB15 üzərində öyrədilib BoT-IoT üzərində heç bir fine-tuning aparılmadan birbaşa sınaqdan keçirilməsi ilə həyata keçirilmişdir; mənbə proposed modelin hər iki tərəfdə F1 dəyərini %91-dən yuxarı saxladığını və hədəf BoT-IoT-da RustGraph-ı 2,1 faiz bəndi üstələdiyini bildirir.
Bu eksperiment standart eyni-dataset train/test qiymətləndirməsindən daha güclü distribution-shift sınağıdır, çünki model hədəf verilənlər dəstinə yenidən uyğunlaşdırılmamışdır.
Mənbə hədəf BoT-IoT-da hybrid DDoS kimi unseen attack variants olduğunu bildirir. Proposed Method-in dynamic graph structure və local-global federated modeling kombinasiyasının bu distribution shift-ə uyğunlaşmada rol oynadığı müəlliflər tərəfindən irəli sürülür.
Lakin cross-dataset nəticəsi real dünyadakı hər şəbəkə mühitinə universal generalization sübutu deyil. Yalnız mənbədə sınaqdan keçirilən UNSW-NB15 → BoT-IoT transfer şərtini dəstəkləyir.
Ablasiya analizi
| Model variantı | UNSW-NB15 | BoT-IoT |
|---|---|---|
| Full Model | 93.5 / 92.8 | 92.0 / 91.3 |
| Adaptive Spatio-Temporal Graph Generation çıxarıldı | 90.1 / 89.4 | 88.7 / 87.9 |
| Federated Differential Privacy çıxarıldı; Centralized Training | 92.8 / 92.0 | 91.2 / 90.5 |
| Reinforcement Learning Dynamic Defense Module çıxarıldı | 93.2 / 92.5 | 91.7 / 91.0 |
| Spatio-Temporal Transformer əvəzinə GCN+LSTM | 89.6 / 88.7 | 87.4 / 86.5 |
| Base GNN Only | 87.3 / 86.1 | 84.9 / 83.8 |
BoT-IoT F1 baxımından full model %91,3-dür. Adaptive graph çıxarıldıqda %87,9-a düşərək 3,4 percentage-point itki yaranır. Spatio-temporal Transformer GCN+LSTM ilə əvəz edildikdə %86,5-ə düşür; itki 4,8 percentage point-dir.
Federated differential privacy mexanizmi centralized training ilə əvəz edildikdə BoT-IoT F1 %91,3-dən %90,5-ə enir; fərq 0,8 percentage point-dir.
RL dynamic-defense module çıxarıldıqda BoT-IoT F1 yalnız %91,3-dən %91,0-a enir. Mənbə bu kiçik classification fərqini gözlənilən nəticə kimi şərh edir, çünki reinforcement-learning qatının əsas işi classification deyil, hücumdan sonra response strategy seçməkdir.
Base GNN Only strukturu BoT-IoT-da %83,8 F1 ilə ən zəif variantdır. Bu nəticə mənbədə graph representation-ın təkbaşına kifayət etmədiyini və spatio-temporal attention-ın mühüm töhfəsini dəstəkləyən ablation tapıntısı kimi şərh edilir.
Privacy–utility trade-off
Ablasiya federated differential privacy mexanizminin çıxarılmasının accuracy/F1 üzərində digər mərkəzi arxitektura komponentləri qədər böyük fərq yaratmadığını göstərir. Mənbə bunu privacy protection-ın daha aşağı utility itkisi ilə tətbiq oluna bildiyinin sübutu kimi şərh edir.
Lakin privacy mexanizmi üçün membership-inference success rate əsas nəticə cədvəllərində kəmiyyət olaraq verilmədiyinə görə privacy–utility qiymətləndirilməsi əsasən differential-privacy parametrləri, detection metrics və ablation nəticələri üzərindən izlənə bilir.
Tədqiqatın dəstəklədiyi nəticələr
- Adaptiv spatio-temporal graph və Transformer kombinasiyası istifadə olunan iki benchmark-da baseline-lardan daha yüksək accuracy və F1 yaratmışdır.
- Proposed Method UNSW-NB15-də %93,5 ± %0,2 accuracy və %92,8 ± %0,3 F1 əldə etmişdir.
- Proposed Method BoT-IoT-da %92,0 ± %0,4 accuracy və %91,3 ± %0,5 F1 əldə etmişdir.
- BoT-IoT-da proposed accuracy DP-GNN-dən 3,5 percentage point yüksəkdir.
- FPR UNSW-NB15-də %1,2 ± %0,1, BoT-IoT-da %1,8 ± %0,2 kimi bildirilmişdir.
- UNSW-NB15 → BoT-IoT direct-transfer təcrübəsi fine-tuning olmadan aparılmışdır.
- Adaptive graph və Transformer ablasiyaları model performansında ən böyük enişləri yaratmışdır.
- Federated differential privacy mexanizmini centralized training ilə əvəz etmək full model-lə müqayisədə %1-dən az F1 fərqi yaratmışdır.
- RTX 3080 eksperiment mühitində end-to-end inference latency 2,1 ± 0,2 ms/sample kimi ölçülmüşdür.
- Input noise std 0,2-yə qədər artırıldıqda proposed accuracy %89,3-ə geriləmiş, lakin mənbədə müqayisə edilən baselines-dan daha yüksək qalmışdır.
- Ultra-low-frequency scanning nümunəsi modelin mühüm uğursuzluq sərhədini göstərir.
Tədqiqatın dəstəkləmədiyi və ya çatışmayan nəticələr
- Real V2X avtomobil şəbəkəsində və ya kommersiya IoT deployment-ında uzunmüddətli sahə performansı göstərilməyib.
- 2,1 ms nəticəsi bütün micro-IoT avadanlıqlarında eyni latency-nin əldə ediləcəyinə zəmanət vermir.
- UNSW-NB15 → BoT-IoT transfer nəticəsi hər naməlum şəbəkə verilənlər domenində eyni generalization-ın yaranacağını sübut etmir.
- Ultra-low-frequency stealth attacks həll edilməyib.
- Membership inference hücumlarının uğur nisbətindəki azalma abstract-da bildirilsə də əsas mətndə kəmiyyət dəyəri və ətraflı protokol verilmir.
- Gradient-compression alqoritminin exact implementation-ı, compression ratio-su və operator təfərrüatları bildirilmir.
- Sliding temporal window size \(K\)-nın sayısal dəyəri bildirilmir.
- Structural və task gradient clipping threshold dəyərləri ayrıca bildirilmir.
- Reward weights \(w_1,w_2,w_3\) sayısal olaraq verilmir.
- Table 3-dəki p-value-ları yaradan statistical test-in exact adı bildirilmir.
- Mənbədə 5 run ilə 10 repeat ifadələri arasında uyğunsuzluq var.
- UNSW-NB15 üçün yazılmış %50/%10/%40 nisbəti Table 1-dəki 50k/5k/10k rəqəmləri ilə uyğun gəlmir.
Məhdudiyyətlər və gələcək tədqiqat
Mənbə ən nəzərəçarpan məhdudiyyətin extremely low-frequency stealth attacks olduğunu bildirir. Federated learning client-larının məhdud local views-a sahib olması və differential-privacy noise-un aşağı-amplitude anomaly gradients-i boğması xüsusilə seyrək hücumlarda detection-ı çətinləşdirir.
Adaptive graph construction-ın 2,1 ms overall latency daxilində işləməsinə baxmayaraq, severely resource-constrained micro-IoT node-larda əlavə energy/computation overhead yarada biləcəyi bildirilir.
Təklif olunan gələcək tədqiqatlar arasında client-lar arasında lightweight meta-event summary paylaşımı, Secure Multi-Party Computation və ya highly aggregated statistics istifadəsi, event-driven sparse graph updates, fully unsupervised və ya open-set anomaly detection və micro-embedded devices üçün graph-construction optimallaşdırması var.
Mənbə və Metod Qeydi
Özgün başlıq: A Spatio-Temporal Transformer-Based Approach for Network Attack Detection
Müəlliflər və sıra: Xin Liu; Xiang Liu.
Corresponding author: Xin Liu; mənbədə ulduz işarəsi ilə göstərilmişdir.
Xin Liu qurumu: School of Advanced Engineering, University of Science and Technology Beijing, Beijing 100083, China.
Xin Liu e-poçt: u202341641@xs.ustb.edu.cn
Xiang Liu qurumu: School of International Education, Beijing University of Chemical Technology, Beijing 102203, China.
Xiang Liu e-poçt: 2024090034@mail.buct.edu.cn
Bərabər töhfə / bərabər birinci müəlliflik: Mənbədə bərabər töhfə bəyanatı yoxdur.
Jurnal: Journal of Universal Computer Science.
Qısaltma: J.UCS.
Cild / nömrə: Volume 32, Number 9.
Səhifələr: 1375–1398.
Nəşr ili: 2026.
Submitted: 23 Yanvar 2026.
Accepted: 7 İyul 2026.
Appeared / Published: 14 Sentyabr 2026.
DOI: 10.3897/jucs.207303.
Rəsmi DOI keçidi: https://doi.org/10.3897/jucs.207303
Mənbə növü: Yayımlanmış özgün tədqiqat məqaləsi.
Rəyçilik statusu: Journal of Universal Computer Science rəyçilər tərəfindən qiymətləndirilən jurnaldır; jurnalın aktual rəsmi profilində single-blind review və ən azı iki editorial-board reviewer göstərilir.
Məqalə lisenziyası: CC BY 4.0; məqalə PDF-inin ilk səhifəsində açıq şəkildə göstərilmişdir.
Əsas problem: Dynamic network topology şəraitində yüksək accuracy, privacy preservation və aşağı-latency attack detection/response hədəflərini eyni framework daxilində nəzərdən keçirmək.
Tapşırığın formullaşdırılması: Binary classification; \(y=0\) normal, \(y=1\) malicious traffic.
Əsas üç modul: Spatio-temporal feature extraction; federated differential-privacy protection; reinforcement-learning attack detection/defense.
Dynamic graph: Communication relationships və traffic-feature similarity əsasında time-dependent adjacency matrix.
Graph threshold: Metod bölməsində learnable \(\epsilon\); sensitivity analysis seçilmiş dəyər kimi \(\epsilon=0.5\) bildirir.
Threshold sensitivity: \(\epsilon\in[0.4,0.6]\) üçün F1 > %91; \(\epsilon>0.7\) üçün F1 təxminən %86,5.
Transformer: 6 layer, hidden dimension 512, 8-head multi-head attention.
Federated aggregation: Mənbə Tənlik 6-da local model parameters-ın sadə ortasını verir.
Differential privacy: DP-SGD, gradient clipping və Gaussian noise.
DP noise multiplier: \(\sigma=0.1\).
Privacy budget: Təxminən \(\epsilon=2.4\), \(\delta=10^{-5}\), 100 epoch sonunda mənbədə bildirilən şərt.
Feature decoupling: Structural gradient və task gradient komponentlərinə ayrılma; dəqiq clipping threshold rəqəmləri bildirilmir.
Gradient compression: Mənbə tərəfindən komponent kimi göstərilir; exact compression algorithm və nisbət bildirilmir.
Reinforcement learning: Q-learning / Deep Q-Network.
DQN discount factor: \(\gamma=0.9\).
Defense actions: Mənbə nümunə kimi traffic limiting və data filtering verir.
Reward: Correct response mükafatını latency və false-positive cost cəzası ilə birləşdirir; \(w_1,w_2,w_3\) dəyərləri bildirilmir.
Global loss: Binary cross-entropy + defense TD loss + regularization.
\(\lambda_{Defense}\): 0.5.
\(\lambda_{reg}\): \(1\times10^{-4}\).
Optimizer: Adam.
Initial learning rate: \(1\times10^{-4}\).
UNSW-NB15 features: d = 42, ID və labels istisna olmaqla.
BoT-IoT features: d = 10 core network features.
UNSW preprocessing: Standardization.
BoT-IoT preprocessing: Min-Max normalization.
Manual feature selection: İstifadə edilməyib.
Table 1 sample split: UNSW-NB15 50k / 5k / 10k; BoT-IoT 100k / 10k / 20k.
Mənbədaxili partition fərqi: Mətn UNSW-NB15 üçün %50/%10/%40 nisbətini verir; Table 1-dəki 50k/5k/10k bununla uyğun gəlmir.
Avadanlıq: NVIDIA GeForce RTX 3080 GPU, 10 GB VRAM.
Proqram təminatı: PyTorch 1.10, CUDA 11.2.
Random seed: 42.
Mənbədaxili run-count fərqi: Experimental Setup 5 run mean ± std deyir; Quantitative Results 10 repeat deyir və Table 4 n=10 göstərir.
Significance level: 0.05.
Statistical-test sərhədi: Table 3 p-value verir; exact statistical-test adı və null-hypothesis təfərrüatı əsas mətndə açıq göstərilmir.
UNSW-NB15 əsas nəticəsi: Accuracy 93.5% ± 0.2%; F1 92.8% ± 0.3%; FPR 1.2% ± 0.1%.
BoT-IoT əsas nəticəsi: Accuracy 92.0% ± 0.4%; F1 91.3% ± 0.5%; FPR 1.8% ± 0.2%.
DP-GNN müqayisəsi: BoT-IoT accuracy 88.5% ± 0.6%; proposed fərqi +3.5 percentage point.
Inference latency: 2.1 ± 0.2 ms/sample.
Inference əhatəsi: Dynamic graph construction + feature extraction + Transformer forward pass.
Proposed parameter count: 7.2 ± 0.2 million.
Proposed FLOPs: 14.8 ± 0.5 G.
Training time: Table 4-də 13.8 ± 0.7 s/epoch.
Cross-dataset test: UNSW-NB15 üzərində training → BoT-IoT üzərində fine-tuning olmadan direct testing.
Cross-dataset nəticəsi: Mənbə proposed F1-in iki verilənlər dəstində %91-dən yuxarı qaldığını və hədəf BoT-IoT-da RustGraph-dan 2.1 percentage point yüksək olduğunu bildirir.
Noise robustness: Gaussian feature noise std 0→0.2; proposed accuracy 93.5%→89.3%.
Mühüm failure case: 6 dəqiqədə bir probe, 30 dəqiqədə 5 probe, 0.8 pkt/s; normal heartbeat 0.7–1.1 pkt/s; adjacency sparsity 99.6%; normal prediction confidence 62.3%.
Membership inference qeydi: Abstract eyni privacy budget altında attack success rate-in əhəmiyyətli şəkildə azaldıldığını bildirir; əsas mətndə kəmiyyət membership-inference success rate və ya ətraflı eksperiment protokolu yoxdur.
Ablasiya nəticəsi: BoT-IoT F1 full model 91.3%; no adaptive graph 87.9%; centralized/no federated DP 90.5%; no RL defense 91.0%; GCN+LSTM replacement 86.5%; base GNN only 83.8%.
Maliyyələşdirmə: Araşdırılan PDF-də ayrıca funding declaration bölməsi yoxdur.
Maraqların toqquşması: Araşdırılan PDF-də ayrıca conflict-of-interest declaration yoxdur.
Data Availability: Araşdırılan PDF-də ayrıca Data Availability statement yoxdur; eksperiment bölməsində UNSW-NB15 və BoT-IoT public datasets kimi müəyyən edilir.
Müəllif töhfələri / CRediT: Araşdırılan PDF-də ayrıca author-contributions və ya CRediT bəyanatı yoxdur.
Əsas tədqiqat sərhədi: Nəticələr benchmark verilənlər dəstləri və RTX 3080 əsaslı eksperiment mühitinə aiddir; real micro-IoT node, V2X fleet və ya production SOC üzərində uzunmüddətli sahə doğrulaması deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib