


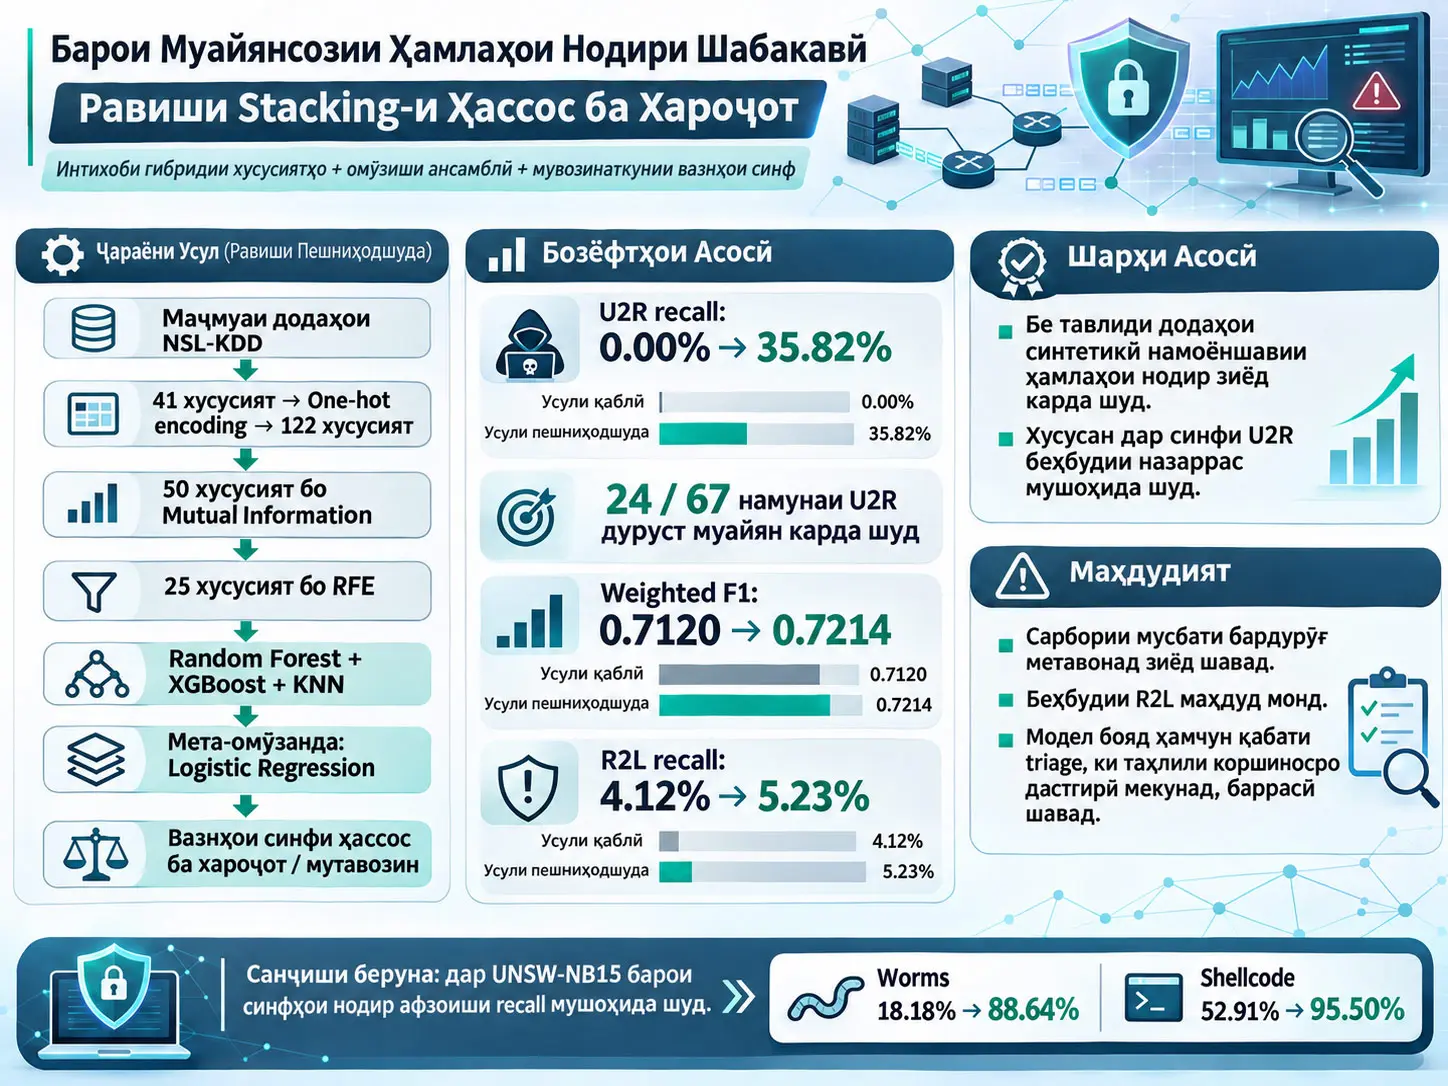
Чорчӯбаи MI–RFE–stacking-и ҳассос ба хароҷот як ҷараёни арзёбии Network Intrusion Detection System (NIDS) мебошад, ки барои баланд бардоштани намоёнии ҳамлаҳои нодир дар ошкорсозии ҳамлаҳои шабакавии бисёрсинфаи номутаносиб интихоби хусусиятҳо бо Mutual Information (MI) ва Recursive Feature Elimination (RFE), stacking ensemble-и гетерогенӣ ва хароҷоти хатоҳои вобаста ба синфро якҷо мекунад ва мушоҳидаҳои аслии додаҳоро нигоҳ медорад. Таҳқиқот таснифгари нав пешниҳод намекунад; балки меомӯзад, ки ҷузъҳои маъмул ба монанди Random Forest, XGBoost, Support Vector Machine (SVM), K-Nearest Neighbors (KNN), Logistic Regression, MI, RFE ва balanced class weighting дар протоколи назоратшаванда ва такроршавандае, ки ба синфҳои нодир тамаркуз мекунад, чӣ гуна рафтор мекунанд.
Арзёбии асосӣ дар benchmark-и NSL-KDD анҷом дода шудааст. KDDTrain+ дорои 125,973 ва KDDTest+ дорои 22,544 сабти пайвастшавии шабакавӣ мебошад. Пас аз one-hot encoding-и тағйирёбандаҳои категориявии protocol_type, service ва flag, 41 хусусияти аслӣ ба 122 хусусияти ададӣ васеъ карда шуданд; Min-Max scaling танҳо ба маҷмуаи омӯзиш мувофиқ карда шуд; сипас бо MI 50 хусусияти дорои холҳои баландтарин нигоҳ дошта шуда, бо RFE-и бар асоси Random Forest шумора ба 25 коҳиш дода шуд.
Stacking ensemble-и асосӣ Random Forest, XGBoost ва KNN-ро ҳамчун base learner ва Logistic Regression-ро ҳамчун meta-learner истифода мебарад. Барои meta-learner пешгӯиҳои 3-fold out-of-fold тавлид мешаванд. Номутавозунии синфҳо бидуни тавлиди додаҳои синтетикӣ бо balanced class weighting дар шакли w_c = N/(C n_c) коркард шудааст. Дар тақсимоти NSL-KDD вазнҳои тахминии синфҳо барои Normal 0.37, барои DoS 0.55, барои Probe 2.16, барои R2L 25.32 ва барои U2R 484.49 мебошанд.
Дар натиҷаи асосии якдавраинаи stacking ensemble, U2R recall аз 0.00% то 35.82% афзудааст; яъне baseline model аз 67 намунаи U2R ягонтояшро дуруст муайян накарда бошад, сохтори cost-sensitive 24-тои онҳоро дуруст муайян кардааст. Weighted F1 аз 0.7120 то 0.7214 боло рафтааст, аммо accuracy аз 0.7542 то 0.7342 коҳиш ёфтааст. R2L recall бошад танҳо аз 4.12% то 5.23%, яъне аз 119/2887 ошкорсозии дуруст то 151/2887 афзудааст.
Натиҷаи U2R ба маҳдудияти ҷиддии тафсир ниёз дорад. Азбаски дар натиҷаи cost-sensitive hard-label stacking барои U2R дар муқобили 24 true positive 1695 false positive гузориш шудааст, precision танҳо 0.0140 мебошад. Дар таҳлили ҷудогонаи probability-threshold ҳам U2R precision тақрибан дар сатҳи %1 боқӣ мондааст. Аз ин рӯ, баромади U2R-и модел, мувофиқи муҳокимаи худи таҳқиқот, қарори ниҳоии автономӣ нест, балки сигнали triage мебошад, ки баррасии таҳлилгари амниятро авлавият медиҳад.
Таҳқиқот инчунин нишон медиҳад, ки равиши cost-sensitive аз ҳамаи алтернативаҳо беҳтар нест. Дар муқоисаи full-training resampling, ADASYN аз рӯи weighted F1 ва R2L recall қавитар аст; дар exploratory baselines-и баъдӣ Balanced Random Forest U2R recall-и баландтар ва шумораи камтари U2R false-positive фароҳам овардааст. Бартарии фарқкунандаи равиши пешниҳодшуда дар он аст, ки бидуни тавлиди намунаҳои синтетикии ақаллият мушоҳидаҳои аслии омӯзишро нигоҳ медорад ва рафтори ҳамлаҳои нодирро ба таври ошкор назорат мекунад.
Дар санҷиши берунии UNSW-NB15 низ recall-и синфҳои нодир ба таври назаррас афзудааст; аммо Normal recall ва weighted F1 коҳиш ёфтаанд. Ин натиҷаҳо тасдиқ мекунанд, ки усул ҳангоми додани вазни бештар ба синфҳои нодир воқеан сарҳадҳои қарорро тағйир медиҳад, вале ин маънои бартарии умумӣ ё муваффақияти автоматии deployment дар шабакаҳои истеҳсолии муосирро надорад.
Чаро Cost-Sensitive Learning Дар Ин Таҳқиқот Истифода Мешавад?
Cost-sensitive learning ба ҷойи баробар ҳисоб кардани ҳамаи хатогиҳои таснифотӣ дар маҷмуаи додаҳои номутаносиб, ба хатогиҳои синфҳои нодир ҷазои баландтари омӯзишӣ медиҳад ва сарҳади қарорро нисбат ба синфҳои ақаллият ҳассостар мекунад; ҳадафи асосӣ дар ин таҳқиқот кам кардани гумшавии махсусан ҳамлаҳои U2R ва R2L дар байни синфҳои аксарият, дар ҳоле ки сабтҳои аслии омӯзиш бо намунаҳои синтетикӣ иваз намешаванд, мебошад.
Чаро ҳамлаҳои нодир метавонанд дар accuracy-и умумӣ гум шаванд?
NSL-KDD панҷ синфи асосиро истифода мебарад: Normal, Denial of Service (DoS), Probe, Remote-to-Local (R2L) ва User-to-Root (U2R). Дар маҷмуаи омӯзиш Normal ва DoS якҷоя тақрибан %90 сабтҳоро ташкил медиҳанд, дар ҳоле ки U2R танҳо аз 52 намунаи омӯзишӣ иборат аст; ин тақрибан %0.04 мебошад. Дар чунин тақсимот модел метавонад синфҳои аксариятро хуб омӯзад ва синфи нодирро қариб пурра нодида гирад, вале ҳамоно accuracy-и глобалии нисбатан баланд ба даст орад.
DoS синфи ҳамлаест, ки ҳадафаш вайрон кардани дастрасии хадамот ё захира мебошад. Probe рафторҳои ҷамъоварии иттилоъ дар бораи шабака ё система ва ҷустуҷӯи ҳадафҳои дастрасро фаро мегирад. R2L синфест, ки ба гирифтани дастрасии беиҷозат аз манбаи дурдаст ба системаи маҳаллӣ марбут аст. U2R бошад ба гирифтани сатҳи баландтар ё имтиёзи administrator/root аз ҷониби корбар марбут буда, хеле нодир, вале аз нигоҳи амният муҳим аст.
Дар Figure 4-и манбаъ 5000 намунаи KDDTest+ бо t-SNE дар ду андоза визуалӣ шудааст. Дар тасвир намунаҳои DoS ва Normal баъзе минтақаҳои ҷудошавандаро ташкил медиҳанд, дар ҳоле ки намунаҳои R2L ва U2R бо трафики Normal ба таври қавӣ ҳампӯш мешаванд. t-SNE дар ин ҷо таснифгар нест; он усулест барои кам кардани feature space-и баландандоза ба ду андоза бо мақсади таҳлили визуалӣ. Паёми асосии тасвир ин аст, ки мушкили ҳамлаҳои нодир на танҳо аз шумораи синфҳо, балки аз feature-space overlap низ сарчашма мегирад.
Формулаи balanced class weight
Вазни асосии хароҷоте, ки дар манбаъ истифода шудааст:
\[ w_c=\frac{N}{C\,n_c} \]
Формула чиро ҳисоб мекунад? Вазни нисбии хатогиро, ки ҳангоми омӯзиш барои ҳар синф истифода мешавад, ҳисоб мекунад.
\(w_c\): вазни беандозаи синфи \(c\).
\(N\): шумораи умумии намунаҳои омӯзиш; дар маҷмуаи асосии омӯзиши NSL-KDD 125,973.
\(C\): шумораи синфҳо; дар ин таҳқиқот 5.
\(n_c\): шумораи намунаҳои омӯзишии мутааллиқ ба синфи дахлдор.
Ҳар қадар шумораи намунаҳои синф кам шавад, \(n_c\) дар махраҷ хурдтар ва \(w_c\) калонтар мешавад. Аз ин рӯ, таснифи нодуруст дар синфи хеле нодир ба монанди U2R аз нигоҳи ҳадафи омӯзиш нисбат ба хатогӣ дар синфи Normal ҷазои хеле баландтар мегирад.
| Синф | Вазни тахминӣ | Маънои алгоритмӣ |
|---|---|---|
| Normal | 0.37 | Синфи хеле сершумор; ҷазои хато нисбатан паст аст. |
| DoS | 0.55 | Синфи ҳамла бо басомади баланд. |
| Probe | 2.16 | Синфи басомади миёна. |
| R2L | 25.32 | Синфи нодир; таснифи нодуруст сахттар ҷазо дода мешавад. |
| U2R | 484.49 | Нодиртарин синф; таснифи нодуруст ҷазои нисбии хеле баланд мегирад. |
Барои Random Forest, SVM ва Logistic Regression class_weight = balanced истифода шудааст. Дар XGBoost вазнҳои намунаҳо бар асоси ҳамон формулаи басомади синф истифода шудаанд. Азбаски дар формулаи стандартии KNN-и истифодашуда чунин механизми class-weight вуҷуд надорад, натиҷаи KNN дар марҳилаи cost-sensitive тағйир намеёбад.
Чаро SMOTE мустақиман истифода нашудааст?
Сабаби асосии интихоби data-preserving аз ҷониби муаллифон ин аст, ки U2R танҳо 52 намунаи воқеии омӯзишӣ дорад. Вақте аз намунаи хеле хурди воқеӣ шумораи зиёди мушоҳидаҳои синтетикӣ тавлид мешавад, нигаронӣ вуҷуд дорад, ки минтақаҳои қарорҳои сунъӣ пайдо мешаванд, ки аз ҷиҳати ададӣ муфиданд, аммо рафтори воқеии ҳамларо ба қадри кофӣ намоиш намедиҳанд. Аз ин рӯ framework-и асосӣ ба ҷойи зиёд кардани додаҳои омӯзиш loss/хароҷоти қарорро тағйир медиҳад.
Аммо таҳқиқот ин асосноккуниро танҳо ҳамчун фарзия нагузошта, SMOTE, Borderline-SMOTE, ADASYN ва SMOTE-Tomek-ро дар ҳамон full-training протокол мустақиман ҳамчун baseline санҷидааст. Натиҷаҳо нишон медиҳанд, ки равиши cost-sensitive нисбат ба resampling бартарии универсалӣ надорад.
Чаро Mutual Information дар марҳилаи аввали интихоби хусусият истифода мешавад?
Mutual Information (MI) усули filter-навъи feature-selection мебошад, ки вобастагии омории байни feature ва синфи ҳадафро арзёбӣ мекунад. Азбаски барои ҳар feature муносибати иттилоотӣ бо target label бе омӯзонидани такрории таснифгар ҳисоб шуда метавонад, дар марҳилаи аввали интихоб хароҷоти нисбатан пасти ҳисоббарорӣ медиҳад.
Дар таҳқиқот барои 122 хусусияти баъди one-hot encoding MI ҳисоб шуда, 50 хусусияти дорои MI-и баландтарин нигоҳ дошта шудаанд. Ин марҳила feature space-ро аввал бо механизми босуръати filter танг мекунад.
Recursive Feature Elimination чӣ мекунад?
Recursive Feature Elimination (RFE) усули wrapper-навъи интихоб аст, ки бо истифода аз иттилои feature-importance-и модел хусусиятҳои камтар муфидро ба таври такрорӣ хориҷ мекунад. Дар ин таҳқиқот 50 хусусияти MI бо Random Forest estimator арзёбӣ шуда, хусусиятҳои камаҳамият хориҷ гардида, 25 хусусият нигоҳ дошта шуданд.
Мантиқи истифодаи якҷояи MI ва RFE дар он аст, ки филтркунии босуръат ва model-independent-и MI бо интихоби дуюмдараҷаи model-aware-и RFE якҷо карда шавад. Дар Figure 3-и манбаъ нишон дода шудааст, ки ду механизми интихоб дар 22 хусусият ҳампӯш мешаванд, се хусусият танҳо дар MI ва се хусусият танҳо дар RFE мавҷуданд.
25 хусусияти ниҳоӣ
25 хусусияти истифодашуда дар таҳқиқот чунинанд: src_bytes, diff_srv_rate, same_srv_rate, dst_host_diff_srv_rate, dst_host_srv_count, count, dst_host_same_srv_rate, dst_host_serror_rate, serror_rate, flag_SF, dst_host_srv_serror_rate, flag_S0, srv_serror_rate, logged_in, dst_host_srv_diff_host_rate, dst_host_same_src_port_rate, dst_host_count, srv_count, service_private, dst_host_rerror_rate, dst_host_srv_rerror_rate, rerror_rate, service_eco_i, protocol_type_icmp ва service_ecr_i.
Муаллифон даъво намекунанд, ки ин 25 хусусият барои ҳамаи масъалаҳои NIDS оптимуми универсалӣ мебошанд. Ин рӯйхат танҳо натиҷаи pipeline-и назоратшавандаи NSL-KDD MI→RFE мебошад.
Гиперпараметрҳои таснифгар
| Модел | Танзими манбаъ | Ёддошти муҳими усул |
|---|---|---|
| Random Forest | 200 дарахт; maximum depth = 20; minimum 5 намуна барои internal split | Пас аз MI ҳамчун RFE estimator низ истифода шудааст. |
| XGBoost | 200 дарахт; maximum depth = 8; learning rate = 0.1; subsampling-и сатр ва сутун = 0.8 | Дар ҳолати cost-sensitive per-instance weight истифода шудааст. |
| SVM | RBF kernel; C = 10; gamma = scale | Аз сабаби хароҷоти ҳисоббарорӣ зермаҷмуаи stratified-и 30,000 намуна барои омӯзиш истифода шудааст. |
| KNN | k = 5; inverse-distance weighting | Азбаски дар татбиқи стандартӣ class weight истифода намешавад, натиҷаи cost-sensitive тағйир намеёбад. |
| Stacking | RF + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold OOF | Meta-learner барои кам кардани leakage бо out-of-fold predictions омӯзонда мешавад. |
Манбаъ мегӯяд, ки барои самаранокии ҳисоббарорӣ дар base model-ҳои дохили stacking “reduced hyperparameters” истифода шудаанд, аммо ҳамаи арзишҳои ададии ин гиперпараметрҳои коҳишёфтаро дар ҳамон ҷой рӯйхат намекунад. Аз ин рӯ набояд гумон кард, ки танзимоти моделҳои инфиродии боло дар base model-ҳои дохили stacking айнан якхелаанд.
Протоколи омӯзиш ва тест
Ҳамаи моделҳои асосӣ дар KDDTrain+ омӯзонда ва дар KDDTest+-и мустақил арзёбӣ шудаанд. KDDTest+ аз нав тақсим, resample ё ба омӯзиши cross-validation дохил карда нашудааст. Ин ҷудокунӣ барои пешгирии ихроҷи иттилоъ ба маҷмуаи тест ва нигоҳ доштани train-test distribution shift-и аслии NSL-KDD муҳим аст.
Экспериментҳои иловагии repeated-seed, resampling, feature-sensitivity ва ablation бо тамоми 125,973 сабти KDDTrain+ анҷом дода шудаанд. SVM бо сабаби маҳдудияти омӯзишии 30,000 намуна аз ин муқоисаҳои иловагӣ хориҷ карда шудааст.
Нармафзор ва сахтафзор
| Ҷузъ | Версия / муҳит |
|---|---|
| Python | 3.13.5 |
| scikit-learn | 1.8.0 |
| XGBoost | 3.1.3 |
| imbalanced-learn | 0.14.1 |
| NumPy | 2.3.5 |
| pandas | 2.2.3 |
| Муҳити иҷро | Linux x86_64, CPU-only |
| CPU | 56 logical CPU core-и дастрас ба container |
| RAM | Тақрибан 4.3 GB |
| GPU | Истифода нашудааст |
Дар 1000 намунаи аввали KDDTest+ inference latency низ чен шудааст: Random Forest 0.2609 ms/sample, XGBoost 0.1081 ms/sample, KNN 1.6117 ms/sample ва Stacking Ensemble 2.0925 ms/sample. Муаллифон мегӯянд, ки ин вақтҳо аз сахтафзор вобаста буда, танҳо барои тавсифи relative computational behavior гузориш шудаанд.
Номувофиқии inference-latency дар дохили манбаъ
Гарчанде дар бахши метод арзишҳои inference latency-и боло ба таври возеҳ гузориш шудаанд, дар Section 5.3-и маҳдудиятҳо навишта шудааст, ки таҳқиқот ҳанӯз “runtime memory usage, inference latency ё end-to-end integration”-ро дар бар намегирад. Азбаски ҳар ду изҳорот дар ҳамон манбаи нашршуда якҷо мавҷуданд, Verianla яке аз онҳоро хомӯшона ҳазф намекунад. Тафсири бехатартар ин аст, ки дар 1000 намунаи аввали тест ченаки маҳдуди deployment-oriented latency мавҷуд аст, аммо барои pipeline-и пурраи истеҳсолӣ арзёбии runtime/memory/end-to-end анҷом дода нашудааст. Ин ҷумлаи охир тафсири якҷояи ду изҳороти манбаъ аст, на натиҷаи нави таҷрибавӣ.
Метрікаҳои арзёбӣ чӣ гуна хонда шаванд?
Манбаъ номҳои метрикҳоро истифода мебарад, аммо формулаҳои асосии precision/recall/F1-ро аз нав ҳосил намекунад. Формулаҳои поён натиҷаи нави таҳқиқот нестанд, балки таърифҳои стандартии омӯзишии метрикҳои гузоришшуда мебошанд.
\[ Recall=\frac{TP}{TP+FN} \]
Recall чен мекунад, ки чӣ қадар намунаҳои воқеан ба синфи дахлдор тааллуқдошта дуруст ошкор шудаанд. Дар ҳамлаи нодири таъсирбаланд ба монанди U2R, recall-и паст маънои онро дорад, ки шумораи зиёди ҳамлаҳо ҳамчун false negative аз даст рафтаанд.
\[ Precision=\frac{TP}{TP+FP} \]
Precision чен мекунад, ки аз ҳушдорҳое, ки модел ба синфи дахлдор нисбат медиҳад, чандтояш воқеан ба он синф тааллуқ доранд. Агар U2R recall баланд шавад, вале precision хеле паст боқӣ монад, analyst alert burden метавонад ҷиддан афзоиш ёбад.
\[ F1=2\frac{Precision\cdot Recall}{Precision+Recall} \]
F1 precision ва recall-ро бо миёнаи гармоникӣ якҷо мекунад. Агар яке аз ҷузъҳо хеле паст бошад, F1 ҳам маҳдуд мешавад.
\[ MacroF1=\frac{1}{C}\sum_{c=1}^{C}F1_c \]
Macro-F1 ба ҳамаи синфҳо вазни баробар медиҳад. Аз ин рӯ, нисбат ба weighted F1 камтар майл дорад, ки иҷрои заифи синфҳои нодирро пушти муваффақияти majority-class пинҳон кунад.
\[ WeightedF1=\sum_{c=1}^{C}\frac{n_c}{N}F1_c \]
Weighted F1 арзиши F1-и ҳар синфро бо support-и синф вазн мекунад. Азбаски синфҳои калон ба монанди Normal ва DoS ба натиҷа бештар таъсир мерасонанд, он барои шарҳи мушкили синфҳои нодир ба танҳоӣ кофӣ нест.
Аз ин рӯ таҳқиқот дар баробари weighted F1, macro-F1, balanced accuracy, macro PR-AUC, macro false-positive rate, macro false-negative rate, recall-и синфӣ, шумораҳои мутлақи TP/FP ва Wilson 95% confidence interval-ро истифода мебарад.
Баланд Шудани U2R Recall Аз 0.00% То 35.82% Чӣ Маъно Дорад?
Баланд шудани U2R recall аз 0.00% то 35.82% маънои онро дорад, ки дар таҷрибаи асосии stacking baseline model аз 67 намунаи воқеии U2R ягонтояшро наёфтааст, дар ҳоле ки cost-sensitive model 24-тояшро дуруст муайян кардааст; аммо азбаски ҳамон сохтор шумораи зиёди U2R false positive тавлид мекунад, натиҷаро ҳамчун “мушкилоти U2R ҳал шуд” тафсир кардан мумкин нест.
Чаро шумораи мутлақ аз фоиз муҳимтар аст?
| Синф | Намунаи тест | TP Baseline | TP Cost-Sensitive | Baseline Recall, %95 GA | Cost-Sensitive Recall, %95 GA |
|---|---|---|---|---|---|
| R2L | 2887 | 119 | 151 | 4.12% [3.46%, 4.91%] | 5.23% [4.48%, 6.10%] |
| U2R | 67 | 0 | 24 | 0.00% [0.00%, 5.42%] | 35.82% [25.40%, 47.78%] |
35.82% барои U2R афзоиши калони фоизӣ менамояд, аммо дар маҷмуаи тест танҳо 67 намунаи U2R вуҷуд дорад. Аз ин рӯ 24 ошкорсозии дуруст бо Wilson confidence interval-и васеъ гузориш шудааст. Интервали Wilson, махсусан вақте ки намуна хурд аст, номуайянии таносуби мушоҳидашударо нисбат ба танҳо як фоиз додан ростқавлона нишон медиҳад.
Дар R2L шумораи намунаҳои тест хеле калонтар аст. Бо вуҷуди ин, сохтори cost-sensitive танҳо 32 намунаи иловагии R2L-ро дуруст тасниф кардааст. Аз ин рӯ, гарчанде афзоиши R2L дар repeated-seed test аз ҷиҳати оморӣ аҳамиятнок менамояд, андозаи амалиётии он маҳдуд аст.
Бори false-positive-и U2R
| Танзим | Синф | TP | FP | FN | Precision | Recall |
|---|---|---|---|---|---|---|
| Baseline | R2L | 119 | 4 | 2768 | 0.9675 | 0.0412 |
| Cost-sensitive | R2L | 151 | 9 | 2736 | 0.9438 | 0.0523 |
| Baseline | U2R | 0 | 0 | 67 | 0.0000 | 0.0000 |
| Cost-sensitive | U2R | 24 | 1695 | 43 | 0.0140 | 0.3582 |
Cost-sensitive stacking дигар U2R-ро комилан нодида намегирад; аммо 1695 false-positive дар муқобили 24 ҳушдори дурусти U2R precision-ро то сатҳи 1.4% коҳиш медиҳад. Аз ин рӯ манбаъ тавсия медиҳад, ки ҳушдори U2R-и модел барои analyst triage истифода шавад, на ҳамчун қарори ниҳоии автономии ҳамла.
Чаро R2L ҳанӯз ҳам ноком аст?
Failure analysis нишон медиҳад, ки дар baseline stacking аз 2887 намунаи R2L, 2764-тояш Normal пешгӯӣ шудаанд. Пас аз class weighting шумораи ба Normal рафта 2269 мешавад; аммо 463 намунаи R2L ин дафъа ба ҷойи R2L-и дуруст ҳамчун U2R тасниф мешаванд. Пас, ҳарчанд модел ба ҳамлаҳои нодир ҳассостар мешавад, ҳанӯз decision region-и кофӣ дурусти R2L-ро намеомӯзад.
| Танзим | Синф | Ҳамагӣ | Пешгӯии Normal | Пешгӯии R2L | Пешгӯии U2R | FNR |
|---|---|---|---|---|---|---|
| Baseline stacking | R2L | 2887 | 2764 | 119 | 0 | 0.959 |
| Baseline stacking | U2R | 67 | 65 | 2 | 0 | 1.000 |
| Cost-sensitive stacking | R2L | 2887 | 2269 | 151 | 463 | 0.948 |
| Cost-sensitive stacking | U2R | 67 | 40 | 3 | 24 | 0.642 |
Оё Сохтори 25-Хусусиятии MI–RFE Беҳтарин Пешгӯиро Медиҳад?
Не. Feature-subset sensitivity-и манбаъ нишон медиҳад, ки конфигуратсияҳои 50-хусусиятӣ ва 122-хусусиятӣ конфигуратсияи 25-хусусиятии MI–RFE-ро аз рӯи weighted F1, R2L recall ва U2R recall пеш мегузаранд; асосноккунии сохтори 25-хусусиятӣ бартарии пешгӯӣ нест, балки андозаи камтар, вақти ҳисобкунии кӯтоҳтар ва компактӣ мебошад.
| Танзими хусусият | Усули интихоб | Weighted F1 | R2L Recall | U2R Recall | Training Time (s) |
|---|---|---|---|---|---|
| 10 хусусият | 10 хусусияти аввали интихобшуда | 0.7053 | 0.0173 | 0.1194 | 110.2 |
| 25 хусусият | MI + RFE | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| 50 хусусият | MI top 50 | 0.7668 | 0.1888 | 0.5075 | 160.5 |
| 122 хусусият | Feature selection нест | 0.7625 | 0.1753 | 0.5224 | 243.5 |
Сохтори 50-хусусиятӣ аз рӯи weighted F1 ва R2L recall беҳтарин натиҷаро медиҳад, дар ҳоле ки сохтори 122-хусусиятӣ аз рӯи U2R recall бо фарқи кам баландтарин арзишро медиҳад. Сохтори 25-хусусиятӣ нисбат ба 50-хусусиятӣ танҳо тақрибан 9.7 сония training time камтар дорад, вале дар ҳар се нишондиҳандаи асосӣ заифтар аст. Аз ин рӯ манбаъ, агар буҷети ҳисоббарорӣ иҷозат диҳад, 50 хусусиятро operating point-и қавитар мешуморад.
Усул ва Натиҷаҳои Таҳқиқот
Натиҷаҳои baseline model
| Модел | Accuracy | Weighted Precision | Weighted Recall | Weighted F1 | Time (s) |
|---|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7739 | 0.7544 | 0.7055 | 1.4 |
| XGBoost | 0.7504 | 0.8088 | 0.7504 | 0.7039 | 2.9 |
| SVM | 0.7183 | 0.7028 | 0.7183 | 0.6717 | 3.3 |
| KNN | 0.7409 | 0.7815 | 0.7409 | 0.6988 | 0.8 |
| Stacking Ensemble | 0.7542 | 0.8149 | 0.7542 | 0.7120 | 11.7 |
Random Forest баландтарин baseline accuracy ва stacking ensemble баландтарин weighted precision ва weighted F1-ро дорад. Бо вуҷуди ин, baseline confusion matrix нишон медиҳанд, ки R2L ва U2R аксар вақт ҳамчун Normal пешгӯӣ мешаванд. Аз ин рӯ далели асосии таҳқиқот “stacking аллакай қавӣ аст” нест, балки он аст, ки aggregate score метавонанд нокомии синфҳои нодирро пинҳон кунанд.
Cost-sensitive learning дар сатҳи модел чиро тағйир дод?
| Модел | Accuracy Baseline | Accuracy CW | F1 Baseline | F1 CW |
|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7533 | 0.7055 | 0.7074 |
| XGBoost | 0.7504 | 0.7648 | 0.7039 | 0.7237 |
| SVM | 0.7183 | 0.7611 | 0.6717 | 0.7423 |
| KNN | 0.7409 | 0.7409 | 0.6988 | 0.6988 |
| Stacking Ensemble | 0.7542 | 0.7342 | 0.7120 | 0.7214 |
SVM бузургтарин беҳбудии глобалиро аз рӯи weighted F1 нишон медиҳад: аз 0.6717 то 0.7423, яъне 7.06 percentage point. Аммо SVM на дар тамоми KDDTrain+, балки бинобар computational feasibility дар stratified subset-и 30,000 намуна омӯзонда шудааст. Аз ин рӯ натиҷаи SVM аз ҷиҳати методологӣ бо таҷрибаҳои stacking/resampling, ки дар тамоми додаҳо иҷро шудаанд, пурра баробар нест.
Гарчанде accuracy-и stacking ensemble аз 0.7542 то 0.7342 коҳиш ёфтааст, баланд шудани weighted F1 аз 0.7120 то 0.7214 нишон медиҳад, ки class weighting баъзе қарорҳои дурусти синфҳои аксариятро қурбон карда, барои синфҳои нодир майдони бештари қарор боз мекунад.
Stacking ensemble дар сатҳи синф чӣ гуна тағйир ёфт?
| Синф | Baseline Recall | Cost-Sensitive Recall | Тағйир |
|---|---|---|---|
| DoS | 79.24% | 80.17% | +0.93% |
| Normal | 97.15% | 91.45% | −5.69% |
| Probe | 63.57% | 62.66% | −0.91% |
| R2L | 4.12% | 5.23% | +1.11% |
| U2R | 0.00% | 35.82% | +35.82% |
Ҳангоми зиёд шудани намоёнии U2R, Normal recall ба 5.69 percentage point коҳиш меёбад. Ин trade-off хато нест, балки натиҷаи он аст, ки class weighting сарҳади қарорро қасдан тағйир медиҳад. Аз нигоҳи амният, қобили қабул будани ин вобаста ба муқоисаи хароҷоти ҳодисаи privilege-escalation-и аз дастрафта бо хароҷоти баррасии false-positive-и иловагӣ мебошад.
Оё Cost-Sensitive Learning Аз Усулҳои Resampling Беҳтар Аст?
Не; таҳқиқот нишон намедиҳад, ки cost-sensitive learning аз ҳамаи усулҳои imbalance беҳтар аст. Дар ҳамон протоколи 125,973-намунаи KDDTrain+, ADASYN баландтарин weighted F1 ва R2L recall-ро ба даст овардааст, дар ҳоле ки cost-sensitive weighting дар ин муқоиса баландтарин U2R recall ва бартарии тағйир надодани training distribution бо додаҳои синтетикиро фароҳам овардааст.
| Усул | Тағйир дар сатҳи дода | Weighted F1 | R2L Recall | U2R Recall | Total Time (s) |
|---|---|---|---|---|---|
| Baseline | Нест | 0.7120 | 0.0412 | 0.0000 | 155.8 |
| Cost-sensitive weights | Додаи синтетикӣ нест | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| SMOTE | Synthetic oversampling | 0.7083 | 0.0450 | 0.0597 | 740.9 |
| Borderline-SMOTE | Boundary-focused oversampling | 0.7273 | 0.0551 | 0.0448 | 686.4 |
| ADASYN | Adaptive synthetic oversampling | 0.7478 | 0.0901 | 0.1343 | 680.2 |
| SMOTE-Tomek | Oversampling + Tomek cleaning | 0.7065 | 0.0433 | 0.0597 | 654.0 |
Дар ин муқоиса ADASYN бо weighted F1 = 0.7478 ва R2L recall = 0.0901 аз cost-sensitive stacking беҳтар аст. Дар муқобил, cost-sensitive stacking бо U2R recall = 0.3582 аз ин чор усули resampling қавитар буда, training distribution-ро бо намунаҳои синтетикӣ тағйир намедиҳад.
Exploratory baseline-ҳои васеътар
| Усул | W-F1 | Macro-F1 | Balanced Accuracy | PR-AUC | R2L Recall | U2R Recall | U2R FP |
|---|---|---|---|---|---|---|---|
| Cost-sensitive stacking | 0.7214 | 0.5023 | 0.5507 | 0.5787 | 0.0523 | 0.3582 | 1695 |
| Balanced Random Forest | 0.7268 | 0.5455 | 0.5927 | 0.6469 | 0.2123 | 0.4627 | 427 |
| XGBoost threshold calibration | 0.7466 | 0.5603 | 0.5692 | 0.6900 | 0.1493 | 0.2537 | 188 |
| Focal-loss MLP | 0.7339 | 0.5640 | 0.5981 | 0.6105 | 0.2224 | 0.3134 | 429 |
Ин муқоисаи васеъшуда маҳдудияти иддаои асосиро боз ҳам равшантар мекунад. Cost-sensitive stacking намоёнии U2R-ро нисбат ба baseline зиёд мекунад; аммо Balanced Random Forest ҳам аз рӯи U2R recall ва ҳам R2L recall қавитар буда, шумораи U2R false-positive хеле камтар аст. XGBoost threshold calibration шумораи пасттарини U2R false-positive-ро то 188 коҳиш медиҳад, дар ҳоле ки U2R recall дар 0.2537 мемонад. Аз ин рӯ таҳқиқот хулосаи “сохтори пешниҳодшуда аз ҳамаи алтернативаҳо беҳтар аст”-ро дастгирӣ намекунад.
Тестҳои омории repeated-seed
Барои пешгирӣ аз вобастагии тағйирёбии стохастикӣ ба як random seed 10 seed истифода шудааст: {0, 1, 2, 3, 4, 5, 10, 21, 42, 100}. Барои муқоисаҳои paired байни baseline ва cost-sensitive stacking Wilcoxon signed-rank ва барои якчанд оилаи модел Friedman test истифода шудааст. Ҳадди аҳамиятнокӣ p < 0.05 мебошад.
| Муқоиса | Метрик | Тест | p-value | Тафсири манбаъ |
|---|---|---|---|---|
| Cost-sensitive stacking vs baseline | Weighted F1 | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | U2R recall | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | R2L recall | Wilcoxon | 0.0039 | Significant |
| Ҳамаи оилаҳои cost-sensitive model | Weighted F1 | Friedman | 0.0018 | Significant |
Ибораи “statistically significant” дар ин ҷо маънои онро надорад, ки андозаи фарқ аз ҷиҳати амалиётӣ кофӣ аст. Мисоли R2L инро равшан нишон медиҳад: дар repeated-seed test фарқ аз ҷиҳати оморӣ аҳамиятнок аст, вале дар шарти асосӣ recall танҳо аз 4.12% то 5.23% ва TP аз 119 то 151 афзудааст. Аҳамиятнокии оморӣ ва таъсири амалии амниятӣ саволҳои гуногунанд.
Component ablation чиро нишон медиҳад?
| Вариант | W-F1 | Macro-F1 | Balanced Accuracy | Macro PR-AUC | R2L Recall | U2R Recall |
|---|---|---|---|---|---|---|
| Baseline stack, class weighting нест | 0.712 | 0.492 | 0.488 | 0.608 | 0.041 | 0.000 |
| CW-only XGBoost | 0.752 | 0.594 | 0.571 | 0.750 | 0.091 | 0.209 |
| Stacking, feature selection нест | 0.763 | 0.577 | 0.642 | 0.694 | 0.175 | 0.522 |
| MI-only XGBoost | 0.743 | 0.595 | 0.570 | 0.720 | 0.086 | 0.284 |
| RFE-only XGBoost | 0.711 | 0.510 | 0.500 | 0.670 | 0.044 | 0.075 |
| Stacking хориҷ шуд | 0.715 | 0.509 | 0.501 | 0.674 | 0.037 | 0.060 |
| Framework-и пурраи 25-feature | 0.721 | 0.502 | 0.551 | 0.579 | 0.052 | 0.358 |
Муҳимтарин натиҷаи ablation ин аст, ки class weighting омили асосии афзоиши U2R visibility мебошад. Вақте class weighting хориҷ мешавад, U2R recall боз ба сифр меафтад. Ҳамзамон feature reduction ройгон нест: варианти stacking бидуни feature selection аз рӯи weighted F1, balanced accuracy, R2L recall ва U2R recall аз framework-и пурраи 25-feature беҳтар аст.
Аз ин рӯ нақши илмии hybrid feature selection бояд на ҳамчун “таъмини accuracy-и баландтар”, балки ҳамчун ба даст овардани feature space-и хурдтар ва ҳисоббарории самараноктар тафсир шавад.
Чаро Weighted F1 ба танҳоӣ кофӣ нест?
| Танзим | Accuracy | Weighted F1 | Macro-F1 | Balanced Accuracy | Macro FPR | Macro FNR | R2L | U2R |
|---|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.754 | 0.712 | 0.492 | 0.488 | 0.084 | 0.512 | 0.041 | 0.000 |
| Cost-sensitive stacking | 0.734 | 0.721 | 0.502 | 0.551 | 0.080 | 0.449 | 0.052 | 0.358 |
Коҳиши Macro FNR аз 0.512 то 0.449 бо афзоиши намоёнии синфҳои нодир мувофиқ аст, аммо 0.449 ҳанӯз ҳам сатҳи баланди аз даст додан мебошад. Манбаъ инро аз нуқтаи назари production NIDS мушкили ҳалшуда ҳисоб намекунад.
Чаро PR-AUC алоҳида ҳисоб карда шуд?
Precision–Recall Area Under the Curve (PR-AUC), махсусан дар масъалаҳое, ки синфи мусбат хеле нодир аст, барои арзёбии он кӯмак мекунад, ки модел дар threshold-ҳои гуногуни қарор байни precision ва recall чӣ гуна рейтинг мекунад. Азбаски prevalence-и U2R дар KDDTest+ танҳо 0.0030 аст, hard-label recall ба танҳоӣ сифати ranking-и эҳтимолиятро шарҳ намедиҳад.
| Синф | Baseline | Cost-Sensitive |
|---|---|---|
| DoS | 0.9448 | 0.9636 |
| Normal | 0.9541 | 0.8066 |
| Probe | 0.8034 | 0.7660 |
| R2L | 0.3280 | 0.3449 |
| U2R | 0.0092 | 0.0126 |
U2R PR-AUC аз 0.0092 то 0.0126 афзудааст. Манбаъ онро тақрибан 3.1 ва 4.2 маротиба аз prevalence baseline болотар тавсиф мекунад. Бо вуҷуди ин, 0.0126 аз ҷиҳати мутлақ сатҳи хеле пасти ranking-quality аст; муаллифон низ U2R-ро яке аз мушкилоти асосии таҳқиқот боқӣ мегузоранд.
Ҳангоми тағйири U2R threshold чӣ мешавад?
| Threshold τ | U2R TP / 67 | U2R Recall | U2R FP | Precision |
|---|---|---|---|---|
| 0.05 | 59 | 0.881 | 6608 | 0.0088 |
| 0.10 | 45 | 0.672 | 3796 | 0.0117 |
| 0.30 | 24 | 0.358 | 2180 | 0.0109 |
| 0.50 | 14 | 0.209 | 1666 | 0.0083 |
| 0.70 | 11 | 0.164 | 1312 | 0.0083 |
| 0.90 | 11 | 0.164 | 953 | 0.0114 |
Ҳангоми паст кардани threshold U2R-и бештар ошкор мешавад, аммо шумораи false-positive ба ҳазорҳо мерасад. Ҳангоми баланд кардани threshold бори ҳушдор кам мешавад, вале recall ҳам паст мешавад. U2R precision дар ҳамаи operating point-ҳои нишон додашуда тақрибан дар сатҳи %1 мебошад.
Дар Table 14 натиҷаи hard-label cost-sensitive U2R 24 TP ва 1695 FP мебошад, дар ҳоле ки дар threshold table натиҷаи \(\tau=0.30\) барои ҳамон 24 TP 2180 FP аст. Ин ду рақам зиддият надоранд: hard-label model қарори оддии multi-class-ро истифода мебарад, дар ҳоле ки threshold experiment operating rule-и дигарро истифода мебарад, ки вақте эҳтимолияти U2R аз \(\tau\) зиёд мешавад, синфро маҷбуран U2R таъин мекунад.
Таҳлили alert-budget
| Буҷети ҳушдори таҳлилгар | U2R-и воқеии гирифташуда / 67 |
|---|---|
| Top 100 ҳушдор | 4 |
| Top 500 ҳушдор | 6 |
| Top 1000 ҳушдор | 11 |
Ин натиҷа нишон медиҳад, ки холи U2R-и модел барои analyst prioritization то андозае иттилоъ дорад, аммо ба танҳоӣ барои қарори автоматии боэътимод precision-и кофӣ намедиҳад.
Санҷиши Берунии UNSW-NB15 Чиро Нишон Медиҳад?
Санҷиши берунии UNSW-NB15 нишон медиҳад, ки бидуни dataset-specific tuning ҳамон мантиқи preprocessing, MI→RFE, stacking ва balanced class-weighting метавонад recall-и чор категорияи нодири ҳамларо ба таври назаррас баланд кунад; аммо ин бо коҳиши Normal recall ва weighted F1 сурат мегирад. Аз ин рӯ, санҷиши берунӣ интиқоли rare-class trade-off-ро тасдиқ мекунад, вале бартарии умумиро дар шабакаҳои истеҳсолӣ исбот намекунад.
Протоколи маҷмуаи додаҳои берунӣ
Training partition-и расмии UNSW-NB15 175,341 ва testing partition 82,332 сабт дорад ва taxonomy-и стандартии даҳсинфӣ истифода шудааст. Дар public mirror-и истифодашуда record identifier ва хусусиятҳои sttl, dttl ва шаш ct_* connection-counter хориҷ шуда, 31 numeric ва се categorical хусусияти боқимонда бо ҳамон pipeline коркард шудаанд.
proto, service ва state one-hot encode шудаанд; Min-Max scaler танҳо ба training partition fit шудааст; бо MI 50 хусусият нигоҳ дошта шуда, бо RFE то 25 коҳиш ёфтааст ва ҳамон stacking architecture бо balanced class weights истифода шудааст. Манбаъ махсусан қайд мекунад, ки UNSW-specific tuning анҷом дода нашудааст.
| Конфигуратсия | Weighted F1 | Macro-F1 | Balanced Accuracy | Analysis Recall | Backdoor Recall | Shellcode Recall | Worms Recall |
|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.8096 | 0.5007 | 0.4856 | 0.0000 | 0.0583 | 0.5291 | 0.1818 |
| Cost-sensitive stacking | 0.7509 | 0.4780 | 0.6696 | 0.2496 | 0.6930 | 0.9550 | 0.8864 |
| Cost-sensitive XGBoost | 0.7488 | 0.5137 | 0.6392 | 0.1300 | 0.5798 | 0.9233 | 0.7273 |
Бо cost-sensitive stacking, Worms аз 18.18% то 88.64% афзуда, аз 44 намунаи Worms 39-тояш дуруст муайян мешавад. Shellcode аз 52.91% то 95.50%, Backdoor аз 5.83% то 69.30% ва Analysis аз 0.00% то 24.96% боло меравад.
Дар иваз Normal recall аз 91.74% то 64.22% ва weighted F1 аз 0.8096 то 0.7509 коҳиш меёбанд. Balanced accuracy аз 0.4856 то 0.6696 боло меравад. Ин ҳамон инъикоси trade-off-и асосии амниятии таҳқиқот дар маҷмуаи додаҳои дигар аст: муваффақияти умумии majority-class кам мешавад, дар ҳоле ки ҳамлаҳои камнамоянда бештар намоён мешаванд.
Class-level PR-AUC-и cost-sensitive model барои Worms 0.5903 ва барои Shellcode 0.3939 гузориш шудааст. Инҳо нисбат ба NSL-KDD U2R PR-AUC = 0.0126 рафтори rare-class ranking-и хеле қавитарро нишон медиҳанд.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Balanced class weighting бидуни тағйири original training observations тавонист recall-и баъзе синфҳои нодири ҳамларо баланд кунад.
- Дар таҷрибаи асосии NSL-KDD, stacking U2R recall аз 0.00% то 35.82% афзудааст.
- Афзоишҳои Weighted F1, U2R recall ва R2L recall дар repeated-seed paired Wilcoxon tests дар сатҳи
p < 0.05аҳамиятноканд. - Гарчанде натиҷаи R2L аз ҷиҳати оморӣ тағйир ёфтааст, беҳбудии мутлақи амалиётӣ маҳдуд аст.
- Class weighting омили асосии U2R visibility мебошад.
- Сохтори 25-feature MI–RFE компактӣ медиҳад, аммо иҷрои максималии пешгӯиро намедиҳад.
- ADASYN дар баъзе метрикаҳои глобалӣ ва R2L аз cost-sensitive stacking беҳтар аст.
- Balanced Random Forest дар муқоисаи васеъшуда аз рӯи U2R ва R2L recall аз cost-sensitive stacking қавитар аст.
- Санҷиши берунии UNSW-NB15 нишон медиҳад, ки афзоиши recall-и синфҳои нодир дар benchmark-и дигар ҳам пайдо мешавад.
- Афзоиши recall-и синфҳои нодир метавонад дар majority-class recall, weighted F1 ё false-positive burden хароҷот эҷод кунад.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад
- Framework NIDS-и умумие нест, ки ҳамаи ҳамлаҳои нодирро боэътимод ҳал кунад.
- Мушкилоти R2L ҳал нашудааст.
- 35.82% recall барои U2R маънои ошкорсозии автономии high-precision-и ҳамларо надорад.
- Нишон дода нашудааст, ки feature set-и 25-хусусиятӣ дар ҳамаи маҷмуаҳои дода ё ҳамаи навъҳои ҳамла оптималӣ аст.
- Нишон дода нашудааст, ки cost-sensitive learning аз SMOTE, ADASYN, Balanced Random Forest, focal loss ё threshold calibration универсалӣ беҳтар аст.
- Натиҷаҳои NSL-KDD ва UNSW-NB15 тамоми encrypted, cloud-native ва IoT traffic-и истеҳсолии муосирро намояндагӣ намекунанд.
- Дар SOC-и зинда ё production packet/flow collector санҷиши end-to-end deployment анҷом дода нашудааст.
- SHAP ё counterfactual analysis барои explainability ба framework-и мавҷуда татбиқ нашудааст.
- Дар ин таҳқиқот validation-и анҷомёфта дар CICIDS2017/2018 ва TON_IoT вуҷуд надорад.
- Аҳамиятнокии оморӣ ба танҳоӣ кафолати operational usefulness ё alert budget-и мувофиқ нест.
Маҳдудиятҳо
Синни benchmark: NSL-KDD барои муқоисаи назоратшаванда муфид аст, аммо encrypted traffic, cloud workloads, IoT protocols ва маъракаҳои ҳамлаи муосирро пурра намояндагӣ намекунад.
R2L overlap: Монандии feature-space байни R2L ва Normal бо class weighting ҳал нашудааст.
Маҳдудияти омӯзиши SVM: SVM танҳо дар 30,000 намунаи stratified training иҷро шудааст; ҳангоми муқоиса бо моделҳое, ки бо тамоми KDDTrain+ кор мекунанд, ин маҳдудият бояд ба назар гирифта шавад.
Бори false-positive: Ҳангоми зиёд шудани U2R visibility precision метавонад хеле паст боқӣ монад. Дар муҳити истеҳсолӣ threshold calibration ва analyst capacity муҳим мешаванд.
Explainability: Қабати шарҳдиҳӣ ба монанди SHAP ё counterfactual analysis илова нашудааст.
External validity: Санҷиши берунии UNSW-NB15 мушкили як-маҷмуа-додаро кам кардааст, вале пурра бартараф накардааст.
Deployment-и зинда: End-to-end live flow collector, SOC integration ва production network behavior санҷида нашудаанд.
Изҳороти latency дар манбаъ: Бо вуҷуди мавҷуд будани ченаки маҳдуди inference-latency дар бахши метод, дар бахши маҳдудиятҳо изҳороти он ки inference latency ҳанӯз арзёбӣ нашудааст, боқӣ мондааст.
Самтҳои кори оянда
Манбаъ пешниҳод мекунад, ки дар оянда ҳамон ablation ва confidence-interval protocol дар CICIDS2017, CSE-CIC-IDS2018 ва TON_IoT татбиқ шавад; adaptive cost schedule, probability calibration, threshold calibration бо held-out validation, interpretability-и бар асоси SHAP, муқоисаи focal-loss model-ҳо дар controlled false-positive budget ва арзёбии усулҳое чун Balanced Random Forest/EasyEnsemble анҷом дода шавад.
Ҳамчунин real-time deployment validation бо flow collector-ҳо ба монанди CICFlowMeter ё Zeek пешниҳод мешавад. Инҳо натиҷаҳои анҷомёфтаи таҳқиқоти ҳозира нестанд, балки пешниҳодҳои кори ояндаанд.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: Cost-Sensitive Stacking Ensemble with Hybrid Feature Selection for Rare Attack Detection in Network Intrusion Detection Systems
Муаллифон ва тартиб: Ioan Corneliu Salisteanu; Iulian Udroiu; Andrei Cosmin Gheorghe; Ionut Adrian Tudoroiu; Emil Mihai Diaconu.
Corresponding author: Andrei Cosmin Gheorghe.
Corresponding e-mail: andrei.gheorghe@valahia.ro
Муассиса: Faculty of Electrical Engineering, Electronics and Information Technology, University “Valahia” of Targoviste, 130004 Targoviste, Romania.
Саҳми баробар / муаллифи якуми баробар: Дар манбаъ изҳороти саҳми баробар мавҷуд нест.
Academic Editor: Emre Tokgoz.
Маҷалла: Electronics.
Ношир: MDPI, Basel, Switzerland.
ISSN: 2079-9292.
Ҷилд / шумора: Volume 15, Issue 14.
Рақами мақола: 3094.
Соли нашр: 2026.
Навъи мақола: Article; таҳқиқоти арзёбии эксперименталии machine learning/NIDS бар асоси benchmark-и назоратшаванда.
DOI: 10.3390/electronics15143094.
Пайванди расмӣ: https://doi.org/10.3390/electronics15143094
Received: 2 Июн 2026.
Revised: 10 Июл 2026.
Accepted: 13 Июл 2026.
Published: 14 Июл 2026.
Ҳолати рецензия: Electronics дар сабти расмии MDPI ҳамчун international, peer-reviewed ва open-access journal тавсиф мешавад.
Литсензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Ҳолати preprint: Манбаи баррасишуда мақолаи нашршудаи маҷалла мебошад; PDF идентификатори ҷудогонаи preprint-ро нишон намедиҳад.
Масъалаи асосии таҳқиқот: Имкони он ки accuracy-и умумӣ дар шароити class imbalance-и ҷиддӣ нокомии rare/high-impact attack-ро пинҳон кунад.
Ҳадди саҳми методологӣ: Ҷузъҳои MI, RFE, stacking ё balanced class weighting ҳар кадом алоҳида алгоритмҳои нав нестанд. Саҳми таҳқиқот дар интегратсияи назоратшавандаи онҳо дар протоколи rare-class-focused, statistically audited ва data-preserving мебошад.
Маҷмуаи асосии дода: NSL-KDD; KDDTrain+ = 125,973 сабт, KDDTest+ = 22,544 сабт.
External validation: UNSW-NB15; official train = 175,341, test = 82,332 сабт; dataset-specific tuning анҷом дода нашудааст.
Синфҳои NSL-KDD: Normal, DoS, Probe, R2L ва U2R.
Preprocessing: one-hot encoding барои protocol_type, service ва flag; 41 attribute-и аслӣ → 122 feature-и ададӣ; training-fit Min-Max scaling [0,1]; difficulty_level хориҷ шудааст.
Feature selection: бо MI 122 → 50, бо RFE-и бар асоси Random Forest 50 → 25.
Ҳадди тафсири feature-selection: Сохтори 25-feature нуқтаи баландтарини иҷро нест; вариантҳои 50-feature ва баъзе no-feature-selection метрикаҳои пешгӯии баландтар додаанд.
Моделҳои инфиродӣ: Random Forest, XGBoost, SVM ва KNN.
Stacking: Random Forest + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold out-of-fold prediction.
Ҳадди SVM: 30,000 намунаи stratified training; бо таҷрибаҳои иловагии full-training мустақиман баробар нест.
Формулаи cost-sensitive: \(w_c=N/(C n_c)\).
Approximate class weights: Normal 0.37; DoS 0.55; Probe 2.16; R2L 25.32; U2R 484.49.
Оё resampling дар framework-и асосӣ истифода шуд? Не. Framework-и асосии cost-sensitive original training observations-ро нигоҳ медорад. SMOTE, Borderline-SMOTE, ADASYN ва SMOTE-Tomek experimental baseline-ҳои ҷудогона мебошанд.
Random seeds: 0, 1, 2, 3, 4, 5, 10, 21, 42, 100.
Statistical tests: Wilcoxon signed-rank ва Friedman; significance threshold p < 0.05.
Натиҷаи асосии U2R: 0/67 → 24/67; recall 0.00% → 35.82%; Wilson %95 GA 25.40%–47.78% дар ҳолати cost-sensitive.
Натиҷаи асосии R2L: 119/2887 → 151/2887; recall 4.12% → 5.23%.
Натиҷаи асосии weighted-F1: Stacking 0.7120 → 0.7214.
Trade-off-и асосии accuracy: Stacking 0.7542 → 0.7342.
U2R hard-label precision: Cost-sensitive stacking 24 TP, 1695 FP, precision 0.0140.
Натиҷаи U2R probability-level: PR-AUC 0.0092 → 0.0126; prevalence 0.0030.
Repeated-seed p-values: Weighted F1 p = 0.0020; U2R recall p = 0.0020; R2L recall p = 0.0039; Friedman weighted-F1 comparison p = 0.0018.
25-feature sensitivity: Weighted F1 = 0.7214; R2L = 0.0523; U2R = 0.3582; training time = 150.8 s.
50-feature sensitivity: Weighted F1 = 0.7668; R2L = 0.1888; U2R = 0.5075; training time = 160.5 s.
122-feature sensitivity: Weighted F1 = 0.7625; R2L = 0.1753; U2R = 0.5224; training time = 243.5 s.
Software: Python 3.13.5; scikit-learn 1.8.0; XGBoost 3.1.3; imbalanced-learn 0.14.1; NumPy 2.3.5; pandas 2.2.3.
Сахтафзор/муҳит: Linux x86_64, CPU-only, 56 logical CPU core available to container, тақрибан 4.3 GB RAM; GPU истифода нашудааст.
Inference latency барои 1000 KDDTest+ аввал: Random Forest 0.2609 ms/sample; XGBoost 0.1081 ms/sample; KNN 1.6117 ms/sample; Stacking 2.0925 ms/sample. Манбаъ онҳоро ҳамчун hardware-dependent relative computational values маҳдуд мекунад.
Ёддошти latency дар дохили манбаъ: Гарчанде Section 3.6 арзишҳои inference latency-ро медиҳад, Section 5.3 мегӯяд, ки inference latency ҳанӯз дохил нашудааст. Азбаски ҳар ду изҳорот дар манбаъ якҷо мавҷуданд, ин фарқ нигоҳ дошта шудааст.
External-validation trade-off: Дар UNSW-NB15 cost-sensitive stacking balanced accuracy 0.4856 → 0.6696 афзудааст, дар ҳоле ки weighted F1 0.8096 → 0.7509 ва Normal recall 91.74% → 64.22% коҳиш ёфтаанд.
UNSW rare-class recall: Analysis 0.00% → 24.96%; Backdoor 5.83% → 69.30%; Shellcode 52.91% → 95.50%; Worms 18.18% → 88.64%.
Маблағгузорӣ: Таҳқиқот маблағгузории берунӣ нагирифтааст.
Data Availability: NSL-KDD benchmark-и дастрас ба ҷомеа мебошад. Манбаъ инчунин мавҷудияти supplementary reproducibility package-ро қайд мекунад, ки Python script-ҳо барои preprocessing, MI–RFE feature selection, training, imbalance baselines, statistical tests ва figure generation-ро дар бар мегирад. Commercial ё private production network trace истифода нашудааст.
Саҳми муаллифон: Conceptualization — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe, Ioan Corneliu Salisteanu ва Iulian Udroiu; methodology — Ioan Corneliu Salisteanu, Andrei Cosmin Gheorghe ва Iulian Udroiu; software — Ionut Adrian Tudoroiu ва Andrei Cosmin Gheorghe; validation — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe ва Emil Mihai Diaconu; formal analysis — Andrei Cosmin Gheorghe; investigation — Emil Mihai Diaconu; resources ва data curation — Ionut Adrian Tudoroiu; original draft — Ionut Adrian Tudoroiu; review/editing — Andrei Cosmin Gheorghe; visualization — Ioan Corneliu Salisteanu ва Iulian Udroiu; supervision — Ioan Corneliu Salisteanu, Iulian Udroiu ва Andrei Cosmin Gheorghe.
Бархӯрди манфиатҳо: Муаллифон изҳор мекунанд, ки бархӯрди манфиатҳо вуҷуд надорад.
Ҳадди асосии методологӣ: Натиҷаҳо таҳлили benchmark-и назоратшавандаи NSL-KDD ва UNSW-NB15 мебошанд; на санҷиши end-to-end дар SOC-и воқеӣ, production network ё live flow collector.
Санҷиши оянда: CICIDS2017, CSE-CIC-IDS2018, TON_IoT, threshold/probability calibration, SHAP, controlled false-positive budgets, Balanced Random Forest/EasyEnsemble ва live CICFlowMeter/Zeek integration.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд