


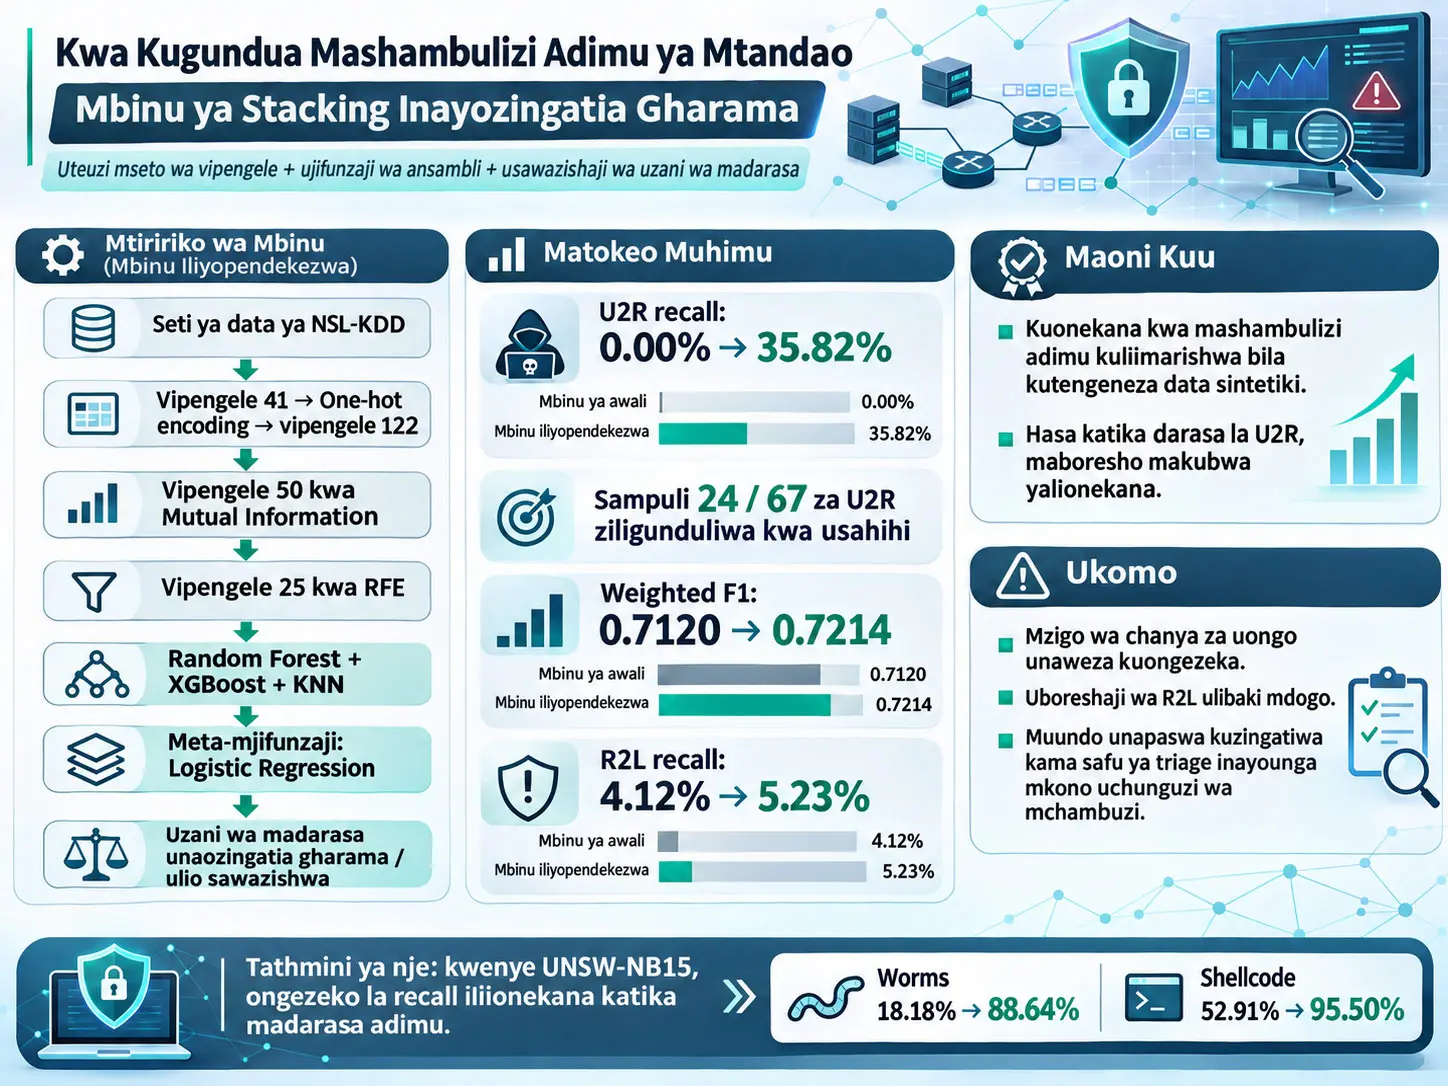
Mfumo wa MI–RFE–stacking unaozingatia gharama ni mkondo wa tathmini wa Network Intrusion Detection System (NIDS) unaohifadhi data ambao huunganisha uteuzi wa vipengele kwa Mutual Information (MI) na Recursive Feature Elimination (RFE), stacking ensemble yenye miundo tofauti na gharama za makosa zinazotegemea darasa ili kuongeza mwonekano wa mashambulizi nadra katika ugunduzi wa mashambulizi ya mtandao ya madarasa mengi yenye kutokuwiana. Utafiti haupendekezi tasnifishaji mpya; unachunguza jinsi vipengele vilivyoanzishwa kama Random Forest, XGBoost, Support Vector Machine (SVM), K-Nearest Neighbors (KNN), Logistic Regression, MI, RFE na balanced class weighting vinavyotenda chini ya itifaki inayodhibitiwa na inayoweza kurudiwa inayolenga madarasa nadra.
Tathmini kuu ilifanywa kwenye benchmark ya NSL-KDD. KDDTrain+ ina rekodi 125,973 za miunganisho ya mtandao, na KDDTest+ ina 22,544. Baada ya one-hot encoding ya vigezo vya kikategoria protocol_type, service na flag, vipengele 41 vya asili vilipanuliwa kuwa vipengele 122 vya nambari; Min-Max scaling iliyofitishwa kwenye seti ya mafunzo pekee ilitumika; kisha vipengele 50 vilivyokuwa na alama za juu zaidi za MI vilihifadhiwa na idadi ikapunguzwa hadi 25 kwa RFE inayotegemea Random Forest.
Stacking ensemble kuu hutumia Random Forest, XGBoost na KNN kama base learner, na Logistic Regression kama meta-learner. Kwa meta-learner, utabiri wa 3-fold out-of-fold huzalishwa. Kutokuwiana kwa madarasa kulishughulikiwa bila kutengeneza data sintetiki, kwa balanced class weighting ya aina w_c = N/(C n_c). Katika mgawanyo wa NSL-KDD, uzito wa kukadiria wa madarasa ni 0.37 kwa Normal, 0.55 kwa DoS, 2.16 kwa Probe, 25.32 kwa R2L na 484.49 kwa U2R.
Katika matokeo makuu ya jaribio moja ya stacking ensemble, U2R recall iliongezeka kutoka 0.00% hadi 35.82%; kwa maneno mengine, wakati baseline model haikuweza kutambua kwa usahihi hata mmoja kati ya sampuli 67 za U2R, muundo wa cost-sensitive ulitambua 24 kwa usahihi. Weighted F1 iliongezeka kutoka 0.7120 hadi 0.7214, lakini accuracy ilipungua kutoka 0.7542 hadi 0.7342. R2L recall iliongezeka kwa kiasi kidogo kutoka 4.12% hadi 5.23%, yaani kutoka utambuzi sahihi 119/2887 hadi 151/2887.
Matokeo ya U2R yanahitaji kikomo madhubuti cha tafsiri. Kwa kuwa cost-sensitive hard-label stacking iliripoti 1695 false positive dhidi ya 24 true positive kwa U2R, precision ni 0.0140 pekee. Katika uchambuzi tofauti wa probability-threshold, U2R precision pia ilibaki karibu na kiwango cha %1. Kwa hiyo, kulingana na mjadala wa utafiti wenyewe, pato la U2R la modeli si uamuzi wa mwisho unaojiendesha, bali ni ishara ya triage inayosaidia kuweka kipaumbele kwa ukaguzi wa mchambuzi wa usalama.
Utafiti pia unaonyesha kwamba mbinu ya cost-sensitive si bora kuliko mbadala zote. Katika ulinganisho wa full-training resampling, ADASYN ni imara zaidi kwa weighted F1 na R2L recall; katika exploratory baselines za baadaye, Balanced Random Forest ilitoa U2R recall ya juu zaidi na idadi ya chini ya U2R false-positive. Faida inayotofautisha mbinu inayopendekezwa ni kuhifadhi uchunguzi wa awali wa mafunzo bila kutengeneza sampuli sintetiki za darasa la wachache na kuchunguza wazi tabia ya mashambulizi nadra.
Katika uthibitishaji wa nje wa UNSW-NB15, recall za madarasa nadra pia ziliongezeka kwa kiasi kikubwa; hata hivyo Normal recall na weighted F1 zilipungua. Matokeo haya yanaunga mkono kwamba mbinu hubadilisha kweli mipaka ya uamuzi inapopewa uzito zaidi kwa madarasa nadra, lakini hayamaanishi ubora wa jumla au mafanikio ya deployment ya kiotomatiki katika mitandao ya kisasa ya uzalishaji.
Kwa Nini Cost-Sensitive Learning Inatumika Katika Utafiti Huu?
Cost-sensitive learning, badala ya kutazama makosa yote ya uainishaji katika seti ya data isiyowiana kuwa sawa, hutoa adhabu kubwa zaidi ya mafunzo kwa makosa katika madarasa nadra na hivyo kufanya mpaka wa uamuzi kuwa nyeti zaidi kwa madarasa ya wachache; lengo kuu katika utafiti huu ni kupunguza hasa kupotea kwa mashambulizi ya U2R na R2L ndani ya madarasa ya wengi bila kubadilisha rekodi halisi za mafunzo kwa sampuli sintetiki.
Kwa nini mashambulizi nadra yanaweza kufichika ndani ya accuracy ya jumla?
NSL-KDD hutumia madarasa matano makuu: Normal, Denial of Service (DoS), Probe, Remote-to-Local (R2L) na User-to-Root (U2R). Katika seti ya mafunzo, Normal na DoS kwa pamoja huunda takriban %90 ya rekodi, ilhali U2R ina sampuli 52 tu za mafunzo; hii ni karibu %0.04. Katika mgawanyo wa aina hii, modeli inaweza kujifunza vizuri madarasa ya wengi na karibu kupuuza kabisa darasa nadra huku bado ikipata global accuracy inayoweza kuonekana kuwa ya juu.
DoS ni darasa la mashambulizi linalolenga kuvuruga upatikanaji wa huduma au rasilimali. Probe huhusisha tabia za kukusanya taarifa kuhusu mtandao au mfumo na kuchunguza malengo yanayoweza kufikiwa. R2L ni darasa linalohusiana na kupata ufikiaji usioidhinishwa wa mfumo wa ndani kutoka chanzo cha mbali. U2R linahusiana na mtumiaji kupata kiwango cha juu zaidi au haki za administrator/root; ni nadra sana lakini muhimu kwa usalama.
Katika Figure 4 ya chanzo, sampuli 5000 za KDDTest+ zimeonyeshwa kwa t-SNE katika vipimo viwili. Picha inaonyesha kwamba sampuli za DoS na Normal huunda baadhi ya maeneo yanayotofautika zaidi, wakati sampuli za R2L na U2R zinaingiliana sana na trafiki ya Normal. t-SNE hapa si tasnifishaji; ni mbinu inayotumika kupunguza feature space yenye vipimo vingi hadi vipimo viwili kwa uchunguzi wa kuona. Ujumbe wa picha ni kwamba tatizo la mashambulizi nadra halitokani tu na idadi ya madarasa, bali pia na feature-space overlap.
Fomula ya balanced class weight
Uzito mkuu wa gharama uliotumika kwenye chanzo:
\[ w_c=\frac{N}{C\,n_c} \]
Fomula inahesabu nini? Inahesabu uzito wa jamaa wa kosa unaotumika wakati wa mafunzo kwa kila darasa.
\(w_c\): uzito usio na kipimo wa darasa \(c\).
\(N\): idadi ya jumla ya sampuli za mafunzo; katika seti kuu ya mafunzo ya NSL-KDD ni 125,973.
\(C\): idadi ya madarasa; katika utafiti huu ni 5.
\(n_c\): idadi ya sampuli za mafunzo za darasa husika.
Kadiri idadi ya sampuli za darasa inavyopungua, \(n_c\) katika kigawanyo hupungua na \(w_c\) huongezeka. Kwa hiyo, uainishaji usio sahihi katika darasa nadra sana kama U2R hupata adhabu ya jamaa iliyo juu sana kuliko kosa katika darasa la Normal kwa madhumuni ya mafunzo.
| Darasa | Uzito wa kukadiria | Maana ya kialgorithimu |
|---|---|---|
| Normal | 0.37 | Darasa linalojitokeza mara nyingi sana; adhabu ya kosa ni ndogo kwa kulinganisha. |
| DoS | 0.55 | Darasa la mashambulizi lenye marudio ya juu. |
| Probe | 2.16 | Darasa lenye marudio ya kati. |
| R2L | 25.32 | Darasa nadra; uainishaji usio sahihi huadhibiwa zaidi. |
| U2R | 484.49 | Darasa nadra zaidi; uainishaji usio sahihi hupata adhabu ya jamaa iliyo juu sana. |
Kwa Random Forest, SVM na Logistic Regression, class_weight = balanced ilitumika. Katika XGBoost, uzito wa sampuli unaotegemea fomula hiyo hiyo ya marudio ya darasa ulitumika. Kwa kuwa muundo wa kawaida wa KNN uliotumika hauna utaratibu huo wa class-weight, matokeo ya KNN hayabadiliki katika hatua ya cost-sensitive.
Kwa nini SMOTE haikutumika moja kwa moja?
Sababu kuu ya uchaguzi wa data-preserving wa waandishi ni kwamba U2R ina sampuli 52 tu halisi za mafunzo. Kuna wasiwasi kwamba sampuli nyingi sintetiki zinapotengenezwa kutoka kwenye sampuli halisi ndogo sana, zinaweza kuunda maeneo ya uamuzi ya bandia ambayo ni muhimu kihesabu lakini hayawakilishi kwa kutosha tabia halisi ya shambulio. Kwa hiyo framework kuu hubadilisha loss/gharama ya uamuzi badala ya kuongeza data ya mafunzo.
Hata hivyo, utafiti haukuacha hoja hii kama dhana tu; SMOTE, Borderline-SMOTE, ADASYN na SMOTE-Tomek zilijaribiwa moja kwa moja kama baseline katika itifaki ile ile ya full-training. Matokeo yanaonyesha kwamba mbinu ya cost-sensitive si bora kwa ujumla kuliko resampling.
Kwa nini Mutual Information inatumika katika hatua ya kwanza ya uteuzi wa vipengele?
Mutual Information (MI) ni mbinu ya feature-selection ya aina ya filter inayotathmini utegemezi wa kitakwimu kati ya feature na darasa lengwa. Kwa kuwa uhusiano wa taarifa na target label unaweza kuhesabiwa kwa kila feature bila kufundisha tasnifishaji mara kwa mara, hutoa gharama ndogo kiasi ya kihesabu katika hatua ya kwanza ya uchujaji.
Katika utafiti, MI ilihesabiwa kwa vipengele 122 baada ya one-hot encoding na vipengele 50 vyenye alama za juu zaidi za MI vikahifadhiwa. Hatua hii kwanza hupunguza feature space kwa utaratibu wa haraka wa filter.
Recursive Feature Elimination hufanya nini?
Recursive Feature Elimination (RFE) ni mbinu ya uteuzi ya aina ya wrapper inayotumia taarifa ya feature-importance ya modeli kuondoa kwa kurudia vipengele vinavyoonekana kuwa na manufaa machache zaidi. Katika utafiti huu, vipengele 50 vya MI vilitathminiwa kwa Random Forest estimator, vipengele visivyo muhimu sana vikaondolewa na vipengele 25 vikabaki.
Hoja ya kutumia MI pamoja na RFE ni kuunganisha uchujaji wa awali wa MI ambao ni wa haraka na usiotegemea modeli na uchujaji wa pili wa RFE unaozingatia modeli. Figure 3 ya chanzo inaonyesha kwamba mbinu hizi mbili za uteuzi zilikutana kwenye vipengele 22, vipengele vitatu vilikuwa upande wa MI pekee na vitatu upande wa RFE pekee.
Vipengele 25 vya mwisho
Vipengele 25 vilivyotumika katika utafiti ni: src_bytes, diff_srv_rate, same_srv_rate, dst_host_diff_srv_rate, dst_host_srv_count, count, dst_host_same_srv_rate, dst_host_serror_rate, serror_rate, flag_SF, dst_host_srv_serror_rate, flag_S0, srv_serror_rate, logged_in, dst_host_srv_diff_host_rate, dst_host_same_src_port_rate, dst_host_count, srv_count, service_private, dst_host_rerror_rate, dst_host_srv_rerror_rate, rerror_rate, service_eco_i, protocol_type_icmp na service_ecr_i.
Waandishi hawadai kwamba vipengele hivi 25 ni optimum ya jumla kwa matatizo yote ya NIDS. Orodha hii ni pato tu la pipeline iliyodhibitiwa ya NSL-KDD MI→RFE.
Hyperparameter za tasnifishaji
| Modeli | Mpangilio wa chanzo | Dokezo muhimu la mbinu |
|---|---|---|
| Random Forest | Miti 200; maximum depth = 20; minimum sampuli 5 kwa internal split | Ilitumika pia kama RFE estimator baada ya MI. |
| XGBoost | Miti 200; maximum depth = 8; learning rate = 0.1; subsampling ya mistari na safu = 0.8 | Per-instance weight ilitumika katika hali ya cost-sensitive. |
| SVM | RBF kernel; C = 10; gamma = scale | Kwa sababu ya gharama ya kihesabu, subset ya mafunzo ya stratified yenye sampuli 30,000 ilitumika. |
| KNN | k = 5; inverse-distance weighting | Kwa kuwa class weight haitumiki katika utekelezaji wa kawaida, matokeo ya cost-sensitive hayabadiliki. |
| Stacking | RF + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold OOF | Meta-learner hufundishwa kwa out-of-fold predictions ili kupunguza leakage. |
Chanzo kinasema kwamba “reduced hyperparameters” zilitumika kwa base model ndani ya stacking kwa ufanisi wa kihesabu, lakini hakiandishi kwa uwazi thamani zote za nambari za hyperparameter hizi zilizopunguzwa katika sehemu hiyo hiyo. Kwa hiyo haipaswi kudhaniwa kwamba mipangilio ya modeli binafsi iliyo juu ni sawa kabisa katika base model za ndani ya stacking.
Itifaki ya mafunzo na majaribio
Modeli zote kuu zilifundishwa kwenye KDDTrain+ na kutathminiwa kwenye KDDTest+ huru. KDDTest+ haikugawanywa tena, haikufanyiwa resample na haikujumuishwa katika mafunzo ya cross-validation. Utengano huu ni muhimu ili kuzuia uvujaji wa taarifa kwenda kwenye seti ya majaribio na kuhifadhi train-test distribution shift ya asili ya NSL-KDD.
Majaribio ya ziada ya repeated-seed, resampling, feature-sensitivity na ablation yalifanywa kwa KDDTrain+ kamili yenye rekodi 125,973. SVM iliondolewa katika ulinganisho huu wa ziada kwa sababu ya kikomo chake cha mafunzo cha sampuli 30,000.
Programu na vifaa
| Kipengele | Toleo / mazingira |
|---|---|
| Python | 3.13.5 |
| scikit-learn | 1.8.0 |
| XGBoost | 3.1.3 |
| imbalanced-learn | 0.14.1 |
| NumPy | 2.3.5 |
| pandas | 2.2.3 |
| Mazingira ya utekelezaji | Linux x86_64, CPU-only |
| CPU | 56 logical CPU core zinazopatikana kwa container |
| RAM | Takriban 4.3 GB |
| GPU | Haikutumika |
Inference latency ilipimwa pia kwenye sampuli 1000 za kwanza za KDDTest+: Random Forest 0.2609 ms/sample, XGBoost 0.1081 ms/sample, KNN 1.6117 ms/sample na Stacking Ensemble 2.0925 ms/sample. Waandishi wanasema muda huu unategemea vifaa na umeripotiwa tu kuelezea relative computational behavior.
Kutolingana kwa inference-latency ndani ya chanzo
Ingawa sehemu ya mbinu inaripoti wazi thamani za inference latency zilizo juu, sehemu ya mapungufu ya Section 5.3 inasema kwamba utafiti bado haujumuishi “runtime memory usage, inference latency au end-to-end integration”. Kwa kuwa kauli hizi mbili zipo pamoja katika chanzo kile kile kilichochapishwa, Verianla haiondoi moja kimyakimya. Tafsiri salama zaidi ni kwamba kipimo kidogo cha deployment-oriented latency kipo kwenye sampuli 1000 za kwanza za majaribio, lakini tathmini ya runtime/memory/end-to-end kwa pipeline kamili ya uzalishaji haijafanywa. Sentensi hii ya mwisho ni tafsiri ya pamoja ya kauli mbili za chanzo, si matokeo mapya ya jaribio.
Metriki za tathmini zinapaswa kusomwaje?
Chanzo hutumia majina ya metriki lakini hakitoi upya derivation ya milinganyo ya msingi ya precision/recall/F1. Milinganyo ifuatayo si matokeo mapya ya utafiti, bali ni ufafanuzi wa kawaida wa kufundishia wa metriki zilizoripotiwa.
\[ Recall=\frac{TP}{TP+FN} \]
Recall hupima ni kiasi gani cha sampuli ambazo kwa kweli ni za darasa husika zimepatikana kwa usahihi. Kwa shambulio nadra lenye athari kubwa kama U2R, recall ndogo ina maana mashambulizi mengi yamekosekana kama false negative.
\[ Precision=\frac{TP}{TP+FP} \]
Precision hupima ni kiasi gani cha tahadhari ambazo modeli imetoa kama darasa husika kwa kweli ni za darasa hilo. Ikiwa U2R recall inaongezeka huku precision ikibaki chini sana, analyst alert burden inaweza kuongezeka sana.
\[ F1=2\frac{Precision\cdot Recall}{Precision+Recall} \]
F1 huunganisha precision na recall kwa wastani wa harmoniki. Ikiwa kipengele kimoja ni kidogo sana, F1 pia huwa na kikomo.
\[ MacroF1=\frac{1}{C}\sum_{c=1}^{C}F1_c \]
Macro-F1 hutoa uzito sawa kwa madarasa yote. Kwa hiyo ina uwezekano mdogo kuliko weighted F1 wa kuficha utendaji dhaifu wa madarasa nadra nyuma ya mafanikio ya majority-class.
\[ WeightedF1=\sum_{c=1}^{C}\frac{n_c}{N}F1_c \]
Weighted F1 hupima F1 ya kila darasa kwa support ya darasa. Kwa kuwa madarasa makubwa kama Normal na DoS yanaathiri zaidi matokeo, haitoshi peke yake kuelezea tatizo la darasa nadra.
Kwa hiyo, pamoja na weighted F1, utafiti hutumia macro-F1, balanced accuracy, macro PR-AUC, macro false-positive rate, macro false-negative rate, recall ya kila darasa, idadi kamili ya TP/FP na Wilson 95% confidence interval.
Kuongezeka kwa U2R Recall Kutoka 0.00% Hadi 35.82% Kunamaanisha Nini?
Kuongezeka kwa U2R recall kutoka 0.00% hadi 35.82% kunamaanisha kwamba katika jaribio kuu la stacking, baseline model haikutambua hata moja kati ya sampuli 67 halisi za U2R, wakati cost-sensitive model ilitambua 24 kwa usahihi; lakini kwa sababu muundo huo huo ulizalisha U2R false positive nyingi, matokeo hayawezi kutafsiriwa kama “tatizo la U2R limetatuliwa”.
Kwa nini idadi kamili ni muhimu kuliko asilimia?
| Darasa | Sampuli za test | TP Baseline | TP Cost-Sensitive | Baseline Recall, %95 GA | Cost-Sensitive Recall, %95 GA |
|---|---|---|---|---|---|
| R2L | 2887 | 119 | 151 | 4.12% [3.46%, 4.91%] | 5.23% [4.48%, 6.10%] |
| U2R | 67 | 0 | 24 | 0.00% [0.00%, 5.42%] | 35.82% [25.40%, 47.78%] |
35.82% kwa U2R inaweza kuonekana kama ongezeko kubwa la asilimia, lakini kuna sampuli 67 tu za U2R katika seti ya majaribio. Kwa hiyo utambuzi sahihi 24 umeripotiwa pamoja na Wilson confidence interval pana. Wilson interval, hasa kwa sampuli ndogo, huonyesha kwa uaminifu zaidi kutokuwa na uhakika wa uwiano ulioonekana kuliko kutoa asilimia moja pekee.
Kwa upande wa R2L, sampuli ya majaribio ni kubwa zaidi. Hata hivyo, muundo wa cost-sensitive uliweza kuainisha kwa usahihi sampuli 32 tu za ziada za R2L. Kwa hiyo ongezeko la R2L linaonekana kuwa significant kitakwimu katika repeated-seed test, lakini ukubwa wake wa kiutendaji ni mdogo.
Mzigo wa U2R false-positive
| Mpangilio | Darasa | TP | FP | FN | Precision | Recall |
|---|---|---|---|---|---|---|
| Baseline | R2L | 119 | 4 | 2768 | 0.9675 | 0.0412 |
| Cost-sensitive | R2L | 151 | 9 | 2736 | 0.9438 | 0.0523 |
| Baseline | U2R | 0 | 0 | 67 | 0.0000 | 0.0000 |
| Cost-sensitive | U2R | 24 | 1695 | 43 | 0.0140 | 0.3582 |
Cost-sensitive stacking sasa haipuuzi U2R kabisa; lakini kuzalisha 1695 false-positive dhidi ya tahadhari 24 sahihi za U2R hupunguza precision hadi 1.4%. Kwa hiyo chanzo kinapendekeza kutumia tahadhari ya U2R ya modeli kwa analyst triage, si kama uamuzi wa mwisho wa kiotomatiki wa shambulio.
Kwa nini R2L bado inashindwa?
Failure analysis inaonyesha kwamba katika baseline stacking, 2764 kati ya sampuli 2887 za R2L zilitabiriwa kuwa Normal. Baada ya class weighting, idadi inayoenda Normal inashuka hadi 2269; lakini sampuli 463 za R2L sasa zinaainishwa kama U2R badala ya R2L sahihi. Kwa hiyo, ingawa modeli inakuwa nyeti zaidi kwa mashambulizi nadra, bado haijifunzi decision region ya R2L yenye usahihi wa kutosha.
| Mpangilio | Darasa | Jumla | Utabiri wa Normal | Utabiri wa R2L | Utabiri wa U2R | FNR |
|---|---|---|---|---|---|---|
| Baseline stacking | R2L | 2887 | 2764 | 119 | 0 | 0.959 |
| Baseline stacking | U2R | 67 | 65 | 2 | 0 | 1.000 |
| Cost-sensitive stacking | R2L | 2887 | 2269 | 151 | 463 | 0.948 |
| Cost-sensitive stacking | U2R | 67 | 40 | 3 | 24 | 0.642 |
Je, Muundo wa MI–RFE wa Vipengele 25 Unatoa Utendaji Bora Zaidi wa Utabiri?
Hapana. Feature-subset sensitivity ya chanzo inaonyesha kwamba usanidi wa vipengele 50 na vipengele 122 unapita usanidi wa MI–RFE wa vipengele 25 kwa weighted F1, R2L recall na U2R recall; sababu ya muundo wa vipengele 25 si ubora wa utabiri, bali ni vipimo vidogo, muda mfupi wa kuhesabu na compactness.
| Mpangilio wa vipengele | Mbinu ya uteuzi | Weighted F1 | R2L Recall | U2R Recall | Training Time (s) |
|---|---|---|---|---|---|
| Vipengele 10 | Vipengele 10 vya kwanza vilivyochaguliwa | 0.7053 | 0.0173 | 0.1194 | 110.2 |
| Vipengele 25 | MI + RFE | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| Vipengele 50 | MI top 50 | 0.7668 | 0.1888 | 0.5075 | 160.5 |
| Vipengele 122 | Hakuna feature selection | 0.7625 | 0.1753 | 0.5224 | 243.5 |
Muundo wa vipengele 50 hutoa matokeo bora zaidi kwa weighted F1 na R2L recall, huku muundo wa vipengele 122 ukitoa thamani ya juu kidogo zaidi kwa U2R recall. Ingawa muundo wa vipengele 25 una training time ya takriban sekunde 9.7 chini kuliko muundo wa vipengele 50, ni dhaifu katika viashiria vyote vitatu vikuu. Kwa hiyo chanzo kinatambua vipengele 50 kama operating point yenye nguvu zaidi ikiwa bajeti ya kihesabu inaruhusu.
Mbinu na Matokeo ya Utafiti
Matokeo ya baseline model
| Modeli | Accuracy | Weighted Precision | Weighted Recall | Weighted F1 | Time (s) |
|---|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7739 | 0.7544 | 0.7055 | 1.4 |
| XGBoost | 0.7504 | 0.8088 | 0.7504 | 0.7039 | 2.9 |
| SVM | 0.7183 | 0.7028 | 0.7183 | 0.6717 | 3.3 |
| KNN | 0.7409 | 0.7815 | 0.7409 | 0.6988 | 0.8 |
| Stacking Ensemble | 0.7542 | 0.8149 | 0.7542 | 0.7120 | 11.7 |
Random Forest ina baseline accuracy ya juu zaidi, huku stacking ensemble ikiwa na weighted precision na weighted F1 ya juu zaidi. Hata hivyo, baseline confusion matrix zinaonyesha kwamba R2L na U2R mara nyingi hutabiriwa kama Normal. Kwa hiyo hoja kuu ya utafiti si “stacking tayari ina nguvu”, bali kwamba aggregate score zinaweza kuficha kushindwa kwa madarasa nadra.
Cost-sensitive learning ilibadilisha nini kwa kila modeli?
| Modeli | Accuracy Baseline | Accuracy CW | F1 Baseline | F1 CW |
|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7533 | 0.7055 | 0.7074 |
| XGBoost | 0.7504 | 0.7648 | 0.7039 | 0.7237 |
| SVM | 0.7183 | 0.7611 | 0.6717 | 0.7423 |
| KNN | 0.7409 | 0.7409 | 0.6988 | 0.6988 |
| Stacking Ensemble | 0.7542 | 0.7342 | 0.7120 | 0.7214 |
SVM inaonyesha ongezeko kubwa zaidi la jumla kwa weighted F1: kutoka 0.6717 hadi 0.7423, ongezeko la 7.06 percentage point. Hata hivyo, SVM haikufundishwa kwenye KDDTrain+ kamili, bali kwenye stratified subset ya sampuli 30,000 kwa sababu ya computational feasibility. Kwa hiyo matokeo ya SVM si sawa kabisa kimetodolojia na majaribio ya stacking/resampling yanayotumia data kamili.
Ingawa accuracy ya stacking ensemble imeshuka kutoka 0.7542 hadi 0.7342, kuongezeka kwa weighted F1 kutoka 0.7120 hadi 0.7214 kunaonyesha kwamba class weighting imeacha baadhi ya maamuzi sahihi katika darasa la wengi ili kufungua nafasi zaidi ya uamuzi kwa madarasa nadra.
Stacking ensemble ilibadilikaje kwa kila darasa?
| Darasa | Baseline Recall | Cost-Sensitive Recall | Mabadiliko |
|---|---|---|---|
| DoS | 79.24% | 80.17% | +0.93% |
| Normal | 97.15% | 91.45% | −5.69% |
| Probe | 63.57% | 62.66% | −0.91% |
| R2L | 4.12% | 5.23% | +1.11% |
| U2R | 0.00% | 35.82% | +35.82% |
Wakati mwonekano wa U2R unaongezeka, Normal recall inapungua kwa 5.69 percentage point. Trade-off hii si kosa, bali ni matokeo ya class weighting kubadilisha kwa makusudi mpaka wa uamuzi. Ikiwa hii inakubalika kwa usalama inategemea kulinganisha gharama ya tukio la privilege-escalation lililokosekana na gharama ya ukaguzi wa false-positive za ziada.
Je, Cost-Sensitive Learning Ni Bora Kuliko Mbinu za Resampling?
Hapana; utafiti hauonyeshi kwamba cost-sensitive learning ni bora kuliko mbinu zote za imbalance. Katika itifaki ile ile ya KDDTrain+ yenye sampuli 125,973, ADASYN ilitoa weighted F1 na R2L recall za juu zaidi, wakati cost-sensitive weighting ilitoa U2R recall ya juu zaidi katika ulinganisho huu pamoja na faida ya kutobadilisha training distribution kwa data sintetiki.
| Mbinu | Mabadiliko katika kiwango cha data | Weighted F1 | R2L Recall | U2R Recall | Total Time (s) |
|---|---|---|---|---|---|
| Baseline | Hakuna | 0.7120 | 0.0412 | 0.0000 | 155.8 |
| Cost-sensitive weights | Hakuna data sintetiki | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| SMOTE | Synthetic oversampling | 0.7083 | 0.0450 | 0.0597 | 740.9 |
| Borderline-SMOTE | Boundary-focused oversampling | 0.7273 | 0.0551 | 0.0448 | 686.4 |
| ADASYN | Adaptive synthetic oversampling | 0.7478 | 0.0901 | 0.1343 | 680.2 |
| SMOTE-Tomek | Oversampling + Tomek cleaning | 0.7065 | 0.0433 | 0.0597 | 654.0 |
Katika ulinganisho huu, ADASYN inapita cost-sensitive stacking kwa weighted F1 = 0.7478 na R2L recall = 0.0901. Kwa upande mwingine, cost-sensitive stacking ina nguvu zaidi kuliko mbinu hizi nne za resampling kwa U2R recall = 0.3582 na haibadilishi training distribution kwa sampuli sintetiki.
Exploratory baseline pana zaidi
| Mbinu | W-F1 | Macro-F1 | Balanced Accuracy | PR-AUC | R2L Recall | U2R Recall | U2R FP |
|---|---|---|---|---|---|---|---|
| Cost-sensitive stacking | 0.7214 | 0.5023 | 0.5507 | 0.5787 | 0.0523 | 0.3582 | 1695 |
| Balanced Random Forest | 0.7268 | 0.5455 | 0.5927 | 0.6469 | 0.2123 | 0.4627 | 427 |
| XGBoost threshold calibration | 0.7466 | 0.5603 | 0.5692 | 0.6900 | 0.1493 | 0.2537 | 188 |
| Focal-loss MLP | 0.7339 | 0.5640 | 0.5981 | 0.6105 | 0.2224 | 0.3134 | 429 |
Ulinganisho huu mpana unaweka wazi zaidi kikomo cha dai kuu. Cost-sensitive stacking huongeza mwonekano wa U2R ikilinganishwa na baseline; lakini Balanced Random Forest ina nguvu zaidi kwa U2R recall na R2L recall na ina U2R false-positive chache sana. XGBoost threshold calibration hupunguza U2R false-positive hadi 188, kiwango cha chini zaidi, huku U2R recall ikibaki 0.2537. Kwa hiyo utafiti hauungi mkono hitimisho kwamba “muundo unaopendekezwa ni bora kuliko mbadala zote”.
Majaribio ya kitakwimu ya repeated-seed
Ili kutotegemea matokeo ya random seed moja kwa utofauti wa kistokastiki, seed 10 zilitumika: {0, 1, 2, 3, 4, 5, 10, 21, 42, 100}. Kwa ulinganisho wa paired kati ya baseline na cost-sensitive stacking, Wilcoxon signed-rank ilitumika; kwa familia nyingi za modeli, Friedman test ilitumika. Kiwango cha significance ni p < 0.05.
| Ulinganisho | Metriki | Test | p-value | Tafsiri ya chanzo |
|---|---|---|---|---|
| Cost-sensitive stacking vs baseline | Weighted F1 | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | U2R recall | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | R2L recall | Wilcoxon | 0.0039 | Significant |
| Familia zote za cost-sensitive model | Weighted F1 | Friedman | 0.0018 | Significant |
Neno “statistically significant” hapa halimaanishi kwamba ukubwa wa tofauti unatosha kiutendaji. Mfano wa R2L unaonyesha hili wazi: katika repeated-seed test tofauti ni significant kitakwimu, lakini katika hali kuu recall imeongezeka tu kutoka 4.12% hadi 5.23% na TP kutoka 119 hadi 151. Significance ya kitakwimu na athari ya kiutendaji ya usalama ni maswali tofauti.
Component ablation inaonyesha nini?
| Toleo | W-F1 | Macro-F1 | Balanced Accuracy | Macro PR-AUC | R2L Recall | U2R Recall |
|---|---|---|---|---|---|---|
| Baseline stack, hakuna class weighting | 0.712 | 0.492 | 0.488 | 0.608 | 0.041 | 0.000 |
| CW-only XGBoost | 0.752 | 0.594 | 0.571 | 0.750 | 0.091 | 0.209 |
| Stacking, hakuna feature selection | 0.763 | 0.577 | 0.642 | 0.694 | 0.175 | 0.522 |
| MI-only XGBoost | 0.743 | 0.595 | 0.570 | 0.720 | 0.086 | 0.284 |
| RFE-only XGBoost | 0.711 | 0.510 | 0.500 | 0.670 | 0.044 | 0.075 |
| Stacking imeondolewa | 0.715 | 0.509 | 0.501 | 0.674 | 0.037 | 0.060 |
| Framework kamili ya 25-feature | 0.721 | 0.502 | 0.551 | 0.579 | 0.052 | 0.358 |
Matokeo muhimu zaidi ya ablation ni kwamba class weighting ndiyo kichocheo kikuu cha ongezeko la U2R visibility. Class weighting inapoondolewa, U2R recall hurudi hadi sifuri. Hata hivyo feature reduction si bure: toleo la stacking bila feature selection linapita framework kamili ya 25-feature kwa weighted F1, balanced accuracy, R2L recall na U2R recall.
Kwa hiyo jukumu la kisayansi la hybrid feature selection linapaswa kutafsiriwa si kama “kutoa accuracy ya juu zaidi”, bali kama kupata feature space ndogo na yenye ufanisi zaidi wa kihesabu.
Kwa nini Weighted F1 pekee haitoshi?
| Mpangilio | Accuracy | Weighted F1 | Macro-F1 | Balanced Accuracy | Macro FPR | Macro FNR | R2L | U2R |
|---|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.754 | 0.712 | 0.492 | 0.488 | 0.084 | 0.512 | 0.041 | 0.000 |
| Cost-sensitive stacking | 0.734 | 0.721 | 0.502 | 0.551 | 0.080 | 0.449 | 0.052 | 0.358 |
Kupungua kwa Macro FNR kutoka 0.512 hadi 0.449 kunaendana na kuongezeka kwa mwonekano wa darasa nadra, lakini 0.449 bado ni kiwango cha juu cha kukosa. Chanzo hakitathmini hili kama tatizo lililotatuliwa kwa production NIDS.
Kwa nini PR-AUC ilihesabiwa tofauti?
Precision–Recall Area Under the Curve (PR-AUC) husaidia kutathmini jinsi modeli inavyopanga precision na recall katika decision threshold tofauti, hasa katika matatizo ambapo darasa chanya ni nadra sana. Kwa kuwa prevalence ya U2R katika KDDTest+ ni 0.0030 pekee, hard-label recall pekee haielezi ubora wa mpangilio wa uwezekano.
| Darasa | Baseline | Cost-Sensitive |
|---|---|---|
| DoS | 0.9448 | 0.9636 |
| Normal | 0.9541 | 0.8066 |
| Probe | 0.8034 | 0.7660 |
| R2L | 0.3280 | 0.3449 |
| U2R | 0.0092 | 0.0126 |
U2R PR-AUC iliongezeka kutoka 0.0092 hadi 0.0126. Chanzo kinaieleza kama takriban mara 3.1 na 4.2 ya prevalence baseline. Hata hivyo, 0.0126 ni kiwango cha chini sana cha ranking-quality kwa thamani kamili; waandishi pia wanaacha U2R kama mojawapo ya changamoto kuu za utafiti.
Nini hutokea threshold ya U2R inapobadilishwa?
| Threshold τ | U2R TP / 67 | U2R Recall | U2R FP | Precision |
|---|---|---|---|---|
| 0.05 | 59 | 0.881 | 6608 | 0.0088 |
| 0.10 | 45 | 0.672 | 3796 | 0.0117 |
| 0.30 | 24 | 0.358 | 2180 | 0.0109 |
| 0.50 | 14 | 0.209 | 1666 | 0.0083 |
| 0.70 | 11 | 0.164 | 1312 | 0.0083 |
| 0.90 | 11 | 0.164 | 953 | 0.0114 |
Threshold inapopunguzwa, U2R zaidi hugunduliwa, lakini idadi ya false-positive hupanda hadi maelfu. Threshold inapoongezwa, mzigo wa tahadhari hupungua, lakini recall pia hupungua. U2R precision iko karibu na %1 katika operating point zote zilizoonyeshwa.
Matokeo ya hard-label cost-sensitive U2R katika Table 14 ni 24 TP na 1695 FP, ilhali matokeo ya \(\tau=0.30\) katika threshold table ni 2180 FP kwa 24 TP zile zile. Nambari hizi mbili hazipingani: hard-label model hutumia uamuzi wake wa kawaida wa multi-class, ilhali threshold experiment hutumia operating rule tofauti inayolazimisha darasa kuwa U2R wakati uwezekano wa U2R unapozidi \(\tau\) iliyowekwa.
Uchambuzi wa alert-budget
| Bajeti ya tahadhari ya mchambuzi | U2R halisi zilizopatikana / 67 |
|---|---|
| Top 100 tahadhari | 4 |
| Top 500 tahadhari | 6 |
| Top 1000 tahadhari | 11 |
Matokeo haya yanaonyesha kwamba alama ya U2R ya modeli hubeba taarifa fulani kwa analyst prioritization, lakini haitoi precision ya kutosha kwa uamuzi wa kiotomatiki wenye uhakika mkubwa ikiwa inatumika pekee yake.
Uthibitishaji wa Nje wa UNSW-NB15 Unaonyesha Nini?
Uthibitishaji wa nje wa UNSW-NB15 unaonyesha kwamba bila dataset-specific tuning, mantiki ile ile ya preprocessing, MI→RFE, stacking na balanced class-weighting inaweza kuongeza kwa kiasi kikubwa recall ya makundi manne ya mashambulizi nadra; hata hivyo hili hutokea kwa gharama ya kupungua kwa Normal recall na weighted F1. Kwa hiyo uthibitishaji wa nje unaunga mkono kwamba rare-class trade-off huhamishwa kwenda kwenye seti nyingine ya data, lakini hauonyeshi ubora wa jumla katika mitandao ya uzalishaji.
Itifaki ya seti ya data ya nje
Official training partition ya UNSW-NB15 ina rekodi 175,341, testing partition ina 82,332 na standard taxonomy ya madarasa kumi ilitumika. Katika public mirror iliyotumika, record identifier pamoja na sttl, dttl na vipengele sita vya ct_* connection-counter viliondolewa; vipengele 31 numeric na vitatu categorical vilivyobaki vilichakatwa kwa pipeline ile ile.
proto, service na state zili-one-hot encode; Min-Max scaler ilifitishwa kwa training partition pekee; vipengele 50 vilihifadhiwa kwa MI; vikapunguzwa hadi 25 kwa RFE na stacking architecture ile ile ikatumika na balanced class weights. Chanzo kinasisitiza kwamba UNSW-specific tuning haikufanywa.
| Usanidi | Weighted F1 | Macro-F1 | Balanced Accuracy | Analysis Recall | Backdoor Recall | Shellcode Recall | Worms Recall |
|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.8096 | 0.5007 | 0.4856 | 0.0000 | 0.0583 | 0.5291 | 0.1818 |
| Cost-sensitive stacking | 0.7509 | 0.4780 | 0.6696 | 0.2496 | 0.6930 | 0.9550 | 0.8864 |
| Cost-sensitive XGBoost | 0.7488 | 0.5137 | 0.6392 | 0.1300 | 0.5798 | 0.9233 | 0.7273 |
Kwa cost-sensitive stacking, Worms huongezeka kutoka 18.18% hadi 88.64% na sampuli 39 kati ya 44 za Worms hutambuliwa kwa usahihi. Shellcode huongezeka kutoka 52.91% hadi 95.50%, Backdoor kutoka 5.83% hadi 69.30%, na Analysis kutoka 0.00% hadi 24.96%.
Kwa upande mwingine, Normal recall hupungua kutoka 91.74% hadi 64.22% na weighted F1 kutoka 0.8096 hadi 0.7509. Balanced accuracy huongezeka kutoka 0.4856 hadi 0.6696. Hii ndiyo picha ya trade-off kuu ya usalama ya utafiti katika seti nyingine ya data: mafanikio ya jumla ya majority-class hupungua huku mashambulizi yaliyowakilishwa kidogo yakionekana zaidi.
Class-level PR-AUC ya cost-sensitive model iliripotiwa kuwa 0.5903 kwa Worms na 0.3939 kwa Shellcode. Hizi zinaonyesha tabia ya rare-class ranking yenye nguvu zaidi kuliko NSL-KDD U2R PR-AUC = 0.0126.
Matokeo yanayoungwa mkono na utafiti
- Balanced class weighting iliweza kuongeza recall ya baadhi ya madarasa nadra ya mashambulizi bila kubadilisha original training observations.
- Katika jaribio kuu la NSL-KDD, stacking U2R recall iliongezeka kutoka 0.00% hadi 35.82%.
- Ongezeko la Weighted F1, U2R recall na R2L recall lilikuwa significant katika repeated-seed paired Wilcoxon tests kwa kiwango cha
p < 0.05. - Ingawa matokeo ya R2L yanabadilika kitakwimu, uboreshaji kamili wa kiutendaji ni mdogo.
- Class weighting ndicho kichocheo kikuu cha U2R visibility.
- Muundo wa 25-feature MI–RFE hutoa compactness lakini hautoi utendaji wa juu zaidi wa utabiri.
- ADASYN inapita cost-sensitive stacking katika baadhi ya metriki za jumla na R2L.
- Balanced Random Forest ni imara zaidi kuliko cost-sensitive stacking kwa U2R na R2L recall katika ulinganisho mpana.
- Uthibitishaji wa nje wa UNSW-NB15 unaonyesha kwamba ongezeko la recall ya darasa nadra hujitokeza pia kwenye benchmark nyingine.
- Ongezeko la recall ya darasa nadra linaweza kuwa na gharama katika majority-class recall, weighted F1 au false-positive burden.
Matokeo yasiyoungwa mkono na utafiti
- Framework si NIDS ya jumla inayotatua kwa kuaminika mashambulizi yote nadra.
- Tatizo la R2L halijatatuliwa.
- 35.82% recall kwa U2R haimaanishi ugunduzi wa mashambulizi wa kiotomatiki wenye high precision.
- Haijaonyeshwa kwamba feature set ya vipengele 25 ni optimum kwa seti zote za data au aina zote za mashambulizi.
- Haijaonyeshwa kwamba cost-sensitive learning ni bora kwa ujumla kuliko SMOTE, ADASYN, Balanced Random Forest, focal loss au threshold calibration.
- Matokeo ya NSL-KDD na UNSW-NB15 hayawakilishi trafiki yote ya kisasa ya uzalishaji ya encrypted, cloud-native na IoT.
- Hakuna end-to-end deployment validation iliyofanywa kwenye SOC hai au production packet/flow collector.
- SHAP au counterfactual analysis haijatumika kwa explainability katika framework iliyopo.
- Hakuna validation iliyokamilishwa katika utafiti huu kwenye CICIDS2017/2018 na TON_IoT.
- Statistical significance peke yake si dhamana ya operational usefulness au alert budget inayofaa.
Mapungufu
Umri wa benchmark: NSL-KDD ni muhimu kwa ulinganisho uliodhibitiwa lakini haiwakilishi kikamilifu encrypted traffic, cloud workloads, IoT protocols na kampeni za kisasa za mashambulizi.
R2L overlap: Ufanano wa feature-space kati ya R2L na Normal haujatatuliwa kwa class weighting.
Kikomo cha mafunzo ya SVM: SVM iliendeshwa kwenye sampuli 30,000 za stratified training pekee; kikomo hiki kinapaswa kuzingatiwa katika ulinganisho na modeli zinazotumia KDDTrain+ kamili.
False-positive burden: U2R visibility inapoongezeka precision inaweza kubaki chini sana. Katika mazingira ya uzalishaji, threshold calibration na analyst capacity huwa muhimu.
Explainability: Hakuna safu ya ufafanuzi kama SHAP au counterfactual analysis iliyoongezwa.
External validity: Uthibitishaji wa nje wa UNSW-NB15 umepunguza tatizo la seti moja ya data lakini haujaliondoa kabisa.
Deployment hai: End-to-end live flow collector, SOC integration na production network behavior hazijajaribiwa.
Kauli ya latency ndani ya chanzo: Ingawa kuna kipimo kidogo cha inference-latency katika sehemu ya mbinu, sehemu ya mapungufu bado ina kauli kwamba inference latency bado haijatathminiwa.
Mwelekeo wa kazi za baadaye
Chanzo kinapendekeza kwamba siku zijazo itifaki ile ile ya ablation na confidence-interval itumike kwenye CICIDS2017, CSE-CIC-IDS2018 na TON_IoT; adaptive cost schedule, probability calibration, threshold calibration kwa held-out validation, interpretability inayotegemea SHAP, ulinganisho wa focal-loss models chini ya controlled false-positive budget na tathmini ya mbinu kama Balanced Random Forest/EasyEnsemble vifanywe.
Pia inapendekezwa real-time deployment validation kwa flow collector kama CICFlowMeter au Zeek. Haya si matokeo yaliyokamilishwa ya utafiti wa sasa, bali mapendekezo ya utafiti wa baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Cost-Sensitive Stacking Ensemble with Hybrid Feature Selection for Rare Attack Detection in Network Intrusion Detection Systems
Waandishi na mpangilio: Ioan Corneliu Salisteanu; Iulian Udroiu; Andrei Cosmin Gheorghe; Ionut Adrian Tudoroiu; Emil Mihai Diaconu.
Corresponding author: Andrei Cosmin Gheorghe.
Corresponding e-mail: andrei.gheorghe@valahia.ro
Taasisi: Faculty of Electrical Engineering, Electronics and Information Technology, University “Valahia” of Targoviste, 130004 Targoviste, Romania.
Mchango sawa / uandishi wa kwanza sawa: Hakuna tamko la mchango sawa katika chanzo.
Academic Editor: Emre Tokgoz.
Jarida: Electronics.
Mchapishaji: MDPI, Basel, Switzerland.
ISSN: 2079-9292.
Juzuu / toleo: Volume 15, Issue 14.
Nambari ya makala: 3094.
Mwaka wa uchapishaji: 2026.
Aina ya makala: Article; utafiti wa tathmini ya experimental machine learning/NIDS unaotegemea benchmark iliyodhibitiwa.
DOI: 10.3390/electronics15143094.
Kiungo rasmi: https://doi.org/10.3390/electronics15143094
Received: 2 Juni 2026.
Revised: 10 Julai 2026.
Accepted: 13 Julai 2026.
Published: 14 Julai 2026.
Hali ya peer review: Electronics inaelezwa katika rekodi rasmi ya MDPI kuwa international, peer-reviewed na open-access journal.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Hali ya preprint: Chanzo kilichochunguzwa ni makala ya jarida iliyochapishwa; PDF haitaji kitambulisho tofauti cha preprint.
Tatizo kuu la utafiti: Uwezekano wa general accuracy kuficha kushindwa kwa rare/high-impact attack chini ya class imbalance kali.
Kikomo cha mchango wa mbinu: Vipengele vya MI, RFE, stacking au balanced class weighting si algorithimu mpya kila kimoja. Mchango wa utafiti ni ujumuishaji wake unaodhibitiwa katika itifaki ya rare-class-focused, statistically audited na data-preserving.
Seti kuu ya data: NSL-KDD; KDDTrain+ = rekodi 125,973, KDDTest+ = rekodi 22,544.
External validation: UNSW-NB15; official train = rekodi 175,341, test = rekodi 82,332; dataset-specific tuning haikufanywa.
Madarasa ya NSL-KDD: Normal, DoS, Probe, R2L na U2R.
Preprocessing: one-hot encoding kwa protocol_type, service na flag; attribute 41 za asili → feature 122 za nambari; training-fit Min-Max scaling [0,1]; difficulty_level imeondolewa.
Feature selection: MI 122 → 50, RFE inayotegemea Random Forest 50 → 25.
Kikomo cha tafsiri ya feature-selection: Muundo wa 25-feature si pointi ya juu zaidi ya utendaji; 50-feature na baadhi ya no-feature-selection variants zilitoa metriki za utabiri za juu zaidi.
Modeli binafsi: Random Forest, XGBoost, SVM na KNN.
Stacking: Random Forest + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold out-of-fold prediction.
Kikomo cha SVM: Sampuli 30,000 za stratified training; si sawa moja kwa moja na majaribio ya ziada ya full-training.
Fomula ya cost-sensitive: \(w_c=N/(C n_c)\).
Approximate class weights: Normal 0.37; DoS 0.55; Probe 2.16; R2L 25.32; U2R 484.49.
Je, resampling ilitumika katika framework kuu? Hapana. Framework kuu ya cost-sensitive huhifadhi original training observations. SMOTE, Borderline-SMOTE, ADASYN na SMOTE-Tomek ni experimental baseline tofauti.
Random seeds: 0, 1, 2, 3, 4, 5, 10, 21, 42, 100.
Statistical tests: Wilcoxon signed-rank na Friedman; significance threshold p < 0.05.
Matokeo makuu ya U2R: 0/67 → 24/67; recall 0.00% → 35.82%; Wilson %95 GA 25.40%–47.78% katika hali ya cost-sensitive.
Matokeo makuu ya R2L: 119/2887 → 151/2887; recall 4.12% → 5.23%.
Matokeo makuu ya weighted-F1: Stacking 0.7120 → 0.7214.
Accuracy trade-off kuu: Stacking 0.7542 → 0.7342.
U2R hard-label precision: Cost-sensitive stacking 24 TP, 1695 FP, precision 0.0140.
Matokeo ya U2R probability-level: PR-AUC 0.0092 → 0.0126; prevalence 0.0030.
Repeated-seed p-values: Weighted F1 p = 0.0020; U2R recall p = 0.0020; R2L recall p = 0.0039; Friedman weighted-F1 comparison p = 0.0018.
25-feature sensitivity: Weighted F1 = 0.7214; R2L = 0.0523; U2R = 0.3582; training time = 150.8 s.
50-feature sensitivity: Weighted F1 = 0.7668; R2L = 0.1888; U2R = 0.5075; training time = 160.5 s.
122-feature sensitivity: Weighted F1 = 0.7625; R2L = 0.1753; U2R = 0.5224; training time = 243.5 s.
Software: Python 3.13.5; scikit-learn 1.8.0; XGBoost 3.1.3; imbalanced-learn 0.14.1; NumPy 2.3.5; pandas 2.2.3.
Vifaa/mazingira: Linux x86_64, CPU-only, 56 logical CPU core available to container, takriban 4.3 GB RAM; GPU haikutumika.
Inference latency kwa KDDTest+ 1000 za kwanza: Random Forest 0.2609 ms/sample; XGBoost 0.1081 ms/sample; KNN 1.6117 ms/sample; Stacking 2.0925 ms/sample. Chanzo kinazizuia kama hardware-dependent relative computational values.
Dokezo la latency ndani ya chanzo: Ingawa Section 3.6 hutoa thamani za inference latency, Section 5.3 inasema inference latency bado haijajumuishwa. Kwa kuwa kauli zote mbili zipo pamoja katika chanzo, tofauti hii imehifadhiwa.
External-validation trade-off: Katika UNSW-NB15, cost-sensitive stacking balanced accuracy iliongezeka 0.4856 → 0.6696, huku weighted F1 ikipungua 0.8096 → 0.7509 na Normal recall 91.74% → 64.22%.
UNSW rare-class recall: Analysis 0.00% → 24.96%; Backdoor 5.83% → 69.30%; Shellcode 52.91% → 95.50%; Worms 18.18% → 88.64%.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Data Availability: NSL-KDD ni benchmark ya umma. Chanzo pia kinasema kuna supplementary reproducibility package yenye Python script kwa preprocessing, MI–RFE feature selection, training, imbalance baselines, statistical tests na figure generation. Hakuna commercial au private production network trace iliyotumika.
Michango ya waandishi: Conceptualization — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe, Ioan Corneliu Salisteanu na Iulian Udroiu; methodology — Ioan Corneliu Salisteanu, Andrei Cosmin Gheorghe na Iulian Udroiu; software — Ionut Adrian Tudoroiu na Andrei Cosmin Gheorghe; validation — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe na Emil Mihai Diaconu; formal analysis — Andrei Cosmin Gheorghe; investigation — Emil Mihai Diaconu; resources na data curation — Ionut Adrian Tudoroiu; original draft — Ionut Adrian Tudoroiu; review/editing — Andrei Cosmin Gheorghe; visualization — Ioan Corneliu Salisteanu na Iulian Udroiu; supervision — Ioan Corneliu Salisteanu, Iulian Udroiu na Andrei Cosmin Gheorghe.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna mgongano wa maslahi.
Kikomo kikuu cha mbinu: Matokeo ni uchambuzi wa benchmark uliodhibitiwa wa NSL-KDD na UNSW-NB15; si end-to-end validation kwenye SOC halisi, production network au live flow collector.
Uthibitishaji wa baadaye: CICIDS2017, CSE-CIC-IDS2018, TON_IoT, threshold/probability calibration, SHAP, controlled false-positive budgets, Balanced Random Forest/EasyEnsemble na live CICFlowMeter/Zeek integration.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *