


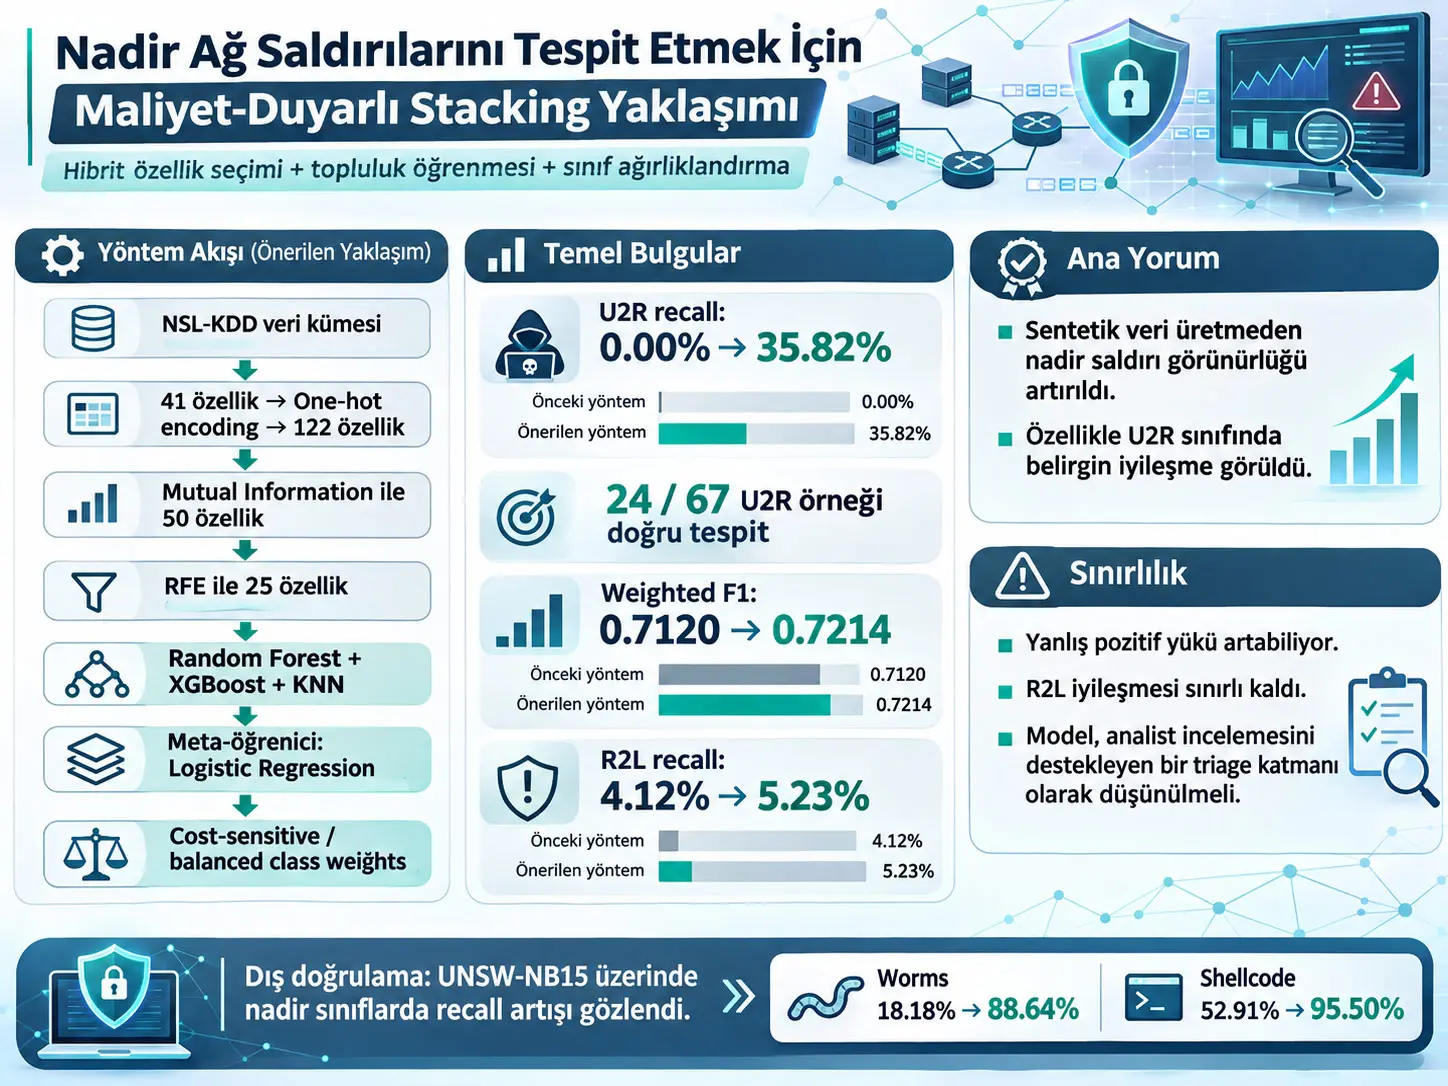
Maliyet-duyarlı MI–RFE–stacking çerçevesi, dengesiz çok sınıflı ağ saldırı tespitinde nadir saldırıların görünürlüğünü artırmak için Mutual Information (MI) ve Recursive Feature Elimination (RFE) ile özellik seçimi, heterojen stacking ensemble ve sınıfa bağlı hata maliyetlerini bir araya getiren veri-koruyucu bir Network Intrusion Detection System (NIDS) değerlendirme boru hattıdır. Çalışma yeni bir sınıflandırıcı önermemektedir; Random Forest, XGBoost, Support Vector Machine (SVM), K-Nearest Neighbors (KNN), Logistic Regression, MI, RFE ve balanced class weighting gibi yerleşik bileşenlerin nadir sınıflara odaklanan kontrollü ve tekrar üretilebilir bir protokol altında nasıl davrandığını incelemektedir.
Ana değerlendirme NSL-KDD benchmark'ında yapılmıştır. KDDTrain+ 125,973, KDDTest+ ise 22,544 ağ bağlantısı kaydı içerir. Kategorik protocol_type, service ve flag değişkenlerinin one-hot encoding işleminden sonra 41 özgün özellik 122 sayısal özelliğe genişletilmiş; yalnız eğitim kümesine uydurulan Min-Max ölçekleme uygulanmış; ardından MI ile en yüksek skorlu 50 özellik tutulmuş ve Random Forest tabanlı RFE ile sayı 25'e indirilmiştir.
Ana stacking ensemble Random Forest, XGBoost ve KNN'yi base learner; Logistic Regression'ı meta-learner olarak kullanır. Meta-learner için 3-fold out-of-fold tahminler üretilir. Sınıf dengesizliği sentetik veri üretilmeden, w_c = N/(C n_c) biçimindeki balanced class weighting ile ele alınmıştır. NSL-KDD dağılımında yaklaşık sınıf ağırlıkları Normal için 0.37, DoS için 0.55, Probe için 2.16, R2L için 25.32 ve U2R için 484.49'dur.
Stacking ensemble'ın ana tek-koşu sonucunda U2R recall 0.00%'dan 35.82%'ye yükselmiştir; başka bir ifadeyle baseline model 67 U2R örneğinin hiçbirini doğru belirleyemezken cost-sensitive yapı 24'ünü doğru belirlemiştir. Weighted F1 0.7120'dan 0.7214'e yükselmiş, fakat accuracy 0.7542'den 0.7342'ye düşmüştür. R2L recall ise yalnız 4.12%'den 5.23%'e, yani 119/2887 doğru tespitten 151/2887'ye yükselmiştir.
U2R sonucu güçlü bir yorum sınırı gerektirir. Cost-sensitive hard-label stacking sonucunda U2R için 24 true positive'a karşı 1695 false positive raporlandığı için precision yalnız 0.0140'dır. Ayrı probability-threshold analizinde de U2R precision yaklaşık %1 düzeyinde kalmıştır. Dolayısıyla modelin U2R çıktısı çalışmanın kendi tartışmasına göre otonom nihai karar değil, güvenlik analistinin incelemesini önceliklendiren bir triage sinyalidir.
Çalışma ayrıca cost-sensitive yaklaşımın bütün alternatiflerden üstün olmadığını göstermektedir. Full-training resampling karşılaştırmasında ADASYN weighted F1 ve R2L recall bakımından daha güçlüdür; daha sonraki exploratory baselines içinde Balanced Random Forest daha yüksek U2R recall ve daha düşük U2R false-positive sayısı sağlamıştır. Önerilen yaklaşımın ayırt edici avantajı, sentetik azınlık örneği üretmeden özgün eğitim gözlemlerini koruması ve nadir saldırı davranışını açık biçimde denetlemesidir.
UNSW-NB15 dış doğrulamasında da nadir sınıf recall'ları belirgin biçimde yükselmiş; ancak Normal recall ve weighted F1 düşmüştür. Bu sonuçlar yöntemin nadir sınıflara daha fazla ağırlık verdiğinde karar sınırlarını gerçekten değiştirdiğini destekler, fakat modern üretim ağlarında genel üstünlük veya otomatik deployment başarısı anlamına gelmez.
Maliyet-Duyarlı Öğrenme Bu Çalışmada Neden Kullanılıyor?
Maliyet-duyarlı öğrenme, dengesiz veri kümesindeki bütün sınıflandırma hatalarını eşit kabul etmek yerine nadir sınıflardaki hatalara daha yüksek eğitim cezası vererek karar sınırını azınlık sınıflarına karşı daha duyarlı hale getirmektedir; bu çalışmada temel amaç özellikle U2R ve R2L saldırılarının çoğunluk sınıfları içinde kaybolmasını azaltırken özgün eğitim kayıtlarını sentetik örneklerle değiştirmemektir.
Nadir saldırılar neden genel accuracy içinde kaybolabiliyor?
NSL-KDD beş ana sınıf kullanır: Normal, Denial of Service (DoS), Probe, Remote-to-Local (R2L) ve User-to-Root (U2R). Eğitim kümesinde Normal ve DoS birlikte kayıtların yaklaşık %90'ını oluştururken U2R yalnız 52 eğitim örneğinden oluşur; bu yaklaşık %0.04'lük bir paydır. Böyle bir dağılımda model çoğunluk sınıflarını iyi öğrenip nadir sınıfı neredeyse tamamen görmezden geldiği halde yüksek sayılabilecek global accuracy elde edebilir.
DoS, hedef hizmet veya kaynağın kullanılabilirliğini bozmayı amaçlayan saldırı sınıfıdır. Probe, ağ veya sistem hakkında bilgi toplama ve erişilebilir hedefleri araştırma davranışlarını kapsar. R2L, uzaktaki bir kaynaktan yerel sisteme yetkisiz erişim elde edilmesiyle ilişkili sınıftır. U2R ise kullanıcının daha yüksek veya yönetici/root düzeyi ayrıcalık elde etmesiyle ilişkili, çok nadir fakat güvenlik açısından kritik sınıftır.
Kaynak Şekil 4'te 5000 KDDTest+ örneği t-SNE ile iki boyutlu olarak görselleştirilmiştir. Görselde DoS ve Normal örnekleri bazı daha ayırt edilebilir bölgeler oluştururken R2L ve U2R örneklerinin Normal trafikle güçlü biçimde örtüştüğü gösterilmektedir. t-SNE burada sınıflandırıcı değildir; yüksek boyutlu feature space'in görsel inceleme amacıyla iki boyuta indirgenmesinde kullanılan bir yöntemdir. Şeklin mesajı, nadir saldırı sorununun yalnız sınıf sayısından değil, feature-space overlap'ten de kaynaklandığıdır.
Balanced class weight formülü
Kaynakta kullanılan temel maliyet ağırlığı:
\[ w_c=\frac{N}{C\,n_c} \]
Formül neyi hesaplar? Her sınıf için eğitim sırasında kullanılacak göreli hata ağırlığını hesaplar.
\(w_c\): \(c\) sınıfının boyutsuz ağırlığıdır.
\(N\): Toplam eğitim örneği sayısıdır; NSL-KDD ana eğitim kümesinde 125,973'tür.
\(C\): Sınıf sayısıdır; bu çalışmada 5'tir.
\(n_c\): İlgili sınıfa ait eğitim örneği sayısıdır.
Bir sınıfın örnek sayısı küçüldükçe paydadaki \(n_c\) küçülür ve \(w_c\) büyür. Dolayısıyla U2R gibi çok nadir bir sınıftaki yanlış sınıflandırma eğitim amacı açısından Normal sınıfındaki bir hatadan çok daha yüksek cezaya sahip olur.
| Sınıf | Yaklaşık ağırlık | Algoritmik anlam |
|---|---|---|
| Normal | 0.37 | Çok sık sınıf; hata cezası görece düşüktür. |
| DoS | 0.55 | Yüksek frekanslı saldırı sınıfı. |
| Probe | 2.16 | Orta sıklıkta sınıf. |
| R2L | 25.32 | Nadir sınıf; yanlış sınıflandırma daha ağır cezalandırılır. |
| U2R | 484.49 | En nadir sınıf; yanlış sınıflandırma çok yüksek göreli ceza alır. |
Random Forest, SVM ve Logistic Regression için class_weight = balanced kullanılmıştır. XGBoost'ta aynı sınıf-frekansı formülüne dayalı örnek ağırlıkları uygulanmıştır. KNN'nin kullanılan standart formülasyonunda aynı class-weight mekanizması bulunmadığından KNN sonucu cost-sensitive aşamada değişmemektedir.
Neden doğrudan SMOTE kullanılmamış?
Yazarların veri-koruyucu tercihinin temel gerekçesi U2R'nin yalnız 52 gerçek eğitim örneğine sahip olmasıdır. Çok küçük gerçek örneklemden çok sayıda sentetik gözlem türetildiğinde numerik olarak kullanışlı fakat gerçek saldırı davranışını yeterince temsil etmeyen yapay karar bölgeleri oluşabileceği endişesi vardır. Bu nedenle ana framework eğitim verisini çoğaltmak yerine loss/karar maliyetini değiştirir.
Ancak çalışma bu gerekçeyi yalnız varsayım olarak bırakmamış ve SMOTE, Borderline-SMOTE, ADASYN ve SMOTE-Tomek'i aynı full-training protokolünde doğrudan baseline olarak test etmiştir. Sonuçlar cost-sensitive yaklaşımın resampling'e evrensel olarak üstün olmadığını göstermektedir.
Mutual Information neden ilk özellik seçim aşamasında kullanılıyor?
Mutual Information (MI), bir feature ile hedef sınıf arasındaki istatistiksel bağımlılığı değerlendiren filter-tipi feature-selection yöntemidir. Bir sınıflandırıcıyı tekrar tekrar eğitmeden her feature için hedef label ile bilgi ilişkisi hesaplanabildiğinden ilk eleme aşamasında görece düşük hesaplama maliyeti sağlar.
Çalışmada one-hot encoding sonrasındaki 122 özellik için MI hesaplanmış ve en yüksek MI skoruna sahip 50 özellik tutulmuştur. Bu aşama feature space'i önce hızlı bir filter mekanizmasıyla daraltır.
Recursive Feature Elimination ne yapıyor?
Recursive Feature Elimination (RFE), bir modelin feature-importance bilgisini kullanarak en az yararlı görülen özellikleri yinelemeli biçimde çıkaran wrapper-tipi bir seçim yöntemidir. Bu çalışmada 50 MI özelliği Random Forest estimator ile değerlendirilmiş ve en az önemli özellikler elenerek 25 özellik bırakılmıştır.
MI ile RFE'nin birlikte kullanılmasının mantığı, MI'nin hızlı model-bağımsız ilk filtrelemesini RFE'nin model-farkındalıklı ikinci elemesiyle birleştirmektir. Kaynak Şekil 3'te iki seçim mekanizmasının 22 özellik üzerinde ortaklaştığı, üç özelliğin yalnız MI ve üç özelliğin yalnız RFE tarafında bulunduğu gösterilmektedir.
Son 25 özellik
Çalışmada kullanılan 25 özellik şunlardır: src_bytes, diff_srv_rate, same_srv_rate, dst_host_diff_srv_rate, dst_host_srv_count, count, dst_host_same_srv_rate, dst_host_serror_rate, serror_rate, flag_SF, dst_host_srv_serror_rate, flag_S0, srv_serror_rate, logged_in, dst_host_srv_diff_host_rate, dst_host_same_src_port_rate, dst_host_count, srv_count, service_private, dst_host_rerror_rate, dst_host_srv_rerror_rate, rerror_rate, service_eco_i, protocol_type_icmp ve service_ecr_i.
Yazarlar bu 25 özelliğin bütün NIDS problemleri için evrensel optimum olduğunu iddia etmemektedir. Bu liste yalnız kontrollü NSL-KDD MI→RFE pipeline'ının çıktısıdır.
Sınıflandırıcı hiperparametreleri
| Model | Kaynak ayarı | Önemli yöntem notu |
|---|---|---|
| Random Forest | 200 ağaç; maximum depth = 20; internal split için minimum 5 örnek | MI sonrası RFE estimator olarak da kullanılmıştır. |
| XGBoost | 200 ağaç; maximum depth = 8; learning rate = 0.1; satır ve sütun subsampling = 0.8 | Cost-sensitive durumda per-instance weight kullanılmıştır. |
| SVM | RBF kernel; C = 10; gamma = scale | Hesaplama maliyeti nedeniyle 30,000 örneklik stratified eğitim alt kümesi kullanılmıştır. |
| KNN | k = 5; inverse-distance weighting | Standart uygulamada class weight kullanılmadığı için cost-sensitive sonuç değişmez. |
| Stacking | RF + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold OOF | Meta-learner leakage'i azaltmak için out-of-fold predictions ile eğitilir. |
Kaynak stacking içindeki base modeller için hesaplama verimliliği amacıyla “reduced hyperparameters” kullanıldığını belirtmekte, ancak bu azaltılmış stacking-içi hiperparametrelerin bütün sayısal değerlerini aynı yerde açıkça listelememektedir. Dolayısıyla yukarıdaki bireysel model ayarlarının stacking içindeki base modellerde birebir aynı olduğu varsayılmamalıdır.
Eğitim ve test protokolü
Tüm ana modeller KDDTrain+ üzerinde eğitilmiş ve bağımsız KDDTest+ üzerinde değerlendirilmiştir. KDDTest+ yeniden bölünmemiş, resample edilmemiş ve cross-validation eğitimine dahil edilmemiştir. Bu ayrım test kümesine bilgi sızmasını engellemek ve özgün NSL-KDD train-test distribution shift'ini korumak için önemlidir.
Ek repeated-seed, resampling, feature-sensitivity ve ablation deneyleri tam 125,973 kayıtlık KDDTrain+ ile yapılmıştır. SVM, 30,000 örneklik eğitim kısıtı nedeniyle bu ek karşılaştırmaların dışında tutulmuştur.
Yazılım ve donanım
| Bileşen | Sürüm / ortam |
|---|---|
| Python | 3.13.5 |
| scikit-learn | 1.8.0 |
| XGBoost | 3.1.3 |
| imbalanced-learn | 0.14.1 |
| NumPy | 2.3.5 |
| pandas | 2.2.3 |
| İşletim ortamı | Linux x86_64, CPU-only |
| CPU | Container'a erişilebilir 56 logical CPU core |
| RAM | Yaklaşık 4.3 GB |
| GPU | Kullanılmadı |
İlk 1000 KDDTest+ örneği üzerinde ayrıca inference latency ölçülmüştür: Random Forest 0.2609 ms/sample, XGBoost 0.1081 ms/sample, KNN 1.6117 ms/sample ve Stacking Ensemble 2.0925 ms/sample. Yazarlar bu sürelerin donanıma bağlı olduğunu ve yalnız göreli computational behavior'ı tanımlamak için raporlandığını belirtmektedir.
Kaynak içindeki inference-latency tutarsızlığı
Yöntem bölümünde yukarıdaki inference latency değerleri açıkça raporlanmasına rağmen Section 5.3 sınırlılıklar bölümünde çalışmanın henüz “runtime memory usage, inference latency veya end-to-end integration” içermediği yazılmıştır. İki ifade aynı yayımlanmış kaynak içinde birlikte bulunduğundan Verianla bunlardan birini sessizce silmemektedir. En güvenli okuma, ilk 1000 test örneğindeki sınırlı deployment-oriented latency ölçümünün mevcut olduğu; fakat tam üretim pipeline'ı için runtime/memory/end-to-end performans değerlendirmesinin yapılmadığıdır. Bu son cümle kaynak içindeki iki ifadenin birlikte yorumlanmasıdır, yeni deney sonucu değildir.
Değerlendirme metrikleri nasıl okunmalı?
Kaynak metrik adlarını kullanmakta ancak temel precision/recall/F1 denklemlerini yeniden türetmemektedir. Aşağıdaki denklemler çalışmanın yeni bulgusu değil, raporlanan metriklerin öğretici standart tanımlarıdır.
\[ Recall=\frac{TP}{TP+FN} \]
Recall, gerçekte ilgili sınıfa ait olan örneklerin ne kadarının doğru yakalandığını ölçer. U2R gibi yüksek etkili nadir saldırıda düşük recall, çok sayıda saldırının false negative olarak kaçırılması anlamına gelir.
\[ Precision=\frac{TP}{TP+FP} \]
Precision, modelin ilgili sınıf diye ürettiği alarmların ne kadarının gerçekten o sınıfa ait olduğunu ölçer. U2R recall yükselirken precision çok düşük kalıyorsa analyst alert burden ciddi biçimde artabilir.
\[ F1=2\frac{Precision\cdot Recall}{Precision+Recall} \]
F1 precision ve recall'u harmonik ortalamayla birleştirir. Bir bileşen çok düşük olduğunda F1 de sınırlanır.
\[ MacroF1=\frac{1}{C}\sum_{c=1}^{C}F1_c \]
Macro-F1 bütün sınıflara eşit ağırlık verir. Bu nedenle nadir sınıflardaki kötü performansı majority-class başarısının arkasında gizlemeye weighted F1'den daha az yatkındır.
\[ WeightedF1=\sum_{c=1}^{C}\frac{n_c}{N}F1_c \]
Weighted F1 her sınıfın F1 değerini sınıf desteğiyle ağırlıklandırır. Normal ve DoS gibi büyük sınıflar sonucu daha fazla etkilediği için nadir sınıf problemini tek başına açıklamak için yeterli değildir.
Çalışma bu nedenle weighted F1 yanında macro-F1, balanced accuracy, macro PR-AUC, macro false-positive rate, macro false-negative rate, sınıf bazlı recall, mutlak TP/FP sayıları ve Wilson 95% confidence interval kullanmaktadır.
U2R Recall'ın 0.00%'dan 35.82%'ye Çıkması Ne Anlama Geliyor?
U2R recall'ın 0.00%'dan 35.82%'ye yükselmesi, ana stacking deneyinde 67 gerçek U2R test örneğinin baseline model tarafından hiçbiri yakalanamazken cost-sensitive model tarafından 24'ünün doğru tespit edilmesi anlamına gelir; ancak aynı yapı çok sayıda U2R false positive ürettiği için sonuç “U2R problemi çözüldü” biçiminde yorumlanamaz.
Mutlak sayı neden yüzdeden daha önemlidir?
| Sınıf | Test örneği | TP Baseline | TP Cost-Sensitive | Baseline Recall, %95 GA | Cost-Sensitive Recall, %95 GA |
|---|---|---|---|---|---|
| R2L | 2887 | 119 | 151 | 4.12% [3.46%, 4.91%] | 5.23% [4.48%, 6.10%] |
| U2R | 67 | 0 | 24 | 0.00% [0.00%, 5.42%] | 35.82% [25.40%, 47.78%] |
U2R için 35.82% büyük bir yüzde artışı gibi görünür, fakat test kümesinde yalnız 67 U2R örneği vardır. 24 doğru tespit bu nedenle geniş Wilson confidence interval ile birlikte raporlanmaktadır. Wilson aralığı, özellikle örneklem küçük olduğunda gözlenen oranın belirsizliğini yalnız tek yüzde vermekten daha dürüst biçimde gösterir.
R2L tarafında test örneklemi çok daha büyüktür. Buna rağmen cost-sensitive yapı yalnız 32 ek R2L örneğini doğru sınıflandırabilmiştir. Bu nedenle R2L artışı istatistiksel olarak repeated-seed testinde anlamlı görünse bile operasyonel büyüklüğü sınırlıdır.
U2R false-positive yükü
| Ayar | Sınıf | TP | FP | FN | Precision | Recall |
|---|---|---|---|---|---|---|
| Baseline | R2L | 119 | 4 | 2768 | 0.9675 | 0.0412 |
| Cost-sensitive | R2L | 151 | 9 | 2736 | 0.9438 | 0.0523 |
| Baseline | U2R | 0 | 0 | 67 | 0.0000 | 0.0000 |
| Cost-sensitive | U2R | 24 | 1695 | 43 | 0.0140 | 0.3582 |
Cost-sensitive stacking U2R'yi artık tamamen görmezden gelmemektedir; fakat 24 doğru U2R alarmına karşı 1695 false-positive oluşması precision'ı 1.4% düzeyine indirir. Bu nedenle kaynak modelin U2R alarmını analyst triage için kullanmayı, nihai otonom saldırı kararı olarak kullanmamayı önerir.
R2L neden hâlâ başarısız?
Failure analysis, baseline stacking'de 2887 R2L örneğinin 2764'ünün Normal tahmin edildiğini göstermektedir. Class weighting sonrasında Normal'e giden sayı 2269'a düşer; ancak 463 R2L örneği bu kez doğru R2L yerine U2R olarak sınıflandırılır. Dolayısıyla model nadir saldırılara daha duyarlı hale gelirken yeterince doğru bir R2L decision region öğrenememektedir.
| Ayar | Sınıf | Toplam | Normal tahmini | R2L tahmini | U2R tahmini | FNR |
|---|---|---|---|---|---|---|
| Baseline stacking | R2L | 2887 | 2764 | 119 | 0 | 0.959 |
| Baseline stacking | U2R | 67 | 65 | 2 | 0 | 1.000 |
| Cost-sensitive stacking | R2L | 2887 | 2269 | 151 | 463 | 0.948 |
| Cost-sensitive stacking | U2R | 67 | 40 | 3 | 24 | 0.642 |
25 Özellikli MI–RFE Yapısı En İyi Tahmin Performansını mı Veriyor?
Hayır. Kaynağın feature-subset sensitivity analizi 50 özellikli ve 122 özellikli konfigürasyonların 25 özellikli MI–RFE konfigürasyonunu weighted F1, R2L recall ve U2R recall açısından geçtiğini göstermektedir; 25 özellikli yapının gerekçesi tahmin üstünlüğü değil daha düşük boyut, daha kısa hesaplama süresi ve kompaktlıktır.
| Özellik ayarı | Seçim yöntemi | Weighted F1 | R2L Recall | U2R Recall | Training Time (s) |
|---|---|---|---|---|---|
| 10 özellik | İlk 10 seçilmiş özellik | 0.7053 | 0.0173 | 0.1194 | 110.2 |
| 25 özellik | MI + RFE | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| 50 özellik | MI top 50 | 0.7668 | 0.1888 | 0.5075 | 160.5 |
| 122 özellik | Feature selection yok | 0.7625 | 0.1753 | 0.5224 | 243.5 |
50 özellikli yapı weighted F1 ve R2L recall açısından en iyi sonucu verirken 122 özellikli yapı U2R recall bakımından az farkla en yüksek değeri vermektedir. 25 özellikli yapı 50 özellikli yapıdan yalnız yaklaşık 9.7 saniye daha düşük training time verirken üç ana performans göstergesinde de daha zayıftır. Kaynak bu nedenle hesaplama bütçesi izin veriyorsa 50 özelliği daha güçlü operating point olarak tanımlar.
Çalışmanın Yöntemi ve Bulguları
Baseline model sonuçları
| Model | Accuracy | Weighted Precision | Weighted Recall | Weighted F1 | Time (s) |
|---|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7739 | 0.7544 | 0.7055 | 1.4 |
| XGBoost | 0.7504 | 0.8088 | 0.7504 | 0.7039 | 2.9 |
| SVM | 0.7183 | 0.7028 | 0.7183 | 0.6717 | 3.3 |
| KNN | 0.7409 | 0.7815 | 0.7409 | 0.6988 | 0.8 |
| Stacking Ensemble | 0.7542 | 0.8149 | 0.7542 | 0.7120 | 11.7 |
Random Forest en yüksek baseline accuracy değerine, stacking ensemble ise en yüksek weighted precision ve weighted F1 değerine sahiptir. Buna rağmen baseline confusion matrix'leri R2L ve U2R'nin sıklıkla Normal olarak tahmin edildiğini göstermektedir. Bu nedenle çalışmanın ana argümanı “stacking zaten güçlüdür” değil, aggregate skorların nadir sınıf başarısızlığını gizleyebileceğidir.
Cost-sensitive learning model bazında ne değiştirdi?
| Model | Accuracy Baseline | Accuracy CW | F1 Baseline | F1 CW |
|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7533 | 0.7055 | 0.7074 |
| XGBoost | 0.7504 | 0.7648 | 0.7039 | 0.7237 |
| SVM | 0.7183 | 0.7611 | 0.6717 | 0.7423 |
| KNN | 0.7409 | 0.7409 | 0.6988 | 0.6988 |
| Stacking Ensemble | 0.7542 | 0.7342 | 0.7120 | 0.7214 |
SVM weighted F1 açısından en büyük global kazancı gösterir: 0.6717'den 0.7423'e, yani 7.06 percentage point artış. Ancak SVM tam KDDTrain+ üzerinde değil, computational feasibility nedeniyle 30,000 örneklik stratified subset üzerinde eğitilmiştir. Bu nedenle SVM sonucu tam veriyle çalışan stacking/resampling deneyleriyle yöntemsel olarak tamamen eşdeğer değildir.
Stacking ensemble'ın accuracy değerinin 0.7542'den 0.7342'ye düşmesine karşın weighted F1'in 0.7120'dan 0.7214'e çıkması, class weighting'in çoğunluk sınıfındaki bazı doğru kararları feda ederek nadir sınıflara daha fazla karar alanı açtığını göstermektedir.
Stacking ensemble sınıf bazında nasıl değişti?
| Sınıf | Baseline Recall | Cost-Sensitive Recall | Değişim |
|---|---|---|---|
| DoS | 79.24% | 80.17% | +0.93% |
| Normal | 97.15% | 91.45% | −5.69% |
| Probe | 63.57% | 62.66% | −0.91% |
| R2L | 4.12% | 5.23% | +1.11% |
| U2R | 0.00% | 35.82% | +35.82% |
U2R'nin görünürlüğü artarken Normal recall 5.69 percentage point düşmektedir. Bu trade-off bir hata değil, class weighting'in karar sınırını bilinçli biçimde değiştirmesinin sonucudur. Güvenlik açısından bunun kabul edilebilir olup olmadığı, kaçırılan privilege-escalation olayının maliyeti ile ek false-positive inceleme maliyetinin karşılaştırılmasına bağlıdır.
Cost-Sensitive Learning Resampling Yöntemlerinden Daha mı İyi?
Hayır; çalışma cost-sensitive learning'in bütün imbalance yöntemlerinden üstün olduğunu göstermemektedir. Aynı 125,973 örneklik KDDTrain+ protokolünde ADASYN en yüksek weighted F1 ve R2L recall değerlerini üretirken cost-sensitive weighting bu karşılaştırmada en yüksek U2R recall değerini ve eğitim dağılımını sentetik veriyle değiştirmeme avantajını sağlamıştır.
| Yöntem | Veri düzeyi değişikliği | Weighted F1 | R2L Recall | U2R Recall | Total Time (s) |
|---|---|---|---|---|---|
| Baseline | Yok | 0.7120 | 0.0412 | 0.0000 | 155.8 |
| Cost-sensitive weights | Sentetik veri yok | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| SMOTE | Sentetik oversampling | 0.7083 | 0.0450 | 0.0597 | 740.9 |
| Borderline-SMOTE | Boundary-focused oversampling | 0.7273 | 0.0551 | 0.0448 | 686.4 |
| ADASYN | Adaptive synthetic oversampling | 0.7478 | 0.0901 | 0.1343 | 680.2 |
| SMOTE-Tomek | Oversampling + Tomek cleaning | 0.7065 | 0.0433 | 0.0597 | 654.0 |
Bu karşılaştırmada ADASYN weighted F1 = 0.7478 ve R2L recall = 0.0901 ile cost-sensitive stacking'i geçmektedir. Buna karşılık cost-sensitive stacking U2R recall = 0.3582 ile bu dört resampling yönteminden daha güçlüdür ve training distribution'ı sentetik örneklerle değiştirmez.
Daha geniş exploratory baseline'lar
| Yöntem | W-F1 | Macro-F1 | Balanced Accuracy | PR-AUC | R2L Recall | U2R Recall | U2R FP |
|---|---|---|---|---|---|---|---|
| Cost-sensitive stacking | 0.7214 | 0.5023 | 0.5507 | 0.5787 | 0.0523 | 0.3582 | 1695 |
| Balanced Random Forest | 0.7268 | 0.5455 | 0.5927 | 0.6469 | 0.2123 | 0.4627 | 427 |
| XGBoost threshold calibration | 0.7466 | 0.5603 | 0.5692 | 0.6900 | 0.1493 | 0.2537 | 188 |
| Focal-loss MLP | 0.7339 | 0.5640 | 0.5981 | 0.6105 | 0.2224 | 0.3134 | 429 |
Bu genişletilmiş karşılaştırma ana iddianın sınırını daha da netleştirir. Cost-sensitive stacking, U2R görünürlüğünü baseline'a göre artırmaktadır; ancak Balanced Random Forest hem U2R recall hem R2L recall açısından daha güçlü ve U2R false-positive sayısı çok daha düşüktür. XGBoost threshold calibration ise en düşük U2R false-positive sayısını 188'e indirirken U2R recall 0.2537'de kalmaktadır. Bu nedenle çalışma “önerilen yapı bütün alternatiflerden daha iyi” sonucunu desteklememektedir.
Repeated-seed istatistiksel testleri
Stokastik değişkenliğin tek bir random seed sonucuna bağlı kalmaması için 10 seed kullanılmıştır: {0, 1, 2, 3, 4, 5, 10, 21, 42, 100}. Baseline ve cost-sensitive stacking için paired karşılaştırmalarda Wilcoxon signed-rank; birden fazla model ailesi için Friedman testi kullanılmıştır. Anlamlılık eşiği p < 0.05'tir.
| Karşılaştırma | Metrik | Test | p-value | Kaynak yorumu |
|---|---|---|---|---|
| Cost-sensitive stacking vs baseline | Weighted F1 | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | U2R recall | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | R2L recall | Wilcoxon | 0.0039 | Significant |
| Tüm cost-sensitive model aileleri | Weighted F1 | Friedman | 0.0018 | Significant |
Buradaki “statistically significant” ifadesi farkın büyüklüğünün operasyonel olarak yeterli olduğu anlamına gelmez. R2L örneği bunu açıkça gösterir: repeated-seed testinde fark istatistiksel olarak anlamlıdır, fakat ana koşuda recall yalnız 4.12%'den 5.23%'e ve TP 119'dan 151'e yükselmiştir. İstatistiksel anlamlılık ile pratik güvenlik etkisi farklı sorulardır.
Component ablation ne gösteriyor?
| Varyant | W-F1 | Macro-F1 | Balanced Accuracy | Macro PR-AUC | R2L Recall | U2R Recall |
|---|---|---|---|---|---|---|
| Baseline stack, class weighting yok | 0.712 | 0.492 | 0.488 | 0.608 | 0.041 | 0.000 |
| CW-only XGBoost | 0.752 | 0.594 | 0.571 | 0.750 | 0.091 | 0.209 |
| Stacking, feature selection yok | 0.763 | 0.577 | 0.642 | 0.694 | 0.175 | 0.522 |
| MI-only XGBoost | 0.743 | 0.595 | 0.570 | 0.720 | 0.086 | 0.284 |
| RFE-only XGBoost | 0.711 | 0.510 | 0.500 | 0.670 | 0.044 | 0.075 |
| Stacking kaldırıldı | 0.715 | 0.509 | 0.501 | 0.674 | 0.037 | 0.060 |
| Tam 25-feature framework | 0.721 | 0.502 | 0.551 | 0.579 | 0.052 | 0.358 |
Ablasyonun en önemli sonucu, U2R visibility artışının ana itici gücünün class weighting olmasıdır. Class weighting kaldırıldığında U2R recall yeniden sıfıra çöker. Bununla birlikte feature reduction bedelsiz değildir: feature selection yapılmayan stacking varyantı weighted F1, balanced accuracy, R2L recall ve U2R recall açısından tam 25-feature framework'ü geçmektedir.
Dolayısıyla hibrit feature selection'ın bilimsel rolü “daha yüksek accuracy üretmek” değil, daha küçük ve daha hesaplama-verimli feature space elde etmek olarak yorumlanmalıdır.
Weighted F1 neden tek başına yeterli değil?
| Ayar | Accuracy | Weighted F1 | Macro-F1 | Balanced Accuracy | Macro FPR | Macro FNR | R2L | U2R |
|---|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.754 | 0.712 | 0.492 | 0.488 | 0.084 | 0.512 | 0.041 | 0.000 |
| Cost-sensitive stacking | 0.734 | 0.721 | 0.502 | 0.551 | 0.080 | 0.449 | 0.052 | 0.358 |
Macro FNR'nin 0.512'den 0.449'a düşmesi nadir sınıf görünürlüğündeki artışla uyumludur, ancak 0.449 hâlâ yüksek bir kaçırma oranıdır. Kaynak bunu production NIDS açısından çözülmüş problem olarak değerlendirmemektedir.
PR-AUC neden ayrıca hesaplandı?
Precision–Recall Area Under the Curve (PR-AUC), özellikle pozitif sınıfın çok nadir olduğu problemlerde modelin farklı karar eşiklerinde precision ve recall arasında nasıl sıralama yaptığını değerlendirmeye yardımcı olur. U2R'nin KDDTest+ içindeki prevalence değeri yalnız 0.0030 olduğu için hard-label recall tek başına olasılık sıralamasının kalitesini açıklamaz.
| Sınıf | Baseline | Cost-Sensitive |
|---|---|---|
| DoS | 0.9448 | 0.9636 |
| Normal | 0.9541 | 0.8066 |
| Probe | 0.8034 | 0.7660 |
| R2L | 0.3280 | 0.3449 |
| U2R | 0.0092 | 0.0126 |
U2R PR-AUC 0.0092'den 0.0126'ya yükselmiştir. Kaynak bunu prevalence baseline'ın yaklaşık 3.1 ve 4.2 katı olarak ifade eder. Buna rağmen 0.0126 mutlak olarak çok düşük bir ranking-quality düzeyidir; yazarlar da U2R'yi çalışmanın merkezi zorluklarından biri olarak bırakmaktadır.
U2R threshold değiştirildiğinde ne oluyor?
| Threshold τ | U2R TP / 67 | U2R Recall | U2R FP | Precision |
|---|---|---|---|---|
| 0.05 | 59 | 0.881 | 6608 | 0.0088 |
| 0.10 | 45 | 0.672 | 3796 | 0.0117 |
| 0.30 | 24 | 0.358 | 2180 | 0.0109 |
| 0.50 | 14 | 0.209 | 1666 | 0.0083 |
| 0.70 | 11 | 0.164 | 1312 | 0.0083 |
| 0.90 | 11 | 0.164 | 953 | 0.0114 |
Eşik düşürüldüğünde daha fazla U2R yakalanır, fakat false-positive sayısı binler seviyesine çıkar. Eşik yükseltildiğinde alarm yükü azalır, fakat recall da düşer. U2R precision bütün gösterilen operating point'lerde yaklaşık %1 civarındadır.
Table 14'teki hard-label cost-sensitive U2R sonucu 24 TP ve 1695 FP iken threshold table'daki \(\tau=0.30\) sonucu aynı 24 TP için 2180 FP'dir. Bu iki sayı çelişki değildir: hard-label model normal multi-class kararını kullanırken threshold experiment, U2R olasılığı belirlenen \(\tau\) değerini aşınca sınıfı zorla U2R olarak atayan farklı bir operating rule kullanır.
Alert-budget analizi
| Analist alarm bütçesi | Yakalanan gerçek U2R / 67 |
|---|---|
| Top 100 alarm | 4 |
| Top 500 alarm | 6 |
| Top 1000 alarm | 11 |
Bu sonuç modelin U2R skorunun analyst prioritization açısından bir miktar bilgi taşıdığını, fakat tek başına yüksek güvenli otomatik karar için yeterli precision sağlamadığını gösterir.
UNSW-NB15 Dış Doğrulaması Ne Gösteriyor?
UNSW-NB15 dış doğrulaması, dataset'e özgü tuning yapılmadan aynı preprocessing, MI→RFE, stacking ve balanced class-weighting mantığının dört nadir saldırı kategorisinin recall'ını güçlü biçimde yükseltebildiğini; ancak bunun Normal recall ve weighted F1 kaybı pahasına gerçekleştiğini gösterir, dolayısıyla dış doğrulama nadir-sınıf trade-off'unun taşındığını destekler fakat üretim ağlarında genel üstünlüğü kanıtlamaz.
Dış veri seti protokolü
UNSW-NB15'in resmî training partition'ı 175,341, testing partition'ı 82,332 kayıttır ve standart on sınıflı taxonomy kullanılmıştır. Kullanılan public mirror'da record identifier ile sttl, dttl ve altı ct_* connection-counter özelliği çıkarılmış; kalan 31 numeric ve üç categorical özellik aynı pipeline ile işlenmiştir.
proto, service ve state one-hot encode edilmiş; Min-Max scaler yalnız training partition'a fit edilmiş; MI ile 50 özellik tutulmuş; RFE ile 25'e düşürülmüş ve aynı stacking architecture balanced class weights ile kullanılmıştır. Kaynak özellikle UNSW-specific tuning yapılmadığını belirtmektedir.
| Konfigürasyon | Weighted F1 | Macro-F1 | Balanced Accuracy | Analysis Recall | Backdoor Recall | Shellcode Recall | Worms Recall |
|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.8096 | 0.5007 | 0.4856 | 0.0000 | 0.0583 | 0.5291 | 0.1818 |
| Cost-sensitive stacking | 0.7509 | 0.4780 | 0.6696 | 0.2496 | 0.6930 | 0.9550 | 0.8864 |
| Cost-sensitive XGBoost | 0.7488 | 0.5137 | 0.6392 | 0.1300 | 0.5798 | 0.9233 | 0.7273 |
Cost-sensitive stacking ile Worms 18.18%'den 88.64%'e çıkar ve 44 Worms örneğinin 39'u doğru belirlenir. Shellcode 52.91%'den 95.50%'ye, Backdoor 5.83%'ten 69.30%'a, Analysis ise 0.00%'dan 24.96%'ya yükselir.
Bunun karşılığında Normal recall 91.74%'ten 64.22%'ye ve weighted F1 0.8096'dan 0.7509'a düşer. Balanced accuracy 0.4856'dan 0.6696'ya yükselir. Bu tam olarak çalışmanın ana güvenlik trade-off'unun başka veri setindeki karşılığıdır: majority-class toplam başarısı düşerken az temsil edilen saldırılar daha görünür hale gelir.
Cost-sensitive modelin class-level PR-AUC değeri Worms için 0.5903, Shellcode için 0.3939 olarak raporlanmıştır. Bunlar NSL-KDD U2R PR-AUC = 0.0126 değerinden çok daha güçlü rare-class ranking davranışı göstermektedir.
Çalışmanın desteklediği sonuçlar
- Balanced class weighting, özgün training observations değiştirilmeden bazı nadir saldırı sınıflarının recall değerini artırabilmiştir.
- NSL-KDD ana deneyinde stacking U2R recall 0.00%'dan 35.82%'ye çıkmıştır.
- Weighted F1, U2R recall ve R2L recall artışları repeated-seed paired Wilcoxon testlerinde
p < 0.05düzeyinde anlamlıdır. - R2L sonucu istatistiksel olarak değişse de mutlak operasyonel iyileşme sınırlıdır.
- Class weighting U2R visibility'nin ana itici bileşenidir.
- 25-feature MI–RFE yapı kompaktlık sağlar fakat maksimum tahmin performansını vermez.
- ADASYN bazı global ve R2L metriklerinde cost-sensitive stacking'i geçmektedir.
- Balanced Random Forest genişletilmiş karşılaştırmada U2R ve R2L recall bakımından cost-sensitive stacking'den daha güçlüdür.
- UNSW-NB15 dış doğrulaması nadir sınıf recall artışının başka benchmark'ta da ortaya çıktığını göstermektedir.
- Nadir sınıf recall artışı majority-class recall, weighted F1 veya false-positive yükünde bedel oluşturabilir.
Çalışmanın desteklemediği sonuçlar
- Framework bütün nadir saldırıları güvenilir biçimde çözen genel bir NIDS değildir.
- R2L problemi çözülmemiştir.
- U2R için 35.82% recall, yüksek-precision otonom saldırı tespiti anlamına gelmez.
- 25 özellikli feature set'in bütün veri setlerinde veya bütün saldırı tiplerinde optimum olduğu gösterilmemiştir.
- Cost-sensitive learning'in SMOTE, ADASYN, Balanced Random Forest, focal loss veya threshold calibration'dan evrensel olarak üstün olduğu gösterilmemiştir.
- NSL-KDD ve UNSW-NB15 sonuçları modern encrypted, cloud-native ve IoT üretim trafiğinin tamamını temsil etmez.
- Canlı bir SOC veya production packet/flow collector üzerinde end-to-end deployment doğrulaması yapılmamıştır.
- Explainability için SHAP veya counterfactual analysis mevcut framework'e uygulanmamıştır.
- CICIDS2017/2018 ve TON_IoT üzerinde bu çalışmada tamamlanmış validation bulunmamaktadır.
- İstatistiksel anlamlılık tek başına operasyonel usefulness veya uygun alert budget garantisi değildir.
Sınırlılıklar
Benchmark yaşı: NSL-KDD kontrollü karşılaştırma için yararlıdır ancak güncel encrypted traffic, cloud workloads, IoT protocols ve modern saldırı kampanyalarını bütünüyle temsil etmez.
R2L overlap: R2L ile Normal arasındaki feature-space benzerliği class weighting ile çözülememiştir.
SVM eğitim kısıtı: SVM yalnız 30,000 stratified training örneğinde çalıştırılmıştır; tam KDDTrain+ ile çalışan modellerle karşılaştırılmasında bu sınır dikkate alınmalıdır.
False-positive yükü: U2R görünürlüğü artarken precision çok düşük kalabilmektedir. Üretim ortamında threshold calibration ve analyst capacity kritik hale gelir.
Explainability: SHAP veya counterfactual analysis gibi açıklanabilirlik katmanı eklenmemiştir.
External validity: UNSW-NB15 dış doğrulaması tek-veri-seti sorununu azaltmıştır fakat tamamen ortadan kaldırmamaktadır.
Canlı deployment: End-to-end live flow collector, SOC entegrasyonu ve production network davranışı test edilmemiştir.
Kaynak-içi latency ifadesi: Yöntem bölümünde sınırlı inference-latency ölçümü bulunmasına rağmen sınırlılıklar bölümünde inference latency'nin henüz değerlendirilmediğini söyleyen ifade kalmıştır.
Gelecek çalışma yönleri
Kaynak gelecekte CICIDS2017, CSE-CIC-IDS2018 ve TON_IoT üzerinde aynı ablation ve confidence-interval protokolünün uygulanmasını; adaptive cost schedule, probability calibration, held-out validation ile threshold calibration, SHAP tabanlı interpretability, focal-loss modellerinin controlled false-positive budget altında karşılaştırılmasını ve Balanced Random Forest/EasyEnsemble gibi yöntemlerin değerlendirilmesini önermektedir.
Ayrıca CICFlowMeter veya Zeek gibi flow collector'larla real-time deployment doğrulaması önerilmektedir. Bunlar mevcut çalışmanın tamamlanmış sonuçları değil, gelecek araştırma önerileridir.
Kaynak ve Yöntem Notu
Özgün başlık: Cost-Sensitive Stacking Ensemble with Hybrid Feature Selection for Rare Attack Detection in Network Intrusion Detection Systems
Yazarlar ve sıra: Ioan Corneliu Salisteanu; Iulian Udroiu; Andrei Cosmin Gheorghe; Ionut Adrian Tudoroiu; Emil Mihai Diaconu.
Corresponding author: Andrei Cosmin Gheorghe.
Corresponding e-posta: andrei.gheorghe@valahia.ro
Kurum: Faculty of Electrical Engineering, Electronics and Information Technology, University “Valahia” of Targoviste, 130004 Targoviste, Romania.
Eşit katkı / eş birinci yazarlık: Kaynakta eşit katkı beyanı bulunmamaktadır.
Academic Editor: Emre Tokgoz.
Dergi: Electronics.
Yayınevi: MDPI, Basel, Switzerland.
ISSN: 2079-9292.
Cilt / sayı: Volume 15, Issue 14.
Makale numarası: 3094.
Yayın yılı: 2026.
Makale türü: Article; kontrollü benchmark tabanlı deneysel makine öğrenmesi/NIDS değerlendirme çalışması.
DOI: 10.3390/electronics15143094.
Resmî bağlantı: https://doi.org/10.3390/electronics15143094
Received: 2 Haziran 2026.
Revised: 10 Temmuz 2026.
Accepted: 13 Temmuz 2026.
Published: 14 Temmuz 2026.
Hakemlik durumu: Electronics, MDPI'nin resmî kaydında international, peer-reviewed ve open-access journal olarak tanımlanmaktadır.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint durumu: İncelenen kaynak yayımlanmış dergi makalesidir; PDF ayrı bir preprint kimliği belirtmemektedir.
Ana araştırma problemi: Genel accuracy'nin ciddi class imbalance altında rare/high-impact attack başarısızlığını gizleyebilmesi.
Yöntemsel katkı sınırı: MI, RFE, stacking veya balanced class weighting bileşenleri ayrı ayrı yeni algoritmalar değildir. Çalışmanın katkısı bunların rare-class-focused, statistically audited ve data-preserving bir değerlendirme protokolünde kontrollü entegrasyonudur.
Ana veri seti: NSL-KDD; KDDTrain+ = 125,973 kayıt, KDDTest+ = 22,544 kayıt.
External validation: UNSW-NB15; official train = 175,341, test = 82,332 kayıt; dataset-specific tuning yapılmamıştır.
NSL-KDD sınıfları: Normal, DoS, Probe, R2L ve U2R.
Preprocessing: protocol_type, service ve flag için one-hot encoding; 41 özgün attribute → 122 sayısal feature; training-fit Min-Max scaling [0,1]; difficulty_level çıkarılmıştır.
Feature selection: MI ile 122 → 50, Random Forest tabanlı RFE ile 50 → 25.
Feature-selection yorum sınırı: 25-feature yapı en yüksek performans noktası değildir; 50-feature ve bazı no-feature-selection varyantları daha yüksek tahmin metrikleri üretmiştir.
Bireysel modeller: Random Forest, XGBoost, SVM ve KNN.
Stacking: Random Forest + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold out-of-fold prediction.
SVM sınırı: 30,000 stratified training örneği; diğer full-training ek deneylerle doğrudan eşdeğer değildir.
Cost-sensitive formül: \(w_c=N/(C n_c)\).
Approximate class weights: Normal 0.37; DoS 0.55; Probe 2.16; R2L 25.32; U2R 484.49.
Resampling ana framework'te kullanıldı mı? Hayır. Ana cost-sensitive framework original training observations'ı korur. SMOTE, Borderline-SMOTE, ADASYN ve SMOTE-Tomek ayrı experimental baseline'lardır.
Random seeds: 0, 1, 2, 3, 4, 5, 10, 21, 42, 100.
Statistical tests: Wilcoxon signed-rank ve Friedman; significance threshold p < 0.05.
Ana U2R sonucu: 0/67 → 24/67; recall 0.00% → 35.82%; Wilson %95 GA 25.40%–47.78% cost-sensitive durumda.
Ana R2L sonucu: 119/2887 → 151/2887; recall 4.12% → 5.23%.
Ana weighted-F1 sonucu: Stacking 0.7120 → 0.7214.
Ana accuracy trade-off: Stacking 0.7542 → 0.7342.
U2R hard-label precision: Cost-sensitive stacking 24 TP, 1695 FP, precision 0.0140.
U2R probability-level result: PR-AUC 0.0092 → 0.0126; prevalence 0.0030.
Repeated-seed p-values: Weighted F1 p = 0.0020; U2R recall p = 0.0020; R2L recall p = 0.0039; Friedman weighted-F1 comparison p = 0.0018.
25-feature sensitivity: Weighted F1 = 0.7214; R2L = 0.0523; U2R = 0.3582; training time = 150.8 s.
50-feature sensitivity: Weighted F1 = 0.7668; R2L = 0.1888; U2R = 0.5075; training time = 160.5 s.
122-feature sensitivity: Weighted F1 = 0.7625; R2L = 0.1753; U2R = 0.5224; training time = 243.5 s.
Software: Python 3.13.5; scikit-learn 1.8.0; XGBoost 3.1.3; imbalanced-learn 0.14.1; NumPy 2.3.5; pandas 2.2.3.
Donanım/ortam: Linux x86_64, CPU-only, 56 logical CPU core available to container, yaklaşık 4.3 GB RAM; GPU kullanılmamıştır.
İlk 1000 KDDTest+ inference latency: Random Forest 0.2609 ms/sample; XGBoost 0.1081 ms/sample; KNN 1.6117 ms/sample; Stacking 2.0925 ms/sample. Kaynak bunları hardware-dependent relative computational values olarak sınırlamaktadır.
Kaynak-içi latency notu: Section 3.6 inference latency değerleri vermesine rağmen Section 5.3 inference latency'nin henüz dahil edilmediğini söylemektedir. İki ifade kaynakta birlikte bulunduğu için bu fark korunmuştur.
External-validation trade-off: UNSW-NB15'te cost-sensitive stacking balanced accuracy 0.4856 → 0.6696 yükselirken weighted F1 0.8096 → 0.7509 ve Normal recall 91.74% → 64.22% düşmüştür.
UNSW rare-class recall: Analysis 0.00% → 24.96%; Backdoor 5.83% → 69.30%; Shellcode 52.91% → 95.50%; Worms 18.18% → 88.64%.
Finansman: Araştırma dış finansman almamıştır.
Data Availability: NSL-KDD kamuya açık benchmark'tır. Kaynak ayrıca preprocessing, MI–RFE feature selection, training, imbalance baselines, statistical tests ve figure generation için Python script'lerini içeren supplementary reproducibility package bulunduğunu belirtmektedir. Ticari veya özel production network trace kullanılmamıştır.
Yazar katkıları: Conceptualization — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe, Ioan Corneliu Salisteanu ve Iulian Udroiu; methodology — Ioan Corneliu Salisteanu, Andrei Cosmin Gheorghe ve Iulian Udroiu; software — Ionut Adrian Tudoroiu ve Andrei Cosmin Gheorghe; validation — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe ve Emil Mihai Diaconu; formal analysis — Andrei Cosmin Gheorghe; investigation — Emil Mihai Diaconu; resources ve data curation — Ionut Adrian Tudoroiu; original draft — Ionut Adrian Tudoroiu; review/editing — Andrei Cosmin Gheorghe; visualization — Ioan Corneliu Salisteanu ve Iulian Udroiu; supervision — Ioan Corneliu Salisteanu, Iulian Udroiu ve Andrei Cosmin Gheorghe.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Temel yöntemsel sınır: Sonuçlar kontrollü NSL-KDD ve UNSW-NB15 benchmark analizidir; gerçek SOC, production network veya canlı flow collector üzerinde end-to-end doğrulama değildir.
Gelecek doğrulama: CICIDS2017, CSE-CIC-IDS2018, TON_IoT, threshold/probability calibration, SHAP, controlled false-positive budgets, Balanced Random Forest/EasyEnsemble ve live CICFlowMeter/Zeek entegrasyonu.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir