


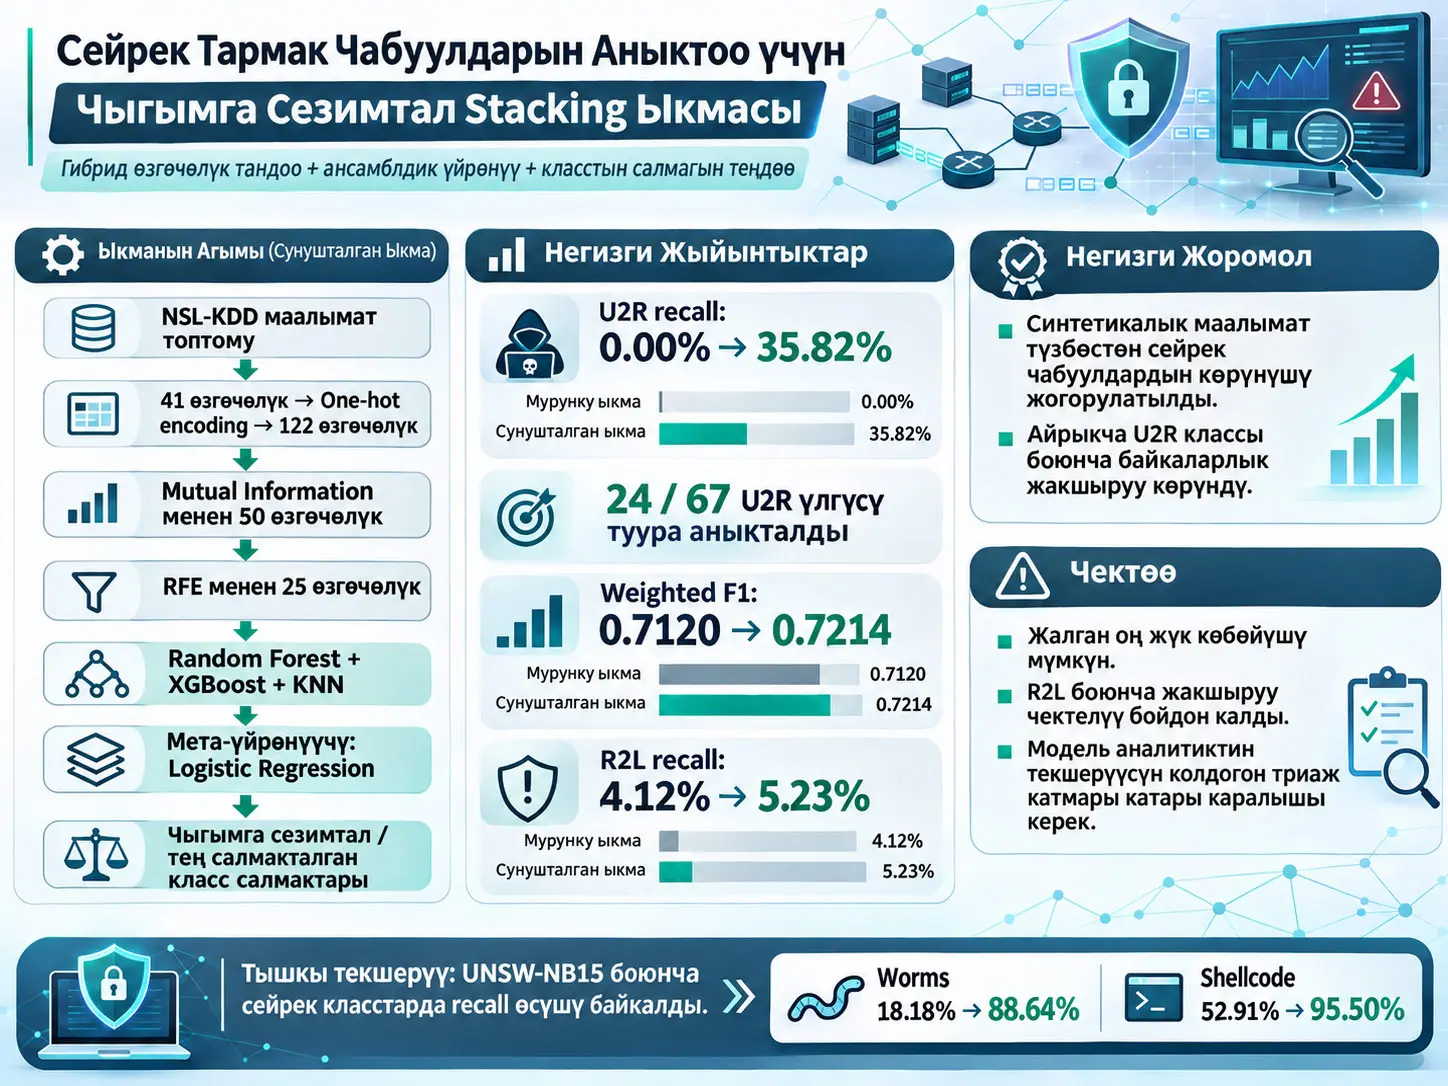
Чыгымга сезимтал MI–RFE–stacking алкагы тең салмаксыз көп класстуу тармактык чабуулдарды аныктоодо сейрек чабуулдардын көрүнүктүүлүгүн жогорулатуу үчүн Mutual Information (MI) жана Recursive Feature Elimination (RFE) аркылуу өзгөчөлүк тандоону, гетерогендүү stacking ensemble'ды жана класска байланыштуу ката чыгымдарын бириктирген маалыматты сактоочу Network Intrusion Detection System (NIDS) баалоо конвейери болуп саналат. Изилдөө жаңы классификатор сунуштабайт; Random Forest, XGBoost, Support Vector Machine (SVM), K-Nearest Neighbors (KNN), Logistic Regression, MI, RFE жана balanced class weighting сыяктуу калыптанган компоненттердин сейрек класстарга багытталган көзөмөлдөнгөн жана кайра өндүрүлө турган протоколдо кандай иштей турганын изилдейт.
Негизги баалоо NSL-KDD benchmark'ында жүргүзүлгөн. KDDTrain+ 125,973, ал эми KDDTest+ 22,544 тармактык байланыш жазуусун камтыйт. Категориялык protocol_type, service жана flag өзгөрмөлөрүн one-hot encoding кылгандан кийин 41 баштапкы өзгөчөлүк 122 сандык өзгөчөлүккө кеңейтилген; Min-Max масштабдоо бир гана окутуу топтомуна ылайыкталган; андан кийин MI боюнча эң жогорку упай алган 50 өзгөчөлүк калтырылып, Random Forest негизиндеги RFE менен саны 25-ке чейин кыскартылган.
Негизги stacking ensemble Random Forest, XGBoost жана KNN'ди base learner, ал эми Logistic Regression'ды meta-learner катары колдонот. Meta-learner үчүн 3-fold out-of-fold божомолдор түзүлөт. Класстардын тең салмаксыздыгы синтетикалык маалымат түзбөстөн, w_c = N/(C n_c) түрүндөгү balanced class weighting менен чечилген. NSL-KDD бөлүштүрүлүшүндө болжолдуу класс салмактары Normal үчүн 0.37, DoS үчүн 0.55, Probe үчүн 2.16, R2L үчүн 25.32 жана U2R үчүн 484.49.
Stacking ensemble'дын негизги бир жолку жыйынтыгында U2R recall 0.00%'дан 35.82%'га жогорулаган; башкача айтканда baseline модель 67 U2R үлгүсүнүн бирин да туура аныктай албаса, cost-sensitive түзүм алардын 24-үн туура аныктаган. Weighted F1 0.7120'дан 0.7214-кө жогорулаган, бирок accuracy 0.7542-ден 0.7342-ге төмөндөгөн. R2L recall болсо болгону 4.12%'дан 5.23%'га, башкача айтканда 119/2887 туура аныктоодон 151/2887-ге чейин өскөн.
U2R жыйынтыгы күчтүү чечмелөө чегин талап кылат. Cost-sensitive hard-label stacking жыйынтыгында U2R үчүн 24 true positive'ге каршы 1695 false positive билдирилгендиктен precision болгону 0.0140. Өзүнчө probability-threshold талдоосунда да U2R precision болжол менен %1 деңгээлинде калган. Ошондуктан моделдин U2R чыгышы изилдөөнүн өз талкуусуна ылайык автономдуу акыркы чечим эмес, коопсуздук аналитигинин кароосун артыкчылыктуу кылган triage сигналы болуп саналат.
Изилдөө ошондой эле cost-sensitive ыкма бардык альтернативалардан жогору эмес экенин көрсөтөт. Full-training resampling салыштыруусунда ADASYN weighted F1 жана R2L recall боюнча күчтүүрөөк; кийинки exploratory baselines ичинде Balanced Random Forest жогорураак U2R recall жана азыраак U2R false-positive санын камсыз кылган. Сунушталган ыкманын айырмалоочу артыкчылыгы — синтетикалык азчылык үлгүлөрүн түзбөстөн баштапкы окутуу байкоолорун сакташы жана сейрек чабуулдардын жүрүм-турумун ачык көзөмөлдөшү.
UNSW-NB15 тышкы текшерүүсүндө да сейрек класстардын recall көрсөткүчтөрү кыйла жогорулаган; бирок Normal recall жана weighted F1 төмөндөгөн. Бул жыйынтыктар ыкма сейрек класстарга көбүрөөк салмак бергенде чечим чек араларын чындап өзгөртөрүн колдойт, бирок заманбап өндүрүш тармактарында жалпы артыкчылык же автоматтык deployment ийгилиги дегенди билдирбейт.
Cost-Sensitive Окутуу Бул Изилдөөдө Эмне Үчүн Колдонулат?
Cost-sensitive окутуу тең салмаксыз маалымат топтомунда бардык классификация каталарын бирдей кабыл алуунун ордуна сейрек класстардагы каталарга жогору окутуу жазасын берип, чечим чек арасын азчылык класстарына сезимталыраак кылат; бул изилдөөдө негизги максат, өзгөчө U2R жана R2L чабуулдарынын көпчүлүк класстар арасында жоголушун азайтуу менен бирге баштапкы окутуу жазууларын синтетикалык үлгүлөр менен алмаштырбоо.
Сейрек чабуулдар эмне үчүн жалпы accuracy ичинде жоголуп кетиши мүмкүн?
NSL-KDD беш негизги классты колдонот: Normal, Denial of Service (DoS), Probe, Remote-to-Local (R2L) жана User-to-Root (U2R). Окутуу топтомунда Normal жана DoS чогуу жазуулардын болжол менен %90-ын түзөт, ал эми U2R болгону 52 окутуу үлгүсүнөн турат; бул болжол менен %0.04 үлүш. Мындай бөлүштүрүүдө модель көпчүлүк класстарды жакшы үйрөнүп, сейрек классты дээрлик толугу менен көз жаздымда калтырса да салыштырмалуу жогорку глобалдык accuracy ала алат.
DoS максаттуу кызматтын же ресурстун жеткиликтүүлүгүн бузууга багытталган чабуул классы. Probe тармак же система жөнүндө маалымат чогултуу жана жеткиликтүү максаттарды изилдөө жүрүм-турумун камтыйт. R2L алыстан жергиликтүү системага уруксатсыз кирүү алуу менен байланышкан класс. U2R болсо колдонуучунун жогору же администратор/root деңгээлиндеги артыкчылыкка ээ болушу менен байланышкан, өтө сейрек, бирок коопсуздук үчүн маанилүү класс.
Булактын Figure 4 бөлүгүндө 5000 KDDTest+ үлгүсү t-SNE аркылуу эки өлчөмдө визуалдаштырылган. Сүрөттө DoS жана Normal үлгүлөрү айрым көбүрөөк айырмаланган аймактарды түзсө, R2L жана U2R үлгүлөрү Normal трафик менен күчтүү дал келгени көрсөтүлөт. t-SNE бул жерде классификатор эмес; жогорку өлчөмдүү feature space'ти визуалдык кароо үчүн эки өлчөмгө түшүрүүчү ыкма. Сүрөттүн негизги билдирүүсү — сейрек чабуул көйгөйү класстын саны менен эле эмес, feature-space overlap менен да байланыштуу.
Balanced class weight формуласы
Булакта колдонулган негизги чыгым салмагы:
\[ w_c=\frac{N}{C\,n_c} \]
Формула эмнени эсептейт? Ар бир класс үчүн окутуу маалында колдонулуучу салыштырмалуу ката салмагын эсептейт.
\(w_c\): \(c\) классынын өлчөмсүз салмагы.
\(N\): Жалпы окутуу үлгүлөрүнүн саны; NSL-KDD негизги окутуу топтомунда 125,973.
\(C\): Класстардын саны; бул изилдөөдө 5.
\(n_c\): Тиешелүү класска таандык окутуу үлгүлөрүнүн саны.
Класстагы үлгүлөрдүн саны азайган сайын бөлгүчтөгү \(n_c\) кичирейип, \(w_c\) чоңоёт. Ошентип U2R сыяктуу өтө сейрек класстагы туура эмес классификация окутуу максаты үчүн Normal класстагы катага караганда кыйла жогорку жаза алат.
| Класс | Болжолдуу салмак | Алгоритмдик мааниси |
|---|---|---|
| Normal | 0.37 | Өтө көп кездешүүчү класс; ката жазасы салыштырмалуу төмөн. |
| DoS | 0.55 | Жогорку жыштыктагы чабуул классы. |
| Probe | 2.16 | Орточо жыштыктагы класс. |
| R2L | 25.32 | Сейрек класс; туура эмес классификация катуураак жазаланат. |
| U2R | 484.49 | Эң сейрек класс; туура эмес классификация абдан жогорку салыштырмалуу жаза алат. |
Random Forest, SVM жана Logistic Regression үчүн class_weight = balanced колдонулган. XGBoost'та ошол эле класс-жыштык формуласына негизделген үлгү салмактары колдонулган. Колдонулган стандарттуу KNN формулировкасында ошол эле class-weight механизми жок болгондуктан KNN жыйынтыгы cost-sensitive баскычында өзгөрбөйт.
Эмне үчүн түздөн-түз SMOTE колдонулган эмес?
Авторлордун маалыматты сактоочу тандоосунун негизги себеби U2R болгону 52 реалдуу окутуу үлгүсүнө ээ болушу. Өтө кичине реалдуу үлгүдөн көп сандагы синтетикалык байкоолор алынганда сандык жактан пайдалуу, бирок реалдуу чабуул жүрүм-турумун жетиштүү көрсөтпөгөн жасалма чечим аймактары пайда болушу мүмкүн деген тынчсыздануу бар. Ошондуктан негизги framework окутуу маалыматтарын көбөйтүүнүн ордуна loss/чечим чыгымын өзгөртөт.
Бирок изилдөө бул жүйөнү жөн гана божомол катары калтырган эмес жана SMOTE, Borderline-SMOTE, ADASYN жана SMOTE-Tomek'ти ошол эле full-training протоколунда түздөн-түз baseline катары сынаган. Жыйынтыктар cost-sensitive ыкма resampling'ден универсалдуу түрдө жогору эмес экенин көрсөтөт.
Mutual Information эмне үчүн биринчи өзгөчөлүк тандоо баскычында колдонулат?
Mutual Information (MI) feature менен максаттуу класс ортосундагы статистикалык көз карандылыкты баалоочу filter тибиндеги feature-selection ыкмасы. Классификаторду кайра-кайра үйрөтпөстөн ар бир feature үчүн максаттуу label менен маалыматтык байланыш эсептелгендиктен, алгачкы тандоо баскычында салыштырмалуу төмөн эсептөө чыгымын берет.
Изилдөөдө one-hot encoding'ден кийинки 122 өзгөчөлүк үчүн MI эсептелип, эң жогорку MI упайы бар 50 өзгөчөлүк калтырылган. Бул баскыч feature space'ти алгач тез filter механизми менен кыскартат.
Recursive Feature Elimination эмне кылат?
Recursive Feature Elimination (RFE) моделдин feature-importance маалыматын колдонуп, эң аз пайдалуу деп эсептелген өзгөчөлүктөрдү итеративдүү алып салуучу wrapper тибиндеги тандоо ыкмасы. Бул изилдөөдө 50 MI өзгөчөлүгү Random Forest estimator менен бааланып, эң аз маанилүү өзгөчөлүктөр алынып, 25 өзгөчөлүк калтырылган.
MI менен RFE'ни чогуу колдонуунун логикасы — MI'нин тез, моделден көз каранды эмес алгачкы фильтрациясын RFE'нин моделге сезимтал экинчи тандоосу менен бириктирүү. Булактын Figure 3 бөлүгүндө эки тандоо механизми 22 өзгөчөлүк боюнча дал келгендиги, үч өзгөчөлүк MI тарапта гана жана үч өзгөчөлүк RFE тарапта гана болгону көрсөтүлөт.
Акыркы 25 өзгөчөлүк
Изилдөөдө колдонулган 25 өзгөчөлүк төмөнкүлөр: src_bytes, diff_srv_rate, same_srv_rate, dst_host_diff_srv_rate, dst_host_srv_count, count, dst_host_same_srv_rate, dst_host_serror_rate, serror_rate, flag_SF, dst_host_srv_serror_rate, flag_S0, srv_serror_rate, logged_in, dst_host_srv_diff_host_rate, dst_host_same_src_port_rate, dst_host_count, srv_count, service_private, dst_host_rerror_rate, dst_host_srv_rerror_rate, rerror_rate, service_eco_i, protocol_type_icmp жана service_ecr_i.
Авторлор бул 25 өзгөчөлүк бардык NIDS көйгөйлөрү үчүн универсалдуу оптималдуу деп ырасташпайт. Бул тизме көзөмөлдөнгөн NSL-KDD MI→RFE pipeline'ынын гана натыйжасы.
Классификатордун гиперпараметрлери
| Модель | Булактагы жөндөө | Маанилүү методдук эскертүү |
|---|---|---|
| Random Forest | 200 дарак; maximum depth = 20; internal split үчүн минимум 5 үлгү | MI'ден кийин RFE estimator катары да колдонулган. |
| XGBoost | 200 дарак; maximum depth = 8; learning rate = 0.1; сап жана мамыча subsampling = 0.8 | Cost-sensitive шартта per-instance weight колдонулган. |
| SVM | RBF kernel; C = 10; gamma = scale | Эсептөө чыгымы себептүү 30,000 үлгүлүк stratified окутуу ички топтому колдонулган. |
| KNN | k = 5; inverse-distance weighting | Стандарттуу колдонууда class weight колдонулбагандыктан cost-sensitive жыйынтык өзгөрбөйт. |
| Stacking | RF + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold OOF | Meta-learner leakage'ин азайтуу үчүн out-of-fold predictions менен окутулат. |
Булак stacking ичиндеги base моделдер үчүн эсептөө натыйжалуулугу максатында “reduced hyperparameters” колдонулганын билдирет, бирок бул кыскартылган stacking-ичиндеги гиперпараметрлердин бардык сандык маанилерин ошол эле жерде ачык тизмелебейт. Ошондуктан жогорудагы жеке моделдин жөндөөлөрү stacking ичиндеги base моделдерде так эле ошондой деп болжолдонбошу керек.
Окутуу жана тест протоколу
Бардык негизги моделдер KDDTrain+ үстүндө окутулуп, көз карандысыз KDDTest+ үстүндө бааланган. KDDTest+ кайра бөлүнгөн эмес, resample кылынган эмес жана cross-validation окутуусуна кошулган эмес. Бул бөлүү тест топтомуна маалымат агып кетишин алдын алуу жана баштапкы NSL-KDD train-test distribution shift'ин сактоо үчүн маанилүү.
Кошумча repeated-seed, resampling, feature-sensitivity жана ablation эксперименттери толук 125,973 жазуулук KDDTrain+ менен жүргүзүлгөн. SVM 30,000 үлгүлүк окутуу чектөөсүнөн улам бул кошумча салыштыруулардан чыгарылган.
Программа жана жабдуу
| Компонент | Версия / чөйрө |
|---|---|
| Python | 3.13.5 |
| scikit-learn | 1.8.0 |
| XGBoost | 3.1.3 |
| imbalanced-learn | 0.14.1 |
| NumPy | 2.3.5 |
| pandas | 2.2.3 |
| Иштөө чөйрөсү | Linux x86_64, CPU-only |
| CPU | Container'га жеткиликтүү 56 logical CPU core |
| RAM | Болжол менен 4.3 GB |
| GPU | Колдонулган эмес |
Алгачкы 1000 KDDTest+ үлгүсүндө inference latency өзүнчө өлчөнгөн: Random Forest 0.2609 ms/sample, XGBoost 0.1081 ms/sample, KNN 1.6117 ms/sample жана Stacking Ensemble 2.0925 ms/sample. Авторлор бул убакыттар жабдууга көз каранды экенин жана салыштырмалуу computational behavior'ду сүрөттөө үчүн гана билдирилгенин белгилешет.
Булак ичиндеги inference-latency дал келбестиги
Метод бөлүмүндө жогорудагы inference latency маанилери ачык берилгенине карабастан, Section 5.3 чектөөлөр бөлүмүндө изилдөө али “runtime memory usage, inference latency же end-to-end integration” камтыбай турганы жазылган. Эки билдирүү бир эле жарыяланган булакта чогуу тургандыктан Verianla алардын бирин үнсүз алып салбайт. Эң коопсуз түшүндүрмө — алгачкы 1000 тест үлгүсүндө чектелген deployment-oriented latency өлчөөсү бар, бирок толук өндүрүш pipeline'ы үчүн runtime/memory/end-to-end иштөө баалоосу жүргүзүлгөн эмес. Бул акыркы сүйлөм булактагы эки билдирүүнү чогуу чечмелөө болуп саналат, жаңы эксперименттик жыйынтык эмес.
Баалоо метрикаларын кантип окуу керек?
Булак метрикалардын аттарын колдонот, бирок негизги precision/recall/F1 формулаларын кайра чыгарбайт. Төмөнкү формулалар изилдөөнүн жаңы жыйынтыгы эмес, билдирилген метрикалардын үйрөтүүчү стандарттуу аныктамалары.
\[ Recall=\frac{TP}{TP+FN} \]
Recall чындыгында тиешелүү класска таандык үлгүлөрдүн канчасы туура кармалганын өлчөйт. U2R сыяктуу жогорку таасирдүү сейрек чабуулда төмөн recall көп сандагы чабуул false negative болуп өтүп кеткенин билдирет.
\[ Precision=\frac{TP}{TP+FP} \]
Precision моделдин тиешелүү класс деп чыгарган эскертүүлөрүнүн канчасы чындап ошол класска таандык экенин өлчөйт. U2R recall өсүп, precision өтө төмөн бойдон калса analyst alert burden олуттуу өсүшү мүмкүн.
\[ F1=2\frac{Precision\cdot Recall}{Precision+Recall} \]
F1 precision менен recall'ду гармоникалык орточо аркылуу бириктирет. Бир компонент өтө төмөн болсо, F1 да чектелет.
\[ MacroF1=\frac{1}{C}\sum_{c=1}^{C}F1_c \]
Macro-F1 бардык класстарга бирдей салмак берет. Ошондуктан сейрек класстардагы начар көрсөткүчтөрдү majority-class ийгилигинин артында жашырууга weighted F1-ге караганда азыраак жакын.
\[ WeightedF1=\sum_{c=1}^{C}\frac{n_c}{N}F1_c \]
Weighted F1 ар бир класстын F1 маанисин класстын колдоосу менен салмактайт. Normal жана DoS сыяктуу чоң класстар жыйынтыкка көбүрөөк таасир эткендиктен сейрек класс көйгөйүн жалгыз өзү түшүндүрүү үчүн жетишсиз.
Ошондуктан изилдөө weighted F1-ден тышкары macro-F1, balanced accuracy, macro PR-AUC, macro false-positive rate, macro false-negative rate, класска негизделген recall, абсолюттук TP/FP сандары жана Wilson 95% confidence interval колдонот.
U2R Recall'дун 0.00%'дан 35.82%'га Жогорулашы Эмнени Билдирет?
U2R recall'дун 0.00%'дан 35.82%'га жогорулашы негизги stacking экспериментинде 67 чыныгы U2R тест үлгүсүнүн baseline модель тарабынан бирөө да кармалбай, cost-sensitive модель тарабынан 24-ү туура аныкталганын билдирет; бирок ошол эле түзүм көп сандагы U2R false positive чыгаргандыктан жыйынтыкты “U2R көйгөйү чечилди” деп түшүндүрүүгө болбойт.
Абсолюттук сан эмне үчүн пайыздан маанилүү?
| Класс | Тест үлгүсү | TP Baseline | TP Cost-Sensitive | Baseline Recall, %95 GA | Cost-Sensitive Recall, %95 GA |
|---|---|---|---|---|---|
| R2L | 2887 | 119 | 151 | 4.12% [3.46%, 4.91%] | 5.23% [4.48%, 6.10%] |
| U2R | 67 | 0 | 24 | 0.00% [0.00%, 5.42%] | 35.82% [25.40%, 47.78%] |
U2R үчүн 35.82% чоң пайыздык өсүш сыяктуу көрүнөт, бирок тест топтомунда болгону 67 U2R үлгүсү бар. 24 туура аныктоо ошондуктан кең Wilson confidence interval менен чогуу берилген. Wilson интервалы, өзгөчө үлгү аз болгондо, байкалган катыштын белгисиздигин бир эле пайызды берүүгө караганда так көрсөтөт.
R2L жагында тест үлгүсү кыйла чоң. Ошого карабастан cost-sensitive түзүм болгону 32 кошумча R2L үлгүсүн туура классификациялай алган. Ошондуктан R2L өсүшү repeated-seed тестинде статистикалык маанилүү көрүнгөнү менен, операциялык көлөмү чектелүү.
U2R false-positive жүгү
| Жөндөө | Класс | TP | FP | FN | Precision | Recall |
|---|---|---|---|---|---|---|
| Baseline | R2L | 119 | 4 | 2768 | 0.9675 | 0.0412 |
| Cost-sensitive | R2L | 151 | 9 | 2736 | 0.9438 | 0.0523 |
| Baseline | U2R | 0 | 0 | 67 | 0.0000 | 0.0000 |
| Cost-sensitive | U2R | 24 | 1695 | 43 | 0.0140 | 0.3582 |
Cost-sensitive stacking U2R'ди эми толугу менен көз жаздымда калтырбайт; бирок 24 туура U2R эскертүүсүнө каршы 1695 false-positive пайда болушу precision'ды 1.4% деңгээлине түшүрөт. Ошондуктан булак моделдин U2R эскертүүсүн analyst triage үчүн колдонууну, акыркы автономдуу чабуул чечими катары колдонбоону сунуштайт.
R2L эмне үчүн дагы эле ийгиликсиз?
Failure analysis baseline stacking'де 2887 R2L үлгүсүнүн 2764-ү Normal деп божомолдонгонун көрсөтөт. Class weighting'ден кийин Normal'га кеткен сан 2269-га түшөт; бирок 463 R2L үлгүсү бул жолу туура R2L ордуна U2R деп классификацияланат. Демек модель сейрек чабуулдарга сезимталыраак болгону менен жетиштүү так R2L decision region үйрөнө албай жатат.
| Жөндөө | Класс | Жалпы | Normal божомолу | R2L божомолу | U2R божомолу | FNR |
|---|---|---|---|---|---|---|
| Baseline stacking | R2L | 2887 | 2764 | 119 | 0 | 0.959 |
| Baseline stacking | U2R | 67 | 65 | 2 | 0 | 1.000 |
| Cost-sensitive stacking | R2L | 2887 | 2269 | 151 | 463 | 0.948 |
| Cost-sensitive stacking | U2R | 67 | 40 | 3 | 24 | 0.642 |
25 Өзгөчөлүктүү MI–RFE Түзүмү Эң Жакшы Божомол Көрсөткүчүн Береби?
Жок. Булактын feature-subset sensitivity талдоосу 50 өзгөчөлүктүү жана 122 өзгөчөлүктүү конфигурациялар 25 өзгөчөлүктүү MI–RFE конфигурациясын weighted F1, R2L recall жана U2R recall боюнча ашып кеткенин көрсөтөт; 25 өзгөчөлүктүү түзүмдүн негиздемеси божомол артыкчылыгы эмес, төмөн өлчөмдүүлүк, кыскараак эсептөө убактысы жана компакттуулук.
| Өзгөчөлүк жөндөөсү | Тандоо ыкмасы | Weighted F1 | R2L Recall | U2R Recall | Training Time (s) |
|---|---|---|---|---|---|
| 10 өзгөчөлүк | Алгачкы 10 тандалган өзгөчөлүк | 0.7053 | 0.0173 | 0.1194 | 110.2 |
| 25 өзгөчөлүк | MI + RFE | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| 50 өзгөчөлүк | MI top 50 | 0.7668 | 0.1888 | 0.5075 | 160.5 |
| 122 өзгөчөлүк | Feature selection жок | 0.7625 | 0.1753 | 0.5224 | 243.5 |
50 өзгөчөлүктүү түзүм weighted F1 жана R2L recall боюнча эң жакшы жыйынтык берсе, 122 өзгөчөлүктүү түзүм U2R recall боюнча аз айырма менен эң жогорку маанини берет. 25 өзгөчөлүктүү түзүм 50 өзгөчөлүктүү түзүмдөн болгону болжол менен 9.7 секундга кыска training time берсе да, үч негизги көрсөткүчтүн баарында начар. Ошондуктан булак эсептөө бюджети жетиштүү болсо 50 өзгөчөлүктү күчтүүрөөк operating point катары аныктайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Baseline модель жыйынтыктары
| Модель | Accuracy | Weighted Precision | Weighted Recall | Weighted F1 | Time (s) |
|---|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7739 | 0.7544 | 0.7055 | 1.4 |
| XGBoost | 0.7504 | 0.8088 | 0.7504 | 0.7039 | 2.9 |
| SVM | 0.7183 | 0.7028 | 0.7183 | 0.6717 | 3.3 |
| KNN | 0.7409 | 0.7815 | 0.7409 | 0.6988 | 0.8 |
| Stacking Ensemble | 0.7542 | 0.8149 | 0.7542 | 0.7120 | 11.7 |
Random Forest эң жогорку baseline accuracy маанисине, stacking ensemble болсо эң жогорку weighted precision жана weighted F1 маанисине ээ. Ошого карабастан baseline confusion matrix'тери R2L жана U2R көп учурда Normal деп божомолдонорун көрсөтөт. Ошондуктан изилдөөнүн негизги жүйөсү “stacking ансыз да күчтүү” эмес, aggregate упайлар сейрек класстагы ийгиликсиздикти жашыра ала турганы.
Cost-sensitive learning модель боюнча эмнени өзгөрттү?
| Модель | Accuracy Baseline | Accuracy CW | F1 Baseline | F1 CW |
|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7533 | 0.7055 | 0.7074 |
| XGBoost | 0.7504 | 0.7648 | 0.7039 | 0.7237 |
| SVM | 0.7183 | 0.7611 | 0.6717 | 0.7423 |
| KNN | 0.7409 | 0.7409 | 0.6988 | 0.6988 |
| Stacking Ensemble | 0.7542 | 0.7342 | 0.7120 | 0.7214 |
SVM weighted F1 боюнча эң чоң глобалдык өсүштү көрсөтөт: 0.6717-ден 0.7423-кө, башкача айтканда 7.06 percentage point. Бирок SVM толук KDDTrain+ үстүндө эмес, computational feasibility себебинен 30,000 үлгүлүк stratified subset үстүндө үйрөтүлгөн. Ошондуктан SVM жыйынтыгы толук маалымат менен иштеген stacking/resampling эксперименттерине методологиялык жактан толук тең эмес.
Stacking ensemble'дын accuracy мааниси 0.7542-ден 0.7342-ге төмөндөгөнүнө карабастан weighted F1 0.7120-дан 0.7214-кө өсүшү class weighting көпчүлүк класстагы айрым туура чечимдерди курмандыкка чалып, сейрек класстарга көбүрөөк чечим мейкиндигин ачканын көрсөтөт.
Stacking ensemble класс боюнча кандай өзгөрдү?
| Класс | Baseline Recall | Cost-Sensitive Recall | Өзгөрүү |
|---|---|---|---|
| DoS | 79.24% | 80.17% | +0.93% |
| Normal | 97.15% | 91.45% | −5.69% |
| Probe | 63.57% | 62.66% | −0.91% |
| R2L | 4.12% | 5.23% | +1.11% |
| U2R | 0.00% | 35.82% | +35.82% |
U2R көрүнүктүүлүгү өскөндө Normal recall 5.69 percentage point төмөндөйт. Бул trade-off ката эмес, class weighting чечим чек арасын атайын өзгөрткөнүнүн натыйжасы. Коопсуздук жагынан мунун кабыл алынабы же жокпу, өткөрүп жиберилген privilege-escalation окуясынын наркы менен кошумча false-positive текшерүү чыгымын салыштырууга байланыштуу.
Cost-Sensitive Learning Resampling Ыкмаларынан Жакшыбы?
Жок; изилдөө cost-sensitive learning бардык imbalance ыкмаларынан жогору экенин көрсөтпөйт. Ошол эле 125,973 үлгүлүк KDDTrain+ протоколунда ADASYN эң жогорку weighted F1 жана R2L recall көрсөткүчтөрүн берген, ал эми cost-sensitive weighting бул салыштырууда эң жогорку U2R recall маанисин жана окутуу бөлүштүрүлүшүн синтетикалык маалымат менен өзгөртпөө артыкчылыгын камсыз кылган.
| Ыкма | Маалымат деңгээлиндеги өзгөрүү | Weighted F1 | R2L Recall | U2R Recall | Total Time (s) |
|---|---|---|---|---|---|
| Baseline | Жок | 0.7120 | 0.0412 | 0.0000 | 155.8 |
| Cost-sensitive weights | Синтетикалык маалымат жок | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| SMOTE | Синтетикалык oversampling | 0.7083 | 0.0450 | 0.0597 | 740.9 |
| Borderline-SMOTE | Boundary-focused oversampling | 0.7273 | 0.0551 | 0.0448 | 686.4 |
| ADASYN | Adaptive synthetic oversampling | 0.7478 | 0.0901 | 0.1343 | 680.2 |
| SMOTE-Tomek | Oversampling + Tomek cleaning | 0.7065 | 0.0433 | 0.0597 | 654.0 |
Бул салыштырууда ADASYN weighted F1 = 0.7478 жана R2L recall = 0.0901 менен cost-sensitive stacking'ден жогору. Анын ордуна cost-sensitive stacking U2R recall = 0.3582 менен ушул төрт resampling ыкмасынан күчтүүрөөк жана training distribution'ду синтетикалык үлгүлөр менен өзгөртпөйт.
Кеңири exploratory baseline'дар
| Ыкма | W-F1 | Macro-F1 | Balanced Accuracy | PR-AUC | R2L Recall | U2R Recall | U2R FP |
|---|---|---|---|---|---|---|---|
| Cost-sensitive stacking | 0.7214 | 0.5023 | 0.5507 | 0.5787 | 0.0523 | 0.3582 | 1695 |
| Balanced Random Forest | 0.7268 | 0.5455 | 0.5927 | 0.6469 | 0.2123 | 0.4627 | 427 |
| XGBoost threshold calibration | 0.7466 | 0.5603 | 0.5692 | 0.6900 | 0.1493 | 0.2537 | 188 |
| Focal-loss MLP | 0.7339 | 0.5640 | 0.5981 | 0.6105 | 0.2224 | 0.3134 | 429 |
Бул кеңейтилген салыштыруу негизги дооматтын чегин дагы так көрсөтөт. Cost-sensitive stacking baseline'га салыштырмалуу U2R көрүнүктүүлүгүн жогорулатат; бирок Balanced Random Forest U2R recall жана R2L recall боюнча күчтүүрөөк жана U2R false-positive саны кыйла төмөн. XGBoost threshold calibration эң төмөн U2R false-positive санын 188-ге түшүргөнү менен U2R recall 0.2537-де калат. Ошондуктан изилдөө “сунушталган түзүм бардык альтернативалардан жакшы” деген жыйынтыкты колдобойт.
Repeated-seed статистикалык тесттери
Стохастикалык өзгөрмөлүүлүк бир random seed жыйынтыгына гана байланып калбашы үчүн 10 seed колдонулган: {0, 1, 2, 3, 4, 5, 10, 21, 42, 100}. Baseline жана cost-sensitive stacking үчүн paired салыштырууларда Wilcoxon signed-rank, бир нече модель үй-бүлөсү үчүн Friedman тести колдонулган. Маанилүүлүк чеги p < 0.05.
| Салыштыруу | Метрика | Тест | p-value | Булактагы чечмелөө |
|---|---|---|---|---|
| Cost-sensitive stacking vs baseline | Weighted F1 | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | U2R recall | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | R2L recall | Wilcoxon | 0.0039 | Significant |
| Бардык cost-sensitive модель үй-бүлөлөрү | Weighted F1 | Friedman | 0.0018 | Significant |
Бул жердеги “statistically significant” деген сөз айырманын көлөмү операциялык жактан жетиштүү дегенди билдирбейт. R2L мисалы муну ачык көрсөтөт: repeated-seed тестинде айырма статистикалык маанилүү, бирок негизги шартта recall болгону 4.12%'дан 5.23%'га жана TP 119-дан 151-ге жогорулаган. Статистикалык маанилүүлүк менен практикалык коопсуздук таасири башка суроолор.
Component ablation эмнени көрсөтөт?
| Вариант | W-F1 | Macro-F1 | Balanced Accuracy | Macro PR-AUC | R2L Recall | U2R Recall |
|---|---|---|---|---|---|---|
| Baseline stack, class weighting жок | 0.712 | 0.492 | 0.488 | 0.608 | 0.041 | 0.000 |
| CW-only XGBoost | 0.752 | 0.594 | 0.571 | 0.750 | 0.091 | 0.209 |
| Stacking, feature selection жок | 0.763 | 0.577 | 0.642 | 0.694 | 0.175 | 0.522 |
| MI-only XGBoost | 0.743 | 0.595 | 0.570 | 0.720 | 0.086 | 0.284 |
| RFE-only XGBoost | 0.711 | 0.510 | 0.500 | 0.670 | 0.044 | 0.075 |
| Stacking алынды | 0.715 | 0.509 | 0.501 | 0.674 | 0.037 | 0.060 |
| Толук 25-feature framework | 0.721 | 0.502 | 0.551 | 0.579 | 0.052 | 0.358 |
Ablation'дун эң маанилүү жыйынтыгы — U2R visibility өсүшүнүн негизги кыймылдаткычы class weighting. Class weighting алынып салынганда U2R recall кайра нөлгө түшөт. Ошол эле учурда feature reduction акысыз эмес: feature selection колдонулбаган stacking варианты weighted F1, balanced accuracy, R2L recall жана U2R recall боюнча толук 25-feature framework'тен жогору.
Демек гибрид feature selection'дын илимий ролу “жогорку accuracy түзүү” эмес, кичирээк жана эсептөө жактан натыйжалуураак feature space алуу катары чечмелениши керек.
Weighted F1 эмне үчүн жалгыз жетишсиз?
| Жөндөө | Accuracy | Weighted F1 | Macro-F1 | Balanced Accuracy | Macro FPR | Macro FNR | R2L | U2R |
|---|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.754 | 0.712 | 0.492 | 0.488 | 0.084 | 0.512 | 0.041 | 0.000 |
| Cost-sensitive stacking | 0.734 | 0.721 | 0.502 | 0.551 | 0.080 | 0.449 | 0.052 | 0.358 |
Macro FNR 0.512-ден 0.449-га төмөндөшү сейрек класстын көрүнүктүүлүгүнүн өсүшүнө шайкеш, бирок 0.449 дагы эле жогорку өткөрүп жиберүү көрсөткүчү. Булак муну production NIDS үчүн чечилген көйгөй катары баалабайт.
PR-AUC эмне үчүн өзүнчө эсептелген?
Precision–Recall Area Under the Curve (PR-AUC), айрыкча оң класс өтө сейрек болгон көйгөйлөрдө модель ар кандай чечим босоголорунда precision менен recall ортосунда кандай тартип түзөрүн баалоого жардам берет. U2R'дин KDDTest+ ичиндеги prevalence мааниси болгону 0.0030 болгондуктан hard-label recall жалгыз өзү ыктымалдыктык рейтингдин сапатын түшүндүрбөйт.
| Класс | Baseline | Cost-Sensitive |
|---|---|---|
| DoS | 0.9448 | 0.9636 |
| Normal | 0.9541 | 0.8066 |
| Probe | 0.8034 | 0.7660 |
| R2L | 0.3280 | 0.3449 |
| U2R | 0.0092 | 0.0126 |
U2R PR-AUC 0.0092-ден 0.0126-га жогорулаган. Булак муну prevalence baseline'дын болжол менен 3.1 жана 4.2 эсеси катары берет. Ошого карабастан 0.0126 абсолюттук мааниде өтө төмөн ranking-quality деңгээли; авторлор да U2R'ди изилдөөнүн борбордук кыйынчылыктарынын бири катары калтырышат.
U2R threshold өзгөргөндө эмне болот?
| Threshold τ | U2R TP / 67 | U2R Recall | U2R FP | Precision |
|---|---|---|---|---|
| 0.05 | 59 | 0.881 | 6608 | 0.0088 |
| 0.10 | 45 | 0.672 | 3796 | 0.0117 |
| 0.30 | 24 | 0.358 | 2180 | 0.0109 |
| 0.50 | 14 | 0.209 | 1666 | 0.0083 |
| 0.70 | 11 | 0.164 | 1312 | 0.0083 |
| 0.90 | 11 | 0.164 | 953 | 0.0114 |
Босого төмөндөгөндө көбүрөөк U2R кармалат, бирок false-positive саны миңдегенге чыгат. Босого жогорулаганда эскертүү жүгү азаят, бирок recall да төмөндөйт. U2R precision көрсөтүлгөн бардык operating point'терде болжол менен %1 тегерегинде.
Table 14-төгү hard-label cost-sensitive U2R жыйынтыгы 24 TP жана 1695 FP болсо, threshold table'дагы \(\tau=0.30\) жыйынтыгы ошол эле 24 TP үчүн 2180 FP берет. Бул эки сан карама-каршы эмес: hard-label модель кадимки multi-class чечимин колдонсо, threshold experiment U2R ыктымалдыгы белгиленген \(\tau\) маанисинен жогору болгондо классты мажбурлап U2R кылып дайындаган башка operating rule колдонот.
Alert-budget талдоосу
| Аналитиктин эскертүү бюджети | Кармалган чыныгы U2R / 67 |
|---|---|
| Top 100 эскертүү | 4 |
| Top 500 эскертүү | 6 |
| Top 1000 эскертүү | 11 |
Бул жыйынтык моделдин U2R упайы analyst prioritization үчүн бир аз маалымат алып жүрөрүн, бирок жалгыз өзү жогорку ишенимдүү автоматтык чечим үчүн жетиштүү precision бербегенин көрсөтөт.
UNSW-NB15 Тышкы Текшерүүсү Эмнени Көрсөтөт?
UNSW-NB15 тышкы текшерүүсү dataset'ке атайын tuning жасалбастан ошол эле preprocessing, MI→RFE, stacking жана balanced class-weighting логикасы төрт сейрек чабуул категориясынын recall маанилерин күчтүү жогорулата аларын; бирок бул Normal recall жана weighted F1 жоготуусунун эсебинен болорун көрсөтөт. Демек тышкы текшерүү сейрек-класс trade-off'у башка маалымат топтомуна да өтөрүн колдойт, бирок өндүрүш тармактарында жалпы артыкчылыкты далилдебейт.
Тышкы маалымат топтомунун протоколу
UNSW-NB15'тин расмий training partition'ы 175,341, testing partition'ы 82,332 жазуу жана стандарттуу он класстуу taxonomy колдонулган. Колдонулган public mirror'до record identifier менен sttl, dttl жана алты ct_* connection-counter өзгөчөлүгү чыгарылып, калган 31 numeric жана үч categorical өзгөчөлүк ошол эле pipeline менен иштетилген.
proto, service жана state one-hot encode кылынган; Min-Max scaler training partition'га гана fit кылынган; MI менен 50 өзгөчөлүк калтырылган; RFE менен 25-ке түшүрүлгөн жана ошол эле stacking architecture balanced class weights менен колдонулган. Булак өзгөчө UNSW-specific tuning жасалбаганын белгилейт.
| Конфигурация | Weighted F1 | Macro-F1 | Balanced Accuracy | Analysis Recall | Backdoor Recall | Shellcode Recall | Worms Recall |
|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.8096 | 0.5007 | 0.4856 | 0.0000 | 0.0583 | 0.5291 | 0.1818 |
| Cost-sensitive stacking | 0.7509 | 0.4780 | 0.6696 | 0.2496 | 0.6930 | 0.9550 | 0.8864 |
| Cost-sensitive XGBoost | 0.7488 | 0.5137 | 0.6392 | 0.1300 | 0.5798 | 0.9233 | 0.7273 |
Cost-sensitive stacking менен Worms 18.18%'дан 88.64%'га чыгат жана 44 Worms үлгүсүнүн 39-у туура аныкталат. Shellcode 52.91%'дан 95.50%'га, Backdoor 5.83%'дан 69.30%'га, Analysis болсо 0.00%'дан 24.96%'га жогорулайт.
Мунун ордуна Normal recall 91.74%'дан 64.22%'га жана weighted F1 0.8096-дан 0.7509-га төмөндөйт. Balanced accuracy 0.4856-дан 0.6696-га жогорулайт. Бул изилдөөнүн негизги коопсуздук trade-off'унун башка маалымат топтомундагы дал келиши: majority-class жалпы ийгилиги төмөндөп, аз көрсөтүлгөн чабуулдар көрүнүктүүрөөк болот.
Cost-sensitive моделдин class-level PR-AUC мааниси Worms үчүн 0.5903, Shellcode үчүн 0.3939 деп билдирилген. Бул NSL-KDD U2R PR-AUC = 0.0126 маанисине караганда кыйла күчтүү rare-class ranking жүрүм-турумун көрсөтөт.
Изилдөө колдогон жыйынтыктар
- Balanced class weighting баштапкы training observations өзгөртүлбөстөн айрым сейрек чабуул класстарынын recall маанисин жогорулата алган.
- NSL-KDD негизги экспериментинде stacking U2R recall 0.00%'дан 35.82%'га жогорулаган.
- Weighted F1, U2R recall жана R2L recall өсүштөрү repeated-seed paired Wilcoxon тесттеринде
p < 0.05деңгээлинде маанилүү. - R2L жыйынтыгы статистикалык жактан өзгөргөнү менен абсолюттук операциялык жакшыруу чектелүү.
- Class weighting U2R visibilityнин негизги кыймылдаткычы.
- 25-feature MI–RFE түзүмү компакттуулукту берет, бирок максималдуу божомол көрсөткүчүн бербейт.
- ADASYN айрым глобалдык жана R2L метрикаларында cost-sensitive stacking'ден жогору.
- Balanced Random Forest кеңейтилген салыштырууда U2R жана R2L recall боюнча cost-sensitive stacking'ден күчтүү.
- UNSW-NB15 тышкы текшерүүсү сейрек класс recall өсүшү башка benchmark'та да пайда болорун көрсөтөт.
- Сейрек класс recall өсүшү majority-class recall, weighted F1 же false-positive жүгүндө чыгым жаратышы мүмкүн.
Изилдөө колдобогон жыйынтыктар
- Framework бардык сейрек чабуулдарды ишенимдүү чечкен жалпы NIDS эмес.
- R2L көйгөйү чечилген эмес.
- U2R үчүн 35.82% recall жогорку-precision автономдуу чабуул аныктоо дегенди билдирбейт.
- 25 өзгөчөлүктүү feature set бардык маалымат топтомдорунда же бардык чабуул түрлөрүндө оптималдуу экени көрсөтүлгөн эмес.
- Cost-sensitive learning SMOTE, ADASYN, Balanced Random Forest, focal loss же threshold calibration'дан универсалдуу түрдө жогору экени көрсөтүлгөн эмес.
- NSL-KDD жана UNSW-NB15 жыйынтыктары заманбап encrypted, cloud-native жана IoT өндүрүш трафигинин баарын билдирбейт.
- Жандуу SOC же production packet/flow collector үстүндө end-to-end deployment текшерүүсү жүргүзүлгөн эмес.
- Explainability үчүн SHAP же counterfactual analysis учурдагы framework'ке колдонулган эмес.
- CICIDS2017/2018 жана TON_IoT үстүндө бул изилдөөдө аяктаган validation жок.
- Статистикалык маанилүүлүк жалгыз өзү операциялык usefulness же туура alert budget кепилдиги эмес.
Чектөөлөр
Benchmark'тын жашы: NSL-KDD көзөмөлдөнгөн салыштыруу үчүн пайдалуу, бирок заманбап encrypted traffic, cloud workloads, IoT protocols жана учурдагы чабуул кампанияларын толук билдирбейт.
R2L overlap: R2L менен Normal ортосундагы feature-space окшоштугу class weighting менен чечилген эмес.
SVM окутуу чектөөсү: SVM болгону 30,000 stratified training үлгүсүндө иштетилген; толук KDDTrain+ менен иштеген моделдерге салыштырганда бул чектөө эске алынышы керек.
False-positive жүгү: U2R көрүнүктүүлүгү өскөндө precision өтө төмөн бойдон калышы мүмкүн. Өндүрүш чөйрөсүндө threshold calibration жана analyst capacity критикалык мааниге ээ.
Explainability: SHAP же counterfactual analysis сыяктуу түшүндүрмө катмары кошулган эмес.
External validity: UNSW-NB15 тышкы текшерүүсү бир-маалымат-топтому көйгөйүн азайткан, бирок толугу менен жойгон эмес.
Жандуу deployment: End-to-end live flow collector, SOC интеграциясы жана production network жүрүм-туруму текшерилген эмес.
Булак ичиндеги latency билдирүүсү: Метод бөлүмүндө чектелген inference-latency өлчөөсү бар болгонуна карабастан, чектөөлөр бөлүмүндө inference latency али бааланган эмес деген билдирүү калган.
Келечектеги изилдөө багыттары
Булак келечекте CICIDS2017, CSE-CIC-IDS2018 жана TON_IoT үстүндө ошол эле ablation жана confidence-interval протоколун колдонуу; adaptive cost schedule, probability calibration, held-out validation менен threshold calibration, SHAP негизиндеги interpretability, focal-loss моделдерин controlled false-positive budget шартында салыштыруу жана Balanced Random Forest/EasyEnsemble сыяктуу ыкмаларды баалоону сунуштайт.
Ошондой эле CICFlowMeter же Zeek сыяктуу flow collector'лор менен real-time deployment текшерүүсү сунушталат. Бул азыркы изилдөөнүн аяктаган жыйынтыктары эмес, келечектеги изилдөө сунуштары.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Cost-Sensitive Stacking Ensemble with Hybrid Feature Selection for Rare Attack Detection in Network Intrusion Detection Systems
Авторлор жана тартип: Ioan Corneliu Salisteanu; Iulian Udroiu; Andrei Cosmin Gheorghe; Ionut Adrian Tudoroiu; Emil Mihai Diaconu.
Corresponding author: Andrei Cosmin Gheorghe.
Corresponding e-mail: andrei.gheorghe@valahia.ro
Мекеме: Faculty of Electrical Engineering, Electronics and Information Technology, University “Valahia” of Targoviste, 130004 Targoviste, Romania.
Тең салым / тең биринчи авторлук: Булакта тең салым жөнүндө билдирүү жок.
Academic Editor: Emre Tokgoz.
Журнал: Electronics.
Басмакана: MDPI, Basel, Switzerland.
ISSN: 2079-9292.
Том / чыгарылыш: Volume 15, Issue 14.
Макала номери: 3094.
Жарыяланган жылы: 2026.
Макаланын түрү: Article; көзөмөлдөнгөн benchmark негизиндеги эксперименттик машиналык окутуу/NIDS баалоо изилдөөсү.
DOI: 10.3390/electronics15143094.
Расмий шилтеме: https://doi.org/10.3390/electronics15143094
Received: 2 Июнь 2026.
Revised: 10 Июль 2026.
Accepted: 13 Июль 2026.
Published: 14 Июль 2026.
Рецензия статусу: Electronics MDPIнин расмий жазуусунда international, peer-reviewed жана open-access journal катары аныкталат.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint статусу: Каралган булак жарыяланган журнал макаласы; PDF өзүнчө preprint идентификаторун көрсөтпөйт.
Негизги изилдөө көйгөйү: Жалпы accuracy катуу class imbalance шартында rare/high-impact attack ийгиликсиздигин жашыра алышы.
Методологиялык салымдын чеги: MI, RFE, stacking же balanced class weighting компоненттери өз-өзүнчө жаңы алгоритмдер эмес. Изилдөөнүн салымы — аларды rare-class-focused, statistically audited жана data-preserving баалоо протоколунда көзөмөлдөнгөн түрдө интеграциялоо.
Негизги маалымат топтому: NSL-KDD; KDDTrain+ = 125,973 жазуу, KDDTest+ = 22,544 жазуу.
External validation: UNSW-NB15; official train = 175,341, test = 82,332 жазуу; dataset-specific tuning жасалган эмес.
NSL-KDD класстары: Normal, DoS, Probe, R2L жана U2R.
Preprocessing: protocol_type, service жана flag үчүн one-hot encoding; 41 баштапкы attribute → 122 сандык feature; training-fit Min-Max scaling [0,1]; difficulty_level алынып салынган.
Feature selection: MI менен 122 → 50, Random Forest негизиндеги RFE менен 50 → 25.
Feature-selection чечмелөө чеги: 25-feature түзүм эң жогорку көрсөткүч чекити эмес; 50-feature жана айрым no-feature-selection варианттары жогорураак божомол метрикаларын чыгарган.
Жеке моделдер: Random Forest, XGBoost, SVM жана KNN.
Stacking: Random Forest + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold out-of-fold prediction.
SVM чеги: 30,000 stratified training үлгүсү; башка full-training кошумча эксперименттер менен түздөн-түз тең эмес.
Cost-sensitive формула: \(w_c=N/(C n_c)\).
Approximate class weights: Normal 0.37; DoS 0.55; Probe 2.16; R2L 25.32; U2R 484.49.
Resampling негизги framework'те колдонулдубу? Жок. Негизги cost-sensitive framework original training observations'ды сактайт. SMOTE, Borderline-SMOTE, ADASYN жана SMOTE-Tomek өзүнчө experimental baseline'дар.
Random seeds: 0, 1, 2, 3, 4, 5, 10, 21, 42, 100.
Statistical tests: Wilcoxon signed-rank жана Friedman; significance threshold p < 0.05.
Негизги U2R жыйынтыгы: 0/67 → 24/67; recall 0.00% → 35.82%; Wilson %95 GA 25.40%–47.78% cost-sensitive шартта.
Негизги R2L жыйынтыгы: 119/2887 → 151/2887; recall 4.12% → 5.23%.
Негизги weighted-F1 жыйынтыгы: Stacking 0.7120 → 0.7214.
Негизги accuracy trade-off: Stacking 0.7542 → 0.7342.
U2R hard-label precision: Cost-sensitive stacking 24 TP, 1695 FP, precision 0.0140.
U2R probability-level жыйынтыгы: PR-AUC 0.0092 → 0.0126; prevalence 0.0030.
Repeated-seed p-values: Weighted F1 p = 0.0020; U2R recall p = 0.0020; R2L recall p = 0.0039; Friedman weighted-F1 comparison p = 0.0018.
25-feature sensitivity: Weighted F1 = 0.7214; R2L = 0.0523; U2R = 0.3582; training time = 150.8 s.
50-feature sensitivity: Weighted F1 = 0.7668; R2L = 0.1888; U2R = 0.5075; training time = 160.5 s.
122-feature sensitivity: Weighted F1 = 0.7625; R2L = 0.1753; U2R = 0.5224; training time = 243.5 s.
Software: Python 3.13.5; scikit-learn 1.8.0; XGBoost 3.1.3; imbalanced-learn 0.14.1; NumPy 2.3.5; pandas 2.2.3.
Жабдуу/чөйрө: Linux x86_64, CPU-only, 56 logical CPU core available to container, болжол менен 4.3 GB RAM; GPU колдонулган эмес.
Алгачкы 1000 KDDTest+ inference latency: Random Forest 0.2609 ms/sample; XGBoost 0.1081 ms/sample; KNN 1.6117 ms/sample; Stacking 2.0925 ms/sample. Булак буларды hardware-dependent relative computational values катары чектейт.
Булак ичиндеги latency эскертүүсү: Section 3.6 inference latency маанилерин бергенине карабастан Section 5.3 inference latency али камтылбаганын айтат. Эки билдирүү булакта чогуу болгондуктан бул айырма сакталган.
External-validation trade-off: UNSW-NB15-те cost-sensitive stacking balanced accuracy 0.4856 → 0.6696 жогоруласа, weighted F1 0.8096 → 0.7509 жана Normal recall 91.74% → 64.22% төмөндөгөн.
UNSW rare-class recall: Analysis 0.00% → 24.96%; Backdoor 5.83% → 69.30%; Shellcode 52.91% → 95.50%; Worms 18.18% → 88.64%.
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Data Availability: NSL-KDD коомдук benchmark. Булак ошондой эле preprocessing, MI–RFE feature selection, training, imbalance baselines, statistical tests жана figure generation үчүн Python script'терин камтыган supplementary reproducibility package бар экенин билдирет. Коммерциялык же жеке production network trace колдонулган эмес.
Авторлордун салымы: Conceptualization — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe, Ioan Corneliu Salisteanu жана Iulian Udroiu; methodology — Ioan Corneliu Salisteanu, Andrei Cosmin Gheorghe жана Iulian Udroiu; software — Ionut Adrian Tudoroiu жана Andrei Cosmin Gheorghe; validation — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe жана Emil Mihai Diaconu; formal analysis — Andrei Cosmin Gheorghe; investigation — Emil Mihai Diaconu; resources жана data curation — Ionut Adrian Tudoroiu; original draft — Ionut Adrian Tudoroiu; review/editing — Andrei Cosmin Gheorghe; visualization — Ioan Corneliu Salisteanu жана Iulian Udroiu; supervision — Ioan Corneliu Salisteanu, Iulian Udroiu жана Andrei Cosmin Gheorghe.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет.
Негизги методологиялык чек: Жыйынтыктар көзөмөлдөнгөн NSL-KDD жана UNSW-NB15 benchmark талдоосу; реалдуу SOC, production network же жандуу flow collector үстүндөгү end-to-end текшерүү эмес.
Келечектеги текшерүү: CICIDS2017, CSE-CIC-IDS2018, TON_IoT, threshold/probability calibration, SHAP, controlled false-positive budgets, Balanced Random Forest/EasyEnsemble жана live CICFlowMeter/Zeek интеграциясы.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген