


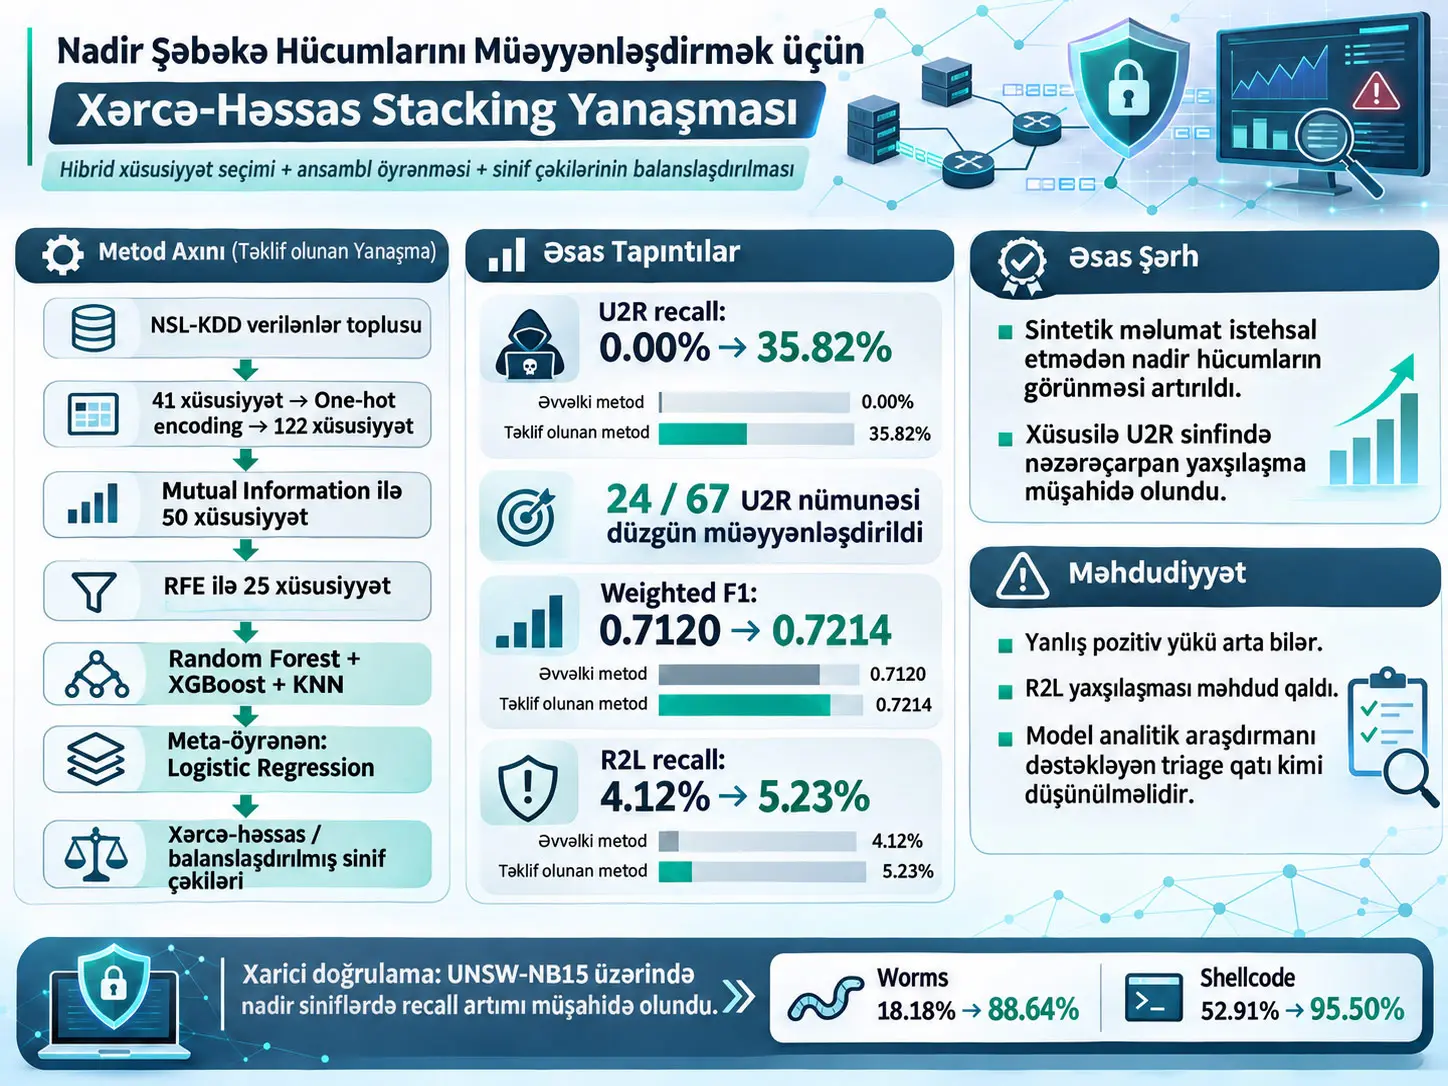
Xərcə-həssas MI–RFE–stacking çərçivəsi, balanssız çoxsinifli şəbəkə hücumlarının aşkarlanmasında nadir hücumların görünürlüğünü artırmaq üçün Mutual Information (MI) və Recursive Feature Elimination (RFE) ilə xüsusiyyət seçimini, heterogen stacking ensemble-ı və sinfə bağlı xəta xərclərini birləşdirən məlumatı qoruyan Network Intrusion Detection System (NIDS) qiymətləndirmə boru xəttidir. Tədqiqat yeni təsnifatçı təklif etmir; Random Forest, XGBoost, Support Vector Machine (SVM), K-Nearest Neighbors (KNN), Logistic Regression, MI, RFE və balanced class weighting kimi mövcud komponentlərin nadir siniflərə yönələn nəzarətli və təkrar istehsal oluna bilən protokol altında necə davrandığını araşdırır.
Əsas qiymətləndirmə NSL-KDD benchmark-ında aparılmışdır. KDDTrain+ 125,973, KDDTest+ isə 22,544 şəbəkə bağlantısı qeydi ehtiva edir. Kateqorik protocol_type, service və flag dəyişənlərinin one-hot encoding əməliyyatından sonra 41 orijinal xüsusiyyət 122 ədədi xüsusiyyətə genişləndirilmiş; yalnız təlim dəstinə uyğunlaşdırılan Min-Max miqyaslama tətbiq edilmiş; sonra MI ilə ən yüksək skorlu 50 xüsusiyyət saxlanılmış və Random Forest əsaslı RFE ilə say 25-ə endirilmişdir.
Əsas stacking ensemble Random Forest, XGBoost və KNN-ni base learner; Logistic Regression-ı meta-learner kimi istifadə edir. Meta-learner üçün 3-fold out-of-fold proqnozlar yaradılır. Sinif balanssızlığı sintetik məlumat yaradılmadan, w_c = N/(C n_c) formasındakı balanced class weighting ilə idarə olunmuşdur. NSL-KDD paylanmasında təxmini sinif çəkiləri Normal üçün 0.37, DoS üçün 0.55, Probe üçün 2.16, R2L üçün 25.32 və U2R üçün 484.49-dur.
Stacking ensemble-ın əsas tək-işləmə nəticəsində U2R recall 0.00%-dan 35.82%-ə yüksəlmişdir; başqa sözlə baseline model 67 U2R nümunəsinin heç birini düzgün müəyyən edə bilmədiyi halda cost-sensitive struktur 24-nü düzgün müəyyən etmişdir. Weighted F1 0.7120-dan 0.7214-ə yüksəlmiş, lakin accuracy 0.7542-dən 0.7342-yə düşmüşdür. R2L recall isə yalnız 4.12%-dən 5.23%-ə, yəni 119/2887 düzgün aşkarlamadan 151/2887-yə yüksəlmişdir.
U2R nəticəsi güclü şərh sərhədi tələb edir. Cost-sensitive hard-label stacking nəticəsində U2R üçün 24 true positive-a qarşı 1695 false positive bildirildiyi üçün precision yalnız 0.0140-dır. Ayrı probability-threshold analizində də U2R precision təxminən %1 səviyyəsində qalmışdır. Buna görə modelin U2R çıxışı tədqiqatın öz müzakirəsinə əsasən avtonom yekun qərar deyil, təhlükəsizlik analitikinin araşdırmasını prioritetləşdirən triage siqnalıdır.
Tədqiqat həmçinin cost-sensitive yanaşmanın bütün alternativlərdən üstün olmadığını göstərir. Full-training resampling müqayisəsində ADASYN weighted F1 və R2L recall baxımından daha güclüdür; daha sonrakı exploratory baselines daxilində Balanced Random Forest daha yüksək U2R recall və daha aşağı U2R false-positive sayı təmin etmişdir. Təklif olunan yanaşmanın fərqləndirici üstünlüyü sintetik azlıq nümunəsi yaratmadan orijinal təlim müşahidələrini qoruması və nadir hücum davranışını açıq şəkildə nəzarətdə saxlamasıdır.
UNSW-NB15 xarici doğrulamasında da nadir sinif recall-ları nəzərəçarpacaq dərəcədə yüksəlmiş; lakin Normal recall və weighted F1 azalmışdır. Bu nəticələr metodun nadir siniflərə daha çox çəki verdikdə qərar sərhədlərini həqiqətən dəyişdirdiyini dəstəkləyir, lakin müasir istehsal şəbəkələrində ümumi üstünlük və ya avtomatik deployment uğuru demək deyil.
Cost-Sensitive Öyrənmə Bu Tədqiqatda Niyə İstifadə Olunur?
Cost-sensitive öyrənmə balanssız məlumat dəstində bütün təsnifat xətalarını bərabər saymaq əvəzinə, nadir siniflərdəki xətalara daha yüksək təlim cəzası verərək qərar sərhədini azlıq siniflərinə qarşı daha həssas edir; bu tədqiqatda əsas məqsəd xüsusilə U2R və R2L hücumlarının çoxluq sinifləri arasında itməsi ehtimalını azaltmaqla yanaşı, orijinal təlim qeydlərini sintetik nümunələrlə əvəz etməməkdir.
Nadir hücumlar niyə ümumi accuracy daxilində görünməz qala bilər?
NSL-KDD beş əsas sinifdən istifadə edir: Normal, Denial of Service (DoS), Probe, Remote-to-Local (R2L) və User-to-Root (U2R). Təlim dəstində Normal və DoS birlikdə qeydlərin təxminən %90-nı təşkil etdiyi halda U2R cəmi 52 təlim nümunəsindən ibarətdir; bu təxminən %0.04 pay deməkdir. Belə paylanmada model çoxluq siniflərini yaxşı öyrənib nadir sinfi demək olar ki, tamamilə görməzdən gəlsə belə, yüksək hesab oluna biləcək qlobal accuracy əldə edə bilər.
DoS, hədəf xidmətin və ya resursun əlçatanlığını pozmağa yönələn hücum sinfidir. Probe, şəbəkə və ya sistem haqqında məlumat toplama və əlçatan hədəfləri araşdırma davranışlarını əhatə edir. R2L, uzaq mənbədən yerli sistemə icazəsiz giriş əldə olunması ilə əlaqəli sinifdir. U2R isə istifadəçinin daha yüksək və ya administrator/root səviyyəsində imtiyaz əldə etməsi ilə əlaqəli, çox nadir, lakin təhlükəsizlik baxımından kritik sinifdir.
Mənbənin Şəkil 4-də 5000 KDDTest+ nümunəsi t-SNE ilə ikiölçülü şəkildə vizuallaşdırılmışdır. Vizualda DoS və Normal nümunələri bəzi daha seçilə bilən bölgələr yaratdığı halda R2L və U2R nümunələrinin Normal trafiklə güclü şəkildə üst-üstə düşdüyü göstərilir. t-SNE burada təsnifatçı deyil; yüksəkölçülü feature space-in vizual araşdırma məqsədilə iki ölçüyə endirilməsində istifadə olunan üsuldur. Şəklin mesajı budur ki, nadir hücum problemi yalnız sinif sayından deyil, feature-space overlap-dan da qaynaqlanır.
Balanced class weight düsturu
Mənbədə istifadə olunan əsas xərc çəkisi:
\[ w_c=\frac{N}{C\,n_c} \]
Düstur nəyi hesablayır? Hər sinif üçün təlim zamanı istifadə olunacaq nisbi xəta çəkisini hesablayır.
\(w_c\): \(c\) sinfinin ölçüsüz çəkisidir.
\(N\): Ümumi təlim nümunələrinin sayıdır; NSL-KDD əsas təlim dəstində 125,973-dür.
\(C\): Siniflərin sayıdır; bu tədqiqatda 5-dir.
\(n_c\): Müvafiq sinfə aid təlim nümunələrinin sayıdır.
Sinfin nümunə sayı azaldıqca məxrəcdəki \(n_c\) kiçilir və \(w_c\) böyüyür. Buna görə U2R kimi çox nadir sinifdə yanlış təsnifat təlim məqsədi baxımından Normal sinifdəki xətadan xeyli daha yüksək cəzaya malik olur.
| Sinif | Təxmini çəki | Alqoritmik məna |
|---|---|---|
| Normal | 0.37 | Çox tez-tez rast gəlinən sinif; xəta cəzası nisbətən aşağıdır. |
| DoS | 0.55 | Yüksək tezlikli hücum sinfi. |
| Probe | 2.16 | Orta tezlikli sinif. |
| R2L | 25.32 | Nadir sinif; yanlış təsnifat daha ağır cəzalandırılır. |
| U2R | 484.49 | Ən nadir sinif; yanlış təsnifat çox yüksək nisbi cəza alır. |
Random Forest, SVM və Logistic Regression üçün class_weight = balanced istifadə olunmuşdur. XGBoost-da eyni sinif-tezlik düsturuna əsaslanan nümunə çəkiləri tətbiq edilmişdir. KNN-nin istifadə olunan standart formulunda eyni class-weight mexanizmi olmadığı üçün KNN nəticəsi cost-sensitive mərhələdə dəyişmir.
Niyə birbaşa SMOTE istifadə edilməyib?
Müəlliflərin məlumatı qoruyan seçiminin əsas səbəbi U2R-nin yalnız 52 real təlim nümunəsinə malik olmasıdır. Çox kiçik real nümunədən çox sayda sintetik müşahidə törədildikdə, ədədi baxımdan faydalı, lakin real hücum davranışını kifayət qədər təmsil etməyən süni qərar bölgələrinin yarana biləcəyinə dair narahatlıq vardır. Buna görə əsas framework təlim məlumatını çoxaltmaq əvəzinə loss/qərar xərcini dəyişdirir.
Lakin tədqiqat bu əsaslandırmanı yalnız fərziyyə kimi saxlamayıb və SMOTE, Borderline-SMOTE, ADASYN və SMOTE-Tomek-i eyni full-training protokolunda birbaşa baseline kimi sınaqdan keçirmişdir. Nəticələr cost-sensitive yanaşmanın resampling-ə universal olaraq üstün olmadığını göstərir.
Mutual Information niyə ilk xüsusiyyət seçimi mərhələsində istifadə olunur?
Mutual Information (MI), feature ilə hədəf sinif arasındakı statistik asılılığı qiymətləndirən filter tipli feature-selection üsuludur. Təsnifatçını təkrar-təkrar öyrətmədən hər feature üçün hədəf label ilə informasiya əlaqəsi hesablana bildiyinə görə ilkin eleme mərhələsində nisbətən aşağı hesablama xərci təmin edir.
Tədqiqatda one-hot encoding-dən sonrakı 122 xüsusiyyət üçün MI hesablanmış və ən yüksək MI skoruna malik 50 xüsusiyyət saxlanmışdır. Bu mərhələ feature space-i əvvəlcə sürətli filter mexanizmi ilə daraldır.
Recursive Feature Elimination nə edir?
Recursive Feature Elimination (RFE), modelin feature-importance məlumatından istifadə edərək ən az faydalı görünən xüsusiyyətləri iterativ şəkildə çıxaran wrapper tipli seçim üsuludur. Bu tədqiqatda 50 MI xüsusiyyəti Random Forest estimator ilə qiymətləndirilmiş və ən az əhəmiyyətli xüsusiyyətlər çıxarılaraq 25 xüsusiyyət saxlanmışdır.
MI ilə RFE-nin birlikdə istifadəsinin məntiqi MI-nin sürətli, modeldən asılı olmayan ilkin filtrlənməsini RFE-nin modeldən xəbərdar ikinci elemesi ilə birləşdirməkdir. Mənbənin Şəkil 3-də iki seçim mexanizminin 22 xüsusiyyət üzərində ortaqlaşdığı, üç xüsusiyyətin yalnız MI və üç xüsusiyyətin yalnız RFE tərəfində olduğu göstərilir.
Son 25 xüsusiyyət
Tədqiqatda istifadə olunan 25 xüsusiyyət bunlardır: src_bytes, diff_srv_rate, same_srv_rate, dst_host_diff_srv_rate, dst_host_srv_count, count, dst_host_same_srv_rate, dst_host_serror_rate, serror_rate, flag_SF, dst_host_srv_serror_rate, flag_S0, srv_serror_rate, logged_in, dst_host_srv_diff_host_rate, dst_host_same_src_port_rate, dst_host_count, srv_count, service_private, dst_host_rerror_rate, dst_host_srv_rerror_rate, rerror_rate, service_eco_i, protocol_type_icmp və service_ecr_i.
Müəlliflər bu 25 xüsusiyyətin bütün NIDS problemləri üçün universal optimal olduğunu iddia etmirlər. Bu siyahı yalnız nəzarətli NSL-KDD MI→RFE pipeline-ının çıxışıdır.
Təsnifatçı hiperparametrləri
| Model | Mənbə ayarı | Mühüm metod qeydi |
|---|---|---|
| Random Forest | 200 ağac; maximum depth = 20; internal split üçün minimum 5 nümunə | MI-dən sonra RFE estimator kimi də istifadə olunmuşdur. |
| XGBoost | 200 ağac; maximum depth = 8; learning rate = 0.1; sətir və sütun subsampling = 0.8 | Cost-sensitive halda per-instance weight istifadə olunmuşdur. |
| SVM | RBF kernel; C = 10; gamma = scale | Hesablama xərci səbəbindən 30,000 nümunəlik stratified təlim alt dəsti istifadə olunmuşdur. |
| KNN | k = 5; inverse-distance weighting | Standart tətbiqdə class weight istifadə edilmədiyinə görə cost-sensitive nəticə dəyişmir. |
| Stacking | RF + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold OOF | Meta-learner leakage-i azaltmaq üçün out-of-fold predictions ilə öyrədilir. |
Mənbə stacking daxilindəki base modellər üçün hesablama səmərəliliyi məqsədilə “reduced hyperparameters” istifadə edildiyini bildirir, lakin bu azaldılmış stacking-daxili hiperparametrlərin bütün ədədi dəyərlərini eyni yerdə açıq şəkildə sadalamır. Buna görə yuxarıdakı fərdi model ayarlarının stacking daxilindəki base modellərdə tam eyni olduğu fərz edilməməlidir.
Təlim və test protokolu
Bütün əsas modellər KDDTrain+ üzərində öyrədilmiş və müstəqil KDDTest+ üzərində qiymətləndirilmişdir. KDDTest+ yenidən bölünməmiş, resample edilməmiş və cross-validation təliminə daxil edilməmişdir. Bu ayrım test dəstinə informasiya sızmasını önləmək və orijinal NSL-KDD train-test distribution shift-i qorumaq üçün vacibdir.
Əlavə repeated-seed, resampling, feature-sensitivity və ablation təcrübələri tam 125,973 qeyddən ibarət KDDTrain+ ilə aparılmışdır. SVM 30,000 nümunəlik təlim məhdudiyyəti səbəbindən bu əlavə müqayisələrdən kənarda saxlanılmışdır.
Proqram təminatı və avadanlıq
| Komponent | Versiya / mühit |
|---|---|
| Python | 3.13.5 |
| scikit-learn | 1.8.0 |
| XGBoost | 3.1.3 |
| imbalanced-learn | 0.14.1 |
| NumPy | 2.3.5 |
| pandas | 2.2.3 |
| Əməliyyat mühiti | Linux x86_64, CPU-only |
| CPU | Container üçün əlçatan 56 logical CPU core |
| RAM | Təxminən 4.3 GB |
| GPU | İstifadə olunmayıb |
İlk 1000 KDDTest+ nümunəsi üzərində ayrıca inference latency ölçülmüşdür: Random Forest 0.2609 ms/sample, XGBoost 0.1081 ms/sample, KNN 1.6117 ms/sample və Stacking Ensemble 2.0925 ms/sample. Müəlliflər bu müddətlərin avadanlıqdan asılı olduğunu və yalnız nisbi computational behavior-u təsvir etmək üçün bildirildiyini qeyd edirlər.
Mənbə daxilində inference-latency uyğunsuzluğu
Metod bölməsində yuxarıdakı inference latency dəyərləri açıq şəkildə bildirildiyi halda Section 5.3 məhdudiyyətlər bölməsində tədqiqatın hələ “runtime memory usage, inference latency və ya end-to-end integration” daxil etmədiyi yazılmışdır. Hər iki ifadə eyni nəşr olunmuş mənbədə birlikdə yer aldığı üçün Verianla onlardan birini səssiz şəkildə silmir. Ən təhlükəsiz oxunuş ilk 1000 test nümunəsində məhdud deployment-oriented latency ölçümünün mövcud olması, lakin tam istehsal pipeline-ı üçün runtime/memory/end-to-end performans qiymətləndirilməsinin aparılmamasıdır. Bu son cümlə mənbə daxilindəki iki ifadənin birlikdə şərhidir, yeni eksperiment nəticəsi deyil.
Qiymətləndirmə metrikləri necə oxunmalıdır?
Mənbə metrik adlarından istifadə edir, lakin əsas precision/recall/F1 tənliklərini yenidən törətmir. Aşağıdakı tənliklər tədqiqatın yeni nəticəsi deyil, bildirilmiş metriklərin öyrədici standart tərifləridir.
\[ Recall=\frac{TP}{TP+FN} \]
Recall həqiqətən müvafiq sinfə aid olan nümunələrin nə qədərinin düzgün tutulduğunu ölçür. U2R kimi yüksək təsirli nadir hücumda aşağı recall çox sayda hücumun false negative kimi qaçırılması deməkdir.
\[ Precision=\frac{TP}{TP+FP} \]
Precision modelin müvafiq sinif kimi yaratdığı xəbərdarlıqların nə qədərinin həqiqətən həmin sinfə aid olduğunu ölçür. U2R recall yüksələrkən precision çox aşağı qalırsa analyst alert burden ciddi şəkildə arta bilər.
\[ F1=2\frac{Precision\cdot Recall}{Precision+Recall} \]
F1 precision və recall-u harmonik orta ilə birləşdirir. Komponentlərdən biri çox aşağı olduqda F1 də məhdudlaşır.
\[ MacroF1=\frac{1}{C}\sum_{c=1}^{C}F1_c \]
Macro-F1 bütün siniflərə bərabər çəki verir. Buna görə nadir siniflərdə zəif performansın majority-class uğurunun arxasında gizlənməsinə weighted F1-dən daha az meyllidir.
\[ WeightedF1=\sum_{c=1}^{C}\frac{n_c}{N}F1_c \]
Weighted F1 hər sinfin F1 dəyərini sinif dəstəyi ilə çəkiləndirir. Normal və DoS kimi böyük siniflər nəticəyə daha çox təsir etdiyi üçün nadir sinif problemini təkbaşına izah etmək üçün kifayət deyil.
Tədqiqat buna görə weighted F1 ilə yanaşı macro-F1, balanced accuracy, macro PR-AUC, macro false-positive rate, macro false-negative rate, sinif əsaslı recall, mütləq TP/FP sayları və Wilson 95% confidence interval istifadə edir.
U2R Recall-ın 0.00%-dan 35.82%-ə Yüksəlməsi Nə Deməkdir?
U2R recall-ın 0.00%-dan 35.82%-ə yüksəlməsi əsas stacking təcrübəsində 67 real U2R test nümunəsinin baseline model tərəfindən heç biri tutulmadığı halda cost-sensitive model tərəfindən 24-nün düzgün müəyyən edilməsi deməkdir; lakin eyni struktur çox sayda U2R false positive yaratdığı üçün nəticə “U2R problemi həll edildi” kimi şərh oluna bilməz.
Mütləq say niyə faizdən daha vacibdir?
| Sinif | Test nümunəsi | TP Baseline | TP Cost-Sensitive | Baseline Recall, %95 GA | Cost-Sensitive Recall, %95 GA |
|---|---|---|---|---|---|
| R2L | 2887 | 119 | 151 | 4.12% [3.46%, 4.91%] | 5.23% [4.48%, 6.10%] |
| U2R | 67 | 0 | 24 | 0.00% [0.00%, 5.42%] | 35.82% [25.40%, 47.78%] |
U2R üçün 35.82% böyük faiz artımı kimi görünür, lakin test dəstində cəmi 67 U2R nümunəsi vardır. 24 düzgün aşkarlama buna görə geniş Wilson confidence interval ilə birlikdə bildirilir. Wilson intervalı xüsusilə nümunə kiçik olduqda müşahidə olunan nisbətin qeyri-müəyyənliyini yalnız bir faiz verməkdən daha dürüst şəkildə göstərir.
R2L tərəfində test nümunəsi daha böyükdür. Buna baxmayaraq cost-sensitive struktur yalnız 32 əlavə R2L nümunəsini düzgün təsnif edə bilmişdir. Buna görə R2L artımı repeated-seed testində statistik baxımdan əhəmiyyətli görünsə də, əməliyyat ölçüsü məhduddur.
U2R false-positive yükü
| Ayar | Sinif | TP | FP | FN | Precision | Recall |
|---|---|---|---|---|---|---|
| Baseline | R2L | 119 | 4 | 2768 | 0.9675 | 0.0412 |
| Cost-sensitive | R2L | 151 | 9 | 2736 | 0.9438 | 0.0523 |
| Baseline | U2R | 0 | 0 | 67 | 0.0000 | 0.0000 |
| Cost-sensitive | U2R | 24 | 1695 | 43 | 0.0140 | 0.3582 |
Cost-sensitive stacking artıq U2R-ni tamamilə görməzdən gəlmir; lakin 24 düzgün U2R xəbərdarlığına qarşı 1695 false-positive yaranması precision-ı 1.4% səviyyəsinə endirir. Buna görə mənbə modelin U2R xəbərdarlığını analyst triage üçün istifadə etməyi, yekun avtonom hücum qərarı kimi istifadə etməməyi tövsiyə edir.
R2L niyə hələ də uğursuzdur?
Failure analysis baseline stacking-də 2887 R2L nümunəsinin 2764-nün Normal kimi proqnozlaşdırıldığını göstərir. Class weighting-dən sonra Normal-a gedən say 2269-a düşür; lakin 463 R2L nümunəsi bu dəfə düzgün R2L əvəzinə U2R kimi təsnif olunur. Beləliklə model nadir hücumlara daha həssas hala gəlsə də, kifayət qədər düzgün R2L decision region öyrənə bilmir.
| Ayar | Sinif | Ümumi | Normal proqnozu | R2L proqnozu | U2R proqnozu | FNR |
|---|---|---|---|---|---|---|
| Baseline stacking | R2L | 2887 | 2764 | 119 | 0 | 0.959 |
| Baseline stacking | U2R | 67 | 65 | 2 | 0 | 1.000 |
| Cost-sensitive stacking | R2L | 2887 | 2269 | 151 | 463 | 0.948 |
| Cost-sensitive stacking | U2R | 67 | 40 | 3 | 24 | 0.642 |
25 Xüsusiyyətli MI–RFE Strukturu Ən Yaxşı Proqnoz Performansını Verirmi?
Xeyr. Mənbənin feature-subset sensitivity təhlili 50 xüsusiyyətli və 122 xüsusiyyətli konfiqurasiyaların 25 xüsusiyyətli MI–RFE konfiqurasiyasını weighted F1, R2L recall və U2R recall baxımından üstələdiyini göstərir; 25 xüsusiyyətli strukturun əsaslandırması proqnoz üstünlüyü deyil, daha aşağı ölçü, daha qısa hesablama müddəti və kompaktlıqdır.
| Xüsusiyyət ayarı | Seçim üsulu | Weighted F1 | R2L Recall | U2R Recall | Training Time (s) |
|---|---|---|---|---|---|
| 10 xüsusiyyət | İlk 10 seçilmiş xüsusiyyət | 0.7053 | 0.0173 | 0.1194 | 110.2 |
| 25 xüsusiyyət | MI + RFE | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| 50 xüsusiyyət | MI top 50 | 0.7668 | 0.1888 | 0.5075 | 160.5 |
| 122 xüsusiyyət | Feature selection yoxdur | 0.7625 | 0.1753 | 0.5224 | 243.5 |
50 xüsusiyyətli struktur weighted F1 və R2L recall baxımından ən yaxşı nəticəni verdiyi halda, 122 xüsusiyyətli struktur U2R recall baxımından az fərqlə ən yüksək dəyəri verir. 25 xüsusiyyətli struktur 50 xüsusiyyətli strukturdan yalnız təxminən 9.7 saniyə daha aşağı training time verdiyi halda üç əsas performans göstəricisinin hamısında daha zəifdir. Mənbə buna görə hesablama büdcəsi imkan verirsə 50 xüsusiyyəti daha güclü operating point kimi müəyyən edir.
Tədqiqatın Metodu və Nəticələri
Baseline model nəticələri
| Model | Accuracy | Weighted Precision | Weighted Recall | Weighted F1 | Time (s) |
|---|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7739 | 0.7544 | 0.7055 | 1.4 |
| XGBoost | 0.7504 | 0.8088 | 0.7504 | 0.7039 | 2.9 |
| SVM | 0.7183 | 0.7028 | 0.7183 | 0.6717 | 3.3 |
| KNN | 0.7409 | 0.7815 | 0.7409 | 0.6988 | 0.8 |
| Stacking Ensemble | 0.7542 | 0.8149 | 0.7542 | 0.7120 | 11.7 |
Random Forest ən yüksək baseline accuracy dəyərinə, stacking ensemble isə ən yüksək weighted precision və weighted F1 dəyərinə malikdir. Buna baxmayaraq baseline confusion matrix-ləri R2L və U2R-nin tez-tez Normal kimi proqnozlaşdırıldığını göstərir. Buna görə tədqiqatın əsas arqumenti “stacking onsuz da güclüdür” deyil, aggregate skorların nadir sinif uğursuzluğunu gizlədə bilməsidir.
Cost-sensitive learning model əsasında nəyi dəyişdi?
| Model | Accuracy Baseline | Accuracy CW | F1 Baseline | F1 CW |
|---|---|---|---|---|
| Random Forest | 0.7544 | 0.7533 | 0.7055 | 0.7074 |
| XGBoost | 0.7504 | 0.7648 | 0.7039 | 0.7237 |
| SVM | 0.7183 | 0.7611 | 0.6717 | 0.7423 |
| KNN | 0.7409 | 0.7409 | 0.6988 | 0.6988 |
| Stacking Ensemble | 0.7542 | 0.7342 | 0.7120 | 0.7214 |
SVM weighted F1 baxımından ən böyük qlobal qazancı göstərir: 0.6717-dən 0.7423-ə, yəni 7.06 percentage point artım. Lakin SVM tam KDDTrain+ üzərində deyil, computational feasibility səbəbindən 30,000 nümunəlik stratified subset üzərində öyrədilmişdir. Buna görə SVM nəticəsi tam məlumatla işləyən stacking/resampling təcrübələri ilə metod baxımından tam ekvivalent deyil.
Stacking ensemble-ın accuracy dəyərinin 0.7542-dən 0.7342-yə düşməsinə baxmayaraq weighted F1-in 0.7120-dan 0.7214-ə yüksəlməsi class weighting-in çoxluq sinfindəki bəzi düzgün qərarları qurban verərək nadir siniflər üçün daha çox qərar sahəsi açdığını göstərir.
Stacking ensemble sinif əsasında necə dəyişdi?
| Sinif | Baseline Recall | Cost-Sensitive Recall | Dəyişiklik |
|---|---|---|---|
| DoS | 79.24% | 80.17% | +0.93% |
| Normal | 97.15% | 91.45% | −5.69% |
| Probe | 63.57% | 62.66% | −0.91% |
| R2L | 4.12% | 5.23% | +1.11% |
| U2R | 0.00% | 35.82% | +35.82% |
U2R-nin görünürlüğü artarkən Normal recall 5.69 percentage point azalır. Bu trade-off xəta deyil, class weighting-in qərar sərhədini şüurlu şəkildə dəyişdirməsinin nəticəsidir. Təhlükəsizlik baxımından bunun qəbul edilə bilib-bilməməsi qaçırılan privilege-escalation hadisəsinin xərci ilə əlavə false-positive araşdırma xərcinin müqayisəsindən asılıdır.
Cost-Sensitive Learning Resampling Üsullarından Daha Yaxşıdırmı?
Xeyr; tədqiqat cost-sensitive learning-in bütün imbalance üsullarından üstün olduğunu göstərmir. Eyni 125,973 nümunəlik KDDTrain+ protokolunda ADASYN ən yüksək weighted F1 və R2L recall dəyərlərini yaratdığı halda cost-sensitive weighting bu müqayisədə ən yüksək U2R recall dəyərini və təlim paylanmasını sintetik məlumatla dəyişdirməmək üstünlüyünü təmin etmişdir.
| Üsul | Məlumat səviyyəsi dəyişikliyi | Weighted F1 | R2L Recall | U2R Recall | Total Time (s) |
|---|---|---|---|---|---|
| Baseline | Yoxdur | 0.7120 | 0.0412 | 0.0000 | 155.8 |
| Cost-sensitive weights | Sintetik məlumat yoxdur | 0.7214 | 0.0523 | 0.3582 | 150.8 |
| SMOTE | Sintetik oversampling | 0.7083 | 0.0450 | 0.0597 | 740.9 |
| Borderline-SMOTE | Boundary-focused oversampling | 0.7273 | 0.0551 | 0.0448 | 686.4 |
| ADASYN | Adaptive synthetic oversampling | 0.7478 | 0.0901 | 0.1343 | 680.2 |
| SMOTE-Tomek | Oversampling + Tomek cleaning | 0.7065 | 0.0433 | 0.0597 | 654.0 |
Bu müqayisədə ADASYN weighted F1 = 0.7478 və R2L recall = 0.0901 ilə cost-sensitive stacking-i üstələyir. Buna qarşı cost-sensitive stacking U2R recall = 0.3582 ilə bu dörd resampling üsulundan daha güclüdür və training distribution-ı sintetik nümunələrlə dəyişdirmir.
Daha geniş exploratory baseline-lar
| Üsul | W-F1 | Macro-F1 | Balanced Accuracy | PR-AUC | R2L Recall | U2R Recall | U2R FP |
|---|---|---|---|---|---|---|---|
| Cost-sensitive stacking | 0.7214 | 0.5023 | 0.5507 | 0.5787 | 0.0523 | 0.3582 | 1695 |
| Balanced Random Forest | 0.7268 | 0.5455 | 0.5927 | 0.6469 | 0.2123 | 0.4627 | 427 |
| XGBoost threshold calibration | 0.7466 | 0.5603 | 0.5692 | 0.6900 | 0.1493 | 0.2537 | 188 |
| Focal-loss MLP | 0.7339 | 0.5640 | 0.5981 | 0.6105 | 0.2224 | 0.3134 | 429 |
Bu genişləndirilmiş müqayisə əsas iddianın sərhədini daha da aydın göstərir. Cost-sensitive stacking U2R görünürlüğünü baseline-a nisbətən artırır; lakin Balanced Random Forest həm U2R recall, həm də R2L recall baxımından daha güclüdür və U2R false-positive sayı xeyli aşağıdır. XGBoost threshold calibration isə ən aşağı U2R false-positive sayını 188-ə endirərkən U2R recall 0.2537-də qalır. Buna görə tədqiqat “təklif olunan struktur bütün alternativlərdən daha yaxşıdır” nəticəsini dəstəkləmir.
Repeated-seed statistik testləri
Stoxastik dəyişkənliyin tək random seed nəticəsindən asılı qalmaması üçün 10 seed istifadə edilmişdir: {0, 1, 2, 3, 4, 5, 10, 21, 42, 100}. Baseline və cost-sensitive stacking üçün paired müqayisələrdə Wilcoxon signed-rank; birdən çox model ailəsi üçün Friedman testi istifadə edilmişdir. Əhəmiyyətlilik həddi p < 0.05-dir.
| Müqayisə | Metrik | Test | p-value | Mənbə şərhi |
|---|---|---|---|---|
| Cost-sensitive stacking vs baseline | Weighted F1 | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | U2R recall | Wilcoxon | 0.0020 | Significant |
| Cost-sensitive stacking vs baseline | R2L recall | Wilcoxon | 0.0039 | Significant |
| Bütün cost-sensitive model ailələri | Weighted F1 | Friedman | 0.0018 | Significant |
Buradakı “statistically significant” ifadəsi fərqin böyüklüyünün əməliyyat baxımından kifayət qədər olduğu demək deyil. R2L nümunəsi bunu açıq şəkildə göstərir: repeated-seed testində fərq statistik baxımdan əhəmiyyətlidir, lakin əsas şərtdə recall yalnız 4.12%-dən 5.23%-ə və TP 119-dan 151-ə yüksəlmişdir. Statistik əhəmiyyətliliklə praktik təhlükəsizlik təsiri fərqli suallardır.
Component ablation nə göstərir?
| Variant | W-F1 | Macro-F1 | Balanced Accuracy | Macro PR-AUC | R2L Recall | U2R Recall |
|---|---|---|---|---|---|---|
| Baseline stack, class weighting yoxdur | 0.712 | 0.492 | 0.488 | 0.608 | 0.041 | 0.000 |
| CW-only XGBoost | 0.752 | 0.594 | 0.571 | 0.750 | 0.091 | 0.209 |
| Stacking, feature selection yoxdur | 0.763 | 0.577 | 0.642 | 0.694 | 0.175 | 0.522 |
| MI-only XGBoost | 0.743 | 0.595 | 0.570 | 0.720 | 0.086 | 0.284 |
| RFE-only XGBoost | 0.711 | 0.510 | 0.500 | 0.670 | 0.044 | 0.075 |
| Stacking çıxarıldı | 0.715 | 0.509 | 0.501 | 0.674 | 0.037 | 0.060 |
| Tam 25-feature framework | 0.721 | 0.502 | 0.551 | 0.579 | 0.052 | 0.358 |
Ablation-un ən vacib nəticəsi U2R visibility artımının əsas hərəkətverici qüvvəsinin class weighting olmasıdır. Class weighting çıxarıldıqda U2R recall yenidən sıfıra düşür. Bununla yanaşı feature reduction xərcsiz deyil: feature selection aparılmayan stacking variantı weighted F1, balanced accuracy, R2L recall və U2R recall baxımından tam 25-feature framework-ü üstələyir.
Beləliklə hibrid feature selection-ın elmi rolu “daha yüksək accuracy yaratmaq” deyil, daha kiçik və daha hesablama-səmərəli feature space əldə etmək kimi şərh olunmalıdır.
Weighted F1 niyə təkbaşına kifayət deyil?
| Ayar | Accuracy | Weighted F1 | Macro-F1 | Balanced Accuracy | Macro FPR | Macro FNR | R2L | U2R |
|---|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.754 | 0.712 | 0.492 | 0.488 | 0.084 | 0.512 | 0.041 | 0.000 |
| Cost-sensitive stacking | 0.734 | 0.721 | 0.502 | 0.551 | 0.080 | 0.449 | 0.052 | 0.358 |
Macro FNR-nin 0.512-dən 0.449-a düşməsi nadir sinif görünürlüğündəki artımla uyğundur, lakin 0.449 hələ də yüksək qaçırma nisbətidir. Mənbə bunu production NIDS baxımından həll olunmuş problem kimi qiymətləndirmir.
PR-AUC niyə ayrıca hesablandı?
Precision–Recall Area Under the Curve (PR-AUC), xüsusilə pozitiv sinfin çox nadir olduğu problemlərdə modelin müxtəlif qərar eşiklərində precision və recall arasında necə sıralama etdiyini qiymətləndirməyə kömək edir. U2R-nin KDDTest+ daxilində prevalence dəyəri cəmi 0.0030 olduğu üçün hard-label recall təkbaşına ehtimal sıralamasının keyfiyyətini izah etmir.
| Sinif | Baseline | Cost-Sensitive |
|---|---|---|
| DoS | 0.9448 | 0.9636 |
| Normal | 0.9541 | 0.8066 |
| Probe | 0.8034 | 0.7660 |
| R2L | 0.3280 | 0.3449 |
| U2R | 0.0092 | 0.0126 |
U2R PR-AUC 0.0092-dən 0.0126-ya yüksəlmişdir. Mənbə bunu prevalence baseline-ın təxminən 3.1 və 4.2 qatı kimi ifadə edir. Buna baxmayaraq 0.0126 mütləq olaraq çox aşağı ranking-quality səviyyəsidir; müəlliflər də U2R-ni tədqiqatın mərkəzi çətinliklərindən biri olaraq saxlayırlar.
U2R threshold dəyişdirildikdə nə baş verir?
| Threshold τ | U2R TP / 67 | U2R Recall | U2R FP | Precision |
|---|---|---|---|---|
| 0.05 | 59 | 0.881 | 6608 | 0.0088 |
| 0.10 | 45 | 0.672 | 3796 | 0.0117 |
| 0.30 | 24 | 0.358 | 2180 | 0.0109 |
| 0.50 | 14 | 0.209 | 1666 | 0.0083 |
| 0.70 | 11 | 0.164 | 1312 | 0.0083 |
| 0.90 | 11 | 0.164 | 953 | 0.0114 |
Eşik aşağı salındıqda daha çox U2R tutulur, lakin false-positive sayı minlərlə səviyyəsinə yüksəlir. Eşik qaldırıldıqda xəbərdarlıq yükü azalır, lakin recall da düşür. U2R precision göstərilən bütün operating point-lərdə təxminən %1 civarındadır.
Table 14-dəki hard-label cost-sensitive U2R nəticəsi 24 TP və 1695 FP olduğu halda threshold table-dakı \(\tau=0.30\) nəticəsi eyni 24 TP üçün 2180 FP-dir. Bu iki say ziddiyyət deyil: hard-label model normal multi-class qərarından istifadə etdiyi halda threshold experiment U2R ehtimalı müəyyən olunmuş \(\tau\) dəyərini keçdikdə sinfi məcburi şəkildə U2R kimi təyin edən fərqli operating rule istifadə edir.
Alert-budget təhlili
| Analitik xəbərdarlıq büdcəsi | Tutulan real U2R / 67 |
|---|---|
| Top 100 xəbərdarlıq | 4 |
| Top 500 xəbərdarlıq | 6 |
| Top 1000 xəbərdarlıq | 11 |
Bu nəticə modelin U2R skorunun analyst prioritization baxımından müəyyən qədər informasiya daşıdığını, lakin təkbaşına yüksək etibarlı avtomatik qərar üçün kifayət qədər precision təmin etmədiyini göstərir.
UNSW-NB15 Xarici Doğrulaması Nə Göstərir?
UNSW-NB15 xarici doğrulaması dataset-ə xüsusi tuning aparılmadan eyni preprocessing, MI→RFE, stacking və balanced class-weighting məntiqinin dörd nadir hücum kateqoriyasının recall dəyərini güclü şəkildə yüksəldə bildiyini; lakin bunun Normal recall və weighted F1 itkisi hesabına baş verdiyini göstərir, buna görə xarici doğrulama nadir-sinif trade-off-un daşındığını dəstəkləyir, lakin istehsal şəbəkələrində ümumi üstünlüyü sübut etmir.
Xarici məlumat dəsti protokolu
UNSW-NB15-in rəsmi training partition-ı 175,341, testing partition-ı 82,332 qeyddir və standart on sinifli taxonomy istifadə edilmişdir. İstifadə olunan public mirror-da record identifier ilə sttl, dttl və altı ct_* connection-counter xüsusiyyəti çıxarılmış; qalan 31 numeric və üç categorical xüsusiyyət eyni pipeline ilə işlənmişdir.
proto, service və state one-hot encode edilmiş; Min-Max scaler yalnız training partition-a fit edilmiş; MI ilə 50 xüsusiyyət saxlanmış; RFE ilə 25-ə endirilmiş və eyni stacking architecture balanced class weights ilə istifadə edilmişdir. Mənbə xüsusilə UNSW-specific tuning aparılmadığını bildirir.
| Konfiqurasiya | Weighted F1 | Macro-F1 | Balanced Accuracy | Analysis Recall | Backdoor Recall | Shellcode Recall | Worms Recall |
|---|---|---|---|---|---|---|---|
| Baseline stacking | 0.8096 | 0.5007 | 0.4856 | 0.0000 | 0.0583 | 0.5291 | 0.1818 |
| Cost-sensitive stacking | 0.7509 | 0.4780 | 0.6696 | 0.2496 | 0.6930 | 0.9550 | 0.8864 |
| Cost-sensitive XGBoost | 0.7488 | 0.5137 | 0.6392 | 0.1300 | 0.5798 | 0.9233 | 0.7273 |
Cost-sensitive stacking ilə Worms 18.18%-dən 88.64%-ə yüksəlir və 44 Worms nümunəsinin 39-u düzgün müəyyən edilir. Shellcode 52.91%-dən 95.50%-ə, Backdoor 5.83%-dən 69.30%-a, Analysis isə 0.00%-dan 24.96%-a yüksəlir.
Bunun müqabilində Normal recall 91.74%-dən 64.22%-ə və weighted F1 0.8096-dan 0.7509-a düşür. Balanced accuracy 0.4856-dan 0.6696-ya yüksəlir. Bu, tədqiqatın əsas təhlükəsizlik trade-off-unun başqa məlumat dəstindəki qarşılığıdır: majority-class ümumi uğuru azalarkən az təmsil olunan hücumlar daha görünən hala gəlir.
Cost-sensitive modelin class-level PR-AUC dəyəri Worms üçün 0.5903, Shellcode üçün 0.3939 kimi bildirilmişdir. Bunlar NSL-KDD U2R PR-AUC = 0.0126 dəyərindən xeyli güclü rare-class ranking davranışı göstərir.
Tədqiqatın dəstəklədiyi nəticələr
- Balanced class weighting orijinal training observations dəyişdirilmədən bəzi nadir hücum siniflərinin recall dəyərini artırmışdır.
- NSL-KDD əsas təcrübəsində stacking U2R recall 0.00%-dan 35.82%-ə yüksəlmişdir.
- Weighted F1, U2R recall və R2L recall artımları repeated-seed paired Wilcoxon testlərində
p < 0.05səviyyəsində əhəmiyyətlidir. - R2L nəticəsi statistik olaraq dəyişsə də, mütləq əməliyyat yaxşılaşması məhduddur.
- Class weighting U2R visibility-nin əsas hərəkətverici komponentidir.
- 25-feature MI–RFE strukturu kompaktlıq təmin edir, lakin maksimum proqnoz performansını vermir.
- ADASYN bəzi qlobal və R2L metriklərində cost-sensitive stacking-i üstələyir.
- Balanced Random Forest genişləndirilmiş müqayisədə U2R və R2L recall baxımından cost-sensitive stacking-dən daha güclüdür.
- UNSW-NB15 xarici doğrulaması nadir sinif recall artımının başqa benchmark-da da ortaya çıxdığını göstərir.
- Nadir sinif recall artımı majority-class recall, weighted F1 və ya false-positive yükündə xərc yarada bilər.
Tədqiqatın dəstəkləmədiyi nəticələr
- Framework bütün nadir hücumları etibarlı şəkildə həll edən ümumi NIDS deyil.
- R2L problemi həll olunmayıb.
- U2R üçün 35.82% recall yüksək-precision avtonom hücum aşkarlanması demək deyil.
- 25 xüsusiyyətli feature set-in bütün məlumat dəstlərində və ya bütün hücum növlərində optimal olduğu göstərilməyib.
- Cost-sensitive learning-in SMOTE, ADASYN, Balanced Random Forest, focal loss və ya threshold calibration-dan universal üstün olduğu göstərilməyib.
- NSL-KDD və UNSW-NB15 nəticələri müasir encrypted, cloud-native və IoT istehsal trafikinin hamısını təmsil etmir.
- Canlı SOC və ya production packet/flow collector üzərində end-to-end deployment doğrulaması aparılmayıb.
- Explainability üçün SHAP və ya counterfactual analysis mövcud framework-ə tətbiq olunmayıb.
- CICIDS2017/2018 və TON_IoT üzərində bu tədqiqatda tamamlanmış validation yoxdur.
- Statistik əhəmiyyətlilik təkbaşına əməliyyat usefulness və ya uyğun alert budget zəmanəti deyil.
Məhdudiyyətlər
Benchmark yaşı: NSL-KDD nəzarətli müqayisə üçün faydalıdır, lakin müasir encrypted traffic, cloud workloads, IoT protocols və müasir hücum kampaniyalarını tam təmsil etmir.
R2L overlap: R2L ilə Normal arasındakı feature-space oxşarlığı class weighting ilə həll olunmayıb.
SVM təlim məhdudiyyəti: SVM yalnız 30,000 stratified training nümunəsində işlədilmişdir; tam KDDTrain+ ilə işləyən modellərlə müqayisədə bu sərhəd nəzərə alınmalıdır.
False-positive yükü: U2R görünürlüğü artarkən precision çox aşağı qala bilər. İstehsal mühitində threshold calibration və analyst capacity kritik hala gəlir.
Explainability: SHAP və ya counterfactual analysis kimi izaholunma qatı əlavə edilməmişdir.
External validity: UNSW-NB15 xarici doğrulaması tək-məlumat-dəsti problemini azaldıb, lakin tam aradan qaldırmır.
Canlı deployment: End-to-end live flow collector, SOC inteqrasiyası və production network davranışı sınaqdan keçirilməyib.
Mənbə-daxili latency ifadəsi: Metod bölməsində məhdud inference-latency ölçümü olmasına baxmayaraq məhdudiyyətlər bölməsində inference latency-nin hələ qiymətləndirilmədiyini bildirən ifadə qalır.
Gələcək tədqiqat istiqamətləri
Mənbə gələcəkdə CICIDS2017, CSE-CIC-IDS2018 və TON_IoT üzərində eyni ablation və confidence-interval protokolunun tətbiqini; adaptive cost schedule, probability calibration, held-out validation ilə threshold calibration, SHAP əsaslı interpretability, focal-loss modellərinin controlled false-positive budget altında müqayisəsini və Balanced Random Forest/EasyEnsemble kimi üsulların qiymətləndirilməsini təklif edir.
Həmçinin CICFlowMeter və ya Zeek kimi flow collector-larla real-time deployment doğrulaması təklif edilir. Bunlar mövcud tədqiqatın tamamlanmış nəticələri deyil, gələcək tədqiqat təklifləridir.
Mənbə və Metod Qeydi
Özgün başlıq: Cost-Sensitive Stacking Ensemble with Hybrid Feature Selection for Rare Attack Detection in Network Intrusion Detection Systems
Müəlliflər və sıra: Ioan Corneliu Salisteanu; Iulian Udroiu; Andrei Cosmin Gheorghe; Ionut Adrian Tudoroiu; Emil Mihai Diaconu.
Corresponding author: Andrei Cosmin Gheorghe.
Corresponding e-poçt: andrei.gheorghe@valahia.ro
Qurum: Faculty of Electrical Engineering, Electronics and Information Technology, University “Valahia” of Targoviste, 130004 Targoviste, Romania.
Bərabər töhfə / bərabər birinci müəlliflik: Mənbədə bərabər töhfə bəyanatı yoxdur.
Academic Editor: Emre Tokgoz.
Jurnal: Electronics.
Nəşriyyat: MDPI, Basel, Switzerland.
ISSN: 2079-9292.
Cild / nömrə: Volume 15, Issue 14.
Məqalə nömrəsi: 3094.
Nəşr ili: 2026.
Məqalə növü: Article; nəzarətli benchmark əsaslı eksperimental maşın öyrənməsi/NIDS qiymətləndirmə tədqiqatı.
DOI: 10.3390/electronics15143094.
Rəsmi keçid: https://doi.org/10.3390/electronics15143094
Received: 2 İyun 2026.
Revised: 10 İyul 2026.
Accepted: 13 İyul 2026.
Published: 14 İyul 2026.
Hakemlik statusu: Electronics MDPI-nin rəsmi qeydində international, peer-reviewed və open-access journal kimi müəyyən edilir.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint statusu: Araşdırılan mənbə nəşr olunmuş jurnal məqaləsidir; PDF ayrıca preprint identifikatoru göstərmir.
Əsas tədqiqat problemi: Ümumi accuracy-nin ciddi class imbalance şəraitində rare/high-impact attack uğursuzluğunu gizlədə bilməsi.
Metodoloji töhfənin sərhədi: MI, RFE, stacking və ya balanced class weighting komponentləri ayrı-ayrılıqda yeni alqoritmlər deyil. Tədqiqatın töhfəsi onların rare-class-focused, statistically audited və data-preserving qiymətləndirmə protokolunda nəzarətli inteqrasiyasıdır.
Əsas məlumat dəsti: NSL-KDD; KDDTrain+ = 125,973 qeyd, KDDTest+ = 22,544 qeyd.
External validation: UNSW-NB15; official train = 175,341, test = 82,332 qeyd; dataset-specific tuning aparılmayıb.
NSL-KDD sinifləri: Normal, DoS, Probe, R2L və U2R.
Preprocessing: protocol_type, service və flag üçün one-hot encoding; 41 orijinal attribute → 122 ədədi feature; training-fit Min-Max scaling [0,1]; difficulty_level çıxarılmışdır.
Feature selection: MI ilə 122 → 50, Random Forest əsaslı RFE ilə 50 → 25.
Feature-selection şərh sərhədi: 25-feature struktur ən yüksək performans nöqtəsi deyil; 50-feature və bəzi no-feature-selection variantları daha yüksək proqnoz metrikləri yaratmışdır.
Fərdi modellər: Random Forest, XGBoost, SVM və KNN.
Stacking: Random Forest + XGBoost + KNN base learner; Logistic Regression meta-learner; 3-fold out-of-fold prediction.
SVM sərhədi: 30,000 stratified training nümunəsi; digər full-training əlavə təcrübələrlə birbaşa ekvivalent deyil.
Cost-sensitive düstur: \(w_c=N/(C n_c)\).
Approximate class weights: Normal 0.37; DoS 0.55; Probe 2.16; R2L 25.32; U2R 484.49.
Resampling əsas framework-də istifadə edilibmi? Xeyr. Əsas cost-sensitive framework original training observations-ı qoruyur. SMOTE, Borderline-SMOTE, ADASYN və SMOTE-Tomek ayrıca experimental baseline-lardır.
Random seeds: 0, 1, 2, 3, 4, 5, 10, 21, 42, 100.
Statistical tests: Wilcoxon signed-rank və Friedman; significance threshold p < 0.05.
Əsas U2R nəticəsi: 0/67 → 24/67; recall 0.00% → 35.82%; Wilson %95 GA 25.40%–47.78% cost-sensitive halda.
Əsas R2L nəticəsi: 119/2887 → 151/2887; recall 4.12% → 5.23%.
Əsas weighted-F1 nəticəsi: Stacking 0.7120 → 0.7214.
Əsas accuracy trade-off: Stacking 0.7542 → 0.7342.
U2R hard-label precision: Cost-sensitive stacking 24 TP, 1695 FP, precision 0.0140.
U2R probability-level nəticəsi: PR-AUC 0.0092 → 0.0126; prevalence 0.0030.
Repeated-seed p-values: Weighted F1 p = 0.0020; U2R recall p = 0.0020; R2L recall p = 0.0039; Friedman weighted-F1 comparison p = 0.0018.
25-feature sensitivity: Weighted F1 = 0.7214; R2L = 0.0523; U2R = 0.3582; training time = 150.8 s.
50-feature sensitivity: Weighted F1 = 0.7668; R2L = 0.1888; U2R = 0.5075; training time = 160.5 s.
122-feature sensitivity: Weighted F1 = 0.7625; R2L = 0.1753; U2R = 0.5224; training time = 243.5 s.
Software: Python 3.13.5; scikit-learn 1.8.0; XGBoost 3.1.3; imbalanced-learn 0.14.1; NumPy 2.3.5; pandas 2.2.3.
Avadanlıq/mühit: Linux x86_64, CPU-only, 56 logical CPU core available to container, təxminən 4.3 GB RAM; GPU istifadə olunmayıb.
İlk 1000 KDDTest+ inference latency: Random Forest 0.2609 ms/sample; XGBoost 0.1081 ms/sample; KNN 1.6117 ms/sample; Stacking 2.0925 ms/sample. Mənbə bunları hardware-dependent relative computational values kimi məhdudlaşdırır.
Mənbə-daxili latency qeydi: Section 3.6 inference latency dəyərləri verdiyi halda Section 5.3 inference latency-nin hələ daxil edilmədiyini bildirir. Hər iki ifadə mənbədə birlikdə mövcud olduğuna görə bu fərq qorunmuşdur.
External-validation trade-off: UNSW-NB15-də cost-sensitive stacking balanced accuracy 0.4856 → 0.6696 yüksəldiyi halda weighted F1 0.8096 → 0.7509 və Normal recall 91.74% → 64.22% azalmışdır.
UNSW rare-class recall: Analysis 0.00% → 24.96%; Backdoor 5.83% → 69.30%; Shellcode 52.91% → 95.50%; Worms 18.18% → 88.64%.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
Data Availability: NSL-KDD açıq benchmark-dır. Mənbə həmçinin preprocessing, MI–RFE feature selection, training, imbalance baselines, statistical tests və figure generation üçün Python script-lərini ehtiva edən supplementary reproducibility package olduğunu bildirir. Kommersiya və ya özəl production network trace istifadə olunmayıb.
Müəllif töhfələri: Conceptualization — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe, Ioan Corneliu Salisteanu və Iulian Udroiu; methodology — Ioan Corneliu Salisteanu, Andrei Cosmin Gheorghe və Iulian Udroiu; software — Ionut Adrian Tudoroiu və Andrei Cosmin Gheorghe; validation — Ionut Adrian Tudoroiu, Andrei Cosmin Gheorghe və Emil Mihai Diaconu; formal analysis — Andrei Cosmin Gheorghe; investigation — Emil Mihai Diaconu; resources və data curation — Ionut Adrian Tudoroiu; original draft — Ionut Adrian Tudoroiu; review/editing — Andrei Cosmin Gheorghe; visualization — Ioan Corneliu Salisteanu və Iulian Udroiu; supervision — Ioan Corneliu Salisteanu, Iulian Udroiu və Andrei Cosmin Gheorghe.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan edirlər.
Əsas metodoloji sərhəd: Nəticələr nəzarətli NSL-KDD və UNSW-NB15 benchmark analizidir; real SOC, production network və ya canlı flow collector üzərində end-to-end doğrulama deyil.
Gələcək doğrulama: CICIDS2017, CSE-CIC-IDS2018, TON_IoT, threshold/probability calibration, SHAP, controlled false-positive budgets, Balanced Random Forest/EasyEnsemble və live CICFlowMeter/Zeek inteqrasiyası.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib