


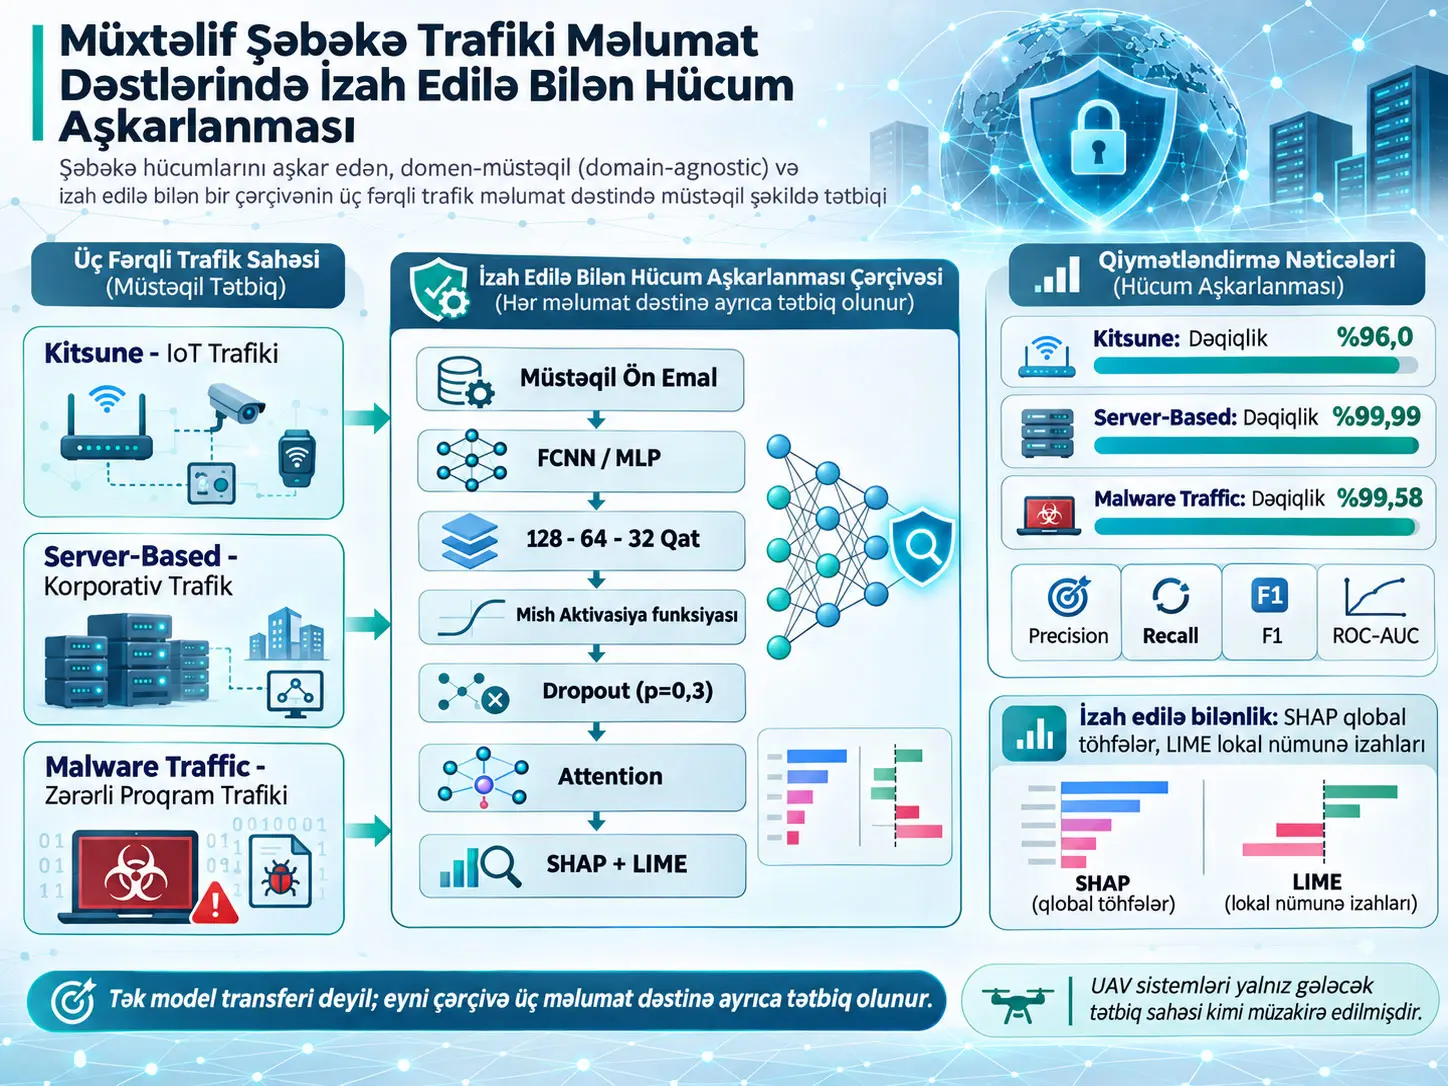
Domen-müstəqil izah edilə bilən şəbəkə hücumlarının aşkarlanması çərçivəsi, eyni məlumat hazırlama və Fully Connected Neural Network (FCNN) modelləşdirmə məntiqini IoT, korporativ server və zərərli proqram trafiki kimi müxtəlif şəbəkə məlumat domenlərinə ayrı-ayrılıqda tətbiq edən və model qərarlarını SHapley Additive exPlanations (SHAP) və Local Interpretable Model-Agnostic Explanations (LIME) vasitəsilə izah etməyi hədəfləyən nəzarətli şəbəkə hücumlarının təsnifatı yanaşmasıdır. Tədqiqatda Kitsune, Server-Based və Malware Traffic məlumat dəstləri müstəqil şəkildə emal edilmiş; ədədi və kateqorik xüsusiyyətlər hazırlanmış; 128, 64 və 32 neyronlu tam əlaqəli qatlar, Mish aktivləşməsi, dropout və attention ehtiva edən model istifadə edilmişdir. Mənbə Kitsune üçün %96,0, Server-Based məlumat dəsti üçün %99,99 və Malware Traffic üçün %99,58 accuracy bildirir.
“Domain-agnostic” ifadəsi bu tədqiqatda bir məlumat dəstində öyrədilmiş modelin başqa məlumat dəstinə birbaşa transfer edilməsi demək deyil. Müəllif nəticə bölməsində cross-dataset transfer learning göstərmədiyini; eyni modelləşdirmə boru xəttinin üç fərqli şəbəkə mühitinə müstəqil tətbiqini qiymətləndirdiyini açıq şəkildə bildirir. Buna görə tədqiqat ortaq metod arxitekturasının müxtəlif məlumat domenlərində istifadə oluna bilməsinə dair sübut təqdim edir, lakin domenlər arasında təlim aparmadan birbaşa model transferini təsdiqləmir.
Kitsune nəticəsi ümumi accuracy baxımından güclü olsa da, siniflər üzrə bərabər deyil. Table 3-də Class 2 üçün precision 0,72, recall 0,76 və F1 0,74; Class 4 üçün precision 0,75, recall 0,69 və F1 0,72 bildirilib. Server-Based və Malware Traffic nəticələri daha yüksək ayrışma göstərir. Buna görə yüksək ümumi accuracy dəyərləri bütün hücum siniflərinin qüsursuz aşkarlandığı kimi şərh edilməməlidir.
SHAP analizi sabit 100 validation nümunəsi üzərində aparılmış; LIME isə hər məlumat dəstində yalnız bir təmsilçi validation nümunəsinə və ən çox 10 izahlı xüsusiyyətə tətbiq edilmişdir. Mənbə bu izah edilə bilənlik alətlərini real vaxtda hər paket üçün işləyən inference komponenti kimi deyil, offline forensic analysis və post-incident investigation məqsədilə mövqeləndirir.
UAV təhlükəsizliyi məqalənin faktiki eksperimental sahəsi deyil. Tədqiqatda UAV telemetry, GPS dəyişkənliyi, RF communication pattern və ya flight log istifadə edilməyib. UAV sistemləri yalnız gələcəkdə metodun sınaqdan keçirilə biləcəyi potensial tətbiq sahəsi kimi müzakirə edilib.
“Domain-Agnostic” Bu Tədqiqatda Nə Deməkdir?
Bu tədqiqatda “domain-agnostic”, eyni ümumi preprocessing və FCNN əsaslı modelləşdirmə boru xəttinin Kitsune IoT trafiki, Server-Based korporativ trafik və Malware Traffic məlumatlarına məlumat dəstinə xas yeni model arxitekturası hazırlanmadan ayrı-ayrılıqda tətbiq edilməsi deməkdir; tədqiqat bir dəfə öyrədilmiş modelin müxtəlif məlumat dəstləri arasında transfer edildiyini və ya ortaq cross-dataset model üzərində sınaq aparıldığını göstərmir.
Tədqiqat problemi
Tədqiqatın başlanğıc nöqtəsi iki problemdir. Birincisi, intrusion detection modellərinin çoxunun bir məlumat dəstinə və müəyyən trafik paylanmasına uyğun hazırlanması səbəbindən fərqli şəbəkə mühitlərində eyni performansı qoruya bilməməsidir. İkincisi, yüksək dəqiqlik yaradan dərin öyrənmə sistemlərinin niyə müəyyən hücum qərarına gəldiyini izah etməkdə çətinlik çəkməsidir.
Bu iki problem xüsusilə təhlükəsizlik analitiklərinin yalnız alarm etiketi deyil, qərara hansı trafik xüsusiyyətlərinin təsir etdiyini də görmək istədiyi kritik sistemlərdə əhəmiyyətlidir. Buna görə tədqiqat təsnifatı və post-hoc izah edilə bilənliyi eyni qiymətləndirmə çərçivəsində nəzərdən keçirir.
Tədqiqatın üç məlumat domeni
| Məlumat dəsti | Şəbəkə domeni | Eksperimentdə istifadə olunan nümunə | Xüsusiyyət sayı | Sinif sayı |
|---|---|---|---|---|
| Kitsune | IoT şəbəkə trafiki | 9.000; orijinal məlumat 20 milyondan çox nümunə ehtiva edir | 115 | 9: 8 hücum + 1 benign |
| Server-Based | Korporativ/server trafiki | 225.398; məlumat dəstinin hamısı | 27 | 3 |
| Malware Traffic | Zərərli proqram kommunikasiya trafiki | 644.602; orijinal məlumat 25 milyondan çox nümunə ehtiva edir | 23 | 5 |
Kitsune məlumat dəsti IoT əsaslı trafik və ARP spoofing, Mirai botnet və denial-of-service kimi hücum davranışlarını əhatə edir. Mənbə 20 milyondan çox orijinal nümunədən 9.000 nümunəlik təmsilçi alt dəstin seçildiyini bildirir. Lakin bu 9.000 nümunənin dəqiq seçim alqoritmini və ya hər sinif üzrə dəqiq nümunə götürmə prosedurunu ətraflı vermir.
Malware Capture Facility mənşəli məlumat 25 milyondan çox qeyddən ibarətdir. Tədqiqatda 644.602 qeyd istifadə edilmişdir. Bu məlumat command-and-control kommunikasiyası, ransomware fəaliyyəti və digər malware-driven network behavior nümunələrini əhatə edir.
Server-Based məlumat dəsti 225.398 nümunə, 27 xüsusiyyət və üç sinifdən ibarətdir. Mənbə burada HTTP flooding, SSH brute-force və SQL injection kimi server tərəfli hücum nümunələrindən bəhs edir.
Çatışmayan dəyərlər necə tamamlanır?
Ədədi xüsusiyyətlərdə çatışmayan dəyərlər müvafiq sütunun orta qiyməti ilə doldurulur. Kateqorik xüsusiyyətlərdə isə ən çox rast gəlinən kateqoriya, yəni mode istifadə olunur. Orta qiymətlə tamamlama ədədi dəyişənin mərkəzi dəyərini qorumağı hədəfləyir, mode ilə tamamlama isə kateqorik dəyişəndə ən geniş yayılmış sinifdən istifadə edir.
Bu üsullar çatışmayan dəyər problemini aradan qaldırır; lakin çatışmayan məlumat mexanizminin niyə yarandığını modelləşdirmir. Mənbə missingness mechanism üçün ayrıca analiz bildirmir.
“Standard scaling ilə [0,1]” ifadəsinə necə yanaşılmalıdır?
Mənbə ədədi xüsusiyyətlərin “Standard scaling” istifadə edilərək [0,1] intervalına gətirildiyini iki ayrı yerdə ifadə edir. Verianla bu ifadəni səssizcə başqa scaler adına çevirmir. Buna görə etibarlı nəticə yalnız budur: mənbə ədədi xüsusiyyətlərin miqyaslandığını və nəticə intervalını [0,1] kimi təsvir edir; istifadə olunan scaler-in proqram səviyyəsində dəqiq sinfi yayımlanmış mətndən etibarlı şəkildə yenidən müəyyən edilə bilməz.
Kateqorik xüsusiyyətlər necə kodlaşdırılır?
Nominal və təbii sıralaması olmayan kateqoriyalar üçün one-hot encoding istifadə edilir. Bu əməliyyat hər kateqoriya üçün ayrıca binary feature yaradaraq, məsələn, protokol növləri arasında süni böyüklük sırasının yaranmasının qarşısını alır.
Mənbə binary və ordinal xüsusiyyətlərin label encoding ilə ədədi kodlara çevrildiyini bildirir.
Sinif balanssızlığı necə idarə olunur?
Metodologiya bölməsində stratified sampling və class-weighted loss istifadə edildiyi yazılır. Lakin mənbə hər sinif üçün istifadə olunan ədədi class weight dəyərlərini və ya onların düsturunu bildirmir.
Denklem 8 isə standart multiclass cross-entropy formasında verilib və tənlikdə açıq sinif-çəki termini göstərilmir. Buna görə class weighting-in dəqiq loss implementasiyasına necə tətbiq edildiyini mənbədə veriləndən daha ətraflı fərz etmək düzgün deyil.
FCNN və Attention Mexanizmi Necə İşləyir?
Tədqiqatın FCNN modeli giriş feature vector-unu 128, 64 və 32 ölçülü gizli təsvirlərə çevirən tam əlaqəli qatlar, Mish aktivləşməsi və dropout ilə işləyir; mənbə izahına və tənliklərə görə son 32 ölçülü latent representation üzərində attention çəkiləri hesablanır və attention-weighted təsvir softmax qatında çoxsinifli hücum proqnozuna çevrilir.
Giriş vektoru
Mənbə giriş vektorunu:
\[ \mathbf{x}\in\mathbb{R}^{d} \]
şəklində müəyyən edir. \(d\) emal edilmiş feature sayıdır. Məqalə nümunə kimi \(d=120\) dəyərini verir; lakin üç məlumat dəstinin orijinal feature sayları fərqli olduğundan bu dəyər bütün məlumat dəstləri üçün sabit və universal son ölçü kimi şərh edilməməlidir.
Denklem 1–3: Gizli təsvirlər
\[ \mathbf{h}_1=\operatorname{Mish}(W_1\mathbf{x}+b_1), \qquad \mathbf{h}_1\in\mathbb{R}^{128} \tag{1} \]
Denklem 1 giriş xüsusiyyətlərini ilk 128 ölçülü latent representation-a çevirir. \(W_1\) öyrənilən weight matrix, \(b_1\) bias vector və \(\mathbf{h}_1\) ilk gizli qatın çıxışıdır.
\[ \mathbf{h}_2=\operatorname{Mish}(W_2\mathbf{h}_1+b_2), \qquad \mathbf{h}_2\in\mathbb{R}^{64} \tag{2} \]
Denklem 2 ilk gizli təsviri 64 ölçüyə çevirir.
\[ \mathbf{h}_3=\operatorname{Mish}(W_3\mathbf{h}_2+b_3), \qquad \mathbf{h}_3\in\mathbb{R}^{32} \tag{3} \]
Denklem 3 son gizli representation-ı 32 ölçüyə endirir. Mish qeyri-xətti aktivləşmə funksiyasıdır. Mənbə Mish-in analitik funksiya tərifini ayrıca vermədiyi üçün Verianla mənbədən kənar yeni tənlik əlavə etmir.
Denklem 4: Dropout
\[ \mathbf{h}^{drop}_i= Dropout(\mathbf{h}_i,p=0.3), \qquad i=1,2,3 \tag{4} \]
Dropout training zamanı gizli vahidlərin bir hissəsini müvəqqəti olaraq deaktiv etməklə modelin ayrı-ayrı latent units-ə həddindən artıq asılı olmasını azaltmağı hədəfləyir. Buradakı \(p=0.3\), mənbədə bildirilən dropout rate-dir.
Denklem 5: Attention çəkiləri
\[ \boldsymbol{\alpha}= softmax(W_a\mathbf{h}_3+b_a) \tag{5} \]
Attention qatı son gizli representation daxilindəki latent units üçün nisbi çəki yaradır. Mənbənin metodologiya bölməsi bu mexanizmin birbaşa orijinal giriş feature-ları üzərində deyil, öyrənilmiş hidden representation üzərində işlədiyini açıq şəkildə bildirir.
Bu fərq vacibdir: attention weight ilə SHAP feature attribution eyni şey deyil. Attention model daxilindəki latent representation-a çəki verir; SHAP isə model proqnozuna giriş xüsusiyyətlərinin töhfəsini post-hoc formada qiymətləndirmək üçün istifadə olunur.
Denklem 6: Attention-weighted təsvir
\[ z= \sum_{j=1}^{32} \alpha_j h_{3j} \tag{6} \]
Denklem 6 mənbədə bu formada verilib. \(\alpha_j\), \(j\)-ci attention weight; \(h_{3j}\), son gizli qatın \(j\)-ci komponentidir.
Mənbə göstərimində diqqət edilməli bir notation problemi var: Denklem 6-dakı cəm ifadəsi ilə \(z\) skalyar kəmiyyət kimi görünür, halbuki sonrakı Denklem 7-də \(w_i^Tz\) formasında vektorial inner-product göstərimi istifadə olunur. Mənbə bu ölçü əlaqəsini ayrıca izah etmir. Verianla tənliyi dəyişmir və çatışmayan ölçü məlumatını fərziyyə ilə tamamlamır.
Denklem 7: Softmax sinif ehtimalı
\[ \hat{y}_i= \frac{\exp(w_i^{T}z+b_i)} {\sum_{j=1}^{C}\exp(w_j^{T}z+b_j)}, \qquad i=1,2,\ldots,C \tag{7} \]
Denklem 7 hər sinif üçün normallaşdırılmış proqnoz ehtimalı yaradır. \(C\) müvafiq məlumat dəstindəki sinif sayıdır. Softmax məxrəci bütün siniflərin exponentiated logit dəyərlərini toplayaraq çıxışları ortaq ehtimal paylanmasına çevirir.
Denklem 8: Çoxsinifli cross-entropy
\[ L= -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{ic}\log(\hat{y}_{ic}) \tag{8} \]
\(N\) training sample sayını, \(C\) sinif sayını, \(y_{ic}\) real class indicator dəyərini və \(\hat{y}_{ic}\) modelin müvafiq sinif üçün proqnozlaşdırdığı ehtimalı təmsil edir. Loss ölçüsüzdür.
Model real sinfə aşağı ehtimal verdikdə \(-\log(\hat{y}_{ic})\) böyüyür və loss artır. Təlim optimallaşdırması bu loss-u azaldacaq weight strukturlarını öyrənməyi hədəfləyir.
Arxitektura təsvirində mənbədaxili fərq
Metodologiya izahında 128, 64 və 32 neyronlu üç gizli qatın hər birindən sonra dropout olduğu və attention mexanizminin son 32 ölçülü representation-a tətbiq edildiyi bildirilir. Denklem 1–6 da bu izahla uyğundur.
Lakin Algorithm 1 model ardıcıllığını FC-128 → Dropout(0.3) → FC-64 → Dropout(0.3) → Attention → FC-32 → softmax kimi verir. Bu ardıcıllıqda attention, FC-32-dən əvvəl görünür və üçüncü dropout açıq şəkildə göstərilmir.
Bu iki təqdimat mənbə daxilində tamamilə eyni deyil. Buna görə Verianla Algorithm 1 sətrini və ya tənlik zəncirini səssizcə digərinə uyğun dəyişmir.
Təlim parametrləri
| Parametr | Mənbə dəyəri | İzah |
|---|---|---|
| Optimizer | AdamW | Weight yeniləmələri üçün istifadə olunan optimizer. |
| Başlanğıc learning rate | 0.001 | Algorithm 1-də verilən başlanğıc dəyəri. |
| Learning-rate schedule | Cosine annealing | Mənbə schedule istifadə edildiyini bildirir; ətraflı schedule parametrləri verilməyib. |
| Batch size | 128 | Hər mini-batch üzrə training sample sayı. |
| Maksimum epoch | 20 | Early stopping daha əvvəl dayandıra bilər. |
| Dropout | 0.3 | Mənbənin Denklem 4 və metod izahında bildirdiyi nisbət. |
| Weight initialization | Xavier | Başlanğıc weight variasiyasını balanslı saxlamaq üçün. |
| Early stopping | Validation loss | Overtraining-i məhdudlaşdırmaq məqsədilə. |
| Monitoring | TensorBoard | Training performansını izləmək üçün. |
Training, validation və test ayrımı dəqiq necə verilib?
Algorithm 1 məlumat dəstlərini %70 training və %30 test şəklində ayırdığını yazır və random_state=42 ilə deterministic stratified split məlumatı SHAP izahında görünür.
Bununla belə, alqoritmin sonrakı sətirlərində “validation” metrikləri və validation loss əsasında early stopping istifadə olunur; SHAP analizi də “validation samples” üzərində müəyyən edilir. Mənbə ayrıca üçüncü validation partition-ın ölçüsünü açıq şəkildə vermir.
Buna görə yayımlanmış mətndən etibarlı şəkildə çıxarıla bilən məlumat 70/30 stratified bölünmə və validation kimi istifadə olunan nümunələrin mövcud olmasıdır; ayrıca train-validation-test nisbətlərini özbaşına yaratmaq düzgün deyil.
SHAP və LIME Bu Tədqiqatda Nəyi İzah Edir?
SHAP modelini bir neçə validation nümunəsi üzərində feature contribution paylanmalarını araşdırmaq, LIME-i isə tək bir prediction ətrafında yerli feature töhfələrini göstərmək üçün istifadə ediblər; mənbə hər iki texnikanı real-time hər paket üçün izah kimi deyil, offline forensic analysis və post-incident investigation aləti kimi məhdudlaşdırır.
SHAP tətbiqi
Mənbə KernelSHAP yanaşmasını shap.Explainer vasitəsilə, sabit 100 validation nümunəsindən ibarət background üzərində və CPU-side prediction wrapper ilə tətbiq etdiyini bildirir.
SHAP summary plot-ları bir feature-ın müxtəlif nümunələrdə model output-una hansı istiqamətdə və nə dərəcədə təsir etdiyini araşdırmaq üçün istifadə olunub.
Kitsune SHAP analizində feature_0, feature_3, feature_1 və feature_8 kimi bir neçə xüsusiyyət nəzərəçarpan töhfə göstərir. Mənbə bunu IoT trafikində qərarın tək bir dominant dəyişəndən asılı olmaması ilə əlaqələndirir.
Server-Based məlumat dəstində SHAP paylanması daha sıx və az sayda xüsusiyyət ətrafında toplanıb. Malware məlumat dəstində isə daha geniş feature contribution paylanması müşahidə olunur.
LIME tətbiqi
LIME hər məlumat dəsti üçün yalnız bir təmsilçi validation nümunəsinə tətbiq edilib. Mənbə istifadə olunan nümunəni idx=0, izah olunan feature sayını isə num_features=10 kimi bildirir.
Kitsune nümunəsində ts, service_http və resp_bytes müsbət; service_dns və proto_tcp mənfi töhfə göstərən feature nümunələri arasında verilib.
Server-Based nümunəsində ts, proto və id.resp_h güclü müsbət töhfələr göstərərkən orig_bytes və resp_bytes mənfi istiqamətli töhfə nümunələri kimi qeyd edilib.
Malware nümunəsində feature_85, feature_86 və feature_107 müsbət; feature_57 və feature_39 mənfi töhfə nümunələri arasındadır.
İzah edilə bilənlik nəticələrinin sərhədi
Mənbə eyni trained checkpoint və eyni 100 validation nümunəsinin istifadə olunması səbəbindən SHAP rankings-in təkrarlandıqda dəyişmədiyini bildirir. Lakin tədqiqat modeli fərqli random seed-lərlə sıfırdan yenidən öyrədərək SHAP ranking variance üçün statistik repeated-training experiment bildirmir.
Buna görə “eyni checkpoint altında izahın təkrar istehsal oluna bilməsi” ilə “fərqli təlim şərtlərində explanation stability” eyni nəticə deyil.
Architecture comparison SHAP nə göstərir?
Mənbə Şəkil 9-da proposed MLP + Attention, attention-sız MLP və Random Forest üçün SHAP feature rankings-i keyfiyyətcə müqayisə edir. Malware məlumat dəstində feature_0, feature_1, feature_2, feature_3 və feature_8 hər üç arxitekturanın top-10 sıralamalarında görünür.
Server-Based məlumat dəstində feature_1 bütün müqayisə olunan modellərdə birinci yerdədir; feature_7, feature_13, feature_15 və feature_16 də arxitekturalar arasında təkrar görünür.
Kitsune-da feature dimensionality və doqquz sinifli struktur səbəbindən ranking variation daha böyükdür; mənbə feature_13 və feature_65-in hər iki MLP variantının top-10 siyahısına daxil olduğunu bildirir.
Bu analiz predictive-performance ablation deyil. Attention modulunun çıxarılmasının accuracy və ya F1 üzərində nə qədər dəyişiklik yaratdığını göstərən kəmiyyət ablation table yoxdur; müəlliflər tam ablation tədqiqatlarını gələcək iş kimi qeyd edirlər.
Tədqiqatın Metodu və Nəticələri
Əsas performans nəticələri
| Məlumat dəsti | Domen | Accuracy | Şərh sərhədi |
|---|---|---|---|
| Kitsune | IoT trafiki | %96,0 | Doqquz sinif arasında Class 2 və Class 4 nəzərəçarpacaq dərəcədə daha zəifdir. |
| Server-Based | Korporativ/server trafiki | %99,99 | Table 3 iki onluq formatda 1.00-a yuvarlaqlaşdırır. |
| Malware Traffic | Malware kommunikasiya trafiki | %99,58 | Table 3 accuracy sütununda 1.00 formasında yuvarlaqlaşdırılıb. |
%99,99 Accuracy Tək Bir Universal Modelin Uğurunu Göstərir?
Xeyr. %99,99 dəyəri Server-Based məlumat dəstində ayrıca qiymətləndirmə şərtində əldə edilən ən yüksək accuracy nəticəsidir; tədqiqat bir dəfə öyrədilmiş modelin Kitsune, Server-Based və Malware Traffic arasında transfer edildiyini göstərmədiyi üçün bu dəyər “üç domendə tək universal model %99,99 dəqiqlik verdi” kimi şərh edilməməlidir.
Kitsune sinif üzrə nəticələri
| Sinif | Precision | Recall | F1-score | Ümumi accuracy |
|---|---|---|---|---|
| Class 0 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 1 | 0.93 | 0.99 | 0.95 | 0.96 |
| Class 2 | 0.72 | 0.76 | 0.74 | 0.96 |
| Class 3 | 0.99 | 0.89 | 0.94 | 0.96 |
| Class 4 | 0.75 | 0.69 | 0.72 | 0.96 |
| Class 5 | 1.00 | 0.99 | 0.99 | 0.96 |
| Class 6 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 7 | 0.97 | 1.00 | 0.98 | 0.96 |
| Class 8 | 0.99 | 0.99 | 0.99 | 0.96 |
Class 2 və Class 4 nəticələri %96 overall accuracy-nin sinif üzrə performans fərqlərini gizlədə biləcəyini açıq göstərir. Class 4 recall = 0.69 olduğuna görə real Class 4 nümunələrinin təxminən üçdə biri müvafiq şərtdə düzgün sinfə təyin edilə bilməyib.
Server-Based və Malware nəticələri
| Məlumat dəsti | Sinif | Precision | Recall | F1 | Table 3 Accuracy |
|---|---|---|---|---|---|
| Server-Based | Class 0 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 1 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 0 | 0.99 | 0.99 | 0.99 | 1.00 |
| Malware | Class 1 | 0.99 | 1.00 | 1.00 | 1.00 |
| Malware | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 3 | 1.00 | 0.98 | 0.99 | 1.00 |
| Malware | Class 4 | 1.00 | 1.00 | 1.00 | 1.00 |
Table 3 iki onluq təqdimata görə ümumi accuracy-ni Server-Based və Malware üçün 1.00 göstərir. Abstract isə daha dəqiq dəyərlər kimi müvafiq olaraq %99,99 və %99,58 verir. Verianla bu iki təqdimatı ziddiyyət kimi gizlətmir; Table 3 dəyərlərini yuvarlaqlaşdırılmış cədvəl göstərimi kimi qoruyur.
Confusion matrix-lər nə göstərir?
Kitsune confusion matrix-ində Class 0, 5, 6, 7 və 8 əsasən diagonal üzərində düzgün təsnifləndirilərkən Class 2 və Class 4-də daha çox off-diagonal xəta görünür. Mənbə bunu siniflər arasındakı feature overlap ilə əlaqələndirir.
Server-Based confusion matrix demək olar tamamilə diagonaldır. Malware confusion matrix-ində də yüksək diagonal dominance görünür, lakin Class 0 ilə Class 1 arasında az miqdarda qarışıqlıq var.
ROC-AUC nəticələri
Kitsune ROC analizində əksər siniflərin AUC dəyəri 1.00-a çatır; Class 2 və Class 4 üçün dəyərlər təxminən 0.99 səviyyəsində bildirilir.
Server-Based məlumat dəstindəki üç sinif üçün AUC = 1.00; Malware Traffic məlumat dəstindəki beş sinif üçün də AUC = 1.00 bildirilib.
Bu nəticələr müvafiq train/test protokolu və istifadə olunan məlumat dəstləri altında ölçülüb. Başqa şəbəkələrdə, yeni hücum növlərində və ya zamanla dəyişən production traffic distribution altında eyni AUC-nin qorunacağı tədqiqat tərəfindən təsdiqlənməyib.
Təlim əyriləri
Kitsune təlimində validation accuracy təxminən 15-ci epoch ətrafında %95-in üzərinə çıxır. Training və validation əyriləri başlanğıcda bir qədər ayrılır, sonrakı epoch-larda daha sabit olur.
Server-Based modelində training və validation accuracy bir neçə epoch ərzində %99,5-in üzərinə çıxır. Malware Traffic-də də accuracy çox erkən mərhələdə %100-ə yaxınlaşır.
Loss əyriləri
Kitsune training loss təxminən 1,2 səviyyəsindən başlayıb 0,2-nin altına düşərkən validation loss təxminən 0,08-ə qədər azalır.
Server-Based təlimində training və validation loss bir neçə epoch ərzində təxminən 0,05-in altına düşür. Malware modelində loss dəyərləri təxminən 0,03 və ya aşağı səviyyədədir.
Mənbə Malware validation loss-un əksər epoch-larda training loss-dan daha aşağı olmasını güclü regularization səbəbindən yüngül underfitting göstəricisi kimi şərh edir. Bu müəllif şərhidir; tədqiqat bunun üçün ayrıca formal statistical test bildirmir.
Müqayisəli Table 4 necə oxunmalıdır?
| Yanaşma | Best Accuracy (%) | İzah edilə bilənlik | Multi-dataset dəstəyi |
|---|---|---|---|
| Ref. 20 | 98.7 | Partial, SHAP | Hybrid Boosting |
| Ref. 11 | 97.9 | High, XAI survey | Review-based |
| Ref. 12 | 96.3 | Low | 2 datasets |
| Ref. 25 | 98.5 | Federated SHAP | Federated DL |
| Proposed model | 99.99 | SHAP visual + feature attribution | Kitsune + Server + Malware |
Table 4-dəki %99,99 təklif olunan sistemin üç məlumat dəstindəki ən yüksək nəticəsi olan Server-Based accuracy-dir. Cədvəl müxtəlif tədqiqatların müxtəlif məlumat dəstləri və metodları üzrə “best achieved accuracy” dəyərlərini yanaşı göstərir. Buna görə nəzarətli, eyni test dəstinə əsaslanan head-to-head benchmark kimi şərh edilməməlidir.
Cross-dataset transfer həqiqətən sınaqdan keçirilib?
Xeyr. Nəticə bölməsinin açıq ifadəsinə görə tədqiqat cross-dataset transfer learning göstərmir. Ortaq pipeline üç network environment-a müstəqil tətbiq olunub.
Mətnin daha əvvəlki hissəsində pipeline-ın müxtəlif domain-lərdə “without requiring retraining or architectural modifications” işlədiyini deyən daha güclü ifadə var. Buna qarşılıq metod bölməsi hər məlumat dəsti üçün training/test prosesini müəyyən edir və nəticə bölməsi transfer learning edilmədiyini açıqlayır. Buna görə Verianla təhlükəsiz şərh kimi “architecture/pipeline customization tələb etmədən müstəqil yenidən tətbiq” mənasını qoruyur, “tək trained model retraining olmadan üç domain-də istifadə edildi” iddiası yaratmır.
UAV-lar üzərində sınaq aparılıbmı?
Xeyr. Məqalədə UAV telemetry, RF signal, flight log və ya GPS variability ehtiva edən UAV-specific dataset istifadə edilməyib. UAV intrusion detection yalnız gələcək potensial application domain kimi müzakirə olunub.
Buna görə tədqiqat UAV-larda spoofing, jamming və ya digər hücumları real uçuş məlumatı üzərində aşkar etdiyini göstərmir.
Statistik qeyri-müəyyənlik və təkrar istehsal oluna bilmə
Tədqiqat accuracy, precision, recall, F1-score və ROC-AUC bildirir. Lakin performans nəticələri üçün confidence interval, p-value, effect size və ya multiple-random-seed distribution bildirilmir.
random_state=42 SHAP üçün istifadə olunan deterministic 70/30 split kontekstində qeyd olunub. Bu, müstəqil training runs arasındakı performans qeyri-müəyyənliyinin ölçüldüyü demək deyil.
Tədqiqatın dəstəklədiyi nəticələr
- Eyni ümumi preprocessing və FCNN modelləşdirmə yanaşması üç fərqli network-data domenində ayrı-ayrılıqda tətbiq oluna bilib.
- Kitsune-da %96,0, Server-Based-də %99,99 və Malware Traffic-də %99,58 accuracy bildirilib.
- Kitsune-da bəzi siniflər digərlərindən nəzərəçarpacaq dərəcədə zəifdir; xüsusilə Class 2 və Class 4-ün F1 dəyərləri müvafiq olaraq 0,74 və 0,72-dir.
- SHAP modelin feature contribution strukturunu bir neçə validation nümunəsi üzərindən araşdırmaq üçün istifadə olunub.
- LIME tək predictions üçün local feature contribution izahı yaratmaq məqsədilə tətbiq olunub.
- Server-Based və Malware məlumat dəstlərində ROC-AUC dəyərləri bildirilən bütün siniflərdə 1.00-dır.
- Tədqiqat eyni architectural pipeline-ın heterogen məlumat domenlərinə tətbiq oluna biləcəyini dəstəkləyir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Tək trained modelin üç məlumat dəsti arasında birbaşa transfer edilərək eyni nəticələri verdiyi göstərilməyib.
- Cross-dataset transfer learning təsdiqlənməyib.
- UAV intrusion defence real UAV məlumatı ilə təsdiqlənməyib.
- SHAP və ya LIME real-time packet-by-packet explanation kimi sınaqdan keçirilməyib.
- Modelin production network üzərində throughput, latency, memory və ya long-term drift performansı bildirilməyib.
- Attention modulunun predictive contribution-ını ədədi olaraq təcrid edən tam performance ablation aparılmayıb.
- Confidence interval və ya repeated-seed performance distribution olmadığı üçün nəticələrin training-run qeyri-müəyyənliyi kəmiyyətcə verilməyib.
- Server-Based %99,99 accuracy bütün məlumat dəstlərində %99,99 ortaq performans demək deyil.
Mənbədəki mühüm metodoloji qeyri-müəyyənliklər
| Mövzu | Mənbə ifadəsi A | Mənbə ifadəsi B | Verianla yanaşması |
|---|---|---|---|
| Miqyaslama | Standard scaling | [0,1] intervalı | Scaler növü xarici məlumata əsasən dəyişdirilmir. |
| Attention mövqeyi | Mətn/tənliklər: 32 neyronlu h3-dən sonra attention | Algorithm 1: attention, FC-32-dən əvvəl | Fərq görünən saxlanılır. |
| Dropout ardıcıllığı | Mətn: üç hidden layer-ın hər birindən sonra dropout | Algorithm 1 ardıcıllığı üçüncü dropout-u göstərmir | Çatışmayan sətir fərziyyə ilə tamamlanmır. |
| Data split | Algorithm 1: 70% train / 30% test | Training mətni validation loss və validation samples istifadə edir | Ayrıca üçüncü split nisbəti uydurulmur. |
| Loss | Metod: class-weighted loss | Denklem 8: standart multiclass cross-entropy | Exact class-weight implementation bilinməyən kimi saxlanılır. |
| Domain generalisation | Ara mətn: “without requiring retraining” | Conclusion: cross-dataset transfer aparılmayıb, məlumat dəstləri müstəqil işlənib | Tək-model transfer uğuru iddia edilmir. |
| Accuracy göstərimi | Abstract: 99,99% və 99,58% | Table 3: 1.00 və 1.00 | Table 3 dəyərləri yuvarlaqlaşdırılmış göstərim kimi qəbul edilir. |
Gələcək tədqiqat istiqamətləri
Müəllif gələcək tədqiqatlar üçün UAV-specific dataset-lərin və flight telemetry, GPS variability və communication-signal pattern kimi domain-relevant feature-ların əlavə edilməsini təklif edir.
Həmçinin real cross-dataset transfer experiments, ablation studies və classical machine-learning baselines ilə nəzarətli müqayisələrin aparılmasının zəruri olduğu bildirilir.
Bunlar mövcud məqalənin tamamlanmış nəticələri deyil.
Mənbə və Metod Qeydi
Orijinal başlıq: A domain-agnostic explainable framework for network attack detection across diverse traffic datasets
Müəllif: Abed Alanazi.
Müəllif sayı: 1.
Bərabər töhfə: Tətbiq edilmir; tədqiqat tək müəlliflidir.
Corresponding author: Abed Alanazi.
E-poçt: ad.alanazi@psau.edu.sa
Qurum: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam bin Abdulaziz University, Al-Kharj 11942, Saudi Arabia.
Jurnal: Scientific Reports.
Nəşriyyat/platforma: Nature Portfolio / Springer Nature.
Cild: 16.
Məqalə nömrəsi: 24512.
Nəşr ili: 2026.
Nəşr tarixi: 16 iyul 2026.
Received: 27 aprel 2026.
Accepted: 6 iyul 2026.
DOI: 10.1038/s41598-026-61637-w.
Rəsmi nəşr səhifəsi: Nature / Scientific Reports məqalə qeydi; DOI vasitəsilə əlçatandır.
Mənbə növü: Nəşr edilmiş orijinal tədqiqat məqaləsi.
Rəyçilik: Scientific Reports ekspert rəyçiliyi tətbiq edən, rəyli Nature Portfolio jurnalidir.
Lisenziya: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Lisenziya və vizual istifadə: NoDerivatives şərtinə görə mənbənin Şəkil 1–9-u dəyişdirilmiş və ya uyğunlaşdırılmış şəkildə Verianla məqaləsinə köçürülməyib. Məqalədəki SVG yalnız mənbə mətnində açıq təsvir olunan metod əlaqələrindən müstəqil kompozisiya ilə hazırlanıb.
Əsas tədqiqat sahəsi: Network intrusion detection, deep learning və Explainable Artificial Intelligence.
Əsas model: Fully Connected Neural Network / Multi-Layer Perceptron əsaslı təsnifatçı; Mish activation, dropout və latent-representation attention ehtiva edir.
Gizli qatlar: 128, 64 və 32 neyron.
Dropout: p = 0.3.
Optimizer: AdamW.
Başlanğıc learning rate: 0.001.
Learning-rate scheduling: Cosine annealing; ətraflı schedule parametrləri mənbədə verilməyib.
Batch size: 128.
Maksimum epoch: 20.
Early stopping: Validation loss-a görə.
Weight initialization: Xavier initialization.
Loss: Multiclass cross-entropy. Metod mətni əlavə olaraq class-weighted loss istifadə edildiyini bildirir; exact class-weight dəyərləri verilməyib.
Data split: Algorithm 1-də 70% training və 30% test. Validation loss və validation samples ayrıca istifadə olunur; ayrıca validation partition nisbəti açıq şəkildə bildirilmir.
Random state: SHAP izahında deterministic 70/30 stratified split üçün random_state = 42 göstərilib.
Kitsune: 20 milyondan çox orijinal nümunə arasından 9.000 nümunə; 115 xüsusiyyət; 9 sinif.
Server-Based: 225.398 nümunə; 27 xüsusiyyət; 3 sinif; məlumat dəstinin hamısı istifadə olunub.
Malware Traffic: 25 milyondan çox orijinal nümunə arasından 644.602 nümunə; 23 xüsusiyyət; 5 sinif.
Çatışmayan dəyərlərin tamamlanması: Ədədi feature-larda mean, kateqorik feature-larda mode.
Kateqorik encoding: Nominal feature-larda one-hot encoding; binary/ordinal feature-larda label encoding.
Scaling üzrə mənbə ifadəsi: Mənbə “Standard scaling” və “[0,1]” ifadələrini birlikdə istifadə edir. Verianla scaler növünü xarici məlumata əsasən dəyişdirməyib.
Əsas accuracy nəticələri: Kitsune %96,0; Server-Based %99,99; Malware Traffic %99,58.
Kitsune zəif sinifləri: Class 2 F1 = 0,74; Class 4 F1 = 0,72.
ROC-AUC: Kitsune-da əksər siniflər 1.00, Class 2 və Class 4 təxminən 0.99; Server-Based və Malware siniflərində 1.00 bildirilib.
SHAP: Sabit 100 validation nümunəsi; KernelSHAP / shap.Explainer; CPU-side prediction wrapper.
LIME: Hər məlumat dəsti üçün bir təmsilçi validation nümunəsi; idx = 0; num_features = 10.
XAI iş rejimi: Offline forensic analysis və post-incident investigation; real-time per-packet explanation deyil.
Cross-architecture SHAP: Proposed MLP + Attention, attention-sız MLP və Random Forest izahları keyfiyyətcə müqayisə olunub; bu müqayisə predictive-performance ablation deyil.
Cross-dataset transfer: Aparılmayıb. Conclusion bölməsi eyni pipeline-ın müxtəlif məlumat dəstlərinə müstəqil tətbiqini qiymətləndirdiyini açıq bildirir.
UAV validation: Aparılmayıb. UAV telemetry, RF signals və flight logs mövcud məlumatda yoxdur.
Statistik testlər: Performans üçün p-value, confidence interval və ya effect size bildirilməyib.
Repeated-seed performance: Bildirilməyib.
Data availability: Kitsune, Malware Capture Facility və istifadə olunan server/network malware dataset mənbədə public dataset kimi göstərilib.
Müəllif töhfələri: Conceptualization, data curation, formal analysis, funding acquisition, investigation, methodology, project administration, validation və writing—review & editing vəzifələrinin hamısı Abed Alanazi tərəfindən yerinə yetirilib.
Maliyyələşdirmə: National Cybersecurity Authority, Kingdom of Saudi Arabia tərəfindən CRPG-25-3295 nömrəli dəstək və Prince Sattam bin Abdulaziz University tərəfindən PSAU/2026/R/1447 layihə maliyyələşdirməsi bildirilib.
Maraqların toqquşması: Müəllif competing interests olmadığını bəyan edir.
Əsas metodoloji sərhəd: Tədqiqat üç açıq şəbəkə təhlükəsizliyi məlumat dəsti üzərində müstəqil eksperimentlərdir; production network sahə doğrulaması, cross-dataset transfer learning və UAV-specific validation ehtiva etmir.
Mənbədaxili arxitektura sərhədi: Mətn/tənliklər attention-ı h3-dən sonra göstərərkən Algorithm 1 attention-ı FC-32-dən əvvəl sıralayır; bu fərq Verianla tərəfindən səssizcə düzəldilməyib.
Mənbədaxili split sərhədi: 70/30 train-test ifadəsi ilə birlikdə validation loss və validation samples istifadə olunub, ayrıca validation nisbəti açıq şəkildə verilməyib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib