


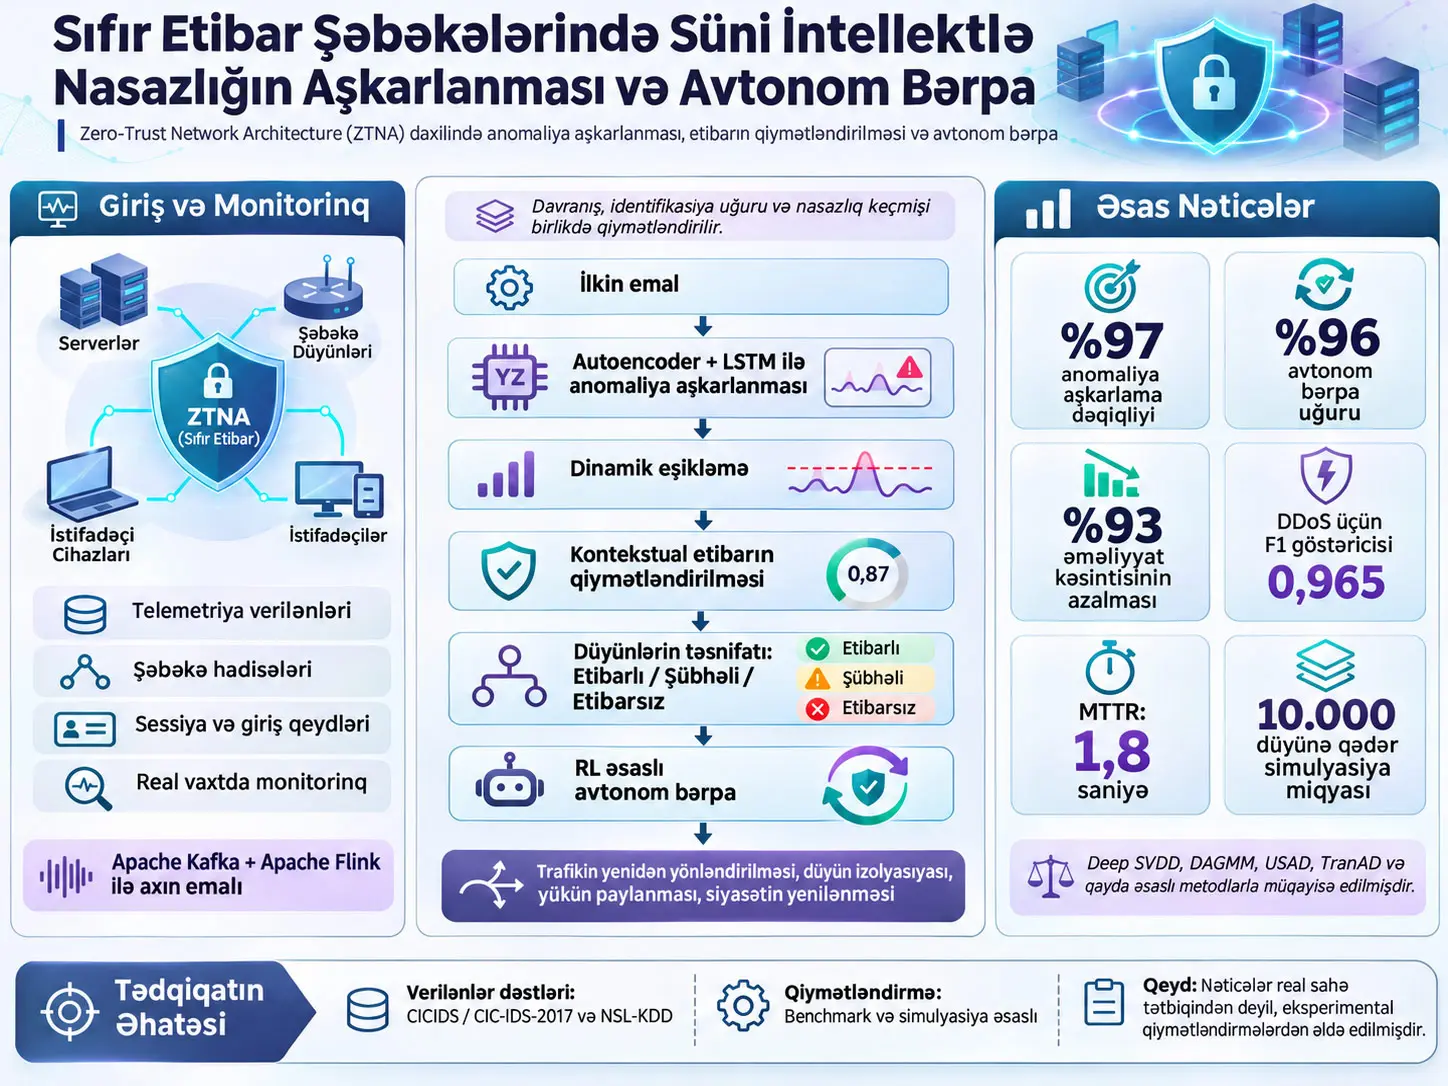
Təklif olunan Autoencoder-LSTM-RL-Trust çərçivəsi, Sıfır Etibar Şəbəkə Arxitekturalarında (Zero-Trust Network Architecture, ZTNA) şəbəkə telemetriyasından anomaliyaları aşkarlamağı, düyünlərin kontekstual etibarlılığını dinamik şəkildə hesablamağı və etibarlı düyünlər üzərindən bərpa əməliyyatlarını reinforcement learning ilə uyğunlaşdırmağı hədəfləyən inteqrasiya olunmuş süni intellekt əsaslı nasazlıq aşkarlama və avtonom bərpa arxitekturasıdır. Çərçivə; Autoencoder və Long Short-Term Memory (LSTM) əsaslı anomaliya analizi, attention mexanizmi, adaptiv eşikləmə, davranış və fault-history əsaslı trust scoring, reinforcement learning (RL) əsaslı recovery orchestration ilə Apache Kafka və Apache Flink üzərindən axın telemetriyası anlayışlarını bir araya gətirir.
Mənbə tədqiqatda sistem CICIDS/CIC-IDS-2017 və NSL-KDD benchmark verilənləri, DDoS, Unauthorized Access və Data Exfiltration hücum sinifləri və müxtəlif miqyaslı şəbəkə simulyasiyaları üzərindən qiymətləndirilmişdir. Məqalənin ümumi sistem səviyyəli nəticəsi %97 anomaly-detection accuracy, %96 autonomous-recovery success və %93 downtime reduction kimi verilir. DDoS üçün F1-score 0,965 bildirilmiş; nəticə bölməsində DDoS Mean Time to Detect (MTTD) 1,6 s, Mean Time to Repair (MTTR) 1,8 s göstərilmişdir.
Bu dəyərlər real korporativ Zero-Trust şəbəkəsində uzunmüddətli sahə performansı deyil. Müəlliflər mövcud doğrulamanın benchmark və simulation-based olduğunu, federated learning komponentinin böyük miqyaslı paylanmış deployment altında hələ eksperimental olaraq sınaqdan keçirilmədiyini və gələcəkdə live software-defined Zero-Trust telemetry mühitlərində doğrulama tələb olunduğunu açıq şəkildə bildirirlər.
Mənbədəki müxtəlif cədvəllər eyni anlayışlar üçün həmişə eyni sayısal dəyərdən istifadə etmir. Məsələn, CICIDS müqayisə cədvəli proposed Autoencoder-LSTM üçün accuracy 0,961 verdiyi halda Discussion 5.1 mətni 0,950 yazır. Recovery ilə bağlı müxtəlif eksperiment cədvəllərində 2,3 s recovery latency, 1,8 s MTTR və 90 ms recovery time ayrıca bildirilir. Buna görə Verianla bu dəyərləri sanki tək bir rəqəmdir kimi birləşdirmir.
Sıfır Etibar Şəbəkə Arxitekturası Bu Tədqiqatda Nə Deməkdir?
Sıfır Etibar Şəbəkə Arxitekturası (Zero-Trust Network Architecture, ZTNA), istifadəçiyə, cihaza və ya şəbəkə mövqeyinə daimi və örtülü etibar vermək əvəzinə girişin davamlı doğrulama, kontekst, autentifikasiya və təfərrüatlı siyasət nəzarəti ilə qiymətləndirilməsini əsas götürən təhlükəsizlik yanaşmasıdır; bu tədqiqat ZTNA-ya anomaliya aşkarlanması, dinamik trust scoring və avtonom recovery funksiyalarını vahid qapalı dövrədə əlavə etməyi məqsəd qoyur.
Tədqiqat problemi
Mənbə tədqiqatın çıxış nöqtəsi ənənəvi şəbəkə təhlükəsizliyi sistemlərinin çoxunun statik eşiklərə, əvvəlcədən müəyyən edilmiş trust fərziyyələrinə və ya insan müdaxiləsi tələb edən recovery prosedurlarına əsaslanmasıdır. Dinamik Zero-Trust mühitlərində düyünlərin davranışı, şəbəkə topologiyası və hücum formaları zamanla dəyişə bildiyi üçün sabit qaydalar həm false positive yarada, həm də yeni hücum modellərinə gec reaksiya verə bilər.
Tədqiqatçılar üç funksiyanın eyni qərar dövrəsində inteqrasiya edilməsini hədəfləyirlər:
- Normal davranışdan sapmaları dərin öyrənmə ilə müəyyən etmək.
- Hər düyünün etibarlılığını davranış və fault tarixçəsinə görə davamlı yeniləmək.
- Bir fault və ya attack müəyyən edildikdə etibarlı düyünlər üzərindən şəbəkənin rol, trafik, siyasət və xidmət strukturunu avtomatik yenidən təşkil etmək.
Tədqiqatın əsas töhfələri
Mənbə beş əsas töhfə müəyyən edir. Birincisi Autoencoder ilə LSTM-in birlikdə istifadə edildiyi dual-model anomaly detection yanaşmasıdır. İkincisi Mahalanobis əsaslı anomaliya konteksti ilə node responsiveness, authentication frequency və fault history kimi davranış ölçülərinin istifadə edildiyi context-aware trust scoring-dir. Üçüncüsü RL əsaslı autonomous recovery orchestration-dır. Dördüncüsü federated learning-in privacy-preserving paylanmış adaptation üçün arxitekturaya daxil edilməsidir. Beşincisi isə benchmark və simulyasiya qiymətləndirmələridir.
Lakin federated learning modulunun eksperimental statusu digər komponentlərdən fərqlidir. Mənbə əsas preliminary experiments-ın mərkəzləşdirilmiş hybrid Autoencoder-LSTM-RL strukturuna fokuslandığını; federated-learning komponentinin mövcud tədqiqatda böyük miqyaslı paylanmış eksperimentdən daha çox reference architecture kimi yer aldığını açıq şəkildə bildirir.
Autoencoder-LSTM Anomaliya Aşkarlanması Necə İşləyir?
Təklif olunan anomaliya aşkarlama zənciri yüksəkölçülü telemetriyanı əvvəlcə mərkəzləmə, ölçü azaltma və normallaşdırma ilə emal edir; Autoencoder normal davranışı yenidən qurmağı öyrənərkən LSTM zaman daxilində asılılıqları modelləşdirir, yenidənqurma xətası və kontekstual skorlar eşiklə müqayisə edilir, anomal nümunələr fault vector-a çevrilərək trust və recovery modullarına ötürülür.
Verilənlərin əldə edilməsi və xüsusiyyət mühəndisliyi
Mənbə real vaxt telemetri axını üçün Apache Kafka və Apache Flink-i arxitekturanın data-ingestion komponentləri kimi təsvir edir. İstifadə oluna biləcək girişlər arasında event logları, failed-login hadisələri, API çağırışları, user interaction pattern-ləri və şəbəkə telemetriyası var.
Feature engineering üç temporal granularity səviyyəsindən istifadə edəcək şəkildə hazırlanmışdır: short-term, mid-term və long-term. Məqsəd LSTM-in yalnız bir anda yaranan sapmaları deyil, zamanla inkişaf edən davranış nümunələrini də öyrənə bilməsidir.
Feature vector həmçinin xarici threat-intelligence məlumatları ilə zənginləşdirilə bilər. Mənbənin verdiyi nümunələr blacklisted IP address-lər və məlum software vulnerability məlumatlarıdır. Bu xarici kontekstin funksiyası eyni xam şəbəkə davranışının təhlükəsizlik baxımından fərqli məna daşıya biləcəyi hallarda modelə əlavə kontekst verməkdir.
Autoencoder-ın vəzifəsi
Autoencoder normal şəbəkə davranışının daha sıxılmış təqdimatını öyrənir və giriş feature vector-unu yenidən yaratmağa çalışır. Normal nümunələr təlim paylanmasına yaxın olduğuna görə reconstruction error-un nisbətən aşağı olması gözlənilir. Normal nümunədən sapmış şəbəkə hadisəsi isə model tərəfindən daha pis yenidən qurula və reconstruction error arta bilər.
LSTM-in vəzifəsi
Long Short-Term Memory şəbəkəsi ardıcıl telemetriyada zaman asılılıqlarını modelləşdirmək üçün istifadə olunur. Anomaliya yalnız tək bir yüksək və ya aşağı dəyərdən ibarət olmaya bilər; məsələn, latency-də artımdan sonra authentication uğurunun azalması kimi hadisə ardıcıllıqları birlikdə məna qazana bilər.
Attention-enhanced LSTM
Mənbə LSTM çıxışlarından sonra attention qatlarının istifadəsini təklif edir. Attention mexanizminin burada nəzərdə tutulan rolu anomaly davranışını izah etməkdə daha vacib ola biləcək zaman addımlarına daha çox çəki verməkdir.
Ensemble autoencoder
Bir böyük Autoencoder əvəzinə müxtəlif feature subset-ləri üzərində bir neçə shallow autoencoder istifadə oluna biləcəyi qeyd edilir. Məqsəd noisy və ya redundant feature qruplarına həddən artıq uyğunlaşma riskini azaltmaq və generalization qabiliyyətini artırmaqdır.
Dynamic thresholding
Sabit anomaly threshold əvəzinə quantile-based və ya statistically adaptive threshold istifadəsi təklif olunur. Beləliklə şəbəkənin normal davranışı zamanla dəyişdikdə threshold-un da concept drift-ə uyğunlaşması hədəflənir.
Mahalanobis distance ilə bağlı mənbə məhdudiyyəti
Mənbə Section 3.2-də anomaly score-un Mahalanobis distance istifadə edilməklə hesablandığını və girişin təlim paylanmasının orta/covariance strukturuna görə qiymətləndirildiyini bildirir. Lakin PDF-in yayımlanmış səhifə görüntüsündə “Mathematically, the anomaly score is computed using Mahalanobis distance:” cümləsindən sonra tənlik görünmür. Verianla bu çatışmayan formulu standart Mahalanobis tənliyi ilə özbaşına tamamlamır.
Tənlik 1–8: Mərkəzləmə, covariance və ölçü azaltma
\[ \mu_i=\frac{1}{N}\sum_{j=1}^{N}x_{j,i}, \qquad i\in\{1,\ldots,d\} \tag{1} \]
Tənlik 1 hər feature üçün nümunə ortasını hesablayır. \(N\) nümunə sayı, \(d\) feature sayı, \(x_{j,i}\) isə \(j\). nümunənin \(i\). feature dəyəridir.
\[ \bar{x}_{j,i}=x_{j,i}-\mu_i, \qquad X=[\bar{x}_{j,i}] \tag{2} \]
Tənlik 2 mean-centering əməliyyatıdır. Hər feature öz ortasından uzaqlığı ilə təqdim olunur.
\[ S=\frac{1}{N-1}\sum_{j=1}^{N} \left(\bar{x}_{j}\bar{x}_{j}^{T}\right) \tag{3} \]
Tənlik 3 mərkəzləşdirilmiş nümunələrdən covariance matrix yaradır. Covariance matrix feature-ların birlikdə necə dəyişdiyini göstərir.
\[ X=U\Sigma V^{T}, \qquad V_k=V[:,1:k] \tag{4} \]
Mənbə bu addımı PCA başlığı altında verir və matrix decomposition formasında SVD göstərimindən istifadə edir. \(V_k\), ilk \(k\) principal direction-u təmsil edir.
\[ Fr_j=\sum_{i=1}^{k}x_{j,i}v_i \tag{5} \]
\[ Fr=[Fr_1,\ldots,Fr_N] \tag{6} \]
Tənlik 5–6 hər nümunəni seçilmiş principal direction-lara proyeksiya edir və reduced feature matrix-i yaradır.
\[ z_{j,i}= \frac{x_{j,i}-\mu_i} {\sqrt{\frac{1}{N}\sum_{k=1}^{N}(x_{k,i}-\mu_i)^2}} \tag{7} \]
\[ Z=[z_{j,i}], \qquad i\in\{1,\ldots,k\} \tag{8} \]
Tənlik 7–8 principal component dəyərlərini scale edərək normalization matrisi \(Z\)-ni yaradır. Mənbədə fiziki vahid göstərilmir; normallaşdırmadan sonrakı dəyərlər miqyaslanmış feature dəyərləridir.
Tənlik 9–17: LSTM, reconstruction error və anomaly score
\[ h_t=LSTM(x_t,h_{t-1}), \qquad x_t\in Z \tag{9} \]
\[ c_t=\sigma_f\odot c_{t-1}+\sigma_i\odot\tilde{c}_t \tag{10} \]
Tənlik 9–10 zaman sırasının LSTM hidden state və cell-state daxilində daşınmasını ifadə edir. \(\odot\) element üzrə vurmadır.
\[ \hat{x}_t=Decoder(h_t) \tag{11} \]
\[ E_t=\sum_{i=1}^{d}(x_{t,i}-\hat{x}_{t,i})^2 \tag{12} \]
\[ E_{total}=\sum_{t=1}^{T}E_t \tag{13} \]
Tənlik 11–13 Autoencoder decoder-ın reconstructed input yaratmasını və real girişlə fərqinin squared reconstruction error kimi hesablanmasını təsvir edir.
\[ \mu_E=\frac{1}{T}\sum_{t=1}^{T}E_t \tag{14} \]
\[ \sigma_E= \sqrt{\frac{1}{T}\sum_{t=1}^{T}(E_t-\mu_E)^2} \tag{15} \]
\[ A_t=\frac{E_t-\mu_E}{\sigma_E} \tag{16} \]
Tənlik 14–16 reconstruction error-u öz orta və standard deviation dəyərinə görə normallaşdırır. \(A_t\), zaman \(t\)-dəki standardize anomaly score-dur.
\[ A_{i,t}= \sum_{j=1}^{w} \left( \frac{e_{i,t-j}}{\sigma_i} \right)^2 \alpha_j \tag{17} \]
Tənlik 17, keçmiş \(w\) pəncərəsindəki error terminlərini çəkili şəkildə birləşdirən smoothed anomaly score ifadəsidir. \(\alpha_j\) mənbədə çəki əmsalı kimi istifadə olunur.
Tənlik 18–23: Feature correlation, ranking və Softmax təsnifatı
\[ Cov(f_i,f_j)= \frac{1}{N}\sum_{t=1}^{N} (f_{t,i}-\mu_i)(f_{t,j}-\mu_j) \tag{18} \]
\[ C_{i,j}= \frac{\sum_{t=1}^{N}(f_{t,i}-\mu_i)(f_{t,j}-\mu_j)} {\sqrt{\sum_{t=1}^{N}(f_{t,i}-\mu_i)^2} \sqrt{\sum_{t=1}^{N}(f_{t,j}-\mu_j)^2}} \tag{19} \]
Tənlik 18 covariance, Tənlik 19 correlation strukturunu hesablayır.
\[ S_i=\sum_{j=1}^{d}|C_{i,j}| \tag{20} \]
\[ Rank(f_i)=sort(S_i) \tag{21} \]
Feature contribution digər feature-larla absolute correlation cəmi üzərindən sıralanır.
\[ z_c=\sum_{i=1}^{k}w_{c,i}x_i+b_c \tag{22} \]
\[ P(y=c\mid x)= \frac{e^{z_c}} {\sum_{j=1}^{C}e^{z_j}} \tag{23} \]
Tənlik 22 sinif logit-ini, Tənlik 23 Softmax ehtimalını hesablayır. Softmax çıxışı cəmi 1 olan sinif ehtimalları yaradır.
Tənlik 24–28: Loss, backpropagation və Adam
\[ L= \sum_{t=1}^{T}\sum_{i=1}^{d} (x_{t,i}-\hat{x}_{t,i})^2 \tag{24} \]
\[ \frac{\partial L}{\partial w} = \sum_{t=1}^{T} \frac{\partial L}{\partial h_t} \frac{\partial h_t}{\partial w} \tag{25} \]
\[ \Delta w= -\eta \sum_{t=1}^{T}\nabla_w L \tag{26} \]
Tənlik 24 reconstruction loss-u, Tənlik 25–26 gradient əsaslı weight update zəncirini göstərir. \(\eta\) learning rate-dir.
\[ m_t=\beta_1m_{t-1}+(1-\beta_1)\nabla_t \tag{27} \]
\[ v_t=\beta_2v_{t-1}+(1-\beta_2)\nabla_t^2 \tag{28} \]
Tənlik 27–28 Adam optimizer-ın birinci və ikinci moment təxminlərini təmsil edir. Mənbə bu tənlikləri verir, lakin PDF-də istifadə olunan sayısal \(\beta_1\), \(\beta_2\) və learning-rate dəyərlərini açıq hiperparametr cədvəlində təqdim etmir.
Tənlik 29–35: Logging, fault vector və recovery trigger
\[ Log(t)=\sum_{i=1}^{k}x_{t,i}\delta_i \tag{29} \]
\[ \delta_i=\mathbf{1}\{A_t>\theta_A\} \tag{30} \]
\[ F_t=\{x_t\mid A_t>\theta_A\} \tag{31} \]
\[ ID= \sum_{i=1}^{k} hash(x_{t,i},t+i) \tag{32} \]
\[ S_t= \frac{A_t} {\sum_{i=1}^{T}A_i} \tag{33} \]
\[ R_t=\mathbf{1}\{S_t>\tau\}, \qquad Log(t)=\{x_t,A_t,S_t,R_t\} \tag{34} \]
\[ U_t=\sum_{j=1}^{M}\omega_j\psi_j(t) \tag{35} \]
Tənlik 29–35 anomaly-nin loglanması, threshold-u aşan feature vector-ların fault vector-a daxil edilməsi, severity score hesablanması və recovery trigger yaradılması üçün istifadə olunan mənbə zənciridir. \(\theta_A\) anomaly threshold, \(\tau\) recovery decision threshold və \(\omega_j\) çəki əmsallarıdır.
Kontekstual Etibar Balı Necə Hesablanır?
Context-aware trust scoring modulu anomaly detector-dan gələn fault vector-u hər düyünün response reliability, authentication success, fault history və inactivity məlumatları ilə birləşdirərək trust dəyərini davamlı yeniləyir; dəyərlər normallaşdırılır, qlobal ortalamadan sapmalar hesablanır və düyünlər trusted, suspicious və ya untrusted kimi təsnif edilir.
Mənbədə görünməyən trust-update tənliyi
Section 3.3 trust score-un previous trust, response reliability və fault history üçün tunable weight-lər ehtiva edən time-decaying tənliklə yeniləndiyini bildirir. Lakin yayımlanmış PDF görüntüsündə “the score is updated as:” cümləsindən sonra bu tənlik görünmür. Buna görə Verianla itkin tənliyi ümumi trust-score formulu ilə tamamlamır.
Tənlik 36–45: Fault vector və davranış siqnalları
\[ F_t=\{x_t\mid A_t>\theta_A\} \tag{36} \]
\[ N_f= \sum_{i=1}^{N} \mathbf{1}\{A_i(t)>\theta_A\}\,n_i \tag{37} \]
\[ T_i(0)= \frac{1}{K} \sum_{k=1}^{K}T^{init}_{i,k} \tag{38} \]
\[ R_i(0)= \sum_{j=1}^{M}\rho^{(0)}_{i,j} \tag{39} \]
\[ F_i(0)= \sum_{j=1}^{M}\phi^{(0)}_{i,j} \tag{40} \]
\[ \Delta S_i(t)= \sum_{j=1}^{T} \left( \gamma_1R_i(j)+ \gamma_2A_i(j)- \gamma_3F_i(j) \right) \tag{41} \]
Tənlik 41-də response və authentication töhfələri trust istiqamətində müsbət, fault tarixçəsi isə mənfi çəki ilə davranış skoruna daxil olur. \(\gamma_1,\gamma_2,\gamma_3\) tunable weight-lərdir.
\[ R_i(t+1)= \sum_{j=1}^{t}\delta_{r_i,j} + R_i(0) \tag{42} \]
\[ A_i(t+1)= \sum_{j=1}^{t}\delta_{a_i,j} + A_i(0) \tag{43} \]
\[ F_i(t+1)= \sum_{j=1}^{t}\delta_{f_i,j} + F_i(0) \tag{44} \]
\[ \Delta S_i(t+1)= \sum_{j=1}^{t+1} \left( \gamma_1R_i(j)+ \gamma_2A_i(j)- \gamma_3F_i(j) \right) \tag{45} \]
Bu tənliklər response, authentication və fault hadisələrini zaman boyunca toplayaraq rolling behavior score yaradır.
Tənlik 46–57: Trust yenilənməsi, decay və node classification
\[ T_i(t+1)= \frac{1}{t+1} \sum_{j=0}^{t} \left( \alpha T_i(j)+ \beta\Delta S_i(j) \right) \tag{46} \]
\[ T_i^{cumulative} = \sum_{j=1}^{t+1}T_i(j) \tag{47} \]
\[ D_i(t)= \sum_{j=1}^{t} T_i(j)e^{-\lambda j} \tag{48} \]
Tənlik 48 inactive və ya köhnə trust məlumatını exponential decay ilə azaldır. \(\lambda\) decay factor-dur.
\[ T_i^{norm}= \frac{T_i(t)} {\sum_{j=1}^{m}T_j(t)} \tag{49} \]
\[ \bar{T}(t)= \frac{1}{m} \sum_{j=1}^{m}T_j(t) \tag{50} \]
\[ \Delta T_i= |T_i(t)-\bar{T}(t)| \tag{51} \]
Tənlik 49–51 hər node trust dəyərini şəbəkə üzrə normallaşdırır və global trust average-dan sapmanı hesablayır.
\[ Trusted_i= \sum_{j=1}^{m} \mathbf{1}\{T_j^{nr}>\tau\}\delta_{ij} \tag{52} \]
\[ Untrusted_i= \sum_{j=1}^{m} \mathbf{1}\{T_j^{nr}<\tau\}\delta_{ij} \tag{53} \]
\[ Suspicious_i= \sum_{j=1}^{m} \mathbf{1}\{\Delta T_j>\epsilon\}\delta_{ij} \tag{54} \]
Mənbə Tənlik 49-da \(T^{norm}\), təsnifat tənliklərində isə \(T^{nr}\) notation istifadə edir. Verianla bu iki göstərimi mənbədə qəti şəkildə eyni simvola çevirmir; kontekst hər ikisinin normallaşdırılmış trust dəyərini təmsil etdiyini düşündürsə də mənbə notation-u tam ardıcıl deyil.
\[ T_{goa}(t)= \sum_{i=1}^{m} T_i(t)\delta_i^{(active)} \tag{55} \]
\[ S_{flagged}= \sum_{i=1}^{m} \mathbf{1}\{T_i^{nr}<\tau\}n_i \tag{56} \]
\[ TrustedList_t= \sum_{i=1}^{m} \mathbf{1}\{T_i^{nr}>\tau\}n_i \tag{57} \]
Bu son addım recovery moduluna yalnız threshold-u keçən doğrulanmış düyünlərin ötürülməsini məqsəd qoyur.
Avtonom Bərpa və Reinforcement Learning Bu Arxitekturada Nə Edir?
Avtonom recovery modulu trust modulunun doğruladığı düyünlər arasından resurs və vəzifə uyğunluğu yüksək olanları seçir; trafikin yenidən yönləndirilməsi, düyün izoliyasiyası, rolun yenidən təyin edilməsi, load redistribution, policy update və service redeployment kimi əməliyyatları tətbiq edir və nəticə uğursuz olarsa reinforcement learning geriəlaqəsi ilə recovery siyasətini yenidən tənzimləyir.
RL agent-in state, action və reward strukturu
State, mövcud fault context və network topology məlumatını ehtiva edir. Action, dynamic role assignment və containment/reconfiguration əməliyyatlarıdır. Reward, downtime reduction, trust preservation və policy compliance kimi nəticələri birləşdirən composite qiymətləndirmədir.
Tənlik 58–66: Etibarlı node seçimi və compatibility
\[ T^{*}= \left\{ n_i\mid T_i^{*}= \frac{T_i}{\max(T)} > \tau_{trust} \right\} \tag{58} \]
\[ M^{trust}= \sum_{i\in T^{*}} T_i^{*}\omega_i \tag{59} \]
\[ R_i= \sum_{j=1}^{m} \kappa_{ij}\theta_j \tag{60} \]
\[ R_i^{nr}= \frac{R_i}{\max(R)} \tag{61} \]
\[ S_i= R_i^{nr} \left( 1+ \frac{1}{T} \sum_{t=1}^{T}\phi_{i,t} \right) \tag{62} \]
Bu zəncirdə \(R_i\) node recovery capability/role fitness tipli bir balı, \(\phi_{i,t}\) isə recent cooperative və ya participative metric-i təmsil edir.
\[ \Delta_i= \sqrt{ \sum_{j=1}^{m} (d_j-\kappa_{ij})^2 } \tag{63} \]
\[ \Gamma_i= \frac{S_i}{1+\Delta_i} \tag{64} \]
\[ R_{sre}=sort_{desc}(\Gamma_i) \tag{65} \]
\[ R_{top}= \{n_i\in R_{sre}\mid i=1,\ldots,k\} \tag{66} \]
Tənlik 63–66 node capability ilə recovery requirement arasındakı fərqi ölçərək compatibility score yaradır və ən yüksək skorlu \(k\) node-u recovery üçün seçir.
Tənlik 67–73: Rol çəkisi, topology, load və recovery effectiveness
\[ Total= \sum_{j=1}^{k} \left(T'_j+R_j\right) \tag{67} \]
\[ \alpha'_i= \alpha_i \left( 1+ \frac{s_1+s_2+\cdots+s_T}{T} \right) \tag{68} \]
Mənbə \(s_T\)-ni zaman \(t\)-dəki system strain/load kontekstində müəyyən edir.
\[ P_{ij}= \sum_{l\in Path(i,j)} \left( \frac{b_l}{1+\lambda_l} \right) T_l \tag{69} \]
Tənlik 69 communication path-i bandwidth, latency və trust əlaqəsi üzərindən yenidən çəkiləndirir.
\[ L_i= \alpha'_iL_{total} \tag{70} \]
\[ Policy_{new}= Policy_{old}+ \sum_{i=1}^{k}\alpha'_i \tag{71} \]
\[ \psi_t= \sum_{i=1}^{k} \left( \lambda_i^{(t)}- \delta_i^{(t)} \right)\omega_i \tag{72} \]
\[ E_{rec}= \frac{\psi_t} {\psi_t+ \sum_{i=1}^{k}\delta_i^{(t)}} \tag{73} \]
Tənlik 72–73 recovery-dən sonrakı improvement və recovery effectiveness nisbətini təsvir edir. Mənbə müxtəlif bölmələrdə \(\lambda\) simvolunu fərqli mənalarda istifadə edə bildiyi üçün simvol adları kontekstə görə oxunmalıdır.
Tənlik 74–77: Q-learning, policy refinement və stabilizasiya
\[ Q(s,a)= Q(s,a)+ \alpha \left[ r+ \gamma \max_{a'} Q(s',a') - Q(s,a) \right] \tag{74} \]
Tənlik 74 standart temporal-difference Q-learning update məntiqini recovery policy tuning-ə tətbiq edir. \(\alpha\) learning rate, \(\gamma\) gələcək reward-un discount factor-udur.
\[ \theta_{t+1}= \theta_t- \eta\nabla_{\theta}L(\theta_t) \tag{75} \]
\[ Stable \Longleftrightarrow \frac{1}{T} \sum_{t=1}^{T} |\delta_t| < \epsilon \tag{76} \]
\[ N_{sal}= \{n_i\mid L_i<\delta_{max} \land E_{rec}>\tau \} \tag{77} \]
Tənlik 75 strategy parameter update-ı, Tənlik 76 stability criterion-u, Tənlik 77 isə load və recovery effectiveness şərtlərini ödəyən final resilient node set-i ifadə edir. Mənbənin notation siyahısında final set üçün fərqli “\(N_{resilient}\)” adlandırması da var; Verianla bu notation fərqini səssizcə düzəltmir.
Nəzəri hesablama mürəkkəbliyi
| Komponent | Mənbə mürəkkəbliyi | Elmi rol |
|---|---|---|
| PCA / SVD | O(n log n) | Yüksəkölçülü telemetry üçün dimensionality reduction |
| Shallow Autoencoder | O(n · d) | Compact representation və reconstruction-error anomaly detection |
| Autoencoder training izahı | O(n · d · e) | n nümunə, d feature, e epoch ehtiva edən təlim xərci |
| LSTM | O(T · H²) | Temporal dependency modelləşdirmə |
| Attention | O(T² · d) | Zaman addımları arasındakı attention əlaqələri |
| GNN | O(E · d²) | Trust propagation / topology-aware qiymətləndirmə |
| Energy-Based Model | O(n · d²) | Energy-function anomaly scoring |
| Mahalanobis distance | O(d²) | Covariance-aware anomaly deviation |
| Dynamic thresholding | O(n) | Quantile və ya statistical adaptive threshold |
| RL / Policy Gradient | O(n · A · T) | Recovery-policy optimization |
| Trust score computation | O(n) | Düyün trust dəyərlərini yeniləmə |
| Trust-aware graph traversal | O(V + E) | Şəbəkə düyünləri və əlaqələrində traversal |
| Kafka / Flink streaming ingestion | O(m) / record | m concurrent stream altında axın telemetriyası |
Bu mürəkkəbliklər mənbə müəlliflərinin nəzəri qiymətləndirməsidir. Real runtime yalnız Big-O notasiya ilə müəyyən edilə bilməz; hardware, implementation, batch size, feature dimension, sequence length və concurrency kimi şərtlərdən asılıdır.
Tədqiqatın Metodu və Nəticələri
Verilənlər dəstləri və qiymətləndirmə əhatəsi
Tədqiqat CICIDS/CIC-IDS-2017 və NSL-KDD benchmark verilənlər dəstlərini intrusion-detection telemetry nümunələri kimi istifadə edir. Müəlliflər bu verilənlər dəstlərinin micro-segmentation, continuous authentication və ya dynamic policy enforcement daxil olmaqla tam production Zero-Trust arxitekturasını təmsil etmədiyini açıq şəkildə qəbul edirlər.
Buna görə verilənlər dəstlərindən çıxarılan nəticələr ZTNA-nın bütün əməliyyat davranışının doğrulanması deyil. Verilənlər dəstləri abnormal behavior, unauthorized access və distributed attack kimi təhlükəsizlik hallarını modelləşdirmək üçün istifadə edilmiş; trust scoring və recovery komponentləri bunların üzərinə əlavə edilmişdir.
Reproducibility baxımından çatışmayan təfərrüatlar
Mənbə yenidən işlənmiş məqalənin learning rate, optimizer, batch size, epoch sayı, hidden-layer size və dynamic threshold kimi təfərrüatları ehtiva etdiyini bildirir. Lakin yayımlanmış PDF-də bunların sayısal dəyərlərini bir yerdə verən açıq hiperparametr cədvəli görünmür. Eyni şəkildə training/validation/test split-lərin təfərrüatlı təsvir edildiyi deyilsə də PDF mətnində dəqiq split faizləri açıq şəkildə yoxdur.
Verianla buna görə learning rate, batch size, epoch və ya split nisbəti uydurmur.
Çoxsinifli confusion matrix
| Həqiqi sinif \ Proqnoz | DDoS | Unauthorized Access | Data Exfiltration |
|---|---|---|---|
| DDoS | 34 | 31 | 30 |
| Unauthorized Access | 41 | 30 | 24 |
| Data Exfiltration | 48 | 26 | 21 |
Bu matris attack-type separation-ın çətin olduğunu göstərir. DDoS hadisələrinin 34-ü düzgün təsnif edildiyi halda 61-i digər iki sinfə getmişdir. Unauthorized Access üçün 30 düzgün; Data Exfiltration üçün yalnız 21 düzgün təsnifat var.
Müəlliflər xüsusilə Data Exfiltration ilə DDoS arasındakı davranış overlap-in sinif sərhədlərini qeyri-müəyyənləşdirdiyini bildirirlər.
%97 Anomaliya Aşkarlama Dəqiqliyi Çoxsinifli Confusion Matrix ilə Eyni Nəticədirmi?
Xeyr. Mənbə %97 ümumi system-level detection accuracy dəyərinin adaptive threshold, contextual trust scoring, temporal attention və RL-based recovery optimization ehtiva edən inteqrasiya olunmuş sistemin aggregate anomaly-detection/recovery qiymətləndirməsindən gəldiyini; Figure 14-dəki çoxsinifli confusion matrix-in isə attack-type separation üçün daha məhdud və erkən mərhələ qiymətləndirmə olduğunu açıq şəkildə ayırır.
Bu fərq kritikdir. Figure 14-dəki çoxsaylı off-diagonal səhvləri nəzərə almadan “model DDoS, Unauthorized Access və Data Exfiltration-ı %97 dəqiqliklə bir-birindən ayırır” demək mənbə ilə uyğun deyil.
Attack-specific Mean Time to Detect
Mənbə mətni klassik/baseline sistemlər üçün üç hücum sinfində 2,3 s, 2,7 s və 2,9 s səviyyələrində detection time; təklif olunan üsul üçün Unauthorized Access 1,9 s, Data Exfiltration 2,0 s və DDoS 1,6 s dəyərlərini bildirir.
Nəticə bölməsində xüsusilə DDoS üçün MTTD = 1,6 s yenidən qeyd edilir.
Attack-specific F1 nəticələri
Təklif olunan model üçün mənbə DDoS F1 = 0,965, Unauthorized Access F1 = 0,945 və Data Exfiltration F1 = 0,920 dəyərlərini bildirir.
DDoS müqayisəsində Deep SVDD 0,872 və TranAD 0,928 kimi verilir. Unauthorized Access müqayisəsində mənbə USAD/DAGMM üçün təxminən 0,892–0,878 aralığını ifadə edir. Data Exfiltration üçün USAD 0,865 dəyəri açıq şəkildə göstərilir.
Ümumi precision, recall və F1 müqayisəsi
| Model | Precision | Recall | F1 |
|---|---|---|---|
| Rule-Based | 0,842 | 0,810 | 0,825 |
| LSTM-Only | 0,912 | 0,897 | 0,904 |
| Autoencoder-LSTM | Mənbə mətni təxminən 0,944 ətrafında performans bildirir | Mənbə mətni təxminən 0,944 ətrafında performans bildirir | Mənbə mətni təxminən 0,944 ətrafında performans bildirir |
| Proposed Method | 0,962 | 0,955 | 0,958 |
ROC/AUC müqayisəsi
Mənbə Figure 13 izahında classical detection üsullarının DDoS, Unauthorized Access və Data Exfiltration üçün AUC dəyərlərini 0,51-dən aşağı, yəni random discrimination-a yaxın kimi təsvir edir.
Mənbə mətnində inkişaf etmiş anomaly-detection modelləri üçün bu AUC dəyərləri verilir: Deep SVDD = 0,740; DAGMM = 0,780; USAD = 0,760; TranAD = 0,810.
Accuracy, specificity və sensitivity
Mənbə Figure 22 izahında təklif olunan üsul üçün Accuracy = 0,960, Specificity = 0,958 və Sensitivity = 0,959 bildirir.
Accuracy bütün proqnozların düzgünlüyünü; specificity normal/non-anomalous nümunələri düzgün şəkildə rədd etmə qabiliyyətini; sensitivity isə real anomaly nümunələrini tutma nisbətini ifadə edir.
False-positive rate və recovery latency ablation-u
| Konfiqurasiya | False Positive Rate | Recovery Latency (s) |
|---|---|---|
| Full model | 0,032 | 2,3 |
| No trust module | 0,071 | 2,3 |
| No RL policy | 0,046 | 4,1 |
| No feature fusion | 0,065 | 3,2 |
| Only Autoencoder | 0,058 | 3,5 |
Trust modulu çıxarıldıqda false-positive rate 0,032-dən 0,071-ə yüksəlir. RL policy çıxarıldıqda recovery latency 2,3 s-dən 4,1 s-yə yüksəlir. Bu ablation-lar iki modulun fərqli funksiyalara töhfə verdiyini göstərir: trust scoring xüsusilə yanlış həyəcanların nəzarəti ilə, RL isə recovery sürəti ilə əlaqələndirilir.
Genişləndirilmiş component-wise ablation
| Konfiqurasiya | FPR | Recovery Latency (s) | Precision | Recall |
|---|---|---|---|---|
| Full model | 0,032 | 2,300 | 0,946 | 0,943 |
| No trust module | 0,071 | 2,300 | 0,901 | 0,871 |
| No RL policy | 0,046 | 4,100 | 0,917 | 0,896 |
| No fault vector filtering | 0,059 | 3,800 | 0,910 | 0,882 |
| No behavior scoring | 0,064 | 3,500 | 0,905 | 0,879 |
| Only Autoencoder | 0,057 | 3,700 | 0,912 | 0,890 |
| No feature fusion | 0,065 | 3,200 | 0,906 | 0,884 |
CICIDS üzrə üsul müqayisəsi
| Model | Accuracy | Precision | Recall | F1 | Training Time (min) | Memory (MB) |
|---|---|---|---|---|---|---|
| Proposed Autoencoder-LSTM | 0,961 | 0,950 | 0,939 | 0,944 | 18 | 420 |
| CNN-GRU | 0,942 | 0,932 | 0,922 | 0,927 | 22 | 460 |
| BiLSTM-Attn | 0,933 | 0,921 | 0,916 | 0,918 | 20 | 440 |
| GCN-LSTM | 0,926 | 0,914 | 0,908 | 0,911 | 25 | 470 |
| SAE-SVM | 0,912 | 0,900 | 0,888 | 0,893 | 15 | 350 |
| Random Forest | 0,892 | 0,878 | 0,865 | 0,871 | 14 | 300 |
| Isolation Forest | 0,861 | 0,851 | 0,840 | 0,845 | 12 | 250 |
| Transformer-IDS | 0,939 | 0,928 | 0,914 | 0,920 | 21 | 455 |
| Hybrid-VAE-GRU | 0,953 | 0,940 | 0,928 | 0,934 | 19 | 430 |
| AE-RL | 0,949 | 0,937 | 0,923 | 0,930 | 17 | 415 |
| Rule-Based | 0,845 | 0,838 | 0,812 | 0,825 | 6 | 160 |
Bu cədvəldə proposed Autoencoder-LSTM accuracy 0,961-dir. Bunun əksinə Discussion 5.1 mətni eyni CICIDS qiymətləndirməsində accuracy 0,950 və precision 0,951 dəyərlərini yazır. Verianla cədvəli səssizcə mətnə görə dəyişdirmir; mənbədəki iki fərqli hesabatı ayrı saxlayır.
Hybrid arxitektura ablation-u
| Model variantı | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|
| Full model — AE + LSTM + RL + Trust | 0,975 | 0,971 | 0,978 | 0,974 | 0,982 |
| Without trust module | 0,942 | 0,935 | 0,944 | 0,939 | 0,961 |
| Without RL policy | 0,951 | 0,942 | 0,955 | 0,948 | 0,968 |
| Without feature fusion | 0,948 | 0,938 | 0,952 | 0,945 | 0,965 |
| Only Autoencoder | 0,931 | 0,922 | 0,937 | 0,929 | 0,951 |
| AE + RL — No LSTM | 0,945 | 0,938 | 0,951 | 0,944 | 0,962 |
| AE + LSTM — No RL | 0,957 | 0,948 | 0,961 | 0,954 | 0,971 |
| AE + Transformer | 0,960 | 0,953 | 0,964 | 0,958 | 0,975 |
Full model bütün Table 6 metriklərində ən yüksək dəyəri verir. Trust modulu çıxarıldıqda F1 0,939-a, RL çıxarıldıqda 0,948-ə enir.
Discussion 5.3-də “removal of the trust module resulted in a F1 score of 3.6” ifadəsi yer alır. F1-score-un bu tədqiqatda 0–1 aralığında bildirilməsi və Table 6-nın 0,939 göstərməsi səbəbilə bu mətn Table 6 ilə uyğun gəlmir. Verianla 3,6 dəyərini elmi nəticə kimi istifadə etmir.
Fault-detection performans müqayisəsi
| Üsul | Detection Accuracy (%) | False Positive Rate (%) | Detection Latency (ms) | Scalability (%) | Model Complexity (1–10) | Resource Usage (MB) |
|---|---|---|---|---|---|---|
| Deep neural network-based anomaly detection | 95 | 3,5 | 54 | 88 | 7 | 200 |
| RL for policy-based recovery | 93 | 4,2 | 67 | 85 | 8 | 185 |
| Federated learning-based distributed fault analytics | 92 | 3,8 | 60 | 92 | 6 | 165 |
| GNN for topological fault mapping | 94 | 4,0 | 64 | 89 | 8 | 195 |
| LSTM-based log sequence anomaly detection | 94 | 3,6 | 55 | 87 | 7 | 170 |
| Proposed method | 97 | 2,4 | 48 | 95 | 6 | 160 |
Table 7-nin proposed-method sətri %97 detection accuracy, %2,4 false-positive rate, 48 ms detection latency, %95 scalability score və 160 MB resource usage bildirir.
Recovery və adaptivity müqayisəsi
| Üsul | Recovery Time (ms) | Success Rate (%) | Self-Adaptivity (%) | Downtime Reduction (%) | Policy Compliance (%) | Learning Efficiency (1–10) |
|---|---|---|---|---|---|---|
| Deep neural network-based anomaly detection | 130 | 91 | 87 | 84 | 90 | 7 |
| RL policy-based recovery | 98 | 94 | 90 | 89 | 93 | 9 |
| Federated learning distributed fault analytics | 105 | 90 | 86 | 86 | 89 | 8 |
| GNN topological fault mapping | 110 | 91 | 88 | 85 | 92 | 8 |
| LSTM log-sequence anomaly detection | 120 | 92 | 89 | 87 | 91 | 8 |
| Proposed method | 90 | 96 | 93 | 93 | 96 | 10 |
Table 8 proposed method üçün 90 ms recovery time və %96 success rate verir. Lakin Figure 20/Conclusion fərqli müqayisədə 1,8 s MTTR və 0,99 recovery success bildirir. Mənbə bu iki recovery ölçümünün eksperimental protokollarını vahid izahlı cədvəldə uyğunlaşdırmadığı üçün Verianla onları eyni dəyər ailəsi kimi birləşdirmir.
MTTR müqayisəsi
Mənbə Figure 20 izahında proposed method üçün MTTR = 1,8 s və recovery success = 0,99; Autoencoder-LSTM üçün MTTR = 2,3 s və success təxminən 0,97; Rule-Based üsul üçün MTTR = 5,1 s və success təxminən 0,82 bildirir.
Bu dəyərlər Table 8-dəki “Recovery Time (ms)” sütunu ilə eyni metrik adı altında verilmədiyi üçün aralarında birbaşa vahid çevrilməsi aparılaraq bərabərləşdirilməyib.
Memory-consumption simulyasiyası
Mənbə 1.000-node və 10.000-node ssenarilərində 5 fault və 20 fault yüklərini müqayisə edir. Proposed method üçün bildirilən memory footprint müvafiq olaraq təxminən 160 MB, 200 MB, 780 MB və 910 MB-dır.
Ənənəvi sistemin ən kiçik ssenaridə 180 MB, ən böyük 10.000-node/20-fault ssenarisində 1040 MB istifadə etdiyi açıq şəkildə bildirilir. Buna görə ən böyük ssenaridə proposed method-un mənbədə verilən 910 MB dəyəri “910 MB qənaət” deyil, ümumi memory usage-dır.
F1 paylanması və qeyri-müəyyənlik
Mənbə Figure 17-də attack-specific F1 sütunları üçün ±1 standard deviation (\(\pm1\sigma\)) error bar istifadə olunduğunu bildirir. Figure 19 isə müxtəlif modellərin F1-score paylanmalarını boxplot formasında müqayisə edir və proposed method üçün yüksək median və nisbətən dar paylanma bildirir.
Mənbə bu bölmədə formal p-value, confidence interval və ya named hypothesis test bildirmir. Buna görə “statistik olaraq əhəmiyyətli” ifadəsi üçün mənbədənkənar p-dəyəri yaradılmayıb.
Tədqiqatın dəstəklədiyi nəticələr
- Benchmark və simulyasiya qiymətləndirməsində təklif olunan inteqrasiya olunmuş sistem %97 system-level anomaly-detection accuracy bildirmişdir.
- Mənbə %96 autonomous-recovery success və %93 downtime reduction bildirir.
- DDoS üçün proposed method F1-score 0,965 və MTTD 1,6 s kimi bildirilmişdir.
- Ümumi proposed-method precision 0,962, recall 0,955 və F1 0,958 dəyərləri ayrıca model müqayisəsində bildirilmişdir.
- Table 6 full hybrid model üçün accuracy 0,975, F1 0,974 və AUC 0,982 verir.
- Trust module-un çıxarılması false-positive rate və detection keyfiyyətinə mənfi təsir göstərmişdir.
- RL policy-nin çıxarılması recovery latency-ni artırmışdır.
- 10.000-node simulyasiyalarında proposed method üçün 780–910 MB səviyyəsində yaddaş istifadəsi bildirilmişdir.
- Kafka və Flink real-time deployment iddiasının ölçülmüş nəticəsi kimi deyil, aşağı gecikməli streaming architecture komponentləri kimi arxitekturaya daxil edilmişdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- %97 accuracy real enterprise Zero-Trust şəbəkəsində sahə uğuru deyil.
- Figure 14 üç attack class-ın %97 dəqiqliklə bir-birindən ayrıldığını göstərmir.
- Federated-learning modulunun böyük miqyaslı edge deployment performansı bu tədqiqatda doğrulanmayıb.
- 90 ms recovery time, 1,8 s MTTR və 2,3 s recovery latency tək və eyni metrik kimi şərh edilə bilməz.
- 910 MB dəyəri 910 MB yaddaş qənaəti demək deyil; böyük simulyasiya ssenarisindəki reported proposed-method usage dəyəridir.
- Source PDF-də numeric learning rate, batch size, epoch count və exact data split nisbətləri açıq göstərilmədiyi üçün reproducibility-nin bütün parametrləri mövcud deyil.
- Mənbədə görünməyən Mahalanobis və ya Section 3.3 trust-update tənlikləri Verianla tərəfindən tamamlanmayıb.
- Benchmark nəticələri digər network topologiyaları, real istifadəçi trafiki, fərqli concept drift şərtləri və ya uzunmüddətli hücum adaptasiyası üçün avtomatik zəmanət yaratmır.
Mənbədəki hesabat fərqləri
| Mövzu | Mənbə mövqeyi A | Mənbə mövqeyi B | Verianla yanaşması |
|---|---|---|---|
| CICIDS accuracy | Table 5: 0,961 | Discussion 5.1: 0,950 | İki hesabat ayrı saxlanılır; zorla tək dəyərə birləşdirilmir. |
| Trust-module F1 | Table 6: 0,939 | Discussion 5.3: “3.6” | Table 6 dəyəri ötürülür; 3,6 ifadəsi mənbədaxili uyğunsuzluq kimi işarələnir. |
| Recovery | Table 3–4: 2,3 s recovery latency | Figure 20/Conclusion: 1,8 s MTTR | Metrik adları fərqli olduğuna görə bərabərləşdirilmir. |
| Recovery | Table 8: 90 ms recovery time, %96 success | Figure 20: 1,8 s MTTR, 0,99 success | Fərqli eksperiment/ölçmə kontekstləri kimi saxlanılır. |
| Memory | Abstract: “910 MB memory usage optimization” | Figure 21 text: 910 MB proposed usage, 1040 MB traditional usage | 910 MB “qənaət” kimi şərh edilmir. |
| Trust notation | Tənlik 49: T norm | Tənlik 52–57: T nr | Notation səssizcə standartlaşdırılmır. |
Gələcək tədqiqat istiqamətləri
Mənbə gələcəkdə enterprise-scale real-time Zero-Trust deployment, asynchronous federated optimization, decentralized adaptive policy learning, graph-aware trust propagation, lightweight edge-compatible architecture və live software-defined Zero-Trust telemetry üzərində doğrulama təklif edir.
Bu gələcək tədqiqat sahələri mövcud məqalənin əldə edilmiş nəticəsi deyil. Xüsusilə federated learning mənbədə architecture-level inteqrasiya kimi təqdim olunsa da, böyük miqyaslı paylanmış edge eksperimentlərinin daha sonra aparılacağı bildirilmişdir.
Mənbə və Metod Qeydi
Özgün başlıq: Artificial Intelligence driven fault detection and autonomous recovery in zero trust network architectures
Müəlliflər və sıra: Sami Morsi; Rajit Nair; Hasan Alkahtani; Sultan Ahmad; Theyazn H. H. Aldhyani; Hikmat A. M. Abdeljaber.
Corresponding author: Sultan Ahmad.
Corresponding e-poçt: s.alisher@psau.edu.sa
Affiliasiya 1: Applied College, King Faisal University, 31982 Al-Ahsa, Saudi Arabia.
Affiliasiya 2: VIT Bhopal University, Bhopal, India.
Affiliasiya 3: College of Computer Science and Information Technology, King Faisal University, P.O. Box 400, 31982 Al-Ahsa, Saudi Arabia.
Affiliasiya 4: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam Bin Abdulaziz University, 11942 Alkharj, Saudi Arabia.
Affiliasiya 5: Department of Computer Science and Engineering, University Center for Research and Development (UCRD), Chandigarh University, Gharuan, Mohali, Punjab 140413, India.
Affiliasiya 6: Department of Extended-Reality and Games Development, Faculty of Information Technology, Applied Science Private University, 11831 Amman, Jordan.
Müəllif-affiliasiya uyğunluğu: Sami Morsi — 1; Rajit Nair — 2; Hasan Alkahtani — 3; Sultan Ahmad — 4 və 5; Theyazn H. H. Aldhyani — 1; Hikmat A. M. Abdeljaber — 6.
Bərabər töhfə: Mənbə ayrıca equal-contribution və ya equal-first-authorship bəyanatı vermir.
Jurnal: Discover Artificial Intelligence.
Nəşriyyat/platforma: Springer Nature / Springer.
Cild: Volume 6.
Məqalə nömrəsi: 871.
Nəşr ili: 2026.
Məqalə növü: Research.
DOI: 10.1007/s44163-026-01654-w.
Rəsmi keçid: https://doi.org/10.1007/s44163-026-01654-w
Received: 26 Fevral 2026.
Accepted: 15 İyun 2026.
Published: Springer-in rəsmi məqalə qeydinə görə 7 İyul 2026.
Version of record: Springer-in rəsmi qeydində 21 Avqust 2026.
Rəyçilik qeydi: Mənbə yayımlanmış Springer Research məqaləsidir və Received/Accepted tarixləri bildirilir. Mənbə PDF tətbiq edilmiş rəyçilik modelinin single-blind/double-blind kimi təfərrüatını göstərmir.
Lisenziya: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Lisenziyanın vizual təsiri: Lisenziya adapted material paylaşımına icazə vermədiyi üçün Verianla HTML-i mənbə fiqurlarını dəyişdirilmiş/uyğunlaşdırılmış formada yenidən istehsal etmir. Məqalədaxili SVG-lər yalnız mətndə açıq şəkildə təsvir edilmiş elmi faktlardan müstəqil kompozisiya ilə yaradılmışdır.
Əsas sahə: Zero-Trust Network Architecture, anomaly detection, autonomous recovery, deep learning, reinforcement learning və trust scoring.
Əsas model: Autoencoder-LSTM-RL-Trust əsaslı inteqrasiya olunmuş framework.
Streaming komponentləri: Apache Kafka və Apache Flink.
Anomaly komponentləri: Autoencoder, LSTM, attention, ensemble shallow autoencoders, dynamic thresholding, Mahalanobis-distance konteksti və Energy-Based Model yanaşması.
Trust komponentləri: Response reliability, authentication strength/frequency, fault history, decay, normalization, deviation və trusted/suspicious/untrusted node classification.
Recovery komponentləri: Trust-ranked node selection, compatibility scoring, traffic rerouting, node isolation, role reassignment, load redistribution, policy update, service redeployment və reinforcement-learning feedback.
Federated learning statusu: Framework arxitekturasına privacy-preserving distributed adaptation üçün daxil edilmişdir; mənbə böyük miqyaslı federated edge deployment eksperimentlərinin gələcəkdə aparılacağını bildirir.
Əsas verilənlər dəstləri: CIC-IDS-2017/CICIDS və NSL-KDD.
Verilənlərin əlçatanlığı: Mənbə dataset-lərin public repository üzərindən əlçatan olduğunu bildirir və CIC-IDS-2017 ilə NSL-KDD üçün Kaggle keçidləri verir.
Attack classes: DDoS, Unauthorized Access və Data Exfiltration.
Ümumi system-level result: %97 anomaly detection accuracy; %96 autonomous recovery success; %93 downtime reduction.
DDoS nəticəsi: F1-score 0,965; nəticə bölməsində MTTD 1,6 s.
MTTR: Figure 20/Conclusion kontekstində 1,8 s.
Table 7 proposed result: %97 detection accuracy; %2,4 FPR; 48 ms detection latency; %95 scalability; complexity 6/10; 160 MB resource usage.
Table 8 proposed result: 90 ms recovery time; %96 success; %93 self-adaptivity; %93 downtime reduction; %96 policy compliance; 10/10 learning efficiency.
Memory simulation: Proposed method üçün 1.000N-5F, 1.000N-20F, 10.000N-5F və 10.000N-20F ssenarilərində müvafiq olaraq 160 MB, 200 MB, 780 MB və 910 MB istifadə bildirilmişdir.
Confusion-matrix məhdudiyyəti: Çoxsinifli attack-type confusion matrix ümumi %97 system-level detection accuracy-nin özü deyil.
Hyperparameter reproducibility məhdudiyyəti: Mənbə hyperparameter təfərrüatlarının daxil edildiyini desə də, yayımlanmış PDF-də learning rate, batch size, epoch, hidden-layer size və split nisbətlərini tam sayısal cədvəl şəklində vermir.
Formul təqdimatı problemi: PDF Section 3.2-də Mahalanobis anomaly-score formulunun, Section 3.3-də isə time-decaying trust-update formulunun olması gözlənilən yerdə tənlik görünmür. Bu çatışmayan elementlər Verianla tərəfindən təxmin edilərək tamamlanmayıb.
Mənbədaxili CICIDS fərqi: Table 5 proposed accuracy 0,961; Discussion 5.1 accuracy 0,950.
Mənbədaxili trust-ablation fərqi: Table 6 without-trust F1 = 0,939; Discussion 5.3 “F1 score of 3.6” yazır.
Mənbədaxili recovery metrik fərqi: Table 3–4 recovery latency 2,3 s; Figure 20/Conclusion MTTR 1,8 s; Table 8 recovery time 90 ms. Mənbə bunların eyni ölçmə protokolu olduğunu göstərmir.
Maliyyələşdirmə: Deanship of Scientific Research, Vice Presidency for Graduate Studies and Scientific Research, King Faisal University, Saudi Arabia; Grant No. KFU262842.
Etika: Ethics approval and consent to participate — Not Applicable.
Consent for publication: Not Applicable.
Maraqların toqquşması: Müəlliflər competing interests olmadığını bəyan edirlər.
Müəllif töhfələri: Sultan Ahmad, Sami Morsi, Rajit Nair və Hasan Alkahtani ədəbiyyat icmalı və methodology; Theyazn H. H. Aldhyani, Sultan Ahmad və Hikmat A. M. Abdeljaber formal analysis, data collection və investigation; Hikmat A. M. Abdeljaber, Theyazn H. H. Aldhyani və Sultan Ahmad initial drafting və statistical analysis; Sami Morsi, Rajit Nair və Hasan Alkahtani supervision vəzifələrini yerinə yetirmişdir. Mənbə həmçinin bütün müəlliflərin sistem və manuscript development-a töhfə verdiyini və final manuscript-i təsdiqlədiyini bildirir.
Əsas metodoloji məhdudiyyət: Mövcud evaluation benchmark və simulation əsaslıdır; live enterprise-scale Zero-Trust deployment doğrulaması aparılmayıb.
Gələcək tədqiqat: Enterprise real-time ZTNA deployment, large-scale federated edge experimentation, federated adaptive optimization, graph-aware trust propagation, lightweight edge architectures və live software-defined Zero-Trust telemetry validation.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib