


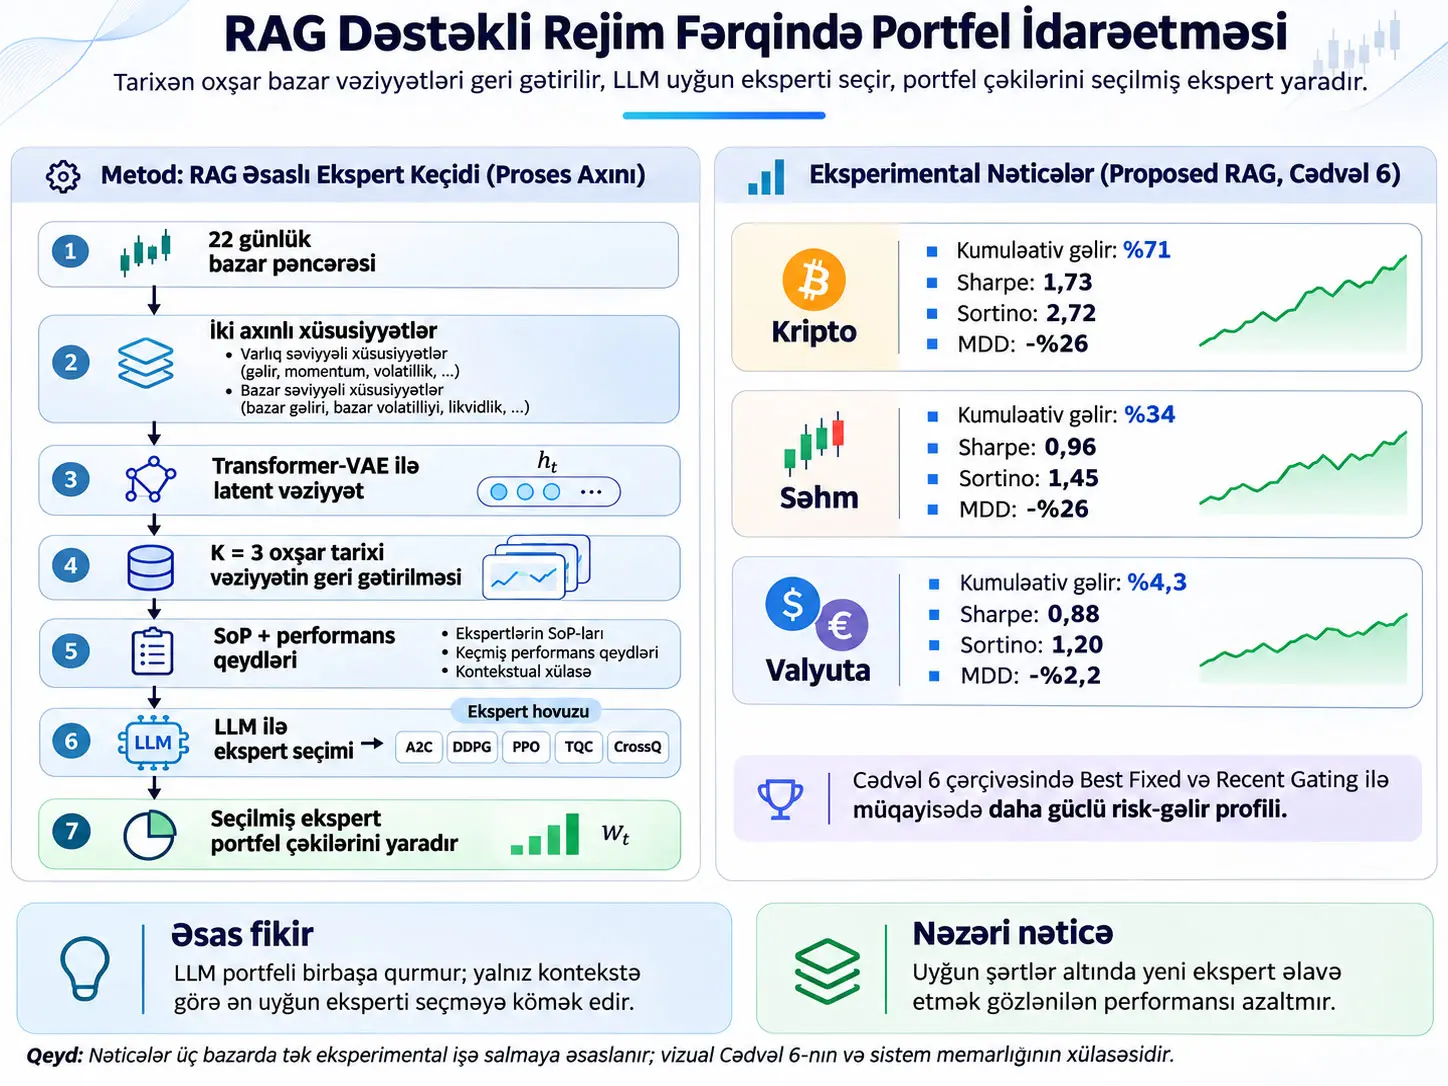
Retrieval-augmented LLM-guided expert switching, cari bazar vəziyyətini tarixən oxşar bazar vəziyyətləri ilə uyğunlaşdıran, həmin dövrlərdə müxtəlif portfel ekspertlərinin necə performans göstərdiyini araşdıran və böyük dil modelindən birbaşa portfel çəkiləri yaratmaq əvəzinə hansı ekspert siyasətinin istifadə olunacağına qərar vermək üçün yararlanan adaptiv portfel-yönləndirmə yanaşmasıdır. Tədqiqat bazar şəraitinin zamanla dəyişdiyi non-stationary maliyyə mühitlərində tək bir portfel modelinin hər rejimdə ən yaxşı davranmaya biləcəyi probleminə yönəlir.
Metodda bazar vəziyyəti iki ayrı məlumat axını ilə təmsil olunur. Birinci axın aktiv səviyyəsindəki log-return, RSI, MACD, ATR, realized volatility və volume-change xüsusiyyətlərini; ikinci axın isə bazar üzrə trend, volatility-regime və liquidity göstəricilərini daşıyır. İki axın ayrı Transformer-VAE encoder-ları ilə latent representation-a çevrilir və vahid \(h_t\) state vector daxilində birləşdirilir. Tarixi state-lər vector database-də saxlanılır; hər state üçün A2C, DDPG, PPO, TQC və CrossQ ekspertlərinin sonrakı beş günlük performansı ilə Statement of Performance (SoP) qeydləri tutulur.
Online qərar mərhələsində mövcud 22 trading-day bazar pəncərəsi eyni latent məkana kodlanır və cosine similarity ilə ən yaxın \(K=3\) tarixi vəziyyət geri gətirilir. Bu tarixi vəziyyətlərdə ekspertlərin reallaşmış performansı, SoP qeydləri və cari bazar konteksti LLM-ə təqdim edilir. LLM portfel çəkilərini özü yaratmır; hansı ekspert siyasətinin aktivləşdiriləcəyi barədə kontekstual qiymətləndirmə aparır. Seçilmiş reinforcement-learning eksperti daha sonra portfel çəkilərini yaradır.
Tədqiqatın Table 6 selection-strategy müqayisəsində Proposed RAG kriptovalyuta bazarında %71 cumulative return və 1,73 Sharpe, səhm bazarında %34 cumulative return və 0,96 Sharpe, valyuta bazarında isə %4,3 cumulative return və 0,88 Sharpe əldə etmişdir. Eyni cədvəldə Best Fixed Expert üçün bu dəyərlər müvafiq olaraq %68/1,64, %26/0,74 və %3,2/0,71-dir. Lakin hər bazar yalnız bir eksperimental run ilə qiymətləndirilmiş, çoxsaylı random seed ortalamaları və ya statistik əhəmiyyət testləri bildirilməmişdir.
Nəticələrin şərhində mühüm mənbədaxili fərq vardır. Table 5-də ayrıca işə salınmış ekspertlərin ən yüksək cumulative return dəyərləri kripto bazarında TQC üçün %76,16, səhm bazarında CrossQ üçün %38,21 və forex-də A2C üçün %4,27-dir; bu dəyərlər Table 6-dakı “Best Fixed” dəyərlərindən fərqlənir. Mənbə bu iki cədvəlin niyə fərqli “fixed expert” nəticələri verdiyini izah etmir. Buna görə tədqiqat Proposed RAG-ın Table 6 daxilindəki seçim strategiyalarından daha yaxşı nəticə verdiyini dəstəkləyir; təklif olunan sistemin bütün şəraitlərdə bütün standalone ekspertlərdən daha yüksək gəlir yaratdığı nəticəsini dəstəkləmir.
Tədqiqatın əsas problemi
Maliyyə bazarları stasionar sistemlər deyil. Volatillik səviyyəsi, likvidlik, cross-asset relationships, trend strukturu və bazar iştirakçılarının davranışı zamanla dəyişə bilər. Buna görə müəyyən dövrdə uğurlu olan portfel siyasəti başqa bir market regime daxilində eyni uğuru göstərməyə bilər.
Tək bir deep-learning və ya deep-reinforcement-learning modelini bütün bazar şəraitinə uyğunlaşdırmağa çalışmaq model tutumunu artıra bilər; lakin model yenə də təlim zamanı gördüyü regularities-ə həddən artıq uyğunlaşa bilər. Mixture-of-Experts yanaşması müxtəlif ekspert modellərdən istifadə edərək bu problemi azaltmağa çalışır, lakin klassik MoE strukturlarında hansı ekspertin aktivləşdiriləcəyini müəyyən edən learned gating network də əvvəllər görülməmiş rejimlərdə səhv seçim edə bilər.
Tədqiqatın təklif etdiyi alternativ yanaşma “son bir neçə gündə hansı model daha uğurlu idi?” sualının əvəzinə “cari bazar vəziyyətinə tarixən oxşayan dövrlərdə hansı ekspert daha uğurlu olmuşdu?” sualını qoyur.
Retrieval-Augmented LLM-Guided Expert Switching Nədir?
Retrieval-augmented LLM-guided expert switching cari bazar vəziyyətinə bənzəyən tarixi vəziyyətləri latent vector database-dən geri gətirib həmin vəziyyətlərdə ekspert modellərin reallaşmış risk-gəlir performansını LLM dəstəkli yönləndirmə mexanizminə təqdim etməklə istifadə olunacaq portfel ekspertini seçən, lakin portfel çəkilərini birbaşa LLM-ə yaratdırmayan expert-routing metodudur.
Sistem iki ayrı mərhələdən ibarətdir
Offline indexing mərhələsi tarixi bazar vəziyyətlərini əvvəlcədən emal edir. Hər historical window dual-stream Transformer-VAE ilə latent state-ə çevrilir. Sonra bütün ekspertlər eyni tarixi vəziyyətdən başlayaraq sabit forward horizon boyunca qiymətləndirilir. Əldə edilən performance records və Statement of Performance qeydləri latent representation ilə birlikdə vector database-ə yerləşdirilir.
Online inference mərhələsi cari bazar vəziyyətini eyni latent məkana çevirir, keçmişdəki ən oxşar \(K=3\) state-i geri gətirir, müvafiq expert-performance qeydlərini toplayır və LLM-dən expert-selection üçün istifadə edir. LLM-in vəzifəsi portfolio allocation yaratmaq deyil, retrieved evidence-i şərh edərək uyğun expert-i müəyyən etməkdir.
Statement of Performance (SoP) nədir?
Statement of Performance hər historical market episode üçün müvafiq ekspertin davranışını və reallaşmış performansını kontekstual şəkildə xülasə edən qeyddir. Mənbədə offline performance record cumulative return, Sharpe ratio və maximum drawdown məlumatlarını ehtiva edir. SoP isə eyni dövrün market context-ini, expert behavior-ını və müvafiq uncertainty factors məlumatını xülasə edərək LLM-in yalnız rəqəmsal skor deyil, kontekstləşdirilmiş tarixi sübut görməsini təmin edir.
LLM Bu Sistemdə Portfel Çəkilərini Birbaşa Yaradırmı?
Xeyr. Tədqiqatdakı instruction-tuned LLM geri gətirilmiş tarixi market-state qeydlərini və ekspertlərin risk-gəlir davranışını şərh edərək hansı expert-in seçiləcəyini müəyyən edən yönləndirmə qatına töhfə verir; faktiki portfolio weight vector seçilmiş A2C, DDPG, PPO, TQC və ya CrossQ eksperti tərəfindən yaradılır.
Niyə LLM birbaşa trader kimi istifadə olunmur?
Tədqiqatın ədəbiyyat qiymətləndirilməsi LLM əsaslı trading agent-lərin uzunmüddətli benchmark-larda həmişə buy-and-hold və ya kəmiyyət metodlarından üstün olmadığını vurğulayır. Buna görə LLM-in vəzifəsi daraldılmışdır. Model birbaşa alqı-satqı miqdarını hesablamaq əvəzinə tarixi konteksti şərh etmək, retrieved episodes arasındakı əlaqələri qiymətləndirmək və expert routing vəzifəsində istifadə olunur.
LLM qiymətləndirilməsi niyə məhdudlaşdırılmışdır?
Erkən prompt versiyalarında LLM-in retrieved historical records daxilində olmayan return dəyərlərinə extrapolation etdiyi və həddən artıq əmin cavablar yaratdığı müşahidə edilmişdir. Mənbə beş prompt iteration-ın bir validation set üzərində qiymətləndirildiyini və mean absolute estimation error-un təxminən %18-dən %11-ə endiyini bildirir.
Son prompt dizaynı üç əsas məhdudiyyət tətbiq edir:
- Empirical grounding: Risk-gəlir qiymətləndirilməsi retrieved historical MDD, realized information ratio və digər reallaşmış performance observations ilə məhdudlaşdırılır.
- Conservative margining: Yeni candidate expert yalnız incumbent expert-ə nisbətən estimated advantage uncertainty/noise margin-i aşdıqda üstün tutulur.
- Tail-event separation: Extreme drawdown, liquidity squeeze və regime transition dövrləri adi dövrlərdən ayrıca qiymətləndirilir.
Mənbə validation set-in neçə nümunədən ibarət olduğunu, hansı bazar dövrlərini əhatə etdiyini və %18 → %11 dəyərlərinin tam paylanmasını bildirmir.
Monotonik Ekspert-Hovuzu Teoremi Nə Deyir?
Mənbənin monotonluq nəticəsi yeni ekspert əlavə etməyin şərtsiz olaraq performansı artırdığını demir; yalnız estimation error-un \(\epsilon\) ilə məhdud olduğu, switch threshold-un \(\tau\ge2\epsilon\) olduğu və yeni ekspertin hədəf bölgəsindəki həqiqi utility advantage-ının \(\delta>\tau+2\epsilon\) şərtini ödədiyi fərziyyələr altında expert pool-a yeni specialist əlavə edilməsinin gözlənilən utility-ni azaltmayacağını göstərir.
Tənlik 1: Switching policy-nin gözlənilən dəyəri
\[ V(\pi_N) = \int_{\mathcal{S}} U_{\pi_N(s)}(s)\,d\mathbb{P}(s). \tag{1} \]
Nəyi hesablayır? \(N\) ekspertli switching policy-nin bütün market-state məkanı üzrə expected risk-adjusted utility dəyərini hesablayır.
- \(\mathcal{S}\): mümkün latent market state məkanıdır.
- \(\mathbb{P}\): state məkanı üzərində ehtimal ölçüsüdür.
- \(\pi_N(s)\): state \(s\) üçün seçilmiş expert indeksidir.
- \(U_i(s)\): expert \(i\)-nin state \(s\) daxilində reallaşmış həqiqi risk-adjusted utility-sidir.
\(U_i(s)\)-nin konkret fiziki vahidi mənbədə müəyyən edilməmişdir. Nəzəri modeldə utility miqyasında kəmiyyətdir və decision time-da birbaşa məlum deyil.
Tənlik 2: LLM dəstəkli expert assessment
\[ \rho_i(s) = \mathcal{M} \left( \mathcal{H}_t(s),E_i \right). \tag{2} \]
\(\mathcal{H}_t(s)\), current state \(s\)-yə bənzəyən retrieved historical episodes çoxluğudur; \(E_i\) müvafiq expert-dir; \(\mathcal{M}\) retrieved evidence üzərində işləyən qiymətləndirmə mexanizmini, \(\rho_i(s)\) isə switching procedure daxilində istifadə olunan estimated assessment dəyərini göstərir.
Kritik fərq: \(\rho_i(s)\), naməlum həqiqi \(U_i(s)\)-nin birbaşa müşahidəsi deyil. Historical performance records rəqəmsal əsası təmin edir; LLM retrieved context-i şərh edib assessment calibration-a töhfə verir.
Tənlik 3: Axiom 1 — bounded estimation error
\[ \sup_{s\in\mathcal{S}} \left| \rho_i(s)-U_i(s) \right| \le \epsilon, \qquad \forall i\in\{1,\ldots,N+1\}. \tag{3} \]
Bu şərt estimated assessment ilə həqiqi utility arasındakı ən böyük xətanın \(\epsilon\) dəyərini aşmadığını fərz edir. \(\epsilon\), \(\rho\) və \(U\) ilə eyni utility/assessment miqyasındadır.
Bu, eksperimental olaraq bütün state məkanı üçün sübut olunmuş xüsusiyyət deyil. Mənbənin practical implementation-ı LLM-i retrieved empirical observations xaricinə extrapolation etməməyə məcbur etməklə bu aksioma yaxınlaşmağa çalışır.
Tənlik 4: Ən yüksək estimated utility-yə malik expert
\[ e^*(s) = \arg\max_{i\in\{1,\ldots,N\}} \rho_i(s). \tag{4} \]
Bu ifadə state \(s\) üçün mövcud expert pool daxilində ən yüksək estimated assessment dəyərinə malik expert indeksini seçir.
Tənlik 5: Conservative switching
\[ \pi_N(s) = \begin{cases} e^*(s), & \rho_{e^*(s)}(s) - \rho_{\pi_N(s)}(s) > \tau, \\ \pi_N(s), & \text{aksi durumda}. \end{cases} \tag{5} \]
və:
\[ \tau\ge2\epsilon. \]
Candidate expert-in incumbent expert-ə nisbətən estimated advantage-ı \(\tau\) dəyərindən böyük deyilsə, mövcud expert saxlanılır. Məqsəd estimation noise səbəbilə lazımsız switching-i azaltmaqdır.
Tənlik 6: Axiom 3 — specialist dominance
\[ U_{N+1}(s) \ge U_{\pi_N(s)}(s) + \delta, \qquad s\in\mathcal{S}_R, \tag{6} \]
və:
\[ \delta > \tau+2\epsilon. \]
\(\mathcal{S}_R\), yeni specialist expert-in hədəfləndiyi market-state subset-dir və mənbə \(P(\mathcal{S}_R)>0\) fərz edir. Yeni ekspert bu bölgədə incumbent policy-dən ən azı \(\delta\) qədər daha yüksək həqiqi utility-yə malik olmalıdır.
Mənbədaxili ifadə qeydi: Axiom 3-dən dərhal sonra mənbə specialist region xaricində yeni expert-in utility-sinin “unlimited” fərz edildiyini yazır. Bu sözün riyazi olaraq “unrestricted/unconstrained” mənasında işlədilib-işlədilmədiyi ayrıca müəyyən edilməmişdir. Verianla bu ifadəni səssiz şəkildə başqa fərziyyə ilə əvəz etmir.
Tənlik 7–9: Səhv switching-in niyə utility-ni azaltmaması gözlənilir?
\[ U_{N+1}(s) \ge \rho_{N+1}(s)-\epsilon. \tag{7} \]
\[ U_{\pi_N(s)}(s) \le \rho_{\pi_N(s)}(s)+\epsilon. \tag{8} \]
İki bərabərsizlik birləşdirildikdə:
\[ U_{N+1}(s) - U_{\pi_N(s)}(s) > \tau-2\epsilon. \tag{9} \]
\(\tau\ge2\epsilon\) olduğuna görə sağ tərəf mənfi deyil. Beləliklə, göstərilən error bound həqiqətən keçərlidirsə, switching threshold-u aşan dəyişiklikdən həqiqi utility-ni azaltmaması gözlənilir.
Tənlik 10–11: Hədəf specialist bölgəsində qəti yaxşılaşma
\[ \rho_{N+1}(s) - \rho_{\pi_N(s)}(s) \ge \delta-2\epsilon. \tag{10} \]
\(\delta>\tau+2\epsilon\) olduğuna görə:
\[ \delta-2\epsilon>\tau. \]
Beləliklə, specialist hədəf region daxilində switching criterion-u ödəyir. Gözlənilən utility-yə minimum contribution:
\[ \Delta V \ge \int_{\mathcal{S}_R} \delta\,d\mathbb{P}(s) = \delta \mathbb{P}(\mathcal{S}_R) > 0. \tag{11} \]
olur.
Mənbə daha sonra specialist-lərin ardıcıl əlavə edilməsi halında:
\[ V(\pi_1) \le V(\pi_2) \le \cdots \le V(\pi_K) \]
şəklində non-decreasing policy-value sequence əldə edildiyini və bunun:
\[ V^* = \int_{\mathcal{S}} \sup_E U_E(s) \,d\mathbb{P}(s) \]
ilə müəyyən edilən best-achievable utility tərəfindən yuxarıdan məhdudlaşdırıldığını bildirir.
Teoremin düzgün şərhi: Bu nəticə “ekspert sayını artırsaq, real portfel gəliri həmişə artar” demək deyil. Nəticə yalnız Axiom 1–3 həqiqətən ödəndikdə riyazi olaraq keçərlidir. Practical prompt qaydaları isə mənbənin öz ifadəsinə görə bu aksiomların sübutu deyil, LLM davranışını aksiomlarla daha uyğun etməyə yönəlmiş implementation heuristics-dir.
Bazar vəziyyəti hansı xüsusiyyətlərlə təmsil olunur?
Hər qərar anında iki rolling-window tensor yaradılır.
Asset-level texniki tensor:
\[ S_t^{tech} \in \mathbb{R}^{L\times A\times F_1}. \]
Burada \(L\) rolling-window uzunluğu, \(A\) portfeldəki aktivlərin sayı və \(F_1\) asset-level feature sayıdır. Eksperimentlərdə \(L=22\) trading day və \(A=30\) istifadə olunur.
Aktiv səviyyəli xüsusiyyətlər dəsti:
- Log-return: Ardıcıl qiymətlərin logarithmic dəyişməsini təmsil edir.
- RSI: Relative Strength Index; qiymət hərəkətlərinin nisbi momentum strukturunu xülasə edən texniki göstəricidir.
- MACD: Moving Average Convergence Divergence; müxtəlif zaman miqyaslarındakı hərəkətli ortalamaların əlaqəsindən istifadə edərək trend/momentum strukturunu təmsil edir.
- ATR: Average True Range; qiymət hərəkətlərinin diapazon əsaslı volatillik böyüklüyünü təmsil edir.
- Realized volatility: müşahidə olunan qiymət hərəkətlərindən törədilən oynaqliq məlumatı.
- Volume changes: əməliyyat həcmi dəyişiklikləri.
Bazar üzrə tensor:
\[ S_t^{mkt} \in \mathbb{R}^{L\times F_2}. \]
Bu stream aggregate trend indicators, volatility-regime measures və liquidity variables ehtiva edir. Mənbə ümumi nəzəri izahda macroeconomic conditions anlayışından bəhs etsə də, praktikada hansı xarici macroeconomic series-in istifadə olunduğunu sadalamır; buna görə Verianla xarici faiz, inflyasiya və ya oxşar məlumat dəstləri əlavə etmir.
Bütün features rolling z-score normalization ilə standartlaşdırılır. Mənbə bunun dəyişən miqyasların təsirini azaltmağı və heteroskedasticity-nin state representation üzərindəki təsirini məhdudlaşdırmağı hədəflədiyini bildirir.
Tənlik 12: Transformer-VAE posterior paylanması
\[ q_{\phi_x} \left( z_x\mid S_t^x \right) = \mathcal{N} \left( \mu_x(S_t^x), \Sigma_x(S_t^x) \right), \qquad x\in\{tech,mkt\}. \tag{12} \]
Hər feature stream öz Transformer encoder-ı tərəfindən Gaussian posterior-a xəritələnir. \(\mu_x\) posterior mean, \(\Sigma_x\) diagonal covariance və \(z_x\) latent representation-dır.
Bu dəyişənlərin fiziki vahidi yoxdur; standartlaşdırılmış girişlərdən öyrənilən latent-space kəmiyyətləridir.
Tənlik 13: Reparameterization
\[ z_x = \mu_x + \varepsilon\odot\sigma_x, \qquad \varepsilon \sim \mathcal{N}(0,I). \tag{13} \]
\(\odot\), element-wise multiplication-dır. \(\sigma_x\), posterior standard deviation vector-udur. Reparameterization stochastic latent sampling aparılarkən gradient-based training-in davam etdirilməsini təmin edir.
Pretraining zamanı sampled latent representation decoder tərəfindən input reconstruction üçün istifadə olunur. Pretraining tamamlandıqdan sonra decoder çıxarılır və encoder market-state representation üçün saxlanılır.
Tənlik 14: İki latent stream-in birləşdirilməsi
\[ h_t = \left[ z_t^{tech} \mid z_t^{mkt} \right] \in \mathbb{R}^{D}. \tag{14} \]
\(h_t\), asset-specific və market-wide latent vectors-ın concatenation nəticəsidir. Historical indexing və online query mərhələsində eyni representation function istifadə olunduğu üçün current state və historical state eyni latent məkanda müqayisə edilir.
Eksperiment bölməsində retrieval embedding dimension:
\[ d=64 \]
olaraq göstərilir. Mənbə \(D\) ilə bu implementation-dakı \(d\) simvolu arasındakı notasiya əlaqəsini ayrıca təfərrüatlandırmır.
Tənlik 15: Historical index qeydi
\[ D_{\tau} = \left( h_{\tau}, R_{\tau}^{(e)}, SoP_{\tau}^{(e)} \right), \qquad e\in\{1,\ldots,E\}. \tag{15} \]
Hər tarixi state qeydi üç məlumat qrupunu bir araya gətirir:
- \(h_{\tau}\): historical latent market state,
- \(R_{\tau}^{(e)}\): expert \(e\)-nin forward horizon üzərindəki reallaşmış performance record-u,
- \(SoP_{\tau}^{(e)}\): eyni şəraitdəki Statement of Performance.
Tənlik 16: Ən yaxın tarixi state-lərin seçilməsi
\[ \mathcal{N}_t = KNN \left( h_t, \{h_{\tau}\}, K \right). \tag{16} \]
Eksperimentlərdə \(K=3\) istifadə olunur. Similarity metric cosine similarity-dir. Test zamanı yalnız:
\[ \tau<t \]
şərtini ödəyən historical observations retrieval üçün istifadə olunur. Bu chronological restriction future information-ın qərar prosesinə sızmasının qarşısını almağı hədəfləyir.
Tənlik 17: Retrieval weight
\[ w_{\tau} = \frac{ sim(h_t,h_{\tau}) }{ \sum_{j\in\mathcal{N}_t} sim(h_t,h_j) }. \tag{17} \]
\(sim(h_t,h_{\tau})\), current state ilə historical state arasındakı cosine similarity dəyəridir. \(w_{\tau}\) ölçüsüz normalized retrieval weight-dir.
Riyazi aydınlıq sərhədi: Cosine similarity nəzəri olaraq mənfi də ola bilər. Mənbə Eq. 17-dən əvvəl similarity dəyərlərinin müsbət aralığa qırpılması, softmax tətbiqi və ya ümumi similarity-nin sıfır olduğu halın necə idarə edildiyini izah etmir. Buna görə \(w_{\tau}\)-nun bütün hallarda klassik convex weight olduğunu fərz etmək təhlükəsiz deyil.
Tənlik 18: Similarity-weighted expert performance
\[ \widehat{R}_t^{(e)} = \sum_{\tau\in\mathcal{N}_t} w_{\tau} R_{\tau}^{(e)}. \tag{18} \]
Bu tənlik retrieved historical episodes daxilində expert \(e\) performansını similarity çəkiləri ilə birləşdirir. \(\widehat{R}_t^{(e)}\), \(R_{\tau}^{(e)}\) hansı performans miqyasında müəyyən edilibsə, eyni miqyası daşıyır.
Mənbədaxili göstərim sərhədi: Offline izahda performance record daxilində cumulative return, Sharpe ratio və MDD olduğu bildirilir; Eq. 18 isə \(R_{\tau}^{(e)}\)-ni tək riyazi kəmiyyət kimi yazır. Bu metriklərin scalar composite score-a necə çevrildiyi və ya Eq. 18-in hər metrik üçün component-wise tətbiq edilib-edilmədiyi mənbədə açıq şəkildə müəyyən edilməmişdir.
Alqoritm 1: Offline Rejim İndekslənməsi və Ekspert Performansının Əsaslandırılması
- Hər historical time step \(\tau\) üçün asset-level və market-wide feature tensors yaradılır.
- Dual-stream T-VAE ilə \(h_{\tau}\) latent embedding hesablanır.
- Hər expert \(E^{(e)}\) historical state-dən başladılır.
- Expert-in forward horizon \(H\) üzərindəki reallaşmış performansı hesablanır.
- Eyni episode üçün Statement of Performance yaradılır.
- \((h_{\tau},R_{\tau}^{(e)},SoP_{\tau}^{(e)})\) qeydi historical index-ə yazılır.
Alqoritm 2: Online Retrieval və Portfel Qərarverməsi
- Current market data-dan \(S_t^{tech}\) və \(S_t^{mkt}\) yaradılır.
- Dual-stream T-VAE ilə \(h_t\) hesablanır.
- Vector database-dən \(K=3\) nearest historical regimes götürülür.
- Hər expert üçün similarity-weighted performance estimate hesablanır.
- Algorithm 2 əlavə olaraq weighted uncertainty \(\sigma_t^{(e)}\) hesablandığını bildirir.
- Retrieved SoPs və current market context LLM-ə verilir.
- LLM expert selection qərarına töhfə verir və \(e^*\) müəyyən edilir.
- Seçilmiş expert \(E^{(e^*)}\) portfolio weights \(w_t\)-ni yaradır.
Təkrar istehsal sərhədi: Algorithm 2-dəki weighted uncertainty \(\sigma_t^{(e)}\) üçün mənbə ayrıca riyazi formula vermir. Bu boşluq Verianla tərəfindən yeni uncertainty estimator əlavə edilməklə doldurulmamışdır.
Tədqiqatın Metodu və Nəticələri
Eksperimental məlumat strukturu
Tədqiqat üç fərqli maliyyə market class üzərində daily OHLCV məlumatından istifadə edir:
- 30 kriptovalyuta,
- 30 səhm,
- 30 xarici valyuta cütü.
OHLCV, Open, High, Low, Close və Volume komponentlərindən ibarət bazar məlumatı strukturudur. Tədqiqatın girişində high-frequency trading kontekstindən bəhs edilsə də, faktiki eksperimentlər intraday high-frequency data ilə deyil, daily OHLCV ilə aparılmışdır.
| Parametr | Mənbə dəyəri |
|---|---|
| Bazar sinfi | Kripto, Səhm, Forex |
| Hər bazardakı symbol sayı | 30 |
| Giriş pəncərəsi \(L\) | 22 ticarət günü |
| Saxlama / forward üfüqü \(H\) | 5 gün |
| Tarixi qonşular \(K\) | 3 |
| Oxşarlıq | Cosine similarity |
| Latent embedding ölçüsü | 64 |
| LLM temperaturu | 0,1 |
| LLM çağırışı | Hər qərar üçün ən çox 1 |
| Future-leakage məhdudiyyəti | Retrieval yalnız \(\tau<t\) |
| Avadanlıq | Tək NVIDIA H100 GPU |
| Eksperiment təkrar sayı | Hər bazar üçün 1 run |
Kriptovalyuta paneli
30 kriptovalyuta simvolu:
ADA, APT, ARB, ATOM, AVAX, BCH, BNB, BTC, DOGE, DOT, EGLD, ETC, ETH, FIL, HBAR, ICP, LINK, LTC, MATIC, MKR, NEAR, RNDR, SHIB, SOL, TON, TRX, UNI, VET, XLM və XRP.
Symbol üzrə availability period eyni deyil. Mənbə Table 2-də ən uzun seriyalardan BTC və LTC üçün 17 Sentyabr 2014–31 May 2026 arasında 4.275 sample bildirdiyi halda, APT üçün 20 Noyabr 2021–24 İyun 2025 arasında 1.311 sample vardır. RNDR, MATIC, UNI və APT kimi bəzi series 2026-dan daha əvvəl bitir.
Cryptocurrency market üçün standart tək broad-market benchmark olmadığına görə mənbə iki synthetic index yaratmışdır:
- bərabər çəkili / çəkisiz kumulyativ gəlir indeksi,
- həcm üzrə çəkili kumulyativ gəlir indeksi.
Mənbə equal-weighted raw-price aggregation-ın az sayda extreme constituents tərəfindən dominant hala gəldiyini və buna görə volume-weighted variant-ın primary market-level descriptor kimi üstün tutulduğunu bildirir.
Səhm paneli
30 səhm:
TMO, MCD, NVDA, DIS, TSLA, CVX, XOM, ACN, V, WMT, KO, LIN, HD, GOOGL, CRM, UNH, BAC, COST, MA, PG, AAPL, JPM, JNJ, MSFT, MRK, META, AMZN, ABBV, BRK-B və PEP.
Bir çox stock series 3 Yanvar 2000–29 May 2026 arasında 6.641 sample ehtiva edir, daha sonra birjaya çıxmış şirkətlərdə isə daha qısa history vardır. Stock market-level context üçün S&P 500, NASDAQ Composite və Dow Jones Industrial Average istinadları istifadə olunmuşdur.
Valyuta paneli
30 forex cütü:
USDCAD, EURAUD, EURCHF, GBPCHF, CHFJPY, NZDCHF, AUDCAD, NZDCAD, GBPUSD, AUDUSD, GBPAUD, USDJPY, GBPJPY, NZDJPY, AUDNZD, EURGBP, USDCHF, EURCAD, AUDJPY, GBPCAD, USDTRY, AUDCHF, EURTRY, EURSEK, GBPNZD, EURUSD, NZDUSD, EURJPY, EURNZD və CADJPY.
FX üçün mənbə vahid standard broad-market composite index bildirmir. Market-wide condition dual-stream encoder-ın aggregate market-feature kanalından təmsil olunur.
Məlumat mənbəyi sərhədi: PDF, OHLCV seriyalarının hansı market-data provider və ya API-dən endirildiyini açıq şəkildə bildirmir. Verianla buna görə Yahoo Finance, Binance, Alpha Vantage və ya başqa provayder fərz etmir.
Beş reinforcement-learning eksperti
| Ekspert | Mənbədə verilən əsas rol |
|---|---|
| A2C | Advantage Actor-Critic; synchronous actor-critic policy-gradient yanaşması. |
| DDPG | Deep Deterministic Policy Gradient; continuous action space üçün off-policy actor-critic. |
| PPO | Proximal Policy Optimization; policy update böyüklüyünü məhdudlaşdıraraq training stability təmin etməyi hədəfləyən policy-gradient metodu. |
| TQC | Truncated Quantile Critics; reward distribution-ı quantile critics ilə modelləşdirən distributional reinforcement-learning eksperti. |
| CrossQ | Ekspert pool daxilində behavioral diversity-ni artırmaq üçün əlavə edilmiş off-policy reinforcement-learning metodu. |
Qiymətləndirmə metrikləri
Cumulative return, qiymətləndirmə dövrü ərzində yığılan ümumi portfel gəlirini təmsil edir.
Annualized return, gəliri illik miqyasa çevirir. Lakin mənbənin istifadə etdiyi exact annualization convention ayrıca formula ilə verilməmişdir.
Annualized volatility, return variability-nin illikləşdirilmiş ölçüsüdür.
Sharpe ratio, gəliri total variability/risk ilə əlaqələndirən risk-adjusted performance metrikidir. Mənbə istifadə olunan risk-free rate dəyərini və exact annualization formulasını bildirmir.
Sortino ratio, total variability əvəzinə downside variability-yə fokuslanır. Mənbə target return və ya minimum acceptable return parametrini ayrıca bildirmir.
Maximum Drawdown (MDD), portfolio value-nun peak səviyyəsindən sonrakı trough səviyyəsinə qədər yaşadığı ən böyük enişi ölçür. Mənfi dəyərin mütləq böyüklüyü azaldıqca drawdown daha yüngüldür; məsələn −%22, −%29-dan daha kiçik itki böyüklüyüdür.
Standalone ekspertlərin performansı
| Bazar | Ekspert | Cumulative Return | Sharpe | Sortino | MDD | Dominance |
|---|---|---|---|---|---|---|
| Kripto | A2C | %63,00 | 1,61 | 2,44 | −%25 | 19 həftə / %34,5 |
| Kripto | DDPG | %71,26 | 1,74 | 2,73 | −%26 | 6 həftə / %10,9 |
| Kripto | PPO | %60,49 | 1,57 | 2,38 | −%27 | 3 həftə / %5,5 |
| Kripto | CrossQ | %53,66 | 1,44 | 2,24 | −%28 | 9 həftə / %16,4 |
| Kripto | TQC | %76,16 | 1,71 | 2,63 | −%29 | 18 həftə / %32,7 |
| Səhm | A2C | %32,16 | 0,90 | 1,35 | −%23 | 17 həftə / %19,3 |
| Səhm | DDPG | %28,89 | 0,85 | 1,26 | −%24 | 5 həftə / %5,7 |
| Səhm | PPO | %33,38 | 0,96 | 1,46 | −%22 | 21 həftə / %23,9 |
| Səhm | CrossQ | %38,21 | 0,95 | 1,42 | −%27 | 32 həftə / %36,4 |
| Səhm | TQC | %32,09 | 0,86 | 1,28 | −%26 | 13 həftə / %14,8 |
| Forex | A2C | %4,27 | 0,88 | 1,20 | −%2,18 | 6 həftə / %6,8 |
| Forex | DDPG | %1,80 | 0,36 | 0,46 | −%2,85 | 12 həftə / %13,6 |
| Forex | PPO | %4,07 | 0,88 | 1,20 | −%2,00 | 9 həftə / %10,2 |
| Forex | CrossQ | %2,62 | 0,53 | 0,69 | −%2,68 | 18 həftə / %20,5 |
| Forex | TQC | %2,26 | 0,48 | 0,60 | −%2,18 | 43 həftə / %48,9 |
Nəticələr expert specialization ideyasını dəstəkləyir: ən yüksək cumulative return, ən yüksək Sharpe, ən aşağı MDD və ən tez-tez dominance eyni expert üzərində cəmlənmir.
Kriptoda TQC ən yüksək cumulative return-ə (%76,16) malik olduğu halda DDPG ən yüksək Sharpe və Sortino-nu (1,74 və 2,73), A2C isə ən kiçik MDD-ni (−%25) verir. Səhmdə CrossQ ən yüksək cumulative return-ə (%38,21), PPO ən yüksək Sharpe/Sortino-ya (0,96/1,46) və ən kiçik MDD-yə (−%22) malikdir. Forex-də A2C cumulative return baxımından %4,27 ilə öndədir; PPO və A2C Sharpe/Sortino baxımından 0,88/1,20 dəyərlərində bərabərdir, ən kiçik MDD isə PPO üçün −%2,00-dır.
Proposed switcher hansı ekspertləri nə qədər tez-tez seçdi?
| Ekspert | Kripto | Səhm | Forex |
|---|---|---|---|
| A2C | %34,5 | %19,3 | %6,8 |
| TQC | %32,7 | %14,8 | %48,9 |
| CrossQ | %16,4 | %36,4 | %20,5 |
| DDPG | %10,9 | %5,7 | %13,6 |
| PPO | %5,5 | %23,9 | %10,2 |
Bu paylanma bir expert-in bütün marketlərdə dominant olmadığını göstərir. Kripto bazarında A2C və TQC tez-tez seçildiyi halda, stock market-də CrossQ, forex-də isə TQC ən yüksək frequency dəyərinə malikdir.
Üç Bazarda Proposed RAG Seçicisi Hansı Nəticələri Verdi?
Mənbə Table 6-nın selection-strategy müqayisəsində Proposed RAG-ın kriptoda %71 cumulative return və 1,73 Sharpe; səhmdə %34 və 0,96; forex-də %4,3 və 0,88 əldə etməklə eyni cədvəldəki Best Fixed və Recent-Performance Gating strategiyalarından daha yüksək cumulative return və Sharpe göstərdiyini bildirir; lakin nəticələr hər bazar üçün tək run-dır və Table 5-də bəzi standalone ekspertlərin cumulative return dəyərləri Proposed RAG-dan daha yüksəkdir.
| Bazar | Metod | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|---|---|
| Kripto | Best Fixed | %68 | %62 | 0,32 | 1,64 | 2,54 | −%27 |
| Kripto | Recent Gating | %69 | %62 | 0,32 | 1,66 | 2,57 | −%27 |
| Kripto | Proposed RAG | %71 | %64 | 0,31 | 1,73 | 2,72 | −%26 |
| Səhm | Best Fixed | %26 | %14 | 0,21 | 0,74 | 1,11 | −%26 |
| Səhm | Recent Gating | %33 | %17 | 0,20 | 0,91 | 1,37 | −%24 |
| Səhm | Proposed RAG | %34 | %18 | 0,19 | 0,96 | 1,45 | −%26 |
| Forex | Best Fixed | %3,2 | %1,8 | 0,026 | 0,71 | 0,92 | −%1,9 |
| Forex | Recent Gating | −%0,4 | −%0,2 | 0,029 | −0,062 | −0,08 | −%2,6 |
| Forex | Proposed RAG | %4,3 | %2,4 | 0,028 | 0,88 | 1,20 | −%2,2 |
Proposed RAG hər risk metrikində mütləq ən yaxşı deyil. Stock market-də Recent Gating-in MDD-si −%24 olduğu halda Proposed RAG −%26-dır. Forex-də Best Fixed-in MDD-si −%1,9, Proposed RAG-ın isə −%2,2-dir. Buna görə mənbənin “risk-return profile” şərhi cumulative return, Sharpe, Sortino, volatility və MDD-nin birlikdə qiymətləndirilməsinə əsaslanır; “hər risk göstəricisində ən yaxşı” kimi genişləndirilməməlidir.
Table 5 ilə Table 6 arasındakı “Best Fixed” fərqi
Mənbə Table 5-də standalone expert nəticələrini, Table 6-da isə selection strategy nəticələrini ayrı-ayrılıqda verir. Lakin iki cədvəlin “ən yaxşı sabit ekspert” baxımından eyni cumulative return dəyərinə çatması gözlənə bilsə də, dəyərlər uyğun gəlmir:
| Bazar | Table 5-də ən yüksək standalone return | Table 6 Best Fixed | Table 6 Proposed RAG |
|---|---|---|---|
| Kripto | TQC: %76,16 | %68 | %71 |
| Səhm | CrossQ: %38,21 | %26 | %34 |
| Forex | A2C: %4,27 | %3,2 | %4,3 |
Mənbə bu fərqi fərqli split, dövr, portfolio construction, initialization və ya başqa protokol dəyişəni ilə izah etmir. Buna görə bu cədvəl fərqindən yeni mexanizm çıxarılmamalıdır.
Bundan əlavə, Section 4.3 mətni “four strategies” ifadəsini istifadə edir, lakin dərhal sonra yalnız üç strategy müəyyən edir: Best Fixed Expert, Recent-Performance Gating və Proposed RAG. Table 6 da yalnız bu üç strategiyanı ehtiva edir. Dördüncü strategiyanın nə olduğu mənbədə göstərilmədiyi üçün Verianla yeni baseline əlavə etmir.
Expert-pool ölçüsü ablasyonu
| Bazar | Ekspert Sayı | Fixed Sharpe | RAG Sharpe | Δ Sharpe |
|---|---|---|---|---|
| Kripto | 1 | 0,81 | 0,81 | %0,0 |
| Kripto | 2 | 0,84 | 0,85 | %1,2 |
| Kripto | 3 | 0,89 | 0,98 | %10,1 |
| Kripto | 4 | 0,96 | 1,15 | %19,8 |
| Səhm | 1 | 0,43 | 0,43 | %0,0 |
| Səhm | 2 | 0,51 | 0,52 | %2,0 |
| Səhm | 3 | 0,55 | 0,63 | %14,5 |
| Səhm | 4 | 0,59 | 0,72 | %22,0 |
| Forex | 1 | 0,35 | 0,35 | %0,0 |
| Forex | 2 | 0,43 | 0,44 | %2,3 |
| Forex | 3 | 0,46 | 0,55 | %19,6 |
| Forex | 4 | 0,51 | 0,65 | %27,5 |
Bir expert olduqda switch etmək mümkün olmadığı üçün RAG və fixed nəticəsi eynidir. Üç və dörd expert-li pool-larda improvement artır. Mənbə bunu yalnız model sayının deyil, complementary expertise müxtəlifliyinin də mühüm olduğuna dəlil kimi şərh edir.
Məhdudiyyət: Full system beş expert ehtiva etsə də, Table 7 yalnız 1–4 expert pool-larını bildirir. Bundan əlavə, nested pool-a expert-lərin hansı ardıcıllıqla əlavə edildiyi cədvəldə göstərilmir. Buna görə “beşinci expert əlavə olunarsa improvement bu qədər olar” şəklində extrapolation edilə bilməz.
Retrieval və LLM component ablation
| Bazar | Configuration | Cumulative Return | Sharpe | MDD |
|---|---|---|---|---|
| Kripto | NR — No Retrieval | %64,8 | 1,622 | −%26,7 |
| Kripto | R−LLM — No LLM | %69,1 | 1,661 | −%27,1 |
| Kripto | Full — R+L+U | %71 | 1,73 | −%26 |
| Səhm | NR — No Retrieval | %33,1 | 0,911 | −%24,4 |
| Səhm | R−LLM — No LLM | %25,5 | 0,735 | −%26,5 |
| Səhm | Full — R+L+U | %34 | 0,96 | −%26 |
| Forex | NR — No Retrieval | %3,2 | 0,710 | −%1,9 |
| Forex | R−LLM — No LLM | −%0,2 | −0,025 | −%2,4 |
| Forex | Full — R+L+U | %4,3 | 0,88 | −%2,2 |
Retrieval çıxarıldıqda full configuration-a nisbətən cumulative return bütün marketlərdə azalır. LLM çıxarıldıqda azalma stock və forex eksperimentlərində daha nəzərə çarpandır. Məsələn, forex-də full model %4,3 cumulative return və 0,88 Sharpe verdiyi halda no-LLM configuration −%0,2 və −0,025-ə düşür.
Lakin full model hər marketdə minimum MDD yaratmır. Stock-da no-retrieval MDD −%24,4 ilə full modelin −%26 dəyərindən kiçikdir; forex-də də no-retrieval −%1,9, full model isə −%2,2-dir.
Mühüm ablasyon sərhədi: Source Table 8 uncertainty-aware component-ı təkbaşına çıxaran configuration ehtiva etmir. Buna görə retrieval və LLM reasoning töhfələri haqqında eksperimental nəticə çıxarmaq olar; uncertainty-aware decision making-in müstəqil töhfəsi bu ablation ilə ölçülə bilməz.
İndeksləmə LLM həssaslığı
| Indexing LLM | Uğur | Uğursuzluq |
|---|---|---|
| Google/Gemma4-E4B | %28 | %72 |
| Google/Gemma4-31B-it | %96 | %4 |
| AliBaba/Qwen3.6-27B-it | %100 | %0 |
Bu “success” metriyi investisiya gəliri deyil. Mənbə bunu indexing instructions-a əməl edib gözlənilən structured output formatını düzgün yaratma uğuru kimi müəyyən edir.
Inference LLM həssaslığı
| Bazar | Inference LLM | Cum. Return | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|
| Kripto | Google/Gemma4-31B-it | %68,3 | 1,65 | 2,55 | −%27 |
| Kripto | Google/Gemma4-E4B | %63,5 | 1,57 | 2,42 | −%28 |
| Kripto | AliBaba/Qwen3.6-27B-it | %71 | 1,73 | 2,72 | −%26 |
| Səhm | Google/Gemma4-31B-it | %25,1 | 0,73 | 1,09 | −%26,5 |
| Səhm | Google/Gemma4-E4B | %24,5 | 0,71 | 1,06 | −%27 |
| Səhm | AliBaba/Qwen3.6-27B-it | %34 | 0,96 | 1,45 | −%26 |
| Forex | Google/Gemma4-31B-it | −%0,3 | −0,05 | −0,06 | −%2,5 |
| Forex | Google/Gemma4-E4B | −%5,4 | −1,07 | −1,37 | −%5,6 |
| Forex | AliBaba/Qwen3.6-27B-it | %4,3 | 0,88 | 1,20 | −%2,2 |
Mənbədə AliBaba/Qwen3.6-27B-it hər üç marketdə ən güclü inference result-larını yaradır. Xüsusilə forex-də LLM seçimi nəticə üzərində böyük fərq yaratmışdır. Bu tapıntı retrieval mexanizminin təkbaşına kifayət etmədiyini, retrieved evidence-in downstream reasoning model tərəfindən necə emal olunduğunun da mühüm olduğunu göstərir.
State-of-the-art metodlarla müqayisə
| Bazar | Metod | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | MDD |
|---|---|---|---|---|---|---|
| Kripto | TAC | %24 | %21,6 | 0,94 | 1,29 | −%31 |
| Kripto | AlphaMixRL | %22 | %19,8 | 1,00 | 1,38 | −%29 |
| Kripto | LLM-MAS | %33 | %30 | 0,96 | 1,50 | −%28 |
| Kripto | Proposed | %71 | %64 | 0,31 | 1,73 | −%26 |
| Səhm | TAC | %10,4 | %5,6 | 0,25 | 0,74 | −%28 |
| Səhm | AlphaMixRL | %11,8 | %6,3 | 0,31 | 0,82 | −%27 |
| Səhm | Multi-LLM Black–Litterman | %31 | %16,4 | 0,28 | 0,91 | −%29 |
| Səhm | Proposed | %34 | %18 | 0,19 | 0,96 | −%26 |
| Forex | TAC | %0,7 | %0,4 | 0,45 | 0,61 | −%5,1 |
| Forex | AlphaMixRL | %0,8 | %0,45 | 0,50 | 0,68 | −%4,6 |
| Forex | Fine-tuned LLaMA | %3,3 | %1,9 | 0,08 | 0,76 | −%3,1 |
| Forex | Proposed | %4,3 | %2,4 | 0,03 | 0,88 | −%2,2 |
Mənbə Table 11-də Proposed framework-ün hər üç marketdə ən yüksək cumulative return və Sharpe dəyərini verdiyini göstərir. Lakin müəlliflər nəticə bölməsində competing implementations-ın həmişə tam eyni experimental protocol altında işlədilmədiyini açıq şəkildə bildirirlər. Buna görə Table 11 nəzarətli benchmark müqayisəsi kimi qiymətləndirilərkən protokol bərabərliyi barədə ehtiyatlı olmaq lazımdır.
Tədqiqatın dəstəklədiyi nəticələr
- Araşdırılan expert pool daxilində ekspertlərin nisbi üstünlüyü market və metriklərə görə dəyişmişdir.
- Table 6 çərçivəsində retrieval-based Proposed RAG hər üç marketdə Best Fixed və Recent Gating-dən daha yüksək cumulative return və Sharpe vermişdir.
- Retrieval-ın çıxarılması hər üç marketdə full configuration-a nisbətən cumulative return-ü azaltmışdır.
- LLM reasoning-in çıxarılması xüsusilə stock və forex eksperimentlərində mühüm performans azalması ilə əlaqəlidir.
- Expert-pool ablation complementary expert sayı artdıqca bildirilən Sharpe improvement-ın 1–4 expert intervalında artdığını göstərmişdir.
- Inference LLM seçimi nəticələri nəzərəçarpacaq dərəcədə dəyişmiş və Qwen3.6-27B-it sınaqdan keçirilən üç model arasında ən güclü nəticələri yaratmışdır.
- Mənbənin riyazi teoremi Axiom 1–3 altında uyğun specialist əlavə edilməsinin expected utility-ni azaltmamasına zəmanət verir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
- Təklif olunan metodun real pulla canlı bazarda eyni gəliri təmin edəcəyi sübut olunmamışdır.
- %71, %34 və %4,3 cumulative return dəyərləri gələcək investisiya gəlirinə zəmanət deyil.
- LLM təkbaşına uğurlu trader kimi doğrulanmamışdır; tədqiqatda LLM expert-routing rolundadır.
- Monotonluq teoremi Axiom 1–3 ödənmədən expert əlavə edilməsinin performansı azalda bilməyəcəyini demir.
- Table 6 nəticələri Proposed RAG-ın bütün standalone expert-lərdən daha yüksək cumulative return verdiyini sübut etmir.
- Tək experimental run statistik etibar intervalı və ya random-seed robustness sübutu deyil.
- Component ablation uncertainty-aware mexanizmin müstəqil töhfəsini ölçməmişdir.
- Üç marketdəki nəticələr bütün bazarlara, bütün dövrlərə və ya fərqli transaction-cost mühitlərinə avtomatik ümumiləşdirilə bilməz.
- Keçmişdə oxşar latent state tapılması gələcəkdə eyni bazar dinamikalarının təkrarlanacağına zəmanət vermir.
Mənbədə çatışmayan və ya təkrar istehsal baxımından qeyri-müəyyən qalan məlumatlar
Market-data provider: Bildirilmir.
Exact train / validation / test calendar split: Chronological retrieval və \(\tau<t\) məhdudiyyəti verilib; lakin bütün marketlər üçün açıq başlanğıc-bitmə tarixli train/validation/test split cədvəli verilməyib.
Transaction-cost dəyəri: SOTA müqayisəsinin eyni transaction-cost assumptions altında aparılmağa çalışıldığı bildirilir; rəqəmsal fee/slippage dəyəri verilmir.
Portfolio constraints: Eyni constraints-in istifadə olunmağa çalışıldığı bildirilir; long-only, leverage, short-selling, cash allocation və ya weight bound dəyərləri açıq şəkildə sadalanmır.
RL expert training hyperparameters: A2C, DDPG, PPO, TQC və CrossQ adları və metod sinifləri verilir; hər modelin learning rate, batch size, optimizer, network depth, reward function və digər training parametrləri bu PDF-də tam reproducibility table formasında təqdim edilmir.
Weighted uncertainty: Algorithm 2 daxilində \(\sigma_t^{(e)}\) hesablandığı bildirilir; formulu verilmir.
Teorem parametrləri: \(\epsilon\), \(\tau\) və \(\delta\) nəzəri şərtlər kimi müəyyən edilib; eksperimentlərdə istifadə olunan rəqəmsal dəyərləri verilmir.
Prompt validation set: Beş prompt iteration bildirilib; validation sample size və tam dövr paylanması göstərilmir.
Expert-pool ablation: Beş ekspertli full pool-a baxmayaraq Table 7 yalnız 1–4 expert nəticələrini verir və expert-lərin nested pool-a hansı ardıcıllıqla əlavə edildiyini izah etmir.
Statistical significance: Çoxsaylı random seed, confidence interval, p-value və ya formal hypothesis test bildirilməyib.
Public code repository: Yüklənmiş PDF-də doğrulanmış public code repository bağlantısı verilməyib.
Tədqiqatın güclü tərəfləri
Tədqiqatın güclü tərəfi expert routing qərarını yalnız son bir neçə günlük performance-a bağlamaq əvəzinə tarixən oxşar market states üzərində reallaşmış expert behavior ilə əsaslandırmasıdır. Bu yanaşma retrieval sistemini yalnız məlumat gətirən köməkçi olmaqdan çıxarıb portfolio expert selection mexanizminin əsas hissəsinə çevirir.
İkinci mühüm güclü tərəf LLM-in vəzifəsini məhdudlaşdırmasıdır. LLM birbaşa portfolio weights yaratmır; retrieved evidence-i şərh edən coordination/routing layer kimi istifadə olunur. Bu fərq LLM-in numerical trading policy əvəzinə contextual reasoning rolunda qiymətləndirilməsinə imkan verir.
Üçüncü güclü tərəf üç fərqli financial market class üzərində eyni \(L=22\), \(H=5\), \(K=3\) retrieval protokolunun tətbiqi və expert heterogeneity, pool size, retrieval, LLM choice və indexing quality üçün müxtəlif ablation/sensitivity analizlərinin aparılmasıdır.
Əsas məhdudiyyətlər
Ən mühüm məhdudiyyət hər market üçün yalnız bir experimental run aparılmasıdır. Buna görə random initialization və ya stochastic training təsirlərinin nəticə paylanması məlum deyil.
İkinci məhdudiyyət competing SOTA methods-ın bütün hallarda tam eyni experimental protocol altında tətbiq edilə bilməməsidir. Bu vəziyyət Table 11-in birbaşa metod üstünlüyü iddiasını ehtiyatla şərh etməyi tələb edir.
Üçüncü məhdudiyyət exact transaction-cost, portfolio constraints, data provider və mühüm RL training hyperparameters kimi reproduction üçün zəruri bəzi detalların mənbədə açıq olmamasıdır.
Dördüncü məhdudiyyət retrieval və LLM components üçün ablation olsa da, uncertainty-aware mechanism-ın təkbaşına çıxarıldığı ablation-ın olmamasıdır.
Beşinci məhdudiyyət historical similarity-nin gələcəkdə də eyni expert suitability əlaqəsini qoruyacağı fərziyyəsinin bazar strukturundakı tamamilə yeni structural breaks zamanı uğursuz ola bilməsidir. Mənbə yanaşması empirical historical grounding istifadə edərək bu riski azaltmağa çalışsa da, unseen regime problemi tam aradan qaldırılmış deyil.
Mənbə və Metod Qeydi
Orijinal başlıq: Regime-Aware Portfolio Management via Retrieval-Augmented LLM-Guided Expert Switching
Müəlliflər: Ahmad Asadi; Reza Safabakhsh.
Müəllif sırası: Mənbədəki sıra qorunmuşdur.
Qurum: Deep Learning Lab, Computer Engineering Department, Amirkabir University of Technology, Hafez Avenue, Tehran, Iran.
Yüklənmiş mənbə: arXiv:2608.28252v1 [cs.AI].
arXiv göndərilmə tarixi: 28 Avqust 2026.
PDF üzərində görünən tarix: 31 Avqust 2026.
Mənbə növü: Preprint.
Resenziya statusu: Yüklənmiş arXiv v1 resenziyalı jurnal Version of Record deyil. 21 Noyabr 2026 tarixinə doğrulana bilən aktual bibliyografik qeydlərdə resenziyalı journal version müəyyən edilməmişdir.
Daha yeni bibliyografik versiya: Eyni başlıqlı 47 səhifəlik SSRN versiyası 23 Oktyabr 2026-da yayımlanmışdır. SSRN suggested citation DOI-si 10.2139/ssrn.7661576-dır. Verianla-nın elmi məzmunu yüklənmiş arXiv v1 əsasında hazırlanmışdır; sonrakı SSRN versiyasının yeni elmi məzmunu bu məqaləyə qarışdırılmamışdır.
Corresponding / contact author: Yüklənmiş arXiv PDF-də corresponding-author işarəsi açıq göstərilmir. Sonrakı SSRN bibliyografik qeydi Reza Safabakhsh-ı Contact Author kimi göstərir.
Bərabər töhfə: Yüklənmiş mənbədə equal contribution bəyanatı görünmür.
Mənbə lisenziyası: Yüklənmiş arXiv v1-də Verianla-nın mənbə fiqurlarını birbaşa yenidən istifadə etməsinə icazə verdiyini dəqiqləşdirən açıq Creative Commons lisenziyası doğrulanmamışdır. Buna görə mənbə fiqurları eynilə istifadə olunmamış, elmi əlaqələr müstəqil sxem kimi yenidən qurulmuşdur.
Maliyyələşdirmə: Yüklənmiş PDF-də ayrıca funding declaration müəyyən edilməmişdir.
Maraqlar toqquşması: Yüklənmiş PDF-də ayrıca conflict-of-interest / competing-interest declaration müəyyən edilməmişdir.
Məlumat əlçatanlığı: Yüklənmiş PDF-də ayrıca Data Availability bölməsi və ya doğrulanmış public dataset repository bağlantısı yoxdur.
Kod əlçatanlığı: Yüklənmiş PDF-də doğrulanmış public source-code repository bağlantısı yoxdur.
Əsas metod: Dual-stream Transformer-VAE market-state representation + chronological vector retrieval + Statement of Performance + instruction-tuned LLM guided expert switching + reinforcement-learning expert pool.
Expert pool: A2C, DDPG, PPO, TQC və CrossQ.
Marketlər: Cryptocurrency, stock və foreign exchange; hər marketdə 30 symbol.
Məlumat tezliyi: Daily OHLCV.
Giriş pəncərəsi: \(L=22\) ticarət günü.
Forward / saxlama üfüqü: \(H=5\) gün.
Retrieval: \(K=3\) ən yaxın tarixi vəziyyət, cosine similarity.
Embedding ölçüsü: \(d=64\).
LLM temperaturu: 0,1.
LLM çağırış limiti: Decision step üçün ən çox bir çağırış.
Leakage nəzarəti: Test zamanı retrieval yalnız \(\tau<t\) historical observations ilə məhdudlaşdırılmışdır.
Avadanlıq: Tək NVIDIA H100 GPU.
Eksperiment təkrarı: Hər market üçün tək run; nəticələr repeated-seed averages deyil.
Statistik sərhəd: Confidence interval, formal significance test və çoxsaylı random-seed paylanması bildirilmir.
Nəzəri nəticə: Monotonic Expert-Pool Performance nəticəsi yalnız bounded estimation error, conservative switching və specialist dominance assumptions altında keçərlidir; real bazar gəliri üçün şərtsiz zəmanət deyil.
Mənbədaxili mühüm hesabat fərqi: Table 5 standalone expert cumulative return dəyərləri ilə Table 6 “Best Fixed” dəyərləri uyğun gəlmir və mənbə fərqin səbəbini izah etmir. Bundan əlavə, Section 4.3 dörd strategy müqayisə etdiyini desə də yalnız üç strategy müəyyən edir.
Təkrar istehsal açıqları: Exact market-data provider, calendar-based train/validation/test split, transaction-cost dəyəri, portfolio constraints, bir çox RL training hyperparameter, weighted-uncertainty formulu, rəqəmsal \(\epsilon/\tau/\delta\) dəyərləri və prompt-validation-set ölçüsü bildirilmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib