


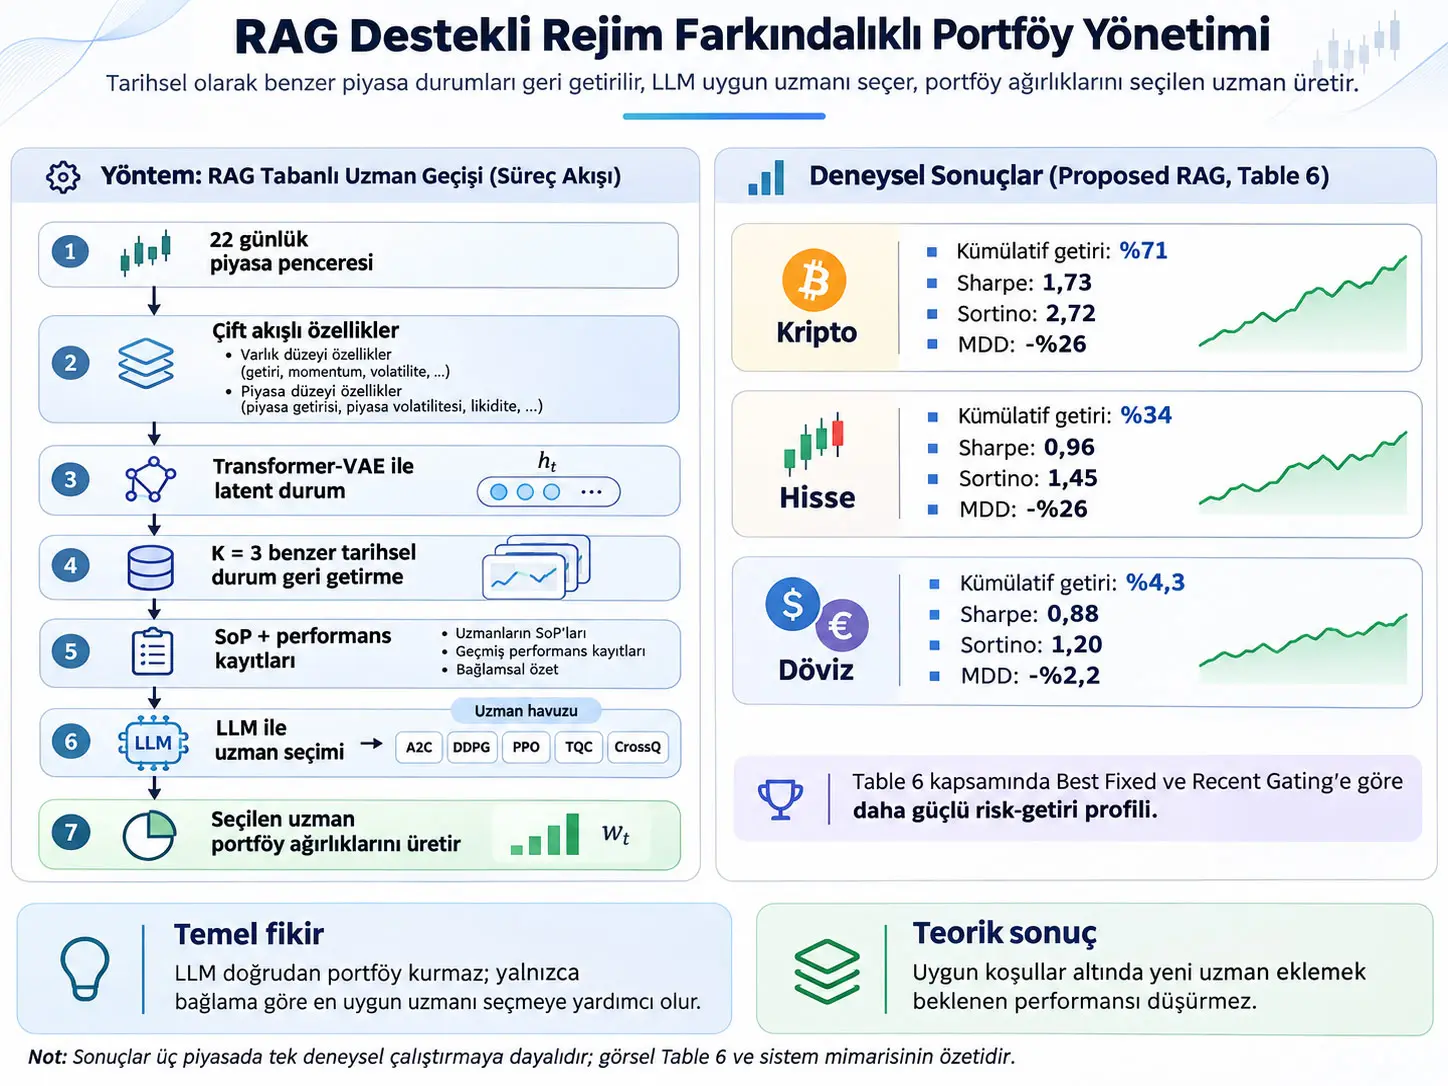
Retrieval-augmented LLM-guided expert switching, güncel piyasa durumunu tarihsel olarak benzer piyasa durumlarıyla eşleştirip bu dönemlerde farklı portföy uzmanlarının nasıl performans gösterdiğini inceleyen ve bir büyük dil modelini doğrudan portföy ağırlığı üretmek yerine hangi uzman politikanın kullanılacağına karar vermede kullanan adaptif bir portföy-yönlendirme yaklaşımıdır. Çalışma, piyasa koşullarının zaman içinde değiştiği non-stationary finans ortamlarında tek bir portföy modelinin her rejimde en iyi davranmayabileceği problemine odaklanmaktadır.
Yöntemde piyasa durumu iki ayrı bilgi akışıyla temsil edilmektedir. İlk akış varlık düzeyindeki log-return, RSI, MACD, ATR, realized volatility ve volume-change özelliklerini; ikinci akış ise piyasa genelindeki trend, volatility-regime ve liquidity göstergelerini taşır. İki akış ayrı Transformer-VAE encoder'ları ile latent representation'a dönüştürülür ve tek bir \(h_t\) state vector içinde birleştirilir. Tarihsel state'ler vector database içinde saklanır; her state için A2C, DDPG, PPO, TQC ve CrossQ uzmanlarının sonraki beş günlük performansı ile Statement of Performance (SoP) kayıtları tutulur.
Online karar aşamasında mevcut 22 trading-day piyasa penceresi aynı latent uzaya kodlanır ve cosine similarity ile en yakın \(K=3\) tarihsel durum geri getirilir. Bu tarihsel durumlarda uzmanların gerçekleşmiş performansı, SoP kayıtları ve güncel piyasa bağlamı LLM'ye sunulur. LLM portföy ağırlıklarını kendisi üretmez; hangi uzman politikanın etkinleştirileceği konusunda bağlamsal değerlendirme yapar. Seçilen reinforcement-learning uzmanı daha sonra portföy ağırlıklarını oluşturur.
Çalışmanın Table 6 selection-strategy karşılaştırmasında Proposed RAG; kripto para piyasasında %71 cumulative return ve 1,73 Sharpe, hisse piyasasında %34 cumulative return ve 0,96 Sharpe, döviz piyasasında ise %4,3 cumulative return ve 0,88 Sharpe elde etmiştir. Bu değerler aynı tabloda Best Fixed Expert için sırasıyla %68/1,64, %26/0,74 ve %3,2/0,71'dir. Ancak her piyasa yalnız bir deneysel çalıştırmayla değerlendirilmiş, çoklu random seed ortalamaları veya istatistiksel anlamlılık testleri raporlanmamıştır.
Sonuçların yorumunda önemli bir kaynak-içi ayrım vardır. Table 5'te tek başına çalıştırılan uzmanların en yüksek cumulative return değerleri kripto piyasasında TQC için %76,16, hisse piyasasında CrossQ için %38,21 ve forexte A2C için %4,27'dir; bu değerler Table 6'daki “Best Fixed” değerlerinden farklıdır. Kaynak bu iki tablonun neden farklı “fixed expert” sonuçları verdiğini açıklamamaktadır. Bu nedenle çalışma, Proposed RAG'ın Table 6 içindeki seçim stratejilerinden daha iyi sonuç verdiğini destekler; önerilen sistemin her koşulda bütün standalone uzmanlardan daha yüksek getiri ürettiği sonucunu desteklemez.
Araştırmanın temel problemi
Finansal piyasalar durağan sistemler değildir. Volatilite düzeyi, likidite, cross-asset relationships, trend yapısı ve piyasa katılımcılarının davranışı zaman içinde değişebilir. Bu nedenle belirli bir dönemde başarılı olan portföy politikası başka bir market regime içinde aynı başarıyı göstermeyebilir.
Tek bir deep-learning veya deep-reinforcement-learning modelini bütün piyasa koşullarına uyarlamaya çalışmak model kapasitesini artırabilir; ancak model yine eğitim sırasında gördüğü regularities'e aşırı uyum sağlayabilir. Mixture-of-Experts yaklaşımı farklı uzman modeller kullanarak bu sorunu azaltmaya çalışır, fakat klasik MoE yapılarında hangi uzmanın etkinleştirileceğini belirleyen learned gating network de daha önce görülmemiş rejimlerde hatalı seçim yapabilir.
Çalışmanın önerdiği alternatif yaklaşım, “son birkaç günde hangi model daha başarılıydı?” sorusunun yerine “mevcut piyasa durumuna tarihsel olarak benzeyen dönemlerde hangi uzman daha başarılı olmuştu?” sorusunu koymaktadır.
Retrieval-Augmented LLM-Guided Expert Switching Nedir?
Retrieval-augmented LLM-guided expert switching, mevcut piyasa durumuna benzeyen tarihsel durumları latent vector database içinden geri getirip bu durumlarda uzman modellerin gerçekleşmiş risk-getiri performansını LLM destekli bir yönlendirme mekanizmasına sunarak kullanılacak portföy uzmanını seçen, ancak portföy ağırlıklarını doğrudan LLM'ye ürettirmeyen bir expert-routing yöntemidir.
Sistem iki ayrı aşamadan oluşur
Offline indexing aşaması, tarihsel piyasa durumlarını önceden işler. Her historical window dual-stream Transformer-VAE ile latent state'e dönüştürülür. Ardından bütün uzmanlar aynı tarihsel durumdan başlayarak sabit forward horizon boyunca değerlendirilir. Elde edilen performance records ve Statement of Performance kayıtları latent representation ile birlikte vector database'e yerleştirilir.
Online inference aşaması, güncel piyasa durumunu aynı latent uzaya dönüştürür, geçmişteki en benzer \(K=3\) state'i geri getirir, ilgili expert-performance kayıtlarını toplar ve LLM'yi expert-selection için kullanır. LLM'nin görevi portfolio allocation üretmek değil, retrieved evidence'i yorumlayarak uygun expert'i belirlemektir.
Statement of Performance (SoP) nedir?
Statement of Performance, her historical market episode için ilgili uzmanın davranışını ve gerçekleşmiş performansını bağlamsal biçimde özetleyen kayıttır. Kaynakta offline performance record; cumulative return, Sharpe ratio ve maximum drawdown bilgilerini içerir. SoP ise aynı dönemin market context'ini, expert behavior'ını ve ilgili uncertainty factors bilgisini özetleyerek LLM'nin yalnız sayısal bir skor değil bağlamlandırılmış tarihsel kanıt görmesini sağlar.
LLM Bu Sistemde Portföy Ağırlıklarını Doğrudan Üretiyor mu?
Hayır. Çalışmadaki instruction-tuned LLM, geri getirilen tarihsel market-state kayıtlarını ve uzmanların risk-getiri davranışını yorumlayarak hangi expert'in seçileceğini belirleyen yönlendirme katmanına katkı verir; gerçek portfolio weight vector seçilen A2C, DDPG, PPO, TQC veya CrossQ uzmanı tarafından oluşturulur.
Neden LLM doğrudan trader olarak kullanılmıyor?
Çalışmanın literatür değerlendirmesi, LLM tabanlı trading agent'ların uzun dönemli benchmark'larda her zaman buy-and-hold veya nicel yöntemlerden üstün olmadığını vurgulamaktadır. Bu nedenle LLM'nin görevi daraltılmıştır. Model doğrudan alım-satım miktarı hesaplamak yerine tarihsel bağlamı yorumlama, retrieved episodes arasındaki ilişkileri değerlendirme ve expert routing görevinde kullanılmaktadır.
LLM değerlendirmesi neden sınırlandırılmıştır?
Erken prompt sürümlerinde LLM'nin retrieved historical records içinde bulunmayan return değerlerine extrapolation yaptığı ve aşırı güvenli cevaplar ürettiği gözlenmiştir. Kaynak beş prompt iteration'ın bir validation set üzerinde değerlendirildiğini ve mean absolute estimation error'ın yaklaşık %18'den %11'e gerilediğini bildirir.
Son prompt tasarımı üç temel sınırlama uygular:
- Empirical grounding: Risk-getiri değerlendirmesi retrieved historical MDD, realized information ratio ve diğer gerçekleşmiş performance observations ile sınırlandırılır.
- Conservative margining: Yeni bir candidate expert, incumbent expert'ten yalnız estimated advantage uncertainty/noise margin'ını aştığında tercih edilir.
- Tail-event separation: Extreme drawdown, liquidity squeeze ve regime transition dönemleri sıradan dönemlerden ayrıca değerlendirilir.
Kaynak validation set'in kaç örnekten oluştuğunu, hangi piyasa dönemlerini içerdiğini ve %18 → %11 değerlerinin tam dağılımını raporlamamaktadır.
Monotonik Uzman-Havuzu Teoremi Ne Söylüyor?
Kaynağın monotoniklik sonucu, yeni bir uzman eklemenin koşulsuz olarak performansı artırdığını söylemez; yalnız estimation error'ın \(\epsilon\) ile sınırlı olduğu, switch threshold'un \(\tau\ge2\epsilon\) olduğu ve yeni uzmanın hedef bölgesindeki gerçek utility advantage'ının \(\delta>\tau+2\epsilon\) koşulunu sağladığı varsayımlar altında expert pool'a yeni specialist eklenmesinin beklenen utility'yi azaltmayacağını gösterir.
Eşitlik 1: Switching policy'nin beklenen değeri
\[ V(\pi_N) = \int_{\mathcal{S}} U_{\pi_N(s)}(s)\,d\mathbb{P}(s). \tag{1} \]
Ne hesaplar? \(N\) uzmanlı bir switching policy'nin bütün market-state uzayı üzerindeki expected risk-adjusted utility değerini hesaplar.
- \(\mathcal{S}\): olası latent market state uzayıdır.
- \(\mathbb{P}\): state uzayı üzerindeki olasılık ölçüsüdür.
- \(\pi_N(s)\): state \(s\) için seçilen expert indeksidir.
- \(U_i(s)\): expert \(i\)'nin state \(s\) içindeki gerçekleşmiş gerçek risk-adjusted utility'sidir.
\(U_i(s)\)'nin belirli bir fiziksel birimi kaynakta tanımlanmamıştır. Teorik modelde utility ölçeğinde bir niceliktir ve decision time'da doğrudan bilinmez.
Eşitlik 2: LLM destekli expert assessment
\[ \rho_i(s) = \mathcal{M} \left( \mathcal{H}_t(s),E_i \right). \tag{2} \]
\(\mathcal{H}_t(s)\), current state \(s\)'ye benzeyen retrieved historical episodes kümesidir; \(E_i\) ilgili expert'tir; \(\mathcal{M}\) retrieved evidence üzerinde çalışan değerlendirme mekanizmasını, \(\rho_i(s)\) ise switching procedure içinde kullanılan estimated assessment değerini gösterir.
Kritik ayrım: \(\rho_i(s)\), bilinmeyen gerçek \(U_i(s)\)'nin doğrudan gözlemi değildir. Historical performance records sayısal temeli sağlar; LLM retrieved context'i yorumlayıp assessment calibration'a katkıda bulunur.
Eşitlik 3: Axiom 1 — bounded estimation error
\[ \sup_{s\in\mathcal{S}} \left| \rho_i(s)-U_i(s) \right| \le \epsilon, \qquad \forall i\in\{1,\ldots,N+1\}. \tag{3} \]
Bu koşul estimated assessment ile gerçek utility arasındaki en büyük hatanın \(\epsilon\) değerini aşmadığını varsayar. \(\epsilon\), \(\rho\) ve \(U\) ile aynı utility/assessment ölçeğindedir.
Bu, deneysel olarak bütün state uzayı için kanıtlanmış bir özellik değildir. Kaynağın practical implementation'ı, LLM'yi retrieved empirical observations dışına extrapolation yapmamaya zorlayarak bu aksiyoma yaklaşmaya çalışır.
Eşitlik 4: En yüksek estimated utility'li expert
\[ e^*(s) = \arg\max_{i\in\{1,\ldots,N\}} \rho_i(s). \tag{4} \]
Bu ifade state \(s\) için mevcut expert pool içindeki en yüksek estimated assessment değerine sahip expert indeksini seçer.
Eşitlik 5: Conservative switching
\[ \pi_N(s) = \begin{cases} e^*(s), & \rho_{e^*(s)}(s) - \rho_{\pi_N(s)}(s) > \tau, \\ \pi_N(s), & \text{aksi durumda}. \end{cases} \tag{5} \]
ve:
\[ \tau\ge2\epsilon. \]
Candidate expert'in incumbent expert'e göre estimated advantage'ı \(\tau\) değerinden büyük değilse mevcut expert korunur. Amaç estimation noise nedeniyle gereksiz switching'i azaltmaktır.
Eşitlik 6: Axiom 3 — specialist dominance
\[ U_{N+1}(s) \ge U_{\pi_N(s)}(s) + \delta, \qquad s\in\mathcal{S}_R, \tag{6} \]
ve:
\[ \delta > \tau+2\epsilon. \]
\(\mathcal{S}_R\), yeni specialist expert'in hedeflendiği market-state subset'idir ve kaynak \(P(\mathcal{S}_R)>0\) varsayar. Yeni uzman bu bölgede incumbent policy'den en az \(\delta\) kadar daha yüksek gerçek utility'ye sahip olmalıdır.
Kaynak-içi ifade notu: Axiom 3'ün hemen ardından kaynak, specialist region dışında yeni expert'in utility'sinin “unlimited” varsayıldığını yazmaktadır. Bu sözcüğün matematiksel olarak “unrestricted/unconstrained” anlamında mı kullanıldığı ayrıca tanımlanmamıştır. Verianla bu ifadeyi sessizce başka bir varsayımla değiştirmemektedir.
Eşitlik 7–9: Hatalı switching'in neden utility'yi düşürmemesi bekleniyor?
\[ U_{N+1}(s) \ge \rho_{N+1}(s)-\epsilon. \tag{7} \]
\[ U_{\pi_N(s)}(s) \le \rho_{\pi_N(s)}(s)+\epsilon. \tag{8} \]
İki eşitsizlik birleştirildiğinde:
\[ U_{N+1}(s) - U_{\pi_N(s)}(s) > \tau-2\epsilon. \tag{9} \]
\(\tau\ge2\epsilon\) olduğundan sağ taraf negatif değildir. Böylece belirtilen error bound gerçekten geçerliyse switching threshold'u aşan bir değişimin gerçek utility'yi azaltmaması beklenir.
Eşitlik 10–11: Hedef specialist bölgesindeki kesin iyileşme
\[ \rho_{N+1}(s) - \rho_{\pi_N(s)}(s) \ge \delta-2\epsilon. \tag{10} \]
\(\delta>\tau+2\epsilon\) olduğundan:
\[ \delta-2\epsilon>\tau. \]
Böylece specialist, hedef region içinde switching criterion'u karşılar. Beklenen utility'ye minimum contribution:
\[ \Delta V \ge \int_{\mathcal{S}_R} \delta\,d\mathbb{P}(s) = \delta \mathbb{P}(\mathcal{S}_R) > 0. \tag{11} \]
olur.
Kaynak daha sonra specialist'lerin ardışık eklenmesi halinde:
\[ V(\pi_1) \le V(\pi_2) \le \cdots \le V(\pi_K) \]
şeklinde non-decreasing policy-value sequence elde edildiğini ve bunun:
\[ V^* = \int_{\mathcal{S}} \sup_E U_E(s) \,d\mathbb{P}(s) \]
ile tanımlanan best-achievable utility tarafından üstten sınırlandığını belirtir.
Teoremin doğru yorumu: Bu sonuç “uzman sayısını artırırsak gerçek portföy getirisi her zaman artar” anlamına gelmez. Sonuç, Axiom 1–3 gerçekten sağlandığında matematiksel olarak geçerlidir. Practical prompt kuralları ise kaynağın kendi ifadesiyle bu aksiyomların kanıtı değil, LLM davranışını aksiyomlarla daha uyumlu hale getirmeye yönelik implementation heuristics'tir.
Piyasa durumu hangi özelliklerle temsil ediliyor?
Her karar anında iki rolling-window tensor oluşturulur.
Asset-level teknik tensor:
\[ S_t^{tech} \in \mathbb{R}^{L\times A\times F_1}. \]
Burada \(L\) rolling-window uzunluğu, \(A\) portföydeki varlık sayısı ve \(F_1\) asset-level feature sayısıdır. Deneylerde \(L=22\) trading day ve \(A=30\) kullanılır.
Asset-level feature set:
- Log-return: Ardışık fiyatların logarithmic değişimini temsil eder.
- RSI: Relative Strength Index; fiyat hareketlerinin göreli momentum yapısını özetleyen teknik göstergedir.
- MACD: Moving Average Convergence Divergence; farklı zaman ölçeklerindeki hareketli ortalamaların ilişkisini kullanarak trend/momentum yapısını temsil eder.
- ATR: Average True Range; fiyat hareketlerinin aralık tabanlı volatilite büyüklüğünü temsil eder.
- Realized volatility: gözlenen fiyat hareketlerinden türetilen oynaklık bilgisi.
- Volume changes: işlem hacmi değişimleri.
Market-wide tensor:
\[ S_t^{mkt} \in \mathbb{R}^{L\times F_2}. \]
Bu stream aggregate trend indicators, volatility-regime measures ve liquidity variables içerir. Kaynak genel teorik açıklamada macroeconomic conditions kavramından söz etse de uygulamada hangi haricî macroeconomic series'in kullanıldığını listelememektedir; bu nedenle Verianla haricî faiz, enflasyon veya benzeri veri setleri eklememektedir.
Bütün features rolling z-score normalization ile standardize edilir. Kaynak bunun değişen ölçeklerin etkisini azaltmayı ve heteroskedasticity'nin state representation üzerindeki etkisini sınırlamayı amaçladığını belirtir.
Eşitlik 12: Transformer-VAE posterior dağılımı
\[ q_{\phi_x} \left( z_x\mid S_t^x \right) = \mathcal{N} \left( \mu_x(S_t^x), \Sigma_x(S_t^x) \right), \qquad x\in\{tech,mkt\}. \tag{12} \]
Her feature stream kendi Transformer encoder'ı tarafından Gaussian posterior'a eşlenir. \(\mu_x\) posterior mean, \(\Sigma_x\) diagonal covariance ve \(z_x\) latent representation'dır.
Bu değişkenlerin fiziksel birimi yoktur; standardize edilmiş girişlerden öğrenilen latent-space büyüklükleridir.
Eşitlik 13: Reparameterization
\[ z_x = \mu_x + \varepsilon\odot\sigma_x, \qquad \varepsilon \sim \mathcal{N}(0,I). \tag{13} \]
\(\odot\), element-wise multiplication'dır. \(\sigma_x\), posterior standard deviation vector'üdür. Reparameterization, stochastic latent sampling yapılırken gradient-based training'in sürdürülebilmesini sağlar.
Pretraining sırasında sampled latent representation decoder tarafından input reconstruction için kullanılır. Pretraining tamamlandıktan sonra decoder kaldırılır ve encoder market-state representation için tutulur.
Eşitlik 14: İki latent stream'in birleştirilmesi
\[ h_t = \left[ z_t^{tech} \mid z_t^{mkt} \right] \in \mathbb{R}^{D}. \tag{14} \]
\(h_t\), asset-specific ve market-wide latent vectors'ın concatenation sonucudur. Historical indexing ile online query aşamasında aynı representation function kullanıldığı için current state ve historical state aynı latent uzayda karşılaştırılır.
Deney bölümünde retrieval embedding dimension:
\[ d=64 \]
olarak belirtilmektedir. Kaynak \(D\) ile bu implementation'daki \(d\) sembolü arasındaki notasyon ilişkisini ayrıca ayrıntılandırmamaktadır.
Eşitlik 15: Historical index kaydı
\[ D_{\tau} = \left( h_{\tau}, R_{\tau}^{(e)}, SoP_{\tau}^{(e)} \right), \qquad e\in\{1,\ldots,E\}. \tag{15} \]
Her tarihsel state kaydı üç bilgi grubunu bir araya getirir:
- \(h_{\tau}\): historical latent market state,
- \(R_{\tau}^{(e)}\): expert \(e\)'nin forward horizon üzerindeki gerçekleşmiş performance record'u,
- \(SoP_{\tau}^{(e)}\): aynı koşullardaki Statement of Performance.
Eşitlik 16: En yakın tarihsel state'lerin seçimi
\[ \mathcal{N}_t = KNN \left( h_t, \{h_{\tau}\}, K \right). \tag{16} \]
Deneylerde \(K=3\) kullanılır. Similarity metric cosine similarity'dir. Test sırasında yalnız:
\[ \tau<t \]
koşulunu sağlayan historical observations retrieval için kullanılmaktadır. Bu chronological restriction future information'ın karar sürecine sızmasını engellemeyi amaçlar.
Eşitlik 17: Retrieval weight
\[ w_{\tau} = \frac{ sim(h_t,h_{\tau}) }{ \sum_{j\in\mathcal{N}_t} sim(h_t,h_j) }. \tag{17} \]
\(sim(h_t,h_{\tau})\), current state ile historical state arasındaki cosine similarity değeridir. \(w_{\tau}\) boyutsuz normalized retrieval weight'tir.
Matematiksel açıklık sınırı: Cosine similarity teorik olarak negatif de olabilir. Kaynak Eq. 17 öncesinde similarity değerlerinin pozitif aralığa kırpılması, softmax uygulanması veya toplam similarity'nin sıfır olduğu durumun nasıl yönetildiğini açıklamamaktadır. Bu nedenle \(w_{\tau}\)'nin her koşulda klasik convex weight olduğunu varsaymak güvenli değildir.
Eşitlik 18: Similarity-weighted expert performance
\[ \widehat{R}_t^{(e)} = \sum_{\tau\in\mathcal{N}_t} w_{\tau} R_{\tau}^{(e)}. \tag{18} \]
Bu denklem retrieved historical episodes içindeki expert \(e\) performansını similarity ağırlıklarıyla birleştirir. \(\widehat{R}_t^{(e)}\), \(R_{\tau}^{(e)}\) hangi performans ölçeğinde tanımlanmışsa aynı ölçeği taşır.
Kaynak-içi gösterim sınırı: Offline açıklamada performance record içinde cumulative return, Sharpe ratio ve MDD bulunduğu belirtilmektedir; Eq. 18 ise \(R_{\tau}^{(e)}\)'yi tek bir matematiksel büyüklük gibi yazar. Bu metriklerin scalar composite score'a nasıl dönüştürüldüğü veya Eq. 18'in her metrik için component-wise uygulanıp uygulanmadığı kaynakta açık biçimde tanımlanmamıştır.
Algorithm 1: Offline Regime Indexing and Expert Performance Grounding
- Her historical time step \(\tau\) için asset-level ve market-wide feature tensors oluşturulur.
- Dual-stream T-VAE ile \(h_{\tau}\) latent embedding hesaplanır.
- Her expert \(E^{(e)}\) historical state'ten başlatılır.
- Expert'in forward horizon \(H\) üzerindeki gerçekleşmiş performansı hesaplanır.
- Aynı episode için Statement of Performance oluşturulur.
- \((h_{\tau},R_{\tau}^{(e)},SoP_{\tau}^{(e)})\) kaydı historical index'e yazılır.
Algorithm 2: Online Retrieval and Portfolio Decision-Making
- Current market data'dan \(S_t^{tech}\) ve \(S_t^{mkt}\) oluşturulur.
- Dual-stream T-VAE ile \(h_t\) hesaplanır.
- Vector database'den \(K=3\) nearest historical regimes alınır.
- Her expert için similarity-weighted performance estimate hesaplanır.
- Algorithm 2 ayrıca weighted uncertainty \(\sigma_t^{(e)}\) hesaplandığını belirtir.
- Retrieved SoPs ve current market context LLM'ye verilir.
- LLM expert selection kararına katkıda bulunur ve \(e^*\) belirlenir.
- Seçilen expert \(E^{(e^*)}\) portfolio weights \(w_t\)'yi üretir.
Yeniden üretilebilirlik sınırı: Algorithm 2'de geçen weighted uncertainty \(\sigma_t^{(e)}\) için kaynak ayrı bir matematiksel formül vermemektedir. Bu boşluk Verianla tarafından yeni bir uncertainty estimator eklenerek doldurulmamıştır.
Çalışmanın Yöntemi ve Bulguları
Deneysel veri yapısı
Çalışma üç farklı finans market class üzerinde daily OHLCV verisi kullanmaktadır:
- 30 cryptocurrency,
- 30 stock,
- 30 foreign-exchange pair.
OHLCV, Open, High, Low, Close ve Volume bileşenlerinden oluşan piyasa verisi yapısıdır. Çalışmanın girişinde high-frequency trading bağlamından söz edilmesine rağmen gerçek deneyler intraday high-frequency data ile değil daily OHLCV ile yürütülmüştür.
| Parametre | Kaynak değeri |
|---|---|
| Market class | Crypto, Stock, Forex |
| Her piyasadaki symbol sayısı | 30 |
| Input window \(L\) | 22 trading day |
| Holding / forward horizon \(H\) | 5 day |
| Historical neighbors \(K\) | 3 |
| Similarity | Cosine similarity |
| Latent embedding dimension | 64 |
| LLM temperature | 0,1 |
| LLM call | Karar başına en fazla 1 |
| Future-leakage kısıtı | Retrieval yalnız \(\tau<t\) |
| Donanım | Tek NVIDIA H100 GPU |
| Deney tekrar sayısı | Her market için 1 run |
Kripto para paneli
30 cryptocurrency symbol:
ADA, APT, ARB, ATOM, AVAX, BCH, BNB, BTC, DOGE, DOT, EGLD, ETC, ETH, FIL, HBAR, ICP, LINK, LTC, MATIC, MKR, NEAR, RNDR, SHIB, SOL, TON, TRX, UNI, VET, XLM ve XRP.
Symbol bazında availability period aynı değildir. Kaynak Table 2'de en uzun serilerden BTC ve LTC için 17 Eylül 2014–31 Mayıs 2026 arasında 4.275 sample raporlanırken, APT için 20 Kasım 2021–24 Haziran 2025 arasında 1.311 sample bulunmaktadır. RNDR, MATIC, UNI ve APT gibi bazı series 2026'dan daha erken sonlanmaktadır.
Cryptocurrency market için standart tek broad-market benchmark bulunmadığından kaynak iki synthetic index oluşturmuştur:
- equal-weighted / unweighted cumulative-return index,
- volume-weighted cumulative-return index.
Kaynak, equal-weighted raw-price aggregation'ın küçük sayıdaki extreme constituents tarafından baskın hale geldiğini ve bu nedenle volume-weighted variant'ın primary market-level descriptor olarak tercih edildiğini belirtir.
Hisse senedi paneli
30 stock:
TMO, MCD, NVDA, DIS, TSLA, CVX, XOM, ACN, V, WMT, KO, LIN, HD, GOOGL, CRM, UNH, BAC, COST, MA, PG, AAPL, JPM, JNJ, MSFT, MRK, META, AMZN, ABBV, BRK-B ve PEP.
Birçok stock series 3 Ocak 2000–29 Mayıs 2026 arasında 6.641 sample içerirken daha sonra halka açılan şirketlerde daha kısa history bulunmaktadır. Stock market-level context için S&P 500, NASDAQ Composite ve Dow Jones Industrial Average referansları kullanılmıştır.
Döviz paneli
30 forex pair:
USDCAD, EURAUD, EURCHF, GBPCHF, CHFJPY, NZDCHF, AUDCAD, NZDCAD, GBPUSD, AUDUSD, GBPAUD, USDJPY, GBPJPY, NZDJPY, AUDNZD, EURGBP, USDCHF, EURCAD, AUDJPY, GBPCAD, USDTRY, AUDCHF, EURTRY, EURSEK, GBPNZD, EURUSD, NZDUSD, EURJPY, EURNZD ve CADJPY.
FX için kaynak tek bir standard broad-market composite index raporlamamaktadır. Market-wide condition dual-stream encoder'ın aggregate market-feature kanalından temsil edilmektedir.
Veri kaynağı sınırı: PDF, OHLCV serilerinin hangi market-data provider veya API'den indirildiğini açık biçimde belirtmemektedir. Verianla bu nedenle Yahoo Finance, Binance, Alpha Vantage veya başka bir sağlayıcıyı varsaymamaktadır.
Beş reinforcement-learning uzmanı
| Expert | Kaynakta verilen temel rol |
|---|---|
| A2C | Advantage Actor-Critic; synchronous actor-critic policy-gradient yaklaşımı. |
| DDPG | Deep Deterministic Policy Gradient; continuous action space için off-policy actor-critic. |
| PPO | Proximal Policy Optimization; policy update büyüklüğünü sınırlayarak training stability sağlamayı amaçlayan policy-gradient yöntemi. |
| TQC | Truncated Quantile Critics; reward distribution'ı quantile critics ile modelleyen distributional reinforcement-learning uzmanı. |
| CrossQ | Expert pool içindeki behavioral diversity'yi artırmak üzere eklenen off-policy reinforcement-learning yöntemi. |
Değerlendirme metrikleri
Cumulative return, değerlendirme dönemi boyunca biriken toplam portföy getirisini temsil eder.
Annualized return, getiriyi yıllık ölçeğe dönüştürür. Ancak kaynağın kullandığı exact annualization convention ayrıca formülle verilmemektedir.
Annualized volatility, return variability'nin yıllıklaştırılmış ölçüsüdür.
Sharpe ratio, getiriyi total variability/risk ile ilişkilendiren risk-adjusted performance metriğidir. Kaynak kullanılan risk-free rate değerini ve exact annualization formülünü raporlamamaktadır.
Sortino ratio, total variability yerine downside variability'ye odaklanır. Kaynak target return veya minimum acceptable return parametresini ayrıca raporlamamaktadır.
Maximum Drawdown (MDD), portfolio value'nun bir peak seviyesinden sonraki trough seviyesine kadar yaşadığı en büyük düşüşü ölçer. Negatif değer mutlak büyüklük açısından küçüldükçe drawdown daha hafiftir; örneğin −%22, −%29'dan daha düşük kayıp büyüklüğüdür.
Standalone uzmanların performansı
| Market | Expert | Cumulative Return | Sharpe | Sortino | MDD | Dominance |
|---|---|---|---|---|---|---|
| Crypto | A2C | %63,00 | 1,61 | 2,44 | −%25 | 19 hafta / %34,5 |
| Crypto | DDPG | %71,26 | 1,74 | 2,73 | −%26 | 6 hafta / %10,9 |
| Crypto | PPO | %60,49 | 1,57 | 2,38 | −%27 | 3 hafta / %5,5 |
| Crypto | CrossQ | %53,66 | 1,44 | 2,24 | −%28 | 9 hafta / %16,4 |
| Crypto | TQC | %76,16 | 1,71 | 2,63 | −%29 | 18 hafta / %32,7 |
| Stock | A2C | %32,16 | 0,90 | 1,35 | −%23 | 17 hafta / %19,3 |
| Stock | DDPG | %28,89 | 0,85 | 1,26 | −%24 | 5 hafta / %5,7 |
| Stock | PPO | %33,38 | 0,96 | 1,46 | −%22 | 21 hafta / %23,9 |
| Stock | CrossQ | %38,21 | 0,95 | 1,42 | −%27 | 32 hafta / %36,4 |
| Stock | TQC | %32,09 | 0,86 | 1,28 | −%26 | 13 hafta / %14,8 |
| Forex | A2C | %4,27 | 0,88 | 1,20 | −%2,18 | 6 hafta / %6,8 |
| Forex | DDPG | %1,80 | 0,36 | 0,46 | −%2,85 | 12 hafta / %13,6 |
| Forex | PPO | %4,07 | 0,88 | 1,20 | −%2,00 | 9 hafta / %10,2 |
| Forex | CrossQ | %2,62 | 0,53 | 0,69 | −%2,68 | 18 hafta / %20,5 |
| Forex | TQC | %2,26 | 0,48 | 0,60 | −%2,18 | 43 hafta / %48,9 |
Sonuçlar expert specialization fikrini desteklemektedir: en yüksek cumulative return, en yüksek Sharpe, en düşük MDD ve en sık dominance aynı expert üzerinde toplanmamaktadır.
Kriptoda TQC en yüksek cumulative return'e (%76,16) sahipken DDPG en yüksek Sharpe ve Sortino'yu (1,74 ve 2,73), A2C ise en küçük MDD'yi (−%25) vermektedir. Hissede CrossQ en yüksek cumulative return'e (%38,21), PPO en yüksek Sharpe/Sortino'ya (0,96/1,46) ve en küçük MDD'ye (−%22) sahiptir. Forexte A2C cumulative return açısından %4,27 ile öndedir; PPO ve A2C Sharpe/Sortino açısından 0,88/1,20 değerlerinde eşittir, en küçük MDD ise PPO için −%2,00'dır.
Proposed switcher hangi uzmanları ne sıklıkla seçti?
| Expert | Crypto | Stock | Forex |
|---|---|---|---|
| A2C | %34,5 | %19,3 | %6,8 |
| TQC | %32,7 | %14,8 | %48,9 |
| CrossQ | %16,4 | %36,4 | %20,5 |
| DDPG | %10,9 | %5,7 | %13,6 |
| PPO | %5,5 | %23,9 | %10,2 |
Bu dağılım bir expert'in bütün marketlerde baskın olmadığını göstermektedir. Kripto piyasasında A2C ve TQC sık seçilirken, stock market'te CrossQ; forexte ise TQC en yüksek frequency değerine sahiptir.
Üç Piyasada Proposed RAG Seçici Hangi Sonuçları Verdi?
Kaynak Table 6'nın selection-strategy karşılaştırmasında Proposed RAG, kriptoda %71 cumulative return ve 1,73 Sharpe; hissede %34 ve 0,96; forexte %4,3 ve 0,88 elde ederek aynı tablodaki Best Fixed ve Recent-Performance Gating stratejilerinden daha yüksek cumulative return ve Sharpe göstermiştir; ancak sonuçlar piyasa başına tek run'dır ve Table 5'te bazı standalone uzmanların cumulative return değerleri Proposed RAG'dan daha yüksektir.
| Market | Yöntem | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|---|---|
| Crypto | Best Fixed | %68 | %62 | 0,32 | 1,64 | 2,54 | −%27 |
| Crypto | Recent Gating | %69 | %62 | 0,32 | 1,66 | 2,57 | −%27 |
| Crypto | Proposed RAG | %71 | %64 | 0,31 | 1,73 | 2,72 | −%26 |
| Stock | Best Fixed | %26 | %14 | 0,21 | 0,74 | 1,11 | −%26 |
| Stock | Recent Gating | %33 | %17 | 0,20 | 0,91 | 1,37 | −%24 |
| Stock | Proposed RAG | %34 | %18 | 0,19 | 0,96 | 1,45 | −%26 |
| Forex | Best Fixed | %3,2 | %1,8 | 0,026 | 0,71 | 0,92 | −%1,9 |
| Forex | Recent Gating | −%0,4 | −%0,2 | 0,029 | −0,062 | −0,08 | −%2,6 |
| Forex | Proposed RAG | %4,3 | %2,4 | 0,028 | 0,88 | 1,20 | −%2,2 |
Proposed RAG her risk metriğinde mutlak olarak en iyi değildir. Stock market'te Recent Gating'in MDD'si −%24 iken Proposed RAG −%26'dır. Forexte Best Fixed'in MDD'si −%1,9 iken Proposed RAG −%2,2'dir. Dolayısıyla kaynağın “risk-return profile” yorumu cumulative return, Sharpe, Sortino, volatility ve MDD'nin birlikte değerlendirilmesine dayanır; “her risk göstergesinde en iyi” biçiminde genişletilmemelidir.
Table 5 ile Table 6 arasındaki “Best Fixed” farkı
Kaynak Table 5'te standalone expert sonuçlarını ve Table 6'da selection strategy sonuçlarını ayrı verir. Ancak iki tablonun “en iyi sabit uzman” açısından aynı cumulative return değerine ulaşması beklenebilecek olmasına rağmen değerler eşleşmemektedir:
| Market | Table 5'te en yüksek standalone return | Table 6 Best Fixed | Table 6 Proposed RAG |
|---|---|---|---|
| Crypto | TQC: %76,16 | %68 | %71 |
| Stock | CrossQ: %38,21 | %26 | %34 |
| Forex | A2C: %4,27 | %3,2 | %4,3 |
Kaynak bu farkı farklı split, dönem, portfolio construction, initialization veya başka protokol değişkeniyle açıklamamaktadır. Bu nedenle bu tablo farkından yeni bir mekanizma çıkarılmamalıdır.
Ayrıca Section 4.3 metni “four strategies” ifadesini kullanmakta, ancak hemen ardından yalnız üç strategy tanımlanmaktadır: Best Fixed Expert, Recent-Performance Gating ve Proposed RAG. Table 6 da yalnız bu üç stratejiyi içermektedir. Dördüncü stratejinin ne olduğu kaynakta belirtilmediği için Verianla yeni bir baseline eklememektedir.
Expert-pool büyüklüğü ablasyonu
| Market | Expert Sayısı | Fixed Sharpe | RAG Sharpe | Δ Sharpe |
|---|---|---|---|---|
| Crypto | 1 | 0,81 | 0,81 | %0,0 |
| Crypto | 2 | 0,84 | 0,85 | %1,2 |
| Crypto | 3 | 0,89 | 0,98 | %10,1 |
| Crypto | 4 | 0,96 | 1,15 | %19,8 |
| Stock | 1 | 0,43 | 0,43 | %0,0 |
| Stock | 2 | 0,51 | 0,52 | %2,0 |
| Stock | 3 | 0,55 | 0,63 | %14,5 |
| Stock | 4 | 0,59 | 0,72 | %22,0 |
| Forex | 1 | 0,35 | 0,35 | %0,0 |
| Forex | 2 | 0,43 | 0,44 | %2,3 |
| Forex | 3 | 0,46 | 0,55 | %19,6 |
| Forex | 4 | 0,51 | 0,65 | %27,5 |
Bir expert olduğunda switch yapmak mümkün olmadığı için RAG ile fixed sonuç aynıdır. Üç ve dört expert'li pool'larda improvement büyümektedir. Kaynak bunu yalnız model sayısının değil complementary expertise çeşitliliğinin önemli olduğuna kanıt olarak yorumlamaktadır.
Sınırlılık: Full system beş expert içerdiği halde Table 7 yalnız 1–4 expert pool'larını raporlamaktadır. Ayrıca nested pool'a expert'lerin hangi sırayla eklendiği tabloda belirtilmemiştir. Bu nedenle “beşinci expert eklenirse improvement şu kadar olur” şeklinde extrapolation yapılamaz.
Retrieval ve LLM component ablation
| Market | Configuration | Cumulative Return | Sharpe | MDD |
|---|---|---|---|---|
| Crypto | NR — No Retrieval | %64,8 | 1,622 | −%26,7 |
| Crypto | R−LLM — No LLM | %69,1 | 1,661 | −%27,1 |
| Crypto | Full — R+L+U | %71 | 1,73 | −%26 |
| Stock | NR — No Retrieval | %33,1 | 0,911 | −%24,4 |
| Stock | R−LLM — No LLM | %25,5 | 0,735 | −%26,5 |
| Stock | Full — R+L+U | %34 | 0,96 | −%26 |
| Forex | NR — No Retrieval | %3,2 | 0,710 | −%1,9 |
| Forex | R−LLM — No LLM | −%0,2 | −0,025 | −%2,4 |
| Forex | Full — R+L+U | %4,3 | 0,88 | −%2,2 |
Retrieval kaldırıldığında full configuration'a göre cumulative return bütün marketlerde düşmektedir. LLM kaldırıldığında düşüş stock ve forex deneylerinde daha belirgindir. Örneğin forexte full model %4,3 cumulative return ve 0,88 Sharpe verirken no-LLM configuration −%0,2 ve −0,025'e düşmektedir.
Ancak full model her markette minimum MDD üretmez. Stock'ta no-retrieval MDD −%24,4 ile full modelin −%26 değerinden daha küçüktür; forexte de no-retrieval −%1,9 iken full model −%2,2'dir.
Önemli ablasyon sınırı: Source Table 8, uncertainty-aware component'ı tek başına kaldıran bir configuration içermemektedir. Dolayısıyla retrieval ve LLM reasoning katkıları hakkında deneysel çıkarım yapılabilir; uncertainty-aware decision making'in bağımsız katkısı bu ablation ile ölçülemez.
Indexing LLM sensitivity
| Indexing LLM | Success | Failure |
|---|---|---|
| Google/Gemma4-E4B | %28 | %72 |
| Google/Gemma4-31B-it | %96 | %4 |
| AliBaba/Qwen3.6-27B-it | %100 | %0 |
Bu “success” metriği yatırım getirisi değildir. Kaynak bunu indexing instructions'ı takip edip beklenen structured output formatını doğru üretme başarısı olarak tanımlar.
Inference LLM sensitivity
| Market | Inference LLM | Cum. Return | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|
| Crypto | Google/Gemma4-31B-it | %68,3 | 1,65 | 2,55 | −%27 |
| Crypto | Google/Gemma4-E4B | %63,5 | 1,57 | 2,42 | −%28 |
| Crypto | AliBaba/Qwen3.6-27B-it | %71 | 1,73 | 2,72 | −%26 |
| Stock | Google/Gemma4-31B-it | %25,1 | 0,73 | 1,09 | −%26,5 |
| Stock | Google/Gemma4-E4B | %24,5 | 0,71 | 1,06 | −%27 |
| Stock | AliBaba/Qwen3.6-27B-it | %34 | 0,96 | 1,45 | −%26 |
| Forex | Google/Gemma4-31B-it | −%0,3 | −0,05 | −0,06 | −%2,5 |
| Forex | Google/Gemma4-E4B | −%5,4 | −1,07 | −1,37 | −%5,6 |
| Forex | AliBaba/Qwen3.6-27B-it | %4,3 | 0,88 | 1,20 | −%2,2 |
Kaynakta AliBaba/Qwen3.6-27B-it üç markette de en güçlü inference result'larını üretmektedir. Özellikle forexte LLM seçimi sonuç üzerinde büyük fark oluşturmuştur. Bu bulgu retrieval mekanizmasının tek başına yeterli olmadığını, retrieved evidence'in downstream reasoning model tarafından nasıl işlendiğinin de önemli olduğunu göstermektedir.
State-of-the-art yöntemlerle karşılaştırma
| Market | Yöntem | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | MDD |
|---|---|---|---|---|---|---|
| Crypto | TAC | %24 | %21,6 | 0,94 | 1,29 | −%31 |
| Crypto | AlphaMixRL | %22 | %19,8 | 1,00 | 1,38 | −%29 |
| Crypto | LLM-MAS | %33 | %30 | 0,96 | 1,50 | −%28 |
| Crypto | Proposed | %71 | %64 | 0,31 | 1,73 | −%26 |
| Stock | TAC | %10,4 | %5,6 | 0,25 | 0,74 | −%28 |
| Stock | AlphaMixRL | %11,8 | %6,3 | 0,31 | 0,82 | −%27 |
| Stock | Multi-LLM Black–Litterman | %31 | %16,4 | 0,28 | 0,91 | −%29 |
| Stock | Proposed | %34 | %18 | 0,19 | 0,96 | −%26 |
| Forex | TAC | %0,7 | %0,4 | 0,45 | 0,61 | −%5,1 |
| Forex | AlphaMixRL | %0,8 | %0,45 | 0,50 | 0,68 | −%4,6 |
| Forex | Fine-tuned LLaMA | %3,3 | %1,9 | 0,08 | 0,76 | −%3,1 |
| Forex | Proposed | %4,3 | %2,4 | 0,03 | 0,88 | −%2,2 |
Kaynak Table 11 içinde Proposed framework üç markette de en yüksek cumulative return ve Sharpe değerini vermektedir. Ancak yazarlar sonuç bölümünde competing implementations'ın her zaman tamamen aynı experimental protocol altında çalıştırılmadığını açıkça belirtmektedir. Bu nedenle Table 11 kontrollü bir benchmark karşılaştırması olarak değerlendirilirken protokol eşitliği konusunda ihtiyat gerekir.
Çalışmanın desteklediği sonuçlar
- İncelenen expert pool içinde uzmanların göreli üstünlüğü market ve metriklere göre değişmiştir.
- Table 6 kapsamında retrieval-based Proposed RAG üç markette de Best Fixed ve Recent Gating'den daha yüksek cumulative return ve Sharpe vermiştir.
- Retrieval'ın kaldırılması üç markette de full configuration'a göre cumulative return'ü azaltmıştır.
- LLM reasoning'in kaldırılması özellikle stock ve forex deneylerinde önemli performans düşüşüyle ilişkilidir.
- Expert-pool ablation, complementary expert sayısı arttıkça raporlanan Sharpe improvement'ın 1–4 expert aralığında büyüdüğünü göstermiştir.
- Inference LLM seçimi sonuçları belirgin biçimde değiştirmiş ve Qwen3.6-27B-it test edilen üç model içinde en güçlü sonuçları üretmiştir.
- Kaynağın matematiksel teoremi, Axiom 1–3 altında uygun specialist eklenmesinin expected utility'yi azaltmamasını garanti eder.
Çalışmanın desteklemediği genellemeler
- Önerilen yöntemin gerçek parayla canlı piyasada aynı getiriyi sağlayacağı kanıtlanmamıştır.
- %71, %34 ve %4,3 cumulative return değerleri gelecekteki yatırım getirisi garantisi değildir.
- LLM tek başına başarılı trader olarak doğrulanmamıştır; çalışmada LLM expert-routing rolündedir.
- Monotoniklik teoremi, Axiom 1–3 sağlanmadan expert eklemenin performansı düşüremeyeceğini söylemez.
- Table 6 sonuçları Proposed RAG'ın bütün standalone expert'lerden daha yüksek cumulative return sağladığını kanıtlamaz.
- Tek experimental run istatistiksel güven aralığı veya random-seed robustness kanıtı değildir.
- Component ablation uncertainty-aware mekanizmanın bağımsız katkısını ölçmemiştir.
- Üç marketteki sonuçlar bütün piyasalara, bütün dönemlere veya farklı transaction-cost ortamlarına otomatik olarak genellenemez.
- Geçmişte benzer latent state bulunması gelecekte aynı piyasa dinamiklerinin tekrar edeceğini garanti etmez.
Kaynakta eksik veya yeniden üretilebilirlik açısından belirsiz kalan bilgiler
Market-data provider: Raporlanmamaktadır.
Exact train / validation / test calendar split: Chronological retrieval ve \(\tau<t\) kısıtı verilmiştir; ancak bütün marketler için açık başlangıç-bitiş tarihli train/validation/test split tablosu verilmemiştir.
Transaction-cost değeri: SOTA karşılaştırmasının aynı transaction-cost assumptions altında yapılmaya çalışıldığı belirtilmektedir; sayısal fee/slippage değeri raporlanmamaktadır.
Portfolio constraints: Aynı constraints kullanılmaya çalışıldığı belirtilmektedir; long-only, leverage, short-selling, cash allocation veya weight bound değerleri açıkça listelenmemektedir.
RL expert training hyperparameters: A2C, DDPG, PPO, TQC ve CrossQ isimleri ve yöntem sınıfları verilmektedir; her modelin learning rate, batch size, optimizer, network depth, reward function ve diğer training ayarları bu PDF'de eksiksiz reproducibility table biçiminde sunulmamaktadır.
Weighted uncertainty: Algorithm 2 içinde \(\sigma_t^{(e)}\) hesaplandığı belirtilmekte; formülü verilmemektedir.
Teorem parametreleri: \(\epsilon\), \(\tau\) ve \(\delta\) teorik koşullar olarak tanımlanmıştır; deneylerde kullanılan sayısal değerleri verilmemektedir.
Prompt validation set: Beş prompt iteration raporlanmıştır; validation sample size ve tam dönem dağılımı belirtilmemektedir.
Expert-pool ablation: Beş uzmanlı full pool'a rağmen Table 7 yalnız 1–4 expert sonuçlarını verir ve expert'lerin nested pool'a hangi sırayla eklendiğini açıklamaz.
Statistical significance: Çoklu random seed, confidence interval, p-value veya formal hypothesis test raporlanmamıştır.
Public code repository: Yüklenen PDF'de doğrulanmış bir public code repository bağlantısı verilmemektedir.
Çalışmanın güçlü yönleri
Çalışmanın güçlü yanı, expert routing kararını yalnız son birkaç günlük performance'a bağlamak yerine tarihsel olarak benzer market states üzerinde gerçekleşmiş expert behavior ile temellendirmesidir. Bu yaklaşım retrieval sistemini yalnız bilgi getiren bir yardımcı olmaktan çıkarıp portfolio expert selection mekanizmasının ana parçasına dönüştürmektedir.
İkinci önemli güçlü yön, LLM'nin görevini sınırlandırmasıdır. LLM doğrudan portfolio weights üretmemekte; retrieved evidence'i yorumlayan coordination/routing layer olarak kullanılmaktadır. Bu ayrım LLM'nin numerical trading policy yerine contextual reasoning rolünde değerlendirilmesini sağlar.
Üçüncü güçlü yön, üç farklı financial market class üzerinde aynı \(L=22\), \(H=5\), \(K=3\) retrieval protokolünün uygulanması ve expert heterogeneity, pool size, retrieval, LLM choice ve indexing quality için farklı ablation/sensitivity analizlerinin yapılmasıdır.
Temel sınırlılıklar
En önemli sınırlılık her market için yalnız tek experimental run gerçekleştirilmesidir. Dolayısıyla random initialization veya stochastic training etkilerinin sonuç dağılımı bilinmemektedir.
İkinci sınırlılık, competing SOTA methods'ın her durumda tamamen aynı experimental protocol altında uygulanamamasıdır. Bu durum Table 11'in doğrudan yöntem üstünlüğü iddiasını ihtiyatla yorumlamayı gerektirir.
Üçüncü sınırlılık, exact transaction-cost, portfolio constraints, data provider ve önemli RL training hyperparameters gibi reproduction açısından gerekli bazı ayrıntıların kaynakta açık olmamasıdır.
Dördüncü sınırlılık, retrieval ve LLM components için ablation bulunmasına rağmen uncertainty-aware mechanism'ın tek başına kaldırıldığı bir ablation bulunmamasıdır.
Beşinci sınırlılık, historical similarity'nin gelecekte de aynı expert suitability ilişkisini koruyacağı varsayımının piyasa yapısındaki tamamen yeni structural breaks altında başarısız olabilmesidir. Kaynak yaklaşımı empirical historical grounding kullanarak bu riski azaltmaya çalışsa da unseen regime problemi tamamen ortadan kaldırılmış değildir.
Kaynak ve Yöntem Notu
Özgün başlık: Regime-Aware Portfolio Management via Retrieval-Augmented LLM-Guided Expert Switching
Yazarlar: Ahmad Asadi; Reza Safabakhsh.
Yazar sırası: Kaynaktaki sıra korunmuştur.
Kurum: Deep Learning Lab, Computer Engineering Department, Amirkabir University of Technology, Hafez Avenue, Tehran, Iran.
Yüklenen kaynak: arXiv:2608.28252v1 [cs.AI].
arXiv gönderim tarihi: 28 Ağustos 2026.
PDF üzerinde görünen tarih: 31 Ağustos 2026.
Kaynak türü: Preprint.
Hakemlik durumu: Yüklenen arXiv v1 hakemli dergi Version of Record değildir. 21 Kasım 2026 itibarıyla doğrulanabilen güncel bibliyografik kayıtlarda hakemli bir journal version tespit edilmemiştir.
Daha yeni bibliyografik sürüm: Aynı başlıklı 47 sayfalık SSRN sürümü 23 Ekim 2026'da yayımlanmıştır. SSRN suggested citation DOI'si 10.2139/ssrn.7661576'dır. Verianla'nın bilimsel içeriği yüklenen arXiv v1 üzerinden hazırlanmıştır; sonraki SSRN sürümünün yeni bilimsel içeriği bu makaleye karıştırılmamıştır.
Corresponding / contact author: Yüklenen arXiv PDF'de corresponding-author işareti açıkça verilmemektedir. Daha sonraki SSRN bibliyografik kaydı Reza Safabakhsh'ı Contact Author olarak göstermektedir.
Eş katkı: Yüklenen kaynakta equal contribution beyanı görülmemektedir.
Kaynak lisansı: Yüklenen arXiv v1 üzerinde Verianla'nın kaynak şekilleri doğrudan yeniden kullanmasına izin verdiğini kesinleştiren açık Creative Commons lisansı doğrulanmamıştır. Bu nedenle kaynak figürler birebir kullanılmamış, bilimsel ilişkiler bağımsız şema olarak yeniden kurulmuştur.
Finansman: Yüklenen PDF'de ayrı bir funding declaration tespit edilmemiştir.
Çıkar çatışması: Yüklenen PDF'de ayrı bir conflict-of-interest / competing-interest declaration tespit edilmemiştir.
Veri erişilebilirliği: Yüklenen PDF'de ayrı bir Data Availability bölümü veya doğrulanmış public dataset repository bağlantısı bulunmamaktadır.
Kod erişilebilirliği: Yüklenen PDF'de doğrulanmış public source-code repository bağlantısı bulunmamaktadır.
Ana yöntem: Dual-stream Transformer-VAE market-state representation + chronological vector retrieval + Statement of Performance + instruction-tuned LLM guided expert switching + reinforcement-learning expert pool.
Expert pool: A2C, DDPG, PPO, TQC ve CrossQ.
Marketler: Cryptocurrency, stock ve foreign exchange; her markette 30 symbol.
Veri frekansı: Daily OHLCV.
Input window: \(L=22\) trading day.
Forward / holding horizon: \(H=5\) day.
Retrieval: \(K=3\) nearest historical state, cosine similarity.
Embedding dimension: \(d=64\).
LLM temperature: 0,1.
LLM çağrı sınırı: Decision step başına en fazla bir çağrı.
Leakage kontrolü: Test sırasında retrieval yalnız \(\tau<t\) historical observations ile sınırlandırılmıştır.
Donanım: Tek NVIDIA H100 GPU.
Deney tekrarı: Her market için tek run; sonuçlar repeated-seed averages değildir.
İstatistiksel sınır: Confidence interval, formal significance test ve çoklu random-seed dağılımı raporlanmamaktadır.
Teorik sonuç: Monotonic Expert-Pool Performance sonucu yalnız bounded estimation error, conservative switching ve specialist dominance assumptions altında geçerlidir; gerçek piyasa getirisi için koşulsuz garanti değildir.
Kaynak-içi önemli raporlama farkı: Table 5 standalone expert cumulative return değerleri ile Table 6 “Best Fixed” değerleri eşleşmemektedir ve kaynak farkın nedenini açıklamamaktadır. Ayrıca Section 4.3 dört strategy karşılaştırdığını söylerken yalnız üç strategy tanımlar.
Yeniden üretilebilirlik açıkları: Exact market-data provider, calendar-based train/validation/test split, transaction-cost değeri, portfolio constraints, birçok RL training hyperparameter, weighted-uncertainty formülü, sayısal \(\epsilon/\tau/\delta\) değerleri ve prompt-validation-set büyüklüğü raporlanmamaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir