


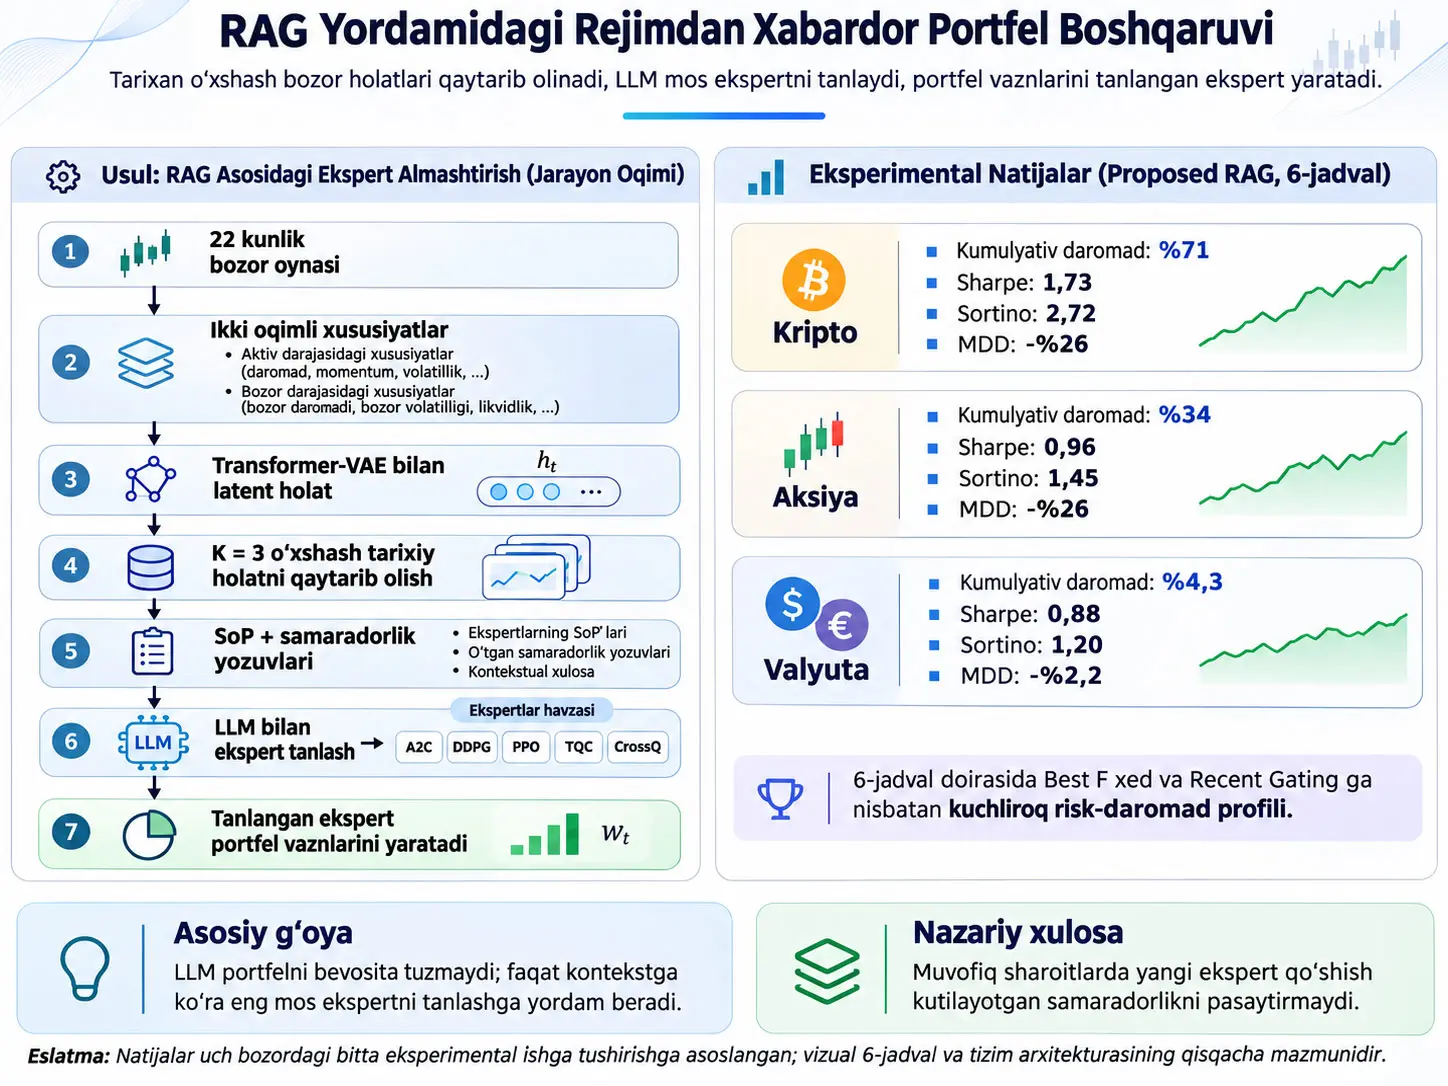
Retrieval-augmented LLM-guided expert switching — joriy bozor holatini tarixan o‘xshash bozor holatlari bilan moslashtirib, bu davrlarda turli portfel ekspertlari qanday natija ko‘rsatganini tahlil qiladigan va katta til modelidan portfel vaznlarini bevosita yaratish o‘rniga qaysi ekspert siyosatidan foydalanishni tanlashda foydalanadigan adaptiv portfel-yo‘naltirish yondashuvidir. Tadqiqot bozor sharoitlari vaqt davomida o‘zgarib turadigan non-stationary moliyaviy muhitlarda bitta portfel modeli har bir rejimda eng yaxshi ishlamasligi mumkinligi muammosiga qaratilgan.
Usulda bozor holati ikki alohida maʼlumot oqimi bilan ifodalanadi. Birinchi oqim aktiv darajasidagi log-return, RSI, MACD, ATR, realized volatility va volume-change xususiyatlarini; ikkinchi oqim esa bozor miqyosidagi trend, volatility-regime va liquidity ko‘rsatkichlarini olib boradi. Ikki oqim alohida Transformer-VAE encoderʼlari orqali latent representationʼga aylantiriladi va yagona \(h_t\) state vector ichida birlashtiriladi. Tarixiy stateʼlar vector database ichida saqlanadi; har bir state uchun A2C, DDPG, PPO, TQC va CrossQ ekspertlarining keyingi besh kunlik natijalari hamda Statement of Performance (SoP) yozuvlari saqlanadi.
Online qaror bosqichida joriy 22 trading-day bozor oynasi shu latent makonga kodlanadi va cosine similarity orqali eng yaqin \(K=3\) tarixiy holat qaytarib olinadi. Ushbu tarixiy holatlarda ekspertlarning real natijalari, SoP yozuvlari va joriy bozor konteksti LLMʼga taqdim etiladi. LLM portfel vaznlarini o‘zi yaratmaydi; qaysi ekspert siyosatini faollashtirish haqida kontekstual baholash qiladi. Tanlangan reinforcement-learning eksperti keyin portfel vaznlarini hosil qiladi.
Tadqiqotning Table 6 selection-strategy taqqoslashida Proposed RAG kriptovalyuta bozorida %71 cumulative return va 1,73 Sharpe, aksiyalar bozorida %34 cumulative return va 0,96 Sharpe, valyuta bozorida esa %4,3 cumulative return va 0,88 Sharpe natijasini olgan. Shu jadvalda Best Fixed Expert uchun qiymatlar mos ravishda %68/1,64, %26/0,74 va %3,2/0,71. Biroq har bir bozor faqat bitta eksperimental run bilan baholangan, ko‘p random seed o‘rtachalari yoki statistik ahamiyat testlari xabar qilinmagan.
Natijalarni talqin qilishda muhim manba-ichki farq bor. Table 5ʼda alohida ishga tushirilgan ekspertlarning eng yuqori cumulative return qiymatlari kripto bozorida TQC uchun %76,16, aksiyalar bozorida CrossQ uchun %38,21 va forexda A2C uchun %4,27; bu qiymatlar Table 6ʼdagi “Best Fixed” qiymatlaridan farq qiladi. Manba nega bu ikki jadval turli “fixed expert” natijalarini berganini tushuntirmaydi. Shu sababli tadqiqot Proposed RAG Table 6 ichidagi tanlov strategiyalaridan yaxshiroq natija berganini qo‘llab-quvvatlaydi; taklif qilingan tizim har qanday sharoitda barcha standalone ekspertlardan yuqori daromad beradi degan xulosani qo‘llab-quvvatlamaydi.
Tadqiqotning asosiy muammosi
Moliyaviy bozorlar statsionar tizimlar emas. Volatillik darajasi, likvidlik, cross-asset relationships, trend tuzilmasi va bozor ishtirokchilarining xatti-harakati vaqt davomida o‘zgarishi mumkin. Shu sababli maʼlum davrda muvaffaqiyatli bo‘lgan portfel siyosati boshqa market regime ichida ayni muvaffaqiyatni ko‘rsatmasligi mumkin.
Bitta deep-learning yoki deep-reinforcement-learning modelini barcha bozor sharoitlariga moslashtirishga urinish model sig‘imini oshirishi mumkin; biroq model trening vaqtida ko‘rgan regularitiesʼga haddan tashqari moslashishi mumkin. Mixture-of-Experts yondashuvi turli ekspert modellardan foydalanib bu muammoni kamaytirishga urinadi, ammo klassik MoE tuzilmalarida qaysi ekspert faollashtirilishini belgilaydigan learned gating network ham avval ko‘rilmagan rejimlarda noto‘g‘ri tanlov qilishi mumkin.
Tadqiqot taklif qilgan muqobil yondashuv “so‘nggi bir necha kunda qaysi model muvaffaqiyatliroq edi?” savoli o‘rniga “joriy bozor holatiga tarixan o‘xshash davrlarda qaysi ekspert muvaffaqiyatliroq bo‘lgan edi?” savolini qo‘yadi.
Retrieval-Augmented LLM-Guided Expert Switching Nima?
Retrieval-augmented LLM-guided expert switching joriy bozor holatiga o‘xshash tarixiy holatlarni latent vector database ichidan qaytarib, bu holatlarda ekspert modellarning amalga oshgan risk-daromad natijalarini LLM qo‘llab-quvvatlaydigan yo‘naltirish mexanizmiga taqdim etish orqali foydalaniladigan portfel ekspertini tanlaydigan, ammo portfel vaznlarini bevosita LLMʼga yaratmaydigan expert-routing usulidir.
Tizim ikki alohida bosqichdan iborat
Offline indexing bosqichi tarixiy bozor holatlarini oldindan qayta ishlaydi. Har bir historical window dual-stream Transformer-VAE orqali latent stateʼga aylantiriladi. Keyin barcha ekspertlar bir xil tarixiy holatdan boshlab doimiy forward horizon davomida baholanadi. Olingan performance records va Statement of Performance yozuvlari latent representation bilan birga vector databaseʼga joylanadi.
Online inference bosqichi joriy bozor holatini shu latent makonga aylantiradi, o‘tmishdagi eng o‘xshash \(K=3\) stateʼni qaytarib oladi, tegishli expert-performance yozuvlarini to‘playdi va LLMʼdan expert-selection uchun foydalanadi. LLM vazifasi portfolio allocation yaratish emas, retrieved evidenceʼni talqin qilib mos expertʼni aniqlashdir.
Statement of Performance (SoP) nima?
Statement of Performance har bir historical market episode uchun tegishli ekspertning xatti-harakati va real natijasini kontekstual tarzda umumlashtiradigan yozuvdir. Manbada offline performance record cumulative return, Sharpe ratio va maximum drawdown maʼlumotlarini o‘z ichiga oladi. SoP esa o‘sha davrning market contextʼi, expert behaviorʼi va tegishli uncertainty factors maʼlumotini umumlashtirib, LLM faqat raqamli skor emas, kontekstlashtirilgan tarixiy dalilni ko‘rishini taʼminlaydi.
LLM Ushbu Tizimda Portfel Vaznlarini Bevosita Yaratadimi?
Yo‘q. Tadqiqotdagi instruction-tuned LLM qaytarib olingan tarixiy market-state yozuvlari va ekspertlarning risk-daromad xatti-harakatini talqin qilib, qaysi expert tanlanishini belgilaydigan yo‘naltirish qatlamiga hissa qo‘shadi; haqiqiy portfolio weight vector tanlangan A2C, DDPG, PPO, TQC yoki CrossQ eksperti tomonidan yaratiladi.
Nega LLM bevosita trader sifatida ishlatilmaydi?
Tadqiqotning adabiyot tahlili LLM asosidagi trading agentʼlar uzoq muddatli benchmarklarda har doim buy-and-hold yoki miqdoriy usullardan ustun emasligini taʼkidlaydi. Shu sababli LLM vazifasi toraytirilgan. Model bevosita oldi-sotdi miqdorini hisoblash o‘rniga tarixiy kontekstni talqin qilish, retrieved episodes orasidagi munosabatlarni baholash va expert routing vazifasida ishlatiladi.
LLM baholashi nega cheklangan?
Dastlabki prompt versiyalarida LLM retrieved historical records ichida mavjud bo‘lmagan return qiymatlariga extrapolation qilgani va haddan tashqari ishonchli javoblar yaratgani kuzatilgan. Manba besh prompt iteration validation set ustida baholanganini va mean absolute estimation error taxminan %18ʼdan %11ʼga kamayganini bildiradi.
Yakuniy prompt dizayni uchta asosiy cheklovni qo‘llaydi:
- Empirical grounding: Risk-daromad baholashi retrieved historical MDD, realized information ratio va boshqa real performance observations bilan cheklanadi.
- Conservative margining: Yangi candidate expert faqat incumbent expertʼga nisbatan estimated advantage uncertainty/noise marginʼdan oshgandagina tanlanadi.
- Tail-event separation: Extreme drawdown, liquidity squeeze va regime transition davrlari oddiy davrlardan alohida baholanadi.
Manba validation set nechta namunadan iboratligini, qaysi bozor davrlarini o‘z ichiga olishini va %18 → %11 qiymatlarining to‘liq taqsimotini xabar qilmaydi.
Monotonik Ekspert-Pool Teoremasi Nimani Aytadi?
Manbaning monotonlik natijasi yangi ekspert qo‘shish shartsiz ravishda natijani oshirishini aytmaydi; faqat estimation error \(\epsilon\) bilan cheklangan, switch threshold \(\tau\ge2\epsilon\) bo‘lgan va yangi ekspertning maqsad hududidagi haqiqiy utility advantageʼi \(\delta>\tau+2\epsilon\) shartini qanoatlantirgan farazlar ostida expert poolʼga yangi specialist qo‘shilishi kutiladigan utilityʼni kamaytirmasligini ko‘rsatadi.
Tenglama 1: Switching policyʼning kutiladigan qiymati
\[ V(\pi_N) = \int_{\mathcal{S}} U_{\pi_N(s)}(s)\,d\mathbb{P}(s). \tag{1} \]
Nimani hisoblaydi? \(N\) ekspertli switching policyʼning butun market-state makoni bo‘yicha expected risk-adjusted utility qiymatini hisoblaydi.
- \(\mathcal{S}\): mumkin bo‘lgan latent market state makoni.
- \(\mathbb{P}\): state makoni ustidagi ehtimollik o‘lchovi.
- \(\pi_N(s)\): state \(s\) uchun tanlangan expert indeksi.
- \(U_i(s)\): expert \(i\)ning state \(s\) ichidagi amalga oshgan haqiqiy risk-adjusted utilityʼsi.
\(U_i(s)\)ning aniq fizik birligi manbada belgilanmagan. Nazariy modelda u utility shkalasidagi kattalik bo‘lib, decision timeʼda bevosita maʼlum emas.
Tenglama 2: LLM qo‘llab-quvvatlagan expert assessment
\[ \rho_i(s) = \mathcal{M} \left( \mathcal{H}_t(s),E_i \right). \tag{2} \]
\(\mathcal{H}_t(s)\) current state \(s\)ga o‘xshash retrieved historical episodes to‘plami; \(E_i\) tegishli expert; \(\mathcal{M}\) retrieved evidence ustida ishlaydigan baholash mexanizmi, \(\rho_i(s)\) esa switching procedure ichida ishlatiladigan estimated assessment qiymatini bildiradi.
Muhim farq: \(\rho_i(s)\) nomaʼlum haqiqiy \(U_i(s)\)ning bevosita kuzatuvi emas. Historical performance records raqamli asosni beradi; LLM retrieved contextʼni talqin qilib assessment calibrationʼga hissa qo‘shadi.
Tenglama 3: Axiom 1 — bounded estimation error
\[ \sup_{s\in\mathcal{S}} \left| \rho_i(s)-U_i(s) \right| \le \epsilon, \qquad \forall i\in\{1,\ldots,N+1\}. \tag{3} \]
Ushbu shart estimated assessment bilan haqiqiy utility orasidagi eng katta xato \(\epsilon\) qiymatidan oshmasligini faraz qiladi. \(\epsilon\), \(\rho\) va \(U\) bilan bir xil utility/assessment shkalasida.
Bu butun state makoni uchun eksperimental ravishda isbotlangan xususiyat emas. Manbaning practical implementationʼi LLMʼni retrieved empirical observations tashqarisiga extrapolation qilmaslikka majburlash orqali ushbu aksiomga yaqinlashishga urinadi.
Tenglama 4: Eng yuqori estimated utilityʼga ega expert
\[ e^*(s) = \arg\max_{i\in\{1,\ldots,N\}} \rho_i(s). \tag{4} \]
Ushbu ifoda state \(s\) uchun mavjud expert pool ichida eng yuqori estimated assessment qiymatiga ega expert indeksini tanlaydi.
Tenglama 5: Conservative switching
\[ \pi_N(s) = \begin{cases} e^*(s), & \rho_{e^*(s)}(s) - \rho_{\pi_N(s)}(s) > \tau, \\ \pi_N(s), & \text{aksi durumda}. \end{cases} \tag{5} \]
va:
\[ \tau\ge2\epsilon. \]
Candidate expertʼning incumbent expertʼga nisbatan estimated advantageʼi \(\tau\) qiymatidan katta bo‘lmasa, mavjud expert saqlanadi. Maqsad estimation noise sabab keraksiz switchingʼni kamaytirishdir.
Tenglama 6: Axiom 3 — specialist dominance
\[ U_{N+1}(s) \ge U_{\pi_N(s)}(s) + \delta, \qquad s\in\mathcal{S}_R, \tag{6} \]
va:
\[ \delta > \tau+2\epsilon. \]
\(\mathcal{S}_R\) yangi specialist expert yo‘naltirilgan market-state subset bo‘lib, manba \(P(\mathcal{S}_R)>0\) deb faraz qiladi. Yangi ekspert ushbu hududda incumbent policyʼdan kamida \(\delta\) miqdorida yuqori haqiqiy utilityʼga ega bo‘lishi kerak.
Manba ichidagi ifoda izohi: Axiom 3ʼdan darhol keyin manba specialist region tashqarisida yangi expert utilityʼsi “unlimited” deb faraz qilinishini yozadi. Ushbu so‘z matematik jihatdan “unrestricted/unconstrained” maʼnosida ishlatilganmi, alohida belgilanmagan. Verianla bu ifodani sukut bilan boshqa farazga almashtirmaydi.
Tenglama 7–9: Noto‘g‘ri switching nega utilityʼni kamaytirmasligi kutiladi?
\[ U_{N+1}(s) \ge \rho_{N+1}(s)-\epsilon. \tag{7} \]
\[ U_{\pi_N(s)}(s) \le \rho_{\pi_N(s)}(s)+\epsilon. \tag{8} \]
Ikki tengsizlik birlashtirilganda:
\[ U_{N+1}(s) - U_{\pi_N(s)}(s) > \tau-2\epsilon. \tag{9} \]
\(\tau\ge2\epsilon\) bo‘lgani uchun o‘ng tomon manfiy emas. Shunday qilib, ko‘rsatilgan error bound haqiqatan amal qilsa, switching thresholdʼdan oshgan o‘zgarish haqiqiy utilityʼni kamaytirmasligi kutiladi.
Tenglama 10–11: Maqsad specialist hududidagi qatʼiy yaxshilanish
\[ \rho_{N+1}(s) - \rho_{\pi_N(s)}(s) \ge \delta-2\epsilon. \tag{10} \]
\(\delta>\tau+2\epsilon\) bo‘lgani uchun:
\[ \delta-2\epsilon>\tau. \]
Shunday qilib, specialist maqsad region ichida switching criterionʼni bajaradi. Kutiladigan utilityʼga minimal contribution:
\[ \Delta V \ge \int_{\mathcal{S}_R} \delta\,d\mathbb{P}(s) = \delta \mathbb{P}(\mathcal{S}_R) > 0. \tag{11} \]
bo‘ladi.
Keyin manba specialistʼlar ketma-ket qo‘shilganda:
\[ V(\pi_1) \le V(\pi_2) \le \cdots \le V(\pi_K) \]
ko‘rinishidagi non-decreasing policy-value sequence olinishi va uning:
\[ V^* = \int_{\mathcal{S}} \sup_E U_E(s) \,d\mathbb{P}(s) \]
bilan aniqlanadigan best-achievable utility tomonidan yuqoridan chegaralanishini bildiradi.
Teoremaning to‘g‘ri talqini: Bu natija “ekspertlar sonini oshirsak, haqiqiy portfel daromadi har doim oshadi” degani emas. Natija Axiom 1–3 haqiqatan bajarilgandagina matematik jihatdan amal qiladi. Practical prompt qoidalari esa manbaning o‘z ifodasiga ko‘ra ushbu aksiomlarning isboti emas, LLM xatti-harakatini aksiomlarga ko‘proq moslashtirishga qaratilgan implementation heuristicsdir.
Bozor holati qaysi xususiyatlar bilan ifodalanadi?
Har bir qaror vaqtida ikkita rolling-window tensor yaratiladi.
Asset-level texnik tensor:
\[ S_t^{tech} \in \mathbb{R}^{L\times A\times F_1}. \]
Bu yerda \(L\) rolling-window uzunligi, \(A\) portfeldagi aktivlar soni va \(F_1\) asset-level feature sonidir. Tajribalarda \(L=22\) trading day va \(A=30\) ishlatiladi.
Aktiv darajasidagi xususiyatlar toʻplami:
- Log-return: Ketma-ket narxlarning logarithmic o‘zgarishini ifodalaydi.
- RSI: Relative Strength Index; narx harakatlarining nisbiy momentum tuzilmasini umumlashtiruvchi texnik ko‘rsatkich.
- MACD: Moving Average Convergence Divergence; turli vaqt miqyoslaridagi harakatlanuvchi o‘rtachalar munosabatidan foydalanib trend/momentum tuzilmasini ifodalaydi.
- ATR: Average True Range; narx harakatlarining diapazonga asoslangan volatillik kattaligini ifodalaydi.
- Realized volatility: kuzatilgan narx harakatlaridan hosil qilingan o‘zgaruvchanlik maʼlumoti.
- Volume changes: savdo hajmi o‘zgarishlari.
Bozor miqyosidagi tensor:
\[ S_t^{mkt} \in \mathbb{R}^{L\times F_2}. \]
Ushbu stream aggregate trend indicators, volatility-regime measures va liquidity variablesni o‘z ichiga oladi. Manba umumiy nazariy izohda macroeconomic conditions tushunchasini tilga olsa-da, amalda qaysi tashqi macroeconomic series ishlatilganini sanab o‘tmaydi; shu sababli Verianla tashqi foiz, inflyatsiya yoki shunga o‘xshash maʼlumotlar to‘plamlarini qo‘shmaydi.
Barcha features rolling z-score normalization bilan standartlashtiriladi. Manba bu o‘zgaruvchi masshtablar taʼsirini kamaytirish va heteroskedasticityʼning state representationga taʼsirini cheklashga qaratilganini bildiradi.
Tenglama 12: Transformer-VAE posterior taqsimoti
\[ q_{\phi_x} \left( z_x\mid S_t^x \right) = \mathcal{N} \left( \mu_x(S_t^x), \Sigma_x(S_t^x) \right), \qquad x\in\{tech,mkt\}. \tag{12} \]
Har bir feature stream o‘z Transformer encoderʼi tomonidan Gaussian posteriorʼga xaritalanadi. \(\mu_x\) posterior mean, \(\Sigma_x\) diagonal covariance va \(z_x\) latent representationdir.
Ushbu o‘zgaruvchilarning fizik birligi yo‘q; ular standartlashtirilgan kirishlardan o‘rganilgan latent-space kattaliklardir.
Tenglama 13: Reparameterization
\[ z_x = \mu_x + \varepsilon\odot\sigma_x, \qquad \varepsilon \sim \mathcal{N}(0,I). \tag{13} \]
\(\odot\) element-wise multiplicationdir. \(\sigma_x\) posterior standard deviation vectoridir. Reparameterization stochastic latent sampling vaqtida gradient-based trainingni davom ettirish imkonini beradi.
Pretraining vaqtida sampled latent representation decoder tomonidan input reconstruction uchun ishlatiladi. Pretraining tugagach decoder olib tashlanadi va encoder market-state representation uchun saqlanadi.
Tenglama 14: Ikki latent streamni birlashtirish
\[ h_t = \left[ z_t^{tech} \mid z_t^{mkt} \right] \in \mathbb{R}^{D}. \tag{14} \]
\(h_t\) asset-specific va market-wide latent vectors concatenation natijasidir. Historical indexing va online query bosqichlarida bir xil representation function ishlatilgani uchun current state va historical state bir xil latent makonda taqqoslanadi.
Tajriba bo‘limida retrieval embedding dimension:
\[ d=64 \]
deb ko‘rsatiladi. Manba \(D\) bilan ushbu implementationdagi \(d\) belgisi orasidagi notatsiya munosabatini alohida batafsil bayon qilmaydi.
Tenglama 15: Historical index yozuvi
\[ D_{\tau} = \left( h_{\tau}, R_{\tau}^{(e)}, SoP_{\tau}^{(e)} \right), \qquad e\in\{1,\ldots,E\}. \tag{15} \]
Har bir tarixiy state yozuvi uchta maʼlumot guruhini birlashtiradi:
- \(h_{\tau}\): historical latent market state,
- \(R_{\tau}^{(e)}\): expert \(e\)ning forward horizon bo‘yicha amalga oshgan performance recordi,
- \(SoP_{\tau}^{(e)}\): xuddi shu sharoitdagi Statement of Performance.
Tenglama 16: Eng yaqin tarixiy stateʼlarni tanlash
\[ \mathcal{N}_t = KNN \left( h_t, \{h_{\tau}\}, K \right). \tag{16} \]
Tajribalarda \(K=3\) ishlatiladi. Similarity metric cosine similaritydir. Test vaqtida faqat:
\[ \tau<t \]
shartini qanoatlantiruvchi historical observations retrieval uchun ishlatiladi. Ushbu chronological restriction future informationning qaror jarayoniga sizib kirishini oldini olishga qaratilgan.
Tenglama 17: Retrieval weight
\[ w_{\tau} = \frac{ sim(h_t,h_{\tau}) }{ \sum_{j\in\mathcal{N}_t} sim(h_t,h_j) }. \tag{17} \]
\(sim(h_t,h_{\tau})\) current state va historical state orasidagi cosine similarity qiymatidir. \(w_{\tau}\) o‘lchovsiz normalized retrieval weightdir.
Matematik aniqlik chegarasi: Cosine similarity nazariy jihatdan manfiy ham bo‘lishi mumkin. Manba Eq. 17 oldidan similarity qiymatlari musbat oraliqqa kesiladimi, softmax qo‘llanadimi yoki umumiy similarity nol bo‘lganda holat qanday boshqarilishini tushuntirmaydi. Shu sababli \(w_{\tau}\) har qanday sharoitda klassik convex weight deb faraz qilish xavfsiz emas.
Tenglama 18: Similarity-weighted expert performance
\[ \widehat{R}_t^{(e)} = \sum_{\tau\in\mathcal{N}_t} w_{\tau} R_{\tau}^{(e)}. \tag{18} \]
Bu tenglama retrieved historical episodes ichidagi expert \(e\) natijasini similarity vaznlari bilan birlashtiradi. \(\widehat{R}_t^{(e)}\), \(R_{\tau}^{(e)}\) qaysi performance shkalasida aniqlangan bo‘lsa, shu shkalani saqlaydi.
Manba ichidagi belgilash chegarasi: Offline izohda performance record ichida cumulative return, Sharpe ratio va MDD mavjudligi aytiladi; Eq. 18 esa \(R_{\tau}^{(e)}\)ni bitta matematik kattalik kabi yozadi. Ushbu metriklar scalar composite scoreʼga qanday aylantirilgani yoki Eq. 18 har bir metrik uchun component-wise qo‘llanganmi, manbada aniq belgilanmagan.
Algoritm 1: Oflayn Rejim Indekslash va Ekspert Natijalarini Asoslash
- Har bir historical time step \(\tau\) uchun asset-level va market-wide feature tensors yaratiladi.
- Dual-stream T-VAE bilan \(h_{\tau}\) latent embedding hisoblanadi.
- Har bir expert \(E^{(e)}\) historical stateʼdan boshlanadi.
- Expertning forward horizon \(H\) bo‘yicha real natijasi hisoblanadi.
- Xuddi shu episode uchun Statement of Performance yaratiladi.
- \((h_{\tau},R_{\tau}^{(e)},SoP_{\tau}^{(e)})\) yozuvi historical indexʼga yoziladi.
Algoritm 2: Onlayn Retrieval va Portfel Qarorini Qabul Qilish
- Current market dataʼdan \(S_t^{tech}\) va \(S_t^{mkt}\) yaratiladi.
- Dual-stream T-VAE bilan \(h_t\) hisoblanadi.
- Vector databaseʼdan \(K=3\) nearest historical regimes olinadi.
- Har bir expert uchun similarity-weighted performance estimate hisoblanadi.
- Algorithm 2 qo‘shimcha ravishda weighted uncertainty \(\sigma_t^{(e)}\) hisoblanishini aytadi.
- Retrieved SoPs va current market context LLMʼga beriladi.
- LLM expert selection qaroriga hissa qo‘shadi va \(e^*\) aniqlanadi.
- Tanlangan expert \(E^{(e^*)}\) portfolio weights \(w_t\)ni yaratadi.
Qayta ishlab chiqarish chegarasi: Algorithm 2ʼda keltirilgan weighted uncertainty \(\sigma_t^{(e)}\) uchun manba alohida matematik formula bermaydi. Ushbu bo‘shliq Verianla tomonidan yangi uncertainty estimator qo‘shib to‘ldirilmagan.
Tadqiqot Usuli va Natijalari
Eksperimental maʼlumot tuzilmasi
Tadqiqot uch xil moliyaviy market class bo‘yicha daily OHLCV maʼlumotidan foydalanadi:
- 30 kriptovalyuta,
- 30 aksiya,
- 30 valyuta juftligi.
OHLCV Open, High, Low, Close va Volume komponentlaridan iborat bozor maʼlumot tuzilmasidir. Tadqiqot kirishida high-frequency trading konteksti tilga olingan bo‘lsa-da, haqiqiy tajribalar intraday high-frequency data bilan emas, daily OHLCV bilan o‘tkazilgan.
| Parametr | Manba qiymati |
|---|---|
| Bozor sinfi | Kripto, Aksiya, Forex |
| Har bozordagi symbol soni | 30 |
| Kirish oynasi \(L\) | 22 savdo kuni |
| Saqlash / forward gorizonti \(H\) | 5 kun |
| Tarixiy qoʻshnilar \(K\) | 3 |
| Oʻxshashlik | Cosine similarity |
| Latent embedding oʻlchami | 64 |
| LLM harorati | 0,1 |
| LLM chaqirigʻi | Har qaror uchun ko‘pi bilan 1 |
| Future-leakage cheklovi | Retrieval faqat \(\tau<t\) |
| Uskuna | Bitta NVIDIA H100 GPU |
| Tajriba takrorlari soni | Har bozor uchun 1 run |
Kriptovalyuta paneli
30 kriptovalyuta ramzi:
ADA, APT, ARB, ATOM, AVAX, BCH, BNB, BTC, DOGE, DOT, EGLD, ETC, ETH, FIL, HBAR, ICP, LINK, LTC, MATIC, MKR, NEAR, RNDR, SHIB, SOL, TON, TRX, UNI, VET, XLM va XRP.
Symbol bo‘yicha availability period bir xil emas. Manba Table 2ʼda eng uzun qatorlardan BTC va LTC uchun 17 Sentabr 2014–31 May 2026 orasida 4.275 sample xabar qilsa, APT uchun 20 Noyabr 2021–24 Iyun 2025 orasida 1.311 sample mavjud. RNDR, MATIC, UNI va APT kabi ayrim series 2026ʼdan oldin tugaydi.
Cryptocurrency market uchun yagona standard broad-market benchmark bo‘lmagani sabab manba ikkita synthetic index yaratgan:
- teng vaznli / vaznsiz kumulyativ daromad indeksi,
- hajm bo‘yicha vaznlangan kumulyativ daromad indeksi.
Manba equal-weighted raw-price aggregation oz sonli extreme constituents tomonidan ustun boshqarilishini va shu sababli volume-weighted variant primary market-level descriptor sifatida afzal ko‘rilishini bildiradi.
Aksiyalar paneli
30 aksiya:
TMO, MCD, NVDA, DIS, TSLA, CVX, XOM, ACN, V, WMT, KO, LIN, HD, GOOGL, CRM, UNH, BAC, COST, MA, PG, AAPL, JPM, JNJ, MSFT, MRK, META, AMZN, ABBV, BRK-B va PEP.
Ko‘plab stock series 3 Yanvar 2000–29 May 2026 orasida 6.641 samplega ega, keyinroq ommaviy savdoga chiqqan kompaniyalarda esa tarix qisqaroq. Stock market-level context uchun S&P 500, NASDAQ Composite va Dow Jones Industrial Average referenslari ishlatilgan.
Valyuta paneli
30 forex juftligi:
USDCAD, EURAUD, EURCHF, GBPCHF, CHFJPY, NZDCHF, AUDCAD, NZDCAD, GBPUSD, AUDUSD, GBPAUD, USDJPY, GBPJPY, NZDJPY, AUDNZD, EURGBP, USDCHF, EURCAD, AUDJPY, GBPCAD, USDTRY, AUDCHF, EURTRY, EURSEK, GBPNZD, EURUSD, NZDUSD, EURJPY, EURNZD va CADJPY.
FX uchun manba yagona standard broad-market composite index xabar qilmaydi. Market-wide condition dual-stream encoderning aggregate market-feature kanali orqali ifodalanadi.
Maʼlumot manbasi chegarasi: PDF OHLCV qatorlari qaysi market-data provider yoki APIʼdan yuklab olinganini aniq ko‘rsatmaydi. Shu sabab Verianla Yahoo Finance, Binance, Alpha Vantage yoki boshqa provayderni taxmin qilmaydi.
Beshta reinforcement-learning eksperti
| Ekspert | Manbada berilgan asosiy rol |
|---|---|
| A2C | Advantage Actor-Critic; synchronous actor-critic policy-gradient yondashuvi. |
| DDPG | Deep Deterministic Policy Gradient; continuous action space uchun off-policy actor-critic. |
| PPO | Proximal Policy Optimization; policy update kattaligini cheklab training stability taʼminlashga qaratilgan policy-gradient usuli. |
| TQC | Truncated Quantile Critics; reward distributionni quantile critics bilan modellashtiruvchi distributional reinforcement-learning eksperti. |
| CrossQ | Ekspert pool ichidagi behavioral diversityni oshirish uchun qoʻshilgan off-policy reinforcement-learning usuli. |
Baholash metrikalari
Cumulative return baholash davri davomida yig‘ilgan jami portfel daromadini ifodalaydi.
Annualized return daromadni yillik shkalaga o‘tkazadi. Biroq manba ishlatgan exact annualization convention alohida formula bilan berilmagan.
Annualized volatility return variabilityning yilliklashtirilgan o‘lchovidir.
Sharpe ratio daromadni total variability/risk bilan bog‘laydigan risk-adjusted performance metrikasidir. Manba ishlatilgan risk-free rate qiymati va exact annualization formulasini xabar qilmaydi.
Sortino ratio total variability o‘rniga downside variabilityga eʼtibor beradi. Manba target return yoki minimum acceptable return parametrini alohida xabar qilmaydi.
Maximum Drawdown (MDD) portfolio value peak darajasidan keyingi trough darajasigacha yuz bergan eng katta pasayishni o‘lchaydi. Manfiy qiymatning mutlaq kattaligi kamaygan sari drawdown yengilroq; masalan, −%22, −%29dan kichikroq yo‘qotish kattaligidir.
Standalone ekspertlar natijasi
| Bozor | Ekspert | Cumulative Return | Sharpe | Sortino | MDD | Dominance |
|---|---|---|---|---|---|---|
| Kripto | A2C | %63,00 | 1,61 | 2,44 | −%25 | 19 hafta / %34,5 |
| Kripto | DDPG | %71,26 | 1,74 | 2,73 | −%26 | 6 hafta / %10,9 |
| Kripto | PPO | %60,49 | 1,57 | 2,38 | −%27 | 3 hafta / %5,5 |
| Kripto | CrossQ | %53,66 | 1,44 | 2,24 | −%28 | 9 hafta / %16,4 |
| Kripto | TQC | %76,16 | 1,71 | 2,63 | −%29 | 18 hafta / %32,7 |
| Aksiya | A2C | %32,16 | 0,90 | 1,35 | −%23 | 17 hafta / %19,3 |
| Aksiya | DDPG | %28,89 | 0,85 | 1,26 | −%24 | 5 hafta / %5,7 |
| Aksiya | PPO | %33,38 | 0,96 | 1,46 | −%22 | 21 hafta / %23,9 |
| Aksiya | CrossQ | %38,21 | 0,95 | 1,42 | −%27 | 32 hafta / %36,4 |
| Aksiya | TQC | %32,09 | 0,86 | 1,28 | −%26 | 13 hafta / %14,8 |
| Forex | A2C | %4,27 | 0,88 | 1,20 | −%2,18 | 6 hafta / %6,8 |
| Forex | DDPG | %1,80 | 0,36 | 0,46 | −%2,85 | 12 hafta / %13,6 |
| Forex | PPO | %4,07 | 0,88 | 1,20 | −%2,00 | 9 hafta / %10,2 |
| Forex | CrossQ | %2,62 | 0,53 | 0,69 | −%2,68 | 18 hafta / %20,5 |
| Forex | TQC | %2,26 | 0,48 | 0,60 | −%2,18 | 43 hafta / %48,9 |
Natijalar expert specialization g‘oyasini qo‘llab-quvvatlaydi: eng yuqori cumulative return, eng yuqori Sharpe, eng past MDD va eng tez-tez dominance bitta expertga jamlanmagan.
Kriptoda TQC eng yuqori cumulative returnga (%76,16) ega bo‘lsa, DDPG eng yuqori Sharpe va Sortinoni (1,74 va 2,73), A2C esa eng kichik MDDni (−%25) beradi. Aksiyalarda CrossQ eng yuqori cumulative returnga (%38,21), PPO eng yuqori Sharpe/Sortinoga (0,96/1,46) va eng kichik MDDga (−%22) ega. Forexda A2C cumulative return bo‘yicha %4,27 bilan oldinda; PPO va A2C Sharpe/Sortino bo‘yicha 0,88/1,20 qiymatlarida teng, eng kichik MDD esa PPO uchun −%2,00.
Proposed switcher qaysi ekspertlarni qanchalik tez-tez tanladi?
| Ekspert | Kripto | Aksiya | Forex |
|---|---|---|---|
| A2C | %34,5 | %19,3 | %6,8 |
| TQC | %32,7 | %14,8 | %48,9 |
| CrossQ | %16,4 | %36,4 | %20,5 |
| DDPG | %10,9 | %5,7 | %13,6 |
| PPO | %5,5 | %23,9 | %10,2 |
Ushbu taqsimot bitta expert barcha marketlarda dominant emasligini ko‘rsatadi. Kripto bozorida A2C va TQC tez-tez tanlansa, stock marketda CrossQ, forexda esa TQC eng yuqori frequency qiymatiga ega.
Uch Bozorda Proposed RAG Tanlovchisi Qanday Natijalar Bergan?
Manba Table 6 selection-strategy taqqoslashida Proposed RAG kriptoda %71 cumulative return va 1,73 Sharpe; aksiyalarda %34 va 0,96; forexda %4,3 va 0,88 natija olib, shu jadvaldagi Best Fixed va Recent-Performance Gating strategiyalaridan yuqori cumulative return va Sharpe ko‘rsatganini bildiradi; biroq natijalar har bir bozor uchun bitta rundan iborat va Table 5da ayrim standalone ekspertlarning cumulative return qiymatlari Proposed RAGdan yuqoridir.
| Bozor | Usul | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|---|---|
| Kripto | Best Fixed | %68 | %62 | 0,32 | 1,64 | 2,54 | −%27 |
| Kripto | Recent Gating | %69 | %62 | 0,32 | 1,66 | 2,57 | −%27 |
| Kripto | Proposed RAG | %71 | %64 | 0,31 | 1,73 | 2,72 | −%26 |
| Aksiya | Best Fixed | %26 | %14 | 0,21 | 0,74 | 1,11 | −%26 |
| Aksiya | Recent Gating | %33 | %17 | 0,20 | 0,91 | 1,37 | −%24 |
| Aksiya | Proposed RAG | %34 | %18 | 0,19 | 0,96 | 1,45 | −%26 |
| Forex | Best Fixed | %3,2 | %1,8 | 0,026 | 0,71 | 0,92 | −%1,9 |
| Forex | Recent Gating | −%0,4 | −%0,2 | 0,029 | −0,062 | −0,08 | −%2,6 |
| Forex | Proposed RAG | %4,3 | %2,4 | 0,028 | 0,88 | 1,20 | −%2,2 |
Proposed RAG har bir risk metrikasida mutlaq eng yaxshi emas. Stock marketda Recent Gating MDDsi −%24 bo‘lsa, Proposed RAG −%26. Forexda Best Fixed MDDsi −%1,9, Proposed RAG esa −%2,2. Shu sabab manbaning “risk-return profile” talqini cumulative return, Sharpe, Sortino, volatility va MDDni birgalikda baholashga asoslanadi; uni “har bir risk ko‘rsatkichida eng yaxshi” deb kengaytirish kerak emas.
Table 5 bilan Table 6 orasidagi “Best Fixed” farqi
Manba Table 5da standalone expert natijalarini va Table 6da selection strategy natijalarini alohida beradi. Biroq ikki jadval “eng yaxshi doimiy ekspert” nuqtayi nazaridan bir xil cumulative return qiymatiga yetishi kutilishi mumkin bo‘lsa-da, qiymatlar mos kelmaydi:
| Bozor | Table 5da eng yuqori standalone return | Table 6 Best Fixed | Table 6 Proposed RAG |
|---|---|---|---|
| Kripto | TQC: %76,16 | %68 | %71 |
| Aksiya | CrossQ: %38,21 | %26 | %34 |
| Forex | A2C: %4,27 | %3,2 | %4,3 |
Manba bu farqni boshqa split, davr, portfolio construction, initialization yoki boshqa protokol o‘zgaruvchisi bilan tushuntirmaydi. Shu sabab ushbu jadval farqidan yangi mexanizm chiqarilmasligi kerak.
Bundan tashqari, Section 4.3 matni “four strategies” iborasini ishlatadi, ammo darhol keyin faqat uch strategy belgilaydi: Best Fixed Expert, Recent-Performance Gating va Proposed RAG. Table 6 ham faqat shu uch strategiyani o‘z ichiga oladi. To‘rtinchi strategiya nima ekani manbada ko‘rsatilmagani uchun Verianla yangi baseline qo‘shmaydi.
Expert-pool hajmi ablatsiyasi
| Bozor | Ekspert Soni | Fixed Sharpe | RAG Sharpe | Δ Sharpe |
|---|---|---|---|---|
| Kripto | 1 | 0,81 | 0,81 | %0,0 |
| Kripto | 2 | 0,84 | 0,85 | %1,2 |
| Kripto | 3 | 0,89 | 0,98 | %10,1 |
| Kripto | 4 | 0,96 | 1,15 | %19,8 |
| Aksiya | 1 | 0,43 | 0,43 | %0,0 |
| Aksiya | 2 | 0,51 | 0,52 | %2,0 |
| Aksiya | 3 | 0,55 | 0,63 | %14,5 |
| Aksiya | 4 | 0,59 | 0,72 | %22,0 |
| Forex | 1 | 0,35 | 0,35 | %0,0 |
| Forex | 2 | 0,43 | 0,44 | %2,3 |
| Forex | 3 | 0,46 | 0,55 | %19,6 |
| Forex | 4 | 0,51 | 0,65 | %27,5 |
Bitta expert bo‘lganda switch qilish mumkin emasligi sabab RAG va fixed natija bir xil. Uch va to‘rt expertli poollarda improvement ortadi. Manba buni faqat model soni emas, complementary expertise xilma-xilligi ham muhim ekaniga dalil sifatida talqin qiladi.
Cheklov: Full system besh expertni o‘z ichiga olsa-da, Table 7 faqat 1–4 expert poollarini xabar qiladi. Bundan tashqari, expertlar nested poolga qaysi tartibda qo‘shilgani jadvalda ko‘rsatilmagan. Shu sabab “beshinchi expert qo‘shilsa improvement shuncha bo‘ladi” tarzida extrapolation qilib bo‘lmaydi.
Retrieval va LLM component ablation
| Bozor | Configuration | Cumulative Return | Sharpe | MDD |
|---|---|---|---|---|
| Kripto | NR — No Retrieval | %64,8 | 1,622 | −%26,7 |
| Kripto | R−LLM — No LLM | %69,1 | 1,661 | −%27,1 |
| Kripto | Full — R+L+U | %71 | 1,73 | −%26 |
| Aksiya | NR — No Retrieval | %33,1 | 0,911 | −%24,4 |
| Aksiya | R−LLM — No LLM | %25,5 | 0,735 | −%26,5 |
| Aksiya | Full — R+L+U | %34 | 0,96 | −%26 |
| Forex | NR — No Retrieval | %3,2 | 0,710 | −%1,9 |
| Forex | R−LLM — No LLM | −%0,2 | −0,025 | −%2,4 |
| Forex | Full — R+L+U | %4,3 | 0,88 | −%2,2 |
Retrieval olib tashlanganda full configurationga nisbatan cumulative return barcha marketlarda kamayadi. LLM olib tashlanganda pasayish stock va forex tajribalarida yaqqolroq. Masalan, forexda full model %4,3 cumulative return va 0,88 Sharpe bersa, no-LLM configuration −%0,2 va −0,025ga tushadi.
Biroq full model har bir marketda minimal MDD bermaydi. Stockda no-retrieval MDD −%24,4 bilan full modelning −%26 qiymatidan kichik; forexda ham no-retrieval −%1,9, full model esa −%2,2.
Muhim ablatsiya chegarasi: Source Table 8 uncertainty-aware componentni alohida olib tashlaydigan configurationni o‘z ichiga olmaydi. Shu sabab retrieval va LLM reasoning hissalari haqida eksperimental xulosa chiqarish mumkin; uncertainty-aware decision makingning mustaqil hissasi ushbu ablation bilan o‘lchanmaydi.
Indekslash LLM sezgirligi
| Indexing LLM | Muvaffaqiyat | Muvaffaqiyatsizlik |
|---|---|---|
| Google/Gemma4-E4B | %28 | %72 |
| Google/Gemma4-31B-it | %96 | %4 |
| AliBaba/Qwen3.6-27B-it | %100 | %0 |
Bu “success” metrikasi investitsiya daromadi emas. Manba uni indexing instructionsga amal qilib, kutilgan structured output formatini to‘g‘ri yaratish muvaffaqiyati sifatida belgilaydi.
Inference LLM sezgirligi
| Bozor | Inference LLM | Cum. Return | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|
| Kripto | Google/Gemma4-31B-it | %68,3 | 1,65 | 2,55 | −%27 |
| Kripto | Google/Gemma4-E4B | %63,5 | 1,57 | 2,42 | −%28 |
| Kripto | AliBaba/Qwen3.6-27B-it | %71 | 1,73 | 2,72 | −%26 |
| Aksiya | Google/Gemma4-31B-it | %25,1 | 0,73 | 1,09 | −%26,5 |
| Aksiya | Google/Gemma4-E4B | %24,5 | 0,71 | 1,06 | −%27 |
| Aksiya | AliBaba/Qwen3.6-27B-it | %34 | 0,96 | 1,45 | −%26 |
| Forex | Google/Gemma4-31B-it | −%0,3 | −0,05 | −0,06 | −%2,5 |
| Forex | Google/Gemma4-E4B | −%5,4 | −1,07 | −1,37 | −%5,6 |
| Forex | AliBaba/Qwen3.6-27B-it | %4,3 | 0,88 | 1,20 | −%2,2 |
Manbada AliBaba/Qwen3.6-27B-it uchala marketda ham eng kuchli inference resultlarni yaratadi. Ayniqsa forexda LLM tanlovi natijaga katta taʼsir ko‘rsatgan. Bu topilma retrieval mexanizmining o‘zi yetarli emasligini, retrieved evidence downstream reasoning model tomonidan qanday qayta ishlanishi ham muhimligini ko‘rsatadi.
State-of-the-art usullar bilan taqqoslash
| Bozor | Usul | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | MDD |
|---|---|---|---|---|---|---|
| Kripto | TAC | %24 | %21,6 | 0,94 | 1,29 | −%31 |
| Kripto | AlphaMixRL | %22 | %19,8 | 1,00 | 1,38 | −%29 |
| Kripto | LLM-MAS | %33 | %30 | 0,96 | 1,50 | −%28 |
| Kripto | Proposed | %71 | %64 | 0,31 | 1,73 | −%26 |
| Aksiya | TAC | %10,4 | %5,6 | 0,25 | 0,74 | −%28 |
| Aksiya | AlphaMixRL | %11,8 | %6,3 | 0,31 | 0,82 | −%27 |
| Aksiya | Multi-LLM Black–Litterman | %31 | %16,4 | 0,28 | 0,91 | −%29 |
| Aksiya | Proposed | %34 | %18 | 0,19 | 0,96 | −%26 |
| Forex | TAC | %0,7 | %0,4 | 0,45 | 0,61 | −%5,1 |
| Forex | AlphaMixRL | %0,8 | %0,45 | 0,50 | 0,68 | −%4,6 |
| Forex | Fine-tuned LLaMA | %3,3 | %1,9 | 0,08 | 0,76 | −%3,1 |
| Forex | Proposed | %4,3 | %2,4 | 0,03 | 0,88 | −%2,2 |
Manba Table 11da Proposed framework uchala marketda ham eng yuqori cumulative return va Sharpe qiymatini beradi. Biroq mualliflar natijalar bo‘limida competing implementations har doim to‘liq bir xil experimental protocol ostida ishlatilmaganini ochiq aytadi. Shu sabab Table 11 nazoratli benchmark taqqoslash sifatida baholanganda protokol tengligi masalasida ehtiyot bo‘lish kerak.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Ko‘rib chiqilgan expert pool ichida ekspertlarning nisbiy ustunligi market va metrikalarga qarab o‘zgargan.
- Table 6 doirasida retrieval-based Proposed RAG uchala marketda ham Best Fixed va Recent Gatingdan yuqori cumulative return va Sharpe bergan.
- Retrievalni olib tashlash uchala marketda ham full configurationga nisbatan cumulative returnni kamaytirgan.
- LLM reasoningni olib tashlash ayniqsa stock va forex tajribalarida muhim natija pasayishi bilan bog‘liq.
- Expert-pool ablation complementary expertlar soni oshgani sari xabar qilingan Sharpe improvement 1–4 expert oralig‘ida oshganini ko‘rsatgan.
- Inference LLM tanlovi natijalarni sezilarli o‘zgartirgan va Qwen3.6-27B-it sinovdan o‘tgan uch model ichida eng kuchli natijalarni bergan.
- Manbaning matematik teoremasi Axiom 1–3 ostida mos specialist qo‘shilishi expected utilityni kamaytirmasligini kafolatlaydi.
Tadqiqot qo‘llab-quvvatlamaydigan umumlashtirishlar
- Taklif qilingan usul haqiqiy pul bilan jonli bozorda ayni daromadni berishi isbotlanmagan.
- %71, %34 va %4,3 cumulative return qiymatlari kelajak investitsiya daromadi kafolati emas.
- LLM o‘zi muvaffaqiyatli trader sifatida tasdiqlanmagan; tadqiqotda LLM expert-routing rolida.
- Monotonlik teoremasi Axiom 1–3 bajarilmasdan expert qo‘shilishi natijani pasaytira olmaydi, demaydi.
- Table 6 natijalari Proposed RAG barcha standalone expertlardan yuqori cumulative return berganini isbotlamaydi.
- Bitta experimental run statistik ishonch oralig‘i yoki random-seed robustness isboti emas.
- Component ablation uncertainty-aware mexanizmning mustaqil hissasini o‘lchamagan.
- Uch marketdagi natijalar barcha bozorlarga, barcha davrlarga yoki boshqa transaction-cost muhitlariga avtomatik umumlashtirilmaydi.
- O‘tmishda o‘xshash latent state topilishi kelajakda ayni bozor dinamikalari takrorlanishini kafolatlamaydi.
Manbada yetishmaydigan yoki qayta ishlab chiqarish nuqtayi nazaridan noaniq maʼlumotlar
Market-data provider: Xabar qilinmagan.
Exact train / validation / test calendar split: Chronological retrieval va \(\tau<t\) cheklovi berilgan; biroq barcha marketlar uchun aniq boshlanish-tugash sanalari ko‘rsatilgan train/validation/test split jadvali yo‘q.
Transaction-cost qiymati: SOTA taqqoslash bir xil transaction-cost assumptions ostida bajarishga harakat qilingani aytiladi; raqamli fee/slippage qiymati xabar qilinmagan.
Portfolio constraints: Bir xil constraints ishlatishga harakat qilingani aytiladi; long-only, leverage, short-selling, cash allocation yoki weight bound qiymatlari aniq sanalmagan.
RL expert training hyperparameters: A2C, DDPG, PPO, TQC va CrossQ nomlari hamda usul sinflari berilgan; har bir modelning learning rate, batch size, optimizer, network depth, reward function va boshqa training sozlamalari ushbu PDFda to‘liq reproducibility table shaklida taqdim etilmagan.
Weighted uncertainty: Algorithm 2 ichida \(\sigma_t^{(e)}\) hisoblanishi aytiladi; formulasi berilmagan.
Teorema parametrlari: \(\epsilon\), \(\tau\) va \(\delta\) nazariy shartlar sifatida belgilanadi; tajribalarda ishlatilgan raqamli qiymatlari berilmagan.
Prompt validation set: Beshta prompt iteration xabar qilingan; validation sample size va to‘liq davr taqsimoti ko‘rsatilmagan.
Expert-pool ablation: Besh ekspertli full poolga qaramay Table 7 faqat 1–4 expert natijalarini beradi va expertlar nested poolga qaysi tartibda qo‘shilganini tushuntirmaydi.
Statistical significance: Ko‘p random seed, confidence interval, p-value yoki formal hypothesis test xabar qilinmagan.
Public code repository: Yuklangan PDFda tasdiqlangan public code repository havolasi berilmagan.
Tadqiqotning kuchli tomonlari
Tadqiqotning kuchli tomoni expert routing qarorini faqat so‘nggi bir necha kunlik performancega bog‘lash o‘rniga tarixan o‘xshash market statesdagi real expert behavior bilan asoslashidir. Bu yondashuv retrieval tizimini faqat maʼlumot olib keluvchi yordamchidan portfolio expert selection mexanizmining asosiy qismiga aylantiradi.
Ikkinchi muhim kuchli tomon LLM vazifasining cheklanishidir. LLM bevosita portfolio weights yaratmaydi; retrieved evidenceni talqin qiladigan coordination/routing layer sifatida ishlatiladi. Bu farq LLMni numerical trading policy o‘rniga contextual reasoning rolida baholash imkonini beradi.
Uchinchi kuchli tomon uch xil financial market classda bir xil \(L=22\), \(H=5\), \(K=3\) retrieval protokoli qo‘llanishi va expert heterogeneity, pool size, retrieval, LLM choice hamda indexing quality uchun turli ablation/sensitivity tahlillari bajarilishidir.
Asosiy cheklovlar
Eng muhim cheklov har bir market uchun faqat bitta experimental run o‘tkazilganidir. Shu sabab random initialization yoki stochastic training taʼsirlarining natija taqsimoti nomaʼlum.
Ikkinchi cheklov competing SOTA methods har doim to‘liq bir xil experimental protocol ostida qo‘llanmaganidir. Bu holat Table 11ning bevosita usul ustunligi daʼvosini ehtiyotkor talqin qilishni talab qiladi.
Uchinchi cheklov exact transaction-cost, portfolio constraints, data provider va muhim RL training hyperparameters kabi reproduction uchun zarur ayrim tafsilotlar manbada ochiq emasligidir.
To‘rtinchi cheklov retrieval va LLM components uchun ablation bor bo‘lsa-da, uncertainty-aware mechanism alohida olib tashlangan ablation yo‘qligidir.
Beshinchi cheklov historical similarity kelajakda ham ayni expert suitability munosabatini saqlaydi degan faraz bozor tuzilmasidagi mutlaqo yangi structural breaks paytida muvaffaqiyatsiz bo‘lishi mumkinligidir. Manba yondashuvi empirical historical grounding bilan bu xavfni kamaytirishga urinsa-da, unseen regime muammosi to‘liq bartaraf etilmagan.
Manba va Usul Haqida Izoh
Original sarlavha: Regime-Aware Portfolio Management via Retrieval-Augmented LLM-Guided Expert Switching
Mualliflar: Ahmad Asadi; Reza Safabakhsh.
Mualliflar tartibi: Manbadagi tartib saqlangan.
Muassasa: Deep Learning Lab, Computer Engineering Department, Amirkabir University of Technology, Hafez Avenue, Tehran, Iran.
Yuklangan manba: arXiv:2608.28252v1 [cs.AI].
arXiv yuborilgan sana: 28 Avgust 2026.
PDFda ko‘rinadigan sana: 31 Avgust 2026.
Manba turi: Preprint.
Taqriz holati: Yuklangan arXiv v1 taqrizdan o‘tgan jurnal Version of Record emas. 21 Noyabr 2026 holatiga tasdiqlanadigan joriy bibliografik yozuvlarda taqrizdan o‘tgan journal version aniqlanmagan.
Yangiroq bibliografik versiya: Shu sarlavhali 47 sahifalik SSRN versiyasi 23 Oktyabr 2026da eʼlon qilingan. SSRN suggested citation DOI 10.2139/ssrn.7661576. Verianla ilmiy mazmuni yuklangan arXiv v1 asosida tayyorlangan; keyingi SSRN versiyasining yangi ilmiy mazmuni ushbu maqolaga qo‘shilmagan.
Corresponding / contact author: Yuklangan arXiv PDFda corresponding-author belgisi aniq berilmagan. Keyingi SSRN bibliografik yozuvi Reza Safabakhshni Contact Author sifatida ko‘rsatadi.
Teng hissa: Yuklangan manbada equal contribution bayonoti ko‘rinmaydi.
Manba litsenziyasi: Yuklangan arXiv v1da Verianla manba figuralarini bevosita qayta ishlatishiga ruxsat berishini aniq tasdiqlovchi ochiq Creative Commons litsenziyasi aniqlanmagan. Shu sabab manba figuralari aynan ishlatilmagan, ilmiy munosabatlar mustaqil sxema sifatida qayta qurilgan.
Moliyalashtirish: Yuklangan PDFda alohida funding declaration aniqlanmagan.
Manfaatlar to‘qnashuvi: Yuklangan PDFda alohida conflict-of-interest / competing-interest declaration aniqlanmagan.
Maʼlumotlar mavjudligi: Yuklangan PDFda alohida Data Availability bo‘limi yoki tasdiqlangan public dataset repository havolasi yo‘q.
Kod mavjudligi: Yuklangan PDFda tasdiqlangan public source-code repository havolasi yo‘q.
Asosiy usul: Dual-stream Transformer-VAE market-state representation + chronological vector retrieval + Statement of Performance + instruction-tuned LLM guided expert switching + reinforcement-learning expert pool.
Expert pool: A2C, DDPG, PPO, TQC va CrossQ.
Marketlar: Cryptocurrency, stock va foreign exchange; har marketda 30 symbol.
Maʼlumot chastotasi: Daily OHLCV.
Kirish oynasi: \(L=22\) savdo kuni.
Forward / saqlash gorizonti: \(H=5\) kun.
Retrieval: \(K=3\) eng yaqin tarixiy holat, cosine similarity.
Embedding o‘lchami: \(d=64\).
LLM harorati: 0,1.
LLM chaqiruv chegarasi: Har decision step uchun ko‘pi bilan bir chaqiruv.
Leakage nazorati: Test paytida retrieval faqat \(\tau<t\) historical observations bilan cheklangan.
Uskuna: Bitta NVIDIA H100 GPU.
Tajriba takrori: Har market uchun bitta run; natijalar repeated-seed averages emas.
Statistik chegara: Confidence interval, formal significance test va ko‘p random-seed taqsimoti xabar qilinmagan.
Nazariy natija: Monotonic Expert-Pool Performance natijasi faqat bounded estimation error, conservative switching va specialist dominance assumptions ostida amal qiladi; haqiqiy bozor daromadi uchun shartsiz kafolat emas.
Manba ichidagi muhim hisobot farqi: Table 5 standalone expert cumulative return qiymatlari bilan Table 6 “Best Fixed” qiymatlari mos kelmaydi va manba sababini tushuntirmaydi. Bundan tashqari, Section 4.3 to‘rtta strategy taqqoslanishini aytadi, ammo faqat uch strategy belgilaydi.
Qayta ishlab chiqarish bo‘shliqlari: Exact market-data provider, calendar-based train/validation/test split, transaction-cost qiymati, portfolio constraints, ko‘plab RL training hyperparameterlar, weighted-uncertainty formulasi, raqamli \(\epsilon/\tau/\delta\) qiymatlari va prompt-validation-set hajmi xabar qilinmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan