


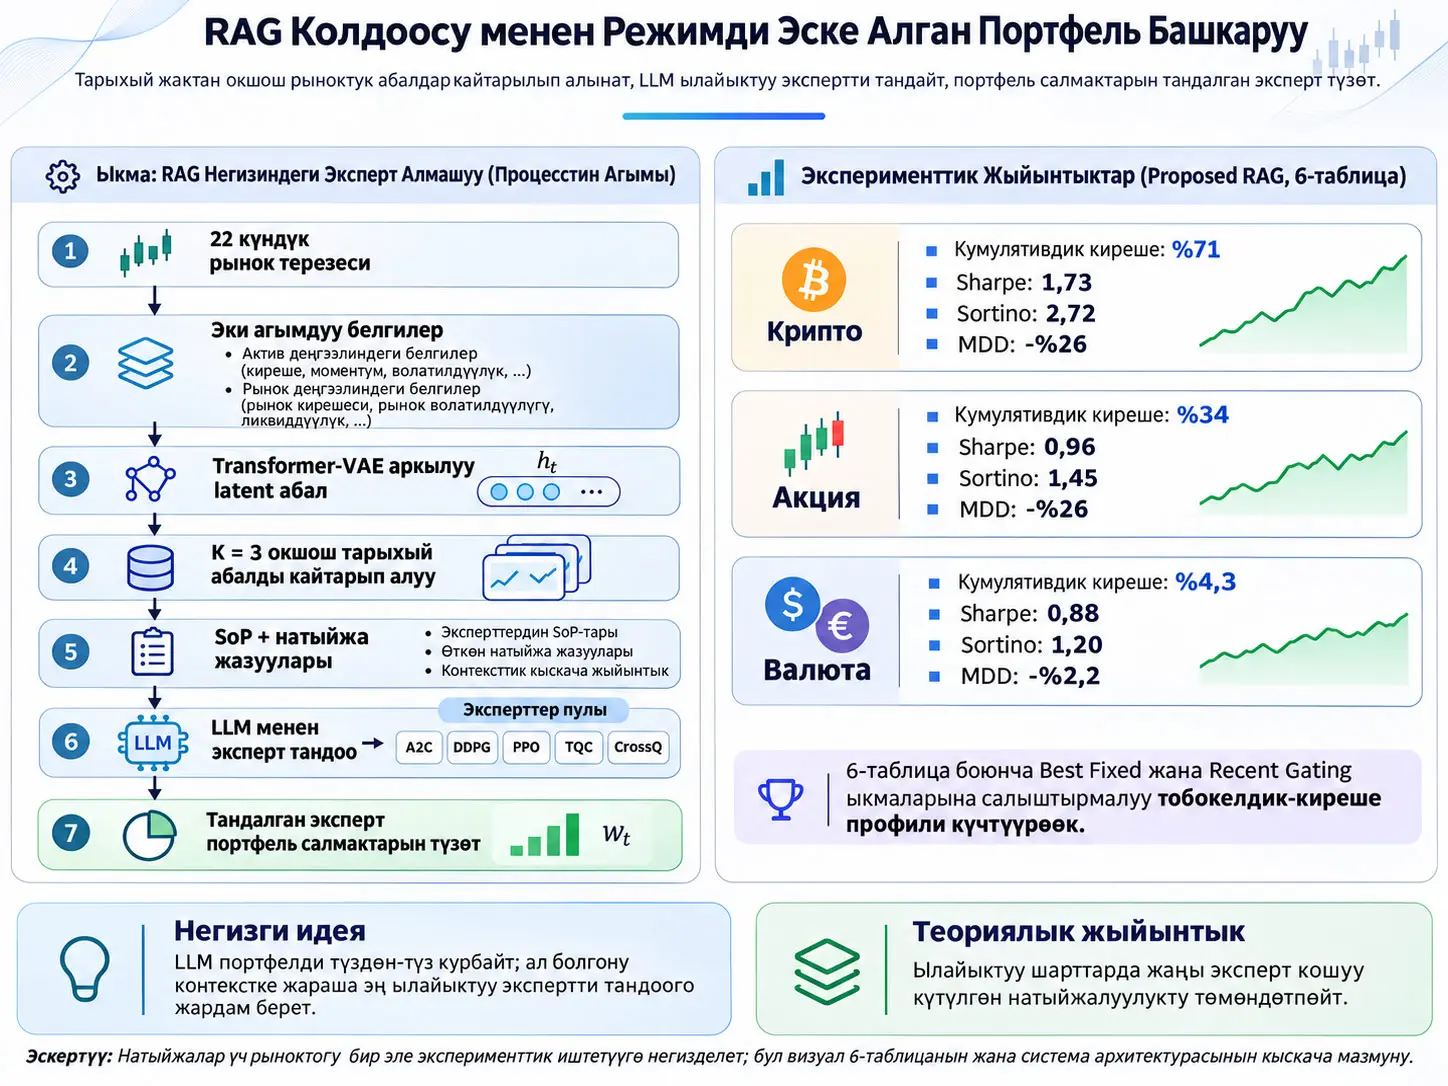
Retrieval-augmented LLM-guided expert switching — учурдагы рыноктук абалды тарыхый жактан окшош рыноктук абалдар менен дал келтирип, ошол мезгилдерде ар кандай портфель эксперттери кандай натыйжа көрсөткөнүн талдаган жана чоң тил моделин портфель салмактарын түздөн-түз өндүрүү үчүн эмес, кайсы эксперттик саясат колдонуларын чечүү үчүн пайдаланган адаптивдүү портфель-багыттоо ыкмасы. Изилдөө рынок шарттары убакыттын өтүшү менен өзгөргөн non-stationary каржы чөйрөлөрүндө бир портфель модели ар бир режимде эң жакшы иштебей калышы мүмкүн деген көйгөйгө көңүл бурат.
Ыкмада рыноктук абал эки өзүнчө маалымат агымы аркылуу көрсөтүлөт. Биринчи агым актив деңгээлиндеги log-return, RSI, MACD, ATR, realized volatility жана volume-change белгилерин; экинчи агым рынок боюнча trend, volatility-regime жана liquidity көрсөткүчтөрүн алып жүрөт. Эки агым өзүнчө Transformer-VAE encoderʼлери аркылуу latent representationʼга айландырылып, бир \(h_t\) state vector ичинде бириктирилет. Тарыхый stateʼтер vector database ичинде сакталат; ар бир state үчүн A2C, DDPG, PPO, TQC жана CrossQ эксперттеринин кийинки беш күндүк натыйжалары жана Statement of Performance (SoP) жазуулары сакталат.
Online чечим этабында учурдагы 22 trading-day рынок терезеси ошол эле latent мейкиндикке коддолот жана cosine similarity аркылуу эң жакын \(K=3\) тарыхый абал кайтарылат. Бул тарыхый абалдардагы эксперттердин иш жүзүндөгү натыйжалары, SoP жазуулары жана учурдагы рынок контексти LLMʼге берилет. LLM портфель салмактарын өзү чыгарбайт; кайсы эксперттик саясат активдештирилерин контексттик баалоо аркылуу аныктайт. Тандалган reinforcement-learning эксперти андан кийин портфель салмактарын түзөт.
Изилдөөнүн Table 6 selection-strategy салыштыруусунда Proposed RAG криптовалюта рыногунда %71 cumulative return жана 1,73 Sharpe, акция рыногунда %34 cumulative return жана 0,96 Sharpe, валюта рыногунда болсо %4,3 cumulative return жана 0,88 Sharpe алган. Ошол эле таблицада Best Fixed Expert үчүн маанилер тиешелүүлүгүнө жараша %68/1,64, %26/0,74 жана %3,2/0,71. Бирок ар бир рынок бир гана эксперименттик run менен бааланган, көп random seed орточолору же статистикалык маанилүүлүк тесттери билдирилген эмес.
Натыйжаларды чечмелөөдө маанилүү булак ичиндеги айырма бар. Table 5ʼте өз алдынча иштетилген эксперттердин эң жогорку cumulative return маанилери крипто рыногунда TQC үчүн %76,16, акция рыногунда CrossQ үчүн %38,21 жана forexте A2C үчүн %4,27; бул маанилер Table 6дагы “Best Fixed” маанилеринен айырмаланат. Булак бул эки таблица эмне үчүн ар башка “fixed expert” натыйжаларын бергенин түшүндүрбөйт. Ошондуктан изилдөө Proposed RAG Table 6дагы тандоо стратегияларынан жакшы натыйжа бергенин колдойт; сунушталган система бардык шарттарда бардык standalone эксперттерден жогорку киреше жаратат деген тыянакты колдобойт.
Изилдөөнүн негизги көйгөйү
Каржы рыноктору туруктуу системалар эмес. Волатилдүүлүк деңгээли, ликвиддүүлүк, cross-asset relationships, тренд түзүмү жана рынок катышуучуларынын жүрүм-туруму убакыттын өтүшү менен өзгөрүшү мүмкүн. Ошондуктан белгилүү бир мезгилде ийгиликтүү болгон портфель саясаты башка market regime ичинде ошол эле ийгиликти көрсөтпөшү мүмкүн.
Бир deep-learning же deep-reinforcement-learning моделин бардык рынок шарттарына ылайыкташтырууга аракет кылуу моделдин мүмкүнчүлүгүн көбөйтүшү мүмкүн; бирок модель окутууда көргөн regularitiesʼге ашыкча ылайыкташып калышы ыктымал. Mixture-of-Experts ыкмасы ар кандай эксперттик моделдерди колдонуп бул көйгөйдү азайтууга аракет кылат, бирок классикалык MoE түзүмдөрүндө кайсы эксперт активдештирилерин аныктаган learned gating network да мурда кездешпеген режимдерде жаңылыш тандоо жасашы мүмкүн.
Изилдөө сунуш кылган альтернативдүү ыкма “акыркы бир нече күндө кайсы модель ийгиликтүүрөөк болду?” деген суроонун ордуна “учурдагы рыноктук абалга тарыхый жактан окшош мезгилдерде кайсы эксперт ийгиликтүүрөөк болгон?” деген суроону коёт.
Retrieval-Augmented LLM-Guided Expert Switching Деген Эмне?
Retrieval-augmented LLM-guided expert switching учурдагы рыноктук абалга окшош тарыхый абалдарды latent vector database ичинен кайтарып, ошол абалдардагы эксперттик моделдердин иш жүзүндөгү тобокелдик-киреше көрсөткүчтөрүн LLM колдогон багыттоо механизминин алдына коюу менен колдонулуучу портфель экспертин тандаган, бирок портфель салмактарын түздөн-түз LLMге чыгартып койбогон expert-routing ыкмасы.
Система эки өзүнчө этаптан турат
Offline indexing этабы тарыхый рыноктук абалдарды алдын ала иштетет. Ар бир historical window dual-stream Transformer-VAE аркылуу latent stateʼке айландырылат. Андан соң бардык эксперттер бирдей тарыхый абалдан баштап туруктуу forward horizon бою бааланат. Алынган performance records жана Statement of Performance жазуулары latent representation менен бирге vector databaseʼге жайгаштырылат.
Online inference этабы учурдагы рыноктук абалды ошол эле latent мейкиндикке айлантып, өткөндөгү эң окшош \(K=3\) stateʼти кайтарат, тиешелүү expert-performance жазууларын чогултат жана LLMди expert-selection үчүн колдонот. LLMдин милдети portfolio allocation чыгаруу эмес, retrieved evidenceʼти чечмелеп ылайыктуу expertти аныктоо.
Statement of Performance (SoP) деген эмне?
Statement of Performance ар бир historical market episode үчүн тиешелүү эксперттин жүрүм-турумун жана иш жүзүндөгү натыйжасын контексттик түрдө жыйынтыктаган жазуу. Булактагы offline performance record cumulative return, Sharpe ratio жана maximum drawdown маалыматтарын камтыйт. SoP болсо ошол эле мезгилдин market contextʼин, expert behaviorʼун жана тиешелүү uncertainty factors маалыматын жыйынтыктап, LLMге жөн гана сандык упай эмес, контексттештирилген тарыхый далил көрүүгө мүмкүндүк берет.
LLM Бул Системада Портфель Салмактарын Түздөн-Түз Чыгарабы?
Жок. Изилдөөдөгү instruction-tuned LLM кайтарылган тарыхый market-state жазууларын жана эксперттердин тобокелдик-киреше жүрүм-турумун чечмелеп, кайсы expert тандаларын аныктаган багыттоо катмарына салым кошот; чыныгы portfolio weight vector тандалган A2C, DDPG, PPO, TQC же CrossQ эксперти тарабынан түзүлөт.
Эмне үчүн LLM түздөн-түз trader катары колдонулбайт?
Изилдөөнүн адабиятты баалоосу LLM негизиндеги trading agentʼтер узак мөөнөттүү benchmarkтарда дайыма buy-and-hold же сандык ыкмалардан жогору боло бербесин баса белгилейт. Ошондуктан LLMдин милдети тарылтылган. Модель түздөн-түз сатып алуу-сатуу көлөмүн эсептөөнүн ордуна тарыхый контекстти чечмелөө, retrieved episodes ортосундагы байланыштарды баалоо жана expert routing милдетинде колдонулат.
LLM баалоосу эмне үчүн чектелген?
Алгачкы prompt версияларында LLM retrieved historical records ичинде жок return маанилерине extrapolation жасап, ашыкча ишенимдүү жоопторду чыгарганы байкалган. Булак беш prompt iteration validation set үстүндө бааланганын жана mean absolute estimation error болжол менен %18ден %11ге түшкөнүн билдирет.
Акыркы prompt дизайны үч негизги чектөөнү колдонот:
- Empirical grounding: Тобокелдик-киреше баалоосу retrieved historical MDD, realized information ratio жана башка иш жүзүндөгү performance observations менен чектелет.
- Conservative margining: Жаңы candidate expert incumbent expertке салыштырмалуу estimated advantage uncertainty/noise marginʼдан ашканда гана тандалат.
- Tail-event separation: Extreme drawdown, liquidity squeeze жана regime transition мезгилдери кадимки мезгилдерден өзүнчө бааланат.
Булак validation set канча үлгүдөн турарын, кайсы рынок мезгилдерин камтарын жана %18 → %11 маанилеринин толук бөлүштүрүлүшүн билдирбейт.
Монотондук Эксперт-Pool Теоремасы Эмне Дейт?
Булактын монотондук натыйжасы жаңы эксперт кошуу шартсыз түрдө көрсөткүчтү жогорулатат деп айтпайт; estimation error \(\epsilon\) менен чектелген, switch threshold \(\tau\ge2\epsilon\) болгон жана жаңы эксперттин максаттуу аймактагы чыныгы utility advantageʼы \(\delta>\tau+2\epsilon\) шартын аткарган божомолдордо гана expert poolʼго жаңы specialist кошуу күтүлгөн utilityʼни азайтпай турганын көрсөтөт.
Теңдеме 1: Switching policyнин күтүлгөн мааниси
\[ V(\pi_N) = \int_{\mathcal{S}} U_{\pi_N(s)}(s)\,d\mathbb{P}(s). \tag{1} \]
Эмнени эсептейт? \(N\) эксперттүү switching policyнин бардык market-state мейкиндиги боюнча expected risk-adjusted utility маанисин эсептейт.
- \(\mathcal{S}\): мүмкүн болгон latent market state мейкиндиги.
- \(\mathbb{P}\): state мейкиндигиндеги ыктымалдык өлчөмү.
- \(\pi_N(s)\): state \(s\) үчүн тандалган expert индекси.
- \(U_i(s)\): expert \(i\)нин state \(s\) ичиндеги иш жүзүндөгү чыныгы risk-adjusted utilityси.
\(U_i(s)\)нин белгилүү физикалык бирдиги булакта аныкталган эмес. Теориялык моделде ал utility шкаласындагы чоңдук жана decision timeда түздөн-түз белгисиз.
Теңдеме 2: LLM колдогон expert assessment
\[ \rho_i(s) = \mathcal{M} \left( \mathcal{H}_t(s),E_i \right). \tag{2} \]
\(\mathcal{H}_t(s)\) current state \(s\)ке окшош retrieved historical episodes топтому; \(E_i\) тиешелүү expert; \(\mathcal{M}\) retrieved evidence үстүндө иштеген баалоо механизмин, \(\rho_i(s)\) болсо switching procedure ичинде колдонулган estimated assessment маанисин көрсөтөт.
Критикалык айырма: \(\rho_i(s)\) белгисиз чыныгы \(U_i(s)\)нин түз байкоосу эмес. Historical performance records сандык негизди берет; LLM retrieved contextти чечмелеп assessment calibrationга салым кошот.
Теңдеме 3: Axiom 1 — bounded estimation error
\[ \sup_{s\in\mathcal{S}} \left| \rho_i(s)-U_i(s) \right| \le \epsilon, \qquad \forall i\in\{1,\ldots,N+1\}. \tag{3} \]
Бул шарт estimated assessment менен чыныгы utility ортосундагы эң чоң ката \(\epsilon\) маанисинен ашпайт деп божомолдойт. \(\epsilon\), \(\rho\) жана \(U\) менен бир utility/assessment шкаласында.
Бул бардык state мейкиндиги үчүн эксперименттик түрдө далилденген өзгөчөлүк эмес. Булактын practical implementationʼы LLMди retrieved empirical observations сыртына extrapolation кылбоого мажбурлап, ушул аксиомага жакындаганга аракет кылат.
Теңдеме 4: Эң жогорку estimated utilityге ээ expert
\[ e^*(s) = \arg\max_{i\in\{1,\ldots,N\}} \rho_i(s). \tag{4} \]
Бул туюнтма state \(s\) үчүн учурдагы expert pool ичинде эң жогорку estimated assessment маанисине ээ expert индексин тандайт.
Теңдеме 5: Conservative switching
\[ \pi_N(s) = \begin{cases} e^*(s), & \rho_{e^*(s)}(s) - \rho_{\pi_N(s)}(s) > \tau, \\ \pi_N(s), & \text{aksi durumda}. \end{cases} \tag{5} \]
жана:
\[ \tau\ge2\epsilon. \]
Candidate expertтин incumbent expertке салыштырмалуу estimated advantageʼы \(\tau\) маанисинен чоң болбосо, учурдагы expert сакталат. Максат estimation noise себебинен керексиз switchingти азайтуу.
Теңдеме 6: Axiom 3 — specialist dominance
\[ U_{N+1}(s) \ge U_{\pi_N(s)}(s) + \delta, \qquad s\in\mathcal{S}_R, \tag{6} \]
жана:
\[ \delta > \tau+2\epsilon. \]
\(\mathcal{S}_R\) жаңы specialist expert багытталган market-state subset жана булак \(P(\mathcal{S}_R)>0\) деп божомолдойт. Жаңы эксперт бул аймакта incumbent policyден кеминде \(\delta\) өлчөмүндө жогору чыныгы utilityге ээ болушу керек.
Булак ичиндеги туюнтма эскертүүсү: Axiom 3төн кийин булак specialist region сыртында жаңы expertтин utilityси “unlimited” деп божомолдонорун жазат. Бул сөз математикалык жактан “unrestricted/unconstrained” маанисинде колдонулганбы, өзүнчө аныкталган эмес. Verianla бул туюнтманы үнсүз башка божомол менен алмаштырбайт.
Теңдеме 7–9: Туура эмес switching эмне үчүн utilityни азайтпашы күтүлөт?
\[ U_{N+1}(s) \ge \rho_{N+1}(s)-\epsilon. \tag{7} \]
\[ U_{\pi_N(s)}(s) \le \rho_{\pi_N(s)}(s)+\epsilon. \tag{8} \]
Эки теңсиздик бириктирилгенде:
\[ U_{N+1}(s) - U_{\pi_N(s)}(s) > \tau-2\epsilon. \tag{9} \]
\(\tau\ge2\epsilon\) болгондуктан оң тарап терс эмес. Демек көрсөтүлгөн error bound чындап жарактуу болсо, switching thresholdдан ашкан өзгөрүү чыныгы utilityни азайтпашы күтүлөт.
Теңдеме 10–11: Максаттуу specialist аймагындагы так жакшыртуу
\[ \rho_{N+1}(s) - \rho_{\pi_N(s)}(s) \ge \delta-2\epsilon. \tag{10} \]
\(\delta>\tau+2\epsilon\) болгондуктан:
\[ \delta-2\epsilon>\tau. \]
Ошентип specialist максат region ичинде switching criterionду аткарат. Күтүлгөн utilityге минималдуу contribution:
\[ \Delta V \ge \int_{\mathcal{S}_R} \delta\,d\mathbb{P}(s) = \delta \mathbb{P}(\mathcal{S}_R) > 0. \tag{11} \]
болот.
Андан соң булак specialistтер ырааттуу кошулганда:
\[ V(\pi_1) \le V(\pi_2) \le \cdots \le V(\pi_K) \]
түрүндөгү non-decreasing policy-value sequence алынарын жана ал:
\[ V^* = \int_{\mathcal{S}} \sup_E U_E(s) \,d\mathbb{P}(s) \]
менен аныкталган best-achievable utility тарабынан жогору жактан чектелерин билдирет.
Теореманын туура чечмелениши: Бул натыйжа “эксперттердин санын көбөйтсөк, чыныгы портфель кирешеси дайыма өсөт” дегенди билдирбейт. Натыйжа Axiom 1–3 чындап аткарылганда гана математикалык жактан жарактуу. Practical prompt эрежелери болсо булактын өз сөзү боюнча бул аксиомалардын далили эмес, LLM жүрүм-турумун аксиомаларга көбүрөөк шайкеш кылууга багытталган implementation heuristics.
Рыноктук абал кайсы белгилер менен көрсөтүлөт?
Ар бир чечим учурда эки rolling-window tensor түзүлөт.
Asset-level техникалык tensor:
\[ S_t^{tech} \in \mathbb{R}^{L\times A\times F_1}. \]
Бул жерде \(L\) rolling-window узундугу, \(A\) портфелдеги активдердин саны жана \(F_1\) asset-level feature саны. Эксперименттерде \(L=22\) trading day жана \(A=30\) колдонулат.
Актив деңгээлиндеги белгилер топтому:
- Log-return: Ырааттуу баалардын logarithmic өзгөрүүсүн көрсөтөт.
- RSI: Relative Strength Index; баа кыймылдарынын салыштырма momentum түзүмүн жыйынтыктаган техникалык көрсөткүч.
- MACD: Moving Average Convergence Divergence; ар башка убакыт масштабдарындагы кыймылдуу орточолордун байланышын колдонуп trend/momentum түзүмүн көрсөтөт.
- ATR: Average True Range; баа кыймылдарынын диапазонго негизделген волатилдүүлүк чоңдугун көрсөтөт.
- Realized volatility: байкалган баа кыймылдарынан алынган өзгөрмөлүүлүк маалыматы.
- Volume changes: соода көлөмүнүн өзгөрүүлөрү.
Рынок боюнча тензор:
\[ S_t^{mkt} \in \mathbb{R}^{L\times F_2}. \]
Бул stream aggregate trend indicators, volatility-regime measures жана liquidity variables камтыйт. Булак жалпы теориялык түшүндүрмөдө macroeconomic conditions түшүнүгүн айтса да, практикада кайсы тышкы macroeconomic series колдонулганын тизмелебейт; ошондуктан Verianla тышкы пайыз, инфляция же окшош маалымат топтомдорун кошпойт.
Бардык features rolling z-score normalization менен стандартташтырылат. Булак мунун өзгөрмө масштабдардын таасирин азайтууну жана heteroskedasticityнин state representationга таасирин чектөөнү көздөй турганын билдирет.
Теңдеме 12: Transformer-VAE posterior бөлүштүрүлүшү
\[ q_{\phi_x} \left( z_x\mid S_t^x \right) = \mathcal{N} \left( \mu_x(S_t^x), \Sigma_x(S_t^x) \right), \qquad x\in\{tech,mkt\}. \tag{12} \]
Ар бир feature stream өзүнүн Transformer encoderи аркылуу Gaussian posteriorга чагылдырылат. \(\mu_x\) posterior mean, \(\Sigma_x\) diagonal covariance жана \(z_x\) latent representation.
Бул өзгөрмөлөрдүн физикалык бирдиги жок; алар стандартташтырылган кириштерден үйрөнүлгөн latent-space чоңдуктар.
Теңдеме 13: Reparameterization
\[ z_x = \mu_x + \varepsilon\odot\sigma_x, \qquad \varepsilon \sim \mathcal{N}(0,I). \tag{13} \]
\(\odot\) — element-wise multiplication. \(\sigma_x\) — posterior standard deviation vector. Reparameterization stochastic latent sampling жүргүзүлгөндө gradient-based trainingди улантууга мүмкүндүк берет.
Pretraining маалында sampled latent representation decoder тарабынан input reconstruction үчүн колдонулат. Pretraining бүткөндөн кийин decoder алынып, encoder market-state representation үчүн сакталат.
Теңдеме 14: Эки latent streamди бириктирүү
\[ h_t = \left[ z_t^{tech} \mid z_t^{mkt} \right] \in \mathbb{R}^{D}. \tag{14} \]
\(h_t\) asset-specific жана market-wide latent vectorsдын concatenation натыйжасы. Historical indexing менен online query этабында бир эле representation function колдонулгандыктан current state жана historical state бир latent мейкиндикте салыштырылат.
Эксперимент бөлүмүндө retrieval embedding dimension:
\[ d=64 \]
деп көрсөтүлөт. Булак \(D\) менен бул implementationдагы \(d\) белгисинин ортосундагы нотациялык байланышты өзүнчө кеңири түшүндүрбөйт.
Теңдеме 15: Historical index жазуусу
\[ D_{\tau} = \left( h_{\tau}, R_{\tau}^{(e)}, SoP_{\tau}^{(e)} \right), \qquad e\in\{1,\ldots,E\}. \tag{15} \]
Ар бир тарыхый state жазуусу үч маалымат тобун бириктирет:
- \(h_{\tau}\): historical latent market state,
- \(R_{\tau}^{(e)}\): expert \(e\)нин forward horizon боюнча иш жүзүндөгү performance recordу,
- \(SoP_{\tau}^{(e)}\): ошол эле шарттардагы Statement of Performance.
Теңдеме 16: Эң жакын тарыхый stateтерди тандоо
\[ \mathcal{N}_t = KNN \left( h_t, \{h_{\tau}\}, K \right). \tag{16} \]
Эксперименттерде \(K=3\) колдонулат. Similarity metric cosine similarity. Тест маалында гана:
\[ \tau<t \]
шартын аткарган historical observations retrieval үчүн колдонулат. Бул chronological restriction future information чечим процессине агып киришин алдын алууга багытталган.
Теңдеме 17: Retrieval weight
\[ w_{\tau} = \frac{ sim(h_t,h_{\tau}) }{ \sum_{j\in\mathcal{N}_t} sim(h_t,h_j) }. \tag{17} \]
\(sim(h_t,h_{\tau})\) current state менен historical state ортосундагы cosine similarity мааниси. \(w_{\tau}\) өлчөмсүз normalized retrieval weight.
Математикалык тактык чеги: Cosine similarity теориялык жактан терс да болушу мүмкүн. Булак Eq. 17ге чейин similarity маанилери оң аралыкка кесилеби, softmax колдонулобу же жалпы similarity нөл болгон абал кандай башкарыларын түшүндүрбөйт. Ошондуктан \(w_{\tau}\) бардык шартта классикалык convex weight деп божомолдоо коопсуз эмес.
Теңдеме 18: Similarity-weighted expert performance
\[ \widehat{R}_t^{(e)} = \sum_{\tau\in\mathcal{N}_t} w_{\tau} R_{\tau}^{(e)}. \tag{18} \]
Бул теңдеме retrieved historical episodes ичиндеги expert \(e\) көрсөткүчүн similarity салмактары менен бириктирет. \(\widehat{R}_t^{(e)}\), \(R_{\tau}^{(e)}\) кайсы performance шкаласында аныкталса, ошол шкаланы алып жүрөт.
Булак ичиндеги белгилөө чеги: Offline түшүндүрмөдө performance record ичинде cumulative return, Sharpe ratio жана MDD бар экени айтылат; Eq. 18 болсо \(R_{\tau}^{(e)}\)ни бир математикалык чоңдук катары жазат. Бул метрикалар scalar composite scoreго кантип айландырылганы же Eq. 18 ар бир метрика үчүн component-wise колдонулганбы, булакта так аныкталган эмес.
Алгоритм 1: Оффлайн Режимди Индекстөө жана Эксперттин Көрсөткүчүн Негиздөө
- Ар бир historical time step \(\tau\) үчүн asset-level жана market-wide feature tensors түзүлөт.
- Dual-stream T-VAE менен \(h_{\tau}\) latent embedding эсептелет.
- Ар бир expert \(E^{(e)}\) historical stateтен башталат.
- Expertтин forward horizon \(H\) боюнча иш жүзүндөгү натыйжасы эсептелет.
- Ошол эле episode үчүн Statement of Performance түзүлөт.
- \((h_{\tau},R_{\tau}^{(e)},SoP_{\tau}^{(e)})\) жазуусу historical indexке жазылат.
Алгоритм 2: Онлайн Retrieval жана Портфель Чечимин Кабыл Алуу
- Current market dataдан \(S_t^{tech}\) жана \(S_t^{mkt}\) түзүлөт.
- Dual-stream T-VAE менен \(h_t\) эсептелет.
- Vector databaseден \(K=3\) nearest historical regimes алынат.
- Ар бир expert үчүн similarity-weighted performance estimate эсептелет.
- Algorithm 2 кошумча weighted uncertainty \(\sigma_t^{(e)}\) эсептелерин айтат.
- Retrieved SoPs жана current market context LLMге берилет.
- LLM expert selection чечимине салым кошот жана \(e^*\) аныкталат.
- Тандалган expert \(E^{(e^*)}\) portfolio weights \(w_t\)ни чыгарат.
Кайра өндүрүү чеги: Algorithm 2деги weighted uncertainty \(\sigma_t^{(e)}\) үчүн булак өзүнчө математикалык формула бербейт. Бул боштук Verianla тарабынан жаңы uncertainty estimator кошулуп толтурулган эмес.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперименттик маалымат түзүмү
Изилдөө үч башка каржы market class боюнча daily OHLCV маалыматын колдонот:
- 30 криптовалюта,
- 30 акция,
- 30 валюта жуп.
OHLCV Open, High, Low, Close жана Volume компоненттеринен турган рынок маалыматынын түзүмү. Изилдөөнүн киришинде high-frequency trading контексти айтылганы менен, чыныгы эксперименттер intraday high-frequency data менен эмес, daily OHLCV менен жүргүзүлгөн.
| Параметр | Булак мааниси |
|---|---|
| Рынок классы | Крипто, Акция, Forex |
| Ар бир рыноктогу symbol саны | 30 |
| Киргизүү терезеси \(L\) | 22 соода күнү |
| Кармоо / forward горизонту \(H\) | 5 күн |
| Тарыхый кошуналар \(K\) | 3 |
| Окшоштук | Cosine similarity |
| Latent embedding өлчөмү | 64 |
| LLM температурасы | 0,1 |
| LLM чакыруусу | Ар бир чечимге эң көп 1 |
| Future-leakage чектөөсү | Retrieval \(\tau<t\) менен гана |
| Жабдык | Бир NVIDIA H100 GPU |
| Эксперимент кайталоо саны | Ар бир рынок үчүн 1 run |
Криптовалюта панели
30 криптовалюта символу:
ADA, APT, ARB, ATOM, AVAX, BCH, BNB, BTC, DOGE, DOT, EGLD, ETC, ETH, FIL, HBAR, ICP, LINK, LTC, MATIC, MKR, NEAR, RNDR, SHIB, SOL, TON, TRX, UNI, VET, XLM жана XRP.
Symbol боюнча availability period бирдей эмес. Булак Table 2де эң узун катарлардан BTC жана LTC үчүн 17 Сентябрь 2014–31 Май 2026 аралыгында 4.275 sample билдирсе, APT үчүн 20 Ноябрь 2021–24 Июнь 2025 аралыгында 1.311 sample бар. RNDR, MATIC, UNI жана APT сыяктуу айрым series 2026дан мурда аяктайт.
Cryptocurrency market үчүн бир стандарттуу broad-market benchmark болбогондуктан булак эки synthetic index түзгөн:
- тең салмакталган / салмакталбаган кумулятивдик киреше индекси,
- көлөм боюнча салмакталган кумулятивдик киреше индекси.
Булак equal-weighted raw-price aggregation аз сандагы extreme constituents тарабынан үстөмдүк кылынарын жана ошондуктан volume-weighted variant primary market-level descriptor катары артык көрүлгөнүн билдирет.
Акциялар панели
30 акция:
TMO, MCD, NVDA, DIS, TSLA, CVX, XOM, ACN, V, WMT, KO, LIN, HD, GOOGL, CRM, UNH, BAC, COST, MA, PG, AAPL, JPM, JNJ, MSFT, MRK, META, AMZN, ABBV, BRK-B жана PEP.
Көп stock series 3 Январь 2000–29 Май 2026 аралыгында 6.641 sample камтыйт, кийин коомдук соодага чыккан компанияларда тарых кыскараак. Stock market-level context үчүн S&P 500, NASDAQ Composite жана Dow Jones Industrial Average шилтемелери колдонулган.
Валюта панели
30 forex жуп:
USDCAD, EURAUD, EURCHF, GBPCHF, CHFJPY, NZDCHF, AUDCAD, NZDCAD, GBPUSD, AUDUSD, GBPAUD, USDJPY, GBPJPY, NZDJPY, AUDNZD, EURGBP, USDCHF, EURCAD, AUDJPY, GBPCAD, USDTRY, AUDCHF, EURTRY, EURSEK, GBPNZD, EURUSD, NZDUSD, EURJPY, EURNZD жана CADJPY.
FX үчүн булак бир standard broad-market composite index билдирбейт. Market-wide condition dual-stream encoderдун aggregate market-feature каналынан көрсөтүлөт.
Маалымат булагынын чеги: PDF OHLCV катарлары кайсы market-data provider же APIден жүктөлгөнүн ачык билдирбейт. Ошондуктан Verianla Yahoo Finance, Binance, Alpha Vantage же башка провайдерди божомолдобойт.
Беш reinforcement-learning эксперти
| Эксперт | Булакта берилген негизги роль |
|---|---|
| A2C | Advantage Actor-Critic; synchronous actor-critic policy-gradient ыкмасы. |
| DDPG | Deep Deterministic Policy Gradient; continuous action space үчүн off-policy actor-critic. |
| PPO | Proximal Policy Optimization; policy update көлөмүн чектөө менен training stability камсыздоого багытталган policy-gradient ыкмасы. |
| TQC | Truncated Quantile Critics; reward distributionду quantile critics менен моделдеген distributional reinforcement-learning эксперти. |
| CrossQ | Эксперт pool ичиндеги behavioral diversityни жогорулатуу үчүн кошулган off-policy reinforcement-learning ыкмасы. |
Баалоо метрикалары
Cumulative return баалоо мезгилиндеги топтолгон жалпы портфель кирешесин көрсөтөт.
Annualized return кирешени жылдык масштабга айлантат. Бирок булак колдонгон exact annualization convention өзүнчө формула менен берилбейт.
Annualized volatility return variabilityнин жылдык өлчөмү.
Sharpe ratio кирешени total variability/risk менен байланыштырган risk-adjusted performance метрикасы. Булак колдонулган risk-free rate маанисин жана exact annualization формуласын билдирбейт.
Sortino ratio total variability ордуна downside variabilityге көңүл бурат. Булак target return же minimum acceptable return параметрин өзүнчө билдирбейт.
Maximum Drawdown (MDD) portfolio value peak деңгээлинен кийинки trough деңгээлине чейинки эң чоң төмөндөөнү өлчөйт. Терс маанинин абсолюттук көлөмү азайган сайын drawdown жеңилирээк; мисалы −%22, −%29га караганда аз жоготуу.
Standalone эксперттердин натыйжалары
| Рынок | Эксперт | Cumulative Return | Sharpe | Sortino | MDD | Dominance |
|---|---|---|---|---|---|---|
| Крипто | A2C | %63,00 | 1,61 | 2,44 | −%25 | 19 жума / %34,5 |
| Крипто | DDPG | %71,26 | 1,74 | 2,73 | −%26 | 6 жума / %10,9 |
| Крипто | PPO | %60,49 | 1,57 | 2,38 | −%27 | 3 жума / %5,5 |
| Крипто | CrossQ | %53,66 | 1,44 | 2,24 | −%28 | 9 жума / %16,4 |
| Крипто | TQC | %76,16 | 1,71 | 2,63 | −%29 | 18 жума / %32,7 |
| Акция | A2C | %32,16 | 0,90 | 1,35 | −%23 | 17 жума / %19,3 |
| Акция | DDPG | %28,89 | 0,85 | 1,26 | −%24 | 5 жума / %5,7 |
| Акция | PPO | %33,38 | 0,96 | 1,46 | −%22 | 21 жума / %23,9 |
| Акция | CrossQ | %38,21 | 0,95 | 1,42 | −%27 | 32 жума / %36,4 |
| Акция | TQC | %32,09 | 0,86 | 1,28 | −%26 | 13 жума / %14,8 |
| Forex | A2C | %4,27 | 0,88 | 1,20 | −%2,18 | 6 жума / %6,8 |
| Forex | DDPG | %1,80 | 0,36 | 0,46 | −%2,85 | 12 жума / %13,6 |
| Forex | PPO | %4,07 | 0,88 | 1,20 | −%2,00 | 9 жума / %10,2 |
| Forex | CrossQ | %2,62 | 0,53 | 0,69 | −%2,68 | 18 жума / %20,5 |
| Forex | TQC | %2,26 | 0,48 | 0,60 | −%2,18 | 43 жума / %48,9 |
Натыйжалар expert specialization идеясын колдойт: эң жогорку cumulative return, эң жогорку Sharpe, эң төмөн MDD жана эң көп dominance бир expertте топтолбойт.
Криптодо TQC эң жогорку cumulative returnге (%76,16) ээ болсо, DDPG эң жогорку Sharpe жана Sortinoну (1,74 жана 2,73), A2C эң кичине MDDни (−%25) берет. Акцияда CrossQ эң жогорку cumulative returnге (%38,21), PPO эң жогорку Sharpe/Sortinoго (0,96/1,46) жана эң кичине MDDге (−%22) ээ. Forexте A2C cumulative return боюнча %4,27 менен алдыда; PPO жана A2C Sharpe/Sortino боюнча 0,88/1,20 маанилеринде тең, эң кичине MDD PPO үчүн −%2,00.
Proposed switcher кайсы эксперттерди канчалык көп тандады?
| Эксперт | Крипто | Акция | Forex |
|---|---|---|---|
| A2C | %34,5 | %19,3 | %6,8 |
| TQC | %32,7 | %14,8 | %48,9 |
| CrossQ | %16,4 | %36,4 | %20,5 |
| DDPG | %10,9 | %5,7 | %13,6 |
| PPO | %5,5 | %23,9 | %10,2 |
Бул бөлүштүрүү бир expert бардык marketтерде үстөм эмес экенин көрсөтөт. Крипто рыногунда A2C жана TQC көп тандалса, stock marketте CrossQ, forexте болсо TQC эң жогорку frequency маанисине ээ.
Үч Рынокто Proposed RAG Тандоочусу Кандай Натыйжа Берди?
Булак Table 6 selection-strategy салыштыруусунда Proposed RAG криптодо %71 cumulative return жана 1,73 Sharpe; акцияда %34 жана 0,96; forexте %4,3 жана 0,88 алып, ошол эле таблицадагы Best Fixed жана Recent-Performance Gating стратегияларынан жогору cumulative return жана Sharpe көрсөткөнүн билдирет; бирок натыйжалар ар рынокко бирден run жана Table 5те айрым standalone эксперттердин cumulative return маанилери Proposed RAGдан жогору.
| Рынок | Ыкма | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|---|---|
| Крипто | Best Fixed | %68 | %62 | 0,32 | 1,64 | 2,54 | −%27 |
| Крипто | Recent Gating | %69 | %62 | 0,32 | 1,66 | 2,57 | −%27 |
| Крипто | Proposed RAG | %71 | %64 | 0,31 | 1,73 | 2,72 | −%26 |
| Акция | Best Fixed | %26 | %14 | 0,21 | 0,74 | 1,11 | −%26 |
| Акция | Recent Gating | %33 | %17 | 0,20 | 0,91 | 1,37 | −%24 |
| Акция | Proposed RAG | %34 | %18 | 0,19 | 0,96 | 1,45 | −%26 |
| Forex | Best Fixed | %3,2 | %1,8 | 0,026 | 0,71 | 0,92 | −%1,9 |
| Forex | Recent Gating | −%0,4 | −%0,2 | 0,029 | −0,062 | −0,08 | −%2,6 |
| Forex | Proposed RAG | %4,3 | %2,4 | 0,028 | 0,88 | 1,20 | −%2,2 |
Proposed RAG ар бир risk метрикасы боюнча абсолюттук эң жакшы эмес. Stock marketте Recent Gating MDDси −%24 болсо, Proposed RAG −%26. Forexте Best Fixed MDDси −%1,9, Proposed RAG −%2,2. Ошондуктан булактын “risk-return profile” түшүндүрмөсү cumulative return, Sharpe, Sortino, volatility жана MDDни бирге баалоого таянат; аны “ар бир risk көрсөткүчүндө эң жакшы” деп кеңейтүүгө болбойт.
Table 5 менен Table 6 ортосундагы “Best Fixed” айырмасы
Булак Table 5те standalone expert натыйжаларын жана Table 6да selection strategy натыйжаларын өзүнчө берет. Бирок эки таблица “эң жакшы туруктуу эксперт” боюнча бирдей cumulative return маанисине жетиши күтүлүшү мүмкүн болсо да, маанилер дал келбейт:
| Рынок | Table 5теги эң жогорку standalone return | Table 6 Best Fixed | Table 6 Proposed RAG |
|---|---|---|---|
| Крипто | TQC: %76,16 | %68 | %71 |
| Акция | CrossQ: %38,21 | %26 | %34 |
| Forex | A2C: %4,27 | %3,2 | %4,3 |
Булак бул айырманы башка split, мезгил, portfolio construction, initialization же башка протокол өзгөрмөсү менен түшүндүрбөйт. Ошондуктан бул таблица айырмасынан жаңы механизм чыгарылбашы керек.
Мындан тышкары Section 4.3 тексти “four strategies” деп айтат, бирок дароо андан кийин үч гана strategy аныктайт: Best Fixed Expert, Recent-Performance Gating жана Proposed RAG. Table 6 да ушул үч стратегияны гана камтыйт. Төртүнчү стратегия эмне экени булакта айтылбагандыктан Verianla жаңы baseline кошпойт.
Expert-pool көлөмүнүн абляциясы
| Рынок | Эксперт Саны | Fixed Sharpe | RAG Sharpe | Δ Sharpe |
|---|---|---|---|---|
| Крипто | 1 | 0,81 | 0,81 | %0,0 |
| Крипто | 2 | 0,84 | 0,85 | %1,2 |
| Крипто | 3 | 0,89 | 0,98 | %10,1 |
| Крипто | 4 | 0,96 | 1,15 | %19,8 |
| Акция | 1 | 0,43 | 0,43 | %0,0 |
| Акция | 2 | 0,51 | 0,52 | %2,0 |
| Акция | 3 | 0,55 | 0,63 | %14,5 |
| Акция | 4 | 0,59 | 0,72 | %22,0 |
| Forex | 1 | 0,35 | 0,35 | %0,0 |
| Forex | 2 | 0,43 | 0,44 | %2,3 |
| Forex | 3 | 0,46 | 0,55 | %19,6 |
| Forex | 4 | 0,51 | 0,65 | %27,5 |
Бир expert болгондо switch кылуу мүмкүн эмес болгондуктан RAG жана fixed натыйжа бирдей. Үч жана төрт expertтүү poolдордо improvement өсөт. Булак муну моделдердин саны гана эмес, complementary expertise ар түрдүүлүгү да маанилүү экенине далил катары чечмелейт.
Чектөө: Full system беш expert камтыса да Table 7 болгону 1–4 expert pool натыйжаларын берет. Мындан тышкары эксперттер nested poolга кайсы иретте кошулганы таблицада айтылбайт. Ошондуктан “бешинчи expert кошулса improvement мынча болот” деп extrapolation кылууга болбойт.
Retrieval жана LLM component ablation
| Рынок | Configuration | Cumulative Return | Sharpe | MDD |
|---|---|---|---|---|
| Крипто | NR — No Retrieval | %64,8 | 1,622 | −%26,7 |
| Крипто | R−LLM — No LLM | %69,1 | 1,661 | −%27,1 |
| Крипто | Full — R+L+U | %71 | 1,73 | −%26 |
| Акция | NR — No Retrieval | %33,1 | 0,911 | −%24,4 |
| Акция | R−LLM — No LLM | %25,5 | 0,735 | −%26,5 |
| Акция | Full — R+L+U | %34 | 0,96 | −%26 |
| Forex | NR — No Retrieval | %3,2 | 0,710 | −%1,9 |
| Forex | R−LLM — No LLM | −%0,2 | −0,025 | −%2,4 |
| Forex | Full — R+L+U | %4,3 | 0,88 | −%2,2 |
Retrieval алынып салынганда full configurationга салыштырмалуу cumulative return бардык marketтерде төмөндөйт. LLM алынып салынганда төмөндөө stock жана forex эксперименттеринде көбүрөөк. Мисалы forexте full model %4,3 cumulative return жана 0,88 Sharpe берсе, no-LLM configuration −%0,2 жана −0,025ке түшөт.
Бирок full model ар marketте минималдуу MDD бербейт. Stockта no-retrieval MDD −%24,4 болуп full modelдин −%26 маанисинен кичине; forexте да no-retrieval −%1,9, full model −%2,2.
Маанилүү абляция чеги: Source Table 8 uncertainty-aware componentти өзүнчө алып салган configuration камтыбайт. Ошондуктан retrieval жана LLM reasoning салымдары жөнүндө эксперименттик тыянак чыгарууга болот; uncertainty-aware decision makingтин өз алдынча салымы бул ablation менен өлчөнбөйт.
Индекстөө LLM сезгичтиги
| Indexing LLM | Ийгилик | Ийгиликсиздик |
|---|---|---|
| Google/Gemma4-E4B | %28 | %72 |
| Google/Gemma4-31B-it | %96 | %4 |
| AliBaba/Qwen3.6-27B-it | %100 | %0 |
Бул “success” метрикасы инвестициялык киреше эмес. Булак аны indexing instructionsты аткарып, күтүлгөн structured output форматын туура чыгаруу ийгилиги деп аныктайт.
Inference LLM сезгичтиги
| Рынок | Inference LLM | Cum. Return | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|
| Крипто | Google/Gemma4-31B-it | %68,3 | 1,65 | 2,55 | −%27 |
| Крипто | Google/Gemma4-E4B | %63,5 | 1,57 | 2,42 | −%28 |
| Крипто | AliBaba/Qwen3.6-27B-it | %71 | 1,73 | 2,72 | −%26 |
| Акция | Google/Gemma4-31B-it | %25,1 | 0,73 | 1,09 | −%26,5 |
| Акция | Google/Gemma4-E4B | %24,5 | 0,71 | 1,06 | −%27 |
| Акция | AliBaba/Qwen3.6-27B-it | %34 | 0,96 | 1,45 | −%26 |
| Forex | Google/Gemma4-31B-it | −%0,3 | −0,05 | −0,06 | −%2,5 |
| Forex | Google/Gemma4-E4B | −%5,4 | −1,07 | −1,37 | −%5,6 |
| Forex | AliBaba/Qwen3.6-27B-it | %4,3 | 0,88 | 1,20 | −%2,2 |
Булакта AliBaba/Qwen3.6-27B-it үч marketте тең эң күчтүү inference resultтарды берет. Айрыкча forexте LLM тандоосу натыйжага чоң айырма жараткан. Бул табылга retrieval механизми жалгыз жетишсиз экенин, retrieved evidence downstream reasoning model тарабынан кандай иштетилгени да маанилүү экенин көрсөтөт.
State-of-the-art ыкмалар менен салыштыруу
| Рынок | Ыкма | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | MDD |
|---|---|---|---|---|---|---|
| Крипто | TAC | %24 | %21,6 | 0,94 | 1,29 | −%31 |
| Крипто | AlphaMixRL | %22 | %19,8 | 1,00 | 1,38 | −%29 |
| Крипто | LLM-MAS | %33 | %30 | 0,96 | 1,50 | −%28 |
| Крипто | Proposed | %71 | %64 | 0,31 | 1,73 | −%26 |
| Акция | TAC | %10,4 | %5,6 | 0,25 | 0,74 | −%28 |
| Акция | AlphaMixRL | %11,8 | %6,3 | 0,31 | 0,82 | −%27 |
| Акция | Multi-LLM Black–Litterman | %31 | %16,4 | 0,28 | 0,91 | −%29 |
| Акция | Proposed | %34 | %18 | 0,19 | 0,96 | −%26 |
| Forex | TAC | %0,7 | %0,4 | 0,45 | 0,61 | −%5,1 |
| Forex | AlphaMixRL | %0,8 | %0,45 | 0,50 | 0,68 | −%4,6 |
| Forex | Fine-tuned LLaMA | %3,3 | %1,9 | 0,08 | 0,76 | −%3,1 |
| Forex | Proposed | %4,3 | %2,4 | 0,03 | 0,88 | −%2,2 |
Булак Table 11де Proposed framework үч marketте тең эң жогорку cumulative return жана Sharpe маанисин берет. Бирок авторлор жыйынтык бөлүмүндө competing implementations дайыма толугу менен бирдей experimental protocol астында иштетилбегенин ачык айтышат. Ошондуктан Table 11 көзөмөлдөнгөн benchmark салыштыруусу катары бааланганда протокол теңдиги боюнча этияттык керек.
Изилдөө колдогон жыйынтыктар
- Каралган expert pool ичинде эксперттердин салыштырма артыкчылыгы market жана метрикага жараша өзгөргөн.
- Table 6 алкагында retrieval-based Proposed RAG үч marketте тең Best Fixed жана Recent Gatingден жогору cumulative return жана Sharpe берген.
- Retrievalды алып салуу үч marketте тең full configurationга салыштырмалуу cumulative returnду азайткан.
- LLM reasoningди алып салуу айрыкча stock жана forex эксперименттеринде олуттуу көрсөткүч төмөндөшү менен байланышкан.
- Expert-pool ablation complementary expert саны көбөйгөн сайын билдирилген Sharpe improvement 1–4 expert аралыгында өскөнүн көрсөткөн.
- Inference LLM тандоосу натыйжаларды олуттуу өзгөртүп, Qwen3.6-27B-it сыналган үч моделдин ичинен эң күчтүү натыйжа берген.
- Булактын математикалык теоремасы Axiom 1–3 астында ылайыктуу specialist кошуу expected utilityни азайтпай турганына кепилдик берет.
Изилдөө колдобогон жалпылоолор
- Сунушталган ыкма чыныгы акча менен жандуу рынокто ошол эле кирешени берет деп далилденген эмес.
- %71, %34 жана %4,3 cumulative return келечектеги инвестициялык кирешеге кепилдик эмес.
- LLM өз алдынча ийгиликтүү trader катары текшерилген эмес; изилдөөдө LLM expert-routing ролунда.
- Монотондук теорема Axiom 1–3 аткарылбаса expert кошуу көрсөткүчтү төмөндөтө албайт деп айтпайт.
- Table 6 Proposed RAG бардык standalone expertтерден жогорку cumulative return берет деп далилдебейт.
- Бир experimental run статистикалык ишеним аралыгы же random-seed robustness далили эмес.
- Component ablation uncertainty-aware механизмдин өз алдынча салымын өлчөбөгөн.
- Үч marketтеги натыйжалар бардык рынокторго, бардык мезгилдерге же башка transaction-cost чөйрөлөрүнө автоматтык жалпыланбайт.
- Өткөндө окшош latent state табылышы келечекте ошол эле рынок динамикасы кайталанарына кепилдик бербейт.
Булакта жетишпеген же кайра өндүрүү боюнча белгисиз маалыматтар
Market-data provider: Билдирилбейт.
Exact train / validation / test calendar split: Chronological retrieval жана \(\tau<t\) чектөөсү берилген; бирок бардык marketтер үчүн так башталыш-аяктоо даталары көрсөтүлгөн train/validation/test split таблицасы берилген эмес.
Transaction-cost мааниси: SOTA салыштыруусу бирдей transaction-cost assumptions астында жүргүзүүгө аракет кылынганы айтылат; сандык fee/slippage мааниси билдирилбейт.
Portfolio constraints: Бирдей constraints колдонууга аракет кылынганы айтылат; long-only, leverage, short-selling, cash allocation же weight bound маанилери так тизмеленбейт.
RL expert training hyperparameters: A2C, DDPG, PPO, TQC жана CrossQ аттары жана ыкма класстары берилет; ар бир моделдин learning rate, batch size, optimizer, network depth, reward function жана башка training жөндөөлөрү бул PDFде толук reproducibility table түрүндө берилген эмес.
Weighted uncertainty: Algorithm 2 ичинде \(\sigma_t^{(e)}\) эсептелерин айтат; формуласы берилбейт.
Теорема параметрлери: \(\epsilon\), \(\tau\) жана \(\delta\) теориялык шарт катары аныкталат; эксперименттерде колдонулган сандык маанилери берилбейт.
Prompt validation set: Беш prompt iteration билдирилген; validation sample size жана толук мезгил бөлүштүрүлүшү көрсөтүлбөйт.
Expert-pool ablation: Беш эксперттүү full pool болсо да Table 7 болгону 1–4 expert натыйжаларын берет жана эксперттер nested poolга кайсы иретте кошулганын түшүндүрбөйт.
Statistical significance: Көп random seed, confidence interval, p-value же formal hypothesis test билдирилбейт.
Public code repository: Жүктөлгөн PDFде текшерилген public code repository шилтемеси берилбейт.
Изилдөөнүн күчтүү жактары
Изилдөөнүн күчтүү жагы expert routing чечимин акыркы бир нече күндүк performanceга гана байлабастан, тарыхый жактан окшош market states ичиндеги иш жүзүндөгү expert behavior менен негиздеши. Бул ыкма retrieval системин жөн гана маалымат алып келген жардамчыдан portfolio expert selection механизминин негизги бөлүгүнө айлантат.
Экинчи маанилүү күчтүү жак LLMдин милдетин чектөө. LLM түздөн-түз portfolio weights чыгарбайт; retrieved evidenceти чечмелеген coordination/routing layer катары колдонулат. Бул айырма LLMди numerical trading policy ордуна contextual reasoning ролунда баалоого мүмкүндүк берет.
Үчүнчү күчтүү жак үч башка financial market class боюнча бирдей \(L=22\), \(H=5\), \(K=3\) retrieval протоколунун колдонулушу жана expert heterogeneity, pool size, retrieval, LLM choice жана indexing quality үчүн ар кандай ablation/sensitivity анализдеринин жүргүзүлүшү.
Негизги чектөөлөр
Эң маанилүү чектөө ар бир market үчүн бир гана experimental run жүргүзүлгөнү. Ошондуктан random initialization же stochastic training таасирлеринин натыйжа бөлүштүрүлүшү белгисиз.
Экинчи чектөө competing SOTA methods бардык учурда толугу менен бирдей experimental protocol астында ишке ашырылбаганы. Бул Table 11дин түздөн-түз ыкма артыкчылыгы жөнүндөгү тыянагын этият чечмелөөнү талап кылат.
Үчүнчү чектөө exact transaction-cost, portfolio constraints, data provider жана маанилүү RL training hyperparameters сыяктуу reproduction үчүн зарыл айрым деталдардын булакта ачык болбогону.
Төртүнчү чектөө retrieval жана LLM components үчүн ablation болгону менен uncertainty-aware mechanism өзүнчө алынып салынган ablation жоктугу.
Бешинчи чектөө historical similarity келечекте да ошол эле expert suitability байланышын сактайт деген божомол рынок түзүмүндөгү таптакыр жаңы structural breaks маалында иштебей калышы мүмкүн. Булак ыкмасы empirical historical grounding менен бул тобокелдикти азайтууга аракет кылса да unseen regime көйгөйү толугу менен жок кылынган эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Regime-Aware Portfolio Management via Retrieval-Augmented LLM-Guided Expert Switching
Авторлор: Ahmad Asadi; Reza Safabakhsh.
Авторлордун ирети: Булактагы ирет сакталган.
Мекеме: Deep Learning Lab, Computer Engineering Department, Amirkabir University of Technology, Hafez Avenue, Tehran, Iran.
Жүктөлгөн булак: arXiv:2608.28252v1 [cs.AI].
arXiv жөнөтүлгөн күнү: 28 Август 2026.
PDFде көрүнгөн дата: 31 Август 2026.
Булак түрү: Preprint.
Рецензиялоо абалы: Жүктөлгөн arXiv v1 рецензияланган журналдын Version of Record версиясы эмес. 21 Ноябрь 2026га карата текшерүүгө болгон актуалдуу библиографиялык жазууларда рецензияланган journal version табылган эмес.
Жаңыраак библиографиялык версия: Ошол эле аталыштагы 47 беттик SSRN версиясы 23 Октябрь 2026да жарыяланган. SSRN suggested citation DOIси 10.2139/ssrn.7661576. Verianlaнын илимий мазмуну жүктөлгөн arXiv v1 боюнча даярдалган; кийинки SSRN версиясынын жаңы илимий мазмуну бул макалага аралаштырылган эмес.
Corresponding / contact author: Жүктөлгөн arXiv PDFде corresponding-author белгиси ачык берилген эмес. Кийинки SSRN библиографиялык жазуусу Reza Safabakhshты Contact Author деп көрсөтөт.
Тең салым: Жүктөлгөн булакта equal contribution билдирүүсү көрүнбөйт.
Булак лицензиясы: Жүктөлгөн arXiv v1де Verianlaга булак фигураларын түздөн-түз кайра колдонууга уруксат берерин так ырастаган ачык Creative Commons лицензиясы текшерилген эмес. Ошондуктан булак фигуралары сөзмө-сөз колдонулган жок, илимий байланыштар көз карандысыз схема катары кайра курулган.
Каржылоо: Жүктөлгөн PDFде өзүнчө funding declaration табылган эмес.
Кызыкчылыктардын кагылышы: Жүктөлгөн PDFде өзүнчө conflict-of-interest / competing-interest declaration табылган эмес.
Маалымат жеткиликтүүлүгү: Жүктөлгөн PDFде өзүнчө Data Availability бөлүмү же текшерилген public dataset repository шилтемеси жок.
Код жеткиликтүүлүгү: Жүктөлгөн PDFде текшерилген public source-code repository шилтемеси жок.
Негизги ыкма: Dual-stream Transformer-VAE market-state representation + chronological vector retrieval + Statement of Performance + instruction-tuned LLM guided expert switching + reinforcement-learning expert pool.
Expert pool: A2C, DDPG, PPO, TQC жана CrossQ.
Marketтер: Cryptocurrency, stock жана foreign exchange; ар marketте 30 symbol.
Маалымат жыштыгы: Daily OHLCV.
Киргизүү терезеси: \(L=22\) соода күнү.
Forward / кармоо горизонту: \(H=5\) күн.
Retrieval: \(K=3\) эң жакын тарыхый абал, cosine similarity.
Embedding өлчөмү: \(d=64\).
LLM температурасы: 0,1.
LLM чакыруу чеги: Ар decision step үчүн эң көп бир чакыруу.
Leakage көзөмөлү: Тест маалында retrieval гана \(\tau<t\) historical observations менен чектелген.
Жабдык: Бир NVIDIA H100 GPU.
Эксперимент кайталанышы: Ар market үчүн бир run; натыйжалар repeated-seed averages эмес.
Статистикалык чек: Confidence interval, formal significance test жана көп random-seed бөлүштүрүлүшү билдирилбейт.
Теориялык натыйжа: Monotonic Expert-Pool Performance натыйжасы bounded estimation error, conservative switching жана specialist dominance assumptions шарттарында гана жарактуу; чыныгы рынок кирешеси үчүн шартсыз кепилдик эмес.
Булак ичиндеги маанилүү отчет айырмасы: Table 5 standalone expert cumulative return маанилери менен Table 6 “Best Fixed” маанилери дал келбейт жана булак айырманын себебин түшүндүрбөйт. Мындан тышкары Section 4.3 төрт strategy салыштырылат десе, үч гана strategy аныктайт.
Кайра өндүрүү боштуктары: Exact market-data provider, calendar-based train/validation/test split, transaction-cost мааниси, portfolio constraints, көптөгөн RL training hyperparameter, weighted-uncertainty формуласы, сандык \(\epsilon/\tau/\delta\) маанилери жана prompt-validation-set көлөмү билдирилбейт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген