


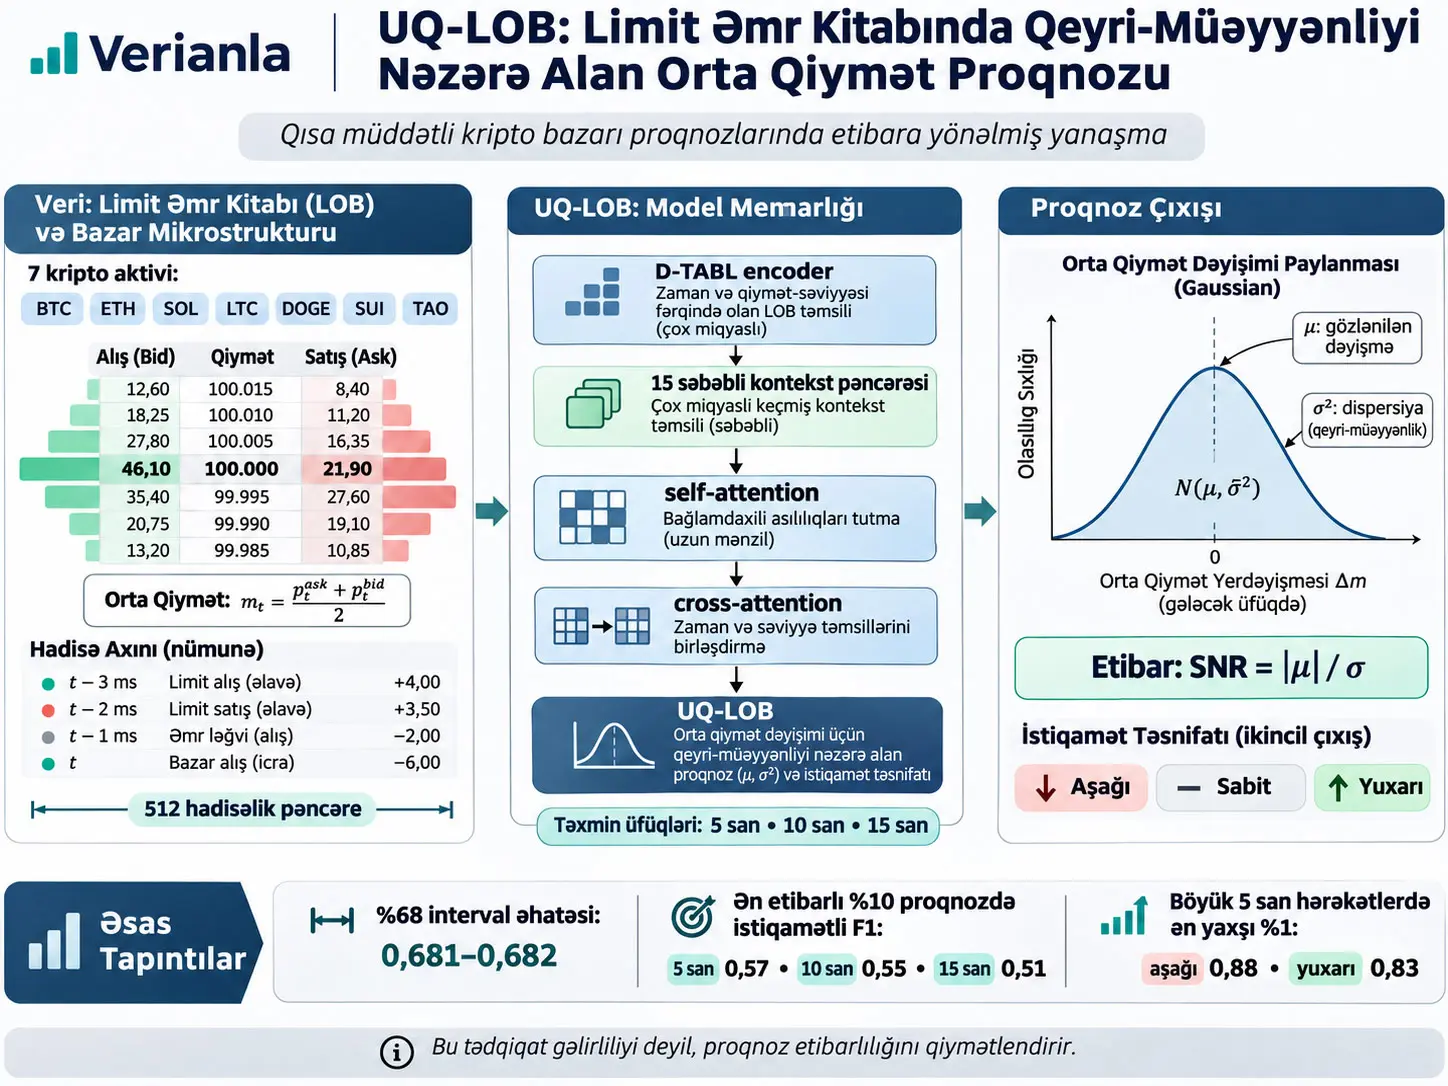
UQ-LOB, əvvəlcədən təlimləndirilmiş limit əmr kitabı (Limit Order Book, LOB) encoder-ının gizli təmsilinin üzərinə əlavə edilən, proqnozun yalnız istiqamətini və ya qiymət dəyişməsini deyil, proqnozun nə dərəcədə etibarlı olduğunu da modelləşdirən encoder-agnostic qeyri-müəyyənliyin kəmiyyətləşdirilməsi moduludur. Tədqiqatda UQ-regression gələcək orta qiymət dəyişməsi üçün \(\mathcal{N}(\mu,\sigma^2)\) formasında Gaussian predictive distribution yaradır, UQ-classification isə aşağı, yuxarı və stasionar siniflər üçün categorical distribution yaradır. UQ-regression-ın etibar ölçüsü \(|\mu|/\sigma\) signal-to-noise ratio (SNR), UQ-classification-ın etibar ölçüsü isə ən yüksək softmax class probability dəyəridir.
Tədqiqat Kraken cryptocurrency exchange-in public market-data API-sindən toplanmış təxminən 5,2 milyard Level-2 və Level-3 order-book hadisəsindən istifadə edir. Bitcoin, Ethereum, Solana, Litecoin, Dogecoin, Sui və Bittensor olmaqla yeddi USD-quoted asset ayrıca 5, 10 və 15 saniyəlik proqnoz üfüqlərində modelləşdirilmişdir. Hər input 512 ardıcıl order-book hadisəsindən ibarətdir. Model target window-dan əvvəl tamamlanmış və nəticələri proqnoz anında artıq baş vermiş 15 context window-dan istifadə edərək cari bazar rejiminə gradient update etmədən uyğunlaşmağa çalışır.
UQ-regression-ın nominal %68 predictive interval-ı testdə %68,1–68,2 empirik coverage təmin edərək nominal səviyyəyə çox yaxın qalmışdır. Buna qarşılıq nominal %95 interval yalnız %90,4–90,7 coverage təmin etmiş və modelin paylanmanın ağır quyruqlarını Gaussian fərziyyəsi ilə yetərincə əhatə edə bilmədiyini göstərmişdir. Confidence gating ilə yalnız ən etibarlı %10 proqnoz saxlandıqda directional macro F1 UQ-regression üçün 5 saniyədə 0,42-dən 0,57-yə, 10 saniyədə 0,41-dən 0,55-ə və 15 saniyədə 0,40-dan 0,51-ə yüksəlmişdir.
Böyük faktiki hərəkətlərdə, yəni faktiki displacement böyüklüyünün yuxarı üçdə bir hissəsinə daxil olan nümunələrdə, UQ-regression-ın ən etibarlı %1-lik təbəqəsi 5 saniyədə aşağı istiqamət üçün 0,88 və yuxarı istiqamət üçün 0,83 F1 əldə etmişdir. Lakin tədqiqat real trading profitability, net return, transaction-cost-adjusted P&L və ya canlı execution performansını ölçmür. Nəticələr qısamüddətli qiymət istiqaməti və displacement proqnozunun etibarlılığı ilə məhdudlaşır.
UQ-LOB Nədir və Nöqtə Proqnozundan Necə Fərqlənir?
UQ-LOB, bir LOB encoder-ının tək bir qiymət istiqaməti və ya displacement dəyəri yaratmasına əlavə olaraq proqnozun ehtimal paylanmasını və nümunəyə məxsus qeyri-müəyyənliyini hesablayan uncertainty-quantification head-dir; UQ-regression gələcək tick displacement üçün \(\mu\) və \(\sigma^2\) yaradır, UQ-classification isə üç directional class üçün ehtimal paylanması yaradır.
Limit əmr kitabı və orta qiymət nədir?
Limit Order Book elektron bazarda hələ icra olunmamış alış və satış əmrlərini qiymət səviyyələrinə görə saxlayan bazar mexanizmidir. Ən yüksək alış qiyməti best bid, ən aşağı satış qiyməti best ask adlanır. Bu iki qiymət arasındakı fərq spread-dir.
Tədqiqatın proqnozlaşdırmağa çalışdığı mid-price, best bid ilə best ask arasındakı orta nöqtədir. Konseptual olaraq:
\[ p_{\mathrm{mid}} = \frac{p_{\mathrm{bid}}+p_{\mathrm{ask}}}{2}. \]
Bu tənlik məqalənin nömrələnmiş tədqiqat tənliklərindən biri deyil; oxucunun mid-price anlayışını başa düşməsi üçün verilmiş əsas tərifdir.
Niyə yalnız qiymət istiqaməti kifayət etmir?
Bir model “qiymət yuxarı gedəcək” deyə bilər; lakin iki ayrı proqnoz eyni istiqaməti göstərsə də, onların etibarlılığı eyni olmaya bilər. UQ-LOB bu problemi input-dependent aleatoric uncertainty vasitəsilə nəzərdən keçirir. Aleatoric uncertainty burada bazar müşahidəsinin özündə olan nümunəyə məxsus qeyri-müəyyənliyi təmsil edir. Bu tədqiqat epistemic uncertainty-ni, yəni model parametrlərinin bilinməməsini birbaşa modelləşdirmir.
UQ-regression bir point estimate əvəzinə:
\[ y^t \mid h^t,\mathcal{C} \sim \mathcal{N}(\mu,\sigma^2) \]
formasında predictive distribution yaradır. \(\mu\) proqnozlaşdırılan tick displacement-ın mərkəzi dəyəridir; \(\sigma\) isə proqnozun qeyri-müəyyənliyini ifadə edir.
Context set niyə istifadə olunur?
Maliyyə microstructure hətta eyni gün ərzində dəyişə bilər. UQ-LOB target prediction-ı yalnız target hidden representation üzərindən etmək əvəzinə yaxın keçmişdə tamamlanmış və outcome-ları proqnoz anında artıq məlum olan nümunələri context kimi istifadə edir.
Bir target instance ümumilikdə:
\[ N=C+1 \]
window ehtiva edir. Tədqiqatda:
\[ C=15, \qquad N=16. \]
Yəni 15 context window və 1 withheld target window birlikdə işlənir.
Tənlik 1: Future leakage-in qarşısını alan causal context şərti
\[ e_i^c = t_i^c+d+h \le t, \qquad \forall i\in\{1,\ldots,C\}. \tag{1} \]
Nəyi hesablayır? Bir context window-un outcome label-ının target prediction anı olan \(t\)-dən əvvəl həqiqətən baş verib-vermədiyini yoxlayır.
\(t_i^c\): context window-un son event zamanı.
\(d\): execution latency; eksperimentdə 0,0005 saniyədir.
\(h\): prediction horizon; əsas eksperimentlərdə 5, 10 və ya 15 saniyədir.
\(e_i^c\): context label-ın tam baş verdiyi zaman.
Yalnız input window-un target-dan əvvəl gəlməsi kifayət deyil. Context-in label horizon-u \(t\)-ni keçərsə gələcək məlumat proqnoza sıza bilər. Tənlik 1 bunun qarşısını alır.
Tənlik 2: Context representation
Hidden representations əvvəlcə ortaq projection space-ə keçirilir. Context label asset/horizon-specific \(y_{\mathrm{ref}}\) ilə miqyaslanır və tanh-bounded projection-dan keçirilir.
Hər context point:
\[ r_i = \mathrm{MLP}_{\mathrm{enc}} \left( [\tilde{h}_i^c;y_i^{\mathrm{proj}}] \right), \qquad i=1,\ldots,C. \tag{2} \]
formasında context representation-a çevrilir.
\(\tilde{h}_i^c\), encoder hidden representation-ın projected formasıdır. \(y_i^{\mathrm{proj}}\), reallaşmış context label-ın miqyaslanmış və projected formasıdır. Kvadrat mötərizələr concatenation mənasını verir.
Tənlik 3: Target-ın context-ə cross-attention tətbiq etməsi
Self-attention context set daxilindəki \(r_i\) dəyərlərini bir-birinə nisbətən yenidən çəkiləndirdikdən sonra target embedding query kimi context-i oxuyur:
\[ r^t = \operatorname{softmax} \left( \frac{qK^\top}{\sqrt{d_r}} \right)V. \tag{3} \]
Burada:
\[ q=W_q\tilde{h}^t, \qquad k_i=W_k\tilde{h}_i^c, \qquad v_i=r_i^{\mathrm{ref}}. \]
\(K\), context key-lərini; \(V\), refined context values-larını sətirlər üzrə bir araya gətirir. \(d_r=256\) attention dimension-dır.
Bu mexanizmin alqoritmik mənası belədir: bütün keçmiş context window-lar bərabər qəbul edilmir. Target representation-a daha uyğun context strukturları daha yüksək attention ala bilər.
UQ-LOB Arxitekturasında Regression və Classification Necə Ayrılır?
UQ-regression və UQ-classification eyni D-TABL encoder, projection, context encoder, self-attention və cross-attention trunk-ını paylaşır; yalnız son decoder dəyişir: regression decoder \(\mu\) və variance parametrini yaradır, classification decoder isə down/up/stationary üçün üç logit yaradır.
Tənlik 4: Regression decoder-ın variance yaratması
\[ [\mu,\nu] = \mathrm{MLP}_{\mathrm{dec}} ([r^t;\tilde{h}^t]), \qquad \sigma^2 = y_{\mathrm{ref}}^2 \operatorname{softplus}(\nu) + \epsilon. \tag{4} \]
\(\mu\), predicted tick displacement; \(\nu\), decoder-ın variance üçün yaratdığı xam parametr; \(\sigma^2\), müsbət predictive variance; \(y_{\mathrm{ref}}\), asset/horizon-specific tick scale və \(\epsilon=10^{-8}\) numerical stability floor dəyəridir.
Softplus istifadəsi variance-ın mənfi olmasının qarşısını alır. \(y_{\mathrm{ref}}^2\) variance-ı müvafiq asset və horizon-un tick miqyasına geri daşıyır.
Tənlik 5: UQ-regression-ın ümumi itkisi
\[ \mathcal{L}_{\mathrm{reg}} = \lambda_1\mathcal{L}_{\mathrm{NLL}} + \lambda_2\mathcal{L}_{\mathrm{WMAE}} + \lambda_3\mathcal{L}_{\mathrm{dir}} + \lambda_4\mathcal{L}_{\mathrm{calib}}. \tag{5} \]
Mənbədə istifadə olunan çəkilər:
\[ (\lambda_1,\lambda_2,\lambda_3,\lambda_4) = (1.0,0.1,0.5,0.5). \]
Dörd terminin funksiyaları bir-birindən fərqlidir: NLL mean və variance-ı probabilistically öyrənir; WMAE böyük displacement-ların təsirini artırır; directional loss istiqamət sinfini dəstəkləyir; calibration loss isə predicted uncertainty-nin reallaşmış residual böyüklüyü ilə uyğunluğunu məcbur edir.
Heteroscedastic Gaussian NLL
\[ \mathcal{L}_{\mathrm{NLL}} = \mathbb{E} \left[ \frac{1}{2}\log(2\pi\sigma^2) + \frac{(y-\mu)^2}{2\sigma^2} \right]. \]
Heteroscedastic, \(\sigma\)-nın hər input üçün eyni sabit dəyər olmaması deməkdir. Model bəzi window-larda aşağı, bəzilərində yüksək uncertainty yarada bilər.
Bu quruluşun məlum problemlərindən biri loss attenuation-dır. Model çətin nümunələrdə \(\sigma\)-nı böyüdərək squared residual cəzasını azalda bilər. Çünki:
\[ \frac{\partial\mathcal{L}_{\mathrm{NLL}}}{\partial\mu} \propto \frac{1}{\sigma^2}. \]
\(\sigma\) həddindən artıq böyüsə, \(\mu\)-ya çatan gradient kiçilə bilər. Mənbə WMAE və directional loss-u qismən bu problemə qarşı istifadə edir.
Tənlik 6: Magnitude-weighted MAE
\[ \mathcal{L}_{\mathrm{WMAE}} = \mathbb{E} \left[ w(y) \frac{|\mu-y|}{y_{\mathrm{ref}}} \right], \tag{6} \]
\[ w(y) = \min \left( 1+ \left( \frac{|y|}{y_{\mathrm{ref}}} \right)^p, w_{\max} \right). \]
Mənbədə:
\[ p=4, \qquad w_{\max}=40. \]
Displacement böyüdükcə \(w(y)\) artır; beləliklə böyük qiymət hərəkətlərinin regression error-u kiçik hərəkətlərdən daha yüksək çəki alır. \(w_{\max}=40\), həddən artıq ekstremal nümunələrin təkbaşına loss-u dominant etməsini məhdudlaşdırır.
Tənlik 7: Directional loss
\[ \mathcal{L}_{\mathrm{dir}} = \mathbb{E} \left[ \mathbf{1}[|y_i|\ge\delta_i] \left( \tilde{\mu}_i-\operatorname{sign}(y_i)m \right)^2 + \mathbf{1}[|y_i|\lt\delta_i] \left| \tilde{\mu}_i-\operatorname{sign}(y_i)m \right| \right]. \tag{7} \]
Burada:
\[ \tilde{\mu}_i=\frac{\mu_i}{y_{\mathrm{ref}}}, \qquad m=1. \]
\(\delta_i\), müvafiq asset, horizon və window üçün directional/stationary threshold-dur.
Faktiki displacement directional threshold-u keçdikdə quadratic penalty tətbiq olunur və predicted mean düzgün işarəli \(\pm m\) hədəfinə doğru daha güclü çəkilir. Stationary nümunələrdə linear penalty istifadə edilir; beləliklə sign məlumatı qorunur, lakin magnitude üzərində eyni sərt çəkmə tətbiq edilmir.
Tənlik 8: Magnitude-conditional calibration loss
\[ \mathcal{L}_{\mathrm{calib}} = \frac{1}{B} \sum_{b=1}^{B} \left( \mathbb{E}_{i\in\mathcal{B}_b} \left[ \frac{|\mu_i-y_i|}{\sigma_i} \right] - \sqrt{\frac{2}{\pi}} \right)^2. \tag{8} \]
Mənbədə:
\[ B=3. \]
\(\mathcal{B}_b\), predicted magnitude \(|\mu|\) dəyərlərinə görə yaradılan quantile bin-ləridir. Standard normal:
\[ Z\sim\mathcal{N}(0,1) \]
üçün:
\[ \mathbb{E}|Z| = \sqrt{\frac{2}{\pi}}. \]
Kalibrə edilmiş Gaussian modeldə standardised absolute residual-ın gözlənilən dəyəri bu hədəfə yaxınlaşmalıdır. Loss bunu yalnız qlobal olaraq deyil, predicted magnitude təbəqələrində ayrıca məcbur edir.
UQ-classification loss
Classification decoder üç class üçün weighted cross-entropy istifadə edir:
\[ \mathcal{L}_{\mathrm{cls}} = - \sum_{c=0}^{2} w_c \mathbf{1}[y_{\mathrm{cls}}=c] \log p_c. \]
Class weight:
\[ w_c\propto\frac{1}{f_c}, \qquad \sum_c w_c=3. \]
\(f_c\), training split daxilindəki class frequency-dir. Nadir class daha yüksək weight alır.
SNR ilə Seçici Proqnoz Nə Deməkdir?
UQ-regression-da confidence \(SNR=|\mu|/\sigma\) kimi müəyyən edilir; model yalnız yüksək SNR-li proqnozları saxladıqda həm predicted displacement böyüklüyü yüksək, həm də predicted uncertainty nisbətən aşağı olan nümunələr seçilir; bununla coverage azalarkən qalan proqnozların directional reliability-si yüksəlir.
Regression confidence
\[ SNR = \frac{|\mu|}{\sigma}. \]
Böyük \(|\mu|\) və kiçik \(\sigma\) yüksək SNR yaradır. SNR ölçüsüzdür, çünki numerator və denominator eyni tick-displacement vahidindədir.
Classification confidence
\[ Confidence_{\mathrm{cls}} = \max_c p_c. \]
Classification üçün modelin ən yüksək softmax probability dəyəri confidence kimi istifadə olunur.
Percentile gating
Confidence percentile \(q\), test set-dəki ən etibarlı:
\[ (100-q)\% \]
proqnozu saxlayır.
Məsələn:
\[ q=90 \]
sətri proqnozların ən etibarlı %10-unun qiymətləndirildiyi deməkdir.
Niyə üç sinifli macro F1 əvəzinə directional macro F1 istifadə olunur?
Confidence gating yüksək-magnitude prediction-ları seçdiyinə görə retained subset daxilində stationary prediction nisbəti sürətlə azalır. Buna görə stationary F1, model directional prediction-da yaxşılaşsa belə, sıfıra yaxınlaşa bilər.
Mənbə buna görə:
\[ F1_{\mathrm{directional}} = \frac{ F1_{\mathrm{down}} + F1_{\mathrm{up}} }{2} \]
ölçüsünü əsas gating metrikası kimi istifadə edir.
Full test set üçün prior-matched random classifier-ın gözlənilən directional macro F1 dəyəri:
\[ \frac{1-p_{\mathrm{stat}}}{2}. \]
Lakin gating class composition-ı dəyişdirdiyinə görə full-set random reference gated subset-lərə birbaşa daşına bilməz.
Predictive interval coverage
Nominal %68 interval üçün:
\[ cov_{68} = \Pr \left[ |y-\mu| \le \sigma \right]. \]
Nominal %95 interval üçün:
\[ cov_{95} = \Pr \left[ |y-\mu| \le 1.96\sigma \right]. \]
Tənlik 9: Magnitude-weighted \(R^2\)
\[ R_w^2 = 1- \frac{ \sum_i w_i(y_i-\mu_i)^2 }{ \sum_i w_i(y_i-\bar{y}_w)^2 }, \tag{9} \]
\[ \bar{y}_w = \frac{ \sum_i w_i y_i }{ \sum_i w_i }. \]
Buradakı \(w_i=w(y_i)\), Tənlik 6-dakı magnitude weight-dir. Buna görə böyük displacement-lar standard \(R^2\)-yə nisbətən daha yüksək təsir qazanır.
Order-book input hansı məlumatları ehtiva edir?
Hər event bir discrete token və yeddi continuous feature ilə təmsil olunur. Token vocabulary ümumilikdə 439 entry-dir və beş categorical attribute-dan yaradılır:
- event type,
- side,
- discretised volume,
- opposing best quote-a görə discretised price distance,
- simultaneity flag.
Order-book depth üçün:
\[ L_{\max}=10. \]
Daha dərin event-lər atılır.
Yeddi continuous feature:
- log inter-event time,
- opposing best quote-a görə log tick distance,
- log relative volume,
- DNFI,
- son 50 event üzrə cumulative DNFI,
- son 200 event üzrə cumulative DNFI,
- QI.
Tənlik 10: Depth-normalised flow imbalance və queue imbalance
\[ \mathrm{DNFI}_t = \frac{ \Delta Q_{1,t}^{b} - \Delta Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1], \]
\[ \mathrm{QI}_t = \frac{ Q_{1,t}^{b} - Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1]. \tag{10} \]
\(Q_{1,t}^{b}\), best bid səviyyəsindəki resting queue size; \(Q_{1,t}^{a}\), best ask səviyyəsindəki resting queue size-dır.
DNFI queue size-ın əvvəlki event-ə nisbətən dəyişməsindən istifadə edir və dinamik order-flow pressure-ı təmsil edir. QI isə eyni anda book üzərində duran bid və ask liquidity arasındakı statik asimmetriyanı göstərir.
D-TABL encoder
Tədqiqatda UQ-LOB-un encoder-agnostic olduğu bildirilsə də, eksperimental implementation yalnız D-TABL encoder ilə aparılmışdır. D-TABL, Temporal Attention-Augmented Bilinear Network strukturunun 512-event input-a uyğunlaşdırılmış daha dərin variantıdır.
Orijinal C(TABL) strukturundakı iki BL layer əvəzinə üç BL layer istifadə edilmiş və ardınca terminal TABL layer əlavə olunmuşdur.
Tənlik 11: Bilinear layer
\[ Y = \phi \left( W_1 X W_2+B \right). \tag{11} \]
\[ X\in\mathbb{R}^{D\times T} \]
input matrix-dir. \(W_1\) feature axis-i, \(W_2\) temporal axis-i project edir. \(B\) learned bias, \(\phi\) isə ReLU activation-dır.
Tənlik 12: Temporal attention-augmented bilinear çevrilmə
Əvvəlcə:
\[ \bar{X}=W_1X \]
hesablanır. Attention score:
\[ E=\bar{X}W \]
və row-wise softmax ilə:
\[ \alpha_{ij} = \frac{ \exp(e_{ij}) }{ \sum_k\exp(e_{ik}) } \]
attention matrix \(A\)-nı yaradır.
Ardınca:
\[ \tilde{X} = \lambda (\bar{X}\odot A) + (1-\lambda)\bar{X}, \qquad Y = \phi (\tilde{X}W_2+B). \tag{12} \]
\(\lambda\in[0,1]\), attention-masked representation ilə original projected representation arasındakı learned mixing coefficient-dir.
Tənlik 13: Discrete token embedding-in continuous features ilə birləşdirilməsi
Token embedding table:
\[ E\in\mathbb{R}^{439\times8}. \]
Token \(k\) üçün:
\[ e_k = E[k,:] \in \mathbb{R}^{8}. \]
Yeddi continuous feature ilə səkkizölçülü token embedding:
\[ x_t = [x_t^{\mathrm{cont}};e_{k_t}] \in \mathbb{R}^{15}, \qquad t=1,\ldots,512. \tag{13} \]
formasında birləşdirilir.
Beləliklə bütün window:
\[ X\in\mathbb{R}^{15\times512} \]
ölçüsündədir.
Regression label necə yaradılır?
Window-un son event zamanı \(t\)-dir. Modelin nəzəri olaraq eyni anda əməliyyat apara bilməyəcəyi qəbul edilərək kiçik latency:
\[ d=0.0005\,\mathrm{s} \]
əlavə edilir.
\[ t_{\mathrm{start}} = t+d. \]
\(p_{\mathrm{start}}\), \(t_{\mathrm{start}}\) anında və ya ondan sonra görünən ilk event-in mid-price dəyəridir.
Prediction horizon:
\[ t_{\mathrm{end}} = t_{\mathrm{start}}+h. \]
Tənlik 14: End price smoothing
Tək event qiyməti microstructure noise-a həddindən artıq həssas ola bildiyi üçün \(t_{\mathrm{end}}\)-dən dərhal əvvəlki \(k=10\) event-in mid-price ortalaması götürülür:
\[ p_{\mathrm{end}} = \frac{1}{k} \sum_{j\in\mathcal{K}} p_j, \tag{14} \]
\[ \mathcal{K} = \{ \text{\(t_j\le t_{\mathrm{end}}\) koşulunu sağlayan en büyük zamanlı \(k\) event} \}. \]
Regression target:
\[ y_h(t) = p_{\mathrm{end}} - p_{\mathrm{start}}. \]
Vahidi tick displacement-dır.
Tənlik 15: Classification threshold
Hər asset və horizon üçün training split-dəki \(h\)-saniyəlik mid-price log-return standard deviation:
\[ \sigma_h^{\mathrm{LR}} \]
hesablanır.
Threshold:
\[ \tau_h^{\mathrm{LR}} = \alpha \sigma_h^{\mathrm{LR}}. \tag{15} \]
Mənbədə:
\[ \alpha=0.25. \]
Log-return threshold mövcud price level-a görə tick displacement-a çevrilir:
\[ \delta_h(t) = p_{\mathrm{start}} \left[ \exp(\tau_h^{\mathrm{LR}}) - 1 \right]. \]
Tənlik 16: Down / up / stationary label
\[ c = \begin{cases} 1\;(\mathrm{up}), & y_h(t)\ge\delta_h(t) \\ 0\;(\mathrm{down}), & y_h(t)\le-\delta_h(t) \\ 2\;(\mathrm{stationary}), & \mathrm{otherwise}. \end{cases} \tag{16} \]
Threshold-un iki tərəfi simmetrikdir. Müsbət threshold keçilərsə up, mənfi threshold keçilərsə down, arada qalarsa stationary etiketi təyin olunur.
Tənlik 17: Regression mean-i classification ilə müqayisə etmək üçün threshold calibration
Regression mean \(\mu\), üç sinifli qiymətləndirməyə çevrilərkən threshold-a əlavə \(k^*\) multiplier tətbiq olunur:
\[ \delta_h^\mu(t) = p_{\mathrm{start}} \left[ \exp(k^*\tau_h^{\mathrm{LR}}) - 1 \right]. \]
\(k^*\), validation period-un ayrıca calibration yarısında:
\[ k^* = \arg\min_k \left| \Pr [ |\mu| \lt \delta_h^{\mu,k}(t) ] - \Pr [ |y_h(t)| \lt \delta_h(t) ] \right|. \tag{17} \]
kimi seçilir.
Məqsəd regression prediction-lardan əldə edilən stationary class nisbətini həqiqi stationary proportion-a yaxınlaşdırmaqdır. Calibration classification head-in öz class distribution-ına görə deyil, true class distribution-a görə aparılır.
Tədqiqatın Metodu və Nəticələri
Məlumat mənbəyi və zaman bölgüsü
Tədqiqat Kraken cryptocurrency exchange-in public market-data API-sindən əldə edilən Level-2 və Level-3 order-book məlumatlarından istifadə edir.
| Element | Mənbədə verilən dəyər |
|---|---|
| Ümumi event | Təxminən 5,2 milyard |
| Ümumi asset-day | Təxminən 600 |
| Assets | BTC, ETH, SOL, LTC, DOGE, SUI, TAO |
| Market | Kraken |
| Quote currency | USD |
| Məlumat dövrü | Noyabr 2025 – Fevral 2026 |
| Training | 18 Yanvar 2026-ya qədər |
| Validation | 19–31 Yanvar 2026 |
| Test | 1–15 Fevral 2026 |
| Təxmini split | %68 train / %15 validation / %17 test asset-days |
| Əsas horizons | 5 s / 10 s / 15 s |
Validation period iki bərabər hissəyə bölünmüşdür: ilk yarısı model selection, ikinci yarısı isə Tənlik 17-dəki threshold multiplier calibration üçün istifadə edilir. Test period hər iki validation mərhələsindən də xronoloji olaraq sonradır.
Asset üzrə məlumat sıxlığı
| Asset | Tick ($) | Gün | Event (milyard) | Event/gün (milyon) | Event/s | Orta IET (ms) | 5 s event | 10 s event | 15 s event |
|---|---|---|---|---|---|---|---|---|---|
| BTC | 0,10 | 94 | 1,254 | 13,338 | 156 | 6,42 | 780 | 1560 | 2340 |
| ETH | 0,01 | 70 | 0,903 | 12,899 | 151 | 6,61 | 755 | 1510 | 2265 |
| DOGE | 1,0×10⁻⁷ | 97 | 1,124 | 11,587 | 134 | 7,46 | 670 | 1340 | 2010 |
| SOL | 0,01 | 78 | 0,539 | 6,909 | 80 | 12,50 | 400 | 800 | 1200 |
| TAO | 0,0001 | 84 | 0,577 | 6,870 | 80 | 12,58 | 400 | 800 | 1200 |
| SUI | 0,0001 | 94 | 0,523 | 5,565 | 64 | 15,52 | 320 | 640 | 960 |
| LTC | 0,01 | 83 | 0,276 | 3,326 | 39 | 25,97 | 195 | 390 | 585 |
Eyni 15 saniyəlik horizon BTC üçün orta hesabla təxminən 2340 event ehtiva etdiyi halda LTC üçün təxminən 585 event ehtiva edir. Buna görə saniyə ilə eyni horizon müxtəlif asset-lərdə fərqli information density deməkdir.
Model parameter sayları
| Komponent | Parameter |
|---|---|
| D-TABL encoder — shared | 268.356 |
| Feature projection — shared | 24.704 |
| CNP context / attention trunk — shared | 766.784 |
| Regression decoder | 165.378 |
| Classification decoder | 165.731 |
| Ümumi regression variant | 1.225.222 |
| Ümumi classification variant | 1.225.575 |
İki variant-ın parameter count-u demək olar eynidir. Beləliklə regression ilə classification confidence müqayisəsi böyük model-capacity fərqi ilə izah edilə bilməz.
Təlim strategiyası
Təlim iki mərhələdə aparılır.
- Hər asset-horizon cütü üçün D-TABL encoder üç sinifli classification task üzərində pretrain edilir.
- UQ-regression və ya UQ-classification head encoder checkpoint-ə əlavə olunur və encoder ilə birlikdə end-to-end fine-tune edilir.
Yeddi asset × üç əsas horizon:
\[ 7\times3=21 \]
asset-horizon cütü yaradır.
Hər cüt üçün regression və classification olmaqla:
\[ 21\times2=42 \]
UQ model variant-ı təlimləndirilir.
Əsas mətndəki təxminən 210 GPU-hour, iki UQ variantı üçün appendix-də verilən:
\[ 105+105=210 \]
GPU-hour ilə uyğundur. Appendix həmçinin base D-TABL pretraining üçün təxminən 78,75 GPU-hour bildirir və bütün təlim pipeline-ını təxminən:
\[ 78.75+105+105 = 288.75 \approx289 \]
GPU-hour kimi verir.
Hiperparametrlər
| Qrup | Parametr | Dəyər |
|---|---|---|
| Input | Window length \(L\) | 512 event |
| Input | Vocabulary \(|\mathcal{V}|\) | 439 |
| Input | Token embedding dimension | 8 |
| Input | Continuous features | 7 |
| Input | Max order-book depth \(L_{\max}\) | 10 |
| Label | Latency \(d\) | 0,0005 s |
| Label | End-price smoothing \(k\) | 10 event |
| Label | Threshold multiplier \(\alpha\) | 0,25 |
| Head | Context size \(C\) | 15 |
| Head | Instances per batch | 16 |
| Head | Projection dimension | 128 |
| Head | Attention dimension \(d_r\) | 256 |
| Head | Attention heads | 4 |
| Head | Context encoder depth | 3 GELU MLP layer |
| Head | Decoder depth | 5 GELU MLP layer |
| Regression | \((\lambda_1,\lambda_2,\lambda_3,\lambda_4)\) | (1,0; 0,1; 0,5; 0,5) |
| Regression | WMAE exponent \(p\) | 4 |
| Regression | \(w_{\max}\) | 40 |
| Regression | Directional margin \(m\) | 1,0 |
| Regression | Calibration bins \(B\) | 3 |
| Regression | Variance floor \(\epsilon\) | \(1\times10^{-8}\) |
| Optimisation | Optimizer | AdamW |
| Optimisation | Encoder learning rate | \(1\times10^{-5}\) |
| Optimisation | Head learning rate | \(5\times10^{-5}\) |
| Optimisation | Weight decay | 0 |
| Optimisation | Warmup | LinearLR, 10k step |
| Optimisation | Cosine restart \(T_0\) | 15k |
| Optimisation | \(T_{\mathrm{mult}}\) | 2 |
| Optimisation | \(\eta_{\min}\) | \(10^{-5}\) |
| Optimisation | \(\gamma\) | 0,5 |
| Training | Max epochs | 15 |
| Training | Random seed train / test | 42 / 999 |
Algorithm 1: Causal context construction
- Tək asset-ə aid bütün window-lar timestamp sırasına qoyulur.
- Target index \(\tau\) üçün yalnız \(j<\tau\) keçmiş window-lar qiymətləndirilir.
- \(t_j+d+h\le t_\tau\) şərtini ödəyən, yəni label outcome-u target prediction anınadək tam baş vermiş window-lar seçilə bilər.
- Bu uyğun namizədlər arasında timestamp-i ən böyük olan, yəni ən yaxın keçmişdəki \(C=15\) window context set-i yaradır.
- Encoder representations və realised labels context kimi, target representation isə withheld prediction nümunəsi kimi qaytarılır.
Confidence Gating Həqiqətən Nə Qədər Yaxşılaşma Təmin Etdi?
Yeddi asset birlikdə qiymətləndirildikdə UQ-regression-ın directional macro F1 dəyəri full test set-dən ən etibarlı %10 proqnozlara keçdikdə 5, 10 və 15 saniyəlik üfüqlərdə müvafiq olaraq +0,15, +0,14 və +0,11 artmış, UQ-classification üçün artımlar +0,11, +0,05 və +0,07 olmuşdur.
| Confidence percentile q | Reg. 5 s | Cls. 5 s | Reg. 10 s | Cls. 10 s | Reg. 15 s | Cls. 15 s |
|---|---|---|---|---|---|---|
| 0 — bütün proqnozlar | 0,42 | 0,45 | 0,41 | 0,45 | 0,40 | 0,45 |
| 10 | 0,44 | 0,46 | 0,43 | 0,45 | 0,42 | 0,46 |
| 20 | 0,46 | 0,47 | 0,45 | 0,46 | 0,44 | 0,46 |
| 30 | 0,48 | 0,47 | 0,47 | 0,47 | 0,46 | 0,47 |
| 40 | 0,49 | 0,48 | 0,48 | 0,47 | 0,47 | 0,47 |
| 50 | 0,50 | 0,49 | 0,49 | 0,48 | 0,47 | 0,48 |
| 60 | 0,51 | 0,50 | 0,50 | 0,48 | 0,48 | 0,48 |
| 70 | 0,52 | 0,51 | 0,51 | 0,49 | 0,48 | 0,49 |
| 80 | 0,54 | 0,53 | 0,52 | 0,50 | 0,49 | 0,50 |
| 90 — ən etibarlı %10 | 0,57 | 0,56 | 0,55 | 0,50 | 0,51 | 0,52 |
Classification full test set üzərində regression-dan daha güclüdür: directional macro F1 təxminən 0,45 olduğu halda regression 0,40–0,42 intervalındadır. Lakin confidence artdıqca regression fərqi bağlayır. Ən etibarlı %10-da regression 5 və 10 saniyədə classification-ı keçir, 15 saniyədə isə çox kiçik fərqlə geridə qalır: 0,51-ə qarşı 0,52.
Böyük hərəkətlərdə nəticələr
Large-move analizi:
\[ |y|>q_{67} \]
şərtindən istifadə edir. \(q_{67}\), həqiqi displacement magnitude paylanmasının təxminən yuxarı üçdə bir sərhədidir.
| Horizon | Top %50 ↓ | Top %50 ↑ | Top %30 ↓ | Top %30 ↑ | Top %10 ↓ | Top %10 ↑ | Top %5 ↓ | Top %5 ↑ | Top %1 ↓ | Top %1 ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 0,69 | 0,63 | 0,73 | 0,67 | 0,81 | 0,75 | 0,84 | 0,79 | 0,88 | 0,83 |
| 10 s | 0,65 | 0,59 | 0,68 | 0,63 | 0,75 | 0,70 | 0,78 | 0,73 | 0,85 | 0,78 |
| 15 s | 0,65 | 0,52 | 0,68 | 0,53 | 0,74 | 0,59 | 0,76 | 0,61 | 0,81 | 0,68 |
Bu subset-də down və up class paylanması təxminən balanslı olduğuna görə prior-matched random reference təxminən 0,5-dir. Confidence artdıqca hər üç horizon-da directional F1 yüksəlir.
Niyə %68 Interval Yaxşı Kalibrə Olunarkən %95 Interval Yetərsiz Əhatə Edir?
UQ-regression-ın calibration loss-u standardised residual-ın ilk mütləq momentini hədəflədiyinə görə təxminən bir-sigma səviyyəsini güclü şəkildə kalibrə edir, lakin tick displacement paylanmasının Gaussian-dan daha ağır quyruqlarını birbaşa modelləşdirmədiyinə görə 1,96-sigma %95 interval nominal səviyyədən aşağı qalır.
| Metrika | 5 s | 10 s | 15 s |
|---|---|---|---|
| Coverage 68 — nominal 0,68 | 0,682 | 0,682 | 0,681 |
| Coverage 95 — nominal 0,95 | 0,904 | 0,904 | 0,907 |
| Calibration error | 0,048 | 0,048 | 0,045 |
| NLPD | 5,278 | 5,586 | 5,778 |
Mühüm cədvəl şərhi: Pooled coverage 0,682 olduğu halda calibration error-ın 0,048 olması ziddiyyət deyil. Mənbə calibration error-ı asset üzrə:
\[ |cov_{68}-0.68| \]
dəyərlərinin ortalaması kimi müəyyən edir. Pooled aggregate coverage fərqli asset-lərdəki müsbət və mənfi sapmaları bir-birini kompensasiya edəcək şəkildə birləşdirə bilər; mean absolute asset-level deviation isə bunu etmir.
Müəlliflər %95 undercoverage üçün future work kimi Student-t likelihood və ya post-hoc conformal recalibration təklif edirlər.
Stationary F1 niyə çökür?
| Metrika | Top %100 | Top %50 | Top %30 | Top %10 | Top %1 |
|---|---|---|---|---|---|
| F1 Down | 0,447 | 0,526 | 0,549 | 0,598 | 0,640 |
| F1 Up | 0,393 | 0,477 | 0,499 | 0,544 | 0,598 |
| F1 Stationary | 0,390 | 0,067 | 0,012 | 0,000 | 0,000 |
| Üç sinifli Macro F1 | 0,410 | 0,357 | 0,353 | 0,381 | 0,413 |
Bu cədvəl çox mühüm qiymətləndirmə problemini göstərir. SNR gating yüksək magnitude prediction-ları seçdiyinə görə stationary nümunələr retained subset-də getdikcə yox olur. Beləliklə Down və Up F1 yüksələrkən Stationary F1 sıfıra düşə bilər. Buna görə üç-class macro F1 selective prediction-ın directional faydasını düzgün əks etdirməyə bilər.
BTC üzərində distribution shift
Yeddi asset-in altısında training, validation və test class proportions nisbətən oxşar qaldığı halda BTC aydın istisnadır.
BTC-USD 5 saniyə horizon-da stationary class təxminən:
Training: %70
Test: %27
olmuşdur.
10 saniyədə training stationary təxminən %64 və test %19; 15 saniyədə training təxminən %57 və test %15-dir.
Mənbə bu fərqi volatility regime shift kimi şərh edir və recent realised outcomes ilə context conditioning istifadəsinin əsas motivasiyalarından biri kimi göstərir. Bununla yanaşı müəlliflər daha uzun və birdən çox regime ehtiva edən test dövrünün robustness üçün zəruri olduğunu bildirirlər.
Per-asset label threshold və scale dəyərləri
| Asset | \(\sigma_h^{LR}\) | \(\tau_h^{LR}\) | \(y_{\mathrm{ref}}\) — tick | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | |
| BTC | 1,82e−4 | 2,63e−4 | 3,29e−4 | 4,85e−4 | 4,50e−5 | 6,60e−5 | 8,20e−5 | 1,21e−4 | 155 | 181 | 205 | 255 |
| DOGE | 3,65e−4 | 5,12e−4 | 6,25e−4 | 8,81e−4 | 9,10e−5 | 1,28e−4 | 1,56e−4 | 2,20e−4 | 187 | 277 | 352 | 507 |
| ETH | 3,14e−4 | 4,43e−4 | 5,42e−4 | 7,74e−4 | 7,80e−5 | 1,11e−4 | 1,36e−4 | 1,94e−4 | 42 | 56 | 69 | 96 |
| LTC | 3,70e−4 | 5,77e−4 | 6,11e−4 | 8,94e−4 | 9,20e−5 | 1,44e−4 | 1,53e−4 | 2,23e−4 | 2 | 2 | 2 | 3 |
| SOL | 3,58e−4 | 5,10e−4 | 6,18e−4 | 8,83e−4 | 8,90e−5 | 1,28e−4 | 1,55e−4 | 2,21e−4 | 3 | 3 | 4 | 6 |
| SUI | 5,09e−4 | 7,34e−4 | 8,79e−4 | 1,246e−3 | 1,27e−4 | 1,83e−4 | 2,20e−4 | 3,11e−4 | 3 | 5 | 6 | 9 |
| TAO | 5,01e−4 | 6,97e−4 | 8,39e−4 | 1,176e−3 | 1,25e−4 | 1,74e−4 | 2,10e−4 | 2,94e−4 | 628 | 953 | 1059 | 1596 |
30 saniyəlik dəyərlər label statistics daxilində verilmişdir; əsas məqalə eksperimentləri isə 5, 10 və 15 saniyə horizons üzərində bildirilir.
Bu Tədqiqat Gəlirli Trading Strategiyasını Sübut Edirmi?
Xeyr. UQ-LOB tədqiqatı directional reliability, displacement fit, uncertainty calibration və confidence gating-i qiymətləndirir; real portfolio P&L, fee-adjusted return, slippage, market impact və ya canlı execution nəticələri ölçülmədiyi üçün tədqiqat gəlirlilik sübutu kimi şərh edilə bilməz.
Tədqiqatın dəstəklədiyi nəticələr
- UQ-regression-ın %68 predictive interval coverage dəyəri nominal səviyyəyə çox yaxındır.
- %95 Gaussian interval ağır quyruqlar səbəbilə nominal səviyyədən aşağı coverage göstərmişdir.
- SNR confidence gating bütün üç horizon-da retained predictions-ın directional macro F1 dəyərini yüksəltmişdir.
- UQ-classification softmax confidence də directional macro F1 üçün mənalı ranking signal-dır.
- UQ-regression full test set üzərində classification-dan daha aşağı directional macro F1 yaratsa da, ən etibarlı %10-da fərq bağlanır.
- Böyük hərəkətlərdə yüksək SNR təbəqələri güclü directional F1 dəyərlərinə çatmışdır.
- Yaxın keçmişdə reallaşmış context outcome-ların istifadəsi future leakage-in qarşısını alan açıq causal constraint ilə həyata keçirilmişdir.
- UQ-regression və UQ-classification demək olar eyni parameter count və eyni shared trunk üzərində müqayisə edilmişdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Modelin real pulla gəlirli olduğu göstərilməmişdir.
- Confidence gating-in transaction cost sonrası net gəlir yaradacağı sübut edilməmişdir.
- %68 calibration bütün bazar rejimlərində davamlı calibration zəmanəti deyil.
- %95 interval-ın nominal coverage təmin etdiyi deyilə bilməz; ölçülən coverage təxminən %90,4–90,7-dir.
- Encoder-agnostic dizayn bütün LOB encoder-larla eksperimental olaraq təsdiqlənməmişdir; tədqiqat D-TABL istifadə etmişdir.
- Nəticələr başqa birja, başqa asset class və ya daha uzun horizon-lara avtomatik ümumiləşdirilə bilməz.
- Model epistemic uncertainty-ni birbaşa həll etmir.
- Tədqiqat uzunmüddətli portfolio risk management və ya optimal position sizing eksperimenti deyil.
Müəlliflərin qeyd etdiyi məhdudiyyətlər və gələcək işlər
Tail calibration: Gaussian likelihood ağır quyruqları yetərincə təmsil etmir. Student-t likelihood və ya conformal recalibration təklif olunur.
Baseline əhatəsi: Tədqiqat eyni shared trunk üzərindəki iki UQ head-i müqayisə edir. MC dropout, deep ensemble və base encoder softmax gating kimi weight-space uncertainty baseline-ları ilə geniş müqayisə aparılmamışdır.
Multi-seed qeyri-müəyyənliyi: Müəlliflər çoxsaylı seed error bar-larının və loss/context ablation-larının gələcəkdə attribution-u gücləndirəcəyini bildirirlər.
Distribution shift: Xüsusilə BTC train/test class distribution-da güclü rejim fərqi vardır. Daha uzun, birdən çox regime əhatə edən test müddəti lazımdır.
Economic evaluation: Directional reliability qiymətləndirilmişdir; profitability qiymətləndirilməmişdir.
Scope: Modellər hər asset və horizon üçün ayrıca təlimləndirilmiş və tək trading venue istifadə edilmişdir. Cross-asset və ya multi-horizon vahid model test edilməmişdir.
Etika və məlumat əlçatanlığı
Mənbə yalnız exchange-in public API-sindən alınan market data istifadə edildiyini və personal data olmadığını bildirir. Model qısamüddətli qiymət hərəkətlərini proqnozlaşdıraraq trading qərarlarına təsir edə bilər; müəlliflər gəlirlilik iddiasında olmadıqlarını və maliyyə riskinin davam etdiyini açıq şəkildə qeyd edirlər.
Raw Kraken order-book məlumatı exchange ilə data-sharing agreement olmadığı səbəbilə yenidən paylana bilmir.
Reproducibility Statement complete source code-un, D-TABL encoder-ın, iki UQ head-in, training/evaluation pipeline-larının, context-construction prosedurunun, label thresholds-un, scale dəyərlərinin və dataset statistics-in yayımlandığını bildirir. Lakin yüklənmiş PDF daxilində public repository-nin birbaşa URL-si verilmir.
Mənbə və Metod Qeydi
Orijinal tədqiqat: UQ-LOB: Uncertainty-Aware Limit Order Book Mid-Price Forecasting
Müəlliflər: Derrick Gilchrist Edward Manoharan; Eljas Linna; Kestutis Baltakys; Hao Dong; Juho Kanniainen.
Müəllif sırası: Mənbədəki sıra olduğu kimi qorunmuşdur.
Corresponding author: Derrick Gilchrist Edward Manoharan.
Bərabər töhfə: Mənbədə equal-contribution bəyanatı görünmür.
Qurum: Data Science Research Centre, Tampere University, Tampere, Finland.
Platforma: arXiv.
Kateqoriya: Computer Science — Artificial Intelligence (cs.AI).
arXiv identifikatoru: arXiv:2609.31491v2.
v1 göndərilmə tarixi: 25 Sentyabr 2026.
v2 reviziya tarixi: 28 Sentyabr 2026.
Mənbə növü: Preprint.
Resenziya statusu: Yüklənmiş v2 arXiv preprint-dir; 21 Noyabr 2026 tarixinə resenziyalı jurnal Version of Record versiyası doğrulanmamışdır.
arXiv/DataCite DOI: 10.48550/arXiv.2609.31491. Bu identifikator journal DOI-si deyil.
Rəsmi keçid: https://arxiv.org/abs/2609.31491v2
Mənbə lisenziyası: Yüklənmiş PDF üzərində açıq Creative Commons təkrar istifadə lisenziyası doğrulanmamışdır. Buna görə mənbə şəkillər birbaşa istifadə edilməmiş və ya stil transferi ilə yenidən yaradılmamışdır.
Maliyyələşdirmə: Yüklənmiş PDF-də ayrıca funding statement müəyyən edilməmişdir.
Maraqlar toqquşması: Yüklənmiş PDF-də ayrıca competing-interest/conflict-of-interest statement müəyyən edilməmişdir.
Müəllif töhfələri: Yüklənmiş PDF-də ayrıca CRediT author-contribution bəyanatı yoxdur.
Məlumat mənbəyi: Kraken cryptocurrency exchange public market-data API; Level-2 və Level-3 order-book data.
Raw məlumat əlçatanlığı: Raw data yenidən paylanmır; mənbə bunun səbəbini exchange ilə data-sharing agreement olmaması kimi açıqlayır.
Kod: Reproducibility Statement complete source code-un yayımlandığını bildirir; lakin PDF daxilində doğrulana bilən repository URL-si verilmir.
Assets: BTC, ETH, SOL, LTC, DOGE, SUI, TAO.
Əsas prediction horizons: 5 s, 10 s, 15 s.
Label statistics əlavə horizon: 30 s dəyərləri Appendix Table 7-də ayrıca verilmişdir; əsas experiment result-ları 5/10/15 saniyədir.
Input window: 512 non-overlapping order-book event.
Context: 15 causal context window + 1 withheld target.
Encoder: D-TABL; üç bilinear layer + terminal temporal-attention-augmented bilinear layer.
UQ-regression: Gaussian predictive distribution \(\mathcal{N}(\mu,\sigma^2)\).
UQ-classification: Down / Up / Stationary categorical prediction.
Regression confidence: \(SNR=|\mu|/\sigma\).
Classification confidence: Maximum softmax probability.
Optimizer: AdamW.
Avadanlıq: NVIDIA GH200 Grace Hopper Superchip.
Pipeline təlim xərci: Appendix hesabına görə təxminən 78,75 GPU-hour D-TABL pretraining + 105 GPU-hour UQ-regression + 105 GPU-hour UQ-classification = təxminən 289 GPU-hour. Əsas mətndəki təxminən 210 GPU-hour ifadəsi iki UQ variant-ının ümumi fine-tuning xərci ilə uyğundur.
Əsas calibration nəticəsi: %68 nominal interval üçün 0,681–0,682 coverage; %95 nominal interval üçün 0,904–0,907 coverage.
Əsas selective-prediction nəticəsi: Ən etibarlı %10-a keçildikdə UQ-regression directional macro F1 5/10/15 saniyədə müvafiq olaraq 0,57 / 0,55 / 0,51; UQ-classification 0,56 / 0,50 / 0,52.
Large-move nəticəsi: 5 saniyədə ən etibarlı %1 UQ-regression F1: down 0,88; up 0,83.
Əsas elmi sərhəd: Tədqiqat predictive confidence və directional reliability-ni qiymətləndirir; real trading profitability, fee-adjusted P&L, slippage və ya market impact ölçmür.
Mühüm təkrar istehsal sərhədi: Raw market data yenidən paylana bilmir. Bununla birlikdə mənbə model specification, label procedure, dataset statistics, scale/threshold dəyərləri və kodun yayımlandığını bildirir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib