


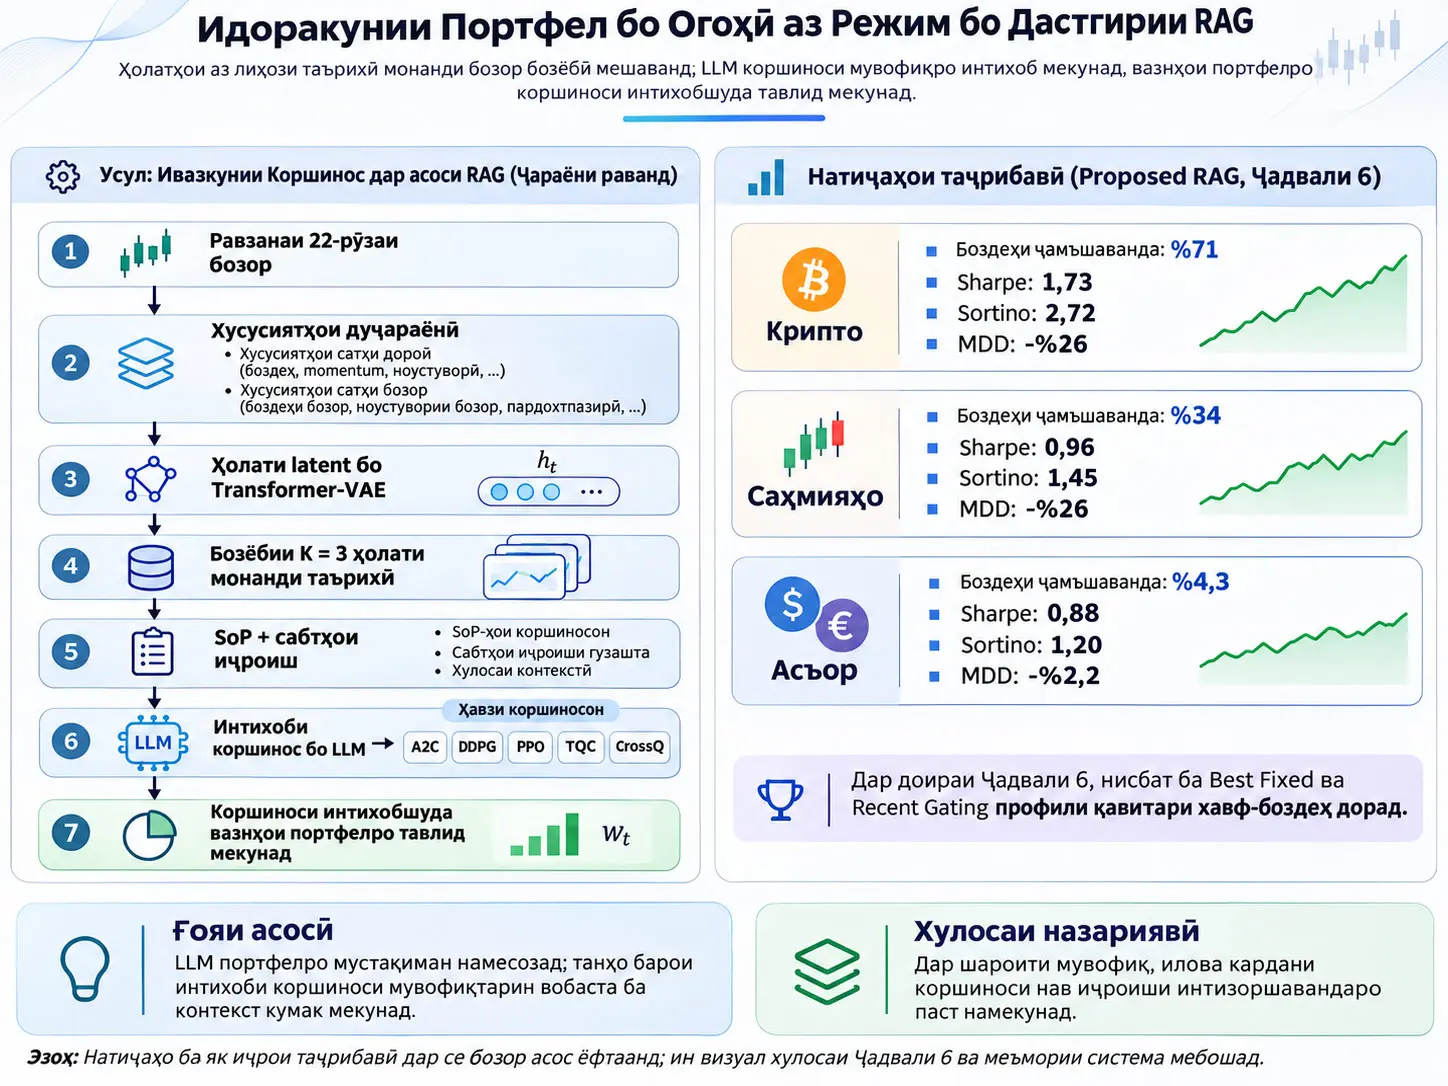
Retrieval-augmented LLM-guided expert switching — равиши мутобиқшавандаи роҳнамоии портфел аст, ки ҳолати кунунии бозорро бо ҳолатҳои таърихан монанди бозор мутобиқ мекунад, меомӯзад, ки коршиносони гуногуни портфел дар он давраҳо чӣ гуна натиҷа нишон додаанд ва модели бузурги забониро на барои тавлиди мустақими вазнҳои портфел, балки барои қарор дар бораи истифодаи кадом сиёсати коршинос ба кор мебарад. Таҳқиқот ба мушкили он равона шудааст, ки дар муҳитҳои молиявии non-stationary, ки шароити бозор бо мурури вақт тағйир меёбад, як модели портфел метавонад дар ҳар режим беҳтарин амал накунад.
Дар усул ҳолати бозор тавассути ду ҷараёни ҷудогонаи иттилоот ифода мешавад. Ҷараёни аввал хусусиятҳои сатҳи дороӣ — log-return, RSI, MACD, ATR, realized volatility ва volume-change-ро; ҷараёни дуюм нишондиҳандаҳои умумии бозор — trend, volatility-regime ва liquidity-ро интиқол медиҳад. Ду ҷараён бо Transformer-VAE encoder-ҳои ҷудогона ба latent representation табдил дода шуда, дар як \(h_t\) state vector якҷо мешаванд. State-ҳои таърихӣ дар vector database нигоҳ дошта мешаванд; барои ҳар state натиҷаи панҷ рӯзи минбаъдаи коршиносони A2C, DDPG, PPO, TQC ва CrossQ ва сабтҳои Statement of Performance (SoP) нигоҳ дошта мешаванд.
Дар марҳилаи online қароргирӣ равзанаи кунунии 22 trading-day бозор ба ҳамон фазои latent кодгузорӣ мешавад ва бо cosine similarity наздиктарин \(K=3\) ҳолати таърихӣ бозёбӣ мешавад. Натиҷаи воқеии коршиносон дар ин ҳолатҳои таърихӣ, сабтҳои SoP ва контексти кунунии бозор ба LLM пешниҳод мешаванд. LLM вазнҳои портфелро худаш тавлид намекунад; он барои муайян кардани кадом сиёсати коршинос фаъол карда шавад, арзёбии контекстӣ анҷом медиҳад. Сипас коршиноси интихобшудаи reinforcement-learning вазнҳои портфелро тавлид мекунад.
Дар муқоисаи selection-strategy-и Table 6, Proposed RAG дар бозори криптовалюта %71 cumulative return ва 1,73 Sharpe, дар бозори саҳмияҳо %34 cumulative return ва 0,96 Sharpe ва дар бозори асъор %4,3 cumulative return ва 0,88 Sharpe ба даст овардааст. Дар ҳамон ҷадвал барои Best Fixed Expert ин арзишҳо мутаносибан %68/1,64, %26/0,74 ва %3,2/0,71 мебошанд. Аммо ҳар бозор танҳо бо як experimental run арзёбӣ шуда, миёнаҳои бисёр random seed ё санҷишҳои аҳамияти оморӣ гузориш нашудаанд.
Дар шарҳи натиҷаҳо фарқи муҳими дохили манбаъ вуҷуд дорад. Дар Table 5 баландтарин cumulative return-и коршиносони мустақилона иҷрошуда дар бозори крипто барои TQC %76,16, дар бозори саҳмияҳо барои CrossQ %38,21 ва дар forex барои A2C %4,27 мебошад; ин арзишҳо аз “Best Fixed”-и Table 6 фарқ мекунанд. Манбаъ шарҳ намедиҳад, ки чаро ин ду ҷадвал натиҷаҳои гуногуни “fixed expert” медиҳанд. Аз ин рӯ таҳқиқот дастгирӣ мекунад, ки Proposed RAG дар байни стратегияҳои интихоби Table 6 натиҷаи беҳтар додааст; аммо дастгирӣ намекунад, ки системаи пешниҳодшуда дар ҳама шароит аз ҳамаи standalone expert-ҳо даромади бештар медиҳад.
Мушкилоти асосии таҳқиқот
Бозорҳои молиявӣ системаҳои собит нестанд. Сатҳи ноустуворӣ, пардохтпазирӣ, cross-asset relationships, сохтори trend ва рафтори иштирокчиёни бозор метавонанд бо вақт тағйир ёбанд. Аз ин рӯ сиёсати портфелие, ки дар як давр муваффақ аст, метавонад дар market regime-и дигар ҳамон муваффақиятро нишон надиҳад.
Кӯшиши мутобиқ кардани як модели deep-learning ё deep-reinforcement-learning ба ҳамаи шароити бозор метавонад иқтидори моделро зиёд кунад; аммо модел метавонад ба regularities-е, ки ҳангоми омӯзиш дидааст, аз ҳад зиёд мутобиқ шавад. Равиши Mixture-of-Experts бо истифода аз моделҳои гуногуни коршинос кӯшиш мекунад ин мушкилро кам кунад, вале дар сохторҳои классикии MoE learned gating network, ки муайян мекунад кадом коршинос фаъол шавад, низ метавонад дар режимҳои қаблан нодида интихоби нодуруст кунад.
Равиши алтернативии пешниҳодшуда ба ҷойи саволи «дар чанд рӯзи охир кадом модел муваффақтар буд?» саволи «дар давраҳое, ки таърихан ба ҳолати кунунии бозор монанд буданд, кадом коршинос муваффақтар буд?» мегузорад.
Retrieval-Augmented LLM-Guided Expert Switching Чист?
Retrieval-augmented LLM-guided expert switching усули expert-routing аст, ки ҳолатҳои таърихии монанд ба ҳолати кунунии бозорро аз latent vector database бозёбӣ карда, натиҷаи воқеии риск-даромади моделҳои коршиносро дар он ҳолатҳо ба механизми роҳнамоии бо LLM дастгиришаванда пешниҳод мекунад ва коршиноси портфели истифодашавандаро интихоб менамояд, аммо вазнҳои портфелро мустақиман аз LLM тавлид намекунад.
Система аз ду марҳилаи ҷудогона иборат аст
Марҳилаи offline indexing ҳолатҳои таърихии бозорро пешакӣ коркард мекунад. Ҳар historical window бо dual-stream Transformer-VAE ба latent state табдил дода мешавад. Сипас ҳамаи коршиносон аз ҳамон ҳолати таърихӣ оғоз карда, дар тӯли forward horizon-и собит арзёбӣ мешаванд. Performance records ва сабтҳои Statement of Performance бо latent representation якҷо дар vector database ҷойгир мешаванд.
Марҳилаи online inference ҳолати кунунии бозорро ба ҳамон фазои latent табдил дода, монандтарин \(K=3\) state-и гузаштаҳоро бозёбӣ мекунад, сабтҳои дахлдори expert-performance-ро ҷамъ менамояд ва LLM-ро барои expert-selection истифода мебарад. Вазифаи LLM тавлиди portfolio allocation нест, балки муайян кардани expert-и мувофиқ тавассути тафсири retrieved evidence мебошад.
Statement of Performance (SoP) чист?
Statement of Performance сабтест, ки барои ҳар historical market episode рафтор ва натиҷаи воқеии коршиноси дахлдорро ба таври контекстӣ ҷамъбаст мекунад. Дар манбаъ offline performance record маълумоти cumulative return, Sharpe ratio ва maximum drawdown-ро дар бар мегирад. SoP бошад market context, expert behavior ва uncertainty factors-и ҳамон даврро ҷамъбаст карда, ба LLM имкон медиҳад на танҳо як холи рақамӣ, балки далели таърихии контекстдорро бинад.
Оё LLM Дар Ин Система Вазнҳои Портфелро Мустақиман Тавлид Мекунад?
Не. Instruction-tuned LLM-и таҳқиқот сабтҳои таърихии market-state-и бозёбишуда ва рафтори риск-даромади коршиносонро тафсир намуда, ба қабати роҳнамоие саҳм мегузорад, ки муайян мекунад кадом expert интихоб шавад; portfolio weight vector-и воқеиро коршиноси интихобшудаи A2C, DDPG, PPO, TQC ё CrossQ тавлид мекунад.
Чаро LLM мустақиман ҳамчун trader истифода намешавад?
Баррасии адабиёти таҳқиқот таъкид мекунад, ки trading agent-ҳои асосёфта ба LLM дар benchmark-ҳои дарозмуддат ҳамеша аз buy-and-hold ё усулҳои миқдорӣ беҳтар нестанд. Аз ин рӯ вазифаи LLM маҳдуд карда шудааст. Модел ба ҷойи ҳисоб кардани ҳаҷми харидуфурӯш контексти таърихиро тафсир мекунад, муносибатҳои байни retrieved episodes-ро арзёбӣ менамояд ва дар вазифаи expert routing истифода мешавад.
Чаро арзёбии LLM маҳдуд карда шудааст?
Дар версияҳои аввали prompt мушоҳида шудааст, ки LLM ба return-ҳое, ки дар retrieved historical records вуҷуд надоштанд, extrapolation мекард ва ҷавобҳои аз ҳад боэътимод медод. Манбаъ хабар медиҳад, ки панҷ prompt iteration дар validation set арзёбӣ шуда, mean absolute estimation error тақрибан аз %18 то %11 коҳиш ёфтааст.
Тарҳи ниҳоии prompt се маҳдудияти асосиро татбиқ мекунад:
- Empirical grounding: Арзёбии риск-даромад бо retrieved historical MDD, realized information ratio ва дигар performance observations-и воқеӣ маҳдуд мешавад.
- Conservative margining: Candidate expert-и нав танҳо вақте интихоб мешавад, ки estimated advantage-и он нисбат ба incumbent expert аз uncertainty/noise margin зиёд бошад.
- Tail-event separation: Давраҳои extreme drawdown, liquidity squeeze ва regime transition аз давраҳои муқаррарӣ ҷудо арзёбӣ мешаванд.
Манбаъ шумораи намунаҳои validation set, давраҳои бозорие, ки онро дар бар мегирад, ва тақсимоти пурраи арзишҳои %18 → %11-ро гузориш намедиҳад.
Теоремаи Монотонии Expert-Pool Чӣ Мегӯяд?
Натиҷаи монотонии манбаъ намегӯяд, ки илова кардани коршиноси нав бечунучаро натиҷаро беҳтар мекунад; танҳо зери фарзияҳое, ки estimation error бо \(\epsilon\) маҳдуд аст, switch threshold \(\tau\ge2\epsilon\) мебошад ва utility advantage-и воқеии коршиноси нав дар минтақаи ҳадаф шарти \(\delta>\tau+2\epsilon\)-ро қонеъ мекунад, илова кардани specialist-и нав ба expert pool expected utility-ро кам намекунад.
Муодилаи 1: Арзиши интизории switching policy
\[ V(\pi_N) = \int_{\mathcal{S}} U_{\pi_N(s)}(s)\,d\mathbb{P}(s). \tag{1} \]
Чиро ҳисоб мекунад? Expected risk-adjusted utility-и switching policy-и дорои \(N\) коршиносро дар тамоми фазои market-state ҳисоб мекунад.
- \(\mathcal{S}\): фазои имконпазири latent market state.
- \(\mathbb{P}\): ченаки эҳтимолият дар фазои state.
- \(\pi_N(s)\): индекси expert-и интихобшуда барои state \(s\).
- \(U_i(s)\): risk-adjusted utility-и воқеии expert \(i\) дар state \(s\).
Воҳиди физикии мушаххаси \(U_i(s)\) дар манбаъ муайян нашудааст. Дар модели назариявӣ он миқдорест дар шкалаи utility ва дар decision time мустақиман маълум нест.
Муодилаи 2: Expert assessment бо дастгирии LLM
\[ \rho_i(s) = \mathcal{M} \left( \mathcal{H}_t(s),E_i \right). \tag{2} \]
\(\mathcal{H}_t(s)\) маҷмӯи retrieved historical episodes-и монанд ба current state \(s\) аст; \(E_i\) expert-и дахлдор; \(\mathcal{M}\) механизми арзёбии коркунанда бо retrieved evidence ва \(\rho_i(s)\) estimated assessment-и истифодашаванда дар switching procedure мебошад.
Фарқи муҳим: \(\rho_i(s)\) мушоҳидаи мустақими \(U_i(s)\)-и ҳақиқии номаълум нест. Historical performance records заминаи рақамиро медиҳанд; LLM retrieved context-ро тафсир карда, ба assessment calibration саҳм мегузорад.
Муодилаи 3: Axiom 1 — bounded estimation error
\[ \sup_{s\in\mathcal{S}} \left| \rho_i(s)-U_i(s) \right| \le \epsilon, \qquad \forall i\in\{1,\ldots,N+1\}. \tag{3} \]
Ин шарт фарз мекунад, ки хатои калонтарин байни estimated assessment ва utility-и ҳақиқӣ аз \(\epsilon\) зиёд нест. \(\epsilon\) дар ҳамон шкалаи utility/assessment бо \(\rho\) ва \(U\) қарор дорад.
Ин хусусият барои тамоми фазои state ба таври таҷрибавӣ исбот нашудааст. Practical implementation-и манбаъ кӯшиш мекунад LLM-ро аз extrapolation берун аз retrieved empirical observations боздорад ва ба ин аксиома наздик шавад.
Муодилаи 4: Expert бо баландтарин estimated utility
\[ e^*(s) = \arg\max_{i\in\{1,\ldots,N\}} \rho_i(s). \tag{4} \]
Ин ифода барои state \(s\) индекси expert-еро интихоб мекунад, ки дар expert pool-и мавҷуда баландтарин estimated assessment дорад.
Муодилаи 5: Conservative switching
\[ \pi_N(s) = \begin{cases} e^*(s), & \rho_{e^*(s)}(s) - \rho_{\pi_N(s)}(s) > \tau, \\ \pi_N(s), & \text{aksi durumda}. \end{cases} \tag{5} \]
ва:
\[ \tau\ge2\epsilon. \]
Агар estimated advantage-и candidate expert нисбат ба incumbent expert аз \(\tau\) зиёд набошад, expert-и мавҷуда нигоҳ дошта мешавад. Ҳадаф кам кардани switching-и нолозим аз сабаби estimation noise аст.
Муодилаи 6: Axiom 3 — specialist dominance
\[ U_{N+1}(s) \ge U_{\pi_N(s)}(s) + \delta, \qquad s\in\mathcal{S}_R, \tag{6} \]
ва:
\[ \delta > \tau+2\epsilon. \]
\(\mathcal{S}_R\) market-state subset аст, ки specialist expert-и нав ба он ҳадаф гирифта шудааст ва манбаъ \(P(\mathcal{S}_R)>0\)-ро фарз мекунад. Коршиноси нав бояд дар ин минтақа нисбат ба incumbent policy ҳадди ақал ба андозаи \(\delta\) utility-и воқеии бештар дошта бошад.
Ёддошти ифодаи дохили манбаъ: Баъд аз Axiom 3 манбаъ менависад, ки utility-и expert-и нав берун аз specialist region “unlimited” фарз мешавад. Маълум нест, ки ин калима аз ҷиҳати математикӣ ба маънои “unrestricted/unconstrained” истифода шудааст ё не. Verianla ин ифодаро бесадо бо фарзияи дигар иваз намекунад.
Муодилаҳои 7–9: Чаро интизор меравад switching-и хато utility-ро кам накунад?
\[ U_{N+1}(s) \ge \rho_{N+1}(s)-\epsilon. \tag{7} \]
\[ U_{\pi_N(s)}(s) \le \rho_{\pi_N(s)}(s)+\epsilon. \tag{8} \]
Ҳангоми якҷо кардани ду нобаробарӣ:
\[ U_{N+1}(s) - U_{\pi_N(s)}(s) > \tau-2\epsilon. \tag{9} \]
Азбаски \(\tau\ge2\epsilon\), тарафи рост манфӣ нест. Ҳамин тавр, агар error bound-и зикршуда воқеан амал кунад, интизор меравад тағйире, ки switching threshold-ро мегузарад, utility-и воқеиро кам накунад.
Муодилаҳои 10–11: Беҳбудии қатъӣ дар минтақаи ҳадафи specialist
\[ \rho_{N+1}(s) - \rho_{\pi_N(s)}(s) \ge \delta-2\epsilon. \tag{10} \]
Азбаски \(\delta>\tau+2\epsilon\):
\[ \delta-2\epsilon>\tau. \]
Ҳамин тавр specialist дар дохили region-и ҳадаф switching criterion-ро қонеъ мекунад. Minimum contribution ба expected utility:
\[ \Delta V \ge \int_{\mathcal{S}_R} \delta\,d\mathbb{P}(s) = \delta \mathbb{P}(\mathcal{S}_R) > 0. \tag{11} \]
мешавад.
Сипас манбаъ мегӯяд, ки агар specialist-ҳо пайдарпай илова шаванд:
\[ V(\pi_1) \le V(\pi_2) \le \cdots \le V(\pi_K) \]
non-decreasing policy-value sequence ба даст меояд ва он бо:
\[ V^* = \int_{\mathcal{S}} \sup_E U_E(s) \,d\mathbb{P}(s) \]
best-achievable utility-и бо ин ифода муайяншуда аз боло маҳдуд мешавад.
Тафсири дурусти теорема: Ин натиҷа маънои онро надорад, ки «агар шумораи коршиносонро зиёд кунем, даромади воқеии портфел ҳамеша зиёд мешавад». Натиҷа танҳо вақте аз ҷиҳати математикӣ дуруст аст, ки Axiom 1–3 воқеан иҷро шаванд. Practical prompt rules, мувофиқи ифодаи худи манбаъ, исботи ин аксиомаҳо нестанд, балки implementation heuristics барои бештар мувофиқ кардани рафтори LLM ба аксиомаҳо мебошанд.
Ҳолати бозор бо кадом хусусиятҳо ифода мешавад?
Дар ҳар лаҳзаи қарор ду rolling-window tensor сохта мешавад.
Asset-level tensor-и техникӣ:
\[ S_t^{tech} \in \mathbb{R}^{L\times A\times F_1}. \]
Дар ин ҷо \(L\) дарозии rolling-window, \(A\) шумораи дороиҳо дар портфел ва \(F_1\) шумораи asset-level feature аст. Дар таҷрибаҳо \(L=22\) trading day ва \(A=30\) истифода мешаванд.
Маҷмӯи хусусиятҳои сатҳи дороӣ:
- Log-return: Тағйироти logarithmic-и пайдарпайи нархҳоро ифода мекунад.
- RSI: Relative Strength Index; нишондиҳандаи техникӣ, ки сохтори нисбии momentum-и ҳаракати нархро ҷамъбаст мекунад.
- MACD: Moving Average Convergence Divergence; бо истифода аз робитаи миёнаҳои ҳаракаткунанда дар миқёсҳои гуногуни вақт сохтори trend/momentum-ро ифода мекунад.
- ATR: Average True Range; бузургии волатилнокии бар диапазон асосёфтаи ҳаракати нархро ифода мекунад.
- Realized volatility: маълумоти ноустуворӣ, ки аз ҳаракатҳои мушоҳидашудаи нарх ҳосил мешавад.
- Volume changes: тағйироти ҳаҷми савдо.
Тензори умумии бозор:
\[ S_t^{mkt} \in \mathbb{R}^{L\times F_2}. \]
Ин stream aggregate trend indicators, volatility-regime measures ва liquidity variables-ро дар бар мегирад. Манбаъ дар шарҳи умумии назариявӣ аз macroeconomic conditions ёд мекунад, аммо дар амал кадом external macroeconomic series истифода шудааст, номбар намекунад; аз ин рӯ Verianla маълумоти берунии фоиз, таваррум ё монанди онро илова намекунад.
Ҳамаи features бо rolling z-score normalization стандартизатсия мешаванд. Манбаъ мегӯяд, ки ин барои кам кардани таъсири миқёсҳои тағйирёбанда ва маҳдуд кардани таъсири heteroskedasticity ба state representation пешбинӣ шудааст.
Муодилаи 12: Тақсимоти posterior-и Transformer-VAE
\[ q_{\phi_x} \left( z_x\mid S_t^x \right) = \mathcal{N} \left( \mu_x(S_t^x), \Sigma_x(S_t^x) \right), \qquad x\in\{tech,mkt\}. \tag{12} \]
Ҳар feature stream тавассути Transformer encoder-и худ ба Gaussian posterior харита мешавад. \(\mu_x\) posterior mean, \(\Sigma_x\) diagonal covariance ва \(z_x\) latent representation аст.
Ин тағйирёбандаҳо воҳиди физикӣ надоранд; онҳо бузургиҳои latent-space мебошанд, ки аз вурудҳои стандартизатсияшуда омӯхта шудаанд.
Муодилаи 13: Reparameterization
\[ z_x = \mu_x + \varepsilon\odot\sigma_x, \qquad \varepsilon \sim \mathcal{N}(0,I). \tag{13} \]
\(\odot\) element-wise multiplication аст. \(\sigma_x\) posterior standard deviation vector мебошад. Reparameterization имкон медиҳад gradient-based training ҳангоми stochastic latent sampling идома ёбад.
Дар pretraining sampled latent representation аз ҷониби decoder барои input reconstruction истифода мешавад. Пас аз анҷоми pretraining decoder хориҷ шуда, encoder барои market-state representation нигоҳ дошта мешавад.
Муодилаи 14: Якҷо кардани ду latent stream
\[ h_t = \left[ z_t^{tech} \mid z_t^{mkt} \right] \in \mathbb{R}^{D}. \tag{14} \]
\(h_t\) натиҷаи concatenation-и asset-specific ва market-wide latent vectors аст. Азбаски дар historical indexing ва online query як representation function истифода мешавад, current state ва historical state дар як фазои latent муқоиса мешаванд.
Дар бахши таҷриба retrieval embedding dimension:
\[ d=64 \]
нишон дода мешавад. Манбаъ робитаи нотационии байни \(D\) ва рамзи \(d\)-и ин implementation-ро алоҳида муфассал намекунад.
Муодилаи 15: Сабти Historical index
\[ D_{\tau} = \left( h_{\tau}, R_{\tau}^{(e)}, SoP_{\tau}^{(e)} \right), \qquad e\in\{1,\ldots,E\}. \tag{15} \]
Ҳар сабти таърихии state се гурӯҳи иттилоотро якҷо мекунад:
- \(h_{\tau}\): historical latent market state,
- \(R_{\tau}^{(e)}\): performance record-и воқеии expert \(e\) дар forward horizon,
- \(SoP_{\tau}^{(e)}\): Statement of Performance дар ҳамон шароит.
Муодилаи 16: Интихоби наздиктарин state-ҳои таърихӣ
\[ \mathcal{N}_t = KNN \left( h_t, \{h_{\tau}\}, K \right). \tag{16} \]
Дар таҷрибаҳо \(K=3\) истифода мешавад. Similarity metric — cosine similarity. Дар вақти тест танҳо:
\[ \tau<t \]
historical observations-е, ки ин шартро қонеъ мекунанд, барои retrieval истифода мешаванд. Ин chronological restriction барои пешгирии ворид шудани future information ба раванди қарор пешбинӣ шудааст.
Муодилаи 17: Retrieval weight
\[ w_{\tau} = \frac{ sim(h_t,h_{\tau}) }{ \sum_{j\in\mathcal{N}_t} sim(h_t,h_j) }. \tag{17} \]
\(sim(h_t,h_{\tau})\) cosine similarity байни current state ва historical state аст. \(w_{\tau}\) normalized retrieval weight-и бевоҳид мебошад.
Ҳудуди возеҳии математикӣ: Cosine similarity аз ҷиҳати назариявӣ метавонад манфӣ ҳам бошад. Манбаъ пеш аз Eq. 17 шарҳ намедиҳад, ки similarity-ҳо ба диапазони мусбат бурида мешаванд, softmax истифода мешавад ё ҳолати сифр шудани маҷмӯи similarity чӣ гуна идора мешавад. Аз ин рӯ фарз кардани он ки \(w_{\tau}\) дар ҳама ҳолат classical convex weight аст, бехатар нест.
Муодилаи 18: Similarity-weighted expert performance
\[ \widehat{R}_t^{(e)} = \sum_{\tau\in\mathcal{N}_t} w_{\tau} R_{\tau}^{(e)}. \tag{18} \]
Ин муодила performance-и expert \(e\)-ро дар retrieved historical episodes бо вазнҳои similarity якҷо мекунад. \(\widehat{R}_t^{(e)}\) ҳамон шкалаеро дорад, ки \(R_{\tau}^{(e)}\) дар он таъриф шудааст.
Ҳудуди нишонгузории дохили манбаъ: Дар шарҳи offline гуфта мешавад, ки performance record cumulative return, Sharpe ratio ва MDD-ро дар бар мегирад; Eq. 18 бошад \(R_{\tau}^{(e)}\)-ро мисли як бузургии математикӣ менависад. Чӣ гуна ин метрикаҳо ба scalar composite score табдил шудаанд ё Eq. 18 барои ҳар метрика component-wise истифода шудааст, дар манбаъ равшан муайян нашудааст.
Алгоритми 1: Индексгузории Офлайнии Режим ва Асосноккунии Натиҷаи Коршинос
- Барои ҳар historical time step \(\tau\) asset-level ва market-wide feature tensors сохта мешаванд.
- Бо dual-stream T-VAE \(h_{\tau}\) latent embedding ҳисоб мешавад.
- Ҳар expert \(E^{(e)}\) аз historical state оғоз карда мешавад.
- Performance-и воқеии expert дар forward horizon \(H\) ҳисоб мешавад.
- Барои ҳамон episode Statement of Performance сохта мешавад.
- Сабти \((h_{\tau},R_{\tau}^{(e)},SoP_{\tau}^{(e)})\) ба historical index навишта мешавад.
Алгоритми 2: Retrieval-и Онлайн ва Қабули Қарори Портфел
- Аз current market data \(S_t^{tech}\) ва \(S_t^{mkt}\) сохта мешаванд.
- Бо dual-stream T-VAE \(h_t\) ҳисоб мешавад.
- Аз vector database \(K=3\) nearest historical regimes гирифта мешавад.
- Барои ҳар expert similarity-weighted performance estimate ҳисоб мешавад.
- Algorithm 2 ҳамчунин ҳисоб шудани weighted uncertainty \(\sigma_t^{(e)}\)-ро зикр мекунад.
- Retrieved SoPs ва current market context ба LLM дода мешаванд.
- LLM ба expert selection саҳм мегузорад ва \(e^*\) муайян мешавад.
- Expert-и интихобшуда \(E^{(e^*)}\) portfolio weights \(w_t\)-ро тавлид мекунад.
Ҳудуди бозтавлидшавӣ: Барои weighted uncertainty \(\sigma_t^{(e)}\), ки дар Algorithm 2 омадааст, манбаъ формулаи ҷудогонаи математикӣ намедиҳад. Verianla ин холигиро бо илова кардани uncertainty estimator-и нав пур накардааст.
Усул ва Натиҷаҳои Таҳқиқот
Сохтори маълумоти таҷрибавӣ
Таҳқиқот дар се financial market class аз daily OHLCV истифода мекунад:
- 30 криптовалюта,
- 30 саҳмия,
- 30 ҷуфти асъори хориҷӣ.
OHLCV сохтори маълумоти бозорӣ аз Open, High, Low, Close ва Volume мебошад. Гарчанде дар муқаддима аз high-frequency trading ёд шудааст, таҷрибаҳои воқеӣ бо intraday high-frequency data не, балки бо daily OHLCV гузаронида шудаанд.
| Параметр | Арзиши манбаъ |
|---|---|
| Синфи бозор | Крипто, Саҳмия, Forex |
| Шумораи symbol дар ҳар бозор | 30 |
| Равзанаи вуруд \(L\) | 22 рӯзи савдо |
| Уфуқи нигоҳдорӣ / forward \(H\) | 5 рӯз |
| Ҳамсояҳои таърихӣ \(K\) | 3 |
| Монандӣ | Cosine similarity |
| Андозаи latent embedding | 64 |
| Ҳарорати LLM | 0,1 |
| Даъвати LLM | Барои ҳар қарор ҳадди аксар 1 |
| Маҳдудияти future-leakage | Retrieval танҳо \(\tau<t\) |
| Таҷҳизот | Як NVIDIA H100 GPU |
| Шумораи такрори таҷриба | Барои ҳар бозор 1 run |
Панели криптовалюта
30 рамзи криптовалюта:
ADA, APT, ARB, ATOM, AVAX, BCH, BNB, BTC, DOGE, DOT, EGLD, ETC, ETH, FIL, HBAR, ICP, LINK, LTC, MATIC, MKR, NEAR, RNDR, SHIB, SOL, TON, TRX, UNI, VET, XLM ва XRP.
Availability period вобаста ба symbol яксон нест. Манбаъ дар Table 2 барои BTC ва LTC аз силсилаҳои дарозтарин 4.275 sample аз 17 Сентябри 2014–31 Майи 2026 гузориш медиҳад, дар ҳоле ки барои APT 1.311 sample аз 20 Ноябри 2021–24 Июни 2025 мавҷуд аст. Баъзе series мисли RNDR, MATIC, UNI ва APT пеш аз 2026 ба охир мерасанд.
Азбаски барои cryptocurrency market як standard broad-market benchmark вуҷуд надорад, манбаъ ду synthetic index сохтааст:
- индекси даромади кумулятивии баробаривазн / бевазн,
- индекси даромади кумулятивии вазншуда аз рӯи ҳаҷм.
Манбаъ мегӯяд, ки equal-weighted raw-price aggregation аз ҷониби шумораи ками extreme constituents ҳукмрон мешавад ва бинобар ин volume-weighted variant ҳамчун primary market-level descriptor бартарӣ дода шудааст.
Панели саҳмияҳо
30 саҳмия:
TMO, MCD, NVDA, DIS, TSLA, CVX, XOM, ACN, V, WMT, KO, LIN, HD, GOOGL, CRM, UNH, BAC, COST, MA, PG, AAPL, JPM, JNJ, MSFT, MRK, META, AMZN, ABBV, BRK-B ва PEP.
Бисёр stock series аз 3 Январи 2000–29 Майи 2026 6.641 sample доранд, дар ширкатҳое, ки баъдтар ба бозор баромадаанд, history кӯтоҳтар аст. Барои stock market-level context аз S&P 500, NASDAQ Composite ва Dow Jones Industrial Average истифода шудааст.
Панели асъор
30 ҷуфти forex:
USDCAD, EURAUD, EURCHF, GBPCHF, CHFJPY, NZDCHF, AUDCAD, NZDCAD, GBPUSD, AUDUSD, GBPAUD, USDJPY, GBPJPY, NZDJPY, AUDNZD, EURGBP, USDCHF, EURCAD, AUDJPY, GBPCAD, USDTRY, AUDCHF, EURTRY, EURSEK, GBPNZD, EURUSD, NZDUSD, EURJPY, EURNZD ва CADJPY.
Барои FX манбаъ як standard broad-market composite index гузориш намедиҳад. Market-wide condition тавассути канали aggregate market-feature-и dual-stream encoder ифода мешавад.
Ҳудуди манбаи маълумот: PDF равшан намегӯяд, ки силсилаҳои OHLCV аз кадом market-data provider ё API гирифта шудаанд. Аз ин рӯ Verianla Yahoo Finance, Binance, Alpha Vantage ё ягон провайдери дигарро фарз намекунад.
Панҷ коршиноси reinforcement-learning
| Коршинос | Нақши асосӣ дар манбаъ |
|---|---|
| A2C | Advantage Actor-Critic; synchronous actor-critic policy-gradient равиш. |
| DDPG | Deep Deterministic Policy Gradient; off-policy actor-critic барои continuous action space. |
| PPO | Proximal Policy Optimization; усули policy-gradient, ки бо маҳдуд кардани андозаи policy update training stability-ро ҳадаф мегирад. |
| TQC | Truncated Quantile Critics; коршиноси distributional reinforcement-learning, ки reward distribution-ро бо quantile critics модел мекунад. |
| CrossQ | Усули off-policy reinforcement-learning, ки барои зиёд кардани behavioral diversity дар expert pool илова шудааст. |
Метрикаҳои арзёбӣ
Cumulative return даромади умумии ҷамъшудаи портфелро дар давраи арзёбӣ ифода мекунад.
Annualized return даромадро ба миқёси солона табдил медиҳад. Аммо exact annualization convention-и манбаъ бо формулаи ҷудогона дода нашудааст.
Annualized volatility ченаки солонашудаи return variability аст.
Sharpe ratio метрикаи risk-adjusted performance мебошад, ки даромадро бо total variability/risk мепайвандад. Манбаъ risk-free rate ва exact annualization formula-ро гузориш намедиҳад.
Sortino ratio ба ҷойи total variability ба downside variability таваҷҷуҳ мекунад. Манбаъ target return ё minimum acceptable return-ро алоҳида намедиҳад.
Maximum Drawdown (MDD) бузургтарин коҳиши portfolio value аз peak то trough-и баъдӣ мебошад. Ҳар қадар қимати мутлақи рақами манфӣ хурд бошад, drawdown сабуктар аст; масалан −%22 аз −%29 талафоти хурдтар аст.
Натиҷаҳои standalone expert-ҳо
| Бозор | Коршинос | Cumulative Return | Sharpe | Sortino | MDD | Dominance |
|---|---|---|---|---|---|---|
| Крипто | A2C | %63,00 | 1,61 | 2,44 | −%25 | 19 ҳафта / %34,5 |
| Крипто | DDPG | %71,26 | 1,74 | 2,73 | −%26 | 6 ҳафта / %10,9 |
| Крипто | PPO | %60,49 | 1,57 | 2,38 | −%27 | 3 ҳафта / %5,5 |
| Крипто | CrossQ | %53,66 | 1,44 | 2,24 | −%28 | 9 ҳафта / %16,4 |
| Крипто | TQC | %76,16 | 1,71 | 2,63 | −%29 | 18 ҳафта / %32,7 |
| Саҳмия | A2C | %32,16 | 0,90 | 1,35 | −%23 | 17 ҳафта / %19,3 |
| Саҳмия | DDPG | %28,89 | 0,85 | 1,26 | −%24 | 5 ҳафта / %5,7 |
| Саҳмия | PPO | %33,38 | 0,96 | 1,46 | −%22 | 21 ҳафта / %23,9 |
| Саҳмия | CrossQ | %38,21 | 0,95 | 1,42 | −%27 | 32 ҳафта / %36,4 |
| Саҳмия | TQC | %32,09 | 0,86 | 1,28 | −%26 | 13 ҳафта / %14,8 |
| Forex | A2C | %4,27 | 0,88 | 1,20 | −%2,18 | 6 ҳафта / %6,8 |
| Forex | DDPG | %1,80 | 0,36 | 0,46 | −%2,85 | 12 ҳафта / %13,6 |
| Forex | PPO | %4,07 | 0,88 | 1,20 | −%2,00 | 9 ҳафта / %10,2 |
| Forex | CrossQ | %2,62 | 0,53 | 0,69 | −%2,68 | 18 ҳафта / %20,5 |
| Forex | TQC | %2,26 | 0,48 | 0,60 | −%2,18 | 43 ҳафта / %48,9 |
Натиҷаҳо идеяи expert specialization-ро дастгирӣ мекунанд: баландтарин cumulative return, баландтарин Sharpe, пасттарин MDD ва бештарини dominance дар як expert ҷамъ намешаванд.
Дар крипто TQC баландтарин cumulative return (%76,16)-ро дорад, DDPG баландтарин Sharpe ва Sortino (1,74 ва 2,73)-ро, A2C бошад хурдтарин MDD (−%25)-ро медиҳад. Дар саҳмия CrossQ баландтарин cumulative return (%38,21), PPO баландтарин Sharpe/Sortino (0,96/1,46) ва хурдтарин MDD (−%22)-ро дорад. Дар forex A2C бо %4,27 cumulative return пешсаф аст; PPO ва A2C дар Sharpe/Sortino бо 0,88/1,20 баробаранд ва хурдтарин MDD барои PPO −%2,00 мебошад.
Proposed switcher кадом коршиносонро чанд бор интихоб кард?
| Коршинос | Крипто | Саҳмия | Forex |
|---|---|---|---|
| A2C | %34,5 | %19,3 | %6,8 |
| TQC | %32,7 | %14,8 | %48,9 |
| CrossQ | %16,4 | %36,4 | %20,5 |
| DDPG | %10,9 | %5,7 | %13,6 |
| PPO | %5,5 | %23,9 | %10,2 |
Ин тақсимот нишон медиҳад, ки як expert дар ҳамаи market-ҳо ҳукмрон нест. Дар крипто A2C ва TQC бештар интихоб мешаванд, дар stock market CrossQ ва дар forex TQC баландтарин frequency-ро дорад.
Proposed RAG Selector Дар Се Бозор Чӣ Натиҷа Дод?
Дар муқоисаи selection-strategy-и Table 6, Proposed RAG дар крипто %71 cumulative return ва 1,73 Sharpe, дар саҳмия %34 ва 0,96, дар forex %4,3 ва 0,88 ба даст оварда, аз Best Fixed ва Recent-Performance Gating дар ҳамон ҷадвал cumulative return ва Sharpe-и бештар нишон додааст; аммо барои ҳар бозор танҳо як run аст ва дар Table 5 баъзе standalone expert-ҳо cumulative return-и бештар аз Proposed RAG доранд.
| Бозор | Усул | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|---|---|
| Крипто | Best Fixed | %68 | %62 | 0,32 | 1,64 | 2,54 | −%27 |
| Крипто | Recent Gating | %69 | %62 | 0,32 | 1,66 | 2,57 | −%27 |
| Крипто | Proposed RAG | %71 | %64 | 0,31 | 1,73 | 2,72 | −%26 |
| Саҳмия | Best Fixed | %26 | %14 | 0,21 | 0,74 | 1,11 | −%26 |
| Саҳмия | Recent Gating | %33 | %17 | 0,20 | 0,91 | 1,37 | −%24 |
| Саҳмия | Proposed RAG | %34 | %18 | 0,19 | 0,96 | 1,45 | −%26 |
| Forex | Best Fixed | %3,2 | %1,8 | 0,026 | 0,71 | 0,92 | −%1,9 |
| Forex | Recent Gating | −%0,4 | −%0,2 | 0,029 | −0,062 | −0,08 | −%2,6 |
| Forex | Proposed RAG | %4,3 | %2,4 | 0,028 | 0,88 | 1,20 | −%2,2 |
Proposed RAG дар ҳар risk metric мутлақан беҳтарин нест. Дар stock market MDD-и Recent Gating −%24 аст, Proposed RAG −%26. Дар forex MDD-и Best Fixed −%1,9 ва Proposed RAG −%2,2. Аз ин рӯ шарҳи “risk-return profile” дар манбаъ ба арзёбии якҷояи cumulative return, Sharpe, Sortino, volatility ва MDD асос меёбад ва набояд ба «дар ҳар нишондиҳандаи риск беҳтарин» васеъ карда шавад.
Фарқи “Best Fixed” байни Table 5 ва Table 6
Манбаъ натиҷаҳои standalone expert-ро дар Table 5 ва натиҷаҳои selection strategy-ро дар Table 6 ҷудо медиҳад. Бо вуҷуди он ки интизор шудан мумкин аст ду ҷадвал барои «беҳтарин expert-и собит» як cumulative return диҳанд, арзишҳо мувофиқ нестанд:
| Бозор | Баландтарин standalone return дар Table 5 | Table 6 Best Fixed | Table 6 Proposed RAG |
|---|---|---|---|
| Крипто | TQC: %76,16 | %68 | %71 |
| Саҳмия | CrossQ: %38,21 | %26 | %34 |
| Forex | A2C: %4,27 | %3,2 | %4,3 |
Манбаъ ин фарқро бо split, давра, portfolio construction, initialization ё тағйирёбандаи дигари протокол шарҳ намедиҳад. Аз ин фарқи ҷадвал набояд механизми нав бароварда шавад.
Ҳамчунин матни Section 4.3 “four strategies” мегӯяд, аммо фавран танҳо се strategy-ро муайян мекунад: Best Fixed Expert, Recent-Performance Gating ва Proposed RAG. Table 6 ҳам танҳо ҳамин се стратегияро дорад. Азбаски стратегияи чорум дар манбаъ муайян нашудааст, Verianla baseline-и нав илова намекунад.
Ablation-и андозаи expert-pool
| Бозор | Шумораи Коршинос | Fixed Sharpe | RAG Sharpe | Δ Sharpe |
|---|---|---|---|---|
| Крипто | 1 | 0,81 | 0,81 | %0,0 |
| Крипто | 2 | 0,84 | 0,85 | %1,2 |
| Крипто | 3 | 0,89 | 0,98 | %10,1 |
| Крипто | 4 | 0,96 | 1,15 | %19,8 |
| Саҳмия | 1 | 0,43 | 0,43 | %0,0 |
| Саҳмия | 2 | 0,51 | 0,52 | %2,0 |
| Саҳмия | 3 | 0,55 | 0,63 | %14,5 |
| Саҳмия | 4 | 0,59 | 0,72 | %22,0 |
| Forex | 1 | 0,35 | 0,35 | %0,0 |
| Forex | 2 | 0,43 | 0,44 | %2,3 |
| Forex | 3 | 0,46 | 0,55 | %19,6 |
| Forex | 4 | 0,51 | 0,65 | %27,5 |
Бо як expert switching имкон надорад, бинобар ин RAG ва fixed як натиҷа доранд. Дар pool-ҳои се ва чор expert improvement зиёд мешавад. Манбаъ инро далели аҳамияти на танҳо шумораи моделҳо, балки гуногунии complementary expertise медонад.
Маҳдудият: Гарчанде full system панҷ expert дорад, Table 7 танҳо pool-ҳои 1–4 expert-ро гузориш медиҳад. Ҳамчунин тартиби илова шудани expert-ҳо ба nested pool гуфта нашудааст. Аз ин рӯ extrapolation-и «бо expert-и панҷум improvement ҳамин қадар мешавад» мумкин нест.
Retrieval ва LLM component ablation
| Бозор | Configuration | Cumulative Return | Sharpe | MDD |
|---|---|---|---|---|
| Крипто | NR — No Retrieval | %64,8 | 1,622 | −%26,7 |
| Крипто | R−LLM — No LLM | %69,1 | 1,661 | −%27,1 |
| Крипто | Full — R+L+U | %71 | 1,73 | −%26 |
| Саҳмия | NR — No Retrieval | %33,1 | 0,911 | −%24,4 |
| Саҳмия | R−LLM — No LLM | %25,5 | 0,735 | −%26,5 |
| Саҳмия | Full — R+L+U | %34 | 0,96 | −%26 |
| Forex | NR — No Retrieval | %3,2 | 0,710 | −%1,9 |
| Forex | R−LLM — No LLM | −%0,2 | −0,025 | −%2,4 |
| Forex | Full — R+L+U | %4,3 | 0,88 | −%2,2 |
Ҳангоми хориҷ кардани retrieval cumulative return нисбат ба full configuration дар ҳамаи market-ҳо коҳиш меёбад. Ҳангоми хориҷ кардани LLM коҳиш дар stock ва forex намоёнтар аст. Масалан, дар forex full model %4,3 cumulative return ва 0,88 Sharpe медиҳад, no-LLM configuration ба −%0,2 ва −0,025 мефарояд.
Аммо full model дар ҳар market minimum MDD намедиҳад. Дар stock no-retrieval MDD −%24,4 буда, аз −%26-и full model хурдтар аст; дар forex ҳам no-retrieval −%1,9 ва full model −%2,2 мебошад.
Ҳудуди муҳими ablation: Source Table 8 configuration-е надорад, ки uncertainty-aware component-ро танҳо хориҷ кунад. Аз ин рӯ дар бораи саҳми retrieval ва LLM reasoning хулосаи таҷрибавӣ гирифтан мумкин аст; саҳми мустақили uncertainty-aware decision making бо ин ablation чен нашудааст.
Ҳассосияти Indexing LLM
| Indexing LLM | Муваффақият | Нокомӣ |
|---|---|---|
| Google/Gemma4-E4B | %28 | %72 |
| Google/Gemma4-31B-it | %96 | %4 |
| AliBaba/Qwen3.6-27B-it | %100 | %0 |
Ин метрикаи “success” даромади сармоягузорӣ нест. Манбаъ онро муваффақияти риояи indexing instructions ва дуруст тавлид кардани structured output-и интизоршуда таъриф мекунад.
Ҳассосияти Inference LLM
| Бозор | Inference LLM | Cum. Return | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|
| Крипто | Google/Gemma4-31B-it | %68,3 | 1,65 | 2,55 | −%27 |
| Крипто | Google/Gemma4-E4B | %63,5 | 1,57 | 2,42 | −%28 |
| Крипто | AliBaba/Qwen3.6-27B-it | %71 | 1,73 | 2,72 | −%26 |
| Саҳмия | Google/Gemma4-31B-it | %25,1 | 0,73 | 1,09 | −%26,5 |
| Саҳмия | Google/Gemma4-E4B | %24,5 | 0,71 | 1,06 | −%27 |
| Саҳмия | AliBaba/Qwen3.6-27B-it | %34 | 0,96 | 1,45 | −%26 |
| Forex | Google/Gemma4-31B-it | −%0,3 | −0,05 | −0,06 | −%2,5 |
| Forex | Google/Gemma4-E4B | −%5,4 | −1,07 | −1,37 | −%5,6 |
| Forex | AliBaba/Qwen3.6-27B-it | %4,3 | 0,88 | 1,20 | −%2,2 |
Дар манбаъ AliBaba/Qwen3.6-27B-it дар ҳар се market қавитарин inference result-ҳоро медиҳад. Хусусан дар forex интихоби LLM ба натиҷа таъсири калон доштааст. Ин нишон медиҳад, ки retrieval танҳо кофӣ нест; тарзи коркарди retrieved evidence аз ҷониби downstream reasoning model низ муҳим аст.
Муқоиса бо усулҳои state-of-the-art
| Бозор | Усул | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | MDD |
|---|---|---|---|---|---|---|
| Крипто | TAC | %24 | %21,6 | 0,94 | 1,29 | −%31 |
| Крипто | AlphaMixRL | %22 | %19,8 | 1,00 | 1,38 | −%29 |
| Крипто | LLM-MAS | %33 | %30 | 0,96 | 1,50 | −%28 |
| Крипто | Proposed | %71 | %64 | 0,31 | 1,73 | −%26 |
| Саҳмия | TAC | %10,4 | %5,6 | 0,25 | 0,74 | −%28 |
| Саҳмия | AlphaMixRL | %11,8 | %6,3 | 0,31 | 0,82 | −%27 |
| Саҳмия | Multi-LLM Black–Litterman | %31 | %16,4 | 0,28 | 0,91 | −%29 |
| Саҳмия | Proposed | %34 | %18 | 0,19 | 0,96 | −%26 |
| Forex | TAC | %0,7 | %0,4 | 0,45 | 0,61 | −%5,1 |
| Forex | AlphaMixRL | %0,8 | %0,45 | 0,50 | 0,68 | −%4,6 |
| Forex | Fine-tuned LLaMA | %3,3 | %1,9 | 0,08 | 0,76 | −%3,1 |
| Forex | Proposed | %4,3 | %2,4 | 0,03 | 0,88 | −%2,2 |
Дар Table 11 Proposed framework дар ҳар се market баландтарин cumulative return ва Sharpe медиҳад. Аммо муаллифон дар натиҷаҳо равшан мегӯянд, ки competing implementations ҳамеша бо experimental protocol-и комилан яксон иҷро нашудаанд. Аз ин рӯ ҳангоми арзёбии Table 11 ҳамчун benchmark-и назоратшаванда баробарии протокол бояд бо эҳтиёт дида шавад.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Дар expert pool-и санҷидашуда бартарии нисбии expert-ҳо вобаста ба market ва metric тағйир ёфтааст.
- Дар Table 6 retrieval-based Proposed RAG дар ҳар се market аз Best Fixed ва Recent Gating cumulative return ва Sharpe-и бештар додааст.
- Хориҷ кардани retrieval cumulative return-ро дар ҳар се market нисбат ба full configuration кам кардааст.
- Хориҷ кардани LLM reasoning махсусан дар stock ва forex бо коҳиши муҳим алоқаманд аст.
- Expert-pool ablation нишон додааст, ки бо афзоиши complementary expert-ҳо Sharpe improvement-и гузоришшуда дар 1–4 expert зиёд шудааст.
- Интихоби inference LLM натиҷаҳоро ба таври намоён тағйир дода, Qwen3.6-27B-it қавитарин натиҷаро аз се модели санҷидашуда додааст.
- Теоремаи математикӣ кафолат медиҳад, ки зери Axiom 1–3 илова кардани specialist-и мувофиқ expected utility-ро кам намекунад.
Умумисозиҳое, ки таҳқиқот дастгирӣ намекунад
- Исбот нашудааст, ки усули пешниҳодшуда дар бозори зинда бо пули воқеӣ ҳамин даромадро медиҳад.
- %71, %34 ва %4,3 cumulative return кафолати даромади оянда нестанд.
- LLM ҳамчун trader-и мустақили муваффақ тасдиқ нашудааст; дар таҳқиқот нақши expert-routing дорад.
- Теоремаи монотония намегӯяд, ки бе иҷрои Axiom 1–3 илова кардани expert performance-ро кам карда наметавонад.
- Table 6 исбот намекунад, ки Proposed RAG аз ҳамаи standalone expert-ҳо cumulative return-и бештар медиҳад.
- Як experimental run далели confidence interval ё random-seed robustness нест.
- Component ablation саҳми мустақили uncertainty-aware mechanism-ро чен накардааст.
- Натиҷаҳои се market ба ҳамаи бозорҳо, давраҳо ё муҳитҳои дигари transaction-cost худкор умумӣ намешаванд.
- Ёфтани latent state-и монанд дар гузашта кафолат намедиҳад, ки ҳамон динамика дар оянда такрор мешавад.
Маълумоти нопурра ё номуайян барои бозтавлидшавӣ
Market-data provider: Гузориш нашудааст.
Exact train / validation / test calendar split: Chronological retrieval ва маҳдудияти \(\tau<t\) дода шудаанд; аммо барои ҳамаи market-ҳо ҷадвали train/validation/test split бо санаҳои равшани оғоз ва анҷом нест.
Transaction-cost: Гуфта мешавад, ки SOTA comparison зери transaction-cost assumptions-и яксон анҷом дода шавад; fee/slippage-и рақамӣ гузориш нашудааст.
Portfolio constraints: Гуфта мешавад constraints-и яксон истифода шаванд; long-only, leverage, short-selling, cash allocation ё weight bound равшан номбар нашудаанд.
RL expert training hyperparameters: Номҳо ва синфҳои A2C, DDPG, PPO, TQC ва CrossQ дода шудаанд; learning rate, batch size, optimizer, network depth, reward function ва дигар training settings барои ҳар модел ҳамчун reproducibility table-и пурра дода нашудаанд.
Weighted uncertainty: Дар Algorithm 2 ҳисоб шудани \(\sigma_t^{(e)}\) гуфта мешавад; формула дода намешавад.
Параметрҳои теорема: \(\epsilon\), \(\tau\) ва \(\delta\) ҳамчун шартҳои назариявӣ муайян шудаанд; арзишҳои рақамии таҷрибавӣ дода намешаванд.
Prompt validation set: Панҷ prompt iteration гузориш шудааст; validation sample size ва тақсимоти пурраи давраҳо нишон дода нашудаанд.
Expert-pool ablation: Бо вуҷуди full pool-и панҷ expert, Table 7 танҳо натиҷаҳои 1–4 expert-ро медиҳад ва тартиби илова шудани expert-ҳо ба nested pool-ро шарҳ намедиҳад.
Statistical significance: Бисёр random seed, confidence interval, p-value ё formal hypothesis test гузориш нашудаанд.
Public code repository: Дар PDF-и боршуда пайванди тасдиқшудаи public code repository дода нашудааст.
Ҷиҳатҳои қавии таҳқиқот
Ҷиҳати қавӣ он аст, ки expert routing танҳо ба performance-и чанд рӯзи охир такя намекунад, балки ба expert behavior-и воқеӣ дар market states-и таърихан монанд асос меёбад. Ин retrieval-ро аз ёвари танҳо маълумотгиранда ба қисми асосии portfolio expert selection табдил медиҳад.
Ҷиҳати дуюм маҳдуд кардани вазифаи LLM аст. LLM portfolio weights-ро мустақим тавлид намекунад; ҳамчун coordination/routing layer барои тафсири retrieved evidence истифода мешавад. Ин LLM-ро на numerical trading policy, балки contextual reasoning арзёбӣ мекунад.
Ҷиҳати сеюм татбиқи як protocol-и \(L=22\), \(H=5\), \(K=3\) retrieval дар се financial market class ва анҷоми ablation/sensitivity барои expert heterogeneity, pool size, retrieval, LLM choice ва indexing quality мебошад.
Маҳдудиятҳои асосӣ
Маҳдудияти асосӣ танҳо як experimental run барои ҳар market аст. Аз ин рӯ тақсимоти таъсири random initialization ё stochastic training номаълум аст.
Маҳдудияти дуюм он аст, ки competing SOTA methods ҳамеша зери experimental protocol-и комилан яксон иҷро нашудаанд. Аз ин рӯ даъвои бартарии мустақими Table 11 бояд бо эҳтиёт тафсир шавад.
Маҳдудияти сеюм набудани баъзе ҷузъиёти зарурии reproduction, аз ҷумла exact transaction-cost, portfolio constraints, data provider ва RL training hyperparameters мебошад.
Маҳдудияти чорум он аст, ки барои retrieval ва LLM components ablation ҳаст, аммо ablation-и хориҷ кардани uncertainty-aware mechanism танҳо вуҷуд надорад.
Маҳдудияти панҷум он аст, ки фарзияи нигоҳ доштани expert suitability дар оянда аз рӯи historical similarity метавонад дар structural breaks-и комилан нав ноком шавад. Empirical historical grounding ин хатарро кам мекунад, вале unseen regime-ро пурра аз байн намебарад.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: Regime-Aware Portfolio Management via Retrieval-Augmented LLM-Guided Expert Switching
Муаллифон: Ahmad Asadi; Reza Safabakhsh.
Тартиби муаллифон: Тартиби манбаъ нигоҳ дошта шудааст.
Муассиса: Deep Learning Lab, Computer Engineering Department, Amirkabir University of Technology, Hafez Avenue, Tehran, Iran.
Манбаи боршуда: arXiv:2608.28252v1 [cs.AI].
Санаи пешниҳоди arXiv: 28 Августи 2026.
Санаи дидашаванда дар PDF: 31 Августи 2026.
Навъи манбаъ: Preprint.
Ҳолати peer review: arXiv v1-и боршуда Version of Record-и маҷаллаи peer-reviewed нест. То 21 Ноябри 2026 дар сабтҳои библиографии тасдиқшаванда journal version-и peer-reviewed ёфт нашудааст.
Версияи нави библиографӣ: Версияи 47-саҳифагии SSRN бо ҳамон унвон 23 Октябри 2026 нашр шудааст. DOI-и SSRN suggested citation 10.2139/ssrn.7661576 аст. Мазмуни илмии Verianla аз arXiv v1-и боршуда омода шудааст; мазмуни нави версияи баъдии SSRN ба ин мақола омехта нашудааст.
Corresponding / contact author: Дар arXiv PDF аломати corresponding-author равшан нест. Сабти баъдии SSRN Reza Safabakhsh-ро Contact Author нишон медиҳад.
Саҳми баробар: Дар манбаи боршуда equal contribution эълом нашудааст.
Литсензияи манбаъ: Дар arXiv v1 литсензияи равшани Creative Commons, ки истифодаи мустақими фигураҳоро барои Verianla тасдиқ кунад, муайян нашудааст. Аз ин рӯ фигураҳо айнан истифода нашуда, робитаҳои илмӣ ҳамчун схемаҳои мустақил бозсозӣ шудаанд.
Маблағгузорӣ: Дар PDF funding declaration-и ҷудогона ёфт нашудааст.
Ихтилофи манфиатҳо: Дар PDF conflict-of-interest / competing-interest declaration-и ҷудогона ёфт нашудааст.
Дастрасии маълумот: Data Availability-и ҷудогона ё пайванди тасдиқшудаи public dataset repository вуҷуд надорад.
Дастрасии код: Пайванди тасдиқшудаи public source-code repository вуҷуд надорад.
Усули асосӣ: Dual-stream Transformer-VAE market-state representation + chronological vector retrieval + Statement of Performance + instruction-tuned LLM guided expert switching + reinforcement-learning expert pool.
Expert pool: A2C, DDPG, PPO, TQC ва CrossQ.
Бозорҳо: Cryptocurrency, stock ва foreign exchange; дар ҳар market 30 symbol.
Басомади маълумот: Daily OHLCV.
Равзанаи вуруд: \(L=22\) рӯзи савдо.
Forward / уфуқи нигоҳдорӣ: \(H=5\) рӯз.
Retrieval: \(K=3\) ҳолати наздиктарини таърихӣ, cosine similarity.
Андозаи embedding: \(d=64\).
Ҳарорати LLM: 0,1.
Маҳдудияти даъвати LLM: Барои ҳар decision step ҳадди аксар як даъват.
Leakage control: Ҳангоми тест retrieval танҳо бо \(\tau<t\) historical observations маҳдуд аст.
Таҷҳизот: Як NVIDIA H100 GPU.
Такрори таҷриба: Барои ҳар market як run; натиҷаҳо repeated-seed averages нестанд.
Ҳудуди оморӣ: Confidence interval, formal significance test ва тақсимоти бисёр random-seed гузориш нашудаанд.
Натиҷаи назариявӣ: Monotonic Expert-Pool Performance танҳо зери bounded estimation error, conservative switching ва specialist dominance assumptions амал мекунад; барои даромади воқеии бозор кафолати бечунучаро нест.
Фарқи муҳими гузориш дар манбаъ: Table 5 standalone expert cumulative return бо Table 6 “Best Fixed” мувофиқат намекунад ва манбаъ сабабро шарҳ намедиҳад. Ҳамчунин Section 4.3 мегӯяд чор strategy муқоиса шудааст, вале танҳо се strategy-ро муайян мекунад.
Холиҳои бозтавлидшавӣ: Exact market-data provider, calendar-based train/validation/test split, transaction-cost, portfolio constraints, бисёр RL training hyperparameter, weighted-uncertainty formula, арзишҳои рақамии \(\epsilon/\tau/\delta\) ва prompt-validation-set size гузориш нашудаанд.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд