


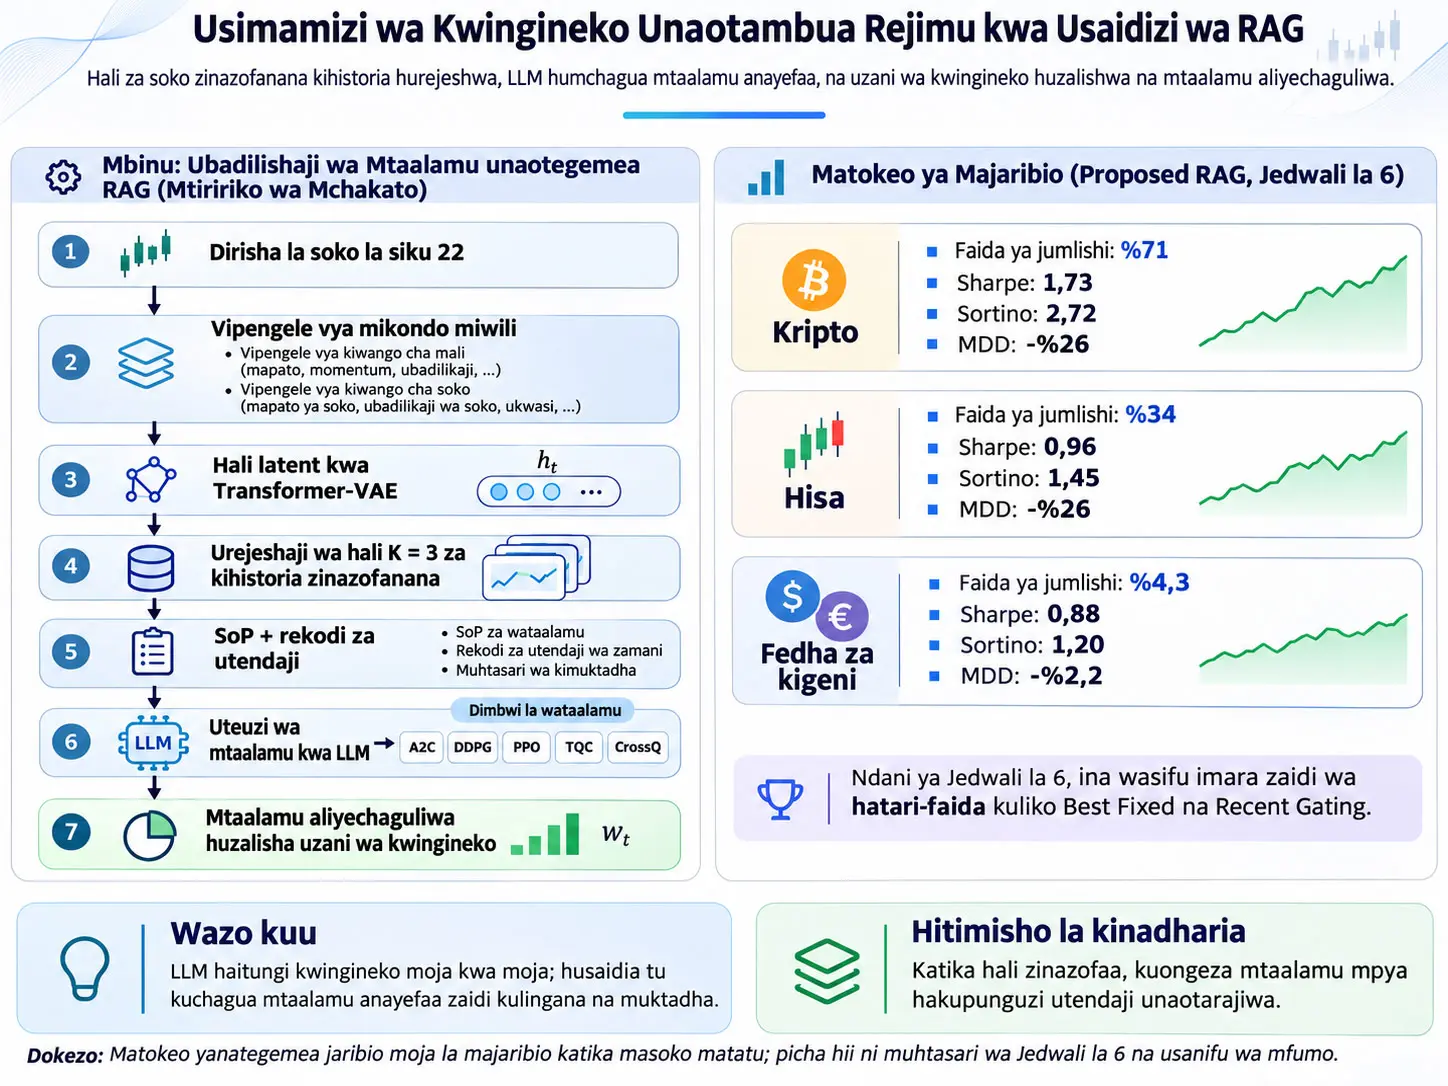
Retrieval-augmented LLM-guided expert switching ni mbinu ya uelekezaji wa kwingineko inayobadilika ambayo hulinganisha hali ya sasa ya soko na hali za kihistoria zinazofanana, huchunguza jinsi wataalamu tofauti wa kwingineko walivyofanya katika vipindi hivyo, na hutumia modeli kubwa ya lugha kuamua ni sera ipi ya mtaalamu itumike badala ya kuizalisha moja kwa moja uzani wa kwingineko. Utafiti unalenga tatizo kwamba katika mazingira ya kifedha ya non-stationary, ambako hali za soko hubadilika kwa muda, modeli moja ya kwingineko huenda isifanye vizuri zaidi katika kila regime.
Katika mbinu hii hali ya soko inawakilishwa kwa mikondo miwili tofauti ya taarifa. Mkondo wa kwanza hubeba vipengele vya kiwango cha mali kama log-return, RSI, MACD, ATR, realized volatility na volume-change; mkondo wa pili hubeba viashiria vya soko zima kama trend, volatility-regime na liquidity. Mikondo hiyo miwili hubadilishwa kuwa latent representation kwa Transformer-VAE encoder tofauti na kuunganishwa ndani ya \(h_t\) state vector moja. State za kihistoria huhifadhiwa katika vector database; kwa kila state huhifadhiwa utendaji wa siku tano zinazofuata wa wataalamu A2C, DDPG, PPO, TQC na CrossQ pamoja na rekodi za Statement of Performance (SoP).
Katika hatua ya uamuzi wa online, dirisha la sasa la soko la 22 trading-day hukodishwa katika nafasi hiyo hiyo ya latent na hali \(K=3\) za kihistoria zilizo karibu zaidi hurejeshwa kwa cosine similarity. Utendaji halisi wa wataalamu katika hali hizo za kihistoria, rekodi za SoP na muktadha wa sasa wa soko huwasilishwa kwa LLM. LLM haitengenezi yenyewe uzani wa kwingineko; hufanya tathmini ya kimuktadha kuhusu sera ipi ya mtaalamu ianzishwe. Kisha mtaalamu aliyechaguliwa wa reinforcement-learning hutengeneza uzani wa kwingineko.
Katika ulinganisho wa selection-strategy wa Table 6, Proposed RAG imepata %71 cumulative return na 1,73 Sharpe katika soko la cryptocurrency, %34 cumulative return na 0,96 Sharpe katika soko la hisa, na %4,3 cumulative return na 0,88 Sharpe katika soko la fedha za kigeni. Katika jedwali hilo hilo, thamani za Best Fixed Expert ni %68/1,64, %26/0,74 na %3,2/0,71 mtawalia. Hata hivyo, kila soko lilitathminiwa kwa experimental run moja tu, na wastani wa random seed nyingi au vipimo vya umuhimu wa kitakwimu havikuripotiwa.
Kuna tofauti muhimu ya ndani ya chanzo katika kutafsiri matokeo. Katika Table 5, cumulative return za juu zaidi za wataalamu waliokimbizwa peke yao ni %76,16 kwa TQC katika crypto, %38,21 kwa CrossQ katika hisa na %4,27 kwa A2C katika forex; thamani hizi zinatofautiana na “Best Fixed” za Table 6. Chanzo hakielezi kwa nini majedwali hayo mawili yanatoa matokeo tofauti ya “fixed expert”. Kwa hiyo utafiti unaunga mkono kwamba Proposed RAG ilifanya vizuri zaidi kuliko mikakati ya uchaguzi ndani ya Table 6; hauungi mkono hitimisho kwamba mfumo uliopendekezwa hutoa mapato makubwa kuliko wataalamu wote wa standalone katika kila hali.
Tatizo kuu la utafiti
Masoko ya fedha si mifumo tulivu. Kiwango cha volatility, liquidity, cross-asset relationships, muundo wa trend na tabia ya washiriki wa soko vinaweza kubadilika kwa muda. Kwa hiyo sera ya kwingineko iliyofanikiwa katika kipindi fulani huenda isionyeshe mafanikio sawa katika market regime nyingine.
Kujaribu kuoanisha modeli moja ya deep-learning au deep-reinforcement-learning na hali zote za soko kunaweza kuongeza uwezo wa modeli; hata hivyo modeli inaweza bado ku-overfit regularities ilizoziona wakati wa mafunzo. Mbinu ya Mixture-of-Experts hujaribu kupunguza tatizo hili kwa kutumia modeli tofauti za wataalamu, lakini katika miundo ya kawaida ya MoE learned gating network inayobainisha mtaalamu wa kuanzishwa inaweza pia kufanya uchaguzi usio sahihi katika regime ambazo hazijawahi kuonekana.
Mbinu mbadala inayopendekezwa na utafiti hubadilisha swali “ni modeli ipi ilikuwa na mafanikio zaidi katika siku chache zilizopita?” na swali “ni mtaalamu gani aliyekuwa na mafanikio zaidi katika vipindi vya kihistoria vilivyofanana na hali ya sasa ya soko?”
Retrieval-Augmented LLM-Guided Expert Switching ni Nini?
Retrieval-augmented LLM-guided expert switching ni mbinu ya expert-routing inayorejesha kutoka latent vector database hali za kihistoria zinazofanana na hali ya sasa ya soko, kuwasilisha utendaji halisi wa risk-return wa modeli za wataalamu katika hali hizo kwa utaratibu wa uelekezaji unaosaidiwa na LLM, na kuchagua mtaalamu wa kwingineko atakayetumika, bila kuifanya LLM itengeneze moja kwa moja uzani wa kwingineko.
Mfumo una hatua mbili tofauti
Hatua ya offline indexing huchakata mapema hali za kihistoria za soko. Kila historical window hubadilishwa kuwa latent state kwa dual-stream Transformer-VAE. Kisha wataalamu wote hutathminiwa katika forward horizon thabiti wakianzia hali hiyo hiyo ya kihistoria. Performance records na rekodi za Statement of Performance zilizopatikana huwekwa katika vector database pamoja na latent representation.
Hatua ya online inference hubadilisha hali ya sasa ya soko kuwa nafasi hiyo hiyo ya latent, hurejesha state \(K=3\) zinazofanana zaidi kutoka zamani, hukusanya rekodi husika za expert-performance na kutumia LLM kwa expert-selection. Kazi ya LLM si kutengeneza portfolio allocation, bali kutafsiri retrieved evidence na kubaini expert anayefaa.
Statement of Performance (SoP) ni nini?
Statement of Performance ni rekodi inayofupisha kimuktadha tabia na utendaji halisi wa mtaalamu husika kwa kila historical market episode. Katika chanzo, offline performance record ina cumulative return, Sharpe ratio na maximum drawdown. SoP hufupisha market context, expert behavior na uncertainty factors za kipindi hicho ili LLM ione si alama ya nambari pekee bali pia ushahidi wa kihistoria uliowekwa katika muktadha.
Je, LLM Hutengeneza Moja kwa Moja Uzani wa Kwingineko Katika Mfumo Huu?
Hapana. Instruction-tuned LLM katika utafiti hutafsiri rekodi za kihistoria za market-state zilizorejeshwa na tabia ya risk-return ya wataalamu, na kuchangia katika safu ya uelekezaji inayobainisha expert wa kuchaguliwa; portfolio weight vector halisi hutengenezwa na mtaalamu aliyechaguliwa wa A2C, DDPG, PPO, TQC au CrossQ.
Kwa nini LLM haitumiki moja kwa moja kama trader?
Tathmini ya fasihi katika utafiti inasisitiza kwamba trading agent za msingi wa LLM si mara zote bora kuliko buy-and-hold au mbinu za kiasi katika benchmark za muda mrefu. Kwa hiyo jukumu la LLM limebanwa. Badala ya kuhesabu moja kwa moja kiasi cha kununua na kuuza, modeli hutafsiri muktadha wa kihistoria, hutathmini mahusiano kati ya retrieved episodes na kutumika katika expert routing.
Kwa nini tathmini ya LLM imewekewa mipaka?
Katika matoleo ya awali ya prompt ilionekana kwamba LLM ilifanya extrapolation kwa return ambazo hazikuwepo katika retrieved historical records na ikatoa majibu yenye kujiamini kupita kiasi. Chanzo kinaripoti kwamba prompt iteration tano zilitathminiwa kwenye validation set na mean absolute estimation error ilipungua kutoka takriban %18 hadi %11.
Muundo wa mwisho wa prompt unatumia vikwazo vitatu vikuu:
- Empirical grounding: Tathmini ya risk-return inawekewa kikomo na retrieved historical MDD, realized information ratio na performance observations nyingine zilizotokea.
- Conservative margining: Candidate expert mpya huchaguliwa dhidi ya incumbent expert tu ikiwa estimated advantage yake inazidi uncertainty/noise margin.
- Tail-event separation: Vipindi vya extreme drawdown, liquidity squeeze na regime transition hutathminiwa tofauti na vipindi vya kawaida.
Chanzo hakiripoti validation set ilikuwa na sampuli ngapi, ilijumuisha vipindi gani vya soko, wala usambazaji kamili wa thamani %18 → %11.
Nadharia ya Monotonic Expert-Pool Inasema Nini?
Matokeo ya monotonicity katika chanzo hayasemi kwamba kuongeza mtaalamu mpya huongeza utendaji bila masharti; yanaonyesha tu kwamba chini ya dhana kwamba estimation error imewekewa kikomo na \(\epsilon\), switch threshold ni \(\tau\ge2\epsilon\), na utility advantage halisi ya mtaalamu mpya katika eneo lengwa inatimiza \(\delta>\tau+2\epsilon\), kuongeza specialist mpya kwenye expert pool hakutapunguza expected utility.
Mlinganyo 1: Thamani inayotarajiwa ya switching policy
\[ V(\pi_N) = \int_{\mathcal{S}} U_{\pi_N(s)}(s)\,d\mathbb{P}(s). \tag{1} \]
Huhesabu nini? Huhesabu expected risk-adjusted utility ya switching policy yenye wataalamu \(N\) katika nafasi nzima ya market-state.
- \(\mathcal{S}\): nafasi ya latent market state zinazowezekana.
- \(\mathbb{P}\): kipimo cha uwezekano juu ya nafasi ya state.
- \(\pi_N(s)\): indeksi ya expert aliyechaguliwa kwa state \(s\).
- \(U_i(s)\): risk-adjusted utility halisi iliyotokea ya expert \(i\) katika state \(s\).
Kitengo mahususi cha kifizikia cha \(U_i(s)\) hakijafafanuliwa katika chanzo. Katika modeli ya kinadharia ni kiasi kwenye skeli ya utility na hakijulikani moja kwa moja wakati wa decision time.
Mlinganyo 2: Expert assessment inayosaidiwa na LLM
\[ \rho_i(s) = \mathcal{M} \left( \mathcal{H}_t(s),E_i \right). \tag{2} \]
\(\mathcal{H}_t(s)\) ni seti ya retrieved historical episodes zinazofanana na current state \(s\); \(E_i\) ni expert husika; \(\mathcal{M}\) ni utaratibu wa tathmini unaofanya kazi juu ya retrieved evidence, na \(\rho_i(s)\) ni estimated assessment inayotumiwa ndani ya switching procedure.
Tofauti muhimu: \(\rho_i(s)\) si uchunguzi wa moja kwa moja wa \(U_i(s)\) halisi isiyojulikana. Historical performance records hutoa msingi wa nambari; LLM hutafsiri retrieved context na kuchangia assessment calibration.
Mlinganyo 3: Axiom 1 — bounded estimation error
\[ \sup_{s\in\mathcal{S}} \left| \rho_i(s)-U_i(s) \right| \le \epsilon, \qquad \forall i\in\{1,\ldots,N+1\}. \tag{3} \]
Sharti hili linadhania kwamba kosa kubwa zaidi kati ya estimated assessment na utility halisi halizidi \(\epsilon\). \(\epsilon\) iko kwenye skeli ile ile ya utility/assessment kama \(\rho\) na \(U\).
Hii si sifa iliyothibitishwa kwa majaribio katika nafasi yote ya state. Practical implementation ya chanzo hujaribu kukaribia aksioma hii kwa kuilazimisha LLM kutofanya extrapolation nje ya retrieved empirical observations.
Mlinganyo 4: Expert mwenye estimated utility ya juu zaidi
\[ e^*(s) = \arg\max_{i\in\{1,\ldots,N\}} \rho_i(s). \tag{4} \]
Usemi huu huchagua kwa state \(s\) indeksi ya expert mwenye estimated assessment ya juu zaidi ndani ya expert pool iliyopo.
Mlinganyo 5: Conservative switching
\[ \pi_N(s) = \begin{cases} e^*(s), & \rho_{e^*(s)}(s) - \rho_{\pi_N(s)}(s) > \tau, \\ \pi_N(s), & \text{aksi durumda}. \end{cases} \tag{5} \]
na:
\[ \tau\ge2\epsilon. \]
Ikiwa estimated advantage ya candidate expert dhidi ya incumbent expert si kubwa kuliko \(\tau\), expert wa sasa huendelea kutumika. Lengo ni kupunguza switching isiyo ya lazima kutokana na estimation noise.
Mlinganyo 6: Axiom 3 — specialist dominance
\[ U_{N+1}(s) \ge U_{\pi_N(s)}(s) + \delta, \qquad s\in\mathcal{S}_R, \tag{6} \]
na:
\[ \delta > \tau+2\epsilon. \]
\(\mathcal{S}_R\) ni market-state subset inayolengwa na specialist expert mpya, na chanzo hudhania \(P(\mathcal{S}_R)>0\). Mtaalamu mpya lazima awe na utility halisi iliyo angalau \(\delta\) juu ya incumbent policy katika eneo hili.
Dokezo la usemi wa ndani ya chanzo: Mara baada ya Axiom 3, chanzo kinaandika kwamba utility ya expert mpya nje ya specialist region inadhaniwa kuwa “unlimited”. Haijafafanuliwa kando kama neno hili linatumika kimahesabu kwa maana ya “unrestricted/unconstrained”. Verianla haibadilishi usemi huu kimya kimya kwa dhana nyingine.
Milinganyo 7–9: Kwa nini switching yenye makosa haitarajiwi kupunguza utility?
\[ U_{N+1}(s) \ge \rho_{N+1}(s)-\epsilon. \tag{7} \]
\[ U_{\pi_N(s)}(s) \le \rho_{\pi_N(s)}(s)+\epsilon. \tag{8} \]
Ukichanganya ukosefu wa usawa huo miwili:
\[ U_{N+1}(s) - U_{\pi_N(s)}(s) > \tau-2\epsilon. \tag{9} \]
Kwa kuwa \(\tau\ge2\epsilon\), upande wa kulia si hasi. Hivyo, ikiwa error bound iliyotajwa ni halali kweli, mabadiliko yanayovuka switching threshold hayatarajiwi kupunguza utility halisi.
Milinganyo 10–11: Uboreshaji madhubuti katika eneo lengwa la specialist
\[ \rho_{N+1}(s) - \rho_{\pi_N(s)}(s) \ge \delta-2\epsilon. \tag{10} \]
Kwa kuwa \(\delta>\tau+2\epsilon\):
\[ \delta-2\epsilon>\tau. \]
Kwa hiyo specialist hutimiza switching criterion ndani ya target region. Minimum contribution kwa expected utility:
\[ \Delta V \ge \int_{\mathcal{S}_R} \delta\,d\mathbb{P}(s) = \delta \mathbb{P}(\mathcal{S}_R) > 0. \tag{11} \]
hupatikana.
Kisha chanzo kinaeleza kwamba specialist wakiongezwa kwa mfuatano:
\[ V(\pi_1) \le V(\pi_2) \le \cdots \le V(\pi_K) \]
hupatikana non-decreasing policy-value sequence ya umbo hilo, na imewekewa kikomo cha juu na:
\[ V^* = \int_{\mathcal{S}} \sup_E U_E(s) \,d\mathbb{P}(s) \]
best-achievable utility inayofafanuliwa na usemi huo.
Tafsiri sahihi ya nadharia: Matokeo haya hayamaanishi kwamba “tukiongeza idadi ya wataalamu, mapato halisi ya kwingineko yataongezeka kila wakati”. Matokeo ni halali kimahesabu tu ikiwa Axiom 1–3 zinatimizwa kweli. Practical prompt rules, kwa maneno ya chanzo, si ushahidi wa aksioma hizi bali ni implementation heuristics za kufanya tabia ya LLM ilingane zaidi na aksioma hizo.
Hali ya soko inawakilishwa na vipengele gani?
Katika kila wakati wa uamuzi hutengenezwa rolling-window tensor mbili.
Asset-level technical tensor:
\[ S_t^{tech} \in \mathbb{R}^{L\times A\times F_1}. \]
Hapa \(L\) ni urefu wa rolling-window, \(A\) ni idadi ya mali katika kwingineko, na \(F_1\) ni idadi ya asset-level feature. Katika majaribio \(L=22\) trading day na \(A=30\) hutumika.
Seti ya vipengele vya kiwango cha asset:
- Log-return: Huwakilisha mabadiliko ya logarithmic ya bei zinazofuatana.
- RSI: Relative Strength Index; kiashiria cha kiufundi kinachofupisha muundo wa momentum linganishi wa mabadiliko ya bei.
- MACD: Moving Average Convergence Divergence; huwakilisha muundo wa trend/momentum kwa kutumia uhusiano wa moving averages katika vipimo tofauti vya wakati.
- ATR: Average True Range; huwakilisha ukubwa wa volatility unaotegemea masafa ya mabadiliko ya bei.
- Realized volatility: taarifa ya volatility inayotokana na mabadiliko ya bei yaliyoonekana.
- Volume changes: mabadiliko ya kiasi cha biashara.
Tensor ya soko zima:
\[ S_t^{mkt} \in \mathbb{R}^{L\times F_2}. \]
Mkondo huu una aggregate trend indicators, volatility-regime measures na liquidity variables. Ingawa chanzo kinataja macroeconomic conditions katika maelezo ya jumla ya kinadharia, hakiorodheshi external macroeconomic series zilizotumika katika utekelezaji; kwa hiyo Verianla haiongezi data za nje za riba, mfumuko wa bei au data set nyingine zinazofanana.
Features zote husanifishwa kwa rolling z-score normalization. Chanzo kinaeleza kwamba lengo ni kupunguza athari za skeli zinazobadilika na kupunguza athari ya heteroskedasticity kwenye state representation.
Mlinganyo 12: Usambazaji wa posterior wa Transformer-VAE
\[ q_{\phi_x} \left( z_x\mid S_t^x \right) = \mathcal{N} \left( \mu_x(S_t^x), \Sigma_x(S_t^x) \right), \qquad x\in\{tech,mkt\}. \tag{12} \]
Kila feature stream huchorwa kwenye Gaussian posterior na Transformer encoder yake. \(\mu_x\) ni posterior mean, \(\Sigma_x\) ni diagonal covariance na \(z_x\) ni latent representation.
Vigezo hivi havina kitengo cha kifizikia; ni quantities za latent-space zilizojifunzwa kutoka input zilizosawazishwa.
Mlinganyo 13: Reparameterization
\[ z_x = \mu_x + \varepsilon\odot\sigma_x, \qquad \varepsilon \sim \mathcal{N}(0,I). \tag{13} \]
\(\odot\) ni element-wise multiplication. \(\sigma_x\) ni posterior standard deviation vector. Reparameterization huwezesha gradient-based training kuendelea wakati stochastic latent sampling inafanywa.
Wakati wa pretraining, sampled latent representation hutumiwa na decoder kwa input reconstruction. Baada ya pretraining kukamilika, decoder huondolewa na encoder huhifadhiwa kwa market-state representation.
Mlinganyo 14: Kuunganisha latent stream mbili
\[ h_t = \left[ z_t^{tech} \mid z_t^{mkt} \right] \in \mathbb{R}^{D}. \tag{14} \]
\(h_t\) ni matokeo ya concatenation ya asset-specific na market-wide latent vectors. Kwa kuwa representation function ileile hutumiwa katika historical indexing na online query, current state na historical state hulinganishwa katika nafasi ileile ya latent.
Katika sehemu ya majaribio, retrieval embedding dimension:
\[ d=64 \]
imeainishwa hivyo. Chanzo hakielezi kwa undani uhusiano wa notation kati ya \(D\) na alama \(d\) katika implementation hii.
Mlinganyo 15: Rekodi ya Historical index
\[ D_{\tau} = \left( h_{\tau}, R_{\tau}^{(e)}, SoP_{\tau}^{(e)} \right), \qquad e\in\{1,\ldots,E\}. \tag{15} \]
Kila rekodi ya state ya kihistoria huunganisha makundi matatu ya taarifa:
- \(h_{\tau}\): historical latent market state,
- \(R_{\tau}^{(e)}\): performance record halisi ya expert \(e\) kwenye forward horizon,
- \(SoP_{\tau}^{(e)}\): Statement of Performance katika hali hizo hizo.
Mlinganyo 16: Kuchagua state za kihistoria zilizo karibu zaidi
\[ \mathcal{N}_t = KNN \left( h_t, \{h_{\tau}\}, K \right). \tag{16} \]
Katika majaribio \(K=3\) hutumika. Similarity metric ni cosine similarity. Wakati wa test, hutumiwa tu:
\[ \tau<t \]
historical observations zinazotimiza sharti hilo kwa retrieval. Chronological restriction hii inalenga kuzuia future information kuvuja katika mchakato wa uamuzi.
Mlinganyo 17: Retrieval weight
\[ w_{\tau} = \frac{ sim(h_t,h_{\tau}) }{ \sum_{j\in\mathcal{N}_t} sim(h_t,h_j) }. \tag{17} \]
\(sim(h_t,h_{\tau})\) ni cosine similarity kati ya current state na historical state. \(w_{\tau}\) ni normalized retrieval weight isiyo na dimension.
Kikomo cha uwazi wa kihisabati: Cosine similarity inaweza kuwa hasi kinadharia. Chanzo hakielezi kabla ya Eq. 17 kama similarity zinakatwa hadi masafa chanya, softmax inatumika, au hali ya jumla ya similarity kuwa sifuri inashughulikiwaje. Kwa hiyo si salama kudhani \(w_{\tau}\) ni classical convex weight katika kila hali.
Mlinganyo 18: Similarity-weighted expert performance
\[ \widehat{R}_t^{(e)} = \sum_{\tau\in\mathcal{N}_t} w_{\tau} R_{\tau}^{(e)}. \tag{18} \]
Mlinganyo huu huunganisha utendaji wa expert \(e\) katika retrieved historical episodes kwa uzani wa similarity. \(\widehat{R}_t^{(e)}\) hubeba skeli ileile ya utendaji ambayo \(R_{\tau}^{(e)}\) imefafanuliwa.
Kikomo cha notation ndani ya chanzo: Maelezo ya offline yanasema performance record ina cumulative return, Sharpe ratio na MDD; Eq. 18 inaandika \(R_{\tau}^{(e)}\) kama quantity moja ya kihisabati. Chanzo hakifafanui wazi jinsi metrika hizi zinavyobadilishwa kuwa scalar composite score au ikiwa Eq. 18 inatumika component-wise kwa kila metrika.
Algoriti 1: Uwekaji Fahirisi wa Regime Nje ya Mtandao na Uwekaji Msingi wa Utendaji wa Mtaalamu
- Kwa kila historical time step \(\tau\), asset-level na market-wide feature tensors huundwa.
- Dual-stream T-VAE huhesabu \(h_{\tau}\) latent embedding.
- Kila expert \(E^{(e)}\) huanzishwa kutoka historical state.
- Utendaji halisi wa expert kwenye forward horizon \(H\) huhesabiwa.
- Statement of Performance huundwa kwa episode hiyo hiyo.
- Rekodi \((h_{\tau},R_{\tau}^{(e)},SoP_{\tau}^{(e)})\) huandikwa kwenye historical index.
Algoriti 2: Retrieval ya Mtandaoni na Uamuzi wa Kwingineko
- Kutoka current market data huundwa \(S_t^{tech}\) na \(S_t^{mkt}\).
- Dual-stream T-VAE huhesabu \(h_t\).
- Vector database hutoa \(K=3\) nearest historical regimes.
- Similarity-weighted performance estimate huhesabiwa kwa kila expert.
- Algorithm 2 pia inasema weighted uncertainty \(\sigma_t^{(e)}\) huhesabiwa.
- Retrieved SoPs na current market context hupewa LLM.
- LLM huchangia uamuzi wa expert selection na \(e^*\) hubainishwa.
- Expert aliyechaguliwa \(E^{(e^*)}\) hutengeneza portfolio weights \(w_t\).
Kikomo cha reproducibility: Kwa weighted uncertainty \(\sigma_t^{(e)}\) katika Algorithm 2, chanzo hakitoi formula tofauti ya kihisabati. Verianla haijajaza pengo hili kwa kuongeza uncertainty estimator mpya.
Mbinu na Matokeo ya Utafiti
Muundo wa data ya majaribio
Utafiti hutumia daily OHLCV katika financial market class tatu tofauti:
- cryptocurrency 30,
- hisa 30,
- jozi 30 za foreign exchange.
OHLCV ni muundo wa data ya soko unaojumuisha Open, High, Low, Close na Volume. Ingawa utangulizi wa utafiti unataja muktadha wa high-frequency trading, majaribio halisi hayakufanywa kwa intraday high-frequency data bali kwa daily OHLCV.
| Kigezo | Thamani ya chanzo |
|---|---|
| Aina ya soko | Crypto, Hisa, Forex |
| Idadi ya symbol katika kila soko | 30 |
| Dirisha la ingizo \(L\) | siku 22 za biashara |
| Holding / forward horizon \(H\) | siku 5 |
| Majirani wa kihistoria \(K\) | 3 |
| Ufanano | Cosine similarity |
| Kipimo cha latent embedding | 64 |
| LLM temperature | 0,1 |
| Simu ya LLM | Kiwango cha juu 1 kwa kila uamuzi |
| Kizuizi cha future-leakage | Retrieval kwa \(\tau<t\) pekee |
| Maunzi | NVIDIA H100 GPU moja |
| Idadi ya marudio ya majaribio | 1 run kwa kila soko |
Paneli ya cryptocurrency
Alama 30 za cryptocurrency:
ADA, APT, ARB, ATOM, AVAX, BCH, BNB, BTC, DOGE, DOT, EGLD, ETC, ETH, FIL, HBAR, ICP, LINK, LTC, MATIC, MKR, NEAR, RNDR, SHIB, SOL, TON, TRX, UNI, VET, XLM na XRP.
Availability period si sawa kwa kila symbol. Table 2 ya chanzo inaripoti 4.275 sample kwa BTC na LTC kuanzia 17 Septemba 2014–31 Mei 2026, huku APT ikiwa na 1.311 sample kuanzia 20 Novemba 2021–24 Juni 2025. Baadhi ya series kama RNDR, MATIC, UNI na APT huishia kabla ya 2026.
Kwa kuwa hakuna standard broad-market benchmark moja kwa cryptocurrency market, chanzo kiliunda synthetic index mbili:
- indeksi ya faida ya jumla yenye uzani sawa / isiyo na uzani,
- indeksi ya faida ya jumla iliyopimwa kwa volume.
Chanzo kinaeleza kuwa equal-weighted raw-price aggregation hutawaliwa na idadi ndogo ya extreme constituents na kwa hiyo volume-weighted variant inapendelewa kama primary market-level descriptor.
Paneli ya hisa
Hisa 30:
TMO, MCD, NVDA, DIS, TSLA, CVX, XOM, ACN, V, WMT, KO, LIN, HD, GOOGL, CRM, UNH, BAC, COST, MA, PG, AAPL, JPM, JNJ, MSFT, MRK, META, AMZN, ABBV, BRK-B na PEP.
Stock series nyingi zina 6.641 sample kuanzia 3 Januari 2000–29 Mei 2026, huku kampuni zilizoorodheshwa baadaye zikiwa na history fupi. S&P 500, NASDAQ Composite na Dow Jones Industrial Average zilitumika kama marejeo ya stock market-level context.
Paneli ya fedha za kigeni
Jozi 30 za forex:
USDCAD, EURAUD, EURCHF, GBPCHF, CHFJPY, NZDCHF, AUDCAD, NZDCAD, GBPUSD, AUDUSD, GBPAUD, USDJPY, GBPJPY, NZDJPY, AUDNZD, EURGBP, USDCHF, EURCAD, AUDJPY, GBPCAD, USDTRY, AUDCHF, EURTRY, EURSEK, GBPNZD, EURUSD, NZDUSD, EURJPY, EURNZD na CADJPY.
Kwa FX, chanzo hakiripoti standard broad-market composite index moja. Market-wide condition inawakilishwa kupitia aggregate market-feature channel ya dual-stream encoder.
Kikomo cha chanzo cha data: PDF haisemi wazi OHLCV series zilipakuliwa kutoka market-data provider au API gani. Kwa hiyo Verianla haidhanii Yahoo Finance, Binance, Alpha Vantage au mtoa huduma mwingine.
Wataalamu watano wa reinforcement-learning
| Mtaalamu | Jukumu kuu lililotolewa katika chanzo |
|---|---|
| A2C | Advantage Actor-Critic; synchronous actor-critic policy-gradient mbinu. |
| DDPG | Deep Deterministic Policy Gradient; off-policy actor-critic kwa continuous action space. |
| PPO | Proximal Policy Optimization; mbinu ya policy-gradient inayolenga training stability kwa kuweka kikomo ukubwa wa policy update. |
| TQC | Truncated Quantile Critics; mtaalamu wa distributional reinforcement-learning anayemodeli reward distribution kwa quantile critics. |
| CrossQ | Mbinu ya off-policy reinforcement-learning iliyoongezwa ili kuongeza behavioral diversity ndani ya expert pool. |
Metrika za tathmini
Cumulative return inawakilisha jumla ya mapato ya kwingineko yaliyokusanywa katika kipindi cha tathmini.
Annualized return hubadilisha mapato kuwa skeli ya mwaka. Hata hivyo exact annualization convention iliyotumiwa na chanzo haijatolewa kwa formula tofauti.
Annualized volatility ni kipimo cha mwaka cha return variability.
Sharpe ratio ni metrika ya risk-adjusted performance inayohusisha mapato na total variability/risk. Chanzo hakiripoti risk-free rate iliyotumika wala exact annualization formula.
Sortino ratio hulenga downside variability badala ya total variability. Chanzo hakiripoti target return au minimum acceptable return.
Maximum Drawdown (MDD) hupima anguko kubwa zaidi la portfolio value kutoka peak hadi trough inayofuata. Kadiri ukubwa kamili wa thamani hasi unavyokuwa mdogo, drawdown huwa nyepesi; kwa mfano −%22 ni hasara ndogo kuliko −%29.
Utendaji wa standalone expert
| Soko | Mtaalamu | Faida ya Jumla | Sharpe | Sortino | MDD | Utawala |
|---|---|---|---|---|---|---|
| Crypto | A2C | %63,00 | 1,61 | 2,44 | −%25 | 19 wiki / %34,5 |
| Crypto | DDPG | %71,26 | 1,74 | 2,73 | −%26 | 6 wiki / %10,9 |
| Crypto | PPO | %60,49 | 1,57 | 2,38 | −%27 | 3 wiki / %5,5 |
| Crypto | CrossQ | %53,66 | 1,44 | 2,24 | −%28 | 9 wiki / %16,4 |
| Crypto | TQC | %76,16 | 1,71 | 2,63 | −%29 | 18 wiki / %32,7 |
| Hisa | A2C | %32,16 | 0,90 | 1,35 | −%23 | 17 wiki / %19,3 |
| Hisa | DDPG | %28,89 | 0,85 | 1,26 | −%24 | 5 wiki / %5,7 |
| Hisa | PPO | %33,38 | 0,96 | 1,46 | −%22 | 21 wiki / %23,9 |
| Hisa | CrossQ | %38,21 | 0,95 | 1,42 | −%27 | 32 wiki / %36,4 |
| Hisa | TQC | %32,09 | 0,86 | 1,28 | −%26 | 13 wiki / %14,8 |
| Forex | A2C | %4,27 | 0,88 | 1,20 | −%2,18 | 6 wiki / %6,8 |
| Forex | DDPG | %1,80 | 0,36 | 0,46 | −%2,85 | 12 wiki / %13,6 |
| Forex | PPO | %4,07 | 0,88 | 1,20 | −%2,00 | 9 wiki / %10,2 |
| Forex | CrossQ | %2,62 | 0,53 | 0,69 | −%2,68 | 18 wiki / %20,5 |
| Forex | TQC | %2,26 | 0,48 | 0,60 | −%2,18 | 43 wiki / %48,9 |
Matokeo yanaunga mkono wazo la utaalamu wa wataalamu: faida ya jumla ya juu zaidi, Sharpe ya juu zaidi, MDD ya chini zaidi na utawala wa mara nyingi zaidi havijakusanyika kwa mtaalamu mmoja.
Katika crypto, TQC ina faida ya jumla ya juu zaidi (%76,16), huku DDPG ikiwa na Sharpe na Sortino za juu zaidi (1,74 na 2,73), na A2C ikitoa MDD ndogo zaidi (−%25). Katika hisa, CrossQ ina faida ya jumla ya juu zaidi (%38,21), PPO ina Sharpe/Sortino za juu zaidi (0,96/1,46) na MDD ndogo zaidi (−%22). Katika forex, A2C inaongoza kwa faida ya jumla ya %4,27; PPO na A2C zinalingana katika Sharpe/Sortino kwa 0,88/1,20, huku MDD ndogo zaidi ikiwa −%2,00 kwa PPO.
Proposed switcher ilichagua wataalamu gani na kwa marudio gani?
| Mtaalamu | Crypto | Hisa | Forex |
|---|---|---|---|
| A2C | %34,5 | %19,3 | %6,8 |
| TQC | %32,7 | %14,8 | %48,9 |
| CrossQ | %16,4 | %36,4 | %20,5 |
| DDPG | %10,9 | %5,7 | %13,6 |
| PPO | %5,5 | %23,9 | %10,2 |
Mgawanyo huu unaonyesha kuwa hakuna mtaalamu mmoja anayetawala katika masoko yote. Katika soko la crypto A2C na TQC huchaguliwa mara kwa mara, katika soko la hisa CrossQ, na katika forex TQC ina marudio ya juu zaidi.
Kiteuzi cha Proposed RAG Kilitoa Matokeo Gani katika Masoko Matatu?
Katika ulinganisho wa mikakati ya uteuzi wa Table 6, Proposed RAG ilipata faida ya jumla ya %71 na Sharpe ya 1,73 katika crypto; %34 na 0,96 katika hisa; na %4,3 na 0,88 katika forex, hivyo ikionyesha faida ya jumla na Sharpe za juu kuliko mikakati ya Best Fixed na Recent-Performance Gating katika jedwali hilo hilo; hata hivyo, matokeo ni run moja tu kwa kila soko na katika Table 5 baadhi ya wataalamu wa standalone wana thamani za faida ya jumla zilizo juu kuliko Proposed RAG.
| Soko | Mbinu | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|---|---|
| Crypto | Best Fixed | %68 | %62 | 0,32 | 1,64 | 2,54 | −%27 |
| Crypto | Recent Gating | %69 | %62 | 0,32 | 1,66 | 2,57 | −%27 |
| Crypto | Proposed RAG | %71 | %64 | 0,31 | 1,73 | 2,72 | −%26 |
| Hisa | Best Fixed | %26 | %14 | 0,21 | 0,74 | 1,11 | −%26 |
| Hisa | Recent Gating | %33 | %17 | 0,20 | 0,91 | 1,37 | −%24 |
| Hisa | Proposed RAG | %34 | %18 | 0,19 | 0,96 | 1,45 | −%26 |
| Forex | Best Fixed | %3,2 | %1,8 | 0,026 | 0,71 | 0,92 | −%1,9 |
| Forex | Recent Gating | −%0,4 | −%0,2 | 0,029 | −0,062 | −0,08 | −%2,6 |
| Forex | Proposed RAG | %4,3 | %2,4 | 0,028 | 0,88 | 1,20 | −%2,2 |
Proposed RAG si bora kabisa katika kila kipimo cha hatari. Katika soko la hisa, MDD ya Recent Gating ni −%24 huku Proposed RAG ikiwa −%26. Katika forex, MDD ya Best Fixed ni −%1,9 huku Proposed RAG ikiwa −%2,2. Kwa hiyo, tafsiri ya “risk-return profile” ya chanzo inategemea kutathmini kwa pamoja faida ya jumla, Sharpe, Sortino, volatility na MDD; haipaswi kupanuliwa kuwa “bora katika kila kiashiria cha hatari”.
Tofauti ya “Best Fixed” kati ya Table 5 na Table 6
Chanzo kinatoa matokeo ya wataalamu wa standalone katika Table 5 na matokeo ya mikakati ya uteuzi katika Table 6 kando. Hata hivyo, ingawa ingeweza kutarajiwa kwamba majedwali hayo mawili yafikie thamani ile ile ya faida ya jumla kwa “mtaalamu bora wa kudumu”, thamani hizo hazilingani:
| Soko | Faida ya juu zaidi ya standalone katika Table 5 | Table 6 Best Fixed | Table 6 Proposed RAG |
|---|---|---|---|
| Crypto | TQC: %76,16 | %68 | %71 |
| Hisa | CrossQ: %38,21 | %26 | %34 |
| Forex | A2C: %4,27 | %3,2 | %4,3 |
Chanzo hakielezi tofauti hii kwa split tofauti, kipindi, portfolio construction, initialization au kigezo kingine cha itifaki. Kwa hiyo, utaratibu mpya haupaswi kuhitimishwa kutokana na tofauti hii ya majedwali.
Zaidi ya hayo, maandishi ya Section 4.3 yanatumia kauli “four strategies”, lakini mara moja baadaye yanafafanua mikakati mitatu tu: Best Fixed Expert, Recent-Performance Gating na Proposed RAG. Table 6 pia ina mikakati hii mitatu pekee. Kwa kuwa chanzo hakibainishi mkakati wa nne ni upi, Verianla haiongezi baseline mpya.
Ablation ya ukubwa wa expert pool
| Soko | Idadi ya Wataalamu | Fixed Sharpe | RAG Sharpe | Δ Sharpe |
|---|---|---|---|---|
| Crypto | 1 | 0,81 | 0,81 | %0,0 |
| Crypto | 2 | 0,84 | 0,85 | %1,2 |
| Crypto | 3 | 0,89 | 0,98 | %10,1 |
| Crypto | 4 | 0,96 | 1,15 | %19,8 |
| Hisa | 1 | 0,43 | 0,43 | %0,0 |
| Hisa | 2 | 0,51 | 0,52 | %2,0 |
| Hisa | 3 | 0,55 | 0,63 | %14,5 |
| Hisa | 4 | 0,59 | 0,72 | %22,0 |
| Forex | 1 | 0,35 | 0,35 | %0,0 |
| Forex | 2 | 0,43 | 0,44 | %2,3 |
| Forex | 3 | 0,46 | 0,55 | %19,6 |
| Forex | 4 | 0,51 | 0,65 | %27,5 |
Kwa kuwa haiwezekani kufanya switch wakati kuna mtaalamu mmoja, matokeo ya RAG na fixed ni sawa. Improvement inaongezeka katika pool zenye wataalamu watatu na wanne. Chanzo kinatafsiri hili kama ushahidi kwamba si idadi ya modeli pekee bali pia utofauti wa complementary expertise ni muhimu.
Kizuizi: Ingawa mfumo kamili una wataalamu watano, Table 7 inaripoti expert pool zenye wataalamu 1–4 pekee. Aidha, jedwali halibainishi wataalamu waliongezwa kwa mpangilio gani kwenye nested pool. Kwa hiyo, haiwezekani kufanya extrapolation ya aina “mtaalamu wa tano akiongezwa improvement itakuwa kiasi fulani”.
Ablation ya vipengele vya Retrieval na LLM
| Soko | Configuration | Cumulative Return | Sharpe | MDD |
|---|---|---|---|---|
| Crypto | NR — No Retrieval | %64,8 | 1,622 | −%26,7 |
| Crypto | R−LLM — No LLM | %69,1 | 1,661 | −%27,1 |
| Crypto | Full — R+L+U | %71 | 1,73 | −%26 |
| Hisa | NR — No Retrieval | %33,1 | 0,911 | −%24,4 |
| Hisa | R−LLM — No LLM | %25,5 | 0,735 | −%26,5 |
| Hisa | Full — R+L+U | %34 | 0,96 | −%26 |
| Forex | NR — No Retrieval | %3,2 | 0,710 | −%1,9 |
| Forex | R−LLM — No LLM | −%0,2 | −0,025 | −%2,4 |
| Forex | Full — R+L+U | %4,3 | 0,88 | −%2,2 |
Retrieval inapoondolewa, faida ya jumla hushuka katika masoko yote ikilinganishwa na full configuration. LLM inapoondolewa, kushuka huwa dhahiri zaidi katika majaribio ya hisa na forex. Kwa mfano, katika forex, full model hutoa faida ya jumla ya %4,3 na Sharpe ya 0,88, huku no-LLM configuration ikishuka hadi −%0,2 na −0,025.
Hata hivyo, full model haitoi MDD ya chini kabisa katika kila soko. Katika hisa, no-retrieval MDD ya −%24,4 ni ndogo kuliko −%26 ya full model; katika forex pia no-retrieval ni −%1,9 huku full model ikiwa −%2,2.
Kizuizi muhimu cha ablation: Source Table 8 haina configuration inayokiondoa peke yake kipengele cha uncertainty-aware. Kwa hiyo, michango ya retrieval na LLM reasoning inaweza kuhitimishwa kwa majaribio; mchango huru wa uncertainty-aware decision making hauwezi kupimwa kwa ablation hii.
Usikivu wa Indexing LLM
| Indexing LLM | Mafanikio | Kushindwa |
|---|---|---|
| Google/Gemma4-E4B | %28 | %72 |
| Google/Gemma4-31B-it | %96 | %4 |
| AliBaba/Qwen3.6-27B-it | %100 | %0 |
Kipimo hiki cha “success” si faida ya uwekezaji. Chanzo kinakifafanua kama mafanikio ya kufuata indexing instructions na kutoa kwa usahihi structured output format inayotarajiwa.
Usikivu wa Inference LLM
| Soko | Inference LLM | Cum. Return | Sharpe | Sortino | MDD |
|---|---|---|---|---|---|
| Crypto | Google/Gemma4-31B-it | %68,3 | 1,65 | 2,55 | −%27 |
| Crypto | Google/Gemma4-E4B | %63,5 | 1,57 | 2,42 | −%28 |
| Crypto | AliBaba/Qwen3.6-27B-it | %71 | 1,73 | 2,72 | −%26 |
| Hisa | Google/Gemma4-31B-it | %25,1 | 0,73 | 1,09 | −%26,5 |
| Hisa | Google/Gemma4-E4B | %24,5 | 0,71 | 1,06 | −%27 |
| Hisa | AliBaba/Qwen3.6-27B-it | %34 | 0,96 | 1,45 | −%26 |
| Forex | Google/Gemma4-31B-it | −%0,3 | −0,05 | −0,06 | −%2,5 |
| Forex | Google/Gemma4-E4B | −%5,4 | −1,07 | −1,37 | −%5,6 |
| Forex | AliBaba/Qwen3.6-27B-it | %4,3 | 0,88 | 1,20 | −%2,2 |
Katika chanzo, AliBaba/Qwen3.6-27B-it inatoa inference results zenye nguvu zaidi katika masoko yote matatu. Hasa katika forex, uchaguzi wa LLM uliunda tofauti kubwa katika matokeo. Ugunduzi huu unaonyesha kuwa retrieval mechanism pekee haitoshi, na kwamba jinsi retrieved evidence inavyochakatwa na downstream reasoning model pia ni muhimu.
Ulinganisho na mbinu za state-of-the-art
| Soko | Mbinu | Cum. Return | Ann. Return | Ann. Vol. | Sharpe | MDD |
|---|---|---|---|---|---|---|
| Crypto | TAC | %24 | %21,6 | 0,94 | 1,29 | −%31 |
| Crypto | AlphaMixRL | %22 | %19,8 | 1,00 | 1,38 | −%29 |
| Crypto | LLM-MAS | %33 | %30 | 0,96 | 1,50 | −%28 |
| Crypto | Proposed | %71 | %64 | 0,31 | 1,73 | −%26 |
| Hisa | TAC | %10,4 | %5,6 | 0,25 | 0,74 | −%28 |
| Hisa | AlphaMixRL | %11,8 | %6,3 | 0,31 | 0,82 | −%27 |
| Hisa | Multi-LLM Black–Litterman | %31 | %16,4 | 0,28 | 0,91 | −%29 |
| Hisa | Proposed | %34 | %18 | 0,19 | 0,96 | −%26 |
| Forex | TAC | %0,7 | %0,4 | 0,45 | 0,61 | −%5,1 |
| Forex | AlphaMixRL | %0,8 | %0,45 | 0,50 | 0,68 | −%4,6 |
| Forex | Fine-tuned LLaMA | %3,3 | %1,9 | 0,08 | 0,76 | −%3,1 |
| Forex | Proposed | %4,3 | %2,4 | 0,03 | 0,88 | −%2,2 |
Katika Table 11 ya chanzo, Proposed framework inatoa faida ya jumla na Sharpe za juu zaidi katika masoko yote matatu. Hata hivyo, waandishi wanaeleza wazi katika sehemu ya matokeo kwamba competing implementations hazikuendeshwa kila wakati chini ya experimental protocol iliyo sawa kabisa. Kwa hiyo, Table 11 inapotathminiwa kama ulinganisho wa benchmark uliodhibitiwa, tahadhari inahitajika kuhusu usawa wa itifaki.
Matokeo yanayoungwa mkono na utafiti
- Katika expert pool iliyochunguzwa, ubora wa jamaa wa wataalamu ulitofautiana kulingana na soko na vipimo.
- Ndani ya Table 6, retrieval-based Proposed RAG ilitoa faida ya jumla na Sharpe za juu kuliko Best Fixed na Recent Gating katika masoko yote matatu.
- Kuondoa Retrieval kulipunguza faida ya jumla katika masoko yote matatu ikilinganishwa na full configuration.
- Kuondoa LLM reasoning kulihusishwa na kushuka muhimu kwa utendaji hasa katika majaribio ya hisa na forex.
- Expert-pool ablation ilionyesha kuwa Sharpe improvement iliyoripotiwa iliongezeka katika safu ya wataalamu 1–4 kadiri idadi ya complementary expert ilivyoongezeka.
- Uchaguzi wa Inference LLM ulibadilisha matokeo kwa kiasi kikubwa, na Qwen3.6-27B-it ikatoa matokeo yenye nguvu zaidi kati ya modeli tatu zilizojaribiwa.
- Nadharia ya kihisabati ya chanzo inahakikisha, chini ya Axiom 1–3, kwamba kuongeza specialist anayefaa hakutapunguza expected utility.
Ujumlishaji ambao utafiti hauungi mkono
- Haijathibitishwa kwamba mbinu iliyopendekezwa itatoa faida ile ile katika soko hai kwa fedha halisi.
- Thamani za faida ya jumla %71, %34 na %4,3 si dhamana ya faida ya uwekezaji ya baadaye.
- LLM haijathibitishwa kuwa trader aliyefanikiwa peke yake; katika utafiti LLM ina jukumu la expert-routing.
- Nadharia ya monotonicity haisemi kwamba kuongeza expert hakuwezi kupunguza utendaji bila Axiom 1–3 kutimizwa.
- Matokeo ya Table 6 hayathibitishi kwamba Proposed RAG inatoa faida ya jumla ya juu kuliko wataalamu wote wa standalone.
- Experimental run moja si ushahidi wa statistical confidence interval au random-seed robustness.
- Component ablation haikupima mchango huru wa uncertainty-aware mechanism.
- Matokeo katika masoko matatu hayawezi kujumlishwa kiotomatiki kwa masoko yote, vipindi vyote au mazingira tofauti ya transaction-cost.
- Kuwepo kwa latent state inayofanana kihistoria hakuhakikishi kwamba mienendo ile ile ya soko itajirudia baadaye.
Taarifa ambazo hazipo katika chanzo au zimebaki na utata kuhusu uzalishaji upya
Market-data provider: Haijaripotiwa.
Exact train / validation / test calendar split: Chronological retrieval na kizuizi cha \(\tau<t\) vimetolewa; hata hivyo, jedwali la train/validation/test split lenye tarehe wazi za kuanza na kumaliza kwa masoko yote halijatolewa.
Thamani ya Transaction-cost: Inaelezwa kwamba ulinganisho wa SOTA ulijaribiwa kufanywa chini ya transaction-cost assumptions zile zile; thamani ya nambari ya fee/slippage haijaripotiwa.
Portfolio constraints: Inaelezwa kwamba constraints zile zile zilijaribiwa kutumiwa; thamani za long-only, leverage, short-selling, cash allocation au weight bound hazijaorodheshwa wazi.
RL expert training hyperparameters: Majina na madarasa ya mbinu za A2C, DDPG, PPO, TQC na CrossQ yametolewa; learning rate, batch size, optimizer, network depth, reward function na mipangilio mingine ya training ya kila modeli haijawasilishwa katika PDF hii kama reproducibility table kamili.
Weighted uncertainty: Algorithm 2 inaeleza kwamba \(\sigma_t^{(e)}\) inahesabiwa; fomula yake haijatolewa.
Vigezo vya nadharia: \(\epsilon\), \(\tau\) na \(\delta\) zimefafanuliwa kama masharti ya kinadharia; thamani za nambari zilizotumiwa katika majaribio hazijatolewa.
Prompt validation set: Prompt iteration tano zimeripotiwa; validation sample size na mgawanyo kamili wa vipindi haujabainishwa.
Expert-pool ablation: Ingawa full pool ina wataalamu watano, Table 7 inatoa matokeo ya wataalamu 1–4 pekee na haielezi mpangilio ambao wataalamu waliongezwa kwenye nested pool.
Statistical significance: Random seed nyingi, confidence interval, p-value au formal hypothesis test hazijaripotiwa.
Public code repository: Kiungo kilichothibitishwa cha public code repository hakijatolewa katika PDF iliyopakiwa.
Nguvu za utafiti
Nguvu ya utafiti ni kwamba uamuzi wa expert routing hautegemei tu performance ya siku chache zilizopita, bali unaegemezwa kwenye expert behavior iliyotokea katika market states zinazofanana kihistoria. Mbinu hii inaondoa retrieval system katika nafasi ya msaidizi anayerejesha taarifa pekee na kuifanya sehemu kuu ya portfolio expert selection mechanism.
Nguvu ya pili muhimu ni kuweka mipaka kwa jukumu la LLM. LLM haitoi moja kwa moja portfolio weights; inatumika kama coordination/routing layer inayotafsiri retrieved evidence. Tofauti hii huruhusu LLM kutathminiwa katika jukumu la contextual reasoning badala ya numerical trading policy.
Nguvu ya tatu ni kutumika kwa retrieval protocol ile ile ya \(L=22\), \(H=5\), \(K=3\) katika financial market class tatu tofauti, pamoja na kufanywa kwa uchanganuzi tofauti wa ablation/sensitivity kwa expert heterogeneity, pool size, retrieval, LLM choice na indexing quality.
Vikwazo vikuu
Kizuizi muhimu zaidi ni kwamba experimental run moja tu ilifanywa kwa kila soko. Kwa hiyo, mgawanyo wa matokeo unaotokana na random initialization au stochastic training haujulikani.
Kizuizi cha pili ni kwamba competing SOTA methods hazikuweza kutekelezwa chini ya experimental protocol iliyo sawa kabisa katika kila hali. Hali hii inahitaji dai la ubora wa moja kwa moja wa mbinu katika Table 11 litafsiriwe kwa tahadhari.
Kizuizi cha tatu ni kwamba baadhi ya maelezo muhimu kwa reproduction, kama exact transaction-cost, portfolio constraints, data provider na RL training hyperparameters muhimu, hayajawekwa wazi katika chanzo.
Kizuizi cha nne ni kwamba, ingawa kuna ablation kwa retrieval na LLM components, hakuna ablation ambayo uncertainty-aware mechanism imeondolewa peke yake.
Kizuizi cha tano ni kwamba dhana kwamba historical similarity itaendelea kuhifadhi uhusiano ule ule wa expert suitability katika siku zijazo inaweza kushindwa chini ya structural breaks mpya kabisa katika muundo wa soko. Ingawa mbinu ya chanzo inajaribu kupunguza hatari hii kwa kutumia empirical historical grounding, tatizo la unseen regime halijaondolewa kabisa.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Regime-Aware Portfolio Management via Retrieval-Augmented LLM-Guided Expert Switching
Waandishi: Ahmad Asadi; Reza Safabakhsh.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa.
Taasisi: Deep Learning Lab, Computer Engineering Department, Amirkabir University of Technology, Hafez Avenue, Tehran, Iran.
Chanzo kilichopakiwa: arXiv:2608.28252v1 [cs.AI].
Tarehe ya kuwasilishwa arXiv: 28 Agosti 2026.
Tarehe inayoonekana kwenye PDF: 31 Agosti 2026.
Aina ya chanzo: Preprint.
Hali ya peer review: arXiv v1 iliyopakiwa si Version of Record ya jarida lililopitiwa na wataalamu. Kufikia 21 Novemba 2026, hakuna journal version iliyopitiwa na wataalamu iliyotambuliwa katika rekodi za sasa za kibibliografia zinazoweza kuthibitishwa.
Toleo jipya zaidi la kibibliografia: Toleo la SSRN lenye kichwa kile kile na kurasa 47 lilichapishwa 23 Oktoba 2026. DOI ya suggested citation ya SSRN ni 10.2139/ssrn.7661576. Maudhui ya kisayansi ya Verianla yameandaliwa kutoka arXiv v1 iliyopakiwa; maudhui mapya ya kisayansi kutoka toleo la baadaye la SSRN hayajachanganywa katika makala hii.
Corresponding / contact author: Alama ya corresponding-author haijaonyeshwa wazi katika arXiv PDF iliyopakiwa. Rekodi ya baadaye ya kibibliografia ya SSRN inaonyesha Reza Safabakhsh kama Contact Author.
Mchango sawa: Hakuna tamko la equal contribution linaloonekana katika chanzo kilichopakiwa.
Leseni ya chanzo: Leseni wazi ya Creative Commons inayothibitisha kwamba Verianla inaruhusiwa kutumia moja kwa moja vielelezo vya chanzo haijathibitishwa kwenye arXiv v1 iliyopakiwa. Kwa hiyo, vielelezo vya chanzo havikutumiwa moja kwa moja; mahusiano ya kisayansi yaliundwa upya kama michoro huru.
Ufadhili: Hakuna funding declaration tofauti iliyotambuliwa katika PDF iliyopakiwa.
Mgongano wa maslahi: Hakuna conflict-of-interest / competing-interest declaration tofauti iliyotambuliwa katika PDF iliyopakiwa.
Upatikanaji wa data: Hakuna sehemu tofauti ya Data Availability au kiungo kilichothibitishwa cha public dataset repository katika PDF iliyopakiwa.
Upatikanaji wa msimbo: Hakuna kiungo kilichothibitishwa cha public source-code repository katika PDF iliyopakiwa.
Mbinu kuu: Dual-stream Transformer-VAE market-state representation + chronological vector retrieval + Statement of Performance + instruction-tuned LLM guided expert switching + reinforcement-learning expert pool.
Expert pool: A2C, DDPG, PPO, TQC na CrossQ.
Masoko: Cryptocurrency, stock na foreign exchange; symbol 30 katika kila soko.
Marudio ya data: Daily OHLCV.
Dirisha la ingizo: \(L=22\) siku za biashara.
Forward / holding horizon: \(H=5\) siku.
Retrieval: \(K=3\) hali za kihistoria zilizo karibu zaidi, cosine similarity.
Kipimo cha embedding: \(d=64\).
LLM temperature: 0,1.
Kikomo cha simu za LLM: Kiwango cha juu cha simu moja kwa kila decision step.
Udhibiti wa leakage: Wakati wa test, retrieval imewekewa mipaka kwa historical observations zinazotimiza \(\tau<t\) pekee.
Vifaa: NVIDIA H100 GPU moja.
Marudio ya jaribio: Run moja kwa kila soko; matokeo si repeated-seed averages.
Kikomo cha takwimu: Confidence interval, formal significance test na mgawanyo wa random-seed nyingi havijaripotiwa.
Matokeo ya kinadharia: Matokeo ya Monotonic Expert-Pool Performance yanatumika tu chini ya bounded estimation error, conservative switching na specialist dominance assumptions; si dhamana isiyo na masharti ya faida ya soko halisi.
Tofauti muhimu ya kuripoti ndani ya chanzo: Thamani za standalone expert cumulative return za Table 5 hazilingani na thamani za “Best Fixed” za Table 6, na chanzo hakielezi sababu ya tofauti hiyo. Aidha, Section 4.3 inasema inalinganisha strategy nne huku ikifafanua strategy tatu pekee.
Mapengo ya uzalishaji upya: Exact market-data provider, calendar-based train/validation/test split, thamani ya transaction-cost, portfolio constraints, RL training hyperparameter nyingi, fomula ya weighted-uncertainty, thamani za nambari za \(\epsilon/\tau/\delta\) na ukubwa wa prompt-validation-set havijaripotiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *