


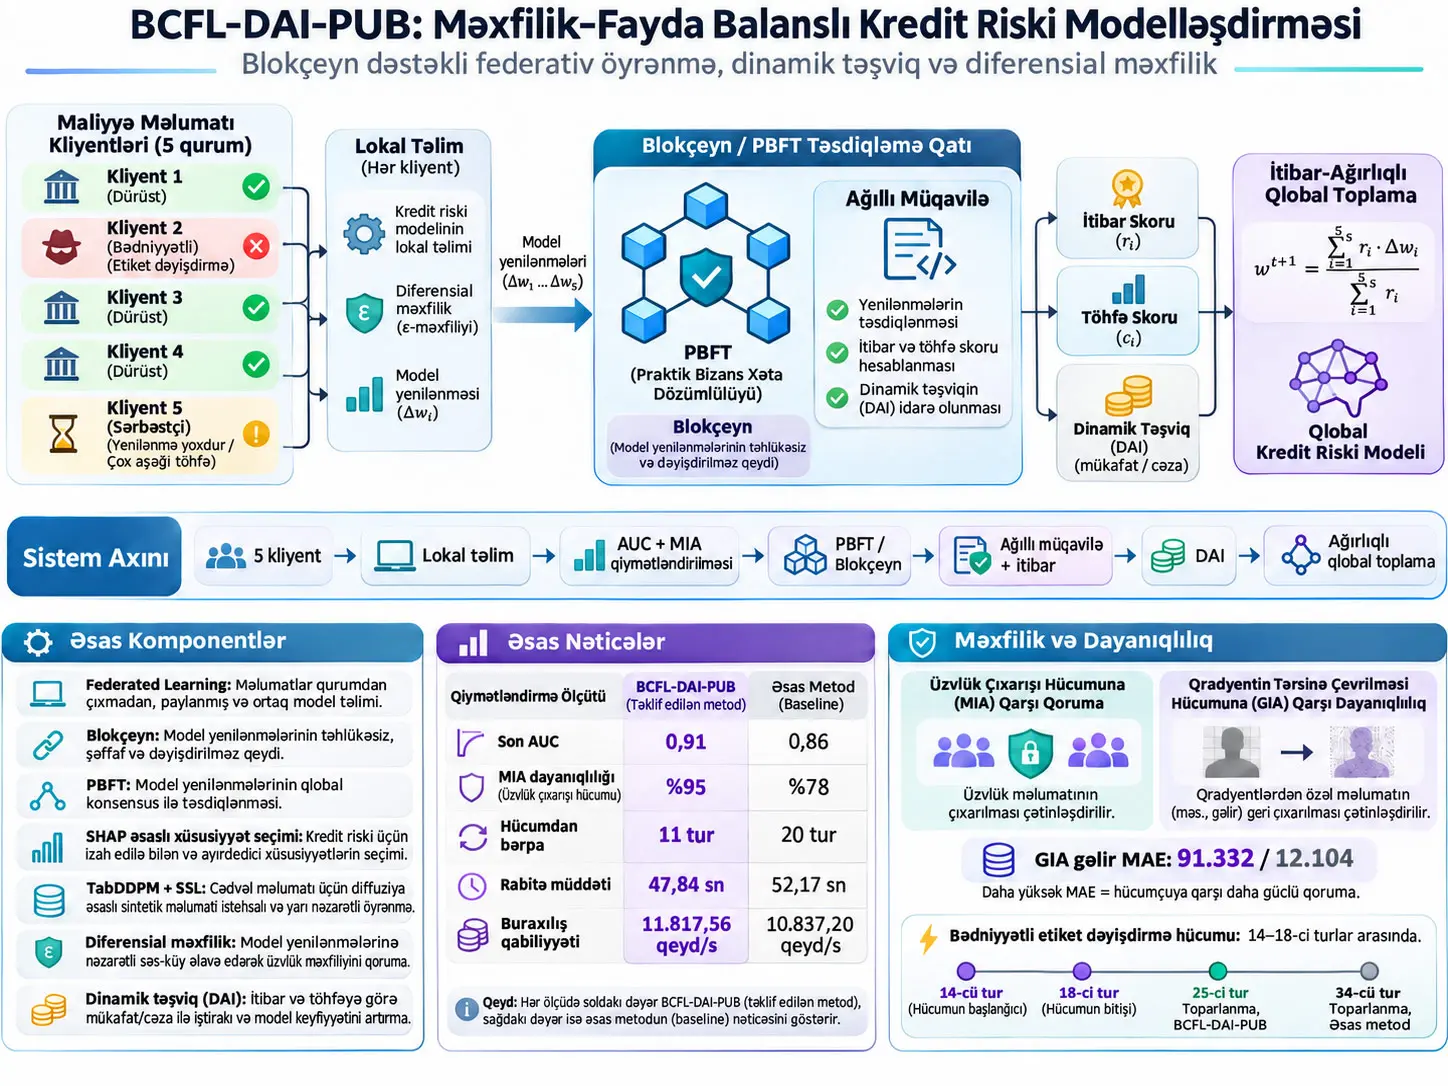
BCFL-DAI-PUB, kredit riskinin modelləşdirilməsi üçün blokçeyn idarəetməsini, Federated Learning (FL), optimizer səviyyəsində diferensial məxfiliyi, Tabular Denoising Diffusion Probabilistic Model (TabDDPM), peer-to-peer model qiymətləndirməsini və Dynamic Adaptive Incentive (DAI) mexanizmini birləşdirən blockchain-federated learning çərçivəsidir. Çərçivə müştərilərin yalnız model faydasını deyil, məxfiliyə töhfəsini də qiymətləndirərək SCAFFOLD əsaslı düzəliş, privacy-budget tənzimlənməsi və pul təşviqi arasında dinamik seçim etməyi; malicious və free-rider müştərilərin global model üzərindəki təsirini reputation-ağırlıqlı aggregation vasitəsilə azaltmağı hədəfləyir.
Tədqiqat Kaggle üzərindəki Home Credit Default Risk məlumat dəstindən istifadə edir. Orijinal məlumat dəstində 307.511 qeyd və 122 xüsusiyyət var; TARGET=1 olan 24.825 kredit defoltu qeydi ilə TARGET=0 olan 282.686 uğurlu geri ödəmə qeydi arasındakı sinif balanssızlığı minority-class oversampling ilə aradan qaldırılaraq ümumilikdə 565.372 balanslaşdırılmış qeyd yaradılır. Bu balanslaşdırılmış məlumat beş simulyasiya edilmiş federated client arasında near-IID və non-IID formalarda paylanmışdır. Tədqiqatın daha real hesab etdiyi non-IID ssenaridə üç honest client, bir label-flipping malicious client və bir free-rider var.
Non-IID 10-fold cross-validation qiymətləndirməsində BCFL-DAI-PUB üçün AUC 0,91501 ± 0,00007, Precision 0,83732 ± 0,00116, Recall 0,74946 ± 0,00018 və F1 Score 0,79096 ± 0,00008 bildirilmişdir. Müqayisə edilən BCFL-PS-HER baseline üçün AUC 0,86071 ± 0,00123-dür. Qarışıq honest + malicious + free-rider ssenarisində təklif olunan model son turlarda təxminən 0,91 AUC-yə, baseline isə təxminən 0,86 AUC-yə çatmışdır.
Label-flipping hücumu 14-cü turda başladılıb 18-ci turda bitirildikdə BCFL-DAI-PUB hücumdan əvvəlki AUC səviyyəsinə 25-ci turda qayıtmış; hücumun başlanmasından recovery müddəti 11 tur olmuşdur. BCFL-PS-HER isə 34-cü turda bərpa olunmuş və 20 tura ehtiyac duymuşdur. Mənbə bu fərqi baseline-ın təxminən 1,82 dəfə daha uzun recovery müddəti kimi bildirir.
Məxfilik qiymətləndirmələrində BCFL-DAI-PUB-un final Membership Inference Attack (MIA) Advantage dəyəri təxminən 0,05, baseline-ın dəyəri isə təxminən 0,22-dir. Buna qarşılıq \(R_{MIA}=1-Adv_{MIA}\) tərifi ilə hesablanan resistance dəyərləri müvafiq olaraq %95 və %78-dir. Gradient Inversion Attack (GIA) testində təklif olunan metodda bütün xüsusiyyətlər üçün MAE 42.105 ± 2.310, income xüsusiyyəti üçün MAE 91.332 ± 9.104 olaraq bildirilmiş; baseline dəyərləri müvafiq olaraq 4.821 ± 387 və 12.104 ± 1.208 olmuşdur. Bu yüksək MAE hücumçunun rekonstruksiyasının daha pis olduğunu ifadə edir; modelin proqnoz xətasının artdığı mənasına gəlmir.
Ən mühüm şərh sərhədi budur ki, bu nəticələr real banklar və ya maliyyə qurumları arasında qurulmuş production blockchain-federated learning şəbəkəsinə aid deyil. Müştərilər vahid açıq kredit məlumat dəstindən simulyasiya edilmiş, malicious/free-rider davranışları nəzarətli şəkildə müəyyənləşdirilmişdir. Buna görə 0,91 AUC, %95 MIA resistance və ya 11 turluq recovery real maliyyə qurumlarında avtomatik olaraq eyni performansa zəmanət vermir.
BCFL-DAI-PUB Nədir?
BCFL-DAI-PUB mərkəzi federated-learning aggregator-ını blokçeyn və smart-contract koordinasiyası ilə əvəz etməyi, müştəri model yeniləmələrini utility və privacy baxımından qarşılıqlı qiymətləndirməyi və Dynamic Adaptive Incentive mexanizmi ilə hər müştərinin təşviqini və global-model təsirini dinamik şəkildə tənzimləməyi hədəfləyən kredit riski modelləşdirmə çərçivəsidir.
Tədqiqatın həll etməyə çalışdığı problem
Kredit riski modellərinin bir neçə maliyyə qurumunun məlumatından faydalanması modelin daha müxtəlif borrower profilləri görməsinə imkan verə bilər. Lakin real maliyyə qeydləri birbaşa qurumlar arasında paylaşıldıqda məlumat məxfiliyi, tənzimləyici uyğunluq və etimad problemləri yaranır. Federated Learning xam məlumatları qurum daxilində saxlayaraq bu problemi azaldır; bununla belə klassik FL arxitekturasında mərkəzi aggregator etimad və single-point-of-failure problemi yarada bilər.
Blockchain-Federated Learning model-update koordinasiyasını paylanmış ledger və smart contract-larla doğrulana bilən hala gətirməyi hədəfləyir. Lakin mənbə tədqiqatın vurğuladığı ikinci problem odur ki, yalnız mərkəzi aggregator-ı aradan qaldırmaq müştərilərin dürüst və davamlı iştirakına zəmanət vermir. Müştərilər hesablama xərcindən yayınmaq, köhnə model update-i göndərmək, free-riding etmək və ya qəsdən malicious model update-i yaratmaq kimi davranışlar göstərə bilər.
Üçüncü problem privacy–utility trade-off-dur. Daha sərt privacy mexanizmləri modelin öyrənmə siqnalını azalda bilər; yüksək utility naminə privacy büdcəsinin yumşaldılması isə inference attack riskini artıra bilər. Mənbə buna görə yalnız predictive utility-ni deyil, privacy contribution-ı da təşviq qərarının bir hissəsinə çevirir.
Ədəbiyyat boşluğu
Mənbədəki ədəbiyyat icmalına görə kredit riski üçün federated-learning tədqiqatları, blockchain inteqrasiyası, incentive mexanizmləri və privacy-preserving texnikalar ayrıca inkişaf etdirilmişdir; lakin credit-risk setting daxilində predictive utility, privacy preservation və adversarially robust incentive allocation məsələlərini vahid blockchain-federated framework daxilində birlikdə həll edən tədqiqatların sayı məhduddur.
BCFL-DAI-PUB-un mənbədə göstərilən beş əsas töhfəsi bunlardır:
- Smart contract tərəfindən koordinasiya olunan global preprocessing.
- SHAP əsaslı və blockchain ilə doğrulana bilən global feature selection.
- Self-Supervised Learning ilə başladılan TabDDPM əsaslı privacy-preserving generative model.
- Utility və privacy contribution-ı birlikdə istifadə edən Dynamic Adaptive Incentive mexanizmi.
- Honest, malicious və free-rider müştərilər altında utility, privacy, recovery və system overhead qiymətləndirməsi.
Məlumat dəsti və sinif balansı
| Xüsusiyyət | Mənbə dəyəri |
|---|---|
| Orijinal qeyd sayı | 307.511 |
| TARGET=1 — loan defaulter | 24.825 |
| TARGET=0 — successful repayment | 282.686 |
| Numerical attribute | 106 |
| Categorical attribute | 16 |
| Ümumi raw feature | 122 |
| Oversampling-dən sonra qeyd | 565.372 |
| Oversampling-dən sonra TARGET=1 | 282.686 |
| Oversampling-dən sonra TARGET=0 | 282.686 |
Mənbə minority class üçün oversampling tətbiq edildiyini bildirir, lakin istifadə olunan oversampling alqoritmini ətraflı adlandırmır. Bundan əlavə, oversampling əməliyyatının cross-validation fold-ları daxilində ayrıca, yoxsa bütün balanced dataset yaradıldıqdan sonra həyata keçirildiyinə dair daha ətraflı data-leakage nəzarət proseduru bildirilmir. Verianla bu boşluğu fərziyyəvi SMOTE və ya başqa sampling texnikası əlavə etməklə doldurmur.
Tənlik 1–3: Federated Learning-in əsas optimallaşdırma problemi
Hər müştəri \(C_i\) öz lokal məlumat dəstini saxlayır:
\[ D_i=\{(x_j,y_j)\}_{j=1}^{n_i}. \tag{1} \]
Nə hesablayır? Tənlik 1 hesablamadan daha çox müştəri \(i\)-nin lokal məlumat dəstinin riyazi tərifidir. \(x_j\) xüsusiyyət vektoru, \(y_j\) hədəf sinif, \(n_i\) isə müştərinin lokal nümunə sayıdır.
Global məqsəd:
\[ \min_{w\in\mathbb{R}^{d}} F(w), \tag{2} \]
və:
\[ F(w)= \sum_{i=1}^{N} \frac{n_i}{n}F_i(w), \qquad n=\sum_{i=1}^{N}n_i. \]
Hər müştərinin lokal loss funksiyası:
\[ F_i(w)= \frac{1}{n_i} \sum_{(x_j,y_j)\in D_i} \ell(w;x_j,y_j). \tag{3} \]
Riyazi rolu: Tənlik 2–3 klassik weighted federated objective-i müəyyənləşdirir. Daha böyük məlumat dəstinə sahib müştəri \(n_i/n\) çəkisi vasitəsilə global objective-ə daha çox töhfə verir.
Vahid: \(w\) model parametr vektorudur. \(F\) və \(\ell\)-nin fiziki vahidi yoxdur; bunlar modelin loss funksiyasından asılı ədədi objective dəyərləridir.
Blockchain niyə əlavə olunur?
BCFL qatı mənbə arxitekturasında model update və evaluation əməliyyatlarını blockchain üzərində doğrulana bilən transaction-lara çevirir. Validator node-lar Practical Byzantine Fault Tolerance (PBFT) consensus ilə transaction-ları doğrulayır. Smart contract global preprocessing parametrlərini, feature-selection istinadlarını, reputation, contribution score və incentive qərarlarını idarə edir.
Mənbənin Şəkil 1-ində həmçinin bir Task Publisher global modeli yaradan və müştərilərə paylayan başlanğıc rolu kimi göstərilir. Buna görə mənbədə işlədilən “fully decentralized” ifadəsi sistemdə heç bir başlanğıc rolunun olmadığı mənasında genişləndirilməməlidir; əsas decentralization iddiası model-update koordinasiyası, doğrulama və aggregation prosesinin mərkəzi etibarlı aggregator-dan asılı olmamasıdır.
Diferensial Məxfilik Bu Tədqiqatda Nəyi Qoruyur?
BCFL-DAI-PUB-da diferensial məxfilik model-update rabitə kanalını şifrələməkdən fərqli olaraq optimizer səviyyəsində gradient məlumatını clipping və Gaussian noise ilə təhrif edərək ayrı-ayrı təlim qeydlərinin gradient inversion və membership inference vasitəsilə geri çıxarılmasını çətinləşdirməyi hədəfləyir.
Tənlik 4–5: Gaussian diferensial məxfilik mexanizmi
Mənbə ümumi Gaussian mexanizmini:
\[ M(D)=f(D)+\mathcal{N}(0,\sigma^2 I) \tag{4} \]
şəklində verir.
Səs-küy miqyası:
\[ \sigma \ge \frac{ \Delta_2f\sqrt{2\ln(1.25/\delta)} }{ \epsilon }. \tag{5} \]
\(D\) xüsusi məlumat dəstini, \(f(D)\) yayımlanacaq hesablamanı, \(\Delta_2f\) L2 sensitivity dəyərini, \(\epsilon\) privacy budget-i, \(\delta\) aşağı ehtimallı privacy-failure parametrini və \(\sigma\) Gaussian noise miqyasını təmsil edir.
Mənbənin DAI məntiqində utility yüksək, lakin privacy contribution aşağı olduqda privacy budget azaldılaraq məxfiliyin gücləndirilməsinə çalışılır. Table 7-də privacy-budget adjustment:
\[ \Delta\epsilon=0.10 \]
olaraq verilmişdir.
Tənlik 6: Gradient Inversion Attack objective-i
\[ \mathcal{L}(\hat{x}) = \left\| \nabla_{\theta} \mathcal{L}(f_{\theta}(\hat{x});y) - g_i \right\|_2^2 + \lambda_{TV}TV(\hat{x}) + \lambda_{range} \sum_j \left[ \max(0,\hat{x}_j-u_j)^2 + \max(0,l_j-\hat{x}_j)^2 \right]. \tag{6} \]
İlk termin hücumçunun sintetik nümunəsinin yaratdığı gradient ilə müşahidə olunan gradient arasındakı fərqi azaldır. \(TV(\hat{x})\) regularization terminidir. \(l_j\) və \(u_j\) tabular feature-ların etibarlı aşağı/yuxarı sərhədlərini qorumağa çalışır.
Mənbə honest-but-curious attacker modelində hücumçunun public model parametrlərinə çıxışı olduğunu, lakin individual client gradient əvəzinə aggregated update müşahidə etdiyini bildirir.
Tənlik 7–8: GIA rekonstruksiya keyfiyyəti
\[ MAE= \frac{1}{d} \sum_{j=1}^{d} |\hat{x}_j-x_j|. \tag{7} \]
MAE kiçikdirsə reconstruction orijinal nümunəyə daha yaxındır; məxfilik müdafiəsi baxımından hücumçu daha uğurludur. Buna görə GIA cədvəlində daha böyük MAE müdafiə baxımından daha yaxşı nəticədir.
Protected categorical attribute üçün tək nümunə səviyyəsində inference indicator:
\[ AIA= \mathbf{1}\{\hat{a}=a^*\}. \tag{8} \]
Burada \(\hat a\) hücumçunun təxmin etdiyi attribute, \(a^*\) real attribute dəyəridir. Table 11-dəki Gender Inference Accuracy bu tək nümunə səviyyəsində doğru/səhv nəticələrin ümumi dəqiqlik ölçüsüdür.
Tənlik 9–11: Membership Inference Attack
Bir nümunənin model üzərindəki loss-u:
\[ \ell(x^*,y^*) = \mathcal{L}(f_{\theta}(x^*),y^*). \tag{9} \]
Membership threshold:
\[ T_{MIA} = \operatorname{median} \{\ell(x_i,y_i)\}. \tag{10} \]
Mənbədə loss:
\[ \ell(x^*,y^*) < T_{MIA} \]
olduqda nümunə training member kimi təsnif edilir.
MIA Advantage:
\[ Adv_{MIA} = TPR-FPR. \tag{11} \]
Mənbənin şərhinə görə \(Adv_{MIA}\le0.05\) negligible risk; 0,10-dan yuxarı dəyərlər mühüm privacy leakage kimi qiymətləndirilmişdir.
Mənbə əlavə olaraq nömrəsiz şəkildə:
\[ R_{MIA}=1-Adv_{MIA} \]
resistance skorunu müəyyənləşdirir. Buna görə aşağı \(Adv_{MIA}\) və yüksək \(R_{MIA}\) daha güclü məxfilik deməkdir.
Tənlik 12–13: Label-flipping poisoning
Binary class etiketi malicious müştəri tərəfindən:
\[ y_i^{mal}=1-y_i \tag{12} \]
şəklində tərsinə çevrilir.
Bunun yaratdığı malicious gradient:
\[ \widetilde{g}_i = \nabla_{\theta} \mathcal{L} (f_{\theta}(x_i),y_i^{mal}). \tag{13} \]
Bu update-lər global modeli əks sinif istiqamətində təsirləndirməyə çalışır. Tədqiqatda label-flipping attack 14-cü communication round-da başladılmış və 18-ci round-da dayandırılmışdır.
Poisoning recovery metrikləri
Mənbə Table 3-də recovery analizini aşağıdakı ölçülərlə müəyyənləşdirir:
\[ AUC_{before} = \frac{1}{t_s-1} \sum_{t=1}^{t_s-1} AUC_t \]
\[ AUC_{attack} = \frac{1}{t_e-t_s+1} \sum_{t=t_s}^{t_e} AUC_t \]
\[ AUC_{min} = \min_{t_s\le t\le t_e} AUC_t \]
\[ t_r = \min_{t>t_e} \left\{ t\mid AUC_t\ge AUC_{before}-\varepsilon \right\} \]
\[ NR_{start}=t_r-t_s, \qquad NR_{end}=t_r-t_e \]
\[ AUC_{after} = \frac{1}{T-t_r} \sum_{t=t_r+1}^{T} AUC_t \]
\[ \Delta_{drop}=AUC_{before}-AUC_{min} \]
\[ \Delta_{recover}=AUC_{after}-AUC_{min} \]
\[ RecoveryRatio = \frac{\Delta_{recover}}{\Delta_{drop}}. \]
\(NR_{start}\), hücumun ilk başladığı andan pre-attack performansın bərpasına qədər keçən ümumi tur sayıdır. \(NR_{end}\) isə hücum dayandıqdan sonra lazım olan əlavə recovery müddətini ölçür.
Smart-contract nəzarətli global preprocessing
BCFL-DAI-PUB iştirakçı qurumların feature encoding və normalization qaydalarının fərqlənməsinin qarşısını almaq üçün global preprocessing schema-sını smart contract vasitəsilə ortaqlaşdırmağı hədəfləyir.
Tənlik 14: Global numerical mean
\[ \mu_{global} = \frac{1}{N} \sum_{i=1}^{N}\mu_i. \tag{14} \]
Hər müştəri numerical feature üçün öz local mean dəyərini göndərir və smart contract local means dəyərlərinin sadə arifmetik ortasını hesablayır.
Mühüm riyazi qeyd: Eq. 14 müştəri məlumat ölçüsü \(n_i\) ilə çəkilən pooled sample mean deyil. Müştəri ölçüləri fərqli olduqda:
\[ \frac{1}{N}\sum_i\mu_i \]
ilə bütün qeydlərin vahid hovuzda hesablanan ortası ümumiyyətlə eyni deyil. Mənbə formulu bu şəkildə müəyyənləşdirdiyi üçün Verianla onu səssizcə çəkili formula ilə əvəz etmir.
Tənlik 15: Global categorical vocabulary
\[ C_{global} = \bigcup_{i=1}^{N}C_i. \tag{15} \]
Hər müştərinin categorical feature-larında gördüyü unique dəyərlər union əməliyyatı ilə vahid global dictionary-də birləşdirilir. Beləliklə One-Hot Encoding ölçülərinin bütün müştərilərdə eyni olması hədəflənir.
Global mean, min–max dəyərləri və \(C_{global}\) standartlaşdırılmış JSON schema şəklində IPFS üzərində saxlanılır; schema hash-i blockchain-ə yazılır.
One-hot encoding-dən sonra 122 raw attribute:
245 preprocessed feature
olmuşdur.
Tənlik 16–17: SHAP ilə global feature selection
Müştəri \(i\)-də feature \(f\)-in SHAP importance dəyəri:
\[ I_i(f) = \frac{1}{n_{samples}} \sum_{j=1}^{n_{samples}} |\phi_j(f)|. \tag{16} \]
\(\phi_j(f)\), nümunə \(j\) üçün feature \(f\)-in SHAP contribution dəyəridir.
Global feature importance:
\[ I_{global}(f) = \frac{1}{N} \sum_{i=1}^{N} I_i(f). \tag{17} \]
Burada da müştərilər bərabər çəki ilə ortalanır; local dataset size-a görə çəkiləndirmə tətbiq edilməmişdir.
Feature-lar \(I_{global}(f)\) dəyərinə görə azalan sıra ilə düzülür və cumulative importance cəmi %75-ə çatana qədər seçilir. Nəticədə 245 feature-dan 184 feature seçilmişdir.
Algorithm 1 nə edir?
Algorithm 1-in elmi axını:
- Hər müştəri local mean, min–max və categorical vocabulary çıxarır.
- Smart contract bu dəyərləri global preprocessing schema-ya çevirir.
- Schema IPFS-ə yüklənir və hash-i blockchain-də yayımlanır.
- Müştərilər eyni schema-dan istifadə edərək missing-value imputation, normalization və One-Hot Encoding tətbiq edir.
- Hər müştəri LightGBM təlim edir və TreeExplainer ilə SHAP importance hesablayır.
- Global SHAP importance dəyərləri ortalanır.
- Cumulative importance %75-ə çatana qədər feature seçilir.
- 184 feature-lıq global feature set smart contract tərəfindən finalize edilir.
Global model initialization
Model initialization iki mərhələlidir. Birinci mərhələdə deep tabular transformer, label tələb etməyən self-supervised contrastive learning ilə pretrain edilir. Öyrənilmiş backbone ilk on diffusion training round ərzində frozen saxlanılır və sonra fine-tuning üçün açılır.
İkinci mərhələdə bu latent representation TabDDPM modelinin başlanğıc girişi kimi istifadə olunur.
Tənlik 18: Numerical forward diffusion
\[ x_t = \sqrt{\bar{\alpha}_t}x_0 + \sqrt{1-\bar{\alpha}_t}\epsilon, \qquad \epsilon\sim\mathcal{N}(0,I). \tag{18} \]
Burada:
\[ \alpha_t=1-\beta_t, \qquad \bar{\alpha}_t=\prod_{i=1}^{t}\alpha_i. \]
\(\beta_t\) timestep noise schedule, \(x_0\) clean latent representation, \(x_t\) isə t anındakı noise-corrupted numerical representation-dır.
Tənlik 19: Categorical forward diffusion
\[ q(c_t\mid c_{t-1}) = (1-\beta_t)v(c_{t-1}) + \frac{\beta_t}{K}. \tag{19} \]
\(K\) categorical state sayı, \(v(c_{t-1})\) əvvəlki categorical state-in one-hot representation-ıdır. Beləliklə continuous və categorical features eyni diffusion model daxilində fərqli noising qaydaları ilə işlənir.
Tənlik 20–22: Reverse denoising loss
Ümumi loss:
\[ L_{total} = L_{mse}+L_{vlb}. \tag{20} \]
Numerical noise-prediction loss:
\[ L_{mse} = \mathbb{E}_{x_0,\epsilon,t} \left[ \| \epsilon-\epsilon_{\theta}(x_t,t) \|_2^2 \right]. \tag{21} \]
Categorical Variational Lower Bound termini:
\[ L_{vlb} = \mathbb{E}_{q} \left[ \sum_{t=1}^{T} D_{KL} \left( q(c_{t-1}\mid c_t,c_0) \| p_{\theta}(c_{t-1}\mid c_t) \right) \right]. \tag{22} \]
\(D_{KL}\), həqiqi reverse posterior ilə öyrənilən reverse distribution arasındakı Kullback–Leibler divergence-dır.
Tənlik 23: DP optimizer gradient-i
\[ \widetilde{g} = \frac{1}{N} \sum_{i=1}^{N} \operatorname{clip}(g_i,C) + \mathcal{N} (0,\sigma^2C^2I). \tag{23} \]
\(C\) gradient clipping norm, \(\sigma\) noise multiplier, \(N\) isə batch size-dır. Clipping tək bir nümunənin gradient təsirini məhdudlaşdırır; Gaussian noise isə gradient-data əlaqəsinin həssas detallarını pozur.
Mənbə göstərim qeydi: Eq. 23 per-sample clipped gradients-in ortasını göstərdiyi halda Algorithm 2 pseudocode-unda clipping tək bir \(g\) simvolu üzərində:
\[ \widetilde g = \frac{g}{\max(1,\|g\|_2/C)} + \mathcal{N}(0,\sigma^2C^2I) \]
şəklində yazılmışdır. İki ifadə eyni DP-SGD ideyasını təmsil etsə də, mənbə granularlıq fərqini ayrıca izah etmir.
Algorithm 2 nə edir?
- Tabular Transformer self-supervised contrastive pretraining ilə təlim edilir.
- Backbone çəkiləri əvvəlcə frozen saxlanılır.
- Latent numerical \(x_0\) və categorical \(c_0\) representations yaradılır.
- TabDDPM denoising network yaradılır.
- Hər iteration-da timestep seçilir.
- Numerical və categorical forward noise tətbiq edilir.
- Model noise və category probability proqnozlaşdırır.
- MSE + VLB loss hesablanır.
- Gradient clipping və Gaussian noise tətbiq edilir.
- 10-cu stabilization round-da backbone unfrozen edilərək privacy-aware fine-tuning-ə keçilir.
Tənlik 24: Local client model update
\[ w_{i,t+1} = w_{i,t} - \eta\nabla L_i(w_{i,t}). \tag{24} \]
\(\eta\) learning rate, \(L_i\) local loss və \(w_{i,t}\) client \(i\)-nin round \(t\)-dəki model parametrləridir.
Mənbə bu tənliyi verir, lakin ümumi training learning rate-in ədədi dəyərini implementation table daxilində bildirmir.
Tənlik 25: Predictive utility üçün AUC
\[ AUC = \sum_{k=1}^{n} (FPR_{k+1}-FPR_k) \left( \frac{TPR_k+TPR_{k+1}}{2} \right). \tag{25} \]
Bu trapezoidal integration ROC əyrisinin altındakı sahəni hesablayır. AUC artdıqca class-ranking performansı güclənir.
Tənlik 26: Privacy metric
\[ Adv_{MIA} = TPR-FPR. \tag{26} \]
Eq. 26 daha əvvəl threat-model bölməsində Eq. 11 kimi müəyyənləşdirilən MIA Advantage-ın client self-assessment mərhələsində yenidən istifadə olunan formasıdır.
Tənlik 27–28: Peer evaluation vector-ları
Utility vector:
\[ ut_i = [ut_{i,1},ut_{i,2},\ldots,ut_{i,N}]. \tag{27} \]
Privacy vector:
\[ pt_i = [pt_{i,1},pt_{i,2},\ldots,pt_{i,N}]. \tag{28} \]
Evaluator \(E_i\) bütün client model-lərini öz private məlumatı üzərində qiymətləndirir. \(ut_{i,j}\), client \(j\)-nin modelinin AUC əsaslı utility qiymətləndirməsi; \(pt_{i,j}\) isə MIA Advantage əsaslı privacy-vulnerability qiymətləndirməsidir.
Bu vector-lar signed transaction kimi blockchain-ə göndərilir və PBFT ilə finalize edilir.
Dynamic Adaptive Incentive (DAI) Mexanizmi Necə İşləyir?
DAI mexanizmi hər communication round-da peer-evaluated utility və MIA əsaslı privacy dəyərlərindən reputation hesablayır, reputation-ı keçmiş davranışla exponential moving average vasitəsilə birləşdirir, client-ın məlumat payını da nəzərə alaraq Utility Contribution və Privacy Contribution skorları yaradır və bu iki skora əsasən pul mükafatı, privacy-budget azaldılması, SCAFFOLD correction və ya təşviqsiz buraxma qərarı verir.
Tənlik 29: Client başına orta peer evaluation
\[ U_{i'}^{t} = \frac{1}{N} \sum_{i=1}^{N} ut_i^{t}[i'], \qquad P_{i'}^{t} = \frac{1}{N} \sum_{i=1}^{N} pt_i^{t}[i']. \tag{29} \]
\(U_{i'}^t\), client \(i'\)-nin digər evaluator-lar tərəfindən verilən orta utility skorudur. \(P_{i'}^t\), MIA Advantage əsaslı orta privacy-vulnerability skorudur.
Tənlik 30: Round üzrə referans utility və privacy
\[ U^t = \frac{1}{N} \sum_{i=1}^{N}U_i^t, \qquad P^t = \frac{1}{N} \sum_{i=1}^{N}P_i^t. \tag{30} \]
Bu dəyərlər reputation hesablamasında round-wise reference kimi istifadə olunur.
Tənlik 31: Normalize reputation
\[ Rep_{Ui}^{t} = 2\sigma \left( \gamma(U_i^t-U^t) \right)-1, \]
\[ Rep_{Pi}^{t} = 2\sigma \left( \gamma(P^t-P_i^t) \right)-1. \tag{31} \]
\(\sigma(\cdot)\) sigmoid function, \(\gamma\) reputation sensitivity parametridir. Table 7-də:
\[ \gamma=4.0 \]
olaraq verilmişdir.
Utility reputation-da client utility-nin global ortadan yüksək olması müsbət reputation yaradır. Privacy tərəfində işarə tərsinə çevrilmişdir: \(P_i^t\) MIA vulnerability olduğuna görə ortadan aşağı privacy leakage daha yüksək privacy reputation yaradır.
Tənlik 32: Historical reputation
\[ FR_{Ui}^{t} = (1-\lambda) FR_{Ui}^{t-1} + \lambda Rep_{Ui}^{t}, \]
\[ FR_{Pi}^{t} = (1-\lambda) FR_{Pi}^{t-1} + \lambda Rep_{Pi}^{t}. \tag{32} \]
Bu exponential moving average bir round-dakı dalğalanmanın reputation-ı birdən-birə müəyyən etməsini məhdudlaşdırır. Mənbədə:
\[ \lambda=0.30. \]
Tənlik 33: Total reputation
\[ TR_i^t = FR_{Ui}^{t} + FR_{Pi}^{t}. \tag{33} \]
Hər historical reputation component \([-1,1]\) intervalında olduğuna görə \(TR_i^t\) nəzəri olaraq \([-2,2]\) intervalına qədər uzana bilər.
Tənlik 34: Məlumat payının contribution miqyasına keçirilməsi
\[ \pi_i = 2\frac{|D_i|}{|D|} - 1. \tag{34} \]
\(|D_i|/|D|\), client \(i\)-nin ümumi məlumatdakı payıdır. Xətti çevirmə bu dəyəri \([-1,1]\) miqyasına keçirir.
Tənlik 35: Utility və Privacy Contribution
\[ UC_i(t) = \alpha_c\pi_i + (1-\alpha_c)FR_{Ui}^{t}, \]
\[ PC_i(t) = \alpha_c\pi_i + (1-\alpha_c)FR_{Pi}^{t}. \tag{35} \]
Mənbədə:
\[ \alpha_c=0.50. \]
Beləliklə contribution score-un yarısı mapped data share, yarısı historical reputation-dan gəlir.
Tənlik 36: Model-status təsnifatı
Mənbə qərar həddini:
\[ T_{DAI}=0.70 \]
olaraq müəyyənləşdirir və:
\[ \Psi(PC_i,UC_i) = \begin{cases} Balanced, & PC_i \gt T_{DAI} \land UC_i \gt T_{DAI} \\ Privacy\ Heavy, & PC_i \gt T_{DAI} \land 0\le UC_i\le T_{DAI} \\ Utility\ Heavy, & 0\le PC_i\le T_{DAI} \land UC_i\gt T_{DAI} \\ Low\ Contribution, & 0\le PC_i\le T_{DAI} \land 0\le UC_i\le T_{DAI} \\ No\ Contribution, & PC_i\lt0 \land UC_i\lt0 \end{cases} \tag{36} \]
Mənbə-daxili qərar boşluğu: Bu piecewise tərif bir skor mənfi, digər skor sıfır və ya müsbət olduqda hansı sinfin istifadə olunacağını göstərmir. Məsələn, \(PC_i<0\) və \(UC_i>0\) və ya əksi Eq. 36-nın heç bir qoluna daxil olmur. Mənbənin implementation təsvirində bəzi malicious client-lər “No Contribution” vəziyyətinə keçirilir; lakin mixed-sign halların implementation-da necə idarə olunduğu açıq şəkildə formullaşdırılmır.
Tənlik 37: Incentive update rule
\[ I_i= \begin{cases} M\leftarrow M+monetary\_benefit, & \Psi=Balanced \\ S\leftarrow global\_correction\_error, & \Psi=Privacy\ Heavy \\ DP\leftarrow DP-0.1, & \Psi=Utility\ Heavy \\ S\leftarrow global\_correction\_error, & \Psi=Low\ Contribution \\ No\ Incentive, & \Psi=No\ Contribution \end{cases} \tag{37} \]
Balanced: Utility və privacy contribution həddən yüksək olduqda monetary benefit verilir.
Utility Heavy: Utility yüksək, lakin privacy contribution qeyri-kafi olduqda privacy budget 0,10 azaldılaraq DP gücləndirilir.
Privacy Heavy: Privacy yüksək, lakin utility qeyri-kafi olduqda SCAFFOLD əsaslı global correction error tətbiq edilir.
Low Contribution: Hər iki skor müsbət, lakin həddin altındadırsa yenə SCAFFOLD correction tətbiq edilir.
No Contribution: Mənbə Eq. 36-da hər iki skor mənfi olduqda incentive verilmir.
Təkrar istehsal oluna bilmə sərhədi: Mənbə monetary benefit-in pul məbləğini/token vahidini və global_correction_error dəyərinin exact SCAFFOLD update formulunu bu bölmədə bildirmir. Bu dəyərlər Verianla tərəfindən uydurulmayıb.
Table 7-dəki DAI və DP parametrləri
| Parametr | Mənbə dəyəri |
|---|---|
| Reputation sensitivity \(\gamma\) | 4,0 |
| Historical reputation weight \(\lambda\) | 0,30 |
| Contribution weight \(\alpha_c\) | 0,50 |
| DAI threshold \(T_{DAI}\) | 0,70 |
| DP-Boost adjustment \(\Delta\epsilon\) | 0,10 |
| Gradient clipping norm \(C\) | 1,0 |
| Gaussian noise multiplier \(\sigma\) | 0,50 |
| Privacy parameter \(\delta\) | \(1\times10^{-5}\) |
| Initial privacy budget \(\epsilon_0\) | 1,20 |
| Privacy-budget range | 0,40–2,50 |
| Backbone unfreeze round | 10 |
| Feature-selection threshold | 0,75 cumulative importance |
| Cross-validation folds | 10 |
| Random seed | 42 |
Mənbə-daxili privacy-budget qeydi: Table 7 global initial privacy budget kimi \(\epsilon_0=1,20\) verdiyi halda malicious C2 və free-rider C5 təsvirində erkən mərhələdə \(\epsilon=2,0\) istifadə edildiyi göstərilir. Mənbə 1,20 başlanğıc dəyərindən bu client-specific dəyərlərə keçidin tam initialization/adaptation yolunu ayrıca izah etmir.
Tənlik 38: Reputation-weighted global aggregation
\[ w^{(t)} = \frac{ \sum_{i=1}^{N} TR_i\,w_i^{(t)} }{ \sum_{i=1}^{N} TR_i }. \tag{38} \]
Mənbənin məqsədi aşağı reputation-a malik malicious və ya free-riding client update-lərinin global model üzərindəki çəkisini azaltmaq, yüksək reputation-a malik honest müştərilərin təsirini qorumaqdır.
Riyazi şərh sərhədi: Eq. 33-ə görə \(TR_i\), iki \([-1,1]\) historical reputation dəyərinin cəmidir və nəzəri olaraq mənfi ola bilər. Eq. 38 isə \(TR_i\)-ni birbaşa çəki kimi istifadə edir. Mənbə:
- mənfi \(TR_i\)-lərin sıfıra kəsilib-kəsilmədiyini,
- çəkilərin müsbət intervala yenidən miqyaslandırılıb-miqyaslandırılmadığını,
- \(\sum_i TR_i=0\) olduqda nə edildiyini
açıq şəkildə bildirmir. Verianla buna görə Eq. 38-i mənbədə olduğu kimi saxlayır və əlavə normalization qaydası uydurmur.
Tədqiqatın Metodu və Nəticələri
Bu Nəticələr Real Banklararası Saha Tətbiqindən Əldə Edilibmi?
Xeyr. Tədqiqatda real maliyyə qurumlarının ayrı məlumat bazaları və production blockchain infrastrukturu istifadə edilməmişdir; vahid Home Credit Default Risk məlumat dəsti oversampling-dən sonra beş simulyasiya edilmiş federated client-a paylanmış və honest, label-flipping malicious və free-riding davranışları nəzarətli eksperiment şəraitində yaradılmışdır.
Near-IID client simulation
| Client | Pay | Qeyd | Class 0 | Class 1 | Rol |
|---|---|---|---|---|---|
| C1 | %40 | 226.149 | %49,50 | %50,50 | Honest |
| C2 | %25 | 141.343 | %49,00 | %51,00 | Malicious |
| C3 | %15 | 84.806 | %50,00 | %50,00 | Honest |
| C4 | %12 | 67.844 | %53,08 | %46,92 | Honest |
| C5 | %8 | 45.230 | %51,00 | %49,00 | Free-rider |
Non-IID client simulation
| Client | Pay | Qeyd | Class 0 | Class 1 | Rol |
|---|---|---|---|---|---|
| C1 | %35 | 197.880 | %70,00 | %30,00 | Honest |
| C2 | %30 | 169.612 | %25,00 | %75,00 | Malicious |
| C3 | %20 | 113.074 | %60,00 | %40,00 | Honest |
| C4 | %8 | 45.230 | %55,00 | %45,00 | Honest |
| C5 | %7 | 39.576 | %22,86 | %77,14 | Free-rider |
Mənbə \(\alpha_D=10,0\) vəziyyətini aşağı heterogeneity/near-IID; \(\alpha_D=0,5\) vəziyyətini isə daha güclü class skew ehtiva edən non-IID ssenari kimi istifadə edir. Digər əsas eksperimentlər daha real hesab edilən \(\alpha_D=0,5\) ssenarisində aparılmışdır.
Near-IID və non-IID overhead
| Şərt | Training time (s) | Consensus time (s) | Aggregation time (s) | Evaluation time (s) | Cumulative communication time (s) | Cumulative memory (MB) |
|---|---|---|---|---|---|---|
| \(\alpha_D=10,0\) | 12,56 | 21,07 | 1,15 | 10,25 | 45,03 | 39,42 |
| \(\alpha_D=0,5\) | 13,20 | 21,58 | 2,05 | 11,01 | 47,84 | 40,8 |
Mənbə non-IID vəziyyətində total communication overhead-in %6,24 və total memory usage-ın %3,50 artdığını bildirir.
Near-IID və non-IID predictive performance
| Şərt | AUC | Precision | Recall | F1 |
|---|---|---|---|---|
| \(\alpha_D=10,0\) | 0,92520 ± 0,00003 | 0,84992 ± 0,00003 | 0,75169 ± 0,00008 | 0,79779 ± 0,00003 |
| \(\alpha_D=0,5\) | 0,91501 ± 0,00007 | 0,83732 ± 0,00116 | 0,74946 ± 0,00018 | 0,79096 ± 0,00008 |
Near-IID-dən non-IID-yə keçiddə mənbə AUC üçün %1,10; Precision üçün %1,48; Recall üçün %0,30 və F1 üçün %0,86 azalma hesablamışdır.
Cədvəllərdəki “±” dəyərləri cross-validation nəticələri ilə birlikdə verilir və mənbə bunları aşağı fold variasiyası kimi şərh edir; Table 9 və Table 13 caption-larında bu “±” dəyərlərinin ayrıca standard deviation, yoxsa standard error olduğu açıq sütun etiketi ilə müəyyənləşdirilmir. Buna görə Verianla onları avtomatik olaraq konkret qeyri-müəyyənlik növü ilə yenidən adlandırmır.
Honest müştərilərin DAI davranışı
C1, C3 və C4 üçün mənbə DAI müdaxilələrinin utility və privacy contribution-ı təxminən 0,70 həddinin üzərində balanced vəziyyətə gətirdiyini və üç honest client-ın təxminən 30-cu communication round ətrafında balanced işləmə vəziyyətinə yaxınlaşdığını bildirir.
Utility yüksək, privacy aşağı olduqda \(\epsilon\) azaldılır; privacy yüksək, utility aşağı olduqda SCAFFOLD correction tətbiq edilir. Hər iki skor həddi keçdikdə monetary incentive verilir.
Malicious Client C2
C2 non-IID ssenaridə ümumi məlumatın %30-na sahibdir. Mənbəyə görə 14-cü tura qədər utility təxminən 0,85 ətrafındadır. Label-flipping attack 14-cü turda başladıqda utility score təxminən 0,78-dən −0,25-ə düşür və mənbə C2-nin 15-ci turdan etibarən “No Contribution” vəziyyətinə keçirildiyini və incentive-larının ləğv edildiyini bildirir.
Qərar məntiqi qeydi: Eq. 36 “No Contribution” üçün həm \(PC_i<0\), həm də \(UC_i<0\) şərtini tələb edir. Mənbə qrafiki və mətni hücumdan sonra utility-nin mənfiləşdiyini açıq göstərsə də privacy score-un hər nöqtədə eyni vaxtda mənfi olduğu ayrıca izah edilmir. Buna görə source narrative ilə piecewise Eq. 36-nın implementation əlaqəsi tam sənədləşdirilməyib.
Free-rider Client C5
C5 mənbəyə görə mənalı local training etmədən outdated update göndərən free-rider-dır. Fig. 8-də final contribution score təxminən 0,35 kimi bildirilir və mənbə bu client-ın incentive almadığını və global model üzərində təsirinin aradan qaldırıldığını bildirir.
Lakin Table 4-ə görə utility və privacy contribution skorlarının hər ikisi 0 ilə 0,70 arasındadırsa vəziyyət “Low Contribution”, primary action isə “Scaffold Incentive”dır. C5 üçün təsvir edilən “no incentive” qərarının ayrıca utility və privacy score dəyərlərindən, yoxsa başqa implementation qaydasından qaynaqlandığı mənbədə tam izah edilmir.
50 tur sonunda contribution score-lar
| Client | Rol | Contribution score |
|---|---|---|
| C1 | Honest | 0,72 |
| C2 | Malicious | −0,20 |
| C3 | Honest | 0,76 |
| C4 | Honest | 0,75 |
| C5 | Free-rider | 0,35 |
Yalnız honest client-lar
Bütün client-ların honest olduğu ssenaridə BCFL-DAI-PUB final AUC:
\[ 0.93 \]
dəyərinə çatarkən BCFL-PS-HER:
\[ 0.88 \]
dəyərində qalmışdır.
Honest + malicious + free-rider ssenarisi
Qarışıq ssenaridə BCFL-DAI-PUB təxminən 0,70 initial AUC-dən 0,91 final AUC-yə yüksəlmişdir. Baseline təxminən 0,60-dan 0,86-ya yüksəlmişdir.
Label-flipping hücumundan bərpa
| Metrik | BCFL-DAI-PUB | BCFL-PS-HER |
|---|---|---|
| Attack start \(t_s\) | 14 | 14 |
| Attack end \(t_e\) | 18 | 18 |
| Pre-attack AUC | ≈0,81 | ≈0,70 |
| Recovery round \(t_r\) | 25 | 34 |
| Attack-onset recovery | 11 tur | 20 tur |
| Post-attack recovery delay | 7 tur | 16 tur |
| Son performans | ≈0,91 | ≈0,86 |
20/11 nisbəti:
\[ \frac{20}{11}\approx1.82 \]
olduğuna görə baseline-ın attack-onset recovery müddəti təklif olunan metodun təxminən 1,82 qatıdır.
Gradient Inversion Attack eksperiment quruluşu
GIA:
- 50-ci communication round-da,
- batch size = 1 ilə,
- beş client üzərində,
- iGIA və DiffGIA komponentləri, analytical gradient matching, total-variation/range regularization və randomized diffusion timestep-ləri istifadə edilərək
tətbiq edilmişdir.
Hər hücum client başına beş dəfə təkrarlanmış və Table 11 mean ± standard deviation kimi bildirilmişdir.
| Metrik | BCFL-PS-HER | BCFL-DAI-PUB | Şərh |
|---|---|---|---|
| MAE — bütün 122 feature | 4.821 ± 387 | 42.105 ± 2.310 | Proposed-da hücumçunun reconstruction error-u 8,7× daha yüksək |
| MAE — Income | 12.104 ± 1.208 | 91.332 ± 9.104 | Proposed-da 7,6× daha yüksək |
| Gender Inference Accuracy | 0,93 ± 0,04 | 0,52 ± 0,06 | −0,41 absolute |
| Reconstructed-data TARGET AUC | 0,823 ± 0,009 | 0,569 ± 0,014 | −0,254 |
Bu cədvəldə reconstruction MAE-nin yüksəlməsi BCFL-DAI-PUB-un kredit proqnoz modelinin pisləşdiyi mənasına gəlmir; hücumçunun private sample reconstruction-ının daha pis hala gəldiyini göstərir.
Mənbənin conclusion bölməsi gradient inversion “success rate”inin 7,6 dəfə azaldığını bildirir. Lakin Table 11-də 7,6× kimi birbaşa ölçülən kəmiyyət Income MAE artımıdır. Buna görə Verianla 7,6× dəyərini attack-success probability kimi yenidən adlandırmır.
Membership Inference Attack nəticələri
| Metod | Başlanğıc AdvMIA | 50-ci tur AdvMIA | Final \(R_{MIA}=1-Adv_{MIA}\) |
|---|---|---|---|
| BCFL-PS-HER | ≈0,50 | ≈0,22 | %78 |
| BCFL-DAI-PUB | ≈0,40 | ≈0,05 | %95 |
Mənbə:
\[ \frac{0.95}{0.78}\approx1.22 \]
nisbəti ilə təklif olunan metodun təxminən 1,22× daha yüksək MIA resistance təqdim etdiyini bildirir.
Şəkil etiketi qeydi: Source Figure 16-nın caption-ı düzgün olaraq “MIA Advantage” dediyi halda qrafikin üst başlığında “Membership Inference Attack Resistance” ifadəsi işlədilib və “Lower is Better” yazılıb. Aşağı olması lazım olan metrik resistance deyil, \(Adv_{MIA}\)-dır. Verianla MIA Advantage ilə MIA Resistance-ı ayrı saxlayır.
System overhead müqayisəsi
| Metrik | BCFL-PS-HER | BCFL-DAI-PUB |
|---|---|---|
| Training time | 14,01 s | 13,20 s |
| Consensus time | 22,04 s | 21,58 s |
| Aggregation time | 4,12 s | 2,05 s |
| Evaluation time | 12,00 s | 11,01 s |
| Cumulative communication time | 52,17 s | 47,84 s |
| Consensus size | 5,21 MB | 5,01 MB |
| Chain size | 2,12 MB | 1,78 MB |
| Model update size | 39,27 MB | 34,01 MB |
| Cumulative memory | 46,60 MB | 40,8 MB |
Mənbə BCFL-DAI-PUB-un cumulative communication overhead-ini baseline ilə müqayisədə %8,29; cumulative storage/memory overhead-ini isə %12,45 daha aşağı bildirir.
Terminologiya sərhədi: Mənbənin “communication overhead” kimi verdiyi 52,17 və 47,84 dəyərləri saniyə vahidindədir; network-byte miqdarı deyil. Buna görə bunlar communication-cycle time / cumulative communication time kimi şərh edilməlidir.
Throughput
Eyni beş-client konfiqurasiyasında:
| Metod | Throughput |
|---|---|
| BCFL-PS-HER | 10.837,20 records/s |
| BCFL-DAI-PUB | 11.817,56 records/s |
Mənbə artımı %9,05 kimi hesablayır.
Bu dəyər blockchain transaction per second deyil. Ölçüm beş-client eksperimentində işlənən record/s dəyəridir.
10-fold baseline müqayisəsi
| Metod | AUC | Precision | Recall | F1 |
|---|---|---|---|---|
| BCFL-PS-HER | 0,86071 ± 0,00123 | 0,81916 ± 0,00131 | 0,72159 ± 0,0021 | 0,76727 ± 0,00102 |
| BCFL-DAI-PUB | 0,91501 ± 0,00007 | 0,83732 ± 0,00116 | 0,74946 ± 0,00018 | 0,79096 ± 0,00008 |
Mənbə nisbi yaxşılaşmaları:
- AUC: %6,31
- Precision: %2,22
- Recall: %3,86
- F1: %3,09
olaraq hesablayır.
Ablation study
| Konfiqurasiya | Free-rider nəzarəti | Malicious nəzarəti | Recovery | GIA qoruması | MIA qoruması | Single point of failure qoruması | Model performansı |
|---|---|---|---|---|---|---|---|
| BC + FL + IM + DP — tam BCFL-DAI-PUB | Bəli | Bəli | Bəli | Bəli | Bəli | Bəli | 0,91 |
| DP çıxarılıb: BC + FL + IM | Bəli | Bəli | Bəli | Xeyr | Xeyr | Bəli | 0,87 |
| DP + IM çıxarılıb: BC + FL | Xeyr | Xeyr | Xeyr | Xeyr | Xeyr | Bəli | 0,80 |
| FL-only ssenari — mənbə model sütununa görə | Xeyr | Xeyr | Xeyr | Xeyr | Xeyr | Xeyr | 0,76 |
Mənbə-daxili Table 15 qeydi: Son sətrin “Architectural Components” etiketi DP, FL, IM və BC-nin çıxarıldığını göstərirmiş kimi görünür, eyni sətrin “Models” sütununda isə FL yazılıb. Dərhal sonrakı müzakirə də blockchain və incentive çıxarıldıqda yalnız federated learning qaldığını izah edir. Buna görə Verianla son sətri “FL-only” kimi izah edir, lakin mənbə etiketindəki ziddiyyəti gizlətmir.
Tədqiqatın dəstəklədiyi nəticələr
- BCFL-DAI-PUB tədqiqatın beş-client simulyasiyasında BCFL-PS-HER-dən daha yüksək predictive AUC bildirmişdir.
- Non-IID məlumat paylanmasında performans near-IID ssenari ilə müqayisədə bir qədər aşağı düşsə də mənbə ölçmələrində stabil qalmışdır.
- DAI mexanizmi mənbə simulyasiyasında honest, malicious və free-rider davranışlarını fərqləndirmişdir.
- Label-flipping hücumundan attack-onset recovery təklif olunan metodda 11, baseline-da 20 tur olaraq ölçülmüşdür.
- Optimizer-level DP GIA reconstruction MAE-ni artırmış; gender inference və reconstructed-data predictive utility-ni azaltmışdır.
- BCFL-DAI-PUB-un final MIA Advantage dəyəri baseline-dan daha aşağıdır.
- Təklif olunan metod eyni beş-client konfiqurasiyasında daha aşağı cumulative communication time və memory overhead ilə daha yüksək records/s throughput bildirmişdir.
- Ablation cədvəli DP-nin inference-attack qorumasına və incentive mechanism-ın malicious/free-rider nəzarətinə mühüm töhfə verdiyini mənbə eksperimentində göstərir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
- BCFL-DAI-PUB-un real bank sistemlərində eyni AUC, privacy və ya recovery dəyərlərini təmin edəcəyi sübut edilməyib.
- Beş simulated client, beş real maliyyə qurumunun əməliyyat davranışını təmsil edən saha doğrulaması deyil.
- 11.817,56 records/s dəyəri public blockchain transaction throughput-u deyil.
- 0,91 AUC kredit qərarı üçün tənzimləyici, klinik və ya iqtisadi yetərlilik həddi deyil.
- %95 MIA resistance bütün membership-inference hücum növlərinə qarşı universal qoruma zəmanəti deyil; tədqiqat Yeom-style loss-threshold attack vasitəsilə qiymətləndirmə aparmışdır.
- GIA nəticələri bütün gradient reconstruction alqoritmlərinin uğursuz olacağını sübut etmir; mənbə müəyyən iGIA/DiffGIA əsaslı attack pipeline istifadə edib.
- PBFT istifadə olunması blockchain qatını bütün hücumlara qarşı təhlükəsiz etmir.
- DAI-nin monetary incentive hissəsinin real iqtisadi təşviq sistemlərində necə davranacağı eksperimental olaraq sınaqdan keçirilməyib.
- Mənbədə real kreditvermə qərarlarının maliyyə itkisi, fairness və ya tənzimləyici nəticələri ölçülməyib.
Təkrar istehsal oluna bilmə və mənbədə açıq saxlanan detallar
Oversampling metodu: Minority-class oversampling tətbiq edilib; istifadə olunan sampling alqoritminin adı və fold-level isolation proseduru ətraflı verilməyib.
Blockchain implementation: Smart contract, blockchain, PBFT və IPFS müəyyənləşdirilir; lakin istifadə olunan real blockchain platforması/chain implementation ətraflı adlandırılmır.
Hardware: CPU, GPU, RAM və fiziki eksperiment mühiti mənbədə ətraflı reproducibility table daxilində verilməyib.
Training parametrləri: DAI/DP parametrləri açıq verilsə də local epoch sayı, ümumi model learning rate-i və əsas training batch size kimi bütün təlim parametrləri tam bildirilmir. GIA eksperimenti üçün batch size=1 açıq şəkildə verilir.
Cross-validation: 10 fold və random seed 42 bildirilir; oversampling, federated partitioning və model training-in hər fold daxilində dəqiq hansı ardıcıllıqla yenidən həyata keçirildiyinə dair bütün detallar verilməyib.
SCAFFOLD correction: DAI action kimi global_correction_error istifadə edir; exact SCAFFOLD control-variate tənliyi və correction magnitude bu məqalənin DAI bölməsində ətraflı çıxarılmayıb.
Monetary incentive: “monetary_benefit” simvolik action kimi verilir; real pul/token məbləği, büdcə və ödəniş iqtisadiyyatı göstərilmir.
DAI mixed-sign halları: Eq. 36-da bir contribution mənfi, digəri nonnegative olan sahələr açıq təsnif edilməyib.
Reputation aggregation: Eq. 38-də mənfi və ya sıfır ümumi reputation vəziyyətinin implementation davranışı izah edilməyib.
Privacy-budget başlanğıcı: Table 7-də \(\epsilon_0=1,20\), bəzi client təsvirlərində \(\epsilon=2,0\) görünür; client-specific initialization yolu açıq deyil.
MIA figure terminologiyası: Figure 16 caption/y-axis \(Adv_{MIA}\) ölçdüyü halda qrafik başlığında “resistance” ifadəsi işlədilir. Aşağı olması lazım olan quantity \(Adv_{MIA}\)-dır.
GIA 7,6× ifadəsi: Table 11 birbaşa Income MAE-nin 7,6× artmasını ölçür; buna görə “attack success probability 7,6× azaldı” şəklində yeni metrik yaradılmamalıdır.
Metodun tətbiqi mənası
Mənbə tədqiqat qurumların xam borrower qeydlərini mərkəzi hovuzda toplamadan ortaq kredit-riski modeli təlim etməsi ideyasını blockchain auditability, optimizer-level privacy və contribution-sensitive governance ilə birləşdirir. Arxitektura baxımından ən mühüm yeniliklərdən biri yalnız model update-i qorumaq deyil, iştirakçıların privacy və utility töhfələrini də ölçərək onların global modelə təsirini və təşviqini dinamik tənzimləməyə cəhd etməsidir.
Bununla belə, production maliyyə sisteminə keçiddə real qurum məlumatı, tənzimləyici tələblər, fairness, model-risk idarəetməsi, blockchain deployment xərci, smart-contract təhlükəsizliyi, məlumat paylanmasının dəyişməsi, real hücumçu davranışları və uzunmüddətli incentive iqtisadiyyatı ayrıca doğrulanmalıdır.
Mənbə və Metod Qeydi
Orijinal tədqiqat: BCFL-DAI-PUB: Blockchain-integrated federated learning with dynamic adaptive incentives for privacy-utility balanced credit risk modelling
Müəlliflər: Padmaja Ramachandra; Santhi Vaithiyanathan.
Müəllif sırası: Mənbədəki sıra olduğu kimi qorunub.
Bərabər töhfə: Padmaja Ramachandra və Santhi Vaithiyanathan mənbədə bərabər töhfəli müəlliflər kimi işarələnib.
Corresponding author: Santhi Vaithiyanathan.
Qurum 1: Vellore Institute of Technology, School of Computer Science and Engineering, Vellore, Tamil Nadu, India.
Qurum 2: Vellore Institute of Technology, School of Computer Science and Engineering, Chennai, Tamil Nadu, India.
Jurnal: PLOS ONE.
Nəşriyyat: PLOS.
Cild / say / məqalə nömrəsi: 21(10): e0361223.
DOI: 10.1371/journal.pone.0361223.
Rəsmi qeyd: DOI 10.1371/journal.pone.0361223 vasitəsilə PLOS ONE məqalə səhifəsi.
Qəbul üçün təqdim edilmə tarixi: 28 yanvar 2026.
Qəbul tarixi: 7 oktyabr 2026.
Nəşr tarixi: 29 oktyabr 2026.
Mənbə növü:Rəyli research article.
Hakemlik: Bəli; PLOS ONE-da yayımlanmış rəyli Version of Record.
Lisenziya: Creative Commons Attribution License (CC BY). Mənbə orijinal müəllif və mənbə göstərildikdə istifadəyə, paylanmaya və yenidən istehsala icazə verən açıq giriş lisenziyası bildirir.
Məlumat əlçatanlığı: Home Credit Default Risk məlumatlarının Kaggle-da əlçatan olduğu bildirilir; məqalə xüsusilə HC_application_train.csv faylını göstərir.
Maliyyələşmə: Müəlliflər tədqiqat üçün xüsusi maliyyələşmə alınmadığını bildiriblər.
Maraqların toqquşması: Müəlliflər competing interest olmadığını bəyan ediblər.
Kod əlçatanlığı: Məqalədə ayrıca public source-code repository bağlantısı bildirilmir.
Müəllif töhfələri: Conceptualization: Padmaja Ramachandra. Data curation: Padmaja Ramachandra. Formal analysis: Padmaja Ramachandra və Santhi Vaithiyanathan. Investigation: Santhi Vaithiyanathan. Methodology: Padmaja Ramachandra. Resources: Santhi Vaithiyanathan. Supervision: Santhi Vaithiyanathan. Validation: Padmaja Ramachandra. Visualization: Padmaja Ramachandra. Writing – original draft: Padmaja Ramachandra. Writing – review & editing: Santhi Vaithiyanathan.
Tədqiqatın əsas elmi növü: Açıq kredit-riski məlumat dəsti üzərində məlumatların simulyasiya edilmiş federated client-lara bölündüyü; malicious və free-rider davranışlarının nəzarətli şəkildə yeridildiyi blockchain-federated learning kompüter eksperimenti.
Məlumat preprocessing: Orijinal 307.511 qeyd minority oversampling-dən sonra 565.372 balanslaşdırılmış qeydə çıxarılmışdır. Raw 122 feature global One-Hot Encoding-dən sonra 245 feature-a çevrilmiş və SHAP cumulative importance %75 threshold ilə 184 feature seçilmişdir.
Federated heterogeneity: Near-IID üçün Dirichlet \(\alpha_D=10,0\), non-IID üçün \(\alpha_D=0,5\) istifadə edilmişdir. Sonrakı əsas eksperimentlər non-IID mühitdə aparılmışdır.
Client davranışları: Üç honest client, bir label-flipping malicious client və bir free-rider client.
Consensus: Client update və peer-evaluation transaction-larının doğrulanması üçün PBFT istifadə edildiyi bildirilir.
Off-chain / on-chain ayrımı: Numerical model/SHAP hesablamalarının off-chain aparıldığı, global schema-nın IPFS-də saxlanıldığı və cryptographic reference/hash-lərin blockchain üzərində qeydə alındığı bildirilir.
Privacy metodu: Gradient clipping + Gaussian noise istifadə edən optimizer-level differential privacy; initial privacy budget \(\epsilon_0=1,20\), range 0,40–2,50, \(\delta=10^{-5}\), \(C=1,0\), \(\sigma=0,50\).
DAI: \(T_{DAI}=0,70\); \(\gamma=4,0\); \(\lambda=0,30\); \(\alpha_c=0,50\); \(\Delta\epsilon=0,10\).
Məxfilik hücumları: Gradient Inversion Attack və Yeom-style black-box Membership Inference Attack.
Poisoning: Label-flipping attack 14–18-ci communication round arasında tətbiq edilmişdir.
Statistika: GIA Table 11 nəticələri beş client üzərindəki təkrarlardan mean ± standard deviation kimi bildirilir. Predictive performance üçün 10-fold cross-validation istifadə olunur. Mənbə p-value, confidence interval və ya effect-size əsaslı inferential significance test təqdim etmir.
Baseline: BCFL-PS-HER; homomorphic encryption və static reputation yanaşmasından istifadə edən blockchain-federated baseline kimi qiymətləndirilir.
Əsas şərh sərhədi: Tədqiqatın eksperimentləri real maliyyə qurumlarının bir-birindən müstəqil məlumat bazaları və ya real production blockchain şəbəkəsi üzərində aparılmayıb. Nəticələrin real bank tətbiqinə ötürülməsi ayrıca doğrulanmalıdır.
Mənbə-daxili metodoloji qeyri-müəyyənliklər: Oversampling alqoritminin dəqiq növü və fold isolation, real blockchain implementation/platform, hardware/software stack, monetary incentive məbləği, exact SCAFFOLD correction equation, Eq. 36 mixed-sign halları, Eq. 38 mənfi/sıfır reputation-weight davranışı və client-specific privacy-budget initialization ayrıca və tam şəkildə bildirilmir.
Mənbə-daxili hesabat qeydləri: Table 15-in son ablation sətri etiket ilə “Models=FL” sütunu arasında uyğunsuzluq ehtiva edir; Figure 16 qrafik başlığı MIA “resistance” desə də çəkilən kəmiyyət MIA Advantage-dır; conclusion-dakı 7,6× GIA ifadəsinin birbaşa cədvəl qarşılığı Income reconstruction MAE-nin 7,6× artmasıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib