


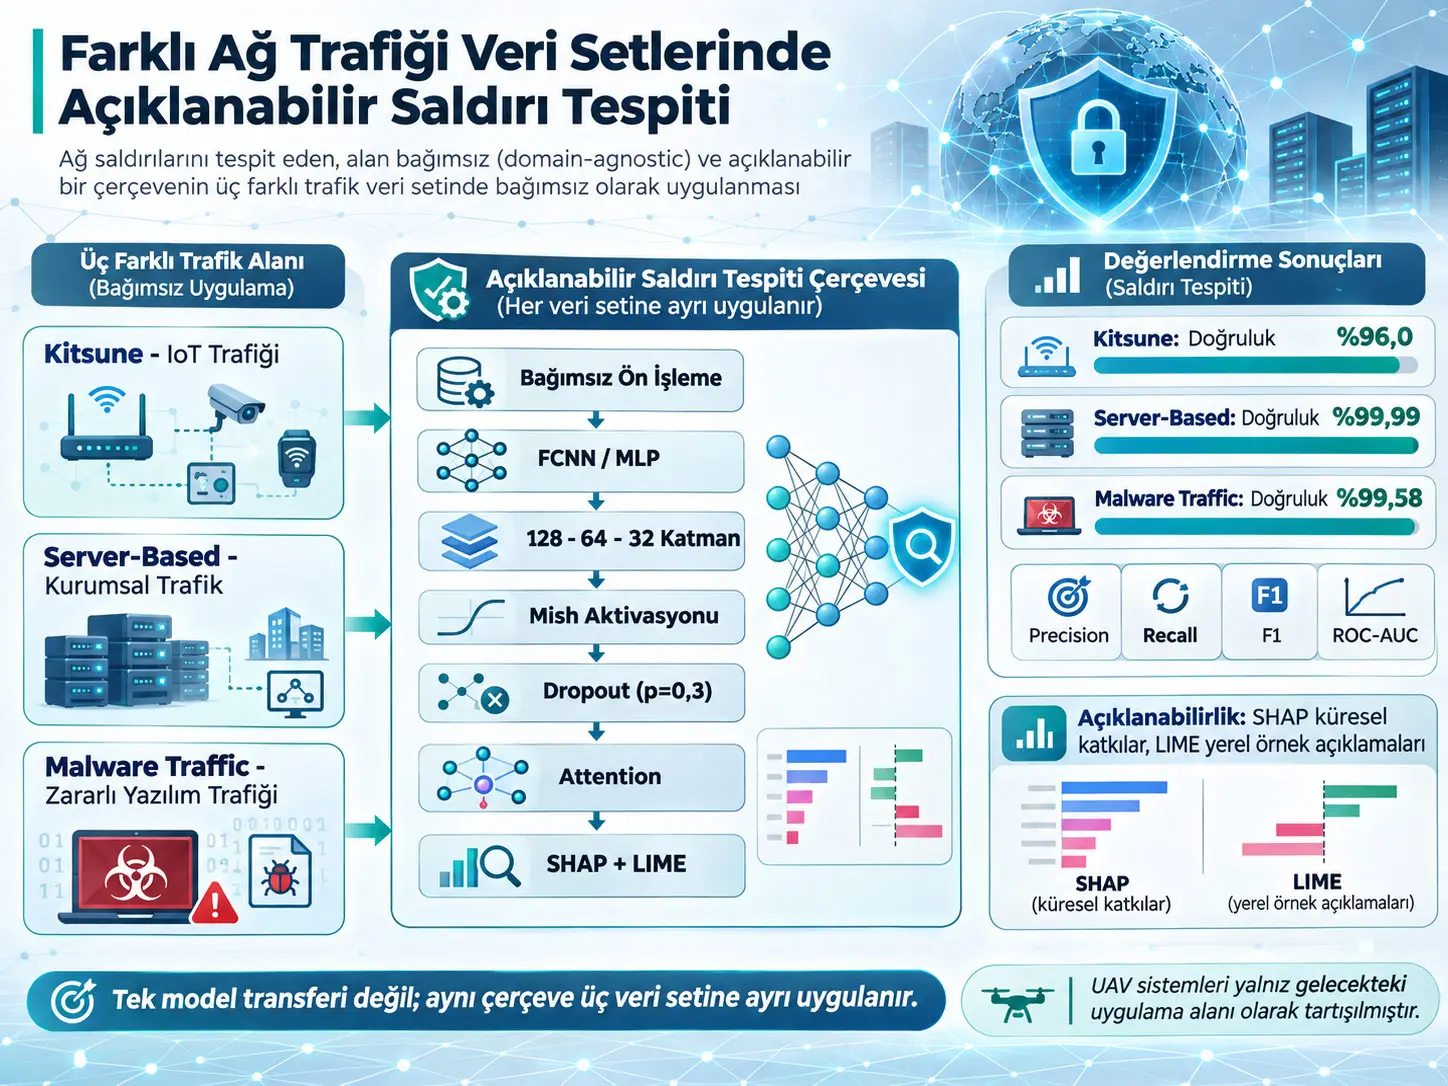
Alan-bağımsız açıklanabilir ağ saldırı tespit çerçevesi, aynı veri hazırlama ve Fully Connected Neural Network (FCNN) modelleme mantığını IoT, kurumsal sunucu ve zararlı yazılım trafiği gibi farklı ağ veri alanlarına ayrı ayrı uygulayan ve model kararlarını SHapley Additive exPlanations (SHAP) ile Local Interpretable Model-Agnostic Explanations (LIME) kullanarak açıklamayı amaçlayan gözetimli bir ağ saldırı sınıflandırma yaklaşımıdır. Çalışmada Kitsune, Server-Based ve Malware Traffic veri setleri bağımsız biçimde işlenmiş; sayısal ve kategorik özellikler hazırlanmış; 128, 64 ve 32 nöronlu tam bağlantılı katmanlar, Mish aktivasyonu, dropout ve attention içeren model kullanılmıştır. Kaynak, Kitsune için %96,0, Server-Based veri seti için %99,99 ve Malware Traffic için %99,58 accuracy raporlamaktadır.
“Domain-agnostic” ifadesi bu çalışmada tek bir veri setinde eğitilmiş modelin başka bir veri setine doğrudan transfer edildiği anlamına gelmez. Yazar sonuç bölümünde açıkça cross-dataset transfer learning göstermediğini; aynı modelleme boru hattının üç farklı ağ ortamına bağımsız uygulanmasını değerlendirdiğini belirtmektedir. Dolayısıyla çalışma ortak yöntem mimarisinin farklı veri alanlarında kullanılabilirliğine ilişkin kanıt sunar, fakat veri alanları arasında eğitim yapmadan doğrudan model transferini doğrulamaz.
Kitsune sonucu genel accuracy bakımından güçlü olmakla birlikte sınıf bazında eşit değildir. Table 3'te Class 2 için precision 0,72, recall 0,76 ve F1 0,74; Class 4 için precision 0,75, recall 0,69 ve F1 0,72 raporlanmıştır. Server-Based ve Malware Traffic sonuçları çok daha yüksek ayrışma göstermektedir. Bu nedenle yüksek genel accuracy değerleri bütün saldırı sınıflarının kusursuz biçimde yakalandığı şeklinde yorumlanmamalıdır.
SHAP analizi sabit 100 validation örneği üzerinde gerçekleştirilmiş; LIME ise her veri setinde yalnız bir temsilî validation örneğine ve en fazla 10 açıklayıcı özelliğe uygulanmıştır. Kaynak bu açıklanabilirlik araçlarını gerçek zamanlı her paket için çalışan bir inference bileşeni olarak değil, offline forensic analysis ve post-incident investigation amacıyla konumlandırmaktadır.
UAV güvenliği makalenin gerçek deney alanı değildir. Çalışmada UAV telemetry, GPS değişkenliği, RF communication pattern veya flight log kullanılmamıştır. UAV sistemleri yalnız gelecekte yöntemin denenebileceği potansiyel bir uygulama alanı olarak tartışılmıştır.
“Domain-Agnostic” Bu Çalışmada Ne Anlama Geliyor?
Bu çalışmada “domain-agnostic”, aynı genel preprocessing ve FCNN tabanlı modelleme boru hattının Kitsune IoT trafiği, Server-Based kurumsal trafik ve Malware Traffic verilerine veri setine özgü yeni bir model mimarisi tasarlanmadan ayrı ayrı uygulanması anlamına gelir; çalışma tek bir eğitilmiş modelin farklı veri setleri arasında transfer edildiğini veya ortak bir cross-dataset model üzerinde test yapıldığını göstermemektedir.
Araştırma problemi
Çalışmanın çıkış noktası iki sorundur. Birincisi, intrusion detection modellerinin çoğunun tek bir veri setine ve belirli trafik dağılımına göre geliştirilmesi nedeniyle farklı ağ ortamlarında aynı performansı koruyamamasıdır. İkincisi, yüksek doğruluk üreten derin öğrenme sistemlerinin neden belirli bir saldırı kararına ulaştığını açıklamakta zorlanmasıdır.
Bu iki sorun özellikle güvenlik analistlerinin yalnız bir alarm etiketi değil, kararın hangi trafik özelliklerinden etkilendiğini de görmek istediği kritik sistemlerde önemlidir. Çalışma bu nedenle sınıflandırma ile post-hoc açıklanabilirliği aynı değerlendirme çatısı altında ele almaktadır.
Çalışmanın üç veri alanı
| Veri seti | Ağ alanı | Deneyde kullanılan örnek | Özellik sayısı | Sınıf sayısı |
|---|---|---|---|---|
| Kitsune | IoT ağ trafiği | 9.000; özgün veri 20 milyondan fazla örnek içeriyor | 115 | 9: 8 saldırı + 1 benign |
| Server-Based | Kurumsal/sunucu trafiği | 225.398; veri setinin tamamı | 27 | 3 |
| Malware Traffic | Zararlı yazılım iletişim trafiği | 644.602; özgün veri 25 milyondan fazla örnek içeriyor | 23 | 5 |
Kitsune veri seti IoT tabanlı trafik ve ARP spoofing, Mirai botnet ve denial-of-service gibi saldırı davranışlarını kapsar. Kaynak 20 milyondan fazla özgün örnekten 9.000 örneklik temsilî alt küme seçildiğini belirtir. Ancak bu 9.000 örneğin tam seçim algoritmasını veya sınıf başına kesin örnekleme prosedürünü ayrıntılı biçimde vermemektedir.
Malware Capture Facility kökenli veri 25 milyondan fazla kayıttan oluşmaktadır. Çalışmada 644.602 kayıt kullanılmıştır. Bu veri; command-and-control iletişimi, ransomware etkinliği ve başka malware-driven network behavior örneklerini kapsamaktadır.
Server-Based veri seti 225.398 örnek, 27 özellik ve üç sınıftan oluşmaktadır. Kaynak burada HTTP flooding, SSH brute-force ve SQL injection gibi sunucu taraflı saldırı örneklerinden söz etmektedir.
Eksik değerler nasıl tamamlanıyor?
Sayısal özelliklerde eksik değerler ilgili sütunun ortalamasıyla doldurulmaktadır. Kategorik özelliklerde ise en sık görülen kategori, yani mode kullanılmaktadır. Ortalama tamamlama sayısal değişkenin merkez değerini korumayı amaçlarken mode tamamlama kategorik değişkende en yaygın sınıfı kullanır.
Bu yöntemler eksik değer sorununu giderir; ancak eksik veri mekanizmasının neden oluştuğunu modellemez. Kaynak missingness mechanism için ayrı bir analiz raporlamamaktadır.
“Standard scaling ile [0,1]” ifadesi nasıl ele alınmalı?
Kaynak sayısal özelliklerin “Standard scaling” kullanılarak [0,1] aralığına taşındığını iki ayrı yerde ifade etmektedir. Verianla bu ifadeyi sessizce başka bir scaler adına dönüştürmemektedir. Bu nedenle güvenilir çıkarım yalnız şudur: kaynak sayısal özelliklerin ölçeklendiğini ve sonuç aralığını [0,1] olarak tarif etmektedir; kullanılan scaler'ın yazılım düzeyindeki kesin sınıfı yayımlanmış metinden güvenle yeniden tanımlanamaz.
Kategorik özellikler nasıl kodlanıyor?
Nominal ve doğal sıralaması bulunmayan kategoriler için one-hot encoding kullanılmaktadır. Bu işlem her kategori için ayrı binary feature üreterek örneğin protokol türleri arasında yapay büyüklük sırası oluşmasını engeller.
Kaynak binary ve ordinal özelliklerin label encoding ile sayısal kodlara dönüştürüldüğünü belirtmektedir.
Sınıf dengesizliği nasıl ele alınıyor?
Metodoloji bölümünde stratified sampling ve class-weighted loss kullanıldığı yazılmaktadır. Ancak kaynak her sınıf için kullanılan sayısal class weight değerlerini veya bunların formülünü raporlamamaktadır.
Denklem 8 ise standart multiclass cross-entropy biçiminde verilmektedir ve denklem üzerinde açık bir sınıf-ağırlık terimi gösterilmemektedir. Dolayısıyla class weighting'in tam loss implementasyonuna nasıl uygulandığını kaynakta verilenden daha ayrıntılı biçimde varsaymak doğru değildir.
FCNN ve Attention Mekanizması Nasıl Çalışıyor?
Çalışmanın FCNN modeli, giriş feature vector'ünü 128, 64 ve 32 boyutlu gizli temsillere dönüştüren tam bağlantılı katmanlar, Mish aktivasyonu ve dropout ile işler; kaynak anlatımına ve denklemlere göre son 32 boyutlu latent representation üzerinde attention ağırlıkları hesaplanır ve attention-weighted temsil softmax katmanında çok-sınıflı saldırı tahminine dönüştürülür.
Girdi vektörü
Kaynak giriş vektörünü:
\[ \mathbf{x}\in\mathbb{R}^{d} \]
şeklinde tanımlamaktadır. \(d\) işlenmiş feature sayısıdır. Makale örnek olarak \(d=120\) değerini verir; ancak üç veri setinin özgün feature sayıları farklı olduğundan bu değer bütün veri setleri için sabit ve evrensel bir son boyut olarak yorumlanmamalıdır.
Denklem 1–3: Gizli temsiller
\[ \mathbf{h}_1=\operatorname{Mish}(W_1\mathbf{x}+b_1), \qquad \mathbf{h}_1\in\mathbb{R}^{128} \tag{1} \]
Denklem 1 giriş özelliklerini ilk 128 boyutlu latent representation'a dönüştürür. \(W_1\) öğrenilen weight matrix, \(b_1\) bias vector ve \(\mathbf{h}_1\) ilk gizli katman çıktısıdır.
\[ \mathbf{h}_2=\operatorname{Mish}(W_2\mathbf{h}_1+b_2), \qquad \mathbf{h}_2\in\mathbb{R}^{64} \tag{2} \]
Denklem 2 ilk gizli temsili 64 boyuta dönüştürür.
\[ \mathbf{h}_3=\operatorname{Mish}(W_3\mathbf{h}_2+b_3), \qquad \mathbf{h}_3\in\mathbb{R}^{32} \tag{3} \]
Denklem 3 son gizli representation'ı 32 boyuta indirir. Mish doğrusal olmayan aktivasyon fonksiyonudur. Kaynak Mish'in analitik fonksiyon tanımını ayrıca vermediği için Verianla kaynak dışından yeni denklem eklememektedir.
Denklem 4: Dropout
\[ \mathbf{h}^{drop}_i= Dropout(\mathbf{h}_i,p=0.3), \qquad i=1,2,3 \tag{4} \]
Dropout training sırasında gizli birimlerin bir bölümünü geçici olarak devre dışı bırakarak modelin tek tek latent units'e aşırı bağımlı hale gelmesini azaltmayı amaçlar. Buradaki \(p=0.3\), kaynakta raporlanan dropout rate'tir.
Denklem 5: Attention ağırlıkları
\[ \boldsymbol{\alpha}= softmax(W_a\mathbf{h}_3+b_a) \tag{5} \]
Attention katmanı son gizli representation içindeki latent units için göreli ağırlık üretmektedir. Kaynak metodoloji bölümü bu mekanizmanın doğrudan özgün giriş feature'ları üzerinde değil, öğrenilmiş hidden representation üzerinde çalıştığını açıkça belirtmektedir.
Bu ayrım önemlidir: attention weight ile SHAP feature attribution aynı şey değildir. Attention model içindeki latent representation'a ağırlık verir; SHAP ise model tahminine giriş özelliklerinin katkısını post-hoc biçimde değerlendirmek için kullanılır.
Denklem 6: Attention-weighted temsil
\[ z= \sum_{j=1}^{32} \alpha_j h_{3j} \tag{6} \]
Denklem 6 kaynakta bu biçimde verilmektedir. \(\alpha_j\), \(j\). attention weight; \(h_{3j}\), son gizli katmanın \(j\). bileşenidir.
Kaynak gösteriminde dikkat edilmesi gereken bir notation problemi vardır: Denklem 6 toplam ifadesiyle \(z\) skaler bir büyüklük gibi görünürken sonraki Denklem 7'de \(w_i^Tz\) biçiminde vektörel inner-product gösterimi kullanılmıştır. Kaynak bu boyut ilişkisini ayrıca açıklamamaktadır. Verianla denklemi değiştirmemekte ve eksik boyut bilgisini varsayımla tamamlamamaktadır.
Denklem 7: Softmax sınıf olasılığı
\[ \hat{y}_i= \frac{\exp(w_i^{T}z+b_i)} {\sum_{j=1}^{C}\exp(w_j^{T}z+b_j)}, \qquad i=1,2,\ldots,C \tag{7} \]
Denklem 7 her sınıf için normalize edilmiş tahmin olasılığı üretir. \(C\) ilgili veri setindeki sınıf sayısıdır. Softmax paydası bütün sınıfların exponentiated logit değerlerini toplayarak çıktıların ortak olasılık dağılımına dönüştürülmesini sağlar.
Denklem 8: Çok sınıflı cross-entropy
\[ L= -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{ic}\log(\hat{y}_{ic}) \tag{8} \]
\(N\) training sample sayısını, \(C\) sınıf sayısını, \(y_{ic}\) gerçek class indicator değerini ve \(\hat{y}_{ic}\) modelin ilgili sınıf için tahmin ettiği olasılığı temsil eder. Loss boyutsuzdur.
Model gerçek sınıfa düşük olasılık verdiğinde \(-\log(\hat{y}_{ic})\) büyür ve loss yükselir. Eğitim optimizasyonu bu loss'u azaltacak weight yapılarını öğrenmeyi amaçlar.
Mimari anlatımındaki kaynak-içi fark
Metodoloji açıklaması 128, 64 ve 32 nöronlu üç gizli katmanın her birinden sonra dropout bulunduğunu ve attention mekanizmasının son 32 boyutlu representation'a uygulandığını belirtmektedir. Denklem 1–6 da bu anlatımla uyumludur.
Ancak Algorithm 1 model dizisini FC-128 → Dropout(0.3) → FC-64 → Dropout(0.3) → Attention → FC-32 → softmax olarak verir. Bu sıralamada attention, FC-32'den önce görünmektedir ve üçüncü dropout açıkça gösterilmemektedir.
Bu iki sunum kaynak içinde tamamen aynı değildir. Verianla bu nedenle Algorithm 1 satırını veya denklem zincirini sessizce diğerine göre değiştirmemektedir.
Eğitim ayarları
| Parametre | Kaynak değeri | Açıklama |
|---|---|---|
| Optimizer | AdamW | Weight güncellemeleri için kullanılan optimizer. |
| Başlangıç learning rate | 0.001 | Algorithm 1'de verilen başlangıç değeri. |
| Learning-rate schedule | Cosine annealing | Kaynak schedule kullanıldığını belirtir; ayrıntılı schedule parametreleri raporlanmaz. |
| Batch size | 128 | Mini-batch başına training sample sayısı. |
| Maksimum epoch | 20 | Early stopping daha erken sonlandırabilir. |
| Dropout | 0.3 | Kaynak Denklem 4 ve yöntem açıklamasında raporlanan oran. |
| Weight initialization | Xavier | Başlangıç weight varyansını dengeli tutmak için. |
| Early stopping | Validation loss | Overtraining'i sınırlamak amacıyla. |
| Monitoring | TensorBoard | Training performansını izlemek için. |
Training, validation ve test ayrımı tam olarak nasıl verilmiş?
Algorithm 1 veri setlerini %70 training ve %30 test biçiminde ayırdığını yazmaktadır ve random_state=42 ile deterministic stratified split bilgisi SHAP açıklamasında görünmektedir.
Bununla birlikte algoritmanın sonraki satırlarında “validation” metrikleri ve validation loss üzerinden early stopping kullanılır; SHAP analizi de “validation samples” üzerinde tanımlanır. Kaynak ayrı bir üçüncü validation partition'ın boyutunu açık biçimde vermemektedir.
Dolayısıyla yayımlanmış metinden güvenle çıkarılabilen bilgi, 70/30 stratified ayrım ve validation olarak kullanılan örneklerin bulunduğudur; ayrı train-validation-test oranlarını kafadan üretmek doğru değildir.
SHAP ve LIME Bu Çalışmada Neyi Açıklıyor?
SHAP modeli birden fazla validation örneği üzerinde feature contribution dağılımlarını incelemek için, LIME ise tekil bir prediction çevresinde yerel feature katkılarını göstermek için kullanılmıştır; kaynak iki tekniği de gerçek-zamanlı paket başına açıklama yerine offline forensic analysis ve post-incident investigation aracı olarak sınırlandırmaktadır.
SHAP uygulaması
Kaynak KernelSHAP yaklaşımını shap.Explainer aracılığıyla, sabit 100 validation örneğinden oluşan background üzerinde ve CPU-side prediction wrapper ile uyguladığını belirtmektedir.
SHAP summary plot'ları bir feature'ın farklı örneklerde model output'unu hangi yönde ve ne ölçüde etkilediğini incelemek için kullanılmıştır.
Kitsune SHAP analizinde feature_0, feature_3, feature_1 ve feature_8 gibi birden fazla özellik belirgin katkı göstermektedir. Kaynak bunu IoT trafiğinde kararın tek bir baskın değişkene bağlı olmamasına bağlamaktadır.
Server-Based veri setinde SHAP dağılımı daha yoğun ve az sayıda özellik etrafında toplanmıştır. Malware veri setinde ise daha geniş feature contribution dağılımı görülmektedir.
LIME uygulaması
LIME veri seti başına yalnız bir temsilî validation örneğine uygulanmıştır. Kaynak kullanılan örneği idx=0, açıklanan feature sayısını ise num_features=10 olarak raporlamaktadır.
Kitsune örneğinde ts, service_http ve resp_bytes pozitif; service_dns ve proto_tcp negatif katkı gösteren feature örnekleri arasında verilmiştir.
Server-Based örneğinde ts, proto ve id.resp_h güçlü pozitif katkılar gösterirken orig_bytes ve resp_bytes negatif yönlü katkı örnekleri olarak belirtilmiştir.
Malware örneğinde feature_85, feature_86 ve feature_107 pozitif; feature_57 ve feature_39 negatif katkı örnekleri arasındadır.
Açıklanabilirlik sonuçlarının sınırı
Kaynak aynı trained checkpoint ve aynı 100 validation örneğinin kullanılması nedeniyle SHAP rankings'in tekrarlandığında değişmediğini ifade etmektedir. Ancak çalışma farklı random seed'lerle modeli baştan tekrar eğitip SHAP ranking variance için istatistiksel bir repeated-training experiment raporlamamaktadır.
Bu nedenle “aynı checkpoint altında açıklama tekrar üretilebilirliği” ile “farklı eğitim koşullarında explanation stability” aynı sonuç değildir.
Architecture comparison SHAP ne gösteriyor?
Kaynak Şekil 9, proposed MLP + Attention, attention'sız MLP ve Random Forest için SHAP feature rankings'i nitel olarak karşılaştırır. Malware veri setinde feature_0, feature_1, feature_2, feature_3 ve feature_8 üç mimarinin de top-10 sıralamalarında görünmektedir.
Server-Based veri setinde feature_1 bütün karşılaştırılan modellerde ilk sıradadır; feature_7, feature_13, feature_15 ve feature_16 da mimariler arasında tekrar görünmektedir.
Kitsune'da feature dimensionality ve dokuz sınıflı yapı nedeniyle ranking variation daha büyüktür; kaynak feature_13 ve feature_65'in iki MLP varyantının da top-10 listesine girdiğini bildirir.
Bu analiz predictive-performance ablation değildir. Attention modülünün çıkarılmasının accuracy veya F1 üzerinde ne kadar değişim oluşturduğunu gösteren nicel bir ablation table mevcut değildir; yazarlar tam ablation çalışmalarını gelecek çalışma olarak belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Ana performans sonuçları
| Veri seti | Alan | Accuracy | Yorum sınırı |
|---|---|---|---|
| Kitsune | IoT trafiği | %96,0 | Dokuz sınıf arasında Class 2 ve Class 4 belirgin biçimde daha zayıftır. |
| Server-Based | Kurumsal/sunucu trafiği | %99,99 | Table 3 iki ondalıklı formatta 1.00 olarak yuvarlar. |
| Malware Traffic | Malware iletişim trafiği | %99,58 | Table 3 accuracy sütununda 1.00 biçiminde yuvarlanmıştır. |
%99,99 Accuracy Tek Bir Evrensel Modelin Başarısını mı Gösteriyor?
Hayır. %99,99 değer Server-Based veri setinde ayrı değerlendirme koşulunda elde edilen en yüksek accuracy sonucudur; çalışma tek bir eğitilmiş modelin Kitsune, Server-Based ve Malware Traffic arasında transfer edildiğini göstermediğinden bu değer “üç alanda tek evrensel model %99,99 doğruluk sağladı” biçiminde yorumlanmamalıdır.
Kitsune sınıf bazlı sonuçları
| Sınıf | Precision | Recall | F1-score | Genel accuracy |
|---|---|---|---|---|
| Class 0 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 1 | 0.93 | 0.99 | 0.95 | 0.96 |
| Class 2 | 0.72 | 0.76 | 0.74 | 0.96 |
| Class 3 | 0.99 | 0.89 | 0.94 | 0.96 |
| Class 4 | 0.75 | 0.69 | 0.72 | 0.96 |
| Class 5 | 1.00 | 0.99 | 0.99 | 0.96 |
| Class 6 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 7 | 0.97 | 1.00 | 0.98 | 0.96 |
| Class 8 | 0.99 | 0.99 | 0.99 | 0.96 |
Class 2 ve Class 4 sonuçları, %96 overall accuracy'nin sınıf bazlı performans farklılıklarını gizleyebileceğini açıkça göstermektedir. Class 4 recall = 0.69 olduğundan gerçek Class 4 örneklerinin yaklaşık üçte biri ilgili koşulda doğru sınıfa atanamamıştır.
Server-Based ve Malware sonuçları
| Veri seti | Sınıf | Precision | Recall | F1 | Table 3 Accuracy |
|---|---|---|---|---|---|
| Server-Based | Class 0 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 1 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 0 | 0.99 | 0.99 | 0.99 | 1.00 |
| Malware | Class 1 | 0.99 | 1.00 | 1.00 | 1.00 |
| Malware | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 3 | 1.00 | 0.98 | 0.99 | 1.00 |
| Malware | Class 4 | 1.00 | 1.00 | 1.00 | 1.00 |
Table 3 iki ondalıklı sunum nedeniyle genel accuracy'yi Server-Based ve Malware için 1.00 göstermektedir. Abstract ise daha hassas değerler olarak sırasıyla %99,99 ve %99,58 vermektedir. Verianla bu iki sunumu çelişki gibi gizlememekte; Table 3 değerlerini yuvarlanmış tablo gösterimi olarak korumaktadır.
Confusion matrix'ler ne gösteriyor?
Kitsune confusion matrix'inde Class 0, 5, 6, 7 ve 8 ağırlıklı olarak diagonal üzerinde doğru sınıflandırılırken Class 2 ve Class 4'te daha fazla off-diagonal hata görülmektedir. Kaynak bu durumu sınıflar arasındaki feature overlap ile ilişkilendirmektedir.
Server-Based confusion matrix neredeyse tamamen diagonaldir. Malware confusion matrix'inde de yüksek diagonal dominance görülmekle birlikte Class 0 ile Class 1 arasında küçük miktarda karışıklık bulunmaktadır.
ROC-AUC sonuçları
Kitsune ROC analizinde çoğu sınıfın AUC değeri 1.00'a ulaşmakta; Class 2 ve Class 4 için değerler yaklaşık 0.99 düzeyinde raporlanmaktadır.
Server-Based veri setindeki üç sınıf için AUC = 1.00; Malware Traffic veri setindeki beş sınıf için de AUC = 1.00 raporlanmıştır.
Bu sonuçlar ilgili train/test protokolü ve kullanılan veri setleri altında ölçülmüştür. Başka ağlarda, yeni saldırı türlerinde veya zamanla değişen production traffic distribution altında aynı AUC'nin korunacağı çalışma tarafından doğrulanmamıştır.
Eğitim eğrileri
Kitsune eğitiminde validation accuracy yaklaşık 15. epoch civarında %95'in üzerine çıkmaktadır. Training ve validation eğrileri başlangıçta bir miktar ayrışmakta, sonraki epoch'larda daha kararlı hale gelmektedir.
Server-Based model training ve validation accuracy birkaç epoch içinde %99,5'in üzerine çıkmaktadır. Malware Traffic'te de accuracy çok erken dönemde %100'e yaklaşmaktadır.
Loss eğrileri
Kitsune training loss yaklaşık 1,2 düzeyinden başlayıp 0,2'nin altına inerken validation loss yaklaşık 0,08'e kadar düşmektedir.
Server-Based eğitiminde training ve validation loss birkaç epoch içinde yaklaşık 0,05'in altına iner. Malware modelinde loss değerleri yaklaşık 0,03 veya altında seyretmektedir.
Kaynak Malware validation loss'un çoğu epoch'ta training loss'tan daha düşük olmasını güçlü regularization nedeniyle hafif underfitting göstergesi olarak yorumlamaktadır. Bu bir yazar yorumudur; çalışma bunun için ayrı formal statistical test raporlamamaktadır.
Karşılaştırmalı Table 4 nasıl okunmalı?
| Yaklaşım | Best Accuracy (%) | Explainability | Multi-dataset support |
|---|---|---|---|
| Ref. 20 | 98.7 | Partial, SHAP | Hybrid Boosting |
| Ref. 11 | 97.9 | High, XAI survey | Review-based |
| Ref. 12 | 96.3 | Low | 2 datasets |
| Ref. 25 | 98.5 | Federated SHAP | Federated DL |
| Proposed model | 99.99 | SHAP visual + feature attribution | Kitsune + Server + Malware |
Table 4'teki %99,99, önerilen sistemin üç veri setindeki en yüksek sonucu olan Server-Based accuracy'dir. Tablo farklı çalışmaların farklı veri setleri ve yöntemleri üzerindeki “best achieved accuracy” değerlerini yan yana koymaktadır. Bu nedenle kontrollü, aynı test kümesine dayanan head-to-head benchmark olarak yorumlanmamalıdır.
Cross-dataset transfer gerçekten test edildi mi?
Hayır. Sonuç bölümünün açık ifadesine göre çalışma cross-dataset transfer learning göstermemektedir. Ortak pipeline üç network environment'a bağımsız uygulanmıştır.
Metnin daha erken bölümünde pipeline'ın farklı domain'lerde “without requiring retraining or architectural modifications” çalıştığını söyleyen daha güçlü bir ifade bulunmaktadır. Buna karşılık yöntem bölümü her veri seti için training/test süreci tanımlar ve sonuç bölümü transfer learning yapılmadığını açıklar. Bu nedenle Verianla güvenli yorum olarak “architecture/pipeline customization gerektirmeden bağımsız yeniden uygulama” anlamını korumakta, “tek trained model retraining olmadan üç domain'de kullanıldı” iddiasını üretmemektedir.
UAV'lar üzerinde test yapıldı mı?
Hayır. Makalede UAV telemetry, RF signal, flight log veya GPS variability içeren UAV-specific dataset kullanılmamıştır. UAV intrusion detection yalnız gelecekteki potansiyel application domain olarak tartışılmıştır.
Dolayısıyla çalışma, UAV'larda spoofing, jamming veya diğer saldırıları gerçek uçuş verisi üzerinde tespit ettiğini göstermemektedir.
İstatistiksel belirsizlik ve tekrarlanabilirlik
Çalışma accuracy, precision, recall, F1-score ve ROC-AUC raporlamaktadır. Ancak performans sonuçları için confidence interval, p-value, effect size veya multiple-random-seed distribution raporlanmamaktadır.
random_state=42 SHAP için kullanılan deterministic 70/30 split bağlamında belirtilmiştir. Bu, bağımsız training runs arasındaki performans belirsizliğinin ölçüldüğü anlamına gelmez.
Çalışmanın desteklediği sonuçlar
- Aynı genel preprocessing ve FCNN modelleme yaklaşımı üç farklı network-data alanında ayrı ayrı uygulanabilmiştir.
- Kitsune'da %96,0, Server-Based'de %99,99 ve Malware Traffic'te %99,58 accuracy raporlanmıştır.
- Kitsune'da bazı sınıflar diğerlerinden belirgin biçimde daha zayıftır; özellikle Class 2 ve Class 4'ün F1 değerleri sırasıyla 0,74 ve 0,72'dir.
- SHAP modelin feature contribution yapısını birden fazla validation örneği üzerinden incelemek için kullanılmıştır.
- LIME tekil predictions için local feature contribution açıklaması üretmek üzere uygulanmıştır.
- Server-Based ve Malware veri setlerinde ROC-AUC değerleri raporlanan bütün sınıflarda 1.00'dır.
- Çalışma aynı architectural pipeline'ın heterojen veri alanlarına uygulanabileceğini desteklemektedir.
Çalışmanın desteklemediği sonuçlar
- Tek bir trained modelin üç veri seti arasında doğrudan transfer edilerek aynı sonuçları verdiği gösterilmemiştir.
- Cross-dataset transfer learning doğrulanmamıştır.
- UAV intrusion defence gerçek UAV verisiyle doğrulanmamıştır.
- SHAP veya LIME gerçek-zamanlı packet-by-packet explanation olarak test edilmemiştir.
- Modelin production network üzerinde throughput, latency, memory veya long-term drift performansı raporlanmamıştır.
- Attention modülünün predictive contribution'ını sayısal olarak izole eden tam performance ablation yapılmamıştır.
- Confidence interval veya repeated-seed performance distribution bulunmadığı için sonuçların training-run belirsizliği nicel olarak verilmemiştir.
- Server-Based %99,99 accuracy, bütün veri setlerinde %99,99 ortak performans anlamına gelmez.
Kaynak içindeki önemli yöntemsel belirsizlikler
| Konu | Kaynak ifadesi A | Kaynak ifadesi B | Verianla yaklaşımı |
|---|---|---|---|
| Ölçekleme | Standard scaling | [0,1] aralığı | Scaler türü dış bilgiden hareketle değiştirilmez. |
| Attention konumu | Metin/denklemler: 32-nöronlu h3 sonrası attention | Algorithm 1: attention, FC-32'den önce | Fark görünür tutulur. |
| Dropout sırası | Metin: üç hidden layer'ın her birinden sonra dropout | Algorithm 1 dizisi üçüncü dropout'u göstermiyor | Eksik satır varsayımla tamamlanmaz. |
| Data split | Algorithm 1: 70% train / 30% test | Training metni validation loss ve validation samples kullanıyor | Ayrı üçüncü split oranı uydurulmaz. |
| Loss | Yöntem: class-weighted loss | Denklem 8: standart multiclass cross-entropy | Exact class-weight implementation bilinmiyor olarak korunur. |
| Domain generalisation | Ara metin: “without requiring retraining” | Conclusion: cross-dataset transfer yapılmadı, veri setleri bağımsız işlendi | Tek-model transfer başarısı iddia edilmez. |
| Accuracy gösterimi | Abstract: 99,99% ve 99,58% | Table 3: 1.00 ve 1.00 | Table 3 değerleri yuvarlanmış gösterim olarak ele alınır. |
Gelecek çalışma yönleri
Yazar gelecek çalışmalar için UAV-specific dataset'ler ve flight telemetry, GPS variability ve communication-signal pattern gibi domain-relevant feature'ların eklenmesini önermektedir.
Ayrıca gerçek cross-dataset transfer experiments, ablation studies ve classical machine-learning baselines ile kontrollü karşılaştırmaların yapılması gerektiği belirtilmektedir.
Bu çalışmalar mevcut makalenin tamamlanmış sonuçları değildir.
Kaynak ve Yöntem Notu
Özgün başlık: A domain-agnostic explainable framework for network attack detection across diverse traffic datasets
Yazar: Abed Alanazi.
Yazar sayısı: 1.
Eşit katkı: Uygulanabilir değildir; çalışma tek yazarlıdır.
Corresponding author: Abed Alanazi.
E-posta: ad.alanazi@psau.edu.sa
Kurum: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam bin Abdulaziz University, Al-Kharj 11942, Saudi Arabia.
Dergi: Scientific Reports.
Yayınevi/platform: Nature Portfolio / Springer Nature.
Cilt: 16.
Makale numarası: 24512.
Yayın yılı: 2026.
Yayın tarihi: 16 Temmuz 2026.
Received: 27 Nisan 2026.
Accepted: 6 Temmuz 2026.
DOI: 10.1038/s41598-026-61637-w.
Resmî yayın sayfası: Nature / Scientific Reports makale kaydı; DOI üzerinden erişilebilir.
Kaynak türü: Yayımlanmış özgün araştırma makalesi.
Hakemlik: Scientific Reports uzman hakem değerlendirmesi uygulayan hakemli bir Nature Portfolio dergisidir.
Lisans: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Lisans ve görsel kullanımı: NoDerivatives koşulu nedeniyle kaynak Şekil 1–9 değiştirilmiş veya uyarlanmış biçimde Verianla makalesine aktarılmamıştır. Makale içindeki SVG yalnız kaynak metninde açıkça tarif edilen yöntem ilişkilerinden bağımsız kompozisyonla hazırlanmıştır.
Ana çalışma alanı: Network intrusion detection, deep learning ve Explainable Artificial Intelligence.
Ana model: Fully Connected Neural Network / Multi-Layer Perceptron tabanlı sınıflandırıcı; Mish activation, dropout ve latent-representation attention içerir.
Gizli katmanlar: 128, 64 ve 32 nöron.
Dropout: p = 0.3.
Optimizer: AdamW.
Başlangıç learning rate: 0.001.
Learning-rate scheduling: Cosine annealing; ayrıntılı schedule parametreleri kaynakta verilmemiştir.
Batch size: 128.
Maksimum epoch: 20.
Early stopping: Validation loss'a göre.
Weight initialization: Xavier initialization.
Loss: Multiclass cross-entropy. Yöntem metni ayrıca class-weighted loss kullanıldığını belirtmektedir; exact class-weight değerleri raporlanmamıştır.
Data split: Algorithm 1'de 70% training ve 30% test. Validation loss ve validation samples ayrıca kullanılmaktadır; ayrı validation partition oranı açıkça raporlanmamıştır.
Random state: SHAP açıklamasında deterministic 70/30 stratified split için random_state = 42 belirtilmiştir.
Kitsune: 20 milyondan fazla özgün örnek arasından 9.000 örnek; 115 özellik; 9 sınıf.
Server-Based: 225.398 örnek; 27 özellik; 3 sınıf; veri setinin tamamı kullanılmıştır.
Malware Traffic: 25 milyondan fazla özgün örnek arasından 644.602 örnek; 23 özellik; 5 sınıf.
Eksik değer tamamlama: Sayısal feature'larda mean, kategorik feature'larda mode.
Kategorik encoding: Nominal feature'larda one-hot encoding; binary/ordinal feature'larda label encoding.
Scaling kaynak ifadesi: Kaynak “Standard scaling” ve “[0,1]” ifadelerini birlikte kullanmaktadır. Verianla scaler türünü dış bilgiden hareketle değiştirmemiştir.
Ana accuracy sonuçları: Kitsune %96,0; Server-Based %99,99; Malware Traffic %99,58.
Kitsune zayıf sınıflar: Class 2 F1 = 0,74; Class 4 F1 = 0,72.
ROC-AUC: Kitsune'da çoğu sınıf 1.00, Class 2 ve Class 4 yaklaşık 0.99; Server-Based ve Malware sınıflarında 1.00 raporlanmıştır.
SHAP: Sabit 100 validation örneği; KernelSHAP / shap.Explainer; CPU-side prediction wrapper.
LIME: Veri seti başına bir temsilî validation örneği; idx = 0; num_features = 10.
XAI çalışma modu: Offline forensic analysis ve post-incident investigation; real-time per-packet explanation değildir.
Cross-architecture SHAP: Proposed MLP + Attention, attention'sız MLP ve Random Forest açıklamaları nitel olarak karşılaştırılmıştır; bu karşılaştırma predictive-performance ablation değildir.
Cross-dataset transfer: Yapılmamıştır. Conclusion bölümü aynı pipeline'ın farklı veri setlerine bağımsız uygulanmasını değerlendirdiğini açıkça belirtir.
UAV validation: Yapılmamıştır. UAV telemetry, RF signals ve flight logs mevcut veri içinde yoktur.
İstatistiksel testler: Performans için p-value, confidence interval veya effect size raporlanmamıştır.
Repeated-seed performance: Raporlanmamıştır.
Data availability: Kitsune, Malware Capture Facility ve kullanılan server/network malware dataset'i kaynakta public dataset olarak belirtilmiştir.
Yazar katkıları: Conceptualization, data curation, formal analysis, funding acquisition, investigation, methodology, project administration, validation ve writing—review & editing görevlerinin tamamı Abed Alanazi tarafından yürütülmüştür.
Finansman: National Cybersecurity Authority, Kingdom of Saudi Arabia tarafından CRPG-25-3295 numaralı destek ve Prince Sattam bin Abdulaziz University tarafından PSAU/2026/R/1447 proje finansmanı raporlanmıştır.
Çıkar çatışması: Yazar competing interests bulunmadığını beyan etmektedir.
Temel yöntemsel sınır: Çalışma üç kamuya açık ağ güvenliği veri seti üzerinde bağımsız deneylerdir; production network saha doğrulaması, cross-dataset transfer learning ve UAV-specific validation içermez.
Kaynak-içi mimari sınırı: Metin/denklemler attention'ı h3 sonrasında gösterirken Algorithm 1 attention'ı FC-32'den önce sıralamaktadır; bu fark Verianla tarafından sessizce düzeltilmemiştir.
Kaynak-içi split sınırı: 70/30 train-test ifadesiyle birlikte validation loss ve validation samples kullanılmış, ayrı validation oranı açıkça verilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir