


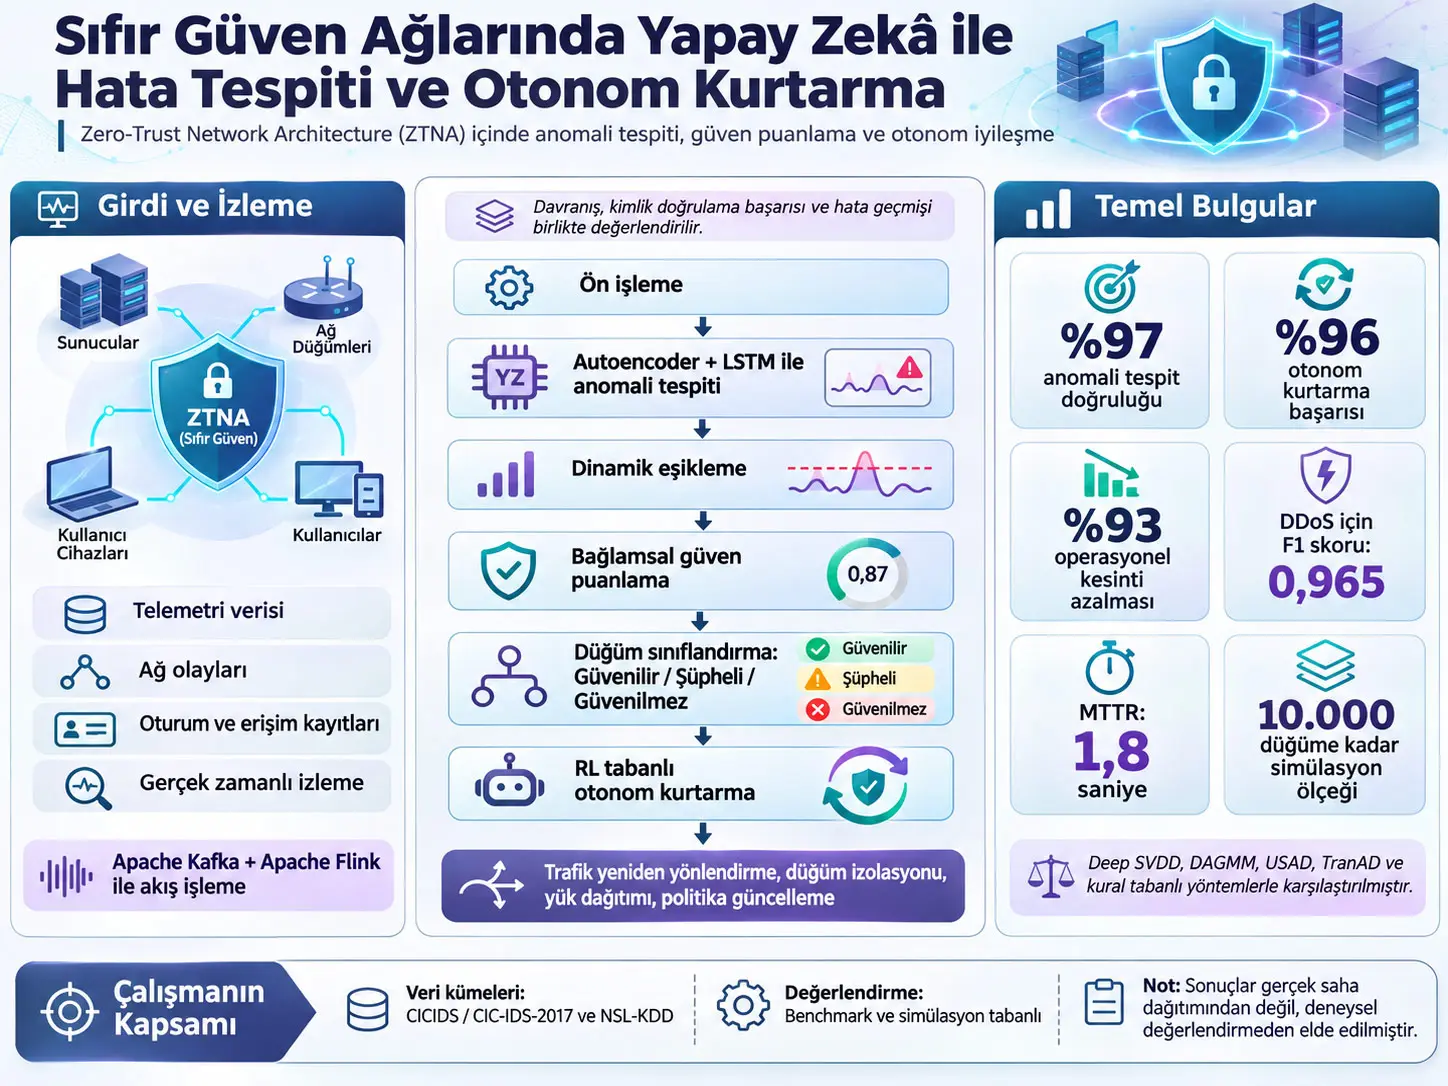
Önerilen Autoencoder-LSTM-RL-Trust çerçevesi, Sıfır Güven Ağ Mimarilerinde (Zero-Trust Network Architecture, ZTNA) ağ telemetrisinden anomali belirlemeyi, düğümlerin bağlamsal güvenilirliğini dinamik olarak hesaplamayı ve güvenilir düğümler üzerinden kurtarma işlemlerini reinforcement learning ile uyarlamayı amaçlayan bütünleşik bir yapay zekâ tabanlı hata tespiti ve otonom kurtarma mimarisidir. Çerçeve; Autoencoder ve Long Short-Term Memory (LSTM) tabanlı anomali analizi, attention mekanizması, adaptif eşikleme, davranış ve fault-history tabanlı trust scoring, reinforcement learning (RL) tabanlı recovery orchestration ile Apache Kafka ve Apache Flink üzerinden akış telemetrisi kavramlarını bir araya getirmektedir.
Kaynak çalışmada sistem CICIDS/CIC-IDS-2017 ve NSL-KDD benchmark verileri, DDoS, Unauthorized Access ve Data Exfiltration saldırı sınıfları ile farklı ölçeklerdeki ağ simülasyonları üzerinden değerlendirilmiştir. Makalenin genel sistem düzeyi sonucu %97 anomaly-detection accuracy, %96 autonomous-recovery success ve %93 downtime reduction olarak verilmektedir. DDoS için F1-score 0,965 raporlanmış; sonuç bölümünde DDoS Mean Time to Detect (MTTD) 1,6 s, Mean Time to Repair (MTTR) 1,8 s olarak belirtilmiştir.
Bu değerler gerçek kurumsal bir Zero-Trust ağında uzun dönem saha performansı değildir. Yazarlar mevcut doğrulamanın benchmark ve simulation-based olduğunu, federated learning bileşeninin büyük ölçekli dağıtık deployment altında henüz deneysel olarak sınanmadığını ve gelecekte live software-defined Zero-Trust telemetry ortamlarında doğrulama gerektiğini açıkça belirtmektedir.
Kaynak içindeki farklı tablolar aynı kavramlar için her zaman aynı sayısal değeri kullanmamaktadır. Örneğin CICIDS karşılaştırma tablosu proposed Autoencoder-LSTM için accuracy 0,961 verirken Discussion 5.1 metni 0,950 yazmaktadır. Recovery ile ilgili farklı deney tablolarında 2,3 s recovery latency, 1,8 s MTTR ve 90 ms recovery time ayrı ayrı raporlanmaktadır. Bu nedenle Verianla bu değerleri tek bir sayıymış gibi birleştirmemektedir.
Sıfır Güven Ağ Mimarisi Bu Çalışmada Ne Anlama Geliyor?
Sıfır Güven Ağ Mimarisi (Zero-Trust Network Architecture, ZTNA), kullanıcı, cihaz veya ağ konumuna kalıcı ve örtük güven vermek yerine erişimin sürekli doğrulama, bağlam, kimlik doğrulama ve ayrıntılı politika denetimiyle değerlendirilmesini temel alan güvenlik yaklaşımıdır; bu çalışma ZTNA'ya anomali tespiti, dinamik trust scoring ve otonom recovery işlevlerini tek kapalı döngüde eklemeyi amaçlamaktadır.
Araştırma problemi
Kaynak çalışmanın çıkış noktası, geleneksel ağ güvenliği sistemlerinin çoğunun statik eşiklere, önceden tanımlanmış trust varsayımlarına veya insan müdahalesi gerektiren recovery prosedürlerine dayanmasıdır. Dinamik Zero-Trust ortamlarında düğümlerin davranışı, ağ topolojisi ve saldırı biçimleri zaman içinde değişebildiği için sabit kurallar hem false positive üretebilir hem de yeni saldırı modellerine geç tepki verebilir.
Araştırmacılar üç işlevin aynı karar döngüsünde bütünleştirilmesini hedeflemektedir:
- Normal davranıştan sapmaları derin öğrenmeyle belirlemek.
- Her düğümün güvenilirliğini davranış ve fault geçmişine göre sürekli güncellemek.
- Bir fault veya attack belirlendiğinde güvenilir düğümler üzerinden ağın rol, trafik, politika ve hizmet yapısını otomatik olarak yeniden düzenlemek.
Çalışmanın ana katkıları
Kaynak beş temel katkı tanımlamaktadır. Birincisi Autoencoder ile LSTM'in birlikte kullanıldığı dual-model anomaly detection yaklaşımıdır. İkincisi Mahalanobis tabanlı anomali bağlamı ile node responsiveness, authentication frequency ve fault history gibi davranışsal ölçülerin kullanıldığı context-aware trust scoring'dir. Üçüncüsü RL tabanlı autonomous recovery orchestration'dır. Dördüncüsü federated learning'in privacy-preserving dağıtık adaptation için mimariye dahil edilmesidir. Beşincisi ise benchmark ve simülasyon değerlendirmeleridir.
Ancak federated learning modülünün deneysel statüsü diğer bileşenlerden farklıdır. Kaynak, esas preliminary experiments'ın merkezi hybrid Autoencoder-LSTM-RL yapısına odaklandığını; federated-learning bileşeninin mevcut çalışmada büyük ölçekli dağıtık deneyden çok bir reference architecture olarak yer aldığını açıkça belirtmektedir.
Autoencoder-LSTM Anomali Tespiti Nasıl Çalışıyor?
Önerilen anomali tespit zinciri, yüksek boyutlu telemetriyi önce merkezleme, boyut azaltma ve normalizasyonla işler; Autoencoder normal davranışı yeniden kurmayı öğrenirken LSTM zaman içindeki bağımlılıkları modeller, yeniden oluşturma hatası ve bağlamsal skorlar eşikle karşılaştırılır, anormal örnekler fault vector'a dönüştürülerek trust ve recovery modüllerine aktarılır.
Veri edinimi ve özellik mühendisliği
Kaynak, gerçek zamanlı telemetri akışı için Apache Kafka ve Apache Flink'i mimarinin veri-ingestion bileşenleri olarak tanımlar. Kullanılabilecek girdiler arasında event logları, failed-login olayları, API çağrıları, user interaction pattern'leri ve ağ telemetrisi bulunur.
Feature engineering üç temporal granularity düzeyini kullanacak biçimde tasarlanmıştır: short-term, mid-term ve long-term. Bunun amacı LSTM'in yalnız tek anda oluşan sapmaları değil, zaman içinde gelişen davranış örüntülerini de öğrenebilmesidir.
Feature vector ayrıca dış threat-intelligence bilgileriyle zenginleştirilebilir. Kaynağın verdiği örnekler blacklisted IP address'ler ve bilinen software vulnerability bilgileridir. Bu dış bağlamın işlevi, aynı ham ağ davranışının güvenlik açısından farklı anlamlara gelebileceği durumlarda modele ek bağlam sağlamaktır.
Autoencoder'ın görevi
Autoencoder normal ağ davranışının daha sıkıştırılmış bir temsilini öğrenir ve girdi feature vector'ünü yeniden üretmeye çalışır. Normal örnekler eğitim dağılımına yakın olduğu için reconstruction error'un görece düşük olması beklenir. Normal örüntüden sapmış bir ağ olayı ise model tarafından daha kötü yeniden oluşturulabilir ve reconstruction error büyüyebilir.
LSTM'in görevi
Long Short-Term Memory ağı ardışık telemetride zaman bağımlılıklarını modellemek için kullanılır. Bir anormallik yalnız tek bir yüksek veya düşük değerden oluşmayabilir; örneğin latency'deki artışı authentication başarısındaki düşüşün izlemesi gibi olay sıraları birlikte anlam kazanabilir.
Attention-enhanced LSTM
Kaynak LSTM çıkışlarının ardından attention katmanlarının kullanılmasını önerir. Attention mekanizmasının burada amaçlanan rolü, anomaly davranışını açıklamada daha önemli olabilecek zaman adımlarına daha fazla ağırlık vermektir.
Ensemble autoencoder
Tek bir büyük Autoencoder yerine farklı feature subset'leri üzerinde birden fazla shallow autoencoder kullanılabileceği belirtilmektedir. Amaç noisy veya redundant feature gruplarına aşırı uyum riskini düşürmek ve generalization kapasitesini artırmaktır.
Dynamic thresholding
Sabit anomaly threshold yerine quantile-based veya statistically adaptive threshold kullanılması önerilmektedir. Böylece ağın normal davranışı zaman içinde değiştiğinde threshold'un da concept drift'e uyum sağlaması hedeflenmektedir.
Mahalanobis distance ile ilgili kaynak sınırı
Kaynak Section 3.2'de anomaly score'un Mahalanobis distance kullanılarak hesaplandığını ve girdinin eğitim dağılımının ortalama/covariance yapısına göre değerlendirildiğini söyler. Ancak PDF'nin yayımlanmış sayfa görüntüsünde “Mathematically, the anomaly score is computed using Mahalanobis distance:” cümlesinden sonra denklem görünmemektedir. Verianla bu eksik formülü standart Mahalanobis denklemiyle kendi başına tamamlamamaktadır.
Denklem 1–8: Merkezleme, covariance ve boyut azaltma
\[ \mu_i=\frac{1}{N}\sum_{j=1}^{N}x_{j,i}, \qquad i\in\{1,\ldots,d\} \tag{1} \]
Denklem 1 her feature için örnek ortalamasını hesaplar. \(N\) örnek sayısı, \(d\) feature sayısı, \(x_{j,i}\) ise \(j\). örneğin \(i\). feature değeridir.
\[ \bar{x}_{j,i}=x_{j,i}-\mu_i, \qquad X=[\bar{x}_{j,i}] \tag{2} \]
Denklem 2 mean-centering işlemidir. Her feature kendi ortalamasından uzaklığıyla temsil edilir.
\[ S=\frac{1}{N-1}\sum_{j=1}^{N} \left(\bar{x}_{j}\bar{x}_{j}^{T}\right) \tag{3} \]
Denklem 3 merkezlenmiş örneklerden covariance matrix üretir. Covariance matrix feature'ların birlikte nasıl değiştiğini temsil eder.
\[ X=U\Sigma V^{T}, \qquad V_k=V[:,1:k] \tag{4} \]
Kaynak bu adımı PCA başlığı altında verir ve matrix decomposition biçiminde SVD gösterimini kullanır. \(V_k\), ilk \(k\) principal direction'ı temsil eder.
\[ Fr_j=\sum_{i=1}^{k}x_{j,i}v_i \tag{5} \]
\[ Fr=[Fr_1,\ldots,Fr_N] \tag{6} \]
Denklem 5–6 her örneği seçilen principal direction'lara projekte eder ve reduced feature matrix'i oluşturur.
\[ z_{j,i}= \frac{x_{j,i}-\mu_i} {\sqrt{\frac{1}{N}\sum_{k=1}^{N}(x_{k,i}-\mu_i)^2}} \tag{7} \]
\[ Z=[z_{j,i}], \qquad i\in\{1,\ldots,k\} \tag{8} \]
Denklem 7–8 principal component değerlerini scale ederek normalization matrisi \(Z\)'yi oluşturur. Kaynakta fiziksel birim belirtilmemektedir; normalizasyon sonrasındaki değerler ölçeklenmiş feature değerleridir.
Denklem 9–17: LSTM, reconstruction error ve anomaly score
\[ h_t=LSTM(x_t,h_{t-1}), \qquad x_t\in Z \tag{9} \]
\[ c_t=\sigma_f\odot c_{t-1}+\sigma_i\odot\tilde{c}_t \tag{10} \]
Denklem 9–10 zaman serisinin LSTM hidden state ve cell-state içinde taşınmasını ifade eder. \(\odot\) eleman bazlı çarpımdır.
\[ \hat{x}_t=Decoder(h_t) \tag{11} \]
\[ E_t=\sum_{i=1}^{d}(x_{t,i}-\hat{x}_{t,i})^2 \tag{12} \]
\[ E_{total}=\sum_{t=1}^{T}E_t \tag{13} \]
Denklem 11–13 Autoencoder decoder'ın reconstructed input üretmesini ve gerçek girdiyle farkının squared reconstruction error olarak hesaplanmasını tanımlar.
\[ \mu_E=\frac{1}{T}\sum_{t=1}^{T}E_t \tag{14} \]
\[ \sigma_E= \sqrt{\frac{1}{T}\sum_{t=1}^{T}(E_t-\mu_E)^2} \tag{15} \]
\[ A_t=\frac{E_t-\mu_E}{\sigma_E} \tag{16} \]
Denklem 14–16 reconstruction error'u kendi ortalama ve standard deviation'ına göre normalize eder. \(A_t\), zaman \(t\)'deki standardize anomaly score'dur.
\[ A_{i,t}= \sum_{j=1}^{w} \left( \frac{e_{i,t-j}}{\sigma_i} \right)^2 \alpha_j \tag{17} \]
Denklem 17, geçmiş \(w\) pencere içindeki error terimlerini ağırlıklı biçimde birleştiren smoothed anomaly score ifadesidir. \(\alpha_j\) kaynakta ağırlık katsayısı olarak kullanılır.
Denklem 18–23: Feature correlation, ranking ve Softmax sınıflandırma
\[ Cov(f_i,f_j)= \frac{1}{N}\sum_{t=1}^{N} (f_{t,i}-\mu_i)(f_{t,j}-\mu_j) \tag{18} \]
\[ C_{i,j}= \frac{\sum_{t=1}^{N}(f_{t,i}-\mu_i)(f_{t,j}-\mu_j)} {\sqrt{\sum_{t=1}^{N}(f_{t,i}-\mu_i)^2} \sqrt{\sum_{t=1}^{N}(f_{t,j}-\mu_j)^2}} \tag{19} \]
Denklem 18 covariance, Denklem 19 correlation yapısını hesaplar.
\[ S_i=\sum_{j=1}^{d}|C_{i,j}| \tag{20} \]
\[ Rank(f_i)=sort(S_i) \tag{21} \]
Feature contribution, diğer feature'larla absolute correlation toplamı üzerinden sıralanmaktadır.
\[ z_c=\sum_{i=1}^{k}w_{c,i}x_i+b_c \tag{22} \]
\[ P(y=c\mid x)= \frac{e^{z_c}} {\sum_{j=1}^{C}e^{z_j}} \tag{23} \]
Denklem 22 sınıf logit'ini, Denklem 23 Softmax olasılığını hesaplar. Softmax çıktısı toplamı 1 olan sınıf olasılıkları üretir.
Denklem 24–28: Loss, backpropagation ve Adam
\[ L= \sum_{t=1}^{T}\sum_{i=1}^{d} (x_{t,i}-\hat{x}_{t,i})^2 \tag{24} \]
\[ \frac{\partial L}{\partial w} = \sum_{t=1}^{T} \frac{\partial L}{\partial h_t} \frac{\partial h_t}{\partial w} \tag{25} \]
\[ \Delta w= -\eta \sum_{t=1}^{T}\nabla_w L \tag{26} \]
Denklem 24 reconstruction loss'u, Denklem 25–26 gradient tabanlı weight update zincirini gösterir. \(\eta\) learning rate'tir.
\[ m_t=\beta_1m_{t-1}+(1-\beta_1)\nabla_t \tag{27} \]
\[ v_t=\beta_2v_{t-1}+(1-\beta_2)\nabla_t^2 \tag{28} \]
Denklem 27–28 Adam optimizer'ın birinci ve ikinci moment tahminlerini temsil eder. Kaynak bu denklemleri verir ancak PDF içinde kullanılan sayısal \(\beta_1\), \(\beta_2\) ve learning-rate değerlerini açık bir hiperparametre tablosuyla sunmaz.
Denklem 29–35: Logging, fault vector ve recovery trigger
\[ Log(t)=\sum_{i=1}^{k}x_{t,i}\delta_i \tag{29} \]
\[ \delta_i=\mathbf{1}\{A_t>\theta_A\} \tag{30} \]
\[ F_t=\{x_t\mid A_t>\theta_A\} \tag{31} \]
\[ ID= \sum_{i=1}^{k} hash(x_{t,i},t+i) \tag{32} \]
\[ S_t= \frac{A_t} {\sum_{i=1}^{T}A_i} \tag{33} \]
\[ R_t=\mathbf{1}\{S_t>\tau\}, \qquad Log(t)=\{x_t,A_t,S_t,R_t\} \tag{34} \]
\[ U_t=\sum_{j=1}^{M}\omega_j\psi_j(t) \tag{35} \]
Denklem 29–35 anomaly'nin loglanması, threshold'u aşan feature vector'lerin fault vector'a alınması, severity score hesaplanması ve recovery trigger üretilmesi için kullanılan kaynak zinciridir. \(\theta_A\) anomaly threshold, \(\tau\) recovery decision threshold ve \(\omega_j\) ağırlık katsayılarıdır.
Bağlamsal Güven Puanı Nasıl Hesaplanıyor?
Context-aware trust scoring modülü, anomaly detector'dan gelen fault vector'ü her düğümün response reliability, authentication success, fault history ve inactivity bilgileriyle birleştirerek trust değerini sürekli günceller; değerler normalize edilir, global ortalamadan sapmalar hesaplanır ve düğümler trusted, suspicious veya untrusted olarak sınıflandırılır.
Kaynakta görünmeyen trust-update denklemi
Section 3.3, trust score'un previous trust, response reliability ve fault history için tunable weight'ler içeren time-decaying bir denklemle güncellendiğini söyler. Ancak yayımlanmış PDF görüntüsünde “the score is updated as:” cümlesinden sonra bu denklem görünmemektedir. Bu nedenle Verianla kayıp denklemi genel bir trust-score formülüyle tamamlamamaktadır.
Denklem 36–45: Fault vector ve davranış sinyalleri
\[ F_t=\{x_t\mid A_t>\theta_A\} \tag{36} \]
\[ N_f= \sum_{i=1}^{N} \mathbf{1}\{A_i(t)>\theta_A\}\,n_i \tag{37} \]
\[ T_i(0)= \frac{1}{K} \sum_{k=1}^{K}T^{init}_{i,k} \tag{38} \]
\[ R_i(0)= \sum_{j=1}^{M}\rho^{(0)}_{i,j} \tag{39} \]
\[ F_i(0)= \sum_{j=1}^{M}\phi^{(0)}_{i,j} \tag{40} \]
\[ \Delta S_i(t)= \sum_{j=1}^{T} \left( \gamma_1R_i(j)+ \gamma_2A_i(j)- \gamma_3F_i(j) \right) \tag{41} \]
Denklem 41'de response ve authentication katkıları trust yönünde pozitif, fault geçmişi negatif ağırlıkla davranış skoruna girer. \(\gamma_1,\gamma_2,\gamma_3\) tunable weight'lerdir.
\[ R_i(t+1)= \sum_{j=1}^{t}\delta_{r_i,j} + R_i(0) \tag{42} \]
\[ A_i(t+1)= \sum_{j=1}^{t}\delta_{a_i,j} + A_i(0) \tag{43} \]
\[ F_i(t+1)= \sum_{j=1}^{t}\delta_{f_i,j} + F_i(0) \tag{44} \]
\[ \Delta S_i(t+1)= \sum_{j=1}^{t+1} \left( \gamma_1R_i(j)+ \gamma_2A_i(j)- \gamma_3F_i(j) \right) \tag{45} \]
Bu denklemler response, authentication ve fault olaylarını zaman boyunca biriktirerek rolling behavior score oluşturur.
Denklem 46–57: Trust güncelleme, decay ve node classification
\[ T_i(t+1)= \frac{1}{t+1} \sum_{j=0}^{t} \left( \alpha T_i(j)+ \beta\Delta S_i(j) \right) \tag{46} \]
\[ T_i^{cumulative} = \sum_{j=1}^{t+1}T_i(j) \tag{47} \]
\[ D_i(t)= \sum_{j=1}^{t} T_i(j)e^{-\lambda j} \tag{48} \]
Denklem 48 inactive veya eski trust bilgisini exponential decay ile azaltır. \(\lambda\) decay factor'dür.
\[ T_i^{norm}= \frac{T_i(t)} {\sum_{j=1}^{m}T_j(t)} \tag{49} \]
\[ \bar{T}(t)= \frac{1}{m} \sum_{j=1}^{m}T_j(t) \tag{50} \]
\[ \Delta T_i= |T_i(t)-\bar{T}(t)| \tag{51} \]
Denklem 49–51 her node trust değerini ağ geneline göre normalize eder ve global trust average'dan sapmayı hesaplar.
\[ Trusted_i= \sum_{j=1}^{m} \mathbf{1}\{T_j^{nr}>\tau\}\delta_{ij} \tag{52} \]
\[ Untrusted_i= \sum_{j=1}^{m} \mathbf{1}\{T_j^{nr}<\tau\}\delta_{ij} \tag{53} \]
\[ Suspicious_i= \sum_{j=1}^{m} \mathbf{1}\{\Delta T_j>\epsilon\}\delta_{ij} \tag{54} \]
Kaynak Denklem 49'da \(T^{norm}\), sınıflandırma denklemlerinde ise \(T^{nr}\) biçiminde notation kullanmaktadır. Verianla bu iki gösterimi kaynakta kesin olarak aynı sembole dönüştürmemektedir; bağlam her ikisinin normalize trust değerini temsil ettiğini düşündürse de kaynak notation'ı tamamen tutarlı değildir.
\[ T_{goa}(t)= \sum_{i=1}^{m} T_i(t)\delta_i^{(active)} \tag{55} \]
\[ S_{flagged}= \sum_{i=1}^{m} \mathbf{1}\{T_i^{nr}<\tau\}n_i \tag{56} \]
\[ TrustedList_t= \sum_{i=1}^{m} \mathbf{1}\{T_i^{nr}>\tau\}n_i \tag{57} \]
Bu son adım recovery modülüne yalnız threshold'u geçen doğrulanmış düğümlerin aktarılmasını amaçlar.
Otonom Kurtarma ve Reinforcement Learning Bu Mimaride Ne Yapıyor?
Otonom recovery modülü, trust modülünün doğruladığı düğümler arasından kaynak ve görev uyumluluğu yüksek olanları seçer; trafik yeniden yönlendirme, düğüm izolasyonu, rol yeniden atama, load redistribution, policy update ve service redeployment gibi işlemleri uygular ve sonuç başarısızsa reinforcement learning geri beslemesiyle recovery politikasını yeniden ayarlar.
RL agent'in state, action ve reward yapısı
State, mevcut fault context ve network topology bilgisini içerir. Action, dynamic role assignment ve containment/reconfiguration işlemleridir. Reward, downtime reduction, trust preservation ve policy compliance gibi sonuçları birleştiren composite değerlendirmedir.
Denklem 58–66: Güvenilir node seçimi ve compatibility
\[ T^{*}= \left\{ n_i\mid T_i^{*}= \frac{T_i}{\max(T)} > \tau_{trust} \right\} \tag{58} \]
\[ M^{trust}= \sum_{i\in T^{*}} T_i^{*}\omega_i \tag{59} \]
\[ R_i= \sum_{j=1}^{m} \kappa_{ij}\theta_j \tag{60} \]
\[ R_i^{nr}= \frac{R_i}{\max(R)} \tag{61} \]
\[ S_i= R_i^{nr} \left( 1+ \frac{1}{T} \sum_{t=1}^{T}\phi_{i,t} \right) \tag{62} \]
Bu zincirde \(R_i\) node recovery capability/role fitness türü bir puanı, \(\phi_{i,t}\) ise recent cooperative veya participative metric'i temsil eder.
\[ \Delta_i= \sqrt{ \sum_{j=1}^{m} (d_j-\kappa_{ij})^2 } \tag{63} \]
\[ \Gamma_i= \frac{S_i}{1+\Delta_i} \tag{64} \]
\[ R_{sre}=sort_{desc}(\Gamma_i) \tag{65} \]
\[ R_{top}= \{n_i\in R_{sre}\mid i=1,\ldots,k\} \tag{66} \]
Denklem 63–66 node capability ile recovery requirement arasındaki farkı ölçüp compatibility score oluşturur ve en yüksek skorlu \(k\) node'u recovery için seçer.
Denklem 67–73: Rol ağırlığı, topology, load ve recovery effectiveness
\[ Total= \sum_{j=1}^{k} \left(T'_j+R_j\right) \tag{67} \]
\[ \alpha'_i= \alpha_i \left( 1+ \frac{s_1+s_2+\cdots+s_T}{T} \right) \tag{68} \]
Kaynak \(s_T\)'yi zaman \(t\)'deki system strain/load bağlamında tanımlar.
\[ P_{ij}= \sum_{l\in Path(i,j)} \left( \frac{b_l}{1+\lambda_l} \right) T_l \tag{69} \]
Denklem 69 communication path'i bandwidth, latency ve trust ilişkisi üzerinden yeniden ağırlıklandırır.
\[ L_i= \alpha'_iL_{total} \tag{70} \]
\[ Policy_{new}= Policy_{old}+ \sum_{i=1}^{k}\alpha'_i \tag{71} \]
\[ \psi_t= \sum_{i=1}^{k} \left( \lambda_i^{(t)}- \delta_i^{(t)} \right)\omega_i \tag{72} \]
\[ E_{rec}= \frac{\psi_t} {\psi_t+ \sum_{i=1}^{k}\delta_i^{(t)}} \tag{73} \]
Denklem 72–73 recovery sonrası improvement ve recovery effectiveness oranını tanımlar. Kaynak farklı bölümlerde \(\lambda\) sembolünü farklı anlamlarda kullanabildiği için sembol adlarının bağlama göre okunması gerekir.
Denklem 74–77: Q-learning, policy refinement ve stabilizasyon
\[ Q(s,a)= Q(s,a)+ \alpha \left[ r+ \gamma \max_{a'} Q(s',a') - Q(s,a) \right] \tag{74} \]
Denklem 74 standart temporal-difference Q-learning update mantığını recovery policy tuning'e uygular. \(\alpha\) learning rate, \(\gamma\) gelecekteki reward'un discount factor'üdür.
\[ \theta_{t+1}= \theta_t- \eta\nabla_{\theta}L(\theta_t) \tag{75} \]
\[ Stable \Longleftrightarrow \frac{1}{T} \sum_{t=1}^{T} |\delta_t| < \epsilon \tag{76} \]
\[ N_{sal}= \{n_i\mid L_i<\delta_{max} \land E_{rec}>\tau \} \tag{77} \]
Denklem 75 strategy parameter update'ı, Denklem 76 stability criterion'ı, Denklem 77 ise yük ve recovery effectiveness koşullarını sağlayan final resilient node set'ini ifade eder. Kaynağın notation listesinde final set için farklı bir “\(N_{resilient}\)” adlandırması da bulunur; Verianla bu notation farkını sessizce düzeltmemektedir.
Teorik hesaplama karmaşıklığı
| Bileşen | Kaynak karmaşıklığı | Bilimsel rol |
|---|---|---|
| PCA / SVD | O(n log n) | Yüksek boyutlu telemetry için dimensionality reduction |
| Shallow Autoencoder | O(n · d) | Compact representation ve reconstruction-error anomaly detection |
| Autoencoder training açıklaması | O(n · d · e) | n örnek, d feature, e epoch içeren eğitim maliyeti |
| LSTM | O(T · H²) | Temporal dependency modelleme |
| Attention | O(T² · d) | Zaman adımları arasındaki attention ilişkileri |
| GNN | O(E · d²) | Trust propagation / topology-aware değerlendirme |
| Energy-Based Model | O(n · d²) | Energy-function anomaly scoring |
| Mahalanobis distance | O(d²) | Covariance-aware anomaly deviation |
| Dynamic thresholding | O(n) | Quantile veya statistical adaptive threshold |
| RL / Policy Gradient | O(n · A · T) | Recovery-policy optimization |
| Trust score computation | O(n) | Düğüm trust değerlerini güncelleme |
| Trust-aware graph traversal | O(V + E) | Ağ düğüm ve bağlantılarında traversal |
| Kafka / Flink streaming ingestion | O(m) / record | m concurrent stream altında akış telemetrisi |
Bu karmaşıklıklar kaynak yazarlarının teorik değerlendirmesidir. Gerçek runtime yalnız Big-O notasyonundan belirlenemez; donanım, implementation, batch size, feature dimension, sequence length ve concurrency gibi koşullara bağlıdır.
Çalışmanın Yöntemi ve Bulguları
Veri setleri ve değerlendirme kapsamı
Çalışma CICIDS/CIC-IDS-2017 ve NSL-KDD benchmark veri setlerini intrusion-detection telemetry örnekleri olarak kullanmaktadır. Yazarlar bu veri setlerinin micro-segmentation, continuous authentication veya dynamic policy enforcement dahil tam bir production Zero-Trust mimarisini temsil etmediğini açıkça kabul etmektedir.
Bu nedenle veri setlerinden çıkarılan sonuçlar ZTNA'nın bütün operasyonel davranışının doğrulanması değildir. Veri setleri abnormal behavior, unauthorized access ve distributed attack gibi güvenlik durumlarını modellemek için kullanılmış; trust scoring ve recovery bileşenleri bunların üzerine eklenmiştir.
Reproducibility açısından eksik kalan ayrıntılar
Kaynak, revize edilmiş makalenin learning rate, optimizer, batch size, epoch sayısı, hidden-layer size ve dynamic threshold gibi ayrıntıları içerdiğini belirtmektedir. Ancak yayımlanmış PDF'de bunların sayısal değerlerini bir arada veren açık hiperparametre tablosu görünmemektedir. Benzer şekilde training/validation/test split'lerin ayrıntılı biçimde açıklandığı söylenmekle birlikte PDF metninde kesin split yüzdeleri açık şekilde bulunmamaktadır.
Verianla bu nedenle learning rate, batch size, epoch veya split oranı uydurmamaktadır.
Çok sınıflı confusion matrix
| Gerçek sınıf \ Tahmin | DDoS | Unauthorized Access | Data Exfiltration |
|---|---|---|---|
| DDoS | 34 | 31 | 30 |
| Unauthorized Access | 41 | 30 | 24 |
| Data Exfiltration | 48 | 26 | 21 |
Bu matris attack-type separation'ın zor olduğunu göstermektedir. DDoS olaylarının 34'ü doğru sınıflandırılırken 61'i diğer iki sınıfa gitmiştir. Unauthorized Access için 30 doğru; Data Exfiltration için yalnız 21 doğru sınıflandırma vardır.
Yazarlar özellikle Data Exfiltration ile DDoS arasındaki davranışsal overlap'in sınıf sınırlarını belirsizleştirdiğini belirtmektedir.
%97 Anomali Tespit Doğruluğu Çok Sınıflı Confusion Matrix ile Aynı Sonuç mudur?
Hayır. Kaynak %97 genel system-level detection accuracy değerinin adaptive threshold, contextual trust scoring, temporal attention ve RL-based recovery optimization içeren bütünleşik sistemin aggregate anomaly-detection/recovery değerlendirmesinden geldiğini; Figure 14'teki çok sınıflı confusion matrix'in ise attack-type separation'a yönelik daha sınırlı ve erken aşama bir değerlendirme olduğunu açıkça ayırmaktadır.
Bu ayrım kritiktir. Figure 14'ün çok sayıda off-diagonal hatasını görmezden gelip “model DDoS, Unauthorized Access ve Data Exfiltration'ı %97 doğrulukla birbirinden ayırıyor” demek kaynakla uyumlu değildir.
Attack-specific Mean Time to Detect
Kaynak metni klasik/baseline sistemler için üç saldırı sınıfında 2,3 s, 2,7 s ve 2,9 s düzeylerinde detection time; önerilen yöntem için Unauthorized Access 1,9 s, Data Exfiltration 2,0 s ve DDoS 1,6 s değerlerini raporlamaktadır.
Sonuç bölümünde özellikle DDoS için MTTD = 1,6 s tekrar edilmektedir.
Attack-specific F1 sonuçları
Önerilen model için kaynak DDoS F1 = 0,965, Unauthorized Access F1 = 0,945 ve Data Exfiltration F1 = 0,920 değerlerini raporlamaktadır.
DDoS karşılaştırmasında Deep SVDD 0,872 ve TranAD 0,928 olarak verilir. Unauthorized Access karşılaştırmasında kaynak USAD/DAGMM için yaklaşık 0,892–0,878 aralığı ifade eder. Data Exfiltration için USAD 0,865 değeri açıkça belirtilmektedir.
Genel precision, recall ve F1 karşılaştırması
| Model | Precision | Recall | F1 |
|---|---|---|---|
| Rule-Based | 0,842 | 0,810 | 0,825 |
| LSTM-Only | 0,912 | 0,897 | 0,904 |
| Autoencoder-LSTM | Kaynak metni yaklaşık 0,944 çevresinde performans bildirir | Kaynak metni yaklaşık 0,944 çevresinde performans bildirir | Kaynak metni yaklaşık 0,944 çevresinde performans bildirir |
| Proposed Method | 0,962 | 0,955 | 0,958 |
ROC/AUC karşılaştırması
Kaynak Figure 13 anlatımında classical detection yöntemlerinin DDoS, Unauthorized Access ve Data Exfiltration için AUC değerlerini 0,51'in altında, yani random discrimination'a yakın olarak tanımlar.
Kaynak metninde gelişmiş anomaly-detection modelleri için şu AUC değerleri verilmektedir: Deep SVDD = 0,740; DAGMM = 0,780; USAD = 0,760; TranAD = 0,810.
Accuracy, specificity ve sensitivity
Kaynak Figure 22 açıklamasında önerilen yöntem için Accuracy = 0,960, Specificity = 0,958 ve Sensitivity = 0,959 raporlamaktadır.
Accuracy bütün tahminlerin doğruluğunu; specificity normal/non-anomalous örnekleri doğru biçimde reddetme yeteneğini; sensitivity ise gerçek anomaly örneklerini yakalama oranını ifade eder.
False-positive rate ve recovery latency ablasyonu
| Konfigürasyon | False Positive Rate | Recovery Latency (s) |
|---|---|---|
| Full model | 0,032 | 2,3 |
| No trust module | 0,071 | 2,3 |
| No RL policy | 0,046 | 4,1 |
| No feature fusion | 0,065 | 3,2 |
| Only Autoencoder | 0,058 | 3,5 |
Trust modülü çıkarıldığında false-positive rate 0,032'den 0,071'e çıkmaktadır. RL policy kaldırıldığında recovery latency 2,3 s'den 4,1 s'ye yükselmektedir. Bu ablasyonlar iki modülün farklı işlevlere katkı verdiğini göstermektedir: trust scoring özellikle yanlış alarm kontrolüyle, RL ise recovery hızıyla ilişkilendirilmektedir.
Genişletilmiş component-wise ablasyon
| Konfigürasyon | FPR | Recovery Latency (s) | Precision | Recall |
|---|---|---|---|---|
| Full model | 0,032 | 2,300 | 0,946 | 0,943 |
| No trust module | 0,071 | 2,300 | 0,901 | 0,871 |
| No RL policy | 0,046 | 4,100 | 0,917 | 0,896 |
| No fault vector filtering | 0,059 | 3,800 | 0,910 | 0,882 |
| No behavior scoring | 0,064 | 3,500 | 0,905 | 0,879 |
| Only Autoencoder | 0,057 | 3,700 | 0,912 | 0,890 |
| No feature fusion | 0,065 | 3,200 | 0,906 | 0,884 |
CICIDS üzerindeki yöntem karşılaştırması
| Model | Accuracy | Precision | Recall | F1 | Training Time (min) | Memory (MB) |
|---|---|---|---|---|---|---|
| Proposed Autoencoder-LSTM | 0,961 | 0,950 | 0,939 | 0,944 | 18 | 420 |
| CNN-GRU | 0,942 | 0,932 | 0,922 | 0,927 | 22 | 460 |
| BiLSTM-Attn | 0,933 | 0,921 | 0,916 | 0,918 | 20 | 440 |
| GCN-LSTM | 0,926 | 0,914 | 0,908 | 0,911 | 25 | 470 |
| SAE-SVM | 0,912 | 0,900 | 0,888 | 0,893 | 15 | 350 |
| Random Forest | 0,892 | 0,878 | 0,865 | 0,871 | 14 | 300 |
| Isolation Forest | 0,861 | 0,851 | 0,840 | 0,845 | 12 | 250 |
| Transformer-IDS | 0,939 | 0,928 | 0,914 | 0,920 | 21 | 455 |
| Hybrid-VAE-GRU | 0,953 | 0,940 | 0,928 | 0,934 | 19 | 430 |
| AE-RL | 0,949 | 0,937 | 0,923 | 0,930 | 17 | 415 |
| Rule-Based | 0,845 | 0,838 | 0,812 | 0,825 | 6 | 160 |
Bu tabloda proposed Autoencoder-LSTM accuracy 0,961'dir. Buna karşılık Discussion 5.1 metni aynı CICIDS değerlendirmesinde accuracy 0,950 ve precision 0,951 değerlerini yazar. Verianla tabloyu sessizce metne göre değiştirmemekte; kaynak içindeki iki farklı raporu ayrı tutmaktadır.
Hybrid mimari ablasyonu
| Model varyantı | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|
| Full model — AE + LSTM + RL + Trust | 0,975 | 0,971 | 0,978 | 0,974 | 0,982 |
| Without trust module | 0,942 | 0,935 | 0,944 | 0,939 | 0,961 |
| Without RL policy | 0,951 | 0,942 | 0,955 | 0,948 | 0,968 |
| Without feature fusion | 0,948 | 0,938 | 0,952 | 0,945 | 0,965 |
| Only Autoencoder | 0,931 | 0,922 | 0,937 | 0,929 | 0,951 |
| AE + RL — No LSTM | 0,945 | 0,938 | 0,951 | 0,944 | 0,962 |
| AE + LSTM — No RL | 0,957 | 0,948 | 0,961 | 0,954 | 0,971 |
| AE + Transformer | 0,960 | 0,953 | 0,964 | 0,958 | 0,975 |
Full model bütün Table 6 metriklerinde en yüksek değeri verir. Trust modülü çıkarıldığında F1 0,939'a, RL çıkarıldığında 0,948'e düşmektedir.
Discussion 5.3'te “removal of the trust module resulted in a F1 score of 3.6” ifadesi yer alır. F1-score'un bu çalışmada 0–1 aralığında raporlanması ve Table 6'nın 0,939 göstermesi nedeniyle bu metin Table 6 ile uyuşmamaktadır. Verianla 3,6 değerini bilimsel sonuç olarak kullanmamaktadır.
Fault-detection performans karşılaştırması
| Yöntem | Detection Accuracy (%) | False Positive Rate (%) | Detection Latency (ms) | Scalability (%) | Model Complexity (1–10) | Resource Usage (MB) |
|---|---|---|---|---|---|---|
| Deep neural network-based anomaly detection | 95 | 3,5 | 54 | 88 | 7 | 200 |
| RL for policy-based recovery | 93 | 4,2 | 67 | 85 | 8 | 185 |
| Federated learning-based distributed fault analytics | 92 | 3,8 | 60 | 92 | 6 | 165 |
| GNN for topological fault mapping | 94 | 4,0 | 64 | 89 | 8 | 195 |
| LSTM-based log sequence anomaly detection | 94 | 3,6 | 55 | 87 | 7 | 170 |
| Proposed method | 97 | 2,4 | 48 | 95 | 6 | 160 |
Table 7'nin proposed-method satırı %97 detection accuracy, %2,4 false-positive rate, 48 ms detection latency, %95 scalability score ve 160 MB resource usage raporlamaktadır.
Recovery ve adaptivity karşılaştırması
| Yöntem | Recovery Time (ms) | Success Rate (%) | Self-Adaptivity (%) | Downtime Reduction (%) | Policy Compliance (%) | Learning Efficiency (1–10) |
|---|---|---|---|---|---|---|
| Deep neural network-based anomaly detection | 130 | 91 | 87 | 84 | 90 | 7 |
| RL policy-based recovery | 98 | 94 | 90 | 89 | 93 | 9 |
| Federated learning distributed fault analytics | 105 | 90 | 86 | 86 | 89 | 8 |
| GNN topological fault mapping | 110 | 91 | 88 | 85 | 92 | 8 |
| LSTM log-sequence anomaly detection | 120 | 92 | 89 | 87 | 91 | 8 |
| Proposed method | 90 | 96 | 93 | 93 | 96 | 10 |
Table 8 proposed method için 90 ms recovery time ve %96 success rate verir. Ancak Figure 20/Conclusion farklı bir karşılaştırmada 1,8 s MTTR ve 0,99 recovery success raporlar. Kaynak bu iki recovery ölçümünün deneysel protokollerini tek bir açıklayıcı tabloda eşleştirmediği için Verianla bunları aynı değer ailesi olarak birleştirmemektedir.
MTTR karşılaştırması
Kaynak Figure 20 anlatımında proposed method için MTTR = 1,8 s ve recovery success = 0,99; Autoencoder-LSTM için MTTR = 2,3 s ve success yaklaşık 0,97; Rule-Based yöntem için MTTR = 5,1 s ve success yaklaşık 0,82 raporlanmaktadır.
Bu değerler Table 8'deki “Recovery Time (ms)” sütunuyla aynı metrik adı altında verilmediği için aralarında doğrudan birim dönüşümü yapılarak eşitleme yapılmamıştır.
Memory-consumption simülasyonu
Kaynak 1.000-node ve 10.000-node senaryolarında 5 fault ve 20 fault yüklerini karşılaştırmaktadır. Proposed method için raporlanan memory footprint sırasıyla yaklaşık 160 MB, 200 MB, 780 MB ve 910 MB'dır.
Geleneksel sistemin en küçük senaryoda 180 MB, en büyük 10.000-node/20-fault senaryosunda 1040 MB kullandığı açıkça belirtilmiştir. Dolayısıyla en büyük senaryoda proposed method'un kaynakta verilen 910 MB değeri bir “910 MB tasarruf” değil, toplam memory usage'dır.
F1 dağılımı ve belirsizlik
Kaynak Figure 17'de attack-specific F1 barları için ±1 standard deviation (\(\pm1\sigma\)) error bar kullanıldığını belirtmektedir. Figure 19 ise farklı modellerin F1-score dağılımlarını boxplot biçiminde karşılaştırır ve proposed method için yüksek median ile görece dar dağılım raporlar.
Kaynak bu bölümde formal p-value, confidence interval veya named hypothesis test raporlamamaktadır. Bu nedenle “istatistiksel olarak anlamlı” ifadesi için kaynak dışı p-değeri üretilmemiştir.
Çalışmanın desteklediği sonuçlar
- Benchmark ve simülasyon değerlendirmesinde önerilen bütünleşik sistem %97 system-level anomaly-detection accuracy raporlamıştır.
- Kaynak %96 autonomous-recovery success ve %93 downtime reduction raporlamaktadır.
- DDoS için proposed method F1-score 0,965 ve MTTD 1,6 s olarak raporlanmıştır.
- Genel proposed-method precision 0,962, recall 0,955 ve F1 0,958 değerleri ayrı model karşılaştırmasında raporlanmıştır.
- Table 6 full hybrid model için accuracy 0,975, F1 0,974 ve AUC 0,982 vermektedir.
- Trust module'ünün çıkarılması false-positive rate ve detection kalitesini olumsuz etkilemiştir.
- RL policy'nin kaldırılması recovery latency'yi artırmıştır.
- 10.000-node simülasyonlarında proposed method için 780–910 MB düzeyinde bellek kullanımı raporlanmıştır.
- Kafka ve Flink, gerçek zamanlı deployment iddiasının ölçülmüş sonucu olarak değil, düşük gecikmeli streaming architecture bileşeni olarak mimariye dahil edilmiştir.
Çalışmanın desteklemediği sonuçlar
- %97 accuracy gerçek bir enterprise Zero-Trust ağındaki saha başarısı değildir.
- Figure 14, üç attack class'ın %97 doğrulukla birbirinden ayrıldığını göstermemektedir.
- Federated-learning modülünün büyük ölçekli edge deployment performansı bu çalışmada doğrulanmamıştır.
- 90 ms recovery time, 1,8 s MTTR ve 2,3 s recovery latency tek ve aynı metrik olarak yorumlanamaz.
- 910 MB değeri 910 MB bellek tasarrufu anlamına gelmez; büyük simülasyon senaryosundaki reported proposed-method usage değeridir.
- Source PDF'de numeric learning rate, batch size, epoch count ve exact data split oranları açıkça bulunmadığı için reproducibility'nin bütün parametreleri mevcut değildir.
- Kaynakta görünmeyen Mahalanobis veya Section 3.3 trust-update denklemleri Verianla tarafından tamamlanmış değildir.
- Benchmark sonuçları başka network topolojileri, gerçek kullanıcı trafiği, farklı concept drift koşulları veya uzun dönem saldırı adaptasyonu için otomatik garanti oluşturmaz.
Kaynak içindeki raporlama farklılıkları
| Konu | Kaynak konumu A | Kaynak konumu B | Verianla yaklaşımı |
|---|---|---|---|
| CICIDS accuracy | Table 5: 0,961 | Discussion 5.1: 0,950 | İki rapor ayrı korunur; tek değere zorla birleştirilmez. |
| Trust-module F1 | Table 6: 0,939 | Discussion 5.3: “3.6” | Table 6 değeri aktarılır; 3,6 ifadesi kaynak-içi uyumsuzluk olarak işaretlenir. |
| Recovery | Table 3–4: 2,3 s recovery latency | Figure 20/Conclusion: 1,8 s MTTR | Metrik isimleri farklı olduğu için eşitlenmez. |
| Recovery | Table 8: 90 ms recovery time, %96 success | Figure 20: 1,8 s MTTR, 0,99 success | Farklı deney/ölçüm bağlamları olarak korunur. |
| Memory | Abstract: “910 MB memory usage optimization” | Figure 21 text: 910 MB proposed usage, 1040 MB traditional usage | 910 MB “tasarruf” olarak yorumlanmaz. |
| Trust notation | Denklem 49: T norm | Denklem 52–57: T nr | Notation sessizce standardize edilmez. |
Gelecek çalışma yönleri
Kaynak gelecekte enterprise-scale real-time Zero-Trust deployment, asynchronous federated optimization, decentralized adaptive policy learning, graph-aware trust propagation, lightweight edge-compatible architecture ve live software-defined Zero-Trust telemetry üzerinde doğrulama önermektedir.
Bu gelecek çalışma alanları mevcut makalenin başarılmış sonucu değildir. Özellikle federated learning, kaynakta architecture-level entegrasyon olarak sunulmasına rağmen büyük ölçekli dağıtık edge deneylerinin daha sonra yapılacağı belirtilmiştir.
Kaynak ve Yöntem Notu
Özgün başlık: Artificial Intelligence driven fault detection and autonomous recovery in zero trust network architectures
Yazarlar ve sıra: Sami Morsi; Rajit Nair; Hasan Alkahtani; Sultan Ahmad; Theyazn H. H. Aldhyani; Hikmat A. M. Abdeljaber.
Corresponding author: Sultan Ahmad.
Corresponding e-posta: s.alisher@psau.edu.sa
Afiliasyon 1: Applied College, King Faisal University, 31982 Al-Ahsa, Saudi Arabia.
Afiliasyon 2: VIT Bhopal University, Bhopal, India.
Afiliasyon 3: College of Computer Science and Information Technology, King Faisal University, P.O. Box 400, 31982 Al-Ahsa, Saudi Arabia.
Afiliasyon 4: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam Bin Abdulaziz University, 11942 Alkharj, Saudi Arabia.
Afiliasyon 5: Department of Computer Science and Engineering, University Center for Research and Development (UCRD), Chandigarh University, Gharuan, Mohali, Punjab 140413, India.
Afiliasyon 6: Department of Extended-Reality and Games Development, Faculty of Information Technology, Applied Science Private University, 11831 Amman, Jordan.
Yazar-afiliiasyon eşleşmesi: Sami Morsi — 1; Rajit Nair — 2; Hasan Alkahtani — 3; Sultan Ahmad — 4 ve 5; Theyazn H. H. Aldhyani — 1; Hikmat A. M. Abdeljaber — 6.
Eşit katkı: Kaynak ayrı bir equal-contribution veya equal-first-authorship beyanı vermemektedir.
Dergi: Discover Artificial Intelligence.
Yayınevi/platform: Springer Nature / Springer.
Cilt: Volume 6.
Makale numarası: 871.
Yayın yılı: 2026.
Makale türü: Research.
DOI: 10.1007/s44163-026-01654-w.
Resmî bağlantı: https://doi.org/10.1007/s44163-026-01654-w
Received: 26 Şubat 2026.
Accepted: 15 Haziran 2026.
Published: Springer'ın resmî makale kaydına göre 7 Temmuz 2026.
Version of record: Springer'ın resmî kaydında 21 Ağustos 2026.
Hakemlik notu: Kaynak yayımlanmış bir Springer Research makalesidir ve Received/Accepted tarihleri raporlanmaktadır. Kaynak PDF, uygulanan hakemlik modelinin single-blind/double-blind gibi ayrıntısını belirtmemektedir.
Lisans: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Lisansın görsel etkisi: Lisans adapted material paylaşımına izin vermediği için Verianla HTML'i kaynak figürleri değiştirilmiş/uyarlanmış biçimde yeniden üretmemektedir. Makale içi SVG'ler yalnız metinde açıkça tanımlanmış bilimsel gerçeklerden bağımsız kompozisyonla oluşturulmuştur.
Temel alan: Zero-Trust Network Architecture, anomaly detection, autonomous recovery, deep learning, reinforcement learning ve trust scoring.
Ana model: Autoencoder-LSTM-RL-Trust tabanlı bütünleşik framework.
Streaming bileşenleri: Apache Kafka ve Apache Flink.
Anomaly bileşenleri: Autoencoder, LSTM, attention, ensemble shallow autoencoders, dynamic thresholding, Mahalanobis-distance bağlamı ve Energy-Based Model yaklaşımı.
Trust bileşenleri: Response reliability, authentication strength/frequency, fault history, decay, normalization, deviation ve trusted/suspicious/untrusted node classification.
Recovery bileşenleri: Trust-ranked node selection, compatibility scoring, traffic rerouting, node isolation, role reassignment, load redistribution, policy update, service redeployment ve reinforcement-learning feedback.
Federated learning statüsü: Framework mimarisine privacy-preserving distributed adaptation için dahil edilmiştir; kaynak büyük ölçekli federated edge deployment deneylerinin gelecekte yapılacağını belirtmektedir.
Ana veri setleri: CIC-IDS-2017/CICIDS ve NSL-KDD.
Veri erişilebilirliği: Kaynak dataset'lerin public repository üzerinden erişilebilir olduğunu belirtmektedir ve CIC-IDS-2017 ile NSL-KDD için Kaggle bağlantıları vermektedir.
Attack classes: DDoS, Unauthorized Access ve Data Exfiltration.
Genel system-level result: %97 anomaly detection accuracy; %96 autonomous recovery success; %93 downtime reduction.
DDoS sonucu: F1-score 0,965; sonuç bölümünde MTTD 1,6 s.
MTTR: Figure 20/Conclusion bağlamında 1,8 s.
Table 7 proposed result: %97 detection accuracy; %2,4 FPR; 48 ms detection latency; %95 scalability; complexity 6/10; 160 MB resource usage.
Table 8 proposed result: 90 ms recovery time; %96 success; %93 self-adaptivity; %93 downtime reduction; %96 policy compliance; 10/10 learning efficiency.
Memory simulation: Proposed method için 1.000N-5F, 1.000N-20F, 10.000N-5F ve 10.000N-20F senaryolarında sırasıyla 160 MB, 200 MB, 780 MB ve 910 MB kullanım raporlanmıştır.
Confusion-matrix sınırı: Çok-sınıflı attack-type confusion matrix genel %97 system-level detection accuracy'nin kendisi değildir.
Hyperparameter reproducibility sınırı: Kaynak hyperparameter ayrıntılarının dahil edildiğini söylese de yayımlanmış PDF'de learning rate, batch size, epoch, hidden-layer size ve split oranlarını eksiksiz sayısal tablo halinde vermemektedir.
Formül sunum problemi: PDF Section 3.2'de Mahalanobis anomaly-score formülünün, Section 3.3'te ise time-decaying trust-update formülünün bulunması beklenen yerde denklem görünmemektedir. Bu eksik öğeler Verianla tarafından tahmin edilerek tamamlanmamıştır.
Kaynak-içi CICIDS farkı: Table 5 proposed accuracy 0,961; Discussion 5.1 accuracy 0,950.
Kaynak-içi trust-ablasyon farkı: Table 6 without-trust F1 = 0,939; Discussion 5.3 “F1 score of 3.6” yazmaktadır.
Kaynak-içi recovery metrik farkı: Table 3–4 recovery latency 2,3 s; Figure 20/Conclusion MTTR 1,8 s; Table 8 recovery time 90 ms. Kaynak bunların aynı ölçüm protokolü olduğunu göstermemektedir.
Finansman: Deanship of Scientific Research, Vice Presidency for Graduate Studies and Scientific Research, King Faisal University, Saudi Arabia; Grant No. KFU262842.
Etik: Ethics approval and consent to participate — Not Applicable.
Consent for publication: Not Applicable.
Çıkar çatışması: Yazarlar competing interests olmadığını beyan etmektedir.
Yazar katkıları: Sultan Ahmad, Sami Morsi, Rajit Nair ve Hasan Alkahtani literatür incelemesi ve methodology; Theyazn H. H. Aldhyani, Sultan Ahmad ve Hikmat A. M. Abdeljaber formal analysis, data collection ve investigation; Hikmat A. M. Abdeljaber, Theyazn H. H. Aldhyani ve Sultan Ahmad initial drafting ve statistical analysis; Sami Morsi, Rajit Nair ve Hasan Alkahtani supervision görevlerini üstlenmiştir. Kaynak ayrıca bütün yazarların sistem ve manuscript development'a katkı verdiğini ve final manuscript'i onayladığını belirtmektedir.
Temel yöntemsel sınır: Mevcut evaluation benchmark ve simulation tabanlıdır; live enterprise-scale Zero-Trust deployment doğrulaması yapılmamıştır.
Gelecek çalışma: Enterprise real-time ZTNA deployment, large-scale federated edge experimentation, federated adaptive optimization, graph-aware trust propagation, lightweight edge architectures ve live software-defined Zero-Trust telemetry validation.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir