


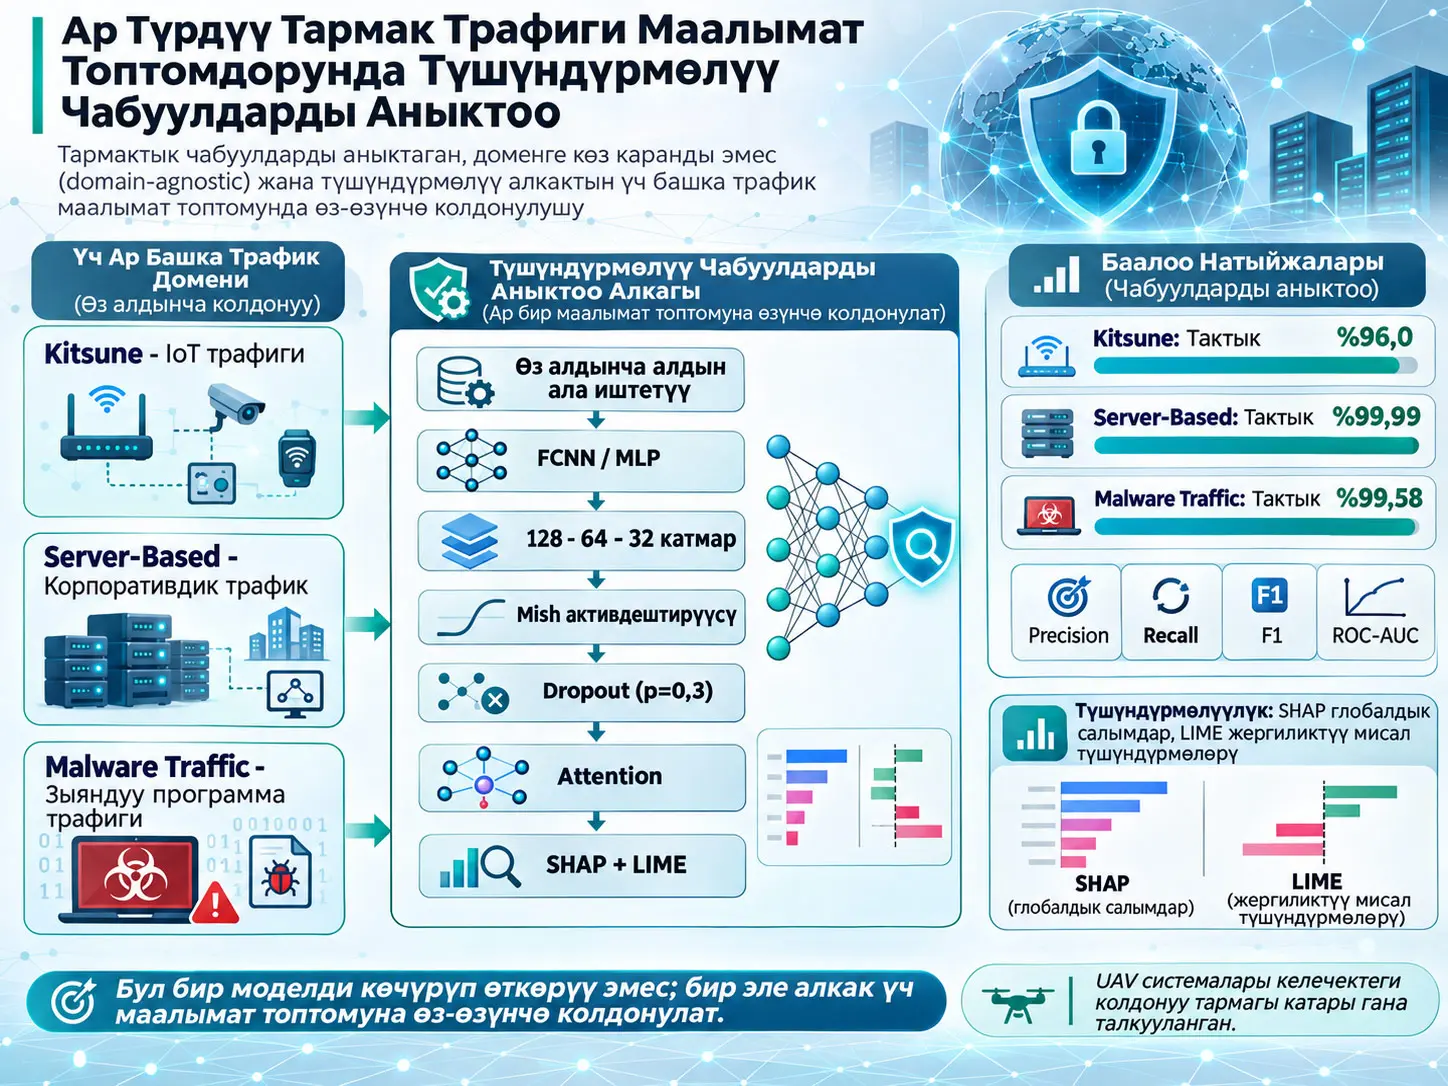
Доменге көз каранды эмес түшүндүрмөлүү тармактык чабуулдарды аныктоо алкагы, бирдей маалымат даярдоо жана Fully Connected Neural Network (FCNN) моделдөө логикасын IoT, корпоративдик сервер жана зыяндуу программа трафиги сыяктуу ар түрдүү тармактык маалымат домендерине өз-өзүнчө колдонгон жана моделдин чечимдерин SHapley Additive exPlanations (SHAP) менен Local Interpretable Model-Agnostic Explanations (LIME) аркылуу түшүндүрүүнү көздөгөн көзөмөлдөнгөн тармактык чабуулдарды классификациялоо ыкмасы. Изилдөөдө Kitsune, Server-Based жана Malware Traffic маалымат топтомдору өз алдынча иштетилген; сандык жана категориялык өзгөчөлүктөр даярдалган; 128, 64 жана 32 нейрондуу толук байланышкан катмарлар, Mish активациясы, dropout жана attention камтыган модель колдонулган. Булак Kitsune үчүн %96,0, Server-Based маалымат топтому үчүн %99,99 жана Malware Traffic үчүн %99,58 accuracy билдирет.
“Domain-agnostic” түшүнүгү бул изилдөөдө бир маалымат топтомунда үйрөтүлгөн модель башка маалымат топтомуна түздөн-түз көчүрүлгөн дегенди билдирбейт. Автор жыйынтык бөлүмүндө cross-dataset transfer learning көрсөтүлбөгөнүн; ошол эле моделдөө pipeline’ы үч башка тармактык чөйрөгө өз алдынча колдонулушу бааланганын ачык айтат. Демек, изилдөө жалпы ыкма архитектурасынын ар башка маалымат домендеринде колдонулушу мүмкүн экенине далил берет, бирок домендер арасында кайра үйрөтпөстөн түз модель трансферин тастыктабайт.
Kitsune жыйынтыгы жалпы accuracy жагынан күчтүү болгону менен класстар боюнча бирдей эмес. Table 3-тө Class 2 үчүн precision 0,72, recall 0,76 жана F1 0,74; Class 4 үчүн precision 0,75, recall 0,69 жана F1 0,72 билдирилген. Server-Based жана Malware Traffic жыйынтыктары кыйла жогорку бөлүнүүнү көрсөтөт. Ошондуктан жогорку жалпы accuracy маанилери бардык чабуул класстары кемчиликсиз кармалды деп чечмеленбеши керек.
SHAP анализи туруктуу 100 validation үлгүсүндө жүргүзүлгөн; LIME болсо ар бир маалымат топтомунда бир гана өкүлчүлүктүү validation үлгүсүнө жана эң көп 10 түшүндүрүүчү өзгөчөлүккө колдонулган. Булак бул түшүндүрмөлүүлүк куралдарын real-time ар бир пакет үчүн иштеген inference компоненти катары эмес, offline forensic analysis жана post-incident investigation үчүн жайгаштырат.
UAV коопсуздугу макаланын чыныгы эксперименттик аймагы эмес. Изилдөөдө UAV telemetry, GPS өзгөрмөлүүлүгү, RF communication pattern же flight log колдонулган эмес. UAV системалары ыкманы келечекте сынап көрүүгө мүмкүн болгон потенциалдуу колдонуу аймагы катары гана талкууланган.
“Domain-Agnostic” Бул Изилдөөдө Эмнени Билдирет?
Бул изилдөөдө “domain-agnostic” бирдей жалпы preprocessing жана FCNN негизиндеги моделдөө pipeline’ынын Kitsune IoT трафигине, Server-Based корпоративдик трафикке жана Malware Traffic маалыматтарына маалымат топтомуна өзгөчө жаңы модель архитектурасын долбоорлобостон өз-өзүнчө колдонулушун билдирет; изилдөө бир үйрөтүлгөн модель ар башка маалымат топтомдорунун арасында көчүрүлгөнүн же жалпы cross-dataset модель үстүндө сыналганын көрсөтпөйт.
Изилдөө маселеси
Изилдөөнүн баштапкы чекити эки маселе. Биринчиси, intrusion detection моделдеринин көбү бир маалымат топтомуна жана белгилүү бир трафик бөлүштүрүлүшүнө ылайык иштелип чыккандыктан, ар башка тармактык чөйрөлөрдө бирдей натыйжалуулукту сактай албай калышы. Экинчиси, жогорку тактык берген терең үйрөнүү системалары эмне үчүн белгилүү бир чабуул чечимине келгенин түшүндүрүүдө кыйналышы.
Бул эки маселе өзгөчө коопсуздук аналитиктери бир гана эскертүү белгисин эмес, чечимге кайсы трафик өзгөчөлүктөрү таасир бергенин да көргүсү келген критикалык системаларда маанилүү. Ошондуктан изилдөө классификация менен post-hoc түшүндүрмөлүүлүктү бир эле баалоо алкагында карайт.
Изилдөөнүн үч маалымат домени
| Маалымат топтому | Тармак домени | Экспериментте колдонулган үлгү | Өзгөчөлүктөрдүн саны | Класстардын саны |
|---|---|---|---|---|
| Kitsune | IoT тармак трафиги | 9.000; баштапкы маалымат 20 миллиондон ашык үлгү камтыйт | 115 | 9: 8 чабуул + 1 benign |
| Server-Based | Корпоративдик/server трафиги | 225.398; маалымат топтомунун баары | 27 | 3 |
| Malware Traffic | Зыяндуу программа байланыш трафиги | 644.602; баштапкы маалымат 25 миллиондон ашык үлгү камтыйт | 23 | 5 |
Kitsune маалымат топтому IoT негизиндеги трафикти жана ARP spoofing, Mirai botnet жана denial-of-service сыяктуу чабуул жүрүм-турумдарын камтыйт. Булак 20 миллиондон ашык баштапкы үлгүдөн 9.000 үлгүлүү өкүлчүлүктүү кичи топтом тандалганын билдирет. Бирок бул 9.000 үлгүнүн так тандоо алгоритмин же ар бир класс боюнча так үлгү алуу жол-жобосун майда-чүйдөсүнө чейин бербейт.
Malware Capture Facility булагындагы маалымат 25 миллиондон ашык жазуудан турат. Изилдөөдө 644.602 жазуу колдонулган. Бул маалымат command-and-control байланыштарын, ransomware активдүүлүгүн жана башка malware-driven network behavior үлгүлөрүн камтыйт.
Server-Based маалымат топтому 225.398 үлгүдөн, 27 өзгөчөлүктөн жана үч класстан турат. Булак бул жерде HTTP flooding, SSH brute-force жана SQL injection сыяктуу server тараптагы чабуул мисалдарын айтат.
Жетишпеген маанилер кантип толтурулат?
Сандык өзгөчөлүктөрдөгү жетишпеген маанилер тиешелүү мамычанын орточо мааниси менен толтурулат. Категориялык өзгөчөлүктөрдө болсо эң көп кездешкен категория, башкача айтканда mode колдонулат. Орточо менен толтуруу сандык өзгөрмөнүн борбордук маанисин сактоого багытталса, mode менен толтуруу категориялык өзгөрмөдөгү эң кеңири таралган классты колдонот.
Бул ыкмалар жетишпеген маанилер маселесин чечет; бирок жетишпеген маалымат механизминин эмнеден пайда болгонун моделдебейт. Булак missingness mechanism үчүн өзүнчө анализ билдирбейт.
“Standard scaling менен [0,1]” дегенди кандай кароо керек?
Булак сандык өзгөчөлүктөр “Standard scaling” аркылуу [0,1] аралыгына көчүрүлгөнүн эки башка жерде айтат. Verianla бул билдирүүнү унчукпай башка scaler аталышына алмаштырбайт. Ошондуктан ишенимдүү жыйынтык бир гана ушул: булак сандык өзгөчөлүктөр масштабдалганын жана жыйынтык аралыгын [0,1] деп сүрөттөйт; колдонулган scaler’дин программалык деңгээлдеги так классын жарыяланган тексттен ишенимдүү кайра аныктоого болбойт.
Категориялык өзгөчөлүктөр кантип коддолот?
Номиналдык жана табигый тартиби жок категориялар үчүн one-hot encoding колдонулат. Бул процесс ар бир категория үчүн өзүнчө binary feature түзүп, мисалы, протокол түрлөрүнүн арасында жасалма чоңдук тартиби пайда болушуна жол бербейт.
Булак binary жана ordinal өзгөчөлүктөр label encoding аркылуу сандык коддорго айландырыларын билдирет.
Класс тең салмаксыздыгы кантип каралат?
Методология бөлүмүндө stratified sampling жана class-weighted loss колдонулганы жазылган. Бирок булак ар бир класс үчүн колдонулган сандык class weight маанилерин же алардын формуласын бербейт.
Denklem 8 стандарттуу multiclass cross-entropy түрүндө берилет жана теңдемеде ачык класс-салмак мүчөсү көрсөтүлбөйт. Ошондуктан class weighting так loss implementation’га кандай колдонулганын булакта берилгенден кеңири божомолдоо туура эмес.
FCNN жана Attention Механизми Кантип Иштейт?
Изилдөөнүн FCNN модели кириш feature vector’ун 128, 64 жана 32 өлчөмдүү жашыруун көрсөтмөлөргө айланткан толук байланышкан катмарлар, Mish активациясы жана dropout менен иштейт; булактын баяны жана теңдемелер боюнча акыркы 32 өлчөмдүү latent representation үстүндө attention салмактары эсептелип, attention-weighted көрсөтмө softmax катмарында көп класстуу чабуул божомолуна айландырылат.
Кириш вектору
Булак кириш векторун:
\[ \mathbf{x}\in\mathbb{R}^{d} \]
түрүндө аныктайт. \(d\) иштетилген feature саны. Макала мисал катары \(d=120\) маанисин берет; бирок үч маалымат топтомунун баштапкы feature сандары ар башка болгондуктан, бул маани бардык топтомдор үчүн туруктуу жана универсалдуу акыркы өлчөм катары чечмеленбеши керек.
Denklem 1–3: Жашыруун көрсөтмөлөр
\[ \mathbf{h}_1=\operatorname{Mish}(W_1\mathbf{x}+b_1), \qquad \mathbf{h}_1\in\mathbb{R}^{128} \tag{1} \]
Denklem 1 кириш өзгөчөлүктөрүн биринчи 128 өлчөмдүү latent representation’га айландырат. \(W_1\) үйрөнүлгөн weight matrix, \(b_1\) bias vector жана \(\mathbf{h}_1\) биринчи жашыруун катмардын чыгышы.
\[ \mathbf{h}_2=\operatorname{Mish}(W_2\mathbf{h}_1+b_2), \qquad \mathbf{h}_2\in\mathbb{R}^{64} \tag{2} \]
Denklem 2 биринчи жашыруун көрсөтмөнү 64 өлчөмгө айландырат.
\[ \mathbf{h}_3=\operatorname{Mish}(W_3\mathbf{h}_2+b_3), \qquad \mathbf{h}_3\in\mathbb{R}^{32} \tag{3} \]
Denklem 3 акыркы жашыруун representation’ды 32 өлчөмгө кыскартат. Mish сызыктуу эмес активация функциясы. Булак Mish’тин аналитикалык функция аныктамасын өзүнчө бербегендиктен, Verianla булактан тыш жаңы теңдеме кошпойт.
Denklem 4: Dropout
\[ \mathbf{h}^{drop}_i= Dropout(\mathbf{h}_i,p=0.3), \qquad i=1,2,3 \tag{4} \]
Dropout training учурунда жашыруун бирдиктердин бир бөлүгүн убактылуу өчүрүп, моделдин айрым latent units’ке ашыкча көз каранды болушун азайтууга багытталат. Бул жердеги \(p=0.3\) — булакта билдирилген dropout rate.
Denklem 5: Attention салмактары
\[ \boldsymbol{\alpha}= softmax(W_a\mathbf{h}_3+b_a) \tag{5} \]
Attention катмары акыркы жашыруун representation ичиндеги latent units үчүн салыштырмалуу салмак чыгарат. Булактын методология бөлүмү бул механизм түздөн-түз баштапкы кириш feature’лары үстүндө эмес, үйрөнүлгөн hidden representation үстүндө иштей турганын ачык айтат.
Бул айырма маанилүү: attention weight менен SHAP feature attribution бир нерсе эмес. Attention моделдин ичиндеги latent representation’га салмак берет; SHAP болсо модель божомолуна кириш өзгөчөлүктөрүнүн салымын post-hoc түрүндө баалоо үчүн колдонулат.
Denklem 6: Attention-weighted көрсөтмө
\[ z= \sum_{j=1}^{32} \alpha_j h_{3j} \tag{6} \]
Denklem 6 булакта ушул түрдө берилген. \(\alpha_j\), \(j\)-attention weight; \(h_{3j}\), акыркы жашыруун катмардын \(j\)-компоненти.
Булактагы белгилөөдө көңүл буруучу notation маселеси бар: Denklem 6-дагы сумма менен \(z\) скаляр чоңдук сыяктуу көрүнөт, ал эми кийинки Denklem 7-де \(w_i^Tz\) түрүндөгү вектордук inner-product жазылышы колдонулат. Булак бул өлчөм байланышын өзүнчө түшүндүрбөйт. Verianla теңдемени өзгөртпөйт жана жетишпеген өлчөм маалыматын божомол менен толтурбайт.
Denklem 7: Softmax класс ыктымалдыгы
\[ \hat{y}_i= \frac{\exp(w_i^{T}z+b_i)} {\sum_{j=1}^{C}\exp(w_j^{T}z+b_j)}, \qquad i=1,2,\ldots,C \tag{7} \]
Denklem 7 ар бир класс үчүн нормалдаштырылган божомол ыктымалдыгын чыгарат. \(C\) тиешелүү маалымат топтомундагы класстардын саны. Softmax бөлгүчү бардык класстардын exponentiated logit маанилерин жыйнап, чыгыштарды жалпы ыктымалдык бөлүштүрүүсүнө айландырат.
Denklem 8: Көп класстуу cross-entropy
\[ L= -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{ic}\log(\hat{y}_{ic}) \tag{8} \]
\(N\) training sample санын, \(C\) класстардын санын, \(y_{ic}\) чыныгы class indicator маанисин жана \(\hat{y}_{ic}\) моделдин тиешелүү класс үчүн божомолдогон ыктымалдыгын билдирет. Loss өлчөмсүз.
Модель чыныгы класска төмөн ыктымалдык бергенде \(-\log(\hat{y}_{ic})\) өсөт жана loss жогорулайт. Окутуу оптимизациясы бул loss’ту азайта турган weight түзүмдөрүн үйрөнүүнү көздөйт.
Архитектура баянындагы булак ичиндеги айырма
Методология баяны 128, 64 жана 32 нейрондуу үч жашыруун катмардын ар биринен кийин dropout бар экенин жана attention механизми акыркы 32 өлчөмдүү representation’га колдонуларын билдирет. Denklem 1–6 да ушул баяндоого шайкеш.
Бирок Algorithm 1 моделдин ыраатын FC-128 → Dropout(0.3) → FC-64 → Dropout(0.3) → Attention → FC-32 → softmax деп берет. Бул ыраатта attention FC-32-ден мурун көрүнөт жана үчүнчү dropout ачык көрсөтүлгөн эмес.
Бул эки сунуш булак ичинде толугу менен бирдей эмес. Ошондуктан Verianla Algorithm 1 сабын же теңдеме чынжырын унчукпай экинчисине ылайык өзгөртпөйт.
Окутуу жөндөөлөрү
| Параметр | Булак мааниси | Түшүндүрмө |
|---|---|---|
| Optimizer | AdamW | Weight жаңыртуулары үчүн колдонулган optimizer. |
| Баштапкы learning rate | 0.001 | Algorithm 1-де берилген баштапкы маани. |
| Learning-rate schedule | Cosine annealing | Булак schedule колдонулганын айтат; майда schedule параметрлери билдирилбейт. |
| Batch size | 128 | Ар бир mini-batch үчүн training sample саны. |
| Максималдуу epoch | 20 | Early stopping эртерээк токтотушу мүмкүн. |
| Dropout | 0.3 | Булактын Denklem 4 жана ыкма түшүндүрмөсүндө билдирилген катыш. |
| Weight initialization | Xavier | Баштапкы weight дисперсиясын тең салмакта кармоо үчүн. |
| Early stopping | Validation loss | Overtraining’ди чектөө максатында. |
| Monitoring | TensorBoard | Training натыйжалуулугун көзөмөлдөө үчүн. |
Training, validation жана test бөлүнүшү так кандай берилген?
Algorithm 1 маалымат топтомдорун %70 training жана %30 test кылып бөлгөнүн жазат жана random_state=42 менен deterministic stratified split маалыматы SHAP түшүндүрмөсүндө көрүнөт.
Ошол эле учурда алгоритмдин кийинки саптарында “validation” метрикалары жана validation loss боюнча early stopping колдонулат; SHAP анализи да “validation samples” үстүндө аныкталат. Булак өзүнчө үчүнчү validation partition көлөмүн ачык бербейт.
Демек, жарыяланган тексттен ишенимдүү алынуучу маалымат 70/30 stratified бөлүнүш жана validation катары колдонулган үлгүлөр бар экени; өзүнчө train-validation-test катыштарын ойлоп табуу туура эмес.
SHAP жана LIME Бул Изилдөөдө Эмнени Түшүндүрөт?
SHAP модель бир нече validation үлгүсүндө feature contribution бөлүштүрүүлөрүн кароо үчүн, LIME болсо бир prediction айланасындагы жергиликтүү feature салымдарын көрсөтүү үчүн колдонулган; булак эки техниканы тең real-time ар пакет үчүн түшүндүрмө эмес, offline forensic analysis жана post-incident investigation куралы катары чектейт.
SHAP колдонулушу
Булак KernelSHAP ыкмасын shap.Explainer аркылуу, туруктуу 100 validation үлгүсүнөн турган background үстүндө жана CPU-side prediction wrapper менен колдонгонун билдирет.
SHAP summary plot’тору бир feature ар башка үлгүлөрдө model output’ка кайсы багытта жана канчалык таасир этерин кароо үчүн колдонулган.
Kitsune SHAP анализинде feature_0, feature_3, feature_1 жана feature_8 сыяктуу бир нече өзгөчөлүк байкаларлык салым көрсөтөт. Булак муну IoT трафигинде чечим бир гана үстөм өзгөрмөгө көз каранды эмес экени менен байланыштырат.
Server-Based маалымат топтомунда SHAP бөлүштүрүүсү тыгызыраак жана аз сандагы өзгөчөлүктөрдүн айланасында топтолгон. Malware маалымат топтомунда болсо feature contribution бөлүштүрүүсү кеңирээк.
LIME колдонулушу
LIME ар бир маалымат топтому үчүн бир гана өкүлчүлүктүү validation үлгүсүнө колдонулган. Булак колдонулган үлгүнү idx=0, түшүндүрүлгөн feature санын болсо num_features=10 деп билдирет.
Kitsune үлгүсүндө ts, service_http жана resp_bytes оң; service_dns жана proto_tcp терс салым көрсөткөн feature мисалдары катары берилет.
Server-Based үлгүсүндө ts, proto жана id.resp_h күчтүү оң салым көрсөтсө, orig_bytes жана resp_bytes терс багыттагы салым мисалдары катары көрсөтүлгөн.
Malware үлгүсүндө feature_85, feature_86 жана feature_107 оң; feature_57 жана feature_39 терс салым мисалдарынын арасында.
Түшүндүрмөлүүлүк жыйынтыктарынын чеги
Булак бир эле trained checkpoint жана бир эле 100 validation үлгүсү колдонулгандыктан SHAP rankings кайталаганда өзгөрбөгөнүн айтат. Бирок изилдөө моделди ар башка random seed менен башынан кайра үйрөтүп, SHAP ranking variance үчүн статистикалык repeated-training experiment билдирбейт.
Ошондуктан “бир checkpoint ичинде түшүндүрмөнү кайра өндүрүү мүмкүнчүлүгү” менен “ар башка окутуу шарттарындагы explanation stability” бир эле жыйынтык эмес.
Architecture comparison SHAP эмнени көрсөтөт?
Булак Figure 9-да proposed MLP + Attention, attention’сыз MLP жана Random Forest үчүн SHAP feature rankings’ти сапаттык салыштырат. Malware маалымат топтомунда feature_0, feature_1, feature_2, feature_3 жана feature_8 үч архитектуранын тең top-10 рейтингинде көрүнөт.
Server-Based маалымат топтомунда feature_1 бардык салыштырылган моделдерде биринчи орунда; feature_7, feature_13, feature_15 жана feature_16 да архитектуралар арасында кайра көрүнөт.
Kitsune’да feature dimensionality жана тогуз класстуу түзүлүштөн улам ranking variation чоңураак; булак feature_13 жана feature_65 эки MLP вариантынын тең top-10 тизмесине киргенин билдирет.
Бул анализ predictive-performance ablation эмес. Attention модулун алып салуу accuracy же F1ге канча өзгөрүү алып келерин көрсөткөн сандык ablation table жок; авторлор толук ablation иштерин келечектеги иш катары белгилешет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Негизги натыйжалуулук жыйынтыктары
| Маалымат топтому | Домен | Accuracy | Түшүндүрмө чеги |
|---|---|---|---|
| Kitsune | IoT трафиги | %96,0 | Тогуз класс арасында Class 2 жана Class 4 байкаларлык начарыраак. |
| Server-Based | Корпоративдик/server трафиги | %99,99 | Table 3 эки ондук форматта 1.00-гө тегеректейт. |
| Malware Traffic | Malware байланыш трафиги | %99,58 | Table 3 accuracy мамычасында 1.00 түрүндө тегеректелген. |
%99,99 Accuracy Бир Универсалдуу Моделдин Ийгилигин Көрсөтөбү?
Жок. %99,99 мааниси Server-Based маалымат топтомунда өзүнчө баалоо шартында алынган эң жогорку accuracy жыйынтыгы; изилдөө бир үйрөтүлгөн модель Kitsune, Server-Based жана Malware Traffic арасында көчүрүлгөнүн көрсөтпөгөндүктөн, бул маанини “үч доменде бир универсалдуу модель %99,99 тактык берди” деп чечмелөөгө болбойт.
Kitsune класс боюнча жыйынтыктары
| Класс | Precision | Recall | F1-score | Жалпы accuracy |
|---|---|---|---|---|
| Class 0 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 1 | 0.93 | 0.99 | 0.95 | 0.96 |
| Class 2 | 0.72 | 0.76 | 0.74 | 0.96 |
| Class 3 | 0.99 | 0.89 | 0.94 | 0.96 |
| Class 4 | 0.75 | 0.69 | 0.72 | 0.96 |
| Class 5 | 1.00 | 0.99 | 0.99 | 0.96 |
| Class 6 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 7 | 0.97 | 1.00 | 0.98 | 0.96 |
| Class 8 | 0.99 | 0.99 | 0.99 | 0.96 |
Class 2 жана Class 4 жыйынтыктары %96 overall accuracy класстар боюнча натыйжалуулук айырмаларын жашырышы мүмкүн экенин ачык көрсөтөт. Class 4 recall = 0.69 болгондуктан, чыныгы Class 4 үлгүлөрүнүн болжол менен үчтөн бири тиешелүү шартта туура класска берилген эмес.
Server-Based жана Malware жыйынтыктары
| Маалымат топтому | Класс | Precision | Recall | F1 | Table 3 Accuracy |
|---|---|---|---|---|---|
| Server-Based | Class 0 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 1 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 0 | 0.99 | 0.99 | 0.99 | 1.00 |
| Malware | Class 1 | 0.99 | 1.00 | 1.00 | 1.00 |
| Malware | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 3 | 1.00 | 0.98 | 0.99 | 1.00 |
| Malware | Class 4 | 1.00 | 1.00 | 1.00 | 1.00 |
Table 3 эки ондук көрсөтүүдөн улам жалпы accuracy’ни Server-Based жана Malware үчүн 1.00 деп көрсөтөт. Abstract болсо такыраак маанилерди тиешелүү түрдө %99,99 жана %99,58 деп берет. Verianla бул эки көрсөтүүнү карама-каршылык катары жашырбайт; Table 3 маанилерин тегеректелген таблицалык көрсөтүү катары сактайт.
Confusion matrix’тер эмнени көрсөтөт?
Kitsune confusion matrix’инде Class 0, 5, 6, 7 жана 8 негизинен diagonal боюнча туура классификацияланса, Class 2 жана Class 4-тө көбүрөөк off-diagonal ката көрүнөт. Булак муну класстар арасындагы feature overlap менен байланыштырат.
Server-Based confusion matrix дээрлик толугу менен diagonal. Malware confusion matrix’инде да жогорку diagonal dominance бар, бирок Class 0 менен Class 1 арасында аз өлчөмдө чаташуу кездешет.
ROC-AUC жыйынтыктары
Kitsune ROC анализинде көпчүлүк класстардын AUC мааниси 1.00-гө жетет; Class 2 жана Class 4 үчүн маанилер болжол менен 0.99 деңгээлинде билдирилет.
Server-Based маалымат топтомундагы үч класс үчүн AUC = 1.00; Malware Traffic маалымат топтомундагы беш класс үчүн да AUC = 1.00 билдирилген.
Бул жыйынтыктар тиешелүү train/test протоколу жана колдонулган маалымат топтомдору шартында өлчөнгөн. Башка тармактарда, жаңы чабуул түрлөрүндө же убакыт өткөн сайын өзгөргөн production traffic distribution шартында ошол эле AUC сакталары изилдөө тарабынан тастыкталган эмес.
Окутуу ийри сызыктары
Kitsune окутуусунда validation accuracy болжол менен 15-epoch чамасында %95-тен жогору чыгат. Training жана validation ийри сызыктары башында бир аз ажырайт, кийинки epoch’тарда туруктуураак болот.
Server-Based моделинде training жана validation accuracy бир нече epoch ичинде %99,5-тен жогору чыгат. Malware Traffic’те да accuracy абдан эрте %100-гө жакындайт.
Loss ийри сызыктары
Kitsune training loss болжол менен 1,2-ден башталып 0,2-ден төмөн түшсө, validation loss болжол менен 0,08-ге чейин азаят.
Server-Based окутуусунда training жана validation loss бир нече epoch ичинде болжол менен 0,05-тен төмөн түшөт. Malware моделинде loss маанилери болжол менен 0,03 же андан төмөн жүрөт.
Булак Malware validation loss көпчүлүк epoch’тарда training loss’тан төмөн болушун күчтүү regularization себептүү жеңил underfitting белгиси катары чечмелейт. Бул автордук чечмелөө; изилдөө муну үчүн өзүнчө formal statistical test билдирбейт.
Салыштырма Table 4 кантип окулушу керек?
| Ыкма | Best Accuracy (%) | Түшүндүрмөлүүлүк | Multi-dataset колдоосу |
|---|---|---|---|
| Ref. 20 | 98.7 | Partial, SHAP | Hybrid Boosting |
| Ref. 11 | 97.9 | High, XAI survey | Review-based |
| Ref. 12 | 96.3 | Low | 2 datasets |
| Ref. 25 | 98.5 | Federated SHAP | Federated DL |
| Proposed model | 99.99 | SHAP visual + feature attribution | Kitsune + Server + Malware |
Table 4-төгү %99,99 сунушталган системанын үч маалымат топтомундагы эң жогорку жыйынтыгы болгон Server-Based accuracy. Таблица ар башка изилдөөлөрдүн ар башка маалымат топтомдору жана ыкмаларындагы “best achieved accuracy” маанилерин жанаша коёт. Ошондуктан аны көзөмөлдөнгөн, бирдей test топтомуна негизделген head-to-head benchmark деп чечмелөөгө болбойт.
Cross-dataset transfer чындап сыналдыбы?
Жок. Жыйынтык бөлүмүнүн ачык билдирүүсүнө ылайык, изилдөө cross-dataset transfer learning көрсөтпөйт. Жалпы pipeline үч network environment’ка өз алдынча колдонулган.
Тексттин мурдагы бөлүгүндө pipeline ар башка domain’дерде “without requiring retraining or architectural modifications” иштейт деген күчтүүрөөк билдирүү бар. Бирок ыкма бөлүмү ар бир маалымат топтому үчүн training/test процессин сүрөттөйт жана жыйынтык бөлүмү transfer learning жүргүзүлбөгөнүн ачык айтат. Ошондуктан Verianla коопсуз чечмелөө катары “architecture/pipeline customization талап кылбастан өз алдынча кайра колдонуу” маанисин сактайт, “бир trained model retraining’сиз үч domain’де колдонулган” деген дооматты жаратпайт.
UAV’ларда сыналганбы?
Жок. Макалада UAV telemetry, RF signal, flight log же GPS variability камтыган UAV-specific dataset колдонулган эмес. UAV intrusion detection келечектеги потенциалдуу application domain катары гана талкууланган.
Демек, изилдөө UAV’ларда spoofing, jamming же башка чабуулдарды чыныгы учуу маалыматтары боюнча аныктаганын көрсөтпөйт.
Статистикалык белгисиздик жана кайталануучулук
Изилдөө accuracy, precision, recall, F1-score жана ROC-AUC билдирет. Бирок натыйжалуулук жыйынтыктары үчүн confidence interval, p-value, effect size же multiple-random-seed distribution берилген эмес.
random_state=42 SHAP үчүн колдонулган deterministic 70/30 split контекстинде көрсөтүлгөн. Бул өз алдынча training runs арасындагы натыйжалуулук белгисиздиги өлчөнгөн дегенди билдирбейт.
Изилдөө колдогон жыйынтыктар
- Бирдей жалпы preprocessing жана FCNN моделдөө ыкмасы үч ар башка network-data доменинде өз-өзүнчө колдонулду.
- Kitsune’да %96,0, Server-Based’де %99,99 жана Malware Traffic’те %99,58 accuracy билдирилген.
- Kitsune’да айрым класстар башкаларынан байкаларлык начар; өзгөчө Class 2 жана Class 4-түн F1 маанилери тиешелүү түрдө 0,74 жана 0,72.
- SHAP моделдин feature contribution түзүлүшүн бир нече validation үлгүсү аркылуу кароо үчүн колдонулган.
- LIME жеке predictions үчүн local feature contribution түшүндүрмөсүн чыгаруу максатында колдонулган.
- Server-Based жана Malware маалымат топтомдорунда ROC-AUC маанилери билдирилген бардык класстар үчүн 1.00.
- Изилдөө бирдей architectural pipeline гетерогендик маалымат домендерине колдонулушу мүмкүн экенин колдойт.
Изилдөө колдобогон жыйынтыктар
- Бир trained model үч маалымат топтомунун арасында түз көчүрүлүп, бирдей жыйынтыктарды бергени көрсөтүлгөн эмес.
- Cross-dataset transfer learning тастыкталган эмес.
- UAV intrusion defence чыныгы UAV маалыматы менен тастыкталган эмес.
- SHAP же LIME real-time packet-by-packet explanation катары сыналган эмес.
- Моделдин production network үстүндөгү throughput, latency, memory же long-term drift натыйжалуулугу билдирилген эмес.
- Attention модулунун predictive contribution’ын сандык жактан бөлүп көрсөткөн толук performance ablation жүргүзүлгөн эмес.
- Confidence interval же repeated-seed performance distribution жок болгондуктан, жыйынтыктардын training-run белгисиздиги сандык түрдө берилген эмес.
- Server-Based %99,99 accuracy бардык маалымат топтомдорунда %99,99 жалпы натыйжалуулук дегенди билдирбейт.
Булактагы маанилүү методологиялык белгисиздиктер
| Тема | Булак билдирүүсү A | Булак билдирүүсү B | Verianla ыкмасы |
|---|---|---|---|
| Масштабдоо | Standard scaling | [0,1] аралыгы | Scaler түрү тышкы маалыматка таянып өзгөртүлбөйт. |
| Attention жайгашуусу | Текст/теңдемелер: 32-нейрондуу h3-төн кийин attention | Algorithm 1: attention, FC-32-ден мурун | Айырма көрүнүктүү сакталат. |
| Dropout ырааты | Текст: үч hidden layer’дын ар биринен кийин dropout | Algorithm 1 ырааты үчүнчү dropout’ту көрсөтпөйт | Жетишпеген сап божомол менен толтурулбайт. |
| Data split | Algorithm 1: 70% train / 30% test | Training тексти validation loss жана validation samples колдонот | Өзүнчө үчүнчү split катышы ойлоп табылбайт. |
| Loss | Ыкма: class-weighted loss | Denklem 8: стандарттуу multiclass cross-entropy | Exact class-weight implementation белгисиз бойдон сакталат. |
| Domain generalisation | Аралык текст: “without requiring retraining” | Conclusion: cross-dataset transfer жүргүзүлгөн эмес, маалымат топтомдору өз алдынча иштетилген | Бир модель трансферинин ийгилиги деп доомат коюлбайт. |
| Accuracy көрсөтүлүшү | Abstract: 99,99% жана 99,58% | Table 3: 1.00 жана 1.00 | Table 3 маанилери тегеректелген көрсөтүү катары кабыл алынат. |
Келечектеги изилдөө багыттары
Автор келечектеги иштер үчүн UAV-specific dataset’терди жана flight telemetry, GPS variability жана communication-signal pattern сыяктуу domain-relevant feature’ларды кошууну сунуштайт.
Ошондой эле чыныгы cross-dataset transfer experiments, ablation studies жана classical machine-learning baselines менен көзөмөлдөнгөн салыштыруулар жүргүзүлүшү керектиги айтылат.
Бул иштер азыркы макаланын бүткөн жыйынтыктары эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: A domain-agnostic explainable framework for network attack detection across diverse traffic datasets
Автор: Abed Alanazi.
Авторлордун саны: 1.
Тең салым: Колдонулбайт; изилдөө бир авторлуу.
Corresponding author: Abed Alanazi.
E-mail: ad.alanazi@psau.edu.sa
Мекеме: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam bin Abdulaziz University, Al-Kharj 11942, Saudi Arabia.
Журнал: Scientific Reports.
Басма/platforma: Nature Portfolio / Springer Nature.
Том: 16.
Макала номери: 24512.
Жарыяланган жылы: 2026.
Жарыяланган күнү: 16 июль 2026.
Received: 27 апрель 2026.
Accepted: 6 июль 2026.
DOI: 10.1038/s41598-026-61637-w.
Расмий жарыя барагы: Nature / Scientific Reports макала жазуусу; DOI аркылуу жеткиликтүү.
Булактын түрү: Жарыяланган оригиналдуу изилдөө макаласы.
Рецензиялоо: Scientific Reports эксперттик рецензиялоону колдонгон, рецензиялануучу Nature Portfolio журналы.
Лицензия: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Лицензия жана визуалды колдонуу: NoDerivatives шартына байланыштуу булактагы Figure 1–9 өзгөртүлгөн же адаптацияланган түрдө Verianla макаласына көчүрүлгөн эмес. Макаладагы SVG булак текстинде ачык сүрөттөлгөн ыкмалык байланыштардан көз карандысыз композиция менен даярдалган.
Негизги изилдөө тармагы: Network intrusion detection, deep learning жана Explainable Artificial Intelligence.
Негизги модель: Fully Connected Neural Network / Multi-Layer Perceptron негизиндеги классификатор; Mish activation, dropout жана latent-representation attention камтыйт.
Жашыруун катмарлар: 128, 64 жана 32 нейрон.
Dropout: p = 0.3.
Optimizer: AdamW.
Баштапкы learning rate: 0.001.
Learning-rate scheduling: Cosine annealing; майда schedule параметрлери булакта берилген эмес.
Batch size: 128.
Максималдуу epoch: 20.
Early stopping: Validation loss боюнча.
Weight initialization: Xavier initialization.
Loss: Multiclass cross-entropy. Ыкма тексти кошумча class-weighted loss колдонулганын билдирет; exact class-weight маанилери берилген эмес.
Data split: Algorithm 1-де 70% training жана 30% test. Validation loss жана validation samples да колдонулат; өзүнчө validation partition катышы ачык билдирилген эмес.
Random state: SHAP түшүндүрмөсүндө deterministic 70/30 stratified split үчүн random_state = 42 көрсөтүлгөн.
Kitsune: 20 миллиондон ашык баштапкы үлгүдөн 9.000 үлгү; 115 өзгөчөлүк; 9 класс.
Server-Based: 225.398 үлгү; 27 өзгөчөлүк; 3 класс; маалымат топтомунун баары колдонулган.
Malware Traffic: 25 миллиондон ашык баштапкы үлгүдөн 644.602 үлгү; 23 өзгөчөлүк; 5 класс.
Жетишпеген маанилерди толтуруу: Сандык feature’ларда mean, категориялык feature’ларда mode.
Категориялык encoding: Номиналдык feature’ларда one-hot encoding; binary/ordinal feature’ларда label encoding.
Scaling боюнча булак билдирүүсү: Булак “Standard scaling” жана “[0,1]” сөздөрүн бирге колдонот. Verianla scaler түрүн тышкы маалыматка таянып өзгөрткөн эмес.
Негизги accuracy жыйынтыктары: Kitsune %96,0; Server-Based %99,99; Malware Traffic %99,58.
Kitsune начар класстары: Class 2 F1 = 0,74; Class 4 F1 = 0,72.
ROC-AUC: Kitsune’да көпчүлүк класстар 1.00, Class 2 жана Class 4 болжол менен 0.99; Server-Based жана Malware класстарында 1.00 билдирилген.
SHAP: Туруктуу 100 validation үлгүсү; KernelSHAP / shap.Explainer; CPU-side prediction wrapper.
LIME: Ар бир маалымат топтому үчүн бир өкүлчүлүктүү validation үлгүсү; idx = 0; num_features = 10.
XAI иштөө режими: Offline forensic analysis жана post-incident investigation; real-time per-packet explanation эмес.
Cross-architecture SHAP: Proposed MLP + Attention, attention’сыз MLP жана Random Forest түшүндүрмөлөрү сапаттык салыштырылган; бул салыштыруу predictive-performance ablation эмес.
Cross-dataset transfer: Жүргүзүлгөн эмес. Conclusion бөлүмү ошол эле pipeline ар башка маалымат топтомдоруна өз алдынча колдонулушу бааланганын ачык айтат.
UAV validation: Жүргүзүлгөн эмес. UAV telemetry, RF signals жана flight logs бар маалыматта жок.
Статистикалык тесттер: Натыйжалуулук үчүн p-value, confidence interval же effect size билдирилген эмес.
Repeated-seed performance: Билдирилген эмес.
Data availability: Kitsune, Malware Capture Facility жана колдонулган server/network malware dataset булакта public dataset катары көрсөтүлгөн.
Автордук салымдар: Conceptualization, data curation, formal analysis, funding acquisition, investigation, methodology, project administration, validation жана writing—review & editing милдеттеринин баарын Abed Alanazi аткарган.
Каржылоо: National Cybersecurity Authority, Kingdom of Saudi Arabia тарабынан CRPG-25-3295 номерлүү колдоо жана Prince Sattam bin Abdulaziz University тарабынан PSAU/2026/R/1447 долбоордук каржылоо билдирилген.
Кызыкчылыктардын кагылышы: Автор competing interests жок экенин билдирет.
Негизги методологиялык чек: Изилдөө үч коомдук тармактык коопсуздук маалымат топтомундагы өз алдынча эксперименттерден турат; production network талаа валидациясын, cross-dataset transfer learning жана UAV-specific validation камтыбайт.
Булак ичиндеги архитектуралык чек: Текст/теңдемелер attention’ды h3-төн кийин көрсөтсө, Algorithm 1 attention’ды FC-32-ден мурун жайгаштырат; бул айырма Verianla тарабынан унчукпай оңдолгон эмес.
Булак ичиндеги split чеги: 70/30 train-test билдирүүсү менен бирге validation loss жана validation samples колдонулган, өзүнчө validation катышы ачык берилген эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген