


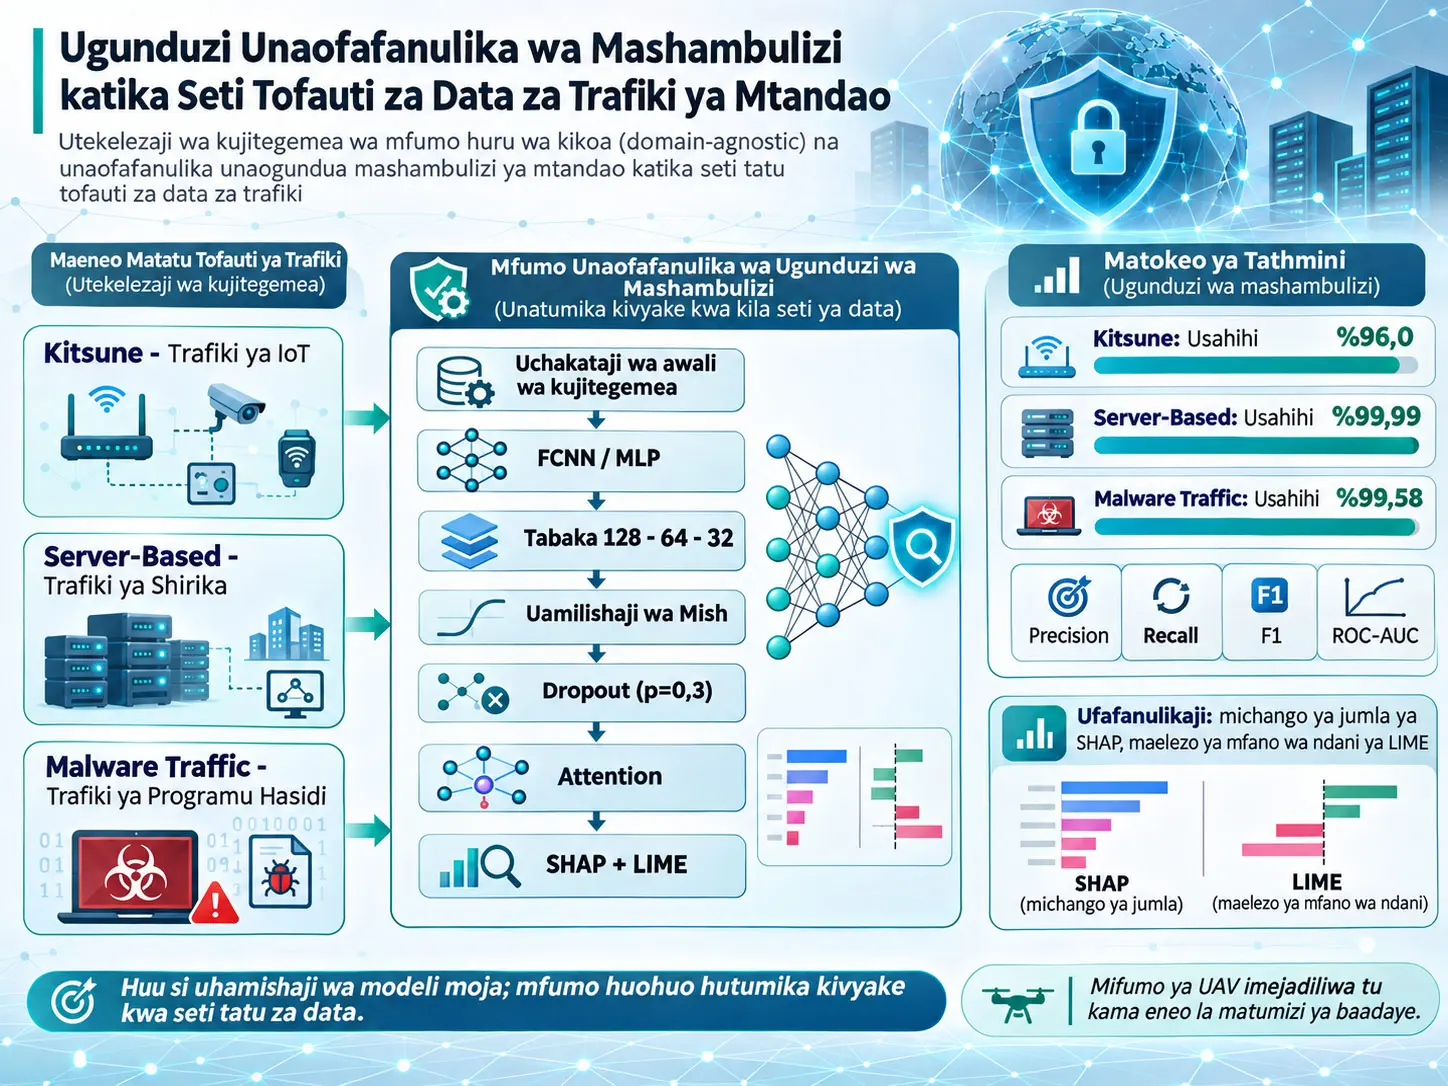
Mfumo Huru wa Kikoa na Unaofafanulika wa Kugundua Mashambulizi ya Mtandao, ni mkabala wa uainishaji wa mashambulizi ya mtandao unaosimamiwa ambao hutumia mantiki ileile ya maandalizi ya data na uundaji wa Fully Connected Neural Network (FCNN) kwa kila kikoa cha data ya mtandao kivyake, kama vile IoT, seva za shirika na trafiki ya programu hasidi, na hulenga kueleza maamuzi ya modeli kwa kutumia SHapley Additive exPlanations (SHAP) na Local Interpretable Model-Agnostic Explanations (LIME). Katika utafiti, seti za data za Kitsune, Server-Based na Malware Traffic zilichakatwa kwa kujitegemea; vipengele vya nambari na vya kategoria viliandaliwa; na modeli yenye tabaka zilizounganishwa kikamilifu zenye neuroni 128, 64 na 32, Mish activation, dropout na attention ilitumika. Chanzo kinaripoti accuracy ya %96,0 kwa Kitsune, %99,99 kwa Server-Based na %99,58 kwa Malware Traffic.
Neno “Domain-agnostic” katika utafiti huu halimaanishi kuwa modeli iliyofunzwa kwenye seti moja ya data ilihamishwa moja kwa moja kwenda seti nyingine. Mwandishi anasema wazi katika sehemu ya hitimisho kwamba cross-dataset transfer learning haikuonyeshwa; badala yake, matumizi huru ya pipeline ileile ya uundaji modeli katika mazingira matatu tofauti ya mtandao yalitathminiwa. Kwa hiyo, utafiti hutoa ushahidi kwamba usanifu wa jumla wa mbinu unaweza kutumika katika vikoa tofauti vya data, lakini hauthibitishi uhamisho wa moja kwa moja wa modeli kati ya vikoa bila mafunzo.
Matokeo ya Kitsune ni imara kwa accuracy ya jumla, lakini hayalingani kwa kila darasa. Table 3 inaripoti precision 0,72, recall 0,76 na F1 0,74 kwa Class 2; na precision 0,75, recall 0,69 na F1 0,72 kwa Class 4. Matokeo ya Server-Based na Malware Traffic yanaonyesha utenganishaji wa juu zaidi. Kwa hiyo, accuracy ya jumla iliyo juu haipaswi kutafsiriwa kuwa madarasa yote ya mashambulizi yamegunduliwa kikamilifu.
Uchambuzi wa SHAP ulifanywa kwenye sampuli 100 za validation zilizowekwa; LIME ilitumika kwa sampuli moja tu ya validation inayowakilisha kila seti ya data na hadi vipengele 10 vya kufafanua. Chanzo kinaweka zana hizi za explainability si kama sehemu ya inference ya real-time inayofanya kazi kwa kila pakiti, bali kwa offline forensic analysis na post-incident investigation.
Usalama wa UAV si eneo halisi la majaribio la makala. Utafiti haukutumia UAV telemetry, mabadiliko ya GPS, RF communication pattern wala flight log. Mifumo ya UAV ilijadiliwa tu kama eneo la matumizi linalowezekana ambako mbinu inaweza kujaribiwa baadaye.
“Domain-Agnostic” Inamaanisha Nini Katika Utafiti Huu?
Katika utafiti huu, “domain-agnostic” humaanisha kwamba preprocessing ileile ya jumla na pipeline ya uundaji modeli inayotegemea FCNN inatumika kivyake kwa trafiki ya Kitsune IoT, trafiki ya shirika ya Server-Based na data ya Malware Traffic bila kubuni usanifu mpya wa modeli maalum kwa kila seti ya data; utafiti hauonyeshi kwamba modeli moja iliyofunzwa ilihamishwa kati ya seti tofauti za data au kujaribiwa kama modeli ya pamoja ya cross-dataset.
Tatizo la utafiti
Utafiti unaanzia kwenye matatizo mawili. Kwanza, modeli nyingi za intrusion detection hutengenezwa kwa seti moja ya data na usambazaji maalum wa trafiki, hivyo haziwezi kudumisha utendaji uleule katika mazingira tofauti ya mtandao. Pili, mifumo ya deep learning yenye accuracy ya juu huwa na ugumu wa kueleza kwa nini imefikia uamuzi fulani wa shambulio.
Matatizo haya mawili ni muhimu hasa katika mifumo nyeti ambapo wachambuzi wa usalama wanataka kuona si lebo ya tahadhari pekee, bali pia vipengele gani vya trafiki vilivyoathiri uamuzi. Kwa hiyo, utafiti unachunguza uainishaji na explainability ya post-hoc ndani ya mfumo mmoja wa tathmini.
Vikoa vitatu vya data vya utafiti
| Seti ya data | Kikoa cha mtandao | Sampuli iliyotumika katika jaribio | Idadi ya vipengele | Idadi ya madarasa |
|---|---|---|---|---|
| Kitsune | Trafiki ya mtandao wa IoT | 9.000; data asili ina zaidi ya sampuli milioni 20 | 115 | 9: mashambulizi 8 + benign 1 |
| Server-Based | Trafiki ya shirika/server | 225.398; seti yote ya data | 27 | 3 |
| Malware Traffic | Trafiki ya mawasiliano ya programu hasidi | 644.602; data asili ina zaidi ya sampuli milioni 25 | 23 | 5 |
Seti ya data ya Kitsune inajumuisha trafiki inayotegemea IoT na tabia za mashambulizi kama ARP spoofing, Mirai botnet na denial-of-service. Chanzo kinasema kwamba subset inayowakilisha yenye sampuli 9.000 ilichaguliwa kutoka zaidi ya sampuli milioni 20 za asili. Hata hivyo, hakielezi kwa kina algoriti kamili ya kuchagua sampuli hizi 9.000 au utaratibu sahihi wa sampling kwa kila darasa.
Data kutoka Malware Capture Facility ina zaidi ya rekodi milioni 25. Rekodi 644.602 zilitumika katika utafiti. Data hii inajumuisha mawasiliano ya command-and-control, shughuli za ransomware na mifano mingine ya malware-driven network behavior.
Seti ya data ya Server-Based ina sampuli 225.398, vipengele 27 na madarasa matatu. Chanzo kinataja mifano ya mashambulizi ya upande wa server kama HTTP flooding, SSH brute-force na SQL injection.
Thamani zinazokosekana zinajazwaje?
Katika vipengele vya nambari, thamani zinazokosekana hujazwa kwa wastani wa safu husika. Katika vipengele vya kategoria, kategoria inayotokea mara nyingi zaidi, yaani mode, hutumika. Ujazaji kwa wastani hulenga kuhifadhi thamani ya kati ya kigezo cha nambari, huku ujazaji kwa mode ukitumia darasa linalojitokeza zaidi katika kigezo cha kategoria.
Mbinu hizi hutatua tatizo la thamani zinazokosekana; hata hivyo, hazimodeli kwa nini missingness mechanism imetokea. Chanzo hakiripoti uchambuzi tofauti wa missingness mechanism.
Kauli “Standard scaling hadi [0,1]” inapaswa kushughulikiwaje?
Chanzo kinasema katika sehemu mbili tofauti kwamba vipengele vya nambari vilihamishwa hadi masafa ya [0,1] kwa kutumia “Standard scaling”. Verianla haibadilishi kauli hii kimyakimya kuwa jina la scaler tofauti. Kwa hiyo, hitimisho salama ni hili tu: chanzo kinasema vipengele vya nambari vilipimwa kwa mizani na kinaeleza masafa ya matokeo kuwa [0,1]; darasa mahsusi la scaler katika kiwango cha programu haliwezi kubainishwa upya kwa uhakika kutoka kwenye maandishi yaliyochapishwa.
Vipengele vya kategoria vinakodishwaje?
One-hot encoding hutumika kwa kategoria za nominal ambazo hazina mpangilio wa asili. Mchakato huu hutengeneza binary feature tofauti kwa kila kategoria na kuzuia, kwa mfano, kuundwa kwa mpangilio bandia wa ukubwa kati ya aina za protokali.
Chanzo kinasema kwamba vipengele vya binary na ordinal hubadilishwa kuwa misimbo ya nambari kwa label encoding.
Kutokuwa na uwiano wa madarasa kunashughulikiwaje?
Sehemu ya metodolojia inasema stratified sampling na class-weighted loss zilitumika. Hata hivyo, chanzo hakiripoti thamani za nambari za class weight kwa kila darasa wala fomula yake.
Denklem 8 imetolewa katika muundo wa kawaida wa multiclass cross-entropy na hakuna kipengele wazi cha uzani wa darasa kwenye mlinganyo. Kwa hiyo, si sahihi kudhani kwa undani zaidi ya chanzo jinsi class weighting ilivyotumika katika exact loss implementation.
FCNN na Mfumo wa Attention Hufanyaje Kazi?
Modeli ya FCNN ya utafiti hufanya kazi kwa tabaka zilizounganishwa kikamilifu, Mish activation na dropout zinazobadilisha feature vector ya ingizo kuwa uwakilishi fiche wa vipimo 128, 64 na 32; kulingana na maelezo na milinganyo ya chanzo, uzani wa attention huhesabiwa kwenye latent representation ya mwisho ya vipimo 32, na uwakilishi wa attention-weighted hubadilishwa kuwa utabiri wa mashambulizi wa madarasa mengi katika tabaka la softmax.
Vekta ya ingizo
Chanzo kinafafanua vekta ya ingizo kama:
\[ \mathbf{x}\in\mathbb{R}^{d} \]
. \(d\) ni idadi ya feature zilizochakatwa. Makala inatoa \(d=120\) kama mfano; hata hivyo, kwa kuwa idadi ya feature za asili katika seti tatu za data ni tofauti, thamani hii haipaswi kutafsiriwa kuwa kipimo cha mwisho cha kudumu na cha jumla kwa seti zote za data.
Denklem 1–3: Uwakilishi fiche
\[ \mathbf{h}_1=\operatorname{Mish}(W_1\mathbf{x}+b_1), \qquad \mathbf{h}_1\in\mathbb{R}^{128} \tag{1} \]
Denklem 1 hubadilisha vipengele vya ingizo kuwa latent representation ya kwanza ya vipimo 128. \(W_1\) ni weight matrix inayojifunzwa, \(b_1\) ni bias vector na \(\mathbf{h}_1\) ni pato la tabaka la kwanza fiche.
\[ \mathbf{h}_2=\operatorname{Mish}(W_2\mathbf{h}_1+b_2), \qquad \mathbf{h}_2\in\mathbb{R}^{64} \tag{2} \]
Denklem 2 hubadilisha uwakilishi fiche wa kwanza kuwa vipimo 64.
\[ \mathbf{h}_3=\operatorname{Mish}(W_3\mathbf{h}_2+b_3), \qquad \mathbf{h}_3\in\mathbb{R}^{32} \tag{3} \]
Denklem 3 hupunguza latent representation ya mwisho hadi vipimo 32. Mish ni activation function isiyo ya mstari. Kwa kuwa chanzo hakitoi ufafanuzi wa analitiki wa Mish, Verianla haiongezi mlinganyo mpya kutoka nje ya chanzo.
Denklem 4: Dropout
\[ \mathbf{h}^{drop}_i= Dropout(\mathbf{h}_i,p=0.3), \qquad i=1,2,3 \tag{4} \]
Dropout hulenga kupunguza utegemezi kupita kiasi wa modeli kwa latent units binafsi kwa kuzima kwa muda sehemu ya vitengo fiche wakati wa training. \(p=0.3\) hapa ni dropout rate iliyoripotiwa katika chanzo.
Denklem 5: Uzani wa Attention
\[ \boldsymbol{\alpha}= softmax(W_a\mathbf{h}_3+b_a) \tag{5} \]
Tabaka la Attention hutengeneza uzani wa jamaa kwa latent units ndani ya representation ya mwisho fiche. Sehemu ya metodolojia ya chanzo inasema wazi kwamba mfumo huu haufanyi kazi moja kwa moja kwenye feature za awali za ingizo, bali kwenye hidden representation iliyojifunzwa.
Tofauti hii ni muhimu: attention weight na SHAP feature attribution si kitu kimoja. Attention huweka uzani kwenye latent representation ndani ya modeli; SHAP hutumika kutathmini kwa post-hoc mchango wa vipengele vya ingizo kwenye utabiri wa modeli.
Denklem 6: Uwakilishi wa Attention-weighted
\[ z= \sum_{j=1}^{32} \alpha_j h_{3j} \tag{6} \]
Denklem 6 imetolewa kwa namna hii katika chanzo. \(\alpha_j\) ni attention weight ya \(j\), na \(h_{3j}\) ni sehemu ya \(j\) ya tabaka fiche la mwisho.
Kuna tatizo la notation linalopaswa kuzingatiwa katika uwasilishaji wa chanzo: katika jumla ya Denklem 6, \(z\) inaonekana kama kiasi scalar, lakini Denklem 7 inayofuata hutumia uandishi wa vector inner-product \(w_i^Tz\). Chanzo hakielezi kando uhusiano huu wa vipimo. Verianla haibadilishi mlinganyo wala kujaza taarifa ya vipimo inayokosekana kwa dhana.
Denklem 7: Uwezekano wa darasa wa Softmax
\[ \hat{y}_i= \frac{\exp(w_i^{T}z+b_i)} {\sum_{j=1}^{C}\exp(w_j^{T}z+b_j)}, \qquad i=1,2,\ldots,C \tag{7} \]
Denklem 7 hutengeneza uwezekano uliosawazishwa wa utabiri kwa kila darasa. \(C\) ni idadi ya madarasa katika seti husika ya data. Kiashiria cha chini cha Softmax hujumlisha thamani za exponentiated logit za madarasa yote na kubadilisha matokeo kuwa usambazaji wa pamoja wa uwezekano.
Denklem 8: Multiclass cross-entropy
\[ L= -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{ic}\log(\hat{y}_{ic}) \tag{8} \]
\(N\) inawakilisha idadi ya training sample, \(C\) idadi ya madarasa, \(y_{ic}\) thamani halisi ya class indicator na \(\hat{y}_{ic}\) uwezekano uliotabiriwa na modeli kwa darasa husika. Loss haina kipimo.
Modeli inapotoa uwezekano mdogo kwa darasa halisi, \(-\log(\hat{y}_{ic})\) huongezeka na loss hupanda. Uboreshaji wa mafunzo hulenga kujifunza miundo ya weight itakayopunguza loss hii.
Tofauti ya ndani ya chanzo katika maelezo ya usanifu
Maelezo ya metodolojia yanasema kuna dropout baada ya kila moja ya tabaka tatu fiche zenye neuroni 128, 64 na 32, na mfumo wa attention hutumika kwenye representation ya mwisho ya vipimo 32. Denklem 1–6 zinaendana na maelezo haya.
Hata hivyo, Algorithm 1 inatoa mlolongo wa modeli kama FC-128 → Dropout(0.3) → FC-64 → Dropout(0.3) → Attention → FC-32 → softmax. Katika mlolongo huu, attention inaonekana kabla ya FC-32 na dropout ya tatu haijaonyeshwa wazi.
Mawasilisho haya mawili hayafanani kabisa ndani ya chanzo. Kwa hiyo, Verianla haibadilishi kimyakimya mstari wa Algorithm 1 au mlolongo wa milinganyo ili ulingane na mwingine.
Mipangilio ya mafunzo
| Kigezo | Thamani ya chanzo | Maelezo |
|---|---|---|
| Optimizer | AdamW | Optimizer inayotumika kwa masasisho ya weight. |
| Learning rate ya mwanzo | 0.001 | Thamani ya mwanzo iliyotolewa katika Algorithm 1. |
| Learning-rate schedule | Cosine annealing | Chanzo kinasema schedule ilitumika; vigezo vya kina vya schedule havijaripotiwa. |
| Batch size | 128 | Idadi ya training sample kwa kila mini-batch. |
| Epoch ya juu zaidi | 20 | Early stopping inaweza kusitisha mapema zaidi. |
| Dropout | 0.3 | Uwiano ulioripotiwa katika Denklem 4 na maelezo ya mbinu. |
| Weight initialization | Xavier | Ili kuweka variance ya awali ya weight katika uwiano. |
| Early stopping | Validation loss | Kwa lengo la kupunguza overtraining. |
| Monitoring | TensorBoard | Kwa kufuatilia utendaji wa training. |
Mgawanyo wa training, validation na test umetolewaje hasa?
Algorithm 1 inaandika kwamba seti za data zimegawanywa kuwa %70 training na %30 test, na random_state=42 pamoja na taarifa ya deterministic stratified split inaonekana katika maelezo ya SHAP.
Hata hivyo, mistari inayofuata ya algoriti hutumia metrika za “validation” na early stopping kulingana na validation loss; uchambuzi wa SHAP pia hufafanuliwa kwenye “validation samples”. Chanzo hakitoi wazi ukubwa wa partition ya tatu tofauti ya validation.
Kwa hiyo, taarifa inayoweza kutolewa kwa uhakika kutoka kwenye maandishi yaliyochapishwa ni mgawanyo wa 70/30 stratified na uwepo wa sampuli zinazotumika kama validation; si sahihi kubuni uwiano tofauti wa train-validation-test.
SHAP na LIME Hufafanua Nini Katika Utafiti Huu?
SHAP ilitumika kuchunguza usambazaji wa feature contribution katika sampuli nyingi za validation, huku LIME ikitumika kuonyesha mchango wa feature wa eneo katika mazingira ya prediction moja; chanzo kinazuia mbinu zote mbili kuwa zana za offline forensic analysis na post-incident investigation badala ya maelezo ya real-time kwa kila pakiti.
Matumizi ya SHAP
Chanzo kinasema mbinu ya KernelSHAP ilitumika kupitia shap.Explainer, kwenye background yenye sampuli 100 za validation zilizowekwa na kwa CPU-side prediction wrapper.
SHAP summary plot zilitumika kuchunguza feature inaathiri model output kwa mwelekeo gani na kwa kiwango gani katika sampuli tofauti.
Katika uchambuzi wa SHAP wa Kitsune, feature_0, feature_3, feature_1 na feature_8 pamoja na vipengele vingine vinaonyesha mchango unaoonekana. Chanzo kinahusisha hili na ukweli kwamba uamuzi katika trafiki ya IoT hautegemei kigezo kimoja kinachotawala.
Katika Server-Based, usambazaji wa SHAP ni mnene zaidi na umejikita karibu na idadi ndogo ya vipengele. Katika Malware, usambazaji mpana zaidi wa feature contribution unaonekana.
Matumizi ya LIME
LIME ilitumika kwa sampuli moja tu ya validation inayowakilisha kila seti ya data. Chanzo kinaripoti sampuli iliyotumika kuwa idx=0 na idadi ya feature zilizoelezwa kuwa num_features=10.
Katika sampuli ya Kitsune, ts, service_http na resp_bytes zimetolewa kama michango chanya; service_dns na proto_tcp kama mifano ya feature yenye mchango hasi.
Katika sampuli ya Server-Based, ts, proto na id.resp_h zinaonyesha mchango mkubwa chanya, huku orig_bytes na resp_bytes zikitajwa kama mifano ya mchango hasi.
Katika sampuli ya Malware, feature_85, feature_86 na feature_107 ni chanya; feature_57 na feature_39 ni hasi.
Mipaka ya matokeo ya explainability
Chanzo kinasema kwamba kwa kuwa trained checkpoint ileile na sampuli zilezile 100 za validation zilitumika, SHAP rankings hazikubadilika ziliporudiwa. Hata hivyo, utafiti hauripoti repeated-training experiment ya takwimu kwa SHAP ranking variance kwa kufundisha modeli upya kutoka mwanzo kwa random seed tofauti.
Kwa hiyo, “uwezo wa kurudia maelezo chini ya checkpoint ileile” na “explanation stability chini ya hali tofauti za mafunzo” si matokeo sawa.
Architecture comparison SHAP inaonyesha nini?
Chanzo Figure 9 kinalinganisha kwa ubora SHAP feature rankings kwa proposed MLP + Attention, MLP bila attention na Random Forest. Katika seti ya Malware, feature_0, feature_1, feature_2, feature_3 na feature_8 zinaonekana katika top-10 za usanifu wote watatu.
Katika Server-Based, feature_1 iko nafasi ya kwanza katika modeli zote zilizolinganishwa; feature_7, feature_13, feature_15 na feature_16 pia hujitokeza tena kati ya usanifu tofauti.
Katika Kitsune, ranking variation ni kubwa zaidi kutokana na feature dimensionality na muundo wa madarasa tisa; chanzo kinaripoti kwamba feature_13 na feature_65 zimeingia kwenye orodha ya top-10 ya aina zote mbili za MLP.
Uchambuzi huu si predictive-performance ablation. Hakuna ablation table ya kiasi inayoonyesha kuondoa moduli ya Attention kunabadilisha accuracy au F1 kwa kiasi gani; waandishi wanataja tafiti kamili za ablation kama kazi ya baadaye.
Mbinu na Matokeo ya Utafiti
Matokeo makuu ya utendaji
| Seti ya data | Kikoa | Accuracy | Kikomo cha tafsiri |
|---|---|---|---|
| Kitsune | Trafiki ya IoT | %96,0 | Miongoni mwa madarasa tisa, Class 2 na Class 4 ni dhaifu zaidi kwa uwazi. |
| Server-Based | Trafiki ya shirika/server | %99,99 | Table 3 huzungusha hadi 1.00 katika muundo wa desimali mbili. |
| Malware Traffic | Trafiki ya mawasiliano ya Malware | %99,58 | Imezungushwa kuwa 1.00 katika safu ya accuracy ya Table 3. |
Je, Accuracy ya %99,99 Inaonyesha Mafanikio ya Modeli Moja ya Jumla?
Hapana. Thamani ya %99,99 ni accuracy ya juu zaidi iliyopatikana kwa Server-Based katika hali tofauti ya tathmini; kwa kuwa utafiti hauonyeshi modeli moja iliyofunzwa ikihamishwa kati ya Kitsune, Server-Based na Malware Traffic, thamani hii haipaswi kutafsiriwa kuwa “modeli moja ya jumla ilipata accuracy ya %99,99 katika vikoa vyote vitatu”.
Matokeo ya Kitsune kwa kila darasa
| Darasa | Precision | Recall | F1-score | Accuracy ya jumla |
|---|---|---|---|---|
| Class 0 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 1 | 0.93 | 0.99 | 0.95 | 0.96 |
| Class 2 | 0.72 | 0.76 | 0.74 | 0.96 |
| Class 3 | 0.99 | 0.89 | 0.94 | 0.96 |
| Class 4 | 0.75 | 0.69 | 0.72 | 0.96 |
| Class 5 | 1.00 | 0.99 | 0.99 | 0.96 |
| Class 6 | 1.00 | 1.00 | 1.00 | 0.96 |
| Class 7 | 0.97 | 1.00 | 0.98 | 0.96 |
| Class 8 | 0.99 | 0.99 | 0.99 | 0.96 |
Matokeo ya Class 2 na Class 4 yanaonyesha wazi kwamba overall accuracy ya %96 inaweza kuficha tofauti za utendaji kwa kila darasa. Kwa kuwa Class 4 recall = 0.69, takriban theluthi moja ya sampuli halisi za Class 4 hazikupewa darasa sahihi chini ya hali hiyo.
Matokeo ya Server-Based na Malware
| Seti ya data | Darasa | Precision | Recall | F1 | Table 3 Accuracy |
|---|---|---|---|---|---|
| Server-Based | Class 0 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 1 | 1.00 | 1.00 | 1.00 | 1.00 |
| Server-Based | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 0 | 0.99 | 0.99 | 0.99 | 1.00 |
| Malware | Class 1 | 0.99 | 1.00 | 1.00 | 1.00 |
| Malware | Class 2 | 1.00 | 1.00 | 1.00 | 1.00 |
| Malware | Class 3 | 1.00 | 0.98 | 0.99 | 1.00 |
| Malware | Class 4 | 1.00 | 1.00 | 1.00 | 1.00 |
Kwa sababu ya uwasilishaji wa desimali mbili, Table 3 inaonyesha accuracy ya jumla kuwa 1.00 kwa Server-Based na Malware. Abstract inatoa thamani sahihi zaidi za %99,99 na %99,58 mtawalia. Verianla haifichi mawasilisho haya mawili kama mkanganyiko; thamani za Table 3 zinahifadhiwa kama uwasilishaji uliokadiriwa wa jedwali.
Confusion matrix zinaonyesha nini?
Katika confusion matrix ya Kitsune, Class 0, 5, 6, 7 na 8 zimeainishwa kwa usahihi hasa kwenye diagonal, huku Class 2 na Class 4 zikiwa na makosa mengi zaidi ya off-diagonal. Chanzo kinahusisha hali hii na feature overlap kati ya madarasa.
Confusion matrix ya Server-Based iko karibu kabisa kwenye diagonal. Katika Malware pia kuna diagonal dominance kubwa, ingawa kuna kuchanganyika kidogo kati ya Class 0 na Class 1.
Matokeo ya ROC-AUC
Katika uchambuzi wa ROC wa Kitsune, AUC ya madarasa mengi hufikia 1.00; kwa Class 2 na Class 4 thamani zinaripotiwa karibu 0.99.
Kwa madarasa matatu ya Server-Based AUC = 1.00; na kwa madarasa matano ya Malware Traffic AUC = 1.00 pia imeripotiwa.
Matokeo haya yalipimwa chini ya train/test protocol husika na seti za data zilizotumika. Utafiti haujathibitisha kwamba AUC hiyo hiyo itadumu katika mitandao mingine, aina mpya za mashambulizi au production traffic distribution inayobadilika kwa muda.
Mikondo ya mafunzo
Katika mafunzo ya Kitsune, validation accuracy hupita %95 karibu na epoch ya 15. Mikondo ya training na validation hutengana kidogo mwanzoni na kuwa thabiti zaidi katika epoch zinazofuata.
Katika Server-Based, training na validation accuracy hupita %99,5 ndani ya epoch chache. Katika Malware Traffic pia accuracy hukaribia %100 mapema sana.
Mikondo ya Loss
Kitsune training loss huanza karibu 1,2 na kushuka chini ya 0,2, huku validation loss ikishuka hadi karibu 0,08.
Katika Server-Based, training na validation loss hushuka chini ya takriban 0,05 ndani ya epoch chache. Katika Malware, loss huwa takriban 0,03 au chini.
Chanzo kinatafsiri Malware validation loss kuwa chini ya training loss katika epoch nyingi kama dalili ya underfitting ndogo kutokana na regularization kali. Hii ni tafsiri ya mwandishi; utafiti hauripoti formal statistical test tofauti kwa hili.
Table 4 ya ulinganisho inapaswa kusomwaje?
| Mkabala | Best Accuracy (%) | Explainability | Usaidizi wa Multi-dataset |
|---|---|---|---|
| Ref. 20 | 98.7 | Partial, SHAP | Hybrid Boosting |
| Ref. 11 | 97.9 | High, XAI survey | Review-based |
| Ref. 12 | 96.3 | Low | 2 datasets |
| Ref. 25 | 98.5 | Federated SHAP | Federated DL |
| Proposed model | 99.99 | SHAP visual + feature attribution | Kitsune + Server + Malware |
%99,99 katika Table 4 ni accuracy ya Server-Based, matokeo ya juu zaidi ya mfumo uliopendekezwa katika seti tatu za data. Jedwali linaweka pamoja “best achieved accuracy” za tafiti tofauti kwenye seti na mbinu tofauti za data. Kwa hiyo halipaswi kutafsiriwa kama head-to-head benchmark iliyodhibitiwa kwenye test set moja.
Je, Cross-dataset transfer ilijaribiwa kweli?
Hapana. Kwa kauli wazi ya sehemu ya hitimisho, utafiti hauonyeshi cross-dataset transfer learning. Pipeline ya pamoja ilitumika kwa kujitegemea katika network environment tatu.
Sehemu ya awali ya maandishi ina kauli yenye nguvu zaidi kwamba pipeline hufanya kazi katika domain tofauti “without requiring retraining or architectural modifications”. Hata hivyo, sehemu ya mbinu inaeleza mchakato wa training/test kwa kila seti ya data na sehemu ya hitimisho inasema wazi kwamba transfer learning haikufanywa. Kwa hiyo, Verianla huhifadhi kama tafsiri salama maana ya “matumizi huru bila architecture/pipeline customization”, na haitengenezi dai kwamba “trained model moja ilitumika katika domain tatu bila retraining”.
Je, ilijaribiwa kwenye UAV?
Hapana. Makala haikutumia UAV-specific dataset yenye UAV telemetry, RF signal, flight log au GPS variability. UAV intrusion detection ilijadiliwa tu kama application domain inayowezekana baadaye.
Kwa hiyo, utafiti hauonyeshi kwamba spoofing, jamming au mashambulizi mengine yaligunduliwa kwenye UAV kwa kutumia data halisi ya ndege.
Kutokuwa na uhakika wa takwimu na reproducibility
Utafiti unaripoti accuracy, precision, recall, F1-score na ROC-AUC. Hata hivyo, confidence interval, p-value, effect size au multiple-random-seed distribution hazijaripotiwa kwa matokeo ya utendaji.
random_state=42 imeelezwa katika muktadha wa deterministic 70/30 split iliyotumika kwa SHAP. Hii haimaanishi kwamba kutokuwa na uhakika wa utendaji kati ya training runs huru kulipimwa.
Hitimisho zinazoungwa mkono na utafiti
- Preprocessing ileile ya jumla na mkabala wa uundaji modeli wa FCNN uliweza kutumika kivyake katika vikoa vitatu tofauti vya network-data.
- Accuracy ya %96,0 kwa Kitsune, %99,99 kwa Server-Based na %99,58 kwa Malware Traffic iliripotiwa.
- Katika Kitsune, baadhi ya madarasa ni dhaifu zaidi kuliko mengine; hasa F1 za Class 2 na Class 4 ni 0,74 na 0,72 mtawalia.
- SHAP ilitumika kuchunguza muundo wa feature contribution wa modeli katika sampuli nyingi za validation.
- LIME ilitumika kutoa maelezo ya local feature contribution kwa predictions binafsi.
- Katika seti za Server-Based na Malware, ROC-AUC ni 1.00 kwa madarasa yote yaliyoripotiwa.
- Utafiti unaunga mkono kwamba architectural pipeline ileile inaweza kutumika katika vikoa heterojeni vya data.
Hitimisho ambazo utafiti hauungi mkono
- Haijaonyeshwa kwamba trained model moja ilihamishwa moja kwa moja kati ya seti tatu za data na kutoa matokeo yale yale.
- Cross-dataset transfer learning haijathibitishwa.
- UAV intrusion defence haijathibitishwa kwa data halisi ya UAV.
- SHAP au LIME haikujaribiwa kama real-time packet-by-packet explanation.
- Utendaji wa throughput, latency, memory au long-term drift wa modeli kwenye production network haujaripotiwa.
- Performance ablation kamili inayotenga kwa kiasi predictive contribution ya moduli ya Attention haikufanywa.
- Kwa kuwa hakuna confidence interval wala repeated-seed performance distribution, kutokuwa na uhakika wa training-run hakujatolewa kwa kiasi.
- Accuracy ya %99,99 ya Server-Based haimaanishi utendaji wa pamoja wa %99,99 katika seti zote za data.
Kutokuwa na uhakika muhimu wa kimetodolojia katika chanzo
| Mada | Kauli ya chanzo A | Kauli ya chanzo B | Mkabala wa Verianla |
|---|---|---|---|
| Scaling | Standard scaling | Masafa ya [0,1] | Aina ya scaler haibadilishwi kwa kutegemea taarifa ya nje. |
| Nafasi ya Attention | Maandishi/milinganyo: attention baada ya h3 yenye neuroni 32 | Algorithm 1: attention kabla ya FC-32 | Tofauti inawekwa wazi. |
| Mpangilio wa Dropout | Maandishi: dropout baada ya kila hidden layer tatu | Mpangilio wa Algorithm 1 hauonyeshi dropout ya tatu | Mstari unaokosekana haujazwi kwa dhana. |
| Data split | Algorithm 1: 70% train / 30% test | Maandishi ya Training yanatumia validation loss na validation samples | Uwiano wa split ya tatu tofauti haukubuniwi. |
| Loss | Mbinu: class-weighted loss | Denklem 8: multiclass cross-entropy ya kawaida | Exact class-weight implementation inahifadhiwa kuwa haijulikani. |
| Domain generalisation | Maandishi ya katikati: “without requiring retraining” | Conclusion: cross-dataset transfer haikufanywa, seti za data zilichakatwa kwa kujitegemea | Mafanikio ya uhamisho wa modeli moja hayadaiwani. |
| Uwasilishaji wa Accuracy | Abstract: 99,99% na 99,58% | Table 3: 1.00 na 1.00 | Thamani za Table 3 zinachukuliwa kama uwasilishaji uliokadiriwa. |
Mwelekeo wa kazi za baadaye
Mwandishi anapendekeza kuongeza UAV-specific dataset na domain-relevant feature kama flight telemetry, GPS variability na communication-signal pattern katika kazi za baadaye.
Pia inaelezwa kuwa real cross-dataset transfer experiments, ablation studies na ulinganisho uliodhibitiwa na classical machine-learning baselines unapaswa kufanywa.
Kazi hizi si matokeo yaliyokamilika ya makala ya sasa.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A domain-agnostic explainable framework for network attack detection across diverse traffic datasets
Mwandishi: Abed Alanazi.
Idadi ya waandishi: 1.
Mchango sawa: Haitumiki; utafiti una mwandishi mmoja.
Corresponding author: Abed Alanazi.
Barua pepe: ad.alanazi@psau.edu.sa
Taasisi: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam bin Abdulaziz University, Al-Kharj 11942, Saudi Arabia.
Jarida: Scientific Reports.
Mchapishaji/platforma: Nature Portfolio / Springer Nature.
Juzuu: 16.
Nambari ya makala: 24512.
Mwaka wa uchapishaji: 2026.
Tarehe ya uchapishaji: 16 Julai 2026.
Received: 27 Aprili 2026.
Accepted: 6 Julai 2026.
DOI: 10.1038/s41598-026-61637-w.
Ukurasa rasmi wa uchapishaji: Rekodi ya makala ya Nature / Scientific Reports; inapatikana kupitia DOI.
Aina ya chanzo: Makala asili ya utafiti iliyochapishwa.
Mapitio ya kitaalamu: Scientific Reports ni jarida la Nature Portfolio linalopitia peer review ya wataalamu.
Leseni: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Leseni na matumizi ya taswira: Kwa sababu ya sharti la NoDerivatives, Figure 1–9 za chanzo hazikuhamishwa kwenye makala ya Verianla katika muundo uliobadilishwa au kurekebishwa. SVG ndani ya makala iliundwa kwa muundo huru kutokana tu na mahusiano ya mbinu yaliyofafanuliwa wazi katika maandishi ya chanzo.
Eneo kuu la utafiti: Network intrusion detection, deep learning na Explainable Artificial Intelligence.
Modeli kuu: Kiainishaji kinachotegemea Fully Connected Neural Network / Multi-Layer Perceptron; kina Mish activation, dropout na latent-representation attention.
Tabaka fiche: Neuroni 128, 64 na 32.
Dropout: p = 0.3.
Optimizer: AdamW.
Learning rate ya mwanzo: 0.001.
Learning-rate scheduling: Cosine annealing; vigezo vya kina vya schedule havijatolewa katika chanzo.
Batch size: 128.
Epoch ya juu zaidi: 20.
Early stopping: Kulingana na Validation loss.
Weight initialization: Xavier initialization.
Loss: Multiclass cross-entropy. Maandishi ya mbinu pia yanasema class-weighted loss ilitumika; exact class-weight values hazijaripotiwa.
Data split: Katika Algorithm 1: 70% training na 30% test. Validation loss na validation samples pia zinatumika; uwiano tofauti wa validation partition haujaripotiwa wazi.
Random state: Katika maelezo ya SHAP, random_state = 42 imetajwa kwa deterministic 70/30 stratified split.
Kitsune: Sampuli 9.000 kutoka zaidi ya sampuli milioni 20 za asili; vipengele 115; madarasa 9.
Server-Based: Sampuli 225.398; vipengele 27; madarasa 3; seti yote ya data ilitumika.
Malware Traffic: Sampuli 644.602 kutoka zaidi ya sampuli milioni 25 za asili; vipengele 23; madarasa 5.
Kujaza thamani zinazokosekana: Mean kwa feature za nambari, mode kwa feature za kategoria.
Categorical encoding: One-hot encoding kwa feature za nominal; label encoding kwa feature za binary/ordinal.
Kauli ya chanzo kuhusu Scaling: Chanzo kinatumia pamoja “Standard scaling” na “[0,1]”. Verianla haijabadilisha aina ya scaler kwa kutumia taarifa ya nje.
Matokeo makuu ya accuracy: Kitsune %96,0; Server-Based %99,99; Malware Traffic %99,58.
Madarasa dhaifu ya Kitsune: Class 2 F1 = 0,74; Class 4 F1 = 0,72.
ROC-AUC: Katika Kitsune madarasa mengi ni 1.00, Class 2 na Class 4 karibu 0.99; katika Server-Based na Malware madarasa yameripotiwa 1.00.
SHAP: Sampuli 100 za validation zilizowekwa; KernelSHAP / shap.Explainer; CPU-side prediction wrapper.
LIME: Sampuli moja ya validation inayowakilisha kila seti ya data; idx = 0; num_features = 10.
Hali ya kazi ya XAI: Offline forensic analysis na post-incident investigation; si real-time per-packet explanation.
Cross-architecture SHAP: Maelezo ya Proposed MLP + Attention, MLP bila attention na Random Forest yalilinganishwa kwa ubora; ulinganisho huu si predictive-performance ablation.
Cross-dataset transfer: Haikufanywa. Sehemu ya Conclusion inasema wazi kwamba pipeline ileile ilitathminiwa kwa kutumiwa kivyake kwenye seti tofauti za data.
UAV validation: Haikufanywa. UAV telemetry, RF signals na flight logs hazipo katika data iliyotumika.
Majaribio ya takwimu: Hakuna p-value, confidence interval wala effect size iliyoripotiwa kwa utendaji.
Repeated-seed performance: Haijaripotiwa.
Data availability: Kitsune, Malware Capture Facility na server/network malware dataset iliyotumika zimetajwa katika chanzo kama public dataset.
Michango ya mwandishi: Conceptualization, data curation, formal analysis, funding acquisition, investigation, methodology, project administration, validation na writing—review & editing zote zilifanywa na Abed Alanazi.
Ufadhili: Msaada wenye nambari CRPG-25-3295 kutoka National Cybersecurity Authority, Kingdom of Saudi Arabia na ufadhili wa mradi PSAU/2026/R/1447 kutoka Prince Sattam bin Abdulaziz University umeripotiwa.
Mgongano wa maslahi: Mwandishi anatangaza kwamba hakuna competing interests.
Kikomo kikuu cha kimetodolojia: Utafiti una majaribio huru kwenye seti tatu za data za usalama wa mtandao zilizo wazi; hauna production network field validation, cross-dataset transfer learning wala UAV-specific validation.
Kikomo cha usanifu ndani ya chanzo: Maandishi/milinganyo huweka attention baada ya h3, huku Algorithm 1 ikiweka attention kabla ya FC-32; tofauti hii haikusahihishwa kimyakimya na Verianla.
Kikomo cha split ndani ya chanzo: Validation loss na validation samples zilitumika pamoja na kauli ya 70/30 train-test, lakini uwiano tofauti wa validation haukutolewa wazi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *