


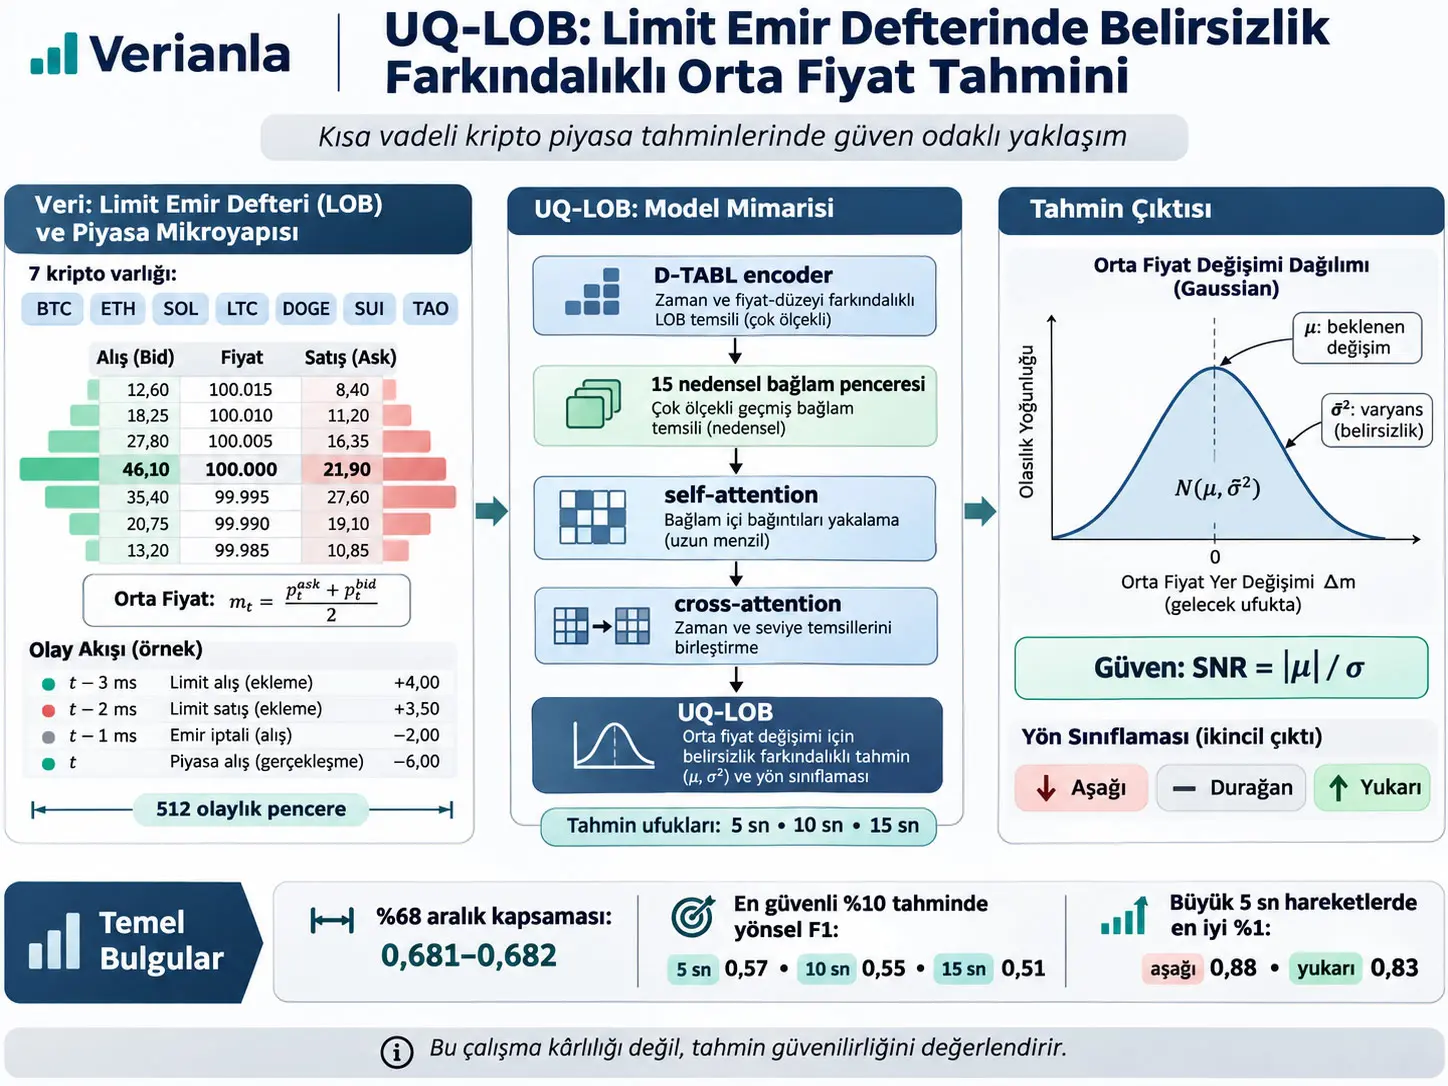
UQ-LOB, önceden eğitilmiş bir limit emir defteri (Limit Order Book, LOB) encoder'ının gizli temsilinin üzerine eklenen, tahminin yalnız yönünü veya fiyat değişimini değil tahminin ne kadar güvenilir olduğunu da modelleyen encoder-agnostic bir belirsizlik nicelleştirme modülüdür. Çalışmada UQ-regression gelecekteki orta fiyat değişimi için \(\mathcal{N}(\mu,\sigma^2)\) biçiminde Gaussian predictive distribution üretirken UQ-classification aşağı, yukarı ve durağan sınıfları için categorical distribution üretir. UQ-regression'ın güven ölçüsü \(|\mu|/\sigma\) signal-to-noise ratio (SNR), UQ-classification'ın güven ölçüsü ise en yüksek softmax class probability değeridir.
Çalışma Kraken cryptocurrency exchange'in public market-data API'sinden toplanan yaklaşık 5,2 milyar Level-2 ve Level-3 order-book olayını kullanmaktadır. Bitcoin, Ethereum, Solana, Litecoin, Dogecoin, Sui ve Bittensor olmak üzere yedi USD-quoted asset ayrı ayrı 5, 10 ve 15 saniyelik tahmin ufuklarında modellenmiştir. Her input 512 ardışık order-book olayından oluşur. Model, target window'dan önce tamamlanan ve sonuçları tahmin anında zaten gerçekleşmiş olan 15 context window'u kullanarak güncel piyasa rejimine gradient update yapmadan uyum sağlamaya çalışır.
UQ-regression'ın nominal %68 predictive interval'ı testte %68,1–68,2 ampirik coverage sağlayarak nominal seviyeye çok yakın kalmıştır. Buna karşılık nominal %95 aralık yalnız %90,4–90,7 coverage sağlamış ve modelin dağılımın ağır kuyruklarını Gaussian varsayımıyla yeterince kapsayamadığını göstermiştir. Confidence gating ile yalnız en güvenli %10 tahmin tutulduğunda directional macro F1 UQ-regression için 5 saniyede 0,42'den 0,57'ye, 10 saniyede 0,41'den 0,55'e ve 15 saniyede 0,40'tan 0,51'e yükselmiştir.
Büyük gerçek hareketlerde, yani gerçek displacement büyüklüğünün üst üçte birlik dilimine giren örneklerde, UQ-regression'ın en güvenli %1'lik katmanı 5 saniyede aşağı yön için 0,88 ve yukarı yön için 0,83 F1 elde etmiştir. Ancak çalışma gerçek trading profitability, net return, transaction-cost-adjusted P&L veya canlı execution performansı ölçmemektedir. Sonuçlar kısa vadeli fiyat yönü ve displacement tahmininin güvenilirliğiyle sınırlıdır.
UQ-LOB Nedir ve Nokta Tahmininden Nasıl Ayrılır?
UQ-LOB, bir LOB encoder'ının tek bir fiyat yönü veya displacement değeri üretmesine ek olarak tahminin olasılıksal dağılımını ve örneğe özgü belirsizliğini hesaplayan bir uncertainty-quantification head'dir; UQ-regression gelecekteki tick displacement için \(\mu\) ve \(\sigma^2\) üretirken UQ-classification üç directional class için olasılık dağılımı üretir.
Limit emir defteri ve orta fiyat nedir?
Limit Order Book, elektronik piyasada henüz gerçekleşmemiş alış ve satış emirlerini fiyat seviyelerine göre tutan piyasa mekanizmasıdır. En yüksek alış fiyatı best bid, en düşük satış fiyatı best ask olarak adlandırılır. Bu iki fiyat arasındaki fark spread'dir.
Çalışmanın tahmin etmeye çalıştığı mid-price, best bid ve best ask arasındaki orta noktadır. Kavramsal olarak:
\[ p_{\mathrm{mid}} = \frac{p_{\mathrm{bid}}+p_{\mathrm{ask}}}{2}. \]
Bu denklem makalenin numaralandırılmış araştırma denklemlerinden biri değildir; okuyucunun mid-price kavramını anlaması için verilen temel tanımdır.
Neden yalnız fiyat yönü yetmiyor?
Bir model “fiyat yukarı gidecek” diyebilir; fakat iki ayrı tahmin aynı yönü gösterirken güvenilirlikleri aynı olmayabilir. UQ-LOB bu problemi input-dependent aleatoric uncertainty üzerinden ele alır. Aleatoric uncertainty burada piyasa gözleminin kendisindeki örneğe özgü belirsizliği temsil eder. Bu çalışma epistemic uncertainty'yi, yani model parametrelerinin bilinmezliğini doğrudan modellememektedir.
UQ-regression bir point estimate yerine:
\[ y^t \mid h^t,\mathcal{C} \sim \mathcal{N}(\mu,\sigma^2) \]
biçiminde predictive distribution oluşturur. \(\mu\) tahmin edilen tick displacement'ın merkez değeridir; \(\sigma\) ise tahminin belirsizliğini ifade eder.
Context set neden kullanılıyor?
Finansal microstructure aynı gün içinde bile değişebilir. UQ-LOB, target prediction'ı yalnız target hidden representation üzerinden yapmak yerine yakın geçmişte tamamlanmış ve outcome'ları tahmin anında artık bilinen örnekleri context olarak kullanır.
Bir target instance toplam:
\[ N=C+1 \]
window içerir. Çalışmada:
\[ C=15, \qquad N=16. \]
Yani 15 context window ve 1 withheld target window birlikte işlenir.
Eşitlik 1: Future leakage'i önleyen causal context koşulu
\[ e_i^c = t_i^c+d+h \le t, \qquad \forall i\in\{1,\ldots,C\}. \tag{1} \]
Ne hesaplar? Bir context window'un outcome label'ının target prediction anı olan \(t\)'den önce gerçekten gerçekleşmiş olup olmadığını kontrol eder.
\(t_i^c\): context window'un son event zamanı.
\(d\): execution latency; deneyde 0,0005 saniyedir.
\(h\): prediction horizon; ana deneylerde 5, 10 veya 15 saniyedir.
\(e_i^c\): context label'ın tamamen gerçekleştiği zaman.
Yalnız input window'un target'tan önce gelmesi yeterli değildir. Context'in label horizon'ı \(t\)'yi aşarsa gelecek bilgisi tahmine sızabilir. Eşitlik 1 bunu engeller.
Eşitlik 2: Context representation
Hidden representations önce ortak projection space'e geçirilir. Context label, asset/horizon-specific \(y_{\mathrm{ref}}\) ile ölçeklenip tanh-bounded projection'dan geçirilir.
Her context point:
\[ r_i = \mathrm{MLP}_{\mathrm{enc}} \left( [\tilde{h}_i^c;y_i^{\mathrm{proj}}] \right), \qquad i=1,\ldots,C. \tag{2} \]
şeklinde context representation'a dönüşür.
\(\tilde{h}_i^c\), encoder hidden representation'ın projected halidir. \(y_i^{\mathrm{proj}}\), gerçekleşmiş context label'ın ölçeklenmiş ve projected halidir. Köşeli parantez concatenation anlamındadır.
Eşitlik 3: Target'ın context'e cross-attention uygulaması
Self-attention context set içindeki \(r_i\) değerlerini birbirlerine göre yeniden ağırlıklandırdıktan sonra target embedding query olarak context'i okur:
\[ r^t = \operatorname{softmax} \left( \frac{qK^\top}{\sqrt{d_r}} \right)V. \tag{3} \]
Burada:
\[ q=W_q\tilde{h}^t, \qquad k_i=W_k\tilde{h}_i^c, \qquad v_i=r_i^{\mathrm{ref}}. \]
\(K\), context key'lerini; \(V\), refined context values'larını satır bazında bir araya getirir. \(d_r=256\) attention dimension'dır.
Bu mekanizmanın algoritmik anlamı şudur: bütün geçmiş context window'lar eşit kabul edilmez. Target representation'a daha uygun context yapıları daha yüksek attention alabilir.
UQ-LOB Mimarisinde Regression ve Classification Nasıl Ayrılıyor?
UQ-regression ve UQ-classification aynı D-TABL encoder, projection, context encoder, self-attention ve cross-attention trunk'ını paylaşır; yalnız son decoder değişir: regression decoder \(\mu\) ve variance parametresi üretirken classification decoder down/up/stationary için üç logit üretir.
Eşitlik 4: Regression decoder'ın variance üretimi
\[ [\mu,\nu] = \mathrm{MLP}_{\mathrm{dec}} ([r^t;\tilde{h}^t]), \qquad \sigma^2 = y_{\mathrm{ref}}^2 \operatorname{softplus}(\nu) + \epsilon. \tag{4} \]
\(\mu\), predicted tick displacement; \(\nu\), decoder'ın variance için ürettiği ham parametre; \(\sigma^2\), pozitif predictive variance; \(y_{\mathrm{ref}}\), asset/horizon-specific tick scale ve \(\epsilon=10^{-8}\) numerical stability floor değeridir.
Softplus kullanılması variance'ın negatif olmasını engeller. \(y_{\mathrm{ref}}^2\) variance'ı ilgili asset ve horizon'ın tick ölçeğine geri taşır.
Eşitlik 5: UQ-regression'ın toplam kaybı
\[ \mathcal{L}_{\mathrm{reg}} = \lambda_1\mathcal{L}_{\mathrm{NLL}} + \lambda_2\mathcal{L}_{\mathrm{WMAE}} + \lambda_3\mathcal{L}_{\mathrm{dir}} + \lambda_4\mathcal{L}_{\mathrm{calib}}. \tag{5} \]
Kaynakta kullanılan ağırlıklar:
\[ (\lambda_1,\lambda_2,\lambda_3,\lambda_4) = (1.0,0.1,0.5,0.5). \]
Dört terimin görevleri birbirinden farklıdır: NLL mean ve variance'ı probabilistically öğrenir; WMAE büyük displacement'ların etkisini artırır; directional loss yön sınıfını destekler; calibration loss ise predicted uncertainty'nin gerçekleşen residual büyüklüğüyle uyumunu zorlar.
Heteroscedastic Gaussian NLL
\[ \mathcal{L}_{\mathrm{NLL}} = \mathbb{E} \left[ \frac{1}{2}\log(2\pi\sigma^2) + \frac{(y-\mu)^2}{2\sigma^2} \right]. \]
Heteroscedastic, \(\sigma\)'nın her input için aynı sabit değer olmaması anlamına gelir. Model bazı window'larda düşük, bazı window'larda yüksek uncertainty üretebilir.
Bu yapının bilinen bir problemi loss attenuation'dır. Model zor örneklerde \(\sigma\)'yı büyüterek squared residual cezasını azaltabilir. Çünkü:
\[ \frac{\partial\mathcal{L}_{\mathrm{NLL}}}{\partial\mu} \propto \frac{1}{\sigma^2}. \]
\(\sigma\) aşırı büyürse \(\mu\)'ya ulaşan gradient küçülebilir. Kaynak WMAE ve directional loss'u kısmen bu probleme karşı kullanmaktadır.
Eşitlik 6: Magnitude-weighted MAE
\[ \mathcal{L}_{\mathrm{WMAE}} = \mathbb{E} \left[ w(y) \frac{|\mu-y|}{y_{\mathrm{ref}}} \right], \tag{6} \]
\[ w(y) = \min \left( 1+ \left( \frac{|y|}{y_{\mathrm{ref}}} \right)^p, w_{\max} \right). \]
Kaynakta:
\[ p=4, \qquad w_{\max}=40. \]
Displacement büyüdükçe \(w(y)\) artar; böylece büyük fiyat hareketlerinin regression error'u küçük hareketlerden daha yüksek ağırlık kazanır. \(w_{\max}=40\), aşırı uç örneklerin tek başına loss'u domine etmesini sınırlar.
Eşitlik 7: Directional loss
\[ \mathcal{L}_{\mathrm{dir}} = \mathbb{E} \left[ \mathbf{1}[|y_i|\ge\delta_i] \left( \tilde{\mu}_i-\operatorname{sign}(y_i)m \right)^2 + \mathbf{1}[|y_i|\lt\delta_i] \left| \tilde{\mu}_i-\operatorname{sign}(y_i)m \right| \right]. \tag{7} \]
Burada:
\[ \tilde{\mu}_i=\frac{\mu_i}{y_{\mathrm{ref}}}, \qquad m=1. \]
\(\delta_i\), ilgili asset, horizon ve window için directional/stationary threshold'dur.
Gerçek displacement directional threshold'u geçtiğinde quadratic penalty uygulanır ve predicted mean doğru işaretli \(\pm m\) hedefe doğru daha güçlü çekilir. Stationary örneklerde linear penalty kullanılır; böylece sign bilgisi korunurken magnitude üzerinde aynı sert çekim uygulanmaz.
Eşitlik 8: Magnitude-conditional calibration loss
\[ \mathcal{L}_{\mathrm{calib}} = \frac{1}{B} \sum_{b=1}^{B} \left( \mathbb{E}_{i\in\mathcal{B}_b} \left[ \frac{|\mu_i-y_i|}{\sigma_i} \right] - \sqrt{\frac{2}{\pi}} \right)^2. \tag{8} \]
Kaynakta:
\[ B=3. \]
\(\mathcal{B}_b\), predicted magnitude \(|\mu|\) değerlerine göre oluşturulan quantile bin'leridir. Standard normal:
\[ Z\sim\mathcal{N}(0,1) \]
için:
\[ \mathbb{E}|Z| = \sqrt{\frac{2}{\pi}}. \]
Kalibre bir Gaussian modelde standardised absolute residual'ın beklenen değeri bu hedefe yaklaşmalıdır. Loss bunu yalnız global olarak değil predicted magnitude katmanlarında ayrı ayrı zorlamaktadır.
UQ-classification loss
Classification decoder üç class için weighted cross-entropy kullanır:
\[ \mathcal{L}_{\mathrm{cls}} = - \sum_{c=0}^{2} w_c \mathbf{1}[y_{\mathrm{cls}}=c] \log p_c. \]
Class weight:
\[ w_c\propto\frac{1}{f_c}, \qquad \sum_c w_c=3. \]
\(f_c\), training split içindeki class frequency'dir. Nadir class daha yüksek weight alır.
SNR ile Seçici Tahmin Ne Anlama Geliyor?
UQ-regression'da confidence \(SNR=|\mu|/\sigma\) olarak tanımlanır; model yalnız yüksek SNR'li tahminleri tuttuğunda hem predicted displacement'ın büyüklüğü yüksek hem de predicted uncertainty görece düşük olan örnekler seçilmiş olur, böylece coverage azalırken kalan tahminlerin directional reliability'si yükselir.
Regression confidence
\[ SNR = \frac{|\mu|}{\sigma}. \]
Büyük \(|\mu|\) ve küçük \(\sigma\), yüksek SNR üretir. SNR boyutsuzdur çünkü numerator ve denominator aynı tick-displacement birimindedir.
Classification confidence
\[ Confidence_{\mathrm{cls}} = \max_c p_c. \]
Classification için modelin en yüksek softmax probability değeri confidence olarak kullanılır.
Percentile gating
Confidence percentile \(q\), test setindeki en güvenli:
\[ (100-q)\% \]
tahmini tutar.
Örneğin:
\[ q=90 \]
satırı, tahminlerin en güvenli %10'unun değerlendirildiği anlamına gelir.
Neden üç sınıflı macro F1 yerine directional macro F1 kullanılıyor?
Confidence gating yüksek-magnitude prediction'ları seçtiği için retained subset içinde stationary prediction oranı hızla düşmektedir. Bu nedenle stationary F1, model directional prediction'da daha iyi hale geldiği halde sıfıra yaklaşabilir.
Kaynak bu nedenle:
\[ F1_{\mathrm{directional}} = \frac{ F1_{\mathrm{down}} + F1_{\mathrm{up}} }{2} \]
ölçüsünü ana gating metriği olarak kullanır.
Full test set için prior-matched random classifier'ın beklenen directional macro F1 değeri:
\[ \frac{1-p_{\mathrm{stat}}}{2}. \]
Ancak gating class composition'ı değiştirdiğinden full-set random reference gated subset'lere doğrudan taşınamaz.
Predictive interval coverage
Nominal %68 interval için:
\[ cov_{68} = \Pr \left[ |y-\mu| \le \sigma \right]. \]
Nominal %95 interval için:
\[ cov_{95} = \Pr \left[ |y-\mu| \le 1.96\sigma \right]. \]
Eşitlik 9: Magnitude-weighted \(R^2\)
\[ R_w^2 = 1- \frac{ \sum_i w_i(y_i-\mu_i)^2 }{ \sum_i w_i(y_i-\bar{y}_w)^2 }, \tag{9} \]
\[ \bar{y}_w = \frac{ \sum_i w_i y_i }{ \sum_i w_i }. \]
Buradaki \(w_i=w(y_i)\), Eşitlik 6'daki magnitude weight'tir. Bu nedenle büyük displacement'lar standard \(R^2\)'ye göre daha yüksek etki kazanır.
Order-book input hangi bilgileri içeriyor?
Her event bir discrete token ve yedi continuous feature ile temsil edilir. Token vocabulary toplam 439 entry'dir ve beş categorical attribute'tan oluşturulur:
- event type,
- side,
- discretised volume,
- opposing best quote'a göre discretised price distance,
- simultaneity flag.
Order-book depth için:
\[ L_{\max}=10. \]
Daha derindeki event'ler atılır.
Yedi continuous feature:
- log inter-event time,
- opposing best quote'a göre log tick distance,
- log relative volume,
- DNFI,
- son 50 event üzerinde cumulative DNFI,
- son 200 event üzerinde cumulative DNFI,
- QI.
Eşitlik 10: Depth-normalised flow imbalance ve queue imbalance
\[ \mathrm{DNFI}_t = \frac{ \Delta Q_{1,t}^{b} - \Delta Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1], \]
\[ \mathrm{QI}_t = \frac{ Q_{1,t}^{b} - Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1]. \tag{10} \]
\(Q_{1,t}^{b}\), best bid seviyesindeki resting queue size; \(Q_{1,t}^{a}\), best ask seviyesindeki resting queue size'dır.
DNFI, queue size'ın önceki event'e göre değişimini kullanır ve dinamik order-flow pressure'ı temsil eder. QI ise aynı anda book üzerinde duran bid ve ask liquidity arasındaki statik asimetriyi gösterir.
D-TABL encoder
Çalışmada UQ-LOB'un encoder-agnostic olduğu belirtilmesine rağmen deneysel implementation yalnız D-TABL encoder ile gerçekleştirilmiştir. D-TABL, Temporal Attention-Augmented Bilinear Network yapısının 512-event input'a uyarlanmış daha derin bir varyantıdır.
Özgün C(TABL) yapısındaki iki BL layer yerine üç BL layer kullanılmış ve ardından terminal TABL layer eklenmiştir.
Eşitlik 11: Bilinear layer
\[ Y = \phi \left( W_1 X W_2+B \right). \tag{11} \]
\[ X\in\mathbb{R}^{D\times T} \]
input matrix'tir. \(W_1\) feature axis'i, \(W_2\) temporal axis'i project eder. \(B\) learned bias ve \(\phi\) ReLU activation'dır.
Eşitlik 12: Temporal attention-augmented bilinear dönüşüm
Önce:
\[ \bar{X}=W_1X \]
hesaplanır. Attention score:
\[ E=\bar{X}W \]
ve row-wise softmax ile:
\[ \alpha_{ij} = \frac{ \exp(e_{ij}) }{ \sum_k\exp(e_{ik}) } \]
attention matrix \(A\)'yı oluşturur.
Ardından:
\[ \tilde{X} = \lambda (\bar{X}\odot A) + (1-\lambda)\bar{X}, \qquad Y = \phi (\tilde{X}W_2+B). \tag{12} \]
\(\lambda\in[0,1]\), attention-masked representation ile original projected representation arasındaki learned mixing coefficient'tir.
Eşitlik 13: Discrete token embedding'in continuous features ile birleştirilmesi
Token embedding table:
\[ E\in\mathbb{R}^{439\times8}. \]
Token \(k\) için:
\[ e_k = E[k,:] \in \mathbb{R}^{8}. \]
Yedi continuous feature ile sekiz boyutlu token embedding:
\[ x_t = [x_t^{\mathrm{cont}};e_{k_t}] \in \mathbb{R}^{15}, \qquad t=1,\ldots,512. \tag{13} \]
biçiminde birleştirilir.
Böylece bütün window:
\[ X\in\mathbb{R}^{15\times512} \]
boyutundadır.
Regression label nasıl oluşturuluyor?
Window'un son event zamanı \(t\)'dir. Modelin teorik olarak aynı anda işlem yapamayacağı kabul edilerek küçük latency:
\[ d=0.0005\,\mathrm{s} \]
eklenir.
\[ t_{\mathrm{start}} = t+d. \]
\(p_{\mathrm{start}}\), \(t_{\mathrm{start}}\) anında veya sonrasında görülen ilk event'in mid-price değeridir.
Prediction horizon:
\[ t_{\mathrm{end}} = t_{\mathrm{start}}+h. \]
Eşitlik 14: End price smoothing
Tek event fiyatı microstructure noise'a aşırı hassas olabileceği için \(t_{\mathrm{end}}\)'den hemen önceki \(k=10\) event'in mid-price ortalaması alınır:
\[ p_{\mathrm{end}} = \frac{1}{k} \sum_{j\in\mathcal{K}} p_j, \tag{14} \]
\[ \mathcal{K} = \{ \text{\(t_j\le t_{\mathrm{end}}\) koşulunu sağlayan en büyük zamanlı \(k\) event} \}. \]
Regression target:
\[ y_h(t) = p_{\mathrm{end}} - p_{\mathrm{start}}. \]
Birim tick displacement'tır.
Eşitlik 15: Classification threshold
Her asset ve horizon için training split'teki \(h\)-saniyelik mid-price log-return standard deviation:
\[ \sigma_h^{\mathrm{LR}} \]
hesaplanır.
Threshold:
\[ \tau_h^{\mathrm{LR}} = \alpha \sigma_h^{\mathrm{LR}}. \tag{15} \]
Kaynakta:
\[ \alpha=0.25. \]
Log-return threshold mevcut price level'a göre tick displacement'a çevrilir:
\[ \delta_h(t) = p_{\mathrm{start}} \left[ \exp(\tau_h^{\mathrm{LR}}) - 1 \right]. \]
Eşitlik 16: Down / up / stationary label
\[ c = \begin{cases} 1\;(\mathrm{up}), & y_h(t)\ge\delta_h(t) \\ 0\;(\mathrm{down}), & y_h(t)\le-\delta_h(t) \\ 2\;(\mathrm{stationary}), & \mathrm{otherwise}. \end{cases} \tag{16} \]
Threshold'un iki tarafı simetriktir. Pozitif threshold aşılırsa up, negatif threshold aşılırsa down, arada kalırsa stationary etiketi atanır.
Eşitlik 17: Regression mean'i classification ile karşılaştırmak için threshold calibration
Regression mean \(\mu\), üç sınıflı değerlendirmeye çevrilirken threshold'a ek bir \(k^*\) multiplier uygulanır:
\[ \delta_h^\mu(t) = p_{\mathrm{start}} \left[ \exp(k^*\tau_h^{\mathrm{LR}}) - 1 \right]. \]
\(k^*\), validation period'ın ayrı calibration yarısında:
\[ k^* = \arg\min_k \left| \Pr [ |\mu| \lt \delta_h^{\mu,k}(t) ] - \Pr [ |y_h(t)| \lt \delta_h(t) ] \right|. \tag{17} \]
olarak seçilir.
Amaç regression prediction'lardan elde edilen stationary class oranını gerçek stationary proportion'a yaklaştırmaktır. Calibration classification head'in kendi class distribution'ına göre değil, true class distribution'a göre yapılır.
Çalışmanın Yöntemi ve Bulguları
Veri kaynağı ve zaman bölümü
Çalışma Kraken cryptocurrency exchange'in public market-data API'sinden alınan Level-2 ve Level-3 order-book verilerini kullanmaktadır.
| Öğe | Kaynakta verilen değer |
|---|---|
| Toplam event | Yaklaşık 5,2 milyar |
| Toplam asset-day | Yaklaşık 600 |
| Assets | BTC, ETH, SOL, LTC, DOGE, SUI, TAO |
| Market | Kraken |
| Quote currency | USD |
| Veri dönemi | Kasım 2025 – Şubat 2026 |
| Training | 18 Ocak 2026'ya kadar |
| Validation | 19–31 Ocak 2026 |
| Test | 1–15 Şubat 2026 |
| Yaklaşık split | %68 train / %15 validation / %17 test asset-days |
| Ana horizons | 5 s / 10 s / 15 s |
Validation period iki eşit parçaya ayrılmıştır: ilk yarısı model selection, ikinci yarısı Eşitlik 17'deki threshold multiplier calibration için kullanılır. Test period her iki validation aşamasından da kronolojik olarak sonradır.
Asset bazında veri yoğunluğu
| Asset | Tick ($) | Gün | Event (milyar) | Event/gün (milyon) | Event/s | Ortalama IET (ms) | 5 s event | 10 s event | 15 s event |
|---|---|---|---|---|---|---|---|---|---|
| BTC | 0,10 | 94 | 1,254 | 13,338 | 156 | 6,42 | 780 | 1560 | 2340 |
| ETH | 0,01 | 70 | 0,903 | 12,899 | 151 | 6,61 | 755 | 1510 | 2265 |
| DOGE | 1,0×10⁻⁷ | 97 | 1,124 | 11,587 | 134 | 7,46 | 670 | 1340 | 2010 |
| SOL | 0,01 | 78 | 0,539 | 6,909 | 80 | 12,50 | 400 | 800 | 1200 |
| TAO | 0,0001 | 84 | 0,577 | 6,870 | 80 | 12,58 | 400 | 800 | 1200 |
| SUI | 0,0001 | 94 | 0,523 | 5,565 | 64 | 15,52 | 320 | 640 | 960 |
| LTC | 0,01 | 83 | 0,276 | 3,326 | 39 | 25,97 | 195 | 390 | 585 |
Aynı 15 saniyelik horizon BTC için ortalama yaklaşık 2340 event içerirken LTC için yaklaşık 585 event içerir. Dolayısıyla saniye cinsinden aynı horizon farklı asset'lerde farklı information density anlamına gelir.
Model parameter sayıları
| Bileşen | Parameter |
|---|---|
| D-TABL encoder — shared | 268.356 |
| Feature projection — shared | 24.704 |
| CNP context / attention trunk — shared | 766.784 |
| Regression decoder | 165.378 |
| Classification decoder | 165.731 |
| Toplam regression variant | 1.225.222 |
| Toplam classification variant | 1.225.575 |
İki variant'ın parameter count'u neredeyse aynıdır. Böylece regression ile classification confidence karşılaştırması büyük bir model-capacity farkıyla açıklanamaz.
Eğitim stratejisi
Eğitim iki aşamada yürütülür.
- Her asset-horizon çifti için D-TABL encoder üç sınıflı classification task üzerinde pretrain edilir.
- UQ-regression veya UQ-classification head encoder checkpoint'e eklenir ve encoder ile birlikte end-to-end fine-tune edilir.
Yedi asset × üç ana horizon:
\[ 7\times3=21 \]
asset-horizon çifti oluşturur.
Her çift için regression ve classification olmak üzere:
\[ 21\times2=42 \]
UQ model variant'ı eğitilir.
Ana metindeki yaklaşık 210 GPU-hour, iki UQ varyantı için appendix'te verilen:
\[ 105+105=210 \]
GPU-hour ile uyumludur. Appendix ayrıca base D-TABL pretraining için yaklaşık 78,75 GPU-hour bildirir ve bütün eğitim pipeline'ını yaklaşık:
\[ 78.75+105+105 = 288.75 \approx289 \]
GPU-hour olarak verir.
Hiperparametreler
| Grup | Parametre | Değer |
|---|---|---|
| Input | Window length \(L\) | 512 event |
| Input | Vocabulary \(|\mathcal{V}|\) | 439 |
| Input | Token embedding dimension | 8 |
| Input | Continuous features | 7 |
| Input | Max order-book depth \(L_{\max}\) | 10 |
| Label | Latency \(d\) | 0,0005 s |
| Label | End-price smoothing \(k\) | 10 event |
| Label | Threshold multiplier \(\alpha\) | 0,25 |
| Head | Context size \(C\) | 15 |
| Head | Instances per batch | 16 |
| Head | Projection dimension | 128 |
| Head | Attention dimension \(d_r\) | 256 |
| Head | Attention heads | 4 |
| Head | Context encoder depth | 3 GELU MLP layer |
| Head | Decoder depth | 5 GELU MLP layer |
| Regression | \((\lambda_1,\lambda_2,\lambda_3,\lambda_4)\) | (1,0; 0,1; 0,5; 0,5) |
| Regression | WMAE exponent \(p\) | 4 |
| Regression | \(w_{\max}\) | 40 |
| Regression | Directional margin \(m\) | 1,0 |
| Regression | Calibration bins \(B\) | 3 |
| Regression | Variance floor \(\epsilon\) | \(1\times10^{-8}\) |
| Optimisation | Optimizer | AdamW |
| Optimisation | Encoder learning rate | \(1\times10^{-5}\) |
| Optimisation | Head learning rate | \(5\times10^{-5}\) |
| Optimisation | Weight decay | 0 |
| Optimisation | Warmup | LinearLR, 10k step |
| Optimisation | Cosine restart \(T_0\) | 15k |
| Optimisation | \(T_{\mathrm{mult}}\) | 2 |
| Optimisation | \(\eta_{\min}\) | \(10^{-5}\) |
| Optimisation | \(\gamma\) | 0,5 |
| Training | Max epochs | 15 |
| Training | Random seed train / test | 42 / 999 |
Algorithm 1: Causal context construction
- Tek asset'e ait bütün window'lar timestamp sırasına konur.
- Target index \(\tau\) için yalnız \(j<\tau\) geçmiş window'lar değerlendirilir.
- \(t_j+d+h\le t_\tau\) koşulunu sağlayan, yani label outcome'u target prediction anına kadar tamamen gerçekleşmiş window'lar seçilebilir.
- Bu uygun adayların timestamp'i en büyük olan, yani en yakın geçmişteki \(C=15\) window context set'i oluşturur.
- Encoder representations ve realised labels context olarak, target representation ise withheld prediction örneği olarak döndürülür.
Confidence Gating Gerçekten Ne Kadar İyileşme Sağladı?
Yedi asset birlikte değerlendirildiğinde UQ-regression'ın directional macro F1 değeri full test setten en güvenli %10 tahminlere geçildiğinde 5, 10 ve 15 saniyelik ufuklarda sırasıyla +0,15, +0,14 ve +0,11 artarken UQ-classification için artışlar +0,11, +0,05 ve +0,07 olmuştur.
| Confidence percentile q | Reg. 5 s | Cls. 5 s | Reg. 10 s | Cls. 10 s | Reg. 15 s | Cls. 15 s |
|---|---|---|---|---|---|---|
| 0 — tüm tahminler | 0,42 | 0,45 | 0,41 | 0,45 | 0,40 | 0,45 |
| 10 | 0,44 | 0,46 | 0,43 | 0,45 | 0,42 | 0,46 |
| 20 | 0,46 | 0,47 | 0,45 | 0,46 | 0,44 | 0,46 |
| 30 | 0,48 | 0,47 | 0,47 | 0,47 | 0,46 | 0,47 |
| 40 | 0,49 | 0,48 | 0,48 | 0,47 | 0,47 | 0,47 |
| 50 | 0,50 | 0,49 | 0,49 | 0,48 | 0,47 | 0,48 |
| 60 | 0,51 | 0,50 | 0,50 | 0,48 | 0,48 | 0,48 |
| 70 | 0,52 | 0,51 | 0,51 | 0,49 | 0,48 | 0,49 |
| 80 | 0,54 | 0,53 | 0,52 | 0,50 | 0,49 | 0,50 |
| 90 — en güvenli %10 | 0,57 | 0,56 | 0,55 | 0,50 | 0,51 | 0,52 |
Classification full test set üzerinde regression'dan daha güçlüdür: directional macro F1 yaklaşık 0,45 iken regression 0,40–0,42 aralığındadır. Ancak confidence arttıkça regression aradaki farkı kapatmaktadır. En güvenli %10'da regression 5 ve 10 saniyede classification'ı geçerken 15 saniyede çok küçük farkla geride kalır: 0,51'e karşı 0,52.
Büyük hareketlerde sonuçlar
Large-move analizi:
\[ |y|>q_{67} \]
koşulunu kullanır. \(q_{67}\), gerçek displacement magnitude dağılımının yaklaşık üst üçte birlik sınırıdır.
| Horizon | Top %50 ↓ | Top %50 ↑ | Top %30 ↓ | Top %30 ↑ | Top %10 ↓ | Top %10 ↑ | Top %5 ↓ | Top %5 ↑ | Top %1 ↓ | Top %1 ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 0,69 | 0,63 | 0,73 | 0,67 | 0,81 | 0,75 | 0,84 | 0,79 | 0,88 | 0,83 |
| 10 s | 0,65 | 0,59 | 0,68 | 0,63 | 0,75 | 0,70 | 0,78 | 0,73 | 0,85 | 0,78 |
| 15 s | 0,65 | 0,52 | 0,68 | 0,53 | 0,74 | 0,59 | 0,76 | 0,61 | 0,81 | 0,68 |
Bu subset'te down ve up class dağılımı yaklaşık dengeli olduğundan prior-matched random reference yaklaşık 0,5'tir. Confidence arttıkça her üç horizon'da directional F1 yükselmektedir.
Neden %68 Aralık İyi Kalibre Olurken %95 Aralık Eksik Kapsıyor?
UQ-regression'ın calibration loss'u standardised residual'ın ilk mutlak momentini hedeflediği için yaklaşık bir-sigma düzeyini güçlü biçimde kalibre eder, fakat tick displacement dağılımının Gaussian'dan daha ağır kuyruklarını doğrudan modellemediğinden 1,96-sigma %95 aralığı nominal seviyenin altında kalır.
| Metrik | 5 s | 10 s | 15 s |
|---|---|---|---|
| Coverage 68 — nominal 0,68 | 0,682 | 0,682 | 0,681 |
| Coverage 95 — nominal 0,95 | 0,904 | 0,904 | 0,907 |
| Calibration error | 0,048 | 0,048 | 0,045 |
| NLPD | 5,278 | 5,586 | 5,778 |
Önemli tablo yorumu: Pooled coverage 0,682 iken calibration error'ın 0,048 olması çelişki değildir. Kaynak calibration error'ı asset bazında:
\[ |cov_{68}-0.68| \]
değerlerinin ortalaması olarak tanımlar. Pooled aggregate coverage farklı asset'lerdeki pozitif ve negatif sapmaları birbirini götürecek biçimde birleştirebilir; mean absolute asset-level deviation ise bunu yapmaz.
Yazarlar %95 undercoverage için future work olarak Student-t likelihood veya post-hoc conformal recalibration önermektedir.
Stationary F1 neden çöküyor?
| Metrik | Top %100 | Top %50 | Top %30 | Top %10 | Top %1 |
|---|---|---|---|---|---|
| F1 Down | 0,447 | 0,526 | 0,549 | 0,598 | 0,640 |
| F1 Up | 0,393 | 0,477 | 0,499 | 0,544 | 0,598 |
| F1 Stationary | 0,390 | 0,067 | 0,012 | 0,000 | 0,000 |
| Üç sınıflı Macro F1 | 0,410 | 0,357 | 0,353 | 0,381 | 0,413 |
Bu tablo çok önemli bir değerlendirme problemi gösterir. SNR gating, yüksek magnitude prediction'ları seçtiği için stationary örnekler retained subset'te giderek kaybolur. Böylece Down ve Up F1 yükselirken Stationary F1 sıfıra düşebilir. Bu nedenle üç-class macro F1, selective prediction'ın directional faydasını doğru yansıtmayabilir.
BTC üzerinde distribution shift
Yedi asset'in altısında training, validation ve test class proportions görece benzer kalırken BTC belirgin istisnadır.
BTC-USD 5 saniye horizon'da stationary class yaklaşık:
Training: %70
Test: %27
olmuştur.
10 saniyede training stationary yaklaşık %64 ve test %19; 15 saniyede training yaklaşık %57 ve test %15'tir.
Kaynak bu farkı volatility regime shift olarak yorumlamakta ve recent realised outcomes ile context conditioning kullanımının temel motivasyonlarından biri olarak göstermektedir. Bununla birlikte yazarlar daha uzun ve birden fazla regime içeren test döneminin robustness için gerekli olduğunu belirtmektedir.
Per-asset label threshold ve scale değerleri
| Asset | \(\sigma_h^{LR}\) | \(\tau_h^{LR}\) | \(y_{\mathrm{ref}}\) — tick | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | |
| BTC | 1,82e−4 | 2,63e−4 | 3,29e−4 | 4,85e−4 | 4,50e−5 | 6,60e−5 | 8,20e−5 | 1,21e−4 | 155 | 181 | 205 | 255 |
| DOGE | 3,65e−4 | 5,12e−4 | 6,25e−4 | 8,81e−4 | 9,10e−5 | 1,28e−4 | 1,56e−4 | 2,20e−4 | 187 | 277 | 352 | 507 |
| ETH | 3,14e−4 | 4,43e−4 | 5,42e−4 | 7,74e−4 | 7,80e−5 | 1,11e−4 | 1,36e−4 | 1,94e−4 | 42 | 56 | 69 | 96 |
| LTC | 3,70e−4 | 5,77e−4 | 6,11e−4 | 8,94e−4 | 9,20e−5 | 1,44e−4 | 1,53e−4 | 2,23e−4 | 2 | 2 | 2 | 3 |
| SOL | 3,58e−4 | 5,10e−4 | 6,18e−4 | 8,83e−4 | 8,90e−5 | 1,28e−4 | 1,55e−4 | 2,21e−4 | 3 | 3 | 4 | 6 |
| SUI | 5,09e−4 | 7,34e−4 | 8,79e−4 | 1,246e−3 | 1,27e−4 | 1,83e−4 | 2,20e−4 | 3,11e−4 | 3 | 5 | 6 | 9 |
| TAO | 5,01e−4 | 6,97e−4 | 8,39e−4 | 1,176e−3 | 1,25e−4 | 1,74e−4 | 2,10e−4 | 2,94e−4 | 628 | 953 | 1059 | 1596 |
30 saniyelik değerler label statistics içinde verilmiştir; ana makale deneyleri ise 5, 10 ve 15 saniye horizons üzerinde raporlanmaktadır.
Bu Çalışma Kârlı Bir Trading Stratejisi Kanıtlıyor mu?
Hayır. UQ-LOB çalışması directional reliability, displacement fit, uncertainty calibration ve confidence gating'i değerlendirir; gerçek portfolio P&L, fee-adjusted return, slippage, market impact veya canlı execution sonuçları ölçülmediği için çalışma kârlılık kanıtı olarak yorumlanamaz.
Çalışmanın desteklediği sonuçlar
- UQ-regression'ın %68 predictive interval coverage değeri nominal seviyeye çok yakındır.
- %95 Gaussian interval ağır kuyruklar nedeniyle nominal seviyenin altında coverage göstermiştir.
- SNR confidence gating, bütün üç horizon'da retained predictions'ın directional macro F1 değerini yükseltmiştir.
- UQ-classification softmax confidence da directional macro F1 için anlamlı bir ranking signal'dır.
- UQ-regression full test set üzerinde classification'dan daha düşük directional macro F1 üretse de en güvenli %10'da aradaki fark kapanmaktadır.
- Büyük hareketlerde yüksek SNR katmanları güçlü directional F1 değerlerine ulaşmıştır.
- Yakın geçmişte gerçekleşmiş context outcome'larının kullanılması future leakage'i önleyen açık causal constraint ile gerçekleştirilmiştir.
- UQ-regression ve UQ-classification neredeyse aynı parameter count ve aynı shared trunk üzerinde karşılaştırılmıştır.
Çalışmanın desteklemediği sonuçlar
- Modelin gerçek para ile kârlı olduğu gösterilmemiştir.
- Confidence gating'in transaction cost sonrası net getiri üreteceği kanıtlanmamıştır.
- %68 calibration bütün piyasa rejimlerinde kalıcı calibration garantisi değildir.
- %95 interval'ın nominal coverage sağladığı söylenemez; ölçülen coverage yaklaşık %90,4–90,7'dir.
- Encoder-agnostic tasarım bütün LOB encoder'larla deneysel olarak doğrulanmamıştır; çalışma D-TABL kullanmıştır.
- Sonuçlar başka borsa, başka asset class veya daha uzun horizon'lara otomatik olarak genellenemez.
- Model epistemic uncertainty'yi doğrudan çözmemektedir.
- Çalışma uzun dönem portfolio risk management veya optimal position sizing deneyi değildir.
Yazarların belirttiği sınırlılıklar ve gelecek çalışmalar
Tail calibration: Gaussian likelihood ağır kuyrukları yeterince temsil etmemektedir. Student-t likelihood veya conformal recalibration önerilmektedir.
Baseline kapsamı: Çalışma aynı shared trunk üzerindeki iki UQ head'i karşılaştırmaktadır. MC dropout, deep ensemble ve base encoder softmax gating gibi weight-space uncertainty baseline'larıyla kapsamlı karşılaştırma yapılmamıştır.
Multi-seed belirsizliği: Yazarlar çoklu seed error bar'larının ve loss/context ablation'larının gelecekte attribution'ı güçlendireceğini belirtmektedir.
Distribution shift: Özellikle BTC train/test class distribution'ında güçlü rejim farkı bulunmaktadır. Daha uzun, birden fazla regime kapsayan test süresi gereklidir.
Economic evaluation: Directional reliability değerlendirilmiştir; profitability değerlendirilmemiştir.
Scope: Modeller her asset ve horizon için ayrı eğitilmiştir ve tek trading venue kullanılmıştır. Cross-asset veya multi-horizon tek model test edilmemiştir.
Etik ve veri erişimi
Kaynak yalnız exchange'in public API'sinden alınan market data kullanıldığını ve personal data bulunmadığını belirtir. Model kısa vadeli fiyat hareketlerini tahmin ederek trading kararlarını etkileyebilir; yazarlar kârlılık iddiasında bulunmadıklarını ve finansal riskin devam ettiğini açıkça belirtmektedir.
Raw Kraken order-book verisi, exchange ile data-sharing agreement bulunmadığı gerekçesiyle yeniden dağıtılamamaktadır.
Reproducibility Statement complete source code'un, D-TABL encoder'ın, iki UQ head'in, training/evaluation pipeline'larının, context-construction prosedürünün, label thresholds'ın, scale değerlerinin ve dataset statistics'in yayımlandığını belirtmektedir. Ancak yüklenen PDF içinde public repository'nin doğrudan URL'si verilmemektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: UQ-LOB: Uncertainty-Aware Limit Order Book Mid-Price Forecasting
Yazarlar: Derrick Gilchrist Edward Manoharan; Eljas Linna; Kestutis Baltakys; Hao Dong; Juho Kanniainen.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Corresponding author: Derrick Gilchrist Edward Manoharan.
Eş katkı: Kaynakta equal-contribution beyanı görülmemektedir.
Kurum: Data Science Research Centre, Tampere University, Tampere, Finland.
Platform: arXiv.
Kategori: Computer Science — Artificial Intelligence (cs.AI).
arXiv kimliği: arXiv:2609.31491v2.
v1 gönderim tarihi: 25 Eylül 2026.
v2 revizyon tarihi: 28 Eylül 2026.
Kaynak türü: Preprint.
Hakemlik: Yüklenen v2 arXiv preprint'tir; 21 Kasım 2026 itibarıyla hakemli dergi Version of Record sürümü doğrulanmamıştır.
arXiv/DataCite DOI: 10.48550/arXiv.2609.31491. Bu tanımlayıcı bir journal DOI'si değildir.
Resmî bağlantı: https://arxiv.org/abs/2609.31491v2
Kaynak lisansı: Yüklenen PDF üzerinde açık Creative Commons yeniden kullanım lisansı doğrulanmamıştır. Bu nedenle kaynak şekiller doğrudan kullanılmamış veya stil transferiyle yeniden üretilmemiştir.
Finansman: Yüklenen PDF'de ayrı bir funding statement tespit edilmemiştir.
Çıkar çatışması: Yüklenen PDF'de ayrı bir competing-interest/conflict-of-interest statement tespit edilmemiştir.
Yazar katkıları: Yüklenen PDF'de ayrı CRediT author-contribution bildirimi bulunmamaktadır.
Veri kaynağı: Kraken cryptocurrency exchange public market-data API; Level-2 ve Level-3 order-book data.
Raw veri erişimi: Raw data yeniden dağıtılmamaktadır; kaynak bunun nedenini exchange ile data-sharing agreement bulunmaması olarak açıklar.
Kod: Reproducibility Statement complete source code'un yayımlandığını belirtmektedir; ancak PDF içinde doğrulanabilir repository URL'si verilmemiştir.
Assets: BTC, ETH, SOL, LTC, DOGE, SUI, TAO.
Ana prediction horizons: 5 s, 10 s, 15 s.
Label statistics ek horizon: 30 s değerleri Appendix Table 7'de ayrıca verilmiştir; ana experiment result'ları 5/10/15 saniyedir.
Input window: 512 non-overlapping order-book event.
Context: 15 causal context window + 1 withheld target.
Encoder: D-TABL; üç bilinear layer + terminal temporal-attention-augmented bilinear layer.
UQ-regression: Gaussian predictive distribution \(\mathcal{N}(\mu,\sigma^2)\).
UQ-classification: Down / Up / Stationary categorical prediction.
Regression confidence: \(SNR=|\mu|/\sigma\).
Classification confidence: Maximum softmax probability.
Optimizer: AdamW.
Donanım: NVIDIA GH200 Grace Hopper Superchip.
Pipeline training maliyeti: Appendix hesabına göre yaklaşık 78,75 GPU-hour D-TABL pretraining + 105 GPU-hour UQ-regression + 105 GPU-hour UQ-classification = yaklaşık 289 GPU-hour. Ana metindeki yaklaşık 210 GPU-hour ifadesi iki UQ variant'ının toplam fine-tuning maliyetiyle uyumludur.
Temel calibration sonucu: %68 nominal interval için 0,681–0,682 coverage; %95 nominal interval için 0,904–0,907 coverage.
Temel selective-prediction sonucu: En güvenli %10'a geçildiğinde UQ-regression directional macro F1 5/10/15 saniyede sırasıyla 0,57 / 0,55 / 0,51; UQ-classification 0,56 / 0,50 / 0,52.
Large-move sonucu: 5 saniyede en güvenli %1 UQ-regression F1: down 0,88; up 0,83.
Temel bilimsel sınır: Çalışma predictive confidence ve directional reliability'yi değerlendirir; gerçek trading profitability, fee-adjusted P&L, slippage veya market impact ölçmez.
Önemli yeniden üretilebilirlik sınırı: Raw market data yeniden dağıtılamamaktadır. Bununla birlikte kaynak model specification, label procedure, dataset statistics, scale/threshold değerleri ve kodun yayımlandığını belirtmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir