


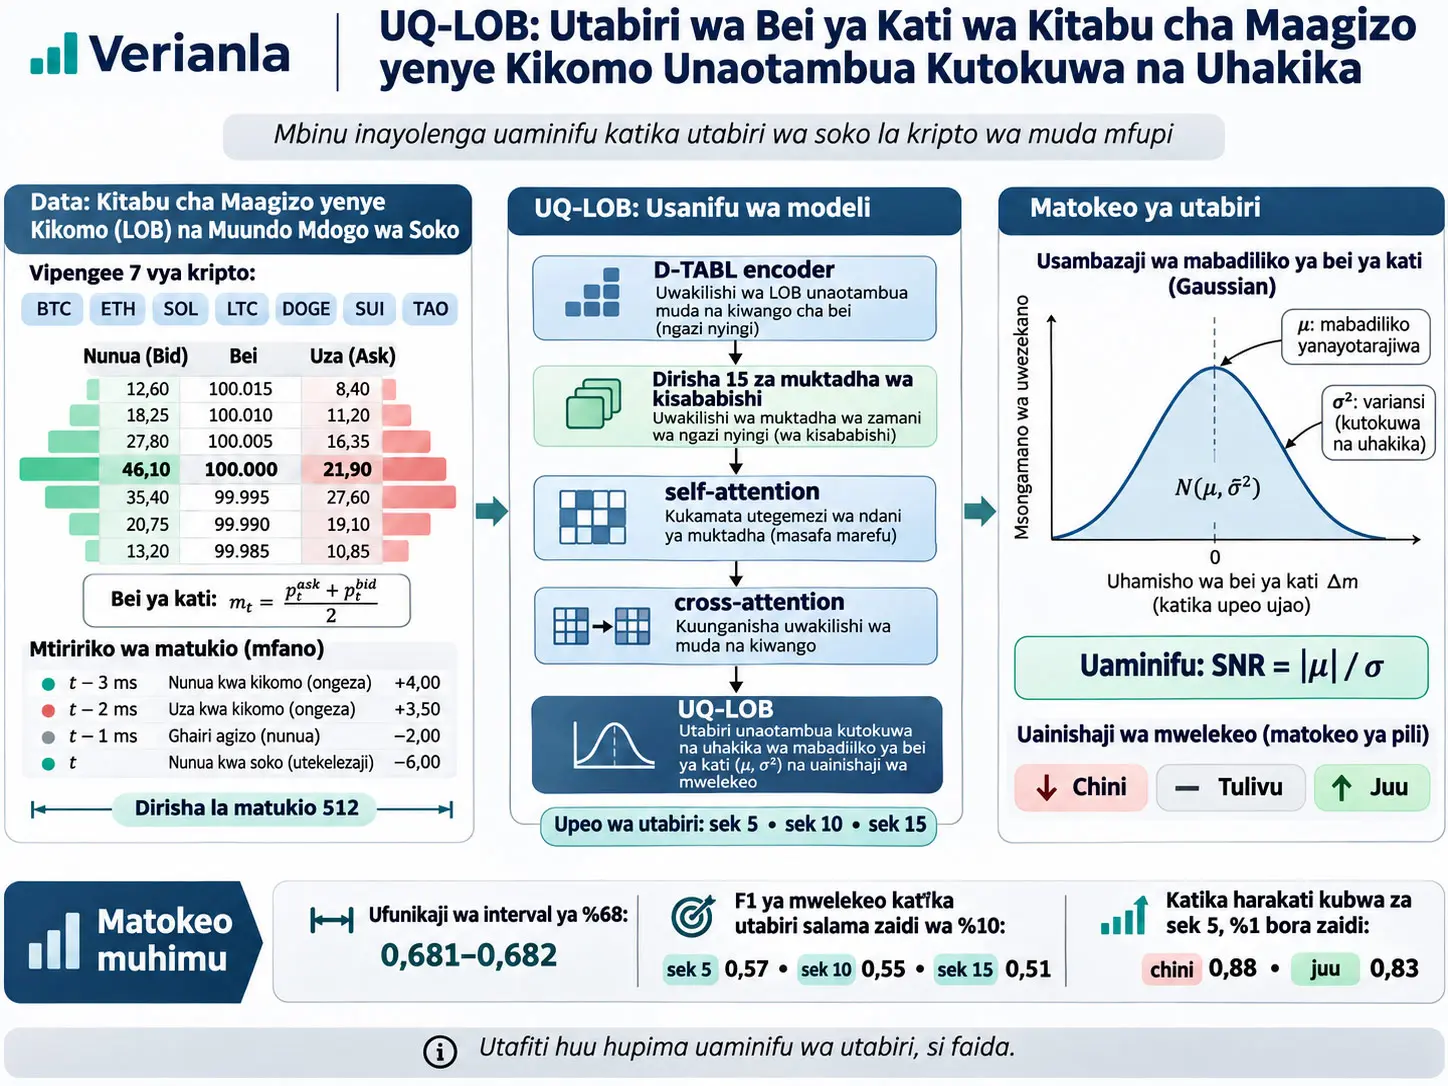
UQ-LOB ni moduli ya ukadiriaji wa kutokuwa na uhakika isiyotegemea encoder, inayoongezwa juu ya uwakilishi fiche wa encoder ya kitabu cha maagizo yenye kikomo (Limit Order Book, LOB) iliyofunzwa awali, na inayomodeli si mwelekeo au mabadiliko ya bei pekee bali pia kiwango cha kuaminika kwa utabiri. Katika utafiti, UQ-regression huzalisha Gaussian predictive distribution ya umbo \(\mathcal{N}(\mu,\sigma^2)\) kwa mabadiliko ya bei ya kati ya baadaye, huku UQ-classification ikizalisha categorical distribution kwa madarasa ya chini, juu na stationary. Kipimo cha confidence cha UQ-regression ni signal-to-noise ratio (SNR) \(|\mu|/\sigma\), na kipimo cha confidence cha UQ-classification ni thamani ya juu zaidi ya softmax class probability.
Utafiti unatumia takribani matukio bilioni 5,2 ya Level-2 na Level-3 order-book yaliyokusanywa kutoka public market-data API ya Kraken cryptocurrency exchange. Asset saba zinazotajwa kwa USD—Bitcoin, Ethereum, Solana, Litecoin, Dogecoin, Sui na Bittensor—zimeundwa modeli kila moja kwa horizon za utabiri za sekunde 5, 10 na 15. Kila input ina matukio 512 mfululizo ya order-book. Modeli hujaribu kujirekebisha kwa regime ya sasa ya soko bila gradient update, kwa kutumia context window 15 zilizokamilika kabla ya target window na ambazo matokeo yake tayari yametokea wakati wa utabiri.
Nominal %68 predictive interval ya UQ-regression imebaki karibu sana na kiwango nominal kwa kutoa empirical coverage ya %68,1–68,2 katika test. Kwa upande mwingine, nominal %95 interval imetoa coverage ya %90,4–90,7 pekee, ikionyesha kwamba modeli haikuweza kufunika vya kutosha heavy tails za distribution chini ya Gaussian assumption. Kwa confidence gating, wakati utabiri salama zaidi wa %10 pekee ulihifadhiwa, directional macro F1 ya UQ-regression iliongezeka kutoka 0,42 hadi 0,57 kwa sekunde 5, kutoka 0,41 hadi 0,55 kwa sekunde 10, na kutoka 0,40 hadi 0,51 kwa sekunde 15.
Katika movement halisi kubwa, yaani katika sampuli zilizo kwenye theluthi ya juu ya magnitude ya displacement halisi, tabaka salama zaidi la %1 la UQ-regression lilipata F1 ya 0,88 kwa mwelekeo wa chini na 0,83 kwa mwelekeo wa juu katika sekunde 5. Hata hivyo, utafiti haupimi trading profitability halisi, net return, transaction-cost-adjusted P&L au live execution performance. Matokeo yamewekewa mipaka kwenye uaminifu wa utabiri wa mwelekeo wa bei wa muda mfupi na displacement.
UQ-LOB ni nini na inatofautianaje na point prediction?
UQ-LOB ni uncertainty-quantification head inayohesabu probabilistic distribution ya utabiri na uncertainty maalumu kwa sampuli, pamoja na LOB encoder kutoa mwelekeo mmoja wa bei au displacement value; UQ-regression huzalisha \(\mu\) na \(\sigma^2\) kwa tick displacement ya baadaye, huku UQ-classification ikizalisha probability distribution kwa directional class tatu.
Limit Order Book na mid-price ni nini?
Limit Order Book ni utaratibu wa soko katika soko la kielektroniki unaohifadhi maagizo ya kununua na kuuza ambayo bado hayajatekelezwa kulingana na viwango vya bei. Bei ya juu zaidi ya kununua huitwa best bid, na bei ya chini zaidi ya kuuza huitwa best ask. Tofauti kati ya bei hizi mbili ni spread.
mid-price ambayo utafiti unajaribu kutabiri ni sehemu ya kati kati ya best bid na best ask. Kidhana:
\[ p_{\mathrm{mid}} = \frac{p_{\mathrm{bid}}+p_{\mathrm{ask}}}{2}. \]
Mlinganyo huu si mojawapo ya milinganyo ya utafiti iliyopewa nambari katika makala; ni ufafanuzi wa msingi uliotolewa ili msomaji aelewe dhana ya mid-price.
Kwa nini mwelekeo wa bei pekee hautoshi?
Modeli inaweza kusema “bei itapanda”; lakini utabiri mbili tofauti zinaweza kuonyesha mwelekeo ule ule bila kuwa na kiwango sawa cha kuaminika. UQ-LOB hushughulikia tatizo hili kupitia input-dependent aleatoric uncertainty. Hapa aleatoric uncertainty inawakilisha uncertainty maalumu kwa sampuli iliyo ndani ya uchunguzi wa soko wenyewe. Utafiti huu haumodeli moja kwa moja epistemic uncertainty, yaani kutokujulikana kwa vigezo vya modeli.
Badala ya point estimate, UQ-regression huunda:
\[ y^t \mid h^t,\mathcal{C} \sim \mathcal{N}(\mu,\sigma^2) \]
predictive distribution ya aina hii. \(\mu\) ni thamani ya kati ya tick displacement inayotabiriwa; \(\sigma\) inaonyesha uncertainty ya utabiri.
Kwa nini context set inatumika?
Financial microstructure inaweza kubadilika hata ndani ya siku hiyo hiyo. Badala ya kufanya target prediction kupitia target hidden representation pekee, UQ-LOB hutumia kama context sampuli zilizokamilika katika siku za karibuni na ambazo outcome zake tayari zinajulikana wakati wa utabiri.
Target instance moja ina jumla ya:
\[ N=C+1 \]
window. Katika utafiti:
\[ C=15, \qquad N=16. \]
Kwa hiyo, context window 15 na withheld target window 1 huchakatwa pamoja.
Mlinganyo 1: Sharti la causal context linalozuia future leakage
\[ e_i^c = t_i^c+d+h \le t, \qquad \forall i\in\{1,\ldots,C\}. \tag{1} \]
Unahesabu nini? Huangalia kama outcome label ya context window imetokea kikamilifu kabla ya \(t\), ambayo ni wakati wa target prediction.
\(t_i^c\): muda wa event ya mwisho ya context window.
\(d\): execution latency; katika jaribio ni sekunde 0,0005.
\(h\): prediction horizon; katika majaribio makuu ni sekunde 5, 10 au 15.
\(e_i^c\): wakati ambapo context label imetokea kikamilifu.
Haitoshi kwamba input window iwe kabla ya target pekee. Ikiwa label horizon ya context itapita \(t\), taarifa za baadaye zinaweza kuvuja kwenye utabiri. Mlinganyo 1 huzuia hilo.
Mlinganyo 2: Context representation
Hidden representations hupitishwa kwanza kwenye projection space ya pamoja. Context label hupimwa kwa asset/horizon-specific \(y_{\mathrm{ref}}\) na kupitishwa kwenye tanh-bounded projection.
Kila context point:
\[ r_i = \mathrm{MLP}_{\mathrm{enc}} \left( [\tilde{h}_i^c;y_i^{\mathrm{proj}}] \right), \qquad i=1,\ldots,C. \tag{2} \]
hubadilika kuwa context representation katika umbo hili.
\(\tilde{h}_i^c\) ni projected form ya encoder hidden representation. \(y_i^{\mathrm{proj}}\) ni projected form iliyopimwa ya context label iliyotokea. Mabano ya mraba yanamaanisha concatenation.
Mlinganyo 3: Target kutumia cross-attention kwa context
Baada ya self-attention kupima upya thamani za \(r_i\) ndani ya context set kulingana na nyingine, target embedding husoma context kama query:
\[ r^t = \operatorname{softmax} \left( \frac{qK^\top}{\sqrt{d_r}} \right)V. \tag{3} \]
Hapa:
\[ q=W_q\tilde{h}^t, \qquad k_i=W_k\tilde{h}_i^c, \qquad v_i=r_i^{\mathrm{ref}}. \]
\(K\) hukusanya context keys kwa safu; \(V\) hukusanya refined context values kwa safu. \(d_r=256\) ni attention dimension.
Maana ya kialgorithm ya utaratibu huu ni kwamba context window zote za zamani hazichukuliwi kuwa sawa. Miundo ya context inayofaa zaidi kwa target representation inaweza kupata attention ya juu zaidi.
Regression na Classification Hutenganishwaje katika Usanifu wa UQ-LOB?
UQ-regression na UQ-classification hushiriki D-TABL encoder, projection, context encoder, self-attention na cross-attention trunk ile ile; decoder ya mwisho pekee ndiyo hubadilika: regression decoder huzalisha \(\mu\) na parameter ya variance, huku classification decoder ikizalisha logit tatu kwa down/up/stationary.
Mlinganyo 4: Uzalishaji wa variance wa regression decoder
\[ [\mu,\nu] = \mathrm{MLP}_{\mathrm{dec}} ([r^t;\tilde{h}^t]), \qquad \sigma^2 = y_{\mathrm{ref}}^2 \operatorname{softplus}(\nu) + \epsilon. \tag{4} \]
\(\mu\) ni predicted tick displacement; \(\nu\) ni parameter ghafi inayozalishwa na decoder kwa variance; \(\sigma^2\) ni predictive variance chanya; \(y_{\mathrm{ref}}\) ni asset/horizon-specific tick scale na \(\epsilon=10^{-8}\) ni numerical stability floor.
Matumizi ya Softplus huzuia variance kuwa hasi. \(y_{\mathrm{ref}}^2\) hurudisha variance kwenye tick scale ya asset na horizon husika.
Mlinganyo 5: Hasara ya jumla ya UQ-regression
\[ \mathcal{L}_{\mathrm{reg}} = \lambda_1\mathcal{L}_{\mathrm{NLL}} + \lambda_2\mathcal{L}_{\mathrm{WMAE}} + \lambda_3\mathcal{L}_{\mathrm{dir}} + \lambda_4\mathcal{L}_{\mathrm{calib}}. \tag{5} \]
Uzani uliotumika katika chanzo:
\[ (\lambda_1,\lambda_2,\lambda_3,\lambda_4) = (1.0,0.1,0.5,0.5). \]
Kazi za terms nne ni tofauti: NLL hujifunza mean na variance kwa probabilistic; WMAE huongeza athari ya displacement kubwa; directional loss husaidia directional class; calibration loss hulazimisha predicted uncertainty kuendana na magnitude ya residual iliyotokea.
Heteroscedastic Gaussian NLL
\[ \mathcal{L}_{\mathrm{NLL}} = \mathbb{E} \left[ \frac{1}{2}\log(2\pi\sigma^2) + \frac{(y-\mu)^2}{2\sigma^2} \right]. \]
Heteroscedastic inamaanisha kwamba \(\sigma\) si thamani ile ile isiyobadilika kwa kila input. Modeli inaweza kutoa uncertainty ndogo katika window fulani na uncertainty kubwa katika nyingine.
Tatizo linalojulikana la muundo huu ni loss attenuation. Modeli inaweza kupunguza adhabu ya squared residual katika sampuli ngumu kwa kuongeza \(\sigma\). Kwa sababu:
\[ \frac{\partial\mathcal{L}_{\mathrm{NLL}}}{\partial\mu} \propto \frac{1}{\sigma^2}. \]
Ikiwa \(\sigma\) inakuwa kubwa kupita kiasi, gradient inayofika kwa \(\mu\) inaweza kupungua. Chanzo hutumia WMAE na directional loss kwa sehemu dhidi ya tatizo hili.
Mlinganyo 6: Magnitude-weighted MAE
\[ \mathcal{L}_{\mathrm{WMAE}} = \mathbb{E} \left[ w(y) \frac{|\mu-y|}{y_{\mathrm{ref}}} \right], \tag{6} \]
\[ w(y) = \min \left( 1+ \left( \frac{|y|}{y_{\mathrm{ref}}} \right)^p, w_{\max} \right). \]
Katika chanzo:
\[ p=4, \qquad w_{\max}=40. \]
Kadiri displacement inavyoongezeka, \(w(y)\) huongezeka; hivyo regression error ya movement kubwa za bei hupata uzani wa juu kuliko movement ndogo. \(w_{\max}=40\) huweka kikomo ili sampuli za extremo zisitawale loss peke yake.
Mlinganyo 7: Directional loss
\[ \mathcal{L}_{\mathrm{dir}} = \mathbb{E} \left[ \mathbf{1}[|y_i|\ge\delta_i] \left( \tilde{\mu}_i-\operatorname{sign}(y_i)m \right)^2 + \mathbf{1}[|y_i|\lt\delta_i] \left| \tilde{\mu}_i-\operatorname{sign}(y_i)m \right| \right]. \tag{7} \]
Hapa:
\[ \tilde{\mu}_i=\frac{\mu_i}{y_{\mathrm{ref}}}, \qquad m=1. \]
\(\delta_i\) ni directional/stationary threshold kwa asset, horizon na window husika.
Wakati displacement halisi inapovuka directional threshold, quadratic penalty hutumika na predicted mean huvutwa kwa nguvu zaidi kuelekea lengo lenye ishara sahihi \(\pm m\). Kwa sampuli stationary, linear penalty hutumika; hivyo taarifa ya sign huhifadhiwa bila kutumia mvuto mkali ule ule kwenye magnitude.
Mlinganyo 8: Magnitude-conditional calibration loss
\[ \mathcal{L}_{\mathrm{calib}} = \frac{1}{B} \sum_{b=1}^{B} \left( \mathbb{E}_{i\in\mathcal{B}_b} \left[ \frac{|\mu_i-y_i|}{\sigma_i} \right] - \sqrt{\frac{2}{\pi}} \right)^2. \tag{8} \]
Katika chanzo:
\[ B=3. \]
\(\mathcal{B}_b\) ni quantile bins zilizoundwa kulingana na thamani za predicted magnitude \(|\mu|\). Kwa standard normal:
\[ Z\sim\mathcal{N}(0,1) \]
kwa:
\[ \mathbb{E}|Z| = \sqrt{\frac{2}{\pi}}. \]
Katika Gaussian model iliyokalibishwa, thamani inayotarajiwa ya standardised absolute residual inapaswa kukaribia lengo hili. Loss hulazimisha hili si kwa global pekee bali pia kwa kila tabaka la predicted magnitude.
UQ-classification loss
Classification decoder hutumia weighted cross-entropy kwa class tatu:
\[ \mathcal{L}_{\mathrm{cls}} = - \sum_{c=0}^{2} w_c \mathbf{1}[y_{\mathrm{cls}}=c] \log p_c. \]
Class weight:
\[ w_c\propto\frac{1}{f_c}, \qquad \sum_c w_c=3. \]
\(f_c\) ni class frequency ndani ya training split. Class adimu hupata weight ya juu zaidi.
Selective Prediction kwa SNR Inamaanisha Nini?
Katika UQ-regression, confidence hufafanuliwa kama \(SNR=|\mu|/\sigma\); modeli inapohifadhi utabiri wenye SNR ya juu pekee, huchagua sampuli ambazo predicted displacement magnitude ni kubwa na predicted uncertainty ni ndogo kwa kulinganisha, hivyo coverage hupungua huku directional reliability ya utabiri uliobaki ikiongezeka.
Regression confidence
\[ SNR = \frac{|\mu|}{\sigma}. \]
\(|\mu|\) kubwa na \(\sigma\) ndogo huzalisha SNR ya juu. SNR haina kipimo kwa sababu numerator na denominator zina kitengo kile kile cha tick-displacement.
Classification confidence
\[ Confidence_{\mathrm{cls}} = \max_c p_c. \]
Kwa classification, thamani ya juu zaidi ya softmax probability ya modeli hutumika kama confidence.
Percentile gating
Confidence percentile \(q\) huhifadhi utabiri salama zaidi wa:
\[ (100-q)\% \]
katika test set.
Kwa mfano:
\[ q=90 \]
mstari huu unamaanisha kwamba utabiri salama zaidi wa %10 unatathminiwa.
Kwa nini directional macro F1 hutumika badala ya macro F1 ya class tatu?
Kwa kuwa confidence gating huchagua high-magnitude predictions, uwiano wa stationary predictions ndani ya retained subset hupungua haraka. Kwa hiyo stationary F1 inaweza kukaribia sifuri hata ikiwa modeli inakuwa bora katika directional prediction.
Kwa sababu hii chanzo hutumia:
\[ F1_{\mathrm{directional}} = \frac{ F1_{\mathrm{down}} + F1_{\mathrm{up}} }{2} \]
kipimo hiki kama gating metric kuu.
Kwa full test set, thamani inayotarajiwa ya directional macro F1 ya prior-matched random classifier ni:
\[ \frac{1-p_{\mathrm{stat}}}{2}. \]
Hata hivyo, kwa kuwa gating hubadilisha class composition, full-set random reference haiwezi kuhamishwa moja kwa moja kwenye gated subsets.
Predictive interval coverage
Kwa nominal %68 interval:
\[ cov_{68} = \Pr \left[ |y-\mu| \le \sigma \right]. \]
Kwa nominal %95 interval:
\[ cov_{95} = \Pr \left[ |y-\mu| \le 1.96\sigma \right]. \]
Mlinganyo 9: Magnitude-weighted \(R^2\)
\[ R_w^2 = 1- \frac{ \sum_i w_i(y_i-\mu_i)^2 }{ \sum_i w_i(y_i-\bar{y}_w)^2 }, \tag{9} \]
\[ \bar{y}_w = \frac{ \sum_i w_i y_i }{ \sum_i w_i }. \]
Hapa \(w_i=w(y_i)\) ni magnitude weight katika Mlinganyo 6. Kwa hiyo displacement kubwa huwa na athari kubwa zaidi kuliko katika standard \(R^2\).
Order-book input ina taarifa gani?
Kila event huwakilishwa kwa discrete token na continuous feature saba. Token vocabulary ina jumla ya entry 439 na huundwa kutoka categorical attribute tano:
- event type,
- side,
- discretised volume,
- discretised price distance kulingana na opposing best quote,
- simultaneity flag.
Kwa order-book depth:
\[ L_{\max}=10. \]
Event zilizo ndani zaidi huondolewa.
Continuous feature saba:
- log inter-event time,
- log tick distance kulingana na opposing best quote,
- log relative volume,
- DNFI,
- cumulative DNFI juu ya event 50 za mwisho,
- cumulative DNFI juu ya event 200 za mwisho,
- QI.
Mlinganyo 10: Depth-normalised flow imbalance na queue imbalance
\[ \mathrm{DNFI}_t = \frac{ \Delta Q_{1,t}^{b} - \Delta Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1], \]
\[ \mathrm{QI}_t = \frac{ Q_{1,t}^{b} - Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1]. \tag{10} \]
\(Q_{1,t}^{b}\) ni resting queue size kwenye kiwango cha best bid; \(Q_{1,t}^{a}\) ni resting queue size kwenye kiwango cha best ask.
DNFI hutumia mabadiliko ya queue size ikilinganishwa na event iliyotangulia na kuwakilisha dynamic order-flow pressure. QI huonyesha static asymmetry kati ya bid na ask liquidity iliyopo kwenye book kwa wakati huo huo.
D-TABL encoder
Ingawa utafiti unasema UQ-LOB ni encoder-agnostic, experimental implementation ilifanywa kwa D-TABL encoder pekee. D-TABL ni variant ya kina zaidi ya Temporal Attention-Augmented Bilinear Network iliyorekebishwa kwa input ya event 512.
Badala ya BL layer mbili katika muundo wa asili wa C(TABL), BL layer tatu zilitumika na kisha terminal TABL layer ikaongezwa.
Mlinganyo 11: Bilinear layer
\[ Y = \phi \left( W_1 X W_2+B \right). \tag{11} \]
\[ X\in\mathbb{R}^{D\times T} \]
ni input matrix. \(W_1\) huproject feature axis, na \(W_2\) huproject temporal axis. \(B\) ni learned bias na \(\phi\) ni ReLU activation.
Mlinganyo 12: Temporal attention-augmented bilinear transformation
Kwanza:
\[ \bar{X}=W_1X \]
huhesabiwa. Attention score:
\[ E=\bar{X}W \]
na kwa row-wise softmax:
\[ \alpha_{ij} = \frac{ \exp(e_{ij}) }{ \sum_k\exp(e_{ik}) } \]
huunda attention matrix \(A\).
Kisha:
\[ \tilde{X} = \lambda (\bar{X}\odot A) + (1-\lambda)\bar{X}, \qquad Y = \phi (\tilde{X}W_2+B). \tag{12} \]
\(\lambda\in[0,1]\) ni learned mixing coefficient kati ya attention-masked representation na original projected representation.
Mlinganyo 13: Kuunganisha discrete token embedding na continuous features
Token embedding table:
\[ E\in\mathbb{R}^{439\times8}. \]
Kwa token \(k\):
\[ e_k = E[k,:] \in \mathbb{R}^{8}. \]
Continuous feature saba pamoja na token embedding yenye vipimo nane:
\[ x_t = [x_t^{\mathrm{cont}};e_{k_t}] \in \mathbb{R}^{15}, \qquad t=1,\ldots,512. \tag{13} \]
huunganishwa katika umbo hili.
Hivyo window nzima:
\[ X\in\mathbb{R}^{15\times512} \]
ina vipimo hivi.
Regression label huundwaje?
Muda wa event ya mwisho ya window ni \(t\). Kwa kudhani kwamba modeli haiwezi kutekeleza muamala mara moja kinadharia, latency ndogo:
\[ d=0.0005\,\mathrm{s} \]
huongezwa.
\[ t_{\mathrm{start}} = t+d. \]
\(p_{\mathrm{start}}\) ni thamani ya mid-price ya event ya kwanza inayoonekana wakati wa au baada ya \(t_{\mathrm{start}}\).
Prediction horizon:
\[ t_{\mathrm{end}} = t_{\mathrm{start}}+h. \]
Mlinganyo 14: End price smoothing
Kwa kuwa bei ya event moja inaweza kuwa nyeti kupita kiasi kwa microstructure noise, wastani wa mid-price wa event \(t_{\mathrm{end}}\) zilizo kabla tu ya \(k=10\) huchukuliwa:
\[ p_{\mathrm{end}} = \frac{1}{k} \sum_{j\in\mathcal{K}} p_j, \tag{14} \]
\[ \mathcal{K} = \{ \text{\(t_j\le t_{\mathrm{end}}\) koşulunu sağlayan en büyük zamanlı \(k\) event} \}. \]
Regression target:
\[ y_h(t) = p_{\mathrm{end}} - p_{\mathrm{start}}. \]
Kitengo ni tick displacement.
Mlinganyo 15: Classification threshold
Kwa kila asset na horizon, standard deviation ya mid-price log-return ya sekunde \(h\) ndani ya training split:
\[ \sigma_h^{\mathrm{LR}} \]
huhesabiwa.
Threshold:
\[ \tau_h^{\mathrm{LR}} = \alpha \sigma_h^{\mathrm{LR}}. \tag{15} \]
Katika chanzo:
\[ \alpha=0.25. \]
Log-return threshold hubadilishwa kuwa tick displacement kulingana na price level ya sasa:
\[ \delta_h(t) = p_{\mathrm{start}} \left[ \exp(\tau_h^{\mathrm{LR}}) - 1 \right]. \]
Mlinganyo 16: Down / up / stationary label
\[ c = \begin{cases} 1\;(\mathrm{up}), & y_h(t)\ge\delta_h(t) \\ 0\;(\mathrm{down}), & y_h(t)\le-\delta_h(t) \\ 2\;(\mathrm{stationary}), & \mathrm{otherwise}. \end{cases} \tag{16} \]
Pande zote mbili za threshold ni symmetric. Ikiwa positive threshold imevukwa, label ya up hupewa; ikiwa negative threshold imevukwa, down hupewa; ikiwa ipo katikati, stationary hupewa.
Mlinganyo 17: Threshold calibration ya kulinganisha regression mean na classification
Wakati regression mean \(\mu\) inabadilishwa kuwa tathmini ya class tatu, multiplier ya ziada \(k^*\) hutumika kwenye threshold:
\[ \delta_h^\mu(t) = p_{\mathrm{start}} \left[ \exp(k^*\tau_h^{\mathrm{LR}}) - 1 \right]. \]
\(k^*\) huchaguliwa katika nusu tofauti ya calibration ya validation period kama:
\[ k^* = \arg\min_k \left| \Pr [ |\mu| \lt \delta_h^{\mu,k}(t) ] - \Pr [ |y_h(t)| \lt \delta_h(t) ] \right|. \tag{17} \]
huchaguliwa.
Lengo ni kuleta uwiano wa stationary class unaopatikana kutoka regression predictions karibu na stationary proportion halisi. Calibration hufanywa kulingana na true class distribution, si class distribution ya classification head yenyewe.
Mbinu na Matokeo ya Utafiti
Chanzo cha data na mgawanyo wa muda
Utafiti unatumia Level-2 na Level-3 order-book data kutoka public market-data API ya Kraken cryptocurrency exchange.
| Kipengele | Thamani iliyotolewa katika chanzo |
|---|---|
| Jumla ya event | Takribani bilioni 5,2 |
| Jumla ya asset-day | Takribani 600 |
| Assets | BTC, ETH, SOL, LTC, DOGE, SUI, TAO |
| Market | Kraken |
| Quote currency | USD |
| Kipindi cha data | Novemba 2025 – Februari 2026 |
| Training | Hadi 18 Januari 2026 |
| Validation | 19–31 Januari 2026 |
| Test | 1–15 Februari 2026 |
| Takriban split | %68 train / %15 validation / %17 test asset-days |
| Horizon kuu | 5 s / 10 s / 15 s |
Validation period imegawanywa katika sehemu mbili sawa: nusu ya kwanza hutumika kwa model selection, na nusu ya pili kwa threshold multiplier calibration katika Mlinganyo 17. Test period iko baada ya hatua zote mbili za validation kwa mpangilio wa muda.
Msongamano wa data kwa asset
| Asset | Tick ($) | Siku | Event (bilioni) | Event/siku (milioni) | Event/s | Wastani IET (ms) | 5 s event | 10 s event | 15 s event |
|---|---|---|---|---|---|---|---|---|---|
| BTC | 0,10 | 94 | 1,254 | 13,338 | 156 | 6,42 | 780 | 1560 | 2340 |
| ETH | 0,01 | 70 | 0,903 | 12,899 | 151 | 6,61 | 755 | 1510 | 2265 |
| DOGE | 1,0×10⁻⁷ | 97 | 1,124 | 11,587 | 134 | 7,46 | 670 | 1340 | 2010 |
| SOL | 0,01 | 78 | 0,539 | 6,909 | 80 | 12,50 | 400 | 800 | 1200 |
| TAO | 0,0001 | 84 | 0,577 | 6,870 | 80 | 12,58 | 400 | 800 | 1200 |
| SUI | 0,0001 | 94 | 0,523 | 5,565 | 64 | 15,52 | 320 | 640 | 960 |
| LTC | 0,01 | 83 | 0,276 | 3,326 | 39 | 25,97 | 195 | 390 | 585 |
Horizon ile ile ya sekunde 15 ina wastani wa takribani event 2340 kwa BTC lakini takribani event 585 kwa LTC. Kwa hiyo, horizon ile ile kwa sekunde ina maana ya information density tofauti katika asset tofauti.
Idadi ya parameter za modeli
| Kipengele | Parameter |
|---|---|
| D-TABL encoder — shared | 268.356 |
| Feature projection — shared | 24.704 |
| CNP context / attention trunk — shared | 766.784 |
| Regression decoder | 165.378 |
| Classification decoder | 165.731 |
| Jumla regression variant | 1.225.222 |
| Jumla classification variant | 1.225.575 |
Parameter count ya variant mbili ni karibu sawa. Hivyo kulinganisha regression confidence na classification confidence hakuwezi kuelezwa kwa tofauti kubwa ya model capacity.
Mkakati wa training
Training hufanyika katika hatua mbili.
- Kwa kila asset-horizon pair, D-TABL encoder hufanyiwa pretrain kwenye classification task ya class tatu.
- UQ-regression au UQ-classification head huongezwa kwenye encoder checkpoint na kufanyiwa end-to-end fine-tune pamoja na encoder.
Asset saba × horizon kuu tatu:
\[ 7\times3=21 \]
huunda asset-horizon pair.
Kwa kila pair, regression na classification:
\[ 21\times2=42 \]
UQ model variant hufunzwa.
Takribani 210 GPU-hour katika matini kuu inaendana na iliyoripotiwa katika appendix kwa UQ variant mbili:
\[ 105+105=210 \]
GPU-hour. Appendix pia inaripoti takribani 78,75 GPU-hour kwa base D-TABL pretraining na inatoa training pipeline nzima kama takribani:
\[ 78.75+105+105 = 288.75 \approx289 \]
GPU-hour.
Hyperparameters
| Kundi | Parameter | Thamani |
|---|---|---|
| Input | Window length \(L\) | 512 event |
| Input | Vocabulary \(|\mathcal{V}|\) | 439 |
| Input | Token embedding dimension | 8 |
| Input | Continuous features | 7 |
| Input | Max order-book depth \(L_{\max}\) | 10 |
| Label | Latency \(d\) | 0,0005 s |
| Label | End-price smoothing \(k\) | 10 event |
| Label | Threshold multiplier \(\alpha\) | 0,25 |
| Head | Context size \(C\) | 15 |
| Head | Instances per batch | 16 |
| Head | Projection dimension | 128 |
| Head | Attention dimension \(d_r\) | 256 |
| Head | Attention heads | 4 |
| Head | Context encoder depth | 3 GELU MLP layer |
| Head | Decoder depth | 5 GELU MLP layer |
| Regression | \((\lambda_1,\lambda_2,\lambda_3,\lambda_4)\) | (1,0; 0,1; 0,5; 0,5) |
| Regression | WMAE exponent \(p\) | 4 |
| Regression | \(w_{\max}\) | 40 |
| Regression | Directional margin \(m\) | 1,0 |
| Regression | Calibration bins \(B\) | 3 |
| Regression | Variance floor \(\epsilon\) | \(1\times10^{-8}\) |
| Optimisation | Optimizer | AdamW |
| Optimisation | Encoder learning rate | \(1\times10^{-5}\) |
| Optimisation | Head learning rate | \(5\times10^{-5}\) |
| Optimisation | Weight decay | 0 |
| Optimisation | Warmup | LinearLR, 10k step |
| Optimisation | Cosine restart \(T_0\) | 15k |
| Optimisation | \(T_{\mathrm{mult}}\) | 2 |
| Optimisation | \(\eta_{\min}\) | \(10^{-5}\) |
| Optimisation | \(\gamma\) | 0,5 |
| Training | Max epochs | 15 |
| Training | Random seed train / test | 42 / 999 |
Algorithm 1: Uundaji wa causal context
- Window zote za asset moja hupangwa kwa mpangilio wa timestamp.
- Kwa target index \(\tau\), window za zamani zenye \(j<\tau\) pekee ndizo hutathminiwa.
- Window zinazotimiza sharti \(t_j+d+h\le t_\tau\), yaani ambazo label outcome yake imetokea kikamilifu kufikia wakati wa target prediction, zinaweza kuchaguliwa.
- Kati ya wagombea hawa wanaofaa, window \(C=15\) zenye timestamp kubwa zaidi, yaani zilizo karibu zaidi katika siku za nyuma, huunda context set.
- Encoder representations na realised labels hurudishwa kama context, huku target representation ikirudishwa kama sampuli ya withheld prediction.
Confidence Gating Ilitoa Uboreshaji wa Kiasi Gani?
Asset saba zilipotathminiwa pamoja, directional macro F1 ya UQ-regression iliongezeka kwa +0,15, +0,14 na +0,11 mtawalia katika horizon za sekunde 5, 10 na 15 wakati wa kutoka full test set hadi utabiri salama zaidi wa %10; kwa UQ-classification ongezeko lilikuwa +0,11, +0,05 na +0,07.
| Confidence percentile q | Reg. 5 s | Cls. 5 s | Reg. 10 s | Cls. 10 s | Reg. 15 s | Cls. 15 s |
|---|---|---|---|---|---|---|
| 0 — utabiri wote | 0,42 | 0,45 | 0,41 | 0,45 | 0,40 | 0,45 |
| 10 | 0,44 | 0,46 | 0,43 | 0,45 | 0,42 | 0,46 |
| 20 | 0,46 | 0,47 | 0,45 | 0,46 | 0,44 | 0,46 |
| 30 | 0,48 | 0,47 | 0,47 | 0,47 | 0,46 | 0,47 |
| 40 | 0,49 | 0,48 | 0,48 | 0,47 | 0,47 | 0,47 |
| 50 | 0,50 | 0,49 | 0,49 | 0,48 | 0,47 | 0,48 |
| 60 | 0,51 | 0,50 | 0,50 | 0,48 | 0,48 | 0,48 |
| 70 | 0,52 | 0,51 | 0,51 | 0,49 | 0,48 | 0,49 |
| 80 | 0,54 | 0,53 | 0,52 | 0,50 | 0,49 | 0,50 |
| 90 — salama zaidi %10 | 0,57 | 0,56 | 0,55 | 0,50 | 0,51 | 0,52 |
Classification ni yenye nguvu zaidi kuliko regression kwenye full test set: directional macro F1 ni takribani 0,45, huku regression ikiwa katika safu ya 0,40–0,42. Hata hivyo, confidence inapoongezeka regression huziba pengo. Katika salama zaidi %10, regression hupita classification kwa sekunde 5 na 10, lakini hubaki nyuma kwa tofauti ndogo sana katika sekunde 15: 0,51 dhidi ya 0,52.
Matokeo katika movement kubwa
Uchanganuzi wa Large-move:
\[ |y|>q_{67} \]
hutumia sharti hili. \(q_{67}\) ni takribani mpaka wa theluthi ya juu ya distribution ya magnitude ya displacement halisi.
| Horizon | Top %50 ↓ | Top %50 ↑ | Top %30 ↓ | Top %30 ↑ | Top %10 ↓ | Top %10 ↑ | Top %5 ↓ | Top %5 ↑ | Top %1 ↓ | Top %1 ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 0,69 | 0,63 | 0,73 | 0,67 | 0,81 | 0,75 | 0,84 | 0,79 | 0,88 | 0,83 |
| 10 s | 0,65 | 0,59 | 0,68 | 0,63 | 0,75 | 0,70 | 0,78 | 0,73 | 0,85 | 0,78 |
| 15 s | 0,65 | 0,52 | 0,68 | 0,53 | 0,74 | 0,59 | 0,76 | 0,61 | 0,81 | 0,68 |
Kwa kuwa katika subset hii distribution ya class za down na up iko karibu na usawa, prior-matched random reference ni takribani 0,5. Confidence inapoongezeka, directional F1 huongezeka katika horizon zote tatu.
Kwa Nini Interval ya %68 Imebaki Imekalibishwa Vizuri Huku Interval ya %95 Ikiwa na Coverage Ndogo?
Kwa kuwa calibration loss ya UQ-regression inalenga first absolute moment ya standardised residual, inakalibisha kwa nguvu kiwango cha takribani one-sigma; lakini kwa sababu haimodeli moja kwa moja heavy tails za tick displacement distribution zinazozidi Gaussian, interval ya 1,96-sigma ya %95 hubaki chini ya kiwango nominal.
| Kipimo | 5 s | 10 s | 15 s |
|---|---|---|---|
| Coverage 68 — nominal 0,68 | 0,682 | 0,682 | 0,681 |
| Coverage 95 — nominal 0,95 | 0,904 | 0,904 | 0,907 |
| Calibration error | 0,048 | 0,048 | 0,045 |
| NLPD | 5,278 | 5,586 | 5,778 |
Ufafanuzi muhimu wa jedwali: Pooled coverage kuwa 0,682 huku calibration error ikiwa 0,048 si mkanganyiko. Chanzo kinafafanua calibration error katika kiwango cha asset kama:
\[ |cov_{68}-0.68| \]
wastani wa thamani hizi. Pooled aggregate coverage inaweza kuunganisha positive na negative deviations katika asset tofauti kwa namna inayozifuta; mean absolute asset-level deviation haifanyi hivyo.
Kwa %95 undercoverage, waandishi wanapendekeza Student-t likelihood au post-hoc conformal recalibration kama future work.
Kwa nini Stationary F1 huanguka?
| Kipimo | Top %100 | Top %50 | Top %30 | Top %10 | Top %1 |
|---|---|---|---|---|---|
| F1 Down | 0,447 | 0,526 | 0,549 | 0,598 | 0,640 |
| F1 Up | 0,393 | 0,477 | 0,499 | 0,544 | 0,598 |
| F1 Stationary | 0,390 | 0,067 | 0,012 | 0,000 | 0,000 |
| Macro F1 ya class tatu | 0,410 | 0,357 | 0,353 | 0,381 | 0,413 |
Jedwali hili linaonyesha tatizo muhimu sana la tathmini. Kwa sababu SNR gating huchagua high-magnitude predictions, sampuli stationary hupotea polepole ndani ya retained subset. Hivyo Down na Up F1 huongezeka huku Stationary F1 ikiweza kushuka hadi sifuri. Kwa hiyo macro F1 ya class tatu inaweza isionyeshe kwa usahihi faida ya directional ya selective prediction.
Distribution shift kwenye BTC
Katika asset sita kati ya saba, training, validation na test class proportions hubaki karibu sawa, lakini BTC ni tofauti iliyo wazi.
Kwa BTC-USD katika horizon ya sekunde 5, stationary class ni takribani:
Training: %70
Test: %27
imekuwa hivyo.
Katika sekunde 10, training stationary ni takribani %64 na test %19; katika sekunde 15, training ni takribani %57 na test %15.
Chanzo kinafafanua tofauti hii kama volatility regime shift na kinaionyesha kama mojawapo ya motisha kuu za kutumia recent realised outcomes pamoja na context conditioning. Hata hivyo, waandishi wanasema kipindi kirefu zaidi cha test kinachojumuisha regime nyingi kinahitajika kwa robustness.
Thamani za per-asset label threshold na scale
| Asset | \(\sigma_h^{LR}\) | \(\tau_h^{LR}\) | \(y_{\mathrm{ref}}\) — tick | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | |
| BTC | 1,82e−4 | 2,63e−4 | 3,29e−4 | 4,85e−4 | 4,50e−5 | 6,60e−5 | 8,20e−5 | 1,21e−4 | 155 | 181 | 205 | 255 |
| DOGE | 3,65e−4 | 5,12e−4 | 6,25e−4 | 8,81e−4 | 9,10e−5 | 1,28e−4 | 1,56e−4 | 2,20e−4 | 187 | 277 | 352 | 507 |
| ETH | 3,14e−4 | 4,43e−4 | 5,42e−4 | 7,74e−4 | 7,80e−5 | 1,11e−4 | 1,36e−4 | 1,94e−4 | 42 | 56 | 69 | 96 |
| LTC | 3,70e−4 | 5,77e−4 | 6,11e−4 | 8,94e−4 | 9,20e−5 | 1,44e−4 | 1,53e−4 | 2,23e−4 | 2 | 2 | 2 | 3 |
| SOL | 3,58e−4 | 5,10e−4 | 6,18e−4 | 8,83e−4 | 8,90e−5 | 1,28e−4 | 1,55e−4 | 2,21e−4 | 3 | 3 | 4 | 6 |
| SUI | 5,09e−4 | 7,34e−4 | 8,79e−4 | 1,246e−3 | 1,27e−4 | 1,83e−4 | 2,20e−4 | 3,11e−4 | 3 | 5 | 6 | 9 |
| TAO | 5,01e−4 | 6,97e−4 | 8,39e−4 | 1,176e−3 | 1,25e−4 | 1,74e−4 | 2,10e−4 | 2,94e−4 | 628 | 953 | 1059 | 1596 |
Thamani za sekunde 30 zimetolewa ndani ya label statistics; majaribio makuu ya makala yanaripotiwa katika horizon za sekunde 5, 10 na 15.
Je, Utafiti Huu Unathibitisha Trading Strategy Yenye Faida?
Hapana. Utafiti wa UQ-LOB unatathmini directional reliability, displacement fit, uncertainty calibration na confidence gating; kwa kuwa portfolio P&L halisi, fee-adjusted return, slippage, market impact au live execution results hazijapimwa, utafiti hauwezi kutafsiriwa kama ushahidi wa profitability.
Matokeo yanayoungwa mkono na utafiti
- Thamani ya %68 predictive interval coverage ya UQ-regression iko karibu sana na kiwango nominal.
- %95 Gaussian interval imeonyesha coverage chini ya kiwango nominal kwa sababu ya heavy tails.
- SNR confidence gating imeongeza directional macro F1 ya retained predictions katika horizon zote tatu.
- Softmax confidence ya UQ-classification pia ni ranking signal yenye maana kwa directional macro F1.
- Ingawa UQ-regression hutoa directional macro F1 ya chini kuliko classification kwenye full test set, katika salama zaidi %10 pengo karibu linafungwa.
- Katika movement kubwa, tabaka za SNR ya juu zimefikia thamani nzuri za directional F1.
- Matumizi ya context outcomes zilizotokea katika siku za karibuni yametekelezwa kwa causal constraint ya wazi inayozuia future leakage.
- UQ-regression na UQ-classification zimelinganishwa kwenye parameter count karibu sawa na shared trunk ile ile.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba modeli ina faida kwa fedha halisi.
- Haijathibitishwa kwamba confidence gating itazalisha net return baada ya transaction cost.
- %68 calibration si dhamana ya calibration ya kudumu katika regime zote za soko.
- Haiwezi kusemwa kwamba %95 interval inatoa nominal coverage; coverage iliyopimwa ni takribani %90,4–90,7.
- Muundo wa encoder-agnostic haujathibitishwa kwa majaribio na LOB encoder zote; utafiti umetumia D-TABL.
- Matokeo hayawezi kujumlishwa moja kwa moja kwa exchange nyingine, asset class nyingine au horizon ndefu zaidi.
- Modeli haitatui moja kwa moja epistemic uncertainty.
- Utafiti si jaribio la long-term portfolio risk management au optimal position sizing.
Vikwazo na kazi za baadaye zilizotajwa na waandishi
Tail calibration: Gaussian likelihood haiwakilishi heavy tails vya kutosha. Student-t likelihood au conformal recalibration inapendekezwa.
Wigo wa baseline: Utafiti unalinganisha UQ head mbili kwenye shared trunk ile ile. Ulinganisho mpana na weight-space uncertainty baseline kama MC dropout, deep ensemble na base encoder softmax gating haujafanywa.
Multi-seed uncertainty: Waandishi wanasema multi-seed error bars na loss/context ablations zinaweza kuimarisha attribution katika siku zijazo.
Distribution shift: Hasa katika train/test class distribution ya BTC kuna tofauti kubwa ya regime. Kipindi kirefu zaidi cha test kinachojumuisha regime nyingi kinahitajika.
Economic evaluation: Directional reliability imetathminiwa; profitability haijatathminiwa.
Scope: Modeli zimefunzwa tofauti kwa kila asset na horizon na trading venue moja imetumika. Modeli moja ya cross-asset au multi-horizon haijajaribiwa.
Maadili na upatikanaji wa data
Chanzo kinasema kwamba market data pekee kutoka public API ya exchange imetumika na hakuna personal data. Modeli inaweza kuathiri maamuzi ya trading kwa kutabiri movement za bei za muda mfupi; waandishi wanaeleza wazi kwamba hawadai profitability na kwamba financial risk inaendelea kuwepo.
Raw Kraken order-book data haiwezi kusambazwa tena kwa sababu hakuna data-sharing agreement na exchange.
Reproducibility Statement inasema kwamba complete source code, D-TABL encoder, UQ head mbili, training/evaluation pipelines, context-construction procedure, label thresholds, scale values na dataset statistics zimechapishwa. Hata hivyo, PDF iliyopakiwa haitoi URL ya moja kwa moja ya public repository.
Maelezo ya Chanzo na Mbinu
Utafiti asili: UQ-LOB: Uncertainty-Aware Limit Order Book Mid-Price Forecasting
Waandishi: Derrick Gilchrist Edward Manoharan; Eljas Linna; Kestutis Baltakys; Hao Dong; Juho Kanniainen.
Mpangilio wa waandishi: Mpangilio katika chanzo umehifadhiwa kama ulivyo.
Corresponding author: Derrick Gilchrist Edward Manoharan.
Mchango sawa: Hakuna tamko la equal-contribution linaloonekana katika chanzo.
Taasisi: Data Science Research Centre, Tampere University, Tampere, Finland.
Jukwaa: arXiv.
Kategoria: Computer Science — Artificial Intelligence (cs.AI).
Utambulisho wa arXiv: arXiv:2609.31491v2.
Tarehe ya kuwasilisha v1: 25 Septemba 2026.
Tarehe ya marekebisho ya v2: 28 Septemba 2026.
Aina ya chanzo: Preprint.
Peer review: v2 iliyopakiwa ni arXiv preprint; kufikia 21 Novemba 2026, Version of Record ya jarida lililopitiwa na wataalamu haijathibitishwa.
arXiv/DataCite DOI: 10.48550/arXiv.2609.31491. Kitambulishi hiki si journal DOI.
Kiungo rasmi: https://arxiv.org/abs/2609.31491v2
Leseni ya chanzo: Leseni wazi ya Creative Commons ya matumizi tena haijathibitishwa kwenye PDF iliyopakiwa. Kwa hiyo, vielelezo vya chanzo havikutumiwa moja kwa moja wala kuzalishwa upya kwa style transfer.
Ufadhili: Funding statement tofauti haikutambuliwa katika PDF iliyopakiwa.
Mgongano wa maslahi: Competing-interest/conflict-of-interest statement tofauti haikutambuliwa katika PDF iliyopakiwa.
Michango ya waandishi: Hakuna CRediT author-contribution statement tofauti katika PDF iliyopakiwa.
Chanzo cha data: Kraken cryptocurrency exchange public market-data API; Level-2 na Level-3 order-book data.
Upatikanaji wa raw data: Raw data haisambazwi tena; chanzo kinaeleza sababu kuwa kutokuwepo kwa data-sharing agreement na exchange.
Msimbo: Reproducibility Statement inasema complete source code imechapishwa; lakini PDF haitoi repository URL inayoweza kuthibitishwa.
Assets: BTC, ETH, SOL, LTC, DOGE, SUI, TAO.
Prediction horizons kuu: 5 s, 10 s, 15 s.
Label statistics horizon ya ziada: Thamani za 30 s zimetolewa tofauti katika Appendix Table 7; main experiment results ni za sekunde 5/10/15.
Input window: 512 non-overlapping order-book event.
Context: 15 causal context window + 1 withheld target.
Encoder: D-TABL; bilinear layer tatu + terminal temporal-attention-augmented bilinear layer.
UQ-regression: Gaussian predictive distribution \(\mathcal{N}(\mu,\sigma^2)\).
UQ-classification: Down / Up / Stationary categorical prediction.
Regression confidence: \(SNR=|\mu|/\sigma\).
Classification confidence: Maximum softmax probability.
Optimizer: AdamW.
Vifaa: NVIDIA GH200 Grace Hopper Superchip.
Gharama ya training ya pipeline: Kwa mujibu wa hesabu ya Appendix, takribani 78,75 GPU-hour D-TABL pretraining + 105 GPU-hour UQ-regression + 105 GPU-hour UQ-classification = takribani 289 GPU-hour. Kauli ya takribani 210 GPU-hour katika matini kuu inaendana na jumla ya gharama ya fine-tuning ya UQ variant mbili.
Matokeo makuu ya calibration: coverage ya 0,681–0,682 kwa %68 nominal interval; coverage ya 0,904–0,907 kwa %95 nominal interval.
Matokeo makuu ya selective-prediction: Wakati wa kwenda kwenye salama zaidi %10, directional macro F1 ya UQ-regression kwa sekunde 5/10/15 ni 0,57 / 0,55 / 0,51 mtawalia; UQ-classification ni 0,56 / 0,50 / 0,52.
Matokeo ya Large-move: Kwa sekunde 5, salama zaidi %1 UQ-regression F1: down 0,88; up 0,83.
Kikomo kikuu cha kisayansi: Utafiti unatathmini predictive confidence na directional reliability; haupimi trading profitability halisi, fee-adjusted P&L, slippage au market impact.
Kikomo muhimu cha reproducibility: Raw market data haisambazwi tena. Hata hivyo, chanzo kinasema model specification, label procedure, dataset statistics, scale/threshold values na code zimechapishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *