


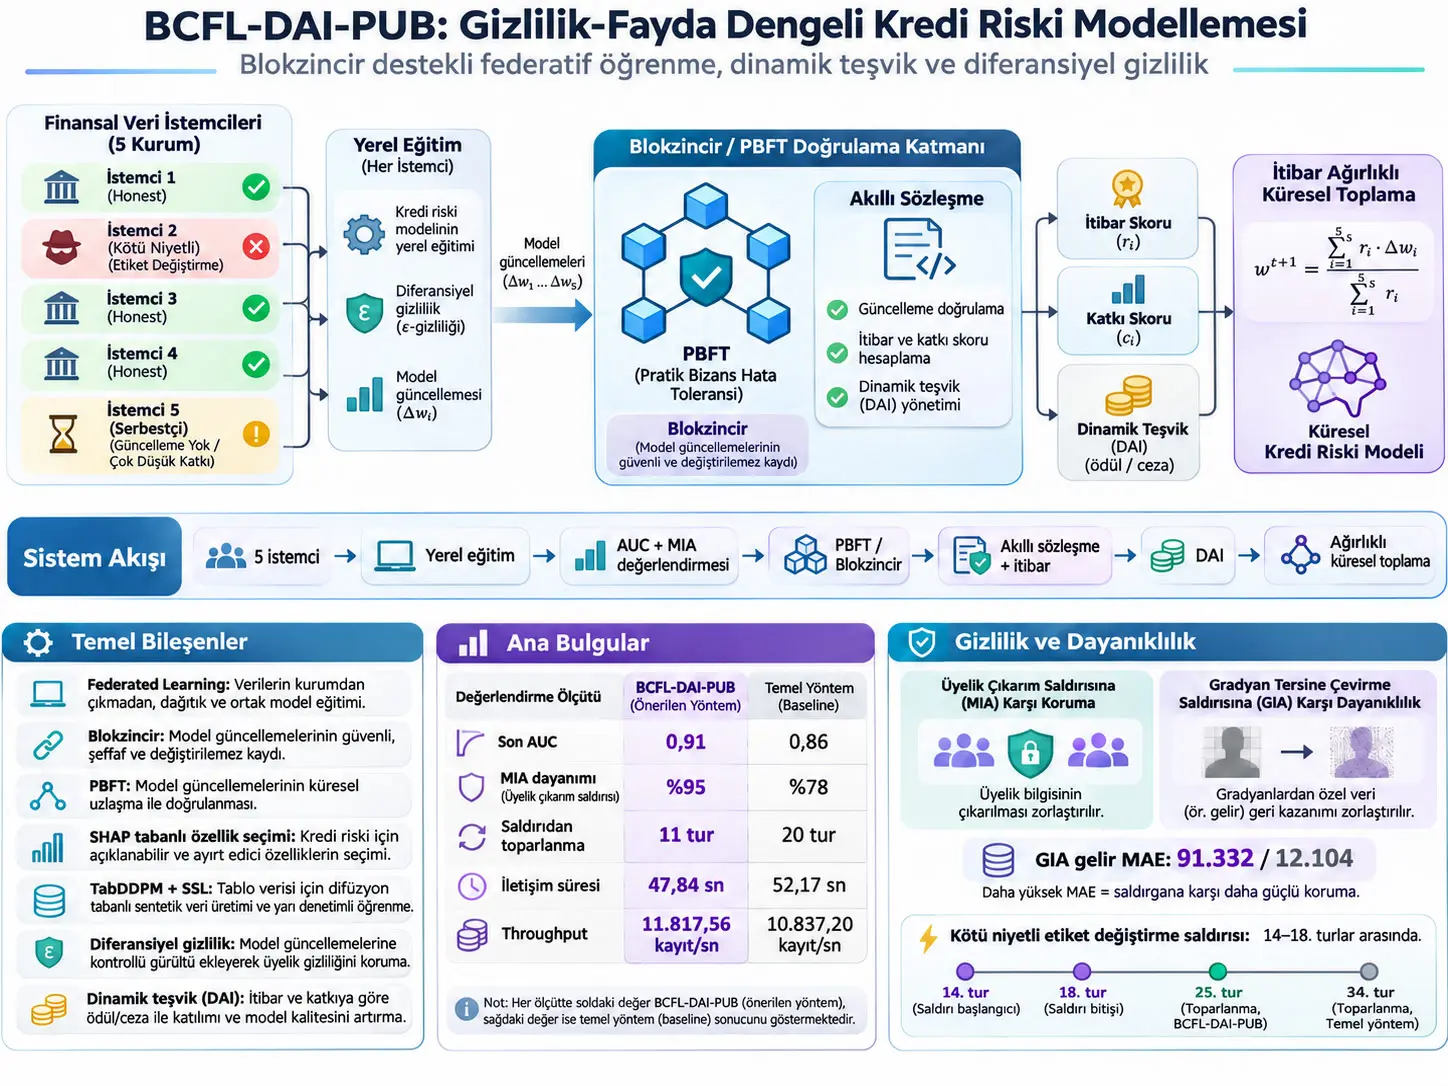
BCFL-DAI-PUB, kredi riski modellemesi için blokzincir yönetişimi, Federated Learning (FL), optimizer düzeyinde diferansiyel gizlilik, Tabular Denoising Diffusion Probabilistic Model (TabDDPM), eşler arası model değerlendirmesi ve Dynamic Adaptive Incentive (DAI) mekanizmasını birleştiren bir blockchain-federated learning çerçevesidir. Çerçeve, istemcilerin yalnız model faydasını değil gizlilik katkısını da değerlendirerek SCAFFOLD tabanlı düzeltme, privacy-budget ayarlaması ve parasal teşvik arasında dinamik seçim yapmayı; kötü niyetli ve free-rider istemcilerin global model üzerindeki etkisini itibar ağırlıklı aggregation yoluyla azaltmayı amaçlamaktadır.
Çalışma, Kaggle üzerindeki Home Credit Default Risk veri kümesini kullanmaktadır. Özgün veri kümesinde 307.511 kayıt ve 122 özellik bulunmakta; TARGET=1 olan 24.825 kredi temerrüt kaydı ile TARGET=0 olan 282.686 geri ödeme kaydı arasındaki sınıf dengesizliği minority-class oversampling ile giderilerek toplam 565.372 dengeli kayıt oluşturulmaktadır. Bu dengeli veri beş simüle federated client arasında near-IID ve non-IID biçimlerde dağıtılmıştır. Çalışmanın daha gerçekçi kabul ettiği non-IID senaryoda üç honest client, bir label-flipping malicious client ve bir free-rider bulunmaktadır.
Non-IID 10-fold cross-validation değerlendirmesinde BCFL-DAI-PUB için AUC 0,91501 ± 0,00007, Precision 0,83732 ± 0,00116, Recall 0,74946 ± 0,00018 ve F1 Score 0,79096 ± 0,00008 raporlanmıştır. Karşılaştırılan BCFL-PS-HER baseline için AUC 0,86071 ± 0,00123'tür. Karışık honest + malicious + free-rider senaryosunda önerilen model son turlarda yaklaşık 0,91 AUC'ye, baseline ise yaklaşık 0,86 AUC'ye ulaşmıştır.
Label-flipping saldırısı 14. turda başlatılıp 18. turda sonlandırıldığında BCFL-DAI-PUB kendi saldırı öncesi AUC düzeyine 25. turda dönmüş; saldırı başlangıcından recovery süresi 11 tur olmuştur. BCFL-PS-HER ise 34. turda toparlanmış ve 20 tura ihtiyaç duymuştur. Kaynak bu farkı baseline'ın yaklaşık 1,82 kat daha uzun recovery süresi olarak raporlamaktadır.
Gizlilik değerlendirmelerinde BCFL-DAI-PUB'un final Membership Inference Attack (MIA) Advantage değeri yaklaşık 0,05, baseline'ın değeri yaklaşık 0,22'dir. Buna karşılık \(R_{MIA}=1-Adv_{MIA}\) tanımıyla hesaplanan resistance değerleri sırasıyla %95 ve %78'dir. Gradient Inversion Attack (GIA) testinde önerilen yöntemde tüm özellikler için MAE 42.105 ± 2.310, income özelliği için MAE 91.332 ± 9.104 olarak raporlanmış; baseline değerleri sırasıyla 4.821 ± 387 ve 12.104 ± 1.208'dir. Bu yüksek MAE, saldırganın yeniden yapılandırmasının daha kötü olduğunu ifade eder; model tahmin hatasının büyüdüğü anlamına gelmez.
En önemli yorum sınırı, bu sonuçların gerçek bankalar veya finans kurumları arasında kurulmuş production blockchain-federated learning ağına ait olmamasıdır. İstemciler tek bir kamuya açık kredi veri kümesinden simüle edilmiş, malicious/free-rider davranışları kontrollü biçimde tanımlanmıştır. Dolayısıyla 0,91 AUC, %95 MIA resistance veya 11-turluk recovery gerçek finans kurumlarında otomatik olarak aynı performansı garanti etmez.
BCFL-DAI-PUB Nedir?
BCFL-DAI-PUB, merkezi federated-learning aggregator'ını blokzincir ve smart-contract koordinasyonuyla değiştirmeyi, istemci model güncellemelerini utility ve privacy açısından karşılıklı değerlendirmeyi ve Dynamic Adaptive Incentive mekanizmasıyla her istemcinin teşvik ve global-model etkisini dinamik olarak ayarlamayı amaçlayan kredi riski modelleme çerçevesidir.
Çalışmanın çözmeye çalıştığı problem
Kredi riski modellerinin birden fazla finans kurumunun verisinden yararlanması, modelin daha çeşitli borrower profilleri görmesini sağlayabilir. Ancak gerçek finansal kayıtlar doğrudan kurumlar arasında paylaşıldığında veri gizliliği, düzenleyici uyum ve güven sorunları ortaya çıkar. Federated Learning bu sorunu ham verileri kurum içinde tutarak azaltır; buna karşılık klasik FL mimarisinde merkezi aggregator bir güven ve single-point-of-failure problemi oluşturabilir.
Blockchain-Federated Learning, model-update koordinasyonunu dağıtık ledger ve smart contract'larla doğrulanabilir hale getirmeyi amaçlar. Fakat kaynak çalışmanın vurguladığı ikinci problem, yalnız merkezi aggregator'ı kaldırmanın istemcilerin dürüst ve sürekli katılımını garanti etmemesidir. İstemciler hesaplama maliyetinden kaçınabilir, eski model update'i gönderebilir, free-riding yapabilir veya bilinçli biçimde kötü niyetli model update'i oluşturabilir.
Üçüncü problem privacy–utility trade-off'tur. Daha sıkı privacy mekanizmaları modelin öğrenme sinyalini azaltabilir; yüksek utility uğruna privacy bütçesinin gevşetilmesi ise inference attack riskini artırabilir. Kaynak bu nedenle yalnız predictive utility'yi değil privacy contribution'ı da teşvik kararının parçası yapmaktadır.
Literatür boşluğu
Kaynak literatür taramasına göre kredi riski için federated-learning çalışmaları, blockchain entegrasyonu, incentive mekanizmaları ve privacy-preserving teknikler ayrı ayrı geliştirilmiştir; ancak credit-risk setting içinde predictive utility, privacy preservation ve adversarially robust incentive allocation'ı tek bir blockchain-federated framework içinde birlikte ele alan çalışma sayısı sınırlıdır.
BCFL-DAI-PUB'un kaynakta belirtilen beş temel katkısı şunlardır:
- Smart contract tarafından koordine edilen global preprocessing.
- SHAP tabanlı ve blockchain ile doğrulanabilir global feature selection.
- Self-Supervised Learning ile başlatılan TabDDPM tabanlı privacy-preserving generative model.
- Utility ve privacy contribution'ı birlikte kullanan Dynamic Adaptive Incentive mekanizması.
- Honest, malicious ve free-rider istemciler altında utility, privacy, recovery ve system overhead değerlendirmesi.
Veri kümesi ve sınıf dengesi
| Özellik | Kaynak değeri |
|---|---|
| Özgün kayıt sayısı | 307.511 |
| TARGET=1 — loan defaulter | 24.825 |
| TARGET=0 — successful repayment | 282.686 |
| Numerical attribute | 106 |
| Categorical attribute | 16 |
| Toplam raw feature | 122 |
| Oversampling sonrası kayıt | 565.372 |
| Oversampling sonrası TARGET=1 | 282.686 |
| Oversampling sonrası TARGET=0 | 282.686 |
Kaynak minority class için oversampling uygulandığını belirtmekte fakat kullanılan oversampling algoritmasını ayrıntılı biçimde adlandırmamaktadır. Ayrıca oversampling işleminin cross-validation fold'ları içinde ayrı ayrı mı, yoksa bütün balanced dataset oluşturulduktan sonra mı gerçekleştirildiğine ilişkin daha ayrıntılı veri-sızıntısı kontrol prosedürü raporlanmamaktadır. Verianla bu eksikliği varsayımsal bir SMOTE veya başka sampling tekniği ekleyerek doldurmamaktadır.
Eşitlik 1–3: Federated Learning'in temel optimizasyon problemi
Her istemci \(C_i\), kendi yerel veri kümesini tutar:
\[ D_i=\{(x_j,y_j)\}_{j=1}^{n_i}. \tag{1} \]
Ne hesaplar? Eşitlik 1 bir hesaplama formülünden çok istemci \(i\)'nin yerel veri kümesinin matematiksel tanımıdır. \(x_j\) özellik vektörü, \(y_j\) hedef sınıf ve \(n_i\) istemcinin yerel örnek sayısıdır.
Global amaç:
\[ \min_{w\in\mathbb{R}^{d}} F(w), \tag{2} \]
ve:
\[ F(w)= \sum_{i=1}^{N} \frac{n_i}{n}F_i(w), \qquad n=\sum_{i=1}^{N}n_i. \]
Her istemcinin yerel loss fonksiyonu:
\[ F_i(w)= \frac{1}{n_i} \sum_{(x_j,y_j)\in D_i} \ell(w;x_j,y_j). \tag{3} \]
Matematiksel rol: Eşitlik 2–3, klasik weighted federated objective'i tanımlar. Büyük veri kümesine sahip istemci \(n_i/n\) ağırlığı üzerinden global objective'e daha fazla katkı verir.
Birim: \(w\) model parametre vektörüdür. \(F\) ve \(\ell\)'nin fiziksel birimi yoktur; model kayıp fonksiyonuna bağlı sayısal objective değerleridir.
Blockchain neden ekleniyor?
BCFL katmanı, kaynak mimarisinde model update ve evaluation işlemlerini blockchain üzerinde doğrulanabilir transaction'lara dönüştürür. Validator node'lar Practical Byzantine Fault Tolerance (PBFT) consensus ile transaction doğrular. Smart contract; global preprocessing parametreleri, feature-selection referansları, reputation, contribution score ve incentive kararlarını yönetir.
Kaynağın Şekil 1'inde ayrıca bir Task Publisher global modeli oluşturup istemcilere dağıtan başlangıç rolü olarak gösterilmektedir. Bu nedenle kaynakta kullanılan “fully decentralized” ifadesi, sistemde hiçbir başlatıcı rol bulunmadığı şeklinde genişletilmemelidir; asıl decentralization iddiası model-update koordinasyonu, doğrulama ve aggregation sürecinin merkezi güvenilir aggregator'a bağımlı olmamasıdır.
Diferansiyel Gizlilik Bu Çalışmada Neyi Koruyor?
BCFL-DAI-PUB'da diferansiyel gizlilik, model-update iletişim kanalını şifrelemekten farklı olarak optimizer düzeyinde gradient bilgisini clipping ve Gaussian noise ile bozarak tek tek eğitim kayıtlarının gradient inversion ve membership inference yoluyla geri çıkarılmasını zorlaştırmayı amaçlamaktadır.
Eşitlik 4–5: Gaussian diferansiyel gizlilik mekanizması
Kaynak genel Gaussian mekanizmasını:
\[ M(D)=f(D)+\mathcal{N}(0,\sigma^2 I) \tag{4} \]
biçiminde verir.
Gürültü ölçeği:
\[ \sigma \ge \frac{ \Delta_2f\sqrt{2\ln(1.25/\delta)} }{ \epsilon }. \tag{5} \]
\(D\) özel veri kümesini, \(f(D)\) yayımlanacak hesaplamayı, \(\Delta_2f\) L2 sensitivity değerini, \(\epsilon\) privacy budget'ı, \(\delta\) düşük olasılıklı privacy-failure parametresini ve \(\sigma\) Gaussian noise ölçeğini temsil eder.
Kaynağın DAI mantığında utility yüksek fakat privacy contribution düşük olduğunda privacy budget azaltılarak gizlilik kuvvetlendirilmeye çalışılır. Table 7'de privacy-budget adjustment:
\[ \Delta\epsilon=0.10 \]
olarak verilmiştir.
Eşitlik 6: Gradient Inversion Attack objective'i
\[ \mathcal{L}(\hat{x}) = \left\| \nabla_{\theta} \mathcal{L}(f_{\theta}(\hat{x});y) - g_i \right\|_2^2 + \lambda_{TV}TV(\hat{x}) + \lambda_{range} \sum_j \left[ \max(0,\hat{x}_j-u_j)^2 + \max(0,l_j-\hat{x}_j)^2 \right]. \tag{6} \]
İlk terim saldırganın sentetik örneğinin oluşturduğu gradient ile gözlenen gradient arasındaki farkı azaltır. \(TV(\hat{x})\) regularization terimidir. \(l_j\) ve \(u_j\) tabular feature'ların geçerli alt/üst sınırlarını korumaya çalışır.
Kaynak honest-but-curious attacker modelinde saldırganın public model parametrelerine eriştiğini, fakat individual client gradient yerine aggregated update gözlediğini belirtmektedir.
Eşitlik 7–8: GIA yeniden yapılandırma kalitesi
\[ MAE= \frac{1}{d} \sum_{j=1}^{d} |\hat{x}_j-x_j|. \tag{7} \]
MAE küçükse reconstruction orijinal örneğe daha yakındır; gizlilik savunması açısından saldırgan daha başarılıdır. Bu nedenle GIA tablosunda daha büyük MAE savunma açısından daha iyi sonuçtur.
Protected categorical attribute için tek örnek düzeyindeki inference indicator:
\[ AIA= \mathbf{1}\{\hat{a}=a^*\}. \tag{8} \]
Burada \(\hat a\) saldırganın tahmin ettiği attribute, \(a^*\) gerçek attribute değeridir. Table 11'deki Gender Inference Accuracy bu örnek düzeyindeki doğru/yanlış sonuçların toplu doğruluk ölçümüdür.
Eşitlik 9–11: Membership Inference Attack
Bir örneğin model üzerindeki loss'u:
\[ \ell(x^*,y^*) = \mathcal{L}(f_{\theta}(x^*),y^*). \tag{9} \]
Membership threshold:
\[ T_{MIA} = \operatorname{median} \{\ell(x_i,y_i)\}. \tag{10} \]
Kaynakta loss:
\[ \ell(x^*,y^*) < T_{MIA} \]
ise örnek training member olarak sınıflandırılır.
MIA Advantage:
\[ Adv_{MIA} = TPR-FPR. \tag{11} \]
Kaynağın yorumuna göre \(Adv_{MIA}\le0.05\) negligible risk; 0,10 üzerindeki değerler önemli privacy leakage olarak ele alınmıştır.
Kaynak ayrıca numarasız olarak:
\[ R_{MIA}=1-Adv_{MIA} \]
resistance skorunu tanımlar. Bu nedenle düşük \(Adv_{MIA}\) ve yüksek \(R_{MIA}\) daha güçlü gizlilik anlamına gelir.
Eşitlik 12–13: Label-flipping poisoning
Binary class etiketi kötü niyetli istemci tarafından:
\[ y_i^{mal}=1-y_i \tag{12} \]
biçiminde ters çevrilir.
Bunun oluşturduğu malicious gradient:
\[ \widetilde{g}_i = \nabla_{\theta} \mathcal{L} (f_{\theta}(x_i),y_i^{mal}). \tag{13} \]
Bu update'ler global modeli ters sınıf yönünde etkilemeye çalışır. Çalışmada label-flipping attack 14. communication round'da başlatılmış ve 18. round'da durdurulmuştur.
Poisoning recovery metrikleri
Kaynak Table 3'te recovery analizini şu ölçülerle tanımlar:
\[ AUC_{before} = \frac{1}{t_s-1} \sum_{t=1}^{t_s-1} AUC_t \]
\[ AUC_{attack} = \frac{1}{t_e-t_s+1} \sum_{t=t_s}^{t_e} AUC_t \]
\[ AUC_{min} = \min_{t_s\le t\le t_e} AUC_t \]
\[ t_r = \min_{t>t_e} \left\{ t\mid AUC_t\ge AUC_{before}-\varepsilon \right\} \]
\[ NR_{start}=t_r-t_s, \qquad NR_{end}=t_r-t_e \]
\[ AUC_{after} = \frac{1}{T-t_r} \sum_{t=t_r+1}^{T} AUC_t \]
\[ \Delta_{drop}=AUC_{before}-AUC_{min} \]
\[ \Delta_{recover}=AUC_{after}-AUC_{min} \]
\[ RecoveryRatio = \frac{\Delta_{recover}}{\Delta_{drop}}. \]
\(NR_{start}\), saldırının ilk başladığı andan pre-attack performansın geri kazanılmasına kadar geçen toplam tur sayısıdır. \(NR_{end}\) ise saldırı durduktan sonra gereken ek recovery süresini ölçer.
Smart-contract kontrollü global preprocessing
BCFL-DAI-PUB, katılımcı kurumların feature encoding ve normalization kurallarının farklılaşmasını önlemek için global preprocessing şemasını smart contract üzerinden ortaklaştırmayı amaçlar.
Eşitlik 14: Global numerical mean
\[ \mu_{global} = \frac{1}{N} \sum_{i=1}^{N}\mu_i. \tag{14} \]
Her istemci numerical feature için kendi local mean değerini gönderir ve smart contract local means değerlerinin basit aritmetik ortalamasını hesaplar.
Önemli matematiksel not: Eq. 14, istemci veri büyüklüğü \(n_i\) ile ağırlıklandırılmış pooled sample mean değildir. İstemci büyüklükleri farklı olduğunda:
\[ \frac{1}{N}\sum_i\mu_i \]
ile bütün kayıtların tek havuzda hesaplanan ortalaması genel olarak aynı değildir. Kaynak formülü bu biçimde tanımladığı için Verianla ağırlıklı bir formülle sessizce değiştirmemektedir.
Eşitlik 15: Global categorical vocabulary
\[ C_{global} = \bigcup_{i=1}^{N}C_i. \tag{15} \]
Her istemcinin categorical feature'larında gördüğü unique değerler union işlemiyle tek global dictionary içinde birleştirilir. Böylece One-Hot Encoding boyutlarının bütün istemcilerde aynı olması amaçlanır.
Global mean, min–max değerleri ve \(C_{global}\) standartlaştırılmış JSON schema halinde IPFS üzerinde saklanır; schema hash'i blockchain'e kaydedilir.
One-hot encoding sonrasında 122 raw attribute:
245 preprocessed feature
haline gelmiştir.
Eşitlik 16–17: SHAP ile global feature selection
İstemci \(i\)'de feature \(f\)'nin SHAP importance değeri:
\[ I_i(f) = \frac{1}{n_{samples}} \sum_{j=1}^{n_{samples}} |\phi_j(f)|. \tag{16} \]
\(\phi_j(f)\), örnek \(j\) için feature \(f\)'nin SHAP contribution değeridir.
Global feature importance:
\[ I_{global}(f) = \frac{1}{N} \sum_{i=1}^{N} I_i(f). \tag{17} \]
Burada da istemciler eşit ağırlıkla ortalanmaktadır; local dataset size'a göre ağırlıklandırma uygulanmamıştır.
Feature'lar \(I_{global}(f)\) değerine göre azalan sıraya konur ve cumulative importance toplamı %75'e ulaşana kadar seçilir. Sonuçta 245 feature içinden 184 feature seçilmiştir.
Algorithm 1 ne yapıyor?
Algorithm 1'in bilimsel akışı:
- Her istemci local mean, min–max ve categorical vocabulary çıkarır.
- Smart contract bu değerleri global preprocessing schema'ya dönüştürür.
- Schema IPFS'e yüklenir ve hash'i blockchain'de yayımlanır.
- İstemciler aynı schema'yı kullanarak missing-value imputation, normalization ve One-Hot Encoding uygular.
- Her istemci LightGBM eğitir ve TreeExplainer ile SHAP importance hesaplar.
- Global SHAP importance değerleri ortalanır.
- Cumulative importance %75'e ulaşana kadar feature seçilir.
- 184 feature'lık global feature set smart contract tarafından finalize edilir.
Global model initialization
Model initialization iki aşamalıdır. İlk aşamada deep tabular transformer, label gerektirmeyen self-supervised contrastive learning ile pretrain edilir. Öğrenilmiş backbone ilk on diffusion training round boyunca frozen tutulur ve ardından fine-tuning için açılır.
İkinci aşamada bu latent representation, TabDDPM modelinin başlangıç girdisi olarak kullanılır.
Eşitlik 18: Numerical forward diffusion
\[ x_t = \sqrt{\bar{\alpha}_t}x_0 + \sqrt{1-\bar{\alpha}_t}\epsilon, \qquad \epsilon\sim\mathcal{N}(0,I). \tag{18} \]
Burada:
\[ \alpha_t=1-\beta_t, \qquad \bar{\alpha}_t=\prod_{i=1}^{t}\alpha_i. \]
\(\beta_t\) timestep noise schedule, \(x_0\) clean latent representation ve \(x_t\) t anındaki noise-corrupted numerical representation'dır.
Eşitlik 19: Categorical forward diffusion
\[ q(c_t\mid c_{t-1}) = (1-\beta_t)v(c_{t-1}) + \frac{\beta_t}{K}. \tag{19} \]
\(K\) categorical state sayısı, \(v(c_{t-1})\) önceki categorical state'in one-hot representation'ıdır. Böylece continuous ve categorical features aynı diffusion model içinde farklı noising kurallarıyla işlenir.
Eşitlik 20–22: Reverse denoising loss
Toplam loss:
\[ L_{total} = L_{mse}+L_{vlb}. \tag{20} \]
Numerical noise-prediction loss:
\[ L_{mse} = \mathbb{E}_{x_0,\epsilon,t} \left[ \| \epsilon-\epsilon_{\theta}(x_t,t) \|_2^2 \right]. \tag{21} \]
Categorical Variational Lower Bound terimi:
\[ L_{vlb} = \mathbb{E}_{q} \left[ \sum_{t=1}^{T} D_{KL} \left( q(c_{t-1}\mid c_t,c_0) \| p_{\theta}(c_{t-1}\mid c_t) \right) \right]. \tag{22} \]
\(D_{KL}\), gerçek reverse posterior ile öğrenilen reverse distribution arasındaki Kullback–Leibler divergence'dır.
Eşitlik 23: DP optimizer gradient'i
\[ \widetilde{g} = \frac{1}{N} \sum_{i=1}^{N} \operatorname{clip}(g_i,C) + \mathcal{N} (0,\sigma^2C^2I). \tag{23} \]
\(C\) gradient clipping norm, \(\sigma\) noise multiplier ve \(N\) batch size'dır. Clipping, tek bir örneğin gradient etkisini sınırlar; Gaussian noise ise gradient-data ilişkisinin hassas ayrıntılarını bozar.
Kaynak gösterim notu: Eq. 23 per-sample clipped gradients'in ortalamasını gösterirken Algorithm 2 pseudocode'unda clipping tek bir \(g\) sembolü üzerinde:
\[ \widetilde g = \frac{g}{\max(1,\|g\|_2/C)} + \mathcal{N}(0,\sigma^2C^2I) \]
biçiminde yazılmıştır. İki ifade aynı DP-SGD fikrini temsil etse de kaynak granularite farkını ayrıca açıklamamaktadır.
Algorithm 2 ne yapıyor?
- Tabular Transformer self-supervised contrastive pretraining ile eğitilir.
- Backbone ağırlıkları başlangıçta frozen tutulur.
- Latent numerical \(x_0\) ve categorical \(c_0\) representations üretilir.
- TabDDPM denoising network oluşturulur.
- Her iteration'da timestep seçilir.
- Numerical ve categorical forward noise uygulanır.
- Model noise ve category probability tahmin eder.
- MSE + VLB loss hesaplanır.
- Gradient clipping ve Gaussian noise uygulanır.
- 10. stabilization round'da backbone unfrozen edilerek privacy-aware fine-tuning'e geçilir.
Eşitlik 24: Local client model update
\[ w_{i,t+1} = w_{i,t} - \eta\nabla L_i(w_{i,t}). \tag{24} \]
\(\eta\) learning rate, \(L_i\) local loss ve \(w_{i,t}\) client \(i\)'nin round \(t\)'deki model parametreleridir.
Kaynak bu denklemi verir fakat genel training learning rate'in sayısal değerini implementation table içinde raporlamamaktadır.
Eşitlik 25: Predictive utility için AUC
\[ AUC = \sum_{k=1}^{n} (FPR_{k+1}-FPR_k) \left( \frac{TPR_k+TPR_{k+1}}{2} \right). \tag{25} \]
Bu trapezoidal integration, ROC eğrisinin altındaki alanı hesaplar. AUC büyüdükçe class-ranking performansı güçlenir.
Eşitlik 26: Privacy metric
\[ Adv_{MIA} = TPR-FPR. \tag{26} \]
Eq. 26, daha önce threat-model bölümünde Eq. 11 olarak tanımlanan MIA Advantage'ın client self-assessment aşamasında tekrar kullanılan halidir.
Eşitlik 27–28: Peer evaluation vector'ları
Utility vector:
\[ ut_i = [ut_{i,1},ut_{i,2},\ldots,ut_{i,N}]. \tag{27} \]
Privacy vector:
\[ pt_i = [pt_{i,1},pt_{i,2},\ldots,pt_{i,N}]. \tag{28} \]
Evaluator \(E_i\), bütün client model'lerini kendi private verisi üzerinde değerlendirir. \(ut_{i,j}\), client \(j\)'nin modelinin AUC tabanlı utility değerlendirmesi; \(pt_{i,j}\), MIA Advantage tabanlı privacy-vulnerability değerlendirmesidir.
Bu vector'lar signed transaction olarak blockchain'e gönderilir ve PBFT ile finalize edilir.
Dynamic Adaptive Incentive (DAI) Mekanizması Nasıl Çalışır?
DAI mekanizması her communication round'da peer-evaluated utility ve MIA tabanlı privacy değerlerinden reputation hesaplar, reputation'ı geçmiş davranışla exponential moving average üzerinden birleştirir, client'ın veri payını da hesaba katarak Utility Contribution ve Privacy Contribution skorları üretir ve bu iki skora göre parasal ödül, privacy-budget azaltımı, SCAFFOLD correction veya teşviksiz bırakma kararı verir.
Eşitlik 29: Client başına ortalama peer evaluation
\[ U_{i'}^{t} = \frac{1}{N} \sum_{i=1}^{N} ut_i^{t}[i'], \qquad P_{i'}^{t} = \frac{1}{N} \sum_{i=1}^{N} pt_i^{t}[i']. \tag{29} \]
\(U_{i'}^t\), client \(i'\)'nin diğer evaluator'lar tarafından verilen ortalama utility skorudur. \(P_{i'}^t\), MIA Advantage tabanlı ortalama privacy-vulnerability skorudur.
Eşitlik 30: Round genelindeki referans utility ve privacy
\[ U^t = \frac{1}{N} \sum_{i=1}^{N}U_i^t, \qquad P^t = \frac{1}{N} \sum_{i=1}^{N}P_i^t. \tag{30} \]
Bu değerler reputation hesaplamasında round-wise reference olarak kullanılır.
Eşitlik 31: Normalize reputation
\[ Rep_{Ui}^{t} = 2\sigma \left( \gamma(U_i^t-U^t) \right)-1, \]
\[ Rep_{Pi}^{t} = 2\sigma \left( \gamma(P^t-P_i^t) \right)-1. \tag{31} \]
\(\sigma(\cdot)\) sigmoid function, \(\gamma\) reputation sensitivity parametresidir. Table 7'de:
\[ \gamma=4.0 \]
olarak verilmiştir.
Utility reputation'da client utility'nin global ortalamadan yüksek olması olumlu reputation yaratır. Privacy tarafında işaret tersine çevrilmiştir: \(P_i^t\) MIA vulnerability olduğundan ortalamadan düşük privacy leakage daha yüksek privacy reputation üretir.
Eşitlik 32: Historical reputation
\[ FR_{Ui}^{t} = (1-\lambda) FR_{Ui}^{t-1} + \lambda Rep_{Ui}^{t}, \]
\[ FR_{Pi}^{t} = (1-\lambda) FR_{Pi}^{t-1} + \lambda Rep_{Pi}^{t}. \tag{32} \]
Bu exponential moving average, tek bir round'daki dalgalanmanın reputation'ı aniden belirlemesini sınırlar. Kaynakta:
\[ \lambda=0.30. \]
Eşitlik 33: Total reputation
\[ TR_i^t = FR_{Ui}^{t} + FR_{Pi}^{t}. \tag{33} \]
Her historical reputation component \([-1,1]\) aralığında olduğundan \(TR_i^t\) teorik olarak \([-2,2]\) aralığına uzanabilir.
Eşitlik 34: Veri payının contribution ölçeğine taşınması
\[ \pi_i = 2\frac{|D_i|}{|D|} - 1. \tag{34} \]
\(|D_i|/|D|\), client \(i\)'nin toplam verideki payıdır. Lineer dönüşüm bu değeri \([-1,1]\) ölçeğine taşır.
Eşitlik 35: Utility ve Privacy Contribution
\[ UC_i(t) = \alpha_c\pi_i + (1-\alpha_c)FR_{Ui}^{t}, \]
\[ PC_i(t) = \alpha_c\pi_i + (1-\alpha_c)FR_{Pi}^{t}. \tag{35} \]
Kaynakta:
\[ \alpha_c=0.50. \]
Dolayısıyla contribution score'un yarısı mapped data share, yarısı historical reputation'dan gelir.
Eşitlik 36: Model-status sınıflandırması
Kaynak karar eşiğini:
\[ T_{DAI}=0.70 \]
olarak tanımlar ve:
\[ \Psi(PC_i,UC_i) = \begin{cases} Balanced, & PC_i \gt T_{DAI} \land UC_i \gt T_{DAI} \\ Privacy\ Heavy, & PC_i \gt T_{DAI} \land 0\le UC_i\le T_{DAI} \\ Utility\ Heavy, & 0\le PC_i\le T_{DAI} \land UC_i\gt T_{DAI} \\ Low\ Contribution, & 0\le PC_i\le T_{DAI} \land 0\le UC_i\le T_{DAI} \\ No\ Contribution, & PC_i\lt0 \land UC_i\lt0 \end{cases} \tag{36} \]
Kaynak-içi karar boşluğu: Bu piecewise tanım, bir skor negatif diğer skor sıfır veya pozitif olduğunda hangi sınıfın kullanılacağını belirtmemektedir. Örneğin \(PC_i<0\) ve \(UC_i>0\) veya bunun tersi Eq. 36'nın hiçbir dalına girmez. Kaynak uygulama anlatımında bazı kötü niyetli istemcileri “No Contribution” durumuna geçiriyor; ancak mixed-sign durumların implementation'da nasıl ele alındığı açıkça formüle edilmemektedir.
Eşitlik 37: Incentive update rule
\[ I_i= \begin{cases} M\leftarrow M+monetary\_benefit, & \Psi=Balanced \\ S\leftarrow global\_correction\_error, & \Psi=Privacy\ Heavy \\ DP\leftarrow DP-0.1, & \Psi=Utility\ Heavy \\ S\leftarrow global\_correction\_error, & \Psi=Low\ Contribution \\ No\ Incentive, & \Psi=No\ Contribution \end{cases} \tag{37} \]
Balanced: Utility ve privacy contribution eşikten yüksek olduğunda monetary benefit verilir.
Utility Heavy: Utility yüksek fakat privacy contribution yetersiz olduğunda privacy budget 0,10 azaltılarak DP güçlendirilir.
Privacy Heavy: Privacy yüksek fakat utility yetersiz olduğunda SCAFFOLD tabanlı global correction error uygulanır.
Low Contribution: İki skor da pozitif fakat eşik altındaysa yine SCAFFOLD correction uygulanır.
No Contribution: Kaynak Eq. 36'da iki skor da negatif olduğunda incentive verilmez.
Yeniden üretilebilirlik sınırı: Kaynak monetary benefit'in parasal miktarını/token birimini ve global_correction_error değerinin exact SCAFFOLD update formülünü bu bölümde raporlamamaktadır. Bu değerler Verianla tarafından uydurulmamıştır.
Table 7'deki DAI ve DP parametreleri
| Parametre | Kaynak değeri |
|---|---|
| Reputation sensitivity \(\gamma\) | 4,0 |
| Historical reputation weight \(\lambda\) | 0,30 |
| Contribution weight \(\alpha_c\) | 0,50 |
| DAI threshold \(T_{DAI}\) | 0,70 |
| DP-Boost adjustment \(\Delta\epsilon\) | 0,10 |
| Gradient clipping norm \(C\) | 1,0 |
| Gaussian noise multiplier \(\sigma\) | 0,50 |
| Privacy parameter \(\delta\) | \(1\times10^{-5}\) |
| Initial privacy budget \(\epsilon_0\) | 1,20 |
| Privacy-budget range | 0,40–2,50 |
| Backbone unfreeze round | 10 |
| Feature-selection threshold | 0,75 cumulative importance |
| Cross-validation folds | 10 |
| Random seed | 42 |
Kaynak-içi privacy-budget notu: Table 7 global initial privacy budget olarak \(\epsilon_0=1,20\) verirken malicious C2 ve free-rider C5 anlatımında erken aşamada \(\epsilon=2,0\) kullanıldığı belirtilmektedir. Kaynak, 1,20 başlangıç değerinden bu client-specific değerlere geçişin tam initialization/adaptation yolunu ayrıca açıklamamaktadır.
Eşitlik 38: Reputation-weighted global aggregation
\[ w^{(t)} = \frac{ \sum_{i=1}^{N} TR_i\,w_i^{(t)} }{ \sum_{i=1}^{N} TR_i }. \tag{38} \]
Kaynağın amacı düşük reputation'a sahip malicious veya free-riding client update'lerinin global model üzerindeki ağırlığını azaltmak, yüksek reputation'a sahip honest istemcilerin etkisini korumaktır.
Matematiksel yorum sınırı: Eq. 33'e göre \(TR_i\), iki \([-1,1]\) historical reputation değerinin toplamıdır ve teorik olarak negatif olabilir. Eq. 38 ise \(TR_i\)'yi doğrudan ağırlık olarak kullanmaktadır. Kaynak:
- negatif \(TR_i\)'lerin sıfıra kırpılıp kırpılmadığını,
- ağırlıkların pozitif aralığa yeniden ölçeklenip ölçeklenmediğini,
- \(\sum_i TR_i=0\) olması durumunda ne yapıldığını
açık biçimde raporlamamaktadır. Verianla Eq. 38'i bu nedenle kaynakta olduğu gibi korumakta ve ek bir normalization kuralı uydurmamaktadır.
Çalışmanın Yöntemi ve Bulguları
Bu Sonuçlar Gerçek Bankalar Arası Bir Saha Uygulamasından mı Elde Edildi?
Hayır. Çalışmada gerçek finans kurumlarının ayrı veri tabanları ve production blockchain altyapısı kullanılmamıştır; tek bir Home Credit Default Risk veri kümesi oversampling sonrasında beş simüle federated client'a dağıtılmış ve honest, label-flipping malicious ve free-riding davranışları kontrollü deney koşullarında oluşturulmuştur.
Near-IID client simulation
| Client | Pay | Kayıt | Class 0 | Class 1 | Rol |
|---|---|---|---|---|---|
| C1 | %40 | 226.149 | %49,50 | %50,50 | Honest |
| C2 | %25 | 141.343 | %49,00 | %51,00 | Malicious |
| C3 | %15 | 84.806 | %50,00 | %50,00 | Honest |
| C4 | %12 | 67.844 | %53,08 | %46,92 | Honest |
| C5 | %8 | 45.230 | %51,00 | %49,00 | Free-rider |
Non-IID client simulation
| Client | Pay | Kayıt | Class 0 | Class 1 | Rol |
|---|---|---|---|---|---|
| C1 | %35 | 197.880 | %70,00 | %30,00 | Honest |
| C2 | %30 | 169.612 | %25,00 | %75,00 | Malicious |
| C3 | %20 | 113.074 | %60,00 | %40,00 | Honest |
| C4 | %8 | 45.230 | %55,00 | %45,00 | Honest |
| C5 | %7 | 39.576 | %22,86 | %77,14 | Free-rider |
Kaynak \(\alpha_D=10,0\) durumunu düşük heterogeneity/near-IID; \(\alpha_D=0,5\) durumunu daha güçlü class skew içeren non-IID senaryo olarak kullanır. Diğer ana deneyler daha gerçekçi kabul edilen \(\alpha_D=0,5\) senaryosunda yürütülmüştür.
Near-IID ve non-IID overhead
| Koşul | Training time (s) | Consensus time (s) | Aggregation time (s) | Evaluation time (s) | Cumulative communication time (s) | Cumulative memory (MB) |
|---|---|---|---|---|---|---|
| \(\alpha_D=10,0\) | 12,56 | 21,07 | 1,15 | 10,25 | 45,03 | 39,42 |
| \(\alpha_D=0,5\) | 13,20 | 21,58 | 2,05 | 11,01 | 47,84 | 40,8 |
Kaynak non-IID durumunda total communication overhead'in %6,24 ve total memory usage'ın %3,50 arttığını raporlamaktadır.
Near-IID ve non-IID predictive performance
| Koşul | AUC | Precision | Recall | F1 |
|---|---|---|---|---|
| \(\alpha_D=10,0\) | 0,92520 ± 0,00003 | 0,84992 ± 0,00003 | 0,75169 ± 0,00008 | 0,79779 ± 0,00003 |
| \(\alpha_D=0,5\) | 0,91501 ± 0,00007 | 0,83732 ± 0,00116 | 0,74946 ± 0,00018 | 0,79096 ± 0,00008 |
Near-IID'den non-IID'ye geçişte kaynak AUC için %1,10; Precision için %1,48; Recall için %0,30 ve F1 için %0,86 azalma hesaplamıştır.
Tablolardaki “±” değerler cross-validation sonuçlarıyla birlikte verilmekte ve kaynak düşük fold varyansı olarak yorumlamaktadır; Table 9 ve Table 13 caption'larında bu “±” değerlerin ayrıca standard deviation mı standard error mı olduğu açık bir sütun etiketiyle tanımlanmamıştır. Bu nedenle Verianla bunları otomatik olarak belirli bir belirsizlik türüne yeniden adlandırmamaktadır.
Honest istemcilerin DAI davranışı
C1, C3 ve C4 için kaynak, DAI müdahalelerinin utility ve privacy contribution'ı yaklaşık 0,70 eşiğinin üzerinde dengeli duruma taşıdığını ve üç honest client'ın yaklaşık 30. communication round civarında dengeli çalışma durumuna yakınsadığını raporlamaktadır.
Utility yüksek fakat privacy düşük olduğunda \(\epsilon\) azaltılır; privacy yüksek utility düşük olduğunda SCAFFOLD correction uygulanır. İki skor da eşik üstüne çıktığında monetary incentive verilir.
Malicious Client C2
C2, non-IID senaryoda toplam verinin %30'una sahiptir. Kaynağa göre 14. tura kadar utility yaklaşık 0,85 civarındadır. Label-flipping attack 14. turda başlatılınca utility score yaklaşık 0,78'den −0,25'e düşer ve kaynak C2'nin 15. turdan itibaren “No Contribution” durumuna alınarak incentive'larının kaldırıldığını belirtir.
Karar mantığı notu: Eq. 36 “No Contribution” için hem \(PC_i<0\) hem \(UC_i<0\) koşulunu gerektirir. Kaynak grafiği ve metni saldırıdan sonra utility'nin negatifleşmesini açıkça gösterse de privacy score'un her noktada aynı anda negatif olduğu ayrı biçimde açıklanmaz. Dolayısıyla source narrative ile piecewise Eq. 36'nın implementation bağlantısı tam olarak belgelenmemiştir.
Free-rider Client C5
C5, kaynağa göre anlamlı local training yapmadan outdated update gönderen free-rider'dır. Fig. 8'de final contribution score yaklaşık 0,35 olarak raporlanır ve kaynak bu client'ın incentive almadığını ve global model üzerinde etkisinin kaldırıldığını belirtir.
Ancak Table 4'e göre utility ve privacy contribution skorlarının ikisi de 0 ile 0,70 arasındaysa durum “Low Contribution” ve primary action “Scaffold Incentive”dır. C5 için anlatılan “no incentive” kararının ayrı utility ve privacy score değerlerinden mi, başka implementation kuralından mı geldiği kaynakta tamamen açıklanmamaktadır.
50 tur sonunda contribution score'lar
| Client | Rol | Contribution score |
|---|---|---|
| C1 | Honest | 0,72 |
| C2 | Malicious | −0,20 |
| C3 | Honest | 0,76 |
| C4 | Honest | 0,75 |
| C5 | Free-rider | 0,35 |
Yalnız honest client'lar
Bütün client'ların honest olduğu senaryoda BCFL-DAI-PUB final AUC:
\[ 0.93 \]
değerine ulaşırken BCFL-PS-HER:
\[ 0.88 \]
değerinde kalmıştır.
Honest + malicious + free-rider senaryosu
Karışık senaryoda BCFL-DAI-PUB yaklaşık 0,70 initial AUC'den 0,91 final AUC'ye yükselmiştir. Baseline yaklaşık 0,60'tan 0,86'ya yükselmiştir.
Label-flipping saldırısından toparlanma
| Metrik | BCFL-DAI-PUB | BCFL-PS-HER |
|---|---|---|
| Attack start \(t_s\) | 14 | 14 |
| Attack end \(t_e\) | 18 | 18 |
| Pre-attack AUC | ≈0,81 | ≈0,70 |
| Recovery round \(t_r\) | 25 | 34 |
| Attack-onset recovery | 11 tur | 20 tur |
| Post-attack recovery delay | 7 tur | 16 tur |
| Son performans | ≈0,91 | ≈0,86 |
20/11 oranı:
\[ \frac{20}{11}\approx1.82 \]
olduğundan baseline'ın attack-onset recovery süresi önerilen yöntemin yaklaşık 1,82 katıdır.
Gradient Inversion Attack deney düzeni
GIA:
- 50. communication round'da,
- batch size = 1 ile,
- beş client üzerinde,
- iGIA ve DiffGIA bileşenleri, analytical gradient matching, total-variation/range regularization ve randomized diffusion timestep'leri kullanılarak
uygulanmıştır.
Her saldırı client başına beş kez tekrarlanmış ve Table 11 mean ± standard deviation olarak raporlanmıştır.
| Metrik | BCFL-PS-HER | BCFL-DAI-PUB | Yorum |
|---|---|---|---|
| MAE — tüm 122 feature | 4.821 ± 387 | 42.105 ± 2.310 | Proposed'da saldırgan reconstruction error 8,7× daha yüksek |
| MAE — Income | 12.104 ± 1.208 | 91.332 ± 9.104 | Proposed'da 7,6× daha yüksek |
| Gender Inference Accuracy | 0,93 ± 0,04 | 0,52 ± 0,06 | −0,41 absolute |
| Reconstructed-data TARGET AUC | 0,823 ± 0,009 | 0,569 ± 0,014 | −0,254 |
Bu tabloda reconstruction MAE'nin yükselmesi BCFL-DAI-PUB'un kredi tahmin modelinin kötüleştiği anlamına gelmez; saldırganın private sample reconstruction'ının daha kötü hale geldiğini gösterir.
Kaynağın conclusion bölümü gradient inversion “success rate”inin 7,6 kat düşürüldüğünü ifade etmektedir. Ancak Table 11'de 7,6× olarak doğrudan ölçülen büyüklük Income MAE artışıdır. Verianla bu nedenle 7,6× değerini attack-success probability olarak yeniden adlandırmamaktadır.
Membership Inference Attack sonuçları
| Yöntem | Başlangıç AdvMIA | 50. tur AdvMIA | Final \(R_{MIA}=1-Adv_{MIA}\) |
|---|---|---|---|
| BCFL-PS-HER | ≈0,50 | ≈0,22 | %78 |
| BCFL-DAI-PUB | ≈0,40 | ≈0,05 | %95 |
Kaynak:
\[ \frac{0.95}{0.78}\approx1.22 \]
oranıyla önerilen yöntemin yaklaşık 1,22× daha yüksek MIA resistance sunduğunu belirtmektedir.
Şekil etiket notu: Source Figure 16'nın caption'ı doğru biçimde “MIA Advantage” derken grafiğin üst başlığında “Membership Inference Attack Resistance” ifadesi kullanılmış ve “Lower is Better” yazılmıştır. Düşük olması gereken metrik resistance değil \(Adv_{MIA}\)'dır. Verianla MIA Advantage ile MIA Resistance'ı birbirinden ayrı tutmaktadır.
System overhead karşılaştırması
| Metrik | BCFL-PS-HER | BCFL-DAI-PUB |
|---|---|---|
| Training time | 14,01 s | 13,20 s |
| Consensus time | 22,04 s | 21,58 s |
| Aggregation time | 4,12 s | 2,05 s |
| Evaluation time | 12,00 s | 11,01 s |
| Cumulative communication time | 52,17 s | 47,84 s |
| Consensus size | 5,21 MB | 5,01 MB |
| Chain size | 2,12 MB | 1,78 MB |
| Model update size | 39,27 MB | 34,01 MB |
| Cumulative memory | 46,60 MB | 40,8 MB |
Kaynak BCFL-DAI-PUB'un cumulative communication overhead'ini baseline'a göre %8,29; cumulative storage/memory overhead'ini %12,45 daha düşük raporlamaktadır.
Terminoloji sınırı: Kaynağın “communication overhead” olarak verdiği 52,17 ve 47,84 değerleri saniye cinsindedir; network-byte miktarı değildir. Bu nedenle bunlar communication-cycle time / cumulative communication time olarak yorumlanmalıdır.
Throughput
Aynı beş-client konfigürasyonunda:
| Yöntem | Throughput |
|---|---|
| BCFL-PS-HER | 10.837,20 records/s |
| BCFL-DAI-PUB | 11.817,56 records/s |
Kaynak artışı %9,05 olarak hesaplamaktadır.
Bu değer blockchain transaction per second değildir. Ölçüm, beş-client deneyinde işlenen record/s değeridir.
10-fold baseline karşılaştırması
| Yöntem | AUC | Precision | Recall | F1 |
|---|---|---|---|---|
| BCFL-PS-HER | 0,86071 ± 0,00123 | 0,81916 ± 0,00131 | 0,72159 ± 0,0021 | 0,76727 ± 0,00102 |
| BCFL-DAI-PUB | 0,91501 ± 0,00007 | 0,83732 ± 0,00116 | 0,74946 ± 0,00018 | 0,79096 ± 0,00008 |
Kaynak göreli iyileşmeleri:
- AUC: %6,31
- Precision: %2,22
- Recall: %3,86
- F1: %3,09
olarak hesaplamaktadır.
Ablation study
| Konfigürasyon | Free-rider kontrolü | Malicious kontrolü | Recovery | GIA koruması | MIA koruması | Single point of failure koruması | Model performansı |
|---|---|---|---|---|---|---|---|
| BC + FL + IM + DP — tam BCFL-DAI-PUB | Evet | Evet | Evet | Evet | Evet | Evet | 0,91 |
| DP kaldırılmış: BC + FL + IM | Evet | Evet | Evet | Hayır | Hayır | Evet | 0,87 |
| DP + IM kaldırılmış: BC + FL | Hayır | Hayır | Hayır | Hayır | Hayır | Evet | 0,80 |
| FL-only senaryo — kaynak model sütununa göre | Hayır | Hayır | Hayır | Hayır | Hayır | Hayır | 0,76 |
Kaynak-içi Table 15 notu: Son satırın “Architectural Components” etiketi DP, FL, IM ve BC'nin kaldırıldığını söylüyor görünürken aynı satırın “Models” sütununda FL yazmaktadır. Hemen sonraki tartışma da blockchain ve incentive kaldırıldığında yalnız federated learning kaldığını anlatır. Bu nedenle Verianla son satırı “FL-only” olarak açıklar fakat kaynak etiketindeki çelişkiyi gizlemez.
Çalışmanın desteklediği sonuçlar
- BCFL-DAI-PUB, çalışmanın beş-client simülasyonunda BCFL-PS-HER'den daha yüksek predictive AUC raporlamıştır.
- Non-IID veri dağılımında performans near-IID senaryoya göre bir miktar düşmesine rağmen kaynak ölçümlerinde kararlı kalmıştır.
- DAI mekanizması kaynak simülasyonunda honest, malicious ve free-rider davranışlarını farklılaştırmıştır.
- Label-flipping saldırısından attack-onset recovery önerilen yöntemde 11, baseline'da 20 tur olarak ölçülmüştür.
- Optimizer-level DP, GIA reconstruction MAE'sini artırmış; gender inference ve reconstructed-data predictive utility'yi azaltmıştır.
- BCFL-DAI-PUB'un final MIA Advantage değeri baseline'dan daha düşüktür.
- Önerilen yöntem aynı beş-client konfigürasyonunda daha düşük cumulative communication time ve memory overhead ile daha yüksek records/s throughput raporlamıştır.
- Ablation tablosu, DP'nin inference-attack korumasına ve incentive mechanism'ın malicious/free-rider kontrolüne önemli katkı sağladığını kaynak deneyinde göstermektedir.
Çalışmanın desteklemediği genellemeler
- BCFL-DAI-PUB'un gerçek banka sistemlerinde aynı AUC, privacy veya recovery değerlerini sağlayacağı kanıtlanmamıştır.
- Beş simulated client, beş gerçek finans kurumunun operasyonel davranışını temsil eden saha doğrulaması değildir.
- 11.817,56 records/s değeri public blockchain transaction throughput'u değildir.
- 0,91 AUC kredi kararı için düzenleyici, klinik veya ekonomik yeterlilik eşiği değildir.
- %95 MIA resistance bütün membership-inference saldırı türlerine karşı evrensel koruma garantisi değildir; çalışma Yeom-style loss-threshold attack üzerinden değerlendirme yapmıştır.
- GIA sonuçları bütün gradient reconstruction algoritmalarının başarısız olacağını kanıtlamaz; kaynak belirli iGIA/DiffGIA tabanlı attack pipeline kullanmıştır.
- PBFT kullanılması blockchain katmanını bütün saldırılara karşı güvenli hale getirmez.
- DAI'nin monetary incentive kısmının gerçek ekonomik teşvik sistemlerinde nasıl davranacağı deneysel olarak test edilmemiştir.
- Kaynakta gerçek kredi verme kararlarının finansal kayıp, fairness veya düzenleyici sonuçları ölçülmemiştir.
Yeniden üretilebilirlik ve kaynakta açık bırakılan ayrıntılar
Oversampling yöntemi: Minority-class oversampling uygulanmıştır; kullanılan sampling algoritmasının adı ve fold-level isolation prosedürü ayrıntılı verilmemiştir.
Blockchain implementation: Smart contract, blockchain, PBFT ve IPFS tanımlanmaktadır; ancak kullanılan gerçek blockchain platformu/chain implementation'ı ayrıntılı biçimde adlandırılmamıştır.
Donanım: CPU, GPU, RAM ve fiziksel deney ortamı kaynakta ayrıntılı reproducibility table içinde verilmemektedir.
Training ayarları: DAI/DP parametreleri açık verilmesine rağmen local epoch sayısı, genel model learning rate'i ve ana training batch size gibi bütün eğitim parametreleri eksiksiz raporlanmamıştır. GIA deneyi için batch size=1 açıkça verilmektedir.
Cross-validation: 10 fold ve random seed 42 raporlanmaktadır; oversampling, federated partitioning ve model training'in her fold içinde tam olarak hangi sırayla yeniden gerçekleştirildiğine ilişkin bütün ayrıntılar verilmemiştir.
SCAFFOLD correction: DAI action olarak global_correction_error kullanmaktadır; exact SCAFFOLD control-variate denklemi ve correction magnitude bu makalenin DAI bölümünde ayrıntılı olarak türetilmemiştir.
Monetary incentive: “monetary_benefit” sembolik action olarak verilir; gerçek para/token miktarı, bütçe ve ödeme ekonomisi belirtilmez.
DAI mixed-sign durumları: Eq. 36'da bir contribution negatif, diğeri nonnegative olan bölgeler açıkça sınıflandırılmamıştır.
Reputation aggregation: Eq. 38'de negatif veya sıfır toplam reputation durumunun implementation davranışı açıklanmamıştır.
Privacy-budget başlangıcı: Table 7'de \(\epsilon_0=1,20\), bazı client anlatımlarında \(\epsilon=2,0\) görülmektedir; client-specific initialization yolu açık değildir.
MIA figure terminolojisi: Figure 16 caption/y-axis \(Adv_{MIA}\) ölçerken grafik başlığında “resistance” ifadesi kullanılmaktadır. Düşük olması gereken quantity \(Adv_{MIA}\)'dır.
GIA 7,6× ifadesi: Table 11 doğrudan Income MAE'nin 7,6× artmasını ölçer; bu nedenle “attack success probability 7,6× düştü” şeklinde yeni bir metrik oluşturulmamalıdır.
Yöntemin uygulama anlamı
Kaynak çalışma, kurumların ham borrower kayıtlarını merkezi bir havuza taşımadan ortak kredi-riski modeli eğitme fikrini blockchain auditability, optimizer-level privacy ve contribution-sensitive governance ile birleştirmektedir. Mimari açıdan en önemli yeniliklerden biri yalnız model update'i güvenceye almak değil, istemcinin utility ve privacy davranışını incentive kararının parçası haline getirmesidir.
Bununla birlikte production finans sistemine geçişte gerçek kurum verisi, düzenleyici gereklilikler, fairness, model-risk yönetimi, blockchain deployment maliyeti, smart-contract güvenliği, veri dağılımı değişimi, gerçek saldırgan davranışları ve uzun dönem incentive ekonomisi ayrıca doğrulanmalıdır.
Kaynak ve Yöntem Notu
Özgün çalışma: BCFL-DAI-PUB: Blockchain-integrated federated learning with dynamic adaptive incentives for privacy-utility balanced credit risk modelling
Yazarlar: Padmaja Ramachandra; Santhi Vaithiyanathan.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş katkı: Padmaja Ramachandra ve Santhi Vaithiyanathan kaynakta eş katkılı yazarlar olarak işaretlenmiştir.
Corresponding author: Santhi Vaithiyanathan.
Kurum 1: Vellore Institute of Technology, School of Computer Science and Engineering, Vellore, Tamil Nadu, India.
Kurum 2: Vellore Institute of Technology, School of Computer Science and Engineering, Chennai, Tamil Nadu, India.
Dergi: PLOS ONE.
Yayınevi: PLOS.
Cilt / sayı / makale numarası: 21(10): e0361223.
DOI: 10.1371/journal.pone.0361223.
Resmî kayıt: DOI 10.1371/journal.pone.0361223 üzerinden PLOS ONE makale sayfası.
Alınma tarihi: 28 Ocak 2026.
Kabul tarihi: 7 Ekim 2026.
Yayın tarihi: 29 Ekim 2026.
Kaynak türü: Hakemli research article.
Hakemlik: Evet; PLOS ONE'da yayımlanmış hakemli Version of Record.
Lisans: Creative Commons Attribution License (CC BY). Kaynak, özgün yazar ve kaynak gösterildiğinde kullanım, dağıtım ve yeniden üretime izin veren açık erişim lisansı bildirmektedir.
Veri erişilebilirliği: Home Credit Default Risk verileri Kaggle üzerinde erişilebilir olarak raporlanmıştır; makale özellikle HC_application_train.csv dosyasını işaret etmektedir.
Finansman: Yazarlar çalışma için özel finansman alınmadığını bildirmiştir.
Çıkar çatışması: Yazarlar competing interest bulunmadığını beyan etmiştir.
Kod erişilebilirliği: Makalede ayrı bir public source-code repository bağlantısı raporlanmamaktadır.
Yazar katkıları: Conceptualization: Padmaja Ramachandra. Data curation: Padmaja Ramachandra. Formal analysis: Padmaja Ramachandra ve Santhi Vaithiyanathan. Investigation: Santhi Vaithiyanathan. Methodology: Padmaja Ramachandra. Resources: Santhi Vaithiyanathan. Supervision: Santhi Vaithiyanathan. Validation: Padmaja Ramachandra. Visualization: Padmaja Ramachandra. Writing — original draft: Padmaja Ramachandra. Writing — review & editing: Santhi Vaithiyanathan.
Çalışmanın temel bilimsel türü: Kamuya açık kredi-riski veri kümesi üzerinde, verilerin simüle federated client'lara bölündüğü; malicious ve free-rider davranışlarının kontrollü biçimde enjekte edildiği blockchain-federated learning bilgisayar deneyi.
Veri preprocessing: Özgün 307.511 kayıt, minority oversampling sonrası 565.372 dengeli kayda çıkarılmıştır. Raw 122 feature, global One-Hot Encoding sonrası 245 feature'a dönüşmüş ve SHAP cumulative importance %75 threshold ile 184 feature seçilmiştir.
Federated heterogeneity: Near-IID için Dirichlet \(\alpha_D=10,0\), non-IID için \(\alpha_D=0,5\) kullanılmıştır. Ana sonraki deneyler non-IID ortamda yapılmıştır.
Client davranışları: Üç honest client, bir label-flipping malicious client ve bir free-rider client.
Consensus: Client update ve peer-evaluation transaction'larının doğrulanması için PBFT kullanıldığı belirtilmektedir.
Off-chain / on-chain ayrımı: Numerical model/SHAP hesaplamalarının off-chain yürütüldüğü, global schema'nın IPFS'te saklandığı ve cryptographic reference/hash'lerin blockchain üzerinde kayıt altına alındığı belirtilmektedir.
Privacy yöntemi: Gradient clipping + Gaussian noise kullanan optimizer-level differential privacy; başlangıç privacy budget \(\epsilon_0=1,20\), range 0,40–2,50, \(\delta=10^{-5}\), \(C=1,0\), \(\sigma=0,50\).
DAI: \(T_{DAI}=0,70\); \(\gamma=4,0\); \(\lambda=0,30\); \(\alpha_c=0,50\); \(\Delta\epsilon=0,10\).
Gizlilik saldırıları: Gradient Inversion Attack ve Yeom-style black-box Membership Inference Attack.
Poisoning: Label-flipping attack 14–18. communication round arasında uygulanmıştır.
İstatistik: GIA Table 11 sonuçları beş client üzerindeki tekrarlardan mean ± standard deviation olarak raporlanır. Predictive performance için 10-fold cross-validation kullanılır. Kaynak p-value, confidence interval veya effect-size tabanlı inferential significance test sunmamaktadır.
Baseline: BCFL-PS-HER; homomorphic encryption ve static reputation yaklaşımını kullanan blockchain-federated baseline olarak ele alınmıştır.
Temel yorum sınırı: Çalışmanın deneyleri gerçek finans kurumlarının birbirinden bağımsız veritabanları veya gerçek production blockchain ağı üzerinde yapılmamıştır. Sonuçların gerçek bankacılık uygulamasına aktarılması ayrıca doğrulanmalıdır.
Kaynak-içi metodolojik belirsizlikler: Oversampling algoritmasının tam türü ve fold isolation, gerçek blockchain implementation/platform, hardware/software stack, monetary incentive miktarı, exact SCAFFOLD correction equation, Eq. 36 mixed-sign durumları, Eq. 38 negatif/sıfır reputation-weight davranışı ve client-specific privacy-budget initialization ayrıntılı biçimde raporlanmamaktadır.
Kaynak-içi raporlama notları: Table 15'in son ablation satırı etiket ile “Models=FL” sütunu arasında tutarsızlık içerir; Figure 16 grafik başlığı MIA “resistance” dese de çizilen büyüklük MIA Advantage'dır; conclusion'daki 7,6× GIA ifadesinin doğrudan tablo karşılığı Income reconstruction MAE'nin 7,6× büyümesidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir