


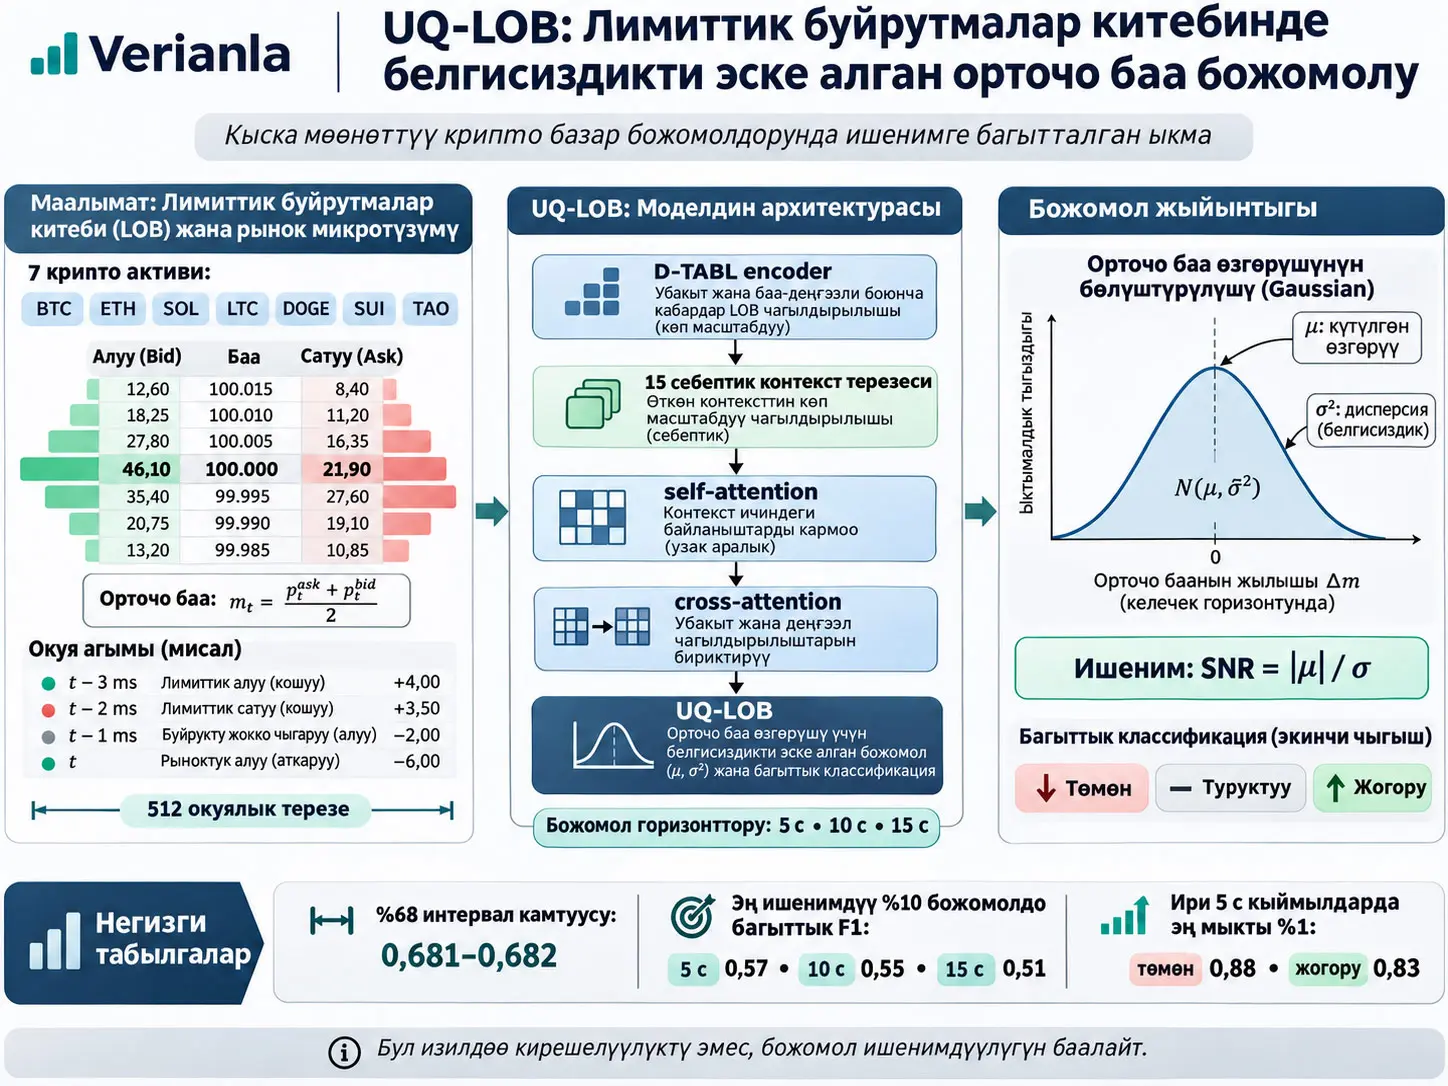
UQ-LOB — алдын ала үйрөтүлгөн лимиттик буйруктар китебинин (Limit Order Book, LOB) encoderʼынын жашыруун өкүлчүлүгүнүн үстүнө кошулуучу, божомолдун багытын же баа өзгөрүүсүн гана эмес, божомол канчалык ишенимдүү экенин да моделдеген encoder-agnostic белгисиздикти сандык баалоо модулу. Изилдөөдө UQ-regression келечектеги орточо баанын өзгөрүшү үчүн \(\mathcal{N}(\mu,\sigma^2)\) түрүндөгү Gaussian predictive distribution чыгарат, ал эми UQ-classification төмөн, жогору жана stationary класстары үчүн categorical distribution чыгарат. UQ-regression ишеним өлчөмү \(|\mu|/\sigma\) signal-to-noise ratio (SNR), ал эми UQ-classification ишеним өлчөмү эң жогорку softmax class probability мааниси болуп саналат.
Изилдөө Kraken cryptocurrency exchangeʼтин public market-data APIʼсинен чогултулган болжол менен 5,2 миллиард Level-2 жана Level-3 order-book окуясын колдонот. Bitcoin, Ethereum, Solana, Litecoin, Dogecoin, Sui жана Bittensor болгон жети USD-quoted asset өз-өзүнчө 5, 10 жана 15 секунддук божомол горизонтторунда моделденген. Ар бир input 512 ырааттуу order-book окуясынан турат. Модель target windowʼдон мурда аяктаган жана натыйжалары божомол учурунда буга чейин ишке ашкан 15 context windowʼну колдонуп, учурдагы рынок режимине gradient update кылбастан ыңгайлашууга аракет кылат.
UQ-regressionʼдун номиналдык %68 predictive intervalʼы тестте %68,1–68,2 эмпирикалык coverage камсыздап, номиналдык деңгээлге абдан жакын калган. Ал эми номиналдык %95 интервал болгону %90,4–90,7 coverage камсыздап, модель бөлүштүрүүнүн оор куйруктарын Gaussian божомолу менен жетиштүү камтый албаганын көрсөткөн. Confidence gating аркылуу эң ишенимдүү %10 божомол гана калтырылганда directional macro F1 UQ-regression үчүн 5 секундда 0,42-ден 0,57-ге, 10 секундда 0,41-ден 0,55-ке жана 15 секундда 0,40-тан 0,51-ге жогорулаган.
Чоң реалдуу кыймылдарда, башкача айтканда реалдуу displacement чоңдугунун жогорку үчтөн бир бөлүгүнө кирген мисалдарда, UQ-regressionʼдун эң ишенимдүү %1 катмары 5 секундда төмөн багыт үчүн 0,88 жана жогору багыт үчүн 0,83 F1 алган. Бирок изилдөө реалдуу trading profitability, net return, transaction-cost-adjusted P&L же жандуу execution көрсөткүчүн өлчөбөйт. Натыйжалар кыска мөөнөттүү баа багыты жана displacement божомолунун ишенимдүүлүгү менен чектелет.
UQ-LOB Деген Эмне жана Чекиттик Божомолдон Кантип Айырмаланат?
UQ-LOB LOB encoder бир гана баа багытын же displacement маанисин чыгаргандан тышкары, божомолдун ыктымалдык бөлүштүрүлүшүн жана мисалга мүнөздүү белгисиздикти эсептеген uncertainty-quantification head; UQ-regression келечектеги tick displacement үчүн \(\mu\) жана \(\sigma^2\) чыгарат, ал эми UQ-classification үч directional class үчүн ыктымалдык бөлүштүрүлүшүн чыгарат.
Лимиттик буйруктар китеби жана орточо баа деген эмне?
Limit Order Book — электрондук рынокто али аткарылбаган сатып алуу жана сатуу буйруктарын баа деңгээлдери боюнча сактаган рынок механизми. Эң жогорку сатып алуу баасы best bid, эң төмөн сатуу баасы best ask деп аталат. Бул эки баанын ортосундагы айырма spread болуп саналат.
Изилдөө божомолдоого аракет кылган mid-price — best bid менен best ask ортосундагы орто чекит. Концептуалдык түрдө:
\[ p_{\mathrm{mid}} = \frac{p_{\mathrm{bid}}+p_{\mathrm{ask}}}{2}. \]
Бул теңдеме макаланын номерленген изилдөө теңдемелеринин бири эмес; окурман mid-price түшүнүгүн түшүнүшү үчүн берилген негизги аныктама.
Эмне үчүн баа багыты гана жетишсиз?
Модель “баа жогорулайт” деп айтышы мүмкүн; бирок эки өзүнчө божомол бир багытты көрсөткөнү менен алардын ишенимдүүлүгү бирдей болбошу мүмкүн. UQ-LOB бул маселени input-dependent aleatoric uncertainty аркылуу карайт. Бул жерде aleatoric uncertainty рынок байкоосунун өзүндөгү мисалга мүнөздүү белгисиздикти билдирет. Бул изилдөө epistemic uncertaintyʼни, башкача айтканда модель параметрлеринин белгисиздигин түздөн-түз моделдебейт.
UQ-regression point estimate ордуна:
\[ y^t \mid h^t,\mathcal{C} \sim \mathcal{N}(\mu,\sigma^2) \]
түрүндө predictive distribution түзөт. \(\mu\) божомолдонгон tick displacementʼтын борбордук мааниси; \(\sigma\) болсо божомолдун белгисиздигин билдирет.
Context set эмне үчүн колдонулат?
Каржылык microstructure бир күндүн ичинде да өзгөрүшү мүмкүн. UQ-LOB target predictionʼды target hidden representation аркылуу гана жасоонун ордуна жакынкы өткөндө аяктаган жана outcomeʼдары божомол учурунда буга чейин белгилүү болгон мисалдарды context катары колдонот.
Бир target instance жалпы:
\[ N=C+1 \]
window камтыйт. Изилдөөдө:
\[ C=15, \qquad N=16. \]
Башкача айтканда 15 context window жана 1 withheld target window бирге иштетилет.
Теңдеме 1: Future leakageʼге жол бербеген causal context шарты
\[ e_i^c = t_i^c+d+h \le t, \qquad \forall i\in\{1,\ldots,C\}. \tag{1} \]
Эмнени эсептейт? Context windowʼдун outcome labelʼы target prediction учуру болгон \(t\)ден мурда чындап ишке ашкан-ашпаганын текшерет.
\(t_i^c\): context windowʼдун акыркы event убактысы.
\(d\): execution latency; экспериментте 0,0005 секунд.
\(h\): prediction horizon; негизги эксперименттерде 5, 10 же 15 секунд.
\(e_i^c\): context label толук ишке ашкан убакыт.
Input window targetʼтан мурда келиши гана жетиштүү эмес. Contextʼтин label horizonʼу \(t\)ден ашса, келечектеги маалымат божомолго агып кириши мүмкүн. Теңдеме 1 муну алдын алат.
Теңдеме 2: Context representation
Hidden representations адегенде жалпы projection spaceʼке өткөрүлөт. Context label asset/horizon-specific \(y_{\mathrm{ref}}\) менен масштабдалып, tanh-bounded projectionʼдон өткөрүлөт.
Ар бир context point:
\[ r_i = \mathrm{MLP}_{\mathrm{enc}} \left( [\tilde{h}_i^c;y_i^{\mathrm{proj}}] \right), \qquad i=1,\ldots,C. \tag{2} \]
түрүндө context representationʼга айланат.
\(\tilde{h}_i^c\) — encoder hidden representationʼдын projected абалы. \(y_i^{\mathrm{proj}}\) — ишке ашкан context labelʼдын масштабдалган жана projected абалы. Чарчы кашаалар concatenation дегенди билдирет.
Теңдеме 3: Targetʼтын contextʼке cross-attention колдонушу
Self-attention context set ичиндеги \(r_i\) маанилерин бири-бирине карата кайра салмактагандан кийин target embedding query катары contextʼти окуйт:
\[ r^t = \operatorname{softmax} \left( \frac{qK^\top}{\sqrt{d_r}} \right)V. \tag{3} \]
Бул жерде:
\[ q=W_q\tilde{h}^t, \qquad k_i=W_k\tilde{h}_i^c, \qquad v_i=r_i^{\mathrm{ref}}. \]
\(K\) context keyʼлерди, \(V\) болсо refined context valuesʼтарды саптар боюнча бириктирет. \(d_r=256\) attention dimension.
Бул механизмдин алгоритмдик мааниси мындай: өткөн бардык context windowʼлар тең деп кабыл алынбайт. Target representationʼга көбүрөөк ылайык келген context түзүмдөрү жогорку attention алышы мүмкүн.
UQ-LOB Архитектурасында Regression жана Classification Кантип Айырмаланат?
UQ-regression жана UQ-classification бир эле D-TABL encoder, projection, context encoder, self-attention жана cross-attention trunkʼын бөлүшөт; акыркы decoder гана өзгөрөт: regression decoder \(\mu\) жана variance параметрин чыгарат, classification decoder болсо down/up/stationary үчүн үч logit чыгарат.
Теңдеме 4: Regression decoderʼдун variance чыгарышы
\[ [\mu,\nu] = \mathrm{MLP}_{\mathrm{dec}} ([r^t;\tilde{h}^t]), \qquad \sigma^2 = y_{\mathrm{ref}}^2 \operatorname{softplus}(\nu) + \epsilon. \tag{4} \]
\(\mu\) — predicted tick displacement; \(\nu\) — decoder variance үчүн чыгарган чийки параметр; \(\sigma^2\) — оң predictive variance; \(y_{\mathrm{ref}}\) — asset/horizon-specific tick scale жана \(\epsilon=10^{-8}\) — numerical stability floor мааниси.
Softplus колдонулушу variance терс болуп калбашын камсыздайт. \(y_{\mathrm{ref}}^2\) varianceʼты тиешелүү asset жана horizonʼдун tick масштабына кайра алып келет.
Теңдеме 5: UQ-regressionʼдун жалпы lossʼу
\[ \mathcal{L}_{\mathrm{reg}} = \lambda_1\mathcal{L}_{\mathrm{NLL}} + \lambda_2\mathcal{L}_{\mathrm{WMAE}} + \lambda_3\mathcal{L}_{\mathrm{dir}} + \lambda_4\mathcal{L}_{\mathrm{calib}}. \tag{5} \]
Булакта колдонулган салмактар:
\[ (\lambda_1,\lambda_2,\lambda_3,\lambda_4) = (1.0,0.1,0.5,0.5). \]
Төрт терминдин милдеттери бири-биринен айырмаланат: NLL mean жана varianceʼты probabilistically үйрөнөт; WMAE чоң displacementʼтардын таасирин күчөтөт; directional loss багыт классын колдойт; calibration loss болсо predicted uncertaintyʼнин ишке ашкан residual чоңдугу менен шайкештигин талап кылат.
Heteroscedastic Gaussian NLL
\[ \mathcal{L}_{\mathrm{NLL}} = \mathbb{E} \left[ \frac{1}{2}\log(2\pi\sigma^2) + \frac{(y-\mu)^2}{2\sigma^2} \right]. \]
Heteroscedastic деген \(\sigma\) ар бир input үчүн бирдей туруктуу маани эмес экенин билдирет. Модель айрым windowʼларда төмөн, айрымдарында жогорку uncertainty чыгара алат.
Бул түзүлүштүн белгилүү көйгөйлөрүнүн бири loss attenuation. Модель татаал мисалдарда \(\sigma\)ны чоңойтуп squared residual жазасын азайтышы мүмкүн. Анткени:
\[ \frac{\partial\mathcal{L}_{\mathrm{NLL}}}{\partial\mu} \propto \frac{1}{\sigma^2}. \]
\(\sigma\) өтө чоңойсо, \(\mu\)га жеткен gradient азайышы мүмкүн. Булак WMAE жана directional lossʼту бул көйгөйгө каршы жарым-жартылай колдонот.
Теңдеме 6: Magnitude-weighted MAE
\[ \mathcal{L}_{\mathrm{WMAE}} = \mathbb{E} \left[ w(y) \frac{|\mu-y|}{y_{\mathrm{ref}}} \right], \tag{6} \]
\[ w(y) = \min \left( 1+ \left( \frac{|y|}{y_{\mathrm{ref}}} \right)^p, w_{\max} \right). \]
Булакта:
\[ p=4, \qquad w_{\max}=40. \]
Displacement чоңойгон сайын \(w(y)\) өсөт; муну менен чоң баа кыймылдарынын regression errorʼу кичине кыймылдарга караганда жогорку салмак алат. \(w_{\max}=40\) өтө экстремалдуу мисалдар lossʼту жалгыз үстөмдөп кетишин чектейт.
Теңдеме 7: Directional loss
\[ \mathcal{L}_{\mathrm{dir}} = \mathbb{E} \left[ \mathbf{1}[|y_i|\ge\delta_i] \left( \tilde{\mu}_i-\operatorname{sign}(y_i)m \right)^2 + \mathbf{1}[|y_i|\lt\delta_i] \left| \tilde{\mu}_i-\operatorname{sign}(y_i)m \right| \right]. \tag{7} \]
Бул жерде:
\[ \tilde{\mu}_i=\frac{\mu_i}{y_{\mathrm{ref}}}, \qquad m=1. \]
\(\delta_i\) тиешелүү asset, horizon жана window үчүн directional/stationary threshold.
Чыныгы displacement directional thresholdʼдон ашканда quadratic penalty колдонулуп, predicted mean туура белгидеги \(\pm m\) максатка күчтүүрөөк тартылат. Stationary мисалдарда linear penalty колдонулат; ошентип sign маалыматы сакталат, бирок magnitude боюнча ошол эле катуу тартуу колдонулбайт.
Теңдеме 8: Magnitude-conditional calibration loss
\[ \mathcal{L}_{\mathrm{calib}} = \frac{1}{B} \sum_{b=1}^{B} \left( \mathbb{E}_{i\in\mathcal{B}_b} \left[ \frac{|\mu_i-y_i|}{\sigma_i} \right] - \sqrt{\frac{2}{\pi}} \right)^2. \tag{8} \]
Булакта:
\[ B=3. \]
\(\mathcal{B}_b\) predicted magnitude \(|\mu|\) маанилери боюнча түзүлгөн quantile binʼдер. Standard normal:
\[ Z\sim\mathcal{N}(0,1) \]
үчүн:
\[ \mathbb{E}|Z| = \sqrt{\frac{2}{\pi}}. \]
Калибрленген Gaussian моделде standardised absolute residualʼдын күтүлгөн мааниси ушул максатка жакындашы керек. Loss муну глобалдык деңгээлде гана эмес, predicted magnitude катмарларында өзүнчө талап кылат.
UQ-classification loss
Classification decoder үч class үчүн weighted cross-entropy колдонот:
\[ \mathcal{L}_{\mathrm{cls}} = - \sum_{c=0}^{2} w_c \mathbf{1}[y_{\mathrm{cls}}=c] \log p_c. \]
Class weight:
\[ w_c\propto\frac{1}{f_c}, \qquad \sum_c w_c=3. \]
\(f_c\) training split ичиндеги class frequency. Сейрек class жогорку weight алат.
SNR Менен Тандалма Божомол Эмнени Билдирет?
UQ-regressionʼдо confidence \(SNR=|\mu|/\sigma\) деп аныкталат; модель жогорку SNRʼдүү божомолдорду гана калтырганда predicted displacement чоңдугу жогору жана predicted uncertainty салыштырмалуу төмөн болгон мисалдар тандалат, ошентип coverage азайганда калган божомолдордун directional reliabilityʼси жогорулайт.
Regression confidence
\[ SNR = \frac{|\mu|}{\sigma}. \]
Чоң \(|\mu|\) жана кичине \(\sigma\) жогорку SNR чыгарат. SNR өлчөмсүз, анткени numerator жана denominator бир эле tick-displacement бирдигинде.
Classification confidence
\[ Confidence_{\mathrm{cls}} = \max_c p_c. \]
Classification үчүн моделдин эң жогорку softmax probability мааниси confidence катары колдонулат.
Percentile gating
Confidence percentile \(q\), тест setʼтеги эң ишенимдүү:
\[ (100-q)\% \]
божомолду калтырат.
Мисалы:
\[ q=90 \]
сабы божомолдордун эң ишенимдүү %10-у бааланып жатканын билдирет.
Эмне үчүн үч класстуу macro F1 ордуна directional macro F1 колдонулат?
Confidence gating жогорку-magnitude predictionʼдарды тандагандыктан retained subset ичинде stationary prediction үлүшү тез азаят. Ошондуктан модель directional predictionʼда жакшыраак болуп жатса да stationary F1 нөлгө жакындашы мүмкүн.
Булак ошондуктан:
\[ F1_{\mathrm{directional}} = \frac{ F1_{\mathrm{down}} + F1_{\mathrm{up}} }{2} \]
өлчөмүн негизги gating метрикасы катары колдонот.
Full test set үчүн prior-matched random classifierʼдын күтүлгөн directional macro F1 мааниси:
\[ \frac{1-p_{\mathrm{stat}}}{2}. \]
Бирок gating class compositionʼды өзгөрткөндүктөн full-set random reference gated subsetʼтерге түздөн-түз көчүрүлбөйт.
Predictive interval coverage
Номиналдык %68 interval үчүн:
\[ cov_{68} = \Pr \left[ |y-\mu| \le \sigma \right]. \]
Номиналдык %95 interval үчүн:
\[ cov_{95} = \Pr \left[ |y-\mu| \le 1.96\sigma \right]. \]
Теңдеме 9: Magnitude-weighted \(R^2\)
\[ R_w^2 = 1- \frac{ \sum_i w_i(y_i-\mu_i)^2 }{ \sum_i w_i(y_i-\bar{y}_w)^2 }, \tag{9} \]
\[ \bar{y}_w = \frac{ \sum_i w_i y_i }{ \sum_i w_i }. \]
Бул жердеги \(w_i=w(y_i)\) — Теңдеме 6-дагы magnitude weight. Ошондуктан чоң displacementʼтар standard \(R^2\)ге караганда жогорку таасир алат.
Order-book input кандай маалыматтарды камтыйт?
Ар бир event бир discrete token жана жети continuous feature менен көрсөтүлөт. Token vocabulary жалпы 439 entry жана беш categorical attributeʼтан түзүлөт:
- event type,
- side,
- discretised volume,
- opposing best quoteʼка карата discretised price distance,
- simultaneity flag.
Order-book depth үчүн:
\[ L_{\max}=10. \]
Андан терең eventʼтер алып салынат.
Жети continuous feature:
- log inter-event time,
- opposing best quoteʼка карата log tick distance,
- log relative volume,
- DNFI,
- акыркы 50 event боюнча cumulative DNFI,
- акыркы 200 event боюнча cumulative DNFI,
- QI.
Теңдеме 10: Depth-normalised flow imbalance жана queue imbalance
\[ \mathrm{DNFI}_t = \frac{ \Delta Q_{1,t}^{b} - \Delta Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1], \]
\[ \mathrm{QI}_t = \frac{ Q_{1,t}^{b} - Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1]. \tag{10} \]
\(Q_{1,t}^{b}\) — best bid деңгээлиндеги resting queue size; \(Q_{1,t}^{a}\) — best ask деңгээлиндеги resting queue size.
DNFI queue sizeʼдын мурунку eventʼке салыштырмалуу өзгөрүшүн колдонот жана динамикалык order-flow pressureʼды билдирет. QI болсо ошол эле учурда book ичинде турган bid жана ask liquidity ортосундагы статикалык асимметрияны көрсөтөт.
D-TABL encoder
Изилдөөдө UQ-LOB encoder-agnostic деп айтылганына карабастан, эксперименттик implementation бир гана D-TABL encoder менен жүргүзүлгөн. D-TABL — Temporal Attention-Augmented Bilinear Network түзүлүшүнүн 512-event inputʼка ыңгайлаштырылган тереңирээк варианты.
Оригиналдуу C(TABL) түзүлүшүндөгү эки BL layer ордуна үч BL layer колдонулуп, андан кийин terminal TABL layer кошулган.
Теңдеме 11: Bilinear layer
\[ Y = \phi \left( W_1 X W_2+B \right). \tag{11} \]
\[ X\in\mathbb{R}^{D\times T} \]
input matrix. \(W_1\) feature axisʼти, \(W_2\) temporal axisʼти project кылат. \(B\) learned bias, \(\phi\) болсо ReLU activation.
Теңдеме 12: Temporal attention-augmented bilinear өзгөртүү
Адегенде:
\[ \bar{X}=W_1X \]
эсептелет. Attention score:
\[ E=\bar{X}W \]
жана row-wise softmax менен:
\[ \alpha_{ij} = \frac{ \exp(e_{ij}) }{ \sum_k\exp(e_{ik}) } \]
attention matrix \(A\)ны түзөт.
Андан кийин:
\[ \tilde{X} = \lambda (\bar{X}\odot A) + (1-\lambda)\bar{X}, \qquad Y = \phi (\tilde{X}W_2+B). \tag{12} \]
\(\lambda\in[0,1]\) attention-masked representation менен original projected representation ортосундагы learned mixing coefficient.
Теңдеме 13: Discrete token embeddingʼди continuous features менен бириктирүү
Token embedding table:
\[ E\in\mathbb{R}^{439\times8}. \]
Token \(k\) үчүн:
\[ e_k = E[k,:] \in \mathbb{R}^{8}. \]
Жети continuous feature менен сегиз өлчөмдүү token embedding:
\[ x_t = [x_t^{\mathrm{cont}};e_{k_t}] \in \mathbb{R}^{15}, \qquad t=1,\ldots,512. \tag{13} \]
түрүндө бириктирилет.
Ошентип бүт window:
\[ X\in\mathbb{R}^{15\times512} \]
өлчөмүндө болот.
Regression label кантип түзүлөт?
Windowʼдун акыркы event убактысы \(t\). Модель теориялык жактан ошол эле замат операция жасай албайт деп кабыл алынып, кичине latency:
\[ d=0.0005\,\mathrm{s} \]
кошулат.
\[ t_{\mathrm{start}} = t+d. \]
\(p_{\mathrm{start}}\) — \(t_{\mathrm{start}}\) учурунда же андан кийин көрүнгөн биринчи eventʼтин mid-price мааниси.
Prediction horizon:
\[ t_{\mathrm{end}} = t_{\mathrm{start}}+h. \]
Теңдеме 14: End price smoothing
Бир event баасы microstructure noiseʼга өтө сезгич болушу мүмкүн болгондуктан \(t_{\mathrm{end}}\)ден дароо мурунку \(k=10\) eventʼтин mid-price орточосу алынат:
\[ p_{\mathrm{end}} = \frac{1}{k} \sum_{j\in\mathcal{K}} p_j, \tag{14} \]
\[ \mathcal{K} = \{ \text{\(t_j\le t_{\mathrm{end}}\) koşulunu sağlayan en büyük zamanlı \(k\) event} \}. \]
Regression target:
\[ y_h(t) = p_{\mathrm{end}} - p_{\mathrm{start}}. \]
Бирдиги tick displacement.
Теңдеме 15: Classification threshold
Ар бир asset жана horizon үчүн training splitʼтеги \(h\)-секунддук mid-price log-return standard deviation:
\[ \sigma_h^{\mathrm{LR}} \]
эсептелет.
Threshold:
\[ \tau_h^{\mathrm{LR}} = \alpha \sigma_h^{\mathrm{LR}}. \tag{15} \]
Булакта:
\[ \alpha=0.25. \]
Log-return threshold учурдагы price levelʼге жараша tick displacementʼка айландырылат:
\[ \delta_h(t) = p_{\mathrm{start}} \left[ \exp(\tau_h^{\mathrm{LR}}) - 1 \right]. \]
Теңдеме 16: Down / up / stationary label
\[ c = \begin{cases} 1\;(\mathrm{up}), & y_h(t)\ge\delta_h(t) \\ 0\;(\mathrm{down}), & y_h(t)\le-\delta_h(t) \\ 2\;(\mathrm{stationary}), & \mathrm{otherwise}. \end{cases} \tag{16} \]
Thresholdʼдун эки тарабы симметриялуу. Оң threshold ашса up, терс threshold ашса down, ортодо калса stationary label берилет.
Теңдеме 17: Regression meanʼди classification менен салыштыруу үчүн threshold calibration
Regression mean \(\mu\) үч класстуу баалоого айландырылганда thresholdʼго кошумча \(k^*\) multiplier колдонулат:
\[ \delta_h^\mu(t) = p_{\mathrm{start}} \left[ \exp(k^*\tau_h^{\mathrm{LR}}) - 1 \right]. \]
\(k^*\) validation periodʼдун өзүнчө calibration жарымында:
\[ k^* = \arg\min_k \left| \Pr [ |\mu| \lt \delta_h^{\mu,k}(t) ] - \Pr [ |y_h(t)| \lt \delta_h(t) ] \right|. \tag{17} \]
деп тандалат.
Максат regression predictionʼдардан алынган stationary class үлүшүн чыныгы stationary proportionʼго жакындатуу. Calibration classification headʼдин өз class distributionʼына эмес, true class distributionʼга жараша жүргүзүлөт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Маалымат булагы жана убакыт бөлүнүшү
Изилдөө Kraken cryptocurrency exchangeʼтин public market-data APIʼсинен алынган Level-2 жана Level-3 order-book маалыматтарын колдонот.
| Элемент | Булакта берилген маани |
|---|---|
| Жалпы event | Болжол менен 5,2 миллиард |
| Жалпы asset-day | Болжол менен 600 |
| Assets | BTC, ETH, SOL, LTC, DOGE, SUI, TAO |
| Market | Kraken |
| Quote currency | USD |
| Маалымат мезгили | Ноябрь 2025 – Февраль 2026 |
| Training | 18 Январь 2026-га чейин |
| Validation | 19–31 Январь 2026 |
| Test | 1–15 Февраль 2026 |
| Болжолдуу split | %68 train / %15 validation / %17 test asset-days |
| Негизги horizons | 5 s / 10 s / 15 s |
Validation period эки тең бөлүккө бөлүнгөн: биринчи жарымы model selection, экинчи жарымы Теңдеме 17-деги threshold multiplier calibration үчүн колдонулат. Test period эки validation этабынан тең хронологиялык жактан кийин турат.
Asset боюнча маалымат тыгыздыгы
| Asset | Tick ($) | Күн | Event (миллиард) | Event/күн (миллион) | Event/s | Орточо IET (ms) | 5 s event | 10 s event | 15 s event |
|---|---|---|---|---|---|---|---|---|---|
| BTC | 0,10 | 94 | 1,254 | 13,338 | 156 | 6,42 | 780 | 1560 | 2340 |
| ETH | 0,01 | 70 | 0,903 | 12,899 | 151 | 6,61 | 755 | 1510 | 2265 |
| DOGE | 1,0×10⁻⁷ | 97 | 1,124 | 11,587 | 134 | 7,46 | 670 | 1340 | 2010 |
| SOL | 0,01 | 78 | 0,539 | 6,909 | 80 | 12,50 | 400 | 800 | 1200 |
| TAO | 0,0001 | 84 | 0,577 | 6,870 | 80 | 12,58 | 400 | 800 | 1200 |
| SUI | 0,0001 | 94 | 0,523 | 5,565 | 64 | 15,52 | 320 | 640 | 960 |
| LTC | 0,01 | 83 | 0,276 | 3,326 | 39 | 25,97 | 195 | 390 | 585 |
Бирдей 15 секунддук horizon BTC үчүн орточо болжол менен 2340 event камтыса, LTC үчүн болжол менен 585 event камтыйт. Демек секунд менен бирдей horizon ар башка assetʼтерде ар башка information density билдирет.
Модель parameter сандары
| Компонент | Parameter |
|---|---|
| D-TABL encoder — shared | 268.356 |
| Feature projection — shared | 24.704 |
| CNP context / attention trunk — shared | 766.784 |
| Regression decoder | 165.378 |
| Classification decoder | 165.731 |
| Жалпы regression variant | 1.225.222 |
| Жалпы classification variant | 1.225.575 |
Эки variantʼтын parameter countʼу дээрлик бирдей. Ошондуктан regression менен classification confidence салыштыруусун чоң model-capacity айырмасы менен түшүндүрүүгө болбойт.
Окутуу стратегиясы
Окутуу эки этапта жүргүзүлөт.
- Ар бир asset-horizon жубу үчүн D-TABL encoder үч класстуу classification task үстүндө pretrain кылынат.
- UQ-regression же UQ-classification head encoder checkpointʼке кошулуп, encoder менен бирге end-to-end fine-tune кылынат.
Жети asset × үч негизги horizon:
\[ 7\times3=21 \]
asset-horizon жубун түзөт.
Ар бир жуп үчүн regression жана classification болуп:
\[ 21\times2=42 \]
UQ model variant окутулат.
Негизги тексттеги болжол менен 210 GPU-hour эки UQ варианты үчүн appendixʼте берилген:
\[ 105+105=210 \]
GPU-hour менен шайкеш. Appendix ошондой эле base D-TABL pretraining үчүн болжол менен 78,75 GPU-hour билдирет жана бүт training pipelineʼды болжол менен:
\[ 78.75+105+105 = 288.75 \approx289 \]
GPU-hour деп берет.
Гиперпараметрлер
| Топ | Параметр | Маани |
|---|---|---|
| Input | Window length \(L\) | 512 event |
| Input | Vocabulary \(|\mathcal{V}|\) | 439 |
| Input | Token embedding dimension | 8 |
| Input | Continuous features | 7 |
| Input | Max order-book depth \(L_{\max}\) | 10 |
| Label | Latency \(d\) | 0,0005 s |
| Label | End-price smoothing \(k\) | 10 event |
| Label | Threshold multiplier \(\alpha\) | 0,25 |
| Head | Context size \(C\) | 15 |
| Head | Instances per batch | 16 |
| Head | Projection dimension | 128 |
| Head | Attention dimension \(d_r\) | 256 |
| Head | Attention heads | 4 |
| Head | Context encoder depth | 3 GELU MLP layer |
| Head | Decoder depth | 5 GELU MLP layer |
| Regression | \((\lambda_1,\lambda_2,\lambda_3,\lambda_4)\) | (1,0; 0,1; 0,5; 0,5) |
| Regression | WMAE exponent \(p\) | 4 |
| Regression | \(w_{\max}\) | 40 |
| Regression | Directional margin \(m\) | 1,0 |
| Regression | Calibration bins \(B\) | 3 |
| Regression | Variance floor \(\epsilon\) | \(1\times10^{-8}\) |
| Optimisation | Optimizer | AdamW |
| Optimisation | Encoder learning rate | \(1\times10^{-5}\) |
| Optimisation | Head learning rate | \(5\times10^{-5}\) |
| Optimisation | Weight decay | 0 |
| Optimisation | Warmup | LinearLR, 10k step |
| Optimisation | Cosine restart \(T_0\) | 15k |
| Optimisation | \(T_{\mathrm{mult}}\) | 2 |
| Optimisation | \(\eta_{\min}\) | \(10^{-5}\) |
| Optimisation | \(\gamma\) | 0,5 |
| Training | Max epochs | 15 |
| Training | Random seed train / test | 42 / 999 |
Algorithm 1: Causal context construction
- Бир assetке тиешелүү бардык windowʼлар timestamp тартибине коюлат.
- Target index \(\tau\) үчүн \(j<\tau\) болгон өткөн windowʼлар гана бааланат.
- \(t_j+d+h\le t_\tau\) шартын аткарган, башкача айтканда label outcome target prediction учуруна чейин толук ишке ашкан windowʼлар тандалышы мүмкүн.
- Бул ылайыктуу талапкерлердин timestampʼи эң чоң, башкача айтканда эң жакын өткөндөгү \(C=15\) window context setʼти түзөт.
- Encoder representations жана realised labels context катары, target representation болсо withheld prediction мисалы катары кайтарылат.
Confidence Gating Чынында Канчалык Жакшыртуу Берди?
Жети asset бирге бааланганда UQ-regressionʼдун directional macro F1 мааниси full test setʼтен эң ишенимдүү %10 божомолго өткөндө 5, 10 жана 15 секунддук горизонттордо тиешелүүлүгүнө жараша +0,15, +0,14 жана +0,11 өскөн; UQ-classification үчүн өсүүлөр +0,11, +0,05 жана +0,07 болгон.
| Confidence percentile q | Reg. 5 s | Cls. 5 s | Reg. 10 s | Cls. 10 s | Reg. 15 s | Cls. 15 s |
|---|---|---|---|---|---|---|
| 0 — бардык божомолдор | 0,42 | 0,45 | 0,41 | 0,45 | 0,40 | 0,45 |
| 10 | 0,44 | 0,46 | 0,43 | 0,45 | 0,42 | 0,46 |
| 20 | 0,46 | 0,47 | 0,45 | 0,46 | 0,44 | 0,46 |
| 30 | 0,48 | 0,47 | 0,47 | 0,47 | 0,46 | 0,47 |
| 40 | 0,49 | 0,48 | 0,48 | 0,47 | 0,47 | 0,47 |
| 50 | 0,50 | 0,49 | 0,49 | 0,48 | 0,47 | 0,48 |
| 60 | 0,51 | 0,50 | 0,50 | 0,48 | 0,48 | 0,48 |
| 70 | 0,52 | 0,51 | 0,51 | 0,49 | 0,48 | 0,49 |
| 80 | 0,54 | 0,53 | 0,52 | 0,50 | 0,49 | 0,50 |
| 90 — эң ишенимдүү %10 | 0,57 | 0,56 | 0,55 | 0,50 | 0,51 | 0,52 |
Classification full test setʼте regressionʼдон күчтүү: directional macro F1 болжол менен 0,45 болсо, regression 0,40–0,42 аралыгында. Бирок confidence өскөн сайын regression айырманы жабат. Эң ишенимдүү %10-до regression 5 жана 10 секундда classificationʼдан жогору болсо, 15 секундда абдан кичине айырма менен артта калат: 0,51-ге каршы 0,52.
Чоң кыймылдардагы натыйжалар
Large-move анализи:
\[ |y|>q_{67} \]
шартын колдонот. \(q_{67}\) чыныгы displacement magnitude бөлүштүрүлүшүнүн болжол менен жогорку үчтөн бир чек арасы.
| Horizon | Top %50 ↓ | Top %50 ↑ | Top %30 ↓ | Top %30 ↑ | Top %10 ↓ | Top %10 ↑ | Top %5 ↓ | Top %5 ↑ | Top %1 ↓ | Top %1 ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 0,69 | 0,63 | 0,73 | 0,67 | 0,81 | 0,75 | 0,84 | 0,79 | 0,88 | 0,83 |
| 10 s | 0,65 | 0,59 | 0,68 | 0,63 | 0,75 | 0,70 | 0,78 | 0,73 | 0,85 | 0,78 |
| 15 s | 0,65 | 0,52 | 0,68 | 0,53 | 0,74 | 0,59 | 0,76 | 0,61 | 0,81 | 0,68 |
Бул subsetʼте down жана up class бөлүштүрүлүшү болжол менен тең салмактуу болгондуктан prior-matched random reference болжол менен 0,5. Confidence өскөн сайын үч horizonʼдун баарында directional F1 жогорулайт.
Эмне үчүн %68 Интервал Жакшы Калибрленсе, %95 Интервал Жетишсиз Камтыйт?
UQ-regressionʼдун calibration lossʼу standardised residualʼдын биринчи абсолюттук моментин көздөгөндүктөн болжол менен бир-sigma деңгээлин күчтүү калибрлейт, бирок tick displacement бөлүштүрүлүшүнүн Gaussianʼдан оор куйруктарын түз моделдебегендиктен 1,96-sigma %95 интервал номиналдык деңгээлден төмөн калат.
| Метрика | 5 s | 10 s | 15 s |
|---|---|---|---|
| Coverage 68 — nominal 0,68 | 0,682 | 0,682 | 0,681 |
| Coverage 95 — nominal 0,95 | 0,904 | 0,904 | 0,907 |
| Calibration error | 0,048 | 0,048 | 0,045 |
| NLPD | 5,278 | 5,586 | 5,778 |
Маанилүү таблица түшүндүрмөсү: Pooled coverage 0,682 болуп, calibration error 0,048 болушу карама-каршылык эмес. Булак calibration errorʼду asset боюнча:
\[ |cov_{68}-0.68| \]
маанилеринин орточосу катары аныктайт. Pooled aggregate coverage ар башка assetʼтердеги оң жана терс четтөөлөрдү бири-бирин жокко чыгара тургандай бириктириши мүмкүн; mean absolute asset-level deviation муну кылбайт.
Авторлор %95 undercoverage үчүн future work катары Student-t likelihood же post-hoc conformal recalibration сунуштайт.
Stationary F1 эмне үчүн кыйрайт?
| Метрика | Top %100 | Top %50 | Top %30 | Top %10 | Top %1 |
|---|---|---|---|---|---|
| F1 Down | 0,447 | 0,526 | 0,549 | 0,598 | 0,640 |
| F1 Up | 0,393 | 0,477 | 0,499 | 0,544 | 0,598 |
| F1 Stationary | 0,390 | 0,067 | 0,012 | 0,000 | 0,000 |
| Үч класстуу Macro F1 | 0,410 | 0,357 | 0,353 | 0,381 | 0,413 |
Бул таблица абдан маанилүү баалоо көйгөйүн көрсөтөт. SNR gating жогорку magnitude predictionʼдарды тандагандыктан stationary мисалдар retained subsetʼте барган сайын жоголот. Ошентип Down жана Up F1 жогорулаганда Stationary F1 нөлгө түшүшү мүмкүн. Ошондуктан үч-class macro F1 selective predictionʼдын directional пайдасын туура чагылдырбашы мүмкүн.
BTC үстүндөгү distribution shift
Жети assetʼтин алтоосунда training, validation жана test class proportions салыштырмалуу окшош бойдон калса, BTC ачык өзгөчөлүк.
BTC-USD 5 секунддук horizonʼдо stationary class болжол менен:
Training: %70
Test: %27
болгон.
10 секундда training stationary болжол менен %64 жана test %19; 15 секундда training болжол менен %57 жана test %15.
Булак бул айырманы volatility regime shift деп чечмелейт жана recent realised outcomes менен context conditioning колдонулушунун негизги мотивацияларынын бири катары көрсөтөт. Ошол эле учурда авторлор robustness үчүн узагыраак жана бир нече regime камтыган test мезгили керек экенин белгилешет.
Per-asset label threshold жана scale маанилери
| Asset | \(\sigma_h^{LR}\) | \(\tau_h^{LR}\) | \(y_{\mathrm{ref}}\) — tick | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | |
| BTC | 1,82e−4 | 2,63e−4 | 3,29e−4 | 4,85e−4 | 4,50e−5 | 6,60e−5 | 8,20e−5 | 1,21e−4 | 155 | 181 | 205 | 255 |
| DOGE | 3,65e−4 | 5,12e−4 | 6,25e−4 | 8,81e−4 | 9,10e−5 | 1,28e−4 | 1,56e−4 | 2,20e−4 | 187 | 277 | 352 | 507 |
| ETH | 3,14e−4 | 4,43e−4 | 5,42e−4 | 7,74e−4 | 7,80e−5 | 1,11e−4 | 1,36e−4 | 1,94e−4 | 42 | 56 | 69 | 96 |
| LTC | 3,70e−4 | 5,77e−4 | 6,11e−4 | 8,94e−4 | 9,20e−5 | 1,44e−4 | 1,53e−4 | 2,23e−4 | 2 | 2 | 2 | 3 |
| SOL | 3,58e−4 | 5,10e−4 | 6,18e−4 | 8,83e−4 | 8,90e−5 | 1,28e−4 | 1,55e−4 | 2,21e−4 | 3 | 3 | 4 | 6 |
| SUI | 5,09e−4 | 7,34e−4 | 8,79e−4 | 1,246e−3 | 1,27e−4 | 1,83e−4 | 2,20e−4 | 3,11e−4 | 3 | 5 | 6 | 9 |
| TAO | 5,01e−4 | 6,97e−4 | 8,39e−4 | 1,176e−3 | 1,25e−4 | 1,74e−4 | 2,10e−4 | 2,94e−4 | 628 | 953 | 1059 | 1596 |
30 секунддук маанилер label statistics ичинде берилген; негизги макала эксперименттери 5, 10 жана 15 секунддук horizons боюнча билдирилет.
Бул Изилдөө Кирешелүү Trading Стратегиясын Далилдейби?
Жок. UQ-LOB изилдөөсү directional reliability, displacement fit, uncertainty calibration жана confidence gatingʼди баалайт; чыныгы portfolio P&L, fee-adjusted return, slippage, market impact же жандуу execution натыйжалары өлчөнбөгөндүктөн, изилдөөнү кирешелүүлүктүн далили катары чечмелөөгө болбойт.
Изилдөө колдогон жыйынтыктар
- UQ-regressionʼдун %68 predictive interval coverage мааниси номиналдык деңгээлге абдан жакын.
- %95 Gaussian interval оор куйруктардан улам номиналдык деңгээлден төмөн coverage көрсөткөн.
- SNR confidence gating үч horizonʼдун баарында retained predictionsʼдын directional macro F1 маанисин жогорулаткан.
- UQ-classification softmax confidence да directional macro F1 үчүн маанилүү ranking signal.
- UQ-regression full test setʼте classificationʼдан төмөн directional macro F1 чыгарса да, эң ишенимдүү %10-до айырма жабылат.
- Чоң кыймылдарда жогорку SNR катмарлары күчтүү directional F1 маанилерине жеткен.
- Жакынкы өткөндө ишке ашкан context outcomeʼдарды колдонуу future leakageʼге жол бербеген ачык causal constraint менен жүргүзүлгөн.
- UQ-regression жана UQ-classification дээрлик бирдей parameter count жана бир эле shared trunk үстүндө салыштырылган.
Изилдөө колдобогон жыйынтыктар
- Модель чыныгы акча менен кирешелүү экени көрсөтүлгөн эмес.
- Confidence gating transaction costʼтон кийинки таза киреше берет деп далилденген эмес.
- %68 calibration бардык рынок режимдеринде туруктуу calibration кепилдиги эмес.
- %95 interval номиналдык coverage берет деп айтууга болбойт; өлчөнгөн coverage болжол менен %90,4–90,7.
- Encoder-agnostic дизайн бардык LOB encoderʼлар менен эксперименттик түрдө тастыкталган эмес; изилдөө D-TABL колдонгон.
- Натыйжалар башка биржага, башка asset classʼка же узагыраак horizonʼдорго автоматтык жалпыланбайт.
- Модель epistemic uncertaintyʼни түздөн-түз чечпейт.
- Изилдөө узак мөөнөттүү portfolio risk management же optimal position sizing эксперименти эмес.
Авторлор көрсөткөн чектөөлөр жана келечектеги иштер
Tail calibration: Gaussian likelihood оор куйруктарды жетиштүү көрсөтпөйт. Student-t likelihood же conformal recalibration сунушталат.
Baseline камтуусу: Изилдөө бир shared trunk үстүндөгү эки UQ headʼди салыштырат. MC dropout, deep ensemble жана base encoder softmax gating сыяктуу weight-space uncertainty baselineʼдары менен кеңири салыштыруу жүргүзүлгөн эмес.
Multi-seed белгисиздиги: Авторлор көп seed error barʼлары жана loss/context ablationʼдары келечекте attributionʼду күчөтөрүн белгилешет.
Distribution shift: Айрыкча BTC train/test class distributionʼда күчтүү режим айырмасы бар. Узагыраак жана бир нече regime камтыган test мөөнөтү керек.
Economic evaluation: Directional reliability бааланган; profitability бааланган эмес.
Scope: Моделдер ар бир asset жана horizon үчүн өзүнчө окутулган жана бир trading venue колдонулган. Cross-asset же multi-horizon бирдиктүү модель тесттен өткөрүлгөн эмес.
Этика жана маалымат жеткиликтүүлүгү
Булак exchangeʼтин public APIʼсинен алынган market data гана колдонулганын жана personal data жок экенин билдирет. Модель кыска мөөнөттүү баа кыймылдарын божомолдоп trading чечимдерине таасир этиши мүмкүн; авторлор кирешелүүлүк дооматын койбой турганын жана каржылык тобокелдик сакталарын ачык белгилешет.
Raw Kraken order-book маалыматы exchange менен data-sharing agreement жок болгондуктан кайра таркатылбайт.
Reproducibility Statement complete source code, D-TABL encoder, эки UQ head, training/evaluation pipelineʼдар, context-construction процедурасы, label thresholds, scale маанилери жана dataset statistics жарыяланганын билдирет. Бирок жүктөлгөн PDF ичинде public repositoryʼнин түз URLʼси берилген эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: UQ-LOB: Uncertainty-Aware Limit Order Book Mid-Price Forecasting
Авторлор: Derrick Gilchrist Edward Manoharan; Eljas Linna; Kestutis Baltakys; Hao Dong; Juho Kanniainen.
Авторлордун ирети: Булактагы ирет так сакталган.
Corresponding author: Derrick Gilchrist Edward Manoharan.
Тең салым: Булакта equal-contribution билдирүүсү көрүнбөйт.
Мекеме: Data Science Research Centre, Tampere University, Tampere, Finland.
Платформа: arXiv.
Категория: Computer Science — Artificial Intelligence (cs.AI).
arXiv идентификатору: arXiv:2609.31491v2.
v1 жөнөтүлгөн дата: 25 Сентябрь 2026.
v2 ревизия датасы: 28 Сентябрь 2026.
Булак түрү: Preprint.
Рецензиялоо: Жүктөлгөн v2 arXiv preprint; 21 Ноябрь 2026-га карата рецензияланган журнал Version of Record версиясы тастыкталган эмес.
arXiv/DataCite DOI: 10.48550/arXiv.2609.31491. Бул идентификатор journal DOI эмес.
Расмий шилтеме: https://arxiv.org/abs/2609.31491v2
Булак лицензиясы: Жүктөлгөн PDFде ачык Creative Commons кайра колдонуу лицензиясы тастыкталган эмес. Ошондуктан булак фигуралары түз колдонулган же style transfer менен кайра өндүрүлгөн эмес.
Каржылоо: Жүктөлгөн PDFде өзүнчө funding statement табылган эмес.
Кызыкчылыктардын кагылышы: Жүктөлгөн PDFде өзүнчө competing-interest/conflict-of-interest statement табылган эмес.
Автордук салымдар: Жүктөлгөн PDFде өзүнчө CRediT author-contribution билдирүүсү жок.
Маалымат булагы: Kraken cryptocurrency exchange public market-data API; Level-2 жана Level-3 order-book data.
Raw маалыматка жетүү: Raw data кайра таркатылбайт; булак мунун себебин exchange менен data-sharing agreement жоктугу деп түшүндүрөт.
Код: Reproducibility Statement complete source code жарыяланганын билдирет; бирок PDF ичинде текшериле турган repository URL берилген эмес.
Assets: BTC, ETH, SOL, LTC, DOGE, SUI, TAO.
Негизги prediction horizons: 5 s, 10 s, 15 s.
Label statistics кошумча horizon: 30 s маанилери Appendix Table 7-де өзүнчө берилген; негизги experiment resultʼтар 5/10/15 секунд.
Input window: 512 non-overlapping order-book event.
Context: 15 causal context window + 1 withheld target.
Encoder: D-TABL; үч bilinear layer + terminal temporal-attention-augmented bilinear layer.
UQ-regression: Gaussian predictive distribution \(\mathcal{N}(\mu,\sigma^2)\).
UQ-classification: Down / Up / Stationary categorical prediction.
Regression confidence: \(SNR=|\mu|/\sigma\).
Classification confidence: Maximum softmax probability.
Optimizer: AdamW.
Жабдык: NVIDIA GH200 Grace Hopper Superchip.
Pipeline training чыгымы: Appendix эсеби боюнча болжол менен 78,75 GPU-hour D-TABL pretraining + 105 GPU-hour UQ-regression + 105 GPU-hour UQ-classification = болжол менен 289 GPU-hour. Негизги тексттеги болжол менен 210 GPU-hour деген билдирүү эки UQ variantʼтын жалпы fine-tuning чыгымына шайкеш.
Негизги calibration натыйжасы: %68 nominal interval үчүн 0,681–0,682 coverage; %95 nominal interval үчүн 0,904–0,907 coverage.
Негизги selective-prediction натыйжасы: Эң ишенимдүү %10-го өткөндө UQ-regression directional macro F1 5/10/15 секундда тиешелүүлүгүнө жараша 0,57 / 0,55 / 0,51; UQ-classification 0,56 / 0,50 / 0,52.
Large-move натыйжасы: 5 секундда эң ишенимдүү %1 UQ-regression F1: down 0,88; up 0,83.
Негизги илимий чек: Изилдөө predictive confidence жана directional reliabilityʼни баалайт; реалдуу trading profitability, fee-adjusted P&L, slippage же market impact өлчөбөйт.
Маанилүү кайра өндүрүү чеги: Raw market data кайра таркатылбайт. Ошол эле учурда булак model specification, label procedure, dataset statistics, scale/threshold маанилери жана код жарыяланганын билдирет.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген