


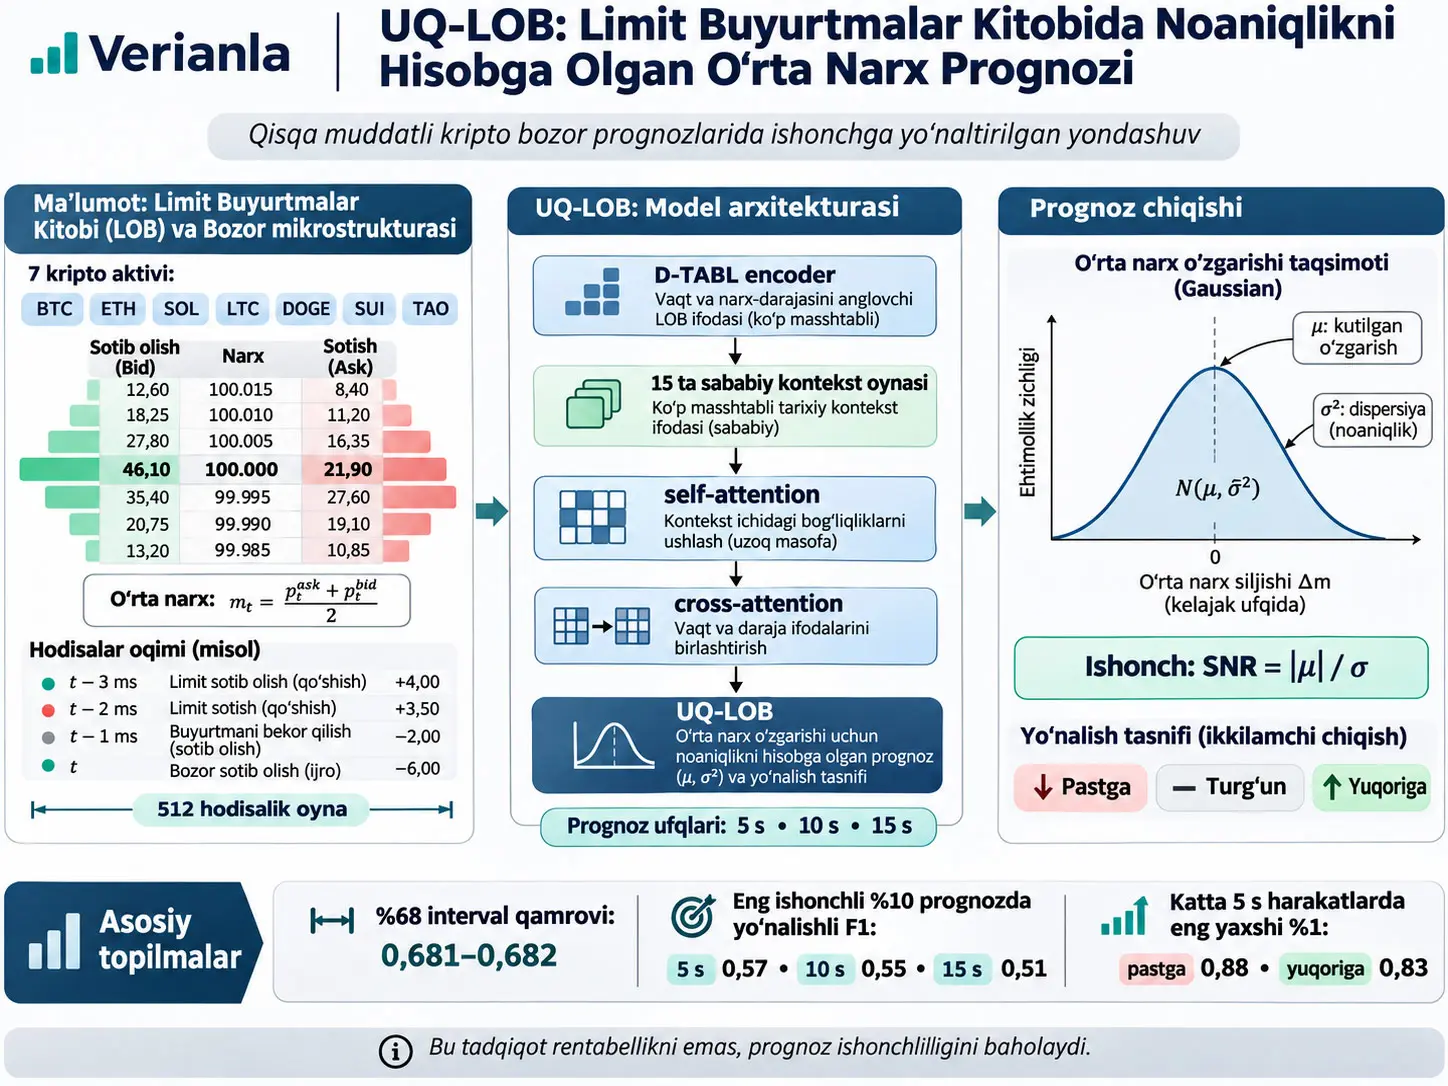
UQ-LOB — oldindan o‘qitilgan limit buyurtmalar kitobi (Limit Order Book, LOB) encoderʼining yashirin ifodasi ustiga qo‘shiladigan, prognozning faqat yo‘nalishi yoki narx o‘zgarishini emas, balki prognoz qanchalik ishonchli ekanini ham modellashtiradigan encoder-agnostic noaniqlikni miqdoriy baholash modulidir. Tadqiqotda UQ-regression kelajakdagi o‘rta narx o‘zgarishi uchun \(\mathcal{N}(\mu,\sigma^2)\) ko‘rinishidagi Gaussian predictive distribution hosil qiladi, UQ-classification esa pastga, yuqoriga va turg‘un sinflar uchun categorical distribution hosil qiladi. UQ-regression ishonch o‘lchovi \(|\mu|/\sigma\) signal-to-noise ratio (SNR), UQ-classification ishonch o‘lchovi esa eng yuqori softmax class probability qiymatidir.
Tadqiqot Kraken cryptocurrency exchangeʼning public market-data APIʼsidan yig‘ilgan taxminan 5,2 milliard Level-2 va Level-3 order-book hodisasidan foydalanadi. Bitcoin, Ethereum, Solana, Litecoin, Dogecoin, Sui va Bittensor kabi yettita USD-quoted asset alohida ravishda 5, 10 va 15 soniyalik prognoz gorizontlarida modellashtirilgan. Har bir input 512 ta ketma-ket order-book hodisasidan iborat. Model target windowʼdan oldin yakunlangan va natijalari prognoz vaqtiga kelib allaqachon ro‘y bergan 15 ta context windowʼdan foydalanib, joriy bozor rejimiga gradient update qilmasdan moslashishga urinadi.
UQ-regressionʼning nominal %68 predictive intervalʼi testda %68,1–68,2 empirik coverage berib, nominal darajaga juda yaqin qolgan. Bunga qarshi nominal %95 interval faqat %90,4–90,7 coverage bergan va model taqsimotning og‘ir dumlarini Gaussian farazi bilan yetarlicha qamrab ololmaganini ko‘rsatgan. Confidence gating yordamida faqat eng ishonchli %10 prognoz qoldirilganda directional macro F1 UQ-regression uchun 5 soniyada 0,42-dan 0,57-ga, 10 soniyada 0,41-dan 0,55-ga va 15 soniyada 0,40-dan 0,51-ga ko‘tarilgan.
Katta haqiqiy harakatlarda, yaʼni haqiqiy displacement kattaligining yuqori uchdan bir qismiga kiradigan namunalarda, UQ-regressionʼning eng ishonchli %1 qatlamida 5 soniyada pastga yo‘nalish uchun 0,88 va yuqoriga yo‘nalish uchun 0,83 F1 olingan. Biroq tadqiqot real trading profitability, net return, transaction-cost-adjusted P&L yoki jonli execution samaradorligini o‘lchamaydi. Natijalar qisqa muddatli narx yo‘nalishi va displacement prognozining ishonchliligi bilan cheklangan.
UQ-LOB Nima va Nuqtaviy Prognozdan Qanday Farq Qiladi?
UQ-LOB LOB encoderʼi bitta narx yo‘nalishi yoki displacement qiymatini chiqarishiga qo‘shimcha ravishda prognozning ehtimollik taqsimoti va namunaga xos noaniqligini hisoblaydigan uncertainty-quantification headʼdir; UQ-regression kelajakdagi tick displacement uchun \(\mu\) va \(\sigma^2\) hosil qiladi, UQ-classification esa uchta directional class uchun ehtimollik taqsimotini hosil qiladi.
Limit buyurtmalar kitobi va o‘rta narx nima?
Limit Order Book — elektron bozorda hali bajarilmagan xarid va sotuv buyurtmalarini narx darajalari bo‘yicha saqlaydigan bozor mexanizmidir. Eng yuqori xarid narxi best bid, eng past sotuv narxi esa best ask deb ataladi. Ushbu ikki narx orasidagi farq spreadʼdir.
Tadqiqot prognozlashga urinayotgan mid-price best bid va best ask orasidagi o‘rta nuqtadir. Konseptual jihatdan:
\[ p_{\mathrm{mid}} = \frac{p_{\mathrm{bid}}+p_{\mathrm{ask}}}{2}. \]
Bu tenglama maqolaning raqamlangan tadqiqot tenglamalaridan biri emas; u o‘quvchi mid-price tushunchasini anglashiga yordam beruvchi asosiy taʼrifdir.
Nega faqat narx yo‘nalishi yetarli emas?
Model “narx yuqoriga ketadi” deyishi mumkin; ammo ikkita alohida prognoz bir xil yo‘nalishni ko‘rsatsa ham, ularning ishonchliligi bir xil bo‘lmasligi mumkin. UQ-LOB bu muammoni input-dependent aleatoric uncertainty orqali ko‘rib chiqadi. Bu yerda aleatoric uncertainty bozor kuzatuvining o‘zidagi namunaga xos noaniqlikni ifodalaydi. Ushbu tadqiqot epistemic uncertaintyʼni, yaʼni model parametrlarining nomaʼlumligini bevosita modellashtirmaydi.
UQ-regression point estimate o‘rniga:
\[ y^t \mid h^t,\mathcal{C} \sim \mathcal{N}(\mu,\sigma^2) \]
ko‘rinishida predictive distribution hosil qiladi. \(\mu\) prognoz qilingan tick displacementʼning markaziy qiymati; \(\sigma\) esa prognoz noaniqligini ifodalaydi.
Context set nega ishlatiladi?
Moliyaviy microstructure hatto bir kun ichida ham o‘zgarishi mumkin. UQ-LOB target predictionʼni faqat target hidden representation orqali qilish o‘rniga yaqin o‘tmishda yakunlangan va outcomeʼlari prognoz vaqtiga kelib maʼlum bo‘lgan namunalarni context sifatida ishlatadi.
Bitta target instance jami:
\[ N=C+1 \]
windowʼni o‘z ichiga oladi. Tadqiqotda:
\[ C=15, \qquad N=16. \]
Yaʼni 15 context window va 1 withheld target window birgalikda qayta ishlanadi.
Tenglama 1: Future leakageʼni oldini oluvchi causal context sharti
\[ e_i^c = t_i^c+d+h \le t, \qquad \forall i\in\{1,\ldots,C\}. \tag{1} \]
Nimani hisoblaydi? Context windowʼning outcome labelʼi target prediction vaqti bo‘lgan \(t\)dan oldin haqiqatda sodir bo‘lgan-bo‘lmaganini tekshiradi.
\(t_i^c\): context windowʼning oxirgi event vaqti.
\(d\): execution latency; tajribada 0,0005 soniya.
\(h\): prediction horizon; asosiy tajribalarda 5, 10 yoki 15 soniya.
\(e_i^c\): context label to‘liq amalga oshgan vaqt.
Faqat input window targetʼdan oldin kelishi yetarli emas. Contextʼning label horizonʼi \(t\)dan oshsa, kelajak maʼlumoti prognozga sizib kirishi mumkin. Tenglama 1 bunga yo‘l qo‘ymaydi.
Tenglama 2: Context representation
Hidden representations avval umumiy projection spaceʼga o‘tkaziladi. Context label asset/horizon-specific \(y_{\mathrm{ref}}\) bilan masshtablanib, tanh-bounded projectionʼdan o‘tkaziladi.
Har bir context point:
\[ r_i = \mathrm{MLP}_{\mathrm{enc}} \left( [\tilde{h}_i^c;y_i^{\mathrm{proj}}] \right), \qquad i=1,\ldots,C. \tag{2} \]
ko‘rinishida context representationʼga aylanadi.
\(\tilde{h}_i^c\) encoder hidden representationʼning projected holati. \(y_i^{\mathrm{proj}}\) amalga oshgan context labelʼning masshtablangan va projected holati. Kvadrat qavslar concatenation maʼnosini bildiradi.
Tenglama 3: Targetʼning contextʼga cross-attention qo‘llashi
Self-attention context set ichidagi \(r_i\) qiymatlarini bir-biriga nisbatan qayta vaznlagach, target embedding query sifatida contextʼni o‘qiydi:
\[ r^t = \operatorname{softmax} \left( \frac{qK^\top}{\sqrt{d_r}} \right)V. \tag{3} \]
Bu yerda:
\[ q=W_q\tilde{h}^t, \qquad k_i=W_k\tilde{h}_i^c, \qquad v_i=r_i^{\mathrm{ref}}. \]
\(K\) context keyʼlarini, \(V\) esa refined context valuesʼlarini satrlar bo‘yicha birlashtiradi. \(d_r=256\) attention dimensionʼdir.
Bu mexanizmning algoritmik maʼnosi shuki, barcha oldingi context windowʼlar teng deb qabul qilinmaydi. Target representationʼga mosroq context tuzilmalari yuqoriroq attention olishi mumkin.
UQ-LOB Arxitekturasida Regression va Classification Qanday Ajraladi?
UQ-regression va UQ-classification bir xil D-TABL encoder, projection, context encoder, self-attention va cross-attention trunkʼini ulashadi; faqat oxirgi decoder o‘zgaradi: regression decoder \(\mu\) va variance parametrini hosil qiladi, classification decoder esa down/up/stationary uchun uchta logit hosil qiladi.
Tenglama 4: Regression decoderʼning variance hosil qilishi
\[ [\mu,\nu] = \mathrm{MLP}_{\mathrm{dec}} ([r^t;\tilde{h}^t]), \qquad \sigma^2 = y_{\mathrm{ref}}^2 \operatorname{softplus}(\nu) + \epsilon. \tag{4} \]
\(\mu\) predicted tick displacement; \(\nu\) decoderʼning variance uchun hosil qilgan xom parametri; \(\sigma^2\) musbat predictive variance; \(y_{\mathrm{ref}}\) asset/horizon-specific tick scale va \(\epsilon=10^{-8}\) numerical stability floor qiymatidir.
Softplus ishlatilishi varianceʼning manfiy bo‘lishini oldini oladi. \(y_{\mathrm{ref}}^2\) varianceʼni tegishli asset va horizonʼning tick masshtabiga qaytaradi.
Tenglama 5: UQ-regressionʼning jami yo‘qotishi
\[ \mathcal{L}_{\mathrm{reg}} = \lambda_1\mathcal{L}_{\mathrm{NLL}} + \lambda_2\mathcal{L}_{\mathrm{WMAE}} + \lambda_3\mathcal{L}_{\mathrm{dir}} + \lambda_4\mathcal{L}_{\mathrm{calib}}. \tag{5} \]
Manbada ishlatilgan vaznlar:
\[ (\lambda_1,\lambda_2,\lambda_3,\lambda_4) = (1.0,0.1,0.5,0.5). \]
To‘rtta terminning vazifalari bir-biridan farq qiladi: NLL mean va varianceʼni probabilistically o‘rganadi; WMAE katta displacementʼlarning taʼsirini oshiradi; directional loss yo‘nalish sinfini qo‘llab-quvvatlaydi; calibration loss esa predicted uncertaintyʼning amalga oshgan residual kattaligi bilan mosligini majburlaydi.
Heteroscedastic Gaussian NLL
\[ \mathcal{L}_{\mathrm{NLL}} = \mathbb{E} \left[ \frac{1}{2}\log(2\pi\sigma^2) + \frac{(y-\mu)^2}{2\sigma^2} \right]. \]
Heteroscedastic \(\sigma\) har bir input uchun bir xil doimiy qiymat emasligini anglatadi. Model ayrim windowʼlarda past, boshqalarida yuqori uncertainty hosil qilishi mumkin.
Bu tuzilmaning maʼlum muammolaridan biri loss attenuationʼdir. Model qiyin namunalarda \(\sigma\)ni kattalashtirib squared residual jazosini kamaytirishi mumkin. Chunki:
\[ \frac{\partial\mathcal{L}_{\mathrm{NLL}}}{\partial\mu} \propto \frac{1}{\sigma^2}. \]
\(\sigma\) haddan tashqari kattalashsa, \(\mu\)ga yetib boradigan gradient kichrayishi mumkin. Manba WMAE va directional lossʼni qisman shu muammoga qarshi ishlatadi.
Tenglama 6: Magnitude-weighted MAE
\[ \mathcal{L}_{\mathrm{WMAE}} = \mathbb{E} \left[ w(y) \frac{|\mu-y|}{y_{\mathrm{ref}}} \right], \tag{6} \]
\[ w(y) = \min \left( 1+ \left( \frac{|y|}{y_{\mathrm{ref}}} \right)^p, w_{\max} \right). \]
Manbada:
\[ p=4, \qquad w_{\max}=40. \]
Displacement kattalashgan sari \(w(y)\) ortadi; shunday qilib katta narx harakatlarining regression errorʼi kichik harakatlarga nisbatan yuqoriroq vazn oladi. \(w_{\max}=40\) haddan tashqari ekstremal namunalarning yolg‘iz o‘zi lossʼni ustun egallashini cheklaydi.
Tenglama 7: Directional loss
\[ \mathcal{L}_{\mathrm{dir}} = \mathbb{E} \left[ \mathbf{1}[|y_i|\ge\delta_i] \left( \tilde{\mu}_i-\operatorname{sign}(y_i)m \right)^2 + \mathbf{1}[|y_i|\lt\delta_i] \left| \tilde{\mu}_i-\operatorname{sign}(y_i)m \right| \right]. \tag{7} \]
Bu yerda:
\[ \tilde{\mu}_i=\frac{\mu_i}{y_{\mathrm{ref}}}, \qquad m=1. \]
\(\delta_i\) tegishli asset, horizon va window uchun directional/stationary thresholdʼdir.
Haqiqiy displacement directional thresholdʼdan oshganda quadratic penalty qo‘llanadi va predicted mean to‘g‘ri ishorali \(\pm m\) maqsadga kuchliroq tortiladi. Stationary namunalarda linear penalty ishlatiladi; shu tariqa sign maʼlumoti saqlanadi, ammo magnitude ustida ayni qattiq tortish qo‘llanmaydi.
Tenglama 8: Magnitude-conditional calibration loss
\[ \mathcal{L}_{\mathrm{calib}} = \frac{1}{B} \sum_{b=1}^{B} \left( \mathbb{E}_{i\in\mathcal{B}_b} \left[ \frac{|\mu_i-y_i|}{\sigma_i} \right] - \sqrt{\frac{2}{\pi}} \right)^2. \tag{8} \]
Manbada:
\[ B=3. \]
\(\mathcal{B}_b\) predicted magnitude \(|\mu|\) qiymatlari asosida tuziladigan quantile binʼlardir. Standard normal:
\[ Z\sim\mathcal{N}(0,1) \]
uchun:
\[ \mathbb{E}|Z| = \sqrt{\frac{2}{\pi}}. \]
Kalibrlangan Gaussian modelda standardised absolute residualʼning kutilgan qiymati ushbu maqsadga yaqinlashishi kerak. Loss buni faqat global emas, predicted magnitude qatlamlarida alohida majburlaydi.
UQ-classification loss
Classification decoder uchta class uchun weighted cross-entropy ishlatadi:
\[ \mathcal{L}_{\mathrm{cls}} = - \sum_{c=0}^{2} w_c \mathbf{1}[y_{\mathrm{cls}}=c] \log p_c. \]
Class weight:
\[ w_c\propto\frac{1}{f_c}, \qquad \sum_c w_c=3. \]
\(f_c\) training split ichidagi class frequencyʼdir. Kam uchraydigan class yuqoriroq weight oladi.
SNR bilan Tanlab Prognozlash Nimani Anglatadi?
UQ-regressionʼda confidence \(SNR=|\mu|/\sigma\) sifatida aniqlanadi; model faqat yuqori SNRʼli prognozlarni saqlaganda ham predicted displacement kattaligi yuqori, ham predicted uncertainty nisbatan past bo‘lgan namunalar tanlanadi, shu bilan coverage kamayadi, qolgan prognozlarning directional reliabilityʼsi esa ortadi.
Regression confidence
\[ SNR = \frac{|\mu|}{\sigma}. \]
Katta \(|\mu|\) va kichik \(\sigma\) yuqori SNR hosil qiladi. SNR o‘lchovsiz, chunki numerator va denominator bir xil tick-displacement birligida.
Classification confidence
\[ Confidence_{\mathrm{cls}} = \max_c p_c. \]
Classification uchun modelning eng yuqori softmax probability qiymati confidence sifatida ishlatiladi.
Percentile gating
Confidence percentile \(q\), test setʼdagi eng ishonchli:
\[ (100-q)\% \]
prognozni saqlaydi.
Masalan:
\[ q=90 \]
qatori prognozlarning eng ishonchli %10-i baholanayotganini anglatadi.
Nega uch sinfli macro F1 o‘rniga directional macro F1 ishlatiladi?
Confidence gating yuqori-magnitude predictionʼlarni tanlagani sabab retained subset ichida stationary prediction ulushi tez kamayadi. Shu sabab stationary F1, model directional predictionʼda yaxshilanayotgan bo‘lsa ham, nolga yaqinlashishi mumkin.
Manba shu sabab:
\[ F1_{\mathrm{directional}} = \frac{ F1_{\mathrm{down}} + F1_{\mathrm{up}} }{2} \]
o‘lchovini asosiy gating metrikasi sifatida ishlatadi.
Full test set uchun prior-matched random classifierʼning kutiladigan directional macro F1 qiymati:
\[ \frac{1-p_{\mathrm{stat}}}{2}. \]
Biroq gating class compositionʼni o‘zgartirganligi sabab full-set random reference gated subsetʼlarga bevosita ko‘chirilmaydi.
Predictive interval coverage
Nominal %68 interval uchun:
\[ cov_{68} = \Pr \left[ |y-\mu| \le \sigma \right]. \]
Nominal %95 interval uchun:
\[ cov_{95} = \Pr \left[ |y-\mu| \le 1.96\sigma \right]. \]
Tenglama 9: Magnitude-weighted \(R^2\)
\[ R_w^2 = 1- \frac{ \sum_i w_i(y_i-\mu_i)^2 }{ \sum_i w_i(y_i-\bar{y}_w)^2 }, \tag{9} \]
\[ \bar{y}_w = \frac{ \sum_i w_i y_i }{ \sum_i w_i }. \]
Bu yerdagi \(w_i=w(y_i)\) Tenglama 6-dagi magnitude weightʼdir. Shu sabab katta displacementʼlar standard \(R^2\)ga nisbatan yuqoriroq taʼsirga ega bo‘ladi.
Order-book input qanday maʼlumotlarni o‘z ichiga oladi?
Har bir event bitta discrete token va yettita continuous feature bilan ifodalanadi. Token vocabulary jami 439 entryʼdan iborat bo‘lib, beshta categorical attributeʼdan tuziladi:
- event type,
- side,
- discretised volume,
- opposing best quoteʼga nisbatan discretised price distance,
- simultaneity flag.
Order-book depth uchun:
\[ L_{\max}=10. \]
Chuqurroq eventʼlar tashlab yuboriladi.
Yettita continuous feature:
- log inter-event time,
- opposing best quoteʼga nisbatan log tick distance,
- log relative volume,
- DNFI,
- so‘nggi 50 event bo‘yicha cumulative DNFI,
- so‘nggi 200 event bo‘yicha cumulative DNFI,
- QI.
Tenglama 10: Depth-normalised flow imbalance va queue imbalance
\[ \mathrm{DNFI}_t = \frac{ \Delta Q_{1,t}^{b} - \Delta Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1], \]
\[ \mathrm{QI}_t = \frac{ Q_{1,t}^{b} - Q_{1,t}^{a} }{ Q_{1,t}^{b} + Q_{1,t}^{a} } \in[-1,+1]. \tag{10} \]
\(Q_{1,t}^{b}\) best bid darajasidagi resting queue size; \(Q_{1,t}^{a}\) best ask darajasidagi resting queue sizeʼdir.
DNFI queue sizeʼning oldingi eventʼga nisbatan o‘zgarishidan foydalanadi va dinamik order-flow pressureʼni ifodalaydi. QI esa bir vaqtda book ustida turgan bid va ask liquidity orasidagi statik asimmetriyani ko‘rsatadi.
D-TABL encoder
Tadqiqotda UQ-LOB encoder-agnostic ekani aytilgan bo‘lsa-da, eksperimental implementation faqat D-TABL encoder bilan bajarilgan. D-TABL Temporal Attention-Augmented Bilinear Network tuzilmasining 512-event inputʼga moslashtirilgan chuqurroq variantidir.
Asl C(TABL) tuzilmasidagi ikkita BL layer o‘rniga uchta BL layer ishlatilgan va keyin terminal TABL layer qo‘shilgan.
Tenglama 11: Bilinear layer
\[ Y = \phi \left( W_1 X W_2+B \right). \tag{11} \]
\[ X\in\mathbb{R}^{D\times T} \]
input matrixʼdir. \(W_1\) feature axisʼni, \(W_2\) temporal axisʼni project qiladi. \(B\) learned bias, \(\phi\) esa ReLU activationʼdir.
Tenglama 12: Temporal attention-augmented bilinear transformatsiya
Avval:
\[ \bar{X}=W_1X \]
hisoblanadi. Attention score:
\[ E=\bar{X}W \]
va row-wise softmax bilan:
\[ \alpha_{ij} = \frac{ \exp(e_{ij}) }{ \sum_k\exp(e_{ik}) } \]
attention matrix \(A\)ni hosil qiladi.
So‘ng:
\[ \tilde{X} = \lambda (\bar{X}\odot A) + (1-\lambda)\bar{X}, \qquad Y = \phi (\tilde{X}W_2+B). \tag{12} \]
\(\lambda\in[0,1]\) attention-masked representation bilan original projected representation orasidagi learned mixing coefficientʼdir.
Tenglama 13: Discrete token embeddingʼni continuous features bilan birlashtirish
Token embedding table:
\[ E\in\mathbb{R}^{439\times8}. \]
Token \(k\) uchun:
\[ e_k = E[k,:] \in \mathbb{R}^{8}. \]
Yettita continuous feature bilan sakkiz o‘lchamli token embedding:
\[ x_t = [x_t^{\mathrm{cont}};e_{k_t}] \in \mathbb{R}^{15}, \qquad t=1,\ldots,512. \tag{13} \]
ko‘rinishida birlashtiriladi.
Shunday qilib butun window:
\[ X\in\mathbb{R}^{15\times512} \]
o‘lchamiga ega.
Regression label qanday yaratiladi?
Windowʼning oxirgi event vaqti \(t\)dir. Model nazariy jihatdan ayni vaqtda operatsiya qila olmasligi qabul qilinib, kichik latency:
\[ d=0.0005\,\mathrm{s} \]
qo‘shiladi.
\[ t_{\mathrm{start}} = t+d. \]
\(p_{\mathrm{start}}\) \(t_{\mathrm{start}}\) vaqtida yoki undan keyin ko‘ringan birinchi eventʼning mid-price qiymatidir.
Prediction horizon:
\[ t_{\mathrm{end}} = t_{\mathrm{start}}+h. \]
Tenglama 14: End price smoothing
Bitta event narxi microstructure noiseʼga haddan tashqari sezgir bo‘lishi mumkinligi sabab \(t_{\mathrm{end}}\)dan bevosita oldingi \(k=10\) eventʼning mid-price o‘rtachasi olinadi:
\[ p_{\mathrm{end}} = \frac{1}{k} \sum_{j\in\mathcal{K}} p_j, \tag{14} \]
\[ \mathcal{K} = \{ \text{\(t_j\le t_{\mathrm{end}}\) koşulunu sağlayan en büyük zamanlı \(k\) event} \}. \]
Regression target:
\[ y_h(t) = p_{\mathrm{end}} - p_{\mathrm{start}}. \]
Birligi tick displacementʼdir.
Tenglama 15: Classification threshold
Har bir asset va horizon uchun training splitʼdagi \(h\)-soniyalik mid-price log-return standard deviation:
\[ \sigma_h^{\mathrm{LR}} \]
hisoblanadi.
Threshold:
\[ \tau_h^{\mathrm{LR}} = \alpha \sigma_h^{\mathrm{LR}}. \tag{15} \]
Manbada:
\[ \alpha=0.25. \]
Log-return threshold joriy price levelʼga ko‘ra tick displacementʼga aylantiriladi:
\[ \delta_h(t) = p_{\mathrm{start}} \left[ \exp(\tau_h^{\mathrm{LR}}) - 1 \right]. \]
Tenglama 16: Down / up / stationary label
\[ c = \begin{cases} 1\;(\mathrm{up}), & y_h(t)\ge\delta_h(t) \\ 0\;(\mathrm{down}), & y_h(t)\le-\delta_h(t) \\ 2\;(\mathrm{stationary}), & \mathrm{otherwise}. \end{cases} \tag{16} \]
Thresholdʼning ikki tomoni simmetrik. Musbat threshold oshirilsa up, manfiy threshold oshirilsa down, oralig‘ida qolsa stationary yorlig‘i beriladi.
Tenglama 17: Regression meanʼni classification bilan taqqoslash uchun threshold calibration
Regression mean \(\mu\) uch sinfli baholashga aylantirilganda thresholdʼga qo‘shimcha \(k^*\) multiplier qo‘llanadi:
\[ \delta_h^\mu(t) = p_{\mathrm{start}} \left[ \exp(k^*\tau_h^{\mathrm{LR}}) - 1 \right]. \]
\(k^*\) validation periodʼning alohida calibration yarmida:
\[ k^* = \arg\min_k \left| \Pr [ |\mu| \lt \delta_h^{\mu,k}(t) ] - \Pr [ |y_h(t)| \lt \delta_h(t) ] \right|. \tag{17} \]
sifatida tanlanadi.
Maqsad regression predictionʼlardan olingan stationary class ulushini haqiqiy stationary proportionʼga yaqinlashtirishdir. Calibration classification headʼning o‘z class distributionʼiga emas, true class distributionʼga ko‘ra qilinadi.
Tadqiqot Usuli va Natijalari
Maʼlumot manbasi va vaqt bo‘linishi
Tadqiqot Kraken cryptocurrency exchangeʼning public market-data APIʼsidan olingan Level-2 va Level-3 order-book maʼlumotlaridan foydalanadi.
| Element | Manbada berilgan qiymat |
|---|---|
| Jami event | Taxminan 5,2 milliard |
| Jami asset-day | Taxminan 600 |
| Assets | BTC, ETH, SOL, LTC, DOGE, SUI, TAO |
| Market | Kraken |
| Quote currency | USD |
| Maʼlumot davri | Noyabr 2025 – Fevral 2026 |
| Training | 18 Yanvar 2026-gacha |
| Validation | 19–31 Yanvar 2026 |
| Test | 1–15 Fevral 2026 |
| Taxminiy split | %68 train / %15 validation / %17 test asset-days |
| Asosiy horizons | 5 s / 10 s / 15 s |
Validation period ikki teng qismga bo‘lingan: birinchi yarmi model selection, ikkinchi yarmi Tenglama 17-dagi threshold multiplier calibration uchun ishlatiladi. Test period har ikki validation bosqichidan ham xronologik jihatdan keyin keladi.
Asset bo‘yicha maʼlumot zichligi
| Asset | Tick ($) | Kun | Event (milliard) | Event/kun (million) | Event/s | O‘rtacha IET (ms) | 5 s event | 10 s event | 15 s event |
|---|---|---|---|---|---|---|---|---|---|
| BTC | 0,10 | 94 | 1,254 | 13,338 | 156 | 6,42 | 780 | 1560 | 2340 |
| ETH | 0,01 | 70 | 0,903 | 12,899 | 151 | 6,61 | 755 | 1510 | 2265 |
| DOGE | 1,0×10⁻⁷ | 97 | 1,124 | 11,587 | 134 | 7,46 | 670 | 1340 | 2010 |
| SOL | 0,01 | 78 | 0,539 | 6,909 | 80 | 12,50 | 400 | 800 | 1200 |
| TAO | 0,0001 | 84 | 0,577 | 6,870 | 80 | 12,58 | 400 | 800 | 1200 |
| SUI | 0,0001 | 94 | 0,523 | 5,565 | 64 | 15,52 | 320 | 640 | 960 |
| LTC | 0,01 | 83 | 0,276 | 3,326 | 39 | 25,97 | 195 | 390 | 585 |
Bir xil 15 soniyalik horizon BTC uchun o‘rtacha taxminan 2340 eventni, LTC uchun esa taxminan 585 eventni o‘z ichiga oladi. Demak soniya bilan bir xil horizon turli assetlarda turli information densityʼni anglatadi.
Model parameter sonlari
| Komponent | Parameter |
|---|---|
| D-TABL encoder — shared | 268.356 |
| Feature projection — shared | 24.704 |
| CNP context / attention trunk — shared | 766.784 |
| Regression decoder | 165.378 |
| Classification decoder | 165.731 |
| Jami regression variant | 1.225.222 |
| Jami classification variant | 1.225.575 |
Ikki variantʼning parameter countʼi deyarli bir xil. Shu sabab regression va classification confidence taqqoslashini katta model-capacity farqi bilan izohlab bo‘lmaydi.
O‘qitish strategiyasi
O‘qitish ikki bosqichda olib boriladi.
- Har bir asset-horizon juftligi uchun D-TABL encoder uch sinfli classification task ustida pretrain qilinadi.
- UQ-regression yoki UQ-classification head encoder checkpointʼga qo‘shiladi va encoder bilan birga end-to-end fine-tune qilinadi.
Yettita asset × uchta asosiy horizon:
\[ 7\times3=21 \]
asset-horizon juftligini hosil qiladi.
Har bir juftlik uchun regression va classification bo‘lib:
\[ 21\times2=42 \]
UQ model variantʼi o‘qitiladi.
Asosiy matndagi taxminan 210 GPU-hour ikki UQ varianti uchun appendixʼda berilgan:
\[ 105+105=210 \]
GPU-hour bilan mos keladi. Appendix shuningdek base D-TABL pretraining uchun taxminan 78,75 GPU-hour bildiradi va butun training pipelineʼni taxminan:
\[ 78.75+105+105 = 288.75 \approx289 \]
GPU-hour deb beradi.
Giperparametrlar
| Guruh | Parametr | Qiymat |
|---|---|---|
| Input | Window length \(L\) | 512 event |
| Input | Vocabulary \(|\mathcal{V}|\) | 439 |
| Input | Token embedding dimension | 8 |
| Input | Continuous features | 7 |
| Input | Max order-book depth \(L_{\max}\) | 10 |
| Label | Latency \(d\) | 0,0005 s |
| Label | End-price smoothing \(k\) | 10 event |
| Label | Threshold multiplier \(\alpha\) | 0,25 |
| Head | Context size \(C\) | 15 |
| Head | Instances per batch | 16 |
| Head | Projection dimension | 128 |
| Head | Attention dimension \(d_r\) | 256 |
| Head | Attention heads | 4 |
| Head | Context encoder depth | 3 GELU MLP layer |
| Head | Decoder depth | 5 GELU MLP layer |
| Regression | \((\lambda_1,\lambda_2,\lambda_3,\lambda_4)\) | (1,0; 0,1; 0,5; 0,5) |
| Regression | WMAE exponent \(p\) | 4 |
| Regression | \(w_{\max}\) | 40 |
| Regression | Directional margin \(m\) | 1,0 |
| Regression | Calibration bins \(B\) | 3 |
| Regression | Variance floor \(\epsilon\) | \(1\times10^{-8}\) |
| Optimisation | Optimizer | AdamW |
| Optimisation | Encoder learning rate | \(1\times10^{-5}\) |
| Optimisation | Head learning rate | \(5\times10^{-5}\) |
| Optimisation | Weight decay | 0 |
| Optimisation | Warmup | LinearLR, 10k step |
| Optimisation | Cosine restart \(T_0\) | 15k |
| Optimisation | \(T_{\mathrm{mult}}\) | 2 |
| Optimisation | \(\eta_{\min}\) | \(10^{-5}\) |
| Optimisation | \(\gamma\) | 0,5 |
| Training | Max epochs | 15 |
| Training | Random seed train / test | 42 / 999 |
Algorithm 1: Causal context construction
- Bitta assetga tegishli barcha windowʼlar timestamp tartibiga qo‘yiladi.
- Target index \(\tau\) uchun faqat \(j<\tau\) bo‘lgan oldingi windowʼlar baholanadi.
- \(t_j+d+h\le t_\tau\) shartini bajaradigan, yaʼni label outcomeʼi target prediction vaqtigacha to‘liq ro‘y bergan windowʼlar tanlanishi mumkin.
- Ushbu mos nomzodlar orasida timestampʼi eng katta, yaʼni eng yaqin o‘tmishdagi \(C=15\) window context setʼni hosil qiladi.
- Encoder representations va realised labels context sifatida, target representation esa withheld prediction namunasi sifatida qaytariladi.
Confidence Gating Haqiqatan Qanchalik Yaxshilanish Berdi?
Yettita asset birgalikda baholanganda UQ-regressionʼning directional macro F1 qiymati full test setʼdan eng ishonchli %10 prognozlarga o‘tilganda 5, 10 va 15 soniyalik gorizontlarda mos ravishda +0,15, +0,14 va +0,11 oshgan, UQ-classification uchun o‘sishlar +0,11, +0,05 va +0,07 bo‘lgan.
| Confidence percentile q | Reg. 5 s | Cls. 5 s | Reg. 10 s | Cls. 10 s | Reg. 15 s | Cls. 15 s |
|---|---|---|---|---|---|---|
| 0 — barcha prognozlar | 0,42 | 0,45 | 0,41 | 0,45 | 0,40 | 0,45 |
| 10 | 0,44 | 0,46 | 0,43 | 0,45 | 0,42 | 0,46 |
| 20 | 0,46 | 0,47 | 0,45 | 0,46 | 0,44 | 0,46 |
| 30 | 0,48 | 0,47 | 0,47 | 0,47 | 0,46 | 0,47 |
| 40 | 0,49 | 0,48 | 0,48 | 0,47 | 0,47 | 0,47 |
| 50 | 0,50 | 0,49 | 0,49 | 0,48 | 0,47 | 0,48 |
| 60 | 0,51 | 0,50 | 0,50 | 0,48 | 0,48 | 0,48 |
| 70 | 0,52 | 0,51 | 0,51 | 0,49 | 0,48 | 0,49 |
| 80 | 0,54 | 0,53 | 0,52 | 0,50 | 0,49 | 0,50 |
| 90 — eng ishonchli %10 | 0,57 | 0,56 | 0,55 | 0,50 | 0,51 | 0,52 |
Classification full test setʼda regressionʼdan kuchliroq: directional macro F1 taxminan 0,45 bo‘lsa, regression 0,40–0,42 oralig‘ida. Biroq confidence oshgan sari regression farqni yopadi. Eng ishonchli %10-da regression 5 va 10 soniyada classificationʼdan o‘tadi, 15 soniyada esa juda kichik farq bilan ortda qoladi: 0,51 ga qarshi 0,52.
Katta harakatlardagi natijalar
Large-move tahlili:
\[ |y|>q_{67} \]
shartidan foydalanadi. \(q_{67}\) haqiqiy displacement magnitude taqsimotining taxminan yuqori uchdan bir chegarasidir.
| Horizon | Top %50 ↓ | Top %50 ↑ | Top %30 ↓ | Top %30 ↑ | Top %10 ↓ | Top %10 ↑ | Top %5 ↓ | Top %5 ↑ | Top %1 ↓ | Top %1 ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 0,69 | 0,63 | 0,73 | 0,67 | 0,81 | 0,75 | 0,84 | 0,79 | 0,88 | 0,83 |
| 10 s | 0,65 | 0,59 | 0,68 | 0,63 | 0,75 | 0,70 | 0,78 | 0,73 | 0,85 | 0,78 |
| 15 s | 0,65 | 0,52 | 0,68 | 0,53 | 0,74 | 0,59 | 0,76 | 0,61 | 0,81 | 0,68 |
Ushbu subsetʼda down va up class taqsimoti taxminan muvozanatli bo‘lgani uchun prior-matched random reference taxminan 0,5. Confidence oshgani sari uchala horizonʼda ham directional F1 ko‘tariladi.
Nega %68 Interval Yaxshi Kalibrlansa-da, %95 Interval Yetarli Qamramaydi?
UQ-regressionʼning calibration lossʼi standardised residualʼning birinchi mutlaq momentini nishonga olgani sabab taxminan bir-sigma darajasini kuchli kalibrlaydi, biroq tick displacement taqsimotining Gaussianʼdan og‘irroq dumlarini bevosita modellashtirmagani uchun 1,96-sigma %95 interval nominal darajadan past qoladi.
| Metrika | 5 s | 10 s | 15 s |
|---|---|---|---|
| Coverage 68 — nominal 0,68 | 0,682 | 0,682 | 0,681 |
| Coverage 95 — nominal 0,95 | 0,904 | 0,904 | 0,907 |
| Calibration error | 0,048 | 0,048 | 0,045 |
| NLPD | 5,278 | 5,586 | 5,778 |
Muhim jadval izohi: Pooled coverage 0,682 bo‘lganda calibration error 0,048 bo‘lishi ziddiyat emas. Manba calibration errorʼni asset asosida:
\[ |cov_{68}-0.68| \]
qiymatlarining o‘rtachasi sifatida aniqlaydi. Pooled aggregate coverage turli assetlardagi musbat va manfiy og‘ishlarni bir-birini qoplaydigan tarzda birlashtirishi mumkin; mean absolute asset-level deviation esa bunday qilmaydi.
Mualliflar %95 undercoverage uchun future work sifatida Student-t likelihood yoki post-hoc conformal recalibrationʼni taklif qiladilar.
Stationary F1 nega qulaydi?
| Metrika | Top %100 | Top %50 | Top %30 | Top %10 | Top %1 |
|---|---|---|---|---|---|
| F1 Down | 0,447 | 0,526 | 0,549 | 0,598 | 0,640 |
| F1 Up | 0,393 | 0,477 | 0,499 | 0,544 | 0,598 |
| F1 Stationary | 0,390 | 0,067 | 0,012 | 0,000 | 0,000 |
| Uch sinfli Macro F1 | 0,410 | 0,357 | 0,353 | 0,381 | 0,413 |
Bu jadval juda muhim baholash muammosini ko‘rsatadi. SNR gating yuqori magnitude predictionʼlarni tanlagani uchun stationary namunalar retained subsetʼda tobora yo‘qoladi. Natijada Down va Up F1 ko‘tarilar ekan, Stationary F1 nolga tushishi mumkin. Shu sabab uch-class macro F1 selective predictionʼning directional foydasini to‘g‘ri aks ettirmasligi mumkin.
BTCʼda distribution shift
Yettita assetning oltitasida training, validation va test class proportions nisbatan o‘xshash qolgan bo‘lsa-da, BTC sezilarli istisno.
BTC-USD 5 soniyalik horizonʼda stationary class taxminan:
Training: %70
Test: %27
bo‘lgan.
10 soniyada training stationary taxminan %64 va test %19; 15 soniyada training taxminan %57 va test %15 bo‘lgan.
Manba bu farqni volatility regime shift sifatida talqin qiladi va recent realised outcomes hamda context conditioning ishlatilishining asosiy motivatsiyalaridan biri sifatida ko‘rsatadi. Shu bilan birga mualliflar uzoqroq va bir nechta regimeʼni qamrab oladigan test davri robustness uchun zarur ekanini taʼkidlaydi.
Per-asset label threshold va scale qiymatlari
| Asset | \(\sigma_h^{LR}\) | \(\tau_h^{LR}\) | \(y_{\mathrm{ref}}\) — tick | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | 5 s | 10 s | 15 s | 30 s | |
| BTC | 1,82e−4 | 2,63e−4 | 3,29e−4 | 4,85e−4 | 4,50e−5 | 6,60e−5 | 8,20e−5 | 1,21e−4 | 155 | 181 | 205 | 255 |
| DOGE | 3,65e−4 | 5,12e−4 | 6,25e−4 | 8,81e−4 | 9,10e−5 | 1,28e−4 | 1,56e−4 | 2,20e−4 | 187 | 277 | 352 | 507 |
| ETH | 3,14e−4 | 4,43e−4 | 5,42e−4 | 7,74e−4 | 7,80e−5 | 1,11e−4 | 1,36e−4 | 1,94e−4 | 42 | 56 | 69 | 96 |
| LTC | 3,70e−4 | 5,77e−4 | 6,11e−4 | 8,94e−4 | 9,20e−5 | 1,44e−4 | 1,53e−4 | 2,23e−4 | 2 | 2 | 2 | 3 |
| SOL | 3,58e−4 | 5,10e−4 | 6,18e−4 | 8,83e−4 | 8,90e−5 | 1,28e−4 | 1,55e−4 | 2,21e−4 | 3 | 3 | 4 | 6 |
| SUI | 5,09e−4 | 7,34e−4 | 8,79e−4 | 1,246e−3 | 1,27e−4 | 1,83e−4 | 2,20e−4 | 3,11e−4 | 3 | 5 | 6 | 9 |
| TAO | 5,01e−4 | 6,97e−4 | 8,39e−4 | 1,176e−3 | 1,25e−4 | 1,74e−4 | 2,10e−4 | 2,94e−4 | 628 | 953 | 1059 | 1596 |
30 soniyalik qiymatlar label statistics ichida berilgan; asosiy maqola tajribalari esa 5, 10 va 15 soniyalik horizons bo‘yicha xabar qilingan.
Ushbu Tadqiqot Foydali Trading Strategiyasini Isbotlaydimi?
Yo‘q. UQ-LOB tadqiqoti directional reliability, displacement fit, uncertainty calibration va confidence gatingʼni baholaydi; haqiqiy portfolio P&L, fee-adjusted return, slippage, market impact yoki jonli execution natijalari o‘lchanmagani uchun tadqiqotni foydalilik isboti sifatida talqin qilib bo‘lmaydi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- UQ-regressionʼning %68 predictive interval coverage qiymati nominal darajaga juda yaqin.
- %95 Gaussian interval og‘ir dumlar sabab nominal darajadan past coverage ko‘rsatgan.
- SNR confidence gating barcha uch horizonʼda retained predictionsʼning directional macro F1 qiymatini oshirgan.
- UQ-classification softmax confidence ham directional macro F1 uchun mazmunli ranking signalʼdir.
- UQ-regression full test setʼda classificationʼdan pastroq directional macro F1 chiqarsa ham, eng ishonchli %10-da farq yopiladi.
- Katta harakatlarda yuqori SNR qatlamlari kuchli directional F1 qiymatlariga erishgan.
- Yaqin o‘tmishda amalga oshgan context outcomeʼlardan foydalanish future leakageʼni oldini oluvchi aniq causal constraint bilan bajarilgan.
- UQ-regression va UQ-classification deyarli bir xil parameter count va bir xil shared trunk ustida taqqoslangan.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
- Model haqiqiy pul bilan foydali ekani ko‘rsatilmagan.
- Confidence gating transaction costʼdan keyin sof daromad yaratishi isbotlanmagan.
- %68 calibration barcha bozor rejimlarida doimiy calibration kafolati emas.
- %95 interval nominal coverage beradi deb bo‘lmaydi; o‘lchangan coverage taxminan %90,4–90,7.
- Encoder-agnostic dizayn barcha LOB encoderʼlar bilan eksperimental tasdiqlanmagan; tadqiqot D-TABL ishlatgan.
- Natijalarni boshqa birja, boshqa asset class yoki uzoqroq horizonʼlarga avtomatik umumlashtirib bo‘lmaydi.
- Model epistemic uncertaintyʼni bevosita hal qilmaydi.
- Tadqiqot uzoq muddatli portfolio risk management yoki optimal position sizing tajribasi emas.
Mualliflar ko‘rsatgan cheklovlar va kelajakdagi ishlar
Tail calibration: Gaussian likelihood og‘ir dumlarni yetarlicha ifodalamaydi. Student-t likelihood yoki conformal recalibration taklif qilinadi.
Baseline qamrovi: Tadqiqot bir xil shared trunk ustidagi ikki UQ headʼni taqqoslaydi. MC dropout, deep ensemble va base encoder softmax gating kabi weight-space uncertainty baselineʼlari bilan keng qamrovli taqqoslash qilinmagan.
Multi-seed noaniqligi: Mualliflar ko‘p seed error barʼlari va loss/context ablationʼlari kelajakda attributionʼni kuchaytirishini bildiradi.
Distribution shift: Ayniqsa BTC train/test class distributionʼida kuchli rejim farqi bor. Uzoqroq va bir nechta regimeʼni qamrab oladigan test muddati zarur.
Economic evaluation: Directional reliability baholangan; profitability baholanmagan.
Scope: Modellar har bir asset va horizon uchun alohida o‘qitilgan va bitta trading venue ishlatilgan. Cross-asset yoki multi-horizon yagona model sinovdan o‘tkazilmagan.
Etika va maʼlumotga kirish
Manba faqat exchangeʼning public APIʼsidan olingan market data ishlatilganini va personal data yo‘qligini bildiradi. Model qisqa muddatli narx harakatlarini prognoz qilib trading qarorlariga taʼsir qilishi mumkin; mualliflar foydalilik daʼvosini qilmasliklarini va moliyaviy xavf saqlanib qolishini aniq taʼkidlaydi.
Raw Kraken order-book maʼlumoti exchange bilan data-sharing agreement bo‘lmagani sabab qayta tarqatilmaydi.
Reproducibility Statement complete source code, D-TABL encoder, ikki UQ head, training/evaluation pipelineʼlar, context-construction protsedurasi, label thresholds, scale qiymatlari va dataset statistics eʼlon qilinganini bildiradi. Biroq yuklangan PDF ichida public repositoryʼning bevosita URLʼsi berilmagan.
Manba va Usul Haqida Izoh
Asl tadqiqot: UQ-LOB: Uncertainty-Aware Limit Order Book Mid-Price Forecasting
Mualliflar: Derrick Gilchrist Edward Manoharan; Eljas Linna; Kestutis Baltakys; Hao Dong; Juho Kanniainen.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Corresponding author: Derrick Gilchrist Edward Manoharan.
Teng hissa: Manbada equal-contribution bayonoti ko‘rinmaydi.
Muassasa: Data Science Research Centre, Tampere University, Tampere, Finland.
Platforma: arXiv.
Kategoriya: Computer Science — Artificial Intelligence (cs.AI).
arXiv identifikatori: arXiv:2609.31491v2.
v1 yuborilgan sana: 25 Sentabr 2026.
v2 tahrir sanasi: 28 Sentabr 2026.
Manba turi: Preprint.
Taqriz holati: Yuklangan v2 arXiv preprint; 21 Noyabr 2026 holatiga ko‘ra taqrizlangan jurnal Version of Record versiyasi tasdiqlanmagan.
arXiv/DataCite DOI: 10.48550/arXiv.2609.31491. Bu identifikator journal DOI emas.
Rasmiy havola: https://arxiv.org/abs/2609.31491v2
Manba litsenziyasi: Yuklangan PDFʼda ochiq Creative Commons qayta foydalanish litsenziyasi tasdiqlanmagan. Shu sabab manba rasmlari bevosita ishlatilmagan yoki stil transferi bilan qayta yaratilmagan.
Moliyalashtirish: Yuklangan PDFʼda alohida funding statement aniqlanmagan.
Manfaatlar to‘qnashuvi: Yuklangan PDFʼda alohida competing-interest/conflict-of-interest statement aniqlanmagan.
Muallif hissalari: Yuklangan PDFʼda alohida CRediT author-contribution bayonoti yo‘q.
Maʼlumot manbasi: Kraken cryptocurrency exchange public market-data API; Level-2 va Level-3 order-book data.
Raw maʼlumotga kirish: Raw data qayta tarqatilmaydi; manba bunga exchange bilan data-sharing agreement yo‘qligini sabab sifatida ko‘rsatadi.
Kod: Reproducibility Statement complete source code eʼlon qilinganini bildiradi; ammo PDF ichida tekshiriladigan repository URLʼsi berilmagan.
Assets: BTC, ETH, SOL, LTC, DOGE, SUI, TAO.
Asosiy prediction horizons: 5 s, 10 s, 15 s.
Label statistics qo‘shimcha horizon: 30 s qiymatlari Appendix Table 7-da alohida berilgan; asosiy experiment resultʼlari 5/10/15 soniyadir.
Input window: 512 non-overlapping order-book event.
Context: 15 causal context window + 1 withheld target.
Encoder: D-TABL; uchta bilinear layer + terminal temporal-attention-augmented bilinear layer.
UQ-regression: Gaussian predictive distribution \(\mathcal{N}(\mu,\sigma^2)\).
UQ-classification: Down / Up / Stationary categorical prediction.
Regression confidence: \(SNR=|\mu|/\sigma\).
Classification confidence: Maximum softmax probability.
Optimizer: AdamW.
Uskuna: NVIDIA GH200 Grace Hopper Superchip.
Pipeline training xarajati: Appendix hisobiga ko‘ra taxminan 78,75 GPU-hour D-TABL pretraining + 105 GPU-hour UQ-regression + 105 GPU-hour UQ-classification = taxminan 289 GPU-hour. Asosiy matndagi taxminan 210 GPU-hour ifodasi ikki UQ variantʼning jami fine-tuning xarajati bilan mos.
Asosiy calibration natijasi: %68 nominal interval uchun 0,681–0,682 coverage; %95 nominal interval uchun 0,904–0,907 coverage.
Asosiy selective-prediction natijasi: Eng ishonchli %10-ga o‘tilganda UQ-regression directional macro F1 5/10/15 soniyada mos ravishda 0,57 / 0,55 / 0,51; UQ-classification 0,56 / 0,50 / 0,52.
Large-move natijasi: 5 soniyada eng ishonchli %1 UQ-regression F1: down 0,88; up 0,83.
Asosiy ilmiy chegara: Tadqiqot predictive confidence va directional reliabilityʼni baholaydi; real trading profitability, fee-adjusted P&L, slippage yoki market impactʼni o‘lchamaydi.
Muhim qayta ishlab chiqarish chegarasi: Raw market data qayta tarqatilmaydi. Shu bilan birga manba model specification, label procedure, dataset statistics, scale/threshold qiymatlari va kod eʼlon qilinganini bildiradi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan