


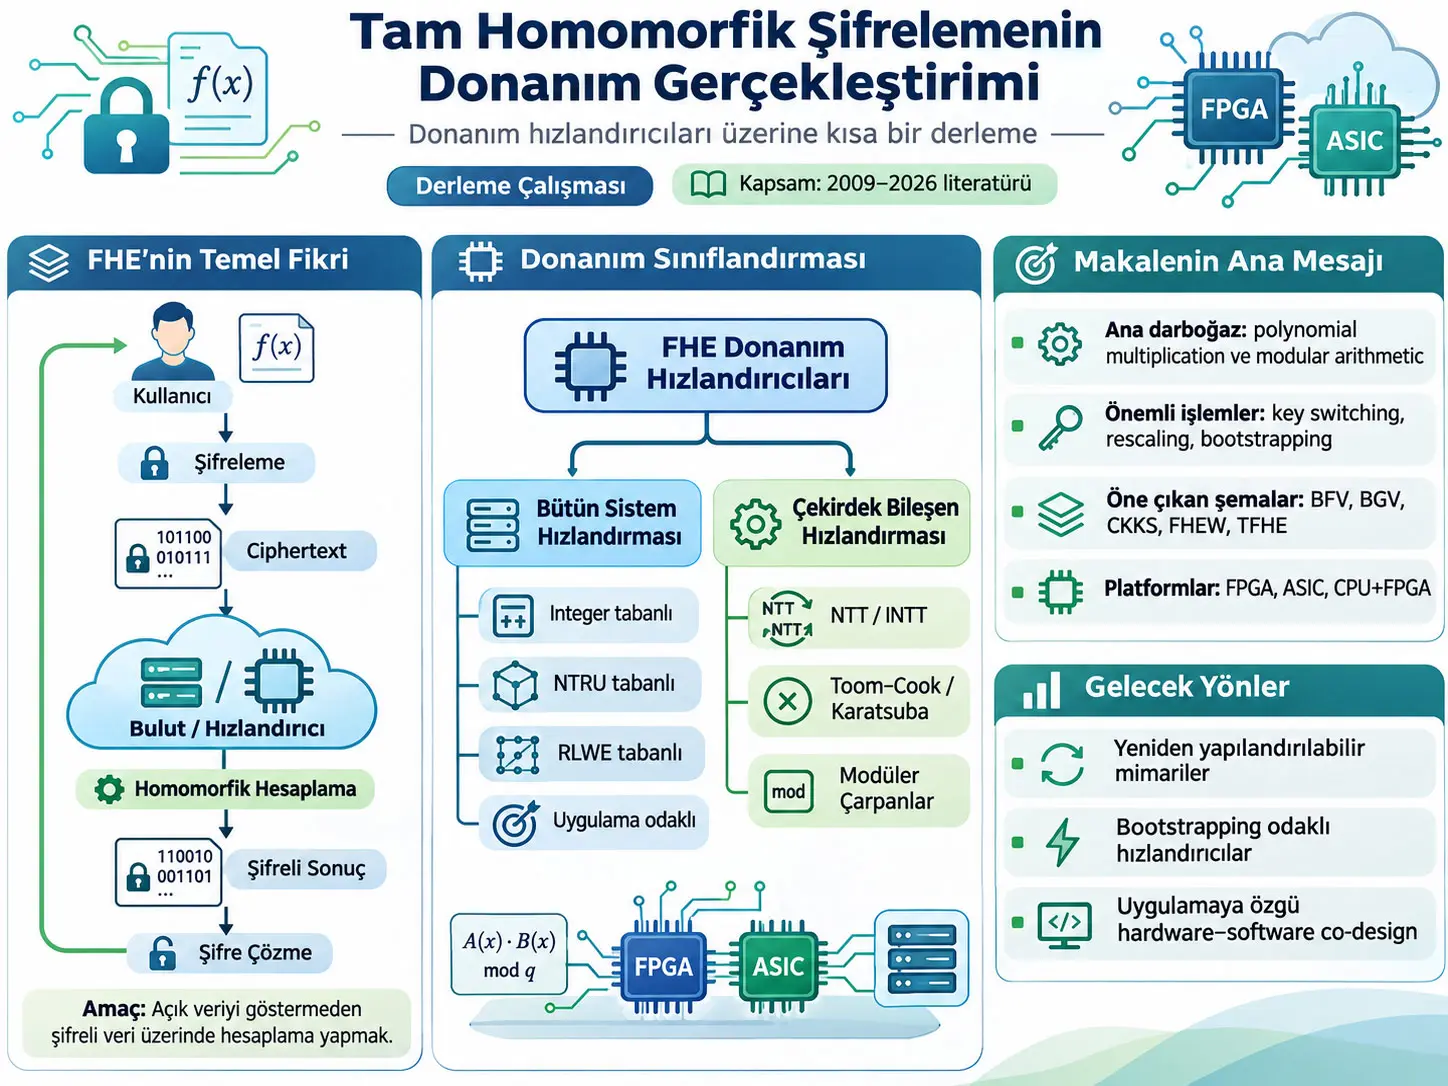
Tam Homomorfik Şifreleme (Fully Homomorphic Encryption, FHE), şifreli verinin önce açık metne dönüştürülmesine gerek kalmadan belirli hesaplamaların doğrudan ciphertext üzerinde yürütülmesini ve elde edilen şifreli sonucun yetkili kullanıcı tarafından çözüldüğünde açık veri üzerinde yapılan karşılık gelen hesaplamayla aynı sonucu vermesini amaçlayan bir şifreleme yaklaşımıdır. Bu çalışma yeni bir FHE algoritması veya hızlandırıcısı önermemekte; 2009–2026 arasında FHE şemalarının gelişimini, bütün FHE sistemini hızlandıran donanım mimarilerini, polinom çarpanlarını ve tamsayı modüler çarpanlarını inceleyen donanım odaklı bir narrative review sunmaktadır. Derlemenin ana sonucu, FHE donanımında performansın yalnız daha hızlı çarpma devresi üretmekle çözülemeyeceği; polinom aritmetiği, bootstrapping, key switching, bellek hareketi, yeniden yapılandırılabilirlik ve uygulamaya özgü veri akışının birlikte ele alınması gerektiğidir.
Yazarların değerlendirmesine göre RLWE tabanlı FHE hızlandırıcıları, daha güçlü standartlaştırılmış kafes temelleri ve esnek cebirsel yapıları nedeniyle güncel donanım araştırmalarının baskın yönlerinden biri haline gelmiştir. BFV, BGV ve CKKS gibi leveled FHE şemaları büyük polinomlar, Residue Number System (RNS), polynomial multiplication, relinearization, key switching ve modulus yönetimiyle çalışırken; FHEW/TFHE ailesi daha küçük modüller ve bit düzeyinde bootstrapping kullanır. Bu farklılıklar tek bir sabit hızlandırıcının bütün FHE algoritmaları için aynı derecede verimli olmasını zorlaştırmaktadır.
Derleme, mevcut hızlandırıcıların önemli bölümünün belirli şemalara veya belirli çekirdek işlemlere göre özelleştirildiğini; bunun performans kazandırırken ortak donanım kaynaklarının yeniden kullanımını ve algoritmalar arası esnekliği sınırladığını vurgulamaktadır. Yazarlar gelecekte paylaşılabilir modular arithmetic birimleri, yeniden yapılandırılabilir NTT/INTT çekirdekleri, programlanabilir veri akışı, bootstrapping odaklı mimariler ve uygulama–algoritma–donanım ortak tasarımının önem kazanacağını öngörmektedir.
Kaynakta aktarılan çok yüksek hızlanma oranları tek bir ortak benchmark'a ait değildir. F1, HEAX, Poseidon, CHAM, HERACLES ve diğer tasarımlar farklı FHE şemaları, donanım teknolojileri, parametreler, iş yükleri ve yazılım taban çizgileri kullanmaktadır. Bu nedenle örneğin 1000×, 5000× veya 17.000× gibi bir hızlanma değeri başka bir satırdaki hızlanma değeriyle doğrudan karşılaştırılarak evrensel performans sıralaması oluşturulamaz.
Çalışmanın çekirdek aritmetik incelemesinde Saber, ML-KEM, ML-DSA ve NTRU Prime gibi FHE olmayan kafes tabanlı kriptografi örneklerine de yer verilmektedir. Bunlar “FHE şeması” olarak sunulmamış; NTT/INTT, Karatsuba ve Toom–Cook gibi ortak polinom aritmetiklerinin donanım gerçekleştirimine ilişkin mühendislik örnekleri olarak kullanılmıştır.
FHE'nin temel fikri nedir?
Klasik bir dış kaynak hesaplama modelinde veri sahibi hassas verisini sunucuya açık biçimde gönderirse sunucu hesaplamayı kolayca yapabilir fakat gizlilik kaybolabilir. FHE'nin hedefi, sunucunun verinin açık içeriğini görmeden ciphertext üzerinde hesaplama gerçekleştirebilmesidir. Kullanıcı önce veriyi kendi anahtarıyla şifreler, bulut yalnız ciphertext'i işler ve sonuç yine şifreli biçimde kullanıcıya döner.
Bu yapıdaki “homomorfik” sözcüğü, açık veri üzerinde yürütülen matematiksel işlemler ile şifreli temsil üzerinde yürütülen işlemler arasında sonuç açısından korunmuş bir ilişki bulunduğunu ifade eder. FHE'nin mühendislik problemi ise bu işlemlerin teorik olarak mümkün olmasından çok, pratikte ne kadar hesaplama, bellek, bant genişliği ve donanım alanı gerektirdiğidir.
Bu derlemeye neden ihtiyaç duyulmuştur?
Kaynak, önceki FHE derlemelerinin önemli bölümünün matematiksel ilkeler, güvenlik özellikleri ve yazılım kütüphanelerine yoğunlaştığını belirtmektedir. Donanım hızlandırmasını ele alan bazı çalışmaların ise ya belirli yıllarla sınırlı kaldığı, ya yalnız genel accelerator architecture düzeyini incelediği ya da yalnız CKKS bootstrapping gibi dar bir alt probleme odaklandığı ifade edilmektedir.
Yazarların hedefi bu boşluğu üç katmanda doldurmaktır: FHE şemalarının gelişimini kronolojik olarak değerlendirmek, bütün FHE sistemine yönelik hızlandırıcıları sınıflandırmak ve performansı belirleyen polynomial multiplier ile modular multiplier gibi ince taneli çekirdek donanım birimlerini ayrıca karşılaştırmak.
Birinci nesil FHE
Kaynak birinci neslin başlangıcını Gentry'nin 2009'daki Gen09 yapısına bağlamaktadır. Gen09 ideal kafesler üzerinde kurulmuş, homomorfik toplama ve çarpmayı birlikte destekleyen ve ciphertext gürültüsünü kontrol altında tutmak için bootstrapping kullanan ilk genel FHE yaklaşımı olarak ele alınmaktadır.
Takip eden SV10, SS10, GH11 ve GHS12a çalışmaları ciphertext/anahtar boyutu, decryption circuit derinliği veya bootstrapping verimliliği gibi sorunları iyileştirmeye çalışmıştır. Derlemenin değerlendirmesine göre bu ilk nesil şemaların teorik önemi yüksek olmakla birlikte cebirsel yapıların karmaşıklığı, büyük ciphertext'ler ve yüksek bootstrapping maliyeti pratik kullanımı sınırlandırmıştır.
İkinci nesil FHE
İkinci nesil, LWE/RLWE ve polinom halkaları üzerinde geliştirilen şemalarla ilişkilendirilmektedir. BV11a/BV11b, BGV, BFV ve CKKS bu dönemin merkezi örnekleridir.
KeySwitching, ciphertext'in işlevsel olarak aynı açık bilgiyi temsil etmeye devam ederken başka bir anahtar/temsil altında kullanılmasını sağlayan dönüşüm mekanizmasıdır. Kaynakta özellikle ciphertext boyutunun veya değerlendirme anahtarlarının yönetiminde önemli rol oynar.
ModulusSwitching, ciphertext modülünü kontrollü biçimde değiştirerek gürültü ve hesaplama maliyetinin yönetilmesine yardımcı olan tekniktir.
Relinearization, homomorfik çarpma sonrasında büyüyen ciphertext yapısını tekrar daha yönetilebilir forma dönüştürmek için kullanılan işlemdir.
Rescaling, özellikle CKKS'nin yaklaşık sayı hesaplama modelinde ölçek ve modül yönetiminin bir parçasıdır. Kaynak CKKS'yi gerçek sayıların yaklaşık hesaplanmasına uygun FHE şeması olarak ele almaktadır.
Üçüncü nesil FHE
Kaynak üçüncü dönemi GSW, FHEW ve TFHE gibi bit-bootstrappable şemalarla ilişkilendirmektedir. Bu yapılarda tek-bit veya mantıksal değerlendirme, blind rotation ve homomorphic accumulator gibi mekanizmalar öne çıkmaktadır.
FHEW için bootstrapping süresinin bir saniyenin altına indirildiği, TFHE tarafında daha sonraki çalışmalarla 52 ms ve ardından 13 ms düzeylerine kadar iyileştirmeler raporlandığı aktarılmaktadır. Bunlar tarihsel olarak farklı çalışmaların sonuçlarıdır; aynı donanım veya aynı parametre setine ait tek bir deney değildir.
BFV, CKKS ve FHEW/TFHE arasındaki temel farklar
| Özellik | BFV | CKKS | FHEW / TFHE |
|---|---|---|---|
| Tür | Leveled FHE | Leveled FHE | Bit-bootstrappable |
| Çekirdek bileşen | Homomorfik çarpma ve relinearization | Homomorfik çarpma ve relinearization | Homomorphic accumulator |
| Paralel teknik | RNS | RNS | Kaynak Tablo 1'de “None” |
| Modül dönüşümü | Base extension / scaling | Yaklaşık modulus up/down conversion | Kaynak Tablo 1'de “None” |
| Çekirdek işlem | Polynomial multiplication | Polynomial multiplication | Polynomial matrix multiplication |
| Temel aritmetik | Tamsayı çarpma ve modüler işlemler | Modüler işlemler | Modüler işlemler |
| Polinom boyutu N | ≥ \(2^{12}\) | ≥ \(2^{12}\) | \(2^{10}\) veya \(2^{11}\) |
| \(\log_2 Q\) | ≥100 | ≥100 | ≤50 |
| Modül seçimi | Asal | Asal | 2'nin kuvveti veya asal |
Kaynak ayrıca leveled BFV/CKKS şemalarında bootstrapping gerektiğinde polinom derecesinin \(2^{16}\)–\(2^{17}\) düzeylerine kadar çıkabildiğini ve ciphertext modülünün yüzlerce hatta binlerce bite ulaşabildiğini belirtmektedir. Bunlar sabit zorunlu parametreler değil, çalışmanın tartıştığı tipik yüksek kaynak gereksinimlerini anlatmaktadır.
FHE Donanım Hızlandırmasının Ana Darboğazı Nedir?
Derlemeye göre temel darboğaz homomorfik değerlendirme, özellikle de büyük polinom boyutları ve geniş modüller altında tekrarlanan polynomial multiplication, modular arithmetic, key switching ve bootstrapping işlemleridir; bu nedenle yalnız hesaplama birimlerinin hızı değil bellek erişimi, veri hareketi, RNS paralelliği ve donanım kaynaklarının yeniden kullanımı da toplam performansı belirler.
RNS neden kullanılıyor?
Residue Number System (RNS), büyük bir modül altında yapılacak hesabı daha küçük modüllerden oluşan birden fazla kanal üzerinde gerçekleştirmeye yarayan temsil yaklaşımıdır. Kaynak BFV ve CKKS gibi leveled FHE şemalarının büyük ciphertext modüllerini küçük modüllere ayırarak paralel işleme yapabilmesini RNS'nin başlıca donanım avantajı olarak açıklamaktadır.
Bu avantaj aynı zamanda ek base conversion, modulus conversion ve veri hareketi gerektirebilir. Dolayısıyla RNS “hesabı bedelsiz hızlandıran” bir yöntem değildir; büyük tamsayı aritmetiğini daha uygun paralel küçük-modül işlemlerine dönüştüren bir mimari tercihtir.
FHE donanım hızlandırıcılarının sınıflandırılması
Integer tabanlı FHE hızlandırıcıları
Erken dönem integer tabanlı FHE hızlandırıcılarında temel amaç çok geniş tamsayı çarpmalarını hızlandırmaktır. Kaynak, FFT tabanlı Schönhage–Strassen ve Comba benzeri çarpanların bu dönemin temel donanım yaklaşımı olduğunu belirtmektedir.
Wang ve arkadaşlarının Stratix-V üzerinde kurduğu 64K noktalı FFT motorunun 100 MHz'de NVIDIA C2050 üzerinde aynı FFT algoritmasına göre yaklaşık iki kat hız elde ettiği aktarılmaktadır. Doröz ve arkadaşlarının 90 nm ASIC tasarımında encryption 18,1 ms, decryption 16,1 ms ve recryption 3,1 s olarak raporlanmış; tasarımın 30 milyon kapıdan küçük olduğu belirtilmiştir.
Kaynağın genel değerlendirmesi, bu tasarımların belirli parametrelerde başarı göstermesine rağmen anahtar boyutları ve geniş tamsayı gereksinimleri arttıkça ölçeklenebilirlik, bellek baskısı ve algoritmik uyarlanabilirlik sorunlarının büyüdüğü yönündedir.
NTRU tabanlı hızlandırıcılar
NTRU tabanlı YASHE ve LTV hızlandırıcılarında NTT, CRT/iCRT, modulus switching ve pipeline optimizasyonları öne çıkmaktadır. Kaynak Pöppelmann'ın YASHE tasarımında \(n=16384\) ve yaklaşık 512-bit \(q\) parametresi için homomorfik toplamayı 0,94 ms, homomorfik çarpmayı 48,67 ms olarak aktarmaktadır.
Roy'un çok çekirdekli YASHE hızlandırıcısında SIMON-64/128 hesabı 2048 ciphertext paralel işlendiğinde 171,3 s, blok başına 83,6 ms ve yazılıma göre 24,5× hızlanma olarak raporlanmaktadır. Öztürk'ün LTV CPU+FPGA sisteminde homomorfik AES blok değerlendirmesi 442 ms ve CPU/GPU karşısında sırasıyla 28,5× ve 17× hızlanma olarak aktarılmaktadır.
Derleme bu hattın uzun dönem sınırlılıkları arasında NTRU tabanlı bazı yapıların subfield attack hassasiyetlerini, şema bağımlılığını ve geniş çaplı yeniden kullanılabilirliğin sınırlı olmasını saymaktadır.
RLWE tabanlı hızlandırıcılar
Derlemede güncel araştırmanın en yoğun alanı RLWE tabanlı BFV, BGV ve CKKS hızlandırıcılarıdır. HEPCloud, HEAX, Medha, F1, CraterLake, ARK ve Poseidon gibi mimariler yalnız tek bir multiplier devresini değil, çok çekirdekli işlem, RNS kanalları, key switching, veri hareketi, programlanabilir instruction set ve bellek hiyerarşisini birlikte ele almaktadır.
| Sınıf | Çalışma / mimari | Platform | Şema | Kaynakta öne çıkan özellik ve sınır |
|---|---|---|---|---|
| Integer | Wang | FPGA, Stratix-V | GH | SSA+FFT entegrasyonu; çok geniş çarpma için özelleştirilmiş ve genelliği sınırlı. |
| Integer | Doröz | 90 nm ASIC | GH | Tam donanım hızlandırması; yüksek donanım maliyeti. |
| Integer | Moore | FPGA, Virtex-7 | Coron | DSP dilimlerini verimli kullanan hafif tasarım; DSP bağımlılığı ve sınırlı esneklik. |
| NTRU | Pöppelmann | FPGA, Stratix-V | YASHE | YASHE için bütüncül hızlandırma; yüksek şema özelleşmesi. |
| NTRU | Roy | FPGA, Virtex-7 | YASHE | Modüler ve yeniden yapılandırılabilir tasarım; ek kontrol yükü. |
| NTRU | Öztürk | FPGA, Virtex-7 | LTV-SHE | LTV-SHE için ilk FPGA hızlandırıcısı; şema bağımlılığı. |
| NTRU | Cousins / HEPU | FPGA, Virtex-7 | LTV | CRT/iCRT hızlandırması; scheduling yükü. |
| RLWE | Roy / HEPCloud | CPU + FPGA, Virtex-6 | BFV | Çok çekirdekli BFV hızlandırması; uyumluluk sınırlı. |
| RLWE | Mert | CPU + FPGA + ASIC | BFV | Hafif NTT optimizasyonu; reconfigurability sınırlı. |
| RLWE | Turan / HEAWS | FPGA, Virtex UltraScale+ | BFV | AWS FPGA üzerinde BFV hızlandırması; genellik sınırlı. |
| RLWE | Riazi / HEAX | CPU + FPGA + ASIC, Stratix-10 | CKKS | Çok katmanlı paralellik; yüksek donanım kaynak yükü. |
| RLWE | Roy / Medha | FPGA, Alveo U250 | CKKS | Çok çekirdek ve instruction-level parallelism; RNS-CKKS odaklı. |
| RLWE | Samardzic / F1 | 14/12 nm ASIC | BGV / CKKS | Programlanabilir ve geniş algoritmik destek; büyük ASIC alanı. |
| RLWE | Samardzic / CraterLake | 14/12 nm ASIC | BGV / CKKS | Unbounded FHE desteği; yüksek mimari karmaşıklık. |
| RLWE | Mert / Medha opt. | FPGA + 7 nm ASIC | CKKS | Microcoded instruction-set yaklaşımı; uyumluluk sınırı. |
| RLWE | Kim / ARK | 7 nm ASIC | BGV / CKKS | Yüksek bellek verimliliği; karmaşık iletişim/veri akışı. |
| RLWE | Yang / Poseidon | FPGA, Alveo U280 | CKKS | Tam bootstrapping desteği; kontrol karmaşıklığı. |
| RLWE | Bertels | FPGA, ZCU102 | FHEW | Hızlı FHEW bootstrapping; haricî anahtar depolamasına bağımlı. |
| RLWE | Jiang / MATCHA | ASIC/GPU | TFHE | Çarpmasız FFT yaklaşımı; uyumluluk sınırlı. |
| RLWE | Van / FPT | FPGA, Alveo U280 | TFHE | Sabit noktalı FFT; dış anahtar bağımlılığı. |
| RLWE | Zhang | FPGA, Alveo U280 | CKKS / TFHE | Şemalar arası switching; kaynak tablosunda tek yönlü olarak belirtilmiş. |
Kaynakta öne çıkarılan bazı RLWE performans örnekleri
- HEPCloud'un geliştirilmiş çok çekirdekli sürümü, optimize yazılıma göre 13×'ten fazla hızlanma raporlamaktadır.
- HEAWS, kaynağın verdiği düzende saniyede 613 homomorphic multiplication gerçekleştirmektedir.
- HEAX, geniş FHE parametre aralığında 164–268× performans artışı bildirmektedir.
- Medha, Xilinx Alveo U250 üzerinde başka reconfigurable hızlandırıcılara göre 2,4× daha düşük latency raporlamaktadır.
- F1, yazılım uygulamalarına karşı geometric mean 5400× ve belirli durumda 17.000×'e kadar hızlanma bildirmektedir.
- CraterLake, kaynakta F1'e göre 11,2× hızlanma olarak aktarılmaktadır.
- Poseidon, kullanılan FHE benchmarkında GPU ve ASIC karşısında sırasıyla 10,6× ve 8,7× hızlanma raporlamaktadır.
- FHEW odaklı Bertels tasarımı bootstrapping işlemini 20 ms'nin altında gerçekleştirmektedir.
- MATCHA, cuHE GPU kütüphanesine göre TFHE throughput'unda 2,3× iyileşme bildirmektedir.
- FPT, CPU tabanlı TFHE bootstrapping'e karşı iki–üç büyüklük mertebesi throughput iyileşmesi raporlamaktadır.
- CKKS–FHEW switching donanımı Xilinx U280 üzerinde yazılım taban çizgisine karşı 365× switching verimliliği artışı bildirmektedir.
Bu sayılar farklı çalışmaların kendi karşılaştırmalarıdır. Hızlanma katsayılarının taban çizgileri, parametreleri ve donanımları aynı olmadığı için yatay bir “kazananlar sıralaması” olarak kullanılmamalıdır.
Uygulamaya yönelik FHE hızlandırıcıları
Derleme, FHE donanım araştırmasının yalnız genel kriptografik primitive'leri hızlandırmaktan uygulama düzeyinde hardware–software co-design'a kaydığını belirtmektedir. Üç ana uygulama grubu edge computing, federated learning ve artificial intelligence olarak incelenmektedir.
| Alan | Tasarım | Kaynakta aktarılan ana sonuç | Yorum sınırı |
|---|---|---|---|
| Edge | HHEML | İstemci encryption latency'sinde >50× azalma/hızlanma ve hardware throughput'ta yaklaşık 2× artış. | Hibrit HE yaklaşımı; ağır homomorfik hesap sunucuya aktarılır. |
| Edge | Pasta on Edge | Mevcut FHE public-key client accelerators'a karşı 97× hızlanma. | 7 nm ve 28 nm ASIC gerçekleştirimleri bağlamında. |
| Edge | Embedded SEAL/CKKS NTT | Saf yazılıma göre yaklaşık 1000× hızlanma. | Özel NTT hızlandırma iş yükü. |
| Federated learning | FedBit | Encryption'da yaklaşık iki büyüklük mertebesi hızlanma ve ortalama communication overhead'de %60,7 azalma. | BFV tabanlı paketleme ve FPGA ortak tasarımı. |
| Federated learning | Yang ve ark. FL framework | Training encryption time'da %71'e kadar azalma. | Kaynak açıkça Paillier'ın partially homomorphic olduğunu ve bu örneğin FHE-FL mühendisliği için referans olduğunu belirtir. |
| AI | CHAM | Matrix–vector multiplication'da 1800×, logistic regression'da 36×, Beaver triple üretiminde 144×. | İş yüküne özgü FPGA karşılaştırmaları. |
| AI | FHE-CGRA | Geleneksel CGRA'ya karşı 8,15× performans; FPGA FHE-CNN hızlandırıcılarına karşı 16,48× enerji verimliliği. | CGRA veri akışı bağlamında. |
| AI | Cheetah | HE parametre ayarı ve operator scheduling ile önceki yaklaşımlara göre 79×'e kadar hızlanma. | Private DNN inference için bütünleşik tasarım. |
| AI | HERACLES | FHE matematik işlemlerinde 24-core Intel Xeon W7-3455'e karşı 1074×–5547×. | Intel 3 nm, 8192-way SIMD SoC bağlamında; tek bir neural-network modeline özgü değildir. |
FHE çekirdek aritmetiğinin polinom halkası
Kaynak güncel ana akım FHE şemalarının çekirdek polinom aritmetiğini bu tür residue-class polynomial ring yapıları üzerinden tartışmaktadır.
\(\mathbb{Z}_q\), katsayıların \(q\) modülünde hesaplandığı tamsayı sınıfını; \(x\) polinom değişkenini; \(N\) polinom boyutunu gösterir. \(x^N+1\) ile bölüm alınması, yüksek dereceli polinom terimlerinin bu bağıntıya göre indirgenmesi anlamına gelir.
Denklemin fiziksel birimi yoktur; bu matematiksel bir cebirsel yapıdır. Donanım açısından \(N\)'nin büyümesi işlenecek katsayı sayısını, \(q\)'nun büyümesi ise katsayı aritmetiğinin bit genişliğini etkiler. Bu nedenle polinom boyutu ve modül seçimi doğrudan multiplier, bellek ve veri yolu tasarımına yansır.
FHE İçin Hangi Polinom Çarpanı Ne Zaman Seçilir?
Kaynağın karar diyagramında NTT/INTT, uygun asal modül ve transform şartlarının sağlandığı durumda öne çıkarken, bu koşulların uygun olmadığı yapılarda polinom boyutuna ve donanım kısıtına göre Toom–Cook veya Karatsuba tercihleri değerlendirilir; bu şema kesin evrensel seçim kuralı değil, derlemenin parametre–donanım uyumluluğunu öğretmek için sunduğu mühendislik karar çerçevesidir.
NTT/INTT ve Toom–Cook/Karatsuba karmaşıklıkları
Kaynak NTT/INTT tabanlı polynomial multiplication için yaklaşık karmaşıklığı şu biçimde verir:
Burada \(N\), polinomdaki katsayı sayısına bağlı boyuttur. Big-O ifadesi fiziksel zaman birimi değil, problem boyutu büyüdükçe gerekli işlem miktarının nasıl ölçeklendiğini gösteren asimptotik büyüklüktür.
Toom–Cook-k için kaynakta verilen genel karmaşıklık yapısı:
\(k\), polinomun kaç alt parçaya ayrıldığını belirtir. Karatsuba, iki parçalı Toom–Cook'un özel durumudur. Bu nedenle \(k=2\) için üs \(\log_2 3\) olur. Kaynak Şekil 3, Karatsuba için yaklaşık \(O(N^{1.585})\), Toom–3 için yaklaşık \(O(N^{1.465})\) ve Toom–4 için yaklaşık \(O(N^{1.404})\) ölçeklerini göstermektedir.
Daha küçük asimptotik üs tek başına gerçek donanımın daha hızlı olduğu anlamına gelmez. Evaluation/interpolation maliyeti, DSP sayısı, bellek trafiği, pipeline yapısı ve paralel işlenebilirlik toplam latency'yi değiştirebilir.
NTT için modül koşulu
Kaynağın TC/Karatsuba karşılaştırması NTT/INTT için pratik olarak \(N\)'nin iki kuvveti ve modülün şu şartı sağlayan asal sayı olmasını belirtmektedir:
Bu koşul, transform için gereken kök yapılarını destekleyen modül seçimiyle ilgilidir. Donanım açısından NTT hızlı ve paralelleştirilebilir bir polinom çarpma yolu sunar; buna karşılık modül seçimi, twiddle-factor belleği, butterfly birimleri ve memory addressing daha karmaşık hale gelebilir.
NTT/INTT tabanlı polynomial multiplier
Number Theoretic Transform (NTT) ve inverse NTT (INTT), polinom çarpımını transform alanında point-wise multiplication işlemlerine dönüştüren temel aritmetik yapılardır. Kaynak bunları RLWE ve NTRU tabanlı şemelerin en önemli hardware primitive'lerinden biri olarak değerlendirmektedir.
Negative Wrapped Convolution (NWC), sıfır doldurma nedeniyle transform uzunluğunun \(2N\)'ye çıkmasını önleyip \(N\)'de tutulmasını sağlar; buna karşılık NTT öncesi ve INTT sonrası ek scaling-factor çarpmaları oluşturur.
Pöppelmann tasarımı için kaynak bir polynomial multiplication maliyetini yaklaşık şu ifade ile aktarmaktadır:
Kaynağın açıklamasına göre ek \(5.5n\) teriminin önemli bölümü katsayı yükleme, point-wise multiplication ve post-scaling işlemlerinden gelmektedir. \(n=512\) için 10.014 cycle ve 4 BRAM raporlanmış; sonraki normalize karşılaştırmada 51,09 µs verilmiştir.
Du ve arkadaşları polynomial multiplication maliyetini:
yapısından:
yapısına düşürmüş; sabit-factor depolamasını \(4N\)'den \(2.5N\)'e indirerek %37,5 ROM tasarrufu bildirmiştir. \(n=512\) için 8806 cycle ve 26.913 multiplication raporlanmaktadır.
| Çalışma | Algoritma | Hibrit | Platform | Öne çıkan avantaj / sınır |
|---|---|---|---|---|
| Pöppelmann | GS NTT | Hayır | FPGA | Dinamik parametre ayarı; kaynak tüketimi ve esneklik sınırı. |
| Xu | CG NTT | Evet | FPGA | Yüksek configurability ve kısa critical path; fixed radix ve kontrol karmaşıklığı. |
| Roy | CT NTT | Evet | FPGA | Area–performans dengesi; yüksek parametre bağımlılığı. |
| Du | CT NTT | Evet | FPGA | İşlem ve depolama optimizasyonu; butterfly paralelliği sınırlı. |
| Pöppelmann | CT NTT | Evet | MCU | Düşük storage overhead ve timing side-channel koruması; parametre ölçeklenebilirliği zayıf. |
| Zhang | CG NTT | Evet | FPGA | Post-processing azaltımı; büyük twiddle-factor belleği. |
| Zeng | CG NTT | Evet | ASIC | Yüksek configurability ve düşük resource use; yüksek paralellikte kontrol karmaşıklığı. |
| Chen | CG NTT | Evet | FPGA | Pipeline ve basit kontrol; resource ve scalability maliyeti. |
| Banerjee | CG NTT | Evet | ASIC | Side-channel direnci ve bütünleşik yapı; özel tasarımlara göre performans/resource sınırı. |
| Longa | CG NTT | Evet | MCU | Mixed radix esnekliği; düşük throughput ve güvenlik riskleri. |
| Phap | CG NTT | Evet | FPGA | Conflict-free memory ile area efficiency; modulus uyumluluğu ve throughput sınırı. |
| Mandal | Winograd NTT | Hayır | FPGA | Az modular multiplier ve düşük latency; daha fazla addition ve kontrol karmaşıklığı. |
| Ramyavani | CG NTT | Hayır | FPGA | Düşük hardware utilization; yalnız küçük polinomlarda optimize edilmiş. |
| Bardia | CG NTT | Evet | FPGA | Çok düşük latency; yüksek paralel donanım/area maliyeti. |
| Zhao | CG NTT | Evet | RISC-V | Load-store unit ile sıkı bütünleşme ve veri aktarım kazancı; critical path/frequency sınırı. |
Kaynak ParallelNTT örneğinde ML-KEM için 128 DSP, ML-DSA için 256 DSP kullanarak önceki FPGA tasarımlarına göre forward/inverse transform latency'sinde 24× ve 21× iyileşme aktarmaktadır. Bu örnekler FHE şeması değildir; NTT donanım mimarisinin ortak lattice-cryptography aritmetiğine uygulanmasını göstermektedir.
Toom–Cook ve Karatsuba
NTT'nin modül ve polinom boyutu koşullarına karşılık Toom–Cook ve Karatsuba daha geniş parametre esnekliği sunabilir. Kaynağın değerlendirmesine göre bu esneklik özellikle resource-constrained veya uygun olmayan modül yapısına sahip tasarımlarda önemlidir.
Karatsuba iki parçalı bölme kullanırken Toom–Cook-3 veya Toom–Cook-4 daha kaba parçalama yaparak daha az recursion seviyesi ve daha düşük asimptotik multiplication count sağlayabilir. Bunun bedeli evaluation, interpolation, recombination ve düzensiz memory access aşamalarının donanımda karmaşıklaşmasıdır.
| Çalışma | Algoritma | Platform | Öne çıkan avantaj / sınır |
|---|---|---|---|
| Migliore | Karatsuba-3 | FPGA | Düşük latency; dynamic reconfiguration ve throughput sınırlı. |
| Zhu | 8-level Iterative Karatsuba | FPGA + ASIC | Karmaşıklık/verim dengesi; recursion overhead ve side-channel eksikliği. |
| Wong | 1-level Karatsuba | FPGA | Negacyclic convolution'da iyi DSP kullanımı; paralellik sınırlı. |
| Wang | TCPM, TC-2/3/4 | FPGA | Yüksek configurability ve paralellik; kontrol mantığı karmaşık. |
| Karmakar | TC + Karatsuba + Schoolbook | Cortex-M4 | Çok düşük memory footprint ve algoritmik uyarlanabilirlik; yüksek karmaşıklık. |
| Mera | 3-level Karatsuba | AVX | Memory optimizasyonu ve timing-attack direnci; kontrol/scalability sınırı. |
| Kannwischer | TC-4 + multi-level Karatsuba | Cortex-M4 | Kararlı bellek ve iyi performans; scalability ve side-channel sınırı. |
| Paksoy | TC-4 | Cortex-M4 | Yüksek versatility; scalability ve side-channel sınırı. |
| Mera | TC-4 | FPGA | Yüksek throughput ve memory access efficiency; scalability sınırlı. |
| Ghosh | Striding TC-4 | ASIC | Düşük bellek ve iyi uyarlanabilirlik; paralel performans ve algoritma esnekliği sınırlı. |
| Li ve çalışma grubu | TC-3 | ASIC | Modüler ve ölçeklenebilir tasarım; hardware resource yüksek. |
| Ma | TC-3 | FPGA | Latency iyileşmesi; frequency ve side-channel sınırı. |
| Vasanthi | Hybrid Karatsuba | FPGA + ASIC | Area ve latency optimizasyonu; yüksek karmaşıklık ve side-channel eksikliği. |
Kaynakta Migliore tasarımında \(n=1024\) için operation count 3583'ten 3071'e düşürülürken FFT karşılaştırması 4158 operation olarak verilmektedir. Sınırlı embedded multiplier koşulunda Karatsuba için %58'e kadar speedup aktarılmaktadır.
Zhu'nun degree-256 Karatsuba tasarımı coefficient multiplication sayısını 65.536'dan 6521'e düşürmüş ve bir multiplication işlemini 81 cycle'da tamamlamıştır. Kaynak bu tasarım için yaklaşık 3,16× hızlanma aktarmaktadır.
Wang'ın reconfigurable TCPM tasarımı TC-2, TC-3 ve TC-4'ü aynı mimaride desteklemekte, post-processing arithmetic operation sayısını en az %33,33 azaltmakta ve Xilinx VC709 üzerinde kaynak karşılaştırmalarına göre 2,47×–50,11× hızlanma bildirmektedir.
Karmakar'ın Cortex-M4 Saber multiplier'ı 256×256 polynomial multiplication için 65.459–66.692 cycle aralığı raporlamaktadır. Mera'nın sonraki çalışmasında matrix-vector polynomial multiplication çeşitli platformlarda %12–37 iyileşmiş, AVX2'de %29,3–36,6 kazanç ve Cortex-M4 memory kullanımında 2,6–5,7 KB azalma aktarılmıştır.
Bu Saber örneklerinin FHE değil post-kuantum key encapsulation bağlamından geldiği unutulmamalıdır. Derleme bunları Toom–Cook/Karatsuba hardware datapath tasarımına ilişkin ortak aritmetik örneği olarak kullanmaktadır.
Tamsayı modüler çarpan neden ayrı bir çekirdek bileşendir?
Polynomial multiplier yalnız katsayıları çarpmaz; ara ve son katsayıların belirlenen modül altında tutulması gerekir. Bu nedenle integer modular multiplier, hem polynomial multiplier'ın içinde hem de FHE'nin birçok diğer aritmetik aşamasında temel donanım birimidir.
| Çarpan türü | Örnek çalışma | Bağlam / platform | Kaynakta öne çıkan mühendislik dengesi |
|---|---|---|---|
| Barrett | Öztürk | LTV / FPGA | Genel ve verimli modular reduction; geniş bit uzunluğunda critical path ve resource maliyeti büyüyebilir. |
| Barrett | Roy | BFV / FPGA | Area ve speed arasında dengeli resource-efficient yapı. |
| Barrett | Hao | Toom–Cook / ASIC | Yüksek area efficiency. |
| Shoup | Riazi | NTT / CPU+FPGA | Farklı durumlar için optimize; çift instantiation hardware overhead oluşturabilir. |
| Shoup | Kim | CKKS / FPGA | Düşük resource ve latency; operandlardan birinin constant olması gerekir. |
| Montgomery | Mert | BFV / CPU+FPGA | Daha az modular reduction; Montgomery domain dönüşümü ek maliyet doğurur. |
| Montgomery | Li | IP-MMM / FPGA | Kısa data path; high-performance ve düşük maliyetli IoT için uygun olarak aktarılır. |
| Montgomery | Roy | HRKM + OSBM / FPGA+ASIC | Tek-cycle çalışma, düşük resource ve latency. |
| Montgomery | Wang | PPMM / FPGA | Düşük cycle count ve yüksek operating frequency. |
| Solinas prime | Cao | FFT/IFFT / FPGA | Özel modül yapısıyla reduction kolaylaşır; kullanılabilecek modül biçimi kısıtlıdır. |
| Solinas prime | Zijlstra | NTT/INTT / FPGA | Shift/add/sub ağırlıklı basit hardware; özel modül gerektirir. |
Kaynağın genel değerlendirmesine göre Barrett ve Montgomery genel modüller ve variable–variable multiplication açısından daha geniş kullanılabilirliğe sahiptir. Shoup yaklaşımı variable–constant multiplication için verimli olabilir fakat sabit operand gereksinimi genelliği sınırlar. Solinas ve özel-prime yapıları çok hızlı reduction sağlayabilir fakat uygun modül seçimini daraltır.
Bootstrapping Neden FHE Donanımında Kritik?
Bootstrapping, ciphertext içinde biriken gürültü veya hesaplama derinliği sınırını yenileyerek leveled FHE'yi teorik olarak sınırsız devre derinliğine yaklaştıran işlem olduğu için kritik kabul edilir; ancak BGV/BFV/CKKS tarafında büyük NTT/INTT, RNS dönüşümü, key switching, rotation ve modulus işlemleri, FHEW/TFHE tarafında ise blind rotation, accumulator güncellemesi ve büyük bootstrapping-key trafiği nedeniyle donanımın en ağır işlemlerinden biridir.
Leveled FHE ile gerçek FHE arasındaki mühendislik farkı
Leveled FHE, önceden belirlenmiş sınırlı hesaplama derinliğine yetecek parametrelerle çalışabilir. Devre derinliği arttıkça ciphertext gürültüsü ve modül bütçesi sınıra yaklaşır. Bootstrapping ciphertext'i homomorfik olarak “yenileyerek” daha fazla hesaplamaya devam etmeyi sağlar.
Ancak bootstrapping donanım maliyeti çok yüksektir. CKKS/BFV/BGV için high-throughput NTT/INTT pipeline, conflict-free multi-bank memory, rotation/key-switching veri akışı, büyük evaluation-key depolama ve bazı durumlarda anahtarın gerektiğinde yeniden oluşturulması önem kazanmaktadır.
FHEW/TFHE tarafında ise blind rotation, homomorphic accumulator, polynomial–vector/matrix multiplication ve bootstrapping key bandwidth'i öne çıkar. Bu nedenle aynı bootstrapping accelerator mimarisinin CKKS ve TFHE için doğrudan aynı şekilde kullanılması beklenmez.
Çalışmanın Yöntemi ve Bulguları
Derleme yöntemi
Makale kendi yöntemini narrative review olarak tanımlar. Yazarlar donanım odaklı bir literatür taraması gerçekleştirmiştir.
| Öğe | Kaynakta bildirilen bilgi |
|---|---|
| Zaman aralığı | 2009–2026; özellikle 2020 sonrası yeni çalışmalara dikkat edilmiştir. |
| Veritabanları | IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar, IACR ePrint. |
| Ana arama terimleri | fully homomorphic encryption, FHE hardware implementation, FHE accelerator, FPGA/ASIC accelerator, polynomial multiplier, NTT/INTT, Toom–Cook, Karatsuba, modular multiplier. |
| Screening | Duplicate kayıtlar çıkarılmış; title, abstract ve full text üzerinden eleme yapılmıştır. |
| Dahil edilen ana çalışma türleri | FHE scheme, hardware accelerator architecture, polynomial multiplication ve integer modular multiplication ile doğrudan ilişkili çalışmalar. |
| Dışlama | Yalnız software library odaklı çalışmalar, hardware implementation içermeyen application-level çalışmalar ve ilgisiz cryptographic hardware. |
| Organizasyon | FHE scheme evolution, accelerator type, core arithmetic component ve implementation platform. |
Yöntemde raporlanmayan unsurlar
- Başlangıçta bulunan toplam kayıt sayısı verilmemiştir.
- Duplicate sonrası kaç kayıt kaldığı raporlanmamıştır.
- Title/abstract ve full-text aşamalarında kaç çalışmanın elendiği açıklanmamıştır.
- Nihai dahil edilen çalışma sayısı yöntem bölümünde tek bir toplam sayı olarak verilmemiştir.
- PRISMA akış diyagramı bulunmamaktadır.
- Önceden kayıtlı review protocol bilgisi raporlanmamıştır.
- Kaynak çalışmalar için formal risk-of-bias veya kalite puanlama sistemi raporlanmamıştır.
- Meta-analysis yapılmamıştır.
Bu nedenle çalışma geniş ve yapılandırılmış bir literatür taraması sunmasına rağmen sonuçları nicel meta-analiz sonucu olarak yorumlanmamalıdır.
Derlemenin üç temel mevcut sorun tespiti
- Dağınık özel donanım blokları: NTT/INTT, modular arithmetic, modulus raising/reduction ve rescaling gibi farklı primitive'ler için ayrı hızlandırıcılar kullanılması ortak processing unit'lerin tekrar edilmesine ve hardware utilization'ın düşmesine yol açabilmektedir.
- Şemaya aşırı özelleşme: Birçok hızlandırıcı yalnız belirli bir BFV, CKKS, TFHE veya başka FHE ailesi için optimize edilmekte; fixed datapath başka parametre veya algoritmalara uyumu sınırlamaktadır.
- Uygulama gereksinimleriyle tam eşleşmeme: Neural-network training, multi-party secure computation ve federated learning gibi iş yükleri latency, depth, precision, memory, communication ve power açısından genel FHE accelerator'dan farklı taleplere sahiptir.
Gelecek yön 1 — Yeniden yapılandırılabilir ve paylaşımlı accelerator
Yazarlar gelecek donanımın operator-specific çekirdekler yerine katmanlı reconfigurable architecture'a yönelmesini önermektedir. Alt katmanda modular arithmetic, butterfly array, NTT/INTT, point-wise multiplier, RNS channel ve on-chip memory bank gibi ortak birimler farklı şemalar tarafından paylaşılabilir.
Orta katmanda programmable modulus-reduction mode, flexible radix, microcoded instruction scheduling ve parametrelenebilir \(N\), \(q\), RNS base ve decomposition base desteği hedeflenmektedir.
Üst katmanda ise BFV base extension/scaling, CKKS rescaling/approximate modulus conversion ve TFHE accumulator update gibi şemaya özgü akışların microprogram veya özel functional extension olarak korunması önerilmektedir.
Gelecek yön 2 — Bootstrapping odaklı accelerator
Derleme, finite-depth işlemler için optimize edilmiş hızlandırıcılardan unbounded-depth computation'ı daha doğrudan destekleyen bootstrapping accelerators'a geçişi önemli bir araştırma yönü olarak görmektedir.
Leveled şemalarda large-parameter NTT/INTT, RNS base conversion, key switching, slot rotation ve rescaling; bit-bootstrappable şemalarda blind rotation, accumulator ve key bandwidth farklı donanım odakları yaratır. Kaynak bazı birimlerin ortaklaştırılabileceğini, bazı mekanizmaların ise şemaya özel kalması gerektiğini savunmaktadır.
Gelecek yön 3 — Uygulama temelli hardware–software co-design
Yazarlar gelecekteki accelerator tasarımının yalnız kriptografik primitive'e göre değil, hedef application workload'a göre yapılması gerektiğini savunmaktadır.
Encrypted neural-network inference için SIMD packing, rotation, key switching, matrix-vector multiplication, convolution, nonlinear approximation ve gerektiğinde bootstrapping birlikte optimize edilmelidir.
Federated learning'de encryption/decryption'dan daha geniş bir problem vardır: secure aggregation, ciphertext packing, communication compression, homomorphic matrix–vector computation ve cross-institution feature interaction aynı pipeline içinde değerlendirilmelidir.
Edge ve IoT tarafında ise low area, low power, küçük storage footprint, compact parameter set, lightweight modular arithmetic ve edge–cloud task partitioning öncelikli hale gelmektedir.
Çalışmanın desteklediği sonuçlar
- FHE'nin pratik donanım maliyetinde polynomial multiplication ve modular multiplication merkezi rol oynamaktadır.
- BFV ve CKKS'de RNS ve büyük polinom aritmetiği donanım paralelliğinin temel konularındandır.
- FHEW/TFHE farklı ciphertext ve bootstrapping yapıları nedeniyle farklı accelerator datapath'lerine ihtiyaç duyar.
- RLWE tabanlı accelerator araştırmaları son yıllarda scheme-level ve system-level co-design yönüne kaymaktadır.
- NTT/INTT çok güçlü bir polynomial multiplication seçeneğidir fakat modulus ve twiddle-factor/memory gereksinimleri vardır.
- Toom–Cook/Karatsuba, daha esnek modulus/polynomial şartları ve uygun resource koşullarında önemli alternatiftir.
- Barrett, Montgomery, Shoup ve Solinas çarpanları arasında efficiency ile modulus/operand flexibility arasında temel trade-off bulunmaktadır.
- Bootstrapping desteği gelecek FHE accelerators için ana tasarım hedeflerinden biridir.
- Application-specific hardware–software co-design, genel primitive hızlandırmadan daha bütüncül sistem optimizasyonuna doğru bir yönelim göstermektedir.
Çalışmanın desteklemediği sonuçlar
- Derleme tek bir FHE accelerator'ın bütün diğerlerinden evrensel olarak daha iyi olduğunu göstermemektedir.
- Farklı makalelerdeki speedup oranları ortak test sistemi üzerinden ölçülmediği için doğrudan aynı ölçek üzerinde sıralanamaz.
- Derleme kendi yeni FPGA veya ASIC prototipini üretmemektedir.
- Derleme kendi enerji, latency veya area benchmark veri setini oluşturmamaktadır.
- FHE'nin bütün sistem güvenliği sorunlarını otomatik olarak çözdüğü sonucu çıkarılamaz; bu derlemenin temel odağı hardware performance'tır.
- ML-KEM, ML-DSA, Saber veya NTRU Prime örneklerinin FHE şeması olduğu sonucu çıkarılamaz; kaynak bunlardan ortak arithmetic hardware örnekleri olarak yararlanmaktadır.
- Paillier örneği tam homomorfik değildir; kaynak bunu federated-learning hardware engineering açısından referans örneği olarak açıkça ayırmaktadır.
- Her uygulama için NTT'nin veya Karatsuba'nın tek doğru polynomial multiplier olduğu sonucu çıkarılamaz.
Derlemenin yeniden üretilebilirlik sınırları
Kaynak arama yapılan akademik veritabanlarını, tarih aralığını, ana anahtar kelimeleri ve dahil etme/dışlama yaklaşımını raporlamaktadır. Bu, sıradan anlatısal bir literatür özetinden daha izlenebilir bir arama çerçevesi sağlar.
Buna karşılık arama dizelerinin her veritabanı için tam Boolean biçimi, aramanın kesin tarihleri, kayıt sayıları, duplicate sayıları, exclusion reason dağılımı ve formal quality assessment bulunmamaktadır. Bu nedenle başka bir araştırmacının aynı makale havuzunu birebir yeniden oluşturması için gerekli bütün systematic-review metadata'sı mevcut değildir.
Ayrıca derleme içinde aktarılan performans sonuçları kendi yeniden benchmark edilen veriler değildir; özgün makalelerin rapor ettiği sonuçlardır. Donanım süreci, FPGA ailesi, saat hızı, FHE parametreleri, security level, software baseline ve workload farklı olduğundan karşılaştırmalı tablolar daha çok mimari eğilimleri anlamak için kullanılmalıdır.
Kaynak ve Yöntem Notu
Özgün başlık: A Brief Survey on Hardware Implementation of Fully Homomorphic Encryption
Yazarlar: Yang Su; Kaixuan Zhou; Weidong Zhong; Jianfei Wang; Jia Hou; Chen Yang.
Yazar sırası: Yang Su birinci, Kaixuan Zhou ikinci, Weidong Zhong üçüncü, Jianfei Wang dördüncü, Jia Hou beşinci, Chen Yang altıncı yazardır.
Sorumlu yazar: Weidong Zhong.
Kurum 1: School of Cryptography Engineering, Engineering University of People’s Armed Police, Xi’an 710086, China.
Kurum 2: School of Microelectronics, Xi’an Jiaotong University, Xi’an 710049, China.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı işareti bulunmamaktadır.
Dergi: Cryptography.
Yayıncı: MDPI, Basel, Switzerland.
Cilt / sayı / makale: 10(4), 49.
Sayfa sayısı: 34.
DOI: 10.3390/cryptography10040049.
Gönderim tarihi: 3 Haziran 2026.
Revizyon tarihi: 4 Temmuz 2026.
Kabul tarihi: 8 Temmuz 2026.
Yayın tarihi: 13 Temmuz 2026.
Makale türü: Review; kaynak kendi yöntemini narrative review olarak tanımlamaktadır.
Hakemlik: Cryptography için resmî MDPI materyallerinde single-blind peer review belirtilmektedir.
Preprint durumu: İşlenen belge yayımlanmış dergi sürümüdür; bu Verianla içeriğinde preprint kullanılmamıştır.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Resmî yayın bağlantısı: DOI 10.3390/cryptography10040049 üzerinden MDPI Cryptography makale kaydı.
Akademik editörler: Ki-Hyun Jung ve Luis Javier García Villalba.
Anahtar kelimeler: fully homomorphic encryption (FHE); hardware implementation; accelerator; polynomial multiplier; modular multiplier.
Derleme dönemi: 2009–2026; özellikle 2020 sonrası literatüre odaklanılmıştır.
Taranan kaynaklar: IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar ve IACR ePrint.
Dahil etme odağı: FHE schemes, hardware accelerator architecture, polynomial multiplication ve integer modular multiplication.
Dışlama odağı: Yalnız software library çalışmaları, hardware implementation içermeyen application-level çalışmalar ve ilgisiz cryptographic hardware.
Yeni deneysel veri: Yoktur. Kaynak yeni veri oluşturmadığını veya analiz etmediğini açıkça belirtmektedir; sonuçlar yayımlanmış literatür ve kamuya açık teorik modellerden türetilmiştir.
Finansman: Araştırma dış finansman almamıştır.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Veri erişilebilirliği: Yeni veri oluşturulmadığından data sharing bu derleme için uygulanabilir değildir.
Yazar katkıları: Resmî MDPI kaydına göre kavramsallaştırma Yang Su ve Kaixuan Zhou; yöntem Yang Su ve Kaixuan Zhou; supervision ve resources Weidong Zhong; formal analysis, visualization ve investigation Jianfei Wang ile Jia Hou; review/editing ve project administration Chen Yang tarafından yürütülmüştür. Bütün yazarların yayımlanan sürümü okuyup kabul ettiği belirtilmektedir.
Etik kurul / insan-hayvan araştırması: Çalışma özgün insan veya hayvan verisi üretmeyen bir literatür derlemesidir; kaynakta ayrı bir insan/animal experimental protocol raporlanmamaktadır.
Kaynak şekilleri: Şekil 1 FHE cloud privacy modelini, Şekil 2 hardware accelerator classification framework'ünü, Şekil 3 FHE parameter/polynomial multiplier selection kararını göstermektedir. Verianla'da bunların üçü de kaynak ilişkilerinden bağımsız inline SVG olarak yeniden kurulmuştur.
Kaynak tabloları: Tablo 1 BFV/CKKS/FHEW-TFHE özelliklerini; Tablo 2 bütün FHE accelerators'ı; Tablo 3 NTT/INTT polynomial multipliers'ı; Tablo 4 Karatsuba/Toom–Cook polynomial multipliers'ı; Tablo 5 integer modular multipliers'ı karşılaştırmaktadır.
Temel yöntemsel sınır: Çalışma narrative review'dür. Veritabanları, zaman aralığı ve screening mantığı raporlanmasına rağmen PRISMA akışı, toplam kayıt/dahil edilen çalışma sayısı, kayıtlı protokol, formal kalite değerlendirmesi ve meta-analysis raporlanmamaktadır.
Karşılaştırma sınırı: Derlemede aktarılan speedup, latency, throughput, area ve energy değerleri farklı özgün çalışmalardan gelmektedir. Farklı hardware technology, FPGA/ASIC/CPU, clock frequency, security parameter, polynomial degree, modulus, workload ve software baseline kullanıldığı için değerler doğrudan ortak benchmark sonucu gibi sıralanmamalıdır.
Kapsam notu: Derleme bazı FHE olmayan post-kuantum kriptografi çalışmalarını polynomial multiplier veya modular arithmetic hardware tasarımına örnek olarak kullanmaktadır. Bu örneklerin FHE şeması olduğu sonucu çıkarılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir