


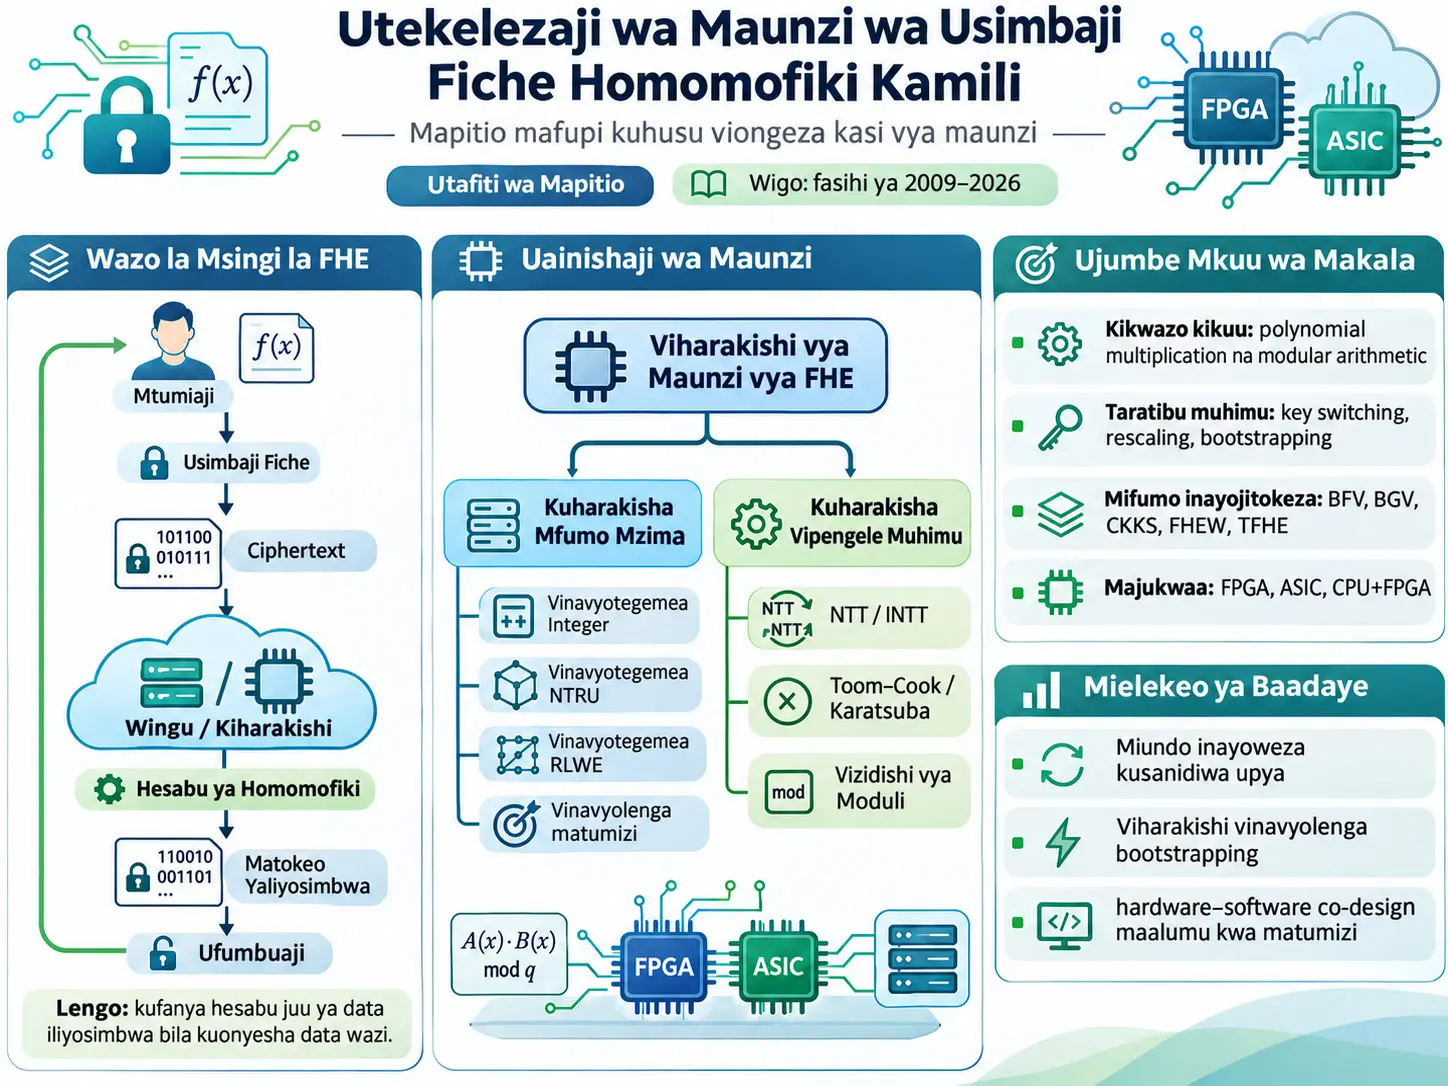
Usimbaji Fiche Homomofiki Kamili (Fully Homomorphic Encryption, FHE) ni mbinu ya usimbaji fiche inayolenga kuruhusu hesabu fulani kufanywa moja kwa moja juu ya ciphertext bila kuhitaji kwanza kubadilisha data iliyosimbwa kuwa maandishi wazi, na kuhakikisha kwamba matokeo yaliyosimbwa, yanapofumbuliwa na mtumiaji aliyeidhinishwa, yanatoa matokeo yale yale kama hesabu husika iliyofanywa juu ya data wazi. Utafiti huu haupendekezi algoriti mpya ya FHE wala kichapuzi kipya; badala yake unawasilisha narrative review inayolenga maunzi na kuchunguza maendeleo ya skimu za FHE kati ya 2009–2026, miundo ya maunzi inayoharakisha mfumo mzima wa FHE, vizidishi vya polinomu na vizidishi vya moduli za nambari kamili. Hitimisho kuu la mapitio ni kwamba utendaji wa maunzi ya FHE hauwezi kutatuliwa kwa kutengeneza mzunguko wa kuzidisha ulio wa haraka zaidi pekee; arithmetic ya polinomu, bootstrapping, key switching, uhamishaji wa data kwenye kumbukumbu, uwezo wa kusanidiwa upya na mtiririko wa data mahsusi kwa programu lazima uzingatiwe kwa pamoja.
Kulingana na tathmini ya waandishi, vichapuzi vya FHE vinavyotegemea RLWE vimekuwa mojawapo ya mielekeo mikuu katika utafiti wa sasa wa maunzi kwa sababu ya misingi thabiti zaidi ya lattice iliyosanifishwa na miundo yake ya kialjebra inayonyumbulika. Skimu za leveled FHE kama BFV, BGV na CKKS hufanya kazi na polinomu kubwa, Residue Number System (RNS), polynomial multiplication, relinearization, key switching na usimamizi wa modulus; ilhali familia ya FHEW/TFHE hutumia moduli ndogo zaidi na bootstrapping katika kiwango cha biti. Tofauti hizi hufanya iwe vigumu kwa kichapuzi kimoja kisichobadilika kuwa na ufanisi sawa kwa algoriti zote za FHE.
Mapitio yanasisitiza kwamba sehemu kubwa ya vichapuzi vilivyopo imeboreshwa mahsusi kwa skimu fulani au operesheni fulani za msingi; ingawa hili huongeza utendaji, pia huzuia matumizi tena ya rasilimali za pamoja za maunzi na unyumbufu kati ya algoriti. Waandishi wanatabiri kwamba siku zijazo kutakuwa na umuhimu mkubwa wa vitengo vinavyoweza kushirikiwa vya modular arithmetic, viini vya NTT/INTT vinavyoweza kusanidiwa upya, mtiririko wa data unaoweza kupangwa, miundo inayolenga bootstrapping, na ubunifu-shirikishi wa programu–algoriti–maunzi.
Viwango vya juu sana vya kuongeza kasi vilivyoripotiwa katika chanzo havitokani na benchmark moja ya pamoja. F1, HEAX, Poseidon, CHAM, HERACLES na miundo mingine hutumia skimu tofauti za FHE, teknolojia tofauti za maunzi, vigezo, mizigo ya kazi na misingi tofauti ya programu. Kwa hiyo, kwa mfano, thamani ya kuongeza kasi ya 1000×, 5000× au 17.000× haiwezi kulinganishwa moja kwa moja na thamani ya kuongeza kasi katika mstari mwingine ili kuunda orodha ya jumla ya utendaji.
Katika uchunguzi wa arithmetic ya msingi, utafiti pia unajumuisha mifano ya kriptografia inayotegemea lattice ambayo si FHE, kama Saber, ML-KEM, ML-DSA na NTRU Prime. Hizi hazijawasilishwa kama “skimu za FHE”; zimetumika kama mifano ya kihandisi ya utekelezaji wa maunzi wa arithmetic za polinomu zinazoshirikiwa, kama NTT/INTT, Karatsuba na Toom–Cook.
Wazo la msingi la FHE ni nini?
Katika modeli ya kawaida ya kukabidhi hesabu kwa mfumo wa nje, ikiwa mmiliki wa data anatuma data nyeti kwa seva katika hali ya wazi, seva inaweza kufanya hesabu kwa urahisi lakini faragha inaweza kupotea. Lengo la FHE ni kuwezesha seva kufanya hesabu juu ya ciphertext bila kuona maudhui ya wazi ya data. Mtumiaji kwanza husimba data kwa kutumia ufunguo wake, wingu huchakata ciphertext pekee, na matokeo hurudishwa kwa mtumiaji yakiwa bado yamesimbwa.
Neno “homomofiki” katika muundo huu linaeleza kwamba kuna uhusiano unaohifadhiwa katika matokeo kati ya operesheni za kihisabati zinazofanywa juu ya data wazi na operesheni zinazofanywa juu ya uwakilishi uliosimbwa. Tatizo la kihandisi la FHE halihusu tu uwezekano wa kinadharia wa operesheni hizi, bali zaidi kiasi cha hesabu, kumbukumbu, upana wa bendi na eneo la maunzi kinachohitajika katika matumizi halisi.
Kwa nini mapitio haya yalihitajika?
Chanzo kinaeleza kwamba sehemu kubwa ya mapitio ya awali ya FHE yalijikita kwenye kanuni za kihisabati, sifa za usalama na maktaba za programu. Baadhi ya tafiti zilizoshughulikia kuongeza kasi kwa maunzi zilibaki katika miaka fulani tu, zilichunguza kiwango cha jumla cha accelerator architecture pekee, au zililenga tatizo dogo maalumu kama CKKS bootstrapping.
Lengo la waandishi ni kujaza pengo hili katika viwango vitatu: kutathmini maendeleo ya skimu za FHE kwa mpangilio wa kihistoria, kuainisha vichapuzi vinavyolenga mfumo mzima wa FHE, na kulinganisha kando vitengo vya maunzi vya kiwango cha msingi kama polynomial multiplier na modular multiplier vinavyoamua utendaji.
Kizazi cha kwanza cha FHE
Chanzo kinaunganisha mwanzo wa kizazi cha kwanza na muundo wa Gen09 wa Gentry wa mwaka 2009. Gen09 inachukuliwa kuwa mbinu ya kwanza ya jumla ya FHE iliyojengwa juu ya ideal lattices, inayounga mkono kwa pamoja jumlisho na zidisho homomofiki na kutumia bootstrapping kudhibiti kelele ya ciphertext.
Tafiti zilizofuata SV10, SS10, GH11 na GHS12a zilijaribu kuboresha matatizo kama ukubwa wa ciphertext/ufunguo, kina cha decryption circuit au ufanisi wa bootstrapping. Kwa mujibu wa tathmini ya mapitio, ingawa umuhimu wa kinadharia wa skimu hizi za kizazi cha kwanza ni mkubwa, ugumu wa miundo ya kialjebra, ciphertext kubwa na gharama kubwa ya bootstrapping vilizuia matumizi ya vitendo.
Kizazi cha pili cha FHE
Kizazi cha pili kinahusishwa na skimu zilizotengenezwa juu ya LWE/RLWE na pete za polinomu. BV11a/BV11b, BGV, BFV na CKKS ni mifano muhimu ya kipindi hiki.
KeySwitching ni utaratibu wa ubadilishaji unaoruhusu ciphertext kuendelea kuwakilisha taarifa ileile wazi kwa namna ya kiutendaji huku ikitumika chini ya ufunguo/uwakilishi mwingine. Katika chanzo, ina jukumu muhimu hasa katika kusimamia ukubwa wa ciphertext au funguo za tathmini.
ModulusSwitching ni mbinu inayosaidia kusimamia kelele na gharama ya hesabu kwa kubadilisha modulus ya ciphertext kwa njia inayodhibitiwa.
Relinearization ni operesheni inayotumiwa kurudisha muundo wa ciphertext uliopanuka baada ya zidisho homomofiki katika umbo linaloweza kusimamiwa kwa urahisi zaidi.
Rescaling ni sehemu ya usimamizi wa kipimo na modulus, hasa katika modeli ya CKKS ya hesabu za takriban. Chanzo kinachukulia CKKS kama skimu ya FHE inayofaa kwa hesabu za takriban za nambari halisi.
Kizazi cha tatu cha FHE
Chanzo kinahusisha kipindi cha tatu na skimu bit-bootstrappable kama GSW, FHEW na TFHE. Katika miundo hii, tathmini ya biti moja au ya kimantiki, blind rotation na homomorphic accumulator huwa muhimu.
Inaripotiwa kwamba muda wa bootstrapping kwa FHEW ulipunguzwa hadi chini ya sekunde moja, na upande wa TFHE maboresho ya baadaye yalifikia 52 ms na kisha 13 ms. Haya ni matokeo ya kihistoria kutoka tafiti tofauti; si jaribio moja la maunzi yale yale au seti ileile ya vigezo.
Tofauti kuu kati ya BFV, CKKS na FHEW/TFHE
| Sifa | BFV | CKKS | FHEW / TFHE |
|---|---|---|---|
| Aina | Leveled FHE | Leveled FHE | Bit-bootstrappable |
| Kijenzi cha msingi | Zidisho homomofiki na relinearization | Zidisho homomofiki na relinearization | Homomorphic accumulator |
| Mbinu sambamba | RNS | RNS | Katika Jedwali 1 la chanzo “None” |
| Ubadilishaji wa modulus | Base extension / scaling | Takriban modulus up/down conversion | Katika Jedwali 1 la chanzo “None” |
| Operesheni ya msingi | Polynomial multiplication | Polynomial multiplication | Polynomial matrix multiplication |
| Arithmetic ya msingi | Zidisho la nambari kamili na operesheni za moduli | Operesheni za moduli | Operesheni za moduli |
| Ukubwa wa polinomu N | ≥ \(2^{12}\) | ≥ \(2^{12}\) | \(2^{10}\) au \(2^{11}\) |
| \(\log_2 Q\) | ≥100 | ≥100 | ≤50 |
| Uteuzi wa modulus | Nambari msingi | Nambari msingi | Nguvu ya 2 au nambari msingi |
Chanzo pia kinaeleza kwamba katika skimu za leveled BFV/CKKS wakati bootstrapping inapohitajika, daraja la polinomu linaweza kufikia viwango vya \(2^{16}\)–\(2^{17}\), na modulus ya ciphertext inaweza kufikia mamia au hata maelfu ya biti. Hivi si vigezo vya lazima vilivyofungwa, bali vinaeleza mahitaji ya kawaida ya juu ya rasilimali yanayojadiliwa katika utafiti.
Kikwazo Kikuu cha Uharakishaji wa Maunzi ya FHE ni Kipi?
Kulingana na mapitio, kikwazo kikuu ni tathmini homomofiki, hasa operesheni zinazorudiwa za polynomial multiplication, modular arithmetic, key switching na bootstrapping chini ya ukubwa mkubwa wa polinomu na moduli pana; kwa hiyo utendaji wa jumla hauamuliwi na kasi ya vitengo vya hesabu pekee bali pia na ufikiaji wa kumbukumbu, uhamishaji wa data, usambamba wa RNS na matumizi tena ya rasilimali za maunzi.
Kwa nini RNS hutumiwa?
Residue Number System (RNS) ni mbinu ya uwakilishi inayowezesha hesabu inayopaswa kufanywa chini ya modulus kubwa kutekelezwa kwenye njia nyingi zenye moduli ndogo. Chanzo kinaeleza uwezo wa skimu za leveled FHE kama BFV na CKKS kugawanya moduli kubwa za ciphertext kuwa moduli ndogo na kuzichakata kwa sambamba kama faida kuu ya RNS katika maunzi.
Faida hii pia inaweza kuhitaji base conversion, modulus conversion na uhamishaji wa data wa ziada. Kwa hiyo RNS si njia ya “kuharakisha hesabu bila gharama”; ni uchaguzi wa usanifu unaobadilisha arithmetic ya nambari kubwa kamili kuwa operesheni sambamba za moduli ndogo zinazofaa zaidi.
Uainishaji wa vichapuzi vya maunzi vya FHE
Vichapuzi vya FHE vinavyotegemea Integer
Katika vichapuzi vya awali vya FHE vinavyotegemea integer, lengo kuu lilikuwa kuharakisha kuzidisha kwa nambari kamili zenye upana mkubwa sana. Chanzo kinataja vizidishi vya Schönhage–Strassen vinavyotegemea FFT na aina za Comba kama mbinu kuu za maunzi za kipindi hicho.
Inaripotiwa kuwa injini ya FFT ya pointi 64K iliyojengwa na Wang na wenzake kwenye Stratix-V ilipata takriban kasi mara mbili katika 100 MHz ikilinganishwa na algoriti ileile ya FFT kwenye NVIDIA C2050. Katika muundo wa 90 nm ASIC wa Doröz na wenzake, encryption iliripotiwa kuwa 18,1 ms, decryption 16,1 ms na recryption 3,1 s; na muundo ulitajwa kuwa na chini ya milango milioni 30.
Tathmini ya jumla ya chanzo ni kwamba ingawa miundo hii ilifanikiwa katika vigezo fulani, kadiri ukubwa wa funguo na mahitaji ya nambari kamili pana yalivyoongezeka, matatizo ya scalability, shinikizo la kumbukumbu na uwezo wa kubadilika kwa algoriti yaliongezeka.
Vichapuzi vinavyotegemea NTRU
Katika vichapuzi vya YASHE na LTV vinavyotegemea NTRU, NTT, CRT/iCRT, modulus switching na uboreshaji wa pipeline hujitokeza. Chanzo kinataja katika muundo wa YASHE wa Pöppelmann kwamba kwa \(n=16384\) na takriban parameter ya 512-bit \(q\), jumlisho homomofiki lilikuwa 0,94 ms na zidisho homomofiki 48,67 ms.
Katika kichapuzi cha YASHE chenye viini vingi cha Roy, hesabu ya SIMON-64/128 iliripotiwa kuwa 171,3 s wakati ciphertext 2048 zilichakatwa kwa sambamba, 83,6 ms kwa kila block, na kuongeza kasi kwa 24,5× dhidi ya programu. Katika mfumo wa LTV CPU+FPGA wa Öztürk, tathmini ya block ya homomofiki ya AES iliripotiwa kuwa 442 ms na kuongeza kasi kwa 28,5× na 17× dhidi ya CPU/GPU mtawalia.
Mapitio yanahesabu miongoni mwa vikwazo vya muda mrefu vya njia hii unyeti wa baadhi ya miundo inayotegemea NTRU kwa subfield attack, utegemezi wa skimu na ukomo wa matumizi tena kwa kiwango kikubwa.
Vichapuzi vinavyotegemea RLWE
Katika mapitio, eneo lenye shughuli nyingi zaidi la utafiti wa sasa ni vichapuzi vya BFV, BGV na CKKS vinavyotegemea RLWE. Miundo kama HEPCloud, HEAX, Medha, F1, CraterLake, ARK na Poseidon haishughulikii mzunguko mmoja tu wa multiplier, bali pia uchakataji wa viini vingi, njia za RNS, key switching, uhamishaji wa data, instruction set inayoweza kupangwa na safu za kumbukumbu kwa pamoja.
| Daraja | Utafiti / usanifu | Jukwaa | Skimu | Sifa na kikomo kinachoangaziwa katika chanzo |
|---|---|---|---|---|
| Integer | Wang | FPGA, Stratix-V | GH | Muunganisho wa SSA+FFT; maalumu kwa kuzidisha kwa upana mkubwa na ujumla wake ni mdogo. |
| Integer | Doröz | 90 nm ASIC | GH | Uharakishaji kamili wa maunzi; gharama kubwa ya maunzi. |
| Integer | Moore | FPGA, Virtex-7 | Coron | Muundo mwepesi unaotumia sehemu za DSP kwa ufanisi; utegemezi wa DSP na unyumbufu mdogo. |
| NTRU | Pöppelmann | FPGA, Stratix-V | YASHE | Uharakishaji jumuishi wa YASHE; ubobezi mkubwa wa skimu. |
| NTRU | Roy | FPGA, Virtex-7 | YASHE | Muundo wa moduli unaoweza kusanidiwa upya; mzigo wa ziada wa udhibiti. |
| NTRU | Öztürk | FPGA, Virtex-7 | LTV-SHE | Kichapuzi cha kwanza cha FPGA kwa LTV-SHE; utegemezi wa skimu. |
| NTRU | Cousins / HEPU | FPGA, Virtex-7 | LTV | Uharakishaji wa CRT/iCRT; mzigo wa scheduling. |
| RLWE | Roy / HEPCloud | CPU + FPGA, Virtex-6 | BFV | Uharakishaji wa BFV wa viini vingi; uoanifu mdogo. |
| RLWE | Mert | CPU + FPGA + ASIC | BFV | Uboreshaji mwepesi wa NTT; reconfigurability ndogo. |
| RLWE | Turan / HEAWS | FPGA, Virtex UltraScale+ | BFV | Uharakishaji wa BFV kwenye AWS FPGA; ujumla mdogo. |
| RLWE | Riazi / HEAX | CPU + FPGA + ASIC, Stratix-10 | CKKS | Usambamba wa tabaka nyingi; mzigo mkubwa wa rasilimali za maunzi. |
| RLWE | Roy / Medha | FPGA, Alveo U250 | CKKS | Viini vingi na instruction-level parallelism; inalenga RNS-CKKS. |
| RLWE | Samardzic / F1 | 14/12 nm ASIC | BGV / CKKS | Inaweza kupangwa na ina msaada mpana wa algoriti; eneo kubwa la ASIC. |
| RLWE | Samardzic / CraterLake | 14/12 nm ASIC | BGV / CKKS | Msaada wa Unbounded FHE; ugumu mkubwa wa usanifu. |
| RLWE | Mert / Medha opt. | FPGA + 7 nm ASIC | CKKS | Mbinu ya Microcoded instruction-set; kikomo cha uoanifu. |
| RLWE | Kim / ARK | 7 nm ASIC | BGV / CKKS | Ufanisi mkubwa wa kumbukumbu; mawasiliano/mtiririko wa data wenye ugumu. |
| RLWE | Yang / Poseidon | FPGA, Alveo U280 | CKKS | Msaada kamili wa bootstrapping; ugumu wa udhibiti. |
| RLWE | Bertels | FPGA, ZCU102 | FHEW | Bootstrapping ya FHEW yenye kasi; utegemezi wa hifadhi ya ufunguo wa nje. |
| RLWE | Jiang / MATCHA | ASIC/GPU | TFHE | Mbinu ya FFT isiyotumia zidisho; uoanifu mdogo. |
| RLWE | Van / FPT | FPGA, Alveo U280 | TFHE | FFT ya fixed-point; utegemezi wa ufunguo wa nje. |
| RLWE | Zhang | FPGA, Alveo U280 | CKKS / TFHE | Switching kati ya skimu; imeonyeshwa kama mwelekeo mmoja katika jedwali la chanzo. |
Baadhi ya mifano ya utendaji wa RLWE iliyoangaziwa katika chanzo
- Toleo lililoboreshwa la HEPCloud lenye viini vingi linaripoti kuongeza kasi kwa zaidi ya 13× dhidi ya programu iliyoboreshwa.
- HEAWS hufanya homomorphic multiplication 613 kwa sekunde katika mpangilio uliotolewa na chanzo.
- HEAX linaripoti ongezeko la utendaji la 164–268× katika anuwai pana ya vigezo vya FHE.
- Medha linaripoti latency ya chini kwa 2,4× kwenye Xilinx Alveo U250 ikilinganishwa na vichapuzi vingine vya reconfigurable.
- F1 linaripoti geometric mean ya 5400× dhidi ya utekelezaji wa programu na hadi 17.000× katika hali fulani.
- CraterLake imetolewa katika chanzo kama kuongeza kasi kwa 11,2× dhidi ya F1.
- Poseidon linaripoti kuongeza kasi kwa 10,6× na 8,7× dhidi ya GPU na ASIC mtawalia kwenye benchmark ya FHE iliyotumika.
- Muundo wa Bertels unaolenga FHEW hufanya bootstrapping katika chini ya 20 ms.
- MATCHA linaripoti uboreshaji wa 2,3× katika throughput ya TFHE dhidi ya maktaba ya GPU ya cuHE.
- FPT linaripoti uboreshaji wa throughput wa viwango viwili–vitatu vya ukubwa dhidi ya bootstrapping ya TFHE inayotegemea CPU.
- Maunzi ya CKKS–FHEW switching kwenye Xilinx U280 yanaripoti ongezeko la ufanisi wa switching la 365× dhidi ya msingi wa programu.
Nambari hizi ni kulinganisha kwa tafiti tofauti kwa misingi yao wenyewe. Kwa sababu misingi, vigezo na maunzi ya vipimo vya kuongeza kasi si sawa, hazipaswi kutumiwa kama “orodha ya washindi” ya moja kwa moja.
Vichapuzi vya FHE vinavyolenga programu
Mapitio yanaeleza kwamba utafiti wa maunzi ya FHE unasogea kutoka kuharakisha primitive za jumla za kriptografia pekee kwenda hardware–software co-design katika kiwango cha programu. Makundi matatu makuu ya matumizi yanachunguzwa: edge computing, federated learning na artificial intelligence.
| Eneo | Muundo | Matokeo makuu yaliyotolewa katika chanzo | Kikomo cha tafsiri |
|---|---|---|---|
| Edge | HHEML | >50× kupungua/kuongezeka kwa kasi katika encryption latency ya mteja na takriban 2× kuongezeka kwa hardware throughput. | Mbinu ya HE mseto; hesabu nzito ya homomofiki huhamishwa kwa seva. |
| Edge | Pasta on Edge | 97× kuongeza kasi dhidi ya FHE public-key client accelerators zilizopo. | Katika muktadha wa utekelezaji wa 7 nm na 28 nm ASIC. |
| Edge | Embedded SEAL/CKKS NTT | Takriban 1000× kuongeza kasi dhidi ya programu tupu. | Mzigo wa kazi wa uharakishaji maalumu wa NTT. |
| Federated learning | FedBit | Takriban viwango viwili vya ukubwa vya kuongeza kasi katika encryption na %60,7 kupungua kwa wastani wa communication overhead. | Ufungashaji unaotegemea BFV na ubunifu-shirikishi wa FPGA. |
| Federated learning | Yang na wenzake FL framework | Hadi %71 kupungua katika training encryption time. | Chanzo kinaeleza wazi kwamba Paillier ni partially homomorphic na mfano huu ni marejeo kwa uhandisi wa FHE-FL. |
| AI | CHAM | 1800× katika matrix–vector multiplication, 36× katika logistic regression, 144× katika uzalishaji wa Beaver triple. | Ulinganisho wa FPGA mahsusi kwa mzigo wa kazi. |
| AI | FHE-CGRA | Utendaji wa 8,15× dhidi ya CGRA ya kawaida; ufanisi wa nishati wa 16,48× dhidi ya vichapuzi vya FPGA FHE-CNN. | Katika muktadha wa mtiririko wa data wa CGRA. |
| AI | Cheetah | Hadi 79× kuongeza kasi dhidi ya mbinu za awali kwa HE parameter tuning na operator scheduling. | Muundo jumuishi kwa Private DNN inference. |
| AI | HERACLES | 1074×–5547× katika operesheni za kihisabati za FHE dhidi ya 24-core Intel Xeon W7-3455. | Katika muktadha wa Intel 3 nm, 8192-way SIMD SoC; si mahsusi kwa modeli moja ya neural-network. |
Pete ya polinomu ya arithmetic ya msingi ya FHE
Chanzo kinajadili arithmetic ya msingi ya polinomu ya skimu kuu za kisasa za FHE kupitia miundo hii ya residue-class polynomial ring.
\(\mathbb{Z}_q\) inaonyesha darasa la nambari kamili ambapo coefficients huhesabiwa kwa modulus \(q\); \(x\) ni kigezo cha polinomu; na \(N\) ni ukubwa wa polinomu. Kugawa kwa \(x^N+1\) kunamaanisha kupunguza terms za polinomu za daraja la juu kulingana na uhusiano huu.
Mlinganyo hauna kitengo cha kimaumbile; ni muundo wa kihisabati wa kialjebra. Kwa upande wa maunzi, kuongezeka kwa \(N\) huongeza idadi ya coefficients zinazoshughulikiwa, na kuongezeka kwa \(q\) huathiri upana wa biti wa arithmetic ya coefficients. Kwa hiyo ukubwa wa polinomu na uteuzi wa modulus huathiri moja kwa moja muundo wa multiplier, kumbukumbu na njia ya data.
Kizidishi Kipi cha Polinomu Huchaguliwa kwa FHE na Lini?
Katika mchoro wa maamuzi wa chanzo, NTT/INTT hupewa kipaumbele wakati prime modulus inayofaa na masharti ya transform yanatimizwa; katika miundo ambayo masharti hayo hayafai, Toom–Cook au Karatsuba huzingatiwa kulingana na ukubwa wa polinomu na vikwazo vya maunzi. Mchoro huu si kanuni kamili ya uchaguzi kwa kila hali, bali ni mfumo wa maamuzi ya kihandisi unaotolewa na mapitio kufundisha ulinganifu wa parameter–hardware.
Ugumu wa NTT/INTT na Toom–Cook/Karatsuba
Chanzo kinatoa ugumu wa takriban wa polynomial multiplication inayotegemea NTT/INTT kama ifuatavyo:
Hapa \(N\) ni ukubwa unaohusiana na idadi ya coefficients katika polinomu. Usemi wa Big-O si kitengo cha muda wa kimwili, bali ni kipimo cha asymptotic kinachoonyesha jinsi kiasi cha operesheni kinavyokua kadiri ukubwa wa tatizo unavyoongezeka.
Muundo wa jumla wa ugumu kwa Toom–Cook-k uliotolewa katika chanzo:
\(k\) inaonyesha polinomu imegawanywa katika sehemu ndogo ngapi. Karatsuba ni hali maalumu ya Toom–Cook ya sehemu mbili. Kwa hiyo kwa \(k=2\), exponent huwa \(\log_2 3\). Kielelezo 3 cha chanzo kinaonyesha takriban \(O(N^{1.585})\) kwa Karatsuba, \(O(N^{1.465})\) kwa Toom–3 na \(O(N^{1.404})\) kwa Toom–4.
Exponent ndogo ya asymptotic pekee haimaanishi kwamba maunzi halisi yatakuwa ya haraka zaidi. Gharama ya evaluation/interpolation, idadi ya DSP, trafiki ya kumbukumbu, muundo wa pipeline na kiwango cha usambamba vinaweza kubadilisha latency ya jumla.
Sharti la modulus kwa NTT
Ulinganisho wa TC/Karatsuba katika chanzo unaonyesha kwamba kwa NTT/INTT, kwa matumizi ya vitendo \(N\) inapaswa kuwa nguvu ya mbili na modulus iwe nambari msingi inayotimiza sharti hili:
Sharti hili linahusiana na uteuzi wa modulus inayounga mkono miundo ya roots inayohitajika kwa transform. Kwa upande wa maunzi, NTT hutoa njia ya haraka na inayoweza kusambazwa kwa usambamba ya kuzidisha polinomu; kwa upande mwingine, uteuzi wa modulus, kumbukumbu ya twiddle-factor, vitengo vya butterfly na memory addressing vinaweza kuwa tata zaidi.
Polynomial multiplier inayotegemea NTT/INTT
Number Theoretic Transform (NTT) na inverse NTT (INTT) ni miundo ya msingi ya arithmetic inayobadilisha zidisho la polinomu kuwa operesheni za point-wise multiplication katika domain ya transform. Chanzo kinazitathmini kama baadhi ya hardware primitive muhimu zaidi za skimu zinazotegemea RLWE na NTRU.
Negative Wrapped Convolution (NWC) huzuia urefu wa transform kuongezeka hadi \(2N\) kwa sababu ya zero padding na kuuweka katika \(N\); kwa upande mwingine huleta zidisho za ziada za scaling-factor kabla ya NTT na baada ya INTT.
Kwa muundo wa Pöppelmann, chanzo kinatoa gharama ya polynomial multiplication moja kwa takriban usemi huu:
Kulingana na maelezo ya chanzo, sehemu kubwa ya term ya ziada ya \(5.5n\) hutokana na kupakia coefficients, point-wise multiplication na operesheni za post-scaling. Kwa \(n=512\), 10.014 cycle na 4 BRAM ziliripotiwa; katika ulinganisho wa kawaida wa baadaye, 51,09 µs ilitolewa.
Du na wenzake walipunguza gharama ya polynomial multiplication kutoka:
hadi:
na wakapunguza uhifadhi wa constant-factor kutoka \(4N\) hadi \(2.5N\), wakiripoti %37,5 ya kuokoa ROM. Kwa \(n=512\), 8806 cycle na 26.913 multiplication zinaripotiwa.
| Utafiti | Algoriti | Mseto | Jukwaa | Faida / kikomo kinachoangaziwa |
|---|---|---|---|---|
| Pöppelmann | GS NTT | Hapana | FPGA | Urekebishaji wa parameter kwa nguvu; matumizi ya rasilimali na kikomo cha unyumbufu. |
| Xu | CG NTT | Ndiyo | FPGA | Configurability kubwa na critical path fupi; fixed radix na ugumu wa udhibiti. |
| Roy | CT NTT | Ndiyo | FPGA | Usawazishaji wa area–utendaji; utegemezi mkubwa wa parameter. |
| Du | CT NTT | Ndiyo | FPGA | Uboreshaji wa operesheni na uhifadhi; usambamba wa butterfly ni mdogo. |
| Pöppelmann | CT NTT | Ndiyo | MCU | Storage overhead ndogo na ulinzi wa timing side-channel; scalability ya parameter ni dhaifu. |
| Zhang | CG NTT | Ndiyo | FPGA | Kupunguza post-processing; kumbukumbu kubwa ya twiddle-factor. |
| Zeng | CG NTT | Ndiyo | ASIC | Configurability kubwa na resource use ndogo; ugumu wa udhibiti katika usambamba mkubwa. |
| Chen | CG NTT | Ndiyo | FPGA | Pipeline na udhibiti rahisi; gharama ya resource na scalability. |
| Banerjee | CG NTT | Ndiyo | ASIC | Upinzani wa side-channel na muundo jumuishi; kikomo cha utendaji/resource dhidi ya miundo maalumu. |
| Longa | CG NTT | Ndiyo | MCU | Unyumbufu wa Mixed radix; throughput ndogo na hatari za usalama. |
| Phap | CG NTT | Ndiyo | FPGA | Area efficiency kwa conflict-free memory; kikomo cha uoanifu wa modulus na throughput. |
| Mandal | Winograd NTT | Hapana | FPGA | Modular multiplier chache na latency ndogo; addition nyingi na ugumu wa udhibiti. |
| Ramyavani | CG NTT | Hapana | FPGA | Hardware utilization ndogo; imeboreshwa kwa polinomu ndogo pekee. |
| Bardia | CG NTT | Ndiyo | FPGA | Latency ya chini sana; gharama kubwa ya maunzi sambamba/area. |
| Zhao | CG NTT | Ndiyo | RISC-V | Muunganisho wa karibu na Load-store unit na faida ya uhamishaji wa data; kikomo cha critical path/frequency. |
Katika mfano wa ParallelNTT, chanzo kinataja matumizi ya 128 DSP kwa ML-KEM na 256 DSP kwa ML-DSA, yakitoa maboresho ya 24× na 21× katika forward/inverse transform latency dhidi ya miundo ya FPGA ya awali. Mifano hii si skimu za FHE; inaonyesha matumizi ya usanifu wa maunzi wa NTT katika arithmetic ya pamoja ya lattice-cryptography.
Toom–Cook na Karatsuba
Kinyume na masharti ya modulus na ukubwa wa polinomu kwa NTT, Toom–Cook na Karatsuba zinaweza kutoa unyumbufu mpana zaidi wa parameter. Kulingana na tathmini ya chanzo, unyumbufu huu ni muhimu hasa katika miundo ya resource-constrained au yenye muundo wa modulus usiofaa.
Karatsuba hutumia mgawanyiko wa sehemu mbili, ilhali Toom–Cook-3 au Toom–Cook-4 inaweza kugawa katika sehemu kubwa zaidi na kutoa viwango vichache vya recursion na multiplication count ya asymptotic ya chini. Gharama yake ni kuongezeka kwa ugumu wa evaluation, interpolation, recombination na hatua za memory access zisizo za kawaida katika maunzi.
| Utafiti | Algoriti | Jukwaa | Faida / kikomo kinachoangaziwa |
|---|---|---|---|
| Migliore | Karatsuba-3 | FPGA | Latency ndogo; dynamic reconfiguration na throughput ni ndogo. |
| Zhu | 8-level Iterative Karatsuba | FPGA + ASIC | Usawazishaji wa ugumu/ufanisi; recursion overhead na ukosefu wa side-channel. |
| Wong | 1-level Karatsuba | FPGA | Matumizi mazuri ya DSP katika negacyclic convolution; usambamba mdogo. |
| Wang | TCPM, TC-2/3/4 | FPGA | Configurability kubwa na usambamba; mantiki ya udhibiti ni tata. |
| Karmakar | TC + Karatsuba + Schoolbook | Cortex-M4 | Memory footprint ndogo sana na uwezo wa kubadilika wa algoriti; ugumu mkubwa. |
| Mera | 3-level Karatsuba | AVX | Uboreshaji wa memory na upinzani wa timing-attack; kikomo cha udhibiti/scalability. |
| Kannwischer | TC-4 + multi-level Karatsuba | Cortex-M4 | Kumbukumbu thabiti na utendaji mzuri; kikomo cha scalability na side-channel. |
| Paksoy | TC-4 | Cortex-M4 | Versatility kubwa; kikomo cha scalability na side-channel. |
| Mera | TC-4 | FPGA | Throughput kubwa na memory access efficiency; scalability ndogo. |
| Ghosh | Striding TC-4 | ASIC | Kumbukumbu ndogo na uwezo mzuri wa kubadilika; utendaji sambamba na unyumbufu wa algoriti ni mdogo. |
| Li na kikundi cha kazi | TC-3 | ASIC | Muundo wa moduli unaoweza kupanuka; hardware resource kubwa. |
| Ma | TC-3 | FPGA | Uboreshaji wa latency; kikomo cha frequency na side-channel. |
| Vasanthi | Hybrid Karatsuba | FPGA + ASIC | Uboreshaji wa area na latency; ugumu mkubwa na ukosefu wa side-channel. |
Katika chanzo, kwa muundo wa Migliore na \(n=1024\), operation count ilipunguzwa kutoka 3583 hadi 3071 huku ulinganisho wa FFT ukipewa kama 4158 operation. Katika mazingira yenye embedded multiplier chache, speedup ya hadi %58 imetolewa kwa Karatsuba.
Muundo wa degree-256 Karatsuba wa Zhu ulipunguza idadi ya coefficient multiplication kutoka 65.536 hadi 6521 na kukamilisha multiplication moja katika 81 cycle. Chanzo kinataja takriban 3,16× kuongeza kasi kwa muundo huu.
Muundo wa reconfigurable TCPM wa Wang unaunga mkono TC-2, TC-3 na TC-4 katika usanifu mmoja, hupunguza idadi ya post-processing arithmetic operation kwa angalau %33,33, na unaripoti 2,47×–50,11× kuongeza kasi kwenye Xilinx VC709 kulingana na ulinganisho wa chanzo.
Multiplier ya Saber ya Karmakar kwenye Cortex-M4 inaripoti 65.459–66.692 cycle kwa 256×256 polynomial multiplication. Katika utafiti wa baadaye wa Mera, matrix-vector polynomial multiplication iliboreka kwa %12–37 kwenye majukwaa tofauti, faida ya %29,3–36,6 kwenye AVX2 na kupungua kwa 2,6–5,7 KB katika matumizi ya memory ya Cortex-M4.
Ni muhimu kukumbuka kwamba mifano hii ya Saber haitoki katika FHE bali katika muktadha wa post-quantum key encapsulation. Mapitio yanaitumia kama mifano ya arithmetic ya pamoja kwa muundo wa hardware datapath wa Toom–Cook/Karatsuba.
Kwa nini kizidishi cha moduli cha nambari kamili ni kijenzi tofauti cha msingi?
Polynomial multiplier haizidishi coefficients pekee; coefficients za kati na za mwisho lazima zihifadhiwe chini ya modulus iliyobainishwa. Kwa hiyo integer modular multiplier ni kitengo cha msingi cha maunzi ndani ya polynomial multiplier na pia katika hatua nyingi nyingine za arithmetic za FHE.
| Aina ya kizidishi | Utafiti wa mfano | Muktadha / jukwaa | Uwiano wa kihandisi unaoangaziwa katika chanzo |
|---|---|---|---|
| Barrett | Öztürk | LTV / FPGA | Modular reduction ya jumla na yenye ufanisi; katika upana mkubwa wa biti critical path na resource vinaweza kuongezeka. |
| Barrett | Roy | BFV / FPGA | Muundo resource-efficient wenye uwiano kati ya area na speed. |
| Barrett | Hao | Toom–Cook / ASIC | Area efficiency kubwa. |
| Shoup | Riazi | NTT / CPU+FPGA | Imeboreshwa kwa hali tofauti; instantiation mbili zinaweza kuleta hardware overhead. |
| Shoup | Kim | CKKS / FPGA | Resource na latency ndogo; operand moja lazima iwe constant. |
| Montgomery | Mert | BFV / CPU+FPGA | Modular reduction chache; ubadilishaji wa Montgomery domain huongeza gharama. |
| Montgomery | Li | IP-MMM / FPGA | Data path fupi; imetajwa kuwa inafaa kwa high-performance na IoT ya gharama ndogo. |
| Montgomery | Roy | HRKM + OSBM / FPGA+ASIC | Utendaji wa cycle moja, resource na latency ndogo. |
| Montgomery | Wang | PPMM / FPGA | Cycle count ndogo na operating frequency kubwa. |
| Solinas prime | Cao | FFT/IFFT / FPGA | Reduction hurahisishwa na muundo maalumu wa modulus; umbo la modulus inayoweza kutumika ni finyu. |
| Solinas prime | Zijlstra | NTT/INTT / FPGA | Hardware rahisi inayotegemea shift/add/sub; huhitaji modulus maalumu. |
Kulingana na tathmini ya jumla ya chanzo, Barrett na Montgomery zina matumizi mapana zaidi kwa moduli za jumla na variable–variable multiplication. Mbinu ya Shoup inaweza kuwa na ufanisi kwa variable–constant multiplication, lakini hitaji la operand ya kudumu hupunguza ujumla wake. Miundo ya Solinas na special-prime inaweza kutoa reduction ya haraka sana lakini hupunguza chaguo la modulus inayofaa.
Kwa Nini Bootstrapping ni Muhimu katika Maunzi ya FHE?
Bootstrapping ni muhimu kwa sababu huonyesha upya kelele iliyokusanyika au kikomo cha kina cha hesabu ndani ya ciphertext, na hivyo kuleta leveled FHE karibu kinadharia na kina kisicho na kikomo cha mzunguko; hata hivyo, upande wa BGV/BFV/CKKS, NTT/INTT kubwa, ubadilishaji wa RNS, key switching, rotation na operesheni za modulus, na upande wa FHEW/TFHE, blind rotation, kusasisha accumulator na trafiki kubwa ya bootstrapping-key huifanya kuwa mojawapo ya operesheni nzito zaidi za maunzi.
Tofauti ya kihandisi kati ya leveled FHE na FHE halisi
Leveled FHE inaweza kufanya kazi kwa vigezo vinavyotosha kina fulani kilichowekwa mapema cha hesabu. Kadiri kina cha mzunguko kinavyoongezeka, kelele ya ciphertext na bajeti ya modulus hukaribia kikomo. Bootstrapping “huonyesha upya” ciphertext kwa namna ya homomofiki na kuruhusu hesabu zaidi kuendelea.
Hata hivyo, gharama ya maunzi ya bootstrapping ni kubwa sana. Kwa CKKS/BFV/BGV, high-throughput NTT/INTT pipeline, conflict-free multi-bank memory, mtiririko wa rotation/key-switching, hifadhi kubwa ya evaluation-key na katika baadhi ya hali kuzalisha upya ufunguo inapohitajika huwa muhimu.
Kwa upande wa FHEW/TFHE, blind rotation, homomorphic accumulator, polynomial–vector/matrix multiplication na bootstrapping key bandwidth huwa muhimu. Kwa hiyo, haitegemewi kwamba usanifu uleule wa bootstrapping accelerator utumike moja kwa moja kwa CKKS na TFHE kwa namna ileile.
Mbinu na Matokeo ya Utafiti
Mbinu ya mapitio
Makala inafafanua mbinu yake kama narrative review. Waandishi walifanya utafutaji wa fasihi unaolenga maunzi.
| Kipengele | Taarifa iliyoripotiwa katika chanzo |
|---|---|
| Kipindi cha muda | 2009–2026; mkazo maalumu umewekwa kwenye tafiti mpya baada ya 2020. |
| Hifadhidata | IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar, IACR ePrint. |
| Maneno makuu ya utafutaji | fully homomorphic encryption, FHE hardware implementation, FHE accelerator, FPGA/ASIC accelerator, polynomial multiplier, NTT/INTT, Toom–Cook, Karatsuba, modular multiplier. |
| Screening | Duplicate records ziliondolewa; uchujaji ulifanywa kwa title, abstract na full text. |
| Aina kuu za tafiti zilizojumuishwa | Tafiti zinazohusiana moja kwa moja na FHE scheme, hardware accelerator architecture, polynomial multiplication na integer modular multiplication. |
| Kuondoa | Tafiti zinazolenga software library pekee, tafiti za application-level zisizo na hardware implementation na cryptographic hardware zisizohusiana. |
| Mpangilio | FHE scheme evolution, accelerator type, core arithmetic component na implementation platform. |
Vipengele ambavyo havikuripotiwa katika mbinu
- Idadi ya jumla ya records zilizopatikana mwanzoni haikutolewa.
- Haikuripotiwa records ngapi zilibaki baada ya duplicate kuondolewa.
- Haikuelezwa tafiti ngapi ziliondolewa katika hatua za title/abstract na full-text.
- Idadi ya mwisho ya tafiti zilizojumuishwa haikutolewa kama nambari moja ya jumla katika sehemu ya mbinu.
- Hakuna mchoro wa mtiririko wa PRISMA.
- Taarifa ya review protocol iliyosajiliwa mapema haikuripotiwa.
- Hakuna mfumo rasmi wa risk-of-bias au upimaji wa ubora ulioripotiwa kwa tafiti chanzo.
- Meta-analysis haikufanywa.
Kwa hiyo, ingawa utafiti unatoa mapitio mapana na yaliyopangwa ya fasihi, matokeo yake hayapaswi kutafsiriwa kama matokeo ya meta-analysis ya kiasi.
Matatizo matatu makuu ya sasa yaliyobainishwa na mapitio
- Bloku maalumu za maunzi zilizotawanyika: Kutumia vichapuzi tofauti kwa primitive tofauti kama NTT/INTT, modular arithmetic, modulus raising/reduction na rescaling kunaweza kusababisha kurudiwa kwa processing units za pamoja na kupungua kwa hardware utilization.
- Ubobezi uliopitiliza kwa skimu: Vichapuzi vingi huboreshwa kwa familia fulani tu ya BFV, CKKS, TFHE au FHE nyingine; fixed datapath hupunguza uoanifu na vigezo au algoriti nyingine.
- Kutolingana kikamilifu na mahitaji ya programu: Mizigo ya kazi kama neural-network training, multi-party secure computation na federated learning ina mahitaji tofauti ya latency, depth, precision, memory, communication na power ikilinganishwa na FHE accelerator ya jumla.
Mwelekeo wa baadaye 1 — Accelerator inayoweza kusanidiwa upya na kushirikiwa
Waandishi wanapendekeza kwamba maunzi ya baadaye yaelekee kwenye reconfigurable architecture ya tabaka badala ya viini operator-specific. Katika tabaka la chini, vitengo vya pamoja kama modular arithmetic, butterfly array, NTT/INTT, point-wise multiplier, RNS channel na on-chip memory bank vinaweza kushirikiwa na skimu tofauti.
Katika tabaka la kati, lengo ni programmable modulus-reduction mode, flexible radix, microcoded instruction scheduling na msaada wa \(N\), \(q\), RNS base na decomposition base unaoweza kuwekewa parameter.
Katika tabaka la juu, inapendekezwa kwamba mitiririko mahsusi kwa skimu kama BFV base extension/scaling, CKKS rescaling/approximate modulus conversion na TFHE accumulator update ihifadhiwe kama microprogram au functional extension maalumu.
Mwelekeo wa baadaye 2 — Accelerator inayolenga Bootstrapping
Mapitio yanaona mpito kutoka vichapuzi vilivyoboreshwa kwa operesheni za finite-depth kwenda bootstrapping accelerators zinazounga mkono unbounded-depth computation kwa moja kwa moja zaidi kuwa mwelekeo muhimu wa utafiti.
Katika skimu za leveled, large-parameter NTT/INTT, RNS base conversion, key switching, slot rotation na rescaling; katika skimu bit-bootstrappable, blind rotation, accumulator na key bandwidth huunda maeneo tofauti ya kuzingatia kwa maunzi. Chanzo kinasisitiza kwamba baadhi ya vitengo vinaweza kushirikiwa lakini baadhi ya taratibu zinapaswa kubaki mahsusi kwa skimu.
Mwelekeo wa baadaye 3 — Hardware–software co-design inayotegemea programu
Waandishi wanaeleza kwamba muundo wa accelerator wa siku zijazo unapaswa kufanywa si kwa primitive ya kriptografia pekee bali pia kulingana na application workload inayolengwa.
Kwa encrypted neural-network inference, SIMD packing, rotation, key switching, matrix-vector multiplication, convolution, nonlinear approximation na, inapohitajika, bootstrapping vinapaswa kuboreshwa kwa pamoja.
Katika federated learning tatizo ni pana zaidi kuliko encryption/decryption: secure aggregation, ciphertext packing, communication compression, homomorphic matrix–vector computation na cross-institution feature interaction vinapaswa kutathminiwa ndani ya pipeline moja.
Kwa upande wa Edge na IoT, low area, low power, storage footprint ndogo, compact parameter set, lightweight modular arithmetic na edge–cloud task partitioning huwa vipaumbele.
Matokeo yanayoungwa mkono na utafiti
- Katika gharama ya vitendo ya maunzi ya FHE, polynomial multiplication na modular multiplication zina jukumu la msingi.
- Katika BFV na CKKS, RNS na arithmetic ya polinomu kubwa ni miongoni mwa mada kuu za usambamba wa maunzi.
- FHEW/TFHE huhitaji accelerator datapath tofauti kwa sababu ya miundo tofauti ya ciphertext na bootstrapping.
- Utafiti wa accelerator unaotegemea RLWE umehamia katika miaka ya karibuni kuelekea scheme-level na system-level co-design.
- NTT/INTT ni chaguo lenye nguvu sana kwa polynomial multiplication lakini lina mahitaji ya modulus na twiddle-factor/memory.
- Toom–Cook/Karatsuba ni mbadala muhimu katika masharti yanayonyumbulika zaidi ya modulus/polynomial na mazingira yanayofaa ya resource.
- Kuna trade-off ya msingi kati ya efficiency na modulus/operand flexibility miongoni mwa vizidishi vya Barrett, Montgomery, Shoup na Solinas.
- Msaada wa Bootstrapping ni mojawapo ya malengo makuu ya muundo wa FHE accelerators za siku zijazo.
- Application-specific hardware–software co-design inaonyesha mwelekeo kutoka uharakishaji wa primitive za jumla kwenda uboreshaji wa mfumo kwa ujumla.
Matokeo ambayo utafiti hauungi mkono
- Mapitio hayaonyeshi kwamba FHE accelerator moja ni bora kwa kila hali kuliko zote nyingine.
- Kwa sababu viwango vya speedup katika makala tofauti havikupimwa kwenye mfumo mmoja wa pamoja wa majaribio, haviwezi kupangwa moja kwa moja kwenye kipimo kimoja.
- Mapitio hayatengenezi prototipu mpya ya FPGA au ASIC.
- Mapitio hayaundi seti yake ya benchmark ya energy, latency au area.
- Haiwezi kuhitimishwa kwamba FHE hutatua kiotomatiki matatizo yote ya usalama wa mfumo; lengo kuu la mapitio haya ni hardware performance.
- Haiwezi kuhitimishwa kwamba ML-KEM, ML-DSA, Saber au NTRU Prime ni skimu za FHE; chanzo huzitumia kama mifano ya arithmetic hardware ya pamoja.
- Paillier si fully homomorphic; chanzo huitenganisha wazi kama mfano wa marejeo kwa federated-learning hardware engineering.
- Haiwezi kuhitimishwa kwamba NTT au Karatsuba ndiyo polynomial multiplier pekee sahihi kwa kila programu.
Vikwazo vya uzalishwaji upya wa mapitio
Chanzo kinaripoti hifadhidata za kitaaluma zilizotafutwa, kipindi cha muda, maneno muhimu na njia ya inclusion/exclusion. Hii hutoa mfumo wa utafutaji unaofuatilika zaidi kuliko muhtasari wa kawaida wa narrative wa fasihi.
Hata hivyo, umbo kamili la Boolean la mistari ya utafutaji kwa kila hifadhidata, tarehe sahihi za utafutaji, idadi ya records, idadi ya duplicate, mgawanyo wa exclusion reason na formal quality assessment havipo. Kwa hiyo systematic-review metadata yote inayohitajika ili mtafiti mwingine ajenge upya kikamilifu mkusanyiko uleule wa makala haipatikani.
Zaidi ya hayo, matokeo ya utendaji yaliyotolewa katika mapitio si data iliyofanyiwa benchmark upya na waandishi wenyewe; ni matokeo yaliyoripotiwa katika makala asilia. Kwa sababu mchakato wa maunzi, familia ya FPGA, clock frequency, vigezo vya FHE, security level, software baseline na workload hutofautiana, majedwali ya kulinganisha yanapaswa kutumiwa zaidi kuelewa mielekeo ya usanifu.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: A Brief Survey on Hardware Implementation of Fully Homomorphic Encryption
Waandishi: Yang Su; Kaixuan Zhou; Weidong Zhong; Jianfei Wang; Jia Hou; Chen Yang.
Mpangilio wa waandishi: Yang Su ni mwandishi wa kwanza, Kaixuan Zhou wa pili, Weidong Zhong wa tatu, Jianfei Wang wa nne, Jia Hou wa tano, na Chen Yang wa sita.
Mwandishi wa mawasiliano: Weidong Zhong.
Taasisi 1: School of Cryptography Engineering, Engineering University of People’s Armed Police, Xi’an 710086, China.
Taasisi 2: School of Microelectronics, Xi’an Jiaotong University, Xi’an 710049, China.
Mchango sawa: Hakuna alama ya uandishi wa kwanza wa pamoja au mchango sawa katika chanzo.
Jarida: Cryptography.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / toleo / makala: 10(4), 49.
Idadi ya kurasa: 34.
DOI: 10.3390/cryptography10040049.
Tarehe ya kuwasilishwa: 3 Juni 2026.
Tarehe ya marekebisho: 4 Julai 2026.
Tarehe ya kukubaliwa: 8 Julai 2026.
Tarehe ya kuchapishwa: 13 Julai 2026.
Aina ya makala: Review; chanzo kinafafanua mbinu yake kama narrative review.
Mapitio ya rika: Nyenzo rasmi za MDPI kwa Cryptography zinaonyesha single-blind peer review.
Hali ya preprint: Hati iliyochakatwa ni toleo la jarida lililochapishwa; preprint haikutumiwa katika maudhui haya ya Verianla.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Kiungo rasmi cha uchapishaji: Rekodi ya makala ya MDPI Cryptography kupitia DOI 10.3390/cryptography10040049.
Wahariri wa kitaaluma: Ki-Hyun Jung na Luis Javier García Villalba.
Maneno muhimu: fully homomorphic encryption (FHE); hardware implementation; accelerator; polynomial multiplier; modular multiplier.
Kipindi cha mapitio: 2009–2026; mkazo maalumu umewekwa kwenye fasihi baada ya 2020.
Vyanzo vilivyotafutwa: IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar na IACR ePrint.
Mtazamo wa inclusion: FHE schemes, hardware accelerator architecture, polynomial multiplication na integer modular multiplication.
Mtazamo wa exclusion: Tafiti za software library pekee, tafiti za application-level zisizo na hardware implementation na cryptographic hardware zisizohusiana.
Data mpya ya majaribio: Hakuna. Chanzo kinaeleza wazi kwamba hakikuunda wala kuchanganua data mpya; matokeo yametokana na fasihi iliyochapishwa na modeli za kinadharia zilizo wazi kwa umma.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna mgongano wa maslahi.
Upatikanaji wa data: Kwa kuwa data mpya haikuundwa, data sharing haitumiki kwa mapitio haya.
Michango ya waandishi: Kulingana na rekodi rasmi ya MDPI, conceptualization ilifanywa na Yang Su na Kaixuan Zhou; mbinu na Yang Su na Kaixuan Zhou; supervision na resources na Weidong Zhong; formal analysis, visualization na investigation na Jianfei Wang pamoja na Jia Hou; review/editing na project administration na Chen Yang. Inaelezwa kuwa waandishi wote walisoma na kukubali toleo lililochapishwa.
Kamati ya maadili / utafiti wa binadamu-wanyama: Utafiti ni mapitio ya fasihi ambayo hayaundi data asilia ya binadamu au wanyama; hakuna human/animal experimental protocol tofauti iliyoripotiwa katika chanzo.
Vielelezo vya chanzo: Kielelezo 1 kinaonyesha FHE cloud privacy model, Kielelezo 2 hardware accelerator classification framework, na Kielelezo 3 uamuzi wa FHE parameter/polynomial multiplier selection. Katika Verianla, vyote vitatu vimejengwa upya kama inline SVG huru kutokana na mahusiano ya chanzo.
Majedwali ya chanzo: Jedwali 1 linalinganisha sifa za BFV/CKKS/FHEW-TFHE; Jedwali 2 FHE accelerators zote; Jedwali 3 NTT/INTT polynomial multipliers; Jedwali 4 Karatsuba/Toom–Cook polynomial multipliers; na Jedwali 5 integer modular multipliers.
Kikomo kikuu cha kimethodolojia: Utafiti ni narrative review. Ingawa hifadhidata, kipindi cha muda na mantiki ya screening zimeripotiwa, mtiririko wa PRISMA, idadi ya jumla ya records/tafiti zilizojumuishwa, protocol iliyosajiliwa, formal quality assessment na meta-analysis hazijaripotiwa.
Kikomo cha kulinganisha: Thamani za speedup, latency, throughput, area na energy zilizotolewa katika mapitio zinatoka katika tafiti asilia tofauti. Kwa sababu hardware technology, FPGA/ASIC/CPU, clock frequency, security parameter, polynomial degree, modulus, workload na software baseline hutofautiana, thamani hazipaswi kupangwa moja kwa moja kana kwamba ni matokeo ya benchmark moja ya pamoja.
Maelezo ya upeo: Mapitio yanatumia baadhi ya tafiti za kriptografia ya post-quantum ambazo si FHE kama mifano ya polynomial multiplier au modular arithmetic hardware design. Haijahitimishwa kwamba mifano hii ni skimu za FHE.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *