


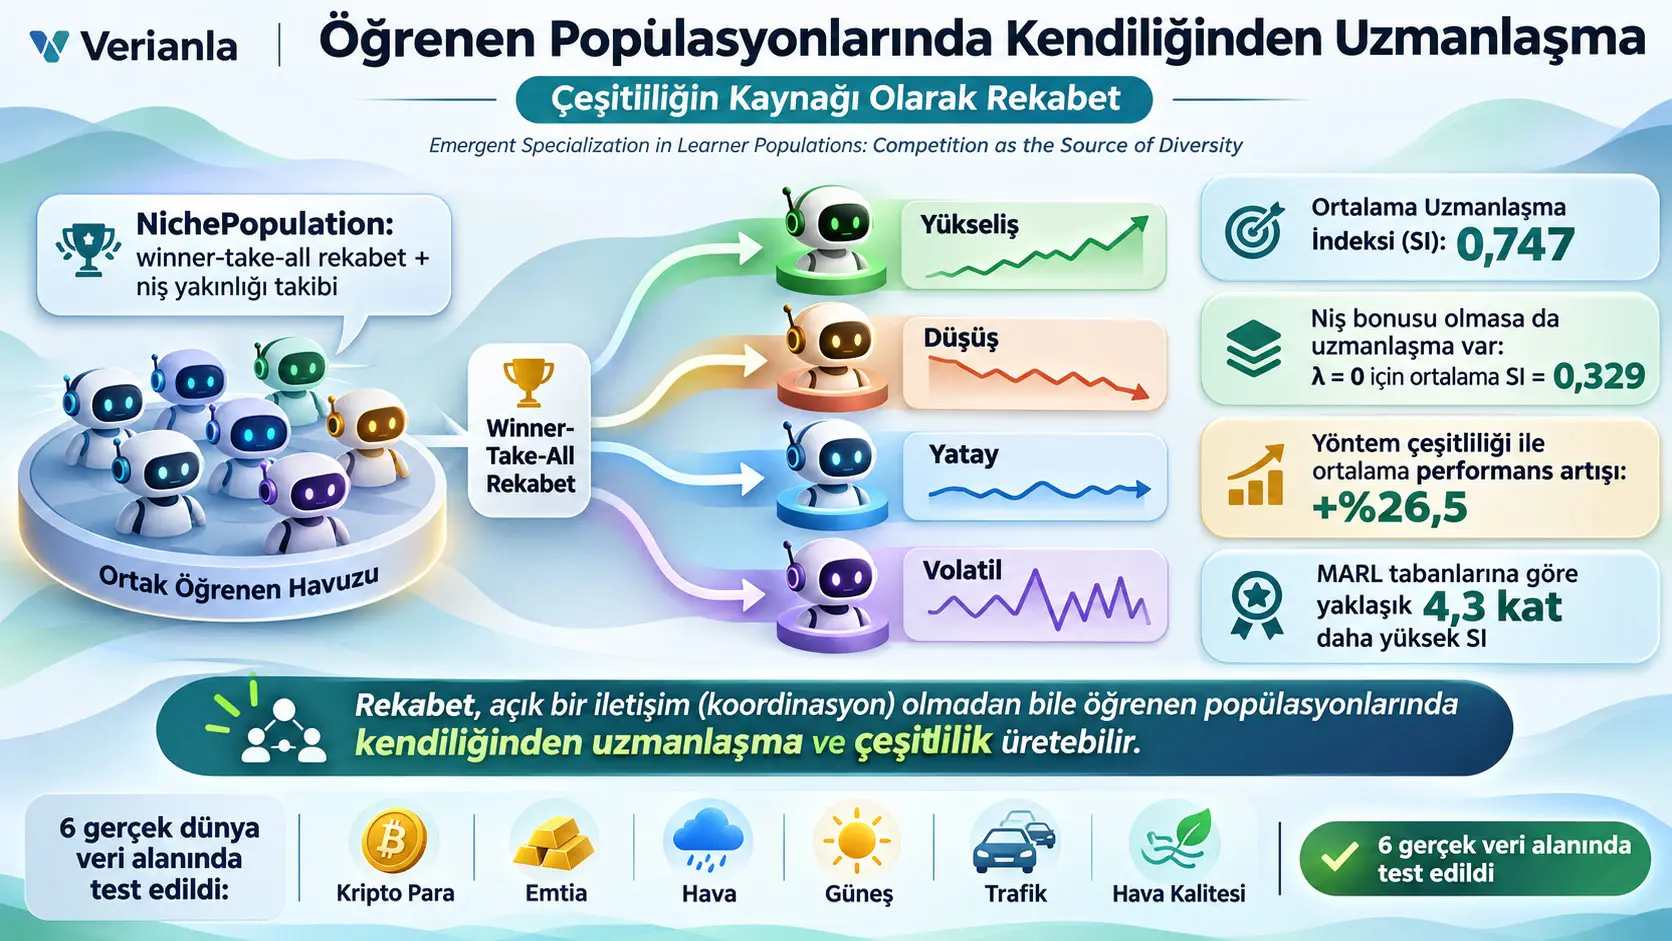
Birden fazla öğrenen model aynı ortamda çalıştığında, hepsinin aynı çözüm yöntemine yönelmesi yerine farklı koşullarda uzmanlaşması mümkün müdür? Daha önemlisi, bu iş bölümü öğrenenler birbirleriyle iletişim kurmadan ve sisteme özel bir “çeşitlilik ödülü” eklenmeden kendiliğinden ortaya çıkabilir mi? NichePopulation adlı yöntem bu soruyu, ekolojik niş kuramındaki rekabetçi dışlama fikrini makine öğrenmesine uyarlayarak incelemektedir.
Çalışmanın temel yaklaşımında sekiz öğrenenden oluşan bir popülasyon, farklı çevresel rejimlerle karşılaşmaktadır. Her öğrenen beş tahmin yönteminden birini seçer. Aynı turda bütün öğrenenler performans gösterse de yalnız en yüksek ayarlanmış ödülü elde eden öğrenen güncellenir. Bu winner-take-all yani “kazanan her şeyi alır” yapısı, aynı davranışı sürdüren öğrenenleri doğrudan rekabete sokar. Yazarın hipotezi, bu rekabetin daha az kalabalık davranış nişlerine yönelmeyi avantajlı hale getirerek zaman içinde uzmanlaşmaya yol açmasıdır.
Yöntem kripto para, emtia fiyatları, hava tahmini, güneş ışınımı, kent içi trafik ve hava kalitesi olmak üzere altı gerçek veri alanında değerlendirilmiştir. Ana Tablo 2'ye göre NichePopulation'ın ortalama Uzmanlaşma İndeksi (Specialization Index, SI) 0,747'dir. Alan bazında SI değerleri 0,573 ile 0,826 arasında değişmiştir. Homojen karşılaştırma grubundaki SI yaklaşık 0,002, rastgele karşılaştırmadaki ortalama SI ise 0,127'dir.
Çalışmanın en önemli ablation deneyinde, uzmanlaşmayı doğrudan teşvik eden isteğe bağlı niş bonusu tamamen kapatılmıştır: λ = 0. Bu durumda ortalama SI 0,329 olarak bulunmuştur. Bu değer rastgele tabanın 0,127 değerinin belirgin biçimde üzerindedir. Dolayısıyla deneyler, incelenen winner-take-all düzeninde rekabetin tek başına ölçülebilir uzmanlaşma oluşturabildiğini desteklemektedir. Bununla birlikte λ = 0,3 kullanıldığında ortalama SI 0,747'ye yükselmiştir; yani bonus uzmanlaşmanın büyüklüğünü önemli ölçüde artırmıştır.
Öğrenenlerin yalnız çevresel rejimlerde değil, kullandıkları tahmin yöntemlerinde de ayrıştığı raporlanmıştır. Popülasyonlar ortalama olarak mevcut yöntemlerin %87'sini kullanmış ve homojen tek-yöntem tabanına göre normalize edilmiş performansta ortalama %26,5 artış göstermiştir. Kripto para alanında raporlanan artış %41,6, emtiada %37,2, hava tahmininde %28,6, trafikte %23,8, güneş ışınımında %17,6 ve hava kalitesinde %9,9'dur.
QMIX, MAPPO ve IQL ile yapılan MARL karşılaştırması yalnız dört alanı —kripto para, emtia, hava ve güneş ışınımı— kapsamaktadır. Yazar NichePopulation'ın bu karşılaştırmada yaklaşık 4,3 kat daha yüksek SI sağladığını, 500 iterasyonluk eğitimde yaklaşık 0,9 saniyeye karşı 3,7 saniyeyle yaklaşık dört kat daha hızlı olduğunu ve yaklaşık 1 MB'a karşı 384–512 MB bellek kullandığını bildirmektedir. MARL yöntemleri için ek hiperparametre optimizasyonu yapılmadığından bu sonuç, yöntemlerin tüm olası yapılandırmalarına karşı kesin üstünlük olarak değerlendirilmemelidir.
Araştırma, rekabetin her ortamda otomatik olarak çeşitlilik yaratacağını göstermemektedir. Yöntemin çalışması için çevrede birden fazla anlamlı rejimin bulunması, farklı yöntemlerin farklı rejimlerde avantajlı olması ve öğrenenlerin gerçekten sınırlı ödül için rekabet etmesi gerekmektedir. Rejimler ve her alandaki tahmin yöntemleri araştırmacı tarafından önceden tanımlanmıştır; algoritma bu rejimleri kendisi keşfetmemektedir.
Türkiye açısından yöntem; farklı piyasa koşullarına uyum sağlayan model toplulukları, üretim tesislerindeki farklı çalışma rejimlerine uzmanlaşan kestirimci bakım modelleri, enerji talebi veya güneş üretimi tahmin sistemleri ve çevresel sensör ağları gibi alanlarda araştırılabilir. Ancak çalışmadaki sonuçlar Türkiye verisi üzerinde doğrulanmamış ve gerçek operasyonel sistemlere yönelik bir saha deneyi yapılmamıştır. Bu nedenle yerel uygulama için rejim tanımı, yöntem envanteri, ödül yapısı ve rekabet mekanizmasının ayrıca doğrulanması gerekir.
Öğrenen Popülasyonlarında Uzmanlaşma Ne Demektir?
Bu çalışmada öğrenen (learner), belirli bir çevresel durumda bir tahmin yöntemi seçen, sonucuna göre ödül alan ve geçmiş deneyimlerinden hangi yöntemin hangi koşullarda daha etkili olduğunu öğrenmeye çalışan hesaplamalı bir birimdir. Popülasyon ise aynı genel yeteneklere sahip birden fazla öğrenenin aynı ortamda faaliyet göstermesidir.
Uzmanlaşma, bir öğrenenin bütün çevresel koşullara eşit biçimde yönelmek yerine belirli rejimlerde daha yüksek tercih veya yetkinlik geliştirmesidir. Örneğin finansal bir ortamda bir öğrenen yükseliş piyasasında, başka biri düşüş piyasasında, bir diğeri yatay piyasada başarılı yöntemlere yönelmeye başlayabilir.
Çalışmanın ekolojik benzetmesi niş (niche) kavramına dayanır. Ekolojide aynı sınırlı kaynağı aynı biçimde kullanan organizmalar doğrudan rekabete girer. Farklı kaynaklara veya koşullara yönelmek bu rekabeti azaltabilir. NichePopulation, benzer bir mekanizmanın yapay öğrenen popülasyonlarında ortaya çıkıp çıkmadığını araştırmaktadır.
Rejim nedir?
Rejim (regime), verinin veya çevrenin niteliksel olarak farklı davranış gösterdiği durum sınıfıdır. Rejim kavramı alanlara göre değişir.
- Kripto para alanında: yükseliş, düşüş, yatay ve volatil dönemler.
- Emtia alanında: yükselen, düşen, kararlı ve volatil dönemler.
- Hava tahmininde: açık, bulutlu, yağışlı ve aşırı hava koşulları.
- Güneş ışınımında: yüksek, orta, düşük ve gece.
- Trafikte: sabah yoğunluğu, akşam yoğunluğu, öğle, gece, hafta sonu ve geçiş.
- Hava kalitesinde: iyi, orta, hassas gruplar için sağlıksız ve sağlıksız.
Burada kritik bir yöntem sınırı vardır: Bu rejimler algoritma tarafından denetimsiz biçimde keşfedilmemiştir. Çalışmada alan bilgisine dayalı olarak önceden tanımlanmışlardır. Yazar da bunu sınırlılıklar arasında açıkça belirtmektedir.
Rejim–yöntem yakınlığı nedir?
Kaynak, belirli bir yöntemin belirli bir rejimde beklenen başarısını:
\[ A(r,m)\in[0,1] \]
ile gösterir.
Burada \(r\) çevresel rejimi, \(m\) tahmin yöntemini temsil eder. Her rejimde en iyi yöntemin değeri 1 olacak biçimde performans ölçeklenir:
\[ \max_m A(r,m)=1 \]
Temel fikir, tek bir yöntemin bütün rejimlerde en iyi olmamasıdır. Eğer bir yöntem bütün koşullarda mutlak biçimde üstün olsaydı öğrenenlerin farklı yöntemlere uzmanlaşması için performans açısından bir neden kalmazdı.
Kripto para alanındaki örnek yöntem yakınlıkları
| Yöntem | Yükseliş | Düşüş | Yatay | Volatil |
|---|---|---|---|---|
| Naive | 0,50 | 0,30 | 0,60 | 0,40 |
| Momentum-Short | 0,80 | 0,70 | 0,40 | 0,60 |
| Momentum-Long | 0,90 | 0,80 | 0,30 | 0,50 |
| Mean-Revert | 0,30 | 0,40 | 0,90 | 0,70 |
| Trend | 0,85 | 0,75 | 0,35 | 0,50 |
Bu örnekte Momentum-Long yükseliş ve düşüş rejimlerinde güçlü iken Mean-Revert yatay ve volatil rejimlerde daha avantajlıdır. Dolayısıyla öğrenenlerin farklı yöntemlerde uzmanlaşmasını mümkün kılan temel heterojenlik önceden mevcuttur.
Uzmanlaşma İndeksi (SI) Nasıl Hesaplanıyor?
Çalışmanın temel ölçütü Specialization Index (SI) adlı, Shannon entropisine dayalı normalize edilmiş uzmanlaşma indeksidir.
Her öğrenen çevresel rejimler üzerinde bir olasılık dağılımı tutar:
\[ \alpha=(\alpha_1,\alpha_2,\ldots,\alpha_R) \]
Burada bütün değerler sıfır veya pozitiftir ve toplamları 1'dir:
\[ \sum_{r=1}^{R}\alpha_r=1 \]
Bu vektör, öğrenenin hangi rejimlere ne ölçüde yöneldiğini temsil eder.
Shannon entropisi
Rejim yakınlığı dağılımının ne kadar dağınık olduğunu ölçmek için:
\[ H(\alpha)=-\sum_r\alpha_r\log\alpha_r \]
kullanılır.
Eğer bütün rejimler eşit ağırlığa sahipse dağılımın entropisi yüksektir. Öğrenen bütün olasılığı tek bir rejimde topladıkça entropi düşer.
Uzmanlaşma indeksi:
\[ SI(\alpha)=1-\frac{H(\alpha)}{\log R} \]
olarak tanımlanmıştır.
- SI = 0: Öğrenen bütün rejimlere eşit yönelmiştir; tam genelci durum.
- SI = 1: Bütün yakınlık tek rejimde toplanmıştır; matematiksel anlamda tam uzman.
- 0 < SI < 1: Kısmi uzmanlaşma.
Örnek: α = (0,82; 0,06; 0,06; 0,06)
Kaynak Ek B'de dört rejimli bir öğrenen için:
\[ \alpha=(0.82,0.06,0.06,0.06) \]
örneği verilmektedir.
Entropi:
\[ H(\alpha)= -0.82\log(0.82) -3(0.06\log(0.06)) \]
olarak hesaplanır ve kaynak yaklaşık:
\[ H(\alpha)=0.668 \]
nat verir.
Dört rejim için maksimum entropi:
\[ \log 4=1.386 \]
olduğundan:
\[ SI=1-\frac{0.668}{1.386} \]
\[ SI\approx0.518 \]
elde edilir.
Buradaki %51,8 ifadesi bir tahmin doğruluğu değildir. Yalnız öğrenenin rejim yakınlığı dağılımının uniform dağılımdan ne ölçüde uzaklaştığını gösteren normalize edilmiş uzmanlaşma ölçüsüdür.
NichePopulation Algoritması Nasıl Çalışıyor?
NichePopulation, her öğrenenin hangi yöntemin hangi rejimde başarılı olduğuna ilişkin inançlar tutmasını, Thompson Sampling ile yöntem seçmesini ve her turda yalnız en yüksek ayarlanmış ödülü alan öğrenenin güncellenmesini birleştirir.
1. Yöntem inançları: Beta dağılımları
Her öğrenen her rejim–yöntem çifti için Beta dağılımı parametreleri tutar:
\[ \beta^{+}_{i,r,m},\quad \beta^{-}_{i,r,m} \]
Başlangıçta bütün çiftler:
\[ Beta(1,1) \]
olarak başlatılır.
Beta(1,1), 0 ile 1 arasında uniform dağılımdır. Öğrenenin başlangıçta hangi yöntemin daha iyi olduğuna ilişkin tercihinin olmadığını temsil eder.
2. Thompson Sampling ile yöntem seçimi
Bir rejim \(r_t\) ortaya çıktığında her yöntem için Beta dağılımından rastgele bir başarı örneği çekilir:
\[ \tilde{\theta}_m \sim Beta( \beta^{+}_{i,r_t,m}, \beta^{-}_{i,r_t,m} ) \]
Öğrenen, örneklenen değerlerin en büyüğüne sahip yöntemi seçer:
\[ m_i= \operatorname*{argmax}_{m\in M} \tilde{\theta}_m \]
Thompson Sampling, keşif ve kullanma arasındaki dengeyi sağlayan olasılıksal bir seçim yöntemidir. Yeterince denenmemiş yöntemlerin belirsizliği yüksek olduğundan zaman zaman seçilme şansları bulunur; iyi performans gösterdiği öğrenilmiş yöntemler ise daha sık seçilir.
3. Ana algoritmadaki niş bonusu
Ana yöntem bölümündeki Algorithm 1, ayarlanmış ödülü:
\[ \tilde{R}_i = R_i \left( 1+ \lambda \mathbf{1}[r_i^{*}=r_t] \alpha_{i,r_t} \right) \]
olarak tanımlar.
Burada:
- \(R_i\): Öğrenenin ham ödülüdür.
- \(\lambda\): Niş bonusu katsayısıdır.
- \(r_i^{*}\): Öğrenenin en yüksek yakınlığa sahip birincil rejimidir.
- \(\mathbf{1}[r_i^{*}=r_t]\): Mevcut rejim öğrenenin birincil nişiyse 1, değilse 0'dır.
- \(\alpha_{i,r_t}\): Öğrenenin mevcut rejime olan niş yakınlığıdır.
\(\lambda=0\) olduğunda:
\[ \tilde{R}_i=R_i \]
olur. Yani özel bir niş bonusu tamamen ortadan kalkar; ancak öğrenenler hâlâ aynı turdaki sınırlı kazanan konumu için rekabet eder.
Kaynak içi yöntem notu: Ek B'deki öğretici anlatım bonusu bunun yerine:
\[ B_i=\lambda(\alpha_{i,r_t}-1/R) \]
ve:
\[ S_i=R_i+B_i \]
şeklinde toplamsal olarak gösterir. Bu formül ana Algorithm 1'deki çarpanlı formülle aynı değildir. Bu nedenle Verianla anlatımında ana yöntem formülü esas alınmaktadır.
4. Winner-take-all rekabeti
Kazanan:
\[ i^{*}= \operatorname*{argmax}_{i} \tilde{R}_i \]
ile seçilir.
Aynı turda başka öğrenenler de iyi sonuç üretmiş olabilir; ancak yalnız en yüksek ayarlanmış ödülü elde eden öğrenen pozitif öğrenme güncellemesi alır.
Bu mekanizma çalışmanın merkezindedir. İki öğrenen aynı rejimde aynı yöntemlere yönelirse doğrudan rekabet ederler. Yalnız biri güncellenebildiğinden erken dönemde oluşan küçük başarı farklılıkları zaman içinde büyüyebilir.
5. Kazananın yöntem inancı nasıl güncelleniyor?
Ana Algorithm 1'de kazananın pozitif Beta parametresi:
\[ \beta^{+}_{i^{*},r_t,m_{i^{*}}} \leftarrow \beta^{+}_{i^{*},r_t,m_{i^{*}}} + \tilde{R}_{i^{*}} \]
şeklinde güncellenir.
Makaledeki algoritma gösteriminde \(\beta^{-}\) parametresi için karşılık gelen ayrı bir negatif güncelleme adımı verilmemiştir. Bu nedenle kaynakta bulunmayan bir güncelleme kuralı eklenmemiştir.
6. Niş yakınlığı nasıl değişiyor?
Kazanan öğrenenin mevcut rejime olan yakınlığı:
\[ \alpha_{i^{*},r_t} \leftarrow \alpha_{i^{*},r_t} + \eta(1-\alpha_{i^{*},r_t}) \]
ile artırılır.
\(\eta\), öğrenme hızıdır. Çalışmanın varsayılan değeri:
\[ \eta=0.1 \]
olarak verilmiştir.
Daha sonra afinite vektörü toplamı tekrar 1 olacak şekilde normalize edilir.
Kaynak içi yöntem notu: Ek B'deki tek iterasyon örneğinde diğer rejimlerin yakınlıkları ayrıca azaltılarak \((0.333,0.222,0.222,0.222)\) sonucuna ulaşılmaktadır. Bu işlem ana Algorithm 1'de açıkça tanımlanan yalnız artırma + normalize etme kuralıyla birebir aynı değildir. Dolayısıyla Ek B'deki sayısal iz, ana algoritmanın kesin matematiksel yeniden hesaplaması olarak kullanılmamalıdır.
Yöntem Uzmanlaşması Nasıl Ölçülüyor?
Çalışma yalnız hangi rejimin tercih edildiğine değil, öğrenenin hangi tahmin yöntemlerini kullandığına da bakmaktadır.
Bir öğrenenin yöntem kullanım dağılımı:
\[ \pi_i\in\Delta^M \]
olsun. Yöntem Uzmanlaşma İndeksi:
\[ MSI(\pi_i) = 1- \frac{H(\pi_i)}{\log M} \]
olarak tanımlanır.
Yüksek MSI, öğrenenin az sayıda yönteme yoğunlaştığını; düşük MSI ise yöntemleri daha dengeli kullandığını gösterir.
Yöntem kapsaması
Popülasyonun mevcut yöntem repertuarının ne kadarını gerçekten kullandığı:
\[ Coverage= \frac{ |\{m:\exists i,\pi_{i,m}>\tau\}| }{M} \]
ile hesaplanmıştır.
Çalışmada:
\[ \tau=0.3 \]
kullanılır.
Örneğin beş yöntemin beşi de en az bir uzman tarafından yeterince güçlü biçimde kullanılıyorsa coverage %100 olur.
Üç Teorik Önerme Ne Söylüyor?
Önerme 1: Rekabetçi dışlama
Kaynak, winner-take-all yapısında \(N>R\) olduğunda aynı niş yakınlığına sahip öğrenenlerin oluşturduğu homojen stratejinin Nash dengesi olmadığını ileri sürmektedir.
Aynı rejimde \(k_r\) öğrenen bulunuyorsa kaynak beklenen getiriyi yüksek düzeyde:
\[ E[\text{Payoff}_i|r] = \frac{V_r}{k_r}-c \]
olarak ifade eder.
Daha az kalabalık \(r'\) rejimine geçen öğrenen için:
\[ E[\text{Payoff}'_i|r'] = \frac{V_{r'}}{k_{r'}-1}-c' \]
yazılır.
Temel argüman, rejimlerin değerleri karşılaştırılabilir olduğunda daha az kalabalık bir nişe yönelmenin beklenen getiriyi artırabileceğidir.
Bu sonuç bütün olası rekabet sistemlerinin evrensel teoremi olarak yorumlanmamalıdır. Kaynak ispatı winner-take-all dinamikleri, benzer rejim değerleri ve kendi model varsayımları altında kurmaktadır.
Nash dengesi nedir?
Nash dengesi, diğer katılımcıların stratejileri sabitken hiçbir katılımcının yalnız kendi stratejisini değiştirerek daha iyi sonuç elde edemediği strateji profilidir.
Kaynağın Önerme 1'deki iddiası, tamamen aynı nişe yığılmış öğrenenlerden birinin daha az kalabalık bir alana yönelerek daha iyi beklenen sonuç elde edebilmesi halinde homojen durumun kararlı bir Nash dengesi olamayacağıdır.
Önerme 2: Beklenen SI alt sınırı
Kaynak, eşit olasılıklı \(R\) rejim ve \(\lambda>0\) için beklenen uzmanlaşmaya yönelik aşağıdaki alt sınırı verir:
\[ E[SI] \geq \frac{\lambda}{1+\lambda} \left(1-\frac{1}{R}\right) \left(1-e^{-\eta T/R}\right) \]
Burada:
- \(\lambda\): niş bonusu katsayısı,
- \(R\): rejim sayısı,
- \(\eta\): öğrenme hızı,
- \(T\): iterasyon sayısıdır.
Varsayılan deneyde:
\[ \lambda=0.3,\quad R=4,\quad \eta=0.1,\quad T=500 \]
olduğunda kaynak alt sınırın yaklaşık:
\[ SI\geq0.17 \]
olduğunu belirtmektedir. Deneysel ortalama yaklaşık 0,75 olduğundan gözlenen değer bu alt sınırın üzerindedir.
Ana metin birincil niş için yaklaşık:
\[ \alpha_{r^{*}}^{*}\approx\frac{\lambda}{1+\lambda} \]
ifadesini kullanırken Ek A'daki genişletilmiş türetim:
\[ \alpha_{r^{*}}^{**} = \frac{\lambda}{1+\lambda} + \frac{1}{R(1+\lambda)} \]
biçiminde ek bir uniform taban terimi içermektedir. İki ifade birebir aynı değildir; ikincisi ek bölümde verilen daha ayrıntılı formdur.
Önerme 3: Tek rejimde çeşitlilik neden çöker?
Kaynak çevrenin etkin rejim sayısını:
\[ k_{\text{eff}} = \exp(H(\pi_r)) \]
ile tanımlar.
Ortam tek rejime doğru çöktüğünde:
\[ k_{\text{eff}}\rightarrow1 \]
olur.
Kaynak bu durumda popülasyon düzeyinde anlamlı farklılaşmanın mümkün olmadığını ve “etkin uzmanlaşmanın” sıfıra gittiğini savunur.
Burada önemli bir ölçüm ayrımı vardır. Bütün öğrenenler aynı rejime tamamen yoğunlaşırsa tek tek öğrenenlerin ham SI değeri matematiksel olarak yüksek olabilir. Kaynak da bunu kabul eder ve bu durumdaki SI'yi “dejenere” olarak tanımlar. Önerme 3'te sıfıra gittiği söylenen şey, öğrenenlerin farklı rejimlere bölündüğü popülasyon düzeyindeki etkili çeşitlilik yorumudur.
Çalışmanın Yöntemi ve Bulguları
Altı gerçek veri alanı
| Alan | Kaynak | Değerlendirme ölçütü | Kayıt | Rejim |
|---|---|---|---|---|
| Kripto para | Bybit Exchange | Sharpe Ratio | 8.766 | 4 |
| Emtia | FRED | Yön doğruluğu | 5.630 | 4 |
| Hava tahmini | Open-Meteo API | RMSE (°C) | 9.105 | 4 |
| Güneş ışınımı | Open-Meteo API | MAE (W/m²) | 116.834 | 4 |
| Kent trafiği | NYC TLC | MAPE (%) | 2.879 | 6 |
| Hava kalitesi | Open-Meteo API | RMSE (µg/m³) | 2.880 | 4 |
Bu satırların aritmetik toplamı 146.094 kayıttır. Kaynağın sonuç bölümünde ise 145.294 toplam kayıt ifadesi bulunmaktadır. Aradaki 800 kayıtlık fark PDF'de açıklanmamıştır. Bu nedenle alan bazındaki Tablo 1 değerleri değiştirilmeden korunmuştur.
Her alanda kullanılan beş yöntem
| Alan | Kullanılan yöntemler |
|---|---|
| Kripto para | Naive; Momentum-Short (5 dönem); Momentum-Long (20 dönem); Mean-Revert (z-score); Trend (doğrusal regresyon) |
| Emtia | Naive; MA-5; MA-20; Mean-Revert; Trend |
| Hava tahmini | Naive; MA-3; MA-7; Seasonal (yıllık örüntü); Trend |
| Güneş ışınımı | Naive; MA-6; Clear-Sky astronomik model; Seasonal günlük örüntü; Hybrid |
| Trafik | Persistence; Hourly-Avg; Weekly-Pattern; Rush-Hour; Exponential Smoothing |
| Hava kalitesi | Persistence; Hourly-Avg; Moving-Avg (24 saat); Regime-Avg; Exponential Smoothing |
Bu yöntem repertuarları otomatik olarak keşfedilmemiştir. Her alan için araştırmacı tarafından önceden hazırlanmıştır. Dolayısıyla gözlenen iş bölümü, tamamen serbest bir model uzayının kendiliğinden keşfi değil, tanımlanmış yöntem repertuarı içindeki uzmanlaşmadır.
Ortak hiperparametreler
| Parametre | Değer |
|---|---|
| Öğrenen sayısı | N = 8 |
| Alan başına yöntem | M = 5 |
| İterasyon / deney | T = 500 |
| Koşul başına bağımsız deney | 30 |
| Varsayılan niş bonusu | λ = 0,3 |
| Öğrenme hızı | η = 0,1 |
| Temel rastgele tohum | 42 |
| Thompson Sampling öncülü | Beta(1,1) |
Uzmanlaşmanın alanlar arası sonuçları
| Alan | NichePopulation SI | Homojen SI | Rastgele SI | Cohen's d | p-değeri |
|---|---|---|---|---|---|
| Kripto para | 0,786 ± 0,055 | 0,002 | 0,132 | 20,05 | < 10−59 |
| Emtia | 0,773 ± 0,055 | 0,002 | 0,132 | 19,89 | < 10−59 |
| Hava | 0,758 ± 0,046 | 0,002 | 0,132 | 23,44 | < 10−63 |
| Güneş | 0,764 ± 0,042 | 0,002 | 0,132 | 25,71 | < 10−65 |
| Trafik | 0,573 ± 0,051 | 0,003 | 0,103 | 15,86 | < 10−53 |
| Hava kalitesi | 0,826 ± 0,036 | 0,002 | 0,132 | 32,06 | < 10−71 |
| Ortalama | 0,747 | 0,002 | 0,127 | 22,84 | — |
Kaynağın özet ve sonuç kısmındaki “Cohen's d > 20 bütün alanlarda” ifadesi bu tabloyla birebir uyuşmamaktadır. Commodities için 19,89, Traffic için 15,86 verilmiştir. Bu nedenle doğru aralık 15,86–32,06, ortalama ise 22,84 olarak aktarılmıştır.
Cohen's d ne anlama geliyor?
Cohen's d, iki grubun ortalamaları arasındaki farkı standart sapma biriminde ifade eden standartlaştırılmış etki büyüklüğüdür.
Kaynakta:
\[ d= \frac{\mu_1-\mu_2}{\sigma_{\text{pooled}}} \]
kullanılmaktadır.
Burada \(\mu_1\) ve \(\mu_2\) grup ortalamaları, \(\sigma_{\text{pooled}}\) ise birleştirilmiş standart sapmadır.
Örneğin d = 20 değeri “yöntem %2000 daha iyi” anlamına gelmez. Ortalamaların birleştirilmiş standart sapmaya göre olağanüstü derecede ayrıştığını ifade eder. Bu çalışmadaki çok yüksek d değerlerinin bir nedeni, 30 tekrarda sonuçların oldukça düşük varyans göstermesidir.
İstatistiksel anlamlılık nasıl kontrol edildi?
Çalışma bir ve iki örneklemli t-testleri kullanmıştır. Altı alan arasında çoklu karşılaştırma yapılması nedeniyle Bonferroni düzeltmesi uygulanmıştır:
\[ \alpha= \frac{0.05}{6} \approx0.0083 \]
Dolayısıyla istatistiksel anlamlılık eşiği:
\[ p<0.0083 \]
olarak alınmıştır.
Güven aralıkları için 1.000 yeniden örneklemeli bootstrap kullanıldığı belirtilmektedir.
λ ablation: Rekabet bonus olmadan ne yaptı?
| Alan | λ=0,0 | λ=0,1 | λ=0,2 | λ=0,3 | λ=0,4 | λ=0,5 |
|---|---|---|---|---|---|---|
| Kripto | 0,314 | 0,415 | 0,598 | 0,786 | 0,837 | 0,856 |
| Emtia | 0,302 | 0,409 | 0,587 | 0,773 | 0,835 | 0,848 |
| Hava | 0,305 | 0,412 | 0,613 | 0,758 | 0,829 | 0,858 |
| Güneş | 0,256 | 0,383 | 0,583 | 0,764 | 0,839 | 0,853 |
| Trafik | 0,294 | 0,331 | 0,425 | 0,573 | 0,708 | 0,790 |
| Hava kalitesi | 0,501 | 0,588 | 0,769 | 0,826 | 0,837 | 0,800 |
| Ortalama | 0,329 | 0,423 | 0,596 | 0,747 | 0,814 | 0,834 |
\(\lambda=0\) koşulunda bütün alanlarda SI, ilgili rastgele tabanın üzerinde kalmıştır. Bununla birlikte kaynak özetindeki “bütün alanlarda SI > 0,30” cümlesi tabloyla tam uyumlu değildir: Solar 0,256 ve Traffic 0,294'tür.
Bilimsel olarak tablo tarafından desteklenen daha dikkatli ifade şudur: λ=0 koşulunda ortalama SI 0,329'dur ve bütün alanlarda uzmanlaşma rastgele karşılaştırmanın üzerinde kalmıştır.
λ arttıkça ne oluyor?
Ortalama SI λ yükseldikçe 0,329'dan 0,834'e çıkmıştır. Yazar bu sonucu, rekabetin uzmanlaşmayı başlattığı; niş bonusunun ise süreci güçlendirdiği şeklinde yorumlamaktadır.
Ancak λ'nın yüksek olması her durumda daha iyi değildir. Hava kalitesi alanında SI:
\[ 0.826\quad(\lambda=0.3) \]
değerinden:
\[ 0.800\quad(\lambda=0.5) \]
değerine düşmüştür.
Kaynak bunu aşırı uzmanlaşmanın keşif davranışını azaltabilmesiyle ilişkilendirmektedir.
Yöntem düzeyindeki iş bölümü
| Alan | MSI | Kapsama | Niche Perf | Homojen Perf | Fark |
|---|---|---|---|---|---|
| Kripto | 0,361 | %79 | 0,886 | 0,626 | +%41,6 |
| Emtia | 0,371 | %73 | 0,890 | 0,648 | +%37,2 |
| Hava | 0,402 | %100 | 0,868 | 0,675 | +%28,6 |
| Güneş | 0,367 | %97 | 0,925 | 0,786 | +%17,6 |
| Trafik | 0,311 | %100 | 0,917 | 0,740 | +%23,8 |
| Hava kalitesi | 0,371 | %73 | 0,916 | 0,834 | +%9,9 |
| Ortalama | 0,364 | %87 | — | — | +%26,5 |
Buradaki performans değerleri alanların ham RMSE, Sharpe oranı veya MAPE değerleri değildir. Kaynak, her alanın tahmin başarısını rastgele tabana göre normalize ederek 0–1 aralığına dönüştürdüğünü açıklamaktadır.
Dolayısıyla “+%26,5 performans” bütün alanların fiziksel hata değerlerinde doğrudan %26,5 azalma anlamına gelmez. Normalize edilmiş alan içi performansların karşılaştırmasından elde edilen ortalama göreli iyileşmedir.
Homojen taban nedir?
Homojen karşılaştırmada bütün öğrenenler aynı tek yöntemi kullanır. Kaynak bu yöntemi “single best-performing method (oracle selection)” biçiminde seçmektedir.
Bu, her rejimde ayrı ayrı mükemmel yöntemi bilen bir oracle değildir. Alan için tek bir yöntem seçilmekte ve bütün öğrenenler aynı yöntemi kullanmaktadır.
MARL karşılaştırması
| Yöntem | Kripto | Emtia | Hava | Güneş |
|---|---|---|---|---|
| NichePopulation | 0,758 | 0,763 | 0,716 | 0,788 |
| QMIX | 0,175 | 0,024 | 0,332 | 0,138 |
| MAPPO | 0,159 | 0,008 | 0,314 | 0,120 |
| IQL | 0,175 | 0,024 | 0,332 | 0,138 |
Bu karşılaştırma altı alanın tamamında değil, dört alanda yapılmıştır.
Kaynak metni NichePopulation ortalamasını 0,756 ve en güçlü MARL ortalamasını 0,167 olarak bildirmekte ve bunu 4,3× fark şeklinde özetlemektedir.
Tablodaki yuvarlanmış değerlerden doğrudan hesaplandığında:
\[ \frac{0.756}{0.167}\approx4.53 \]
elde edilir. Bu nedenle 4,3×, yazarın metinde raporladığı değer olarak korunmuştur; tablodan yeniden hesaplanmış kesin oran gibi sunulmamıştır.
MARL karşılaştırmasının sınırı
QMIX, MAPPO ve IQL için aynı sekiz öğrenen, 500 eğitim iterasyonu ve rastgele tohum bütçeleri kullanılmıştır. Ancak kaynak açıkça bu yöntemler için ayrıca hiperparametre optimizasyonu yapılmadığını belirtmektedir.
Bu nedenle sonuç, NichePopulation'ın bu deney yapılandırmasında daha yüksek SI ürettiğini gösterir. Bütün olası QMIX, MAPPO veya IQL yapılandırmalarına karşı evrensel üstünlük kanıtı değildir.
Hesaplama maliyeti
Kaynakta 500 iterasyon için NichePopulation yaklaşık:
0,9 saniye
eğitim süresiyle, MARL yöntemleri yaklaşık:
3,7 saniye
düzeyinde raporlanmıştır.
Bellek tüketimi yaklaşık 1 MB'a karşı 384–512 MB olarak verilmiştir.
Bu ölçümler tek makinede:
- Apple M1 Pro, 10 çekirdek
- 16 GB RAM
- macOS 14.3
- Python 3.10
- NumPy, SciPy ve Matplotlib
ortamında alınmıştır. Kaynak bütün deney koşullarının toplam çalışma süresini yaklaşık dört saat olarak bildirmektedir.
Trafik Alanında Uzmanlaşma Neden Daha Düşük?
Trafik alanı 0,573 SI ile altı alan içindeki en düşük sonucu vermiştir. Kaynak bunu bir başarısızlık olarak gizlemek yerine yöntemin sınır koşullarını tartışmak için kullanmaktadır.
Öne sürülen üç açıklama vardır:
- Trafikte diğer alanlardaki dört rejim yerine altı rejim bulunmaktadır. Sekiz öğrenenin altı rejime dağılması, rejim başına ortalama doğrudan rekabeti azaltabilir.
- Trafik rejimleri bağımsız değildir. Sabah yoğunluğunu öğle, ardından akşam yoğunluğu izler. Bu zamansal korelasyon teoride kullanılan bağımsız rejim varsayımına uymaz.
- “Geçiş” rejimi başka rejimlerle kısmen örtüştüğünden niş sınırları daha belirsizdir.
Buna rağmen trafik alanında yöntem kapsaması %100 ve homojen tabana göre normalize performans artışı %23,8'dir.
Matematiksel tutarlılık notu: Kaynak aynı bölümde \(1-1/R\) ifadesinin R=6 için teorik üst sınırı düşürdüğünü söylemektedir. Ancak:
\[ 1-\frac{1}{6}=\frac{5}{6}\approx0.833 \]
ve:
\[ 1-\frac{1}{4}=\frac{3}{4}=0.75 \]
olduğundan ilk değer daha küçüğe değil daha büyüğe gider. Ayrıca SI tanımının matematiksel üst sınırı 1'dir. Bu nedenle düşük Traffic SI'nin bu özel “daha düşük üst sınır” açıklaması doğrulanmış matematiksel sonuç olarak aktarılmamıştır.
Rekabet Gerçekten Tek Başına Yeterli mi?
Bu çalışmanın deneysel çerçevesinde, λ = 0 koşulu niş bonusunu ortadan kaldırmasına rağmen winner-take-all rekabetini, önceden tanımlanmış heterojen rejimleri, farklı rejimlerde farklı başarı gösteren yöntem repertuarını ve kazananın seçici güncellenmesini korumaktadır.
Dolayısıyla “rekabet tek başına yeterli” sonucunun tam anlamı şudur:
Bu modelde, özel niş bonusu olmaksızın yalnız winner-take-all rekabet ve öğrenme dinamiği mevcutken rastgele tabanın üzerinde uzmanlaşma ortaya çıkmıştır.
Bu ifade, herhangi iki yapay zekâ modelini rekabete sokmanın her ortamda otomatik ve yararlı uzmanlaşma üreteceğini göstermemektedir.
Uzmanlaşma için kaynağın belirlediği üç koşul
- Rejim heterojenliği: Çevrede gerçekten birbirinden farklı birden fazla koşul bulunmalıdır.
- Strateji farklılaşması: Farklı yöntemler farklı rejimlerde avantajlı olmalıdır.
- Sınırlı kaynak / gerçek rekabet: Bütün öğrenenlerin aynı anda eşit biçimde ödüllendirilmediği bir rekabet baskısı bulunmalıdır.
Bu koşullar ortadan kalktığında çalışmanın teorik mekanizması da zayıflar.
Çalışmanın Desteklediği Sonuçlar
- Winner-take-all rekabet altında öğrenenler farklı rejimlere yönelik niş yakınlıkları geliştirebilmiştir.
- Varsayılan λ=0,3 koşulunda altı alandaki ortalama SI 0,747'dir.
- λ=0 koşulunda ortalama SI 0,329'dur ve rastgele tabanın 0,127 ortalamasının üzerindedir.
- Niş bonusu uzmanlaşmanın büyüklüğünü artırmıştır; λ=0,3'te ortalama SI 0,747'ye çıkmıştır.
- Popülasyonlar mevcut yöntemlerin ortalama %87'sini kullanmıştır.
- Normalize edilmiş tahmin performansında homojen tabana göre ortalama +%26,5 artış raporlanmıştır.
- Dört alandaki MARL karşılaştırmasında NichePopulation daha yüksek SI üretmiştir.
- Winner-take-all sistem düşük hesaplama ve bellek maliyeti göstermiştir.
- Trafik alanı daha düşük rejim uzmanlaşmasına rağmen %100 yöntem kapsamı ve +%23,8 normalize performans artışı göstermiştir.
Çalışmanın Desteklemediği Genellemeler
- Rekabetin bütün makine öğrenmesi sistemlerinde mutlaka yararlı çeşitlilik oluşturduğu kanıtlanmamıştır.
- Rejimler algoritma tarafından kendiliğinden keşfedilmemektedir; alan bilgisiyle önceden tanımlanmıştır.
- Tahmin yöntemleri otomatik keşfedilmemiş veya üretilmemiştir; alan başına beş yöntem elle belirlenmiştir.
- “Bütün alanlarda Cohen's d > 20” ifadesi ana sonuç tablosuyla uyuşmamaktadır.
- “λ=0 iken bütün alanlarda SI > 0,30” ifadesi ana ablation tablosuyla uyuşmamaktadır.
- MARL karşılaştırması altı alanın tamamında yapılmamıştır; Tablo 5 yalnız dört alan içermektedir.
- MARL yöntemleri için kapsamlı hiperparametre optimizasyonu yapılmadığından bütün olası yapılandırmalara karşı kesin üstünlük gösterilmemiştir.
- Winner-take-all mekanizmasının bütün daha yumuşak rekabet biçimlerinden zorunlu olarak üstün olduğu deneysel olarak gösterilmemiştir; top-k veya oransal ödül mekanizmaları gelecek çalışmalara bırakılmıştır.
- Çalışma gerçek zamanlı finansal alım-satım sistemi veya yatırım stratejisi değildir.
- Kripto para alanındaki yüksek performans artışı gerçek portföy getirisinde %41,6 kazanç anlamına gelmez.
- Gerçek üretim sistemlerinde iletişim olmaksızın koordinasyonun her zaman rekabetle çözülebileceği gösterilmemiştir.
Başlıca sınırlılıklar
Rejim belirleme: Çalışma hareketli ortalama kesişimleri, volatilite eşikleri ve alan bilgisiyle oluşturulan basit rejim sınıflandırıcıları kullanmaktadır. Hidden Markov Model veya change-point detection gibi yöntemler denenmemiştir.
Durağanlık varsayımı: Teorik analiz rejim dağılımının durağan olduğunu varsayar. Gerçek dünyada rejim sıklıkları zamanla değişebilir.
Winner-take-all seçimi: Yalnız tek öğrenenin güncellenmesi bilinçli bir tasarım kararıdır. Top-k veya oransal ödül mekanizmalarının sonucu araştırılmamıştır.
Elle tanımlanan yöntemler: Her alan için yöntem repertuarı araştırmacı tarafından hazırlanmıştır. Meta-learning veya program synthesis ile otomatik yöntem keşfi yapılmamıştır.
Elle tanımlanan rejimler: Sistem yeni alanlarda rejimleri sıfırdan keşfetmemektedir.
Eksik oracle karşılaştırması: Her rejimde kusursuz biçimde en iyi yöntemi seçen bir oracle tabanı bulunmamaktadır. Ayrıca rekabetçi dışlama olmadan aynı çoklu öğrenen repertuarını kullanan ayrı bir ensemble karşılaştırması yapılmamıştır.
Kaynak içi önemli tutarsızlıkların özeti
| Konu | Kaynakta bir ifade | Kaynak tablosu / diğer bölüm |
|---|---|---|
| Cohen's d | “Bütün alanlarda d > 20” | Commodities 19,89; Traffic 15,86 |
| λ=0 | “Bütün alanlarda SI > 0,30” | Solar 0,256; Traffic 0,294 |
| Toplam kayıt | Sonuç: 145.294 | Tablo 1 satır toplamı: 146.094 |
| MARL oranı | Metin: 4,3× | Raporlanan ortalamalar 0,756 / 0,167 ≈ 4,53× |
| Niş bonusu | Ana Algorithm 1: çarpanlı ödül | Ek B: toplamsal bonus |
| Afinite güncellemesi | Ana yöntem: kazanan rejimi artır + normalize et | Ek örnekte diğer rejimler ayrıca azaltılıyor |
| Traffic teorik açıklaması | R=6 için 1−1/R'nin daha düşük sınır verdiği söyleniyor | 5/6, 3/4'ten büyüktür; SI üst sınırı tanım gereği 1'dir |
Araştırmanın genel sonucu
Çalışma, önceden tanımlanmış heterojen çevresel rejimler ve farklı rejimlerde farklı performans gösteren yöntemler mevcut olduğunda, winner-take-all rekabetinin başlangıçta aynı olan öğrenenleri zaman içinde farklı uzmanlık alanlarına yöneltebildiğini göstermektedir.
Deneylerin en güçlü bulgusu, özel niş bonusu kapatıldığında bile rastgele tabanın üzerinde uzmanlaşmanın korunmasıdır. Bu, uzmanlaşmanın yalnız doğrudan çeşitlilik ödülünün sonucu olmadığını desteklemektedir.
Bununla birlikte λ=0 ile λ=0,3 arasındaki büyük SI farkı, niş bonusunun nicel uzmanlaşma düzeyinde önemli rol oynadığını da göstermektedir. Dolayısıyla çalışmanın bulgusu “bonus gereksizdir” değil, “rekabet uzmanlaşmayı başlatabilir; bonus bunu belirgin biçimde güçlendirebilir” şeklinde daha doğru ifade edilir.
NichePopulation'ın düşük hesaplama maliyeti ve açık niş yakınlığı dağılımları, yorumlanabilir öğrenen popülasyonları açısından dikkat çekicidir. Ancak rejimlerin ve yöntem repertuarlarının elle hazırlanması, durağan ortam varsayımı, winner-take-all güncellemesinin tek rekabet biçimi olarak test edilmesi ve bazı kaynak içi matematiksel/sayısal tutarsızlıklar nedeniyle sonuçların daha geniş sistemlere aktarımı ek doğrulama gerektirmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Emergent Specialization in Learner Populations: Competition as the Source of Diversity.
Yazar: Yuhao Li.
Kurum: University of Pennsylvania.
Eş katkı: Uygulanabilir değildir; çalışma tek yazarlıdır.
Sorumlu yazar: Ayrı corresponding-author bildirimi bulunmamaktadır; PDF'de tek yazarın iletişim adresi verilmiştir.
ArXiv kimliği: arXiv:2601.19943.
İncelenen sürüm: arXiv:2601.19943v1.
Gönderim tarihi: 16 Ocak 2026.
ArXiv DOI: 10.48550/arXiv.2601.19943.
Resmî kaynak: https://arxiv.org/abs/2601.19943
Kaynak türü: Makine öğrenmesi alanında yöntem geliştirme, kuramsal analiz ve gerçek veri üzerinde deneysel değerlendirme içeren ön baskı.
Hakemlik durumu: Kasım 2026 bibliyografik kontrolünde ayrıca doğrulanmış hakemli bir dergi veya konferans sürümü tespit edilmemiştir. ArXiv kaydı kendi başına hakemlik göstergesi değildir.
Bilimsel alan: Machine Learning (cs.LG); çalışma ayrıca çoklu öğrenen sistemleri, çok-etmenli pekiştirmeli öğrenme, ekolojik niş kuramı ve bilgi kuramıyla ilişkilidir.
Temel yöntem: NichePopulation; winner-take-all competitive exclusion, Thompson Sampling, yöntem inançları ve niş yakınlığı takibi.
Temel deney yapılandırması: Sekiz öğrenen, alan başına beş yöntem, deney başına 500 iterasyon, koşul başına 30 bağımsız tekrar, varsayılan λ=0,3, öğrenme hızı η=0,1.
Gerçek veri alanları: Bybit kripto para verileri, FRED emtia fiyatları, Open-Meteo hava ve güneş ışınımı/hava kalitesi verileri, NYC TLC trafik verileri.
Tablo 1 kayıtları: 8.766 + 5.630 + 9.105 + 116.834 + 2.879 + 2.880 = 146.094. Kaynak sonuç bölümündeki 145.294 toplam kayıt ifadesiyle 800 kayıtlık açıklanmamış fark bulunmaktadır.
Ana SI sonucu: Ana Tablo 2'de altı alan ortalaması 0,747; özet bunu yuvarlayarak yaklaşık 0,75 olarak sunmaktadır.
λ=0 sonucu: Ortalama SI 0,329. Tablo 3'te Solar 0,256 ve Traffic 0,294 olduğundan özetin “bütün alanlarda SI > 0,30” ifadesi birebir doğru değildir.
Etki büyüklüğü: Tablo 2'de Cohen's d 15,86–32,06 aralığındadır; ortalama 22,84'tür. Kaynağın “bütün alanlarda d > 20” ifadesi Commodities ve Traffic satırlarıyla uyuşmamaktadır.
Yöntem çeşitliliği: Ortalama Method Specialization Index 0,364; yöntem kapsamı %87; normalize edilmiş homojen tabana göre ortalama performans farkı +%26,5.
MARL karşılaştırması: QMIX, MAPPO ve IQL yalnız Crypto, Commodities, Weather ve Solar alanlarında karşılaştırılmıştır. Kaynak 4,3× SI üstünlüğü raporlamaktadır. Tablo ortalamalarından doğrudan oran yaklaşık 4,52–4,53× elde edilmektedir.
MARL ayarlama sınırı: Kaynak, karşılaştırma yöntemleri için yayımlanmış hiperparametrelerin kullanıldığını ancak ek hiperparametre optimizasyonu yapılmadığını açıkça belirtmektedir.
Hesaplama ortamı: Apple M1 Pro (10 çekirdek), 16 GB RAM, macOS 14.3, Python 3.10; NumPy, SciPy ve Matplotlib.
İstatistiksel yöntem: Bir ve iki örneklemli t-testleri, altı alan için Bonferroni düzeltmesi (α=0,0083), Cohen's d ve 1.000 örneklemeli bootstrap güven aralıkları.
Kuramsal yapı: Rekabetçi dışlama, SI alt sınırı ve mono-rejim durumunda etkili popülasyon çeşitliliğinin çökmesi üzerine üç önerme sunulmaktadır.
Ana yöntem–Ek B farklılığı: Algorithm 1'de ayarlanmış ödül çarpanlı biçimde tanımlanırken Ek B'deki öğretici anlatım toplamsal bonus kullanır. Ek B'nin afinite güncelleme örneği de ana algoritmadaki artırma + normalizasyon kuralından ek adımlar içermektedir. Bu farklılıklar tek bir denklemmiş gibi birleştirilmemiştir.
Traffic açıklaması: Kaynağın R=6 için \(1-1/R\) teriminin daha düşük teorik sınır oluşturduğu yönündeki cümlesi matematiksel olarak kendi verilen değerleriyle uyuşmamaktadır. Traffic'in deneysel SI=0,573 sonucu korunmuş, ilgili hatalı sınır yorumu genellenmemiştir.
Regimelerin durumu: Rejimler algoritmanın kendisi tarafından keşfedilmemiştir; alan bilgisiyle önceden tanımlanmıştır.
Yöntem envanteri: Beş tahmin yöntemi her alan için elle tasarlanmıştır. Otomatik yöntem keşfi veya üretimi bu çalışmada gerçekleştirilmemiştir.
Oracle sınırı: Her rejimde kusursuz şekilde yöntem değiştiren tam oracle tabanı bulunmamaktadır. Rekabet olmaksızın aynı çoklu yöntem repertuarını kullanan saf ensemble karşılaştırması da yapılmamıştır.
Kod ve veri: Kaynak, kod, veri ve deney yapılandırmalarının https://github.com/HowardLiYH/NichePopulation adresinde bulunduğunu belirtmektedir. Depo daha sonraki tarihlerde geliştirilebileceğinden bu Verianla metni yalnız incelenen arXiv v1 sonuçlarını esas almaktadır.
Finansman: PDF'de ayrı bir finansman beyanı tespit edilmemiştir.
Çıkar çatışması: PDF'de ayrı bir çıkar çatışması beyanı tespit edilmemiştir.
CRediT/yazar katkısı: Ayrı CRediT katkı bildirimi bulunmamaktadır; çalışma tek yazarlıdır.
Bilimsel yorum sınırı: Araştırma, tanımlanan winner-take-all deney sisteminde rekabetin özel çeşitlilik ödülü olmadan rastgele tabanın üzerinde uzmanlaşma oluşturabildiğini göstermektedir. Sonuç, rekabetin bütün yapay zekâ veya çok-etmenli sistemlerde evrensel olarak uzmanlaşmanın tek veya zorunlu kaynağı olduğunu kanıtlamaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir