


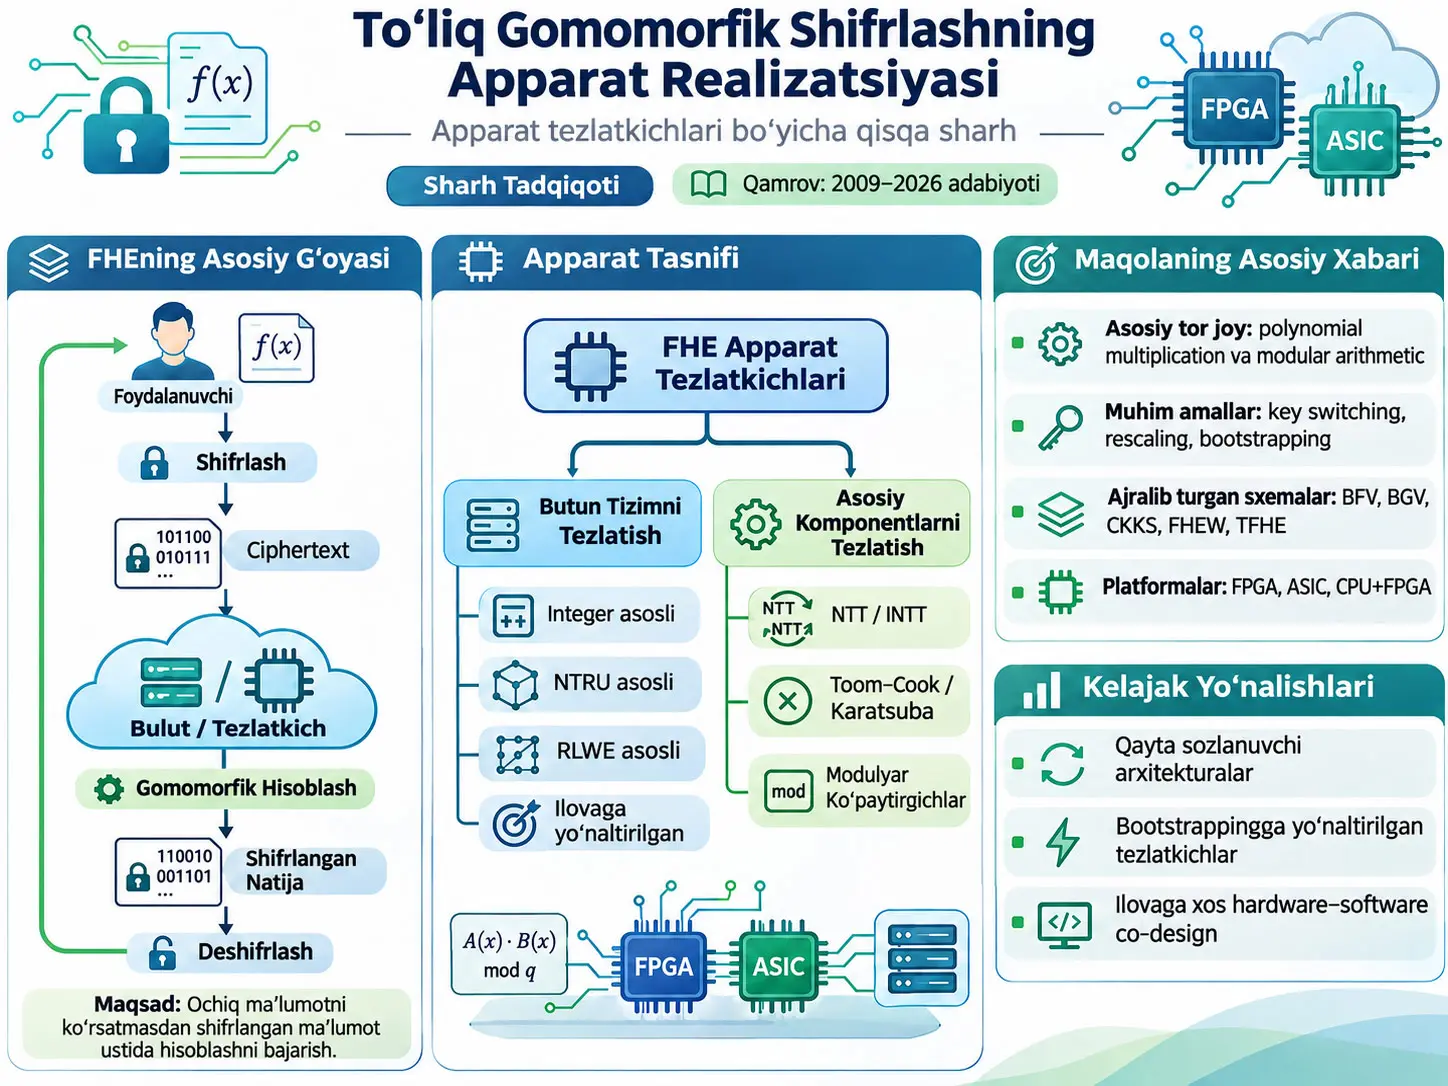
To‘liq Gomomorfik Shifrlash (Fully Homomorphic Encryption, FHE) — shifrlangan ma’lumotni avval ochiq matnga aylantirishga ehtiyoj bo‘lmasdan, muayyan hisob-kitoblarni bevosita ciphertext ustida bajarish va hosil bo‘lgan shifrlangan natija vakolatli foydalanuvchi tomonidan deshifrlanganda ochiq ma’lumot ustida bajarilgan mos hisob-kitob bilan bir xil natijani berishini maqsad qiladigan shifrlash yondashuvidir. Ushbu tadqiqot yangi FHE algoritmi yoki tezlatgichini taklif qilmaydi; 2009–2026 oralig‘ida FHE sxemalarining rivojlanishini, butun FHE tizimini tezlashtiruvchi apparat arxitekturalarini, polinom ko‘paytirgichlarini va butun sonli modulli ko‘paytirgichlarni ko‘rib chiqadigan apparatga yo‘naltirilgan narrative review taqdim etadi. Sharhning asosiy xulosasi shundan iboratki, FHE apparatida unumdorlik muammosini faqat tezroq ko‘paytirish sxemasini yaratish bilan hal qilib bo‘lmaydi; polinom arifmetikasi, bootstrapping, key switching, xotira harakati, qayta konfiguratsiyalanuvchanlik va ilovaga xos ma’lumot oqimi birgalikda ko‘rib chiqilishi kerak.
Mualliflarning baholashiga ko‘ra, RLWE asosidagi FHE tezlatgichlari yanada kuchli standartlashtirilgan panjara asoslari va moslashuvchan algebraik tuzilmalari sababli zamonaviy apparat tadqiqotlarining ustun yo‘nalishlaridan biriga aylangan. BFV, BGV va CKKS kabi leveled FHE sxemalari katta polinomlar, Residue Number System (RNS), polynomial multiplication, relinearization, key switching va modulus boshqaruvi bilan ishlasa; FHEW/TFHE oilasi kichikroq modullar va bit darajasidagi bootstrappingdan foydalanadi. Bu farqlar bitta qat’iy tezlatgichning barcha FHE algoritmlari uchun bir xil darajada samarali bo‘lishini qiyinlashtiradi.
Sharh mavjud tezlatgichlarning muhim qismi muayyan sxemalar yoki muayyan yadro amallariga moslashtirilganini; bu unumdorlikni oshirsa-da, umumiy apparat resurslarini qayta ishlatish va algoritmlararo moslashuvchanlikni cheklashini ta’kidlaydi. Mualliflar kelajakda ulashiladigan modular arithmetic bloklari, qayta konfiguratsiyalanuvchi NTT/INTT yadrolari, dasturlanadigan ma’lumot oqimi, bootstrappingga yo‘naltirilgan arxitekturalar va ilova–algoritm–apparatni birgalikda loyihalash muhimlashishini bashorat qiladilar.
Manbada keltirilgan juda yuqori tezlashish koeffitsiyentlari bitta umumiy benchmarkga tegishli emas. F1, HEAX, Poseidon, CHAM, HERACLES va boshqa dizaynlar turli FHE sxemalari, apparat texnologiyalari, parametrlar, ish yuklari va dasturiy ta’minot bazaviy chiziqlaridan foydalanadi. Shu sababli, masalan, 1000×, 5000× yoki 17.000× kabi tezlashish qiymatini boshqa qatordagi tezlashish qiymati bilan to‘g‘ridan-to‘g‘ri solishtirib universal unumdorlik reytingini tuzib bo‘lmaydi.
Tadqiqotning yadro arifmetikasini ko‘rib chiqish qismida Saber, ML-KEM, ML-DSA va NTRU Prime kabi FHE bo‘lmagan panjaraga asoslangan kriptografiya misollari ham berilgan. Ular “FHE sxemasi” sifatida taqdim etilmagan; NTT/INTT, Karatsuba va Toom–Cook kabi umumiy polinom arifmetikasining apparat realizatsiyasiga oid muhandislik misollari sifatida ishlatilgan.
FHEning asosiy g‘oyasi nima?
Klassik tashqi hisoblash modelida ma’lumot egasi maxfiy ma’lumotini serverga ochiq holda yuborsa, server hisoblashni oson bajarishi mumkin, biroq maxfiylik yo‘qolishi mumkin. FHEnining maqsadi server ma’lumotning ochiq mazmunini ko‘rmasdan ciphertext ustida hisoblashni amalga oshira olishidir. Foydalanuvchi avval ma’lumotni o‘z kaliti bilan shifrlaydi, bulut faqat ciphertextni qayta ishlaydi va natija yana shifrlangan ko‘rinishda foydalanuvchiga qaytadi.
Bu tuzilishdagi “gomomorfik” so‘zi ochiq ma’lumot ustida bajarilgan matematik amallar bilan shifrlangan tasvir ustida bajarilgan amallar o‘rtasida natija nuqtai nazaridan saqlanadigan bog‘lanish mavjudligini anglatadi. FHEnining muhandislik muammosi esa bu amallarning nazariy jihatdan mumkinligidan ko‘ra, amalda qancha hisoblash, xotira, o‘tkazish qobiliyati va apparat maydonini talab qilishidadir.
Nega bu sharhga ehtiyoj tug‘ilgan?
Manbada avvalgi FHE sharhlarining muhim qismi matematik tamoyillar, xavfsizlik xususiyatlari va dasturiy kutubxonalarga e’tibor qaratgani aytiladi. Apparat tezlatishini ko‘rib chiqqan ayrim tadqiqotlar esa ma’lum yillar bilan cheklangan, faqat umumiy accelerator architecture darajasini o‘rgangan yoki faqat CKKS bootstrapping kabi tor kichik muammoga yo‘naltirilgan deb qayd etiladi.
Mualliflarning maqsadi bu bo‘shliqni uch qatlamda to‘ldirishdir: FHE sxemalarining rivojlanishini xronologik baholash, butun FHE tizimiga yo‘naltirilgan tezlatgichlarni tasniflash va unumdorlikni belgilaydigan polynomial multiplier hamda modular multiplier kabi mayda donali yadro apparat bloklarini alohida taqqoslash.
Birinchi avlod FHE
Manba birinchi avlodning boshlanishini Gentryning 2009-yildagi Gen09 tuzilmasi bilan bog‘laydi. Gen09 ideal panjaralar ustida qurilgan, gomomorfik qo‘shish va ko‘paytirishni birgalikda qo‘llab-quvvatlaydigan hamda ciphertext shovqinini nazorat ostida ushlab turish uchun bootstrappingdan foydalangan ilk umumiy FHE yondashuvi sifatida ko‘riladi.
Keyingi SV10, SS10, GH11 va GHS12a ishlari ciphertext/kalit o‘lchami, decryption circuit chuqurligi yoki bootstrapping samaradorligi kabi muammolarni yaxshilashga uringan. Sharh bahosiga ko‘ra, ushbu birinchi avlod sxemalari nazariy jihatdan muhim bo‘lsa-da, algebraik tuzilmalarning murakkabligi, katta ciphertextlar va yuqori bootstrapping xarajati amaliy foydalanishni cheklagan.
Ikkinchi avlod FHE
Ikkinchi avlod LWE/RLWE va polinom halqalari ustida ishlab chiqilgan sxemalar bilan bog‘lanadi. BV11a/BV11b, BGV, BFV va CKKS bu davrning asosiy misollaridir.
KeySwitching — ciphertext funksional jihatdan bir xil ochiq ma’lumotni ifodalashda davom etgan holda boshqa kalit/tasvir ostida ishlatilishiga imkon beradigan o‘zgartirish mexanizmidir. Manbada u ayniqsa ciphertext o‘lchami yoki baholash kalitlarini boshqarishda muhim rol o‘ynaydi.
ModulusSwitching — ciphertext modulini nazoratli tarzda o‘zgartirib, shovqin va hisoblash xarajatini boshqarishga yordam beruvchi usuldir.
Relinearization — gomomorfik ko‘paytirishdan keyin kattalashgan ciphertext tuzilmasini yana boshqarish osonroq bo‘lgan shaklga qaytarish uchun ishlatiladigan amaldir.
Rescaling — ayniqsa CKKSning taxminiy sonlar hisoblash modelida masshtab va modul boshqaruvining bir qismidir. Manba CKKSni haqiqiy sonlar ustida taxminiy hisoblashga mos FHE sxemasi sifatida ko‘rib chiqadi.
Uchinchi avlod FHE
Manba uchinchi davrni GSW, FHEW va TFHE kabi bit-bootstrappable sxemalar bilan bog‘laydi. Bu tuzilmalarda bir bitli yoki mantiqiy baholash, blind rotation va homomorphic accumulator kabi mexanizmlar ajralib turadi.
FHEW uchun bootstrapping vaqti bir soniyadan pastga tushirilgani, TFHE tomonida esa keyingi tadqiqotlar bilan 52 ms va undan so‘ng 13 ms darajasigacha yaxshilanishlar qayd etilgani aytiladi. Bular tarixan turli tadqiqotlarning natijalari bo‘lib, bir xil apparat yoki bir xil parametrlar to‘plamiga tegishli yagona tajriba emas.
BFV, CKKS va FHEW/TFHE o‘rtasidagi asosiy farqlar
| Xususiyat | BFV | CKKS | FHEW / TFHE |
|---|---|---|---|
| Turi | Leveled FHE | Leveled FHE | Bit-bootstrappable |
| Yadro komponent | Gomomorfik ko‘paytirish va relinearization | Gomomorfik ko‘paytirish va relinearization | Homomorphic accumulator |
| Parallel usul | RNS | RNS | Manba 1-jadvalda “None” |
| Modul o‘zgartirish | Base extension / scaling | Taxminiy modulus up/down conversion | Manba 1-jadvalda “None” |
| Yadro amal | Polynomial multiplication | Polynomial multiplication | Polynomial matrix multiplication |
| Asosiy arifmetika | Butun son ko‘paytirish va modulli amallar | Modulli amallar | Modulli amallar |
| Polinom o‘lchami N | ≥ \(2^{12}\) | ≥ \(2^{12}\) | \(2^{10}\) yoki \(2^{11}\) |
| \(\log_2 Q\) | ≥100 | ≥100 | ≤50 |
| Modul tanlovi | Tub son | Tub son | 2 ning darajasi yoki tub son |
Manba, shuningdek, leveled BFV/CKKS sxemalarida bootstrapping kerak bo‘lganda polinom darajasi \(2^{16}\)–\(2^{17}\) darajalarigacha chiqishi va ciphertext moduli yuzlab, hatto minglab bitga yetishi mumkinligini aytadi. Bular qat’iy majburiy parametrlar emas, tadqiqot muhokama qilgan tipik yuqori resurs talablarini ifodalaydi.
FHE Apparat Tezlatishining Asosiy Tor Joyi Nima?
Sharhga ko‘ra, asosiy tor joy gomomorfik baholash, ayniqsa katta polinom o‘lchamlari va keng modullar ostida takrorlanadigan polynomial multiplication, modular arithmetic, key switching va bootstrapping amallaridir; shu sababli faqat hisoblash bloklarining tezligi emas, xotiraga murojaat, ma’lumot harakati, RNS parallelligi va apparat resurslarini qayta ishlatish ham umumiy unumdorlikni belgilaydi.
Nega RNS ishlatiladi?
Residue Number System (RNS) — katta modul ostida bajariladigan hisoblashni kichikroq modullardan tashkil topgan bir nechta kanalda bajarishga imkon beruvchi ifodalash yondashuvidir. Manba BFV va CKKS kabi leveled FHE sxemalarining katta ciphertext modullarini kichik modullarga ajratib, parallel ishlov berish imkoniyatini RNSning asosiy apparat afzalligi sifatida tushuntiradi.
Bu afzallik qo‘shimcha base conversion, modulus conversion va ma’lumot harakatini ham talab qilishi mumkin. Demak, RNS “hisoblashni bepul tezlashtiradigan” usul emas; katta butun son arifmetikasini parallel kichik-modulli amallarga qulayroq shaklda aylantiradigan arxitektura tanlovidir.
FHE apparat tezlatgichlarining tasnifi
Integer asosli FHE tezlatgichlari
Ilk davrdagi integer asosli FHE tezlatgichlarida asosiy maqsad juda keng butun son ko‘paytirishlarini tezlashtirishdir. Manba FFT asosidagi Schönhage–Strassen va Comba singari ko‘paytirgichlarni bu davrning asosiy apparat yondashuvlari sifatida ko‘rsatadi.
Wang va hamkasblari Stratix-Vda yaratgan 64K nuqtali FFT dvigateli 100 MHzda NVIDIA C2050da xuddi shu FFT algoritmiga nisbatan taxminan ikki baravar tezlikka erishgani keltiriladi. Doröz va hamkasblarining 90 nm ASIC dizaynida encryption 18,1 ms, decryption 16,1 ms va recryption 3,1 s deb xabar qilingan; dizayn 30 million darvozadan kichik ekani aytilgan.
Manbaning umumiy bahosiga ko‘ra, bu dizaynlar ayrim parametrlarda muvaffaqiyat ko‘rsatgan bo‘lsa-da, kalit o‘lchamlari va keng butun son talablari oshgani sari masshtablanuvchanlik, xotira bosimi va algoritmik moslashuvchanlik muammolari kuchayadi.
NTRU asosli tezlatgichlar
NTRU asosidagi YASHE va LTV tezlatgichlarida NTT, CRT/iCRT, modulus switching va pipeline optimallashtirishlar ajralib turadi. Manba Pöppelmannning YASHE dizaynida \(n=16384\) va taxminan 512-bit \(q\) parametri uchun gomomorfik qo‘shishni 0,94 ms, gomomorfik ko‘paytirishni 48,67 ms deb keltiradi.
Royning ko‘p yadroli YASHE tezlatgichida SIMON-64/128 hisobi 2048 ciphertext parallel ishlanganda 171,3 s, har blok uchun 83,6 ms va dasturiy ta’minotga nisbatan 24,5× tezlashish sifatida xabar qilinadi. Öztürkning LTV CPU+FPGA tizimida gomomorfik AES blok baholashi 442 ms va CPU/GPUga nisbatan mos ravishda 28,5× va 17× tezlashish deb keltiriladi.
Sharh bu yo‘nalishning uzoq muddatli cheklovlari qatorida NTRU asosidagi ayrim tuzilmalarning subfield attackga sezgirligini, sxemaga bog‘liqlikni va keng ko‘lamli qayta foydalanishning cheklanganligini sanaydi.
RLWE asosli tezlatgichlar
Sharhda zamonaviy tadqiqotlarning eng faol sohasi RLWE asosidagi BFV, BGV va CKKS tezlatgichlaridir. HEPCloud, HEAX, Medha, F1, CraterLake, ARK va Poseidon kabi arxitekturalar faqat bitta multiplier sxemasini emas, ko‘p yadroli ishlov berish, RNS kanallari, key switching, ma’lumot harakati, dasturlanadigan instruction set va xotira iyerarxiyasini birgalikda ko‘rib chiqadi.
| Sinf | Tadqiqot / arxitektura | Platforma | Sxema | Manbada ajratib ko‘rsatilgan xususiyat va cheklov |
|---|---|---|---|---|
| Integer | Wang | FPGA, Stratix-V | GH | SSA+FFT integratsiyasi; juda keng ko‘paytirish uchun ixtisoslashgan va umumiyligi cheklangan. |
| Integer | Doröz | 90 nm ASIC | GH | To‘liq apparat tezlatishi; yuqori apparat xarajati. |
| Integer | Moore | FPGA, Virtex-7 | Coron | DSP bo‘laklaridan samarali foydalanadigan yengil dizayn; DSPga bog‘liqlik va cheklangan moslashuvchanlik. |
| NTRU | Pöppelmann | FPGA, Stratix-V | YASHE | YASHE uchun yaxlit tezlatish; yuqori sxema ixtisoslashuvi. |
| NTRU | Roy | FPGA, Virtex-7 | YASHE | Modulli va qayta konfiguratsiyalanuvchi dizayn; qo‘shimcha boshqaruv yuki. |
| NTRU | Öztürk | FPGA, Virtex-7 | LTV-SHE | LTV-SHE uchun ilk FPGA tezlatgichi; sxemaga bog‘liqlik. |
| NTRU | Cousins / HEPU | FPGA, Virtex-7 | LTV | CRT/iCRT tezlatishi; scheduling yuki. |
| RLWE | Roy / HEPCloud | CPU + FPGA, Virtex-6 | BFV | Ko‘p yadroli BFV tezlatishi; moslik cheklangan. |
| RLWE | Mert | CPU + FPGA + ASIC | BFV | Yengil NTT optimallashtirish; reconfigurability cheklangan. |
| RLWE | Turan / HEAWS | FPGA, Virtex UltraScale+ | BFV | AWS FPGAda BFV tezlatishi; umumiylik cheklangan. |
| RLWE | Riazi / HEAX | CPU + FPGA + ASIC, Stratix-10 | CKKS | Ko‘p qatlamli parallellik; yuqori apparat resurs yuki. |
| RLWE | Roy / Medha | FPGA, Alveo U250 | CKKS | Ko‘p yadro va instruction-level parallelism; RNS-CKKSga yo‘naltirilgan. |
| RLWE | Samardzic / F1 | 14/12 nm ASIC | BGV / CKKS | Dasturlanadigan va keng algoritmik qo‘llab-quvvatlash; katta ASIC maydoni. |
| RLWE | Samardzic / CraterLake | 14/12 nm ASIC | BGV / CKKS | Unbounded FHE qo‘llab-quvvatlashi; yuqori arxitektura murakkabligi. |
| RLWE | Mert / Medha opt. | FPGA + 7 nm ASIC | CKKS | Microcoded instruction-set yondashuvi; moslik cheklovi. |
| RLWE | Kim / ARK | 7 nm ASIC | BGV / CKKS | Yuqori xotira samaradorligi; murakkab aloqa/ma’lumot oqimi. |
| RLWE | Yang / Poseidon | FPGA, Alveo U280 | CKKS | To‘liq bootstrapping qo‘llab-quvvatlashi; boshqaruv murakkabligi. |
| RLWE | Bertels | FPGA, ZCU102 | FHEW | Tez FHEW bootstrapping; tashqi kalit saqlashga bog‘liqlik. |
| RLWE | Jiang / MATCHA | ASIC/GPU | TFHE | Ko‘paytirishsiz FFT yondashuvi; moslik cheklangan. |
| RLWE | Van / FPT | FPGA, Alveo U280 | TFHE | Qat’iy nuqtali FFT; tashqi kalitga bog‘liqlik. |
| RLWE | Zhang | FPGA, Alveo U280 | CKKS / TFHE | Sxemalararo switching; manba jadvalida bir yo‘nalishli deb ko‘rsatilgan. |
Manbada ajratib ko‘rsatilgan ayrim RLWE unumdorlik misollari
- HEPCloudning takomillashtirilgan ko‘p yadroli versiyasi optimallashtirilgan dasturiy ta’minotga nisbatan 13× dan ortiq tezlashishni bildiradi.
- HEAWS, manbada berilgan tuzilishda soniyasiga 613 homomorphic multiplication bajaradi.
- HEAX, keng FHE parametr oralig‘ida 164–268× unumdorlik oshishini bildiradi.
- Medha, Xilinx Alveo U250da boshqa reconfigurable tezlatgichlarga nisbatan 2,4× pastroq latency bildiradi.
- F1, dasturiy realizatsiyalarga nisbatan geometric mean 5400× va muayyan holatda 17.000× gacha tezlashishni bildiradi.
- CraterLake, manbada F1ga nisbatan 11,2× tezlashish sifatida keltiriladi.
- Poseidon, ishlatilgan FHE benchmarkida GPU va ASICga nisbatan mos ravishda 10,6× va 8,7× tezlashishni bildiradi.
- FHEWga yo‘naltirilgan Bertels dizayni bootstrapping amalini 20 ms dan kam vaqtda bajaradi.
- MATCHA, cuHE GPU kutubxonasiga nisbatan TFHE throughputida 2,3× yaxshilanishni bildiradi.
- FPT, CPU asosidagi TFHE bootstrappingga nisbatan ikki–uch kattalik tartibida throughput yaxshilanishini bildiradi.
- CKKS–FHEW switching apparati Xilinx U280da dasturiy bazaviy chiziqqa nisbatan 365× switching samaradorligi oshishini bildiradi.
Bu sonlar turli tadqiqotlarning o‘z taqqoslashlaridir. Tezlashish koeffitsiyentlarining bazaviy chiziqlari, parametrlari va apparatlari bir xil bo‘lmagani uchun ularni gorizontal “g‘oliblar reytingi” sifatida ishlatib bo‘lmaydi.
Ilovaga yo‘naltirilgan FHE tezlatgichlari
Sharh FHE apparat tadqiqotlari faqat umumiy kriptografik primitivelarni tezlashtirishdan ilova darajasidagi hardware–software co-design tomonga o‘tayotganini qayd etadi. Uch asosiy ilova guruhi edge computing, federated learning va artificial intelligence sifatida ko‘rib chiqiladi.
| Soha | Dizayn | Manbada keltirilgan asosiy natija | Talqin chegarasi |
|---|---|---|---|
| Edge | HHEML | Mijoz encryption latencysida >50× kamayish/tezlashish va hardware throughputda taxminan 2× oshish. | Gibrid HE yondashuvi; og‘ir gomomorfik hisob serverga uzatiladi. |
| Edge | Pasta on Edge | Mavjud FHE public-key client acceleratorsga nisbatan 97× tezlashish. | 7 nm va 28 nm ASIC realizatsiyalari kontekstida. |
| Edge | Embedded SEAL/CKKS NTT | Sof dasturiy ta’minotga nisbatan taxminan 1000× tezlashish. | Maxsus NTT tezlatish ish yuki. |
| Federated learning | FedBit | Encryptionda taxminan ikki kattalik tartibida tezlashish va o‘rtacha communication overheadda %60,7 kamayish. | BFV asosidagi paketlash va FPGA birgalikda dizayni. |
| Federated learning | Yang va boshq. FL framework | Training encryption timeda %71 gacha kamayish. | Manba Paillierning partially homomorphic ekanini va bu misol FHE-FL muhandisligi uchun referens ekanini ochiq aytadi. |
| AI | CHAM | Matrix–vector multiplicationda 1800×, logistic regressionda 36×, Beaver triple ishlab chiqarishda 144×. | Ish yukiga xos FPGA taqqoslashlari. |
| AI | FHE-CGRA | An’anaviy CGRAga nisbatan 8,15× unumdorlik; FPGA FHE-CNN tezlatgichlariga nisbatan 16,48× energiya samaradorligi. | CGRA ma’lumot oqimi kontekstida. |
| AI | Cheetah | HE parametrlarini sozlash va operator scheduling bilan oldingi yondashuvlarga nisbatan 79× gacha tezlashish. | Private DNN inference uchun integratsiyalangan dizayn. |
| AI | HERACLES | FHE matematik amallarida 24-core Intel Xeon W7-3455ga nisbatan 1074×–5547×. | Intel 3 nm, 8192-way SIMD SoC kontekstida; bitta neural-network modeliga xos emas. |
FHE yadro arifmetikasining polinom halqasi
Manba zamonaviy asosiy oqim FHE sxemalarining yadro polinom arifmetikasini shu turdagi residue-class polynomial ring tuzilmalari orqali muhokama qiladi.
\(\mathbb{Z}_q\) koeffitsiyentlar \(q\) modulida hisoblanadigan butun sonlar sinfini; \(x\) polinom o‘zgaruvchisini; \(N\) polinom o‘lchamini bildiradi. \(x^N+1\) ga bo‘lish yuqori darajali polinom hadlarining ushbu munosabatga muvofiq kamaytirilishini anglatadi.
Tenglamaning fizik birligi yo‘q; bu matematik algebraik tuzilmadir. Apparat nuqtai nazaridan \(N\) ning kattalashishi ishlanadigan koeffitsiyentlar soniga, \(q\) ning kattalashishi esa koeffitsiyent arifmetikasining bit kengligiga ta’sir qiladi. Shu sababli polinom o‘lchami va modul tanlovi multiplier, xotira va ma’lumot yo‘li dizayniga bevosita aks etadi.
FHE Uchun Qaysi Polinom Ko‘paytirgich Qachon Tanlanadi?
Manbaning qaror diagrammasida NTT/INTT mos tub modul va transform shartlari bajarilganda ustun turadi, bu shartlar mos kelmaydigan tuzilmalarda esa polinom o‘lchami va apparat cheklovlariga qarab Toom–Cook yoki Karatsuba variantlari ko‘rib chiqiladi; bu sxema qat’iy universal tanlov qoidasi emas, sharh parametr–apparat mosligini tushuntirish uchun taqdim etgan muhandislik qaror doirasidir.
NTT/INTT va Toom–Cook/Karatsuba murakkabliklari
Manba NTT/INTT asosidagi polynomial multiplication uchun taxminiy murakkablikni quyidagicha beradi:
Bu yerda \(N\) polinomdagi koeffitsiyentlar soniga bog‘liq o‘lchamdir. Big-O ifodasi fizik vaqt birligi emas, muammo o‘lchami ortgani sari zarur amallar soni qanday masshtablanishini ko‘rsatuvchi asimptotik kattalikdir.
Toom–Cook-k uchun manbada berilgan umumiy murakkablik tuzilishi:
\(k\) polinom nechta kichik qismga bo‘linishini bildiradi. Karatsuba ikki qismli Toom–Cookning maxsus holatidir. Shuning uchun \(k=2\) bo‘lganda daraja \(\log_2 3\) bo‘ladi. Manba 3-rasm Karatsuba uchun taxminan \(O(N^{1.585})\), Toom–3 uchun taxminan \(O(N^{1.465})\) va Toom–4 uchun taxminan \(O(N^{1.404})\) masshtablarini ko‘rsatadi.
Kichikroq asimptotik daraja o‘z-o‘zidan real apparat tezroq degani emas. Evaluation/interpolation xarajati, DSP soni, xotira trafigi, pipeline tuzilishi va parallel ishlov berish imkoniyati umumiy latencyga ta’sir qilishi mumkin.
NTT uchun modul sharti
Manbaning TC/Karatsuba taqqoslashi NTT/INTT uchun amalda \(N\) ning ikki darajasi bo‘lishi va modul quyidagi shartni qanoatlantiruvchi tub son bo‘lishini ko‘rsatadi:
Bu shart transform uchun zarur ildiz tuzilmalarini qo‘llab-quvvatlaydigan modul tanlovi bilan bog‘liq. Apparat jihatidan NTT tez va parallellashtiriladigan polinom ko‘paytirish yo‘lini beradi; buning evaziga modul tanlovi, twiddle-factor xotirasi, butterfly bloklari va memory addressing murakkablashishi mumkin.
NTT/INTT asosidagi polynomial multiplier
Number Theoretic Transform (NTT) va inverse NTT (INTT) — polinom ko‘paytmasini transform sohasida point-wise multiplication amallariga aylantiradigan asosiy arifmetik tuzilmalardir. Manba ularni RLWE va NTRU asosidagi sxemalarning eng muhim hardware primitivelaridan biri sifatida baholaydi.
Negative Wrapped Convolution (NWC) nol bilan to‘ldirish sababli transform uzunligi \(2N\) ga chiqishini oldini olib, uni \(N\) da saqlaydi; buning evaziga NTTdan oldin va INTTdan keyin qo‘shimcha scaling-factor ko‘paytirishlari paydo bo‘ladi.
Pöppelmann dizayni uchun manba bitta polynomial multiplication xarajatini taxminan quyidagi ifoda bilan beradi:
Manbaning izohiga ko‘ra, qo‘shimcha \(5.5n\) hadining muhim qismi koeffitsiyentlarni yuklash, point-wise multiplication va post-scaling amallaridan kelib chiqadi. \(n=512\) uchun 10.014 cycle va 4 BRAM xabar qilingan; keyingi normallashtirilgan taqqoslashda 51,09 µs berilgan.
Du va hamkasblari polynomial multiplication xarajatini:
tuzilmasidan:
tuzilmasiga tushirgan; doimiy-factor saqlashni \(4N\) dan \(2.5N\) ga kamaytirib, %37,5 ROM tejamkorligini bildirgan. \(n=512\) uchun 8806 cycle va 26.913 multiplication xabar qilingan.
| Tadqiqot | Algoritm | Gibrid | Platforma | Ajratib ko‘rsatilgan afzallik / cheklov |
|---|---|---|---|---|
| Pöppelmann | GS NTT | Yo‘q | FPGA | Dinamik parametr sozlash; resurs sarfi va moslashuvchanlik cheklovi. |
| Xu | CG NTT | Ha | FPGA | Yuqori configurability va qisqa critical path; fixed radix va boshqaruv murakkabligi. |
| Roy | CT NTT | Ha | FPGA | Area–unumdorlik muvozanati; yuqori parametr bog‘liqligi. |
| Du | CT NTT | Ha | FPGA | Amal va saqlash optimallashtirishi; butterfly parallelligi cheklangan. |
| Pöppelmann | CT NTT | Ha | MCU | Past storage overhead va timing side-channel himoyasi; parametr masshtablanuvchanligi zaif. |
| Zhang | CG NTT | Ha | FPGA | Post-processing kamaytirilishi; katta twiddle-factor xotirasi. |
| Zeng | CG NTT | Ha | ASIC | Yuqori configurability va past resource use; yuqori parallellikda boshqaruv murakkabligi. |
| Chen | CG NTT | Ha | FPGA | Pipeline va oddiy boshqaruv; resource va scalability xarajati. |
| Banerjee | CG NTT | Ha | ASIC | Side-channelga chidamlilik va integratsiyalangan tuzilma; maxsus dizaynlarga nisbatan unumdorlik/resource cheklovi. |
| Longa | CG NTT | Ha | MCU | Mixed radix moslashuvchanligi; past throughput va xavfsizlik xatarlari. |
| Phap | CG NTT | Ha | FPGA | Conflict-free memory bilan area efficiency; modulus mosligi va throughput cheklovi. |
| Mandal | Winograd NTT | Yo‘q | FPGA | Kam modular multiplier va past latency; ko‘proq addition va boshqaruv murakkabligi. |
| Ramyavani | CG NTT | Yo‘q | FPGA | Past hardware utilization; faqat kichik polinomlarda optimallashtirilgan. |
| Bardia | CG NTT | Ha | FPGA | Juda past latency; yuqori parallel apparat/area xarajati. |
| Zhao | CG NTT | Ha | RISC-V | Load-store unit bilan zich integratsiya va ma’lumot uzatish yutug‘i; critical path/frequency cheklovi. |
Manba ParallelNTT misolida ML-KEM uchun 128 DSP, ML-DSA uchun 256 DSP ishlatib, oldingi FPGA dizaynlariga nisbatan forward/inverse transform latencysida 24× va 21× yaxshilanishni keltiradi. Bu misollar FHE sxemasi emas; NTT apparat arxitekturasining umumiy lattice-cryptography arifmetikasiga qo‘llanishini ko‘rsatadi.
Toom–Cook va Karatsuba
NTTning modul va polinom o‘lchami shartlariga qarshi Toom–Cook va Karatsuba kengroq parametr moslashuvchanligini ta’minlashi mumkin. Manba bahosiga ko‘ra, bu moslashuvchanlik ayniqsa resource-constrained yoki mos bo‘lmagan modul tuzilmasiga ega dizaynlarda muhim.
Karatsuba ikki qismli bo‘lishdan foydalansa, Toom–Cook-3 yoki Toom–Cook-4 yirikroq qismlarga ajratib, kamroq recursion darajasi va pastroq asimptotik multiplication count berishi mumkin. Buning evaziga evaluation, interpolation, recombination va notekis memory access bosqichlari apparatda murakkablashadi.
| Tadqiqot | Algoritm | Platforma | Ajratib ko‘rsatilgan afzallik / cheklov |
|---|---|---|---|
| Migliore | Karatsuba-3 | FPGA | Past latency; dynamic reconfiguration va throughput cheklangan. |
| Zhu | 8-level Iterative Karatsuba | FPGA + ASIC | Murakkablik/samaradorlik muvozanati; recursion overhead va side-channel yetishmasligi. |
| Wong | 1-level Karatsuba | FPGA | Negacyclic convolutionda yaxshi DSP foydalanishi; parallellik cheklangan. |
| Wang | TCPM, TC-2/3/4 | FPGA | Yuqori configurability va parallellik; boshqaruv mantiqi murakkab. |
| Karmakar | TC + Karatsuba + Schoolbook | Cortex-M4 | Juda kichik memory footprint va algoritmik moslashuvchanlik; yuqori murakkablik. |
| Mera | 3-level Karatsuba | AVX | Memory optimallashtirish va timing-attackga chidamlilik; boshqaruv/scalability cheklovi. |
| Kannwischer | TC-4 + multi-level Karatsuba | Cortex-M4 | Barqaror xotira va yaxshi unumdorlik; scalability va side-channel cheklovi. |
| Paksoy | TC-4 | Cortex-M4 | Yuqori versatility; scalability va side-channel cheklovi. |
| Mera | TC-4 | FPGA | Yuqori throughput va memory access efficiency; scalability cheklangan. |
| Ghosh | Striding TC-4 | ASIC | Past xotira va yaxshi moslashuvchanlik; parallel unumdorlik va algoritm moslashuvchanligi cheklangan. |
| Li va ishchi guruh | TC-3 | ASIC | Modulli va masshtablanuvchi dizayn; hardware resource yuqori. |
| Ma | TC-3 | FPGA | Latency yaxshilanishi; frequency va side-channel cheklovi. |
| Vasanthi | Hybrid Karatsuba | FPGA + ASIC | Area va latency optimallashtirishi; yuqori murakkablik va side-channel yetishmasligi. |
Manbada Migliore dizaynida \(n=1024\) uchun operation count 3583 dan 3071 ga kamaytirilgan, FFT taqqoslashi esa 4158 operation deb berilgan. Cheklangan embedded multiplier sharoitida Karatsuba uchun %58 gacha speedup keltiriladi.
Zhu ning degree-256 Karatsuba dizayni coefficient multiplication sonini 65.536 dan 6521 ga tushirgan va bitta multiplication amalini 81 cycleda yakunlagan. Manba bu dizayn uchun taxminan 3,16× tezlashishni keltiradi.
Wangning reconfigurable TCPM dizayni TC-2, TC-3 va TC-4 ni bitta arxitekturada qo‘llab-quvvatlaydi, post-processing arithmetic operation sonini kamida %33,33 kamaytiradi va Xilinx VC709da manba taqqoslashlariga ko‘ra 2,47×–50,11× tezlashishni bildiradi.
Karmakarning Cortex-M4 Saber multiplieri 256×256 polynomial multiplication uchun 65.459–66.692 cycle oralig‘ini bildiradi. Meraning keyingi tadqiqotida matrix-vector polynomial multiplication turli platformalarda %12–37 yaxshilangan, AVX2da %29,3–36,6 yutuq va Cortex-M4 memory ishlatilishida 2,6–5,7 KB kamayish keltirilgan.
Bu Saber misollari FHE emas, post-kvant key encapsulation kontekstidan kelgani unutilmasligi kerak. Sharh ularni Toom–Cook/Karatsuba hardware datapath dizayniga oid umumiy arifmetik misollar sifatida ishlatadi.
Nega butun sonli modulli ko‘paytirgich alohida yadro komponent?
Polynomial multiplier faqat koeffitsiyentlarni ko‘paytirmaydi; oraliq va yakuniy koeffitsiyentlar belgilangan modul ostida ushlab turilishi kerak. Shu sababli integer modular multiplier ham polynomial multiplier ichida, ham FHEnining ko‘plab boshqa arifmetik bosqichlarida asosiy apparat blokidir.
| Ko‘paytirgich turi | Misol tadqiqot | Kontekst / platforma | Manbada ajratib ko‘rsatilgan muhandislik muvozanati |
|---|---|---|---|
| Barrett | Öztürk | LTV / FPGA | Umumiy va samarali modular reduction; keng bit uzunligida critical path va resource xarajati oshishi mumkin. |
| Barrett | Roy | BFV / FPGA | Area va speed orasida muvozanatli resource-efficient tuzilma. |
| Barrett | Hao | Toom–Cook / ASIC | Yuqori area efficiency. |
| Shoup | Riazi | NTT / CPU+FPGA | Turli holatlar uchun optimallashtirilgan; ikki marta instantiation hardware overhead keltirishi mumkin. |
| Shoup | Kim | CKKS / FPGA | Past resource va latency; operandlardan biri constant bo‘lishi kerak. |
| Montgomery | Mert | BFV / CPU+FPGA | Kamroq modular reduction; Montgomery domain o‘zgartirish qo‘shimcha xarajat tug‘diradi. |
| Montgomery | Li | IP-MMM / FPGA | Qisqa data path; high-performance va arzon IoT uchun mos deb keltiriladi. |
| Montgomery | Roy | HRKM + OSBM / FPGA+ASIC | Bir-cycle ishlash, past resource va latency. |
| Montgomery | Wang | PPMM / FPGA | Past cycle count va yuqori operating frequency. |
| Solinas prime | Cao | FFT/IFFT / FPGA | Maxsus modul tuzilmasi bilan reduction osonlashadi; ishlatiladigan modul shakli cheklangan. |
| Solinas prime | Zijlstra | NTT/INTT / FPGA | Shift/add/subga tayangan oddiy hardware; maxsus modul talab qiladi. |
Manbaning umumiy bahosiga ko‘ra Barrett va Montgomery umumiy modullar hamda variable–variable multiplication uchun kengroq qo‘llanish imkoniga ega. Shoup yondashuvi variable–constant multiplication uchun samarali bo‘lishi mumkin, biroq doimiy operand talabi umumiylikni cheklaydi. Solinas va maxsus-prime tuzilmalari juda tez reduction berishi mumkin, ammo mos modul tanlovini toraytiradi.
Nega Bootstrapping FHE Apparatida Muhim?
Bootstrapping ciphertext ichida to‘plangan shovqin yoki hisoblash chuqurligi chegarasini yangilab, leveled FHEni nazariy jihatdan cheksiz sxema chuqurligiga yaqinlashtiradigan amal bo‘lgani uchun muhim hisoblanadi; biroq BGV/BFV/CKKS tomonida katta NTT/INTT, RNS o‘zgartirish, key switching, rotation va modulus amallari, FHEW/TFHE tomonida esa blind rotation, accumulator yangilanishi va katta bootstrapping-key trafigi sababli apparatdagi eng og‘ir amallardan biridir.
Leveled FHE bilan haqiqiy FHE o‘rtasidagi muhandislik farqi
Leveled FHE oldindan belgilangan cheklangan hisoblash chuqurligiga yetadigan parametrlar bilan ishlashi mumkin. Sxema chuqurligi ortgani sari ciphertext shovqini va modul byudjeti chegaraga yaqinlashadi. Bootstrapping ciphertextni gomomorfik tarzda “yangilab”, ko‘proq hisoblashni davom ettirishga imkon beradi.
Biroq bootstrapping apparat xarajati juda yuqori. CKKS/BFV/BGV uchun high-throughput NTT/INTT pipeline, conflict-free multi-bank memory, rotation/key-switching ma’lumot oqimi, katta evaluation-key saqlash va ayrim holatlarda kalitni zarurat bo‘lganda qayta yaratish muhimlashadi.
FHEW/TFHE tomonida esa blind rotation, homomorphic accumulator, polynomial–vector/matrix multiplication va bootstrapping key bandwidth ajralib turadi. Shu sababli bir xil bootstrapping accelerator arxitekturasi CKKS va TFHE uchun bevosita bir xil tarzda ishlatilishi kutilmaydi.
Tadqiqot Usuli va Natijalari
Sharh usuli
Maqola o‘z usulini narrative review deb belgilaydi. Mualliflar apparatga yo‘naltirilgan adabiyot qidiruvini amalga oshirgan.
| Element | Manbada keltirilgan ma’lumot |
|---|---|
| Vaqt oralig‘i | 2009–2026; ayniqsa 2020 yildan keyingi yangi tadqiqotlarga e’tibor qaratilgan. |
| Ma’lumot bazalari | IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar, IACR ePrint. |
| Asosiy qidiruv atamalari | fully homomorphic encryption, FHE hardware implementation, FHE accelerator, FPGA/ASIC accelerator, polynomial multiplier, NTT/INTT, Toom–Cook, Karatsuba, modular multiplier. |
| Screening | Duplicate yozuvlar chiqarilgan; title, abstract va full text bo‘yicha saralash o‘tkazilgan. |
| Kiritilgan asosiy tadqiqot turlari | FHE scheme, hardware accelerator architecture, polynomial multiplication va integer modular multiplication bilan bevosita bog‘liq tadqiqotlar. |
| Chiqarish | Faqat software libraryga yo‘naltirilgan tadqiqotlar, hardware implementationni o‘z ichiga olmaydigan application-level tadqiqotlar va aloqasiz cryptographic hardware. |
| Tashkillashtirish | FHE scheme evolution, accelerator type, core arithmetic component va implementation platform. |
Usulda xabar qilinmagan unsurlar
- Dastlab topilgan umumiy yozuvlar soni berilmagan.
- Duplicatelardan keyin nechta yozuv qolgani xabar qilinmagan.
- Title/abstract va full-text bosqichlarida nechta tadqiqot chiqarilgani tushuntirilmagan.
- Yakuniy kiritilgan tadqiqotlar soni usul bo‘limida bitta umumiy son sifatida berilmagan.
- PRISMA oqim diagrammasi mavjud emas.
- Oldindan ro‘yxatdan o‘tkazilgan review protocol ma’lumoti xabar qilinmagan.
- Manba tadqiqotlari uchun formal risk-of-bias yoki sifat ballash tizimi xabar qilinmagan.
- Meta-analysis bajarilmagan.
Shu sababli tadqiqot keng va tuzilmali adabiyot ko‘rib chiqishini taqdim etsa-da, natijalarni miqdoriy meta-analysis natijasi sifatida talqin qilish kerak emas.
Sharh aniqlagan uchta asosiy mavjud muammo
- Tarqoq maxsus apparat bloklari: NTT/INTT, modular arithmetic, modulus raising/reduction va rescaling kabi turli primitivlar uchun alohida tezlatgichlardan foydalanish umumiy processing unitlarning takrorlanishi va hardware utilization pasayishiga olib kelishi mumkin.
- Sxemaga haddan tashqari ixtisoslashuv: Ko‘plab tezlatgichlar faqat muayyan BFV, CKKS, TFHE yoki boshqa FHE oilasi uchun optimallashtiriladi; fixed datapath boshqa parametr yoki algoritmlarga moslashishni cheklaydi.
- Ilova talablariga to‘liq mos kelmaslik: Neural-network training, multi-party secure computation va federated learning kabi ish yuklari latency, depth, precision, memory, communication va power nuqtai nazaridan umumiy FHE acceleratordan boshqa talablarni qo‘yadi.
Kelajak yo‘nalishi 1 — Qayta konfiguratsiyalanuvchi va ulashiladigan accelerator
Mualliflar kelajak apparati operator-specific yadrolar o‘rniga qatlamli reconfigurable architecturega yo‘nalishi kerakligini taklif qiladi. Quyi qatlamda modular arithmetic, butterfly array, NTT/INTT, point-wise multiplier, RNS channel va on-chip memory bank kabi umumiy bloklar turli sxemalar tomonidan ulashilishi mumkin.
O‘rta qatlamda programmable modulus-reduction mode, flexible radix, microcoded instruction scheduling va parametrik \(N\), \(q\), RNS base hamda decomposition base qo‘llab-quvvatlashi ko‘zda tutiladi.
Yuqori qatlamda esa BFV base extension/scaling, CKKS rescaling/approximate modulus conversion va TFHE accumulator update kabi sxemaga xos oqimlarni microprogram yoki maxsus functional extension sifatida saqlash taklif etiladi.
Kelajak yo‘nalishi 2 — Bootstrappingga yo‘naltirilgan accelerator
Sharh finite-depth amallar uchun optimallashtirilgan tezlatgichlardan unbounded-depth computationni bevosita qo‘llab-quvvatlaydigan bootstrapping accelerators tomon o‘tishni muhim tadqiqot yo‘nalishi deb hisoblaydi.
Leveled sxemalarda large-parameter NTT/INTT, RNS base conversion, key switching, slot rotation va rescaling; bit-bootstrappable sxemalarda blind rotation, accumulator va key bandwidth turli apparat yo‘nalishlarini yuzaga keltiradi. Manba ayrim bloklarni umumlashtirish mumkinligini, ayrim mexanizmlar esa sxemaga xos qolishi kerakligini ta’kidlaydi.
Kelajak yo‘nalishi 3 — Ilovaga asoslangan hardware–software co-design
Mualliflar kelajak accelerator dizayni faqat kriptografik primitivega emas, balki maqsad application workloadga ko‘ra ham amalga oshirilishi kerakligini ta’kidlaydilar.
Encrypted neural-network inference uchun SIMD packing, rotation, key switching, matrix-vector multiplication, convolution, nonlinear approximation va kerak bo‘lganda bootstrapping birgalikda optimallashtirilishi kerak.
Federated learningda muammo encryption/decryptiondan kengroq: secure aggregation, ciphertext packing, communication compression, homomorphic matrix–vector computation va cross-institution feature interaction bitta pipeline ichida ko‘rib chiqilishi kerak.
Edge va IoT tomonida esa low area, low power, kichik storage footprint, compact parameter set, lightweight modular arithmetic va edge–cloud task partitioning ustuvor bo‘ladi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- FHEnining amaliy apparat xarajatida polynomial multiplication va modular multiplication markaziy rol o‘ynaydi.
- BFV va CKKSda RNS va katta polinom arifmetikasi apparat parallelligining asosiy masalalaridandir.
- FHEW/TFHE turli ciphertext va bootstrapping tuzilmalari sababli turli accelerator datapathlariga ehtiyoj sezadi.
- RLWE asosidagi accelerator tadqiqotlari so‘nggi yillarda scheme-level va system-level co-design yo‘nalishiga siljimoqda.
- NTT/INTT juda kuchli polynomial multiplication variantidir, biroq modulus va twiddle-factor/memory talablari mavjud.
- Toom–Cook/Karatsuba moslashuvchanroq modulus/polynomial shartlari va mos resource sharoitlarida muhim muqobildir.
- Barrett, Montgomery, Shoup va Solinas ko‘paytirgichlari o‘rtasida efficiency va modulus/operand flexibility orasida asosiy trade-off mavjud.
- Bootstrappingni qo‘llab-quvvatlash kelajak FHE accelerators uchun asosiy dizayn maqsadlaridan biridir.
- Application-specific hardware–software co-design umumiy primitive tezlatishdan yanada yaxlit tizim optimallashtirish tomon yo‘nalishni ko‘rsatadi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- Sharh bitta FHE accelerator barcha boshqalardan universal tarzda yaxshiroq ekanini ko‘rsatmaydi.
- Turli maqolalardagi speedup koeffitsiyentlari umumiy test tizimida o‘lchanmagani uchun ularni to‘g‘ridan-to‘g‘ri bir xil masshtabda saralab bo‘lmaydi.
- Sharh o‘zining yangi FPGA yoki ASIC prototipini yaratmaydi.
- Sharh o‘z energy, latency yoki area benchmark ma’lumotlar to‘plamini yaratmaydi.
- FHE barcha tizim xavfsizligi muammolarini avtomatik hal qiladi degan xulosa chiqarib bo‘lmaydi; ushbu sharhning asosiy yo‘nalishi hardware performancedir.
- ML-KEM, ML-DSA, Saber yoki NTRU Prime misollarini FHE sxemasi deb xulosa qilib bo‘lmaydi; manba ularni umumiy arithmetic hardware misollari sifatida ishlatadi.
- Paillier misoli to‘liq gomomorfik emas; manba uni federated-learning hardware engineering uchun referens misol sifatida aniq ajratadi.
- Har bir ilova uchun NTT yoki Karatsuba yagona to‘g‘ri polynomial multiplier degan xulosa chiqarib bo‘lmaydi.
Sharhning qayta ishlab chiqarish chegaralari
Manba qidiruv o‘tkazilgan akademik ma’lumot bazalari, vaqt oralig‘i, asosiy kalit so‘zlar va kiritish/chiqarish yondashuvini xabar qiladi. Bu oddiy narrative adabiyot xulosasiga nisbatan kuzatilishi osonroq qidiruv doirasini beradi.
Biroq har bir ma’lumot bazasi uchun qidiruv satrlarining to‘liq Boolean shakli, qidiruvning aniq sanalari, yozuvlar soni, duplicate soni, exclusion reason taqsimoti va formal quality assessment mavjud emas. Shu sababli boshqa tadqiqotchining ayni maqolalar havzasini bir xil tarzda qayta yaratishi uchun zarur bo‘lgan barcha systematic-review metadata mavjud emas.
Bundan tashqari, sharhda keltirilgan unumdorlik natijalari mualliflar qayta benchmark qilgan ma’lumotlar emas; ular asl maqolalarda xabar qilingan natijalardir. Apparat jarayoni, FPGA oilasi, soat chastotasi, FHE parametrlari, security level, software baseline va workload turlicha bo‘lgani uchun taqqoslovchi jadvallar ko‘proq arxitektura tendensiyalarini tushunish uchun ishlatilishi kerak.
Manba va Usul Haqida Izoh
Asl sarlavha: A Brief Survey on Hardware Implementation of Fully Homomorphic Encryption
Mualliflar: Yang Su; Kaixuan Zhou; Weidong Zhong; Jianfei Wang; Jia Hou; Chen Yang.
Mualliflar tartibi: Yang Su birinchi, Kaixuan Zhou ikkinchi, Weidong Zhong uchinchi, Jianfei Wang to‘rtinchi, Jia Hou beshinchi, Chen Yang oltinchi muallif.
Mas’ul muallif: Weidong Zhong.
Muassasa 1: School of Cryptography Engineering, Engineering University of People’s Armed Police, Xi’an 710086, China.
Muassasa 2: School of Microelectronics, Xi’an Jiaotong University, Xi’an 710049, China.
Teng hissa: Manbada teng birinchi mualliflik yoki teng hissa belgisi mavjud emas.
Jurnal: Cryptography.
Nashriyot: MDPI, Basel, Switzerland.
Jild / son / maqola: 10(4), 49.
Sahifalar soni: 34.
DOI: 10.3390/cryptography10040049.
Yuborilgan sana: 3 iyun 2026.
Qayta ko‘rib chiqilgan sana: 4 iyul 2026.
Qabul qilingan sana: 8 iyul 2026.
Nashr sanasi: 13 iyul 2026.
Maqola turi: Review; manba o‘z usulini narrative review deb ta’riflaydi.
Taqriz: Cryptography uchun rasmiy MDPI materiallarida single-blind peer review ko‘rsatilgan.
Preprint holati: Qayta ishlangan hujjat nashr etilgan jurnal versiyasidir; ushbu Verianla mazmunida preprint ishlatilmagan.
Litsenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Rasmiy nashr havolasi: DOI 10.3390/cryptography10040049 orqali MDPI Cryptography maqola yozuvi.
Akademik muharrirlar: Ki-Hyun Jung va Luis Javier García Villalba.
Kalit so‘zlar: fully homomorphic encryption (FHE); hardware implementation; accelerator; polynomial multiplier; modular multiplier.
Sharh davri: 2009–2026; ayniqsa 2020 yildan keyingi adabiyotga e’tibor qaratilgan.
Qidirilgan manbalar: IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar va IACR ePrint.
Kiritish yo‘nalishi: FHE schemes, hardware accelerator architecture, polynomial multiplication va integer modular multiplication.
Chiqarish yo‘nalishi: Faqat software library tadqiqotlari, hardware implementationni o‘z ichiga olmaydigan application-level tadqiqotlar va aloqasiz cryptographic hardware.
Yangi eksperimental ma’lumot: Yo‘q. Manba yangi ma’lumot yaratmaganini yoki tahlil qilmaganini aniq aytadi; natijalar nashr qilingan adabiyot va ochiq nazariy modellardan olingan.
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildiradi.
Ma’lumotlardan foydalanish imkoniyati: Yangi ma’lumot yaratilmagani uchun data sharing ushbu sharh uchun tatbiq etilmaydi.
Mualliflar hissasi: Rasmiy MDPI yozuviga ko‘ra konseptualizatsiya Yang Su va Kaixuan Zhou; usul Yang Su va Kaixuan Zhou; supervision va resources Weidong Zhong; formal analysis, visualization va investigation Jianfei Wang hamda Jia Hou; review/editing va project administration Chen Yang tomonidan bajarilgan. Barcha mualliflar nashr qilingan versiyani o‘qib, qabul qilgani ko‘rsatiladi.
Etika qo‘mitasi / inson-hayvon tadqiqoti: Tadqiqot original inson yoki hayvon ma’lumotini yaratmaydigan adabiyot sharhidir; manbada alohida inson/animal experimental protocol xabar qilinmagan.
Manba rasmlari: 1-rasm FHE cloud privacy modelini, 2-rasm hardware accelerator classification frameworkni, 3-rasm FHE parameter/polynomial multiplier selection qarorini ko‘rsatadi. Verianlada ularning uchtasi ham manba bog‘lanishlaridan mustaqil inline SVG sifatida qayta qurilgan.
Manba jadvallari: 1-jadval BFV/CKKS/FHEW-TFHE xususiyatlarini; 2-jadval barcha FHE acceleratorsni; 3-jadval NTT/INTT polynomial multipliersni; 4-jadval Karatsuba/Toom–Cook polynomial multipliersni; 5-jadval integer modular multipliersni taqqoslaydi.
Asosiy uslubiy cheklov: Tadqiqot narrative reviewdir. Ma’lumot bazalari, vaqt oralig‘i va screening mantiqi xabar qilingan bo‘lsa-da, PRISMA oqimi, umumiy yozuv/kiritilgan tadqiqotlar soni, ro‘yxatdan o‘tgan protokol, formal sifat baholashi va meta-analysis xabar qilinmagan.
Taqqoslash cheklovi: Sharhda keltirilgan speedup, latency, throughput, area va energy qiymatlari turli asl tadqiqotlardan olingan. Turli hardware technology, FPGA/ASIC/CPU, clock frequency, security parameter, polynomial degree, modulus, workload va software baseline ishlatilgani sababli qiymatlarni umumiy benchmark natijasi kabi bevosita tartiblash kerak emas.
Qamrov izohi: Sharh ayrim FHE bo‘lmagan post-kvant kriptografiya tadqiqotlarini polynomial multiplier yoki modular arithmetic hardware dizayniga misol sifatida ishlatadi. Bu misollar FHE sxemasi degan xulosa chiqarilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan