


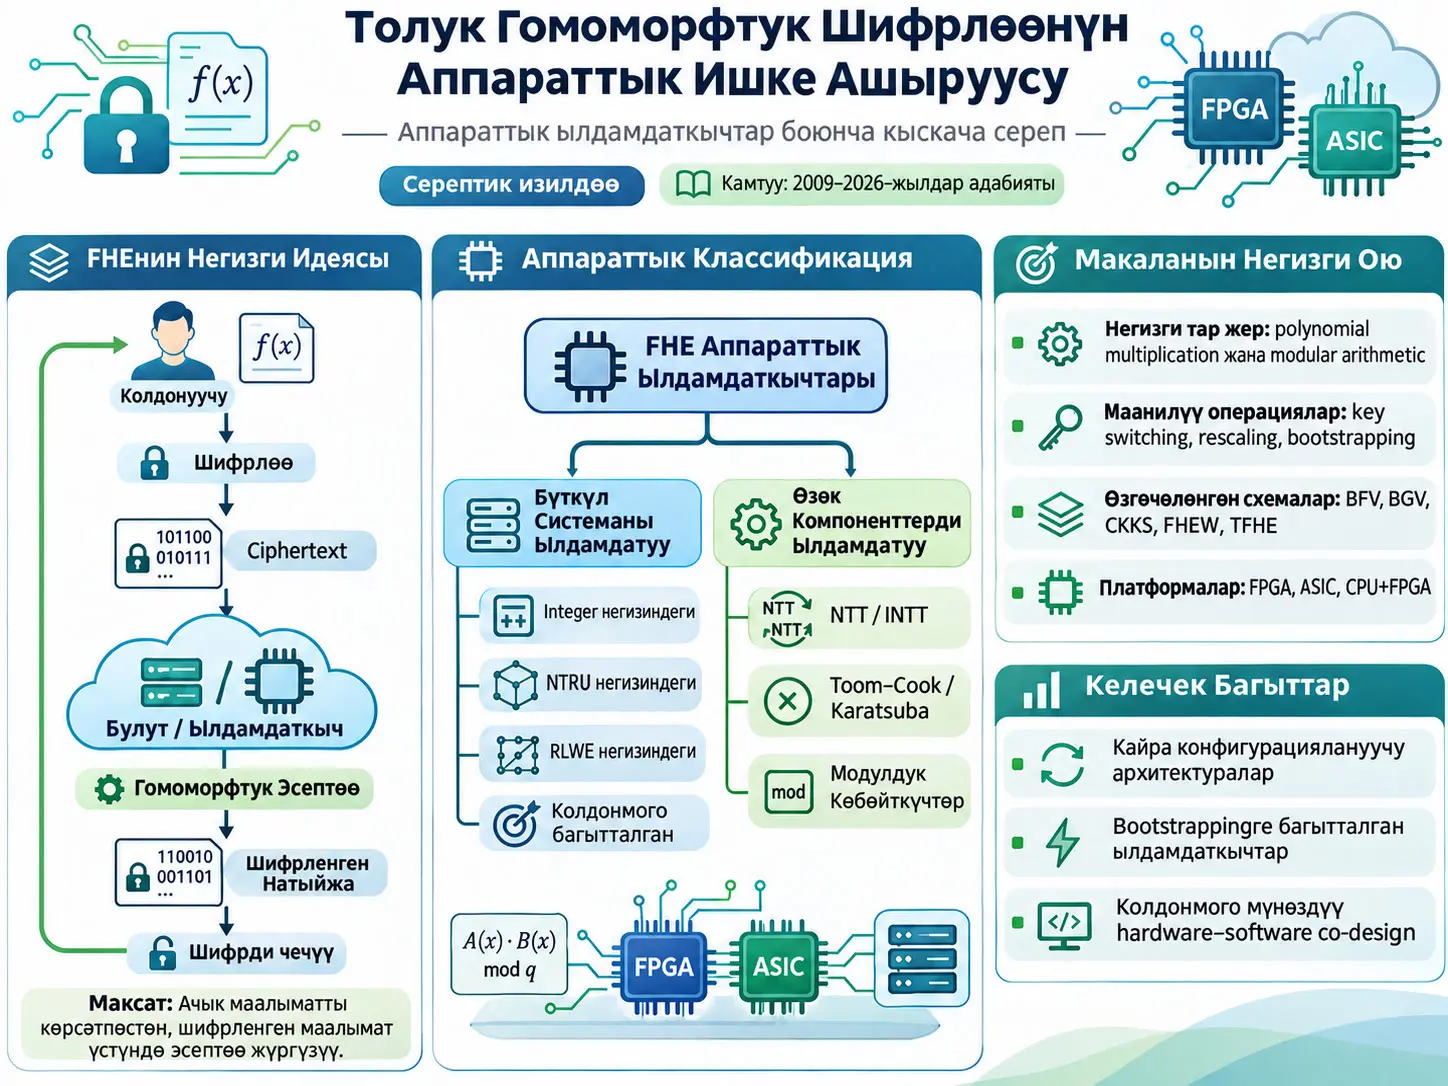
Толук Гомоморфтук Шифрлөө (Fully Homomorphic Encryption, FHE) — шифрленген маалыматты адегенде ачык текстке айландырбастан, белгилүү эсептөөлөрдү түздөн-түз ciphertext үстүндө аткарууга жана алынган шифрленген натыйжа ыйгарым укуктуу колдонуучу тарабынан чечмеленгенде ачык маалыматта жүргүзүлгөн тиешелүү эсептөө менен бирдей натыйжа берүүгө багытталган шифрлөө ыкмасы. Бул изилдөө жаңы FHE алгоритмин же тездеткичти сунуштабайт; 2009–2026 аралыгында FHE схемаларынын өнүгүшүн, бүтүндөй FHE системасын тездеткен аппараттык архитектураларды, полиномдук көбөйткүчтөрдү жана бүтүн сандуу модулдук көбөйткүчтөрдү караган аппараттык багыттагы narrative review сунуштайт. Обзордун негизги жыйынтыгы — FHE аппаратынын өндүрүмдүүлүгүн жөн гана ылдамыраак көбөйтүү схемасын түзүү менен чечүүгө болбойт; полиномдук арифметика, bootstrapping, key switching, эс тутумдагы маалымат кыймылы, кайра конфигурациялануучулук жана колдонмого мүнөздүү маалымат агымы бирге каралышы керек.
Авторлордун баалоосу боюнча RLWE негизиндеги FHE тездеткичтери күчтүүрөөк стандартташтырылган тор негиздери жана ийкемдүү алгебралык түзүлүштөрү себептүү учурдагы аппараттык изилдөөлөрдүн басымдуу багыттарынын бирине айланган. BFV, BGV жана CKKS сыяктуу leveled FHE схемалары чоң полиномдор, Residue Number System (RNS), polynomial multiplication, relinearization, key switching жана modulus башкаруусу менен иштесе; FHEW/TFHE үй-бүлөсү кичирээк модулдарды жана бит деңгээлиндеги bootstrappingди колдонот. Бул айырмачылыктар бир туруктуу тездеткичтин бардык FHE алгоритмдеринде бирдей натыйжалуу болушун кыйындатат.
Обзор учурдагы тездеткичтердин олуттуу бөлүгү белгилүү схемаларга же белгилүү өзөктүк операцияларга ылайык адистештирилгенин; бул өндүрүмдүүлүктү жогорулатканы менен жалпы аппараттык ресурстарды кайра пайдаланууну жана алгоритмдер аралык ийкемдүүлүктү чектерин баса белгилейт. Авторлор келечекте бөлүшүлө турган modular arithmetic блоктору, кайра конфигурациялануучу NTT/INTT өзөктөрү, программалануучу маалымат агымы, bootstrapping багытындагы архитектуралар жана колдонмо–алгоритм–аппарат биргелешкен долбоорлоосу маанилүү болорун болжолдошот.
Булакта келтирилген өтө жогорку ылдамдануу коэффициенттери бир эле жалпы benchmarkка таандык эмес. F1, HEAX, Poseidon, CHAM, HERACLES жана башка долбоорлор ар башка FHE схемаларын, аппараттык технологияларды, параметрлерди, жумуш жүктөрүн жана программалык базалык деңгээлдерди колдонушат. Ошондуктан, мисалы, 1000×, 5000× же 17.000× деген ылдамдануу маанисин башка саптагы ылдамдануу мааниси менен түз салыштырып, универсалдуу өндүрүмдүүлүк рейтингин түзүүгө болбойт.
Изилдөөнүн өзөктүк арифметика бөлүмүндө Saber, ML-KEM, ML-DSA жана NTRU Prime сыяктуу FHE эмес, торго негизделген криптография мисалдары да каралат. Булар “FHE схемасы” катары берилген эмес; NTT/INTT, Karatsuba жана Toom–Cook сыяктуу жалпы полиномдук арифметиканын аппараттык ишке ашырылышына байланышкан инженердик мисалдар катары колдонулган.
FHEнин негизги идеясы эмнеде?
Классикалык тышкы эсептөө моделинде маалымат ээси сезимтал маалыматын серверге ачык түрдө жөнөтсө, сервер эсептөөнү оңой аткара алат, бирок купуялуулук жоголушу мүмкүн. FHEнин максаты — сервер маалыматтын ачык мазмунун көрбөстөн ciphertext үстүндө эсептөөнү аткара алышы. Колдонуучу адегенде маалыматты өз ачкычы менен шифрлейт, булут ciphertextти гана иштетет жана натыйжа кайрадан шифрленген түрдө колдонуучуга кайтарылат.
Бул түзүлүштөгү “гомоморфтук” деген сөз ачык маалымат үстүндө жүргүзүлгөн математикалык операциялар менен шифрленген өкүлчүлүк үстүндө жүргүзүлгөн операциялардын ортосунда натыйжа жагынан сакталган байланыш бар экенин билдирет. FHEнин инженердик маселеси бул операциялардын теориялык жактан мүмкүн болушунан көбүрөөк, практикалык түрдө канча эсептөө, эс тутум, өткөрүү жөндөмү жана аппараттык аянт талап кылганында.
Бул обзор эмне үчүн керек болгон?
Булак мурунку FHE обзорлорунун олуттуу бөлүгү математикалык принциптерге, коопсуздук касиеттерине жана программалык китепканаларга басым жасаганын билдирет. Аппараттык тездетүүнү караган айрым иштер белгилүү жылдар менен гана чектелген, же жалпы accelerator architecture деңгээлин гана изилдеген, же CKKS bootstrapping сыяктуу тар субпроблемага гана багытталган деп айтылат.
Авторлордун максаты бул боштукту үч катмарда толтуруу: FHE схемаларынын өнүгүшүн хронологиялык баалоо, бүт FHE системасына багытталган тездеткичтерди классификациялоо жана өндүрүмдүүлүктү аныктаган polynomial multiplier менен modular multiplier сыяктуу майда деңгээлдеги өзөктүк аппараттык блокторду өзүнчө салыштыруу.
Биринчи муундагы FHE
Булак биринчи муундун башталышын Gentryнин 2009-жылдагы Gen09 түзүлүшү менен байланыштырат. Gen09 идеалдуу торлордун үстүндө курулган, гомоморфтук кошууну жана көбөйтүүнү бирге колдогон жана ciphertext ызы-чуусун көзөмөлдөп туруу үчүн bootstrapping колдонгон биринчи жалпы FHE ыкмасы катары каралат.
Кийинки SV10, SS10, GH11 жана GHS12a иштер ciphertext/ачкыч өлчөмү, decryption circuit тереңдиги же bootstrapping натыйжалуулугу сыяктуу маселелерди жакшыртууга аракет кылган. Обзордун баалоосу боюнча бул биринчи муундагы схемалар теориялык жактан маанилүү болгону менен, алгебралык түзүлүштөрдүн татаалдыгы, чоң ciphertextтер жана bootstrappingдин жогорку баасы практикалык колдонууну чектеген.
Экинчи муундагы FHE
Экинчи муун LWE/RLWE жана полином шакектери үстүндө иштелип чыккан схемалар менен байланышат. BV11a/BV11b, BGV, BFV жана CKKS бул доордун негизги мисалдары.
KeySwitching — ciphertext функционалдык жактан ошол эле ачык маалыматты билдирип кала берип, башка ачкыч/өкүлчүлүк астында колдонулушуна мүмкүнчүлүк берген өзгөртүү механизми. Булакта айрыкча ciphertext өлчөмүн же баалоо ачкычтарын башкарууда маанилүү роль ойнойт.
ModulusSwitching — ciphertext модулун көзөмөлдөнгөн түрдө өзгөртүп, ызы-чуу жана эсептөө чыгымын башкарууга жардам берген ыкма.
Relinearization — гомоморфтук көбөйтүүдөн кийин чоңойгон ciphertext түзүлүшүн кайра башкарууга ыңгайлуураак формага өткөрүү үчүн колдонулган операция.
Rescaling — өзгөчө CKKSтин болжолдуу сандык эсептөө моделинде масштабды жана модулду башкаруунун бир бөлүгү. Булак CKKSти реал сандарды болжолдуу эсептөөгө ылайык FHE схемасы катары карайт.
Үчүнчү муундагы FHE
Булак үчүнчү мезгилди GSW, FHEW жана TFHE сыяктуу bit-bootstrappable схемалар менен байланыштырат. Бул түзүлүштөрдө бир-биттик же логикалык баалоо, blind rotation жана homomorphic accumulator сыяктуу механизмдер өзгөчө орунда.
FHEW үчүн bootstrapping убактысы бир секунддан төмөн түшүрүлгөнү, TFHE тарапта кийинчерээк жүргүзүлгөн иштер менен 52 ms жана андан соң 13 ms деңгээлине чейин жакшыртуулар билдирилгени айтылат. Бул тарыхый жактан ар башка иштердин жыйынтыктары; бир эле аппаратка же бирдей параметрлер топтомуна таандык жалгыз эксперимент эмес.
BFV, CKKS жана FHEW/TFHE ортосундагы негизги айырмачылыктар
| Өзгөчөлүк | BFV | CKKS | FHEW / TFHE |
|---|---|---|---|
| Түрү | Leveled FHE | Leveled FHE | Bit-bootstrappable |
| Өзөктүк компонент | Гомоморфтук көбөйтүү жана relinearization | Гомоморфтук көбөйтүү жана relinearization | Homomorphic accumulator |
| Параллелдүү ыкма | RNS | RNS | Булактагы 1-таблицада “None” |
| Модулду өзгөртүү | Base extension / scaling | Болжолдуу modulus up/down conversion | Булактагы 1-таблицада “None” |
| Өзөктүк операция | Polynomial multiplication | Polynomial multiplication | Polynomial matrix multiplication |
| Негизги арифметика | Бүтүн сан көбөйтүү жана модулдук операциялар | Модулдук операциялар | Модулдук операциялар |
| Полином өлчөмү N | ≥ \(2^{12}\) | ≥ \(2^{12}\) | \(2^{10}\) же \(2^{11}\) |
| \(\log_2 Q\) | ≥100 | ≥100 | ≤50 |
| Модул тандоо | Жөнөкөй сан | Жөнөкөй сан | 2нин даражасы же жөнөкөй сан |
Булак ошондой эле leveled BFV/CKKS схемаларында bootstrapping керек болгондо полином даражасы \(2^{16}\)–\(2^{17}\) деңгээлине чейин өсүшү жана ciphertext модулу жүздөгөн, ал тургай миңдеген битке жетиши мүмкүн экенин белгилейт. Бул туруктуу милдеттүү параметрлер эмес, иште талкууланган типтүү жогорку ресурс талаптарын билдирет.
FHE Аппараттык Тездетүүнүн Негизги Тар Жери Эмне?
Обзорго ылайык негизги тар жер — гомоморфтук баалоо, айрыкча чоң полином өлчөмдөрүндө жана кең модулдарда кайталанган polynomial multiplication, modular arithmetic, key switching жана bootstrapping операциялары; ошондуктан жалпы өндүрүмдүүлүктү эсептөө блокторунун ылдамдыгы гана эмес, эс тутумга жетүү, маалымат кыймылы, RNS параллелдүүлүгү жана аппараттык ресурстарды кайра пайдалануу да аныктайт.
RNS эмне үчүн колдонулат?
Residue Number System (RNS) — чоң модул астында аткарыла турган эсептөөнү кичирээк модулдардан турган бир нече канал боюнча жүргүзүүгө мүмкүндүк берген өкүлчүлүк ыкмасы. Булак BFV жана CKKS сыяктуу leveled FHE схемаларынын чоң ciphertext модулдарын кичи модулдарга бөлүп, параллелдүү иштетүү мүмкүнчүлүгүн RNSтин негизги аппараттык артыкчылыгы катары түшүндүрөт.
Бул артыкчылык кошумча base conversion, modulus conversion жана маалымат кыймылын да талап кылышы мүмкүн. Демек, RNS “эсептөөнү бекер тездеткен” ыкма эмес; чоң бүтүн сан арифметикасын параллелдүү кичи-модулдук операцияларга ыңгайлуураак түрдө айланткан архитектуралык тандоо.
FHE аппараттык тездеткичтеринин классификациясы
Integer негизиндеги FHE тездеткичтери
Алгачкы integer негизиндеги FHE тездеткичтеринде негизги максат өтө кең бүтүн сандарды көбөйтүүнү тездетүү болгон. Булак FFT негизиндеги Schönhage–Strassen жана Comba сыяктуу көбөйткүчтөрдү бул мезгилдин негизги аппараттык ыкмасы катары көрсөтөт.
Wang жана кесиптештери Stratix-V үстүндө курган 64K чекиттүү FFT кыймылдаткычы 100 MHzде NVIDIA C2050 үстүндөгү ошол эле FFT алгоритмине салыштырмалуу болжол менен эки эсе ылдамдыкка жеткени айтылат. Doröz жана кесиптештеринин 90 nm ASIC дизайнында encryption 18,1 ms, decryption 16,1 ms жана recryption 3,1 s деп билдирилген; дизайн 30 миллион дарбазадан кичине экени көрсөтүлгөн.
Булактын жалпы баалоосу боюнча бул долбоорлор белгилүү параметрлерде ийгилик көрсөткөнү менен, ачкыч өлчөмдөрү жана кең бүтүн сан талаптары өскөн сайын масштабдуулук, эс тутум басымы жана алгоритмдик ыңгайлашуучулук маселелери күчөйт.
NTRU негизиндеги тездеткичтер
NTRU негизиндеги YASHE жана LTV тездеткичтеринде NTT, CRT/iCRT, modulus switching жана pipeline оптималдаштыруулары алдыга чыгат. Булак Pöppelmannдын YASHE дизайнында \(n=16384\) жана болжол менен 512-bit \(q\) параметри үчүн гомоморфтук кошууну 0,94 ms, гомоморфтук көбөйтүүнү 48,67 ms деп келтирет.
Royдун көп өзөктүү YASHE тездеткичинде SIMON-64/128 эсептөөсү 2048 ciphertext параллелдүү иштетилгенде 171,3 s, ар бир блок үчүн 83,6 ms жана программалык камсыздоого салыштырмалуу 24,5× ылдамдануу деп билдирилет. Öztürkдүн LTV CPU+FPGA системасында гомоморфтук AES блок баалоосу 442 ms жана CPU/GPUга салыштырмалуу тиешелүүлүгүнө жараша 28,5× жана 17× ылдамдануу деп берилет.
Обзор бул багыттын узак мөөнөттүү чектөөлөрүнүн катарына NTRU негизиндеги айрым түзүлүштөрдүн subfield attackка сезгичтигин, схемага көз карандылыкты жана кең масштабда кайра пайдалануунун чектелишин киргизет.
RLWE негизиндеги тездеткичтер
Обзордо азыркы изилдөөлөрдүн эң активдүү багыты RLWE негизиндеги BFV, BGV жана CKKS тездеткичтери. HEPCloud, HEAX, Medha, F1, CraterLake, ARK жана Poseidon сыяктуу архитектуралар бир эле multiplier схемасын эмес, көп өзөктүү иштетүүнү, RNS каналдарын, key switchingти, маалымат кыймылын, программалануучу instruction setти жана эс тутум иерархиясын бирге карайт.
| Класс | Изилдөө / архитектура | Платформа | Схема | Булакта баса белгиленген өзгөчөлүк жана чек |
|---|---|---|---|---|
| Integer | Wang | FPGA, Stratix-V | GH | SSA+FFT интеграциясы; өтө кең көбөйтүү үчүн адистешкен жана жалпы колдонулушу чектелүү. |
| Integer | Doröz | 90 nm ASIC | GH | Толук аппараттык тездетүү; жогорку аппараттык чыгым. |
| Integer | Moore | FPGA, Virtex-7 | Coron | DSP тилкелерин натыйжалуу колдонгон жеңил дизайн; DSPге көз карандылык жана чектелген ийкемдүүлүк. |
| NTRU | Pöppelmann | FPGA, Stratix-V | YASHE | YASHE үчүн комплекстүү тездетүү; жогорку схема адистешүүсү. |
| NTRU | Roy | FPGA, Virtex-7 | YASHE | Модулдук жана кайра конфигурациялануучу дизайн; кошумча башкаруу жүгү. |
| NTRU | Öztürk | FPGA, Virtex-7 | LTV-SHE | LTV-SHE үчүн биринчи FPGA тездеткичи; схемага көз карандылык. |
| NTRU | Cousins / HEPU | FPGA, Virtex-7 | LTV | CRT/iCRT тездетүү; scheduling жүгү. |
| RLWE | Roy / HEPCloud | CPU + FPGA, Virtex-6 | BFV | Көп өзөктүү BFV тездетүү; шайкештик чектелүү. |
| RLWE | Mert | CPU + FPGA + ASIC | BFV | Жеңил NTT оптималдаштыруу; reconfigurability чектелүү. |
| RLWE | Turan / HEAWS | FPGA, Virtex UltraScale+ | BFV | AWS FPGA үстүндө BFV тездетүү; жалпылык чектелүү. |
| RLWE | Riazi / HEAX | CPU + FPGA + ASIC, Stratix-10 | CKKS | Көп катмарлуу параллелдүүлүк; жогорку аппараттык ресурс жүгү. |
| RLWE | Roy / Medha | FPGA, Alveo U250 | CKKS | Көп өзөк жана instruction-level parallelism; RNS-CKKSке багытталган. |
| RLWE | Samardzic / F1 | 14/12 nm ASIC | BGV / CKKS | Программалануучу жана кең алгоритмдик колдоо; чоң ASIC аянты. |
| RLWE | Samardzic / CraterLake | 14/12 nm ASIC | BGV / CKKS | Unbounded FHE колдоосу; жогорку архитектуралык татаалдык. |
| RLWE | Mert / Medha opt. | FPGA + 7 nm ASIC | CKKS | Microcoded instruction-set ыкмасы; шайкештик чеги. |
| RLWE | Kim / ARK | 7 nm ASIC | BGV / CKKS | Жогорку эс тутум натыйжалуулугу; татаал байланыш/маалымат агымы. |
| RLWE | Yang / Poseidon | FPGA, Alveo U280 | CKKS | Толук bootstrapping колдоосу; башкаруу татаалдыгы. |
| RLWE | Bertels | FPGA, ZCU102 | FHEW | Тез FHEW bootstrapping; тышкы ачкыч сактагычка көз карандылык. |
| RLWE | Jiang / MATCHA | ASIC/GPU | TFHE | Көбөйтүүсүз FFT ыкмасы; шайкештик чектелүү. |
| RLWE | Van / FPT | FPGA, Alveo U280 | TFHE | Туруктуу чекиттүү FFT; тышкы ачкычка көз карандылык. |
| RLWE | Zhang | FPGA, Alveo U280 | CKKS / TFHE | Схемалар аралык switching; булак таблицасында бир багыттуу деп көрсөтүлгөн. |
Булакта баса белгиленген айрым RLWE өндүрүмдүүлүк мисалдары
- HEPCloudдун жакшыртылган көп өзөктүү версиясы оптималдаштырылган программалык камсыздоого салыштырмалуу 13×тен ашык ылдамданууну билдирет.
- HEAWS булакта берилген конфигурацияда секундасына 613 homomorphic multiplication аткарат.
- HEAX кең FHE параметр диапазонунда 164–268× өндүрүмдүүлүк өсүшүн билдирет.
- Medha Xilinx Alveo U250 үстүндө башка reconfigurable тездеткичтерге салыштырмалуу 2,4× төмөн latency билдирет.
- F1 программалык ишке ашырууларга салыштырмалуу geometric mean 5400× жана белгилүү бир шартта 17.000×ге чейин ылдамданууну билдирет.
- CraterLake булакта F1ге салыштырмалуу 11,2× ылдамдануу деп берилет.
- Poseidon колдонулган FHE benchmarkында GPU жана ASICке салыштырмалуу тиешелүүлүгүнө жараша 10,6× жана 8,7× ылдамданууну билдирет.
- FHEW багытындагы Bertels дизайны bootstrapping операциясын 20 msден аз убакытта аткарат.
- MATCHA cuHE GPU китепканасына салыштырмалуу TFHE throughputунда 2,3× жакшыртууну билдирет.
- FPT CPU негизиндеги TFHE bootstrappingке салыштырмалуу эки–үч тартипке чоң throughput жакшыртуусун билдирет.
- CKKS–FHEW switching аппараты Xilinx U280 үстүндө программалык базалык деңгээлге салыштырмалуу 365× switching натыйжалуулугун жогорулаткан.
Бул сандар ар башка изилдөөлөрдүн өз салыштыруулары. Ылдамдануу коэффициенттеринин базалык деңгээлдери, параметрлери жана аппараттары бирдей болбогондуктан аларды түздөн-түз “жеңүүчүлөр рейтингине” айлантууга болбойт.
Колдонмого багытталган FHE тездеткичтери
Обзор FHE аппараттык изилдөөлөрү жалпы криптографиялык primitiveлерди гана тездетүүдөн колдонмо деңгээлиндеги hardware–software co-designга өтүп жатканын белгилейт. Үч негизги колдонмо тобу edge computing, federated learning жана artificial intelligence катары каралат.
| Тармак | Дизайн | Булакта берилген негизги жыйынтык | Түшүндүрмө чеги |
|---|---|---|---|
| Edge | HHEML | Кардардын encryption latencyсинде >50× азайтуу/ылдамдатуу жана hardware throughputта болжол менен 2× өсүш. | Гибрид HE ыкмасы; оор гомоморфтук эсеп серверге өткөрүлөт. |
| Edge | Pasta on Edge | Учурдагы FHE public-key client acceleratorsга салыштырмалуу 97× ылдамдануу. | 7 nm жана 28 nm ASIC ишке ашырууларынын контекстинде. |
| Edge | Embedded SEAL/CKKS NTT | Таза программалык камсыздоого салыштырмалуу болжол менен 1000× ылдамдануу. | Атайын NTT тездетүү жумуш жүгү. |
| Federated learning | FedBit | Encryptionда болжол менен эки чоңдук тартибиндей ылдамдануу жана орточо communication overheadде %60,7 азайуу. | BFV негизиндеги пакеттөө жана FPGA биргелешкен долбоорлоосу. |
| Federated learning | Yang жана башк. FL framework | Training encryption timeда %71ге чейин азайуу. | Булак Paillier partially homomorphic экенин жана бул мисал FHE-FL инженериясы үчүн шилтеме экенин так белгилейт. |
| AI | CHAM | Matrix–vector multiplicationда 1800×, logistic regressionда 36×, Beaver triple өндүрүүдө 144×. | Жумуш жүгүнө мүнөздүү FPGA салыштыруулары. |
| AI | FHE-CGRA | Салттуу CGRAга салыштырмалуу 8,15× өндүрүмдүүлүк; FPGA FHE-CNN тездеткичтерине салыштырмалуу 16,48× энергия натыйжалуулугу. | CGRA маалымат агымынын контекстинде. |
| AI | Cheetah | HE параметрлерин жөндөө жана operator scheduling менен мурунку ыкмаларга караганда 79×ге чейин ылдамдануу. | Private DNN inference үчүн интеграцияланган дизайн. |
| AI | HERACLES | FHE математикалык операцияларында 24-core Intel Xeon W7-3455ке салыштырмалуу 1074×–5547×. | Intel 3 nm, 8192-way SIMD SoC контекстинде; бир neural-network моделине гана тиешелүү эмес. |
FHE өзөктүк арифметикасынын полином шакеги
Булак азыркы негизги FHE схемаларынын өзөктүк полиномдук арифметикасын ушундай residue-class polynomial ring түзүлүштөрү аркылуу талкуулайт.
\(\mathbb{Z}_q\) коэффициенттер \(q\) модулу боюнча эсептелген бүтүн сандар классын; \(x\) полином өзгөрмөсүн; \(N\) полином өлчөмүн билдирет. \(x^N+1\) боюнча бөлүү жогорку даражадагы полином мүчөлөрүн ушул байланышка ылайык азайтуу дегенди түшүндүрөт.
Теңдеменин физикалык бирдиги жок; бул математикалык алгебралык түзүлүш. Аппарат жагынан \(N\) чоңойсо иштетиле турган коэффициенттердин саны өсөт, \(q\) чоңойсо коэффициенттик арифметиканын бит туурасы көбөйөт. Ошондуктан полином өлчөмү жана модул тандоосу multiplier, эс тутум жана маалымат жолу дизайнына түз таасир берет.
FHE Үчүн Кайсы Полиномдук Көбөйткүч Качан Тандалат?
Булактын чечим диаграммасында NTT/INTT ылайыктуу жөнөкөй модул жана transform шарттары аткарылганда алдыга чыгат, ал эми бул шарттар ылайык болбогон түзүлүштөрдө полином өлчөмүнө жана аппараттык чектөөлөргө жараша Toom–Cook же Karatsuba варианттары каралат; бул схема катуу универсалдуу тандоо эрежеси эмес, обзор параметр–аппарат шайкештигин түшүндүрүү үчүн сунуштаган инженердик чечим алкагы.
NTT/INTT жана Toom–Cook/Karatsuba татаалдыктары
Булак NTT/INTT негизиндеги polynomial multiplication үчүн болжолдуу татаалдыкты төмөнкүдөй берет:
Бул жерде \(N\) полиномдогу коэффициенттердин санына байланышкан өлчөм. Big-O физикалык убакыт бирдиги эмес, маселенин көлөмү чоңойгон сайын талап кылынган операциялардын саны кандай масштабда өсөрүн көрсөткөн асимптотикалык чоңдук.
Toom–Cook-k үчүн булакта берилген жалпы татаалдык түзүлүшү:
\(k\) полином канча бөлүккө бөлүнөрүн көрсөтөт. Karatsuba эки бөлүктүү Toom–Cookтун өзгөчө түрү. Ошондуктан \(k=2\) болгондо даража \(\log_2 3\) болот. Булактагы 3-сүрөт Karatsuba үчүн болжол менен \(O(N^{1.585})\), Toom–3 үчүн болжол менен \(O(N^{1.465})\) жана Toom–4 үчүн болжол менен \(O(N^{1.404})\) масштабдарын көрсөтөт.
Кичирээк асимптотикалык даража өзү эле реалдуу аппарат ылдамыраак болот дегенди билдирбейт. Evaluation/interpolation чыгымы, DSP саны, эс тутум трафиги, pipeline түзүлүшү жана параллелдүү иштетүү мүмкүнчүлүгү жалпы latencyни өзгөртүшү мүмкүн.
NTT үчүн модул шарты
Булактын TC/Karatsuba салыштыруусунда NTT/INTT үчүн практикада \(N\) экинин даражасы болушу жана модул төмөнкү шартты аткарган жөнөкөй сан болушу керек деп көрсөтүлөт:
Бул шарт transform үчүн керектүү тамыр түзүлүштөрүн колдогон модул тандоосу менен байланыштуу. Аппарат жагынан NTT тез жана параллелдештирүүгө ыңгайлуу полином көбөйтүү жолун берет; бирок модул тандоо, twiddle-factor эс тутуму, butterfly блоктору жана memory addressing татаалдашы мүмкүн.
NTT/INTT негизиндеги polynomial multiplier
Number Theoretic Transform (NTT) жана inverse NTT (INTT) — полином көбөйтүүсүн transform мейкиндигинде point-wise multiplication операцияларына айланткан негизги арифметикалык түзүлүштөр. Булак аларды RLWE жана NTRU негизиндеги схемалардын эң маанилүү hardware primitiveлеринин бири катары баалайт.
Negative Wrapped Convolution (NWC) нөл менен толтуруудан улам transform узундугу \(2N\)ге өсүп кетишине жол бербей, аны \(N\)де кармайт; анын ордуна NTTге чейин жана INTTден кийин кошумча scaling-factor көбөйтүүлөрүн жаратат.
Pöppelmann дизайны үчүн булак бир polynomial multiplication чыгымын болжол менен төмөнкүдөй берет:
Булактын түшүндүрмөсүнө ылайык кошумча \(5.5n\) мүчөнүн олуттуу бөлүгү коэффициенттерди жүктөөдөн, point-wise multiplication жана post-scaling операцияларынан келип чыгат. \(n=512\) үчүн 10.014 cycle жана 4 BRAM билдирилген; кийинки нормалдаштырылган салыштырууда 51,09 µs берилген.
Du жана кесиптештери polynomial multiplication чыгымын:
түзүлүшүнөн:
түзүлүшүнө түшүргөн; туруктуу-factor сактоону \(4N\)ден \(2.5N\)ге азайтып, %37,5 ROM үнөмдөөсүн билдирген. \(n=512\) үчүн 8806 cycle жана 26.913 multiplication берилет.
| Изилдөө | Алгоритм | Гибрид | Платформа | Баса белгиленген артыкчылык / чектөө |
|---|---|---|---|---|
| Pöppelmann | GS NTT | Жок | FPGA | Динамикалык параметр жөндөө; ресурс керектөө жана ийкемдүүлүк чеги. |
| Xu | CG NTT | Ооба | FPGA | Жогорку configurability жана кыска critical path; fixed radix жана башкаруу татаалдыгы. |
| Roy | CT NTT | Ооба | FPGA | Area–өндүрүмдүүлүк тең салмагы; жогорку параметр көз карандылыгы. |
| Du | CT NTT | Ооба | FPGA | Операция жана сактоо оптималдаштырылышы; butterfly параллелдүүлүгү чектелүү. |
| Pöppelmann | CT NTT | Ооба | MCU | Төмөн storage overhead жана timing side-channel коргоо; параметр масштабдуулугу начар. |
| Zhang | CG NTT | Ооба | FPGA | Post-processing азайтуу; чоң twiddle-factor эс тутуму. |
| Zeng | CG NTT | Ооба | ASIC | Жогорку configurability жана төмөн resource use; жогорку параллелдүүлүктө башкаруу татаалдыгы. |
| Chen | CG NTT | Ооба | FPGA | Pipeline жана жөнөкөй башкаруу; resource жана scalability чыгымы. |
| Banerjee | CG NTT | Ооба | ASIC | Side-channelга туруктуулук жана интеграцияланган түзүлүш; атайын дизайндарына салыштырмалуу өндүрүмдүүлүк/resource чеги. |
| Longa | CG NTT | Ооба | MCU | Mixed radix ийкемдүүлүгү; төмөн throughput жана коопсуздук тобокелдиктери. |
| Phap | CG NTT | Ооба | FPGA | Conflict-free memory менен area efficiency; modulus шайкештиги жана throughput чеги. |
| Mandal | Winograd NTT | Жок | FPGA | Аз modular multiplier жана төмөн latency; көбүрөөк addition жана башкаруу татаалдыгы. |
| Ramyavani | CG NTT | Жок | FPGA | Төмөн hardware utilization; кичи полиномдордо гана оптималдаштырылган. |
| Bardia | CG NTT | Ооба | FPGA | Өтө төмөн latency; жогорку параллелдүү аппарат/area чыгымы. |
| Zhao | CG NTT | Ооба | RISC-V | Load-store unit менен тыгыз интеграция жана маалымат өткөрүү артыкчылыгы; critical path/frequency чеги. |
Булак ParallelNTT мисалында ML-KEM үчүн 128 DSP, ML-DSA үчүн 256 DSP колдонуп, мурунку FPGA дизайндарга салыштырмалуу forward/inverse transform latencyсинде 24× жана 21× жакшыртуу бергенин билдирет. Бул мисалдар FHE схемасы эмес; NTT аппараттык архитектурасынын жалпы lattice-cryptography арифметикасына колдонулушун көрсөтөт.
Toom–Cook жана Karatsuba
NTTнин модул жана полином өлчөмү шарттарына салыштырмалуу Toom–Cook жана Karatsuba параметрлер боюнча кеңири ийкемдүүлүк бере алат. Булактын баалоосу боюнча бул ийкемдүүлүк өзгөчө resource-constrained же ылайыксыз модул түзүлүшү бар долбоорлордо маанилүү.
Karatsuba эки бөлүккө бөлүүнү колдонсо, Toom–Cook-3 же Toom–Cook-4 чоңураак бөлүктөргө бөлүп, recursion деңгээлин азайтып жана асимптотикалык multiplication countту төмөндөтүшү мүмкүн. Мунун ордуна evaluation, interpolation, recombination жана бир калыпта эмес memory access этаптары аппаратта татаалдашат.
| Изилдөө | Алгоритм | Платформа | Баса белгиленген артыкчылык / чектөө |
|---|---|---|---|
| Migliore | Karatsuba-3 | FPGA | Төмөн latency; dynamic reconfiguration жана throughput чектелүү. |
| Zhu | 8-level Iterative Karatsuba | FPGA + ASIC | Татаалдык/натыйжалуулук тең салмагы; recursion overhead жана side-channel жетишсиздиги. |
| Wong | 1-level Karatsuba | FPGA | Negacyclic convolutionда жакшы DSP колдонулушу; параллелдүүлүк чектелүү. |
| Wang | TCPM, TC-2/3/4 | FPGA | Жогорку configurability жана параллелдүүлүк; башкаруу логикасы татаал. |
| Karmakar | TC + Karatsuba + Schoolbook | Cortex-M4 | Өтө төмөн memory footprint жана алгоритмдик ыңгайлашуучулук; жогорку татаалдык. |
| Mera | 3-level Karatsuba | AVX | Memory оптималдаштыруу жана timing-attackка туруктуулук; башкаруу/scalability чеги. |
| Kannwischer | TC-4 + multi-level Karatsuba | Cortex-M4 | Туруктуу эс тутум жана жакшы өндүрүмдүүлүк; scalability жана side-channel чеги. |
| Paksoy | TC-4 | Cortex-M4 | Жогорку versatility; scalability жана side-channel чеги. |
| Mera | TC-4 | FPGA | Жогорку throughput жана memory access efficiency; scalability чектелүү. |
| Ghosh | Striding TC-4 | ASIC | Төмөн эс тутум жана жакшы ыңгайлашуучулук; параллелдүү өндүрүмдүүлүк жана алгоритм ийкемдүүлүгү чектелүү. |
| Li жана жумушчу топ | TC-3 | ASIC | Модулдук жана масштабдалуучу дизайн; hardware resource жогору. |
| Ma | TC-3 | FPGA | Latency жакшыртуу; frequency жана side-channel чеги. |
| Vasanthi | Hybrid Karatsuba | FPGA + ASIC | Area жана latency оптималдаштыруу; жогорку татаалдык жана side-channel жетишсиздиги. |
Булакта Migliore дизайнында \(n=1024\) үчүн operation count 3583төн 3071ге түшүрүлгөн, FFT салыштыруусу 4158 operation деп берилген. Чектелген embedded multiplier шартында Karatsuba үчүн %58ге чейин speedup билдирилет.
Zhuнун degree-256 Karatsuba дизайны coefficient multiplication санын 65.536дан 6521ге түшүрүп, бир multiplication операциясын 81 cycleда аяктаган. Булак бул дизайн үчүн болжол менен 3,16× ылдамданууну билдирет.
Wangдын reconfigurable TCPM дизайны TC-2, TC-3 жана TC-4тү бир архитектурада колдойт, post-processing arithmetic operation санын эң аз дегенде %33,33 азайтат жана Xilinx VC709 үстүндө булак салыштырууларына ылайык 2,47×–50,11× ылдамданууну билдирет.
Karmakarдын Cortex-M4 Saber multiplierи 256×256 polynomial multiplication үчүн 65.459–66.692 cycle диапазонун билдирет. Meraнын кийинки ишинде matrix-vector polynomial multiplication ар кандай платформаларда %12–37 жакшырган, AVX2де %29,3–36,6 өсүш жана Cortex-M4 memory колдонулушунда 2,6–5,7 KB азайуу берилген.
Бул Saber мисалдары FHE эмес, пост-кванттык key encapsulation контекстинен алынганын унутпоо керек. Обзор аларды Toom–Cook/Karatsuba hardware datapath дизайнына байланыштуу жалпы арифметикалык мисал катары колдонот.
Эмне үчүн бүтүн сандык модулдук көбөйткүч өзүнчө өзөктүк компонент?
Polynomial multiplier коэффициенттерди гана көбөйтпөйт; аралык жана акыркы коэффициенттер белгиленген модул астында кармалышы керек. Ошондуктан integer modular multiplier polynomial multiplier ичинде да, FHEнин көптөгөн башка арифметикалык этаптарында да негизги аппараттык блок болуп саналат.
| Көбөйткүч түрү | Мисал изилдөө | Контекст / платформа | Булакта баса белгиленген инженердик тең салмак |
|---|---|---|---|
| Barrett | Öztürk | LTV / FPGA | Жалпы жана натыйжалуу modular reduction; кең бит узундугунда critical path жана resource чыгымы өсүшү мүмкүн. |
| Barrett | Roy | BFV / FPGA | Area менен speed ортосунда тең салмактуу resource-efficient түзүлүш. |
| Barrett | Hao | Toom–Cook / ASIC | Жогорку area efficiency. |
| Shoup | Riazi | NTT / CPU+FPGA | Ар кандай учурларга оптималдаштырылган; кош instantiation hardware overhead жаратышы мүмкүн. |
| Shoup | Kim | CKKS / FPGA | Төмөн resource жана latency; операнддардын бири constant болушу керек. |
| Montgomery | Mert | BFV / CPU+FPGA | Азыраак modular reduction; Montgomery domain өзгөртүүсү кошумча чыгым жаратат. |
| Montgomery | Li | IP-MMM / FPGA | Кыска data path; high-performance жана арзан IoT үчүн ылайыктуу деп берилет. |
| Montgomery | Roy | HRKM + OSBM / FPGA+ASIC | Бир-cycle иштөө, төмөн resource жана latency. |
| Montgomery | Wang | PPMM / FPGA | Төмөн cycle count жана жогорку operating frequency. |
| Solinas prime | Cao | FFT/IFFT / FPGA | Атайын модул түзүлүшү менен reduction жеңилдейт; колдонулуучу модул формасы чектелет. |
| Solinas prime | Zijlstra | NTT/INTT / FPGA | Shift/add/sub басымдуу жөнөкөй hardware; атайын модул талап кылат. |
Булактын жалпы баалоосу боюнча Barrett жана Montgomery жалпы модулдар жана variable–variable multiplication үчүн кеңири колдонулат. Shoup variable–constant multiplication үчүн натыйжалуу болушу мүмкүн, бирок туруктуу operand талабы жалпылыкты чектейт. Solinas жана атайын-prime түзүлүштөрү өтө тез reduction бере алат, бирок ылайыктуу модул тандоосун тарылтат.
Bootstrapping FHE Аппаратында Эмне Үчүн Критикалык?
Bootstrapping ciphertext ичинде топтолгон ызы-чууну же эсептөө тереңдигинин чегин жаңыртып, leveled FHEни теориялык жактан чексиз схема тереңдигине жакындаткан операция болгондуктан критикалык деп эсептелет; бирок BGV/BFV/CKKS тарапта чоң NTT/INTT, RNS өзгөртүүсү, key switching, rotation жана modulus операциялары, FHEW/TFHE тарапта болсо blind rotation, accumulator жаңыртуу жана чоң bootstrapping-key трафиги себептүү аппараттагы эң оор операциялардын бири.
Leveled FHE менен чыныгы FHE ортосундагы инженердик айырма
Leveled FHE алдын ала аныкталган чектелген эсептөө тереңдигине жетиштүү параметрлер менен иштей алат. Схема тереңдиги жогорулаган сайын ciphertext ызы-чуусу жана модул бюджети чекке жакындайт. Bootstrapping ciphertextти гомоморфтук түрдө “жаңыртып”, кошумча эсептөөлөрдү улантууга мүмкүндүк берет.
Бирок bootstrapping аппараттык чыгымы өтө жогору. CKKS/BFV/BGV үчүн high-throughput NTT/INTT pipeline, conflict-free multi-bank memory, rotation/key-switching маалымат агымы, чоң evaluation-key сактагыч жана айрым учурларда ачкычты талап кылынганда кайра жаратуу маанилүү.
FHEW/TFHE тарапта blind rotation, homomorphic accumulator, polynomial–vector/matrix multiplication жана bootstrapping key bandwidth алдыга чыгат. Ошондуктан бир эле bootstrapping accelerator архитектурасын CKKS жана TFHE үчүн түз эле бирдей колдонуу күтүлбөйт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Обзор ыкмасы
Макала өз ыкмасын narrative review деп аныктайт. Авторлор аппараттык багыттагы адабият издөөнү жүргүзүшкөн.
| Элемент | Булакта берилген маалымат |
|---|---|
| Убакыт аралыгы | 2009–2026; өзгөчө 2020-жылдан кийинки жаңы иштерге көңүл бурулган. |
| Маалымат базалары | IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar, IACR ePrint. |
| Негизги издөө терминдери | fully homomorphic encryption, FHE hardware implementation, FHE accelerator, FPGA/ASIC accelerator, polynomial multiplier, NTT/INTT, Toom–Cook, Karatsuba, modular multiplier. |
| Screening | Duplicate жазуулар алынып салынган; title, abstract жана full text боюнча иргөө жүргүзүлгөн. |
| Киргизилген негизги изилдөө түрлөрү | FHE scheme, hardware accelerator architecture, polynomial multiplication жана integer modular multiplication менен түз байланышкан иштер. |
| Чыгарып салуу | Жалаң software library багытындагы иштер, hardware implementation камтыбаган application-level иштер жана тиешеси жок cryptographic hardware. |
| Уюштуруу | FHE scheme evolution, accelerator type, core arithmetic component жана implementation platform. |
Ыкмада билдирилбеген элементтер
- Башында табылган жалпы жазуулардын саны берилген эмес.
- Duplicate алып салынгандан кийин канча жазуу калганы көрсөтүлгөн эмес.
- Title/abstract жана full-text этаптарында канча иш четтетилгени түшүндүрүлгөн эмес.
- Акырында киргизилген иштердин саны ыкма бөлүмүндө бир жалпы сан катары берилген эмес.
- PRISMA агым диаграммасы жок.
- Алдын ала катталган review protocol тууралуу маалымат берилген эмес.
- Булак иштер үчүн formal risk-of-bias же сапат балл системасы көрсөтүлгөн эмес.
- Meta-analysis жүргүзүлгөн эмес.
Ошондуктан изилдөө кеңири жана түзүмдүү адабият кароосун сунуштаса да, анын жыйынтыктарын сандык meta-analysis жыйынтыгы катары түшүндүрүүгө болбойт.
Обзор аныктаган үч негизги учурдагы маселе
- Чачыранды атайын аппараттык блоктор: NTT/INTT, modular arithmetic, modulus raising/reduction жана rescaling сыяктуу ар кандай primitiveлер үчүн өзүнчө тездеткичтерди колдонуу жалпы processing unitтердин кайталанышына жана hardware utilization төмөндөшүнө алып келиши мүмкүн.
- Схемага ашыкча адистешүү: Көптөгөн тездеткичтер белгилүү бир BFV, CKKS, TFHE же башка FHE үй-бүлөсүнө гана оптималдаштырылат; fixed datapath башка параметрлерге же алгоритмдерге шайкештикти чектейт.
- Колдонмо талаптарына толук дал келбөө: Neural-network training, multi-party secure computation жана federated learning сыяктуу жумуш жүктөрү latency, depth, precision, memory, communication жана power боюнча жалпы FHE acceleratorдан башка талаптарды коёт.
Келечектеги багыт 1 — Кайра конфигурациялануучу жана бөлүшүлүүчү accelerator
Авторлор келечектеги аппарат operator-specific өзөктөрдүн ордуна катмарлуу reconfigurable architecture багытына өтүшү керек деп сунушташат. Төмөнкү катмарда modular arithmetic, butterfly array, NTT/INTT, point-wise multiplier, RNS channel жана on-chip memory bank сыяктуу жалпы блоктор ар кандай схемалар тарабынан бөлүшүлүшү мүмкүн.
Орто катмарда programmable modulus-reduction mode, flexible radix, microcoded instruction scheduling жана параметрленүүчү \(N\), \(q\), RNS base жана decomposition base колдоосу максат кылынат.
Жогорку катмарда болсо BFV base extension/scaling, CKKS rescaling/approximate modulus conversion жана TFHE accumulator update сыяктуу схемага мүнөздүү агымдарды microprogram же атайын functional extension катары сактоо сунушталат.
Келечектеги багыт 2 — Bootstrapping багытындагы accelerator
Обзор finite-depth операциялар үчүн оптималдаштырылган тездеткичтерден unbounded-depth computationду түзүрөөк колдогон bootstrapping acceleratorsга өтүүнү маанилүү изилдөө багыты катары көрөт.
Leveled схемаларда large-parameter NTT/INTT, RNS base conversion, key switching, slot rotation жана rescaling; bit-bootstrappable схемаларда blind rotation, accumulator жана key bandwidth ар башка аппараттык фокустарды жаратат. Булак айрым блокторду жалпы кылууга болорун, ал эми айрым механизмдер схемага мүнөздүү бойдон калышы керектигин айтат.
Келечектеги багыт 3 — Колдонмого негизделген hardware–software co-design
Авторлор келечектеги accelerator дизайны криптографиялык primitiveге гана эмес, максаттуу application workloadга жараша да түзүлүшү керек деп эсептешет.
Encrypted neural-network inference үчүн SIMD packing, rotation, key switching, matrix-vector multiplication, convolution, nonlinear approximation жана зарыл болсо bootstrapping бирге оптималдаштырылышы керек.
Federated learningде маселе encryption/decryptionдан кеңири: secure aggregation, ciphertext packing, communication compression, homomorphic matrix–vector computation жана cross-institution feature interaction бир pipeline ичинде каралышы керек.
Edge жана IoT тарабында low area, low power, кичи storage footprint, compact parameter set, lightweight modular arithmetic жана edge–cloud task partitioning артыкчылыктуу болуп калат.
Изилдөө колдогон жыйынтыктар
- FHEнин практикалык аппараттык чыгымында polynomial multiplication жана modular multiplication борбордук роль ойнойт.
- BFV жана CKKSте RNS жана чоң полиномдук арифметика аппараттык параллелдүүлүктүн негизги темаларынан.
- FHEW/TFHE ар башка ciphertext жана bootstrapping түзүлүштөрүнөн улам ар башка accelerator datapathтарга муктаж.
- RLWE негизиндеги accelerator изилдөөлөрү акыркы жылдары scheme-level жана system-level co-design багытына жылууда.
- NTT/INTT абдан күчтүү polynomial multiplication тандоосу, бирок modulus жана twiddle-factor/memory талаптары бар.
- Toom–Cook/Karatsuba ийкемдүүрөөк modulus/polynomial шарттарында жана ылайыктуу resource шартында маанилүү альтернатива.
- Barrett, Montgomery, Shoup жана Solinas көбөйткүчтөрүнүн ортосунда efficiency менен modulus/operand flexibility боюнча негизги trade-off бар.
- Bootstrapping колдоосу келечектеги FHE accelerators үчүн негизги дизайн максаттарынын бири.
- Application-specific hardware–software co-design жалпы primitive тездетүүдөн комплекстүү системалык оптималдаштырууга карай багытты көрсөтөт.
Изилдөө колдобогон жыйынтыктар
- Обзор бир FHE accelerator бардык башкалардан универсалдуу түрдө жакшы экенин көрсөтпөйт.
- Ар кайсы макалалардагы speedup коэффициенттери бирдей тест системасында өлчөнбөгөндүктөн, аларды түз эле бир шкалада тизүүгө болбойт.
- Обзор өзүнүн жаңы FPGA же ASIC прототибин чыгарбайт.
- Обзор өзүнүн energy, latency же area benchmark маалымат топтомун түзбөйт.
- FHE бардык системалык коопсуздук маселелерин автоматтык чечет деген жыйынтык чыгарууга болбойт; бул обзордун негизги фокусу hardware performance.
- ML-KEM, ML-DSA, Saber же NTRU Prime мисалдары FHE схемасы деген жыйынтык чыгарууга болбойт; булак аларды жалпы arithmetic hardware мисалдары катары колдонот.
- Paillier мисалы толук гомоморфтук эмес; булак аны federated-learning hardware engineering үчүн шилтеме мисал катары так бөлүп көрсөтөт.
- Ар бир колдонмо үчүн NTT же Karatsuba жалгыз туура polynomial multiplier деген жыйынтык чыгарууга болбойт.
Обзордун кайра өндүрүмдүүлүк чектери
Булак издөө жүргүзүлгөн академиялык маалымат базаларын, убакыт аралыгын, негизги ачкыч сөздөрдү жана киргизүү/чыгаруу ыкмасын билдирет. Бул кадимки narrative адабият кыскача баянынан көбүрөөк көзөмөлдөнүүчү издөө алкагын түзөт.
Бирок ар бир маалымат базасы үчүн издөө саптарынын толук Boolean формасы, издөө так даталары, жазуулар саны, duplicate саны, exclusion reason бөлүштүрүлүшү жана formal quality assessment жок. Ошондуктан башка изилдөөчү дал ошол макалалар пулун толук кайталап түзүшү үчүн керек болгон бардык systematic-review metadata жетишсиз.
Мындан тышкары, обзордо келтирилген өндүрүмдүүлүк жыйынтыктары авторлор кайра benchmark кылган маалыматтар эмес; алар түпнуска макалаларда билдирилген жыйынтыктар. Аппараттык процесс, FPGA үй-бүлөсү, саат жыштыгы, FHE параметрлери, security level, software baseline жана workload ар башка болгондуктан салыштырма таблицалар архитектуралык тенденцияларды түшүнүү үчүн көбүрөөк колдонулушу керек.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: A Brief Survey on Hardware Implementation of Fully Homomorphic Encryption
Авторлор: Yang Su; Kaixuan Zhou; Weidong Zhong; Jianfei Wang; Jia Hou; Chen Yang.
Авторлордун тартиби: Yang Su биринчи, Kaixuan Zhou экинчи, Weidong Zhong үчүнчү, Jianfei Wang төртүнчү, Jia Hou бешинчи, Chen Yang алтынчы автор.
Жооптуу автор: Weidong Zhong.
Мекеме 1: School of Cryptography Engineering, Engineering University of People’s Armed Police, Xi’an 710086, China.
Мекеме 2: School of Microelectronics, Xi’an Jiaotong University, Xi’an 710049, China.
Тең салым: Булакта тең биринчи авторлук же тең салым белгиси жок.
Журнал: Cryptography.
Басма: MDPI, Basel, Switzerland.
Том / сан / макала: 10(4), 49.
Бет саны: 34.
DOI: 10.3390/cryptography10040049.
Жөнөтүлгөн күнү: 3 июнь 2026.
Кайра кароо күнү: 4 июль 2026.
Кабыл алынган күнү: 8 июль 2026.
Жарыяланган күнү: 13 июль 2026.
Макаланын түрү: Review; булак өз ыкмасын narrative review деп аныктайт.
Рецензия: Cryptography үчүн расмий MDPI материалдарында single-blind peer review көрсөтүлөт.
Preprint абалы: Иштелген документ жарыяланган журналдык версия; бул Verianla мазмунунда preprint колдонулган эмес.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Расмий жарыя шилтемеси: DOI 10.3390/cryptography10040049 аркылуу MDPI Cryptography макала жазуусу.
Академиялык редакторлор: Ki-Hyun Jung жана Luis Javier García Villalba.
Ачкыч сөздөр: fully homomorphic encryption (FHE); hardware implementation; accelerator; polynomial multiplier; modular multiplier.
Обзор мезгили: 2009–2026; өзгөчө 2020-жылдан кийинки адабиятка көңүл бурулган.
Каралган булактар: IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar жана IACR ePrint.
Киргизүү фокусу: FHE schemes, hardware accelerator architecture, polynomial multiplication жана integer modular multiplication.
Чыгарып салуу фокусу: Жалаң software library изилдөөлөрү, hardware implementation камтыбаган application-level изилдөөлөр жана тиешеси жок cryptographic hardware.
Жаңы эксперименталдык маалымат: Жок. Булак жаңы маалымат түзбөгөнүн же талдабаганын ачык билдирет; жыйынтыктар жарыяланган адабияттан жана коомдук жеткиликтүү теориялык моделдерден алынган.
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет.
Маалыматтын жеткиликтүүлүгү: Жаңы маалымат түзүлбөгөндүктөн data sharing бул обзор үчүн колдонулбайт.
Автордук салымдар: Расмий MDPI жазуусуна ылайык концептуалдаштыруу Yang Su жана Kaixuan Zhou; ыкма Yang Su жана Kaixuan Zhou; supervision жана resources Weidong Zhong; formal analysis, visualization жана investigation Jianfei Wang менен Jia Hou; review/editing жана project administration Chen Yang тарабынан аткарылган. Бардык авторлор жарыяланган версияны окуп, кабыл алганы көрсөтүлөт.
Этика комитети / адам-жаныбар изилдөөсү: Изилдөө жаңы адам же жаныбар маалыматтарын түзбөгөн адабият обзору; булакта өзүнчө адам/animal experimental protocol көрсөтүлгөн эмес.
Булак сүрөттөрү: 1-сүрөт FHE cloud privacy modelин, 2-сүрөт hardware accelerator classification frameworkтү, 3-сүрөт FHE parameter/polynomial multiplier selection чечимин көрсөтөт. Verianlaда үчөө тең булак байланыштарына таянып өз алдынча inline SVG катары кайра курулган.
Булак таблицалары: 1-таблица BFV/CKKS/FHEW-TFHE өзгөчөлүктөрүн; 2-таблица бардык FHE acceleratorsду; 3-таблица NTT/INTT polynomial multipliersду; 4-таблица Karatsuba/Toom–Cook polynomial multipliersду; 5-таблица integer modular multipliersду салыштырат.
Негизги методологиялык чек: Изилдөө narrative review. Маалымат базалары, убакыт аралыгы жана screening логикасы көрсөтүлгөнү менен PRISMA агымы, жалпы жазуулар/киргизилген иштердин саны, катталган протокол, formal сапат баалоосу жана meta-analysis көрсөтүлгөн эмес.
Салыштыруу чеги: Обзордо келтирилген speedup, latency, throughput, area жана energy маанилери ар башка түпнуска иштерден алынган. Ар башка hardware technology, FPGA/ASIC/CPU, clock frequency, security parameter, polynomial degree, modulus, workload жана software baseline колдонулгандыктан, маанилерди жалпы benchmark жыйынтыгы катары түз иреттөөгө болбойт.
Камтуу эскертүүсү: Обзор айрым FHE эмес пост-кванттык криптография иштерин polynomial multiplier же modular arithmetic hardware дизайнына мисал катары колдонот. Бул мисалдар FHE схемасы деген жыйынтык чыгарылган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген