


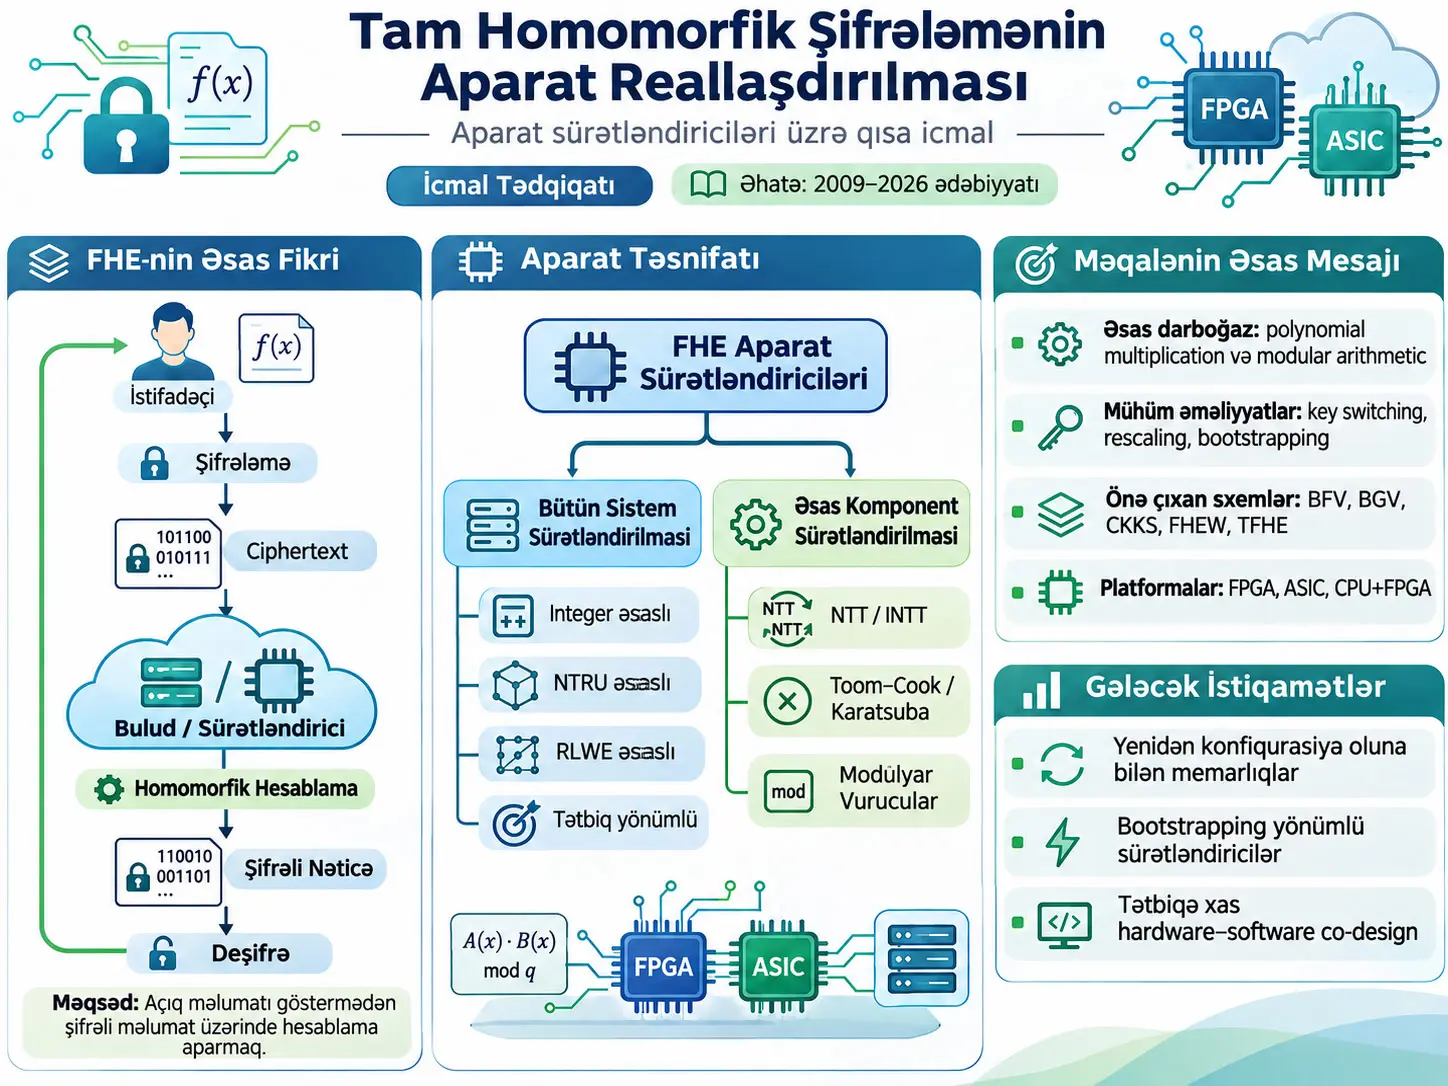
Tam Homomorfik Şifrələmə (Fully Homomorphic Encryption, FHE), şifrələnmiş məlumatı əvvəlcə açıq mətnə çevirməyə ehtiyac olmadan müəyyən hesablamaların birbaşa ciphertext üzərində aparılmasını və əldə edilən şifrəli nəticənin səlahiyyətli istifadəçi tərəfindən deşifrə edildikdə açıq məlumat üzərində aparılan uyğun hesablama ilə eyni nəticəni verməsini hədəfləyən şifrələmə yanaşmasıdır. Bu tədqiqat yeni FHE alqoritmi və ya sürətləndiricisi təklif etmir; 2009–2026 arasında FHE sxemlərinin inkişafını, bütün FHE sistemini sürətləndirən aparat arxitekturalarını, polinom vurucularını və tam ədəd modul vurucularını araşdıran aparat yönümlü narrative review təqdim edir. İcmalın əsas nəticəsi budur ki, FHE aparatında performans yalnız daha sürətli vurma sxemi hazırlamaqla həll edilə bilməz; polinom arifmetikası, bootstrapping, key switching, yaddaş hərəkəti, yenidən konfiqurasiya edilə bilmə və tətbiqə xas məlumat axını birlikdə nəzərə alınmalıdır.
Müəlliflərin qiymətləndirməsinə görə RLWE əsaslı FHE sürətləndiriciləri daha güclü standartlaşdırılmış qəfəs əsasları və çevik cəbri strukturları səbəbindən müasir aparat tədqiqatlarının üstün istiqamətlərindən birinə çevrilmişdir. BFV, BGV və CKKS kimi leveled FHE sxemləri böyük polinomlar, Residue Number System (RNS), polynomial multiplication, relinearization, key switching və modulus idarəetməsi ilə işləyərkən; FHEW/TFHE ailəsi daha kiçik modullar və bit səviyyəli bootstrapping istifadə edir. Bu fərqlər tək sabit sürətləndiricinin bütün FHE alqoritmləri üçün eyni dərəcədə səmərəli olmasını çətinləşdirir.
İcmal mövcud sürətləndiricilərin mühüm hissəsinin müəyyən sxemlərə və ya müəyyən nüvə əməliyyatlarına görə ixtisaslaşdırıldığını; bunun performans qazandırmaqla yanaşı ortaq aparat resurslarının təkrar istifadəsini və alqoritmlərarası çevikliyi məhdudlaşdırdığını vurğulayır. Müəlliflər gələcəkdə paylaşıla bilən modular arithmetic vahidlərinin, yenidən konfiqurasiya edilə bilən NTT/INTT nüvələrinin, proqramlaşdırıla bilən məlumat axınının, bootstrapping yönümlü arxitekturaların və tətbiq–alqoritm–aparat birgə layihələndirilməsinin əhəmiyyət qazanacağını proqnozlaşdırırlar.
Mənbədə verilən çox yüksək sürətlənmə nisbətləri vahid ortaq benchmark-a aid deyil. F1, HEAX, Poseidon, CHAM, HERACLES və digər dizaynlar fərqli FHE sxemləri, aparat texnologiyaları, parametrlər, iş yükləri və proqram təminatı baza xətlərindən istifadə edir. Buna görə, məsələn 1000×, 5000× və ya 17.000× kimi bir sürətlənmə dəyəri başqa sətirdəki sürətlənmə dəyəri ilə birbaşa müqayisə edilərək universal performans sıralaması yaradıla bilməz.
Tədqiqatın nüvə arifmetikasına dair icmalında Saber, ML-KEM, ML-DSA və NTRU Prime kimi FHE olmayan qəfəs əsaslı kriptoqrafiya nümunələrinə də yer verilir. Bunlar “FHE sxemi” kimi təqdim edilməyib; NTT/INTT, Karatsuba və Toom–Cook kimi ortaq polinom arifmetikasının aparat reallaşdırılmasına dair mühəndislik nümunələri kimi istifadə olunub.
FHE-nin əsas ideyası nədir?
Klassik xarici hesablama modelində məlumat sahibi həssas məlumatını serverə açıq şəkildə göndərirsə, server hesablamanı asanlıqla edə bilər, lakin məxfilik itə bilər. FHE-nin məqsədi serverin məlumatın açıq məzmununu görmədən ciphertext üzərində hesablama apara bilməsidir. İstifadəçi əvvəlcə məlumatı öz açarı ilə şifrələyir, bulud yalnız ciphertext-i emal edir və nəticə yenə şifrələnmiş formada istifadəçiyə qayıdır.
Bu strukturdakı “homomorfik” sözü açıq məlumat üzərində aparılan riyazi əməliyyatlarla şifrələnmiş təqdimat üzərində aparılan əməliyyatlar arasında nəticə baxımından qorunan əlaqənin olduğunu ifadə edir. FHE-nin mühəndislik problemi isə bu əməliyyatların nəzəri olaraq mümkün olmasından daha çox praktikada nə qədər hesablama, yaddaş, bant genişliyi və aparat sahəsi tələb etməsidir.
Bu icmala niyə ehtiyac yaranıb?
Mənbə əvvəlki FHE icmallarının mühüm hissəsinin riyazi prinsiplərə, təhlükəsizlik xüsusiyyətlərinə və proqram kitabxanalarına yönəldiyini bildirir. Aparat sürətləndirilməsini nəzərdən keçirən bəzi tədqiqatların isə ya müəyyən illərlə məhdud qaldığı, ya yalnız ümumi accelerator architecture səviyyəsini araşdırdığı, ya da yalnız CKKS bootstrapping kimi dar alt problemə fokuslandığı qeyd olunur.
Müəlliflərin məqsədi bu boşluğu üç səviyyədə doldurmaqdır: FHE sxemlərinin inkişafını xronoloji olaraq qiymətləndirmək, bütün FHE sisteminə yönəlmiş sürətləndiriciləri təsnif etmək və performansı müəyyən edən polynomial multiplier ilə modular multiplier kimi incə dənəli nüvə aparat vahidlərini ayrıca müqayisə etmək.
Birinci nəsil FHE
Mənbə birinci nəslin başlanğıcını Gentry-nin 2009-cu ildəki Gen09 strukturuna bağlayır. Gen09 ideal qəfəslər üzərində qurulmuş, homomorfik toplama və vurmanı birlikdə dəstəkləyən və ciphertext səs-küyünü nəzarətdə saxlamaq üçün bootstrapping istifadə edən ilk ümumi FHE yanaşması kimi təqdim olunur.
Sonrakı SV10, SS10, GH11 və GHS12a tədqiqatları ciphertext/açar ölçüsü, decryption circuit dərinliyi və ya bootstrapping səmərəliliyi kimi problemləri yaxşılaşdırmağa çalışıb. İcmalın qiymətləndirməsinə görə bu ilk nəsil sxemlərin nəzəri əhəmiyyəti yüksək olsa da, cəbri strukturların mürəkkəbliyi, böyük ciphertext-lər və yüksək bootstrapping xərci praktik istifadəni məhdudlaşdırıb.
İkinci nəsil FHE
İkinci nəsil LWE/RLWE və polinom halqaları üzərində hazırlanmış sxemlərlə əlaqələndirilir. BV11a/BV11b, BGV, BFV və CKKS bu dövrün əsas nümunələridir.
KeySwitching, ciphertext-in funksional olaraq eyni açıq məlumatı təmsil etməyə davam etdiyi halda başqa açar/təqdimat altında istifadə edilməsinə imkan verən çevirmə mexanizmidir. Mənbədə xüsusilə ciphertext ölçüsünün və ya qiymətləndirmə açarlarının idarə olunmasında mühüm rol oynayır.
ModulusSwitching, ciphertext modulunu nəzarətli şəkildə dəyişdirərək səs-küyün və hesablama xərcinin idarə olunmasına kömək edən texnikadır.
Relinearization, homomorfik vurmadan sonra böyüyən ciphertext strukturunu yenidən daha idarəolunan formaya çevirmək üçün istifadə olunan əməliyyatdır.
Rescaling, xüsusilə CKKS-nin təxmini ədəd hesablama modelində miqyas və modul idarəetməsinin bir hissəsidir. Mənbə CKKS-ni həqiqi ədədlərin təxmini hesablanmasına uyğun FHE sxemi kimi nəzərdən keçirir.
Üçüncü nəsil FHE
Mənbə üçüncü dövrü GSW, FHEW və TFHE kimi bit-bootstrappable sxemlərlə əlaqələndirir. Bu strukturlarda tək-bit və ya məntiqi qiymətləndirmə, blind rotation və homomorphic accumulator kimi mexanizmlər önə çıxır.
FHEW üçün bootstrapping müddətinin bir saniyənin altına endirildiyi, TFHE tərəfində isə sonrakı tədqiqatlarla 52 ms və daha sonra 13 ms səviyyələrinə qədər yaxşılaşmaların bildirildiyi qeyd olunur. Bunlar tarixən fərqli tədqiqatların nəticələridir; eyni aparat və ya eyni parametr dəstinə aid vahid təcrübə deyil.
BFV, CKKS və FHEW/TFHE arasındakı əsas fərqlər
| Xüsusiyyət | BFV | CKKS | FHEW / TFHE |
|---|---|---|---|
| Növ | Leveled FHE | Leveled FHE | Bit-bootstrappable |
| Nüvə komponenti | Homomorfik vurma və relinearization | Homomorfik vurma və relinearization | Homomorphic accumulator |
| Paralel texnika | RNS | RNS | Mənbə Cədvəl 1-də “None” |
| Modul çevrilməsi | Base extension / scaling | Təxmini modulus up/down conversion | Mənbə Cədvəl 1-də “None” |
| Nüvə əməliyyatı | Polynomial multiplication | Polynomial multiplication | Polynomial matrix multiplication |
| Əsas arifmetika | Tam ədəd vurması və modul əməliyyatları | Modul əməliyyatları | Modul əməliyyatları |
| Polinom ölçüsü N | ≥ \(2^{12}\) | ≥ \(2^{12}\) | \(2^{10}\) və ya \(2^{11}\) |
| \(\log_2 Q\) | ≥100 | ≥100 | ≤50 |
| Modul seçimi | Sadə ədəd | Sadə ədəd | 2-nin qüvvəti və ya sadə ədəd |
Mənbə həmçinin leveled BFV/CKKS sxemlərində bootstrapping lazım olduqda polinom dərəcəsinin \(2^{16}\)–\(2^{17}\) səviyyələrinə qədər çıxa bildiyini və ciphertext modulunun yüzlərlə, hətta minlərlə bitə çata bildiyini bildirir. Bunlar sabit məcburi parametrlər deyil, tədqiqatda müzakirə olunan tipik yüksək resurs tələblərini təsvir edir.
FHE Aparat Sürətləndirilməsinin Əsas Darboğazı Nədir?
İcmala görə əsas darboğaz homomorfik qiymətləndirmə, xüsusilə də böyük polinom ölçüləri və geniş modullar altında təkrarlanan polynomial multiplication, modular arithmetic, key switching və bootstrapping əməliyyatlarıdır; buna görə yalnız hesablama vahidlərinin sürəti deyil, yaddaşa giriş, məlumat hərəkəti, RNS paralelliyi və aparat resurslarının təkrar istifadəsi də ümumi performansı müəyyən edir.
RNS niyə istifadə olunur?
Residue Number System (RNS), böyük modul altında aparılacaq hesablamanı daha kiçik modullardan ibarət bir neçə kanal üzərində yerinə yetirməyə imkan verən təqdimat yanaşmasıdır. Mənbə BFV və CKKS kimi leveled FHE sxemlərinin böyük ciphertext modullarını kiçik modullara ayıraraq paralel emal edə bilməsini RNS-nin əsas aparat üstünlüyü kimi izah edir.
Bu üstünlük eyni zamanda əlavə base conversion, modulus conversion və məlumat hərəkəti tələb edə bilər. Buna görə RNS “hesablamanı pulsuz sürətləndirən” üsul deyil; böyük tam ədəd arifmetikasını daha uyğun paralel kiçik-modul əməliyyatlarına çevirən arxitektur seçimdir.
FHE aparat sürətləndiricilərinin təsnifatı
Integer əsaslı FHE sürətləndiriciləri
Erkən dövr integer əsaslı FHE sürətləndiricilərində əsas məqsəd çox geniş tam ədəd vurmalarını sürətləndirməkdir. Mənbə FFT əsaslı Schönhage–Strassen və Comba kimi vurucuların bu dövrün əsas aparat yanaşmaları olduğunu bildirir.
Wang və həmkarlarının Stratix-V üzərində qurduğu 64K nöqtəli FFT mühərrikinin 100 MHz-də NVIDIA C2050 üzərində eyni FFT alqoritminə nisbətən təxminən iki dəfə sürət əldə etdiyi bildirilir. Doröz və həmkarlarının 90 nm ASIC dizaynında encryption 18,1 ms, decryption 16,1 ms və recryption 3,1 s kimi bildirilmiş; dizaynın 30 milyon qapıdan kiçik olduğu qeyd olunmuşdur.
Mənbənin ümumi qiymətləndirməsi budur ki, bu dizaynlar müəyyən parametrlərdə uğur göstərsə də, açar ölçüləri və geniş tam ədəd tələbləri artdıqca miqyaslana bilmə, yaddaş təzyiqi və alqoritmik uyğunlaşma problemləri böyüyür.
NTRU əsaslı sürətləndiricilər
NTRU əsaslı YASHE və LTV sürətləndiricilərində NTT, CRT/iCRT, modulus switching və pipeline optimallaşdırmaları önə çıxır. Mənbə Pöppelmann-ın YASHE dizaynında \(n=16384\) və təxminən 512-bit \(q\) parametri üçün homomorfik toplamanı 0,94 ms, homomorfik vurmanı 48,67 ms kimi göstərir.
Roy-un çoxnüvəli YASHE sürətləndiricisində SIMON-64/128 hesablaması 2048 ciphertext paralel emal edildikdə 171,3 s, blok başına 83,6 ms və proqram təminatına nisbətən 24,5× sürətlənmə kimi bildirilir. Öztürk-ün LTV CPU+FPGA sistemində homomorfik AES blok qiymətləndirməsi 442 ms və CPU/GPU ilə müqayisədə müvafiq olaraq 28,5× və 17× sürətlənmə kimi verilir.
İcmal bu istiqamətin uzunmüddətli məhdudiyyətləri arasında bəzi NTRU əsaslı strukturların subfield attack həssaslığını, sxem asılılığını və geniş miqyasda təkrar istifadənin məhdud olmasını göstərir.
RLWE əsaslı sürətləndiricilər
İcmalda müasir tədqiqatın ən sıx sahəsi RLWE əsaslı BFV, BGV və CKKS sürətləndiriciləridir. HEPCloud, HEAX, Medha, F1, CraterLake, ARK və Poseidon kimi arxitekturalar yalnız bir multiplier sxemini deyil, çoxnüvəli emalı, RNS kanallarını, key switching-i, məlumat hərəkətini, proqramlaşdırıla bilən instruction set-i və yaddaş iyerarxiyasını birlikdə nəzərdən keçirir.
| Sinif | Tədqiqat / arxitektura | Platforma | Sxem | Mənbədə önə çıxan xüsusiyyət və sərhəd |
|---|---|---|---|---|
| Integer | Wang | FPGA, Stratix-V | GH | SSA+FFT inteqrasiyası; çox geniş vurma üçün ixtisaslaşdırılıb və ümumiliyi məhduddur. |
| Integer | Doröz | 90 nm ASIC | GH | Tam aparat sürətləndirilməsi; yüksək aparat xərci. |
| Integer | Moore | FPGA, Virtex-7 | Coron | DSP dilimlərindən səmərəli istifadə edən yüngül dizayn; DSP asılılığı və məhdud çeviklik. |
| NTRU | Pöppelmann | FPGA, Stratix-V | YASHE | YASHE üçün bütüncül sürətləndirmə; yüksək sxem ixtisaslaşması. |
| NTRU | Roy | FPGA, Virtex-7 | YASHE | Modul və yenidən konfiqurasiya edilə bilən dizayn; əlavə idarəetmə yükü. |
| NTRU | Öztürk | FPGA, Virtex-7 | LTV-SHE | LTV-SHE üçün ilk FPGA sürətləndiricisi; sxem asılılığı. |
| NTRU | Cousins / HEPU | FPGA, Virtex-7 | LTV | CRT/iCRT sürətləndirilməsi; scheduling yükü. |
| RLWE | Roy / HEPCloud | CPU + FPGA, Virtex-6 | BFV | Çoxnüvəli BFV sürətləndirilməsi; uyğunluq məhduddur. |
| RLWE | Mert | CPU + FPGA + ASIC | BFV | Yüngül NTT optimallaşdırması; reconfigurability məhduddur. |
| RLWE | Turan / HEAWS | FPGA, Virtex UltraScale+ | BFV | AWS FPGA üzərində BFV sürətləndirilməsi; ümumilik məhduddur. |
| RLWE | Riazi / HEAX | CPU + FPGA + ASIC, Stratix-10 | CKKS | Çoxqatlı paralellik; yüksək aparat resurs yükü. |
| RLWE | Roy / Medha | FPGA, Alveo U250 | CKKS | Çoxnüvə və instruction-level parallelism; RNS-CKKS yönümlü. |
| RLWE | Samardzic / F1 | 14/12 nm ASIC | BGV / CKKS | Proqramlaşdırıla bilən və geniş alqoritmik dəstək; böyük ASIC sahəsi. |
| RLWE | Samardzic / CraterLake | 14/12 nm ASIC | BGV / CKKS | Unbounded FHE dəstəyi; yüksək arxitektur mürəkkəblik. |
| RLWE | Mert / Medha opt. | FPGA + 7 nm ASIC | CKKS | Microcoded instruction-set yanaşması; uyğunluq sərhədi. |
| RLWE | Kim / ARK | 7 nm ASIC | BGV / CKKS | Yüksək yaddaş səmərəliliyi; mürəkkəb kommunikasiya/məlumat axını. |
| RLWE | Yang / Poseidon | FPGA, Alveo U280 | CKKS | Tam bootstrapping dəstəyi; idarəetmə mürəkkəbliyi. |
| RLWE | Bertels | FPGA, ZCU102 | FHEW | Sürətli FHEW bootstrapping; xarici açar yaddaşından asılılıq. |
| RLWE | Jiang / MATCHA | ASIC/GPU | TFHE | Vurmasız FFT yanaşması; uyğunluq məhduddur. |
| RLWE | Van / FPT | FPGA, Alveo U280 | TFHE | Sabit nöqtəli FFT; xarici açar asılılığı. |
| RLWE | Zhang | FPGA, Alveo U280 | CKKS / TFHE | Sxemlərarası switching; mənbə cədvəlində birtərəfli kimi göstərilib. |
Mənbədə önə çıxarılan bəzi RLWE performans nümunələri
- HEPCloud-un təkmilləşdirilmiş çoxnüvəli versiyası optimallaşdırılmış proqram təminatına nisbətən 13×-dən çox sürətlənmə bildirir.
- HEAWS, mənbədə verilən düzəndə saniyədə 613 homomorphic multiplication həyata keçirir.
- HEAX, geniş FHE parametr diapazonunda 164–268× performans artımı bildirir.
- Medha, Xilinx Alveo U250 üzərində digər reconfigurable sürətləndiricilərlə müqayisədə 2,4× daha aşağı latency bildirir.
- F1, proqram tətbiqləri ilə müqayisədə geometric mean 5400× və müəyyən halda 17.000×-ə qədər sürətlənmə bildirir.
- CraterLake, mənbədə F1-lə müqayisədə 11,2× sürətlənmə kimi göstərilir.
- Poseidon, istifadə edilən FHE benchmarkında GPU və ASIC ilə müqayisədə müvafiq olaraq 10,6× və 8,7× sürətlənmə bildirir.
- FHEW yönümlü Bertels dizaynı bootstrapping əməliyyatını 20 ms-dən az müddətdə həyata keçirir.
- MATCHA, cuHE GPU kitabxanası ilə müqayisədə TFHE throughput-unda 2,3× yaxşılaşma bildirir.
- FPT, CPU əsaslı TFHE bootstrapping ilə müqayisədə iki–üç böyüklük mərtəbəsi throughput yaxşılaşması bildirir.
- CKKS–FHEW switching aparatı Xilinx U280 üzərində proqram baza xəttinə qarşı 365× switching səmərəliliyi artımı bildirir.
Bu rəqəmlər fərqli tədqiqatların öz müqayisələridir. Sürətlənmə əmsallarının baza xətləri, parametrləri və aparatları eyni olmadığı üçün üfüqi “qaliblər sıralaması” kimi istifadə edilməməlidir.
Tətbiq yönümlü FHE sürətləndiriciləri
İcmal FHE aparat tədqiqatının yalnız ümumi kriptoqrafik primitive-ləri sürətləndirməkdən tətbiq səviyyəli hardware–software co-design-a keçdiyini bildirir. Üç əsas tətbiq qrupu edge computing, federated learning və artificial intelligence kimi araşdırılır.
| Sahə | Dizayn | Mənbədə verilən əsas nəticə | Şərh sərhədi |
|---|---|---|---|
| Edge | HHEML | İstemci encryption latency-sində >50× azalma/sürətlənmə və hardware throughput-da təxminən 2× artım. | Hibrid HE yanaşması; ağır homomorfik hesablama serverə ötürülür. |
| Edge | Pasta on Edge | Mövcud FHE public-key client accelerators ilə müqayisədə 97× sürətlənmə. | 7 nm və 28 nm ASIC reallaşdırmaları kontekstində. |
| Edge | Embedded SEAL/CKKS NTT | Təmiz proqram təminatına nisbətən təxminən 1000× sürətlənmə. | Xüsusi NTT sürətləndirmə iş yükü. |
| Federated learning | FedBit | Encryption-da təxminən iki böyüklük mərtəbəsi sürətlənmə və orta communication overhead-də %60,7 azalma. | BFV əsaslı paketləmə və FPGA birgə dizaynı. |
| Federated learning | Yang və b. FL framework | Training encryption time-da %71-ə qədər azalma. | Mənbə açıq şəkildə Paillier-in partially homomorphic olduğunu və bu nümunənin FHE-FL mühəndisliyi üçün istinad olduğunu bildirir. |
| AI | CHAM | Matrix–vector multiplication-da 1800×, logistic regression-da 36×, Beaver triple istehsalında 144×. | İş yükünə xas FPGA müqayisələri. |
| AI | FHE-CGRA | Ənənəvi CGRA ilə müqayisədə 8,15× performans; FPGA FHE-CNN sürətləndiriciləri ilə müqayisədə 16,48× enerji səmərəliliyi. | CGRA məlumat axını kontekstində. |
| AI | Cheetah | HE parametr tənzimləməsi və operator scheduling ilə əvvəlki yanaşmalara görə 79×-ə qədər sürətlənmə. | Private DNN inference üçün inteqrə olunmuş dizayn. |
| AI | HERACLES | FHE riyazi əməliyyatlarında 24-core Intel Xeon W7-3455 ilə müqayisədə 1074×–5547×. | Intel 3 nm, 8192-way SIMD SoC kontekstində; tək neural-network modelinə xas deyil. |
FHE nüvə arifmetikasının polinom halqası
Mənbə müasir əsas axın FHE sxemlərinin nüvə polinom arifmetikasını bu cür residue-class polynomial ring strukturları üzərindən müzakirə edir.
\(\mathbb{Z}_q\), əmsalların \(q\) modulu üzrə hesablandığı tam ədəd sinfini; \(x\) polinom dəyişənini; \(N\) polinom ölçüsünü göstərir. \(x^N+1\) ilə bölmə aparılması yüksək dərəcəli polinom terminlərinin bu əlaqəyə görə azaldılması deməkdir.
Tənliyin fiziki vahidi yoxdur; bu, riyazi cəbri strukturdur. Aparat baxımından \(N\)-nin böyüməsi emal ediləcək əmsalların sayını, \(q\)-nun böyüməsi isə əmsal arifmetikasının bit genişliyini təsir edir. Buna görə polinom ölçüsü və modul seçimi birbaşa multiplier, yaddaş və məlumat yolu dizaynına əks olunur.
FHE Üçün Hansı Polinom Vurucusu Nə Vaxt Seçilir?
Mənbənin qərar diaqramında NTT/INTT, uyğun sadə modul və transform şərtləri təmin olunduqda önə çıxır; bu şərtlərin uyğun olmadığı strukturlarda isə polinom ölçüsünə və aparat məhdudiyyətinə görə Toom–Cook və ya Karatsuba seçimləri nəzərdən keçirilir. Bu sxem qəti universal seçim qaydası deyil, icmalın parametr–aparat uyğunluğunu öyrətmək üçün təqdim etdiyi mühəndislik qərar çərçivəsidir.
NTT/INTT və Toom–Cook/Karatsuba mürəkkəblikləri
Mənbə NTT/INTT əsaslı polynomial multiplication üçün təxmini mürəkkəbliyi belə verir:
Burada \(N\), polinomdakı əmsal sayına bağlı ölçüdür. Big-O ifadəsi fiziki zaman vahidi deyil, problem ölçüsü artdıqca tələb olunan əməliyyat miqdarının necə miqyaslandığını göstərən asimptotik kəmiyyətdir.
Toom–Cook-k üçün mənbədə verilən ümumi mürəkkəblik strukturu:
\(k\), polinomun neçə alt hissəyə bölündüyünü göstərir. Karatsuba iki hissəli Toom–Cook-un xüsusi halıdır. Buna görə \(k=2\) üçün qüvvət \(\log_2 3\) olur. Mənbə Şəkil 3 Karatsuba üçün təxminən \(O(N^{1.585})\), Toom–3 üçün təxminən \(O(N^{1.465})\) və Toom–4 üçün təxminən \(O(N^{1.404})\) miqyaslarını göstərir.
Daha kiçik asimptotik qüvvət təkbaşına real aparatın daha sürətli olması demək deyil. Evaluation/interpolation xərci, DSP sayı, yaddaş trafiki, pipeline strukturu və paralel emal imkanı ümumi latency-ni dəyişə bilər.
NTT üçün modul şərti
Mənbənin TC/Karatsuba müqayisəsi NTT/INTT üçün praktik olaraq \(N\)-nin ikinin qüvvəti və modulun aşağıdakı şərti ödəyən sadə ədəd olmasını bildirir:
Bu şərt transform üçün lazım olan kök strukturlarını dəstəkləyən modul seçimi ilə əlaqəlidir. Aparat baxımından NTT sürətli və paralelləşdirilə bilən polinom vurma yolu təqdim edir; əvəzində modul seçimi, twiddle-factor yaddaşı, butterfly vahidləri və memory addressing daha mürəkkəb ola bilər.
NTT/INTT əsaslı polynomial multiplier
Number Theoretic Transform (NTT) və inverse NTT (INTT), polinom vurmasını transform sahəsində point-wise multiplication əməliyyatlarına çevirən əsas arifmetik strukturlardır. Mənbə bunları RLWE və NTRU əsaslı sxemlərin ən mühüm hardware primitive-lərindən biri kimi qiymətləndirir.
Negative Wrapped Convolution (NWC), sıfır doldurma səbəbindən transform uzunluğunun \(2N\)-ə çıxmasının qarşısını alıb \(N\)-də saxlayır; bunun əvəzində NTT-dən əvvəl və INTT-dən sonra əlavə scaling-factor vurmaları yaradır.
Pöppelmann dizaynı üçün mənbə bir polynomial multiplication xərcini təxminən aşağıdakı ifadə ilə verir:
Mənbənin izahına görə əlavə \(5.5n\) terminlərinin mühüm hissəsi əmsalların yüklənməsi, point-wise multiplication və post-scaling əməliyyatlarından qaynaqlanır. \(n=512\) üçün 10.014 cycle və 4 BRAM bildirilmiş; sonrakı normallaşdırılmış müqayisədə 51,09 µs verilmişdir.
Du və həmkarları polynomial multiplication xərcini:
strukturundan:
strukturuna endirmiş; sabit-factor yaddaşını \(4N\)-dən \(2.5N\)-ə azaldaraq %37,5 ROM qənaəti bildirmişdir. \(n=512\) üçün 8806 cycle və 26.913 multiplication bildirilir.
| Tədqiqat | Alqoritm | Hibrid | Platforma | Önə çıxan üstünlük / məhdudiyyət |
|---|---|---|---|---|
| Pöppelmann | GS NTT | Xeyr | FPGA | Dinamik parametr tənzimlənməsi; resurs istifadəsi və çeviklik məhdudiyyəti. |
| Xu | CG NTT | Bəli | FPGA | Yüksək configurability və qısa critical path; fixed radix və idarəetmə mürəkkəbliyi. |
| Roy | CT NTT | Bəli | FPGA | Area–performans tarazlığı; yüksək parametr asılılığı. |
| Du | CT NTT | Bəli | FPGA | Əməliyyat və yaddaş optimallaşdırması; butterfly paralelliyi məhduddur. |
| Pöppelmann | CT NTT | Bəli | MCU | Aşağı storage overhead və timing side-channel qorunması; parametr miqyaslana bilməsi zəifdir. |
| Zhang | CG NTT | Bəli | FPGA | Post-processing azalması; böyük twiddle-factor yaddaşı. |
| Zeng | CG NTT | Bəli | ASIC | Yüksək configurability və aşağı resource use; yüksək paralellikdə idarəetmə mürəkkəbliyi. |
| Chen | CG NTT | Bəli | FPGA | Pipeline və sadə idarəetmə; resource və scalability xərci. |
| Banerjee | CG NTT | Bəli | ASIC | Side-channel dayanıqlığı və inteqrə struktur; xüsusi dizaynlarla müqayisədə performans/resource məhdudiyyəti. |
| Longa | CG NTT | Bəli | MCU | Mixed radix çevikliyi; aşağı throughput və təhlükəsizlik riskləri. |
| Phap | CG NTT | Bəli | FPGA | Conflict-free memory ilə area efficiency; modulus uyğunluğu və throughput məhdudiyyəti. |
| Mandal | Winograd NTT | Xeyr | FPGA | Az modular multiplier və aşağı latency; daha çox addition və idarəetmə mürəkkəbliyi. |
| Ramyavani | CG NTT | Xeyr | FPGA | Aşağı hardware utilization; yalnız kiçik polinomlarda optimallaşdırılıb. |
| Bardia | CG NTT | Bəli | FPGA | Çox aşağı latency; yüksək paralel aparat/area xərci. |
| Zhao | CG NTT | Bəli | RISC-V | Load-store unit ilə sıx inteqrasiya və məlumat ötürmə qazancı; critical path/frequency məhdudiyyəti. |
Mənbə ParallelNTT nümunəsində ML-KEM üçün 128 DSP, ML-DSA üçün 256 DSP istifadə edərək əvvəlki FPGA dizaynlarına nisbətən forward/inverse transform latency-sində 24× və 21× yaxşılaşma bildirir. Bu nümunələr FHE sxemi deyil; NTT aparat arxitekturasının ortaq lattice-cryptography arifmetikasına tətbiqini göstərir.
Toom–Cook və Karatsuba
NTT-nin modul və polinom ölçüsü şərtlərinə qarşı Toom–Cook və Karatsuba daha geniş parametr çevikliyi təmin edə bilər. Mənbənin qiymətləndirməsinə görə bu çeviklik xüsusilə resource-constrained və ya uyğun olmayan modul strukturuna malik dizaynlarda vacibdir.
Karatsuba iki hissəli bölmədən istifadə edərkən Toom–Cook-3 və ya Toom–Cook-4 daha iri bölmələmə apararaq daha az recursion səviyyəsi və daha aşağı asimptotik multiplication count təmin edə bilər. Bunun əvəzi evaluation, interpolation, recombination və qeyri-müntəzəm memory access mərhələlərinin aparatda mürəkkəbləşməsidir.
| Tədqiqat | Alqoritm | Platforma | Önə çıxan üstünlük / məhdudiyyət |
|---|---|---|---|
| Migliore | Karatsuba-3 | FPGA | Aşağı latency; dynamic reconfiguration və throughput məhduddur. |
| Zhu | 8-level Iterative Karatsuba | FPGA + ASIC | Mürəkkəblik/səmərəlilik tarazlığı; recursion overhead və side-channel çatışmazlığı. |
| Wong | 1-level Karatsuba | FPGA | Negacyclic convolution-da yaxşı DSP istifadəsi; paralellik məhduddur. |
| Wang | TCPM, TC-2/3/4 | FPGA | Yüksək configurability və paralellik; idarəetmə məntiqi mürəkkəbdir. |
| Karmakar | TC + Karatsuba + Schoolbook | Cortex-M4 | Çox aşağı memory footprint və alqoritmik uyğunlaşma; yüksək mürəkkəblik. |
| Mera | 3-level Karatsuba | AVX | Memory optimallaşdırması və timing-attack dayanıqlığı; idarəetmə/scalability məhdudiyyəti. |
| Kannwischer | TC-4 + multi-level Karatsuba | Cortex-M4 | Sabit yaddaş və yaxşı performans; scalability və side-channel məhdudiyyəti. |
| Paksoy | TC-4 | Cortex-M4 | Yüksək versatility; scalability və side-channel məhdudiyyəti. |
| Mera | TC-4 | FPGA | Yüksək throughput və memory access efficiency; scalability məhduddur. |
| Ghosh | Striding TC-4 | ASIC | Aşağı yaddaş və yaxşı uyğunlaşma; paralel performans və alqoritm çevikliyi məhduddur. |
| Li və işçi qrup | TC-3 | ASIC | Modul və miqyaslana bilən dizayn; hardware resource yüksəkdir. |
| Ma | TC-3 | FPGA | Latency yaxşılaşması; frequency və side-channel məhdudiyyəti. |
| Vasanthi | Hybrid Karatsuba | FPGA + ASIC | Area və latency optimallaşdırması; yüksək mürəkkəblik və side-channel çatışmazlığı. |
Mənbədə Migliore dizaynında \(n=1024\) üçün operation count 3583-dən 3071-ə endirilərkən FFT müqayisəsi 4158 operation kimi verilir. Məhdud embedded multiplier şəraitində Karatsuba üçün %58-ə qədər speedup bildirilir.
Zhu-nun degree-256 Karatsuba dizaynı coefficient multiplication sayını 65.536-dan 6521-ə endirmiş və bir multiplication əməliyyatını 81 cycle-da tamamlamışdır. Mənbə bu dizayn üçün təxminən 3,16× sürətlənmə bildirir.
Wang-ın reconfigurable TCPM dizaynı TC-2, TC-3 və TC-4-ü eyni arxitekturada dəstəkləyir, post-processing arithmetic operation sayını ən az %33,33 azaldır və Xilinx VC709 üzərində mənbə müqayisələrinə görə 2,47×–50,11× sürətlənmə bildirir.
Karmakar-ın Cortex-M4 Saber multiplier-i 256×256 polynomial multiplication üçün 65.459–66.692 cycle aralığı bildirir. Mera-nın sonrakı tədqiqatında matrix-vector polynomial multiplication müxtəlif platformalarda %12–37 yaxşılaşmış, AVX2-də %29,3–36,6 qazanc və Cortex-M4 memory istifadəsində 2,6–5,7 KB azalma bildirilmişdir.
Bu Saber nümunələrinin FHE deyil, post-kvant key encapsulation kontekstindən gəldiyi unudulmamalıdır. İcmal bunları Toom–Cook/Karatsuba hardware datapath dizaynına dair ortaq arifmetik nümunə kimi istifadə edir.
Tam ədəd modul vurucusu niyə ayrıca nüvə komponentidir?
Polynomial multiplier yalnız əmsalları vurmur; aralıq və son əmsallar müəyyən edilmiş modul altında saxlanmalıdır. Buna görə integer modular multiplier həm polynomial multiplier daxilində, həm də FHE-nin bir çox digər arifmetik mərhələsində əsas aparat vahididir.
| Vurucu növü | Nümunə tədqiqat | Kontekst / platforma | Mənbədə önə çıxan mühəndislik tarazlığı |
|---|---|---|---|
| Barrett | Öztürk | LTV / FPGA | Ümumi və səmərəli modular reduction; geniş bit uzunluğunda critical path və resource xərci arta bilər. |
| Barrett | Roy | BFV / FPGA | Area və speed arasında balanslı resource-efficient struktur. |
| Barrett | Hao | Toom–Cook / ASIC | Yüksək area efficiency. |
| Shoup | Riazi | NTT / CPU+FPGA | Fərqli hallar üçün optimallaşdırılıb; ikiqat instantiation hardware overhead yarada bilər. |
| Shoup | Kim | CKKS / FPGA | Aşağı resource və latency; operandlardan birinin constant olması tələb olunur. |
| Montgomery | Mert | BFV / CPU+FPGA | Daha az modular reduction; Montgomery domain çevrilməsi əlavə xərc yaradır. |
| Montgomery | Li | IP-MMM / FPGA | Qısa data path; high-performance və aşağı xərcli IoT üçün uyğun kimi təqdim olunur. |
| Montgomery | Roy | HRKM + OSBM / FPGA+ASIC | Tək-cycle iş, aşağı resource və latency. |
| Montgomery | Wang | PPMM / FPGA | Aşağı cycle count və yüksək operating frequency. |
| Solinas prime | Cao | FFT/IFFT / FPGA | Xüsusi modul strukturu ilə reduction asanlaşır; istifadə edilə bilən modul forması məhduddur. |
| Solinas prime | Zijlstra | NTT/INTT / FPGA | Shift/add/sub ağırlıqlı sadə hardware; xüsusi modul tələb edir. |
Mənbənin ümumi qiymətləndirməsinə görə Barrett və Montgomery ümumi modullar və variable–variable multiplication baxımından daha geniş istifadə imkanına malikdir. Shoup yanaşması variable–constant multiplication üçün səmərəli ola bilər, lakin sabit operand tələbi ümumiliyi məhdudlaşdırır. Solinas və xüsusi-prime strukturları çox sürətli reduction təmin edə bilər, lakin uyğun modul seçimini daraldır.
Bootstrapping FHE Aparatında Niyə Kritikdir?
Bootstrapping, ciphertext daxilində yığılan səs-küyü və ya hesablama dərinliyi sərhədini yeniləyərək leveled FHE-ni nəzəri olaraq sərhədsiz dövrə dərinliyinə yaxınlaşdıran əməliyyat olduğuna görə kritik hesab edilir; lakin BGV/BFV/CKKS tərəfində böyük NTT/INTT, RNS çevrilməsi, key switching, rotation və modulus əməliyyatları, FHEW/TFHE tərəfində isə blind rotation, accumulator yenilənməsi və böyük bootstrapping-key trafiki səbəbindən aparatın ən ağır əməliyyatlarından biridir.
Leveled FHE ilə həqiqi FHE arasındakı mühəndislik fərqi
Leveled FHE əvvəlcədən müəyyən edilmiş məhdud hesablama dərinliyinə kifayət edəcək parametrlərlə işləyə bilər. Dövrə dərinliyi artdıqca ciphertext səs-küyü və modul büdcəsi həddə yaxınlaşır. Bootstrapping ciphertext-i homomorfik şəkildə “yeniləyərək” daha çox hesablama aparmağa davam etməyə imkan verir.
Lakin bootstrapping-in aparat xərci çox yüksəkdir. CKKS/BFV/BGV üçün high-throughput NTT/INTT pipeline, conflict-free multi-bank memory, rotation/key-switching məlumat axını, böyük evaluation-key yaddaşı və bəzi hallarda açarın lazım olduqda yenidən yaradılması əhəmiyyət qazanır.
FHEW/TFHE tərəfində isə blind rotation, homomorphic accumulator, polynomial–vector/matrix multiplication və bootstrapping key bandwidth önə çıxır. Buna görə eyni bootstrapping accelerator arxitekturasının CKKS və TFHE üçün birbaşa eyni şəkildə istifadə olunması gözlənilmir.
Tədqiqatın Metodu və Nəticələri
İcmal metodu
Məqalə öz metodunu narrative review kimi müəyyən edir. Müəlliflər aparat yönümlü ədəbiyyat taraması aparmışlar.
| Element | Mənbədə bildirilən məlumat |
|---|---|
| Zaman aralığı | 2009–2026; xüsusilə 2020-dən sonrakı yeni tədqiqatlara diqqət ayrılmışdır. |
| Verilənlər bazaları | IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar, IACR ePrint. |
| Əsas axtarış terminləri | fully homomorphic encryption, FHE hardware implementation, FHE accelerator, FPGA/ASIC accelerator, polynomial multiplier, NTT/INTT, Toom–Cook, Karatsuba, modular multiplier. |
| Screening | Duplicate qeydlər çıxarılmış; title, abstract və full text üzrə seçim aparılmışdır. |
| Daxil edilən əsas tədqiqat növləri | FHE scheme, hardware accelerator architecture, polynomial multiplication və integer modular multiplication ilə birbaşa əlaqəli tədqiqatlar. |
| İstisna | Yalnız software library yönümlü tədqiqatlar, hardware implementation ehtiva etməyən application-level tədqiqatlar və əlaqəsiz cryptographic hardware. |
| Təşkil | FHE scheme evolution, accelerator type, core arithmetic component və implementation platform. |
Metodda bildirilməyən elementlər
- Başlanğıcda tapılan ümumi qeyd sayı verilməyib.
- Duplicate-lərdən sonra neçə qeyd qaldığı bildirilməyib.
- Title/abstract və full-text mərhələlərində neçə tədqiqatın çıxarıldığı açıqlanmayıb.
- Yekun daxil edilən tədqiqat sayı metod bölməsində vahid ümumi say kimi verilməyib.
- PRISMA axın diaqramı yoxdur.
- Əvvəlcədən qeydiyyata alınmış review protocol məlumatı bildirilməyib.
- Mənbə tədqiqatlar üçün formal risk-of-bias və ya keyfiyyət ballandırma sistemi bildirilməyib.
- Meta-analysis aparılmayıb.
Buna görə tədqiqat geniş və strukturlaşdırılmış ədəbiyyat taraması təqdim etsə də, nəticələr kəmiyyət meta-analysis nəticəsi kimi şərh edilməməlidir.
İcmalın müəyyən etdiyi üç əsas mövcud problem
- Dağınıq xüsusi aparat blokları: NTT/INTT, modular arithmetic, modulus raising/reduction və rescaling kimi fərqli primitive-lər üçün ayrı sürətləndiricilərdən istifadə edilməsi ortaq processing unit-lərin təkrarına və hardware utilization-ın azalmasına səbəb ola bilər.
- Sxemə həddindən artıq ixtisaslaşma: Bir çox sürətləndirici yalnız müəyyən BFV, CKKS, TFHE və ya başqa FHE ailəsi üçün optimallaşdırılır; fixed datapath başqa parametr və ya alqoritmlərə uyğunluğu məhdudlaşdırır.
- Tətbiq tələbləri ilə tam uyğunlaşmama: Neural-network training, multi-party secure computation və federated learning kimi iş yükləri latency, depth, precision, memory, communication və power baxımından ümumi FHE accelerator-dan fərqli tələblərə malikdir.
Gələcək istiqamət 1 — Yenidən konfiqurasiya edilə bilən və paylaşılan accelerator
Müəlliflər gələcək aparatın operator-specific nüvələr əvəzinə qatlı reconfigurable architecture-a yönəlməsini təklif edirlər. Alt qatda modular arithmetic, butterfly array, NTT/INTT, point-wise multiplier, RNS channel və on-chip memory bank kimi ortaq vahidlər müxtəlif sxemlər tərəfindən paylaşıla bilər.
Orta qatda programmable modulus-reduction mode, flexible radix, microcoded instruction scheduling və parametrləşdirilə bilən \(N\), \(q\), RNS base və decomposition base dəstəyi hədəflənir.
Üst qatda isə BFV base extension/scaling, CKKS rescaling/approximate modulus conversion və TFHE accumulator update kimi sxemə xas axınların microprogram və ya xüsusi functional extension kimi qorunması təklif olunur.
Gələcək istiqamət 2 — Bootstrapping yönümlü accelerator
İcmal finite-depth əməliyyatlar üçün optimallaşdırılmış sürətləndiricilərdən unbounded-depth computation-u daha birbaşa dəstəkləyən bootstrapping accelerators-a keçidi mühüm tədqiqat istiqaməti kimi görür.
Leveled sxemlərdə large-parameter NTT/INTT, RNS base conversion, key switching, slot rotation və rescaling; bit-bootstrappable sxemlərdə blind rotation, accumulator və key bandwidth fərqli aparat fokusları yaradır. Mənbə bəzi vahidlərin ortaqlaşdırıla biləcəyini, bəzi mexanizmlərin isə sxemə xas qalmalı olduğunu müdafiə edir.
Gələcək istiqamət 3 — Tətbiq əsaslı hardware–software co-design
Müəlliflər gələcək accelerator dizaynının yalnız kriptoqrafik primitive-ə görə deyil, hədəf application workload-a görə hazırlanmalı olduğunu bildirirlər.
Encrypted neural-network inference üçün SIMD packing, rotation, key switching, matrix-vector multiplication, convolution, nonlinear approximation və lazım gəldikdə bootstrapping birlikdə optimallaşdırılmalıdır.
Federated learning-də encryption/decryption-dan daha geniş problem var: secure aggregation, ciphertext packing, communication compression, homomorphic matrix–vector computation və cross-institution feature interaction eyni pipeline daxilində qiymətləndirilməlidir.
Edge və IoT tərəfində isə low area, low power, kiçik storage footprint, compact parameter set, lightweight modular arithmetic və edge–cloud task partitioning prioritetə çevrilir.
Tədqiqatın dəstəklədiyi nəticələr
- FHE-nin praktik aparat xərcində polynomial multiplication və modular multiplication mərkəzi rol oynayır.
- BFV və CKKS-də RNS və böyük polinom arifmetikası aparat paralelliyinin əsas mövzularındandır.
- FHEW/TFHE fərqli ciphertext və bootstrapping strukturları səbəbindən fərqli accelerator datapath-lərinə ehtiyac duyur.
- RLWE əsaslı accelerator tədqiqatları son illərdə scheme-level və system-level co-design istiqamətinə keçir.
- NTT/INTT çox güclü polynomial multiplication variantıdır, lakin modulus və twiddle-factor/memory tələbləri var.
- Toom–Cook/Karatsuba daha çevik modulus/polynomial şərtləri və uyğun resource şəraitində mühüm alternativdir.
- Barrett, Montgomery, Shoup və Solinas vurucuları arasında efficiency ilə modulus/operand flexibility arasında əsas trade-off var.
- Bootstrapping dəstəyi gələcək FHE accelerators üçün əsas dizayn hədəflərindən biridir.
- Application-specific hardware–software co-design ümumi primitive sürətləndirilməsindən daha bütüncül sistem optimallaşdırmasına doğru istiqamət göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
- İcmal tək bir FHE accelerator-ın bütün digərlərindən universal olaraq daha yaxşı olduğunu göstərmir.
- Fərqli məqalələrdəki speedup nisbətləri ortaq test sistemi ilə ölçülmədiyi üçün birbaşa eyni miqyasda sıralana bilməz.
- İcmal öz yeni FPGA və ya ASIC prototipini istehsal etmir.
- İcmal öz energy, latency və ya area benchmark verilənlər dəstini yaratmır.
- FHE-nin bütün sistem təhlükəsizliyi problemlərini avtomatik həll etdiyi nəticəsi çıxarıla bilməz; bu icmalın əsas fokusu hardware performance-dır.
- ML-KEM, ML-DSA, Saber və ya NTRU Prime nümunələrinin FHE sxemi olduğu nəticəsi çıxarıla bilməz; mənbə bunlardan ortaq arithmetic hardware nümunələri kimi istifadə edir.
- Paillier nümunəsi tam homomorfik deyil; mənbə bunu federated-learning hardware engineering baxımından istinad nümunəsi kimi açıq şəkildə ayırır.
- Hər tətbiq üçün NTT-nin və ya Karatsuba-nın yeganə doğru polynomial multiplier olduğu nəticəsi çıxarıla bilməz.
İcmalın təkrar istehsal oluna bilmə sərhədləri
Mənbə axtarış aparılan akademik verilənlər bazalarını, tarix aralığını, əsas açar sözləri və daxil etmə/istisna yanaşmasını bildirir. Bu, adi anlatısal ədəbiyyat xülasəsindən daha izlənə bilən axtarış çərçivəsi yaradır.
Bununla yanaşı, axtarış sətirlərinin hər verilənlər bazası üçün tam Boolean forması, axtarışın dəqiq tarixləri, qeyd sayı, duplicate sayı, exclusion reason bölgüsü və formal quality assessment yoxdur. Buna görə başqa tədqiqatçının eyni məqalə hovuzunu tam eynilə yenidən qurması üçün lazım olan bütün systematic-review metadata mövcud deyil.
Həmçinin icmalda verilən performans nəticələri müəlliflərin yenidən benchmark etdiyi məlumatlar deyil; orijinal məqalələrin bildirdiyi nəticələrdir. Aparat prosesi, FPGA ailəsi, saat tezliyi, FHE parametrləri, security level, software baseline və workload fərqli olduğundan müqayisəli cədvəllər daha çox arxitektur meylləri anlamaq üçün istifadə edilməlidir.
Mənbə və Metod Qeydi
Orijinal başlıq: A Brief Survey on Hardware Implementation of Fully Homomorphic Encryption
Müəlliflər: Yang Su; Kaixuan Zhou; Weidong Zhong; Jianfei Wang; Jia Hou; Chen Yang.
Müəllif sırası: Yang Su birinci, Kaixuan Zhou ikinci, Weidong Zhong üçüncü, Jianfei Wang dördüncü, Jia Hou beşinci, Chen Yang altıncı müəllifdir.
Məsul müəllif: Weidong Zhong.
Qurum 1: School of Cryptography Engineering, Engineering University of People’s Armed Police, Xi’an 710086, China.
Qurum 2: School of Microelectronics, Xi’an Jiaotong University, Xi’an 710049, China.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik və ya bərabər töhfə işarəsi yoxdur.
Jurnal: Cryptography.
Nəşriyyat: MDPI, Basel, Switzerland.
Cild / nömrə / məqalə: 10(4), 49.
Səhifə sayı: 34.
DOI: 10.3390/cryptography10040049.
Göndərilmə tarixi: 3 iyun 2026.
Reviziya tarixi: 4 iyul 2026.
Qəbul tarixi: 8 iyul 2026.
Nəşr tarixi: 13 iyul 2026.
Məqalə növü: Review; mənbə öz metodunu narrative review kimi təsvir edir.
Rəy prosesi: Cryptography üçün rəsmi MDPI materiallarında single-blind peer review göstərilir.
Preprint statusu: Emal edilən sənəd nəşr olunmuş jurnal versiyasıdır; bu Verianla məzmununda preprint istifadə edilməyib.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Rəsmi nəşr bağlantısı: DOI 10.3390/cryptography10040049 vasitəsilə MDPI Cryptography məqalə qeydi.
Akademik redaktorlar: Ki-Hyun Jung və Luis Javier García Villalba.
Açar sözlər: fully homomorphic encryption (FHE); hardware implementation; accelerator; polynomial multiplier; modular multiplier.
İcmal dövrü: 2009–2026; xüsusilə 2020-dən sonrakı ədəbiyyata fokuslanılıb.
Araşdırılan mənbələr: IEEE Xplore, ACM Digital Library, SpringerLink, ScienceDirect, Web of Science, Google Scholar və IACR ePrint.
Daxil etmə fokusu: FHE schemes, hardware accelerator architecture, polynomial multiplication və integer modular multiplication.
İstisna fokusu: Yalnız software library tədqiqatları, hardware implementation ehtiva etməyən application-level tədqiqatlar və əlaqəsiz cryptographic hardware.
Yeni eksperimental məlumat: Yoxdur. Mənbə yeni məlumat yaratmadığını və ya təhlil etmədiyini açıq bildirir; nəticələr dərc olunmuş ədəbiyyatdan və ictimaiyyətə açıq nəzəri modellərdən əldə edilib.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almayıb.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan edirlər.
Məlumat əlçatanlığı: Yeni məlumat yaradılmadığı üçün data sharing bu icmal üçün tətbiq edilə bilməz.
Müəllif töhfələri: Rəsmi MDPI qeydinə görə konseptuallaşdırma Yang Su və Kaixuan Zhou; metodologiya Yang Su və Kaixuan Zhou; supervision və resources Weidong Zhong; formal analysis, visualization və investigation Jianfei Wang ilə Jia Hou; review/editing və project administration Chen Yang tərəfindən həyata keçirilib. Bütün müəlliflərin nəşr olunan versiyanı oxuyub qəbul etdiyi bildirilir.
Etik komitə / insan-heyvan tədqiqatı: Tədqiqat orijinal insan və ya heyvan məlumatı yaratmayan ədəbiyyat icmalıdır; mənbədə ayrıca insan/animal experimental protocol bildirilməyib.
Mənbə şəkilləri: Şəkil 1 FHE cloud privacy modelini, Şəkil 2 hardware accelerator classification framework-ünü, Şəkil 3 FHE parameter/polynomial multiplier selection qərarını göstərir. Verianla-da bunların üçü də mənbə əlaqələrindən müstəqil inline SVG kimi yenidən qurulub.
Mənbə cədvəlləri: Cədvəl 1 BFV/CKKS/FHEW-TFHE xüsusiyyətlərini; Cədvəl 2 bütün FHE accelerators-ı; Cədvəl 3 NTT/INTT polynomial multipliers-ı; Cədvəl 4 Karatsuba/Toom–Cook polynomial multipliers-ı; Cədvəl 5 integer modular multipliers-ı müqayisə edir.
Əsas metodoloji sərhəd: Tədqiqat narrative review-dür. Verilənlər bazaları, zaman aralığı və screening məntiqi bildirilsə də, PRISMA axını, ümumi qeyd/daxil edilən tədqiqat sayı, qeydiyyatdan keçmiş protokol, formal keyfiyyət qiymətləndirməsi və meta-analysis bildirilməyib.
Müqayisə sərhədi: İcmalda verilən speedup, latency, throughput, area və energy dəyərləri fərqli orijinal tədqiqatlardan gəlir. Fərqli hardware technology, FPGA/ASIC/CPU, clock frequency, security parameter, polynomial degree, modulus, workload və software baseline istifadə edildiyi üçün dəyərlər birbaşa ortaq benchmark nəticəsi kimi sıralanmamalıdır.
Əhatə qeydi: İcmal bəzi FHE olmayan post-kvant kriptoqrafiya tədqiqatlarını polynomial multiplier və ya modular arithmetic hardware dizaynına nümunə kimi istifadə edir. Bu nümunələrin FHE sxemi olduğu nəticəsi çıxarılmayıb.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib