


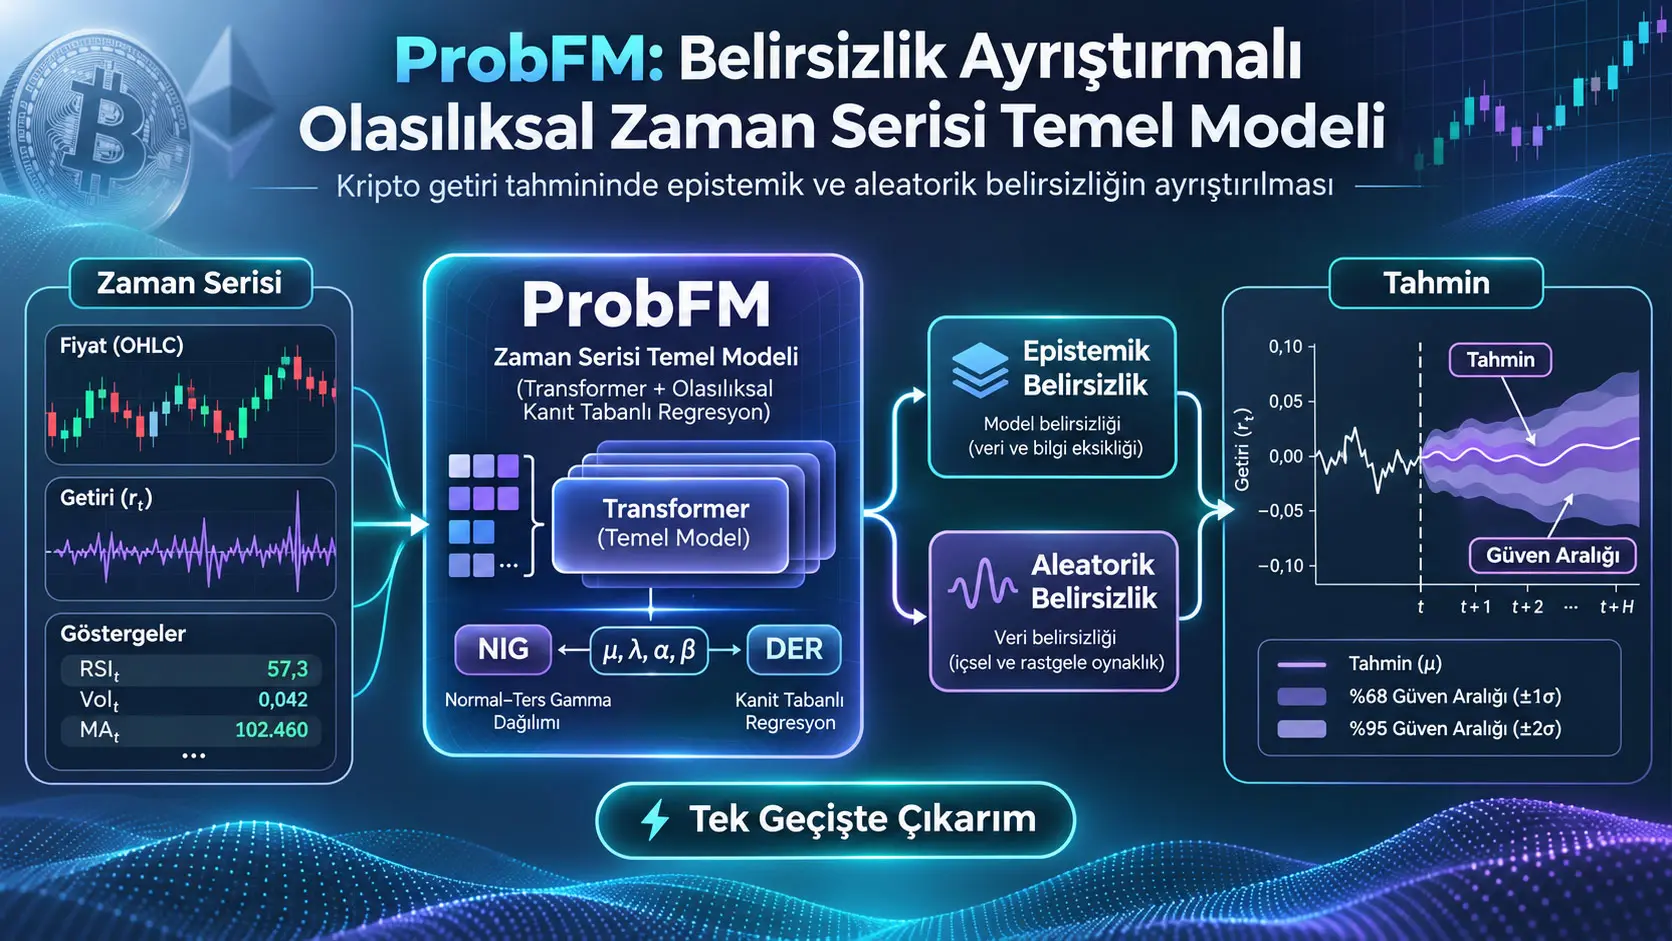
ProbFM (Probabilistic Foundation Model), zaman serisi tahmininde yalnız bir nokta tahmini üretmek yerine tahmin belirsizliğini epistemik ve aleatorik bileşenlere ayırmayı amaçlayan, Deep Evidential Regression (DER) ile Normal-Inverse-Gamma (NIG) dağılımını kullanan olasılıksal bir zaman serisi çerçevesidir. Çalışma bir tarafta adaptif patching, Transformer omurgası, DER başlığı, coverage loss ve evidence annealing içeren tam ProbFM mimarisini tanımlar; diğer tarafta belirsizlik yönteminin katkısını mimari farklılıklardan ayırmak amacıyla bütün karşılaştırma yöntemlerini aynı 1 katmanlı, 32 gizli boyutlu LSTM üzerinde sınar. Ampirik değerlendirme 1 Ocak 2020–3 Ekim 2025 arasındaki ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT ve XRP günlük log getirilerini kullanır.
DER'nin temel amacı “model ne kadar yanılıyor?” sorusuna ek olarak “bu belirsizlik modelin yeterince bilgi sahibi olmamasından mı, yoksa verinin doğası gereği gürültülü olmasından mı kaynaklanıyor?” sorusunu ayırmaktır. Çalışmada epistemik belirsizlik, model parametreleri hakkındaki belirsizliği ve ilkesel olarak daha fazla bilgiyle azaltılabilecek kısmı; aleatorik belirsizlik ise gözlem sürecindeki veya piyasa verisindeki indirgenemez gürültüyü temsil eder. NIG yapısı bu iki bileşenin tek ileri geçişte ayrı ayrı hesaplanmasını sağlar.
BTC için Evidential Regression “ProbFM core”, RMSE 0,045 ve MAE 0,030 ile diğer modellerle benzer nokta tahmin hatası göstermektedir. Buna karşılık %95 tahmin aralıklarında PICP yalnız 0,46'dır; yani hedeflenen %95 kapsamanın çok altında kalır. ProbFM core aynı BTC deneyinde yıllık Sharpe 1,33, Sortino 2,27, Calmar 3,04 ve kazanma oranı 0,52 ile kaynak tablosundaki güçlü risk-ayarlı işlem sonuçlarından birini üretir. Ancak işlem simülasyonu komisyon, slippage ve market impact içermediği için bu değerler gerçek piyasa net getirisi veya uygulanabilir yatırım performansı olarak yorumlanamaz.
Çalışmanın önemli yöntemsel sınırı, yayımlanan karşılaştırmalı deneylerin tam Transformer ProbFM mimarisini doğrudan benchmark etmemesidir. Deneyler DER belirsizlik mekanizmasını izole etmek için aynı LSTM omurgasını kullanır. Dolayısıyla çalışma, DER tabanlı belirsizlik ayrıştırmasının kontrollü LSTM ortamındaki davranışı için ampirik kanıt sunarken, tam ProbFM Transformer mimarisinin sıfır-atışlı veya geniş çaplı foundation-model üstünlüğünü bu veri tablolarıyla kanıtlamaz.
ProbFM Nedir ve Bu Çalışmada Ne Yapmayı Amaçlar?
ProbFM, zaman serisi girdisini işleyerek yalnız gelecek değerin merkez tahminini değil, tahmine eşlik eden epistemik ve aleatorik belirsizlik bileşenlerini de üreten DER/NIG tabanlı olasılıksal bir model çerçevesidir; önerilen tam mimari adaptif patching, konumsal kodlama, Transformer temsil öğrenmesi, NIG parametrelerini üreten evidential başlık, coverage-aware kayıp ve tek-geçişli belirsizlik çıkarımından oluşur.
Çalışmanın çözmeye çalıştığı problem
Standart zaman serisi modelleri yalnız “yarınki getiri tahmini nedir?” sorusuna odaklanabilir. Finansal uygulamalarda ise aynı tahmin değerinin ne kadar güvenilir olduğu da önemlidir. Örneğin iki modelin ikisi de ertesi gün için %1 pozitif getiri tahmin edebilir; fakat modellerden biri çok güçlü veri desteğine sahipken diğeri daha önce görmediği bir piyasa rejiminde çalışıyor olabilir.
Çalışma bu nedenle toplam tahmin belirsizliğini iki farklı kaynağa ayırır. Epistemik belirsizlik model bilgisindeki eksikliği, aleatorik belirsizlik ise veri üretim sürecinin kendi gürültüsünü temsil eder. Bu ayrım özellikle risk yönetiminde önemlidir; çünkü “daha fazla veri toplamak” epistemik belirsizliği azaltabilirken gerçek piyasa rastlantısallığını temsil eden aleatorik belirsizliği ortadan kaldırmaz.
Epistemik ve Aleatorik Belirsizlik Arasındaki Fark Nedir?
Epistemik belirsizlik modelin bilmediği veya yeterince öğrenmediği kısımdan kaynaklanan ve uygun yeni veriyle azaltılabilen model belirsizliğidir; aleatorik belirsizlik ise veri üretim sürecindeki içsel gürültü ve rastlantısallığı temsil eder ve yalnız daha fazla veri eklemekle zorunlu olarak ortadan kalkmaz. ProbFM bu iki bileşeni NIG posteriorundan ayrı matematiksel büyüklükler olarak çıkarır.
Normal-Inverse-Gamma yapısı
Tek değişkenli ve tek adımlı zaman serisi problemi için veri kümesi:
\[ \mathcal{D}=\{(x_i,y_i)\}_{i=1}^{N} \]
olarak tanımlanır. \(x_i\in\mathbb{R}^{T}\), uzunluğu \(T\) olan geçmiş zaman penceresini; \(y_i\in\mathbb{R}\) ise tek-adım ileri hedefi temsil eder.
Geleneksel olasılıksal yaklaşım doğrudan:
\[ f_\theta:x\rightarrow p(y\mid x) \]
eşlemesini öğrenirken DER:
\[ f_\theta:x\rightarrow p(\phi\mid x) \]
eşlemesini öğrenir. Buradaki \(\phi\), tahmin dağılımının parametreleridir. Böylece ağ yalnız dağılım parametrelerini tahmin etmek yerine bu parametrelerin kendileri hakkındaki kanıt ve belirsizliği temsil etmeye çalışır.
Denklem (1): NIG prior
\[ p(\mu,\sigma^2)=\operatorname{NIG}(\mu,\lambda,\alpha,\beta) \tag{1} \]
Bu ifade, Gaussian dağılımının ortalaması ve varyansı hakkındaki belirsizliğin Normal-Inverse-Gamma ailesiyle temsil edildiğini belirtir. \(\mu\) merkezi tahminle, \(\lambda\) ortalama parametresinin kesinliğiyle, \(\alpha\) ve \(\beta\) ise inverse-gamma varyans bileşeniyle ilişkilidir.
Denklem (2) ve (3): NIG ayrıştırması
\[ p(\mu\mid\sigma^2) = \mathcal{N}\left(\mu,\frac{\sigma^2}{\lambda}\right) \tag{2} \]
\[ p(\sigma^2) = \operatorname{Inverse\mbox{-}Gamma}(\alpha,\beta) \tag{3} \]
İlk denklem ortalama parametresi üzerindeki Gaussian koşullu dağılımı, ikinci denklem ise varyans hakkındaki inverse-gamma dağılımını temsil eder. \(\lambda\) büyüdüğünde ortalama parametresine ilişkin varyans küçülür; başka bir deyişle modelin ortalama konusundaki epistemik belirsizliği azalabilir.
Denklem (4): tahmin edilen ortalama
\[ \mathbb{E}[y\mid x]=\mu \tag{4} \]
Modelin tek nokta tahmini \(\mu\)'dur.
Denklem (5): aleatorik belirsizlik
\[ U_{\text{aleatoric}} = \mathbb{E}[\sigma^2\mid x] = \frac{\beta}{\alpha-1} \tag{5} \]
Bu büyüklük veri gürültüsüne atfedilen belirsizlik bileşenidir. Formülün sonlu olması için \(\alpha>1\) gerekir. \(\beta\) diğer değişkenler sabitken arttığında aleatorik varyans artar; \(\alpha\) büyüdüğünde azalır.
Denklem (6): epistemik belirsizlik
\[ U_{\text{epistemic}} = \operatorname{Var}[\mu\mid x] = \frac{\beta}{(\alpha-1)\lambda} \tag{6} \]
Aleatorik terimden farklı olarak epistemik belirsizlikte ek olarak \(\lambda\) bulunur. \(\lambda\) büyüdükçe modelin ortalama tahmini hakkındaki epistemik belirsizlik küçülür.
Çok ufuklu tahmine genişletme
Kaynak, NIG yapısının tek değişkenli ve tek-adımlı tahmin için kullanıldığını; gelecekte çok ufuklu veya çok değişkenli tahminde Normal-Inverse-Wishart (NIW) prior kullanılabileceğini belirtir. Bu genişletme çalışmada uygulanmış ampirik bir sonuç değildir; gelecekteki mimari yön olarak sunulur.
Adaptif patching neden kullanılıyor?
ProbFM'nin önerilen Transformer mimarisi uzun zaman serisini tek tek zaman noktaları yerine “patch” adı verilen parçalara ayırır. Kaynağın frekans tabanlı patch büyüklüğü eşlemesi şöyledir:
| Zaman serisi frekansı | Önerilen patch büyüklüğü |
|---|---|
| Yıllık / üç aylık | 8 |
| Aylık | 8, 16, 32 |
| Haftalık / günlük | 16, 32 |
| Saatlik | 32, 64 |
| Dakika düzeyi | 32, 64, 128 |
| Saniye düzeyi | 64, 128 |
Kaynağın amacı, farklı zaman çözünürlüklerinde aynı temporal granülerliğin zorla kullanılmasını önlemektir. Bununla birlikte bu patch seçeneklerinin her birinin ayrı ablasyon sonucu çalışmada verilmez.
Denklem (8) ve (9): patch ve embedding
\[ X_{\text{patches}} = \operatorname{Patching}(X_{\text{raw}},\text{patch\_size}) \tag{8} \]
\[ X_{\text{encoded}} = \operatorname{LinearProjection}(X_{\text{patches}}) + \operatorname{PositionalEncoding} \tag{9} \]
İlk adım ham zaman serisini patch'lere ayırır. İkinci adım patch'leri Transformer'ın kullanabileceği gömme uzayına yansıtır ve zaman sırasının kaybolmaması için konumsal kod ekler.
Denklem (10): sinüzoidal konumsal kodlama
\[ PE_{(t,d)} = \begin{cases} \sin\left(t/10000^{d/d_{\text{model}}}\right), & d\text{ çift ise}\\ \cos\left(t/10000^{d/d_{\text{model}}}\right), & d\text{ tek ise} \end{cases} \tag{10} \]
\(t\) dizideki zaman konumunu, \(d\) embedding boyut indeksini, \(d_{\text{model}}\) ise toplam embedding boyutunu belirtir. Sinüs ve kosinüs frekanslarının boyuta göre değişmesi, Transformer'ın dizideki göreli ve mutlak konum ilişkilerinden yararlanmasını sağlar.
Denklem (11): Multi-Head Attention'ın temel attention işlemi
\[ \operatorname{Attention}(Q,K,V) = \operatorname{softmax} \left( \frac{QK^{T}}{\sqrt{d_k}} \right)V \tag{11} \]
\(Q\) sorgu, \(K\) anahtar ve \(V\) değer matrislerini temsil eder. \(QK^T\), farklı zaman-patch temsillerinin birbirine ne kadar dikkat etmesi gerektiğini ölçen benzerlik skorlarını üretir. \(\sqrt{d_k}\) ölçekleme terimi, boyut büyüdüğünde iç çarpımların aşırı büyümesini sınırlamaya yardım eder.
Denklem (12): feed-forward ağ
\[ \operatorname{FFN}(x) = \operatorname{SwiGLU}(W_1x+b_1) \tag{12} \]
SwiGLU, Transformer bloklarındaki doğrusal olmayan dönüşüm katmanında kullanılan kapılı aktivasyon ailesidir.
DER başlığı NIG parametrelerini nasıl üretir?
\[ \mu=W_\mu h+b_\mu \tag{13} \]
\[ \lambda= \operatorname{Softplus}(W_\lambda h+b_\lambda)+\epsilon \tag{14} \]
\[ \alpha= \operatorname{Softplus}(W_\alpha h+b_\alpha)+1+\epsilon \tag{15} \]
\[ \beta= \operatorname{Softplus}(W_\beta h+b_\beta)+\epsilon \tag{16} \]
\(h\), Transformer'ın son temsilidir. \(\mu\) gerçek sayı olabilir; \(\lambda\) ve \(\beta\) pozitif, \(\alpha\) ise 1'den büyük olmak zorundadır. Softplus dönüşümü bu alan kısıtlarını ağ çıktısına uygular. \(\epsilon\), tam sıfır değer nedeniyle oluşabilecek geçersiz parametreleri önleyen küçük pozitif sabittir; kaynak bu sabitin sayısal değerini ana mimari bölümünde vermemektedir.
Evidential loss nasıl çalışıyor?
Kaynağın temel evidential kayıp fonksiyonu:
\[ \mathcal{L}_{EDL} = \mathcal{L}_{NLL} + \lambda_{\text{evd}}\mathcal{L}_{reg} \tag{17} \]
şeklindedir. \(\mathcal{L}_{NLL}\), tahmin edilen olasılık dağılımının gerçek hedefe ne kadar uygun olduğunu; \(\mathcal{L}_{reg}\) ise yanlış tahmin yaparken aşırı yüksek kanıt/özgüven üretilmesini cezalandırır. \(\lambda_{\text{evd}}\), iki bileşenin göreli ağırlığını belirler. Kontrollü deney yapılandırmasında \(\lambda_{\text{evd}}=0,1\) raporlanır.
Denklem (18): NIG negatif log-likelihood
\[ \begin{aligned} \mathcal{L}_{NLL} ={}& \frac{1}{2}\log\left(\frac{\pi}{\lambda}\right) -\alpha\log(\Omega)\\ &+ \left(\alpha+\frac{1}{2}\right) \log\left( \frac{(y-\mu)^2}{\lambda}+\Omega \right)\\ &+ \log\left( \frac{\Gamma(\alpha)} {\Gamma\left(\alpha+\frac{1}{2}\right)} \right), \end{aligned} \tag{18} \]
\[ \Omega=2\beta(1+\lambda) \]
Bu denklem NIG yapısının marjinal Student-t tahmin dağılımından türeyen likelihood maliyetidir. Tahmin hedefe uzaklaştığında \((y-\mu)^2\) terimi büyür ve kayıp yükselir. Aynı zamanda dağılımın belirsizlik parametreleri de kaybı belirler.
Denklem (19): evidential regularization
\[ \mathcal{L}_{reg} = |\hat{y}-y|\cdot(\alpha+\nu-2) \tag{19} \]
Bu terim, hata yüksekken modelin aşırı yüksek kanıt üretmesini cezalandırmak için kullanılır. Ancak kaynak burada önceki NIG denklemlerindeki \(\lambda\) yerine \(\nu\) sembolünü kullanır. Appendix C'de de DER parametreleri \((\gamma,\nu,\alpha,\beta)\) biçiminde raporlanırken mimari bölümünde \((\mu,\lambda,\alpha,\beta)\) kullanılır. Kaynak bu iki notasyon arasındaki eşlemeyi açıkça tanımlamamaktadır; bu nedenle Verianla sembolleri sessizce birbirinin yerine koymamaktadır.
Coverage loss neyi amaçlıyor?
\[ \mathcal{L}_{coverage} = |\operatorname{PICP}_{target} - \operatorname{PICP}_{actual}| \tag{20} \]
Burada amaç, gerçek kapsama oranını hedef kapsama oranına yaklaştırmaktır. Örneğin %95 tahmin aralığı hedefleniyorsa:
\[ \operatorname{PICP}_{target}=0.95 \]
olur.
Gerçek PICP:
\[ \operatorname{PICP}_{actual} = \frac{1}{N} \sum_{i=1}^{N} \mathbb{I} \left( y_i\in [CI_{\text{lower},i},CI_{\text{upper},i}] \right) \tag{21} \]
olarak hesaplanır. Gösterge fonksiyonu gerçek hedef aralık içindeyse 1, değilse 0 üretir. Bu değerlerin ortalaması, tahmin aralıklarının gerçek hedefleri kapsama oranıdır.
Önemli yorum sınırı şudur: loss fonksiyonuna coverage terimi eklemek, test setinde otomatik olarak %95 coverage elde edileceğini garanti etmez. Nitekim BTC için kaynak Tablo 3'te ProbFM core PICP yalnız 0,46'dır.
Birleşik kayıp
\[ \mathcal{L}_{ProbFM} = \mathcal{L}_{EDL} + \lambda_{coverage}\mathcal{L}_{coverage} + \lambda_{wd}\|\theta\|_2^2 \tag{22} \]
Birinci terim evidential tahmin, ikinci terim tahmin aralığı coverage hedefi, üçüncü terim ise L2 ağırlık düzenlileştirmesidir. Kaynak \(\lambda_{coverage}\)'ın sabit tutulduğunu belirtir ancak kontrollü deney için sayısal değerini raporlamaz.
Optimizer ve gradient clipping
Kaynak ana ProbFM eğitim bölümünde AdamW kullandığını belirtir ve güncellemeyi:
\[ \theta_{t+1} = \theta_t - \eta\cdot \operatorname{clip} (\nabla_\theta\mathcal{L},\operatorname{max\_norm}) \tag{23} \]
şeklinde gösterir. Bu denklem clipping mantığını öne çıkaran sadeleştirilmiş bir güncelleme ifadesidir. Kaynak max norm için genel olarak 1,0–5,0 aralığını söyler; kontrollü LSTM deneyinin Appendix C yapılandırmasında ise max norm 1,0'dır.
Appendix C ayrıca kontrollü deneylerde optimizer'ı Adam olarak verir. Ana mimari bölümü AdamW yazdığı için iki bilgi farklı deney bağlamlarına ait olabilir; ancak kaynak bu ayrımı açık bir eşleme tablosuyla açıklamamaktadır.
Denklem (24): cosine annealing notu
Kaynak öğrenme oranı programını:
\[ \eta_t = \eta_{\text{base}} \cos\left( \frac{\pi t}{T_{\text{total}}} \right) \operatorname{warmup}(t) \tag{24} \]
olarak yazar. Bu formül yazıldığı biçimiyle \(t>T_{\text{total}}/2\) olduğunda kosinüs teriminin negatifleşmesine izin verir. Kaynak bunun yalnız şematik bir gösterim mi, yoksa gerçek kodda kullanılan schedule mı olduğunu açıklamamaktadır. Bu nedenle Verianla standart cosine schedule formülünü kaynağın yerine koyarak sessiz düzeltme yapmamaktadır.
Denklem (25): evidence annealing
\[ \operatorname{evidence\_scale}(t) = \min\left(1.0,\frac{t}{T_{\text{anneal}}}\right) \tag{25} \]
Bu faktör eğitimin başında 0'dan başlayıp \(T_{\text{anneal}}\) adımında 1'e ulaşır. Kaynak tipik olarak toplam eğitimin %10–20'si boyunca artırıldığını belirtir. Amaç, ağ temsil öğrenmeden önce aşırı özgüvenli evidential parametreler üretmesini sınırlamaktır.
Tek geçişte çıkarım
Tahmin sırasında DER başlığı dört NIG parametresini tek forward pass ile üretir. Kaynağın nokta tahmini:
\[ \hat{y}=\mu \tag{26} \]
Toplam tahmin varyansı:
\[ \operatorname{Var}[y\mid x] = \frac{\beta}{\alpha-1} \left( 1+\frac{1}{\lambda} \right) \tag{27} \]
Epistemik belirsizlik:
\[ U_{\text{epistemic}} = \frac{\beta}{(\alpha-1)\lambda} \tag{28} \]
Aleatorik belirsizlik:
\[ U_{\text{aleatoric}} = \frac{\beta}{\alpha-1} \tag{29} \]
olarak verilir.
Denklem (27) açık biçimde Denklem (28) ve (29)'un toplamıdır:
\[ \operatorname{Var}[y\mid x] = U_{\text{aleatoric}} + U_{\text{epistemic}} \]
Bu son eşitlik kaynak denklemlerinin doğrudan cebirsel sonucudur; yeni deneysel bulgu değildir.
Tahmin aralığı
Kaynak posterior predictive dağılımın Student-t olduğunu belirterek:
\[ CI_{1-\alpha} = \hat{y} \pm t_{2\alpha,\alpha/2} \sqrt{ \frac{\beta(\lambda+1)} {\alpha\lambda} } \tag{30} \]
ifadesini verir ve Student-t serbestlik derecesini \(2\alpha\) olarak tanımlar.
Notasyon uyarısı: Aynı bölümde \(\alpha\) hem NIG dağılımının shape parametresi olarak hem de \(1-\alpha\) güven düzeyi gösteriminde kullanılmış görünmektedir. Bu nedenle Denklem (30)'da sembol anlamı bağlama göre belirsizleşmektedir. Verianla kaynak denklemi değiştirmeden bu sembol çakışmasını görünür tutmaktadır.
CRPS nedir?
Continuous Ranked Probability Score (CRPS), yalnız nokta tahminini değil tüm tahmin dağılımını gerçek gözlemle karşılaştıran olasılıksal tahmin metriğidir. Daha düşük CRPS kaynakta daha iyi olarak yorumlanır.
Gaussian tahmin için kaynak:
\[ CRPS = \sigma \left[ z(2\Phi(z)-1) + 2\phi(z) - \frac{1}{\sqrt{\pi}} \right] \tag{31} \]
formülünü kullanır ve:
\[ z=\frac{y-\mu}{\sigma} \]
tanımını verir. \(\Phi\), standart normal dağılımın kümülatif dağılım fonksiyonu; \(\phi\) ise olasılık yoğunluk fonksiyonudur.
PICP, sharpness ve uncertainty-error correlation birlikte nasıl okunmalı?
PICP, gerçek gözlemlerin tahmin aralığının içinde kalma oranıdır. %95 aralık için iyi kalibrasyonda PICP'nin 0,95 civarında olması beklenir.
Sharpness, tahmin aralığının ortalama genişliğidir. Daha dar aralık tek başına daha iyi değildir; aralık çok dar olduğu için gerçek değerleri dışarıda bırakıyorsa model aşırı özgüvenli olabilir.
Uncertainty-Error Correlation, tahmin edilen belirsizliğin gerçek tahmin hatasıyla Pearson korelasyonudur. Pozitif değer, modelin zor örneklere daha yüksek belirsizlik atama eğilimine işaret eder. Sıfıra yakın veya negatif değer bu ilişkiyi desteklemez.
ProbFM'nin %95 Tahmin Aralıkları Gerçekten İyi Kalibre mi?
Kaynak sonuçlarına göre bütün varlıklar için hayır: ProbFM core %95 hedefli aralıklarda BTC'de PICP 0,46, ADA'da 0,31, SOL'da 0,39 ve XRP'de 0,36 üretirken DOGE ve ETH'de 1,00'a ulaşır; bu geniş değişkenlik, coverage loss eklenmiş olmasına rağmen incelenen testlerde kalibrasyonun varlıklar arasında tutarlı biçimde %95 hedefine oturmadığını gösterir.
| Varlık | CRPS | PICP (%95 hedef) | Sharpness | Belirsizlik-Hata Korelasyonu |
|---|---|---|---|---|
| BTC | 2,65 | 0,46 | 3,90 | 0,00 |
| ADA | 3,39 | 0,31 | 3,32 | 0,09 |
| BNB | 1,30 | 0,68 | 3,63 | −0,12 |
| DASH | 1,57 | 0,59 | 3,49 | 0,04 |
| DOGE | 0,25 | 1,00 | 3,77 | 0,18 |
| ETH | 0,29 | 1,00 | 4,17 | 0,22 |
| LTC | 2,69 | 0,46 | 3,56 | 0,03 |
| SOL | 2,96 | 0,39 | 3,85 | −0,14 |
| USDC | 2,32 | 0,78 | 7,44 | −0,04 |
| USDT | 2,54 | 0,45 | 3,56 | −0,01 |
| XRP | 2,90 | 0,36 | 3,25 | −0,03 |
Bu tablo önemli bir ayrımı gösterir: ProbFM core çoğu varlıkta Gaussian NLL ve Student-t NLL'den daha dar tahmin aralıkları üretmektedir, ancak dar aralıklar çoğu varlıkta nominal %95 kapsama ulaşmamaktadır. DOGE ve ETH'de ise PICP 1,00'dır. Bu nedenle yalnız sharpness'a bakarak “daha iyi belirsizlik tahmini” sonucu çıkarılamaz; coverage ile birlikte değerlendirilmesi gerekir.
Çalışmanın Yöntemi ve Bulguları
Veri seti
Çalışma Stooq üzerinden indirilen 11 likit kripto varlığın günlük fiyat verisini kullanır:
ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT ve XRP.
Zaman aralığı 1 Ocak 2020–3 Ekim 2025'tir. Her varlık aynı başlangıç tarihine kadar uzanmadığı için veri uzunlukları varlık bulunabilirliğine bağlıdır.
Günlük log getiri:
\[ r_t = \log\left( \frac{P_t}{P_{t-1}} \right) \]
ile hesaplanır. \(P_t\) mevcut günün, \(P_{t-1}\) önceki günün kapanış fiyatıdır. Log getiri fiyat oranını toplamsal zaman-serisi formuna dönüştürür.
Eğitim, doğrulama ve test ayrımı
| Öğe | Kaynakta raporlanan değer |
|---|---|
| Ana deney omurgası | 1 katmanlı LSTM |
| Gizli boyut | 32 |
| Dropout | 0,1 |
| Lookback | 50 zaman adımı |
| Train/validation dönemi | 2023 sonuna kadar |
| Test dönemi | 2024 ve sonrası |
| Validation | Training verisinin %20'si; sembol bazında zaman sırası korunarak |
| Outlier truncation | Her sembolde eğitim verisinden hesaplanan 1. ve 99. yüzdelikler |
| Standardizasyon | Sembol bazında; eğitim ortalaması 0, standart sapması 1 olacak biçimde |
| Kontrollü deney optimizer'ı | Adam |
| Learning rate | 0,001 |
| Batch size | 128 |
| Maksimum epoch | 50 |
| Early stopping patience | 10 epoch |
| Gradient clipping | max norm 1,0 |
| Weight decay | 0,001 |
| DER regularization ağırlığı | \(\lambda_{\text{evd}}=0,1\) |
| Random seed | 0 |
| Framework | PyTorch |
| Model seçimi | En iyi validation loss checkpoint'i |
Karşılaştırılan yöntemler
| Yöntem | Olasılıksal mı? | Temel çıktı mantığı |
|---|---|---|
| MSE | Hayır | Tek ortalama tahmini |
| Huber | Hayır | Robust tek nokta tahmini |
| Gaussian NLL | Evet | Ortalama + varyans |
| Student-t NLL | Evet | Ortalama + ölçek + serbestlik derecesi |
| Quantile Loss | Evet | Birden fazla quantile |
| Adaptive Conformal | Evet | MSE tahmini + kalibrasyon setiyle aralık |
| Deep Evidential Regression | Evet | NIG parametreleri ve epistemik/aleatorik ayrışma |
BTC nokta tahmin performansı
| Yöntem | RMSE | MAE | Pearson korelasyonu |
|---|---|---|---|
| MSE | 0,044 | 0,030 | −0,309 |
| Huber | 0,044 | 0,029 | −0,394 |
| Gaussian NLL | 0,044 | 0,029 | −0,192 |
| Student-t NLL | 0,045 | 0,030 | −0,529 |
| Quantile Loss | 0,044 | 0,029 | −0,395 |
| Adaptive Conformal | 0,044 | 0,030 | −0,314 |
| DER / ProbFM core | 0,045 | 0,030 | −0,536 |
RMSE ve MAE bakımından yöntemler birbirine oldukça yakındır. DER/ProbFM core en iyi nokta tahmin yöntemidir denemez; RMSE'si 0,045 ile bazı yöntemlerin 0,044 değerinden biraz yüksektir. Kaynağın doğru iddiası, nokta tahmin doğruluğunun “rekabetçi/comparable” olmasıdır.
Daha dikkat çekici olan, BTC'de bütün raporlanan Pearson korelasyonlarının negatif olmasıdır. DER/ProbFM core için korelasyon −0,536'dır. Bu sonuç, tahmin ve gerçekleşen günlük getirilerin doğrusal yön uyumunun BTC testinde güçlü pozitif olmadığını açıkça gösterir. Bununla birlikte kaynak işlem stratejisi performansında farklı bir yönsel ve belirsizlik filtreli değerlendirme kullanmaktadır; iki metriği birbirinin yerine koymamak gerekir.
Kaynak Şekil 2 ne gösteriyor?
Kaynak Şekil 2, DER'nin tahmin ettiği günlük getirilerin dağılımını gerçek test getirileriyle ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT ve XRP için yan yana gösterir. Yazarlar özellikle daha volatil kripto varlıklarda tahmin edilen getiri dağılımlarının gerçek getirilerden belirgin biçimde daha geniş olduğunu belirtir.
Şeklin histogram ham verileri PDF içinde tablo olarak verilmediği için Verianla kesin histogram bar yüksekliklerini yeniden üretmemektedir. Kaynakta desteklenen bilimsel mesaj metinsel olarak korunmuştur.
BTC olasılıksal metrikleri
| Yöntem | CRPS | PICP (%95) | Sharpness | Belirsizlik-Hata Korelasyonu |
|---|---|---|---|---|
| Gaussian NLL | 2,21 | 0,95 | 15,22 | 0,12 |
| Student-t NLL | 3,17 | 0,95 | 15,48 | 0,11 |
| Quantile Loss | NA | 0,75 | 7,92 | 0,17 |
| Adaptive Conformal | 2,26 | 0,81 | 9,67 | 0,09 |
| DER / ProbFM core | 2,65 | 0,46 | 3,90 | 0,00 |
BTC'de Gaussian NLL en düşük CRPS'yi (2,21) ve tam 0,95 PICP'yi üretirken ProbFM core CRPS 2,65 ve PICP 0,46 üretmektedir. ProbFM core'un sharpness değeri 3,90 ile belirgin biçimde daha küçüktür; fakat bu dar aralıkların yalnız %46 kapsama sağlaması, sharpness'ın tek başına olumlu sonuç olarak yorumlanamayacağını gösterir.
İşlem simülasyonunun kuralı
Kaynak yönsel bir işlem stratejisi kullanır:
- Tahmin edilen getiri \(>0\) ise uzun pozisyon (BUY).
- Tahmin edilen getiri \(\le0\) ise kısa pozisyon (SELL).
- \(\operatorname{PnL}=\operatorname{signal}\times\operatorname{actual\ return}\times100\) ve sonuç basis point cinsinden değerlendirilir.
Olasılıksal yöntemlerde ek olarak toplam tahmin belirsizliği kendi dağılımının 75. yüzdeliğinin üzerindeyse işlem filtrelenir. Bu nedenle olasılıksal modellerin trading sonuçları yalnız tahmin yönünü değil belirsizlik filtresini de içermektedir.
Sharpe, Sortino, drawdown ve Calmar neyi ölçüyor?
Kaynak Sharpe oranını:
\[ \operatorname{Sharpe} = \frac{\mu_r}{\sigma_r} \]
olarak tanımlar ve günlük oranı \(\sqrt{252}\) ile yıllıklaştırır.
Sortino oranı:
\[ \operatorname{Sortino} = \frac{\mu_r}{\sigma_{\text{downside}}} \]
biçimindedir ve yalnız negatif getirilerin standart sapmasını risk olarak kullanır.
Maximum Drawdown, kümülatif PnL'deki en büyük zirve-dip düşüşüdür. Calmar oranı, yıllıklandırılmış getiriyi mutlak maksimum düşüşe böler. Win Rate ise kârlı işlemlerin toplam işlem sayısına oranıdır.
BTC işlem performansı
| Yöntem | Yıllık Sharpe | Yıllık Sortino | Max DD (bps) | Calmar | Win Rate |
|---|---|---|---|---|---|
| MSE | 0,90 | 1,52 | −15,89 | 1,98 | 0,51 |
| Huber | 0,59 | 0,93 | −15,14 | 1,35 | 0,51 |
| Gaussian NLL | 0,49 | 0,77 | −15,14 | 1,12 | 0,50 |
| Student-t NLL | 0,70 | 1,08 | −15,89 | 1,41 | 0,51 |
| Quantile Loss | 1,13 | 1,90 | −15,14 | 2,60 | 0,52 |
| Adaptive Conformal | 0,98 | 1,64 | −15,14 | 2,25 | 0,51 |
| DER / ProbFM core | 1,33 | 2,27 | −15,14 | 3,04 | 0,52 |
Kaynak BTC için ProbFM core'un en yüksek Sharpe ve Sortino oranını ürettiğini vurgular. Bununla birlikte kazanma oranı 0,52'dir ve Quantile Loss ile aynıdır. Yüksek risk-ayarlı oranların kaynağı yalnız “daha çok doğru yön tahmini” değildir; işlem seçimi ve belirsizlik filtresi de sonuçlara dahildir.
Tam Transformer ProbFM Mimarisi Bu Çalışmada Ampirik Olarak Doğrulandı mı?
Tam olarak değil. Çalışma Transformer tabanlı ProbFM mimarisini ayrıntılı biçimde tanımlasa da sonuç tablolarındaki kontrollü ampirik karşılaştırmalar 1 katmanlı, 32 gizli boyutlu ortak LSTM omurgası üzerinde DER ve diğer belirsizlik yöntemlerini karşılaştırır; bu nedenle raporlanan BTC ve diğer kripto performansları esas olarak DER/ProbFM-core belirsizlik mekanizmasını doğrular, tam adaptif-patching Transformer mimarisinin üstünlüğünü doğrudan test etmez.
Diğer 10 varlıkta ProbFM core işlem sonuçları
| Varlık | Yıllık Sharpe | Yıllık Sortino | Max DD (bps) | Calmar | Win Rate |
|---|---|---|---|---|---|
| BTC | 1,33 | 2,27 | −15,14 | 3,04 | 0,52 |
| ADA | −0,83 | −0,86 | −88,94 | −0,86 | 0,46 |
| BNB | 1,96 | 2,80 | −21,26 | 3,44 | 0,57 |
| DASH | −0,49 | −0,55 | −66,52 | −0,47 | 0,50 |
| DOGE | −0,08 | −0,12 | −63,42 | −0,10 | 0,49 |
| ETH | 1,10 | 1,84 | −38,83 | 1,91 | 0,50 |
| LTC | 0,17 | 0,22 | −42,44 | 0,23 | 0,55 |
| SOL | 1,64 | 2,84 | −28,99 | 4,07 | 0,54 |
| USDC | 9,14 | 16,24 | −0,05 | 53,43 | 0,68 |
| USDT | 5,28 | 8,32 | −0,11 | 20,03 | 0,58 |
| XRP | 1,44 | 2,67 | −28,35 | 3,55 | 0,53 |
Sonuçlar varlıklar arasında homojen değildir. ADA, DASH ve DOGE'de ProbFM core Sharpe oranı negatiftir; BTC, BNB, ETH, SOL ve XRP'de pozitiftir. USDC ve USDT için çok yüksek Sharpe/Sortino değerleri raporlanır. Bu iki varlık stabilcoin olduğundan getiri ve drawdown ölçekleri diğer kripto varlıklardan farklıdır; ayrıca işlem maliyetleri hesaba katılmamıştır. Bu nedenle yüksek stabilcoin oranlarını doğrudan diğer kripto varlıkların ekonomik performansıyla eşdeğer görmek doğru değildir.
Kaynakta geçen “portföy optimizasyonu” iddiasının sınırı
Makalenin giriş bölümü, belirsizlik tabanlı position sizing kullanan portföy optimizasyonunun equal-weighted baseline'ı geçtiğini söyler. Buna karşın yüklenen PDF'deki yöntem, sonuç ve ek tablolarında ayrı bir portföy optimizasyon deneyi, portföy ağırlıklandırma denklemi veya equal-weighted karşılaştırma tablosu verilmemiştir. Görünür ampirik sonuçlar günlük yönsel işlem stratejisi ve 75. yüzdelik belirsizlik filtresine aittir.
Bu nedenle Verianla, portföy optimizasyonu iddiasını doğrulanmış ayrıntılı sonuç gibi genişletmemektedir. Kaynakta ayrıntısı gösterilmeyen bu iddia yalnız kaynak yazarının giriş bölümündeki beyanı olarak kalmaktadır.
Çalışmanın desteklediği sonuçlar
- DER/NIG yapısı tek forward pass içinde epistemik ve aleatorik belirsizliği matematiksel olarak ayrı büyüklükler halinde üretebilir.
- Kontrollü LSTM deneyinde DER'nin nokta tahmin RMSE/MAE değerleri diğer yöntemlerle genel olarak aynı büyüklük düzeyindedir.
- BTC işlem simülasyonunda ProbFM core kaynak tablosundaki en yüksek Sharpe ve Sortino değerlerini üretmiştir.
- Belirsizlik metrikleri kripto varlıklar arasında ciddi biçimde değişmektedir.
- Coverage loss'a rağmen ProbFM core'un %95 PICP hedefi bütün varlıklarda sağlanmamıştır.
- Belirsizlik filtresi, kaynağın finansal karar deneyi içinde işlem seçiminin bir parçasıdır.
Çalışmanın desteklemediği genellemeler
- ProbFM'nin bütün kripto varlıklarda en iyi tahmin modeli olduğu sonucu desteklenmez.
- Tam Transformer ProbFM mimarisinin tabloda karşılaştırılan tüm yöntemlerden üstün olduğu gösterilmemiştir.
- %95 tahmin aralıklarının genel olarak iyi kalibre olduğu gösterilmemiştir.
- Raporlanan Sharpe ve Sortino oranları gerçek işlem maliyetleri sonrası yatırım getirisi değildir.
- Çalışma gelecekteki kripto fiyatını garanti eden bir alım-satım sistemi sunmaz.
- Sonuçların hisse senedi, döviz, enerji veya diğer zaman serisi alanlarına genellenebilirliği henüz sınanmamıştır.
- Sonuçların farklı random seed'ler altında istatistiksel dağılımı raporlanmamıştır.
Kaynağın kendi sınırlılıkları
Veri kapsamı: Birincil değerlendirme yalnız 11 kripto varlığa odaklanır.
Piyasa rejimleri: Kaynak, incelenen dönemin aşırı çöküşler veya uzun süreli ayı piyasaları dahil bütün piyasa rejimlerini kapsamayabileceğini kabul eder.
İşlem maliyetleri: Slippage, komisyon ve market impact simülasyonda yoktur.
Mimari kapsam: Kontrollü karşılaştırmalar LSTM tabanlıdır; başka mimariler farklı trade-off'lar üretebilir.
Ablasyon eksikliği: Coverage loss, evidence annealing ve bounded prediction dönüşümünün katkıları ayrı ayrı ablasyonla bu sürümde ölçülmemiştir.
İstatistiksel robustluk: Kaynak gelecekte birden fazla random initialization, güven aralıkları, run'lar arası standart sapmalar ve formal hipotez testleri yapılmasını önermektedir. Mevcut reproducibility ayarında random seed 0 raporlanır.
Klasik modeller: ARIMA ve GARCH gibi klasik zaman serisi/finans ekonometrisi modelleri mevcut deney tablosunda karşılaştırılmamış, gelecekteki çalışma olarak bırakılmıştır.
Kaynak-içi teknik ve raporlama notları
| Konu | Kaynakta görülen durum | Doğru yorum sınırı |
|---|---|---|
| Transformer / LSTM ayrımı | Tam ProbFM Transformer olarak tanımlanıyor; karşılaştırmalı deneyler ortak LSTM omurgası kullanıyor. | Tablo sonuçları tam Transformer ProbFM benchmark'ı olarak sunulmamalıdır. |
| NIG notasyonu | Mimari bölümünde \(\mu,\lambda,\alpha,\beta\); deney ve regularization bölümünde \(\gamma,\nu,\alpha,\beta\) kullanılıyor. | Kaynak açık eşleme vermediği için semboller sessizce değiştirilmemelidir. |
| Optimizer | Ana yöntem AdamW; kontrollü deney Appendix C Adam bildiriyor. | İki eğitim bağlamı ayrılmalıdır; kaynak ayrımı tam açıklamıyor. |
| Cosine schedule | Eq. 24 yalnız \(\cos(\pi t/T)\) içeriyor. | Yazıldığı haliyle ikinci yarıda negatif olabilir; kaynak uygulama koduyla açıklamıyor. |
| Confidence interval notasyonu | \(\alpha\), hem NIG shape hem güven seviyesi tamamlayıcısı gibi kullanılıyor. | Eq. 30 sembol anlamı bağlama bağlı olarak belirsizdir. |
| Coverage sonucu | Coverage loss hedefi %95; BTC ProbFM-core PICP 0,46. | Coverage loss varlığı kalibrasyon başarısını garanti etmez. |
| Portföy optimizasyonu | Girişte başarı iddiası bulunuyor; ayrı yöntem/sonuç tablosu görünmüyor. | Detaylandırılmamış yazar beyanı, tam ampirik sonuç gibi genişletilmemelidir. |
Kaynak ve Yöntem Notu
Özgün başlık: ProbFM: Probabilistic Time Series Foundation Model with Uncertainty Decomposition
Yazarlar: Arundeep Chinta; Lucas Vinh Tran; Jay Katukuri.
Yazar sırası: Kaynaktaki sıra korunmuştur.
Afiliasyonlar: Arundeep Chinta ve Jay Katukuri — JPMorganChase, Palo Alto, USA. Lucas Vinh Tran — JPMorganChase, London, UK.
İletişim: Kaynak ilk sayfasında üç yazarın da e-posta adresini verir. Ayrı “corresponding author” işareti bulunmamaktadır.
Eşit katkı: Yüklenen PDF'de eşit katkı beyanı bulunmamaktadır.
Kaynak türü: arXiv preprint.
arXiv kimliği: arXiv:2601.10591v1.
Birincil alan: cs.LG — Machine Learning.
Yükleme tarihi: 15 Ocak 2026.
Dergi / konferans: Kasım 2026 itibarıyla aynı başlık için doğrulanmış hakemli bir dergi veya konferans yayını tespit edilmemiştir; resmî kayıt preprint olarak kalmaktadır.
DOI: Yüklenen PDF'de ve doğrulanan resmî arXiv kayıt metninde ayrı bir yayın DOI'si raporlanmamıştır; bu nedenle Verianla doğrulanmamış DOI eklememektedir.
Lisans: Yüklenen PDF'nin görünür metninde açık lisans bilgisi bulunmamaktadır; doğrulanamayan lisans bilgisi eklenmemiştir.
Finansman: Ayrı finansman beyanı yüklenen PDF'de bulunmamaktadır.
Çıkar çatışması: Ayrı çıkar çatışması beyanı görünmemektedir.
CRediT yazar katkıları: Ayrı CRediT katkı tablosu bulunmamaktadır.
Veri kaynağı: Kripto fiyat verileri Stooq üzerinden alınmıştır. Kaynak ayrı bir data-availability beyanı veya yeniden üretim kod deposu vermemektedir.
Veri dönemi: 1 Ocak 2020–3 Ekim 2025; varlık bulunabilirliğine bağlı olarak tüm seriler aynı uzunlukta değildir.
Temel çalışma türü: Olasılıksal zaman serisi modelleme + kontrollü makine öğrenmesi karşılaştırması + finansal işlem simülasyonu.
Önerilen mimari: Adaptif patching, positional encoding, Transformer, DER/NIG head, evidential loss, coverage loss, evidence annealing ve tek-pass inference.
Ampirik karşılaştırma mimarisi: 1 katmanlı, 32 gizli boyutlu LSTM; tüm yöntemlerde aynı omurga kullanılarak belirsizlik yöntemlerinin etkisi izole edilmiştir.
Önemli sonuç sınırı: Çalışma tam Transformer ProbFM'nin bütün rakip foundation modellerden daha iyi olduğunu göstermemektedir. Ampirik tablolar esas olarak DER mekanizmasının ortak LSTM ortamındaki davranışını göstermektedir.
Kalibrasyon sınırı: %95 hedefli tahmin aralıklarında ProbFM core'un PICP değeri varlıklar arasında 0,31–1,00 aralığında değişmektedir; dolayısıyla kaynak sonuçları homojen %95 kalibrasyon göstermez.
İşlem simülasyonu sınırı: Slippage, komisyon ve market impact dahil değildir. Raporlanan Sharpe, Sortino, Calmar ve drawdown değerleri gerçek piyasa uygulamasında aynı biçimde gerçekleşeceğinin kanıtı değildir.
Kaynak disclaimer'ı: Makale, JPMorganChase'in bilgilerin eksiksizliği veya doğruluğu konusunda garanti vermediğini; görüşlerin yazarlara ait olduğunu ve belgenin yatırım araştırması, yatırım tavsiyesi, menkul kıymet veya finansal ürün alım-satım önerisi olmadığını açıkça belirtmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir