


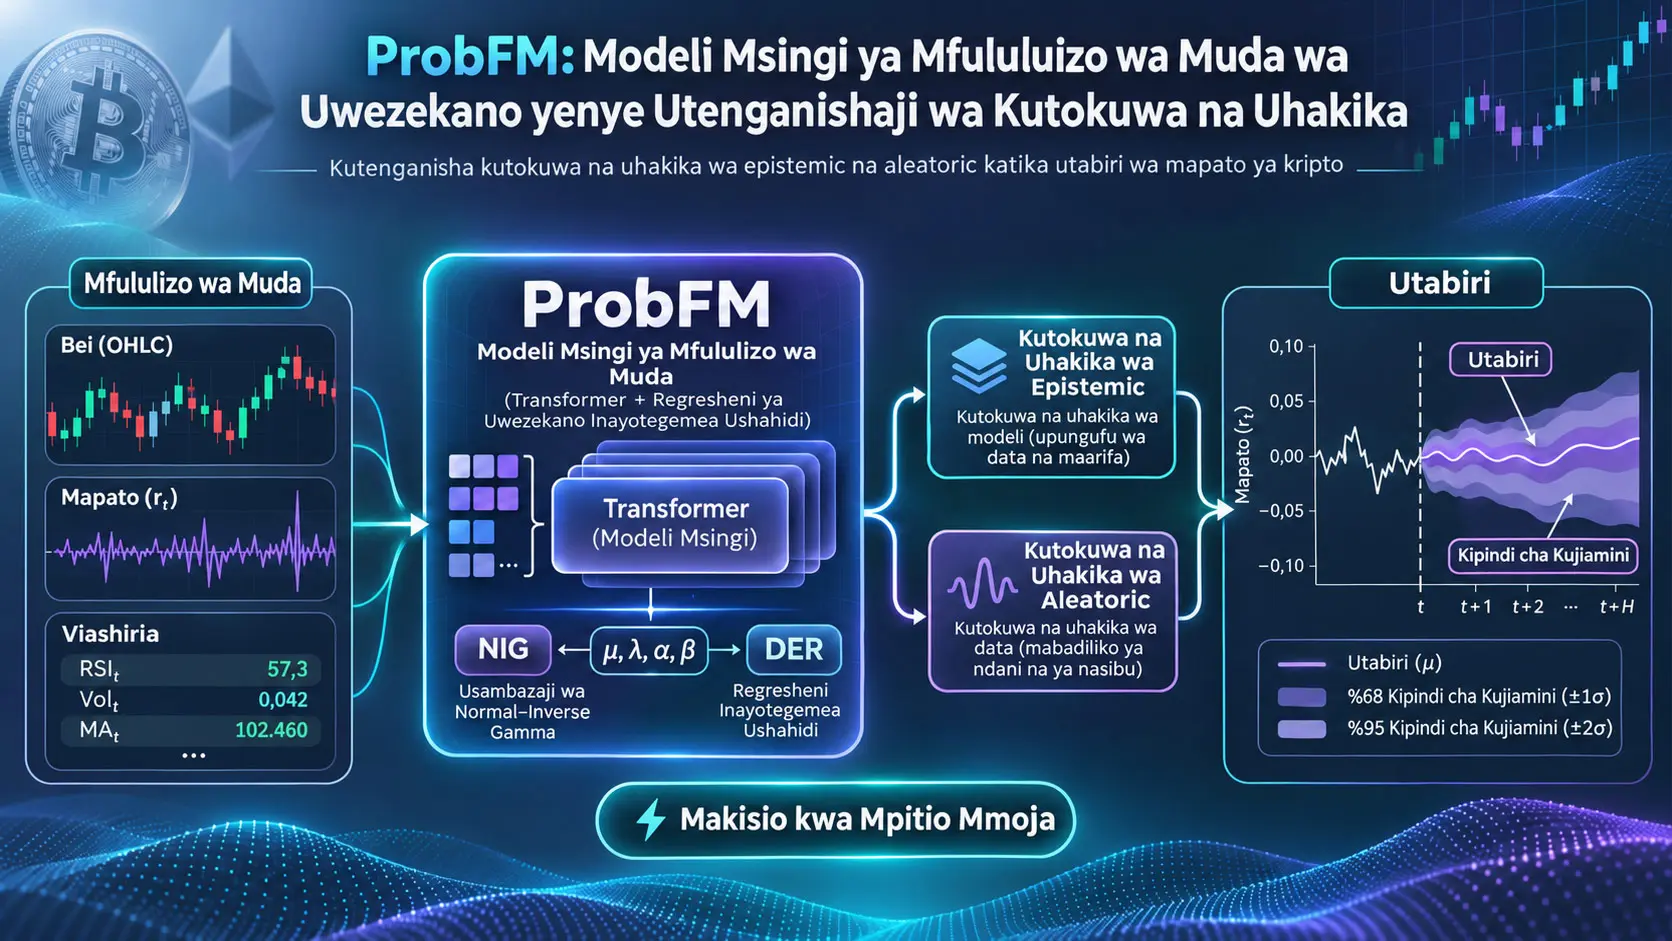
ProbFM (Probabilistic Foundation Model) ni mfumo wa mfululizo wa muda wa uwezekano unaolenga kutenganisha kutokuwa na uhakika wa utabiri katika vipengele vya epistemic na aleatoric badala ya kutoa utabiri wa nukta pekee, kwa kutumia Deep Evidential Regression (DER) pamoja na usambazaji wa Normal-Inverse-Gamma (NIG). Utafiti huu kwa upande mmoja unaeleza usanifu kamili wa ProbFM unaojumuisha adaptive patching, uti wa mgongo wa Transformer, kichwa cha DER, coverage loss na evidence annealing; kwa upande mwingine unajaribu mbinu zote za kulinganisha kwenye LSTM ileile yenye tabaka 1 na kipimo fiche 32 ili kutenganisha mchango wa mbinu ya kutokuwa na uhakika na tofauti za usanifu. Tathmini ya kimajaribio hutumia mapato ya kila siku ya log ya ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT na XRP kati ya 1 Januari 2020–3 Oktoba 2025.
Lengo kuu la DER ni kutenganisha swali “modeli inakosea kwa kiasi gani?” na swali la ziada “kutokuwa na uhakika huku kunatokana na modeli kutokuwa na maarifa ya kutosha, au kunatokana na data kuwa na kelele kwa asili yake?” Katika utafiti huu, kutokuwa na uhakika wa epistemic huwakilisha kutokuwa na uhakika kuhusu vigezo vya modeli na sehemu ambayo kimsingi inaweza kupunguzwa kwa taarifa zaidi; kutokuwa na uhakika wa aleatoric huwakilisha kelele isiyoweza kupunguzwa katika mchakato wa uchunguzi au katika data ya soko. Muundo wa NIG huruhusu vipengele hivi viwili kuhesabiwa kando ndani ya forward pass moja.
Kwa BTC, Evidential Regression “ProbFM core” inaonyesha hitilafu ya utabiri wa nukta inayofanana na modeli nyingine, ikiwa na RMSE 0,045 na MAE 0,030. Hata hivyo, katika vipindi vya utabiri vya %95, PICP ni 0,46 tu; yaani iko chini sana ya kiwango lengwa cha ufunikaji cha %95. Katika jaribio hilohilo la BTC, ProbFM core inatoa mojawapo ya matokeo yenye nguvu ya biashara yaliyorekebishwa kwa hatari katika jedwali la chanzo, ikiwa na Sharpe ya mwaka 1,33, Sortino 2,27, Calmar 3,04 na kiwango cha kushinda 0,52. Lakini kwa kuwa uigaji wa biashara haujumuishi kamisheni, slippage wala market impact, thamani hizi haziwezi kufasiriwa kuwa mapato halisi ya soko baada ya gharama au utendaji wa uwekezaji unaoweza kutekelezwa.
Kikomo muhimu cha kimetodolojia cha utafiti huu ni kwamba majaribio linganishi yaliyochapishwa hayafanyi benchmark ya moja kwa moja ya usanifu kamili wa Transformer ProbFM. Majaribio hutumia uti wa mgongo uleule wa LSTM ili kutenga mekanizimu ya kutokuwa na uhakika ya DER. Kwa hiyo, utafiti huu unatoa ushahidi wa kimajaribio kuhusu tabia ya utenganishaji wa kutokuwa na uhakika unaotegemea DER katika mazingira yaliyodhibitiwa ya LSTM, lakini hauthibitishi kwa majedwali haya ya data ubora wa zero-shot au wa kiwango kikubwa wa foundation-model wa usanifu kamili wa ProbFM Transformer.
ProbFM ni Nini na Utafiti Huu Unalenga Kufanya Nini?
ProbFM ni mfumo wa modeli ya uwezekano unaotegemea DER/NIG ambao huchakata ingizo la mfululizo wa muda na kutoa si tu utabiri wa kati wa thamani ya baadaye, bali pia vipengele vya kutokuwa na uhakika wa epistemic na aleatoric vinavyoambatana na utabiri; usanifu kamili unaopendekezwa unajumuisha adaptive patching, positional encoding, ujifunzaji wa uwakilishi kwa Transformer, kichwa cha evidential kinachotoa vigezo vya NIG, coverage-aware loss na utoaji wa kutokuwa na uhakika katika pass moja.
Tatizo ambalo utafiti unajaribu kutatua
Modeli za kawaida za mfululizo wa muda zinaweza kuzingatia tu swali “utabiri wa mapato ya kesho ni upi?” Katika matumizi ya kifedha, pia ni muhimu kujua thamani hiyo ya utabiri inaaminika kwa kiasi gani. Kwa mfano, modeli mbili zinaweza zote kutabiri mapato chanya ya %1 kwa siku inayofuata; lakini moja inaweza kuwa na msaada mkubwa wa data huku nyingine ikifanya kazi katika hali ya soko ambayo haijawahi kuiona hapo awali.
Kwa sababu hiyo, utafiti hugawanya kutokuwa na uhakika wa jumla wa utabiri katika vyanzo viwili tofauti. Kutokuwa na uhakika wa epistemic huwakilisha upungufu wa maarifa ya modeli, huku kutokuwa na uhakika wa aleatoric ukiwakilisha kelele ya ndani ya mchakato wa kuzalisha data. Tofauti hii ni muhimu hasa katika usimamizi wa hatari; kwa sababu “kukusanya data zaidi” kunaweza kupunguza kutokuwa na uhakika wa epistemic, lakini hakuondoi kutokuwa na uhakika wa aleatoric unaowakilisha nasibu halisi ya soko.
Tofauti Kati ya Kutokuwa na Uhakika wa Epistemic na Aleatoric ni Nini?
Kutokuwa na uhakika wa epistemic ni kutokuwa na uhakika wa modeli unaotokana na sehemu ambayo modeli haijui au haijajifunza vya kutosha na ambao unaweza kupunguzwa kwa data mpya inayofaa; kutokuwa na uhakika wa aleatoric huwakilisha kelele ya ndani na unasibu katika mchakato wa kuzalisha data na si lazima uondoke kwa kuongeza data zaidi pekee. ProbFM hutoa vipengele hivi viwili kutoka posterior ya NIG kama ukubwa tofauti wa kihisabati.
Muundo wa Normal-Inverse-Gamma
Kwa tatizo la mfululizo wa muda lenye kigezo kimoja na hatua moja, mkusanyiko wa data hufafanuliwa kama:
\[ \mathcal{D}=\{(x_i,y_i)\}_{i=1}^{N} \]
\(x_i\in\mathbb{R}^{T}\) huwakilisha dirisha la muda wa nyuma lenye urefu \(T\); \(y_i\in\mathbb{R}\) huwakilisha lengo la hatua moja mbele.
Wakati mbinu ya kawaida ya uwezekano hujifunza moja kwa moja uhusiano:
\[ f_\theta:x\rightarrow p(y\mid x) \]
DER hujifunza:
\[ f_\theta:x\rightarrow p(\phi\mid x) \]
Hapa \(\phi\) ni vigezo vya usambazaji wa utabiri. Kwa hiyo, badala ya kutabiri tu vigezo vya usambazaji, mtandao hujaribu kuwakilisha ushahidi na kutokuwa na uhakika kuhusu vigezo hivyo vyenyewe.
Mlinganyo (1): NIG prior
\[ p(\mu,\sigma^2)=\operatorname{NIG}(\mu,\lambda,\alpha,\beta) \tag{1} \]
Kauli hii inaonyesha kwamba kutokuwa na uhakika kuhusu wastani na variansi ya usambazaji wa Gaussian huwakilishwa na familia ya Normal-Inverse-Gamma. \(\mu\) inahusiana na utabiri wa kati, \(\lambda\) na usahihi wa kigezo cha wastani, huku \(\alpha\) na \(\beta\) vikihusiana na sehemu ya variansi ya inverse-gamma.
Mlinganyo (2) na (3): utenganishaji wa NIG
\[ p(\mu\mid\sigma^2) = \mathcal{N}\left(\mu,\frac{\sigma^2}{\lambda}\right) \tag{2} \]
\[ p(\sigma^2) = \operatorname{Inverse\mbox{-}Gamma}(\alpha,\beta) \tag{3} \]
Mlinganyo wa kwanza huwakilisha usambazaji sharti wa Gaussian juu ya kigezo cha wastani, na wa pili huwakilisha usambazaji wa inverse-gamma kuhusu variansi. \(\lambda\) inapoongezeka, variansi inayohusiana na kigezo cha wastani hupungua; kwa maneno mengine, kutokuwa na uhakika wa epistemic wa modeli kuhusu wastani kunaweza kupungua.
Mlinganyo (4): wastani unaotabiriwa
\[ \mathbb{E}[y\mid x]=\mu \tag{4} \]
Utabiri mmoja wa nukta wa modeli ni \(\mu\).
Mlinganyo (5): kutokuwa na uhakika wa aleatoric
\[ U_{\text{aleatoric}} = \mathbb{E}[\sigma^2\mid x] = \frac{\beta}{\alpha-1} \tag{5} \]
Ukubwa huu ni sehemu ya kutokuwa na uhakika inayohusishwa na kelele ya data. Ili fomula iwe na thamani finiti, \(\alpha>1\) inahitajika. \(\beta\) inapoongezeka huku vigezo vingine vikiwa vilevile, variansi ya aleatoric huongezeka; \(\alpha\) inapoongezeka, hupungua.
Mlinganyo (6): kutokuwa na uhakika wa epistemic
\[ U_{\text{epistemic}} = \operatorname{Var}[\mu\mid x] = \frac{\beta}{(\alpha-1)\lambda} \tag{6} \]
Tofauti na sehemu ya aleatoric, kutokuwa na uhakika wa epistemic pia kuna \(\lambda\). Kadri \(\lambda\) inavyoongezeka, kutokuwa na uhakika wa epistemic wa modeli kuhusu utabiri wa wastani hupungua.
Upanuzi kwenda utabiri wa upeo mwingi
Chanzo kinasema kwamba muundo wa NIG umetumiwa kwa utabiri wa kigezo kimoja na hatua moja; katika siku zijazo prior ya Normal-Inverse-Wishart (NIW) inaweza kutumika katika utabiri wa upeo mwingi au wa vigezo vingi. Upanuzi huu si matokeo ya kimajaribio yaliyotekelezwa katika utafiti; umetolewa kama mwelekeo wa usanifu wa baadaye.
Kwa nini adaptive patching inatumika?
Usanifu wa Transformer unaopendekezwa wa ProbFM hugawanya mfululizo mrefu wa muda katika vipande vinavyoitwa “patch” badala ya kushughulikia kila nukta ya muda peke yake. Ulinganishaji wa ukubwa wa patch kulingana na frequency katika chanzo ni huu:
| Frequency ya mfululizo wa muda | Ukubwa wa patch unaopendekezwa |
|---|---|
| Kila mwaka / kila robo mwaka | 8 |
| Kila mwezi | 8, 16, 32 |
| Kila wiki / kila siku | 16, 32 |
| Kila saa | 32, 64 |
| Kiwango cha dakika | 32, 64, 128 |
| Kiwango cha sekunde | 64, 128 |
Lengo la chanzo ni kuepuka kulazimisha granularity ileile ya muda katika viwango tofauti vya azimio la wakati. Hata hivyo, matokeo ya ablation ya kila chaguo la patch hayajatolewa kivyake katika utafiti.
Mlinganyo (8) na (9): patch na embedding
\[ X_{\text{patches}} = \operatorname{Patching}(X_{\text{raw}},\text{patch\_size}) \tag{8} \]
\[ X_{\text{encoded}} = \operatorname{LinearProjection}(X_{\text{patches}}) + \operatorname{PositionalEncoding} \tag{9} \]
Hatua ya kwanza hugawanya mfululizo ghafi wa muda katika patch. Hatua ya pili huprojekti patch hizo katika nafasi ya embedding ambayo Transformer inaweza kutumia na kuongeza positional encoding ili mpangilio wa muda usipotee.
Mlinganyo (10): sinusoidal positional encoding
\[ PE_{(t,d)} = \begin{cases} \sin\left(t/10000^{d/d_{\text{model}}}\right), & d\text{ çift ise}\\ \cos\left(t/10000^{d/d_{\text{model}}}\right), & d\text{ tek ise} \end{cases} \tag{10} \]
\(t\) inaonyesha nafasi ya muda katika mfuatano, \(d\) ni fahirisi ya kipimo cha embedding, na \(d_{\text{model}}\) ni kipimo cha jumla cha embedding. Kubadilika kwa frequency za sinus na cosinus kulingana na kipimo huruhusu Transformer kutumia mahusiano ya nafasi ya jamaa na ya moja kwa moja katika mfuatano.
Mlinganyo (11): operesheni ya msingi ya attention katika Multi-Head Attention
\[ \operatorname{Attention}(Q,K,V) = \operatorname{softmax} \left( \frac{QK^{T}}{\sqrt{d_k}} \right)V \tag{11} \]
\(Q\) huwakilisha matriksi ya query, \(K\) matriksi ya key, na \(V\) matriksi ya value. \(QK^T\) huzalisha alama za ufanano zinazopima ni kwa kiwango gani uwakilishi tofauti wa time-patch unapaswa kuzingatia kila mmoja. Sehemu ya scaling \(\sqrt{d_k}\) husaidia kuzuia inner products kuwa kubwa kupita kiasi kadri kipimo kinavyoongezeka.
Mlinganyo (12): mtandao wa feed-forward
\[ \operatorname{FFN}(x) = \operatorname{SwiGLU}(W_1x+b_1) \tag{12} \]
SwiGLU ni familia ya uamilishaji wenye gating inayotumiwa katika tabaka la mabadiliko yasiyo ya mstari ndani ya bloksi za Transformer.
Kichwa cha DER kinazalishaje vigezo vya NIG?
\[ \mu=W_\mu h+b_\mu \tag{13} \]
\[ \lambda= \operatorname{Softplus}(W_\lambda h+b_\lambda)+\epsilon \tag{14} \]
\[ \alpha= \operatorname{Softplus}(W_\alpha h+b_\alpha)+1+\epsilon \tag{15} \]
\[ \beta= \operatorname{Softplus}(W_\beta h+b_\beta)+\epsilon \tag{16} \]
\(h\) ni uwakilishi wa mwisho wa Transformer. \(\mu\) inaweza kuwa nambari halisi; \(\lambda\) na \(\beta\) lazima ziwe chanya, na \(\alpha\) lazima iwe kubwa kuliko 1. Mabadiliko ya Softplus huweka vikwazo hivi vya domain kwenye matokeo ya mtandao. \(\epsilon\) ni thabiti ndogo chanya inayozuia vigezo batili vinavyoweza kusababishwa na thamani ya sifuri kamili; chanzo hakitoi thamani ya nambari ya thabiti hii katika sehemu kuu ya usanifu.
Evidential loss inafanyaje kazi?
Fungsi ya msingi ya evidential loss ya chanzo ni:
\[ \mathcal{L}_{EDL} = \mathcal{L}_{NLL} + \lambda_{\text{evd}}\mathcal{L}_{reg} \tag{17} \]
\(\mathcal{L}_{NLL}\) hupima jinsi usambazaji wa uwezekano uliotabiriwa unavyolingana na lengo halisi; \(\mathcal{L}_{reg}\) huadhibu utoaji wa ushahidi/kujiamini kupita kiasi wakati utabiri ni mbaya. \(\lambda_{\text{evd}}\) huamua uzito wa jamaa wa vipengele viwili. Katika usanidi wa jaribio lililodhibitiwa, \(\lambda_{\text{evd}}=0,1\) imeripotiwa.
Mlinganyo (18): NIG negative log-likelihood
\[ \begin{aligned} \mathcal{L}_{NLL} ={}& \frac{1}{2}\log\left(\frac{\pi}{\lambda}\right) -\alpha\log(\Omega)\\ &+ \left(\alpha+\frac{1}{2}\right) \log\left( \frac{(y-\mu)^2}{\lambda}+\Omega \right)\\ &+ \log\left( \frac{\Gamma(\alpha)} {\Gamma\left(\alpha+\frac{1}{2}\right)} \right), \end{aligned} \tag{18} \]
\[ \Omega=2\beta(1+\lambda) \]
Mlinganyo huu ni gharama ya likelihood inayotokana na usambazaji wa utabiri wa pembeni wa Student-t wa muundo wa NIG. Utabiri unapokuwa mbali zaidi na lengo, sehemu ya \((y-\mu)^2\) huongezeka na loss hupanda. Wakati huohuo, vigezo vya kutokuwa na uhakika vya usambazaji pia huamua loss.
Mlinganyo (19): evidential regularization
\[ \mathcal{L}_{reg} = |\hat{y}-y|\cdot(\alpha+\nu-2) \tag{19} \]
Sehemu hii hutumiwa kuadhibu modeli inapotoa ushahidi wa juu kupita kiasi wakati kosa ni kubwa. Hata hivyo, chanzo hapa, badala ya \(\lambda\) iliyotumika katika milinganyo ya awali ya NIG, kinatumia alama \(\nu\). Katika Appendix C pia vigezo vya DER vimeripotiwa kama \((\gamma,\nu,\alpha,\beta)\), wakati sehemu ya usanifu hutumia \((\mu,\lambda,\alpha,\beta)\). Chanzo hakifafanui kwa uwazi ulinganifu kati ya notations hizi mbili; kwa hiyo Verianla haibadilishi alama kimya kimya.
Coverage loss inalenga nini?
\[ \mathcal{L}_{coverage} = |\operatorname{PICP}_{target} - \operatorname{PICP}_{actual}| \tag{20} \]
Lengo hapa ni kuleta kiwango halisi cha coverage karibu na kiwango lengwa cha coverage. Kwa mfano, ikiwa interval ya utabiri ya %95 ndiyo lengo:
\[ \operatorname{PICP}_{target}=0.95 \]
hivyo ndivyo inavyokuwa.
PICP halisi:
\[ \operatorname{PICP}_{actual} = \frac{1}{N} \sum_{i=1}^{N} \mathbb{I} \left( y_i\in [CI_{\text{lower},i},CI_{\text{upper},i}] \right) \tag{21} \]
huhesabiwa. Indicator function hutoa 1 ikiwa lengo halisi liko ndani ya interval, na 0 ikiwa haliko. Wastani wa thamani hizi ni kiwango ambacho intervals za utabiri hufunika malengo halisi.
Kikomo muhimu cha tafsiri ni hiki: kuongeza sehemu ya coverage kwenye loss function hakuhakikishi kiotomatiki kupata %95 coverage kwenye test set. Kwa kweli, kwa BTC katika Jedwali 3 la chanzo, PICP ya ProbFM core ni 0,46 tu.
Loss iliyounganishwa
\[ \mathcal{L}_{ProbFM} = \mathcal{L}_{EDL} + \lambda_{coverage}\mathcal{L}_{coverage} + \lambda_{wd}\|\theta\|_2^2 \tag{22} \]
Sehemu ya kwanza ni utabiri wa evidential, ya pili ni lengo la coverage la interval ya utabiri, na ya tatu ni L2 weight regularization. Chanzo kinasema \(\lambda_{coverage}\) hudumishwa kuwa constant, lakini hakitoi thamani yake ya nambari kwa jaribio lililodhibitiwa.
Optimizer na gradient clipping
Chanzo kinasema kinatumia AdamW katika sehemu kuu ya mafunzo ya ProbFM na kinaonyesha sasisho kama:
\[ \theta_{t+1} = \theta_t - \eta\cdot \operatorname{clip} (\nabla_\theta\mathcal{L},\operatorname{max\_norm}) \tag{23} \]
Mlinganyo huu ni usemi uliorahisishwa wa sasisho unaosisitiza mantiki ya clipping. Chanzo kinasema kwa ujumla max norm iko katika 1,0–5,0; lakini katika usanidi wa Appendix C wa jaribio la LSTM lililodhibitiwa, max norm ni 1,0.
Appendix C pia inaonyesha optimizer kama Adam katika majaribio yaliyodhibitiwa. Kwa kuwa sehemu kuu ya usanifu inaandika AdamW, taarifa hizi mbili huenda zikahusu mazingira tofauti ya majaribio; hata hivyo, chanzo hakielezi tofauti hiyo kwa jedwali la ulinganifu lililo wazi.
Mlinganyo (24): dokezo la cosine annealing
Chanzo kinaandika ratiba ya learning rate kama:
\[ \eta_t = \eta_{\text{base}} \cos\left( \frac{\pi t}{T_{\text{total}}} \right) \operatorname{warmup}(t) \tag{24} \]
Kwa jinsi fomula hii ilivyoandikwa, inaruhusu sehemu ya cosinus kuwa hasi wakati \(t>T_{\text{total}}/2\). Chanzo hakielezi kama hii ni maonyesho ya kischematic tu au schedule iliyotumika katika code halisi. Kwa hiyo Verianla haiweki formula ya kawaida ya cosine schedule badala ya chanzo kwa kuisahihisha kimya kimya.
Mlinganyo (25): evidence annealing
\[ \operatorname{evidence\_scale}(t) = \min\left(1.0,\frac{t}{T_{\text{anneal}}}\right) \tag{25} \]
Factor hii huanza 0 mwanzoni mwa mafunzo na kufika 1 katika hatua ya \(T_{\text{anneal}}\). Chanzo kinasema kwa kawaida huongezwa katika %10–20 ya mafunzo yote. Lengo ni kuzuia mtandao kutoa vigezo vya evidential vyenye kujiamini kupita kiasi kabla haujajifunza uwakilishi.
Utoaji katika pass moja
Wakati wa utabiri, kichwa cha DER huzalisha vigezo vinne vya NIG kwa forward pass moja. Utabiri wa nukta wa chanzo ni:
\[ \hat{y}=\mu \tag{26} \]
Variansi ya jumla ya utabiri:
\[ \operatorname{Var}[y\mid x] = \frac{\beta}{\alpha-1} \left( 1+\frac{1}{\lambda} \right) \tag{27} \]
Kutokuwa na uhakika wa epistemic:
\[ U_{\text{epistemic}} = \frac{\beta}{(\alpha-1)\lambda} \tag{28} \]
Kutokuwa na uhakika wa aleatoric:
\[ U_{\text{aleatoric}} = \frac{\beta}{\alpha-1} \tag{29} \]
hutolewa.
Mlinganyo (27) kwa uwazi ni jumla ya Mlinganyo (28) na (29):
\[ \operatorname{Var}[y\mid x] = U_{\text{aleatoric}} + U_{\text{epistemic}} \]
Usawa huu wa mwisho ni matokeo ya moja kwa moja ya algebra ya milinganyo ya chanzo; si ugunduzi mpya wa kimajaribio.
Interval ya utabiri
Chanzo kinasema posterior predictive distribution ni Student-t na kutoa:
\[ CI_{1-\alpha} = \hat{y} \pm t_{2\alpha,\alpha/2} \sqrt{ \frac{\beta(\lambda+1)} {\alpha\lambda} } \tag{30} \]
na kinafafanua degrees of freedom ya Student-t kuwa \(2\alpha\).
Onyo la notation: Katika sehemu hiyo hiyo \(\alpha\) inaonekana kutumiwa kama shape parameter ya usambazaji wa NIG na pia katika uandishi wa confidence level \(1-\alpha\). Kwa hiyo katika Mlinganyo (30) maana ya alama inakuwa na utata kulingana na muktadha. Verianla huacha mgongano huu wa alama uonekane bila kubadilisha mlinganyo wa chanzo.
CRPS ni nini?
Continuous Ranked Probability Score (CRPS) ni kipimo cha utabiri wa uwezekano kinacholinganisha si utabiri wa nukta pekee bali usambazaji wote wa utabiri na uchunguzi halisi. CRPS ya chini hufasiriwa kuwa bora zaidi katika chanzo.
Kwa utabiri wa Gaussian, chanzo hutumia:
\[ CRPS = \sigma \left[ z(2\Phi(z)-1) + 2\phi(z) - \frac{1}{\sqrt{\pi}} \right] \tag{31} \]
na hufafanua:
\[ z=\frac{y-\mu}{\sigma} \]
\(\Phi\) ni cumulative distribution function ya standard normal distribution; \(\phi\) ni probability density function.
PICP, sharpness na uncertainty-error correlation zisomwe pamoja vipi?
PICP ni uwiano wa uchunguzi halisi unaobaki ndani ya interval ya utabiri. Kwa interval ya %95, PICP karibu na 0,95 hutegemewa katika kalibrashi nzuri.
Sharpness ni upana wa wastani wa interval ya utabiri. Interval nyembamba si bora yenyewe; ikiwa interval ni nyembamba sana kiasi cha kuacha thamani halisi nje, modeli inaweza kuwa na kujiamini kupita kiasi.
Uncertainty-Error Correlation ni Pearson correlation kati ya kutokuwa na uhakika uliotabiriwa na hitilafu halisi ya utabiri. Thamani chanya inaonyesha mwelekeo wa modeli kutoa kutokuwa na uhakika wa juu zaidi kwa mifano migumu. Thamani karibu na sifuri au hasi haiungi mkono uhusiano huo.
Je, Interval za Utabiri za %95 za ProbFM Zimekalibishwa Vizuri Kweli?
Kulingana na matokeo ya chanzo, si kwa mali zote: katika interval zinazolenga %95, ProbFM core hutoa PICP 0,46 kwa BTC, 0,31 kwa ADA, 0,39 kwa SOL na 0,36 kwa XRP, huku ikifikia 1,00 kwa DOGE na ETH; tofauti hii kubwa inaonyesha kwamba licha ya kuongezwa kwa coverage loss, kalibrashi katika majaribio yaliyochunguzwa haikulingana kwa uthabiti na lengo la %95 kati ya mali.
| Mali | CRPS | PICP (lengo %95) | Sharpness | Correlation ya Kutokuwa na Uhakika-Hitilafu |
|---|---|---|---|---|
| BTC | 2,65 | 0,46 | 3,90 | 0,00 |
| ADA | 3,39 | 0,31 | 3,32 | 0,09 |
| BNB | 1,30 | 0,68 | 3,63 | −0,12 |
| DASH | 1,57 | 0,59 | 3,49 | 0,04 |
| DOGE | 0,25 | 1,00 | 3,77 | 0,18 |
| ETH | 0,29 | 1,00 | 4,17 | 0,22 |
| LTC | 2,69 | 0,46 | 3,56 | 0,03 |
| SOL | 2,96 | 0,39 | 3,85 | −0,14 |
| USDC | 2,32 | 0,78 | 7,44 | −0,04 |
| USDT | 2,54 | 0,45 | 3,56 | −0,01 |
| XRP | 2,90 | 0,36 | 3,25 | −0,03 |
Jedwali hili linaonyesha tofauti muhimu: ProbFM core hutoa interval nyembamba zaidi za utabiri kuliko Gaussian NLL na Student-t NLL kwa mali nyingi, lakini interval hizo nyembamba hazifikii coverage ya nominal ya %95 kwa mali nyingi. Kwa DOGE na ETH, PICP ni 1,00. Kwa hiyo haiwezekani kuhitimisha “utabiri bora wa kutokuwa na uhakika” kwa kuangalia sharpness pekee; lazima itathminiwe pamoja na coverage.
Mbinu na Matokeo ya Utafiti
Mkusanyiko wa data
Utafiti hutumia data ya bei ya kila siku ya mali 11 za crypto zenye ukwasi iliyopakuliwa kutoka Stooq:
ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT na XRP.
Kipindi cha muda ni 1 Januari 2020–3 Oktoba 2025. Kwa kuwa si kila mali inapatikana hadi tarehe ileile ya kuanzia, urefu wa data hutegemea upatikanaji wa mali.
Mapato ya log ya kila siku huhesabiwa kama:
\[ r_t = \log\left( \frac{P_t}{P_{t-1}} \right) \]
\(P_t\) ni bei ya kufunga ya siku ya sasa na \(P_{t-1}\) ni bei ya kufunga ya siku iliyotangulia. Log return hubadilisha uwiano wa bei kuwa muundo wa mfululizo wa muda unaoweza kujumlishwa.
Mgawanyo wa training, validation na test
| Kipengele | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Uti wa mgongo wa jaribio kuu | LSTM yenye tabaka 1 |
| Kipimo fiche | 32 |
| Dropout | 0,1 |
| Lookback | hatua 50 za muda |
| Kipindi cha Train/validation | hadi mwisho wa 2023 |
| Kipindi cha Test | 2024 na baada ya hapo |
| Validation | %20 ya data ya Training; kwa kuhifadhi mpangilio wa muda kwa kila symbol |
| Outlier truncation | percentile za 1. na 99. zilizohesabiwa kutoka data ya training kwa kila symbol |
| Standardization | kwa kila symbol; ili wastani wa training uwe 0 na standard deviation iwe 1 |
| Optimizer ya jaribio lililodhibitiwa | Adam |
| Learning rate | 0,001 |
| Batch size | 128 |
| Maximum epoch | 50 |
| Early stopping patience | 10 epoch |
| Gradient clipping | max norm 1,0 |
| Weight decay | 0,001 |
| Uzito wa DER regularization | \(\lambda_{\text{evd}}=0,1\) |
| Random seed | 0 |
| Framework | PyTorch |
| Uteuzi wa modeli | checkpoint yenye validation loss bora zaidi |
Mbinu zilizolinganishwa
| Mbinu | Ya uwezekano? | Mantiki kuu ya matokeo |
|---|---|---|
| MSE | Hapana | Utabiri mmoja wa wastani |
| Huber | Hapana | Utabiri wa nukta wa robust |
| Gaussian NLL | Ndiyo | Wastani + variansi |
| Student-t NLL | Ndiyo | Wastani + scale + degrees of freedom |
| Quantile Loss | Ndiyo | Quantile nyingi |
| Adaptive Conformal | Ndiyo | Utabiri wa MSE + interval kupitia calibration set |
| Deep Evidential Regression | Ndiyo | Vigezo vya NIG na utenganishaji wa epistemic/aleatoric |
Utendaji wa utabiri wa nukta wa BTC
| Mbinu | RMSE | MAE | Pearson correlation |
|---|---|---|---|
| MSE | 0,044 | 0,030 | −0,309 |
| Huber | 0,044 | 0,029 | −0,394 |
| Gaussian NLL | 0,044 | 0,029 | −0,192 |
| Student-t NLL | 0,045 | 0,030 | −0,529 |
| Quantile Loss | 0,044 | 0,029 | −0,395 |
| Adaptive Conformal | 0,044 | 0,030 | −0,314 |
| DER / ProbFM core | 0,045 | 0,030 | −0,536 |
Kwa RMSE na MAE, mbinu ziko karibu sana. Haiwezi kusemwa kwamba DER/ProbFM core ndiyo mbinu bora ya utabiri wa nukta; RMSE yake ni 0,045, juu kidogo ya 0,044 ya baadhi ya mbinu. Dai sahihi la chanzo ni kwamba usahihi wa utabiri wa nukta ni “competitive/comparable”.
Jambo la kuvutia zaidi ni kwamba Pearson correlations zote zilizoripotiwa kwa BTC ni hasi. Kwa DER/ProbFM core, correlation ni −0,536. Matokeo haya yanaonyesha wazi kwamba ulinganifu wa mstari wa mwelekeo kati ya utabiri na mapato halisi ya kila siku haukuwa chanya kwa nguvu katika test ya BTC. Hata hivyo, chanzo hutumia tathmini tofauti ya mwelekeo na filter ya kutokuwa na uhakika katika utendaji wa mkakati wa biashara; vipimo hivi viwili havipaswi kutumiwa badala ya kila kimoja.
Kielelezo 2 cha chanzo kinaonyesha nini?
Kielelezo 2 cha chanzo kinaonyesha kwa pamoja usambazaji wa mapato ya kila siku yaliyotabiriwa na DER na mapato halisi ya test kwa ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT na XRP. Waandishi wanaeleza hasa kwamba kwa mali za crypto zenye volatility kubwa zaidi, usambazaji wa mapato yaliyotabiriwa ni mpana zaidi kwa kiasi kinachoonekana kuliko mapato halisi.
Kwa kuwa data ghafi ya histogram ya kielelezo haikutolewa kama jedwali ndani ya PDF, Verianla haitengenezi upya urefu sahihi wa histogram bars. Ujumbe wa kisayansi unaoungwa mkono na chanzo umehifadhiwa kwa maandishi.
Vipimo vya uwezekano vya BTC
| Mbinu | CRPS | PICP (%95) | Sharpness | Correlation ya Kutokuwa na Uhakika-Hitilafu |
|---|---|---|---|---|
| Gaussian NLL | 2,21 | 0,95 | 15,22 | 0,12 |
| Student-t NLL | 3,17 | 0,95 | 15,48 | 0,11 |
| Quantile Loss | NA | 0,75 | 7,92 | 0,17 |
| Adaptive Conformal | 2,26 | 0,81 | 9,67 | 0,09 |
| DER / ProbFM core | 2,65 | 0,46 | 3,90 | 0,00 |
Kwa BTC, Gaussian NLL inatoa CRPS ya chini zaidi (2,21) na PICP kamili ya 0,95, wakati ProbFM core inatoa CRPS 2,65 na PICP 0,46. Thamani ya sharpness ya ProbFM core ni ndogo zaidi, 3,90; lakini kwamba interval hizi nyembamba hutoa coverage ya %46 tu inaonyesha sharpness haiwezi kutafsiriwa peke yake kuwa matokeo chanya.
Kanuni ya uigaji wa biashara
Chanzo hutumia mkakati wa biashara wa mwelekeo:
- Ikiwa mapato yaliyotabiriwa ni \(>0\), nafasi ndefu (BUY).
- Ikiwa mapato yaliyotabiriwa ni \(\le0\), nafasi fupi (SELL).
- \(\operatorname{PnL}=\operatorname{signal}\times\operatorname{actual\ return}\times100\) na matokeo hutathminiwa kwa basis point.
Katika mbinu za uwezekano, biashara pia huchujwa ikiwa kutokuwa na uhakika wa jumla wa utabiri uko juu ya percentile ya 75. ya usambazaji wake. Kwa hiyo matokeo ya trading ya modeli za uwezekano hujumuisha si mwelekeo wa utabiri pekee bali pia filter ya kutokuwa na uhakika.
Sharpe, Sortino, drawdown na Calmar hupima nini?
Chanzo hufafanua Sharpe ratio kama:
\[ \operatorname{Sharpe} = \frac{\mu_r}{\sigma_r} \]
na huifanya ratio ya kila siku kuwa ya mwaka kwa \(\sqrt{252}\).
Sortino ratio ni:
\[ \operatorname{Sortino} = \frac{\mu_r}{\sigma_{\text{downside}}} \]
na hutumia standard deviation ya mapato hasi pekee kama hatari.
Maximum Drawdown ni kushuka kukubwa zaidi kutoka kilele hadi chini katika PnL ya jumla. Calmar ratio hugawanya mapato yaliyofanywa ya mwaka kwa maximum drawdown ya absolute. Win Rate ni uwiano wa biashara zenye faida kwa jumla ya biashara.
Utendaji wa biashara wa BTC
| Mbinu | Sharpe ya mwaka | Sortino ya mwaka | Max DD (bps) | Calmar | Win Rate |
|---|---|---|---|---|---|
| MSE | 0,90 | 1,52 | −15,89 | 1,98 | 0,51 |
| Huber | 0,59 | 0,93 | −15,14 | 1,35 | 0,51 |
| Gaussian NLL | 0,49 | 0,77 | −15,14 | 1,12 | 0,50 |
| Student-t NLL | 0,70 | 1,08 | −15,89 | 1,41 | 0,51 |
| Quantile Loss | 1,13 | 1,90 | −15,14 | 2,60 | 0,52 |
| Adaptive Conformal | 0,98 | 1,64 | −15,14 | 2,25 | 0,51 |
| DER / ProbFM core | 1,33 | 2,27 | −15,14 | 3,04 | 0,52 |
Chanzo kinasisitiza kwamba ProbFM core inatoa Sharpe na Sortino za juu zaidi kwa BTC. Hata hivyo, win rate ni 0,52 na ni sawa na Quantile Loss. Chanzo cha ratio hizo za juu zilizorekebishwa kwa hatari si “utabiri sahihi zaidi wa mwelekeo” pekee; uteuzi wa biashara na filter ya kutokuwa na uhakika pia ni sehemu ya matokeo.
Je, Usanifu Kamili wa Transformer ProbFM Ulithibitishwa Kimajaribio Katika Utafiti Huu?
Si kikamilifu. Ingawa utafiti unaeleza kwa undani usanifu wa ProbFM unaotegemea Transformer, ulinganisho wa kimajaribio uliodhibitiwa katika majedwali ya matokeo unalinganisha DER na mbinu nyingine za kutokuwa na uhakika kwenye uti wa mgongo wa LSTM wenye tabaka 1 na kipimo fiche 32; kwa hiyo utendaji ulioripotiwa kwa BTC na crypto nyingine unathibitisha hasa mekanizimu ya kutokuwa na uhakika ya DER/ProbFM-core, si ubora wa usanifu kamili wa adaptive-patching Transformer moja kwa moja.
Matokeo ya biashara ya ProbFM core katika mali nyingine 10
| Mali | Sharpe ya mwaka | Sortino ya mwaka | Max DD (bps) | Calmar | Win Rate |
|---|---|---|---|---|---|
| BTC | 1,33 | 2,27 | −15,14 | 3,04 | 0,52 |
| ADA | −0,83 | −0,86 | −88,94 | −0,86 | 0,46 |
| BNB | 1,96 | 2,80 | −21,26 | 3,44 | 0,57 |
| DASH | −0,49 | −0,55 | −66,52 | −0,47 | 0,50 |
| DOGE | −0,08 | −0,12 | −63,42 | −0,10 | 0,49 |
| ETH | 1,10 | 1,84 | −38,83 | 1,91 | 0,50 |
| LTC | 0,17 | 0,22 | −42,44 | 0,23 | 0,55 |
| SOL | 1,64 | 2,84 | −28,99 | 4,07 | 0,54 |
| USDC | 9,14 | 16,24 | −0,05 | 53,43 | 0,68 |
| USDT | 5,28 | 8,32 | −0,11 | 20,03 | 0,58 |
| XRP | 1,44 | 2,67 | −28,35 | 3,55 | 0,53 |
Matokeo si sawa kati ya mali. Sharpe ratio ya ProbFM core ni hasi kwa ADA, DASH na DOGE; na ni chanya kwa BTC, BNB, ETH, SOL na XRP. Thamani za juu sana za Sharpe/Sortino zimeripotiwa kwa USDC na USDT. Kwa kuwa mali hizi mbili ni stablecoin, vipimo vya return na drawdown vinatofautiana na crypto nyingine; pia gharama za biashara hazikujumuishwa. Kwa hiyo si sahihi kuchukulia ratio za juu za stablecoin kuwa sawa moja kwa moja na utendaji wa kiuchumi wa crypto nyingine.
Kikomo cha dai la “portfolio optimization” katika chanzo
Sehemu ya utangulizi wa makala inasema portfolio optimization inayotumia position sizing inayotegemea kutokuwa na uhakika ilizidi equal-weighted baseline. Hata hivyo, katika mbinu, matokeo na majedwali ya nyongeza ya PDF iliyopakiwa, hakuna jaribio tofauti la portfolio optimization, equation ya portfolio weighting, wala jedwali la equal-weighted comparison. Matokeo ya kimajaribio yanayoonekana yanahusu mkakati wa kila siku wa biashara wa mwelekeo na filter ya kutokuwa na uhakika ya percentile ya 75.
Kwa hiyo Verianla haipanui dai la portfolio optimization kama matokeo ya kina yaliyothibitishwa. Dai hili ambalo halijaelezwa kwa undani katika chanzo linabaki kuwa tamko la mwandishi wa chanzo katika sehemu ya utangulizi.
Matokeo yanayoungwa mkono na utafiti
- Muundo wa DER/NIG unaweza kutoa kutokuwa na uhakika wa epistemic na aleatoric kama ukubwa tofauti wa kihisabati ndani ya forward pass moja.
- Katika jaribio la LSTM lililodhibitiwa, thamani za RMSE/MAE za utabiri wa nukta wa DER kwa ujumla ziko katika kiwango sawa cha ukubwa na mbinu nyingine.
- Katika uigaji wa biashara wa BTC, ProbFM core ilitoa thamani za juu zaidi za Sharpe na Sortino katika jedwali la chanzo.
- Vipimo vya kutokuwa na uhakika hutofautiana sana kati ya mali za crypto.
- Licha ya coverage loss, lengo la %95 PICP la ProbFM core halikufikiwa kwa mali zote.
- Filter ya kutokuwa na uhakika ni sehemu ya uteuzi wa biashara katika jaribio la maamuzi ya kifedha la chanzo.
Ujumla ambao utafiti hauungi mkono
- Hitimisho kwamba ProbFM ndiyo modeli bora zaidi ya utabiri kwa mali zote za crypto haliungwi mkono.
- Haijaonyeshwa kwamba usanifu kamili wa Transformer ProbFM ni bora kuliko mbinu zote zilizolinganishwa katika jedwali.
- Haijaonyeshwa kwamba interval za utabiri za %95 kwa ujumla zimekalibishwa vizuri.
- Sharpe na Sortino ratio zilizoripotiwa si mapato ya uwekezaji baada ya gharama halisi za biashara.
- Utafiti hautoi mfumo wa kununua na kuuza unaohakikisha bei ya crypto ya baadaye.
- Uwezo wa kuhamisha matokeo kwenda hisa, fedha za kigeni, nishati au maeneo mengine ya mfululizo wa muda bado haujajaribiwa.
- Usambazaji wa takwimu wa matokeo chini ya random seed tofauti haujaripotiwa.
Mapungufu ya chanzo chenyewe
Wigo wa data: Tathmini kuu inalenga mali 11 za crypto pekee.
Hali za soko: Chanzo kinakubali kwamba kipindi kilichochunguzwa huenda hakijumuishi hali zote za soko, ikiwemo kuporomoka kwa kiwango kikubwa au bear markets za muda mrefu.
Gharama za biashara: Slippage, kamisheni na market impact hazipo katika uigaji.
Wigo wa usanifu: Ulinganisho uliodhibitiwa unategemea LSTM; usanifu mwingine unaweza kutoa trade-off tofauti.
Ukosefu wa ablation: Michango ya coverage loss, evidence annealing na bounded prediction transformation haikupimwa kivyake kwa ablation katika toleo hili.
Uthabiti wa takwimu: Chanzo kinapendekeza siku zijazo kutumika random initialization nyingi, confidence intervals, standard deviations kati ya run, na formal hypothesis tests. Katika mpangilio wa sasa wa reproducibility, random seed 0 imeripotiwa.
Modeli za kawaida: Modeli za kawaida za mfululizo wa muda/financial econometrics kama ARIMA na GARCH hazikulinganishwa katika jedwali la sasa la majaribio na zimeachwa kwa kazi ya baadaye.
Madokezo ya kiufundi na ya kuripoti ndani ya chanzo
| Mada | Hali inayoonekana katika chanzo | Kikomo sahihi cha tafsiri |
|---|---|---|
| Tofauti ya Transformer / LSTM | ProbFM kamili inaelezwa kama Transformer; majaribio linganishi hutumia uti wa mgongo wa LSTM wa pamoja. | Matokeo ya jedwali hayapaswi kuwasilishwa kama benchmark ya Transformer ProbFM kamili. |
| Notation ya NIG | Sehemu ya usanifu hutumia \(\mu,\lambda,\alpha,\beta\); sehemu ya jaribio na regularization hutumia \(\gamma,\nu,\alpha,\beta\). | Kwa kuwa chanzo hakitoi ulinganifu wazi, alama hazipaswi kubadilishwa kimya kimya. |
| Optimizer | Mbinu kuu ni AdamW; jaribio lililodhibitiwa katika Appendix C linaripoti Adam. | Mazingira mawili ya mafunzo lazima yatenganishwe; chanzo hakielezi tofauti hiyo kikamilifu. |
| Cosine schedule | Eq. 24 ina \(\cos(\pi t/T)\) pekee. | Kwa jinsi ilivyoandikwa inaweza kuwa hasi katika nusu ya pili; chanzo hakifafanui kwa implementation code. |
| Notation ya confidence interval | \(\alpha\) inaonekana kutumiwa kama NIG shape na pia kama complement ya confidence level. | Katika Eq. 30 maana ya alama ina utata unaotegemea muktadha. |
| Matokeo ya Coverage | Lengo la coverage loss ni %95; BTC ProbFM-core PICP 0,46. | Kuwepo kwa coverage loss hakuhakikishi mafanikio ya kalibrashi. |
| Portfolio optimization | Kuna dai la mafanikio katika utangulizi; hakuna jedwali tofauti la mbinu/matokeo linaloonekana. | Tamko la mwandishi lisiloelezwa kwa undani halipaswi kupanuliwa kama matokeo kamili ya kimajaribio. |
Maelezo ya Chanzo na Mbinu
Kichwa asili: ProbFM: Probabilistic Time Series Foundation Model with Uncertainty Decomposition
Waandishi: Arundeep Chinta; Lucas Vinh Tran; Jay Katukuri.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa.
Affiliations: Arundeep Chinta na Jay Katukuri — JPMorganChase, Palo Alto, USA. Lucas Vinh Tran — JPMorganChase, London, UK.
Mawasiliano: Chanzo kinatoa anuani za barua pepe za waandishi wote watatu katika ukurasa wa kwanza. Hakuna alama tofauti ya “corresponding author”.
Mchango sawa: Hakuna tamko la mchango sawa katika PDF iliyopakiwa.
Aina ya chanzo: arXiv preprint.
Kitambulisho cha arXiv: arXiv:2601.10591v1.
Eneo kuu: cs.LG — Machine Learning.
Tarehe ya kupakia: 15 Januari 2026.
Jarida / konferensi: Kufikia Novemba 2026, hakuna chapisho lililothibitishwa la jarida au konferensi lenye peer review kwa kichwa hicho hicho lililotambuliwa; rekodi rasmi inaendelea kuwa preprint.
DOI: Hakuna DOI tofauti ya chapisho iliyoripotiwa katika PDF iliyopakiwa wala katika maandishi ya rekodi rasmi ya arXiv yaliyothibitishwa; kwa hiyo Verianla haiongezi DOI ambayo haijathibitishwa.
Leseni: Hakuna taarifa wazi ya leseni katika maandishi yanayoonekana ya PDF iliyopakiwa; taarifa ya leseni isiyothibitishwa haijaongezwa.
Ufadhili: Hakuna tamko tofauti la ufadhili katika PDF iliyopakiwa.
Mgongano wa maslahi: Hakuna tamko tofauti la mgongano wa maslahi linaloonekana.
Michango ya waandishi ya CRediT: Hakuna jedwali tofauti la michango ya CRediT.
Chanzo cha data: Data ya bei ya crypto ilipatikana kupitia Stooq. Chanzo hakitoi tamko tofauti la data-availability wala repository ya code ya reproducibility.
Kipindi cha data: 1 Januari 2020–3 Oktoba 2025; kutokana na upatikanaji wa mali, si mfululizo wote wenye urefu sawa.
Aina kuu ya utafiti: Uundaji wa modeli za uwezekano za mfululizo wa muda + ulinganisho uliodhibitiwa wa machine learning + uigaji wa biashara ya kifedha.
Usanifu unaopendekezwa: Adaptive patching, positional encoding, Transformer, DER/NIG head, evidential loss, coverage loss, evidence annealing na single-pass inference.
Usanifu wa ulinganisho wa kimajaribio: LSTM yenye tabaka 1 na kipimo fiche 32; uti wa mgongo uleule hutumiwa katika mbinu zote ili kutenga athari ya mbinu za kutokuwa na uhakika.
Kikomo muhimu cha matokeo: Utafiti hauonyeshi kwamba Transformer ProbFM kamili ni bora kuliko foundation models zote pinzani. Majedwali ya kimajaribio yanaonyesha hasa tabia ya mekanizimu ya DER katika mazingira ya LSTM ya pamoja.
Kikomo cha kalibrashi: Katika interval za utabiri zinazolenga %95, thamani ya PICP ya ProbFM core hubadilika kati ya 0,31–1,00 kwa mali tofauti; kwa hiyo matokeo ya chanzo hayaonyeshi kalibrashi ya %95 iliyo sawa kwa mali zote.
Kikomo cha uigaji wa biashara: Slippage, kamisheni na market impact hazijajumuishwa. Thamani za Sharpe, Sortino, Calmar na drawdown zilizoripotiwa si ushahidi kwamba zitatokea kwa namna ileile katika matumizi halisi ya soko.
Disclaimer ya chanzo: Makala inaeleza wazi kwamba JPMorganChase haitoi dhamana kuhusu ukamilifu au usahihi wa taarifa; maoni ni ya waandishi, na hati si utafiti wa uwekezaji, ushauri wa uwekezaji, wala pendekezo la kununua au kuuza dhamana au bidhaa ya kifedha.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *