


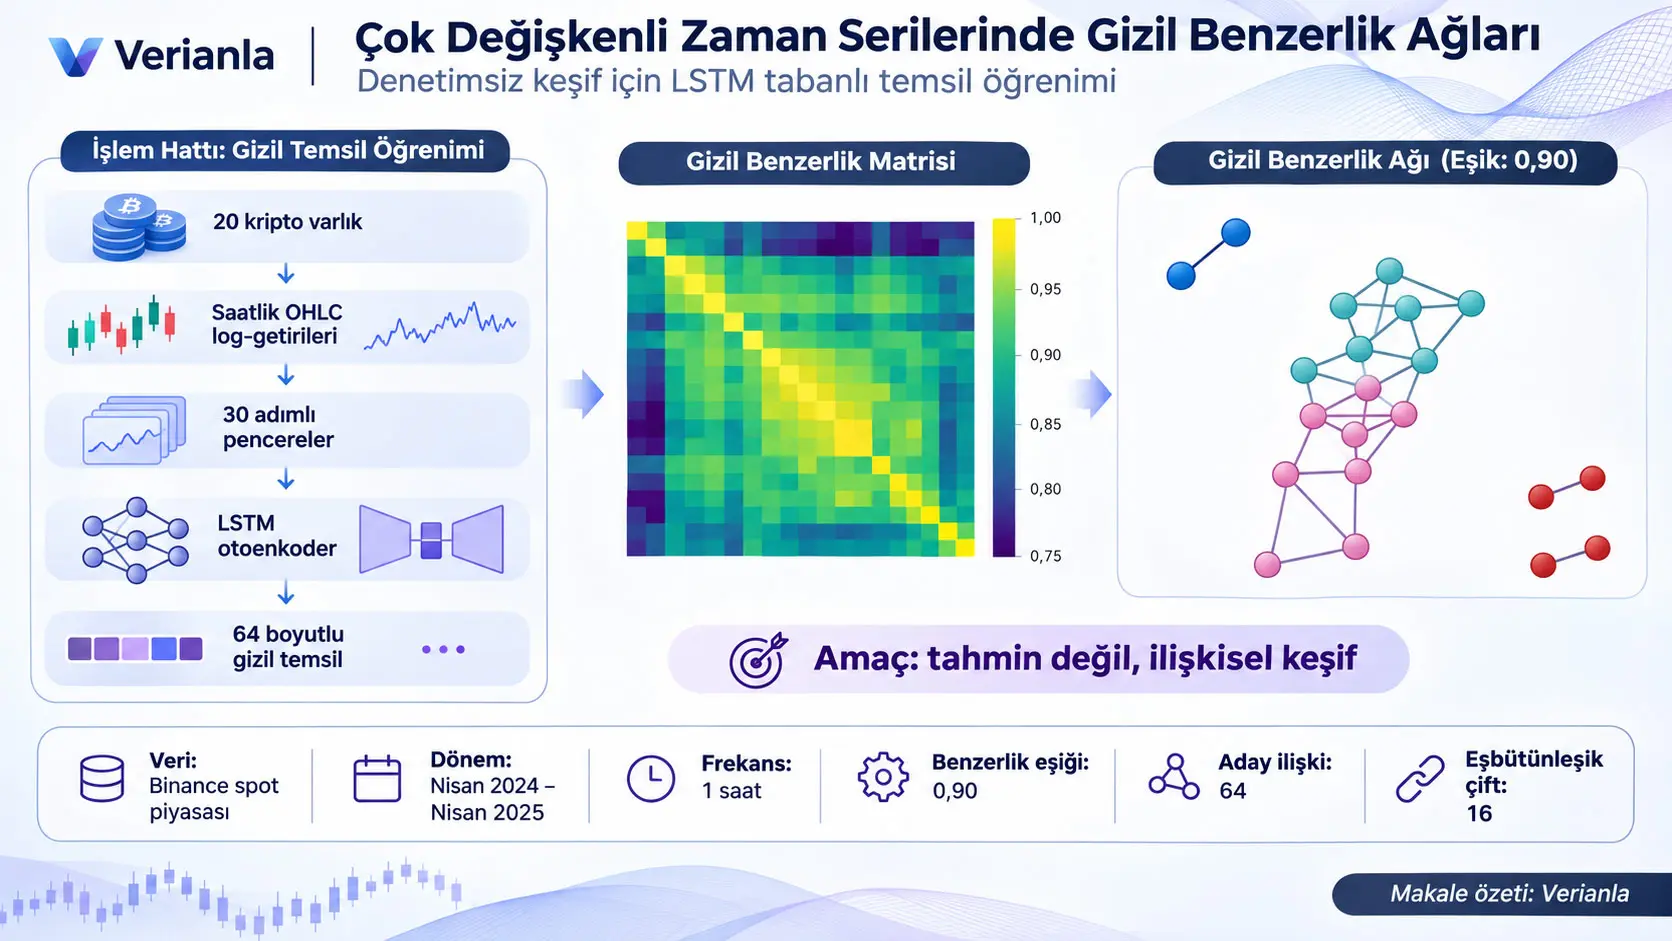
Gizil Yapısal Benzerlik Ağları (Latent Structural Similarity Networks), çok değişkenli zaman serilerindeki varlıkların yalnız aynı anda yükselip düşmelerine değil, zaman boyunca sergiledikleri daha karmaşık davranış örüntülerine göre benzerliklerinin keşfedilmesini amaçlayan bir denetimsiz makine öğrenmesi yaklaşımıdır. Olusegun Owoeye tarafından hazırlanan bu çalışma, zaman serilerini düşük boyutlu gizil temsillere dönüştürerek varlıklar arasında doğrudan gözlenmesi zor olan yapısal ilişkilerin bir benzerlik ağı üzerinden araştırılabileceğini göstermektedir.
Önerilen yöntem, bir sonraki fiyatı tahmin etmek veya otomatik yatırım işlemi gerçekleştirmek üzere geliştirilmemiştir. Araştırmanın temel hedefi, çok sayıda varlık arasındaki olası ilişkileri önceden belirlenmiş alım-satım veya optimizasyon kurallarına ihtiyaç duymadan keşfetmektir. Bu amaçla zaman serileri örtüşen pencerelere bölünmekte, Long Short-Term Memory (LSTM) tabanlı bir diziden diziye otoenkoder kullanılarak gizil temsiller öğrenilmekte ve bu temsiller arasındaki kosinüs benzerlikleri üzerinden bir ilişki ağı oluşturulmaktadır.
Yöntem, Binance borsasından alınan kripto para spot piyasa verileri üzerinde değerlendirilmiştir. Araştırmada piyasa değerine göre seçilmiş 20 kripto varlığın USDT karşısındaki fiyat serileri kullanılmıştır. Veri dönemi Nisan 2024 ile Nisan 2025 arasındaki yaklaşık bir yıllık zaman aralığını kapsamaktadır. Gözlemler bir saatlik frekanstadır. Açılış, en yüksek, en düşük ve kapanış fiyatları (Open, High, Low, Close; OHLC) logaritmik getirilere dönüştürülmüş, 30 zaman adımlı örtüşen pencereler oluşturulmuş ve bütün varlıklar için ortak bir LSTM otoenkoderi eğitilmiştir.
Otoenkoderin kodlayıcı bölümünde gizli boyutu 256 olan iki LSTM katmanı kullanılmış, elde edilen temsil ReLU etkinleştirme fonksiyonuna sahip yoğun bir katmanla 64 boyutlu gizil vektöre dönüştürülmüştür. Eğitimde Adam optimizasyonu, ortalama karesel yeniden oluşturma hatası, 64 örneklik mini-batch ve 20 epoch kullanılmıştır. Her varlığa ait farklı zaman pencerelerinin gizil vektörleri ortalanarak varlık düzeyinde tek bir temsil elde edilmiş; ardından bütün varlık çiftleri arasındaki kosinüs benzerlikleri hesaplanmıştır.
0,90 kosinüs benzerliği eşiği uygulandığında 20 varlık arasında 64 aday ilişki elde edilmiştir. Ortaya çıkan ağ, bütün varlıkların birbirleriyle aynı düzeyde bağlantılı olduğu tekdüze bir yapı göstermemiş; yoğun bağlantılı gruplar, farklı bağlı bileşenler ve birbirinden ayrılmış çiftler içermiştir. Bu sonuç, öğrenilen gizil temsillerin bütün varlıkları aynı genel piyasa davranışına indirgemek yerine belirli yapısal farklılıkları koruduğunu göstermektedir.
Keşfedilen 64 aday çift ayrıca klasik Engle–Granger eşbütünleşme testi (cointegration test) kullanılarak değerlendirilmiştir. %95 güven düzeyiyle yürütülen bu sonradan uygulanan tanısal incelemede 16 çift eşbütünleşme ölçütünü karşılamıştır. Bu sayı 64 adayın %25'ine karşılık gelmektedir. Geriye kalan 48 çiftin testi geçmemesi, bu ilişkilerin mutlaka yanlış olduğu anlamına gelmez; çünkü yöntemin aradığı gizil yapısal benzerlik ile klasik doğrusal uzun dönem denge ilişkisi aynı matematiksel kavram değildir.
Çalışmanın temel katkısı, çok değişkenli zaman serilerindeki ilişkilerin araştırılması için tahmin ve karar verme süreçlerinden bağımsız bir keşif katmanı ortaya koymasıdır. Bu yaklaşım finansal piyasaların yanında biyolojik ölçümler, endüstriyel sensörler, malzeme bozulma süreçleri ve çok değişkenli mühendislik sistemleri için de uyarlanabilir bir yöntem çerçevesi sunmaktadır. Ancak bu diğer alanlarda ayrı deneyler gerçekleştirilmemiştir.
Araştırmanın önemli sınırı, sonuçların tek bir veri frekansı ve tek bir sabit benzerlik eşiğiyle raporlanmış olmasıdır. Makalede zamansal kararlılık, eşik duyarlılığı ve yeniden tahminlerde bağlantıların devamlılığını değerlendirmek için bir protokol açıklanmış; fakat bu kontrollerin tamamına ait ayrıntılı sayısal deney sonuçları verilmemiştir. Ayrıca yöntem alternatif keşif algoritmalarıyla karşılaştırılmamış ve herhangi bir yatırım stratejisinin getirisi test edilmemiştir.
Türkiye açısından çalışmanın önemi, etiketlenmiş sonuç verisi bulunmayan karmaşık zaman serilerinde ön araştırma yapılmasına yönelik genel bir yöntem sunmasıdır. Endüstriyel makine sensörlerinin ortak davranışlarını, farklı üretim ekipmanlarının zaman içindeki değişim örüntülerini veya finansal varlık gruplarındaki yapısal yakınlıkları araştırmak için uyarlanabilir. Bununla birlikte bu kullanım alanları çalışmada doğrudan doğrulanmış uygulamalar değil, yöntemin yapısından hareketle tartışılan olası araştırma alanlarıdır.
Gizil Yapısal Benzerlik Nedir ve Geleneksel Korelasyondan Nasıl Ayrılır?
Gizil yapısal benzerlik, iki veya daha fazla varlığın gözlenen değerlerinin yalnız aynı anda birlikte değişmesine değil, zaman içinde öğrendikleri çok değişkenli davranış örüntülerinin ne kadar birbirine benzediğine odaklanır. Çalışmada bu benzerlik ham veri üzerinde doğrudan hesaplanmaz; LSTM otoenkoderinin öğrendiği gizil vektörler karşılaştırılarak değerlendirilir.
Zaman serisi nedir?
Zaman serisi (time series), bir değişkenin zaman boyunca farklı noktalarda gözlenen değerlerinin sıralı bütünüdür. Örneğin bir kripto paranın saatlik kapanış fiyatları, bir makinenin dakikalık sıcaklık ölçümleri veya bir üretim hattının saniyelik titreşim verileri zaman serisi oluşturur.
Bu tür verilerde gözlemlerin sırası önemlidir. Aynı değerlerin farklı zamanlarda farklı sıralarla ortaya çıkması, sistemin davranışına ilişkin farklı bilgiler taşıyabilir.
Çok değişkenli zaman serisi nedir?
Çok değişkenli zaman serisi (Multivariate Time Series), aynı varlık veya sistem için birden fazla özelliğin zaman boyunca birlikte ölçülmesidir.
Kripto para piyasasında yalnız kapanış fiyatına bakmak tek değişkenli bir yaklaşımken, açılış, en yüksek, en düşük ve kapanış fiyatlarından elde edilen özellikleri birlikte değerlendirmek çok değişkenli bir yaklaşımdır.
Çalışmanın yöntem bölümünde \(N\) adet varlık bulunduğu ve her varlığın \(T\) zaman noktası boyunca \(d\) boyutlu özellik vektörleriyle temsil edildiği varsayılmaktadır:
\[ X_i=\{x_{i,t}\}_{t=1}^{T} \]
\[ x_{i,t}\in\mathbb{R}^{d} \]
Burada:
- \(X_i\): \(i\). varlığa ait çok değişkenli zaman serisidir.
- \(x_{i,t}\): \(i\). varlığın \(t\) zamanındaki özellik vektörüdür.
- \(N\): İncelenen varlık sayısıdır.
- \(T\): Zaman gözlemlerinin toplam sayısıdır.
- \(d\): Her zaman noktasındaki özellik sayısıdır.
- \(\mathbb{R}^{d}\): \(d\) boyutlu gerçek sayılar uzayıdır.
Bu gösterim yalnız fiyat verileri için geçerli değildir. Aynı matematiksel model, bir endüstriyel motorun sıcaklık, akım, titreşim ve basınç gibi farklı ölçümlerini birlikte içeren zaman serilerini de temsil edebilir.
Geleneksel korelasyon neyi ölçer?
Korelasyon, iki değişkenin belirli koşullar altında birlikte değişim yönünü ve derecesini özetlemek için kullanılan istatistiksel ilişkidir. Yaygın kullanılan Pearson korelasyonu doğrusal birlikte değişime odaklanır.
Örneğin iki varlığın getirileri sık sık aynı yönde hareket ediyorsa pozitif doğrusal korelasyon görülebilir. Ancak bu, iki varlığın daha karmaşık zaman içi davranışlarının tamamen aynı olduğu anlamına gelmez.
İki varlık aynı zamanlarda aynı yönde hareket etmese bile volatilite kümelenmesi, gecikmeli tepki, belirli döngüler veya farklı dönemlerde benzer değişim yapıları gösterebilir.
Çalışma, yalnız eşzamanlı doğrusal birlikte hareketin bu ilişkilerin tamamını yakalamak için yeterli olmayabileceği düşüncesinden hareket etmektedir.
Gizil uzay ne demektir?
Gizil uzay (latent space), gözlenen çok boyutlu verinin bir öğrenme modeli tarafından daha az sayıda özellik üzerinden yeniden temsil edildiği matematiksel uzaydır.
Buradaki gizil ifadesi, özelliklerin doğrudan ham veri sütunları olarak gözlenmemesini anlatır. Model, eğitim sırasında veri örüntülerini daha sıkıştırılmış bir gösterime dönüştürmeyi öğrenir.
Örneğin bir modelin ürettiği 64 boyutlu vektör, kaynakta tanımlanmayan belirli bir boyutunun doğrudan “volatilite”, başka bir boyutunun “fiyat eğilimi” olduğu anlamına gelmez. Gizil boyutlar öğrenilmiş matematiksel temsil bileşenleridir.
Bu nedenle araştırmada gizil temsilin tek tek her boyutu ekonomik bir değişkenmiş gibi yorumlanmamaktadır. Yazar, özellikle bu temsillerden türetilen ilişkisel ağ yapısına odaklanmıştır.
Denetimsiz öğrenme nedir?
Denetimsiz öğrenme (unsupervised learning), modelin her örnek için önceden hazırlanmış doğru sınıf veya hedef etiketine ihtiyaç duymadan verinin yapısından belirli ilişkileri öğrenmesidir.
Bu çalışmada otoenkoder, gelecekteki kripto para fiyatını tahmin ederek eğitilmemektedir. Girdi olarak aldığı zaman serisi penceresini yeniden oluşturmaya çalışmaktadır.
Böylece öğrenme hedefi bir yatırım kararının doğruluğu değil, zaman serisindeki bilgilerin sıkıştırılmış bir temsilde korunmasıdır.
Otoenkoder nedir?
Otoenkoder (autoencoder), bir kodlayıcı (encoder) ve bir çözücüden (decoder) oluşan sinir ağı yaklaşımıdır.
Kodlayıcı, giriş verisini daha düşük boyutlu bir gizil temsile dönüştürür. Çözücü ise bu gizil temsilden hareketle başlangıç verisini yeniden oluşturmaya çalışır.
Bu sistemin eğitiminde önemli ölçüt, yeniden oluşturulan verinin orijinal veriye ne kadar benzediğidir.
Kaynak, ortalama karesel yeniden oluşturma hatasının (Mean Squared Error, MSE) en aza indirildiğini belirtmektedir. Bu hata ölçüsünün genel matematiksel biçimi öğretici olarak:
\[ MSE=\frac{1}{m}\sum_{j=1}^{m}(x_j-\hat{x}_j)^2 \]
şeklinde gösterilebilir.
Burada \(x_j\) gerçek giriş değerini, \(\hat{x}_j\) yeniden oluşturulan değeri ve \(m\) karşılaştırılan toplam skaler değer sayısını temsil eder.
Her gözlem ile yeniden oluşturulmuş karşılığı arasındaki farkın karesi alındığı için büyük hatalar daha yüksek katkı sağlar. Model eğitim boyunca bu hatayı düşürmeye çalışır.
Bu denklem standart MSE tanımını öğretmek için verilmiştir; kaynakta modele özgü tüm tensor boyutlarıyla yazılmış ayrı bir kayıp fonksiyonu bulunmamaktadır.
LSTM neden kullanılmıştır?
Long Short-Term Memory (LSTM), sıralı veri içindeki zamansal ilişkileri öğrenmek amacıyla geliştirilmiş tekrarlayan sinir ağı mimarisidir.
Klasik doğrusal boyut indirgeme yöntemleri bazı zaman içi ilişkileri sınırlı biçimde temsil edebilirken LSTM, bir veri dizisinin önceki adımlarından gelen bilgiyi sonraki adımların işlenmesi sırasında kullanabilir.
Çalışmada LSTM'nin seçilme gerekçesi, benzerliğin yalnız belirli bir andaki değişken değerlerine değil, zaman boyunca gelişen davranış örüntülerine bağlı olabilmesidir.
Ancak LSTM kullanılması, modelin bütün doğrusal olmayan ilişkileri kesin olarak öğrendiğinin veya bütün piyasa rejimlerine dayanıklı olduğunun kanıtı değildir. Bu özellikler kullanılan eğitim verisi ve bağımsız doğrulama koşullarına bağlıdır.
Diziden diziye otoenkoder ne yapıyor?
Sequence-to-Sequence Autoencoder, sabit uzunlukta veya belirli bir biçimde düzenlenmiş giriş dizilerini kodlayarak yeniden dizi biçiminde üretmeyi hedefler.
Çalışmada her zaman penceresi çok değişkenli bir dizi olarak kodlayıcıya verilir. Kodlayıcı bu diziyi gizil vektöre dönüştürür; çözücü ise aynı zaman penceresinin özelliklerini yeniden oluşturur.
Araştırmacının amacı, iyi yeniden oluşturma davranışı sergileyen ortak gizil uzayın varlıklar arasındaki daha geniş zaman içi yapısal ilişkileri incelemek için kullanılabilmesidir.
Bu yaklaşım neden doğrudan korelasyon yerine temsil öğreniyor?
Ham getiri serileriyle hesaplanan geleneksel benzerlik ölçümleri hızlı ve anlaşılırdır. Ancak her zaman aralığındaki çok değişkenli davranışları tek bir getiriyi kullanarak özetlemek bazı bilgileri kaybettirebilir.
Önerilen yöntem önce kısa zaman dizilerindeki örüntüleri öğrenmekte, sonra bu pencereleri varlık düzeyinde özetlemekte ve son aşamada gizil vektörleri karşılaştırmaktadır.
Bu durum geleneksel korelasyonun bilimsel olarak geçersiz olduğu anlamına gelmez. Araştırma, daha geniş bir keşif çerçevesi sunmakta; ancak doğrudan korelasyona karşı kapsamlı sayısal üstünlük karşılaştırması gerçekleştirmemektedir.
Çalışmada 20 Kripto Varlık Arasındaki Benzerlikler Nasıl Keşfedildi?
Çalışma, Binance'deki 20 kripto varlığın bir saatlik OHLC fiyatlarından hesaplanan çok değişkenli log-getirileri 30 adımlık pencerelere bölerek ortak bir LSTM otoenkoderinde işlemiştir. Her varlığın öğrenilen pencere temsilleri ortalanmış ve oluşan 64 boyutlu gizil vektörler arasındaki kosinüs benzerliğine 0,90 eşik uygulanarak aday ilişki ağı oluşturulmuştur.
Veri kümesinin kapsamı
| Öğe | Kaynak değeri |
|---|---|
| Veri kaynağı | Binance |
| Piyasa | Kripto para spot piyasası |
| Varlık sayısı | 20 |
| Seçim ölçütü | Çalışma dönemi için piyasa değerine göre en büyük 20 kripto varlık |
| Kotasyon para birimi | USDT |
| Veri dönemi | Nisan 2024 – Nisan 2025 |
| Örnekleme frekansı | 1 saat |
| Fiyat özellikleri | Open, High, Low, Close (OHLC) |
| Girdi dönüşümü | Logaritmik getiriler |
| Pencere uzunluğu | 30 zaman adımı |
| Kodlayıcı | İki katmanlı LSTM |
| LSTM gizli boyutu | 256 |
| Gizil temsil boyutu | 64 |
| Mini-batch | 64 |
| Eğitim süresi | 20 epoch |
| Optimizasyon | Adam |
| Kayıp ölçütü | Ortalama karesel yeniden oluşturma hatası |
| Benzerlik ölçütü | Kosinüs benzerliği |
| Benzerlik eşiği | 0,90 |
| Keşfedilen aday ilişki | 64 |
| Eşbütünleşme ölçütünü karşılayan | 16 |
Kaynak veri dönemini ay düzeyinde açıklamaktadır. Kesin başlangıç ve bitiş saatleri, veri çekim zaman damgası, her varlığın eksiksiz geçmiş kayıt sayısı ve varlık seçiminin bütün ara kuralları ayrı ayrı raporlanmamıştır. Bu nedenle bu ayrıntılar varsayımla tamamlanmamıştır.
OHLC verileri neyi ifade eder?
OHLC, belirli bir zaman aralığı için dört fiyat bilgisini içerir:
- Open: Saatlik aralığın açılış fiyatı.
- High: Aynı aralıkta gözlenen en yüksek fiyat.
- Low: Aynı aralıkta gözlenen en düşük fiyat.
- Close: Aralığın kapanış fiyatı.
Bu dört bilgi, yalnız kapanış fiyatına göre daha fazla zaman aralığı içi davranış bilgisi taşıyabilir. Örneğin aynı kapanış fiyatına sahip iki saatlik mumun en yüksek ve en düşük fiyatları farklı olabilir.
Çalışmada bu OHLC serileri logaritmik getirilere dönüştürülmüş ve ayrıca yeni özellik kanalları eklenmemiştir.
Logaritmik getiri nedir?
Logaritmik getiri, iki ardışık pozitif fiyatın oranının doğal logaritmasıyla ifade edilen fiyat değişimi ölçüsüdür.
Standart tanım öğretici olarak:
\[ r_t=\ln\left(\frac{P_t}{P_{t-1}}\right) \]
şeklindedir.
Burada \(P_t\) ilgili zaman noktasındaki fiyatı, \(P_{t-1}\) bir önceki zaman noktasındaki fiyatı ve \(\ln\) doğal logaritmayı gösterir.
Logaritmik getiriler fiyatların mutlak düzeyinden çok göreli değişimlerine odaklanılmasını sağlar. Bu, farklı fiyat seviyelerindeki varlıkları aynı öğrenme çerçevesinde değerlendirmeye yardımcı olabilir.
Bu matematiksel gösterim standart log-getiri tanımıdır. Kaynak OHLC log-getirilerini kullandığını belirtmekle birlikte dört fiyat kanalının dönüşümündeki tüm eksik değer, sıfır fiyat ve veri eşleştirme ayrıntılarını ayrı ayrı açıklamamaktadır.
Veriler neden pencerelere bölünüyor?
Finansal ve endüstriyel zaman serilerinde davranış zaman boyunca değişebilir. Bütün dönemi tek bir değişmez dağılım varsayımıyla ele almak, belirli dönemlerde ortaya çıkan yerel yapısal özellikleri gizleyebilir.
Kayan pencere (rolling window), zaman serisinin ardışık ve çoğunlukla örtüşen alt bölümler halinde incelenmesidir.
Çalışmada her pencerenin uzunluğu:
\[ L=30 \]
olarak belirlenmiştir. Veri frekansı bir saat olduğundan bu, her pencerenin 30 saatlik gözlem dizisini içermesi anlamına gelir.
Kaynakta pencere adımı (stride) için ayrıca bütün ayrıntılarıyla açıklanmış bir sayısal değer bulunmadığından bir pencerenin kesin olarak kaç gözlem ilerletilerek oluşturulduğu varsayımla belirtilmemiştir.
Her pencere:
\[ X_i^{(\tau)}\in\mathbb{R}^{L\times d} \]
şeklinde gösterilir.
Burada \(\tau\) pencere indeksini, \(L\) pencere uzunluğunu, \(d\) özellik boyutunu ifade eder.
Kaynak her pencerenin kendi içinde özellik bazında normalize edildiğini belirtmektedir. Ancak kullanılan normalizasyonun tam denklemi ve olası aykırı değer/eksik veri işlemleri ayrıca ayrıntılandırılmamıştır. Bu yüzden belirli bir z-skor veya min–max dönüşümü kaynak yöntemiymiş gibi kabul edilmemiştir.
Pencere bazında normalizasyonun amacı
Farklı varlıkların fiyat düzeyi ve oynaklık ölçekleri birbirinden farklı olabilir. Normalizasyon, modelin yalnız mutlak büyüklük farklarına odaklanmasını azaltmayı ve zaman içi davranış biçimlerini daha karşılaştırılabilir hale getirmeyi amaçlar.
Bu işlem bütün varlıkları aynı ekonomik özelliğe dönüştürmez. Yalnız kullanılan veri gösteriminin ölçek etkilerini azaltmayı hedefler.
LSTM otoenkoder mimarisinin ayrıntıları
Kaynağa göre kodlayıcı bölümde ardışık iki LSTM katmanı bulunmaktadır ve gizli boyut 256'dır. Son LSTM çıktısı, ReLU etkinleştirme fonksiyonuna sahip yoğun katmanla 64 boyutlu gizil vektöre dönüştürülmektedir.
Çözücü bölümünde gizil vektör yeniden bir projeksiyondan geçirilir, zaman ekseni boyunca tekrarlanır ve iki LSTM katmanı ile zaman dağıtımlı doğrusal katman yardımıyla giriş dizisinin özellik boyutuna dönüştürülür.
Model TensorFlow/Keras üzerinde geliştirilmiş ve Adam optimizasyonu kullanılarak 20 epoch eğitilmiştir.
Epoch, eğitim verisinin model öğrenme sürecinde bir tam geçişine verilen addır. Mini-batch ise her parametre güncellemesinde birlikte kullanılan örnek grubudur. Çalışmada mini-batch büyüklüğü 64'tür.
Eğitim verileri bütün 20 varlığın kayan pencerelerinden oluşturulmuş ortak örnek havuzundan alınmıştır. Böylece her varlık için bütünüyle farklı bir model yerine ortak gizil uzay üreten tek bir model eğitilmiştir.
Ortak model kullanılması varlıklar arası karşılaştırma için önemlidir; çünkü farklı varlıkların gizil vektörleri aynı temsil sisteminde üretilmektedir.
Pencere temsilleri nasıl birleştiriliyor?
Otoenkoder her varlığın her penceresi için bir gizil temsil üretmektedir. Ancak varlıklar arasında tek bir benzerlik karşılaştırması yapabilmek için her varlığı temsil eden ortak bir vektöre ihtiyaç vardır.
Kaynakta bu amaçla pencere vektörlerinin aritmetik ortalaması kullanılmaktadır:
\[ z_i=\frac{1}{K_i}\sum_{\tau=1}^{K_i}h_i^{(\tau)} \]
Burada:
- \(z_i\): \(i\). varlığın birleştirilmiş gizil temsilidir.
- \(K_i\): İlgili varlık için oluşturulan pencere sayısıdır.
- \(h_i^{(\tau)}\): \(i\). varlığın \(\tau\). penceresinden öğrenilen gizil vektördür.
- \(\tau\): Pencere indeksidir.
Formül, varlığın bütün pencere temsillerinin toplanıp pencere sayısına bölündüğünü gösterir. Sonuç, varlığın zaman boyunca öğrenilen örüntülerini özetleyen tek bir vektördür.
Bu yaklaşım geçici ve yalnız belirli bir pencerede görülen değişimlerin etkisini ortalamayla azaltmayı hedefler.
Ancak bu ortalama işlemi bütün zamansal değişimi kayıpsız korumaz. Örneğin farklı dönemlerde birbirinden önemli ölçüde ayrılan davranışlar tek vektörde birleşebilir. Yazarın ileriye yönelik kararlılık değerlendirmelerine önem vermesinin nedenlerinden biri de budur.
Kosinüs benzerliği nasıl hesaplanıyor?
Çalışmanın ikinci temel denklemi, iki varlığın gizil vektörleri arasındaki kosinüs benzerliğidir (cosine similarity):
\[ s_{ij}=\frac{z_i^{\top}z_j}{\|z_i\|\|z_j\|} \]
Bu denklemde:
- \(s_{ij}\): \(i\) ve \(j\) varlıkları arasındaki kosinüs benzerliğidir.
- \(z_i\): Birinci varlığın gizil vektörüdür.
- \(z_j\): İkinci varlığın gizil vektörüdür.
- \(z_i^{\top}z_j\): İki vektörün skaler çarpımıdır.
- \(\|z_i\|\): Birinci vektörün Öklid normudur.
- \(\|z_j\|\): İkinci vektörün Öklid normudur.
Öklid normu, bir vektörün matematiksel uzunluğudur. Kosinüs benzerliği, vektörlerin büyüklüğünden çok yönlerinin ne kadar birbirine yakın olduğunu değerlendirmeye yarar.
İki sıfır olmayan vektör aynı yöndeyse kosinüs benzerliği 1 olur. Birbirine dikse 0, zıt yönlerdeyse −1 olur.
Bu değer finansal getiriler arasındaki Pearson korelasyon katsayısıyla aynı ölçüm değildir. Kaynakta karşılaştırılan nesneler ham getiri dizileri değil, öğrenilmiş gizil vektörlerdir.
Formül sıfır vektör için doğrudan tanımlı değildir çünkü paydadaki norm sıfır olur. Kaynak, böyle bir durum için özel bir hesaplama kuralı raporlamamaktadır.
Neden kosinüs benzerliği seçilmiş?
Yazarın amacı gizil temsillerin mutlak büyüklüklerinden çok yönsel benzerliklerini incelemektir. Aynı yönde bulunan iki gizil vektörün büyüklükleri farklı olsa bile kosinüs benzerliği yüksek olabilir.
Bu özellik farklı fiyat ve ölçek yapılarındaki varlıkları karşılaştırırken yararlı bir matematiksel ölçüt sağlayabilir.
Ancak yüksek kosinüs benzerliği iki kripto varlığın gelecekte mutlaka aynı getiriye sahip olacağı, aralarında neden-sonuç ilişkisi bulunduğu veya aynı ekonomik temele dayandığı anlamına gelmez.
Benzerlik matrisi nedir?
Her varlık çifti için hesaplanan \(s_{ij}\) değerleri bir matris içinde düzenlenebilir. Böylece satır ve sütunlarda varlıkların, kesişimlerde ise bu varlıklar arasındaki benzerliklerin bulunduğu bir yapı elde edilir.
20 varlık için bu yapı 20×20 boyutlu simetrik bir benzerlik matrisidir.
Matrisin köşegenindeki değerler, sıfır olmayan vektörlerin kendileriyle kosinüs benzerliği hesaplandığı için 1'dir.
Kaynak Şekil 1, bu matrisin renklerle gösterilmiş halidir. Şekilde bütün hücrelerin aynı renkte olmadığı, belirli varlık gruplarında daha yüksek benzerliklerin bulunduğu görülmektedir.
Bu durum modelin tüm kripto varlıkları tamamen aynı temsil vektörüne indirgemediğini göstermektedir.
Ancak Şekil 1'in her hücresine karşılık gelen 400 sayısal değer ayrı tablo halinde yayımlanmamıştır. Bu nedenle Verianla, görünür renklerden kesin benzerlik katsayıları uydurmamaktadır.
Benzerlik ağı nasıl kuruluyor?
Benzerlik matrisi tek başına bütün varlık çiftlerini içerir. Araştırmanın amacı ise bu yoğun ilişki alanından daha güçlü adayları ayırabilmektir.
Bu nedenle varlıkların düğüm (node), yeterince yüksek benzerlik taşıyan ilişkilerin ise kenar (edge) olarak temsil edildiği ağırlıklı ve yönsüz bir grafik oluşturulmaktadır.
Çalışmada kullanılan eşik:
\[ \tau=0.90 \]
olarak belirlenmiştir.
Benzerlik değeri bu eşiği karşılayan varlık çiftleri ağda tutulur; diğer çiftler aday ağın kenarları arasına alınmaz.
Bu eşik veri üzerinden deneysel olarak seçilmiş, çok yoğun veya aşırı seyrek ağlardan kaçınmayı amaçlamıştır. Kaynak eşik değerinin bir yatırım optimizasyonuyla belirlendiğini söylememektedir.
Bir ağda düğüm, kenar ve bağlı bileşen ne demektir?
Düğüm (node): Bu araştırmada tek bir kripto varlığı temsil eder.
Kenar (edge): İki varlık arasında eşik koşulunu karşılayan gizil benzerlik ilişkisini temsil eder.
Ağırlık (weight): Kenara karşılık gelen kosinüs benzerliği değeridir.
Bağlı bileşen (connected component): Kendi içinde bir kenar yolu üzerinden birbirine erişilebilen düğümlerin oluşturduğu gruptur.
Yoğun alt grafik: Bir grup içindeki düğümler arasında görece çok sayıda bağlantı bulunmasıdır.
İzole çift: Birbirine bağlı olmakla birlikte ağdaki diğer büyük bileşenlerden ayrılmış iki düğümlü yapıdır.
Kaynak Şekil 2'de farklı yoğunluklarda gruplar ve birbirinden ayrılmış çiftler görülmektedir. Ağın tek bir bütün halinde her varlığı diğerine bağlamaması, öğrenilen temsilin ayırt edici bir ilişkisel yapı oluşturduğu şeklinde yorumlanmaktadır.
20 varlık arasında kaç olası çift bulunur?
20 varlığın her birinin diğer 19 varlıkla karşılaştırılabildiği düşünüldüğünde, her çiftin iki defa sayılmasını önlemek için toplam olası benzersiz çift sayısı:
\[ \binom{20}{2}=\frac{20(20-1)}{2}=190 \]
olarak hesaplanır.
Bu sayı kaynağın 20 varlıklı ve yönsüz ağ yapısından elde edilen basit kombinatorik sonuçtur; yeni bir deneysel bulgu değildir.
Çalışmada 190 olası benzersiz çiftin 64'ü eşik koşulunu karşılayarak aday ağda tutulmuştur.
Böylece keşif yöntemi bütün varlık çiftlerini doğrudan sonraki incelemeye almak yerine 64 adayla sınırlı bir ilişkisel yapı sunmaktadır.
Eşik değeri neden önemlidir?
Eşikleme, ağın ne kadar yoğun olacağını doğrudan etkileyen bir işlemdir.
Daha yüksek bir benzerlik eşiği kullanılması genellikle daha az bağlantının tutulmasına neden olur. Daha düşük eşik ise daha fazla varlık çiftinin aday ağ içinde yer almasına yol açabilir.
Ancak bu çalışmada farklı eşikler için ayrı ayrı hesaplanmış ağ sonuçları raporlanmamıştır. Dolayısıyla örneğin 0,85 veya 0,95 eşiklerinin kaç kenar üreteceği kaynaktan bilinmemektedir.
Kaynak, alternatif eşikleme stratejileri ve eşik taramalarının sonraki araştırmalarda değerlendirilmesini önermektedir.
Öğrenilen ağ neden kesin ilişki haritası değildir?
Ağın kenarları iki varlığın öğrenilmiş gizil temsilleri arasında yüksek yönsel benzerlik bulunduğunu gösterir.
Ancak bu özellik iki varlığın gerçek dünyada birbirini etkilediğinin, ortak bir temel nedene sahip olduğunun veya gelecekte birlikte hareket edeceğinin kesin kanıtı değildir.
Yazar, ağı doğrudan doğruya bir ilişkisel hipotez ağı (relational hypothesis graph) olarak konumlandırmaktadır. Bu kavram ağın ileri inceleme için aday ilişkiler önerdiğini, kesin nedensellik veya doğrulanmış ekonomik denge ilişkileri sunmadığını anlatır.
64 Aday İlişkiden Neden Yalnız 16'sı Eşbütünleşme Testini Karşıladı?
Çünkü çalışmanın gizil benzerlik ölçütü ile Engle–Granger eşbütünleşme testi farklı türde ilişkileri değerlendirmektedir. Gizil benzerlik, öğrenilmiş çok değişkenli zaman örüntülerinin yakınlığını ölçerken eşbütünleşme, belirli bütünleşme ve doğrusal uzun dönem ilişki varsayımları altında seriler arasında durağan bir doğrusal birleşim bulunup bulunmadığını inceler.
Eşbütünleşme nedir?
Eşbütünleşme (cointegration), durağan olmayan belirli zaman serilerinin uygun doğrusal birleşiminin durağan bir yapıya sahip olması durumudur.
Bu kavram özellikle zaman serileri arasında uzun dönemli denge ilişkilerini araştırmak için kullanılır.
İki serinin kısa vadede benzer yönlerde hareket etmesi eşbütünleşme için tek başına yeterli değildir. Benzer şekilde doğrusal korelasyonun düşük olması da bütün olası uzun dönem ilişkilerini dışlamaz.
Engle–Granger testi ne yapıyor?
Engle–Granger eşbütünleşme testi, uygun bütünleşme koşullarında iki zaman serisi arasında doğrusal uzun dönem ilişki bulunup bulunmadığını araştırmaya yönelik klasik ekonometrik yöntemlerden biridir.
Standart iki değişkenli yaklaşımda bir seri diğerinin doğrusal fonksiyonu olarak modellenir ve modelden kalan hata teriminin durağanlığı incelenir.
Öğretici biçimde:
\[ Y_t=\alpha+\beta X_t+\varepsilon_t \]
yazılabilir.
Burada \(Y_t\) ve \(X_t\) zaman serilerini, \(\alpha\) sabit terimi, \(\beta\) doğrusal ilişki katsayısını ve \(\varepsilon_t\) artık terimi temsil eder.
İlgili teorik koşullar sağlandığında artık terimin durağan olması, seriler arasında eşbütünleşmeye işaret edebilir.
Bu denklem standart Engle–Granger yönteminin öğretici gösterimidir. Kaynak makalede hangi varlık çiftine hangi sayısal \(\alpha\) ve \(\beta\) değerlerinin uygulandığı raporlanmamıştır.
Durağanlık nedir?
Durağanlık (stationarity), zaman serisinin belirli istatistiksel özelliklerinin zaman boyunca değişmemesiyle ilgili kavramdır.
Zayıf durağanlık bağlamında genellikle ortalamanın sabit olması, varyansın zamanla değişmemesi ve kovaryansın yalnız zaman noktaları arasındaki gecikmeye bağlı olması değerlendirilir.
Finansal fiyat düzeyleri çoğu zaman durağan olmayan süreçler olarak incelenir. Logaritmik getiriler bazı modelleme koşullarında daha durağan bir gösterim sağlayabilir.
Ancak getirilerin kullanılması, her kripto varlığın bütün incelenen dönemde matematiksel anlamda durağan olduğunun kesin olarak kanıtlandığı anlamına gelmez. Kaynak bütün varlıklar için ayrı durağanlık testi tabloları sunmamaktadır.
Kaynakta eşbütünleşme nasıl kullanılmış?
Çalışmada Engle–Granger testi, gizil ağ oluşturulduktan sonra uygulanmıştır.
Önce 0,90 eşikle 64 aday ilişki seçilmiş, daha sonra bu aday çiftler %95 güven düzeyinde eşbütünleşme testine tabi tutulmuştur.
Test sonucunda 16 aday çift ölçütü karşılamıştır.
Bu sonuç:
\[ \frac{16}{64}\times100=\%25 \]
oranına karşılık gelir.
Kalan 48 aday çift için eşbütünleşme koşulunun karşılanmadığı raporlanmıştır.
Kaynakta bütün 64 çiftin ayrı ayrı p-değerleri, test istatistikleri veya kullanılan regresyon katsayıları yayımlanmamıştır. Bu nedenle varlık bazında hangi çiftin hangi istatistiksel değerle testi geçtiği bu PDF'den yeniden hesaplanamaz.
48 çift başarısız keşif midir?
Hayır. Çalışmanın amacı eşbütünleşik çiftleri maksimum doğrulukla belirleyen bir sınıflandırıcı üretmek değildir.
Gizil ağ, farklı zaman örüntülerinin ortak yapısını keşfetmeye çalışmaktadır. Eşbütünleşme testi ise daha dar ve belirli matematiksel koşulları olan klasik bir ekonometrik ilişkiyi araştırmaktadır.
Bu nedenle testin karşılanmaması, gizil vektörler arasında yüksek benzerlik bulunmadığını göstermez.
Ayrıca 16 çiftin eşbütünleşme ölçütünü karşılaması, bu çiftlerin otomatik olarak kârlı yatırım fırsatı olduğu anlamına gelmez.
Bu sonuçlar bir yatırım stratejisi oluşturuyor mu?
Hayır. Araştırma alım-satım sinyali üretmemiş, işlem açma veya kapama kuralı tasarlamamış ve strateji getirisi hesaplamamıştır.
İşlem maliyeti, kayma (slippage), portföy getirisi, Sharpe oranı, maksimum düşüş veya gerçek yatırım kazancı gibi sonuçlar raporlanmamıştır.
Yazar, ilişki ağını daha sonraki alan odaklı araştırmaların kullanabileceği bir ön keşif yapısı olarak sunmaktadır.
İlişki ağının asıl avantajı nedir?
Çok sayıda varlıktan oluşan bir sistemde bütün olası çiftlerin ayrıntılı olarak tek tek incelenmesi önemli bir analiz yükü oluşturabilir.
Önerilen yaklaşım önce bütün varlıkları ortak gizil uzayda karşılaştırmakta, sonra yüksek benzerlik taşıyan ilişkileri ayırmaktadır.
Böylece daha ayrıntılı incelemeler için sınırlı bir aday listesi elde edilir.
Ancak burada önemli bir ayrım vardır: İlk benzerlik hesaplaması bütün çiftler üzerinde yapılmaktadır. Dolayısıyla yöntem başlangıçtaki bütün çiftli benzerlik hesaplamalarını ortadan kaldırmamaktadır. Daraltma, daha sonraki ayrıntılı inceleme aşamasında gerçekleşmektedir.
Zamansal kararlılık nasıl değerlendirilebilir?
Çalışma, keşfedilen bağlantıların farklı zaman aralıklarında tekrar ortaya çıkıp çıkmadığını incelemek için bir kararlılık değerlendirme protokolü önermektedir.
Bu yaklaşımda veri dönemi farklı zaman bloklarına ayrılarak aynı öğrenme ve ağ oluşturma işlemleri tekrar uygulanabilir.
Daha sonra ağlardaki ortak kenarlar karşılaştırılabilir.
Kaynak örnek olarak Jaccard benzerliği ve benzerlik matrisleri arasındaki sıra korelasyonunu önermektedir.
İki kenar kümesi için Jaccard benzerliğinin standart tanımı:
\[ J(A,B)=\frac{|A\cap B|}{|A\cup B|} \]
şeklindedir.
Burada \(A\) ve \(B\) farklı zaman bloklarında elde edilen kenar kümeleridir. \(A\cap B\) ortak kenarları, \(A\cup B\) en az bir ağda bulunan bütün benzersiz kenarları ifade eder.
Jaccard değeri 1 olduğunda iki küme aynıdır; 0 olduğunda ortak kenar bulunmamaktadır.
Bu formül makalede önerilen kararlılık değerlendirmesini öğretmek amacıyla verilmiştir. Kaynak bu araştırma için hesaplanmış belirli bir Jaccard değeri raporlamamıştır.
Çekirdek bağlantı kümesi nedir?
Yazar, farklı yeniden tahminlerde sürekli ortaya çıkan bağlantıların çekirdek kenarlar (core edges) olarak incelenebileceğini açıklamaktadır.
Örneğin belirli bir varlık çiftinin farklı zaman bloklarında tekrar tekrar yüksek benzerlik göstermesi, yalnız tek bir dönemde ortaya çıkan benzerlikten daha kararlı bir aday ilişkiye işaret edebilir.
Kaynak bunu araştırma protokolünün parçası olarak tanımlamaktadır. Ancak hangi 64 bağlantının kaç zaman bloğunda tekrarlandığına ilişkin eksiksiz bir süreklilik tablosu bulunmamaktadır.
Eşik duyarlılığı neden ayrıca test edilmeli?
0,90 eşiğiyle oluşturulan ağın belirli bir yapısı bulunmaktadır. Eşik değiştiğinde bağlantıların bir bölümü kaldırılabilir veya yenileri eklenebilir.
Bu nedenle en büyük bağlı bileşenin büyüklüğü, yoğun bağlantılı düğümlerin korunması veya güçlü kenarların devamlılığı gibi özellikler farklı eşiklerde incelenebilir.
Ancak kaynak farklı eşiklere ait ölçülmüş karşılaştırmalı sonuçları yayımlamamıştır. Çalışmanın sunduğu eşik duyarlılığı değerlendirmesi bir yöntem önerisidir; çoklu eşik deneylerinin tamamlandığı anlamına gelmez.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımı
Bu araştırma, denetimsiz öğrenmeyle elde edilen gizil temsillerin çok değişkenli zaman serilerinde ilişkisel keşif için kullanılıp kullanılamayacağını değerlendiren deneysel bir yöntem gösterimidir.
Araştırmanın temel işlem sırası şöyledir:
- Binance'den seçilmiş 20 kripto varlığın saatlik OHLC verileri alınmıştır.
- Fiyat serileri logaritmik getirilere dönüştürülmüştür.
- Çok değişkenli getiriler 30 zaman adımlı örtüşen pencerelere ayrılmıştır.
- Her pencerede özellikler bağımsız olarak normalize edilmiştir.
- Bütün varlıkların pencereleri ortak LSTM otoenkoderine verilmiştir.
- Otoenkoder ortalama karesel yeniden oluşturma hatasını azaltacak şekilde eğitilmiştir.
- Her pencere için 64 boyutlu gizil vektör üretilmiştir.
- Her varlığın pencere vektörleri ortalanarak varlık düzeyinde temsil oluşturulmuştur.
- 20 varlığın gizil vektörleri arasında kosinüs benzerlikleri hesaplanmıştır.
- 0,90 eşik değeriyle ağırlıklı ve yönsüz bir benzerlik ağı oluşturulmuştur.
- Ağdan 64 aday varlık ilişkisi elde edilmiştir.
- Bu 64 çift Engle–Granger testiyle sonradan değerlendirilmiş, 16 çift eşbütünleşme ölçütünü karşılamıştır.
Deneyin birinci sonucu: gizil benzerlik matrisi
Kaynak Şekil 1, 20 kripto varlığın birleştirilmiş gizil vektörleri üzerinden hesaplanan kosinüs benzerliği matrisini göstermektedir.
Matrisin renk dağılımında bütün varlık çiftlerinin aynı düzeyde benzer olmadığı görülmektedir.
Belirli varlık gruplarında yüksek gizil benzerlik bulunurken bazı çiftlerde daha düşük değerler mevcuttur. Bu sonuç araştırmacı tarafından ortak modelin bütün varlıkları tek bir genel piyasa temsiline indirgemediğinin göstergesi olarak yorumlanmaktadır.
Ancak kaynaktaki şekil 20×20 benzerlik değerlerinin tam sayısal tablosunu vermemektedir. Bu nedenle figürden kesin hücre değerleri çıkarılarak ayrı bir sonuç tablosu oluşturulmamıştır.
Deneyin ikinci sonucu: seyrek benzerlik ağı
Kaynak Şekil 2, 0,90 eşik değerinin uygulanmasıyla oluşan ağı göstermektedir.
Bu ağda 20 varlık ve 64 aday bağlantı bulunmaktadır.
Ağ birden fazla bağlı bileşene ayrılmaktadır. Bazı gruplarda yoğun bağlantılar bulunurken bazı varlıklar daha zayıf bağlantılı veya ayrılmış çiftler içinde yer almaktadır.
Bu farklılaşma, benzerlik yapısının bütün varlıklar üzerinde tekdüze olmadığına işaret etmektedir.
Kaynak ağın genel topolojik özelliklerini açıklamakla birlikte her düğümün kesin derece sayısını, bütün kenar ağırlıklarını ve tüm bağlantı listesini tablo olarak yayımlamamıştır.
Bu nedenle Verianla, kaynak Şekil 2'yi yeniden üretmek için tahmini kenar listesi veya uydurma varlık bağlantısı oluşturmamaktadır.
Deneyin üçüncü sonucu: klasik eşbütünleşme tanısı
64 aday çiftin Engle–Granger testiyle incelenmesi sonucunda 16 çiftin eşbütünleşme ölçütünü karşıladığı bildirilmiştir.
Bu bulgu, gizil benzerlik yönteminin klasik doğrusal uzun dönem ilişki tanımıyla örtüşen bazı çiftleri de ortaya çıkardığını göstermektedir.
Ancak yalnız 16 çiftin ölçütü karşılaması, yöntemin keşif performansının %25 olduğu anlamına gelmez. Çünkü eşbütünleşme bu araştırmanın eğitim hedefi veya kesin doğru etiket kümesi değildir.
Yazarın yaklaşımında klasik test, keşfedilen ilişkileri farklı bir istatistiksel açıdan yorumlama aracıdır.
Kaynakta ölçülmeyen başarı ölçütleri
Çalışmada bir sınıflandırma problemi tanımlanmadığı için doğruluk (accuracy), precision, recall veya F1-score gibi ölçütler raporlanmamıştır.
Herhangi bir fiyat tahmini yapılmadığından tahmin RMSE, MAE veya gelecekteki fiyat hareketlerini tahmin etme başarı oranı da verilmemiştir.
Ayrıca alternatif keşif yöntemleriyle aynı veri üzerinde sayısal karşılaştırma yapılmadığı için önerilen yaklaşımın diğer tüm yöntemlerden üstün olduğu sonucuna ulaşılamaz.
Yöntemin yorumlanabilirliği
Çalışma, yorumlanabilirliği öğrenilen 64 boyutlu vektörün her bileşenine doğrudan ekonomik anlam atayarak sağlamamaktadır.
Yorumlanabilirlik daha çok ağ düzeyinde ortaya çıkmaktadır.
Ağın hangi düğümleri birbirine bağladığı, hangi varlıkların aynı bileşende yer aldığı, hangi alt grupların daha yoğun olduğu ve hangi çiftlerin daha sonra istatistiksel incelemeye alınabileceği gözlenebilir hale gelmektedir.
Bu nedenle yaklaşım, gizil uzayı doğrudan açıklamaktan çok gizil uzayın ürettiği ilişkisel yapıyı analiz edilebilir bir nesneye dönüştürmektedir.
Yöntemin genel alanlara aktarılabilirliği
Yazar, önerilen yaklaşımın finansal verilere özgü matematiksel kurallara dayanmadığını belirtmektedir.
Aynı genel işlem zinciri farklı çok değişkenli zaman serilerinde kullanılabilecek biçimde tasarlanmıştır.
Örneğin biyolojik fenotipleme, malzeme bozulma analizi ve endüstriyel varlık izleme gibi alanlarda benzer zaman örüntülerine sahip sistemlerin keşfedilmesi için araştırma yapılabilir.
Ancak bu çalışma yalnız kripto para verileri üzerinde deneysel gösterim içermektedir. Biyolojik, endüstriyel veya malzeme verileri için ayrı performans sonuçları yayımlanmamıştır.
Türkiye'deki olası mühendislik kullanım alanları
Türkiye'deki endüstriyel tesislerde makinelerden sıcaklık, akım, titreşim, basınç ve enerji tüketimi gibi zaman serileri elde edilebilir.
Gizil yapısal benzerlik yaklaşımının bu tür verilerde araştırılması, benzer davranış sergileyen ekipmanların veya sensör gruplarının ön inceleme amacıyla belirlenmesine yardımcı olabilir.
Ancak böyle bir uyarlamada veri temizleme, sensörlerin eş zamanlılığı, örnekleme frekansı, pencere uzunluğu, normalizasyon, model eğitimi ve benzerlik eşiklerinin ilgili endüstriyel sistem için ayrıca doğrulanması gerekir.
Bu olası kullanım, makalenin Türkiye'deki sanayi tesislerinde gerçekleştirilmiş bir uygulaması değildir.
Araştırmanın güçlü yönleri
Çalışmanın ilk önemli yönü, gizil temsil öğrenimini doğrudan tahmin veya sınıflandırma amacı olmadan kullanmasıdır.
İkinci önemli yönü, çok değişkenli zaman pencerelerinin ortak bir öğrenme modeliyle temsil edilmesidir.
Üçüncü önemli yönü, öğrenilmiş temsillerin yalnız boyut indirgeme çıktısı olarak bırakılmaması ve varlıklar arasında ağ oluşturmak için kullanılmasıdır.
Dördüncü önemli yönü, klasik eşbütünleşme testinin nihai doğru etiketi olarak değil, farklı bir tanısal bakış açısı olarak değerlendirilmesidir.
Bu özellikler araştırmanın asıl katkısının bir yatırım algoritması değil, farklı alanlarda kullanılabilecek keşif katmanı tasarımı olduğunu göstermektedir.
Araştırmanın sınırlılıkları
Deneyler yalnız bir saatlik frekansta gerçekleştirilmiştir. Dakikalık, günlük veya haftalık veri çözünürlüklerinde aynı ağ yapısının oluşacağı gösterilmemiştir.
Benzerlik ağı tek bir 0,90 eşik değeriyle raporlanmıştır. Alternatif eşikleme yöntemleri karşılaştırılmamıştır.
Zamansal kararlılık ve eşik duyarlılığı için değerlendirme protokolü tanımlansa da farklı zaman blokları ve eşikler için ayrıntılı sayısal kararlılık sonuçları raporlanmamıştır.
Yöntem diğer temsil öğrenimi veya keşif yöntemleriyle aynı veri üzerinde karşılaştırılmamıştır.
Engle–Granger eşbütünleşmesi yalnız tek bir klasik tanısal değerlendirme aracıdır; bütün olası yapısal ilişki türlerini doğrulayan eksiksiz bir test değildir.
Çalışmada belirli bir yatırım veya operasyonel karar verme görevi bulunmamaktadır. Bu nedenle keşfedilen ağın herhangi bir karar sisteminin başarısını ne kadar artıracağı ölçülmemiştir.
Kaynakta bütün varlıkların tam sayısal gizil vektörleri, eksiksiz 20×20 benzerlik matrisi ve bütün 64 bağlantının ağırlıklarını içeren ayrı bir veri tablosu bulunmamaktadır.
Araştırmanın desteklediği sonuçlar
- Denetimsiz LSTM otoenkoderiyle çok değişkenli zaman serileri ortak gizil uzayda temsil edilebilmiştir.
- 20 kripto varlığın gizil benzerlikleri aynı düzeyde değil, farklılaşmış yapıda bulunmuştur.
- 0,90 kosinüs eşiğiyle 64 aday ilişki elde edilmiştir.
- Ağ yoğun alt gruplar ve farklı bağlı bileşenlerden oluşan bir topoloji göstermiştir.
- 64 adaydan 16'sı Engle–Granger eşbütünleşme ölçütünü karşılamıştır.
- Klasik eşbütünleşme ile gizil yapısal benzerliğin farklı kavramlar olduğu tartışılmıştır.
- Yöntem tahmin veya yatırım optimizasyonu olmadan ilişkisel keşif katmanı olarak sunulmuştur.
Araştırmanın desteklemediği genellemeler
- Modelin gelecekteki kripto fiyatlarını başarıyla tahmin ettiği gösterilmemiştir.
- Keşfedilen 64 ilişkinin tamamının ekonomik nedensellik taşıdığı kanıtlanmamıştır.
- 16 eşbütünleşik çiftin kârlı yatırım fırsatı olduğu sonucu çıkarılamaz.
- 48 çiftin otomatik olarak yanlış keşif olduğu söylenemez.
- Yöntemin bütün diğer keşif yöntemlerinden daha başarılı olduğu gösterilmemiştir.
- Farklı zaman frekanslarında aynı sonuçların elde edileceği doğrulanmamıştır.
- 0,90 dışındaki eşiklerde aynı topolojinin korunacağı kanıtlanmamıştır.
- Biyolojik veya endüstriyel veri kümelerinde ayrıca deney yapılmamıştır.
- Çalışmanın bütün keşfedilen ilişkiler için nedensellik veya doğrulanmış uzun dönem ekonomik denge bulduğu söylenemez.
Araştırmanın genel sonucu
Olusegun Owoeye'nin çalışması, çok değişkenli zaman serileri arasındaki ilişkilerin yalnız ham gözlemler üzerindeki sabit benzerlik ölçümleriyle incelenmek zorunda olmadığını göstermektedir.
Kayan zaman pencerelerinin LSTM otoenkoderiyle ortak gizil temsillere dönüştürülmesi ve bu temsillerden bir ilişkisel ağ oluşturulması, karmaşık veri kümelerinde aday benzerliklerin araştırılması için bir yöntem sunmaktadır.
Kripto para verilerinde elde edilen 64 aday ilişki ve bunların 16'sının klasik eşbütünleşme ölçütünü karşılaması, gizil temsillerin yalnız doğrusal uzun dönem denge ilişkilerine indirgenemeyen farklı zamansal davranışları da bir araya getirebildiğini düşündürmektedir.
Ancak bu bulgu, keşfedilen bütün ilişkilerin dış doğrulamasının tamamlandığı veya yöntemin tahmin ve alım-satım performansının kanıtlandığı anlamına gelmez.
Çalışmanın temel bilimsel katkısı, öğrenilmiş zaman serisi temsillerini bağımsız bir ilişkisel keşif katmanına dönüştürmesidir. Böylece farklı araştırma alanlarında daha ayrıntılı analizler için yapılandırılmış aday ilişki kümeleri oluşturulabilmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Latent Structural Similarity Networks for Unsupervised Discovery in Multivariate Time Series.
Yazar: Olusegun Owoeye.
Yazar sırası: Tek yazarlı çalışmadır.
Eş katkı: Tek yazarlı çalışma olduğundan uygulanabilir değildir.
Sorumlu yazar: PDF tek yazarın e-posta adresini vermektedir; ayrı corresponding-author işareti bulunmamaktadır.
Kurum: Independent Researcher; University of Cambridge (current affiliation).
Kurum açıklaması: Kaynak, araştırmacıyı bağımsız araştırmacı olarak tanımlamakta ve University of Cambridge'i güncel kurum bağlantısı şeklinde belirtmektedir. Bu kayıt Cambridge Üniversitesi'nin araştırmayı kurumsal olarak yürüttüğü veya finanse ettiği anlamına genişletilmemiştir.
ArXiv kimliği: arXiv:2601.18803.
İncelenen sürüm: arXiv:2601.18803v1.
Kaynakta gösterilen tarih: 15 Ocak 2026.
Bibliyografik tarih notu: ArXiv indeks ve güncelleme kayıtlarında 28 Ocak 2026 tarihi de görünmektedir. PDF üzerindeki tarih ile platforma ilişkin güncelleme tarihi birbirine karıştırılmamıştır.
DOI: 10.48550/arXiv.2601.18803.
Resmî kaynak: https://arxiv.org/abs/2601.18803
Yayın türü: ArXiv ön baskısı (preprint).
Hakemlik durumu: ArXiv kaydı kendi başına hakemlik kanıtı değildir. Bu incelemede ayrıca doğrulanmış bir hakemli dergi veya konferans sürümü tespit edilmemiştir.
Dergi / yayıncı: İncelenen sürüm için ayrı bir hakemli dergi, cilt veya sayı bilgisi doğrulanmamıştır.
Lisans: Kaynak arXiv dağıtım izni kapsamında erişilebilmektedir. Bu izin, üçüncü tarafların kaynak figür ve metinleri sınırsız yeniden kullanmasına yönelik genel bir Creative Commons lisansı olarak kabul edilmemiştir.
Bilimsel alan: Computer Science – Machine Learning (cs.LG).
Çalışma türü: Denetimsiz temsil öğrenimi ve ilişkisel ağ keşfi üzerine yöntem geliştirme ve gerçek veri gösterimi.
Veri kaynağı: Binance spot kripto para piyasası.
Varlık evreni: Piyasa değerine göre belirlenmiş 20 kripto varlık.
Kotasyon: USDT.
Veri dönemi: Nisan 2024 – Nisan 2025.
Örnekleme frekansı: 1 saat.
Girdi özellikleri: Open, High, Low, Close fiyatlarının logaritmik getiri gösterimleri.
Pencere uzunluğu: L = 30 zaman adımı.
Model: Sequence-to-Sequence LSTM Autoencoder.
Kodlayıcı: Gizli boyutu 256 olan iki LSTM katmanı ve 64 boyutlu gizil temsil üreten ReLU etkinleştirmeli yoğun katman.
Çözücü: Gizil vektörün projeksiyonu, dizi uzunluğu boyunca tekrarı, iki LSTM katmanı ve zaman dağıtımlı doğrusal çıkış katmanı.
Eğitim altyapısı: TensorFlow/Keras.
Optimizasyon: Adam.
Kayıp fonksiyonu: Mean Squared Reconstruction Error.
Mini-batch: 64.
Epoch: 20.
Varlık düzeyi gizil temsil: Her varlığın pencere temsillerinin ortalaması.
Benzerlik yöntemi: Cosine Similarity.
Eşik: 0,90.
Ağ yapısı: Ağırlıklı, yönsüz benzerlik grafiği.
Keşfedilen aday ilişki: 64 kenar.
İstatistiksel tanı: Engle–Granger Cointegration Test.
Test güven düzeyi: 0,95.
Eşbütünleşme ölçütünü karşılayan: 16 çift.
Yorum sınırı: Eşbütünleşme testi araştırmanın eğitim hedefi, kesin doğruluk etiketi veya yatırım performansı ölçüsü değildir. Yalnız sonradan uygulanan ekonometrik tanısal değerlendirmedir.
Şekil 1: 20 varlığın birleştirilmiş gizil temsilleri arasındaki kosinüs benzerliği matrisini göstermektedir.
Şekil 2: 0,90 eşikle oluşturulan gizil benzerlik ağını göstermektedir. Ağ farklı bağlı bileşenler, yoğun alt gruplar ve ayrılmış çiftler içermektedir.
Görsel yeniden inşa: Kaynakta ham 20×20 matris ve 64 kenarın bütün ağırlıkları yayımlanmadığından gerçek sonuçların sahte yeniden üretimi yapılmamıştır. Verianla yöntemin işlem ilişkilerini ve raporlanmış sayısal bulguları bağımsız SVG şemalarıyla göstermiştir.
Kararlılık değerlendirmesi: Zamansal bloklarda ağ tekrar oluşturma, Jaccard kenar benzerliği ve eşik duyarlılığı için yöntemsel protokol sunulmuştur. Bu kontroller için ayrıntılı sonuç tablosu yayımlanmamıştır.
Alternatif yöntem karşılaştırması: Kaynakta başka keşif sistemleriyle aynı veri üzerinde doğrudan performans benchmarkı yapılmamıştır.
Tahmin ve yatırım performansı: Araştırmada fiyat tahmini, yatırım optimizasyonu, alım-satım yürütmesi veya strateji kârlılığı ölçülmemiştir.
Veri erişilebilirliği: Veri kaynağı ve temel ön işleme yöntemi açıklanmıştır. Ancak bütün ham verileri, varlık seçim tarihçesini, gizil vektörleri ve tam benzerlik matrisini içeren ayrı bir resmî veri paketi PDF'de belirtilmemiştir.
Kod erişilebilirliği: Kaynak PDF'de yöntemin bütün eğitim ve ağ üretim kodunu sunan doğrulanabilir bir açık kod deposu bağlantısı bulunmamaktadır.
Finansman: PDF'de ayrı bir finansman beyanı tespit edilmemiştir.
Çıkar çatışması: PDF'de ayrı bir çıkar çatışması beyanı tespit edilmemiştir.
CRediT/yazar katkısı: Tek yazarlı çalışmada ayrı bir ayrıntılı katkı matrisi bulunmamaktadır.
Önceki araştırmayla ilişki: Yazar, yöntemin bazı bileşenlerinin daha geniş bir mülkiyete tabi araştırma çerçevesinden geliştirildiğini ve mevcut makalede alan özgü karar ve optimizasyon unsurları çıkarılarak bağımsız keşif katmanı şeklinde incelendiğini açıklamaktadır.
Türkiye bağlamı: Araştırma Türkiye'deki finansal varlıklar, endüstriyel tesisler veya biyolojik veri kümeleri üzerinde ayrı deney sunmamaktadır. Yerel uygulama alanları sonraki bilimsel doğrulama gerektirir.
Bilimsel sonuç sınırı: Yöntem, denetimsiz gizil temsil öğrenimiyle 20 kripto varlık arasında yapılandırılmış bir aday benzerlik ağı oluşturmuştur. Ancak ağ gerçek nedensellik ilişkilerinin, gelecekteki fiyat hareketlerinin veya doğrulanmış karar performansının kesin gösterimi değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir