


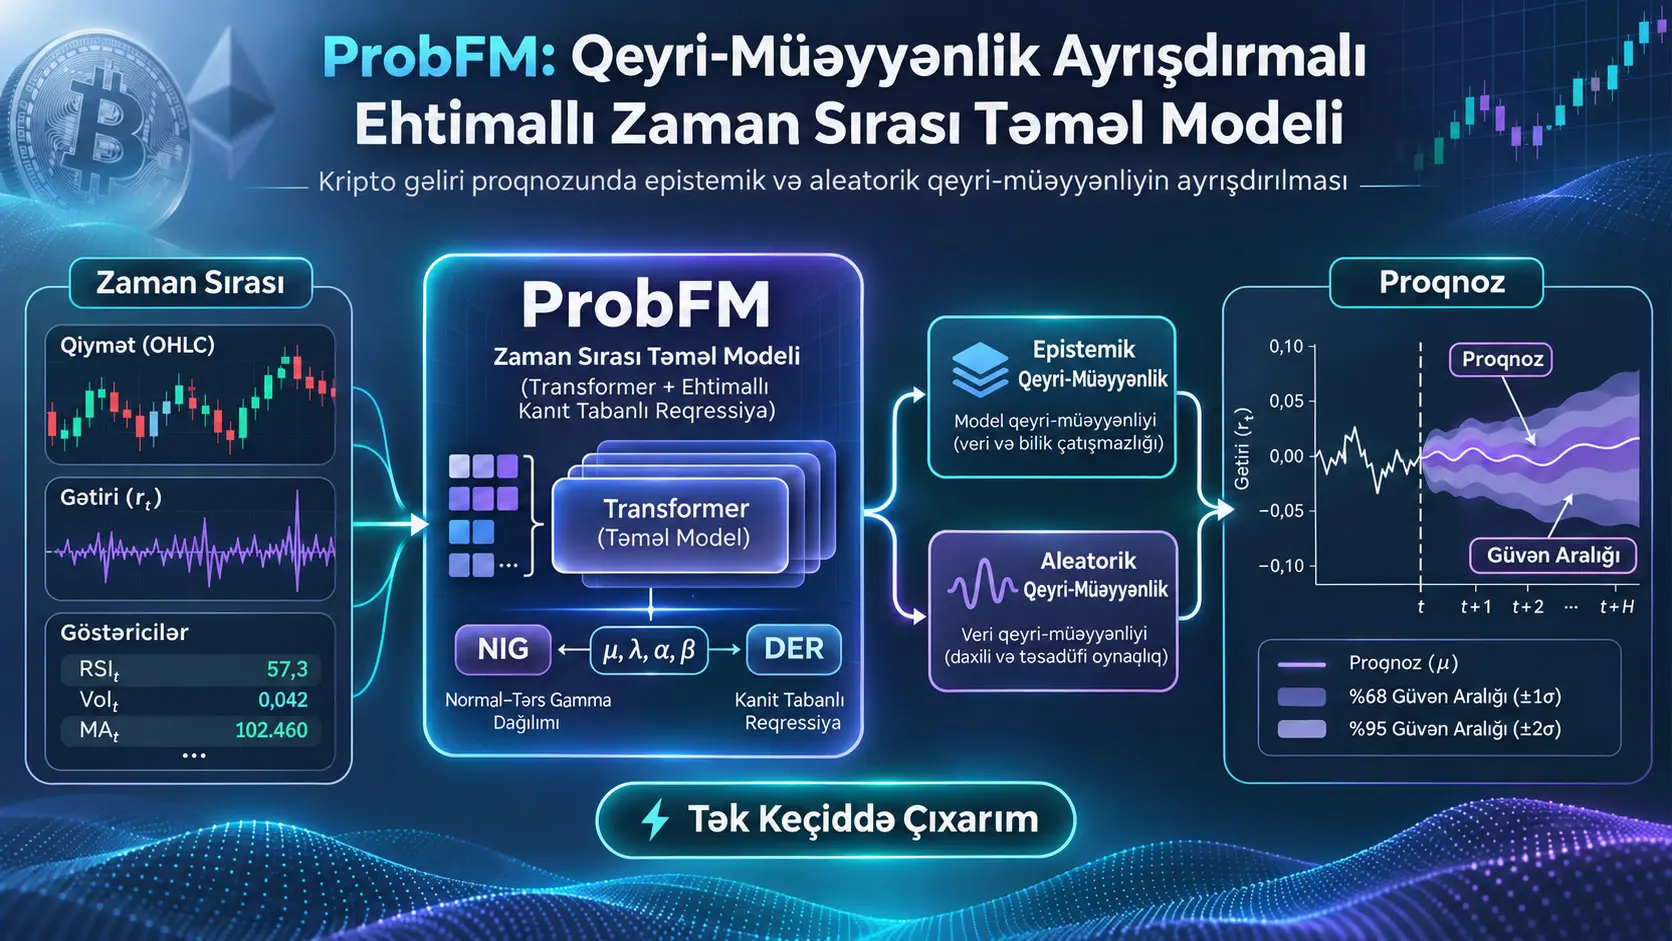
ProbFM (Probabilistic Foundation Model), zaman sırası proqnozlaşdırılmasında yalnız nöqtə proqnozu yaratmaq əvəzinə proqnoz qeyri-müəyyənliyini epistemik və aleatorik komponentlərə ayırmağı hədəfləyən, Deep Evidential Regression (DER) ilə Normal-Inverse-Gamma (NIG) paylanmasından istifadə edən ehtimallı zaman sırası çərçivəsidir. Tədqiqat bir tərəfdən adaptiv patching, Transformer onurğası, DER başlığı, coverage loss və evidence annealing daxil olan tam ProbFM arxitekturasını təsvir edir; digər tərəfdən qeyri-müəyyənlik metodunun töhfəsini arxitektura fərqlərindən ayırmaq məqsədilə bütün müqayisə metodlarını eyni 1 qatlı, 32 gizli ölçülü LSTM üzərində sınaqdan keçirir. Empirik qiymətləndirmə 1 Yanvar 2020–3 Oktyabr 2025 arasındakı ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT və XRP gündəlik loqarifmik gəlirlərindən istifadə edir.
DER-nin əsas məqsədi “model nə qədər səhv edir?” sualına əlavə olaraq “bu qeyri-müəyyənlik modelin kifayət qədər məlumata malik olmamasındanmı, yoxsa məlumatın təbiətcə səs-küylü olmasındanmı qaynaqlanır?” sualını ayırmaqdır. Tədqiqatda epistemik qeyri-müəyyənlik, model parametrləri haqqındakı qeyri-müəyyənliyi və prinsipcə daha çox məlumatla azaldıla bilən hissəni; aleatorik qeyri-müəyyənlik isə müşahidə prosesindəki və ya bazar məlumatındakı azaldılması mümkün olmayan səs-küyü təmsil edir. NIG quruluşu bu iki komponentin tək irəli keçiddə ayrı-ayrılıqda hesablanmasını təmin edir.
BTC üçün Evidential Regression “ProbFM core”, RMSE 0,045 və MAE 0,030 ilə digər modellərlə oxşar nöqtə proqnozu xətası göstərir. Bunun əksinə, %95 proqnoz intervallarında PICP cəmi 0,46-dır; yəni hədəflənən %95 əhatədən xeyli aşağı qalır. ProbFM core eyni BTC təcrübəsində illik Sharpe 1,33, Sortino 2,27, Calmar 3,04 və qazanma nisbəti 0,52 ilə mənbə cədvəlindəki güclü riskə uyğunlaşdırılmış ticarət nəticələrindən birini yaradır. Lakin ticarət simulyasiyasına komissiya, slippage və market impact daxil edilmədiyinə görə bu dəyərlər real bazar xalis gəliri və ya tətbiq edilə bilən investisiya performansı kimi şərh oluna bilməz.
Tədqiqatın mühüm metodoloji məhdudiyyəti dərc edilmiş müqayisəli təcrübələrin tam Transformer ProbFM arxitekturasını birbaşa benchmark etməməsidir. Təcrübələr DER qeyri-müəyyənlik mexanizmini təcrid etmək üçün eyni LSTM onurğasından istifadə edir. Buna görə tədqiqat DER əsaslı qeyri-müəyyənlik ayrışmasının nəzarətli LSTM mühitindəki davranışı üçün empirik dəlil təqdim etsə də, tam ProbFM Transformer arxitekturasının zero-shot və ya genişmiqyaslı foundation-model üstünlüyünü bu məlumat cədvəlləri ilə sübut etmir.
ProbFM Nədir və Bu Tədqiqatda Nə Etməyi Məqsəd Qoyur?
ProbFM, zaman sırası girişini emal edərək yalnız gələcək dəyərin mərkəzi proqnozunu deyil, proqnozu müşayiət edən epistemik və aleatorik qeyri-müəyyənlik komponentlərini də yaradan DER/NIG əsaslı ehtimallı model çərçivəsidir; təklif olunan tam arxitektura adaptiv patching, mövqe kodlaşdırması, Transformer təmsil öyrənməsi, NIG parametrlərini yaradan evidential başlıq, coverage-aware itki və tək-keçidli qeyri-müəyyənlik çıxarımından ibarətdir.
Tədqiqatın həll etməyə çalışdığı problem
Standart zaman sırası modelləri yalnız “sabahkı gəlir proqnozu nədir?” sualına fokuslana bilər. Maliyyə tətbiqlərində isə eyni proqnoz dəyərinin nə qədər etibarlı olduğu da vacibdir. Məsələn, iki modelin hər ikisi ertəsi gün üçün %1 müsbət gəlir proqnozlaşdıra bilər; lakin modellərdən biri çox güclü məlumat dəstəyinə malik olduğu halda digəri əvvəllər görmədiyi bazar rejimində işləyir ola bilər.
Tədqiqat bu səbəbdən ümumi proqnoz qeyri-müəyyənliyini iki fərqli mənbəyə ayırır. Epistemik qeyri-müəyyənlik model biliklərindəki çatışmazlığı, aleatorik qeyri-müəyyənlik isə məlumat yaratma prosesinin öz səs-küyünü təmsil edir. Bu ayrım xüsusilə risk idarəetməsində vacibdir; çünki “daha çox məlumat toplamaq” epistemik qeyri-müəyyənliyi azalda bildiyi halda real bazar təsadüfiliyini təmsil edən aleatorik qeyri-müəyyənliyi aradan qaldırmır.
Epistemik və Aleatorik Qeyri-Müəyyənlik Arasındakı Fərq Nədir?
Epistemik qeyri-müəyyənlik modelin bilmədiyi və ya kifayət qədər öyrənmədiyi hissədən yaranan və uyğun yeni məlumatla azaldıla bilən model qeyri-müəyyənliyidir; aleatorik qeyri-müəyyənlik isə məlumat yaratma prosesindəki daxili səs-küy və təsadüfiliyi təmsil edir və yalnız daha çox məlumat əlavə etməklə mütləq aradan qalxmır. ProbFM bu iki komponenti NIG posteriorundan ayrı riyazi kəmiyyətlər kimi çıxarır.
Normal-Inverse-Gamma quruluşu
Tək dəyişənli və tək addımlı zaman sırası problemi üçün məlumat dəsti:
\[ \mathcal{D}=\{(x_i,y_i)\}_{i=1}^{N} \]
kimi müəyyən edilir. \(x_i\in\mathbb{R}^{T}\), uzunluğu \(T\) olan keçmiş zaman pəncərəsini; \(y_i\in\mathbb{R}\) isə bir-addım irəli hədəfi təmsil edir.
Ənənəvi ehtimallı yanaşma birbaşa:
\[ f_\theta:x\rightarrow p(y\mid x) \]
uyğunluğunu öyrənərkən DER:
\[ f_\theta:x\rightarrow p(\phi\mid x) \]
uyğunluğunu öyrənir. Buradakı \(\phi\), proqnoz paylanmasının parametrləridir. Beləliklə şəbəkə yalnız paylanma parametrlərini proqnozlaşdırmaq əvəzinə bu parametrlərin özləri haqqındakı dəlil və qeyri-müəyyənliyi təmsil etməyə çalışır.
Tənlik (1): NIG prior
\[ p(\mu,\sigma^2)=\operatorname{NIG}(\mu,\lambda,\alpha,\beta) \tag{1} \]
Bu ifadə Gaussian paylanmasının ortalaması və variasiyası haqqındakı qeyri-müəyyənliyin Normal-Inverse-Gamma ailəsi ilə təmsil edildiyini bildirir. \(\mu\) mərkəzi proqnozla, \(\lambda\) orta parametrin dəqiqliyi ilə, \(\alpha\) və \(\beta\) isə inverse-gamma variasiya komponenti ilə əlaqəlidir.
Tənlik (2) və (3): NIG ayrışması
\[ p(\mu\mid\sigma^2) = \mathcal{N}\left(\mu,\frac{\sigma^2}{\lambda}\right) \tag{2} \]
\[ p(\sigma^2) = \operatorname{Inverse\mbox{-}Gamma}(\alpha,\beta) \tag{3} \]
Birinci tənlik orta parametr üzərindəki Gaussian şərti paylanmanı, ikinci tənlik isə variasiya haqqındakı inverse-gamma paylanmasını təmsil edir. \(\lambda\) böyüdükdə orta parametrə aid variasiya azalır; başqa sözlə modelin orta haqqındakı epistemik qeyri-müəyyənliyi azala bilər.
Tənlik (4): proqnozlaşdırılan orta
\[ \mathbb{E}[y\mid x]=\mu \tag{4} \]
Modelin tək nöqtə proqnozu \(\mu\)-dur.
Tənlik (5): aleatorik qeyri-müəyyənlik
\[ U_{\text{aleatoric}} = \mathbb{E}[\sigma^2\mid x] = \frac{\beta}{\alpha-1} \tag{5} \]
Bu kəmiyyət məlumat səs-küyünə aid edilən qeyri-müəyyənlik komponentidir. Formulun sonlu olması üçün \(\alpha>1\) tələb olunur. \(\beta\) digər dəyişənlər sabit olduqda artdıqca aleatorik variasiya artır; \(\alpha\) böyüdükdə azalır.
Tənlik (6): epistemik qeyri-müəyyənlik
\[ U_{\text{epistemic}} = \operatorname{Var}[\mu\mid x] = \frac{\beta}{(\alpha-1)\lambda} \tag{6} \]
Aleatorik termindən fərqli olaraq epistemik qeyri-müəyyənlikdə əlavə olaraq \(\lambda\) mövcuddur. \(\lambda\) böyüdükcə modelin orta proqnozu haqqındakı epistemik qeyri-müəyyənlik azalır.
Çox üfüqlü proqnoza genişləndirmə
Mənbə NIG quruluşunun tək dəyişənli və tək-addımlı proqnoz üçün istifadə edildiyini; gələcəkdə çox üfüqlü və ya çox dəyişənli proqnozda Normal-Inverse-Wishart (NIW) prior istifadə edilə biləcəyini bildirir. Bu genişləndirmə tədqiqatda tətbiq edilmiş empirik nəticə deyil; gələcək arxitektura istiqaməti kimi təqdim olunur.
Adaptiv patching niyə istifadə olunur?
ProbFM-nin təklif olunan Transformer arxitekturası uzun zaman sırasını ayrı-ayrı zaman nöqtələri əvəzinə “patch” adlanan hissələrə ayırır. Mənbənin tezliyə əsaslanan patch ölçüsü uyğunluğu belədir:
| Zaman sırasının tezliyi | Təklif olunan patch ölçüsü |
|---|---|
| İllik / rüblük | 8 |
| Aylıq | 8, 16, 32 |
| Həftəlik / gündəlik | 16, 32 |
| Saatlıq | 32, 64 |
| Dəqiqə səviyyəsi | 32, 64, 128 |
| Saniyə səviyyəsi | 64, 128 |
Mənbənin məqsədi müxtəlif zaman çözünürlüklərində eyni temporal qranulyarlığın məcburi istifadəsinin qarşısını almaqdır. Bununla belə, bu patch seçimlərinin hər birinin ayrıca ablasiya nəticəsi tədqiqatda verilmir.
Tənlik (8) və (9): patch və embedding
\[ X_{\text{patches}} = \operatorname{Patching}(X_{\text{raw}},\text{patch\_size}) \tag{8} \]
\[ X_{\text{encoded}} = \operatorname{LinearProjection}(X_{\text{patches}}) + \operatorname{PositionalEncoding} \tag{9} \]
Birinci addım xam zaman sırasını patch-lərə ayırır. İkinci addım patch-ləri Transformer-in istifadə edə biləcəyi embedding fəzasına proyeksiya edir və zaman ardıcıllığının itirilməməsi üçün mövqe kodu əlavə edir.
Tənlik (10): sinusoidal mövqe kodlaşdırması
\[ PE_{(t,d)} = \begin{cases} \sin\left(t/10000^{d/d_{\text{model}}}\right), & d\text{ çift ise}\\ \cos\left(t/10000^{d/d_{\text{model}}}\right), & d\text{ tek ise} \end{cases} \tag{10} \]
\(t\) sıralamadakı zaman mövqeyini, \(d\) embedding ölçüsü indeksini, \(d_{\text{model}}\) isə ümumi embedding ölçüsünü bildirir. Sinus və kosinus tezliklərinin ölçüyə görə dəyişməsi Transformer-in sıradakı nisbi və mütləq mövqe əlaqələrindən istifadə etməsini təmin edir.
Tənlik (11): Multi-Head Attention-ın əsas attention əməliyyatı
\[ \operatorname{Attention}(Q,K,V) = \operatorname{softmax} \left( \frac{QK^{T}}{\sqrt{d_k}} \right)V \tag{11} \]
\(Q\) sorğu, \(K\) açar və \(V\) dəyər matrislərini təmsil edir. \(QK^T\), müxtəlif zaman-patch təmsillərinin bir-birinə nə qədər diqqət yetirməli olduğunu ölçən oxşarlıq skorlarını yaradır. \(\sqrt{d_k}\) miqyaslama termini ölçü böyüdükdə daxili hasillərin həddindən artıq böyüməsini məhdudlaşdırmağa kömək edir.
Tənlik (12): feed-forward şəbəkə
\[ \operatorname{FFN}(x) = \operatorname{SwiGLU}(W_1x+b_1) \tag{12} \]
SwiGLU, Transformer bloklarındakı qeyri-xətti çevrilmə qatında istifadə olunan qapılı aktivasiya ailəsidir.
DER başlığı NIG parametrlərini necə yaradır?
\[ \mu=W_\mu h+b_\mu \tag{13} \]
\[ \lambda= \operatorname{Softplus}(W_\lambda h+b_\lambda)+\epsilon \tag{14} \]
\[ \alpha= \operatorname{Softplus}(W_\alpha h+b_\alpha)+1+\epsilon \tag{15} \]
\[ \beta= \operatorname{Softplus}(W_\beta h+b_\beta)+\epsilon \tag{16} \]
\(h\), Transformer-in son təmsilidir. \(\mu\) həqiqi ədəd ola bilər; \(\lambda\) və \(\beta\) müsbət, \(\alpha\) isə 1-dən böyük olmalıdır. Softplus çevrilməsi bu sahə məhdudiyyətlərini şəbəkə çıxışına tətbiq edir. \(\epsilon\), tam sıfır dəyər səbəbindən yarana biləcək etibarsız parametrlərin qarşısını alan kiçik müsbət sabitdir; mənbə bu sabitin ədədi dəyərini əsas arxitektura bölməsində vermir.
Evidential loss necə işləyir?
Mənbənin əsas evidential itki funksiyası:
\[ \mathcal{L}_{EDL} = \mathcal{L}_{NLL} + \lambda_{\text{evd}}\mathcal{L}_{reg} \tag{17} \]
şəklindədir. \(\mathcal{L}_{NLL}\), proqnozlaşdırılan ehtimal paylanmasının həqiqi hədəfə nə qədər uyğun olduğunu; \(\mathcal{L}_{reg}\) isə səhv proqnoz verərkən həddindən artıq yüksək dəlil/özünəinam yaradılmasını cəzalandırır. \(\lambda_{\text{evd}}\), iki komponentin nisbi çəkisini müəyyən edir. Nəzarətli təcrübə konfiqurasiyasında \(\lambda_{\text{evd}}=0,1\) bildirilir.
Tənlik (18): NIG mənfi log-likelihood
\[ \begin{aligned} \mathcal{L}_{NLL} ={}& \frac{1}{2}\log\left(\frac{\pi}{\lambda}\right) -\alpha\log(\Omega)\\ &+ \left(\alpha+\frac{1}{2}\right) \log\left( \frac{(y-\mu)^2}{\lambda}+\Omega \right)\\ &+ \log\left( \frac{\Gamma(\alpha)} {\Gamma\left(\alpha+\frac{1}{2}\right)} \right), \end{aligned} \tag{18} \]
\[ \Omega=2\beta(1+\lambda) \]
Bu tənlik NIG quruluşunun marjinal Student-t proqnoz paylanmasından törəyən likelihood xərcidir. Proqnoz hədəfdən uzaqlaşdıqda \((y-\mu)^2\) termini böyüyür və itki artır. Eyni zamanda paylanmanın qeyri-müəyyənlik parametrləri də itkini müəyyən edir.
Tənlik (19): evidential regularization
\[ \mathcal{L}_{reg} = |\hat{y}-y|\cdot(\alpha+\nu-2) \tag{19} \]
Bu termin xəta yüksək olduqda modelin həddindən artıq yüksək dəlil yaratmasını cəzalandırmaq üçün istifadə olunur. Lakin mənbə burada əvvəlki NIG tənliklərindəki \(\lambda\) əvəzinə \(\nu\) simvolundan istifadə edir. Appendix C-də də DER parametrləri \((\gamma,\nu,\alpha,\beta)\) formasında verildiyi halda arxitektura bölməsində \((\mu,\lambda,\alpha,\beta)\) istifadə olunur. Mənbə bu iki notasiya arasındakı uyğunluğu açıq şəkildə müəyyən etmir; buna görə Verianla simvolları səssizcə bir-birinin yerinə qoymur.
Coverage loss nəyi məqsəd qoyur?
\[ \mathcal{L}_{coverage} = |\operatorname{PICP}_{target} - \operatorname{PICP}_{actual}| \tag{20} \]
Burada məqsəd faktiki əhatə nisbətini hədəf əhatə nisbətinə yaxınlaşdırmaqdır. Məsələn, %95 proqnoz intervalı hədəflənirsə:
\[ \operatorname{PICP}_{target}=0.95 \]
olur.
Faktiki PICP:
\[ \operatorname{PICP}_{actual} = \frac{1}{N} \sum_{i=1}^{N} \mathbb{I} \left( y_i\in [CI_{\text{lower},i},CI_{\text{upper},i}] \right) \tag{21} \]
kimi hesablanır. Göstərici funksiyası həqiqi hədəf intervalın içindədirsə 1, deyiləsə 0 yaradır. Bu dəyərlərin ortalaması proqnoz intervallarının həqiqi hədəfləri əhatə etmə nisbətidir.
Mühüm şərh sərhədi budur: loss funksiyasına coverage termini əlavə etmək test dəstində avtomatik olaraq %95 coverage əldə ediləcəyinə zəmanət vermir. Belə ki, BTC üçün mənbə Cədvəl 3-də ProbFM core PICP cəmi 0,46-dır.
Birləşdirilmiş itki
\[ \mathcal{L}_{ProbFM} = \mathcal{L}_{EDL} + \lambda_{coverage}\mathcal{L}_{coverage} + \lambda_{wd}\|\theta\|_2^2 \tag{22} \]
Birinci termin evidential proqnoz, ikinci termin proqnoz intervalı coverage hədəfi, üçüncü termin isə L2 çəki requlyarizasiyasıdır. Mənbə \(\lambda_{coverage}\)-ın sabit saxlandığını bildirir, lakin nəzarətli təcrübə üçün ədədi dəyərini vermir.
Optimizer və gradient clipping
Mənbə əsas ProbFM təlim bölməsində AdamW istifadə etdiyini bildirir və yenilənməni:
\[ \theta_{t+1} = \theta_t - \eta\cdot \operatorname{clip} (\nabla_\theta\mathcal{L},\operatorname{max\_norm}) \tag{23} \]
şəklində göstərir. Bu tənlik clipping məntiqini ön plana çıxaran sadələşdirilmiş yeniləmə ifadəsidir. Mənbə max norm üçün ümumi olaraq 1,0–5,0 aralığını bildirir; nəzarətli LSTM təcrübəsinin Appendix C konfiqurasiyasında isə max norm 1,0-dır.
Appendix C həmçinin nəzarətli təcrübələrdə optimizer-i Adam kimi verir. Əsas arxitektura bölməsində AdamW yazıldığına görə iki məlumat müxtəlif təcrübə kontekstlərinə aid ola bilər; lakin mənbə bu ayrımı açıq uyğunluq cədvəli ilə izah etmir.
Tənlik (24): cosine annealing qeydi
Mənbə öyrənmə sürəti cədvəlini:
\[ \eta_t = \eta_{\text{base}} \cos\left( \frac{\pi t}{T_{\text{total}}} \right) \operatorname{warmup}(t) \tag{24} \]
kimi yazır. Bu formul yazıldığı formada \(t>T_{\text{total}}/2\) olduqda kosinus termininin mənfi olmasına imkan verir. Mənbə bunun yalnız sxematik göstərim, yoxsa real kodda istifadə olunan schedule olduğunu açıqlamır. Buna görə Verianla standart cosine schedule formulunu mənbənin yerinə qoyaraq səssiz düzəliş etmir.
Tənlik (25): evidence annealing
\[ \operatorname{evidence\_scale}(t) = \min\left(1.0,\frac{t}{T_{\text{anneal}}}\right) \tag{25} \]
Bu faktor təlimin əvvəlində 0-dan başlayıb \(T_{\text{anneal}}\) addımında 1-ə çatır. Mənbə tipik olaraq ümumi təlimin %10–20-si boyunca artırıldığını bildirir. Məqsəd şəbəkə təmsil öyrənmədən əvvəl həddindən artıq özünəinamlı evidential parametrlər yaratmasını məhdudlaşdırmaqdır.
Tək keçiddə çıxarım
Proqnoz zamanı DER başlığı dörd NIG parametrini tək forward pass ilə yaradır. Mənbənin nöqtə proqnozu:
\[ \hat{y}=\mu \tag{26} \]
Ümumi proqnoz variasiyası:
\[ \operatorname{Var}[y\mid x] = \frac{\beta}{\alpha-1} \left( 1+\frac{1}{\lambda} \right) \tag{27} \]
Epistemik qeyri-müəyyənlik:
\[ U_{\text{epistemic}} = \frac{\beta}{(\alpha-1)\lambda} \tag{28} \]
Aleatorik qeyri-müəyyənlik:
\[ U_{\text{aleatoric}} = \frac{\beta}{\alpha-1} \tag{29} \]
kimi verilir.
Tənlik (27) açıq şəkildə Tənlik (28) və (29)-un cəmidir:
\[ \operatorname{Var}[y\mid x] = U_{\text{aleatoric}} + U_{\text{epistemic}} \]
Bu son bərabərlik mənbə tənliklərinin birbaşa cəbri nəticəsidir; yeni eksperimental nəticə deyil.
Proqnoz intervalı
Mənbə posterior predictive paylanmanın Student-t olduğunu bildirərək:
\[ CI_{1-\alpha} = \hat{y} \pm t_{2\alpha,\alpha/2} \sqrt{ \frac{\beta(\lambda+1)} {\alpha\lambda} } \tag{30} \]
ifadəsini verir və Student-t sərbəstlik dərəcəsini \(2\alpha\) kimi müəyyən edir.
Notasiya xəbərdarlığı: Eyni bölmədə \(\alpha\) həm NIG paylanmasının shape parametri, həm də \(1-\alpha\) etibar səviyyəsi göstərimində istifadə edilmiş görünür. Buna görə Tənlik (30)-da simvolun mənası kontekstdən asılı olaraq qeyri-müəyyənləşir. Verianla mənbə tənliyini dəyişmədən bu simvol toqquşmasını görünən saxlayır.
CRPS nədir?
Continuous Ranked Probability Score (CRPS), yalnız nöqtə proqnozunu deyil, bütün proqnoz paylanmasını həqiqi müşahidə ilə müqayisə edən ehtimallı proqnoz metrikidir. Daha aşağı CRPS mənbədə daha yaxşı kimi şərh olunur.
Gaussian proqnoz üçün mənbə:
\[ CRPS = \sigma \left[ z(2\Phi(z)-1) + 2\phi(z) - \frac{1}{\sqrt{\pi}} \right] \tag{31} \]
formulundan istifadə edir və:
\[ z=\frac{y-\mu}{\sigma} \]
tərifini verir. \(\Phi\), standart normal paylanmanın kumulyativ paylanma funksiyası; \(\phi\) isə ehtimal sıxlıq funksiyasıdır.
PICP, sharpness və uncertainty-error correlation birlikdə necə oxunmalıdır?
PICP, həqiqi müşahidələrin proqnoz intervalının içində qalma nisbətidir. %95 interval üçün yaxşı kalibrasiyada PICP-nin 0,95 ətrafında olması gözlənilir.
Sharpness, proqnoz intervalının orta enidir. Daha dar interval təkbaşına daha yaxşı deyil; interval həddindən artıq dar olduğuna görə həqiqi dəyərləri kənarda qoyursa model həddindən artıq özünəinamlı ola bilər.
Uncertainty-Error Correlation, proqnozlaşdırılan qeyri-müəyyənliyin həqiqi proqnoz xətası ilə Pearson korrelyasiyasıdır. Müsbət dəyər modelin çətin nümunələrə daha yüksək qeyri-müəyyənlik vermə meylinə işarə edir. Sıfıra yaxın və ya mənfi dəyər bu əlaqəni dəstəkləmir.
ProbFM-nin %95 Proqnoz Intervalları Həqiqətən Yaxşı Kalibrə Edilibmi?
Mənbə nəticələrinə görə bütün aktivlər üçün xeyr: ProbFM core %95 hədəfli intervallarda BTC-də PICP 0,46, ADA-da 0,31, SOL-da 0,39 və XRP-də 0,36 yaradarkən DOGE və ETH-də 1,00-a çatır; bu geniş dəyişkənlik coverage loss əlavə edilmiş olmasına baxmayaraq araşdırılan testlərdə kalibrasiyanın aktivlər arasında ardıcıl şəkildə %95 hədəfinə uyğun gəlmədiyini göstərir.
| Aktiv | CRPS | PICP (%95 hədəf) | Sharpness | Qeyri-Müəyyənlik-Xəta Korrelyasiyası |
|---|---|---|---|---|
| BTC | 2,65 | 0,46 | 3,90 | 0,00 |
| ADA | 3,39 | 0,31 | 3,32 | 0,09 |
| BNB | 1,30 | 0,68 | 3,63 | −0,12 |
| DASH | 1,57 | 0,59 | 3,49 | 0,04 |
| DOGE | 0,25 | 1,00 | 3,77 | 0,18 |
| ETH | 0,29 | 1,00 | 4,17 | 0,22 |
| LTC | 2,69 | 0,46 | 3,56 | 0,03 |
| SOL | 2,96 | 0,39 | 3,85 | −0,14 |
| USDC | 2,32 | 0,78 | 7,44 | −0,04 |
| USDT | 2,54 | 0,45 | 3,56 | −0,01 |
| XRP | 2,90 | 0,36 | 3,25 | −0,03 |
Bu cədvəl mühüm bir fərqi göstərir: ProbFM core əksər aktivlərdə Gaussian NLL və Student-t NLL-dən daha dar proqnoz intervalları yaradır, lakin dar intervallar əksər aktivlərdə nominal %95 əhatəyə çatmır. DOGE və ETH-də isə PICP 1,00-dır. Buna görə yalnız sharpness-a baxaraq “daha yaxşı qeyri-müəyyənlik proqnozu” nəticəsi çıxarmaq olmaz; coverage ilə birlikdə qiymətləndirilməlidir.
Tədqiqatın Metodu və Nəticələri
Məlumat dəsti
Tədqiqat Stooq üzərindən endirilmiş 11 likvid kripto aktivin gündəlik qiymət məlumatından istifadə edir:
ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT və XRP.
Zaman aralığı 1 Yanvar 2020–3 Oktyabr 2025-dir. Hər aktiv eyni başlanğıc tarixinədək uzanmadığı üçün məlumat uzunluqları aktivin mövcudluğundan asılıdır.
Gündəlik loqarifmik gəlir:
\[ r_t = \log\left( \frac{P_t}{P_{t-1}} \right) \]
ilə hesablanır. \(P_t\) cari günün, \(P_{t-1}\) əvvəlki günün bağlanış qiymətidir. Loqarifmik gəlir qiymət nisbətini toplanan zaman-sırası formasına çevirir.
Təlim, doğrulama və test ayrımı
| Element | Mənbədə bildirilən dəyər |
|---|---|
| Əsas təcrübə onurğası | 1 qatlı LSTM |
| Gizli ölçü | 32 |
| Dropout | 0,1 |
| Lookback | 50 zaman addımı |
| Train/validation dövrü | 2023 sonuna qədər |
| Test dövrü | 2024 və sonrası |
| Validation | Training məlumatının %20-si; simvol üzrə zaman sırası qorunaraq |
| Outlier truncation | Hər simvolda təlim məlumatından hesablanan 1. və 99. percentillər |
| Standartlaşdırma | Simvol üzrə; təlim ortalaması 0, standart sapması 1 olacaq şəkildə |
| Nəzarətli təcrübə optimizer-i | Adam |
| Learning rate | 0,001 |
| Batch size | 128 |
| Maksimum epoch | 50 |
| Early stopping patience | 10 epoch |
| Gradient clipping | max norm 1,0 |
| Weight decay | 0,001 |
| DER requlyarizasiya çəkisi | \(\lambda_{\text{evd}}=0,1\) |
| Random seed | 0 |
| Framework | PyTorch |
| Model seçimi | Ən yaxşı validation loss checkpoint-i |
Müqayisə edilən metodlar
| Metod | Ehtimallıdırmı? | Əsas çıxış məntiqi |
|---|---|---|
| MSE | Xeyr | Tək orta proqnozu |
| Huber | Xeyr | Robust tək nöqtə proqnozu |
| Gaussian NLL | Bəli | Orta + variasiya |
| Student-t NLL | Bəli | Orta + miqyas + sərbəstlik dərəcəsi |
| Quantile Loss | Bəli | Birdən çox quantile |
| Adaptive Conformal | Bəli | MSE proqnozu + kalibrasiya dəsti ilə interval |
| Deep Evidential Regression | Bəli | NIG parametrləri və epistemik/aleatorik ayrışma |
BTC nöqtə proqnozu performansı
| Metod | RMSE | MAE | Pearson korrelyasiyası |
|---|---|---|---|
| MSE | 0,044 | 0,030 | −0,309 |
| Huber | 0,044 | 0,029 | −0,394 |
| Gaussian NLL | 0,044 | 0,029 | −0,192 |
| Student-t NLL | 0,045 | 0,030 | −0,529 |
| Quantile Loss | 0,044 | 0,029 | −0,395 |
| Adaptive Conformal | 0,044 | 0,030 | −0,314 |
| DER / ProbFM core | 0,045 | 0,030 | −0,536 |
RMSE və MAE baxımından metodlar bir-birinə olduqca yaxındır. DER/ProbFM core-un ən yaxşı nöqtə proqnozu metodu olduğu deyilə bilməz; RMSE-si 0,045 ilə bəzi metodların 0,044 dəyərindən bir qədər yüksəkdir. Mənbənin düzgün iddiası nöqtə proqnozu dəqiqliyinin “rəqabətli/comparable” olmasıdır.
Daha diqqətçəkən məqam BTC-də bildirilən bütün Pearson korrelyasiyalarının mənfi olmasıdır. DER/ProbFM core üçün korrelyasiya −0,536-dır. Bu nəticə proqnozlaşdırılan və reallaşan gündəlik gəlirlərin xətti istiqamət uyğunluğunun BTC testində güclü müsbət olmadığını aydın göstərir. Bununla belə, mənbə ticarət strategiyası performansında fərqli istiqamət və qeyri-müəyyənlik filtri əsaslı qiymətləndirmədən istifadə edir; iki metriki bir-birinin yerinə qoymaq olmaz.
Mənbə Şəkil 2 nə göstərir?
Mənbə Şəkil 2 DER-nin proqnozlaşdırdığı gündəlik gəlirlərin paylanmasını həqiqi test gəlirləri ilə ADA, BNB, BTC, DASH, DOGE, ETH, LTC, SOL, USDC, USDT və XRP üçün yanaşı göstərir. Müəlliflər xüsusilə daha volatil kripto aktivlərdə proqnozlaşdırılan gəlir paylanmalarının həqiqi gəlirlərdən nəzərəçarpacaq dərəcədə daha geniş olduğunu bildirirlər.
Şəklin histogram xam məlumatları PDF daxilində cədvəl kimi verilmədiyi üçün Verianla dəqiq histogram sütun hündürlüklərini yenidən yaratmır. Mənbədə dəstəklənən elmi mesaj mətn şəklində qorunur.
BTC ehtimallı metrikləri
| Metod | CRPS | PICP (%95) | Sharpness | Qeyri-Müəyyənlik-Xəta Korrelyasiyası |
|---|---|---|---|---|
| Gaussian NLL | 2,21 | 0,95 | 15,22 | 0,12 |
| Student-t NLL | 3,17 | 0,95 | 15,48 | 0,11 |
| Quantile Loss | NA | 0,75 | 7,92 | 0,17 |
| Adaptive Conformal | 2,26 | 0,81 | 9,67 | 0,09 |
| DER / ProbFM core | 2,65 | 0,46 | 3,90 | 0,00 |
BTC-də Gaussian NLL ən aşağı CRPS-ni (2,21) və tam 0,95 PICP-ni yaratdığı halda ProbFM core CRPS 2,65 və PICP 0,46 yaradır. ProbFM core-un sharpness dəyəri 3,90 ilə nəzərəçarpacaq dərəcədə daha kiçikdir; lakin bu dar intervalların yalnız %46 əhatə təmin etməsi sharpness-ın təkbaşına müsbət nəticə kimi şərh edilə bilməyəcəyini göstərir.
Ticarət simulyasiyasının qaydası
Mənbə istiqamətli ticarət strategiyasından istifadə edir:
- Proqnozlaşdırılan gəlir \(>0\) olduqda uzun mövqe (BUY).
- Proqnozlaşdırılan gəlir \(\le0\) olduqda qısa mövqe (SELL).
- \(\operatorname{PnL}=\operatorname{signal}\times\operatorname{actual\ return}\times100\) və nəticə basis point vahidində qiymətləndirilir.
Ehtimallı metodlarda əlavə olaraq ümumi proqnoz qeyri-müəyyənliyi öz paylanmasının 75. percentilindən yuxarıdırsa ticarət filtrlənir. Buna görə ehtimallı modellərin trading nəticələri yalnız proqnoz istiqamətini deyil, qeyri-müəyyənlik filtrini də əhatə edir.
Sharpe, Sortino, drawdown və Calmar nəyi ölçür?
Mənbə Sharpe nisbətini:
\[ \operatorname{Sharpe} = \frac{\mu_r}{\sigma_r} \]
kimi müəyyən edir və gündəlik nisbəti \(\sqrt{252}\) ilə illikləşdirir.
Sortino nisbəti:
\[ \operatorname{Sortino} = \frac{\mu_r}{\sigma_{\text{downside}}} \]
şəklindədir və yalnız mənfi gəlirlərin standart sapmasını risk kimi istifadə edir.
Maximum Drawdown, kumulyativ PnL-də ən böyük zirvə-dib enişidir. Calmar nisbəti, illikləşdirilmiş gəliri mütləq maksimum enişə bölür. Win Rate isə gəlirli əməliyyatların ümumi əməliyyat sayına nisbətidir.
BTC ticarət performansı
| Metod | İllik Sharpe | İllik Sortino | Max DD (bps) | Calmar | Win Rate |
|---|---|---|---|---|---|
| MSE | 0,90 | 1,52 | −15,89 | 1,98 | 0,51 |
| Huber | 0,59 | 0,93 | −15,14 | 1,35 | 0,51 |
| Gaussian NLL | 0,49 | 0,77 | −15,14 | 1,12 | 0,50 |
| Student-t NLL | 0,70 | 1,08 | −15,89 | 1,41 | 0,51 |
| Quantile Loss | 1,13 | 1,90 | −15,14 | 2,60 | 0,52 |
| Adaptive Conformal | 0,98 | 1,64 | −15,14 | 2,25 | 0,51 |
| DER / ProbFM core | 1,33 | 2,27 | −15,14 | 3,04 | 0,52 |
Mənbə BTC üçün ProbFM core-un ən yüksək Sharpe və Sortino nisbətini yaratdığını vurğulayır. Bununla belə qazanma nisbəti 0,52-dir və Quantile Loss ilə eynidir. Yüksək riskə uyğunlaşdırılmış nisbətlərin mənbəyi yalnız “daha çox düzgün istiqamət proqnozu” deyil; əməliyyat seçimi və qeyri-müəyyənlik filtri də nəticələrə daxildir.
Tam Transformer ProbFM Arxitekturası Bu Tədqiqatda Empirik Olarak Doğrulanıbmı?
Tam olaraq xeyr. Tədqiqat Transformer əsaslı ProbFM arxitekturasını ətraflı təsvir etsə də nəticə cədvəllərindəki nəzarətli empirik müqayisələr 1 qatlı, 32 gizli ölçülü ortaq LSTM onurğasında DER və digər qeyri-müəyyənlik metodlarını müqayisə edir; buna görə bildirilən BTC və digər kripto performansları əsasən DER/ProbFM-core qeyri-müəyyənlik mexanizmini doğrulayır, tam adaptiv-patching Transformer arxitekturasının üstünlüyünü birbaşa sınaqdan keçirmir.
Digər 10 aktivdə ProbFM core ticarət nəticələri
| Aktiv | İllik Sharpe | İllik Sortino | Max DD (bps) | Calmar | Win Rate |
|---|---|---|---|---|---|
| BTC | 1,33 | 2,27 | −15,14 | 3,04 | 0,52 |
| ADA | −0,83 | −0,86 | −88,94 | −0,86 | 0,46 |
| BNB | 1,96 | 2,80 | −21,26 | 3,44 | 0,57 |
| DASH | −0,49 | −0,55 | −66,52 | −0,47 | 0,50 |
| DOGE | −0,08 | −0,12 | −63,42 | −0,10 | 0,49 |
| ETH | 1,10 | 1,84 | −38,83 | 1,91 | 0,50 |
| LTC | 0,17 | 0,22 | −42,44 | 0,23 | 0,55 |
| SOL | 1,64 | 2,84 | −28,99 | 4,07 | 0,54 |
| USDC | 9,14 | 16,24 | −0,05 | 53,43 | 0,68 |
| USDT | 5,28 | 8,32 | −0,11 | 20,03 | 0,58 |
| XRP | 1,44 | 2,67 | −28,35 | 3,55 | 0,53 |
Nəticələr aktivlər arasında homogen deyil. ADA, DASH və DOGE-də ProbFM core Sharpe nisbəti mənfidir; BTC, BNB, ETH, SOL və XRP-də müsbətdir. USDC və USDT üçün çox yüksək Sharpe/Sortino dəyərləri bildirilir. Bu iki aktiv stablecoin olduğuna görə gəlir və drawdown miqyasları digər kripto aktivlərdən fərqlidir; əlavə olaraq əməliyyat xərcləri nəzərə alınmayıb. Buna görə yüksək stablecoin nisbətlərini birbaşa digər kripto aktivlərin iqtisadi performansı ilə ekvivalent hesab etmək doğru deyil.
Mənbədə keçən “portfel optimallaşdırması” iddiasının sərhədi
Məqalənin giriş bölməsi qeyri-müəyyənliyə əsaslanan position sizing istifadə edən portfel optimallaşdırmasının equal-weighted baseline-ı keçdiyini bildirir. Lakin yüklənmiş PDF-də metod, nəticə və əlavə cədvəllərdə ayrıca portfel optimallaşdırması təcrübəsi, portfel çəki tənliyi və ya equal-weighted müqayisə cədvəli verilməyib. Görünən empirik nəticələr gündəlik istiqamətli ticarət strategiyası və 75. percentil qeyri-müəyyənlik filtrinə aiddir.
Buna görə Verianla portfel optimallaşdırması iddiasını doğrulanmış ətraflı nəticə kimi genişləndirmir. Mənbədə təfərrüatı göstərilməyən bu iddia yalnız mənbə müəllifinin giriş bölməsindəki bəyanı olaraq qalır.
Tədqiqatın dəstəklədiyi nəticələr
- DER/NIG quruluşu tək forward pass daxilində epistemik və aleatorik qeyri-müəyyənliyi riyazi olaraq ayrı kəmiyyətlər şəklində yarada bilər.
- Nəzarətli LSTM təcrübəsində DER-nin nöqtə proqnozu RMSE/MAE dəyərləri digər metodlarla ümumən eyni böyüklük səviyyəsindədir.
- BTC ticarət simulyasiyasında ProbFM core mənbə cədvəlindəki ən yüksək Sharpe və Sortino dəyərlərini yaradıb.
- Qeyri-müəyyənlik metrikləri kripto aktivlər arasında ciddi şəkildə dəyişir.
- Coverage loss-a baxmayaraq ProbFM core-un %95 PICP hədəfi bütün aktivlərdə təmin edilməyib.
- Qeyri-müəyyənlik filtri mənbənin maliyyə qərarı təcrübəsində əməliyyat seçiminin bir hissəsidir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
- ProbFM-nin bütün kripto aktivlərdə ən yaxşı proqnoz modeli olduğu nəticəsi dəstəklənmir.
- Tam Transformer ProbFM arxitekturasının cədvəldə müqayisə edilən bütün metodlardan üstün olduğu göstərilməyib.
- %95 proqnoz intervallarının ümumən yaxşı kalibrə edildiyi göstərilməyib.
- Bildirilən Sharpe və Sortino nisbətləri real əməliyyat xərclərindən sonrakı investisiya gəliri deyil.
- Tədqiqat gələcək kripto qiymətini zəmanət edən alqı-satqı sistemi təqdim etmir.
- Nəticələrin səhm, valyuta, enerji və ya digər zaman sırası sahələrinə ümumiləşdirilə bilməsi hələ sınaqdan keçirilməyib.
- Nəticələrin müxtəlif random seed-lər altında statistik paylanması bildirilməyib.
Mənbənin öz məhdudiyyətləri
Məlumat əhatəsi: Birincil qiymətləndirmə yalnız 11 kripto aktivə fokuslanır.
Bazar rejimləri: Mənbə araşdırılan dövrün həddindən artıq çökmələr və ya uzunmüddətli ayı bazarları daxil olmaqla bütün bazar rejimlərini əhatə etməyə biləcəyini qəbul edir.
Əməliyyat xərcləri: Slippage, komissiya və market impact simulyasiyada yoxdur.
Arxitektura əhatəsi: Nəzarətli müqayisələr LSTM əsaslıdır; başqa arxitekturalar fərqli trade-off-lar yarada bilər.
Ablasiya çatışmazlığı: Coverage loss, evidence annealing və bounded prediction çevrilməsinin töhfələri bu versiyada ayrıca ablasiya ilə ölçülməyib.
Statistik robustluq: Mənbə gələcəkdə bir neçə random initialization, etibar intervalları, run-lar arası standart sapmalar və formal hipotez testləri aparılmasını təklif edir. Mövcud reproducibility quruluşunda random seed 0 bildirilir.
Klassik modellər: ARIMA və GARCH kimi klassik zaman sırası/maliyyə ekonometrikası modelləri mövcud təcrübə cədvəlində müqayisə edilməyib, gələcək iş kimi saxlanılıb.
Mənbədaxili texniki və hesabat qeydləri
| Mövzu | Mənbədə görünən vəziyyət | Düzgün şərh sərhədi |
|---|---|---|
| Transformer / LSTM ayrımı | Tam ProbFM Transformer kimi təsvir olunur; müqayisəli təcrübələr ortaq LSTM onurğasından istifadə edir. | Cədvəl nəticələri tam Transformer ProbFM benchmark-ı kimi təqdim edilməməlidir. |
| NIG notasiyası | Arxitektura bölməsində \(\mu,\lambda,\alpha,\beta\); təcrübə və regularization bölməsində \(\gamma,\nu,\alpha,\beta\) istifadə olunur. | Mənbə açıq uyğunluq vermədiyinə görə simvollar səssizcə dəyişdirilməməlidir. |
| Optimizer | Əsas metod AdamW; nəzarətli təcrübə Appendix C Adam bildirir. | İki təlim konteksti ayrılmalıdır; mənbə ayrımı tam izah etmir. |
| Cosine schedule | Eq. 24 yalnız \(\cos(\pi t/T)\) ehtiva edir. | Yazıldığı formada ikinci yarıda mənfi ola bilər; mənbə tətbiq kodu ilə izah etmir. |
| Confidence interval notasiyası | \(\alpha\), həm NIG shape, həm etibar səviyyəsinin tamamlayıcısı kimi istifadə olunur. | Eq. 30-da simvolun mənası kontekstdən asılı olaraq qeyri-müəyyəndir. |
| Coverage nəticəsi | Coverage loss hədəfi %95; BTC ProbFM-core PICP 0,46. | Coverage loss-un mövcudluğu kalibrasiya uğuruna zəmanət vermir. |
| Portfel optimallaşdırması | Girişdə uğur iddiası var; ayrıca metod/nəticə cədvəli görünmür. | Təfərrüatlandırılmamış müəllif bəyanı tam empirik nəticə kimi genişləndirilməməlidir. |
Mənbə və Metod Qeydi
Orijinal başlıq: ProbFM: Probabilistic Time Series Foundation Model with Uncertainty Decomposition
Müəlliflər: Arundeep Chinta; Lucas Vinh Tran; Jay Katukuri.
Müəllif sırası: Mənbədəki sıra qorunub.
Afiliasiyalar: Arundeep Chinta və Jay Katukuri — JPMorganChase, Palo Alto, USA. Lucas Vinh Tran — JPMorganChase, London, UK.
Əlaqə: Mənbə ilk səhifəsində hər üç müəllifin e-poçt ünvanını verir. Ayrı “corresponding author” işarəsi yoxdur.
Bərabər töhfə: Yüklənmiş PDF-də bərabər töhfə bəyanı yoxdur.
Mənbə növü: arXiv preprint.
arXiv identifikatoru: arXiv:2601.10591v1.
Birincil sahə: cs.LG — Machine Learning.
Yükləmə tarixi: 15 Yanvar 2026.
Jurnal / konfrans: Noyabr 2026 etibarilə eyni başlıq üçün doğrulanmış hakemli jurnal və ya konfrans nəşri aşkar edilməyib; rəsmi qeyd preprint olaraq qalır.
DOI: Yüklənmiş PDF-də və doğrulanmış rəsmi arXiv qeyd mətnində ayrıca nəşr DOI-si bildirilməyib; buna görə Verianla doğrulanmamış DOI əlavə etmir.
Lisenziya: Yüklənmiş PDF-nin görünən mətnində açıq lisenziya məlumatı yoxdur; doğrulana bilməyən lisenziya məlumatı əlavə edilməyib.
Maliyyələşdirmə: Ayrı maliyyələşdirmə bəyanı yüklənmiş PDF-də yoxdur.
Maraq toqquşması: Ayrı maraq toqquşması bəyanı görünmür.
CRediT müəllif töhfələri: Ayrı CRediT töhfə cədvəli yoxdur.
Məlumat mənbəyi: Kripto qiymət məlumatları Stooq üzərindən alınıb. Mənbə ayrıca data-availability bəyanı və ya təkrar istehsal kod deposu vermir.
Məlumat dövrü: 1 Yanvar 2020–3 Oktyabr 2025; aktivin mövcudluğundan asılı olaraq bütün sıralar eyni uzunluqda deyil.
Əsas tədqiqat növü: Ehtimallı zaman sırası modelləşdirilməsi + nəzarətli maşın öyrənməsi müqayisəsi + maliyyə ticarət simulyasiyası.
Təklif olunan arxitektura: Adaptiv patching, positional encoding, Transformer, DER/NIG head, evidential loss, coverage loss, evidence annealing və single-pass inference.
Empirik müqayisə arxitekturası: 1 qatlı, 32 gizli ölçülü LSTM; bütün metodlarda eyni onurğadan istifadə edilərək qeyri-müəyyənlik metodlarının təsiri təcrid edilib.
Mühüm nəticə sərhədi: Tədqiqat tam Transformer ProbFM-nin bütün rəqib foundation modellərdən daha yaxşı olduğunu göstərmir. Empirik cədvəllər əsasən DER mexanizminin ortaq LSTM mühitindəki davranışını göstərir.
Kalibrasiya sərhədi: %95 hədəfli proqnoz intervallarında ProbFM core-un PICP dəyəri aktivlər arasında 0,31–1,00 aralığında dəyişir; buna görə mənbə nəticələri homogen %95 kalibrasiya göstərmir.
Ticarət simulyasiyası sərhədi: Slippage, komissiya və market impact daxil deyil. Bildirilən Sharpe, Sortino, Calmar və drawdown dəyərləri real bazar tətbiqində eyni şəkildə baş verəcəyinin sübutu deyil.
Mənbə disclaimer-ı: Məqalə JPMorganChase-in məlumatların tamlığı və ya düzgünlüyü barədə zəmanət vermədiyini; fikirlərin müəlliflərə aid olduğunu və sənədin investisiya araşdırması, investisiya məsləhəti, qiymətli kağız və ya maliyyə məhsulunun alqı-satqısı üçün tövsiyə olmadığını açıq şəkildə bildirir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib