


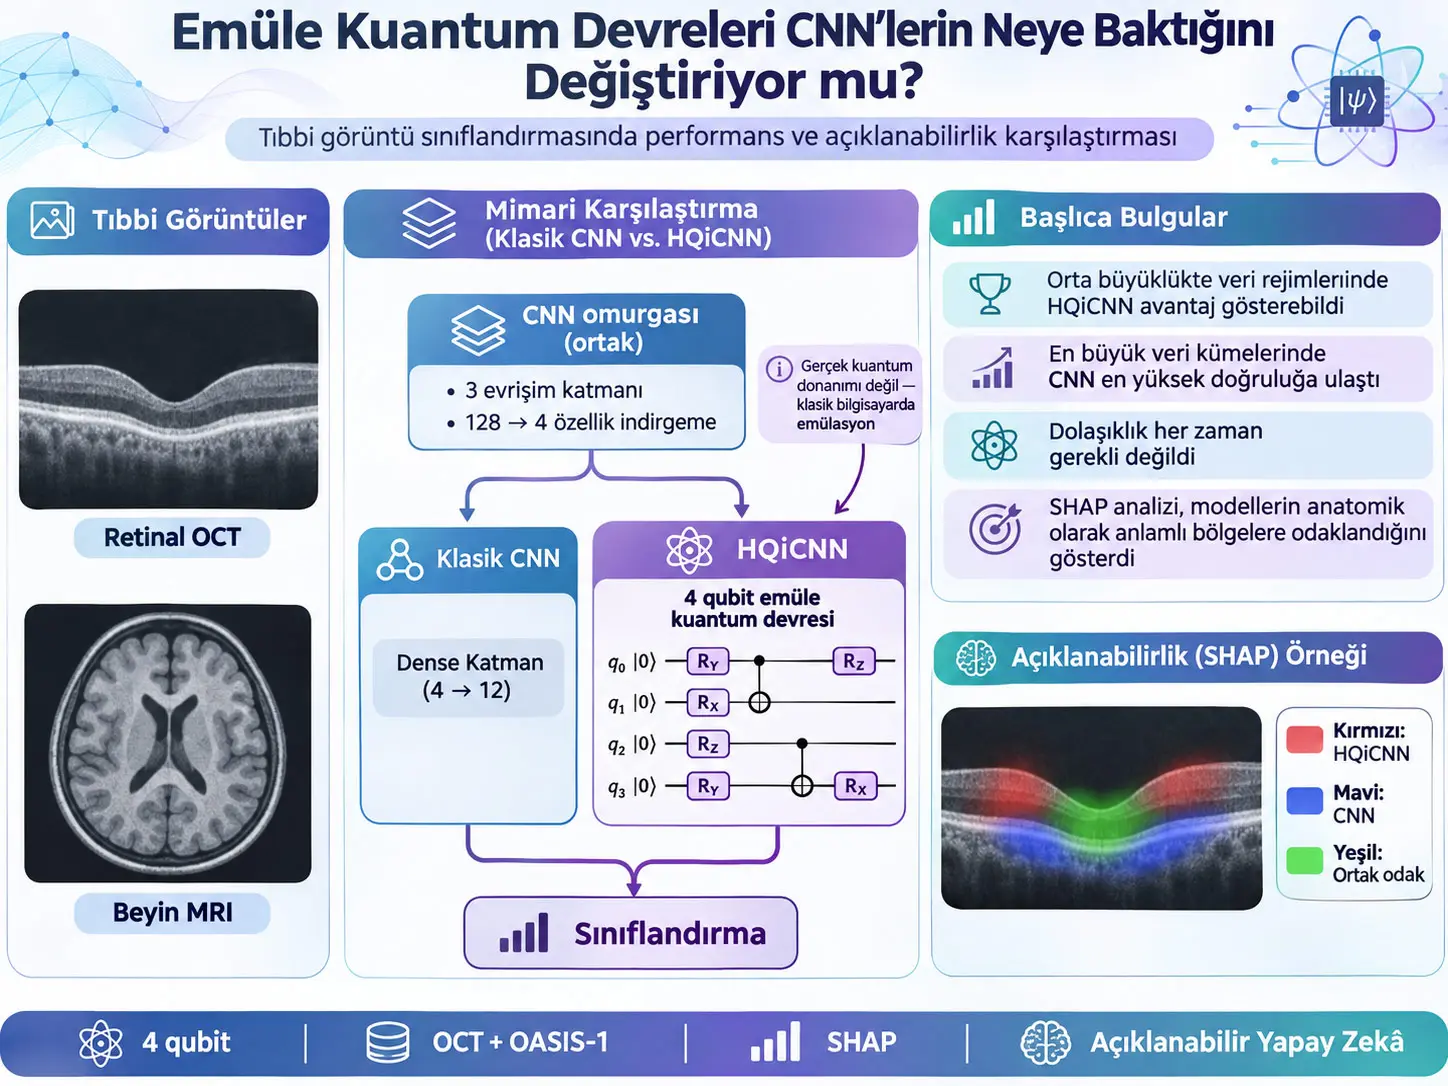
Hibrit Kuantum-İlhamlı Evrişimsel Sinir Ağı (Hybrid Quantum-inspired Convolutional Neural Network, HQiCNN), klasik bir CNN görüntü-özellik çıkarma omurgasını koruyup ara temsil katmanındaki klasik dense layer yerine dört qubitlik, klasik bilgisayarda emüle edilen parametrik kuantum devresi kullanan bir görüntü sınıflandırma modelidir. Çalışma, HQiCNN'i aynı convolutional backbone'u kullanan klasik CNN ile retinal optik koherens tomografisi (OCT) ve demans evrelemesi için hazırlanmış beyin MRI görüntüleri üzerinde karşılaştırmaktadır. Ana araştırma sorusu, küçük ve klasik olarak emüle edilebilen bir kuantum devresinin gerçek kuantum donanımı gerektirmeden CNN'in öğrendiği ara temsili ve görüntünün hangi bölgelerine önem verdiğini anlamlı biçimde değiştirip değiştiremeyeceğidir.
İki model mümkün olduğunca kontrollü bir mimari karşılaştırma için aynı convolutional backbone'u kullanır. Görüntü önce üç katmanlı convolutional block tarafından 128 boyutlu bir feature vector'a dönüştürülür; ardından linear reduction katmanı bu vektörü 4 boyuta indirir. Klasik CNN kolunda bu dört özellik ReLU etkinleştirmeli \(4\rightarrow12\) dense layer'a girerken, HQiCNN kolunda dört feature dört qubitlik emüle kuantum devresine angle encoding ile aktarılır. Devrede \(R_Y\) input encoding, trainable \(R_X\) ve \(R_Z\) rotations ve isteğe bağlı CNOT entanglement bulunur. Dört qubit üzerinde \(X\), \(Y\) ve \(Z\) Pauli observables okunarak toplam 12 classical output feature elde edilir. Her iki kolun 12 boyutlu çıktısı aynı tür classical output layer'a gider.
Bu devre gerçek bir quantum processor üzerinde çalıştırılmamıştır. Kuantum bileşen PyTorch'un yerel matematiksel işlemleriyle klasik bilgisayarda emüle edildiği için hardware noise, decoherence, finite-shot measurement uncertainty ve fiziksel qubit connectivity gibi gerçek kuantum bilgisayar sınırlılıkları benchmark'a dahil değildir. Emüle yapı ayrıca quantum hardware'de gerekli olacak parameter-shift gradient estimation yerine ordinary backpropagation kullanabilmektedir.
OCT için training size, learning rate, batch size, circuit entanglement ve observable-set boyutu sistematik biçimde değiştirilmiştir. Dokuz training size, üç learning rate, üç batch size, entangled/non-entangled circuit, üç observable set ve 10 random seed içeren ana OCT hyperparameter programı toplam 640 execution olarak raporlanmaktadır. Maksimum training süresi 100 epoch, early-stopping patience sekiz epoch, learning-rate-scheduler patience üç epoch ve reduction factor 0.3'tür.
Sonuçlar tek bir mimarinin her durumda üstün olmadığını gösterir. OCT'de klasik CNN en büyük training set için çalışmanın en yüksek genel test accuracy değerine, %93.7'ye ulaşmıştır. HQiCNN ise özellikle orta büyüklükteki training sets, yaklaşık 800–2000 örnek civarındaki birçok configuration'da klasik CNN'den daha yüksek mean test accuracy üretmiştir. Benzer eğilim OASIS dementia robustness test'inde de görülmüş; daha küçük training sizes'da HQiCNN üstünken veri miktarı büyüdükçe fark daralmış ve büyük training size'da CNN hafifçe öne geçmiştir.
Entanglement genel olarak zorunlu bir avantaj sağlamamıştır. Non-entangled circuit ortalamada çoğu configuration'da benzer veya daha iyi performans verirken yalnız belirli training sizes, özellikle 1000 ve 1200 örnek düzeylerinde entanglement daha doğru ve daha kararlı sonuçlar üretmiştir. Kaynak bu sonucu önemli görmektedir; çünkü separable circuits klasik emülasyonda daha kolay ölçeklenirken entangled circuits'in simulation maliyeti qubit sayısıyla çok daha hızlı büyür.
Explainability bölümünde araştırmacılar iki SHAP-tabanlı araç önermektedir. \(|SHAP|IoU\), iki model için mutlak SHAP değerlerinin en yüksek %10'una sahip görüntü bölgelerinin örtüşmesini görselleştirir. \(EMD_{pos}\) ise iki modelin pozitif SHAP dağılımları arasındaki uzamsal farkı Earth Mover's Distance/Wasserstein yaklaşımıyla nicelleştirir. OCT'de ortalama \(EMD_{pos}\), 1000 training sample için \(0.066\pm0.019\), 30000 sample için \(0.045\pm0.018\) bulunmuştur. Değerin veri arttıkça küçülmesi, iki modelin pozitif attribution bölgelerinin daha fazla benzeştiğini göstermektedir.
Ancak çalışma bir klinik tanı sistemi doğrulaması değildir. SHAP haritalarının retinal pigment epithelium ve hastalıkla ilişkili anatomik bölgelerde yoğunlaşması anatomik olarak anlamlı bir işaret olsa da yazarlar bu bölgelerin klinik olarak doğrulanmış biomarker olmadığını açıkça belirtmektedir. Ayrıca bağımsız dış klinik validation, clinician reader study, tam 3D MRI analysis ve training/inference computational-cost comparison yapılmamıştır.
HQiCNN Nedir ve Bu Çalışmada Gerçek Bir Kuantum Bilgisayar Kullanılıyor mu?
HQiCNN, klasik CNN omurgasının ara dense representation layer'ını dört qubitlik emüle parametrik kuantum devresiyle değiştiren hybrid quantum-inspired bir sınıflandırma modelidir; bu çalışmada fiziksel kuantum işlemci kullanılmamış, kuantum devresi PyTorch üzerinde klasik bilgisayarda matematiksel olarak emüle edilmiştir.
“Quantum-inspired” burada tam olarak ne anlama geliyor?
Bu çalışmada “quantum-inspired” ifadesi yalnız genel bir pazarlama etiketi değildir. HQiCNN'in ara katmanı gerçek quantum-circuit matematiğini kullanan dört-qubitlik bir parameterized circuit yapısına sahiptir:
- classical features qubit rotation angles biçiminde encode edilir,
- qubit states unitary rotation matrices ile dönüştürülür,
- trainable \(R_X\) ve \(R_Z\) rotations kullanılır,
- entangled configuration'da CNOT gates uygulanır,
- son state'den \(X\), \(Y\) ve \(Z\) Pauli observables'ın expectation-value benzeri classical outputs elde edilir.
Ancak bütün bu işlemler physical qubits üzerinde değil, klasik bilgisayardaki tensor/matrix operations ile hesaplanmaktadır. Bu ayrım çok önemlidir: kaynak, “kuantum bilgisayar kullanarak tıbbi görüntü sınıflandırması yaptık” dememektedir.
Qubit nedir?
Qubit, iki boyutlu kompleks Hilbert space içinde tanımlanan kuantum bilgi birimidir. Kaynak temel qubit state'i:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle = \begin{bmatrix} \alpha\\ \beta \end{bmatrix} \]
biçiminde verir.
Normalization koşulu:
\[ |\alpha|^2+|\beta|^2=1 \]
olmalıdır.
Burada:
- \(|0\rangle\) ve \(|1\rangle\): computational basis states,
- \(\alpha\) ve \(\beta\): complex probability amplitudes,
- \(|\alpha|^2\) ve \(|\beta|^2\): ideal measurement sırasında ilgili basis outcome'ların Born-rule probabilities değerleridir.
Superposition, qubit'in ölçüm öncesi yalnız \(|0\rangle\) veya yalnız \(|1\rangle\) olmak zorunda olmaması ve bu basis states'in normalized linear combination'ı olarak temsil edilebilmesi anlamına gelir.
Bu makalede qubit state fiziksel bir cihazda hazırlanmaz; aynı matematiksel state vector klasik hesaplama üzerinde tutulur.
Hilbert space nedir?
Hilbert space, quantum state vectors'ın tanımlandığı kompleks inner-product vector space'dir. Tek qubit için temel space iki boyutludur. Birden fazla qubit tensor product ile birleştirildiğinde state-space dimension büyür. Dört qubit için genel pure-state vector:
\[ 2^4=16 \]
complex amplitude içerir.
Bu sayı burada çalışmanın yeni sonucu değildir; dört-qubit state-space yapısının matematiksel anlamını açıklayan temel kuantum bilgisi yorumudur.
Quantum gate nedir?
Quantum gate, quantum state üzerinde acting eden unitary operator'dür. Unitary olma koşulu:
\[ U^\dagger U=I \]
olduğundan state normu korunur.
Çalışmanın temel circuit gates'i \(R_X\), \(R_Y\), \(R_Z\) ve CNOT'tur.
Kaynakta verilen \(R_X\), \(R_Y\) ve \(R_Z\) dönüşleri
Kaynak Denklem (1)'de:
\[ R_X(\theta) = \begin{bmatrix} \cos(\theta/2) & -i\sin(\theta/2)\\ -i\sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Y(\theta) = \begin{bmatrix} \cos(\theta/2) & -\sin(\theta/2)\\ \sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Z(\theta) = \begin{bmatrix} e^{-i\theta/2} & 0\\ 0 & e^{i\theta/2} \end{bmatrix}. \tag{1} \]
matrislerini kullanmaktadır.
Bu matrices, qubit state'i Bloch sphere üzerinde sırasıyla \(x\), \(y\) ve \(z\) eksenleri çevresinde \(\theta\) açısı kadar rotate eden unitary transformations'dır.
\(\theta\) boyutsuz bir açısal parametredir ve radians cinsinden yorumlanır. Circuit içindeki input-dependent veya trainable parameter'ın hangi gate'e uygulandığına bağlı olarak \(\theta\), encoded classical feature veya optimization sırasında öğrenilen model parameter'ı olabilir.
Pauli observables nedir?
Kaynak Denklem (2)'de üç temel Pauli matrix'i verir:
\[ X= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix}, \qquad Y= \begin{bmatrix} 0&-i\\ i&0 \end{bmatrix}, \qquad Z= \begin{bmatrix} 1&0\\ 0&-1 \end{bmatrix}. \tag{2} \]
Pauli matrices hem quantum gates/rotations'ın oluşturulmasında hem de observables olarak quantum state'den classical information çıkarılmasında merkezi rol oynar.
Bu çalışmanın ana HQiCNN configuration'ında her dört qubit için üç local observable:
\[ X,\ Y,\ Z \]
değerlendirildiği için:
\[ 4\ \text{qubit}\times3\ \text{observable}=12 \]
classical feature üretilir.
Entanglement nedir?
Entanglement, çoklu quantum system state'inin bağımsız subsystem states'in tensor product'ına ayrılamadığı quantum correlation biçimidir.
Örneğin genel iki-qubit state:
\[ |\psi\rangle \neq |\psi_A\rangle\otimes|\psi_B\rangle \]
ise state entangled olabilir.
HQiCNN'in entangled sürümünde qubits arasında linear CNOT layer uygulanmaktadır. Non-entangled sürümde bu coupling kaldırılır.
Bu çalışmanın önemli sonucu, entanglement'ın genel performans için zorunlu olmadığını göstermesidir. Bu bulgu “entanglement hiçbir quantum machine-learning modelinde yararsızdır” anlamına gelmez; yalnız burada kullanılan dört-qubit HQiCNN, datasets ve measurement scheme için raporlanmıştır.
Parameterized Quantum Circuit nedir?
Parameterized Quantum Circuit (PQC), bazı gate angles'ın trainable parameters olduğu quantum circuit yapısıdır. Classical machine-learning optimizer training loss'u azaltmak için bu parameters'ı günceller.
Kaynakta HQiCNN circuit:
- 4-dimensional classical vector'ı alır,
- her component'i bir qubit'e \(R_Y\) angle encoding ile yerleştirir,
- trainable \(R_X\) ve \(R_Z\) rotations uygular,
- entangled sürümde CNOT gates kullanır,
- Pauli observables ölçümünden 12-dimensional classical representation çıkarır.
CNN ile HQiCNN Arasındaki Karşılaştırma Nasıl Kontrol Edildi?
İki model aynı convolutional feature extractor, aynı 128→4 linear reduction ve aynı 12-boyutlu representation'dan classification output'a giden son katmanı paylaşır; ana mimari değişken, klasik CNN'deki \(4\rightarrow12\) ReLU dense layer'ın HQiCNN'de dört-qubitlik emüle parametrik circuit ile değiştirilmesidir.
Ortak convolutional backbone
Giriş medical image, üç convolutional layer'dan oluşan ortak block'a girer. Kaynak her layer için:
- Conv2D,
- kernel size 3,
- Batch Normalization,
- Max Pooling,
- ReLU
bileşenlerini belirtmektedir.
Bu block sonunda görüntü:
\[ 128 \]
boyutlu feature vector'a dönüştürülür.
Linear reduction
Activation kullanmayan linear reduction layer:
\[ 128\rightarrow4 \]
dönüşümü yapar.
Böylece iki model aynı dört-dimensional latent representation'ı alır.
Klasik CNN kolu
Klasik branch:
\[ 4\rightarrow12 \]
dense layer ve ReLU activation kullanır.
HQiCNN kolu
HQiCNN aynı dört-dimensional vector'ı dört qubit'e angle-encode eder ve quantum-circuit representation sonrasında:
\[ 4\ \text{qubit} \times 3\ \text{local Pauli observable} = 12 \]
output feature üretir.
Son classification layer
Her iki branch'in 12-dimensional representation'ı ortak output layer'a gider. Output dimension dataset'teki label sayısına eşittir:
- OCT: 4 sınıf,
- OASIS robustness task: 3 sınıf.
Input neden \(2\pi\cdot\mathrm{sigmoid}(v)\) ile dönüştürülüyor?
Parameterized rotation gates açısal input kullanır. Kaynak, dört-dimensional vector:
\[ v \]
için üç preprocessing strategy karşılaştırmıştır.
Birinci seçenek:
\[ \widetilde v = 2\pi\cdot\operatorname{sigmoid}(v). \]
Sigmoid:
\[ (0,1) \]
aralığına sıkıştırdığı için \(2\pi\) ile çarpıldığında angle range:
\[ (0,2\pi) \]
olur.
İkinci seçenek:
\[ \operatorname{remainder}(v,2\pi) \]
ile periodic wrapping yapmaktır.
Üçüncü seçenek herhangi bir explicit transform uygulamadan raw \(v\) değerlerini kullanmaktır.
Kaynak scaled sigmoid transformation'ın bu üç seçenek içinde consistently better performance verdiğini ve kalan deneylerde bu yöntemin kullanıldığını belirtmektedir. Ana metinde bu preprocessing karşılaştırmasının bütün sayısal değerleri ayrı bir tablo halinde verilmemiştir.
Parameter-shift rule neden burada kullanılmıyor?
Fiziksel veya black-box quantum circuit'te trainable rotation parameter'larının gradient'i parameter-shift rule ile hesaplanabilir. Kaynağın açıklamasına göre \(p\) trainable parameter için bu yaklaşım:
\[ 2p \]
forward circuit evaluation gerektirir.
Buradaki circuit tamamen differentiable PyTorch operations ile emüle edildiği için automatic differentiation/backpropagation kullanılabilmektedir. Yazarlar bütün gradients'ın tek backward pass içinde birlikte hesaplanabildiğini ve gradient-computation evaluation scaling'inin \(O(p)\) circuit passes gereksiniminden tek backward pass'e indirildiğini vurgulamaktadır.
Bu bir quantum-hardware speedup sonucu değildir. Avantaj, classical emulation'ın differentiable software graph'ından yararlanılmasıdır.
Barren plateau nedir ve bu çalışmada ölçüldü mü?
Barren plateau, parameterized quantum circuits'te cost-function gradient'larının circuit size/depth büyüdükçe çok küçük hale gelerek training'i zorlaştırabildiği optimizasyon problemidir.
Makale barren plateau'yu QML ölçeklenebilirliğinin genel sınırlılıklarından biri olarak tanıtır; ancak çalışmanın ana deney programı dört-qubitlik emüle shallow circuit üzerindedir ve barren-plateau scaling için ayrı bir deneysel ölçüm veya exponent fitting yapmaz.
Dolayısıyla “bu çalışma barren plateau problemini çözdü” sonucu çıkarılamaz.
OCT veri seti
Retinal optical coherence tomography veri kümesi toplam:
\[ 84\,495 \]
JPEG image içermektedir ve kaynakta standart training/test splits ile dört sınıf belirtilmiştir:
- NORMAL,
- CNV — choroidal neovascularization,
- DME — diabetic macular edema,
- DRUSEN.
Kaynak veri setinin görüntülerinin 2013–2017 arasında birden fazla uluslararası clinical center'da Spectralis OCT cihazlarıyla toplandığını ve label quality için çok aşamalı ophthalmologist review uygulandığını aktarmaktadır.
Bu bilgi orijinal OCT dataset'in özelliğidir; mevcut HQiCNN çalışmasının yeni hasta topladığı anlamına gelmez.
OASIS-1 MRI veri seti
Robustness analysis için OASIS-1 structural MRI kullanılmıştır. Kaynağa göre dataset:
\[ 416 \]
subject içerir ve yaş aralığı:
\[ 18-96 \]
yıldır.
Preprocessing zinciri:
- 3D image files'ın NIfTI formatına dönüştürülmesi,
- standard anatomical orientation'a reorientation,
- bias-field correction,
- field-of-view cropping,
- skull stripping,
- MNI152 template'e 2 mm resolution ile 12-degree-of-freedom affine registration,
- trilinear interpolation,
- tissue segmentation,
- white-matter partial-volume mask oluşturulması,
- white-matter mean intensity hesaplanması,
- Shinohara normalization,
- registered 3D volume'dan axial 2D slices çıkarılması
olarak açıklanmaktadır.
Bütün model inputs:
\[ 64\times64 \]
pixel resolution'a resize edilmiş ve:
\[ [0,1] \]
aralığına normalize edilmiştir.
OASIS sınıfları neden gerçek CDR tanısı olarak okunmamalı?
Kaynak OASIS-derived labels'ı üç gruba dönüştürmektedir:
- Non Demented,
- Very Mild Dementia,
- Mild/Moderate Dementia.
Yazarlar bu labels'ın formal clinical CDR assessment olmadığını açık biçimde belirtmektedir.
Yalnız severity descriptions üzerinden yaklaşık eşleme yapılmıştır:
- Non Demented ≈ CDR 0,
- Very Mild Dementia ≈ CDR 0.5,
- Mild/Moderate Dementia ≈ CDR ≥ 1.
Moderate Dementia sınıfı 500'den az sample içerdiği için Mild Dementia ile birleştirilmiştir. Majority class da diğer classes'ın boyutuna downsample edilerek üç-sınıflı task dengelenmiştir.
Bu nedenle çalışma doğrudan formal CDR clinical scoring algorithm'ı eğitmemiştir.
EMDpos Neyi Ölçüyor?
\(EMD_{pos}\), HQiCNN ve klasik CNN için normalize edilmiş pozitif SHAP pixel distributions'ını iki boyutlu Earth Mover's Distance ile karşılaştıran bir açıklanabilirlik metriğidir; değer küçüldükçe iki modelin doğru sınıflandırmayı destekleyen görüntü bölgelerinin uzamsal dağılımı birbirine daha fazla yaklaşır.
SHAP nedir?
SHAP, bir model prediction'ına input features'ın ne yönde ve ne büyüklükte katkı verdiğini Shapley-value yaklaşımıyla açıklayan model-agnostic explainability framework'tür.
Image model'de feature pixel veya pixel region olarak yorumlanabilir. Pozitif SHAP value, ilgili pixel'in değerlendirilen output'u destekleyen contribution gösterdiğini ifade eder.
Bu açıklama feature attribution'dır; tek başına biological causality veya clinical biomarker kanıtı değildir.
\(|SHAP|IoU\) nasıl kullanılıyor?
Kaynak her model için mutlak SHAP values'ın en yüksek:
\[ 10\% \]
bölümünü seçerek iki region-of-interest mask:
\[ R_A,\ R_B \]
oluşturur.
Kaynak Figure 6'da:
- kırmızı: yalnız HQiCNN'in güçlü attribution verdiği bölgeler,
- mavi: yalnız CNN'in güçlü attribution verdiği bölgeler,
- yeşil: iki modelin ortak gördüğü bölgeler
olarak sunulmaktadır.
Kaynak \(|SHAP|IoU\) için ayrı bir scalar Intersection-over-Union formülünü numaralı denklem biçiminde vermemektedir; yöntem esas olarak üst-%10 masks arasındaki spatial intersection'ı görünür kılmak için kullanılmaktadır.
\(EMD_{pos}\) formülü
Önce iki modelin positive SHAP values'ı normalize edilerek iki-dimensional probability distributions elde edilir.
Kaynak Denklem (3):
\[ EMD_{pos} = \min_{\gamma\in\Pi(\omega_{HQiCNN}\mid\omega_{CNN})} \sum_{i,j} \gamma_{i,j} \left\| p_i-p_j \right\|_2. \tag{3} \]
Burada:
- \(\omega_{HQiCNN}\) ve \(\omega_{CNN}\): normalize edilmiş positive SHAP spatial distributions,
- \(\gamma_{i,j}\): pixel location \(i\)'den location \(j\)'ye taşınan probability mass miktarı,
- \(p_i,p_j\): normalized pixel coordinates,
- \(\|\cdot\|_2\): Euclidean distance,
- \(\Pi\): iki distributions'ın marginals'ını koruyan admissible transport plans kümesini temsil eden kaynak gösterimidir.
Kaynak pixel coordinate'u:
\[ p= \left( \frac{y}{64}, \frac{x}{64} \right) \]
olarak normalize eder.
64×64 image:
\[ 64\times64=4096 \]
grid point içerir.
EMD'nin fiziksel bir metre, milimetre veya pixel birimi yoktur; coordinate normalization nedeniyle burada boyutsuz spatial-distance metric olarak kullanılmaktadır.
\(EMD_{pos}\) alt ve üst sınırı
Identical distributions için:
\[ EMD_{pos}=0. \]
Kaynak maksimum geometrik ayrımı image grid'in karşılıklı corners'ı üzerinden hesaplar:
\[ D = \sqrt{ \left(\frac{63}{64}\right)^2 + \left(\frac{63}{64}\right)^2 } = \frac{63}{64}\sqrt2 \approx1.3921. \tag{4} \]
Dolayısıyla:
\[ 0 \le EMD_{pos} \le \frac{63}{64}\sqrt2 \approx1.3921. \tag{5} \]
olarak verilir.
Düşük değer iki modelin positive-SHAP spatial distribution'larının benzer olduğunu; yüksek değer ise probability mass'ın daha uzağa taşınması gerektiğini ifade eder.
Çalışmanın Yöntemi ve Bulguları
OCT hyperparameter deney tasarımı
| Hyperparameter | Değerler | Seçenek sayısı |
|---|---|---|
| Training size | 200, 400, 800, 1000, 1200, 1600, 2000, 12000, 30000 | 9 |
| Learning rate | 10−2, 10−3, 10−4 | 3 |
| Batch size | 8, 16, 32 | 3 |
| Quantum circuit | Entangled, Not Entangled | 2 |
| Observable set | O1, O2, O3 | 3 |
| Random seed | 10 randomly selected seeds | 10 |
Kaynak toplam OCT hyperparameter executions sayısını:
\[ 9\times3\times10 + 3\times10 + 2\times8\times10 + 3\times6\times10 = 640 \]
olarak vermektedir.
Bu 640 sayısı Table 1'deki OCT hyperparameter programına aittir. OASIS robustness experiment bu toplamın içine ayrıca açık bir formülle eklenmemiştir.
Training ayarları
| Ayar | Kaynakta verilen değer / yöntem |
|---|---|
| Framework | PyTorch |
| Quantum emulation | Native PyTorch functions |
| Loss | Cross-entropy |
| Output softmax | Kullanılmıyor; cross-entropy unnormalized logits üzerinde çalışıyor |
| Gradient handling | GradScaler |
| Maksimum epoch | 100 |
| Early-stopping patience | 8 epoch |
| Learning-rate scheduler patience | 3 epoch |
| Learning-rate reduction factor | 0.3 |
| Random repetitions | 10 seed |
Table 2: learning rate ve training size sonuçları
Aşağıdaki değerler kaynak Table 2'de raporlanan 10 random seed üzerindeki mean test accuracy ± standard deviation değerleridir.
| Model | LR | 200 | 400 | 800 | 1000 | 1200 | 1600 | 2000 | 12000 | 30000 |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN | 0.01 | 0.436 ± 0.104 | 0.495 ± 0.135 | 0.575 ± 0.049 | 0.670 ± 0.082 | 0.698 ± 0.098 | 0.749 ± 0.083 | 0.843 ± 0.020 | 0.929 ± 0.015 | 0.930 ± 0.010 |
| CNN | 0.001 | 0.467 ± 0.098 | 0.535 ± 0.125 | 0.633 ± 0.058 | 0.661 ± 0.074 | 0.734 ± 0.055 | 0.751 ± 0.076 | 0.774 ± 0.127 | 0.924 ± 0.010 | 0.937 ± 0.006 |
| CNN | 0.0001 | 0.311 ± 0.069 | 0.358 ± 0.078 | 0.550 ± 0.092 | 0.518 ± 0.132 | 0.628 ± 0.068 | 0.643 ± 0.049 | 0.672 ± 0.042 | 0.885 ± 0.011 | 0.919 ± 0.006 |
| HQiCNN | 0.01 | 0.325 ± 0.094 | 0.468 ± 0.105 | 0.551 ± 0.099 | 0.638 ± 0.092 | 0.714 ± 0.078 | 0.800 ± 0.032 | 0.818 ± 0.066 | 0.930 ± 0.009 | 0.929 ± 0.012 |
| HQiCNN | 0.001 | 0.448 ± 0.082 | 0.559 ± 0.076 | 0.688 ± 0.051 | 0.745 ± 0.074 | 0.769 ± 0.028 | 0.795 ± 0.055 | 0.828 ± 0.034 | 0.920 ± 0.008 | 0.931 ± 0.008 |
| HQiCNN | 0.0001 | 0.347 ± 0.089 | 0.414 ± 0.085 | 0.542 ± 0.080 | 0.582 ± 0.053 | 0.600 ± 0.051 | 0.653 ± 0.037 | 0.684 ± 0.058 | 0.897 ± 0.008 | 0.920 ± 0.008 |
Training size sonucu
Her iki modelde de genel eğilim training data arttıkça test accuracy'nin yükselmesidir.
Kaynak özellikle yaklaşık:
\[ 12\,000 \]
sample sonrasında gains'in daha yavaş hale geldiğini ve saturation/diminishing-returns davranışı başladığını belirtmektedir.
HQiCNN'in en belirgin göreli avantajları small-to-intermediate data regime'in ortasında görülmektedir. Buna karşılık en büyük training set için klasik CNN:
\[ 0.937\pm0.006 \]
ile çalışmadaki en yüksek global OCT accuracy'ye ulaşmıştır.
HQiCNN'in 30000 sample, learning rate 0.001 değeri:
\[ 0.931\pm0.008 \]
olarak raporlanmaktadır.
Dolayısıyla çalışma “HQiCNN her veri büyüklüğünde CNN'den daha iyidir” sonucunu desteklemez.
Learning rate sonucu
Kaynak:
\[ 10^{-3} \]
learning rate'in genel olarak accuracy ve optimization stability arasında en dengeli seçenek olduğunu belirtmektedir.
\(10^{-2}\) bazı configurations'da yüksek performans üretse de seed/configuration variation daha büyüktür.
\[ 10^{-4} \]
ise çoğu durumda daha düşük accuracy üretmiş ve kaynak bunu optimization'ın allocated training budget içinde fazla conservative kalmasıyla ilişkilendirmiştir.
Bu sonuç yalnız burada kullanılan architectures, datasets ve training budget için geçerlidir; genel bütün neural networks için evrensel optimum learning rate değildir.
Figure 3'ün interpolation uyarısı
Kaynak small/intermediate training-size bölgesindeki HQiCNN–CNN mean-accuracy difference değerlerini heatmap ile sunmaktadır.
Heatmap'in girdileri discrete measured configurations'dır; kaynak caption'ı görseli daha smooth yapmak amacıyla interpolation kullanıldığını açıkça belirtmektedir.
Bu nedenle Verianla interpolated color field'dan yeni kesin numeric values okumamış, kaynak Table 2'deki gerçek discrete values'ı source-of-truth olarak korumuştur.
Batch size sonucu
Training size 1000 için batch sizes:
\[ 8,\ 16,\ 32 \]
karşılaştırılmıştır.
Kaynağın Figure 4(a) yorumu HQiCNN'in üç batch size'ın tamamında mean accuracy ve stability bakımından klasik CNN'den daha iyi olduğunu belirtmektedir.
Figure 4(a)'da individual box-plot values ayrı numeric table halinde verilmediği için Verianla bar/box positions'dan kesin yeni sayılar üretmemektedir.
Entanglement sonucu
Entangled circuit CNOT layer içerirken non-entangled model aynı entangling gates olmadan çalışmaktadır.
Kaynağın sonucu:
- ortalama olarak non-entangled configuration daha iyi sonuç verir,
- 1000 ve 1200 training samples için entangled configuration daha accurate ve stable görünür,
- genel güçlü performans için entanglement zorunlu değildir.
Kaynak ayrıca output observables'ın local olmasının entanglement tarafından oluşturulan higher-order correlations'ın tamamını görünür hale getirmeyebileceğini olası açıklama olarak belirtmektedir.
Bu bir kanıtlanmış mekanizma değildir; yazarların sonuç yorumudur.
Neden non-entangled devre ölçeklenebilirlik açısından önemli?
Kaynak, separable circuit classical emulation complexity'sinin qubit sayısıyla linear ölçeklenebildiğini; entangled circuit simulation'ın ise genel durumda exponential complexity oluşturabildiğini belirtmektedir.
Bu nedenle benzer classification accuracy entanglement olmadan elde edilebiliyorsa daha büyük emulated circuit'lere geçiş computational açıdan daha uygulanabilir olabilir.
Bu bulgu gerçek quantum hardware için doğrudan “entanglement kullanmayın” tavsiyesi değildir.
Observable sets
Kaynak üç nested observable set tanımlar.
Kaynak gösterimiyle:
\[ O_1 = \{\Gamma_i\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i\in\{1,4\}. \]
\[ O_2 = O_1 \cup \{\Gamma_i\Gamma_j\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j\in\{1,4\}, \quad i\neq j. \]
\[ O_3 = O_1 \cup O_2 \cup \{\Gamma_i\Gamma_j\Gamma_k\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j,k\in\{1,4\}, \quad i\neq j\neq k. \]
Notasyon uyarısı: Kaynak metin dört-qubit circuit üzerinde local, pairwise ve triple observables tanımladığını açıkça söylerken indis kümelerini literal olarak \(\{1,4\}\) biçiminde basmaktadır. Bu gösterim yalnız iki indeks içerdiği için bağlamla tam uyumlu görünmemektedir. Verianla gösterimi \(\{1,\ldots,4\}\) biçimine sessizce değiştirmemiştir.
Observable-set sonucu
Small ve intermediate training sizes'da \(O_1\), \(O_2\) ve \(O_3\) arasında belirgin performans farkı görülmemektedir.
Kaynak bunu low-data regime'de modelin feature-space expressivity'den önce training data miktarı tarafından sınırlandığı biçiminde yorumlamaktadır.
Large-data regime'de, özellikle:
\[ 12\,000 \quad\text{ve}\quad 30\,000 \]
training samples için daha zengin observable sets slightly higher accuracy üretmektedir.
Kaynak bu sonucu hardware açısından da tartışmaktadır: non-commuting ek observables gerçek hardware'de ekstra measurement budget gerektirir. Emulated setting'de ise bu physical shot overhead bulunmamaktadır.
Figure 4(c) kaynak içi caption hatası
Figure 4(c)'nin grafiği ve çevre metni \(O_1,O_2,O_3\) observable-set comparison'ını göstermektedir.
Buna karşın subfigure caption kaynakta yeniden:
“Accuracy comparison ... for different batch sizes”
anlamına gelen ifadeyi kullanmaktadır.
Bu nedenle Verianla Figure 4(c)'yi observable-set experiment olarak, ana metnin açıklaması ve graph legend ile uyumlu biçimde tarif etmekte; kaynak caption'ındaki uyuşmazlığı da görünür bırakmaktadır.
OASIS robustness sonucu
OCT experiments'de belirlenen iyi-performing hyperparameters OASIS dementia classification problemine aktarılmıştır.
Kaynak Figure 5 üç training size göstermektedir:
\[ 999,\ 3000,\ 12000. \]
999 sayısı üç classes arasında balanced dataset oluşturma gereksinimi nedeniyle kullanılmıştır.
Figure 5'in kaynak yorumu:
- küçük training size'da HQiCNN klasik CNN'den daha iyi,
- training size arttıkça fark daralıyor,
- en büyük training size'da klasik CNN hafifçe öne geçiyor.
Figure 5'in raw box-plot observations'ı numeric table halinde yayımlanmadığı için burada grafikten yeni kesin accuracy değerleri çıkarılmamıştır.
Bu experiment yazarların kendi ifadesiyle robustness check'tir; clinical conclusion üretmek amacıyla tasarlanmamıştır.
SHAP explainability sonuçları
OCT explainability experiment için her modelde, 10 seeds içinden accuracy'si modelin mean accuracy değerine en yakın seed seçilmiştir.
Kaynak attribution maps'te iki modelin özellikle:
- retinal pigment epithelium (RPE),
- retinal layers,
- disease-associated elevations/deformations
çevresindeki anatomik alanlara odaklandığını belirtmektedir.
1000 training sample koşulunda HQiCNN attribution maps daha localized ve anatomically coherent görünürken classical CNN daha fragmented attribution distribution göstermektedir.
30000 sample'a çıkıldığında iki modelin attribution overlap'i belirgin biçimde artmaktadır.
Bu gözlemler attribution pattern düzeyindedir; klinik tanı mekanizmasının nedensel doğrulaması değildir.
\(EMD_{pos}\) sonuçları
| Training size | EMDpos | Yorum |
|---|---|---|
| 1000 | 0.066 ± 0.019 | İki model arasında düşük fakat 30000-sample durumuna göre daha büyük spatial fark |
| 30000 | 0.045 ± 0.018 | Daha yüksek SHAP-spatial agreement |
Her iki değer de theoretical upper bound:
\[ 1.3921 \]
değerine göre oldukça düşüktür.
Kaynak ayrıca same-image EMD distributions'ın farklı görüntüler arasındaki cross-image reference distribution'dan daha düşük olduğunu raporlamaktadır.
Bu sonuç, iki modelin aynı görüntü üzerinde benzer anatomik regions'a positive attribution vermesiyle uyumludur.
Fakat düşük \(EMD_{pos}\):
- modelin klinik olarak doğru nedensel açıklama yaptığı,
- bulunan bölgenin validated biomarker olduğu,
- modelin hastalık patofizyolojisini öğrendiği
anlamına gelmez.
Bu Çalışma Bir “Kuantum Üstünlüğü” Gösteriyor mu?
Hayır; çalışma gerçek kuantum donanımına karşı klasik bilgisayar üstünlüğü veya hesaplama karmaşıklığı anlamında quantum advantage göstermemektedir. HQiCNN'in ara katmanı klasik bilgisayarda emüle edilmiştir ve sonuçlar yalnız belirli veri/optimizasyon rejimlerinde bu kuantum-ilhamlı temsilin parameter-controlled klasik CNN'e alternatif olabildiğini göstermektedir.
Çalışmanın sonuç bölümünün en önemli cümlelerinden biri, HQiCNN avantajının yalnız “quantum operations eklenmiş olmasından” kaynaklanmadığını belirtmesidir.
Performans:
- training data miktarı,
- learning rate ve optimization dynamics,
- entanglement seçimi,
- observable set
ile birlikte değişmektedir.
Bu nedenle “kuantum layer her durumda daha iyi representation öğrenir” gibi genel bir sonuç kaynak tarafından desteklenmemektedir.
Çalışmanın desteklediği sonuçlar
- Dört-qubitlik emüle quantum circuit, klasik CNN'in ara dense layer'ına alternatif bir representation layer olarak kullanılabilir.
- HQiCNN orta büyüklükteki bazı training-data regimes'de klasik CNN'den daha yüksek test accuracy üretmiştir.
- Klasik CNN en büyük OCT training set'inde çalışmanın en yüksek genel accuracy değerine ulaşmıştır.
- Learning rate ile training size'ın etkileşimi iki mimari arasındaki farkı belirgin biçimde etkiler.
- 10−3 learning rate çalışma koşullarında en dengeli/stabil seçenek olarak raporlanmıştır.
- Batch sizes 8, 16 ve 32 altında 1000-sample OCT experiment'te HQiCNN'in avantajı korunmuştur.
- Entanglement genel olarak güçlü performans için zorunlu değildir.
- Large-data regime'de daha zengin observable sets küçük fakat ölçülebilir iyileşme sağlamıştır.
- OASIS robustness test'inde small-data → HQiCNN avantajı, large-data → CNN avantajına dönüşen benzer eğilim görülmüştür.
- \(|SHAP|IoU\) ve \(EMD_{pos}\), iki modelin attribution patterns'ını karşılaştırmak için kullanılabilmiştir.
- 1000 sample'da HQiCNN SHAP maps daha localized görünürken 30000 sample'da modellerin attribution distributions'ı daha fazla benzeşmiştir.
Çalışmanın desteklemediği sonuçlar
- Gerçek kuantum bilgisayarın CNN'den daha iyi tıbbi görüntü sınıflandırdığı gösterilmemiştir.
- Quantum computational advantage veya asymptotic quantum speedup gösterilmemiştir.
- HQiCNN'in bütün datasets ve bütün training sizes için CNN'den üstün olduğu gösterilmemiştir.
- Entanglement'ın sınıflandırma başarısı için zorunlu olduğu gösterilmemiştir.
- SHAP regions klinik olarak doğrulanmış biomarker değildir.
- OASIS labels formal CDR clinical assessments değildir.
- Model hastane kullanımında prospective olarak doğrulanmamıştır.
- Bağımsız multicenter external clinical validation yapılmamıştır.
- Clinician reader study yapılmamıştır.
- MRI classification full 3D volume üzerinden yapılmamıştır; 2D slices kullanılmıştır.
- Training time, inference speed, memory use ve genel computational efficiency benchmark edilmemiştir.
- Gerçek quantum-hardware noise, decoherence ve finite-shot measurement error test edilmemiştir.
Temel sınırlılıklar
- Quantum circuit yalnız dört qubit ve shallow emulated yapıdadır.
- Gerçek quantum hardware kullanılmamıştır.
- Hardware connectivity constraint yoktur.
- Finite-shot measurement uncertainty yoktur.
- Decoherence veya gate noise yoktur.
- OASIS robustness task 2D slices'a indirgenmiştir.
- Independent external clinical dataset validation eksiktir.
- Clinician reader study eksiktir.
- Computational-cost comparison yapılmamıştır.
- Code public repository olarak verilmemiş; corresponding authors'tan reasonable request üzerine sağlanabileceği belirtilmiştir.
- “Parameter-matched” ifadesi kullanılsa da manuscript iki modelin toplam trainable-parameter sayılarını açık numeric comparison tablosunda raporlamamaktadır.
Kaynak içindeki önemli raporlama notları
- Figure 3 caption'ında “red areas” yerine “read areas” yazım hatası bulunmaktadır; heatmap'in kırmızı bölgeleri HQiCNN'in daha iyi olduğu alanlardır.
- Figure 3 discrete configurations'dan oluşturulmuş olmasına rağmen görsel smoothness için interpolation kullanmaktadır.
- Figure 4(c) observable-set karşılaştırması olduğu halde subfigure caption batch-size comparison olarak yazılmıştır.
- Observable indisleri dört-qubit bağlamında \(i,j,k\in\{1,4\}\) biçiminde basılmıştır; kaynak bunun literal set mi yoksa 1–4 indeks aralığının kısaltılmış/yanlış yazımı mı olduğunu açıklamamaktadır.
- “Parameter-matched” ifadesi kaynakta kullanılır, fakat total trainable-parameter counts ayrı sayısal tabloyla verilmez.
Kaynak ve Yöntem Notu
Özgün başlık: Do emulated quantum circuits change what CNNs look at? Performance and explainability comparison in medical image classification
Yazarlar: Guillermo Rubiños Rodríguez; Martín Ottavianelli; Mateo Alonso; Gonzalo Blázquez Gil; Boris-Stephan Rauchmann; Pablo Díez-Valle; Sergio Altares-López.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş katkı: Pablo Díez-Valle ve Sergio Altares-López kaynakta eş katkılı yazarlar olarak işaretlenmiştir.
Corresponding author: Sergio Altares-López.
Corresponding-author e-posta: slopez@med.lmu.de
Kurum 1: Instituto Tecnológico de Galicia, Cantón Grande 9, Planta 3, 15003 A Coruña, Spain.
Kurum 2: Centro Singular de Investigación en Tecnoloxías Intelixentes (CiTIUS), Universidade de Santiago de Compostela, Santiago de Compostela, 15782, Spain.
Kurum 3: Department of Neuroradiology, LMU University Hospital, Ludwig Maximilian University of Munich, Marchioninistraße 15, 81377 Munich, Germany.
Kurum 4: Department of Psychiatry and Psychotherapy, LMU University Hospital, LMU Munich, Nussbaumstraße 7, 80336 Munich, Germany.
Kaynak türü: Quantum machine learning / medical image classification alanında hesaplamalı preprint.
Platform: arXiv.
arXiv: arXiv:2607.21186v1 [quant-ph].
Gönderim tarihi: 23 Temmuz 2026.
DOI: 10.48550/arXiv.2607.21186.
Hakemlik durumu: İncelenen kaynak arXiv preprint sürümüdür. Bibliyografik doğrulama sırasında aynı çalışma için ayrı ve doğrulanmış nihai hakemli dergi sürümü tespit edilmemiştir.
Lisans: arXiv kayıt metadata'sında arXiv non-exclusive distribution license gösterilmektedir; Creative Commons lisansı olduğu varsayılmamıştır.
Sayfa sayısı: 17.
Şekil sayısı: 6.
Tablo sayısı: 2.
Ana çalışma türü: Mevcut medical-image datasets üzerinde supervised machine-learning benchmark ve explainability analysis.
Quantum çalışma türü: Gerçek quantum hardware değil; dört-qubitlik parametrik circuit'in classical emulation'ı.
Quantum implementation: Native PyTorch operations; dedicated quantum-computing framework kullanılmamıştır.
Gradient yöntemi: Emulated circuit için automatic differentiation/backpropagation; physical-circuit parameter-shift measurement kullanılmamıştır.
Classical baseline: Ortak convolutional backbone + \(4\rightarrow12\) ReLU dense layer.
HQiCNN branch: Ortak convolutional backbone + 4-qubit emulated parameterized quantum circuit + 12 observable output.
Input preprocessing: 2π·sigmoid(v), remainder(v,2π) ve no-transform karşılaştırılmış; kalan çalışmada scaled sigmoid seçilmiştir.
Ana OCT veri seti: 84,495 JPEG retinal OCT image; NORMAL, CNV, DME ve DRUSEN sınıfları.
Robustness veri seti: OASIS-1-derived structural MRI; kaynak 416 subject, 18–96 yaş aralığı bildirmektedir.
OASIS task sınıfları: Non Demented, Very Mild Dementia, Mild/Moderate Dementia.
CDR sınırı: OASIS labels formal clinical CDR assessment değildir; kaynak yalnız approximately corresponding CDR stages biçiminde ilişki kurmaktadır.
Input resolution: 64 × 64 pixel.
Input normalization: [0,1].
OCT hyperparameter executions: 640.
Random seeds: 10.
Maximum epochs: 100.
Early stopping patience: 8 epoch.
LR scheduler patience: 3 epoch.
LR reduction factor: 0.3.
Loss: Cross-entropy.
OCT highest reported accuracy: CNN, learning rate 0.001, 30000 training samples: \(0.937\pm0.006\).
Explainability yöntemleri: \(|SHAP|IoU\) ve \(EMD_{pos}\).
EMDpos: 1000 samples için \(0.066\pm0.019\); 30000 samples için \(0.045\pm0.018\).
EMDpos theoretical range: \(0\le EMD_{pos}\le(63/64)\sqrt2\approx1.3921\).
External clinical validation: Yok.
Clinician reader study: Yok.
MRI dimensionality: Full 3D classification yerine processed 2D axial slices kullanılmıştır.
Computational-cost analysis: Training time, inference efficiency ve memory requirements sistematik olarak benchmark edilmemiştir.
Data availability: OCT data kaynak referansındaki mevcut dataset'e; OASIS1-derived images ve preprocessing data kaynakta belirtilen dataset kaynaklarına dayanmaktadır.
Code availability: Corresponding authors'tan reasonable request üzerine sağlanabileceği belirtilmiştir; kaynak public code repository vermemektedir.
Finansman: PESL-Stiftung-Alzheimer 2026, Bayern, Germany, registered project 80765114 Pesl-Alzheimer-Stift; Principal Investigator Dr.-Ing. Sergio Altares-López. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Gonzalo Blázquez Gil ve Pablo Díez-Valle ayrıca CDTI CERVERA Research Programme tarafından finanse edilen ARQADE (CER-20251019) desteğini kabul etmektedir.
Yazar katkıları: Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle ve Sergio Altares-López experiments'ı tasarlamış ve planlamıştır. Guillermo Rubiños Rodríguez ve Martín Ottavianelli experiments'ı yürütmüştür. Gonzalo Blázquez Gil, Sergio Altares-López ve Boris-Stephan Rauchmann funding sağlamıştır. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle ve Sergio Altares-López results interpretation'a katkı vermiştir. Guillermo Rubiños Rodríguez ve Sergio Altares-López manuscript writing'de öncü rol almıştır. Tüm yazarlar critical feedback vermiş ve araştırma, analiz ve manuscript'in şekillenmesine katkıda bulunmuştur.
Çıkar çatışması: Yazarlar competing financial interests olmadığını beyan etmektedir.
Ayrı ethics statement: Yüklenen preprintte ayrı bir institutional-review/ethics-approval statement bölümü görünmemektedir. Çalışma yeni hasta recruitment'ı yerine mevcut datasets üzerinde computational analysis yürütmektedir; bunun ötesinde etik onay durumu kaynak adına varsayımla tamamlanmamıştır.
Mükerrerlik kontrolü: Bu exact başlık ve arXiv:2607.21186 için önceki Verianla işleme kaydı bulunmadığından yeni makale olarak hazırlanmıştır.
Kaynak içi raporlama notları: Figure 4(c) caption observable-set graph'ını batch-size comparison olarak etiketlemektedir; observable-index notation'da \(\{1,4\}\) kullanımı bağlam açısından belirsizdir; Figure 3 interpolation kullanmaktadır; total model parameter counts ayrı numeric table olarak verilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir