


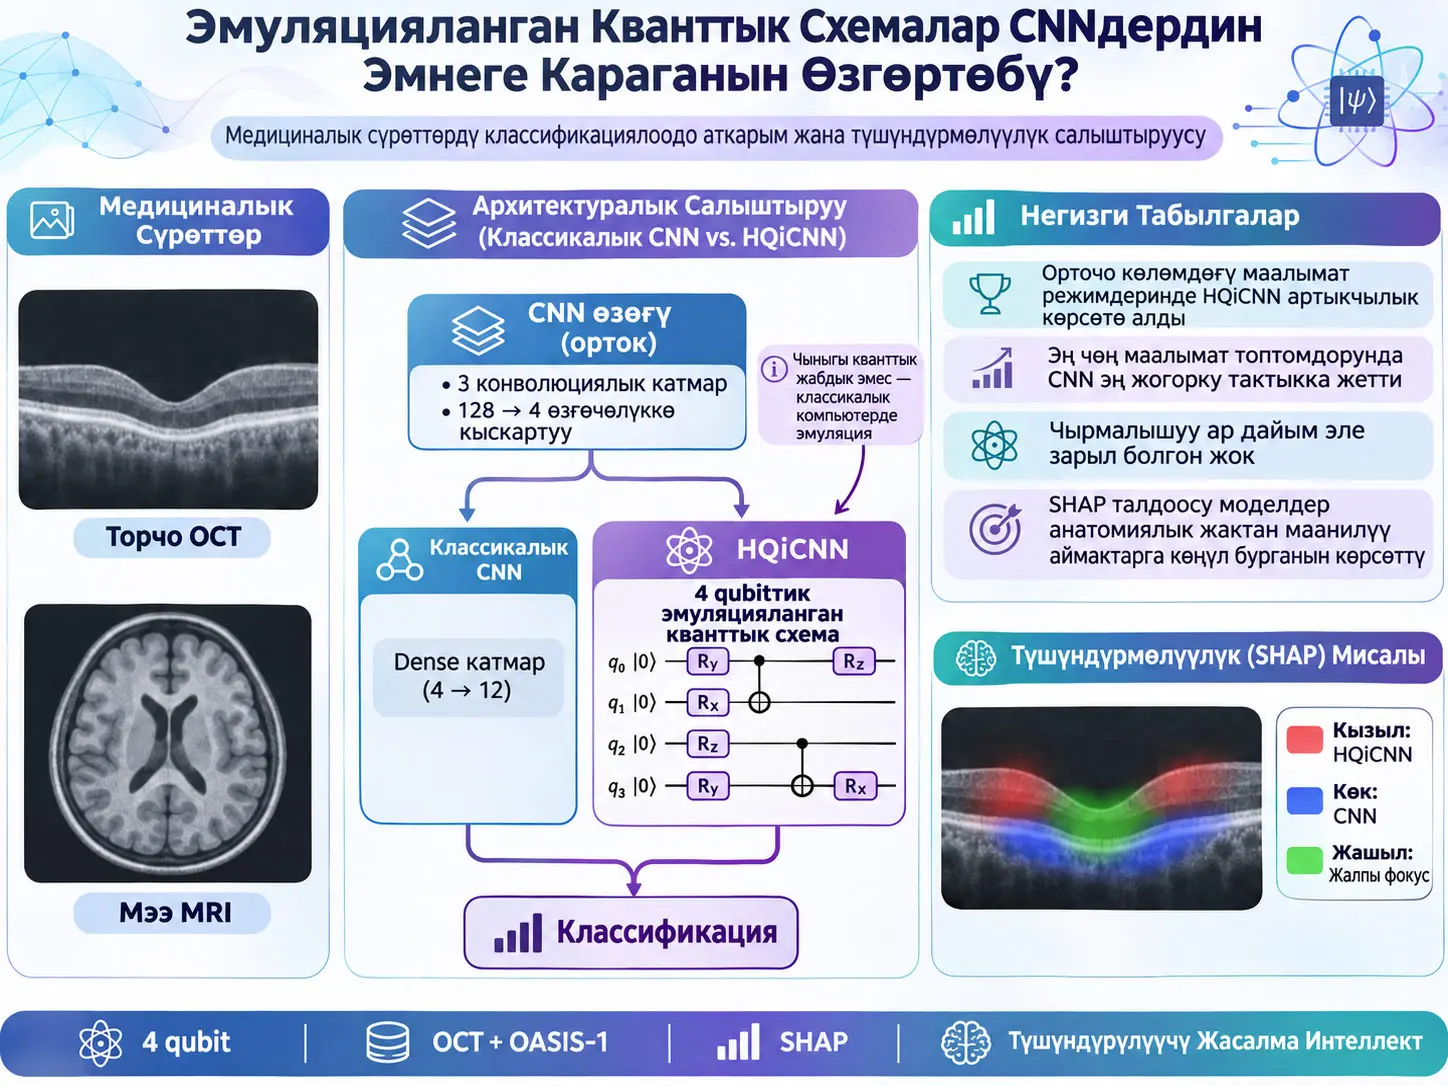
Гибриддик Кванттан Шыктанган Конволюциялык Нейрон Тармагы (Hybrid Quantum-inspired Convolutional Neural Network, HQiCNN) — классикалык CNNдин сүрөттөн өзгөчөлүк чыгаруу өзөгүн сактап, аралык көрсөтүү катмарындагы классикалык dense layer ордуна төрт qubitтен турган, классикалык компьютерде эмуляцияланган параметрдик кванттык схеманы колдонгон сүрөттөрдү классификациялоо модели. Изилдөө HQiCNNди ошол эле convolutional backbone колдонгон классикалык CNN менен торчонун оптикалык когеренттик томографиясы (OCT) жана деменцияны стадиялоо үчүн даярдалган мээнин MRI сүрөттөрүндө салыштырат. Негизги изилдөө суроосу — кичине жана классикалык түрдө эмуляциялоого мүмкүн болгон кванттык схема чыныгы кванттык жабдыкты талап кылбастан CNN үйрөнгөн аралык көрсөтүүнү жана сүрөттүн кайсы аймактарына маани берерин маанилүү түрдө өзгөртө алабы деген суроо.
Эки модель мүмкүн болушунча көзөмөлдөнгөн архитектуралык салыштыруу үчүн бирдей convolutional backbone колдонот. Сүрөт адегенде үч катмарлуу convolutional block аркылуу 128 өлчөмдүү feature vector'го айландырылат; андан кийин linear reduction катмары бул векторду 4 өлчөмгө түшүрөт. Классикалык CNN бутагында бул төрт өзгөчөлүк ReLU активдештирүүсү бар \(4\rightarrow12\) dense layer'га кирет, ал эми HQiCNN бутагында төрт feature төрт qubitтик эмуляцияланган кванттык схемага angle encoding аркылуу берилет. Схемада \(R_Y\) input encoding, trainable \(R_X\) жана \(R_Z\) rotations жана ыктыярдуу CNOT entanglement бар. Төрт qubitте \(X\), \(Y\) жана \(Z\) Pauli observables окулуп, жалпысынан 12 classical output feature алынат. Эки бутактын тең 12 өлчөмдүү чыгышы бирдей түрдөгү classical output layer'га өтөт.
Бул схема чыныгы quantum processor'до иштетилген эмес. Кванттык компонент PyTorchтун жергиликтүү математикалык операциялары менен классикалык компьютерде эмуляциялангандыктан hardware noise, decoherence, finite-shot measurement uncertainty жана физикалык qubit connectivity сыяктуу чыныгы кванттык компьютердин чектөөлөрү benchmarkка киргизилген эмес. Эмуляцияланган түзүлүш ошондой эле quantum hardware'де талап кылынуучу parameter-shift gradient estimation ордуна ordinary backpropagation колдонууга мүмкүндүк берет.
OCT үчүн training size, learning rate, batch size, circuit entanglement жана observable-set өлчөмү системалуу түрдө өзгөртүлгөн. Тогуз training size, үч learning rate, үч batch size, entangled/non-entangled circuit, үч observable set жана 10 random seed камтыган негизги OCT hyperparameter программасы жалпы 640 execution деп билдирилет. Максималдуу training мөөнөтү 100 epoch, early-stopping patience сегиз epoch, learning-rate-scheduler patience үч epoch жана reduction factor 0.3.
Натыйжалар бир эле архитектура бардык шартта үстөм эмес экенин көрсөтөт. OCTде классикалык CNN эң чоң training set үчүн изилдөөдөгү эң жогорку жалпы test accuracy — %93.7 көрсөткүчүнө жеткен. HQiCNN болсо айрыкча орто көлөмдөгү training sets, болжол менен 800–2000 үлгү тегерегиндеги көптөгөн configuration'дарда классикалык CNNге караганда жогорураак mean test accuracy берген. Ушундай эле тенденция OASIS dementia robustness test'инде да байкалган; кичирээк training sizes'да HQiCNN жогору болгон, маалымат көбөйгөн сайын айырма азайып, чоң training size'да CNN бир аз алдыга чыккан.
Entanglement жалпы алганда сөзсүз артыкчылык берген эмес. Non-entangled circuit орточо эсепте көпчүлүк configuration'дарда окшош же жакшыраак натыйжа көрсөткөн, бирок айрым training sizes, өзгөчө 1000 жана 1200 үлгү деңгээлинде entanglement так жана туруктуу натыйжаларды берген. Булак бул жыйынтыкты маанилүү деп эсептейт; анткени separable circuits классикалык эмуляцияда оңойураак масштабдалат, ал эми entangled circuitsтин simulation чыгымы qubit саны менен кыйла тез өсөт.
Explainability бөлүмүндө изилдөөчүлөр SHAP негизиндеги эки куралды сунуштайт. \(|SHAP|IoU\) эки модель үчүн абсолюттук SHAP маанилеринин эң жогорку %10уна ээ болгон сүрөт аймактарынын дал келишин визуалдаштырат. \(EMD_{pos}\) болсо эки моделдин оң SHAP бөлүштүрүүлөрүнүн ортосундагы мейкиндик айырманы Earth Mover's Distance/Wasserstein ыкмасы менен сандык түрдө баалайт. OCTде орточо \(EMD_{pos}\) 1000 training sample үчүн \(0.066\pm0.019\), 30000 sample үчүн \(0.045\pm0.018\) деп табылган. Маани маалымат көбөйгөн сайын азайышы эки моделдин оң attribution аймактары көбүрөөк окшош боло баштаганын көрсөтөт.
Бирок бул изилдөө клиникалык диагностикалык системаны валидациялоо эмес. SHAP карталарынын retinal pigment epithelium жана ооруга байланыштуу анатомиялык аймактарда топтолушу анатомиялык жактан маанилүү белги болгону менен, авторлор бул аймактар клиникалык жактан тастыкталган biomarker эмес экенин ачык белгилешет. Мындан тышкары көз карандысыз тышкы клиникалык validation, clinician reader study, толук 3D MRI analysis жана training/inference computational-cost comparison жүргүзүлгөн эмес.
HQiCNN Деген Эмне жана Бул Изилдөөдө Чыныгы Кванттык Компьютер Колдонулабы?
HQiCNN — классикалык CNN өзөгүнүн аралык dense representation layer'ын төрт qubitтик эмуляцияланган параметрдик кванттык схема менен алмаштырган hybrid quantum-inspired классификациялоо модели; бул изилдөөдө физикалык кванттык процессор колдонулган эмес, кванттык схема PyTorch үстүндө классикалык компьютерде математикалык түрдө эмуляцияланган.
“Quantum-inspired” бул жерде так эмнени билдирет?
Бул изилдөөдө “quantum-inspired” деген сөз жөн гана жалпы маркетингдик белги эмес. HQiCNNдин аралык катмары чыныгы quantum-circuit математикасын колдонгон төрт-qubitтик parameterized circuit түзүлүшүнө ээ:
- classical features qubit rotation angles түрүндө encode кылынат,
- qubit states unitary rotation matrices менен өзгөртүлөт,
- trainable \(R_X\) жана \(R_Z\) rotations колдонулат,
- entangled configuration'да CNOT gates колдонулат,
- акыркы state'тен \(X\), \(Y\) жана \(Z\) Pauli observables'тын expectation-value сыяктуу classical outputs алынат.
Бирок бул операциялардын баары physical qubits үстүндө эмес, классикалык компьютердеги tensor/matrix operations аркылуу эсептелет. Бул айырма өтө маанилүү: булак “кванттык компьютер колдонуп медициналык сүрөттөрдү классификацияладык” деп айтпайт.
Qubit деген эмне?
Qubit — эки өлчөмдүү комплекстүү Hilbert space ичинде аныкталган кванттык маалымат бирдиги. Булак негизги qubit state'ти:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle = \begin{bmatrix} \alpha\\ \beta \end{bmatrix} \]
түрүндө берет.
Normalization шарты:
\[ |\alpha|^2+|\beta|^2=1 \]
болушу керек.
Бул жерде:
- \(|0\rangle\) жана \(|1\rangle\): computational basis states,
- \(\alpha\) жана \(\beta\): complex probability amplitudes,
- \(|\alpha|^2\) жана \(|\beta|^2\): ideal measurement учурунда тиешелүү basis outcome'дардын Born-rule probabilities маанилери.
Superposition qubit өлчөнгөнгө чейин сөзсүз \(|0\rangle\) же сөзсүз \(|1\rangle\) абалында болбостон, бул basis states'тин normalized linear combination'ы катары берилерин билдирет.
Бул макалада qubit state физикалык түзмөктө даярдалбайт; ошол эле математикалык state vector классикалык эсептөөдө сакталат.
Hilbert space деген эмне?
Hilbert space — quantum state vectors аныкталган комплекстүү inner-product vector space. Бир qubit үчүн негизги space эки өлчөмдүү. Бир нече qubit tensor product аркылуу бириктирилгенде state-space dimension өсөт. Төрт qubit үчүн жалпы pure-state vector:
\[ 2^4=16 \]
complex amplitude камтыйт.
Бул сан бул жерде изилдөөнүн жаңы натыйжасы эмес; төрт-qubit state-space түзүлүшүнүн математикалык маанисин түшүндүргөн негизги кванттык маалымат түшүндүрмөсү.
Quantum gate деген эмне?
Quantum gate — quantum state үстүндө acting кылган unitary operator. Unitary болуу шарты:
\[ U^\dagger U=I \]
болгондуктан state нормасы сакталат.
Изилдөөнүн негизги circuit gates'и \(R_X\), \(R_Y\), \(R_Z\) жана CNOT.
Булакта берилген \(R_X\), \(R_Y\) жана \(R_Z\) айлануулары
Булак Теңдеме (1)де:
\[ R_X(\theta) = \begin{bmatrix} \cos(\theta/2) & -i\sin(\theta/2)\\ -i\sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Y(\theta) = \begin{bmatrix} \cos(\theta/2) & -\sin(\theta/2)\\ \sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Z(\theta) = \begin{bmatrix} e^{-i\theta/2} & 0\\ 0 & e^{i\theta/2} \end{bmatrix}. \tag{1} \]
матрицаларын колдонот.
Бул matrices qubit state'ти Bloch sphere үстүндө тиешелүүлүгүнө жараша \(x\), \(y\) жана \(z\) окторунун айланасында \(\theta\) бурчуна rotate кылган unitary transformations.
\(\theta\) өлчөмсүз бурчтук параметр жана radians менен түшүндүрүлөт. Circuit ичиндеги input-dependent же trainable parameter кайсы gate'ке колдонулганына жараша \(\theta\), encoded classical feature же optimization маалында үйрөнүлгөн model parameter болушу мүмкүн.
Pauli observables деген эмне?
Булак Теңдеме (2)де үч негизги Pauli matrix'ти берет:
\[ X= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix}, \qquad Y= \begin{bmatrix} 0&-i\\ i&0 \end{bmatrix}, \qquad Z= \begin{bmatrix} 1&0\\ 0&-1 \end{bmatrix}. \tag{2} \]
Pauli matrices quantum gates/rotations түзүүдө да, observables катары quantum state'тен classical information чыгарууда да борбордук роль ойнойт.
Бул изилдөөнүн негизги HQiCNN configuration'ында ар бир төрт qubit үчүн үч local observable:
\[ X,\ Y,\ Z \]
баалангандыктан:
\[ 4\ \text{qubit}\times3\ \text{observable}=12 \]
classical feature алынат.
Entanglement деген эмне?
Entanglement — көп quantum system state өз алдынча subsystem states'тин tensor product'уна ажыратылбай турган quantum correlation формасы.
Мисалы, жалпы эки-qubit state:
\[ |\psi\rangle \neq |\psi_A\rangle\otimes|\psi_B\rangle \]
болсо state entangled болушу мүмкүн.
HQiCNNдин entangled версиясында qubits ортосунда linear CNOT layer колдонулат. Non-entangled версиясында бул coupling алынып салынат.
Бул изилдөөнүн маанилүү жыйынтыгы entanglement жалпы аткарым үчүн милдеттүү эмес экенин көрсөтөт. Бул табылга “entanglement эч бир quantum machine-learning моделинде пайдасыз” дегенди билдирбейт; ал бул жерде колдонулган төрт-qubit HQiCNN, datasets жана measurement scheme үчүн гана билдирилген.
Parameterized Quantum Circuit деген эмне?
Parameterized Quantum Circuit (PQC) — айрым gate angles trainable parameters болгон quantum circuit түзүлүшү. Classical machine-learning optimizer training loss'ту азайтуу үчүн бул parameters'ды жаңыртат.
Булакта HQiCNN circuit:
- 4-dimensional classical vector'ду кабыл алат,
- ар бир component'ти бир qubit'ке \(R_Y\) angle encoding менен жайгаштырат,
- trainable \(R_X\) жана \(R_Z\) rotations колдонот,
- entangled версиясында CNOT gates колдонот,
- Pauli observables өлчөөсүнөн 12-dimensional classical representation чыгарат.
CNN менен HQiCNN Ортосундагы Салыштыруу Кантип Көзөмөлдөндү?
Эки модель бирдей convolutional feature extractor, бирдей 128→4 linear reduction жана бирдей 12-өлчөмдүү representation'дан classification output'ка барган акыркы катмарды бөлүшөт; негизги архитектуралык өзгөрмө — классикалык CNNдеги \(4\rightarrow12\) ReLU dense layer'дын HQiCNNде төрт-qubitтик эмуляцияланган параметрдик circuit менен алмаштырылышы.
Ортоқ convolutional backbone
Киргизилген medical image үч convolutional layer'дан турган жалпы block'ко кирет. Булак ар бир layer үчүн:
- Conv2D,
- kernel size 3,
- Batch Normalization,
- Max Pooling,
- ReLU
компоненттерин көрсөтөт.
Бул block соңунда сүрөт:
\[ 128 \]
өлчөмдүү feature vector'го айландырылат.
Linear reduction
Activation колдонбогон linear reduction layer:
\[ 128\rightarrow4 \]
өзгөртүүсүн аткарат.
Ошентип эки модель тең бирдей төрт-dimensional latent representation'ды алат.
Классикалык CNN бутагы
Классикалык branch:
\[ 4\rightarrow12 \]
dense layer жана ReLU activation колдонот.
HQiCNN бутагы
HQiCNN ошол эле төрт-dimensional vector'ду төрт qubit'ке angle-encode кылып, quantum-circuit representation'дан кийин:
\[ 4\ \text{qubit} \times 3\ \text{local Pauli observable} = 12 \]
output feature чыгарат.
Акыркы classification layer
Эки branch'тин 12-dimensional representation'ы жалпы output layer'га өтөт. Output dimension dataset'теги label санына барабар:
- OCT: 4 класс,
- OASIS robustness task: 3 класс.
Input эмне үчүн \(2\pi\cdot\mathrm{sigmoid}(v)\) менен өзгөртүлөт?
Parameterized rotation gates бурчтук input колдонот. Булак төрт-dimensional vector:
\[ v \]
үчүн үч preprocessing strategy салыштырган.
Биринчи вариант:
\[ \widetilde v = 2\pi\cdot\operatorname{sigmoid}(v). \]
Sigmoid:
\[ (0,1) \]
аралыгына кыскарткандыктан \(2\pi\) менен көбөйтүлгөндө angle range:
\[ (0,2\pi) \]
болот.
Экинчи вариант:
\[ \operatorname{remainder}(v,2\pi) \]
аркылуу periodic wrapping кылуу.
Үчүнчү вариант эч кандай explicit transform колдонбостон raw \(v\) маанилерин колдонуу.
Булак scaled sigmoid transformation бул үч варианттын арасында consistently better performance бергенин жана калган тажрыйбаларда ушул ыкма колдонулганын белгилейт. Негизги текстте бул preprocessing салыштыруунун бардык сандык маанилери өзүнчө таблица түрүндө берилген эмес.
Parameter-shift rule эмне үчүн бул жерде колдонулбайт?
Физикалык же black-box quantum circuitте trainable rotation parameter'лардын gradient'и parameter-shift rule менен эсептелиши мүмкүн. Булактын түшүндүрмөсүнө ылайык \(p\) trainable parameter үчүн бул ыкма:
\[ 2p \]
forward circuit evaluation талап кылат.
Бул жердеги circuit толугу менен differentiable PyTorch operations менен эмуляциялангандыктан automatic differentiation/backpropagation колдонууга болот. Авторлор бардык gradients бир backward pass ичинде чогуу эсептелерин жана gradient-computation evaluation scaling \(O(p)\) circuit passes талабынан бир backward passке түшөрүн баса белгилешет.
Бул quantum-hardware speedup натыйжасы эмес. Артыкчылык classical emulation'дын differentiable software graph'ын пайдаланууда.
Barren plateau деген эмне жана бул изилдөөдө өлчөндүбү?
Barren plateau — parameterized quantum circuitsте cost-function gradient'тар circuit size/depth чоңойгон сайын өтө кичине болуп, trainingди татаалдаштырышы мүмкүн болгон оптималдаштыруу көйгөйү.
Макала barren plateauну QML масштабдуулугунун жалпы чектөөлөрүнүн бири катары тааныштырат; бирок изилдөөнүн негизги тажрыйба программасы төрт-qubitтик эмуляцияланган shallow circuit үстүндө жүргүзүлгөн жана barren-plateau scaling үчүн өзүнчө эксперименттик өлчөө же exponent fitting жасалган эмес.
Демек “бул изилдөө barren plateau көйгөйүн чечти” деген тыянак чыгарууга болбойт.
OCT маалыматтар топтому
Retinal optical coherence tomography маалыматтар топтому жалпы:
\[ 84\,495 \]
JPEG image камтыйт жана булакта стандарттык training/test splits менен төрт класс көрсөтүлөт:
- NORMAL,
- CNV — choroidal neovascularization,
- DME — diabetic macular edema,
- DRUSEN.
Булак маалыматтар топтомунун сүрөттөрү 2013–2017 аралыгында бир нече эл аралык clinical center'де Spectralis OCT түзмөктөрү менен чогултулганын жана label quality үчүн көп баскычтуу ophthalmologist review колдонулганын билдирет.
Бул маалымат оригиналдуу OCT datasetтин өзгөчөлүгү; азыркы HQiCNN изилдөөсү жаңы бейтаптарды топтоду дегенди билдирбейт.
OASIS-1 MRI маалыматтар топтому
Robustness analysis үчүн OASIS-1 structural MRI колдонулган. Булак боюнча dataset:
\[ 416 \]
subject камтыйт жана жаш курак аралыгы:
\[ 18-96 \]
жыл.
Preprocessing чынжыры:
- 3D image files'ды NIfTI форматына айландыруу,
- standard anatomical orientation'га reorientation,
- bias-field correction,
- field-of-view cropping,
- skull stripping,
- MNI152 template'ке 2 mm resolution менен 12-degree-of-freedom affine registration,
- trilinear interpolation,
- tissue segmentation,
- white-matter partial-volume mask түзүү,
- white-matter mean intensity эсептөө,
- Shinohara normalization,
- registered 3D volume'дан axial 2D slices чыгаруу
деп түшүндүрүлөт.
Бардык model inputs:
\[ 64\times64 \]
pixel resolution'га resize кылынган жана:
\[ [0,1] \]
аралыгына normalize кылынган.
OASIS класстары эмне үчүн чыныгы CDR диагнозу катары окулбашы керек?
Булак OASIS-derived labels'ды үч топко айлантат:
- Non Demented,
- Very Mild Dementia,
- Mild/Moderate Dementia.
Авторлор бул labels formal clinical CDR assessment эмес экенин ачык белгилешет.
Severity descriptions аркылуу гана болжолдуу дал келтирүү жасалган:
- Non Demented ≈ CDR 0,
- Very Mild Dementia ≈ CDR 0.5,
- Mild/Moderate Dementia ≈ CDR ≥ 1.
Moderate Dementia классы 500дөн аз sample камтыгандыктан Mild Dementia менен бириктирилген. Majority class да башка classes көлөмүнө downsample кылынып, үч-класстуу task тең салмакталган.
Ошондуктан изилдөө түздөн-түз formal CDR clinical scoring algorithm үйрөткөн эмес.
EMDpos Эмнени Өлчөйт?
\(EMD_{pos}\) HQiCNN жана классикалык CNN үчүн нормалдаштырылган оң SHAP pixel distributions'ды эки өлчөмдүү Earth Mover's Distance менен салыштырган түшүндүрмөлүүлүк метрикасы; маани азайган сайын эки моделдин туура классификацияны колдогон сүрөт аймактарынын мейкиндик бөлүштүрүлүшү бири-бирине көбүрөөк жакындайт.
SHAP деген эмне?
SHAP — model prediction'га input features кайсы багытта жана канчалык өлчөмдө салым кошконун Shapley-value ыкмасы менен түшүндүргөн model-agnostic explainability framework.
Image modelде feature pixel же pixel region катары түшүндүрүлүшү мүмкүн. Оң SHAP value тиешелүү pixel бааланып жаткан output'ту колдогон contribution бергенин билдирет.
Бул түшүндүрмө feature attribution; өз алдынча biological causality же clinical biomarker далили эмес.
\(|SHAP|IoU\) кантип колдонулат?
Булак ар бир модель үчүн абсолюттук SHAP values'дын эң жогорку:
\[ 10\% \]
бөлүгүн тандап, эки region-of-interest mask:
\[ R_A,\ R_B \]
түзөт.
Булак Figure 6да:
- кызыл: HQiCNN гана күчтүү attribution берген аймактар,
- көк: CNN гана күчтүү attribution берген аймактар,
- жашыл: эки модель тең жалпы көргөн аймактар
түрүндө көрсөтөт.
Булак \(|SHAP|IoU\) үчүн өзүнчө scalar Intersection-over-Union формуласын номерленген теңдеме түрүндө бербейт; ыкма негизинен жогорку-%10 masks ортосундагы spatial intersection'ды көрүнүктүү кылуу үчүн колдонулат.
\(EMD_{pos}\) формуласы
Алгач эки моделдин positive SHAP values'ы нормалдаштырылып, эки-dimensional probability distributions алынат.
Булак Теңдеме (3):
\[ EMD_{pos} = \min_{\gamma\in\Pi(\omega_{HQiCNN}\mid\omega_{CNN})} \sum_{i,j} \gamma_{i,j} \left\| p_i-p_j \right\|_2. \tag{3} \]
Бул жерде:
- \(\omega_{HQiCNN}\) жана \(\omega_{CNN}\): нормалдаштырылган positive SHAP spatial distributions,
- \(\gamma_{i,j}\): pixel location \(i\)ден location \(j\)ге ташылган probability mass көлөмү,
- \(p_i,p_j\): normalized pixel coordinates,
- \(\|\cdot\|_2\): Euclidean distance,
- \(\Pi\): эки distributions'дын marginals'ын сактаган admissible transport plans жыйындысын билдирген булак белгилөөсү.
Булак pixel coordinate'ду:
\[ p= \left( \frac{y}{64}, \frac{x}{64} \right) \]
түрүндө нормалдаштырат.
64×64 image:
\[ 64\times64=4096 \]
grid point камтыйт.
EMDнин физикалык метр, миллиметр же pixel бирдиги жок; coordinate normalization себептүү бул жерде өлчөмсүз spatial-distance metric катары колдонулат.
\(EMD_{pos}\) төмөнкү жана жогорку чеги
Identical distributions үчүн:
\[ EMD_{pos}=0. \]
Булак максималдуу геометриялык ажырымды image grid'дин карама-каршы corners аркылуу эсептейт:
\[ D = \sqrt{ \left(\frac{63}{64}\right)^2 + \left(\frac{63}{64}\right)^2 } = \frac{63}{64}\sqrt2 \approx1.3921. \tag{4} \]
Ошондуктан:
\[ 0 \le EMD_{pos} \le \frac{63}{64}\sqrt2 \approx1.3921. \tag{5} \]
түрүндө берилет.
Төмөн маани эки моделдин positive-SHAP spatial distribution'дары окшош экенин; жогорку маани probability mass алысыраак ташылышы керек экенин билдирет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
OCT hyperparameter тажрыйба дизайны
| Hyperparameter | Маанилер | Варианттардын саны |
|---|---|---|
| Training size | 200, 400, 800, 1000, 1200, 1600, 2000, 12000, 30000 | 9 |
| Learning rate | 10−2, 10−3, 10−4 | 3 |
| Batch size | 8, 16, 32 | 3 |
| Quantum circuit | Entangled, Not Entangled | 2 |
| Observable set | O1, O2, O3 | 3 |
| Random seed | 10 randomly selected seeds | 10 |
Булак жалпы OCT hyperparameter executions санын:
\[ 9\times3\times10 + 3\times10 + 2\times8\times10 + 3\times6\times10 = 640 \]
түрүндө берет.
Бул 640 саны Table 1деги OCT hyperparameter программасына тиешелүү. OASIS robustness experiment бул жалпы санга өзүнчө ачык формула менен кошулган эмес.
Training жөндөөлөрү
| Жөндөө | Булакта берилген маани / ыкма |
|---|---|
| Framework | PyTorch |
| Quantum emulation | Native PyTorch functions |
| Loss | Cross-entropy |
| Output softmax | Колдонулбайт; cross-entropy unnormalized logits үстүндө иштейт |
| Gradient handling | GradScaler |
| Максималдуу epoch | 100 |
| Early-stopping patience | 8 epoch |
| Learning-rate scheduler patience | 3 epoch |
| Learning-rate reduction factor | 0.3 |
| Random repetitions | 10 seed |
Table 2: learning rate жана training size натыйжалары
Төмөнкү маанилер булак Table 2де 10 random seed боюнча берилген mean test accuracy ± standard deviation маанилери.
| Model | LR | 200 | 400 | 800 | 1000 | 1200 | 1600 | 2000 | 12000 | 30000 |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN | 0.01 | 0.436 ± 0.104 | 0.495 ± 0.135 | 0.575 ± 0.049 | 0.670 ± 0.082 | 0.698 ± 0.098 | 0.749 ± 0.083 | 0.843 ± 0.020 | 0.929 ± 0.015 | 0.930 ± 0.010 |
| CNN | 0.001 | 0.467 ± 0.098 | 0.535 ± 0.125 | 0.633 ± 0.058 | 0.661 ± 0.074 | 0.734 ± 0.055 | 0.751 ± 0.076 | 0.774 ± 0.127 | 0.924 ± 0.010 | 0.937 ± 0.006 |
| CNN | 0.0001 | 0.311 ± 0.069 | 0.358 ± 0.078 | 0.550 ± 0.092 | 0.518 ± 0.132 | 0.628 ± 0.068 | 0.643 ± 0.049 | 0.672 ± 0.042 | 0.885 ± 0.011 | 0.919 ± 0.006 |
| HQiCNN | 0.01 | 0.325 ± 0.094 | 0.468 ± 0.105 | 0.551 ± 0.099 | 0.638 ± 0.092 | 0.714 ± 0.078 | 0.800 ± 0.032 | 0.818 ± 0.066 | 0.930 ± 0.009 | 0.929 ± 0.012 |
| HQiCNN | 0.001 | 0.448 ± 0.082 | 0.559 ± 0.076 | 0.688 ± 0.051 | 0.745 ± 0.074 | 0.769 ± 0.028 | 0.795 ± 0.055 | 0.828 ± 0.034 | 0.920 ± 0.008 | 0.931 ± 0.008 |
| HQiCNN | 0.0001 | 0.347 ± 0.089 | 0.414 ± 0.085 | 0.542 ± 0.080 | 0.582 ± 0.053 | 0.600 ± 0.051 | 0.653 ± 0.037 | 0.684 ± 0.058 | 0.897 ± 0.008 | 0.920 ± 0.008 |
Training size натыйжасы
Эки модельде тең жалпы тенденция training data көбөйгөн сайын test accuracy жогорулашы.
Булак өзгөчө болжол менен:
\[ 12\,000 \]
sample'дан кийин gains жайыраак болуп, saturation/diminishing-returns жүрүмү башталганын белгилейт.
HQiCNNдин эң ачык салыштырмалуу артыкчылыктары small-to-intermediate data regime ортосунда байкалат. Ал эми эң чоң training set үчүн классикалык CNN:
\[ 0.937\pm0.006 \]
менен изилдөөдөгү эң жогорку жалпы OCT accuracy'ге жеткен.
HQiCNNдин 30000 sample, learning rate 0.001 мааниси:
\[ 0.931\pm0.008 \]
деп билдирилет.
Демек изилдөө “HQiCNN бардык маалымат көлөмүндө CNNден жакшы” деген тыянакты колдобойт.
Learning rate натыйжасы
Булак:
\[ 10^{-3} \]
learning rate жалпы accuracy жана optimization stability ортосунда эң тең салмактуу вариант экенин белгилейт.
\(10^{-2}\) айрым configurations'да жогорку натыйжа бергени менен seed/configuration variation чоңураак.
\[ 10^{-4} \]
көпчүлүк учурда төмөнүрөөк accuracy берген жана булак муну optimization allocated training budget ичинде өтө conservative болуп калганы менен байланыштырган.
Бул жыйынтык бул жерде колдонулган architectures, datasets жана training budget үчүн гана жарактуу; бардык neural networks үчүн универсалдуу optimum learning rate эмес.
Figure 3төгү interpolation эскертүүсү
Булак small/intermediate training-size аймагындагы HQiCNN–CNN mean-accuracy difference маанилерин heatmap менен көрсөтөт.
Heatmap кириштери discrete measured configurations; булак caption визуалды smooth кылуу үчүн interpolation колдонулганын ачык айтат.
Ошондуктан Verianla interpolated color field'ден жаңы так numeric values окуган эмес, булак Table 2деги чыныгы discrete values'ды source-of-truth катары сактаган.
Batch size натыйжасы
Training size 1000 үчүн batch sizes:
\[ 8,\ 16,\ 32 \]
салыштырылган.
Булактын Figure 4(a) түшүндүрмөсү HQiCNN үч batch size'дын баарында mean accuracy жана stability боюнча классикалык CNNден жакшы экенин билдирет.
Figure 4(a)дагы individual box-plot values өзүнчө numeric table катары берилбегендиктен Verianla bar/box positions'дан так жаңы сандарды чыгарбайт.
Entanglement натыйжасы
Entangled circuit CNOT layer камтыйт, non-entangled модель болсо ошол entangling gates жок иштейт.
Булактын жыйынтыгы:
- орточо non-entangled configuration жакшыраак натыйжа берет,
- 1000 жана 1200 training samples үчүн entangled configuration accurate жана stable көрүнөт,
- жалпы күчтүү аткарым үчүн entanglement милдеттүү эмес.
Булак ошондой эле output observables local болгондуктан entanglement түзгөн higher-order correlations толугу менен көрүнбөй калышы мүмкүн экенин ыктымал түшүндүрмө катары айтат.
Бул далилденген механизм эмес; авторлордун жыйынтыкты чечмелөөсү.
Non-entangled схема масштабдуулук үчүн эмне үчүн маанилүү?
Булак separable circuit classical emulation complexity qubit саны менен linear масштабдалышы мүмкүн экенин; entangled circuit simulation болсо жалпы учурда exponential complexity жаратышы мүмкүн экенин белгилейт.
Ошондуктан окшош classification accuracy entanglement жок алынса, чоңураак emulated circuitтерге өтүү computational жактан ишке ашырууга ыңгайлуу болушу мүмкүн.
Бул жыйынтык чыныгы quantum hardware үчүн түз “entanglement колдонбогула” деген сунуш эмес.
Observable sets
Булак үч nested observable set аныктайт.
Булак белгилөөсү менен:
\[ O_1 = \{\Gamma_i\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i\in\{1,4\}. \]
\[ O_2 = O_1 \cup \{\Gamma_i\Gamma_j\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j\in\{1,4\}, \quad i\neq j. \]
\[ O_3 = O_1 \cup O_2 \cup \{\Gamma_i\Gamma_j\Gamma_k\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j,k\in\{1,4\}, \quad i\neq j\neq k. \]
Белгилөө эскертүүсү: Булак текстинде төрт-qubit circuit үстүндө local, pairwise жана triple observables аныкталганы ачык айтылган, бирок индекс топтомдору literal түрдө \(\{1,4\}\) деп басылган. Бул белгилөө болгону эки индексти камтыгандыктан контекстке толук шайкеш көрүнбөйт. Verianla белгилөөнү \(\{1,\ldots,4\}\) түрүнө унчукпай өзгөрткөн эмес.
Observable-set натыйжасы
Small жана intermediate training sizes'да \(O_1\), \(O_2\) жана \(O_3\) ортосунда ачык аткарым айырмасы байкалбайт.
Булак муну low-data regime'де модель feature-space expressivity'ден мурда training data көлөмү менен чектелет деп чечмелейт.
Large-data regime'де, айрыкча:
\[ 12\,000 \quad\text{ve}\quad 30\,000 \]
training samples үчүн байыраак observable sets slightly higher accuracy берет.
Булак бул жыйынтыкты hardware жагынан да талкуулайт: non-commuting кошумча observables чыныгы hardware'де кошумча measurement budget талап кылат. Emulated setting'де болсо мындай physical shot overhead жок.
Figure 4(c) булагындагы caption катасы
Figure 4(c) графиги жана аны курчаган текст \(O_1,O_2,O_3\) observable-set comparison'ын көрсөтөт.
Бирок subfigure caption булакта кайрадан:
“Accuracy comparison ... for different batch sizes”
маанисиндеги сөз айкашын колдонот.
Ошондуктан Verianla Figure 4(c)ни observable-set experiment катары, негизги тексттин түшүндүрмөсү жана graph legend менен шайкеш сүрөттөп, булак captionындагы дал келбестикти да ачык калтырат.
OASIS robustness натыйжасы
OCT experiments'те аныкталган жакшы-performing hyperparameters OASIS dementia classification көйгөйүнө өткөрүлгөн.
Булак Figure 5те үч training size көрсөтөт:
\[ 999,\ 3000,\ 12000. \]
999 саны үч classes арасында balanced dataset түзүү зарылдыгынан колдонулган.
Figure 5тин булак түшүндүрмөсү:
- кичине training size'да HQiCNN классикалык CNNден жакшы,
- training size көбөйгөн сайын айырма азаят,
- эң чоң training size'да классикалык CNN бир аз алдыга чыгат.
Figure 5тин raw box-plot observations сандык таблица түрүндө жарыяланбагандыктан бул жерде графиктен жаңы так accuracy маанилери алынган эмес.
Бул experiment авторлордун өз сөзү менен robustness check; clinical conclusion чыгарууга арналган эмес.
SHAP explainability натыйжалары
OCT explainability experiment үчүн ар бир модельдө 10 seeds ичинен accuracyсы моделдин mean accuracy маанисине эң жакын seed тандалган.
Булак attribution maps'та эки модель өзгөчө:
- retinal pigment epithelium (RPE),
- retinal layers,
- disease-associated elevations/deformations
айланасындагы анатомиялык аймактарга көңүл бурганын белгилейт.
1000 training sample шартында HQiCNN attribution maps көбүрөөк localized жана anatomically coherent көрүнөт, ал эми classical CNN көбүрөөк fragmented attribution distribution көрсөтөт.
30000 sample'га жеткенде эки моделдин attribution overlap'ы кыйла көбөйөт.
Бул байкоолор attribution pattern деңгээлинде; клиникалык диагноз механизминин себептик валидациясы эмес.
\(EMD_{pos}\) натыйжалары
| Training size | EMDpos | Түшүндүрмө |
|---|---|---|
| 1000 | 0.066 ± 0.019 | Эки моделдин ортосунда төмөн, бирок 30000-sample абалына салыштырмалуу чоңураак spatial айырма |
| 30000 | 0.045 ± 0.018 | Жогорураак SHAP-spatial agreement |
Эки маани тең theoretical upper bound:
\[ 1.3921 \]
маанисине салыштырмалуу кыйла төмөн.
Булак ошондой эле same-image EMD distributions ар башка сүрөттөрдүн ортосундагы cross-image reference distribution'дан төмөн экенин билдирет.
Бул жыйынтык эки модель бир эле сүрөттө окшош анатомиялык regions'га positive attribution бергени менен шайкеш.
Бирок төмөн \(EMD_{pos}\):
- модель клиникалык жактан туура себептик түшүндүрмө берди,
- табылган аймак validated biomarker,
- модель оорунун патофизиологиясын үйрөндү
дегенди билдирбейт.
Бул Изилдөө “Кванттык Артыкчылыкты” Көрсөтөбү?
Жок; изилдөө чыныгы кванттык жабдыкка салыштырмалуу классикалык компьютердин артыкчылыгы же эсептөө татаалдыгы маанисинде quantum advantage көрсөткөн эмес. HQiCNNдин аралык катмары классикалык компьютерде эмуляцияланган жана натыйжалар белгилүү маалымат/оптималдаштыруу режимдеринде гана бул кванттан шыктанган көрсөтүү parameter-controlled классикалык CNNге альтернатива боло аларын көрсөтөт.
Изилдөөнүн жыйынтык бөлүмүндөгү эң маанилүү сүйлөмдөрдүн бири HQiCNN артыкчылыгы жөн гана “quantum operations кошулганынан” келип чыкпасын белгилейт.
Аткарым:
- training data көлөмү,
- learning rate жана optimization dynamics,
- entanglement тандоосу,
- observable set
менен кошо өзгөрөт.
Ошондуктан “кванттык layer бардык учурда жакшыраак representation үйрөнөт” деген жалпы тыянак булак тарабынан колдоого алынбайт.
Изилдөө колдогон жыйынтыктар
- Төрт-qubitтик эмуляцияланган quantum circuit классикалык CNNдин аралык dense layer'ына альтернатива representation layer катары колдонулушу мүмкүн.
- HQiCNN орто көлөмдөгү айрым training-data regimes'де классикалык CNNге караганда жогорку test accuracy берген.
- Классикалык CNN эң чоң OCT training set'инде изилдөөнүн эң жогорку жалпы accuracy маанисине жеткен.
- Learning rate менен training size'дын өз ара таасири эки архитектуранын айырмасына олуттуу таасир берет.
- 10−3 learning rate изилдөө шарттарында эң тең салмактуу/stable вариант деп билдирилген.
- Batch sizes 8, 16 жана 32 шартында 1000-sample OCT experiment'те HQiCNN артыкчылыгы сакталган.
- Entanglement жалпы күчтүү аткарым үчүн милдеттүү эмес.
- Large-data regime'де байыраак observable sets кичине, бирок өлчөнө турган жакшыртуу берген.
- OASIS robustness test'инде small-data → HQiCNN артыкчылыгы, large-data → CNN артыкчылыгына өткөн окшош тенденция байкалган.
- \(|SHAP|IoU\) жана \(EMD_{pos}\) эки моделдин attribution patterns'ын салыштыруу үчүн колдонулган.
- 1000 sample'да HQiCNN SHAP maps көбүрөөк localized көрүнүп, 30000 sample'да моделдердин attribution distributions'ы көбүрөөк окшошкон.
Изилдөө колдобогон жыйынтыктар
- Чыныгы кванттык компьютер CNNге караганда медициналык сүрөттөрдү жакшыраак классификациялай турганы көрсөтүлгөн эмес.
- Quantum computational advantage же asymptotic quantum speedup көрсөтүлгөн эмес.
- HQiCNN бардык datasets жана бардык training sizes үчүн CNNден артык экени көрсөтүлгөн эмес.
- Entanglement классификация ийгилиги үчүн милдеттүү экени көрсөтүлгөн эмес.
- SHAP regions клиникалык тастыкталган biomarker эмес.
- OASIS labels formal CDR clinical assessments эмес.
- Модель ооруканада колдонуу үчүн prospective түрдө валидацияланган эмес.
- Көз карандысыз multicenter external clinical validation жүргүзүлгөн эмес.
- Clinician reader study жүргүзүлгөн эмес.
- MRI classification full 3D volume боюнча жасалган эмес; 2D slices колдонулган.
- Training time, inference speed, memory use жана жалпы computational efficiency benchmark кылынган эмес.
- Чыныгы quantum-hardware noise, decoherence жана finite-shot measurement error сыналган эмес.
Негизги чектөөлөр
- Quantum circuit болгону төрт qubit жана shallow emulated түзүлүштө.
- Чыныгы quantum hardware колдонулган эмес.
- Hardware connectivity constraint жок.
- Finite-shot measurement uncertainty жок.
- Decoherence же gate noise жок.
- OASIS robustness task 2D slices'га түшүрүлгөн.
- Independent external clinical dataset validation жетишпейт.
- Clinician reader study жетишпейт.
- Computational-cost comparison жүргүзүлгөн эмес.
- Code public repository катары берилген эмес; corresponding authors'тан reasonable request менен берилиши мүмкүн экени айтылган.
- “Parameter-matched” деген сөз колдонулганына карабастан manuscript эки моделдин жалпы trainable-parameter сандарын ачык numeric comparison таблицада бербейт.
Булактагы маанилүү отчеттук эскертүүлөр
- Figure 3 caption'да “red areas” ордуна “read areas” деген ката бар; heatmap'теги кызыл аймактар HQiCNN жакшыраак болгон жерлер.
- Figure 3 discrete configurations'дан түзүлгөнүнө карабастан визуалдык smoothness үчүн interpolation колдонот.
- Figure 4(c) observable-set салыштыруусу болсо да subfigure caption batch-size comparison деп жазылган.
- Observable индекстери төрт-qubit контекстинде \(i,j,k\in\{1,4\}\) түрүндө басылган; булак бул literal setпи же 1–4 индекс аралыгынын кыскартылган/ката жазылышыбы түшүндүрбөйт.
- “Parameter-matched” деген сөз булакта колдонулат, бирок total trainable-parameter counts өзүнчө сандык таблица катары берилбейт.
Булак жана Ыкма Жөнүндө Эскертүү
Оригиналдуу аталыш: Do emulated quantum circuits change what CNNs look at? Performance and explainability comparison in medical image classification
Авторлор: Guillermo Rubiños Rodríguez; Martín Ottavianelli; Mateo Alonso; Gonzalo Blázquez Gil; Boris-Stephan Rauchmann; Pablo Díez-Valle; Sergio Altares-López.
Авторлордун ирети: Булактагы ирет толугу менен сакталган.
Тең салым: Pablo Díez-Valle жана Sergio Altares-López булакта тең салым кошкон авторлор катары белгиленген.
Corresponding author: Sergio Altares-López.
Corresponding-author e-почта: slopez@med.lmu.de
Мекеме 1: Instituto Tecnológico de Galicia, Cantón Grande 9, Planta 3, 15003 A Coruña, Spain.
Мекеме 2: Centro Singular de Investigación en Tecnoloxías Intelixentes (CiTIUS), Universidade de Santiago de Compostela, Santiago de Compostela, 15782, Spain.
Мекеме 3: Department of Neuroradiology, LMU University Hospital, Ludwig Maximilian University of Munich, Marchioninistraße 15, 81377 Munich, Germany.
Мекеме 4: Department of Psychiatry and Psychotherapy, LMU University Hospital, LMU Munich, Nussbaumstraße 7, 80336 Munich, Germany.
Булактын түрү: Quantum machine learning / medical image classification тармагындагы эсептөөчү preprint.
Платформа: arXiv.
arXiv: arXiv:2607.21186v1 [quant-ph].
Жөнөтүлгөн күнү: 23 июль 2026.
DOI: 10.48550/arXiv.2607.21186.
Рецензиялоо абалы: Каралган булак arXiv preprint версиясы. Библиографиялык текшерүүдө ушул эле иш үчүн өзүнчө жана тастыкталган акыркы рецензияланган журнал версиясы табылган эмес.
Лицензия: arXiv жазуусунун metadataсында arXiv non-exclusive distribution license көрсөтүлгөн; Creative Commons лицензиясы бар деп божомолдонгон эмес.
Барактардын саны: 17.
Сүрөттөрдүн саны: 6.
Таблицалардын саны: 2.
Негизги изилдөө түрү: Бар болгон medical-image datasets үстүндө supervised machine-learning benchmark жана explainability analysis.
Quantum изилдөө түрү: Чыныгы quantum hardware эмес; төрт-qubitтик параметрдик circuit'тин classical emulation'ы.
Quantum implementation: Native PyTorch operations; dedicated quantum-computing framework колдонулган эмес.
Gradient ыкмасы: Emulated circuit үчүн automatic differentiation/backpropagation; physical-circuit parameter-shift measurement колдонулган эмес.
Classical baseline: Жалпы convolutional backbone + \(4\rightarrow12\) ReLU dense layer.
HQiCNN branch: Жалпы convolutional backbone + 4-qubit emulated parameterized quantum circuit + 12 observable output.
Input preprocessing: 2π·sigmoid(v), remainder(v,2π) жана no-transform салыштырылган; калган изилдөөдө scaled sigmoid тандалган.
Негизги OCT маалыматтар топтому: 84,495 JPEG retinal OCT image; NORMAL, CNV, DME жана DRUSEN класстары.
Robustness маалыматтар топтому: OASIS-1-derived structural MRI; булак 416 subject, 18–96 жаш аралыгын билдирет.
OASIS task класстары: Non Demented, Very Mild Dementia, Mild/Moderate Dementia.
CDR чеги: OASIS labels formal clinical CDR assessment эмес; булак болжол менен corresponding CDR stages түрүндө гана байланыш түзөт.
Input resolution: 64 × 64 pixel.
Input normalization: [0,1].
OCT hyperparameter executions: 640.
Random seeds: 10.
Maximum epochs: 100.
Early stopping patience: 8 epoch.
LR scheduler patience: 3 epoch.
LR reduction factor: 0.3.
Loss: Cross-entropy.
OCT highest reported accuracy: CNN, learning rate 0.001, 30000 training samples: \(0.937\pm0.006\).
Explainability ыкмалары: \(|SHAP|IoU\) жана \(EMD_{pos}\).
EMDpos: 1000 samples үчүн \(0.066\pm0.019\); 30000 samples үчүн \(0.045\pm0.018\).
EMDpos theoretical range: \(0\le EMD_{pos}\le(63/64)\sqrt2\approx1.3921\).
External clinical validation: Жок.
Clinician reader study: Жок.
MRI dimensionality: Full 3D classification ордуна processed 2D axial slices колдонулган.
Computational-cost analysis: Training time, inference efficiency жана memory requirements системалуу benchmark кылынган эмес.
Data availability: OCT data булак шилтемесиндеги бар datasetке; OASIS1-derived images жана preprocessing data булакта көрсөтүлгөн dataset булактарына негизделет.
Code availability: Corresponding authors'тан reasonable request боюнча берилиши мүмкүн экени айтылган; булак public code repository бербейт.
Каржылоо: PESL-Stiftung-Alzheimer 2026, Bayern, Germany, registered project 80765114 Pesl-Alzheimer-Stift; Principal Investigator Dr.-Ing. Sergio Altares-López. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Gonzalo Blázquez Gil жана Pablo Díez-Valle ошондой эле CDTI CERVERA Research Programme тарабынан каржыланган ARQADE (CER-20251019) колдоосун тааныйт.
Авторлордун салымы: Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle жана Sergio Altares-López experiments'ти долбоорлоп жана пландаштырган. Guillermo Rubiños Rodríguez жана Martín Ottavianelli experiments'ти жүргүзгөн. Gonzalo Blázquez Gil, Sergio Altares-López жана Boris-Stephan Rauchmann funding камсыз кылган. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle жана Sergio Altares-López results interpretation'га салым кошкон. Guillermo Rubiños Rodríguez жана Sergio Altares-López manuscript writing'де негизги роль ойногон. Бардык авторлор critical feedback берип, изилдөөнүн, анализдин жана manuscript'тин калыптанышына салым кошкон.
Кызыкчылыктардын кагылышы: Авторлор competing financial interests жок экенин билдиришет.
Өзүнчө ethics statement: Жүктөлгөн preprintте өзүнчө institutional-review/ethics-approval statement бөлүмү көрүнбөйт. Изилдөө жаңы patient recruitment ордуна бар datasets үстүндө computational analysis жүргүзөт; мындан ары этикалык уруксат абалы булактын атынан божомол менен толукталган эмес.
Кайталануу текшерүүсү: Бул exact аталыш жана arXiv:2607.21186 үчүн мурдагы Verianla иштетүү жазуусу жок болгондуктан жаңы макала катары даярдалган.
Булактагы отчеттук эскертүүлөр: Figure 4(c) caption observable-set graph'ты batch-size comparison деп белгилейт; observable-index notation'да \(\{1,4\}\) колдонулушу контекст жагынан бүдөмүк; Figure 3 interpolation колдонот; total model parameter counts өзүнчө numeric table катары берилген эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген