


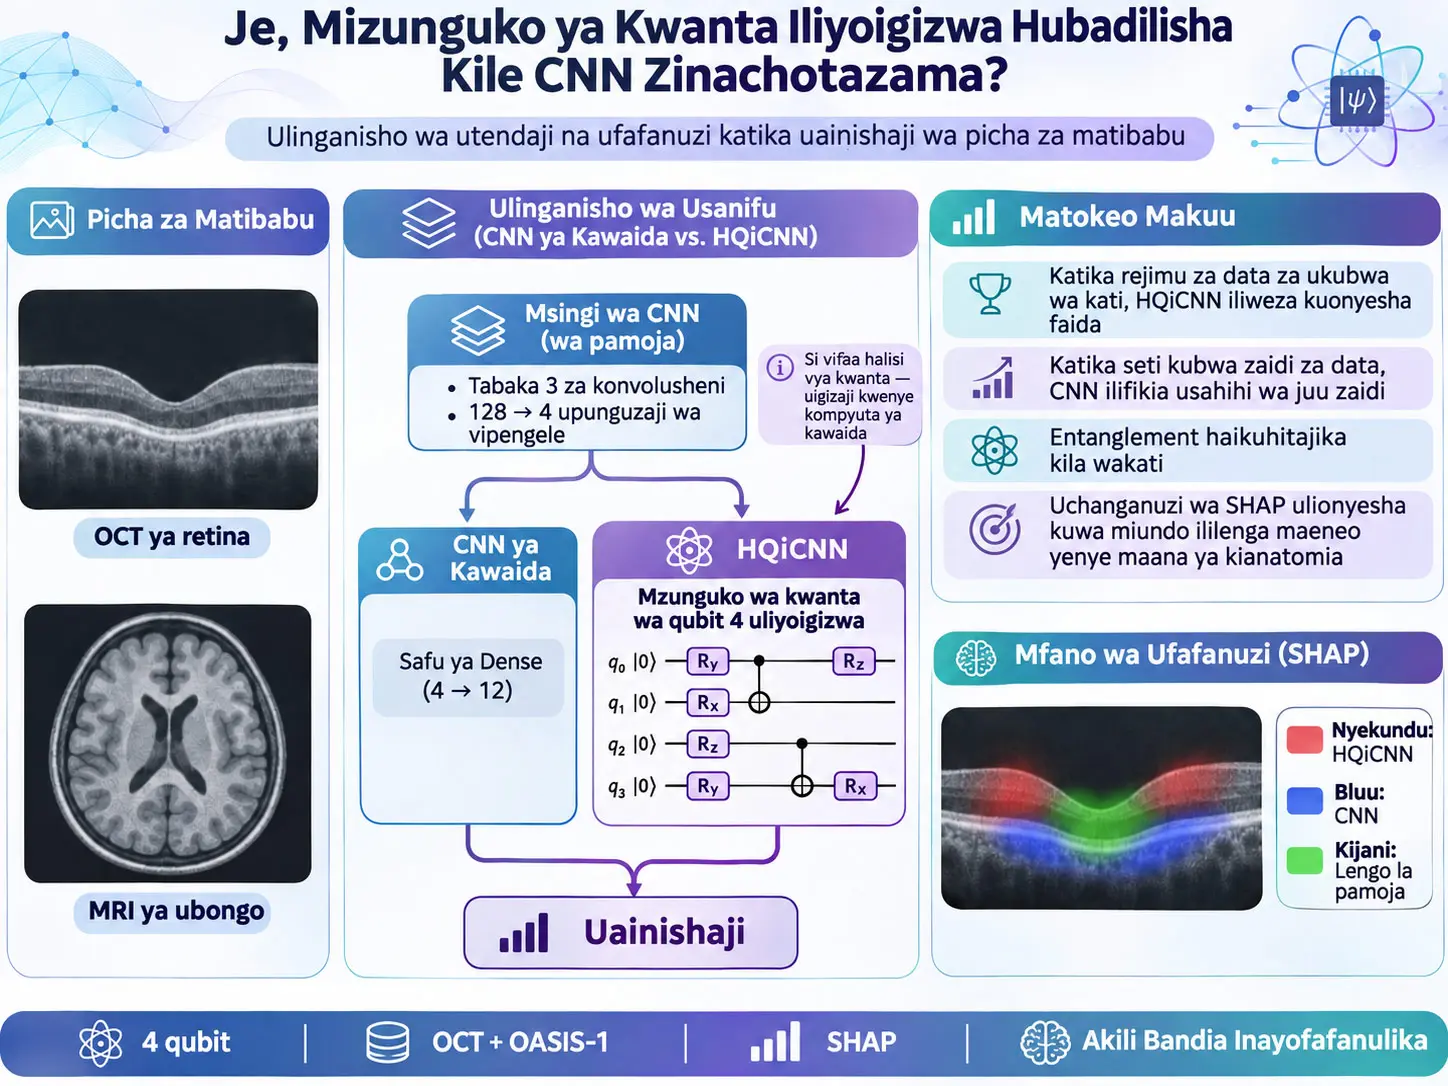
Mtandao Mseto wa Neva wa Konvolusheni Uliochochewa na Kwanta (Hybrid Quantum-inspired Convolutional Neural Network, HQiCNN) ni modeli ya uainishaji wa picha inayohifadhi uti wa mgongo wa kawaida wa CNN wa uchimbaji wa vipengele vya picha, lakini badala ya classical dense layer katika safu ya uwakilishi wa kati hutumia mzunguko wa kwanta wenye vigezo wa qubit nne unaoigizwa kwenye kompyuta ya kawaida. Utafiti unalinganisha HQiCNN na CNN ya kawaida inayotumia convolutional backbone ileile kwenye picha za retinal optical coherence tomography (OCT) na picha za MRI za ubongo zilizoandaliwa kwa upangaji wa hatua za demensia. Swali kuu la utafiti ni kama mzunguko mdogo wa kwanta unaoweza kuigizwa kwa njia ya kawaida unaweza, bila kuhitaji vifaa halisi vya kwanta, kubadilisha kwa maana uwakilishi wa kati unaojifunzwa na CNN na maeneo ya picha ambayo modeli huyapa umuhimu.
Modeli zote mbili hutumia convolutional backbone ileile ili kulinganisha usanifu kwa udhibiti mkubwa iwezekanavyo. Picha kwanza hubadilishwa na convolutional block ya tabaka tatu kuwa feature vector yenye vipimo 128; kisha linear reduction hupunguza vekta hii hadi vipimo 4. Katika tawi la CNN ya kawaida, vipengele hivi vinne huingia kwenye \(4\rightarrow12\) dense layer yenye uanzishaji wa ReLU, ilhali katika tawi la HQiCNN vipengele vinne hupelekwa kwa angle encoding kwenye mzunguko wa kwanta wa qubit nne ulioigizwa. Mzunguko una \(R_Y\) input encoding, trainable \(R_X\) na \(R_Z\) rotations, pamoja na CNOT entanglement ya hiari. Kwa kusoma \(X\), \(Y\) na \(Z\) Pauli observables kwenye qubit nne, jumla ya 12 classical output feature hupatikana. Matokeo yenye vipimo 12 ya matawi yote mawili huenda kwenye aina ileile ya classical output layer.
Mzunguko huu haukuendeshwa kwenye quantum processor halisi. Kwa kuwa sehemu ya kwanta iliigizwa kwenye kompyuta ya kawaida kwa kutumia operesheni za kihisabati za asili za PyTorch, vikwazo vya kompyuta halisi ya kwanta kama hardware noise, decoherence, finite-shot measurement uncertainty na physical qubit connectivity havikujumuishwa kwenye benchmark. Muundo ulioigizwa pia unaweza kutumia ordinary backpropagation badala ya parameter-shift gradient estimation ambayo ingehitajika kwenye quantum hardware.
Kwa OCT, training size, learning rate, batch size, circuit entanglement na ukubwa wa observable-set vilibadilishwa kwa utaratibu. Programu kuu ya OCT hyperparameter yenye training size tisa, learning rate tatu, batch size tatu, entangled/non-entangled circuit, observable set tatu na 10 random seed imeripotiwa kuwa na jumla ya 640 execution. Muda wa juu wa training ulikuwa 100 epoch, early-stopping patience epoch nane, learning-rate-scheduler patience epoch tatu na reduction factor 0.3.
Matokeo yanaonyesha kuwa hakuna usanifu mmoja unaoshinda katika kila hali. Katika OCT, CNN ya kawaida ilifikia test accuracy ya juu zaidi kwa ujumla katika utafiti, %93.7, kwa training set kubwa zaidi. HQiCNN, kwa upande mwingine, ilitoa mean test accuracy ya juu kuliko CNN ya kawaida katika configuration nyingi za training sets za ukubwa wa kati, hasa karibu na sampuli 800–2000. Mwelekeo unaofanana ulionekana pia katika OASIS dementia robustness test; HQiCNN ilikuwa bora katika training sizes ndogo, tofauti ikapungua kadiri data ilivyoongezeka, na katika training size kubwa CNN ikawa mbele kidogo.
Entanglement kwa ujumla haikutoa faida ya lazima. Non-entangled circuit kwa wastani ilitoa utendaji unaofanana au bora katika configuration nyingi, huku entanglement ikitoa matokeo sahihi na thabiti zaidi katika training sizes fulani, hasa katika viwango vya sampuli 1000 na 1200. Chanzo kinaona matokeo haya kuwa muhimu kwa sababu separable circuits huwa rahisi zaidi kuongezwa ukubwa katika uigaji wa kawaida, wakati gharama ya simulation ya entangled circuits hukua kwa kasi zaidi kadiri idadi ya qubit inavyoongezeka.
Katika sehemu ya Explainability, watafiti wanapendekeza zana mbili zinazotegemea SHAP. \(|SHAP|IoU\) huonyesha kwa picha mwingiliano wa maeneo ya picha yenye %10 ya juu zaidi ya absolute SHAP values kwa modeli hizo mbili. \(EMD_{pos}\) hupima kwa namba tofauti ya kijiometri kati ya positive SHAP distributions za modeli hizo mbili kwa kutumia mbinu ya Earth Mover's Distance/Wasserstein. Katika OCT, wastani wa \(EMD_{pos}\) ulikuwa \(0.066\pm0.019\) kwa 1000 training sample na \(0.045\pm0.018\) kwa 30000 sample. Kupungua kwa thamani kadiri data inavyoongezeka kunaonyesha kuwa maeneo ya positive attribution ya modeli hizo mbili yanafanana zaidi.
Hata hivyo, utafiti huu si uthibitishaji wa mfumo wa utambuzi wa kliniki. Ingawa ramani za SHAP kujikusanya katika retinal pigment epithelium na maeneo ya anatomia yanayohusiana na ugonjwa ni ishara yenye maana ya anatomia, waandishi wanaeleza wazi kuwa maeneo haya si biomarker zilizothibitishwa kliniki. Pia hakuna independent external clinical validation, clinician reader study, full 3D MRI analysis wala training/inference computational-cost comparison iliyofanywa.
HQiCNN ni Nini na Je, Utafiti Huu Unatumia Kompyuta Halisi ya Kwanta?
HQiCNN ni modeli ya uainishaji ya hybrid quantum-inspired inayobadilisha dense representation layer ya kati ya uti wa mgongo wa CNN ya kawaida na mzunguko wa kwanta wenye vigezo wa qubit nne ulioigizwa; katika utafiti huu hakuna prosesa ya kwanta ya kimwili iliyotumika, na mzunguko wa kwanta uliigizwa kihisabati kwenye kompyuta ya kawaida kwa kutumia PyTorch.
“Quantum-inspired” hapa inamaanisha nini hasa?
Katika utafiti huu, neno “quantum-inspired” si lebo ya jumla ya masoko pekee. Safu ya kati ya HQiCNN ina muundo wa parameterized circuit wa qubit nne unaotumia hisabati halisi ya quantum-circuit:
- classical features huwekwa katika mfumo wa qubit rotation angles,
- qubit states hubadilishwa kwa unitary rotation matrices,
- trainable \(R_X\) na \(R_Z\) rotations hutumika,
- katika entangled configuration CNOT gates hutumika,
- kutoka state ya mwisho hupatikana classical outputs zinazofanana na expectation-value za \(X\), \(Y\) na \(Z\) Pauli observables.
Lakini operesheni hizi zote huhesabiwa kwa tensor/matrix operations kwenye kompyuta ya kawaida, si kwenye physical qubits. Tofauti hii ni muhimu sana: chanzo hakisemi “tulifanya uainishaji wa picha za matibabu kwa kutumia kompyuta ya kwanta”.
Qubit ni nini?
Qubit ni kitengo cha taarifa ya kwanta kinachofafanuliwa ndani ya Hilbert space changamani yenye vipimo viwili. Chanzo hutoa qubit state ya msingi kama:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle = \begin{bmatrix} \alpha\\ \beta \end{bmatrix} \]
.
Sharti la Normalization:
\[ |\alpha|^2+|\beta|^2=1 \]
lazima litimizwe.
Hapa:
- \(|0\rangle\) na \(|1\rangle\): computational basis states,
- \(\alpha\) na \(\beta\): complex probability amplitudes,
- \(|\alpha|^2\) na \(|\beta|^2\): ni Born-rule probabilities za basis outcome husika katika ideal measurement.
Superposition inamaanisha kuwa kabla ya kupimwa qubit si lazima iwe \(|0\rangle\) pekee au \(|1\rangle\) pekee, bali inaweza kuwakilishwa kama normalized linear combination ya basis states hizi.
Katika makala hii qubit state haiandaliwi kwenye kifaa cha kimwili; state vector hiyo hiyo ya kihisabati huhifadhiwa kwenye hesabu ya kawaida.
Hilbert space ni nini?
Hilbert space ni complex inner-product vector space ambamo quantum state vectors hufafanuliwa. Kwa qubit moja, space ya msingi ina vipimo viwili. Qubit nyingi zinapounganishwa kwa tensor product, state-space dimension huongezeka. Kwa qubit nne, pure-state vector ya jumla ina:
\[ 2^4=16 \]
complex amplitude.
Nambari hii si matokeo mapya ya utafiti; ni maelezo ya msingi ya taarifa ya kwanta yanayofafanua maana ya kihisabati ya muundo wa state-space wa qubit nne.
Quantum gate ni nini?
Quantum gate ni unitary operator inayofanya acting kwenye quantum state. Kwa kuwa sharti la unitary ni:
\[ U^\dagger U=I \]
norm ya state huhifadhiwa.
Circuit gates kuu za utafiti ni \(R_X\), \(R_Y\), \(R_Z\) na CNOT.
Mizunguko ya \(R_X\), \(R_Y\) na \(R_Z\) iliyotolewa kwenye chanzo
Chanzo katika Mlinganyo (1) kinatumia:
\[ R_X(\theta) = \begin{bmatrix} \cos(\theta/2) & -i\sin(\theta/2)\\ -i\sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Y(\theta) = \begin{bmatrix} \cos(\theta/2) & -\sin(\theta/2)\\ \sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Z(\theta) = \begin{bmatrix} e^{-i\theta/2} & 0\\ 0 & e^{i\theta/2} \end{bmatrix}. \tag{1} \]
matrices hizi.
Matices hizi ni unitary transformations zinazozungusha qubit state kwenye Bloch sphere kuzunguka mihimili ya \(x\), \(y\) na \(z\) mtawalia kwa pembe \(\theta\).
\(\theta\) ni parameter ya pembe isiyo na kipimo na hutafsiriwa katika radians. Kulingana na input-dependent au trainable parameter imewekwa kwenye gate gani ndani ya circuit, \(\theta\) inaweza kuwa encoded classical feature au model parameter inayojifunzwa wakati wa optimization.
Pauli observables ni nini?
Chanzo katika Mlinganyo (2) kinatoa Pauli matrix tatu za msingi:
\[ X= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix}, \qquad Y= \begin{bmatrix} 0&-i\\ i&0 \end{bmatrix}, \qquad Z= \begin{bmatrix} 1&0\\ 0&-1 \end{bmatrix}. \tag{2} \]
Pauli matrices zina jukumu kuu katika kuunda quantum gates/rotations na pia katika kutoa classical information kutoka quantum state kama observables.
Katika configuration kuu ya HQiCNN, kwa kila moja ya qubit nne, local observable tatu:
\[ X,\ Y,\ Z \]
hutathminiwa, kwa hiyo:
\[ 4\ \text{qubit}\times3\ \text{observable}=12 \]
classical feature huzalishwa.
Entanglement ni nini?
Entanglement ni aina ya quantum correlation ambapo state ya mfumo wa kwanta wenye sehemu nyingi haiwezi kutenganishwa kuwa tensor product ya subsystem states huru.
Kwa mfano, ikiwa state ya jumla ya qubit mbili:
\[ |\psi\rangle \neq |\psi_A\rangle\otimes|\psi_B\rangle \]
basi state inaweza kuwa entangled.
Katika toleo la entangled la HQiCNN, linear CNOT layer hutumika kati ya qubits. Katika toleo la non-entangled, coupling hii huondolewa.
Matokeo muhimu ya utafiti huu ni kwamba entanglement si lazima kwa utendaji wa jumla. Hili halimaanishi “entanglement haina manufaa katika kila quantum machine-learning model”; limeorodheshwa tu kwa HQiCNN ya qubit nne, datasets na measurement scheme zilizotumika hapa.
Parameterized Quantum Circuit ni nini?
Parameterized Quantum Circuit (PQC) ni muundo wa quantum circuit ambapo baadhi ya gate angles ni trainable parameters. Classical machine-learning optimizer husasisha parameters hizi ili kupunguza training loss.
Katika chanzo, HQiCNN circuit:
- hupokea 4-dimensional classical vector,
- huweka kila component kwenye qubit moja kwa \(R_Y\) angle encoding,
- hutumia trainable \(R_X\) na \(R_Z\) rotations,
- hutumia CNOT gates katika toleo la entangled,
- hutoa 12-dimensional classical representation kutoka kwa kipimo cha Pauli observables.
Ulinganisho Kati ya CNN na HQiCNN Ulidhibitiwaje?
Modeli zote mbili zinatumia convolutional feature extractor ileile, 128→4 linear reduction ileile na safu ya mwisho ileile inayoenda kutoka representation yenye vipimo 12 hadi classification output; tofauti kuu ya usanifu ni kwamba \(4\rightarrow12\) ReLU dense layer katika CNN ya kawaida hubadilishwa na circuit yenye vigezo ya qubit nne iliyoigizwa katika HQiCNN.
Convolutional backbone ya pamoja
Medical image ya kuingiza huingia kwenye block ya pamoja yenye convolutional layer tatu. Chanzo kinaeleza kwa kila layer:
- Conv2D,
- kernel size 3,
- Batch Normalization,
- Max Pooling,
- ReLU
vipengele hivi.
Mwishoni mwa block hii picha hubadilishwa kuwa:
\[ 128 \]
feature vector yenye vipimo hivyo.
Linear reduction
Linear reduction layer isiyotumia Activation hufanya mabadiliko:
\[ 128\rightarrow4 \]
.
Kwa hiyo modeli zote mbili hupokea four-dimensional latent representation ileile.
Tawi la CNN ya kawaida
Classical branch hutumia:
\[ 4\rightarrow12 \]
dense layer na ReLU activation.
Tawi la HQiCNN
HQiCNN hu-angle-encode four-dimensional vector hiyo hiyo kwenye qubit nne na baada ya quantum-circuit representation huzalisha:
\[ 4\ \text{qubit} \times 3\ \text{local Pauli observable} = 12 \]
output feature.
Classification layer ya mwisho
Representation yenye vipimo 12 ya branch zote mbili huenda kwenye output layer ya pamoja. Output dimension ni sawa na idadi ya label katika dataset:
- OCT: madarasa 4,
- OASIS robustness task: madarasa 3.
Kwa nini input hubadilishwa kwa \(2\pi\cdot\mathrm{sigmoid}(v)\)?
Parameterized rotation gates hutumia input ya pembe. Chanzo kililinganisha preprocessing strategy tatu kwa four-dimensional vector:
\[ v \]
.
Chaguo la kwanza:
\[ \widetilde v = 2\pi\cdot\operatorname{sigmoid}(v). \]
Kwa kuwa Sigmoid hukandamiza hadi:
\[ (0,1) \]
iki multiplied by \(2\pi\), angle range huwa:
\[ (0,2\pi) \]
.
Chaguo la pili ni:
\[ \operatorname{remainder}(v,2\pi) \]
kwa periodic wrapping.
Chaguo la tatu ni kutumia raw \(v\) values bila explicit transform yoyote.
Chanzo kinasema scaled sigmoid transformation ilitoa consistently better performance kati ya chaguo hizi tatu na ilitumika katika majaribio yaliyobaki. Katika maandishi makuu, thamani zote za namba za preprocessing comparison hii hazikutolewa katika jedwali tofauti.
Kwa nini parameter-shift rule haitumiki hapa?
Katika physical au black-box quantum circuit, gradient ya trainable rotation parameters inaweza kuhesabiwa kwa parameter-shift rule. Kulingana na maelezo ya chanzo, kwa \(p\) trainable parameter mbinu hii huhitaji:
\[ 2p \]
forward circuit evaluation.
Kwa kuwa circuit hapa imeigizwa kikamilifu kwa differentiable PyTorch operations, automatic differentiation/backpropagation inaweza kutumika. Waandishi wanasisitiza kuwa gradients zote zinaweza kuhesabiwa pamoja ndani ya backward pass moja na gradient-computation evaluation scaling inapunguzwa kutoka hitaji la \(O(p)\) circuit passes hadi backward pass moja.
Hii si matokeo ya quantum-hardware speedup. Faida inatokana na kutumia differentiable software graph ya classical emulation.
Barren plateau ni nini na ilipimwa katika utafiti huu?
Barren plateau ni tatizo la optimization katika parameterized quantum circuits ambapo cost-function gradients zinaweza kuwa ndogo sana kadiri circuit size/depth inavyoongezeka, hivyo kufanya training kuwa ngumu.
Makala inataja barren plateau kama mojawapo ya vikwazo vya jumla vya scalability ya QML; lakini programu kuu ya majaribio iko kwenye shallow circuit ya qubit nne iliyoigizwa na haifanyi kipimo maalumu cha majaribio au exponent fitting kwa barren-plateau scaling.
Kwa hiyo haiwezi kuhitimishwa kuwa “utafiti huu umetatua tatizo la barren plateau”.
Seti ya data ya OCT
Seti ya data ya retinal optical coherence tomography ina jumla ya:
\[ 84\,495 \]
JPEG image na chanzo kinaeleza madarasa manne pamoja na standard training/test splits:
- NORMAL,
- CNV — choroidal neovascularization,
- DME — diabetic macular edema,
- DRUSEN.
Chanzo kinaeleza kuwa picha za seti hii ya data zilikusanywa kati ya 2013–2017 katika clinical center kadhaa za kimataifa kwa vifaa vya Spectralis OCT, na ophthalmologist review ya hatua nyingi ilitumika kwa label quality.
Hii ni sifa ya original OCT dataset; haimaanishi kuwa utafiti huu wa HQiCNN ulikusanya wagonjwa wapya.
Seti ya data ya OASIS-1 MRI
OASIS-1 structural MRI ilitumika kwa robustness analysis. Kulingana na chanzo dataset ina:
\[ 416 \]
subject na umri:
\[ 18-96 \]
miaka.
Mlolongo wa Preprocessing unaelezwa kama:
- kubadilisha 3D image files kuwa fomati ya NIfTI,
- reorientation kwenda standard anatomical orientation,
- bias-field correction,
- field-of-view cropping,
- skull stripping,
- 12-degree-of-freedom affine registration kwenda MNI152 template kwa 2 mm resolution,
- trilinear interpolation,
- tissue segmentation,
- kuunda white-matter partial-volume mask,
- kuhesabu white-matter mean intensity,
- Shinohara normalization,
- kutoa axial 2D slices kutoka registered 3D volume
.
Model inputs zote zilifanyiwa resize hadi:
\[ 64\times64 \]
pixel resolution na normalize hadi:
\[ [0,1] \]
.
Kwa nini madarasa ya OASIS hayapaswi kusomwa kama utambuzi halisi wa CDR?
Chanzo hubadilisha OASIS-derived labels kuwa vikundi vitatu:
- Non Demented,
- Very Mild Dementia,
- Mild/Moderate Dementia.
Waandishi wanaeleza wazi kuwa labels hizi si formal clinical CDR assessment.
Ulinganisho wa kukadiria tu ulifanywa kupitia severity descriptions:
- Non Demented ≈ CDR 0,
- Very Mild Dementia ≈ CDR 0.5,
- Mild/Moderate Dementia ≈ CDR ≥ 1.
Kwa kuwa darasa la Moderate Dementia lilikuwa na sample chini ya 500, liliunganishwa na Mild Dementia. Majority class pia ilifanyiwa downsample hadi ukubwa wa classes nyingine ili kusawazisha task ya madarasa matatu.
Kwa hiyo utafiti haukufundisha moja kwa moja formal CDR clinical scoring algorithm.
EMDpos Hupima Nini?
\(EMD_{pos}\) ni metriki ya explainability inayolinganisha normalized positive SHAP pixel distributions za HQiCNN na CNN ya kawaida kwa Earth Mover's Distance yenye vipimo viwili; kadiri thamani inavyopungua, ndivyo mgawanyo wa kijiometri wa maeneo ya picha yanayounga mkono uainishaji sahihi unavyofanana zaidi kati ya modeli hizo mbili.
SHAP ni nini?
SHAP ni model-agnostic explainability framework inayoeleza kwa mbinu ya Shapley-value jinsi input features zinavyochangia model prediction kwa mwelekeo na ukubwa.
Katika image model, feature inaweza kutafsiriwa kama pixel au pixel region. Positive SHAP value inaonyesha kuwa pixel husika ina contribution inayounga mkono output inayotathminiwa.
Maelezo haya ni feature attribution; peke yake si ushahidi wa biological causality au clinical biomarker.
\(|SHAP|IoU\) hutumikaje?
Chanzo huchagua kwa kila modeli sehemu ya juu ya:
\[ 10\% \]
ya absolute SHAP values na kuunda region-of-interest mask mbili:
\[ R_A,\ R_B \]
.
Katika Figure 6 ya chanzo:
- nyekundu: maeneo ambayo HQiCNN pekee hutoa attribution kubwa,
- bluu: maeneo ambayo CNN pekee hutoa attribution kubwa,
- kijani: maeneo ya pamoja ya modeli zote mbili
huonyeshwa.
Chanzo hakitoi formula ya scalar Intersection-over-Union iliyohesabiwa kama equation tofauti kwa \(|SHAP|IoU\); mbinu hutumika hasa kufanya spatial intersection kati ya top-%10 masks ionekane.
Formula ya \(EMD_{pos}\)
Kwanza positive SHAP values za modeli zote mbili hunormalishwa ili kupata two-dimensional probability distributions.
Chanzo Mlinganyo (3):
\[ EMD_{pos} = \min_{\gamma\in\Pi(\omega_{HQiCNN}\mid\omega_{CNN})} \sum_{i,j} \gamma_{i,j} \left\| p_i-p_j \right\|_2. \tag{3} \]
Hapa:
- \(\omega_{HQiCNN}\) na \(\omega_{CNN}\): normalized positive SHAP spatial distributions,
- \(\gamma_{i,j}\): kiasi cha probability mass kinachohamishwa kutoka pixel location \(i\) kwenda location \(j\),
- \(p_i,p_j\): normalized pixel coordinates,
- \(\|\cdot\|_2\): Euclidean distance,
- \(\Pi\): uandishi wa chanzo unaowakilisha seti ya admissible transport plans inayohifadhi marginals za distributions hizo mbili.
Chanzo hunormalisha pixel coordinate kama:
\[ p= \left( \frac{y}{64}, \frac{x}{64} \right) \]
.
64×64 image ina:
\[ 64\times64=4096 \]
grid point.
EMD haina kipimo cha kimwili cha mita, milimita au pixel; kwa sababu ya coordinate normalization, hapa hutumika kama spatial-distance metric isiyo na kipimo.
Kikomo cha chini na cha juu cha \(EMD_{pos}\)
Kwa Identical distributions:
\[ EMD_{pos}=0. \]
Chanzo huhesabu utengano wa juu wa kijiometri kupitia corners zinazokabiliana za image grid:
\[ D = \sqrt{ \left(\frac{63}{64}\right)^2 + \left(\frac{63}{64}\right)^2 } = \frac{63}{64}\sqrt2 \approx1.3921. \tag{4} \]
Kwa hiyo:
\[ 0 \le EMD_{pos} \le \frac{63}{64}\sqrt2 \approx1.3921. \tag{5} \]
hutolewa.
Thamani ndogo inaonyesha positive-SHAP spatial distribution za modeli hizo mbili zinafanana; thamani kubwa inaonyesha probability mass inahitaji kuhamishwa mbali zaidi.
Mbinu na Matokeo ya Utafiti
Muundo wa majaribio ya OCT hyperparameter
| Hyperparameter | Thamani | Idadi ya chaguo |
|---|---|---|
| Training size | 200, 400, 800, 1000, 1200, 1600, 2000, 12000, 30000 | 9 |
| Learning rate | 10−2, 10−3, 10−4 | 3 |
| Batch size | 8, 16, 32 | 3 |
| Quantum circuit | Entangled, Not Entangled | 2 |
| Observable set | O1, O2, O3 | 3 |
| Random seed | 10 randomly selected seeds | 10 |
Chanzo kinatoa jumla ya OCT hyperparameter executions kama:
\[ 9\times3\times10 + 3\times10 + 2\times8\times10 + 3\times6\times10 = 640 \]
.
Namba hii 640 inahusu programu ya OCT hyperparameter katika Table 1. OASIS robustness experiment haikuongezwa wazi kwenye jumla hii kwa formula tofauti.
Mipangilio ya Training
| Mpangilio | Thamani / mbinu iliyotolewa kwenye chanzo |
|---|---|
| Framework | PyTorch |
| Quantum emulation | Native PyTorch functions |
| Loss | Cross-entropy |
| Output softmax | Haitumiki; cross-entropy hufanya kazi kwenye unnormalized logits |
| Gradient handling | GradScaler |
| Maksimum epoch | 100 |
| Early-stopping patience | 8 epoch |
| Learning-rate scheduler patience | 3 epoch |
| Learning-rate reduction factor | 0.3 |
| Random repetitions | 10 seed |
Table 2: matokeo ya learning rate na training size
Thamani zifuatazo ni mean test accuracy ± standard deviation zilizoripotiwa katika Table 2 ya chanzo kwa 10 random seed.
| Model | LR | 200 | 400 | 800 | 1000 | 1200 | 1600 | 2000 | 12000 | 30000 |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN | 0.01 | 0.436 ± 0.104 | 0.495 ± 0.135 | 0.575 ± 0.049 | 0.670 ± 0.082 | 0.698 ± 0.098 | 0.749 ± 0.083 | 0.843 ± 0.020 | 0.929 ± 0.015 | 0.930 ± 0.010 |
| CNN | 0.001 | 0.467 ± 0.098 | 0.535 ± 0.125 | 0.633 ± 0.058 | 0.661 ± 0.074 | 0.734 ± 0.055 | 0.751 ± 0.076 | 0.774 ± 0.127 | 0.924 ± 0.010 | 0.937 ± 0.006 |
| CNN | 0.0001 | 0.311 ± 0.069 | 0.358 ± 0.078 | 0.550 ± 0.092 | 0.518 ± 0.132 | 0.628 ± 0.068 | 0.643 ± 0.049 | 0.672 ± 0.042 | 0.885 ± 0.011 | 0.919 ± 0.006 |
| HQiCNN | 0.01 | 0.325 ± 0.094 | 0.468 ± 0.105 | 0.551 ± 0.099 | 0.638 ± 0.092 | 0.714 ± 0.078 | 0.800 ± 0.032 | 0.818 ± 0.066 | 0.930 ± 0.009 | 0.929 ± 0.012 |
| HQiCNN | 0.001 | 0.448 ± 0.082 | 0.559 ± 0.076 | 0.688 ± 0.051 | 0.745 ± 0.074 | 0.769 ± 0.028 | 0.795 ± 0.055 | 0.828 ± 0.034 | 0.920 ± 0.008 | 0.931 ± 0.008 |
| HQiCNN | 0.0001 | 0.347 ± 0.089 | 0.414 ± 0.085 | 0.542 ± 0.080 | 0.582 ± 0.053 | 0.600 ± 0.051 | 0.653 ± 0.037 | 0.684 ± 0.058 | 0.897 ± 0.008 | 0.920 ± 0.008 |
Matokeo ya Training size
Kwa modeli zote mbili, mwelekeo wa jumla ni test accuracy kuongezeka kadiri training data inavyoongezeka.
Chanzo hasa kinaeleza kuwa baada ya takriban:
\[ 12\,000 \]
sample, gains hupungua kasi na tabia ya saturation/diminishing-returns huanza.
Faida za kulinganisha za HQiCNN zinaonekana zaidi katikati ya small-to-intermediate data regime. Kinyume chake, kwa training set kubwa zaidi, CNN ya kawaida ilifikia:
\[ 0.937\pm0.006 \]
ambayo ni global OCT accuracy ya juu zaidi katika utafiti.
Thamani ya HQiCNN kwa 30000 sample, learning rate 0.001 ni:
\[ 0.931\pm0.008 \]
.
Kwa hiyo utafiti hauungi mkono hitimisho kwamba “HQiCNN ni bora kuliko CNN katika kila ukubwa wa data”.
Matokeo ya Learning rate
Chanzo kinaeleza kuwa:
\[ 10^{-3} \]
learning rate kwa ujumla ndiyo chaguo lenye uwiano bora kati ya accuracy na optimization stability.
Ingawa \(10^{-2}\) hutoa utendaji wa juu katika baadhi ya configurations, seed/configuration variation huwa kubwa zaidi.
\[ 10^{-4} \]
kwa kawaida ilitoa accuracy ya chini na chanzo kilihusisha hali hii na optimization kubaki conservative sana ndani ya allocated training budget.
Matokeo haya yanatumika tu kwa architectures, datasets na training budget zilizotumiwa hapa; si universal optimum learning rate kwa neural networks zote.
Onyo la interpolation katika Figure 3
Chanzo kinaonyesha HQiCNN–CNN mean-accuracy difference katika eneo la small/intermediate training-size kwa heatmap.
Input za heatmap ni discrete measured configurations; caption ya chanzo inaeleza wazi kuwa interpolation ilitumika kufanya taswira iwe smooth zaidi.
Kwa hiyo Verianla haikusoma numeric values mpya za uhakika kutoka interpolated color field, bali ilihifadhi discrete values halisi katika Table 2 kama source-of-truth.
Matokeo ya Batch size
Kwa training size 1000, batch sizes:
\[ 8,\ 16,\ 32 \]
zililinganishwa.
Maelezo ya Figure 4(a) ya chanzo yanasema HQiCNN ilikuwa bora kuliko CNN ya kawaida katika batch size zote tatu kwa mean accuracy na stability.
Kwa kuwa individual box-plot values katika Figure 4(a) hazikutolewa kama numeric table tofauti, Verianla haitengenezi namba mpya za uhakika kutoka bar/box positions.
Matokeo ya Entanglement
Entangled circuit ina CNOT layer, ilhali non-entangled model hufanya kazi bila entangling gates hizo.
Matokeo ya chanzo:
- kwa wastani non-entangled configuration hutoa matokeo bora zaidi,
- kwa 1000 na 1200 training samples entangled configuration inaonekana accurate na stable zaidi,
- entanglement si lazima kwa utendaji mzuri wa jumla.
Chanzo pia kinapendekeza kama maelezo yanayowezekana kwamba local output observables huenda zisionyeshe kikamilifu higher-order correlations zinazoundwa na entanglement.
Huu si utaratibu uliothibitishwa; ni tafsiri ya waandishi ya matokeo.
Kwa nini non-entangled circuit ni muhimu kwa scalability?
Chanzo kinaeleza kuwa separable circuit classical emulation complexity inaweza kuongezeka kwa linear kulingana na idadi ya qubit, ilhali entangled circuit simulation katika hali ya jumla inaweza kuwa na exponential complexity.
Kwa hiyo ikiwa classification accuracy inayofanana inaweza kupatikana bila entanglement, kuhamia kwenye emulated circuit kubwa zaidi kunaweza kuwa rahisi zaidi kwa upande wa computational.
Matokeo haya si ushauri wa moja kwa moja wa “msitumie entanglement” kwa quantum hardware halisi.
Observable sets
Chanzo kinafafanua nested observable set tatu.
Kwa uandishi wa chanzo:
\[ O_1 = \{\Gamma_i\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i\in\{1,4\}. \]
\[ O_2 = O_1 \cup \{\Gamma_i\Gamma_j\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j\in\{1,4\}, \quad i\neq j. \]
\[ O_3 = O_1 \cup O_2 \cup \{\Gamma_i\Gamma_j\Gamma_k\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j,k\in\{1,4\}, \quad i\neq j\neq k. \]
Onyo la notation: Maandishi ya chanzo yanaeleza wazi kuwa local, pairwise na triple observables zinafafanuliwa kwenye circuit ya qubit nne, lakini seti za index zimechapishwa literal kama \(\{1,4\}\). Kwa kuwa uandishi huu una index mbili tu, hauonekani kuendana kikamilifu na muktadha. Verianla haikubadilisha kimya kimya uandishi huu kuwa \(\{1,\ldots,4\}\).
Matokeo ya Observable-set
Katika small na intermediate training sizes, hakuna tofauti kubwa ya performance inayoonekana kati ya \(O_1\), \(O_2\) na \(O_3\).
Chanzo kinatafsiri hili kwamba katika low-data regime modeli huzuia kwanza na kiasi cha training data kabla ya feature-space expressivity.
Katika large-data regime, hasa kwa:
\[ 12\,000 \quad\text{ve}\quad 30\,000 \]
training samples, observable sets tajiri zaidi hutoa slightly higher accuracy.
Chanzo pia kinajadili matokeo haya kwa upande wa hardware: non-commuting observables za ziada huhitaji measurement budget ya ziada kwenye hardware halisi. Katika emulated setting, physical shot overhead hii haipo.
Hitilafu ya caption ya Figure 4(c) ndani ya chanzo
Grafu na maandishi yanayozunguka Figure 4(c) yanaonyesha \(O_1,O_2,O_3\) observable-set comparison.
Hata hivyo, subfigure caption katika chanzo hutumia tena kauli yenye maana ya:
“Accuracy comparison ... for different batch sizes”
.
Kwa hiyo Verianla inaeleza Figure 4(c) kama observable-set experiment kwa kuzingatia maelezo ya maandishi makuu na graph legend, huku ikiacha kutokulingana kwa caption ya chanzo kuonekana.
Matokeo ya OASIS robustness
Good-performing hyperparameters zilizobainishwa katika OCT experiments zilihamishwa kwenda tatizo la OASIS dementia classification.
Chanzo Figure 5 kinaonyesha training size tatu:
\[ 999,\ 3000,\ 12000. \]
Namba 999 ilitumika kwa sababu ya hitaji la kuunda balanced dataset kati ya classes tatu.
Maelezo ya chanzo ya Figure 5:
- katika training size ndogo HQiCNN ni bora kuliko CNN ya kawaida,
- kadiri training size inavyoongezeka tofauti hupungua,
- katika training size kubwa zaidi CNN ya kawaida huwa mbele kidogo.
Kwa kuwa raw box-plot observations za Figure 5 hazikuchapishwa kama numeric table, hakuna accuracy mpya za uhakika zilizotolewa kutoka kwenye grafu hapa.
Experiment hii, kwa maneno ya waandishi wenyewe, ni robustness check; haikuundwa ili kutoa clinical conclusion.
Matokeo ya SHAP explainability
Kwa OCT explainability experiment, kwa kila modeli seed yenye accuracy iliyo karibu zaidi na mean accuracy ya modeli ilichaguliwa kutoka seeds 10.
Chanzo kinaeleza kuwa katika attribution maps modeli zote mbili huangazia hasa maeneo ya anatomia karibu na:
- retinal pigment epithelium (RPE),
- retinal layers,
- disease-associated elevations/deformations
.
Katika hali ya 1000 training sample, HQiCNN attribution maps huonekana localized na anatomically coherent zaidi, ilhali classical CNN huonyesha fragmented attribution distribution zaidi.
Wakati wa kufikia 30000 sample, attribution overlap ya modeli hizo mbili huongezeka kwa kiasi kikubwa.
Uchunguzi huu uko katika kiwango cha attribution pattern; si uthibitisho wa kisababishi wa utaratibu wa utambuzi wa kliniki.
Matokeo ya \(EMD_{pos}\)
| Training size | EMDpos | Maelezo |
|---|---|---|
| 1000 | 0.066 ± 0.019 | Tofauti ya spatial kati ya modeli mbili ni ndogo lakini kubwa kuliko hali ya 30000-sample |
| 30000 | 0.045 ± 0.018 | SHAP-spatial agreement ya juu zaidi |
Thamani zote mbili ni ndogo sana ikilinganishwa na theoretical upper bound:
\[ 1.3921 \]
.
Chanzo pia kinaripoti kuwa same-image EMD distributions ni ndogo kuliko cross-image reference distribution kati ya picha tofauti.
Matokeo haya yanaendana na modeli mbili kutoa positive attribution kwa anatomia regions zinazofanana kwenye picha ileile.
Hata hivyo, \(EMD_{pos}\) ndogo haimaanishi:
- modeli inatoa maelezo sahihi ya kisababishi kliniki,
- eneo lililopatikana ni validated biomarker,
- modeli imejifunza pathofiziolojia ya ugonjwa
.
Je, Utafiti Huu Unaonyesha “Ubora wa Kwanta”?
Hapana; utafiti hauonyeshi quantum advantage kwa maana ya ubora wa kompyuta halisi ya kwanta dhidi ya kompyuta ya kawaida au kwa maana ya computational complexity. Safu ya kati ya HQiCNN iliigizwa kwenye kompyuta ya kawaida, na matokeo yanaonyesha tu kwamba katika mazingira fulani ya data/optimization uwakilishi huu uliochochewa na kwanta unaweza kuwa mbadala wa CNN ya kawaida yenye parameter-controlled.
Mojawapo ya sentensi muhimu zaidi katika sehemu ya hitimisho la utafiti inaeleza kuwa faida ya HQiCNN haitokani tu na “kuongezwa kwa quantum operations”.
Utendaji hubadilika pamoja na:
- kiasi cha training data,
- learning rate na optimization dynamics,
- uchaguzi wa entanglement,
- observable set
.
Kwa hiyo hitimisho la jumla kama “quantum layer hujifunza representation bora katika kila hali” haliungwi mkono na chanzo.
Hitimisho zinazoungwa mkono na utafiti
- Quantum circuit ya qubit nne iliyoigizwa inaweza kutumika kama representation layer mbadala kwa dense layer ya kati ya CNN ya kawaida.
- HQiCNN ilitoa test accuracy ya juu kuliko CNN ya kawaida katika baadhi ya training-data regimes za ukubwa wa kati.
- CNN ya kawaida ilifikia accuracy ya juu zaidi kwa ujumla katika training set kubwa zaidi ya OCT.
- Mwingiliano kati ya learning rate na training size unaathiri kwa kiasi kikubwa tofauti kati ya usanifu hizo mbili.
- 10−3 learning rate iliripotiwa kuwa chaguo lenye uwiano na uthabiti bora katika hali za utafiti.
- Katika batch sizes 8, 16 na 32 kwenye 1000-sample OCT experiment, faida ya HQiCNN ilidumishwa.
- Entanglement si lazima kwa utendaji mzuri wa jumla.
- Katika large-data regime, observable sets tajiri zaidi zilitoa maboresho madogo lakini yanayopimika.
- Katika OASIS robustness test, mwelekeo unaofanana ulionekana kutoka small-data → faida ya HQiCNN hadi large-data → faida ya CNN.
- \(|SHAP|IoU\) na \(EMD_{pos}\) zilitumika kulinganisha attribution patterns za modeli hizo mbili.
- Kwa 1000 sample, HQiCNN SHAP maps zilionekana localized zaidi; kwa 30000 sample attribution distributions za modeli zilifanana zaidi.
Hitimisho ambazo utafiti hauungi mkono
- Haijaonyeshwa kuwa kompyuta halisi ya kwanta huainisha picha za matibabu vizuri kuliko CNN.
- Quantum computational advantage au asymptotic quantum speedup haijaonyeshwa.
- Haijaonyeshwa kuwa HQiCNN ni bora kuliko CNN kwa datasets zote na training sizes zote.
- Haijaonyeshwa kuwa entanglement ni lazima kwa mafanikio ya uainishaji.
- SHAP regions si biomarker zilizothibitishwa kliniki.
- OASIS labels si formal CDR clinical assessments.
- Modeli haijafanyiwa prospective validation kwa matumizi ya hospitali.
- Independent multicenter external clinical validation haijafanywa.
- Clinician reader study haijafanywa.
- MRI classification haikufanywa kwa full 3D volume; 2D slices zilitumika.
- Training time, inference speed, memory use na general computational efficiency hazikufanyiwa benchmark.
- Real quantum-hardware noise, decoherence na finite-shot measurement error hazikujaribiwa.
Vikwazo vya msingi
- Quantum circuit ina qubit nne pekee na muundo shallow emulated.
- Real quantum hardware haikutumika.
- Hakuna hardware connectivity constraint.
- Hakuna finite-shot measurement uncertainty.
- Hakuna decoherence au gate noise.
- OASIS robustness task ilipunguzwa kuwa 2D slices.
- Independent external clinical dataset validation haipo.
- Clinician reader study haipo.
- Computational-cost comparison haikufanywa.
- Code haikutolewa kama public repository; imeelezwa kuwa inaweza kupatikana kutoka corresponding authors kwa reasonable request.
- Ingawa neno “Parameter-matched” limetumika, manuscript haitoi jumla ya trainable-parameter counts za modeli hizo mbili katika numeric comparison table wazi.
Maelezo muhimu ya kuripoti ndani ya chanzo
- Katika Figure 3 caption kuna kosa la kuandika “read areas” badala ya “red areas”; maeneo mekundu ya heatmap ndiyo maeneo ambako HQiCNN ni bora.
- Ingawa Figure 3 imejengwa kutoka discrete configurations, hutumia interpolation kwa visual smoothness.
- Figure 4(c) ni observable-set comparison lakini subfigure caption imeandikwa kama batch-size comparison.
- Observable indices zimechapishwa kama \(i,j,k\in\{1,4\}\) katika muktadha wa qubit nne; chanzo hakielezi kama hii ni literal set au maandishi yaliyofupishwa/yenye kosa ya index range 1–4.
- Neno “Parameter-matched” linatumika kwenye chanzo, lakini total trainable-parameter counts hazitolewi katika numeric table tofauti.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Do emulated quantum circuits change what CNNs look at? Performance and explainability comparison in medical image classification
Waandishi: Guillermo Rubiños Rodríguez; Martín Ottavianelli; Mateo Alonso; Gonzalo Blázquez Gil; Boris-Stephan Rauchmann; Pablo Díez-Valle; Sergio Altares-López.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa kama ulivyo.
Mchango sawa: Pablo Díez-Valle na Sergio Altares-López wameainishwa kwenye chanzo kama waandishi waliotoa mchango sawa.
Corresponding author: Sergio Altares-López.
Corresponding-author e-mail: slopez@med.lmu.de
Taasisi 1: Instituto Tecnológico de Galicia, Cantón Grande 9, Planta 3, 15003 A Coruña, Spain.
Taasisi 2: Centro Singular de Investigación en Tecnoloxías Intelixentes (CiTIUS), Universidade de Santiago de Compostela, Santiago de Compostela, 15782, Spain.
Taasisi 3: Department of Neuroradiology, LMU University Hospital, Ludwig Maximilian University of Munich, Marchioninistraße 15, 81377 Munich, Germany.
Taasisi 4: Department of Psychiatry and Psychotherapy, LMU University Hospital, LMU Munich, Nussbaumstraße 7, 80336 Munich, Germany.
Aina ya chanzo: Computational preprint katika eneo la Quantum machine learning / medical image classification.
Jukwaa: arXiv.
arXiv: arXiv:2607.21186v1 [quant-ph].
Tarehe ya kuwasilisha: 23 Julai 2026.
DOI: 10.48550/arXiv.2607.21186.
Hali ya mapitio ya rika: Chanzo kilichochunguzwa ni toleo la arXiv preprint. Wakati wa uthibitishaji wa bibliografia, toleo tofauti na lililothibitishwa la mwisho la jarida lililopitiwa na rika kwa kazi hiyo hiyo halikubainishwa.
Leseni: Metadata ya rekodi ya arXiv inaonyesha arXiv non-exclusive distribution license; haijachukuliwa kuwa ni Creative Commons license.
Idadi ya kurasa: 17.
Idadi ya takwimu: 6.
Idadi ya majedwali: 2.
Aina kuu ya utafiti: Supervised machine-learning benchmark na explainability analysis kwenye medical-image datasets zilizopo.
Aina ya quantum study: Si real quantum hardware; ni classical emulation ya circuit yenye vigezo ya qubit nne.
Quantum implementation: Native PyTorch operations; dedicated quantum-computing framework haikutumika.
Mbinu ya Gradient: Automatic differentiation/backpropagation kwa emulated circuit; physical-circuit parameter-shift measurement haikutumika.
Classical baseline: Convolutional backbone ya pamoja + \(4\rightarrow12\) ReLU dense layer.
HQiCNN branch: Convolutional backbone ya pamoja + 4-qubit emulated parameterized quantum circuit + 12 observable output.
Input preprocessing: 2π·sigmoid(v), remainder(v,2π) na no-transform zililinganishwa; scaled sigmoid ilichaguliwa katika sehemu iliyobaki ya utafiti.
Seti kuu ya data ya OCT: 84,495 JPEG retinal OCT image; madarasa NORMAL, CNV, DME na DRUSEN.
Seti ya data ya Robustness: OASIS-1-derived structural MRI; chanzo kinaripoti 416 subject, umri wa 18–96.
Madarasa ya OASIS task: Non Demented, Very Mild Dementia, Mild/Moderate Dementia.
Kikomo cha CDR: OASIS labels si formal clinical CDR assessment; chanzo huweka tu uhusiano wa approximately corresponding CDR stages.
Input resolution: 64 × 64 pixel.
Input normalization: [0,1].
OCT hyperparameter executions: 640.
Random seeds: 10.
Maximum epochs: 100.
Early stopping patience: 8 epoch.
LR scheduler patience: 3 epoch.
LR reduction factor: 0.3.
Loss: Cross-entropy.
OCT highest reported accuracy: CNN, learning rate 0.001, 30000 training samples: \(0.937\pm0.006\).
Mbinu za Explainability: \(|SHAP|IoU\) na \(EMD_{pos}\).
EMDpos: kwa 1000 samples \(0.066\pm0.019\); kwa 30000 samples \(0.045\pm0.018\).
EMDpos theoretical range: \(0\le EMD_{pos}\le(63/64)\sqrt2\approx1.3921\).
External clinical validation: Hakuna.
Clinician reader study: Hakuna.
MRI dimensionality: Processed 2D axial slices zilitumika badala ya full 3D classification.
Computational-cost analysis: Training time, inference efficiency na memory requirements hazikufanyiwa benchmark kwa utaratibu.
Data availability: OCT data inategemea dataset iliyopo katika rejea ya chanzo; OASIS1-derived images na preprocessing data zinategemea vyanzo vya dataset vilivyoelezwa kwenye chanzo.
Code availability: Imeelezwa kuwa inaweza kutolewa na corresponding authors kwa reasonable request; chanzo hakitoi public code repository.
Ufadhili: PESL-Stiftung-Alzheimer 2026, Bayern, Germany, registered project 80765114 Pesl-Alzheimer-Stift; Principal Investigator Dr.-Ing. Sergio Altares-López. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Gonzalo Blázquez Gil na Pablo Díez-Valle pia wanatambua msaada wa ARQADE (CER-20251019), unaofadhiliwa na CDTI CERVERA Research Programme.
Michango ya waandishi: Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle na Sergio Altares-López walibuni na kupanga experiments. Guillermo Rubiños Rodríguez na Martín Ottavianelli walifanya experiments. Gonzalo Blázquez Gil, Sergio Altares-López na Boris-Stephan Rauchmann walitoa funding. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle na Sergio Altares-López walichangia results interpretation. Guillermo Rubiños Rodríguez na Sergio Altares-López waliongoza manuscript writing. Waandishi wote walitoa critical feedback na kuchangia katika kuunda utafiti, uchambuzi na manuscript.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna competing financial interests.
Ethics statement tofauti: Katika preprint iliyopakiwa hakuna sehemu tofauti ya institutional-review/ethics-approval statement inayoonekana. Utafiti unafanya computational analysis kwenye datasets zilizopo badala ya patient recruitment mpya; zaidi ya hapo, hali ya idhini ya maadili haijajazwa kwa dhana kwa niaba ya chanzo.
Ukaguzi wa marudio: Kwa kuwa hakuna rekodi ya awali ya Verianla kwa exact title hii na arXiv:2607.21186, imeandaliwa kama makala mpya.
Maelezo ya kuripoti ndani ya chanzo: Figure 4(c) caption inaweka observable-set graph kama batch-size comparison; matumizi ya \(\{1,4\}\) katika observable-index notation hayako wazi kwa muktadha; Figure 3 hutumia interpolation; total model parameter counts hazikutolewa kama numeric table tofauti.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *