


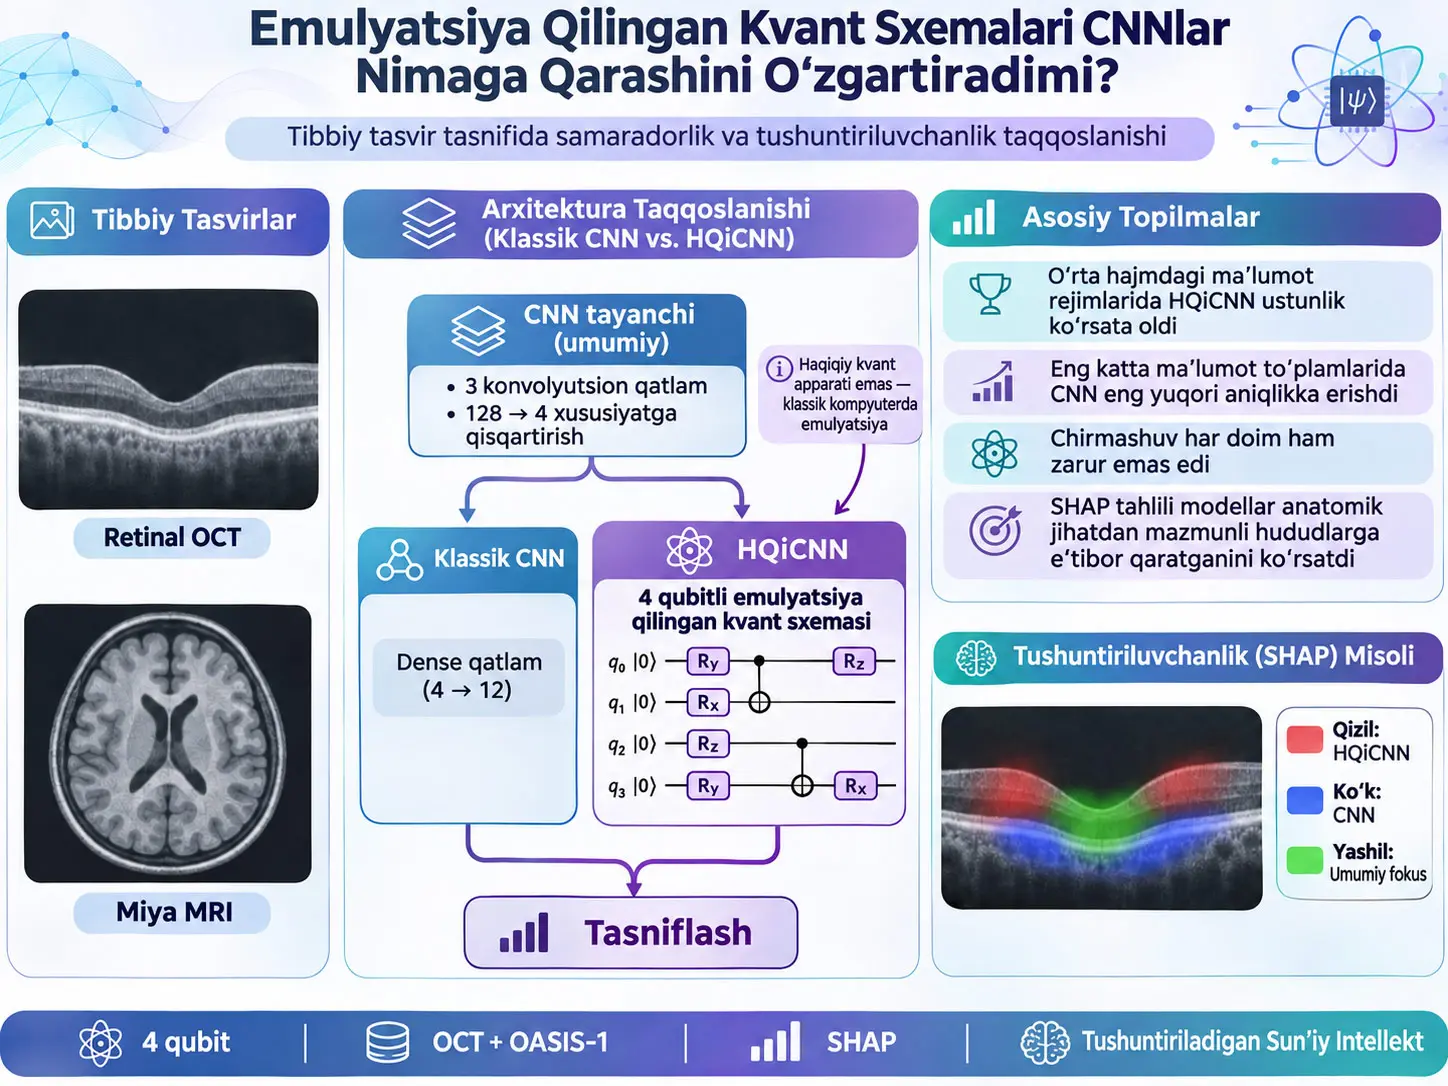
Gibrid Kvantdan Ilhomlangan Konvolyutsion Neyron Tarmogʻi (Hybrid Quantum-inspired Convolutional Neural Network, HQiCNN) klassik CNN tasvirdan xususiyat ajratish tayanchini saqlab qolib, oraliq ifoda qatlamidagi klassik dense layer oʻrniga toʻrt qubitli, klassik kompyuterda emulyatsiya qilingan parametrik kvant sxemasidan foydalanadigan tasvir tasniflash modelidir. Tadqiqot HQiCNNni xuddi shu convolutional backbone’dan foydalanadigan klassik CNN bilan retinal optik kogerent tomografiya (OCT) va demensiya bosqichlarini aniqlash uchun tayyorlangan miya MRI tasvirlarida taqqoslaydi. Asosiy tadqiqot savoli kichik va klassik usulda emulyatsiya qilinadigan kvant sxemasi haqiqiy kvant qurilmasini talab qilmasdan CNN oʻrgangan oraliq ifodani va tasvirning qaysi hududlariga ahamiyat berishini mazmunli ravishda oʻzgartira oladimi, degan savoldir.
Ikki model imkon qadar nazorat qilinadigan arxitektura taqqoslovi uchun bir xil convolutional backbone’dan foydalanadi. Tasvir avval uch qatlamli convolutional block orqali 128 oʻlchamli feature vector’ga aylantiriladi; soʻng linear reduction qatlami bu vektorni 4 oʻlchamga tushiradi. Klassik CNN tarmogʻida bu toʻrt xususiyat ReLU faollashtirishli \(4\rightarrow12\) dense layer’ga kiradi, HQiCNN tarmogʻida esa toʻrt feature toʻrt qubitli emulyatsiya qilingan kvant sxemasiga angle encoding orqali uzatiladi. Sxemada \(R_Y\) input encoding, trainable \(R_X\) va \(R_Z\) rotations hamda ixtiyoriy CNOT entanglement mavjud. Toʻrt qubitda \(X\), \(Y\) va \(Z\) Pauli observables oʻqilib, jami 12 classical output feature olinadi. Har ikki tarmoqning 12 oʻlchamli chiqishi bir xil turdagi classical output layer’ga oʻtadi.
Bu sxema haqiqiy quantum processor’da ishlatilmagan. Kvant komponenti PyTorch’ning mahalliy matematik amallari bilan klassik kompyuterda emulyatsiya qilingani uchun hardware noise, decoherence, finite-shot measurement uncertainty va fizik qubit connectivity kabi haqiqiy kvant kompyuter cheklovlari benchmark’ga kiritilmagan. Emulyatsiya qilingan tuzilma quantum hardware’da talab qilinadigan parameter-shift gradient estimation oʻrniga ordinary backpropagation’dan foydalanishi ham mumkin.
OCT uchun training size, learning rate, batch size, circuit entanglement va observable-set oʻlchami tizimli ravishda oʻzgartirilgan. Toʻqqiz training size, uch learning rate, uch batch size, entangled/non-entangled circuit, uch observable set va 10 random seedni qamrab olgan asosiy OCT hyperparameter dasturi jami 640 execution sifatida hisobot qilingan. Maksimal training muddati 100 epoch, early-stopping patience sakkiz epoch, learning-rate-scheduler patience uch epoch va reduction factor 0.3.
Natijalar bitta arxitektura barcha holatlarda ustun emasligini koʻrsatadi. OCTda klassik CNN eng katta training set uchun tadqiqotdagi eng yuqori umumiy test accuracy qiymati — %93.7 ga erishgan. HQiCNN esa ayniqsa oʻrta hajmdagi training sets, taxminan 800–2000 namuna atrofidagi koʻplab configuration’larda klassik CNNdan yuqoriroq mean test accuracy bergan. Xuddi shunday tendensiya OASIS dementia robustness test’ida ham kuzatilgan; kichikroq training sizes’da HQiCNN ustun boʻlgan, maʼlumot miqdori oshgan sari farq qisqargan va katta training size’da CNN biroz oldinga chiqqan.
Entanglement umuman olganda majburiy ustunlik bermagan. Non-entangled circuit oʻrtacha koʻpchilik configuration’da oʻxshash yoki yaxshiroq natija bergan, faqat ayrim training sizes, ayniqsa 1000 va 1200 namuna darajasida entanglement aniqroq va barqarorroq natijalar yaratgan. Manba bu natijani muhim deb hisoblaydi; chunki separable circuits klassik emulyatsiyada osonroq masshtablanadi, entangled circuits’ning simulation xarajati esa qubit soni bilan ancha tez oʻsadi.
Explainability boʻlimida tadqiqotchilar SHAP asosidagi ikki vositani taklif qiladilar. \(|SHAP|IoU\) ikki model uchun mutlaq SHAP qiymatlarining eng yuqori %10 iga ega tasvir hududlarining ustma-ust tushishini vizuallashtiradi. \(EMD_{pos}\) esa ikki modelning musbat SHAP taqsimotlari orasidagi fazoviy farqni Earth Mover's Distance/Wasserstein yondashuvi bilan miqdoriy baholaydi. OCTda oʻrtacha \(EMD_{pos}\), 1000 training sample uchun \(0.066\pm0.019\), 30000 sample uchun \(0.045\pm0.018\) topilgan. Qiymatning maʼlumot ortgan sari kamayishi ikki modelning musbat attribution hududlari koʻproq oʻxshashib borishini koʻrsatadi.
Biroq tadqiqot klinik diagnostika tizimini tasdiqlash emas. SHAP xaritalarining retinal pigment epithelium va kasallik bilan bogʻliq anatomik hududlarda jamlanishi anatomik jihatdan mazmunli belgi boʻlsa-da, mualliflar bu hududlar klinik tasdiqlangan biomarker emasligini aniq taʼkidlaydilar. Shuningdek, mustaqil tashqi klinik validation, clinician reader study, toʻliq 3D MRI analysis va training/inference computational-cost comparison oʻtkazilmagan.
HQiCNN Nima va Bu Tadqiqotda Haqiqiy Kvant Kompyuteri Ishlatiladimi?
HQiCNN klassik CNN tayanchining oraliq dense representation layer’ini toʻrt qubitli emulyatsiya qilingan parametrik kvant sxemasi bilan almashtiradigan hybrid quantum-inspired tasniflash modelidir; bu tadqiqotda fizik kvant protsessori ishlatilmagan, kvant sxemasi PyTorch’da klassik kompyuterda matematik tarzda emulyatsiya qilingan.
“Quantum-inspired” bu yerda aynan nimani anglatadi?
Bu tadqiqotda “quantum-inspired” iborasi shunchaki umumiy marketing yorligʻi emas. HQiCNNning oraliq qatlami haqiqiy quantum-circuit matematikasidan foydalanadigan toʻrt-qubitli parameterized circuit tuzilmasiga ega:
- classical features qubit rotation angles shaklida encode qilinadi,
- qubit states unitary rotation matrices bilan oʻzgartiriladi,
- trainable \(R_X\) va \(R_Z\) rotations ishlatiladi,
- entangled configuration’da CNOT gates qoʻllanadi,
- yakuniy state’dan \(X\), \(Y\) va \(Z\) Pauli observables’ning expectation-value ga oʻxshash classical outputs olinadi.
Ammo bu amallarning barchasi physical qubits’da emas, klassik kompyuterdagi tensor/matrix operations orqali hisoblanadi. Bu farq juda muhim: manba “kvant kompyuteridan foydalanib tibbiy tasvirlarni tasnifladik” demaydi.
Qubit nima?
Qubit ikki oʻlchamli kompleks Hilbert space ichida aniqlanadigan kvant axborot birligidir. Manba asosiy qubit state’ni:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle = \begin{bmatrix} \alpha\\ \beta \end{bmatrix} \]
shaklida beradi.
Normalization sharti:
\[ |\alpha|^2+|\beta|^2=1 \]
boʻlishi kerak.
Bu yerda:
- \(|0\rangle\) va \(|1\rangle\): computational basis states,
- \(\alpha\) va \(\beta\): complex probability amplitudes,
- \(|\alpha|^2\) va \(|\beta|^2\): ideal measurement vaqtida tegishli basis outcome’larning Born-rule probabilities qiymatlaridir.
Superposition qubit oʻlchashdan oldin faqat \(|0\rangle\) yoki faqat \(|1\rangle\) boʻlishi shart emasligi va bu basis states’ning normalized linear combination’i sifatida ifodalanishi mumkinligini anglatadi.
Bu maqolada qubit state fizik qurilmada tayyorlanmaydi; ayni matematik state vector klassik hisoblashda saqlanadi.
Hilbert space nima?
Hilbert space quantum state vectors aniqlanadigan kompleks inner-product vector space’dir. Bitta qubit uchun asosiy space ikki oʻlchamli. Bir nechta qubit tensor product bilan birlashtirilganda state-space dimension ortadi. Toʻrt qubit uchun umumiy pure-state vector:
\[ 2^4=16 \]
complex amplitude saqlaydi.
Bu son bu yerda tadqiqotning yangi natijasi emas; toʻrt-qubit state-space tuzilmasining matematik maʼnosini tushuntiradigan asosiy kvant axboroti izohidir.
Quantum gate nima?
Quantum gate quantum state ustida acting qiladigan unitary operator’dir. Unitary boʻlish sharti:
\[ U^\dagger U=I \]
boʻlgani uchun state normasi saqlanadi.
Tadqiqotning asosiy circuit gates’i \(R_X\), \(R_Y\), \(R_Z\) va CNOT.
Manbada berilgan \(R_X\), \(R_Y\) va \(R_Z\) aylanishlari
Manba Tenglama (1)da:
\[ R_X(\theta) = \begin{bmatrix} \cos(\theta/2) & -i\sin(\theta/2)\\ -i\sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Y(\theta) = \begin{bmatrix} \cos(\theta/2) & -\sin(\theta/2)\\ \sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Z(\theta) = \begin{bmatrix} e^{-i\theta/2} & 0\\ 0 & e^{i\theta/2} \end{bmatrix}. \tag{1} \]
matritsalaridan foydalanadi.
Bu matrices qubit state’ni Bloch sphere’da mos ravishda \(x\), \(y\) va \(z\) oʻqlari atrofida \(\theta\) burchakka rotate qiladigan unitary transformations’dir.
\(\theta\) oʻlchamsiz burchak parametri boʻlib, radians’da talqin qilinadi. Circuit ichidagi input-dependent yoki trainable parameter qaysi gate’ga qoʻllanishiga qarab \(\theta\), encoded classical feature yoki optimization vaqtida oʻrganiladigan model parameter boʻlishi mumkin.
Pauli observables nima?
Manba Tenglama (2)da uch asosiy Pauli matrix’ni beradi:
\[ X= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix}, \qquad Y= \begin{bmatrix} 0&-i\\ i&0 \end{bmatrix}, \qquad Z= \begin{bmatrix} 1&0\\ 0&-1 \end{bmatrix}. \tag{2} \]
Pauli matrices quantum gates/rotations hosil qilishda ham, observables sifatida quantum state’dan classical information chiqarishda ham markaziy rol oʻynaydi.
Bu tadqiqotning asosiy HQiCNN configuration’ida har toʻrt qubit uchun uch local observable:
\[ X,\ Y,\ Z \]
baholangani uchun:
\[ 4\ \text{qubit}\times3\ \text{observable}=12 \]
classical feature hosil qilinadi.
Entanglement nima?
Entanglement koʻp quantum system state’ini mustaqil subsystem states’ning tensor product’iga ajratib boʻlmaydigan quantum correlation shaklidir.
Masalan, umumiy ikki-qubit state:
\[ |\psi\rangle \neq |\psi_A\rangle\otimes|\psi_B\rangle \]
boʻlsa state entangled boʻlishi mumkin.
HQiCNNning entangled versiyasida qubits orasida linear CNOT layer qoʻllanadi. Non-entangled versiyada bu coupling olib tashlanadi.
Bu tadqiqotning muhim natijasi entanglement umumiy natija uchun zarur emasligini koʻrsatishidir. Bu xulosa “entanglement hech bir quantum machine-learning modelida foydasiz” degani emas; faqat bu yerda ishlatilgan toʻrt-qubit HQiCNN, datasets va measurement scheme uchun hisobot qilingan.
Parameterized Quantum Circuit nima?
Parameterized Quantum Circuit (PQC) ayrim gate angles trainable parameters boʻlgan quantum circuit tuzilmasidir. Classical machine-learning optimizer training loss’ni kamaytirish uchun bu parameters’ni yangilaydi.
Manbada HQiCNN circuit:
- 4-dimensional classical vector’ni qabul qiladi,
- har bir component’ni bir qubit’ga \(R_Y\) angle encoding orqali joylashtiradi,
- trainable \(R_X\) va \(R_Z\) rotations qoʻllaydi,
- entangled versiyada CNOT gates ishlatadi,
- Pauli observables oʻlchovidan 12-dimensional classical representation chiqaradi.
CNN va HQiCNN Oʻrtasidagi Taqqoslash Qanday Nazorat Qilindi?
Ikki model bir xil convolutional feature extractor, bir xil 128→4 linear reduction va bir xil 12-oʻlchamli representation’dan classification output’ga boruvchi yakuniy qatlamni baham koʻradi; asosiy arxitektura oʻzgaruvchisi klassik CNNdagi \(4\rightarrow12\) ReLU dense layer’ning HQiCNNda toʻrt-qubitli emulyatsiya qilingan parametrik circuit bilan almashtirilishidir.
Umumiy convolutional backbone
Kirish medical image uch convolutional layer’dan tashkil topgan umumiy block’ka kiradi. Manba har bir layer uchun:
- Conv2D,
- kernel size 3,
- Batch Normalization,
- Max Pooling,
- ReLU
komponentlarini koʻrsatadi.
Bu block oxirida tasvir:
\[ 128 \]
oʻlchamli feature vector’ga aylantiriladi.
Linear reduction
Activation ishlatmaydigan linear reduction layer:
\[ 128\rightarrow4 \]
oʻzgarishini bajaradi.
Shunday qilib, ikki model bir xil toʻrt-dimensional latent representation’ni oladi.
Klassik CNN tarmogʻi
Klassik branch:
\[ 4\rightarrow12 \]
dense layer va ReLU activation’dan foydalanadi.
HQiCNN tarmogʻi
HQiCNN xuddi shu toʻrt-dimensional vector’ni toʻrt qubit’ga angle-encode qiladi va quantum-circuit representation’dan soʻng:
\[ 4\ \text{qubit} \times 3\ \text{local Pauli observable} = 12 \]
output feature hosil qiladi.
Yakuniy classification layer
Har ikki branch’ning 12-dimensional representation’i umumiy output layer’ga oʻtadi. Output dimension dataset’dagi label soniga teng:
- OCT: 4 sinf,
- OASIS robustness task: 3 sinf.
Input nima uchun \(2\pi\cdot\mathrm{sigmoid}(v)\) bilan oʻzgartiriladi?
Parameterized rotation gates burchakli input ishlatadi. Manba toʻrt-dimensional vector:
\[ v \]
uchun uch preprocessing strategy’ni taqqoslagan.
Birinchi variant:
\[ \widetilde v = 2\pi\cdot\operatorname{sigmoid}(v). \]
Sigmoid:
\[ (0,1) \]
oraligʻiga siqqani uchun \(2\pi\) ga koʻpaytirilganda angle range:
\[ (0,2\pi) \]
boʻladi.
Ikkinchi variant:
\[ \operatorname{remainder}(v,2\pi) \]
orqali periodic wrapping qilishdir.
Uchinchi variant hech qanday explicit transform qoʻllamasdan raw \(v\) qiymatlaridan foydalanishdir.
Manba scaled sigmoid transformation shu uch variant orasida consistently better performance berganini va qolgan tajribalarda shu usul qoʻllanganini bildiradi. Asosiy matnda bu preprocessing taqqoslovining barcha sonli qiymatlari alohida jadval sifatida berilmagan.
Parameter-shift rule nima uchun bu yerda ishlatilmaydi?
Fizik yoki black-box quantum circuit’da trainable rotation parameter’larning gradient’i parameter-shift rule bilan hisoblanishi mumkin. Manba izohiga koʻra \(p\) trainable parameter uchun bu yondashuv:
\[ 2p \]
forward circuit evaluation talab qiladi.
Bu yerdagi circuit toʻliq differentiable PyTorch operations bilan emulyatsiya qilingani uchun automatic differentiation/backpropagation ishlatilishi mumkin. Mualliflar barcha gradients bitta backward pass ichida birgalikda hisoblanishini va gradient-computation evaluation scaling \(O(p)\) circuit passes talabidan bitta backward pass’ga tushirilishini taʼkidlaydilar.
Bu quantum-hardware speedup natijasi emas. Afzallik classical emulation’ning differentiable software graph’idan foydalanishdir.
Barren plateau nima va bu tadqiqotda oʻlchanganmi?
Barren plateau parameterized quantum circuits’da cost-function gradient’lari circuit size/depth kattalashgani sari juda kichiklashib, training’ni qiyinlashtirishi mumkin boʻlgan optimallashtirish muammosidir.
Maqola barren plateau’ni QML masshtablanuvchanligining umumiy cheklovlaridan biri sifatida taqdim etadi; ammo tadqiqotning asosiy tajriba dasturi toʻrt-qubitli emulyatsiya qilingan shallow circuit’da boʻlib, barren-plateau scaling uchun alohida eksperimental oʻlchov yoki exponent fitting qilmaydi.
Shuning uchun “bu tadqiqot barren plateau muammosini hal qildi” degan xulosa chiqarib boʻlmaydi.
OCT maʼlumotlar toʻplami
Retinal optical coherence tomography maʼlumotlar toʻplami jami:
\[ 84\,495 \]
JPEG image saqlaydi va manbada standart training/test splits bilan toʻrt sinf koʻrsatilgan:
- NORMAL,
- CNV — choroidal neovascularization,
- DME — diabetic macular edema,
- DRUSEN.
Manba maʼlumotlar toʻplami tasvirlari 2013–2017 yillar orasida bir nechta xalqaro clinical center’da Spectralis OCT qurilmalari bilan toʻplanganini va label quality uchun koʻp bosqichli ophthalmologist review qoʻllanganini bildiradi.
Bu maʼlumot original OCT dataset xususiyatidir; joriy HQiCNN tadqiqoti yangi bemorlar toʻplaganini anglatmaydi.
OASIS-1 MRI maʼlumotlar toʻplami
Robustness analysis uchun OASIS-1 structural MRI ishlatilgan. Manbaga koʻra dataset:
\[ 416 \]
subject saqlaydi va yosh oraligʻi:
\[ 18-96 \]
yil.
Preprocessing zanjiri:
- 3D image files’ni NIfTI formatiga oʻtkazish,
- standard anatomical orientation’ga reorientation,
- bias-field correction,
- field-of-view cropping,
- skull stripping,
- MNI152 template’ga 2 mm resolution bilan 12-degree-of-freedom affine registration,
- trilinear interpolation,
- tissue segmentation,
- white-matter partial-volume mask yaratish,
- white-matter mean intensity hisoblash,
- Shinohara normalization,
- registered 3D volume’dan axial 2D slices chiqarish
deb tushuntiriladi.
Barcha model inputs:
\[ 64\times64 \]
pixel resolution’ga resize qilingan va:
\[ [0,1] \]
oraligʻiga normalize qilingan.
OASIS sinflari nima uchun haqiqiy CDR tashxisi sifatida oʻqilmasligi kerak?
Manba OASIS-derived labels’ni uch guruhga aylantiradi:
- Non Demented,
- Very Mild Dementia,
- Mild/Moderate Dementia.
Mualliflar bu labels formal clinical CDR assessment emasligini aniq koʻrsatadilar.
Faqat severity descriptions orqali taxminiy moslashtirish qilingan:
- Non Demented ≈ CDR 0,
- Very Mild Dementia ≈ CDR 0.5,
- Mild/Moderate Dementia ≈ CDR ≥ 1.
Moderate Dementia sinfi 500 dan kam sample saqlagani uchun Mild Dementia bilan birlashtirilgan. Majority class ham boshqa classes hajmiga downsample qilinib, uch-sinfli task muvozanatlashtirilgan.
Shu sababli tadqiqot bevosita formal CDR clinical scoring algorithm’ni oʻrgatmagan.
EMDpos Nimani Oʻlchaydi?
\(EMD_{pos}\) HQiCNN va klassik CNN uchun normallashtirilgan musbat SHAP pixel distributions’ni ikki oʻlchamli Earth Mover's Distance bilan taqqoslaydigan tushuntiriluvchanlik metrikasidir; qiymat kichraygan sari ikki modelning toʻgʻri tasnifni qoʻllab-quvvatlaydigan tasvir hududlari fazoviy taqsimoti bir-biriga koʻproq yaqinlashadi.
SHAP nima?
SHAP model prediction’ga input features qaysi yoʻnalishda va qanday miqdorda hissa qoʻshganini Shapley-value yondashuvi bilan tushuntiradigan model-agnostic explainability framework’dir.
Image model’da feature pixel yoki pixel region sifatida talqin qilinishi mumkin. Musbat SHAP value tegishli pixel baholanayotgan output’ni qoʻllab-quvvatlaydigan contribution koʻrsatishini anglatadi.
Bu izoh feature attribution’dir; oʻz-oʻzicha biological causality yoki clinical biomarker dalili emas.
\(|SHAP|IoU\) qanday ishlatiladi?
Manba har bir model uchun mutlaq SHAP values’ning eng yuqori:
\[ 10\% \]
qismini tanlab, ikki region-of-interest mask:
\[ R_A,\ R_B \]
hosil qiladi.
Manba Figure 6’da:
- qizil: faqat HQiCNN kuchli attribution bergan hududlar,
- koʻk: faqat CNN kuchli attribution bergan hududlar,
- yashil: ikki model umumiy koʻrgan hududlar
sifatida koʻrsatadi.
Manba \(|SHAP|IoU\) uchun alohida scalar Intersection-over-Union formulasini raqamlangan tenglama shaklida bermaydi; usul asosan yuqori-%10 masks orasidagi spatial intersection’ni koʻrinadigan qilish uchun ishlatiladi.
\(EMD_{pos}\) formulasi
Avval ikki modelning positive SHAP values’i normallashtirilib, ikki-dimensional probability distributions olinadi.
Manba Tenglama (3):
\[ EMD_{pos} = \min_{\gamma\in\Pi(\omega_{HQiCNN}\mid\omega_{CNN})} \sum_{i,j} \gamma_{i,j} \left\| p_i-p_j \right\|_2. \tag{3} \]
Bu yerda:
- \(\omega_{HQiCNN}\) va \(\omega_{CNN}\): normallashtirilgan positive SHAP spatial distributions,
- \(\gamma_{i,j}\): pixel location \(i\)dan location \(j\)ga koʻchirilgan probability mass miqdori,
- \(p_i,p_j\): normalized pixel coordinates,
- \(\|\cdot\|_2\): Euclidean distance,
- \(\Pi\): ikki distributions’ning marginals’ini saqlaydigan admissible transport plans toʻplamini ifodalovchi manba belgisi.
Manba pixel coordinate’ni:
\[ p= \left( \frac{y}{64}, \frac{x}{64} \right) \]
shaklida normallashtiradi.
64×64 image:
\[ 64\times64=4096 \]
grid point saqlaydi.
EMDning fizik metr, millimetr yoki pixel birligi yoʻq; coordinate normalization sababli bu yerda oʻlchamsiz spatial-distance metric sifatida ishlatiladi.
\(EMD_{pos}\) quyi va yuqori chegarasi
Identical distributions uchun:
\[ EMD_{pos}=0. \]
Manba maksimal geometrik ajralishni image grid’ning qarama-qarshi corners’i orqali hisoblaydi:
\[ D = \sqrt{ \left(\frac{63}{64}\right)^2 + \left(\frac{63}{64}\right)^2 } = \frac{63}{64}\sqrt2 \approx1.3921. \tag{4} \]
Shuning uchun:
\[ 0 \le EMD_{pos} \le \frac{63}{64}\sqrt2 \approx1.3921. \tag{5} \]
shaklida beriladi.
Past qiymat ikki modelning positive-SHAP spatial distribution’lari oʻxshashligini; yuqori qiymat esa probability mass uzoqroqqa koʻchirilishi kerakligini anglatadi.
Tadqiqot Usuli va Natijalari
OCT hyperparameter tajriba dizayni
| Hyperparameter | Qiymatlar | Variantlar soni |
|---|---|---|
| Training size | 200, 400, 800, 1000, 1200, 1600, 2000, 12000, 30000 | 9 |
| Learning rate | 10−2, 10−3, 10−4 | 3 |
| Batch size | 8, 16, 32 | 3 |
| Quantum circuit | Entangled, Not Entangled | 2 |
| Observable set | O1, O2, O3 | 3 |
| Random seed | 10 randomly selected seeds | 10 |
Manba umumiy OCT hyperparameter executions sonini:
\[ 9\times3\times10 + 3\times10 + 2\times8\times10 + 3\times6\times10 = 640 \]
deb beradi.
Bu 640 soni Table 1’dagi OCT hyperparameter dasturiga tegishli. OASIS robustness experiment bu jami ichiga alohida ochiq formula bilan qoʻshilmagan.
Training sozlamalari
| Sozlama | Manbada berilgan qiymat / usul |
|---|---|
| Framework | PyTorch |
| Quantum emulation | Native PyTorch functions |
| Loss | Cross-entropy |
| Output softmax | Ishlatilmaydi; cross-entropy unnormalized logits ustida ishlaydi |
| Gradient handling | GradScaler |
| Maksimal epoch | 100 |
| Early-stopping patience | 8 epoch |
| Learning-rate scheduler patience | 3 epoch |
| Learning-rate reduction factor | 0.3 |
| Random repetitions | 10 seed |
Table 2: learning rate va training size natijalari
Quyidagi qiymatlar manba Table 2’da 10 random seed boʻyicha hisobot qilingan mean test accuracy ± standard deviation qiymatlaridir.
| Model | LR | 200 | 400 | 800 | 1000 | 1200 | 1600 | 2000 | 12000 | 30000 |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN | 0.01 | 0.436 ± 0.104 | 0.495 ± 0.135 | 0.575 ± 0.049 | 0.670 ± 0.082 | 0.698 ± 0.098 | 0.749 ± 0.083 | 0.843 ± 0.020 | 0.929 ± 0.015 | 0.930 ± 0.010 |
| CNN | 0.001 | 0.467 ± 0.098 | 0.535 ± 0.125 | 0.633 ± 0.058 | 0.661 ± 0.074 | 0.734 ± 0.055 | 0.751 ± 0.076 | 0.774 ± 0.127 | 0.924 ± 0.010 | 0.937 ± 0.006 |
| CNN | 0.0001 | 0.311 ± 0.069 | 0.358 ± 0.078 | 0.550 ± 0.092 | 0.518 ± 0.132 | 0.628 ± 0.068 | 0.643 ± 0.049 | 0.672 ± 0.042 | 0.885 ± 0.011 | 0.919 ± 0.006 |
| HQiCNN | 0.01 | 0.325 ± 0.094 | 0.468 ± 0.105 | 0.551 ± 0.099 | 0.638 ± 0.092 | 0.714 ± 0.078 | 0.800 ± 0.032 | 0.818 ± 0.066 | 0.930 ± 0.009 | 0.929 ± 0.012 |
| HQiCNN | 0.001 | 0.448 ± 0.082 | 0.559 ± 0.076 | 0.688 ± 0.051 | 0.745 ± 0.074 | 0.769 ± 0.028 | 0.795 ± 0.055 | 0.828 ± 0.034 | 0.920 ± 0.008 | 0.931 ± 0.008 |
| HQiCNN | 0.0001 | 0.347 ± 0.089 | 0.414 ± 0.085 | 0.542 ± 0.080 | 0.582 ± 0.053 | 0.600 ± 0.051 | 0.653 ± 0.037 | 0.684 ± 0.058 | 0.897 ± 0.008 | 0.920 ± 0.008 |
Training size natijasi
Har ikki modelda ham umumiy tendensiya training data oshgani sari test accuracy koʻtarilishidir.
Manba ayniqsa taxminan:
\[ 12\,000 \]
sample’dan keyin gains sekinlashganini va saturation/diminishing-returns xatti-harakati boshlanganini bildiradi.
HQiCNNning eng aniq nisbiy afzalliklari small-to-intermediate data regime oʻrtasida koʻrinadi. Aksincha, eng katta training set uchun klassik CNN:
\[ 0.937\pm0.006 \]
bilan tadqiqotdagi eng yuqori global OCT accuracy’ga erishgan.
HQiCNNning 30000 sample, learning rate 0.001 qiymati:
\[ 0.931\pm0.008 \]
deb hisobot qilingan.
Demak tadqiqot “HQiCNN barcha maʼlumot hajmlarida CNNdan yaxshiroq” degan xulosani qoʻllab-quvvatlamaydi.
Learning rate natijasi
Manba:
\[ 10^{-3} \]
learning rate umuman accuracy va optimization stability orasida eng muvozanatli variant ekanini bildiradi.
\(10^{-2}\) ayrim configurations’da yuqori natija bersa-da seed/configuration variation kattaroq.
\[ 10^{-4} \]
esa koʻpchilik holatda pastroq accuracy bergan va manba buni optimization’ning allocated training budget ichida haddan tashqari conservative qolishi bilan bogʻlagan.
Bu natija faqat bu yerda ishlatilgan architectures, datasets va training budget uchun amal qiladi; barcha neural networks uchun universal optimum learning rate emas.
Figure 3 interpolation ogohlantirishi
Manba small/intermediate training-size hududidagi HQiCNN–CNN mean-accuracy difference qiymatlarini heatmap bilan koʻrsatadi.
Heatmap kirishlari discrete measured configurations; manba caption tasvirni smooth qilish uchun interpolation ishlatilganini aniq bildiradi.
Shu sababli Verianla interpolated color field’dan yangi aniq numeric values oʻqimagan, manba Table 2’dagi haqiqiy discrete values’ni source-of-truth sifatida saqlagan.
Batch size natijasi
Training size 1000 uchun batch sizes:
\[ 8,\ 16,\ 32 \]
taqqoslangan.
Manbaning Figure 4(a) izohi HQiCNN uch batch size’ning barchasida mean accuracy va stability jihatidan klassik CNNdan yaxshiroq ekanini bildiradi.
Figure 4(a)’da individual box-plot values alohida numeric table sifatida berilmagani uchun Verianla bar/box positions’dan aniq yangi sonlar chiqarmaydi.
Entanglement natijasi
Entangled circuit CNOT layer’ni saqlaydi, non-entangled model esa xuddi shu entangling gates’siz ishlaydi.
Manbaning natijasi:
- oʻrtacha non-entangled configuration yaxshiroq natija beradi,
- 1000 va 1200 training samples uchun entangled configuration accurate va stable koʻrinadi,
- umumiy kuchli natija uchun entanglement zarur emas.
Manba shuningdek output observables local boʻlishi entanglement hosil qilgan higher-order correlations’ning barchasini koʻrinadigan qilmasligi mumkinligini ehtimoliy izoh sifatida aytadi.
Bu isbotlangan mexanizm emas; mualliflarning natija talqinidir.
Non-entangled sxema masshtablanuvchanlik uchun nega muhim?
Manba separable circuit classical emulation complexity qubit soni bilan linear masshtablanishi mumkinligini; entangled circuit simulation esa umumiy holatda exponential complexity hosil qilishi mumkinligini bildiradi.
Shuning uchun oʻxshash classification accuracy entanglement’siz olinadigan boʻlsa, kattaroq emulated circuit’larga oʻtish computational jihatdan amalga oshirishga qulayroq boʻlishi mumkin.
Bu natija haqiqiy quantum hardware uchun bevosita “entanglement ishlatmang” tavsiyasi emas.
Observable sets
Manba uchta nested observable set’ni belgilaydi.
Manba yozuvi bilan:
\[ O_1 = \{\Gamma_i\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i\in\{1,4\}. \]
\[ O_2 = O_1 \cup \{\Gamma_i\Gamma_j\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j\in\{1,4\}, \quad i\neq j. \]
\[ O_3 = O_1 \cup O_2 \cup \{\Gamma_i\Gamma_j\Gamma_k\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j,k\in\{1,4\}, \quad i\neq j\neq k. \]
Notatsiya ogohlantirishi: Manba matni toʻrt-qubit circuit’da local, pairwise va triple observables belgilanishini aniq aytadi, biroq indeks toʻplamlarini literal tarzda \(\{1,4\}\) deb bosadi. Bu yozuv faqat ikki indeksni saqlagani sababli kontekst bilan toʻliq mos koʻrinmaydi. Verianla yozuvni \(\{1,\ldots,4\}\) shakliga jim oʻzgartirmagan.
Observable-set natijasi
Small va intermediate training sizes’da \(O_1\), \(O_2\) va \(O_3\) orasida aniq natija farqi koʻrinmaydi.
Manba buni low-data regime’da model feature-space expressivity’dan oldin training data miqdori bilan cheklanadi deb talqin qiladi.
Large-data regime’da, ayniqsa:
\[ 12\,000 \quad\text{ve}\quad 30\,000 \]
training samples uchun boyroq observable sets slightly higher accuracy beradi.
Manba bu natijani hardware jihatidan ham muhokama qiladi: non-commuting qoʻshimcha observables haqiqiy hardware’da qoʻshimcha measurement budget talab qiladi. Emulated setting’da esa bu physical shot overhead yoʻq.
Figure 4(c) manba ichidagi caption xatosi
Figure 4(c) grafigi va atrof matni \(O_1,O_2,O_3\) observable-set comparison’ni koʻrsatadi.
Biroq subfigure caption manbada yana:
“Accuracy comparison ... for different batch sizes”
mazmunidagi iborani ishlatadi.
Shu sababli Verianla Figure 4(c)ni observable-set experiment sifatida, asosiy matn tushuntirishi va graph legend bilan uygʻun tarzda taʼriflaydi; manba caption’dagi nomuvofiqlikni ham koʻrinadigan holda qoldiradi.
OASIS robustness natijasi
OCT experiments’da aniqlangan yaxshi-performing hyperparameters OASIS dementia classification muammosiga oʻtkazilgan.
Manba Figure 5 uch training size’ni koʻrsatadi:
\[ 999,\ 3000,\ 12000. \]
999 soni uch classes orasida balanced dataset yaratish zarurati sabab ishlatilgan.
Figure 5 manba talqini:
- kichik training size’da HQiCNN klassik CNNdan yaxshiroq,
- training size oshgani sari farq qisqaradi,
- eng katta training size’da klassik CNN biroz oldinga chiqadi.
Figure 5 raw box-plot observations numeric table shaklida eʼlon qilinmagani uchun bu yerda grafikdan yangi aniq accuracy qiymatlari chiqarilmagan.
Bu experiment mualliflarning oʻz iborasi bilan robustness check; clinical conclusion chiqarish uchun ishlab chiqilmagan.
SHAP explainability natijalari
OCT explainability experiment uchun har bir modelda 10 seeds ichidan accuracy’si modelning mean accuracy qiymatiga eng yaqin seed tanlangan.
Manba attribution maps’da ikki model ayniqsa:
- retinal pigment epithelium (RPE),
- retinal layers,
- disease-associated elevations/deformations
atrofidagi anatomik hududlarga eʼtibor qaratishini bildiradi.
1000 training sample sharoitida HQiCNN attribution maps koʻproq localized va anatomically coherent koʻrinsa, classical CNN koʻproq fragmented attribution distribution koʻrsatadi.
30000 sample’ga chiqqanda ikki modelning attribution overlap’i ancha ortadi.
Bu kuzatuvlar attribution pattern darajasida; klinik tashxis mexanizmining sababiy tasdigʻi emas.
\(EMD_{pos}\) natijalari
| Training size | EMDpos | Izoh |
|---|---|---|
| 1000 | 0.066 ± 0.019 | Ikki model orasida past, ammo 30000-sample holatiga qaraganda kattaroq spatial farq |
| 30000 | 0.045 ± 0.018 | Yuqoriroq SHAP-spatial agreement |
Har ikki qiymat theoretical upper bound:
\[ 1.3921 \]
qiymatiga nisbatan ancha past.
Manba shuningdek same-image EMD distributions turli tasvirlar orasidagi cross-image reference distribution’dan pastroq ekanini bildiradi.
Bu natija ikki model bir xil tasvirda oʻxshash anatomik regions’ga positive attribution berishi bilan mos keladi.
Ammo past \(EMD_{pos}\):
- model klinik jihatdan toʻgʻri sababiy tushuntirish bergani,
- topilgan hudud validated biomarker ekani,
- model kasallik patofiziologiyasini oʻrgangani
degani emas.
Bu Tadqiqot “Kvant Ustunligi”ni Koʻrsatadimi?
Yoʻq; tadqiqot haqiqiy kvant qurilmasiga nisbatan klassik kompyuter ustunligi yoki hisoblash murakkabligi maʼnosida quantum advantage koʻrsatmaydi. HQiCNNning oraliq qatlami klassik kompyuterda emulyatsiya qilingan va natijalar faqat muayyan maʼlumot/optimallashtirish rejimlarida bu kvantdan ilhomlangan ifoda parameter-controlled klassik CNNga muqobil boʻla olishini koʻrsatadi.
Tadqiqotning xulosa boʻlimidagi eng muhim gaplardan biri HQiCNN afzalligi faqat “quantum operations qoʻshilganidan” kelib chiqmasligini taʼkidlaydi.
Natija:
- training data miqdori,
- learning rate va optimization dynamics,
- entanglement tanlovi,
- observable set
bilan birga oʻzgaradi.
Shuning uchun “kvant layer har doim yaxshiroq representation oʻrganadi” kabi umumiy xulosa manba tomonidan qoʻllab-quvvatlanmaydi.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- Toʻrt-qubitli emulyatsiya qilingan quantum circuit klassik CNNning oraliq dense layer’iga muqobil representation layer sifatida ishlatilishi mumkin.
- HQiCNN oʻrta hajmdagi ayrim training-data regimes’da klassik CNNga qaraganda yuqoriroq test accuracy bergan.
- Klassik CNN eng katta OCT training set’ida tadqiqotning eng yuqori umumiy accuracy qiymatiga erishgan.
- Learning rate va training size oʻzaro taʼsiri ikki arxitektura orasidagi farqqa sezilarli taʼsir qiladi.
- 10−3 learning rate tadqiqot sharoitida eng muvozanatli/stabil variant sifatida hisobot qilingan.
- Batch sizes 8, 16 va 32 sharoitida 1000-sample OCT experiment’da HQiCNN afzalligi saqlangan.
- Entanglement umuman kuchli natija uchun zarur emas.
- Large-data regime’da boyroq observable sets kichik, ammo oʻlchanadigan yaxshilanish bergan.
- OASIS robustness test’ida small-data → HQiCNN afzalligi, large-data → CNN afzalligiga oʻtadigan oʻxshash tendensiya kuzatilgan.
- \(|SHAP|IoU\) va \(EMD_{pos}\) ikki modelning attribution patterns’ini taqqoslash uchun ishlatilgan.
- 1000 sample’da HQiCNN SHAP maps koʻproq localized koʻrinsa, 30000 sample’da modellarning attribution distributions’i koʻproq oʻxshashgan.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
- Haqiqiy kvant kompyuteri CNNdan yaxshiroq tibbiy tasvir tasnifi qilishi koʻrsatilmagan.
- Quantum computational advantage yoki asymptotic quantum speedup koʻrsatilmagan.
- HQiCNN barcha datasets va barcha training sizes uchun CNNdan ustun ekani koʻrsatilmagan.
- Entanglement tasniflash muvaffaqiyati uchun zarur ekani koʻrsatilmagan.
- SHAP regions klinik tasdiqlangan biomarker emas.
- OASIS labels formal CDR clinical assessments emas.
- Model shifoxona qoʻllanishida prospective tarzda tasdiqlanmagan.
- Mustaqil multicenter external clinical validation oʻtkazilmagan.
- Clinician reader study oʻtkazilmagan.
- MRI classification full 3D volume boʻyicha bajarilmagan; 2D slices ishlatilgan.
- Training time, inference speed, memory use va umumiy computational efficiency benchmark qilinmagan.
- Haqiqiy quantum-hardware noise, decoherence va finite-shot measurement error sinovdan oʻtkazilmagan.
Asosiy cheklovlar
- Quantum circuit faqat toʻrt qubit va shallow emulated tuzilishga ega.
- Haqiqiy quantum hardware ishlatilmagan.
- Hardware connectivity constraint yoʻq.
- Finite-shot measurement uncertainty yoʻq.
- Decoherence yoki gate noise yoʻq.
- OASIS robustness task 2D slices’ga tushirilgan.
- Independent external clinical dataset validation yetishmaydi.
- Clinician reader study yetishmaydi.
- Computational-cost comparison oʻtkazilmagan.
- Code public repository sifatida berilmagan; corresponding authors’dan reasonable request bilan olinishi mumkinligi aytilgan.
- “Parameter-matched” iborasi ishlatilsa-da manuscript ikki modelning jami trainable-parameter sonlarini ochiq numeric comparison jadvalida bermaydi.
Manba ichidagi muhim hisobot izohlari
- Figure 3 caption’da “red areas” oʻrniga “read areas” yozuv xatosi bor; heatmap’ning qizil hududlari HQiCNN yaxshiroq boʻlgan joylardir.
- Figure 3 discrete configurations’dan tuzilgan boʻlsa-da vizual smoothness uchun interpolation ishlatadi.
- Figure 4(c) observable-set taqqoslovi boʻlsa-da subfigure caption batch-size comparison deb yozilgan.
- Observable indekslari toʻrt-qubit kontekstida \(i,j,k\in\{1,4\}\) shaklida bosilgan; manba bu literal setmi yoki 1–4 indeks oraligʻining qisqartirilgan/xato yozilishimi, tushuntirmaydi.
- “Parameter-matched” iborasi manbada ishlatiladi, ammo total trainable-parameter counts alohida sonli jadval sifatida berilmagan.
Manba va Usul Haqida Izoh
Asl sarlavha: Do emulated quantum circuits change what CNNs look at? Performance and explainability comparison in medical image classification
Mualliflar: Guillermo Rubiños Rodríguez; Martín Ottavianelli; Mateo Alonso; Gonzalo Blázquez Gil; Boris-Stephan Rauchmann; Pablo Díez-Valle; Sergio Altares-López.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Teng hissa: Pablo Díez-Valle va Sergio Altares-López manbada teng hissa qoʻshgan mualliflar sifatida belgilangan.
Corresponding author: Sergio Altares-López.
Corresponding-author e-mail: slopez@med.lmu.de
Muassasa 1: Instituto Tecnológico de Galicia, Cantón Grande 9, Planta 3, 15003 A Coruña, Spain.
Muassasa 2: Centro Singular de Investigación en Tecnoloxías Intelixentes (CiTIUS), Universidade de Santiago de Compostela, Santiago de Compostela, 15782, Spain.
Muassasa 3: Department of Neuroradiology, LMU University Hospital, Ludwig Maximilian University of Munich, Marchioninistraße 15, 81377 Munich, Germany.
Muassasa 4: Department of Psychiatry and Psychotherapy, LMU University Hospital, LMU Munich, Nussbaumstraße 7, 80336 Munich, Germany.
Manba turi: Quantum machine learning / medical image classification sohasidagi hisoblash preprinti.
Platforma: arXiv.
arXiv: arXiv:2607.21186v1 [quant-ph].
Yuborilgan sana: 23 iyul 2026.
DOI: 10.48550/arXiv.2607.21186.
Taqriz holati: Koʻrib chiqilgan manba arXiv preprint versiyasidir. Bibliografik tekshiruv vaqtida shu tadqiqot uchun alohida va tasdiqlangan yakuniy taqrizdan oʻtgan jurnal versiyasi aniqlanmagan.
Litsenziya: arXiv yozuvi metadata’sida arXiv non-exclusive distribution license koʻrsatiladi; Creative Commons litsenziyasi bor deb taxmin qilinmagan.
Sahifalar soni: 17.
Rasmlar soni: 6.
Jadvallar soni: 2.
Asosiy tadqiqot turi: Mavjud medical-image datasets ustida supervised machine-learning benchmark va explainability analysis.
Quantum tadqiqot turi: Haqiqiy quantum hardware emas; toʻrt-qubitli parametrik circuit’ning classical emulation’i.
Quantum implementation: Native PyTorch operations; dedicated quantum-computing framework ishlatilmagan.
Gradient usuli: Emulated circuit uchun automatic differentiation/backpropagation; physical-circuit parameter-shift measurement ishlatilmagan.
Classical baseline: Umumiy convolutional backbone + \(4\rightarrow12\) ReLU dense layer.
HQiCNN branch: Umumiy convolutional backbone + 4-qubit emulated parameterized quantum circuit + 12 observable output.
Input preprocessing: 2π·sigmoid(v), remainder(v,2π) va no-transform taqqoslangan; qolgan tadqiqotda scaled sigmoid tanlangan.
Asosiy OCT maʼlumotlar toʻplami: 84,495 JPEG retinal OCT image; NORMAL, CNV, DME va DRUSEN sinflari.
Robustness maʼlumotlar toʻplami: OASIS-1-derived structural MRI; manba 416 subject, 18–96 yosh oraligʻini bildiradi.
OASIS task sinflari: Non Demented, Very Mild Dementia, Mild/Moderate Dementia.
CDR chegarasi: OASIS labels formal clinical CDR assessment emas; manba faqat approximately corresponding CDR stages shaklida aloqa oʻrnatadi.
Input resolution: 64 × 64 pixel.
Input normalization: [0,1].
OCT hyperparameter executions: 640.
Random seeds: 10.
Maximum epochs: 100.
Early stopping patience: 8 epoch.
LR scheduler patience: 3 epoch.
LR reduction factor: 0.3.
Loss: Cross-entropy.
OCT highest reported accuracy: CNN, learning rate 0.001, 30000 training samples: \(0.937\pm0.006\).
Explainability usullari: \(|SHAP|IoU\) va \(EMD_{pos}\).
EMDpos: 1000 samples uchun \(0.066\pm0.019\); 30000 samples uchun \(0.045\pm0.018\).
EMDpos theoretical range: \(0\le EMD_{pos}\le(63/64)\sqrt2\approx1.3921\).
External clinical validation: Yoʻq.
Clinician reader study: Yoʻq.
MRI dimensionality: Full 3D classification oʻrniga processed 2D axial slices ishlatilgan.
Computational-cost analysis: Training time, inference efficiency va memory requirements tizimli ravishda benchmark qilinmagan.
Data availability: OCT data manba havolasidagi mavjud dataset’ga; OASIS1-derived images va preprocessing data manbada koʻrsatilgan dataset manbalariga asoslanadi.
Code availability: Corresponding authors’dan reasonable request bilan berilishi mumkinligi aytilgan; manba public code repository bermaydi.
Moliyalashtirish: PESL-Stiftung-Alzheimer 2026, Bayern, Germany, registered project 80765114 Pesl-Alzheimer-Stift; Principal Investigator Dr.-Ing. Sergio Altares-López. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Gonzalo Blázquez Gil va Pablo Díez-Valle shuningdek CDTI CERVERA Research Programme tomonidan moliyalashtirilgan ARQADE (CER-20251019) yordamini tan oladi.
Mualliflar hissasi: Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle va Sergio Altares-López experiments’ni loyihalagan va rejalashtirgan. Guillermo Rubiños Rodríguez va Martín Ottavianelli experiments’ni bajargan. Gonzalo Blázquez Gil, Sergio Altares-López va Boris-Stephan Rauchmann funding taʼminlagan. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle va Sergio Altares-López results interpretation’ga hissa qoʻshgan. Guillermo Rubiños Rodríguez va Sergio Altares-López manuscript writing’da yetakchi rol oʻynagan. Barcha mualliflar critical feedback bergan hamda tadqiqot, tahlil va manuscript shakllanishiga hissa qoʻshgan.
Manfaatlar toʻqnashuvi: Mualliflar competing financial interests yoʻqligini bildiradilar.
Alohida ethics statement: Yuklangan preprint’da alohida institutional-review/ethics-approval statement boʻlimi koʻrinmaydi. Tadqiqot yangi patient recruitment oʻrniga mavjud datasets ustida computational analysis oʻtkazadi; bundan tashqari etik tasdiq holati manba nomidan taxmin bilan toʻldirilmagan.
Takroriylik tekshiruvi: Ushbu exact sarlavha va arXiv:2607.21186 uchun oldingi Verianla ishlov berish yozuvi boʻlmagani sababli yangi maqola sifatida tayyorlangan.
Manba ichidagi hisobot izohlari: Figure 4(c) caption observable-set graph’ni batch-size comparison deb belgilaydi; observable-index notation’da \(\{1,4\}\) ishlatilishi kontekst jihatidan noaniq; Figure 3 interpolation ishlatadi; total model parameter counts alohida numeric table sifatida berilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan