


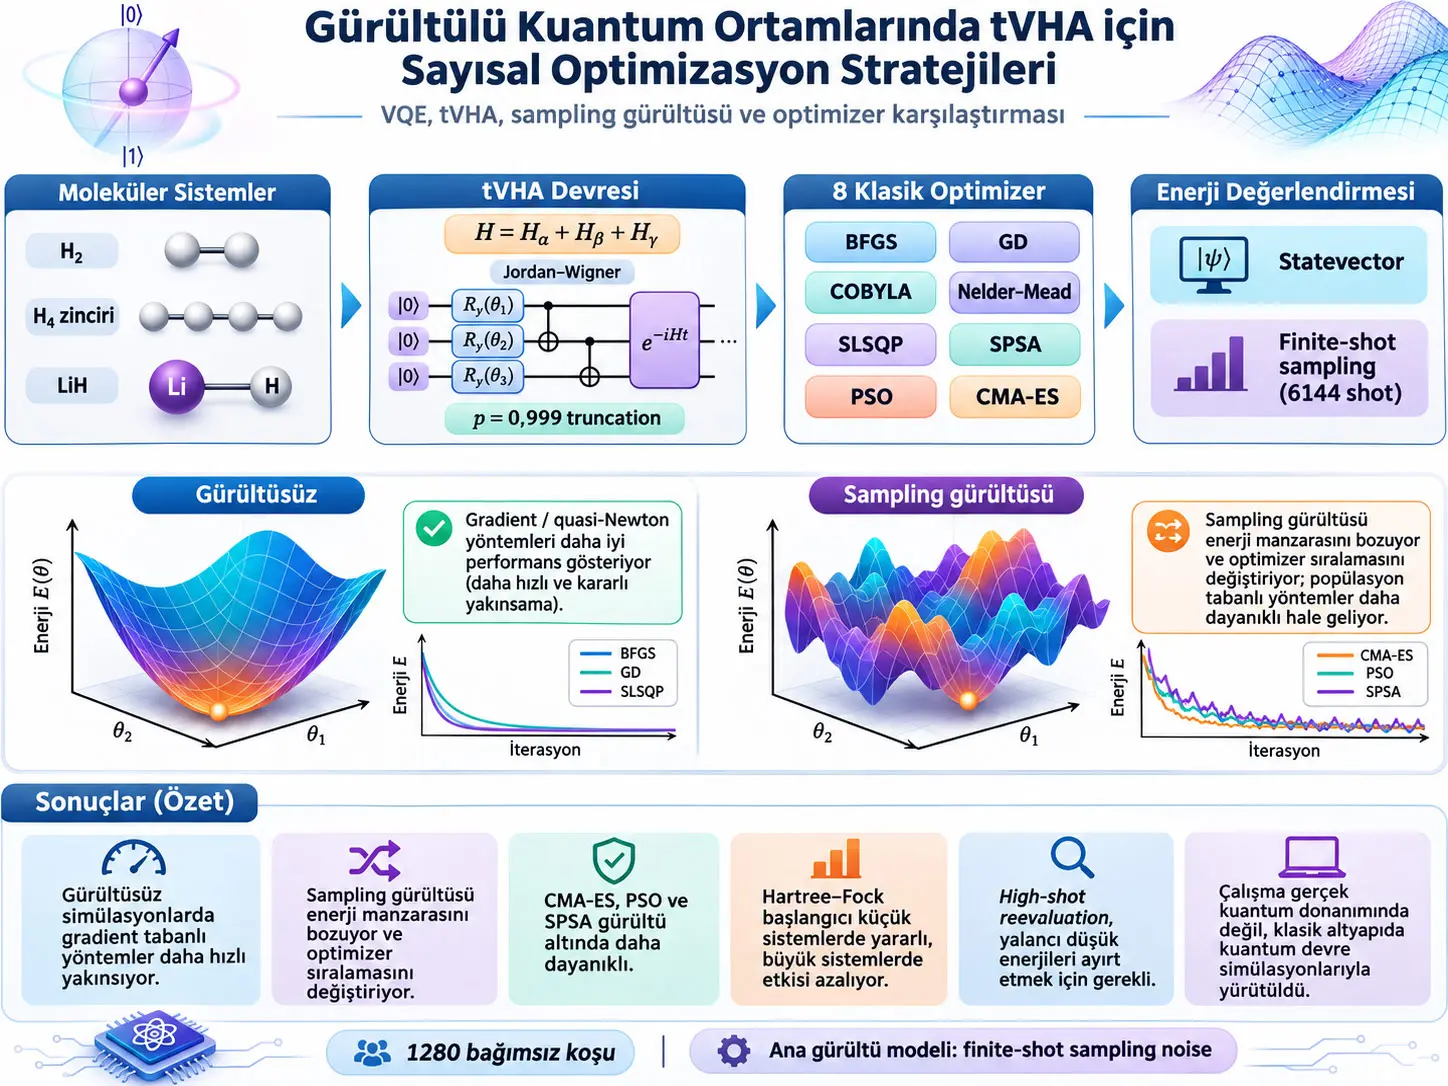
Truncated Variational Hamiltonian Ansatz (tVHA), moleküler elektronik Hamiltonyenin fiziksel yapısından türetilen, parametreli kuantum devresini daha yönetilebilir hale getirmek için özellikle non-Coulomb iki-cisim terimlerini kontrollü biçimde budayan, kimyasal olarak yapılandırılmış bir varyasyonel kuantum ansatzıdır. Bu çalışma, tVHA tabanlı Variational Quantum Eigensolver (VQE) hesaplamalarında sekiz klasik optimizasyon algoritmasının davranışını H2, doğrusal H4 zinciri ve LiH'nin full-space ve active-space gösterimleri üzerinde karşılaştırmaktadır. Araştırma gerçek kuantum donanımı üzerinde yürütülmemiş; quantum circuits klasik yüksek başarımlı hesaplama altyapısında Qiskit ile simüle edilmiştir. Bu nedenle burada ölçülen “gürültü dayanıklılığı”, öncelikle finite-shot sampling noise'a karşı simülasyon performansıdır.
Karşılaştırılan sekiz optimizer BFGS, Covariance Matrix Adaptation Evolution Strategy (CMA-ES), COBYLA, Gradient Descent (GD), Nelder–Mead, Particle Swarm Optimization (PSO), Sequential Least Squares Programming (SLSQP) ve Simultaneous Perturbation Stochastic Approximation (SPSA)'dır. Her molecule–optimizer ikilisi dört senaryoda test edilmiştir: Hartree–Fock başlangıç + statevector, Hartree–Fock başlangıç + finite-shot sampling, random başlangıç + statevector ve random başlangıç + finite-shot sampling. Her senaryo için 10 bağımsız koşu gerçekleştirilmiş ve toplam:
\[ 4\ \text{moleküler temsil} \times 8\ \text{optimizer} \times 4\ \text{senaryo} \times 10\ \text{koşu} = 1280 \]
bağımsız simulation üretilmiştir.
Ana noisy benchmark'ta function evaluation başına 6144 shot kullanılmıştır. Exact reference için Qiskit StatevectorEstimator, finite-shot hesaplamalar için Qiskit Aer Estimator kullanılmıştır. Aer Estimator Born kuralına göre örnekleme yaptığı için measured expectation values finite sample variance taşır. Çalışmanın temel bulgusu, sampling noise'un yalnız sonuçlara küçük hata eklemediği; cost landscape'in şeklini, görünür minimumları, gradient directions'ı ve dolayısıyla optimizer sıralamasını değiştirdiğidir.
Gürültüsüz statevector koşullarında özellikle küçük H2 sistemi için BFGS ve başka deterministik yöntemler son derece hızlı ve doğru yakınsarken, finite-shot sampling noise altında bu üstünlük büyük ölçüde kaybolmaktadır. Moleküler ve parametre uzayı karmaşıklaştıkça CMA-ES, PSO ve SPSA gibi population-based veya stochastic yöntemler daha tutarlı hale gelmektedir. Full-space LiH noisy benchmark'ında high-shot reevaluation sonrasında CMA-ES yaklaşık \(8\times10^{-3}\) Ha hata ile kaynakta en iyi sonucu verirken, active-space LiH'de CMA-ES \(2.6\times10^{-4}\) Ha, SPSA \(3.9\times10^{-4}\) Ha ve PSO \(4.2\times10^{-4}\) Ha seviyelerine ulaşmıştır.
Çalışmanın en kritik fiziksel yorum sınırı variational principle ile ilgilidir. Exact expectation value için:
\[ E(\boldsymbol{\theta})\ge E_0 \]
olmaya devam eder. Finite-shot hesaplamada bunun altında görülebilen değer:
\[ \hat E(\boldsymbol{\theta})
şeklindeki istatistiksel enerji tahminidir. Bu durum gerçek fiziksel quantum state'in temel durum enerjisinden daha düşük enerjiye sahip olduğu anlamına gelmez. Sampling fluctuation, ölçülen estimator'ı geçici olarak aşağı çekebilir.
Çalışmanın sonuçları gerçek quantum hardware performansının doğrudan doğrulaması değildir. Benchmark coherent gate errors, stochastic gate errors, amplitude damping, thermal relaxation veya readout-assignment bias içermemektedir. Yazarlar da future work kapsamında bu gerçekçi hardware noise channels'ın ayrıca test edilmesi gerektiğini belirtmektedir.
tVHA Nedir ve VQE İçinde Ne Yapar?
Truncated Variational Hamiltonian Ansatz, moleküler Hamiltonyenin tek-elektron, Coulomb iki-elektron ve non-Coulomb iki-elektron bileşenlerini doğrudan parametreli quantum evolution bloklarına dönüştüren ve daha düşük devre karmaşıklığı için non-Coulomb katkıların bir bölümünü önem sırasına göre kesen kimyasal olarak yapılandırılmış bir ansatzdır; VQE içinde görevi, temel durum enerjisini arayan classical optimizer'ın ayarlayacağı quantum state ailesini tanımlamaktır.
VQE neden hem kuantum hem klasik bir algoritmadır?
Variational Quantum Eigensolver, hybrid quantum–classical bir yöntemdir. Quantum tarafı parametreli bir durum:
\[ |\psi(\boldsymbol{\theta})\rangle \]
hazırlar ve Hamiltonyen expectation value'yu ölçer:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle. \]
Classical optimizer ise \(\boldsymbol{\theta}\) parametrelerini değiştirerek bu enerjiyi küçültmeye çalışır.
Dolayısıyla optimizer'ın gördüğü objective function kuantum devrenin ürettiği enerji tahminidir. Bu tahmin gürültülü olduğunda optimizer yanlış gradient, yanlış curvature veya geçici false minimum görebilir.
Ansatz nedir?
Ansatz, VQE'nin arama yapacağı parametreli quantum-state ailesidir. İyi bir ansatz iki zıt ihtiyacı dengelemelidir:
- Gerçek moleküler ground state'e yeterince yaklaşabilecek kadar expressive olmalıdır.
- NISQ koşullarında çalıştırılabilecek kadar az parametreli ve düşük devre derinliğine sahip olmalıdır.
Çok zayıf ansatz ground state'e erişemez. Çok karmaşık ansatz ise devre derinliğini, ölçüm maliyetini ve optimizasyon zorluğunu artırabilir.
Moleküler Hamiltonyen nasıl parçalanıyor?
Kaynak tVHA yapısını önce:
\[ H=H_{\alpha}+H_{\beta}+H_{\gamma} \tag{1} \]
şeklinde tanımlamaktadır.
Burada:
- \(H_{\alpha}\): one-body terimleri,
- \(H_{\beta}\): Coulomb two-body terimleri,
- \(H_{\gamma}\): non-Coulomb two-body terimleri
temsil eder.
Kaynak Denklem (2)'yi şu biçimde vermektedir:
\[ H= \sum_{ij} h_{ij}a_i^{\dagger}a_j + \frac{1}{2} \sum_{ij} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ja_i + \frac{1}{2} \sum_{\substack{ijk\ell\\i\neq k\\j\neq\ell}} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ka_{\ell}. \tag{2} \]
\(a_i^\dagger\) fermionic creation operator, \(a_j\) annihilation operator'dür. \(h_{ij}\) one-electron integrals'ın, \(g_{ijk\ell}\) ise two-electron interaction coefficients'in sembolik gösterimidir.
Kaynak notasyonu uyarısı: Denklem (2)'nin Coulomb teriminde toplam işareti yalnız \(i,j\) üzerinde yazılıyken coefficient \(g_{ijk\ell}\) biçiminde dört indeks taşımaktadır. Kaynak bu noktada \(k,\ell\) indislerini ayrıca açıklamamaktadır. Bu nedenle Verianla denklemi daha alışılmış bir indeks yapısına sessizce dönüştürmemiş, kaynaktaki gösterimi korumuştur.
tVHA'daki truncation threshold neyi ifade ediyor?
Non-Coulomb two-body terms önem büyüklüğüne göre sıralandıktan sonra kaynak Denklem (3)'te cumulative truncation fraction'ı:
\[ p= \frac{1} {\sum_s |g_s^{\gamma}|} \sum_{s=1}^{s_{\mathrm{cut}}} |g_s^{\gamma}| \tag{3} \]
olarak tanımlamaktadır.
Burada:
- \(g_s^\gamma\): non-Coulomb two-body coefficient,
- \(s\): dört fermionic index'in tek sıralı indeks altında toplanmış biçimi,
- \(s_{\mathrm{cut}}\): korunan terms için cutoff,
- \(p\): korunan cumulative interaction weight fraction'dır.
Bu benchmark'ta:
\[ p=0.999 \]
kullanılmıştır.
Yani kaynak tanımına göre non-Coulomb two-body interaction strength'in cumulative büyüklüğünün %99,9'unu oluşturan terms korunmaya çalışılmış, daha küçük katkılar devre karmaşıklığını azaltmak için budanmıştır.
Bu truncation ücretsiz değildir. Daha az operator daha sığ circuit üretmeye yardım edebilir; fakat ansatz'ın erişebildiği state space'i daraltarak reachability deficit oluşturabilir. Böyle bir durumda optimizer kusursuz çalışsa bile ansatz gerçek full-configuration-interaction ground state'e tam olarak ulaşamayabilir.
Fermionic Hamiltonyen neden qubit operatorlerine dönüştürülüyor?
Elektronlar fermion oldukları için electronic Hamiltonian creation/annihilation operators ile yazılır. Gate-model quantum circuit ise qubit ve Pauli operators ile çalışır. Çalışmada fermionic Hamiltonian:
\[ H_{\alpha} = \sum_{\alpha}c_{\alpha}P_{\alpha}, \qquad H_{\beta} = \sum_{\beta}c_{\beta}P_{\beta}, \qquad H_{\gamma} = \sum_{\gamma}c_{\gamma}P_{\gamma} \]
şeklindeki Pauli-term yapılarına Jordan–Wigner transformation ile dönüştürülmektedir.
Kaynak Bravyi–Kitaev transformation'ın da prensipte mümkün olduğunu, ancak Jordan–Wigner mapping'in her qubit state'ini spin-orbital occupation number olarak daha doğrudan yorumlamaya izin verdiğini belirtmektedir.
Commuting Pauli groups neden kullanılıyor?
Birbirleriyle commute eden Pauli terms aynı measurement context içinde birlikte ele alınabilir. Kaynak Pauli terms'i graph coloring ile commuting groups'a ayırmakta ve bu sayede ölçüm yükünü azaltmayı amaçlamaktadır.
Üç Hamiltonian fragment için commuting-set families:
\[ \mathcal{G}^{\alpha}, \qquad \mathcal{G}^{\beta}, \qquad \mathcal{G}^{\gamma} \]
olarak gösterilir.
tVHA unitary dönüşümü nasıl kuruluyor?
Kaynak Denklem (4):
\[ U(\boldsymbol{\alpha},\boldsymbol{\beta},\boldsymbol{\gamma}) = \prod_{d=1}^{D} \left[ \prod_{G\in\mathcal{G}^{\alpha}} e^{i\alpha_d c_{\alpha,G}P_{\alpha}} \right] \left[ \prod_{G\in\mathcal{G}^{\beta}} e^{i\beta_d c_{\beta,G}P_{\beta}} \right] \left[ \prod_{G\in\mathcal{G}^{\gamma}} e^{i\gamma_d c_{\gamma,G}P_{\gamma}} \right]. \tag{4} \]
Burada:
- \(D\): discretization/Trotter-step sayısı ve dolayısıyla circuit depth ile ilişkili parametre,
- \(\alpha_d,\beta_d,\gamma_d\): classical optimizer tarafından değiştirilen variational parameters,
- \(c_{\alpha,G},c_{\beta,G},c_{\gamma,G}\): Pauli-group coefficients,
- \(P\): ilgili Pauli operator,
- \(\mathcal G\): commuting groups'dur.
Non-commuting Hamiltonian parçalarının exponential evolution'ı birinci mertebe Suzuki–Trotter, diğer adıyla Lie–Trotter expansion ile yaklaşık olarak gerçekleştirilmektedir.
Kaynak H2 için nasıl bir quantum circuit örneği veriyor?
Kaynak Figure 1, H2 ground-state problemi için tamamen decomposed, 4-qubit ve 3 trainable-parameter tVHA circuit örneğini göstermektedir.
| Gate | Sayı |
|---|---|
| CX | 48 |
| H | 32 |
| \(\sqrt{X}\) | 16 |
| RZ | 16 |
| \(\sqrt{X}^{\dagger}\) | 16 |
| RZZ | 6 |
| U3 | 2 |
Bu gate count yalnız kaynakta gösterilen H2 circuit örneğine aittir; diğer moleküller için aynı gate sayılarını varsaymak doğru değildir.
Hartree–Fock initialization nasıl oluşturuluyor?
Kaynak adiabatic state preparation fikrine dayalı başlangıcı:
\[ U_{\mathrm{ad}} = \prod_{d=1}^{D} e^{-i\frac{\tau}{D}H_0} e^{-i\frac{\tau}{D}\frac{d}{D}V} \tag{5} \]
şeklinde vermektedir.
Burada:
- \(H_0\): non-interacting Hamiltonian component,
- \(V\): interacting component,
- \(\tau\): effective adiabatic-evolution parameter,
- \(d/D\): interaction'ın adım ilerledikçe büyüyen fractional weight'i,
- \(D\): discretization step sayısıdır.
Kaynak \(H_{\beta}\) ve \(H_{\gamma}\) için başlangıç parametrelerini:
\[ \beta_d^{(0)} = \gamma_d^{(0)} = \frac{\tau}{D} \langle V\rangle_{\mathrm{HF}} \frac{d}{D} \]
şeklinde vermektedir.
\(H_{\alpha}\) başlangıç parametresine ilişkin kaynak cümlesinde \(\alpha_d^{(0)}\), \(\tau/D\) ve \(\langle H_\alpha\rangle_{\mathrm{HF}}\) birlikte yazılmaktadır; ancak yayımlanan PDF metninde bu bölümde açık eşitlik işareti görünmemektedir. Bu nedenle eksik görünen sembolik bağlantı Verianla tarafından tahmin edilerek tamamlanmamıştır.
Random initialization ise:
\[ \theta_i^{(0)} \sim \mathcal U(0,1) \]
uniform distribution ile yapılmıştır.
Finite-Shot Sampling Noise Neden Enerji Manzarasını Bozar?
Finite-shot sampling noise, expectation value'nun sonsuz ölçüm ortalaması yerine sınırlı sayıda quantum measurement outcome'dan tahmin edilmesi nedeniyle enerji tahminine rastlantısal hata ekler; gerçek gradient küçük olduğunda bu hata gradient'i maskeleyebilir, ters yönlü gösterebilir, düz vadileri yapay biçimde pürüzlü hale getirebilir ve optimizer'a gerçekte bulunmayan minimumlar gösterebilir.
Statevector ile shot-based simulation arasındaki fark
StatevectorEstimator quantum state amplitudes üzerinden expectation value'yu deterministik olarak hesaplar. Finite-shot sampling variance yoktur.
Aer Estimator ise measurement outcomes'u Born kuralına göre örnekler. Shot sayısı sonlu olduğunda aynı parameter point tekrar ölçülürse aynı estimated energy çıkmak zorunda değildir.
Kaynak ana benchmark için:
\[ N_{\mathrm{shots}}=6144 \]
kullanmıştır.
Sampling variance genel olarak:
\[ \sigma^2\propto\frac{1}{N_{\mathrm{shots}}} \]
ölçeğinde küçülür.
Bu nedenle standard deviation yaklaşık olarak:
\[ \sigma\propto\frac{1}{\sqrt{N_{\mathrm{shots}}}} \]
davranışı gösterir. Shot sayısını dört katına çıkarmak, diğer koşullar aynıysa standard deviation'ı yaklaşık yarıya indiren square-root scaling ile uyumludur.
Energy-landscape slicing nasıl yapıldı?
Yazarlar önce yüksek hassasiyetli sampling ile:
\[ N_{\mathrm{shots}}\ge10^6 \]
koşulunda reference parameter set:
\[ \boldsymbol{\theta}^{\ast} \]
elde etmiştir.
Sonra seçilmiş iki parameter direction için:
\[ \delta_i,\delta_j\in[-\Delta,\Delta] \]
grid'i boyunca enerji tekrar hesaplanmış, diğer parameters optimum reference values'da sabit tutulmuştur.
Böylece aynı temel energy surface'in farklı shot counts altında optimizer tarafından nasıl “görüldüğü” karşılaştırılmıştır.
Kaynakta gözlenen üç temel landscape bozulması
Kaynak Figure 2'nin ana mesajı üç mekanizma altında özetlenebilir:
- False minima: finite-shot fluctuations nedeniyle gerçek yüzeyde bulunmayan yerel düşük bölgeler ortaya çıkabilir.
- Gradient reversal: noisy slope gerçek slope'un ters yönünü gösterebilir.
- Noise-induced ruggedness: özellikle quasi-degenerate veya flat valley tabanlarında küçük gerçek gradient sampling fluctuations tarafından bastırılır.
Bu koşullarda optimizer deterministic descent yerine parameter space içinde stochastic drift veya random-walk benzeri hareket gösterebilir.
Barren plateau nedir?
Barren plateau, parameterized quantum circuit'in cost-function gradient'larının sistem büyüdükçe son derece küçük hale geldiği ve optimizer'ın anlamlı descent direction bulmasının zorlaştığı düz optimization landscape rejimidir.
Kaynak teorik bağlamı:
\[ \ell_{\theta} = \langle\rho(\theta),O\rangle, \qquad \rho(\theta)\in\mathcal B(\mathcal H) \tag{6} \]
ve:
\[ \operatorname{Var}_{\theta}(\ell_{\theta}) \in \mathcal O\left(\frac{1}{4^n}\right) \tag{7} \]
ifadeleriyle açıklamaktadır.
Burada:
- \(\rho(\theta)\): parameterized quantum state/operator representation,
- \(O\): observable,
- \(\ell_\theta\): observable expectation'dan türetilen loss,
- \(n\): qubit sayısıdır.
Hilbert-space dimension:
\[ \dim\mathcal H=2^n \]
ve operator-space dimension:
\[ \dim\mathcal B(\mathcal H)=4^n \]
olarak büyür.
Kaynak 12-qubit LiH örneği için:
\[ 4^{12}=16\,777\,216\approx1.6\times10^7 \]
operator-space dimension büyüklüğünü vurgular.
Denklem (6)–(7) bu benchmark'ta ölçülmüş yeni empirical scaling sonucu değil, sampling noise ile barren-plateau probleminin birlikte neden ciddi olabildiğini açıklayan teorik çerçevedir.
Varyasyonel İlke Finite-Shot Ölçümde Gerçekten İhlal Ediliyor mu?
Exact quantum expectation value varyasyonel alt sınırı ihlal etmez; \(E(\theta)\ge E_0\) olmaya devam eder, ancak finite-shot measurement'tan hesaplanan rastlantısal estimator \(\hat E\) gerçek expectation'ın çevresinde dağıldığı için bazı örneklerde \(E_0\)'ın altında görünebilir ve kaynak “variational-bound violation” ifadesini bu görünür istatistiksel ihlal için kullanır.
Exact enerji ile estimated enerji aynı şey değildir
Varyasyonel ilke:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle \ge E_0 \]
der.
\(E_0\) exact ground-state energy'dir.
Finite-shot ölçümde optimizer'ın gördüğü ise:
\[ \hat E = E+\text{sampling fluctuation} \]
biçimindeki stochastic estimator'dır.
Eğer gerçek variational energy ground state'e zaten çok yakınsa, negatif sampling fluctuation kalan energy gap'ten büyük olabilir. O zaman:
\[ \hat E
görülebilir.
Bu “daha düşük fiziksel ground state keşfedildi” anlamına gelmez.
Sampling noise matematiksel olarak nasıl modelleniyor?
Kaynak Denklem (8):
\[ \bar C(\boldsymbol{\theta}) = C(\boldsymbol{\theta}) + \epsilon_{\mathrm{sampling}} \tag{8} \]
şeklindedir.
Burada:
- \(C(\theta)\): gerçek expectation-based objective,
- \(\bar C(\theta)\): finite-shot noisy estimate,
- \(\epsilon_{\mathrm{sampling}}\): mean'i sıfır kabul edilen sampling error'dur.
Kaynak:
\[ \operatorname{Var} (\epsilon_{\mathrm{sampling}}) = \frac{\operatorname{Var}[C(\theta)]} {N_{\mathrm{shots}}} \]
ilişkisini kullanır.
Hamiltonyen variance nasıl hesaplanıyor?
\[ \hat H = \sum_k c_kP_k \]
için kaynak Denklem (9):
\[ \operatorname{Var}[C(\theta)] = \langle\hat H^2\rangle - \langle\hat H\rangle^2. \tag{9} \]
Bu, observable'ın ikinci momenti ile expectation value'nun karesi arasındaki farktır.
Kaynak ayrıca Pauli-term shot noise'a ek olarak aynı commuting measurement groups içindeki covariance contributions'ın estimator variance'a katkıda bulunduğunu belirtmektedir.
Sampling noise floor nasıl tanımlanıyor?
Kaynak optimization trajectory boyunca effective noise floor'u:
\[ \sigma_{\mathrm{noise}} \approx \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \frac{ \operatorname{Var}[C(\theta_i)] }{ N_{\mathrm{shots}} } } \tag{10} \]
olarak tahmin eder.
Burada \(N\), trajectory boyunca değerlendirilen noktaların sayısıdır.
Noise floor'a yaklaşıldığında optimizer'ın daha düşük observed energy bulması artık mutlaka daha iyi parameters bulduğu anlamına gelmez; measured differences noise magnitude ile aynı ölçeğe girmiş olabilir.
Figure 3'te shot sayısıyla noise floor nasıl değişiyor?
| Shot sayısı | Noise floor (Ha) | Veri statüsü |
|---|---|---|
| 8 | ±6,7 × 10⁻² | Kaynak Figure 3 etiketi |
| 16 | ±4,2 × 10⁻² | Kaynak Figure 3 etiketi |
| 32 | ±2,5 × 10⁻² | Kaynak Figure 3 etiketi |
| 64 | ±1,7 × 10⁻² | Kaynak Figure 3 etiketi |
| 512 | ±6,0 × 10⁻³ | Kaynak Figure 3 etiketi |
| 1024 | ±4,0 × 10⁻³ | Kaynak Figure 3 etiketi |
| 6144 | ±1,6 × 10⁻³ | Kaynak Figure 3 etiketi |
| 12.000 | ±1,2 × 10⁻³ | Kaynak Figure 3 etiketi |
| 30.000 | ±7,3 × 10⁻⁴ | Kaynak Figure 3 etiketi |
Shot sayısı yükseldikçe noise floor azalır; fakat \(1/\sqrt{N_{\mathrm{shots}}}\) karakterindeki scaling nedeniyle aynı mutlak iyileştirmeyi elde etmek giderek daha fazla shot gerektirir. Yazarların “yaklaşık 1000 shot sonrasında diminishing returns” değerlendirmesi, iyileşmenin tamamen durduğu anlamına değil, ek shot başına sağlanan marjinal hassasiyet kazancının küçüldüğüne işaret eder.
Population Mean Neden Tek “En İyi” Adaydan Daha Güvenilir Olabilir?
Sampling noise yaklaşık simetrik olduğunda population içindeki birçok adayın ortalaması pozitif ve negatif measurement fluctuations'ı birbirine karşı sönümleyebilir; buna karşılık yalnız en düşük ölçülen adayı seçmek, büyük population içinde şans eseri aşırı düşük ölçülmüş bir “good outlier” seçme olasılığını artırarak optimizer'ın noise'u gerçek ilerleme sanmasına yol açabilir.
Population büyüdüğünde iki zıt etki aynı anda oluşabilir
Bu çalışmanın önemli nüanslarından biri şudur:
- Best-value selection: population büyüdükçe çok düşük bir lucky noise sample bulma olasılığı artabilir.
- Population mean: population büyüdükçe bağımsız/sınırlı korelasyonlu fluctuations ortalamada birbirini daha iyi götürebilir.
Kaynak population-average estimation error için:
\[ \mathrm{Error} \propto \frac{\sigma_{\mathrm{noise}}}{\sqrt{\lambda}} \]
ölçeklemesini kullanmaktadır.
Burada \(\lambda\), population size'dır.
Bu ifade “sampling noise'un fiziksel temel sınırı kırıldı” biçiminde yorumlanmamalıdır. Daha fazla population member üzerinden istatistiksel bilgi birleştirildiği için tek bir noisy evaluation'a kıyasla mean estimate daha hassas hale gelmektedir.
Kaynağın karşılaştırdığı üç noise-floor stratejisi
- Shot escalation: her evaluation için shot sayısını artırmak.
- Selective high-shot reevaluation: görünürde en iyi candidates'ı daha yüksek shot ile tekrar ölçmek.
- Population averaging: CMA-ES steady-state population statistics'ini kullanmak.
Shot escalation doğrudan variance'ı azaltır ancak maliyeti yükseltir. Selective reevaluation, seçilen aday zaten lucky outlier ise selection bias riski taşır. Population mean ise sampling fluctuations'ın simetrisini kullanarak tek minimum gözleminin bias'ını azaltmayı amaçlar.
Yazarlar CMA-ES'in noise floor tarafından belirlenen steady-state distribution'a yakınsayabilmesini kullanmaktadır; fakat bunun global ground-state optimum'a ulaşmayı garanti etmediğini de açıkça belirtmektedir.
Population size ek analizi ne gösterdi?
Appendix C:
\[ \lambda=7,\ 25,\ 50,\ 100 \]
population sizes için ek analiz sunmaktadır.
\(\lambda=7\) koşulunda bile iteration mean, tek best-value selection'a göre daha düşük hata eğilimi göstermektedir.
\(\lambda=25\) ve özellikle \(\lambda=50\) koşullarında population mean theoretical/empirical noise floor'a oldukça yakın davranmaktadır.
\(\lambda=100\) için 30.000-shot rejiminde kaynak, yaklaşık iteration 5 civarında hızlı biçimde zero-error çevresine gelindiğini, yaklaşık iteration 20'ye kadar bu bölgede kalındığını ve daha sonra noise-induced divergence/overfitting belirtilerinin ortaya çıktığını bildirmektedir.
Bu nedenle çalışma “population ne kadar büyükse her zaman o kadar iyi” sonucuna ulaşmamaktadır. Yazarlar optimum bir population-size window bulunabileceğini öne sürmekte, fakat bütün problemler için geçerli tek bir optimum \(\lambda\) değeri belirlememektedir.
Çalışmanın Yöntemi ve Bulguları
Benchmark, classical high-performance computing altyapısında simüle edilen tVHA circuits üzerinde sekiz classical optimizer'ın exact statevector ve finite-shot sampling koşullarındaki davranışını, Hartree–Fock ve random initialization seçenekleriyle karşılaştırmaktadır.
Moleküler sistemler
| Özellik | H2 | LiH Active Space | LiH Full Space | H4 Zinciri |
|---|---|---|---|---|
| Bond length / distances (Å) | 0,74279 | 1,596 | 1,596 | 0,7; 0,7; 0,768 |
| Charge | 0 | 0 | 0 | 0 |
| Multiplicity | 1 | 1 | 1 | 1 |
| Basis set | STO-3G | STO-3G | STO-3G | STO-3G |
| Active space | Full | (2,2), 3 orbital | Full | Full |
Kaynak footnote'u LiH active-space için orbitals [1,2,3] ve 2 alpha + 2 beta electrons ifadesini kullanmaktadır. Bu gösterim kaynakta verildiği biçimde korunmuştur.
STO-3G basis set ne anlama geliyor?
STO-3G, moleküler orbital calculations'da kullanılan minimal Gaussian basis family'dir. Kaynak bunu bütün sistemlerde aynı basis olarak kullanarak optimizer karşılaştırmasını aynı temel electronic-structure approximation üzerinde yürütmektedir.
Active-space reduction neden önemli?
Active-space yaklaşımı tüm molecular orbitals yerine electron correlation açısından önemli seçilmiş orbitals üzerinde hesap yapar. Böylece:
- qubit/circuit gereksinimi,
- parameter-space boyutu,
- optimizer'ın taraması gereken effective landscape
azaltılabilir.
Ancak active-space sonucu full molecular Hilbert-space çözümüyle aynı problem değildir. Kaynak LiH active-space'in noise robustness'ı artırdığını gösterse de bunu “full LiH problemi eksiksiz ve daha doğru çözüldü” şeklinde yorumlamak doğru değildir.
Karşılaştırılan optimizer'lar
| Optimizer | Kaynak sınıflandırması | Temel çalışma mantığı |
|---|---|---|
| BFGS | Gradient-based | Inverse-Hessian approximation ile quasi-Newton güncellemesi |
| CMA-ES | Metaheuristic / evolutionary | Candidate population ve adaptive multivariate Gaussian covariance |
| COBYLA | Gradient-free | Objective ve constraints için local linear approximations ve trust-region yaklaşımı |
| GD | Gradient-based | Negative gradient direction boyunca parameter update |
| Nelder–Mead | Gradient-free | Simplex reflection, expansion, contraction ve shrink işlemleri |
| PSO | Metaheuristic / swarm | Particles'ın individual-best ve global-best bilgisine göre hareket etmesi |
| SLSQP | Gradient-based | Sequential quadratic programming ve constrained local approximation |
| SPSA | Kaynak Table 3'te gradient-free | Tüm parameters'ı aynı anda perturb ederek iki function evaluation ile stochastic gradient estimate |
SLSQP sınıflandırma notu: Kaynağın Introduction bölümünde COBYLA ile SLSQP “derivative-free techniques” ifadesi altında birlikte anılmaktadır. Buna karşılık Appendix A ve Table 3 SLSQP'yi gradient-based method olarak sınıflandırır ve sequential quadratic programming yapısını açıklar. Verianla ana tabloda daha ayrıntılı Appendix A/Table 3 sınıflandırmasını kullanmış, Introduction'daki farklı ifadeyi gizlememiştir.
Kaç bağımsız simulation çalıştırıldı?
Her optimizer–molecule ikilisi için dört configuration ve configuration başına 10 run vardır:
| Senaryo | Initialization | Energy evaluation |
|---|---|---|
| 1 | Hartree–Fock | Statevector |
| 2 | Hartree–Fock | 6144-shot sampling |
| 3 | Random | Statevector |
| 4 | Random | 6144-shot sampling |
Toplam:
\[ 1280 \]
bağımsız run gerçekleştirilmiştir.
Pseudo-random seeds sabitlenmemiştir. Kaynağa göre böylece starting points, optimizer'ın stochastic steps'i ve shot sampling her trial'da bağımsız stochastic draw olarak gerçekleşmiştir.
Bu tercih ensemble-level robustness'ı değerlendirmek açısından anlamlıdır; fakat tek bir run'ın bit-bit yeniden üretimini sabit seed kullanımına göre zorlaştırır.
Optimizer hyperparameters nasıl seçildi?
Kaynak, optimizer hyperparameters'ın molecule bazında ayrı ayrı tune edilmediğini; ilgili implementations'ın yaygın defaults değerlerinin tercih edildiğini belirtmektedir. Amaç yöntemler arasında case-by-case tuning bias'ını azaltmaktır.
Buna karşılık Appendix E stopping/convergence criteria için açık toleranslar vermektedir.
Convergence criteria
| Optimizer | Kaynak parametresi | Kaynak criterion |
|---|---|---|
| BFGS | \(ftol=10^{-10}\) | \(\frac{f_k-f_{k+1}}{\max(|f_k|,|f_{k+1}|,1)}\le ftol\) |
| COBYLA | \(tol=10^{-7}\) | \(\Delta f_k=|f_{k+1}-f_k|\le tol\) |
| GD | \(tol=5\times10^{-4}\) | \(\|\theta_{k+1}-\theta_k\|\le tol\) |
| CMA-ES | \(tolx=10^{-12}\), \(tolfun=10^{-12}\) | \(\max_i\sigma_i\le tolx\) ve population objective range \(\le tolfun\) |
| Nelder–Mead | \(xatol=10^{-6}\) | \(\|x_{k+1}-x_k\|\le xatol\) |
| PSO | velocity threshold \(10^{-5}\), cluster threshold 1 | Unclustered-particle count ve maximum velocity birlikte sınırın altına indiğinde |
| SLSQP | \(ftol=10^{-10}\) | BFGS ile aynı normalized function-change formu |
| SPSA | \(N=100\), \(allowed\_increase=10^{-3}\) | Son 100 objective value için fitted trend slope pozitif olduğunda stagnation/termination kontrolü |
Appendix E'deki SPSA slope kriteri
Kaynak Denklem (18):
\[ \mathrm{slope} = \frac{1}{N} \frac{df_k}{dk} > 0 \tag{18} \]
gösterimini kullanmaktadır.
Slope, son \(N=100\) objective values üzerinde linear regression ile belirlenmektedir.
Reproducibility boşluğu: Kaynak bütün optimizers için maximum function-evaluation limitinin aynı olduğunu belirtmektedir; ancak yüklenen manuscript metninde bu ortak maximum'un sayısal değeri görünür biçimde raporlanmamıştır. Page 11'de de “running up to optimization iterations” ifadesinde iteration sayısı eksik kalmaktadır. Bu değer Verianla tarafından tahmin edilmemiştir.
Yazılım stack'i
| Python library | Sürüm |
|---|---|
| qiskit | 1.0.2 |
| qiskit_algorithms | 0.3.1 |
| qiskit_nature | 0.7.2 |
| qiskit_aer | 0.14.2 |
| pyscf | 2.6.0 |
| scipy | 1.15.2 |
| cma | 3.3.0 |
Hesaplama altyapısı
Simülasyonlar IT4Innovations Barbora supercomputer üzerinde yürütülmüştür. Kaynak sistemi:
- 192 standard node: node başına 2 × 18-core Intel Xeon ve 192 GB RAM,
- 8 GPU node: 2 × 12-core Intel Xeon + 4 × NVIDIA V100,
- 1 fat node: 8 × 16-core Intel Xeon + 6 TB RAM,
- 200 Gb/s Infiniband HDR,
- 310 TB SCRATCH storage ve 28 GB/s throughput
olarak tanımlamaktadır.
Runs job-level embarrassingly parallel biçimde Slurm jobs olarak dağıtılmıştır. LiH ve H4 için 5–10 concurrent run grupları kullanılmıştır.
Kaynak toplam computational consumption'ı yaklaşık:
\[ 4500\ \text{node-hour} \]
olarak raporlamaktadır.
High-shot reevaluation neden yapılmıştır?
Noisy optimizer bazen lucky sampling fluctuation nedeniyle gerçekte olduğundan çok iyi görünen candidate parameters seçebilir. Figure 4–7 captions, optimization sırasında bulunan candidate parameters'ın:
\[ 10^5\ \text{shot} \]
ile yeniden değerlendirildiğini göstermektedir.
High-shot reevaluation optimizer'ı yeniden çalıştırmak değildir. Amaç aynı parameter point'in enerjisini daha düşük sampling variance ile tekrar ölçerek görünen başarının gerçek parameter quality'den mi yoksa low-shot fluctuation'dan mı kaynaklandığını ayırt etmektir.
H2 sonuçları
Gürültüsüz statevector koşulunda H2 en kolay benchmark'tır.
Kaynak:
- BFGS, CMA-ES, COBYLA, Nelder–Mead ve PSO için yaklaşık \(10^{-13}\)–\(10^{-14}\) Ha altında errors,
- GD + HF için yaklaşık \(10^{-6}\) Ha,
- SPSA için yaklaşık \(3\times10^{-5}\) Ha
raporlamaktadır.
Bu rejimde yöntemler arasındaki ana fark final accuracy'den çok convergence speed'dir.
Sampling noise altında high-shot corrected values için kaynak:
| Optimizer / koşul | Raporlanan hata (Ha) |
|---|---|
| GD + HF | 6,6 × 10⁻⁴ |
| SPSA + HF | 4,1 × 10⁻⁴ |
| CMA-ES | 4,5 × 10⁻⁴ |
| COBYLA | 2,4 × 10⁻³ |
| Nelder–Mead + HF | 3,9 × 10⁻³ |
| BFGS | yaklaşık 4 × 10⁻³ |
| PSO random | 6,5 × 10⁻⁴ |
| PSO HF | 1,0 × 10⁻³ |
SLSQP sampling-noise koşulunda H2'de dahi güvenilir biçimde converge etmemiştir.
Kaynak içi sıralama uyarısı: Kaynak metin “lowest corrected mean errors come from GD ... followed by SPSA ... and CMA-ES” şeklinde yazmaktadır. Ancak verilen sayılar karşılaştırıldığında:
\[ 4.1\times10^{-4} < 4.5\times10^{-4} < 6.6\times10^{-4}. \]
Dolayısıyla sayısal büyüklük sırası SPSA, CMA-ES, GD biçimindedir. Verianla kaynak cümlesini kendi kararıyla yeniden sıralayıp “kaynak böyle dedi” şeklinde sunmamaktadır; hem metinsel ifade hem sayısal değerler görünür tutulmaktadır.
H4 sonuçları
H4 chain daha karmaşık Hamiltonian ve optimization landscape üretmektedir.
Statevector koşulunda kaynak:
- BFGS, COBYLA ve SLSQP için yaklaşık \(7\times10^{-3}\) Ha,
- GD için yaklaşık \(2,5\times10^{-2}\) Ha
hata düzeylerini bildirir.
Sampling-noise high-shot reevaluation sonrasında:
| Optimizer | Raporlanan corrected mean error (Ha) |
|---|---|
| CMA-ES + HF | 2,25 × 10⁻² |
| PSO | 2,7 × 10⁻² |
| GD | 3,01 × 10⁻² |
| SPSA | yaklaşık 3,5–3,8 × 10⁻² bandında |
| COBYLA | yaklaşık 3,5–3,8 × 10⁻² bandında |
| BFGS | >4,5 × 10⁻² |
| Nelder–Mead | >4,5 × 10⁻² |
Kaynak içi sıralama uyarısı: Metin CMA-ES'ten sonra “GD ve PSO” biçiminde bir sıra kurmaktadır; fakat verilen sayılarda PSO'nun \(2,7\times10^{-2}\) Ha değeri GD'nin \(3,01\times10^{-2}\) Ha değerinden daha küçüktür.
LiH full-space sonuçları
Kaynak statevector koşulunda BFGS, CMA-ES, COBYLA, Nelder–Mead ve SPSA'nın yaklaşık:
\[ 4\times10^{-3}\ \mathrm{Ha} \]
civarına ulaştığını, GD'nin yaklaşık \(2\times10^{-2}\) Ha ve PSO'nun yaklaşık \(9\times10^{-3}\) Ha kaldığını belirtmektedir.
Kaynak aynı cümlede ilk grup için “sub-millihartree precision” ifadesini kullanmaktadır.
Ancak:
\[ 4\times10^{-3}\ \mathrm{Ha} = 4\ \mathrm{mHa}. \]
“Sub-millihartree” matematiksel olarak 1 mHa'dan küçük, yani \(10^{-3}\) Ha altı anlamına gelir. Dolayısıyla kaynakta kullanılan niteleme ile aynı cümlede verilen yaklaşık \(4\times10^{-3}\) Ha sayısı birbiriyle uyuşmamaktadır. Verianla sayıyı esas alarak bunu gizlememektedir.
Sampling noise + high-shot reevaluation:
| Optimizer / koşul | Raporlanan hata |
|---|---|
| CMA-ES + HF | ~8,0 mHa |
| CMA-ES random | ~10,5 mHa |
| PSO + HF | ~13,2 mHa |
| PSO random | ~13,6 mHa |
| SPSA + HF | ~16 mHa |
| GD | ~19 mHa |
| BFGS + HF | ~19,7 mHa |
| BFGS random | ~22,2 mHa |
| COBYLA / Nelder–Mead | yaklaşık 20 mHa düzeyi |
Full-space LiH, larger parameter-space koşulunda population-based CMA-ES'in sampling noise altında en tutarlı sonuç verdiği sistemlerden biridir.
LiH active-space sonuçları
Active-space reduction optimization problemini belirgin biçimde kolaylaştırmaktadır.
Statevector koşulunda CMA-ES, PSO, Nelder–Mead ve SPSA:
\[ <2\times10^{-4}\ \mathrm{Ha} \]
seviyesine ulaşmaktadır.
BFGS ve COBYLA da yaklaşık \(2\times10^{-4}\) Ha civarındadır.
Sampling-noise high-shot reevaluation:
| Optimizer / koşul | Raporlanan hata |
|---|---|
| CMA-ES + HF | 2,6 × 10⁻⁴ Ha |
| SPSA | 3,9 × 10⁻⁴ Ha |
| PSO | 4,2 × 10⁻⁴ Ha |
| Nelder–Mead + HF | 5,3 × 10⁻⁴ Ha |
| COBYLA / BFGS | ~8 × 10⁻⁴–1,1 × 10⁻³ Ha |
| GD | birkaç mHa |
| SLSQP | >3 × 10⁻¹ Ha |
Kaynak daha sonraki literature-comparison paragrafında SPSA + HF için \(6,5\times10^{-4}\) Ha ve 486 function evaluation da raporlamaktadır. Section 6'nın high-shot sonuç paragrafında ise \(3,9\times10^{-4}\) Ha yazmaktadır. Kaynak bu iki sayının farklı evaluation stage, aggregation veya reporting choice'tan mı kaynaklandığını açıkça açıklamamaktadır. Bu nedenle iki değer birbiriyle zorla birleştirilmemiştir.
Full LiH ile active-space LiH arasındaki ana fark
Kaynak active-space reduction'ın optimizer demand ve noise sensitivity'yi yaklaşık bir order of magnitude azalttığını belirtmektedir.
Discussion bölümünde COBYLA sampling için active-space truncation sonrasında:
\[ 95.2\% \]
error reduction raporlanmaktadır.
Bu yüzde belirli LiH/COBYLA comparison'a aittir; bütün optimizers, moleküller veya gerçek quantum hardware için genel bir %95,2 iyileşme olarak yorumlanmamalıdır.
Figure 8 neyi gösteriyor?
Kaynak Figure 8, dört sistemin tüm optimizers için final errors değerlerini altı evaluation category halinde karşılaştırmaktadır:
- Random Init Statevector,
- HF Init Statevector,
- Random Init Sampling Noise,
- HF Init Sampling Noise,
- Random-Sampling High-Shot Reevaluation,
- HF-Sampling High-Shot Reevaluation.
Bars mean final error'ı, error bars ise kaynak caption'a göre %95 confidence interval değerlerini temsil eder.
Kaynak Figure 8'in bütün bar heights değerlerini ayrı bir numeric table olarak raporlamamaktadır. Bu nedenle Verianla grafikten piksel okuyarak sahte hassasiyetli yeni sayılar üretmemiştir.
Kaynağın ana optimizer sonucu nasıl özetlenmelidir?
| Koşul | Kaynakta öne çıkan davranış | Yorum sınırı |
|---|---|---|
| Küçük sistem + statevector | BFGS ve deterministic/gradient methods hızlı ve yüksek doğruluklu | Noise yoktur; hardware davranışı değildir |
| Finite-shot sampling | Gradient/curvature information bozulur | Yalnız sampling noise test edilmiştir |
| Daha büyük parameter space | CMA-ES, PSO, SPSA daha kararlı hale gelir | Her system için tek bir universal sıralama yoktur |
| Active-space LiH | Optimization kolaylaşır ve noise sensitivity azalır | Problem full-space LiH ile aynı state space değildir |
| Population mean | Best-value selection'a göre symmetric sampling noise'u daha iyi bastırabilir | Global optimum garantisi değildir |
Çalışmanın desteklediği sonuçlar
- Optimizer ranking sampling noise varlığına güçlü biçimde bağlıdır.
- Gürültüsüz küçük sistemlerde gradient/quasi-Newton yöntemler çok etkili olabilir.
- Finite-shot sampling gradient ve curvature estimates'ı bozabilir.
- SLSQP tested sampling-noise koşullarında ciddi divergence göstermiştir.
- BFGS noiseless koşullardaki güçlü avantajını sampling noise altında büyük ölçüde kaybetmiştir.
- CMA-ES, PSO ve SPSA larger/noisy benchmark'larda daha tutarlı olmuştur.
- Hartree–Fock initialization küçük sistemlerde çoğunlukla yardımcıdır fakat avantajı complexity ile azalır.
- Random initialization bazı population-based methods için HF ile eşit veya daha iyi olabilir.
- Active-space reduction LiH'de optimization ve noise robustness'ı önemli ölçüde iyileştirmiştir.
- Finite-shot energy estimates exact ground-state lower bound'un altında görünebilir.
- High-shot reevaluation low-shot “iyi” sonuçların bir bölümünün sampling artifact olduğunu göstermiştir.
- Population mean, single best candidate selection'a kıyasla noise-overfitting riskini azaltabilir.
Çalışmanın desteklemediği sonuçlar
- Çalışma gerçek quantum computer üzerinde sekiz optimizer'ı benchmark etmemiştir.
- CMA-ES'in bütün VQE problemlerinde kesin olarak en iyi optimizer olduğu gösterilmemiştir.
- Sampling noise'un fiziksel olarak ground-state energy'den daha düşük gerçek quantum states oluşturduğu gösterilmemiştir.
- Variational principle exact expectation değerleri için çürütülmemiştir.
- Gate infidelity, coherent error, depolarizing noise, amplitude damping, thermal relaxation veya readout error benchmark edilmemiştir.
- Optimizer sıralamasının gerçek hardware noise altında aynı kalacağı kanıtlanmamıştır.
- Quantum computational speedup veya quantum advantage gösterilmemiştir.
- STO-3G ve incelenen küçük molecular systems sonuçları büyük kimyasal sistemlere otomatik genellenemez.
- Population size arttıkça performansın sınırsız biçimde iyileşeceği gösterilmemiştir.
- Source Table 2'deki “hardware için uygun” gibi optimizer tavsiyeleri doğrudan hardware benchmark sonucu değildir.
Çalışmanın temel sınırlılıkları
Kaynak ve yöntem birlikte değerlendirildiğinde ana sınırlılıklar şunlardır:
- Quantum circuits klasik bilgisayar/HPC üzerinde simüle edilmiştir.
- Ana noisy condition yalnız finite-shot sampling noise'dur.
- Real-device gate/readout/calibration noise dahil değildir.
- STO-3G minimal basis kullanılmıştır.
- İncelenen molecular systems H2, H4 ve LiH ile sınırlıdır.
- Random seeds sabit değildir.
- Bütün optimizer hyperparameters molecule-specific tuning'e tabi tutulmamıştır.
- Common maximum function-evaluation sayısının numeric değeri manuscript metninde görünür biçimde raporlanmamaktadır.
- Figure 8'in bütün bar values'ı numeric table olarak verilmemiştir.
- tVHA truncation circuit depth'i düşürürken reachability deficit oluşturabilir.
- CMA-ES steady-state stability global optimum garantisi değildir.
Gelecek çalışma yönleri
Yazarlar gelecekte:
- fast gradient search ile population methods arasında noise-adaptive switching,
- measured noise floor'a göre dynamic shot allocation,
- noise-aware stopping rules,
- thermal relaxation,
- amplitude damping,
- readout assignment errors,
- hardware-backed calibration
gibi daha gerçekçi noise conditions ve hybrid optimization strategies araştırılmasını önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Numerical Optimization Strategies for the Variational Hamiltonian Ansatz in Noisy Quantum Environments
Yazarlar: Silvie Illésová; Vojtěch Novák; Tomáš Bezděk; Clemens Possel; Martin Beseda.
Yazar sırası: Kaynaktaki sıra korunmuştur.
Eş katkı: Yüklenen v4 PDF'de açık bir equal-contribution/equal-first-author beyanı görünmemektedir.
Corresponding author: Martin Beseda.
Corresponding-author e-posta: martin.beseda@univaq.it
Kurum 1: Gran Sasso Science Institute, L’Aquila, Italy.
Kurum 2: Department of Applied Mathematics, Faculty of Electrical Engineering and Computer Science, VSB-Technical University of Ostrava, Ostrava, Czech Republic.
Kurum 3: IT4Innovations National Supercomputing Center, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Kurum 4: Department of Computer Science, Faculty of Electrical Engineering and Computer Science, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Kurum 5: Department of Mathematics, TUM School of Computation, Information and Technology, Technical University of Munich, Garching bei München, Germany.
Kurum 6: Fraunhofer Institute for Chemical Technology ICT, Pfinztal, Germany.
Kurum 7: Department of Physics, Saarland University, Saarbrücken, Germany.
Kurum 8: Department of Information Engineering, Computer Science and Mathematics, University of L’Aquila, L’Aquila, Italy.
Platform: arXiv.
arXiv: arXiv:2505.22398v4 [quant-ph].
İlk arXiv gönderimi: 28 Mayıs 2025.
Yüklenen sürüm: v4, 22 Ocak 2026.
DOI: 10.48550/arXiv.2505.22398.
Resmî bağlantı: https://arxiv.org/abs/2505.22398
Kaynak türü: Teorik/hesaplamalı quantum-chemistry ve numerical-optimization preprint/manuscript.
Hakemlik durumu: Yüklenen kaynak arXiv preprint sürümüdür. PDF IOP Publishing manuscript template'i kullanmakta; ancak Journal Name, volume/year/article-number ve received/revised dates placeholder durumundadır. Bu incelemede exact title için doğrulanmış nihai hakemli journal publication kaydı tespit edilmediği için makale hakemli final yayın olarak sunulmamıştır.
IOP şablon notu: PDF üzerinde “Journal vv (yyyy) aaaaaa”, “Journal Name”, “dd Month yyyy” gibi placeholders bulunmaktadır. Bunlar gerçek bibliyografik journal metadata olarak kullanılmamıştır.
Dosya kimliği notu: Yüklenen dosyanın adı Research Square DOI biçiminde bir ifade taşısa da PDF'nin kendi iç kimliği arXiv:2505.22398v4, PDF metadata DOI'si ise 10.48550/arXiv.2505.22398'dir. Research Square kaydı bu incelemede güvenilir resmî sayfadan ayrıca doğrulanamadığı için ana DOI olarak kullanılmamıştır.
Lisans: PDF metadata'sı Creative Commons Attribution 4.0 International (CC BY 4.0) lisansını göstermektedir.
Anahtar kelimeler: Variational Quantum Eigensolver; Noisy optimization; CMA-ES; Truncated Variational Hamiltonian Ansatz; Quantum chemistry.
Çalışma türü: Classical HPC üzerinde quantum-circuit simulation ve optimizer benchmarking.
Gerçek quantum hardware: Kullanılmamıştır.
Ana noise modeli: Finite-shot sampling noise.
Dahil edilmeyen noise türleri: coherent/stochastic gate errors, thermal relaxation, amplitude damping ve readout bias ana benchmark'a dahil değildir.
Moleküler sistemler: H₂, linear H₄ chain, LiH full space, LiH active space.
Basis: STO-3G.
Hamiltonian mapping: Jordan–Wigner.
tVHA truncation: \(p=0.999\), yani kaynak yorumuna göre non-Coulomb two-body interaction strength'in cumulative %99,9'u korunmaktadır.
Ana sampling budget: 6144 shot / function evaluation.
Landscape reference sampling: \(N_{\mathrm{shots}}\ge10^6\).
High-shot reevaluation: Figure 4–7'de \(10^5\) shot.
Bağımsız run sayısı: 1280.
Random seeds: Sabitlenmemiştir.
Optimizer tuning: Kaynak case-by-case hyperparameter optimization yerine yaygın implementation defaults kullanıldığını belirtmektedir; ayrı stopping tolerances Appendix E'de raporlanmıştır.
Hesaplama altyapısı: Barbora supercomputer, Bull Sequana X cluster; toplam yaklaşık 4500 node-hour.
Yazılım: Qiskit 1.0.2; qiskit_algorithms 0.3.1; qiskit_nature 0.7.2; qiskit_aer 0.14.2; PySCF 2.6.0; SciPy 1.15.2; cma 3.3.0.
Data Availability: Computed results ve bunları üreten scripts Zenodo üzerinde public olarak paylaşılmıştır.
Zenodo DOI: 10.5281/zenodo.15526170.
Conflict of Interest: Yazarlar bilinen competing financial interests veya personal relationships bulunmadığını beyan etmektedir.
Ethical Statement: Human participants, human data veya animal experimentation bulunmadığı için ethical approval gerekmemiştir.
Funding / destek: Clemens Possel, Baden-Württemberg Ministry of Economic Affairs, Labour and Tourism tarafından QC-4-BW, QC-4-BW II ve KQCBW24 projeleri üzerinden desteklenmiştir. Tomáš Bezděk SGS No. SP2025/049, Vojtěch Novák SGS No. SP2025/072 desteklerini almıştır. Çalışma ayrıca Czech Ministry of Education, Youth and Sports tarafından e-INFRA CZ ID:90254 üzerinden desteklenmiştir.
Yazar katkıları: Kaynakta ayrı CRediT author-contribution breakdown bulunmamaktadır.
İstatistik: Her configuration için 10 independent run gerçekleştirilmiştir. Figure 8 mean final errors ve %95 confidence intervals göstermektedir. Kaynakta optimizer çiftleri için kapsamlı formal p-value significance-testing tablosu raporlanmamıştır.
Equation (2) notasyonu: Coulomb term'de toplam \(\sum_{ij}\) biçimindeyken coefficient \(g_{ijk\ell}\) olarak dört indeks taşımaktadır. Kaynak bu gösterimi ayrıca açıklamamaktadır; Verianla denklem indekslerini varsayımla değiştirmemiştir.
H₂ sonuç sırası notu: Kaynak GD + HF \(6,6\times10^{-4}\) Ha'yı “lowest” olarak önce yazarken SPSA + HF \(4,1\times10^{-4}\) Ha ve CMA-ES \(4,5\times10^{-4}\) Ha olarak daha küçük numeric values raporlar.
H₄ sıra notu: Metin CMA-ES'ten sonra GD ve PSO sırasını kullanırken verilen PSO değeri \(2,7\times10^{-2}\) Ha, GD değeri \(3,01\times10^{-2}\) Ha'dır.
LiH unit-language notu: Full-space statevector paragrafı yaklaşık \(4\times10^{-3}\) Ha değerlerini “sub-millihartree” diye nitelendirir; \(4\times10^{-3}\) Ha = 4 mHa olduğundan sayı ile niteleme uyuşmamaktadır.
SLSQP sınıflandırma notu: Introduction'da derivative-free methods bağlamında anılırken Appendix A ve Table 3'te gradient-based constrained optimizer olarak tanımlanır.
SPSA active-space notu: Main result paragraph \(3,9\times10^{-4}\) Ha high-shot result verirken daha sonraki literature-comparison paragraph \(6,5\times10^{-4}\) Ha ve 486 function evaluations değeri verir. Kaynak farkı ayrıntılı biçimde açıklamamaktadır.
Maximum function-evaluation notu: Bütün optimizers için aynı maximum limit kullanıldığı belirtilmiş ancak yüklenen manuscript text'te ortak sayısal maksimum açık biçimde görünmemektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir