


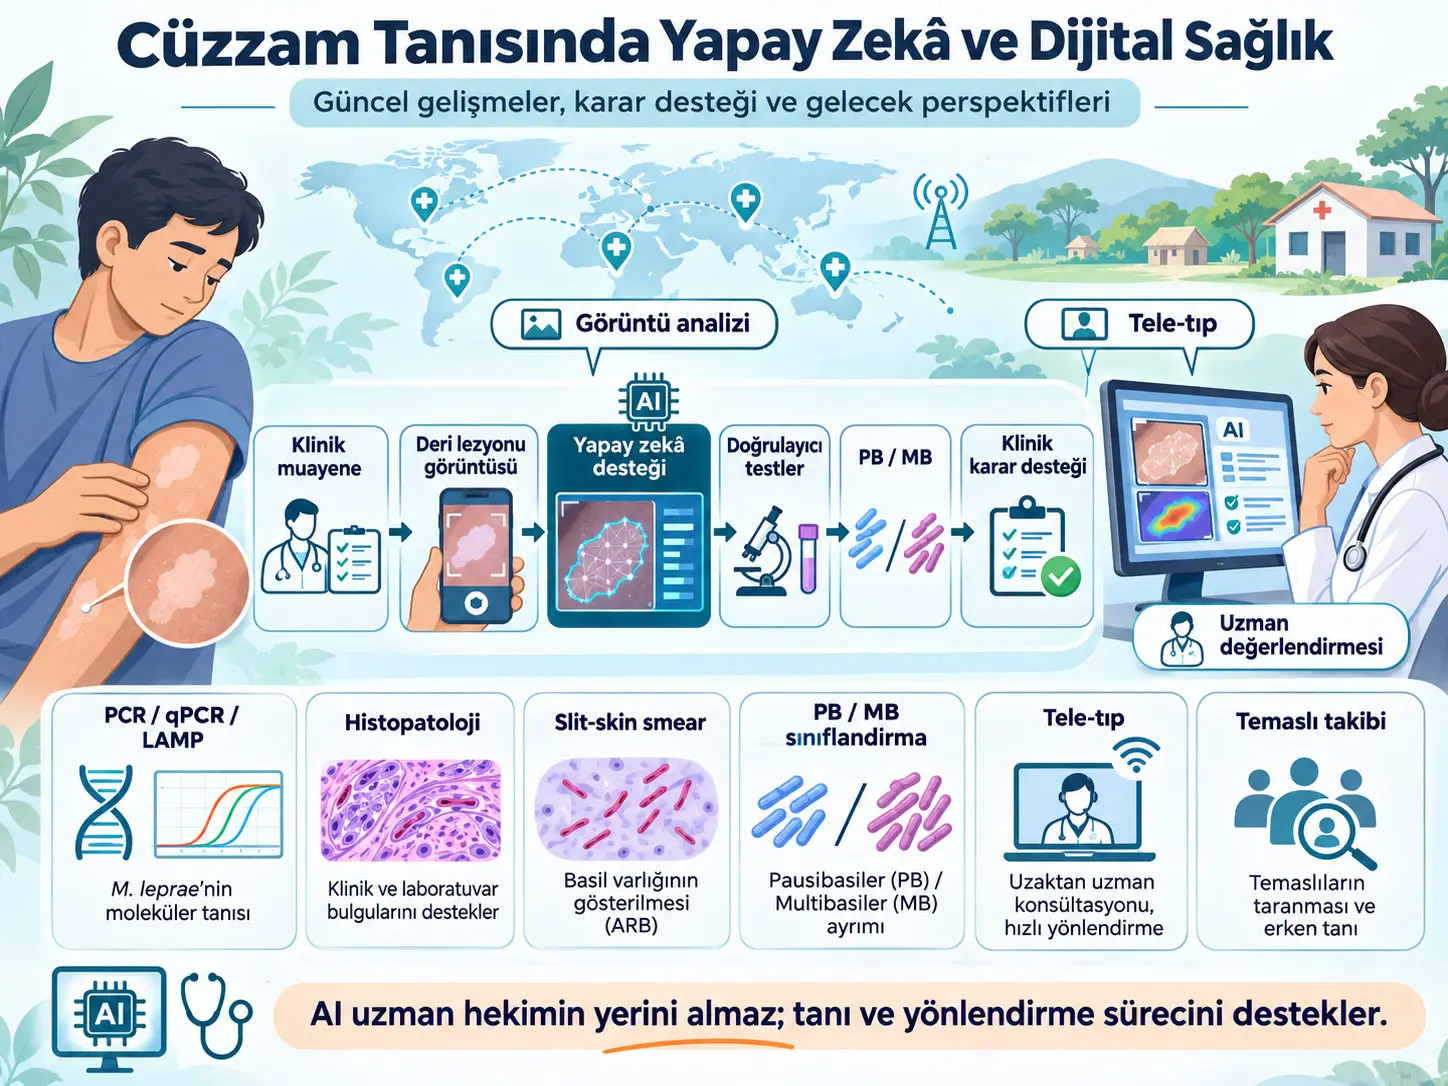
Cüzzam (lepra, Hansen hastalığı), başlıca Mycobacterium leprae ve daha seyrek olarak Mycobacterium lepromatosis ile ilişkili, özellikle deri ve periferik sinir sistemini etkileyen kronik bir enfeksiyon hastalığıdır. Bu yapılandırılmış narratif derleme, cüzzam tanısında makine öğrenmesi, derin öğrenme, bilgisayarlı görü, multimodal yapay zekâ, tele-tıp ve mobil sağlık teknolojilerinin mevcut kanıt düzeyini değerlendirir. Çalışma yeni bir AI modeli veya yeni hasta verisi üretmez; daha önce yayımlanmış cüzzama özgü çalışmalar ile gerektiğinde genel dermatoloji AI literatüründen gelen dolaylı kanıtı birbirinden ayırarak inceler.
Derlemenin ana mesajı, AI'nin cüzzam tanısında umut verici bir karar destek aracı olabileceği fakat mevcut kanıtların AI'nin uzman klinik değerlendirmesinin yerini almasını desteklemediğidir. Araştırma ortamlarında bazı modeller yüksek doğruluk, duyarlılık, özgüllük veya AUC değerleri bildirmiştir; ancak çalışmalar veri seti, hasta popülasyonu, görüntü elde etme yöntemi, hedef görev ve doğrulama biçimi bakımından birbirinden önemli ölçüde farklıdır. Bu nedenle bildirilen performans değerleri tek bir “cüzzam AI doğruluğu” gibi birleştirilemez.
Cüzzama doğrudan odaklanan örneklerden birinde de Souza ve arkadaşlarının klinik ve epidemiyolojik kayıtlarla çalışan random forest tabanlı sistemi paucibacillary ve multibacillary sınıflandırmasında %92,38 doğruluk, %93,97 duyarlılık ve %87,09 özgüllük bildirmiştir. AI4Leprosy çalışmasında deri lezyonu fotoğrafları ile demografik ve klinik değişkenleri birleştiren multimodal sistem için %90 doğruluk ve 0,9646 AUC raporlanmıştır. Beş farklı deriyle ilişkili ihmal edilmiş tropikal hastalığı içeren Yotsu ve arkadaşlarının görüntü çalışmasında ise genel doğru tahmin oranı %70'in üzerinde olmuş ve ResNet-50, VGG-16'dan daha iyi performans göstermiştir. Son sonuç yalnız cüzzama özgü bir performans değeri değildir.
Bu sayılar doğrudan karşılaştırılamaz. İlk çalışma operasyonel PB/MB sınıflandırmasını yapılandırılmış verilerle, ikincisi multimodal cüzzam sınıflandırmasını fotoğraf ve klinik verilerle, üçüncüsü ise cüzzam dahil beş deri hastalığını görüntülerden ayırmayı değerlendirmiştir. Ayrıca kaynak derlemenin kendi Tablo 1'inde bazı doğrulama ve model mimarisi alanları “verify in full text” veya “architecture to verify” biçiminde tamamlanmamış editoryal yer tutucular içerdiğinden, bu alanlar Verianla tarafından tahmin edilmemiştir.
Derleme, cüzzam tanısında tek başına yeterli duyarlılığa sahip tek bir laboratuvar testi bulunmadığını vurgular. Klinik değerlendirme; slit-skin smear mikroskopisi, histopatoloji, PCR/qPCR gibi moleküler yöntemler, serolojik testler ve biyobelirteçlerle birlikte kullanılabilir. Özellikle paucibacillary (PB) hastalıkta bakteri yükünün düşük olması hem geleneksel mikroskopiyi hem de erken klinik tanıyı zorlaştırmaktadır.
AI'nin en olası yakın dönem rolü; deri lezyonu görüntülerinin değerlendirilmesini desteklemek, PB/MB operasyonel sınıflandırmasına yardım etmek, belirsiz vakaları triyaj etmek, görüntü kalitesini kontrol etmek ve uzman erişiminin sınırlı olduğu bölgelerde teledermatoloji yönlendirmesini kolaylaştırmaktır. Bununla birlikte geniş, iyi etiketlenmiş ve farklı popülasyonları kapsayan veri setlerinin azlığı; harici doğrulama eksikliği; cilt pigmentasyonu, demografik temsil ve görüntüleme koşullarından doğabilecek algoritmik yanlılık; açıklanabilirlik ve veri gizliliği sorunları rutin klinik kullanımı sınırlamaktadır.
Kaynak ayrıca cüzzama özgü çalışmaların cilt tonu alt gruplarına göre performans sonuçları vermediğini özellikle belirtir. Dolayısıyla “AI koyu ciltte daha kötü çalışıyor” veya “cilt tonundan etkilenmiyor” sonuçlarının hiçbiri bu derlemenin cüzzama özgü verileriyle kanıtlanmış değildir. Bu risk genel dermatoloji AI literatüründen mantıklı bir kaygı olarak ortaya çıkmaktadır ve cüzzamda prospektif alt grup doğrulaması gerektirir.
Sonuç olarak çalışma, yapay zekâ ve dijital sağlığı özerk tanı sistemi olarak değil; klinisyen, doğrulayıcı laboratuvar testi, tele-tıp ve sevk sistemlerini birbirine bağlayan yardımcı bir katman olarak konumlandırmaktadır.
Cüzzam Tanısında Yapay Zekânın Rolü Nedir?
Cüzzam tanısında yapay zekâ, klinik fotoğraflar veya yapılandırılmış klinik ve epidemiyolojik verilerdeki örüntüleri kullanarak lezyon tanıma, operasyonel sınıflandırma, triyaj ve klinik karar desteğine yardımcı olabilecek hesaplamalı bir destek katmanıdır; mevcut cüzzama özgü kanıt, AI'nin klinisyenin ve doğrulayıcı tanı yöntemlerinin yerini almasını değil onları tamamlamasını desteklemektedir.
Cüzzamın erken tanısı neden zor?
Cüzzamın klinik görünümü tek tip değildir. Deride hipopigmente veya eritemli alanlar, duyu kaybı, periferik sinir tutulumu, motor bozukluk, kas güçsüzlüğü, terlemede azalma, kuru deri, nodüller veya daha yaygın deri infiltrasyonu gibi farklı bulgular ortaya çıkabilir. Bu değişkenlik, özellikle erken hastalıkta başka inflamatuvar veya enfeksiyöz deri hastalıklarıyla karışma riskini artırır.
Kaynağın vurguladığı ikinci sorun uzun inkübasyon süresidir. Klinik belirtiler enfeksiyondan uzun süre sonra ortaya çıkabildiği için erken vaka yakalama güçleşebilir.
Üçüncü sorun, hastalığın bütün spektrumunda tek başına yeterli duyarlılık sağlayan bir laboratuvar testinin bulunmamasıdır. Son tanısal değerlendirme klinik bulgular, bakteriyolojik inceleme, histopatoloji, moleküler yöntemler ve gerektiğinde immünolojik biyobelirteçlerin bir arada değerlendirilmesine dayanabilir.
Cüzzam tanısındaki kardinal bulgular
Derlemede klinik tanının temelinde üç ana bulgu grubu yer alır: duyu kaybıyla ilişkili hipopigmente veya eritemli deri lezyonları, duysal ya da motor bozukluğun eşlik ettiği periferik sinir tutulumu ve slit-skin smear incelemesinde aside dirençli basillerin gösterilmesi.
Bu bulgulardan herhangi birinin otomatik görüntü sınıflandırmasıyla tamamen ikame edildiği sonucu kaynakta yoktur. Özellikle duyu muayenesi ve periferik sinir değerlendirmesi yalnız bir deri fotoğrafından doğrudan elde edilemeyen klinik bilgilerdir.
Paucibacillary ve Multibacillary Cüzzam Arasındaki Ayrım Neden Önemlidir?
Paucibacillary (PB) ve multibacillary (MB), cüzzamın operasyonel sınıflandırmasında kullanılan iki gruptur; bu derlemede PB hastalık özellikle önemlidir çünkü düşük bakteri yükü ve daha silik klinik belirtiler mikroskopi ve diğer tanısal yaklaşımların duyarlılığını azaltarak erken tanıyı güçleştirebilir.
Paucibacillary hastalık
PB hastalıkta bakteri yükünün düşük olması, klasik bakteriyolojik doğrulamanın daha zor olmasına neden olabilir. Kaynak slit-skin smear mikroskopisinin PB hastalıkta düşük duyarlılık gösterebildiğini belirtmektedir.
Bu durum AI açısından da önemlidir. Eğer referans tanının kendisi zor elde ediliyorsa, bir AI modelinin eğitileceği “doğru etiket”lerin oluşturulması da daha zor hale gelir. Bu, Verianla'nın kaynak bulgularından çıkardığı yöntemsel açıklamadır; kaynak yeni bir sayısal etiket hatası oranı vermemektedir.
Multibacillary hastalık
MB hastalık daha yüksek bakteri yüküyle ilişkili olduğundan slit-skin smear gibi bakteriyolojik yöntemler bu grupta daha yararlı olabilir. Kaynak, slit-skin smear yönteminin MB hastalığın doğrulanmasında yüksek özgüllüğe sahip olduğunu ve bacterial index belirleyebildiğini bildirir.
Kaynak kesin PB/MB eşiklerini veriyor mu?
Derleme PB ve MB operasyonel sınıflandırmasından söz etmekte ve Şekil 1'de iki sınıfı tanı yolunun bir aşaması olarak göstermektedir. Ancak bu makalenin ana metni PB/MB için ayrıntılı sayısal lezyon veya sinir eşiklerini öğretici bir sınıflandırma tablosu biçiminde sunmamaktadır. Bu nedenle Verianla kaynakta olmayan eşikleri bu makalenin bulgusu olarak eklememektedir.
Slit-skin smear mikroskopisi nedir?
Slit-skin smear, deriden alınan materyalde aside dirençli basillerin mikroskopik olarak araştırıldığı bakteriyolojik bir değerlendirmedir. Derleme bu yöntemin MB hastalıkta yüksek özgüllük sağladığını ve bacterial index ölçümüne yardımcı olduğunu, fakat PB hastalıkta duyarlılığın düşük olabildiğini belirtir.
Performans uygun numune alınmasına ve deneyimli personele bağlıdır. Bu nedenle yöntemin yalnız teknik varlığı değil, uygulanma kalitesi de tanı güvenilirliğinin parçasıdır.
Histopatoloji neden kullanılıyor?
Deri biyopsisinin histopatolojik incelemesi granulomatöz inflamasyon, periferik sinir tutulumu ve basil dağılımı gibi bulgular hakkında tamamlayıcı bilgi sağlar. Ridley–Jopling sınıflandırması gibi histopatolojik/klinik çerçevelere de katkı sunabilir.
Kaynak aynı zamanda erken hastalıkta bazı histopatolojik bulguların özgül olmayabileceğini ve yorumun dermatopatoloji deneyimi gerektirdiğini belirtmektedir.
PCR ve qPCR ne sağlar?
Polymerase chain reaction (PCR) ve quantitative PCR (qPCR), Mycobacterium leprae DNA'sını doğrudan hedefleyen moleküler tanı yaklaşımlarıdır. Özellikle bakteriyel yükün düşük olduğu ve klasik mikroskopinin negatif kalabildiği PB vakalarında tanısal desteği artırma potansiyelleri vardır.
Ancak derleme PCR performansının klinik sınıflandırmaya, örnek türüne, hedef dizisine ve yöntem tasarımına göre değişebileceğini vurgular. Ayrıca moleküler yöntemler teknik altyapı ve maliyet gerektirdiğinden bütün endemik bölgelerde rutin olarak erişilebilir değildir.
LAMP nedir?
Kaynak Şekil 1'de LAMP moleküler tanı basamaklarından biri olarak gösterilmektedir. LAMP, “loop-mediated isothermal amplification” ifadesinin kısaltmasıdır ve hedef nükleik asidin sabit sıcaklık koşullarında çoğaltılmasına dayanan bir moleküler amplifikasyon yaklaşımıdır. Bu açıklama kavramı öğretmek içindir; derleme LAMP için bağımsız performans verisi veya yeni deney raporlamamaktadır.
Anti-PGL-I serolojisinin sınırı nedir?
Phenolic glycolipid-I (PGL-I) antijenine karşı antikorları hedefleyen serolojik yöntemler vaka saptama veya temaslılarda risk sınıflandırması için araştırılmıştır. Ancak antikor yanıtının bakteri yüküyle ilişkili olması, PB hastalıkta duyarlılığı sınırlayabilir.
Derlemenin önemli sonucu, mevcut durumda hiçbir biyobelirtecin cüzzamın bütün klinik spektrumunda yeterince doğru tek başına tanı testi olmadığıdır.
AI tanı akışının neresinde yer alıyor?
Kaynak AI'yi klinik şüpheden sonraki bütün tanı sürecinin yerine geçen tek bir “otomatik teşhis kutusu” olarak tanımlamaz. AI daha çok görüntü analizi, operasyonel sınıflandırma, klinik karar desteği, triyaj ve sevk süreçlerine yardımcı olabilecek bir katmandır.
Bu ayrım özellikle önemlidir çünkü cüzzamda duyu muayenesi, periferik sinir değerlendirmesi, bakteriyolojik inceleme ve moleküler doğrulama gibi fotoğraftan bağımsız bilgiler de tanı sürecinin parçalarıdır.
Tele-tıp ve mobil sağlık ne sağlayabilir?
Akıllı telefonla görüntü elde etme, teledermatoloji ve mobil sağlık araçları uzman hekime fiziksel erişimin sınırlı olduğu bölgelerde şüpheli vakaların uzaktan değerlendirilmesine yardımcı olabilir.
Derleme WHO Skin NTD mobil uygulamasını bu bağlamdaki dijital sağlık örneklerinden biri olarak ele alır. Potansiyel kullanım alanları uzaktan danışmanlık, vaka önceliklendirme, epidemiyolojik sürveyans, temaslı takibi ve tedavi izlemini kapsamaktadır.
Bununla birlikte uygulamanın varlığı klinik etkinliğin veya cüzzama özgü AI doğruluğunun otomatik kanıtı değildir. Gerçek uygulamada çevrimdışı çalışma, kullanılabilirlik, maliyet, veri paylaşımı, sistemler arası uyumluluk ve sevk zincirinin tamamlanması da değerlendirilmelidir.
Accuracy, Sensitivity, Specificity ve AUC Nasıl Yorumlanmalıdır?
Accuracy bütün doğru sınıflandırmaların toplam oranını, sensitivity gerçek pozitif vakaların ne kadarının yakalandığını, specificity gerçek negatiflerin ne kadarının doğru dışlandığını, AUC ise farklı karar eşiklerinde duyarlılık ile yanlış pozitif oranı arasındaki ayrım performansını özetler; bu metriklerin yüksek olması yararlı olmakla birlikte bağımsız harici doğrulama ve klinik uygulanabilirliğin yerini tutmaz.
TP, TN, FP ve FN ne demektir?
- TP — True Positive: Gerçekte pozitif olan ve modelin pozitif sınıflandırdığı örnek.
- TN — True Negative: Gerçekte negatif olan ve modelin negatif sınıflandırdığı örnek.
- FP — False Positive: Gerçekte negatif olduğu halde modelin pozitif sınıflandırdığı örnek.
- FN — False Negative: Gerçekte pozitif olduğu halde modelin negatif sınıflandırdığı örnek.
Önemli not: Aşağıdaki denklemler kaynak makalenin özgün denklemleri değildir. Kaynakta bildirilen performans metriklerinin ne anlama geldiğini öğretmek için verilen standart kavramsal tanımlardır.
Accuracy — doğruluk
Accuracy, bütün örneklerin ne kadarının doğru sınıflandırıldığını gösterir. Ancak sınıflar çok dengesizse yüksek accuracy yanıltıcı olabilir. Örneğin negatif örnekler çok fazlaysa model çoğunluğu doğru tahmin ederek yüksek accuracy elde edebilir fakat pozitif hastaları yeterince yakalayamayabilir.
Sensitivity — duyarlılık
Duyarlılık, gerçekten hastalığa veya hedef sınıfa sahip örneklerin ne kadarının model tarafından yakalandığını gösterir. Tanıda düşük duyarlılık, gerçek hastaların önemli bir bölümünün gözden kaçması anlamına gelebilir.
Specificity — özgüllük
Özgüllük, gerçekten negatif olan örneklerin ne kadarının doğru biçimde negatif sınıflandırıldığını gösterir. Düşük özgüllük çok sayıda yanlış pozitif yönlendirmeye yol açabilir.
AUC nedir?
AUC, ROC eğrisinin altında kalan alanı ifade eder. ROC eğrisi farklı karar eşikleri boyunca true-positive rate ile false-positive rate arasındaki ilişkiyi gösterir. AUC'nin 1'e yaklaşması modelin değerlendirilen veri setinde sınıfları ayırma kapasitesinin arttığını gösterir.
Ancak AUC'nin yüksek olması modelin bütün klinik eşiklerde aynı ölçüde yararlı olduğu anlamına gelmez. Ayrıca aynı model yeni hastanelerde, farklı kamera sistemlerinde veya başka popülasyonlarda daha düşük performans gösterebilir.
Harici doğrulama ne demektir?
Harici doğrulama, modelin geliştirilirken kullanılmamış bağımsız bir popülasyon veya veri setinde sınanmasıdır. Bu test, modelin yalnız eğitim merkezinin özelliklerini veya veri toplama alışkanlıklarını ezberleyip ezberlemediğini anlamaya yardım eder.
Derlemede harici doğrulama eksikliği cüzzam AI literatürünün ana sınırlılıklarından biri olarak vurgulanmaktadır.
Prospektif doğrulama neden daha güçlüdür?
Prospektif doğrulamada model önceden geliştirilir ve daha sonra gerçek klinik akışta karşılaşılan yeni vakalarda değerlendirilir. Bu düzen, retrospektif veri setlerinden farklı olarak veri toplama, kullanıcı davranışı, sevk süreci ve klinik karar gibi gerçek uygulama unsurlarını daha iyi temsil edebilir.
Genel Dermatoloji AI Sonuçları Cüzzama Doğrudan Aktarılabilir mi?
Hayır. Derleme genel dermatolojideki güçlü AI sonuçlarını yalnız insan–AI iş birliğinin mümkün olduğuna dair dolaylı kanıt olarak kullanır; cüzzama özgü dermatolog–AI head-to-head çalışmalar yeterince kurulmadığından melanoma veya başka deri hastalıklarında elde edilen performans artışları cüzzam tanısı için nicel olarak kullanılamaz.
PanDerm örneği neden dolaylı kanıt?
Makale, 2025 tarihli geniş dermatoloji değerlendirmesinden PanDerm adlı multimodal foundation model için erken melanoma saptamada klinisyenlere göre %10,2'lik fark, dermoskopik deri kanseri sınıflandırmasında klinisyen doğruluğunda %11 artış ve 128 deri hastalığındaki ayırıcı tanıda dermatolog olmayan klinisyenlerin performansında %16,5 artış bildirildiğini aktarır.
Ancak PanDerm cüzzam için doğrulanmış bir model değildir. Bu sayılar cüzzam tanısının performans tahmini olarak kullanılamaz.
Ayrıca kaynak metni PanDerm sonuçlarını [19] numaralı atıfla verirken kaynakça listesinde [19] Moor ve arkadaşlarının 2023 foundation-model makalesidir; PanDerm ile ilişkili 2025 Nature Medicine kaydı [21] olarak listelenmiştir. Verianla bu kaynak-içi numaralandırma uyumsuzluğunu sessizce düzeltmemektedir.
AI Uzman Hekimin Yerini Alabilir mi?
Bu derlemeye göre hayır; mevcut cüzzam kanıtı AI'yi uzman değerlendirmesinin yerine geçen özerk teşhis sistemi olarak değil, klinik karar desteği, triyaj, operasyonel sınıflandırma ve uzman bakıma erişimi kolaylaştıran yardımcı teknoloji olarak desteklemektedir.
Neden özerk tanı için kanıt yetersiz?
Birincisi, mevcut cüzzama özgü çalışmaların sayısı ve veri çeşitliliği sınırlıdır. İkincisi, araştırma görevleri birbirinden farklıdır: bazı modeller PB/MB sınıflandırması, bazıları cüzzam sınıflandırması, bazıları ise birden fazla deri hastalığını ayırma problemi üzerinde çalışır.
Üçüncüsü, harici ve prospektif doğrulama sınırlıdır. Bir modelin kendi geliştirme veri setindeki yüksek performansı başka coğrafyada, başka kamera cihazında veya başka klinik pratikte aynı sonucu garanti etmez.
Dördüncüsü, cüzzam tanısında yalnız görsel bilgi bulunmaz. Duyu kaybı, periferik sinir tutulumu, bakteriyolojik sonuçlar, histopatoloji ve moleküler bulgular gibi farklı veri türlerinin klinik olarak birlikte yorumlanması gerekir.
Automation bias nedir?
Automation bias, sağlık çalışanının otomatik sistemin önerisine gereğinden fazla güvenerek kendi klinik değerlendirmesini ikinci plana atması riskidir. Derleme gelecekteki insan–AI okuyucu çalışmalarında AI'nin ön saflardaki sağlık çalışanlarının performansını artırıp artırmadığının, aynı zamanda automation bias yaratıp yaratmadığının değerlendirilmesini önermektedir.
Algoritmik yanlılık cilt pigmentasyonuyla ilişkili olabilir mi?
Olabilir; ancak kaynak burada çok dikkatli bir sınır koymaktadır. Deri rengi ve pigmentasyon görüntü tabanlı modellerde distribution shift ve farklı performans için olası bir kaynaktır. Bununla birlikte derlemedeki cüzzama özgü primer çalışmalar cilt tonu bazında ayrıştırılmış performans sonuçları sunmamaktadır.
Bu nedenle mevcut cüzzam verileri pigmentasyon kaynaklı performans eşitsizliğinin gerçekleştiğini de gerçekleşmediğini de göstermez. Bu konu farklı endemik popülasyonlarda prospektif alt grup değerlendirmesi gerektirir.
Explainable AI neden önemli?
Açıklanabilir AI, modelin hangi bulgu veya veri örüntüsüne dayanarak belirli bir öneri ürettiğinin klinisyen tarafından daha iyi anlaşılmasını amaçlar. Sağlık uygulamalarında bu özellik yalnız teknik merak değil, güven, hata incelemesi, hasta güvenliği ve düzenleyici gözetim açısından önem taşır.
Kaynak şeffaf model geliştirme, açıklanabilirlik, fairness, hasta mahremiyeti, bilgilendirilmiş onam, güvenli veri yönetişimi ve klinik gözetimi güvenilir AI için gerekli alanlar arasında saymaktadır.
Çalışmanın Yöntemi ve Bulguları
Derleme nasıl yürütüldü?
Yazarlar çalışmayı “structured narrative review” olarak tanımlamaktadır. PubMed/MEDLINE ana bibliyografik veri tabanı olarak kullanılmıştır.
PubMed aramasında cüzzam tarafında “leprosy”, “Hansen disease” veya “Mycobacterium leprae”; teknoloji tarafında ise “artificial intelligence”, “machine learning”, “deep learning”, “convolutional neural network”, “computer vision”, “foundation model”, “digital health”, “telemedicine”, “mobile health” veya “clinical decision support” terimleri birleştirilmiştir.
Arama 17 Ağustos 2026'da son kez güncellenmiştir. Ayrıca yayıncı web siteleri ve WHO kaynaklarında cüzzam tanısı ile dijital sağlık uygulamasına ilişkin hedefli aramalar yapılmış; uygun derleme ve primer çalışmaların kaynakçaları ek yayınlar için incelenmiştir.
Moleküler tanı, biyobelirteçler, harici doğrulama, algoritmik yanlılık ve insan–AI tanısal karşılaştırmaları için de hedefli ek aramalar yapılmıştır.
Hangi yayınlara öncelik verildi?
Cüzzamda AI veya dijital sağlık uygulamasını doğrudan değerlendiren hakemli primer çalışmalara öncelik verilmiştir. Primer kanıtın az olduğu alanlarda sistematik veya kapsam belirleme derlemeleri ile yetkili kılavuzlar kullanılmıştır.
Tanısal sınıflandırma, operasyonel sınıflandırma, görüntü analizi, teledermatoloji, klinik karar desteği, moleküler/biyobelirteç entegrasyonu, harici doğrulama veya uygulama sorunlarını ele alan çalışmalar uygun kabul edilmiştir.
Daha eski çalışmalar yalnız cüzzam tele-tıp veya uzaktan tanı alanında temel kanıt oluşturuyorsa korunmuştur.
Neden meta-analiz yapılmadı?
Yazarlar çalışmalar arasında klinik görevlerin, veri setlerinin, sonuç tanımlarının ve performans metriklerinin önemli ölçüde farklı olduğunu belirtmektedir. Bu heterojenlik nedeniyle nicel meta-analiz uygun görülmemiş ve bulgular narratif biçimde sentezlenmiştir.
Bu karar aynı zamanda farklı model metriklerinin doğrudan tek bir birleşik performans sayısına dönüştürülmemesi gerektiğini gösterir.
Cüzzama doğrudan uygulanmış AI çalışmalarının karşılaştırması
| Çalışma | Görev | Veri | Model / yaklaşım | Kaynakta bildirilen ana performans | Yorum sınırı |
|---|---|---|---|---|---|
| de Souza ve ark. (2021) | PB / MB operasyonel sınıflandırma | Brezilya SINAN klinik ve epidemiyolojik kayıtları | Random forest ve cross-platform karar destek uygulaması | Accuracy %92,38; sensitivity %93,97; specificity %87,09 | Kaynak derleme tablosunda payda ve harici doğrulama ayrıntıları “verify” yer tutucularıyla bırakılmıştır. |
| Barbieri ve ark. (2022), AI4Leprosy | Klinik bilgi ve lezyon fotoğrafıyla cüzzam sınıflandırması | 222 katılımcıdan 1229 deri görüntüsü; 585 metadata seti | Multimodal AI | Accuracy %90; AUC 0,9646 | Kaynak Tablo 1 model mimarisini “architecture to verify” olarak bırakmıştır; Verianla mimari ayrıntı uydurmamaktadır. |
| Yotsu ve ark. (2023) | Cüzzam dahil beş deri NTD'sinin görüntü tabanlı sınıflandırılması | Beş hastalıktan 506 hastaya ait 1709 görüntü | ResNet-50 ve VGG-16 | Genel doğru tahmin %70'in üzerinde; ResNet-50, VGG-16'dan daha iyi | Performans beş hastalığın toplamına aittir; cüzzam alt grubuna özgü tek başına doğruluk değeri değildir. |
de Souza ve arkadaşlarının modeli ne yaptı?
Bu çalışma cüzzam hastalarını doğrudan yalnız fotoğrafa bakarak teşhis etmeye çalışmaktan farklı bir görev ele almıştır. Amaç, klinik ve epidemiyolojik kayıtlar kullanılarak paucibacillary ve multibacillary operasyonel sınıflandırmasına yardımcı olmaktır.
Random forest, birden fazla karar ağacını bir araya getiren ve her ağacın çıktısından kolektif sınıflandırma üreten bir makine öğrenmesi yaklaşımıdır. Burada kaynak derleme modelin ayrıntılı hiperparametrelerini veya bütün veri ön işleme adımlarını yeniden vermemektedir.
Bildirilen %92,38 accuracy, %93,97 sensitivity ve %87,09 specificity umut verici araştırma performansıdır. Fakat bu değerlerin başka ülkelerde veya bağımsız klinik akışlarda aynı şekilde ortaya çıkacağı sonucu çıkarılamaz.
AI4Leprosy neden multimodal?
AI4Leprosy çalışması yalnız deri fotoğrafı kullanmak yerine klinik görüntüyü demografik ve klinik değişkenlerle birleştirmiştir. Bu nedenle kaynak tarafından multimodal AI çalışması olarak ele alınmaktadır.
Kaynak derleme 222 katılımcıdan 1229 deri görüntüsü ve 585 metadata seti raporlamakta, model için %90 accuracy ve 0,9646 AUC vermektedir.
Ancak kaynak Tablo 1 model mimarisini kesin olarak belirtmek yerine “architecture to verify” ifadesini bırakmıştır. Bu nedenle Verianla modelin CNN katmanları, optimizer'ı, loss fonksiyonu veya başka teknik mimari ayrıntılarını kaynakta doğrulanmamış biçimde tamamlamaz.
Yotsu ve arkadaşlarının sonucu neden dikkatli okunmalı?
Yotsu ve arkadaşlarının çalışması yalnız cüzzamdan oluşan bir veri setini sınıflandırmamıştır. Beş farklı deriyle ilişkili neglected tropical disease sınıfından 506 hastaya ait toplam 1709 görüntü kullanılmıştır.
Kaynak derleme “%70'in üzerinde doğru tahmin” sonucunu bütün çok sınıflı görev için verir. Bu oranı “cüzzam tanısında %70'ten fazla doğruluk” olarak yeniden yazmak bilimsel olarak doğru değildir.
Üç çalışmanın performansları neden sıralanmamalı?
%92,38, %90 ve %70'in üzeri değerlerini yan yana koyarak “birinci model en iyi” şeklinde sıralama yapmak uygun değildir. Modeller farklı görevleri, farklı popülasyonları ve farklı veri türlerini değerlendirmiştir.
Ayrıca accuracy, sensitivity, specificity ve AUC aynı performans kavramı değildir. Bir modelin AUC değeri başka modelin accuracy değeriyle doğrudan nicel üstünlük karşılaştırmasına sokulamaz.
Foundation model yaklaşımı cüzzamda doğrulandı mı?
Hayır. Kaynak, büyük multimodal foundation modellerin gelecekte klinik fotoğraf, dermoskopi, histopatoloji, metin ve yapılandırılmış klinik veriyi aynı temsilde birleştirme potansiyelinden söz etmektedir.
Ancak cüzzama özgü bir foundation modelin klinik yararının henüz gösterilmediğini açıkça belirtir.
Gelecekte önerilen multimodal veri entegrasyonu
Kaynak gelecekte standartlaştırılmış deri fotoğraflarının duyu bulguları, periferik sinir değerlendirmesi, moleküler testler, konak yanıtı biyobelirteçleri ve uzun dönem takip verileriyle birleştirilebileceğini tartışmaktadır.
Bu yapı şu anda doğrulanmış klinik araç değildir. Yazarlar, ek veri türlerinin gerçekten klinisyen tek başına veya daha basit modellerden daha fazla yarar sağlayıp sağlamadığının prospektif olarak ölçülmesini gerekli görmektedir.
PCR/qPCR ve AI entegrasyonunun potansiyeli
Moleküler testler morfolojik deri görünümünden farklı bir bilgi katmanı sağlar. Özellikle düşük bakteri yükünün bulunduğu PB hastalıkta, görüntü ve klinik veriye moleküler kanıt eklenmesi teorik olarak tanısal belirsizliği azaltabilir.
Derleme bu yaklaşımı araştırılması gereken bir gelecek yönü olarak tanımlar. Entegre sistemlerin tanısal verimi, tanıya kadar geçen süreyi, hastalık ilerleme öngörüsünü veya temaslı risk sınıflandırmasını gerçekten iyileştirdiği henüz prospektif olarak gösterilmiş değildir.
Dijital sağlık sistemleri hangi gerçek yaşam ölçütleriyle değerlendirilmelidir?
Kaynak, yalnız accuracy veya AUC'nin yeterli olmadığını vurgular. Uygulama çalışmalarında kullanılabilirlik, çevrimdışı çalışabilme, sistemler arası birlikte çalışabilirlik, maliyet-etkinlik, sevkin tamamlanması, tedaviye kadar geçen süre ve eşitlik gibi gerçek sağlık hizmeti ölçütleri de değerlendirilmelidir.
Çalışmanın güçlü yönleri
- Cüzzama özgü AI kanıtı ile genel dermatoloji AI kanıtını açıkça ayırmaktadır.
- Tanıyı yalnız görüntü sınıflandırması olarak görmeyip klinik, bakteriyolojik, histopatolojik ve moleküler katmanlarla birlikte değerlendirmektedir.
- PB hastalığın düşük bakteri yüküne bağlı özel tanı zorluğunu görünür kılmaktadır.
- Model performansını yalnız accuracy üzerinden değerlendirmemekte; harici doğrulama, calibration ve alt grup performansını da gündeme getirmektedir.
- Cilt pigmentasyonu ve demografik temsil gibi fairness sorunlarını tartışmaktadır.
- Tele-tıp, mobil sağlık ve sevk zincirini AI tartışmasına dahil etmektedir.
- AI'nin uzman hekimin yerini değil, karar desteğini hedeflemesi gerektiğini açık biçimde belirtmektedir.
Çalışmanın sınırlılıkları
- Çalışma narratif derlemedir; sistematik meta-analiz değildir.
- PubMed/MEDLINE ana veri tabanıdır; kapsam bütün bilimsel veri tabanlarını eksiksiz tarayan formal sistematik derleme düzeyinde değildir.
- Dahil edilen çalışmalar görev, veri türü ve performans ölçütü bakımından heterojendir.
- Cüzzama özgü primer AI çalışması sayısı sınırlıdır.
- Bağımsız harici ve prospektif doğrulama genel olarak yetersizdir.
- Tablo 1'de “verify in full text”, “architecture to verify” ve “denominator to verify” gibi tamamlanmamış editoryal ifadeler bulunmaktadır.
- Derleme cilt tonuna göre ayrılmış cüzzama özgü AI performans verisi sağlamamaktadır.
- Genel dermatolojiden gelen PanDerm sonuçları cüzzama doğrudan aktarılamaz.
- PanDerm paragrafındaki atıf numarası ile kaynakça listesindeki ilgili kayıt arasında kaynak-içi eşleşme sorunu vardır.
- Çalışma yeni AI modeli geliştirmemekte veya yeni hasta kohortu üzerinde prospektif doğrulama yapmamaktadır.
- Performans metrikleri için tüm çalışmalarda ortak güven aralıkları veya ortak hata ölçüleri verilmemektedir.
- Model calibration değerleri bütün primer çalışmalar için nicel biçimde raporlanmamıştır.
- Ekonomik uygulanabilirlik ve gerçek klinik sevk sonuçları henüz yeterince doğrulanmamıştır.
Çalışmanın desteklediği ve desteklemediği sonuçlar
| Çalışmanın desteklediği | Çalışmanın desteklemediği |
|---|---|
| AI cüzzamda karar desteği, triyaj ve operasyonel sınıflandırmaya yardımcı olabilir. | AI'nin klinisyenin yerine geçebilecek özerk cüzzam tanı sistemi olduğu. |
| Bazı cüzzama özgü modeller araştırma veri setlerinde yüksek performans bildirmiştir. | Bu performansların bütün ülkelerde ve sağlık sistemlerinde aynı olacağı. |
| Multimodal veri, tek veri türüne göre ek bilgi sağlayabilir. | Fotoğraf + klinik + moleküler + biyobelirteç entegrasyonunun klinik yararının cüzzamda kanıtlandığı. |
| PB hastalık düşük bakteri yükü nedeniyle tanısal olarak daha zor olabilir. | AI'nin PB hastalık sorununu tek başına çözdüğü. |
| Cilt pigmentasyonu AI için olası dağılım kayması kaynağıdır. | Cüzzam AI modellerinde belirli cilt tonlarında performans eşitsizliğinin bu derlemeyle kanıtlandığı. |
| Tele-tıp ve mobil sağlık uzman bakıma erişimi destekleyebilir. | Mobil uygulamaların doğrulayıcı test veya uzman muayenesine gerek bırakmadığı. |
| Genel dermatoloji foundation modelleri insan–AI iş birliğinin mümkün olduğuna dair dolaylı kanıt sağlar. | PanDerm'in cüzzam için doğrulanmış tanı modeli olduğu. |
| Harici ve prospektif doğrulama klinik geçiş için gereklidir. | Yüksek accuracy veya AUC'nin tek başına gerçek yaşam klinik başarısını kanıtladığı. |
Gelecek araştırma öncelikleri
Yazarlar çok merkezli iş birliklerini, standartlaştırılmış klinik veri setlerini, prospektif harici doğrulamayı, şeffaf raporlamayı ve açıklanabilir AI'yi temel öncelikler arasında göstermektedir.
Farklı cilt pigmentasyonlarında, farklı endemik popülasyonlarda ve farklı sağlık hizmeti ortamlarında alt grup performansının ayrı değerlendirilmesi fairness açısından gereklidir.
AI modellerinde yalnız discrimination değil, calibration ve uncertainty estimation da değerlendirilmelidir. Modelin doğru tahmin oranı kadar ne zaman belirsiz olduğunu güvenilir biçimde gösterebilmesi de klinik güvenlik açısından önemlidir.
Prospektif human–AI reader studies; AI tek başına, klinisyen tek başına ve AI destekli klinisyen performansını karşılaştırarak sistemin gerçek katkısını ölçmelidir.
Son hedef, AI'nin hastayı doğrudan otomatik olarak “pozitif/negatif” ilan ettiği kopuk bir araç değil; şüpheli vakayı uygun doğrulayıcı teste ve uzman bakıma bağlayan güvenli klinik karar destek sistemi olmasıdır.
Derlemenin temel bilimsel sonucu
Bu derlemenin temel sonucu “AI cüzzamı insanlardan daha iyi teşhis eder” değildir. Mevcut cüzzama özgü çalışmalar araştırma koşullarında umut verici performans göstermektedir; fakat veri setleri küçük veya sınırlı, görevler heterojen ve bağımsız prospektif doğrulama yetersizdir.
En savunulabilir yaklaşım, AI'nin deri görüntüsü, klinik veri ve dijital sağlık akışlarından yararlanarak ön saflardaki sağlık çalışanlarını desteklemesi; belirsiz veya şüpheli vakaları doğrulayıcı laboratuvar yöntemlerine ve uzman klinik değerlendirmeye yönlendirmesidir.
Kaynak ve Yöntem Notu
Özgün başlık: Artificial Intelligence and Digital Health in the Diagnosis of Leprosy: Current Advances and Future Perspectives
Yazarlar: Gerardo Rivera; Raúl Rubio; Luis Rodríguez; Josefina Rodríguez; Augusto Salinas; David Orozco; Francisco González; María Moreno.
Sorumlu yazar: María Moreno.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı beyanı belirtilmemiştir.
Kurum 1: Academic Department and Cardiovascular Tissue Bank, Faculty of Medicine, University of Monterrey (UDEM), Monterrey, Nuevo Leon, Mexico.
Kurum 2: Center for Interdisciplinary Studies and Research, Autonomous University of Coahuila (UAdeC), Saltillo, Coahuila, Mexico.
Kurum 3: Mexican Social Security Institute (IMSS), Monterrey, Nuevo Leon, Mexico.
Dergi: Acta Microbiologica Hellenica.
Yayınevi: MDPI, Hellenic Society for Microbiology adına.
Kaynak türü: Review; yazarların yöntem tanımıyla structured narrative review.
Bibliyografik kayıt: Acta Microbiologica Hellenica, 2026, 71(4), Article 44.
DOI: 10.3390/amh71040044
Resmî bağlantı: DOI 10.3390/amh71040044 üzerinden yayınevi kaydı.
Yayın zaman çizelgesi: Received: 31 Ağustos 2026; Revised: 16 Ekim 2026; Accepted: 20 Ekim 2026; Published: 22 Ekim 2026.
Academic Editor: Tomislav S. Kostyanev.
Hakemlik durumu: Yayımlanmış Review; Acta Microbiologica Hellenica hakemli, açık erişimli bir tıbbi mikrobiyoloji dergisidir.
Lisans: Creative Commons Attribution (CC BY).
Preprint durumu: İncelenen kaynak yayımlanmış dergi sürümüdür; kaynakta ayrı preprint kimliği belirtilmemiştir.
Literatür arama yöntemi: PubMed/MEDLINE ana veri tabanı; yayıncı siteleri ve WHO kaynaklarında hedefli arama; uygun çalışmaların kaynakça taraması; moleküler tanı, biyobelirteç, harici doğrulama, algoritmik yanlılık ve insan–AI karşılaştırmaları için ek hedefli aramalar.
Son arama güncellemesi: 17 Ağustos 2026.
Meta-analiz: Yapılmamıştır. Yazarlar çalışma görevleri, veri setleri, sonuç tanımları ve performans metriklerindeki heterojenlik nedeniyle nicel meta-analizin uygun olmadığını belirtmiştir.
Yeni deneysel veri: Yok.
Yeni AI modeli: Yok.
Kaynakta numaralandırılmış bilimsel denklem: Yok. Accuracy, sensitivity ve specificity denklemleri Verianla'da yalnız kaynakta kullanılan metriklerin öğretici açıklaması olarak verilmiştir.
Temel cüzzam-AI çalışmaları: de Souza ve ark. (2021), Barbieri ve ark. / AI4Leprosy (2022) ve Yotsu ve ark. (2023).
Kaynak Tablo 1 editoryal notu: Bazı hücrelerde “denominator to verify”, “architecture to verify” ve “verify in full text” ifadeleri yayımlanmış kaynakta görünmektedir. Bu alanlar Verianla tarafından tahmin edilerek doldurulmamıştır.
PanDerm atıf notu: Makale PanDerm performans paragrafında [19] numarasını kullanmaktadır; kaynakça listesinde [19] Moor ve ark. (2023), PanDerm ile doğrudan ilişkili 2025 Nature Medicine kaydı ise [21] Yan ve ark. olarak görünmektedir. Bu kaynak-içi atıf eşleşmesi sessizce değiştirilmemiştir.
IRB: Uygulanabilir değil; çalışma daha önce yayımlanmış ve kamuya açık literatürün narratif derlemesidir.
Bilgilendirilmiş onam: Uygulanabilir değil.
Finansman: Çalışma dış finansman almamıştır.
Veri erişilebilirliği: Yöntem bölümü analiz edilen verilerin atıf verilen yayınlarda bulunduğunu belirtirken son Data Availability Statement, makalenin sonuçlarını destekleyen ham verilerin yazarlardan talep üzerine sağlanacağını bildirmektedir. Verianla iki beyanı da değiştirmeden kayda geçirir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Conceptualization: María Moreno ve Gerardo Rivera.
Methodology: Gerardo Rivera, María Moreno ve Luis Rodríguez.
Software: Raúl Rubio ve Augusto Salinas.
Validation: Gerardo Rivera, Josefina Rodríguez ve David Orozco.
Formal analysis: Gerardo Rivera, María Moreno ve Francisco González.
Investigation: Gerardo Rivera, María Moreno, Raúl Rubio, Luis Rodríguez, Josefina Rodríguez, Augusto Salinas, David Orozco ve Francisco González.
Resources: María Moreno ve Francisco González.
Data curation: Gerardo Rivera, Luis Rodríguez ve Josefina Rodríguez.
Writing — original draft: Gerardo Rivera ve María Moreno.
Writing — review & editing: María Moreno, Gerardo Rivera, Raúl Rubio, Luis Rodríguez, Josefina Rodríguez, Augusto Salinas, David Orozco ve Francisco González.
Visualization: Gerardo Rivera ve David Orozco.
Supervision: María Moreno ve Raúl Rubio.
Project administration: María Moreno.
Funding acquisition: María Moreno.
Acknowledgment notu: Kaynak, yazarların çıktıyı gözden geçirip düzenlediklerini ve yayımlanan içeriğin sorumluluğunu üstlendiklerini belirtmektedir; belirli bir yapay zekâ aracı veya kullanım ayrıntısı kaynakta ayrıca adlandırılmamıştır.
Ana yorum sınırı: Cüzzama özgü AI modellerindeki araştırma performansı, gerçek dünya klinik etkinliğinin veya uzman hekimin yerine geçebilmenin kanıtı değildir. Genel dermatoloji AI sonuçları cüzzama nicel olarak aktarılmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir