


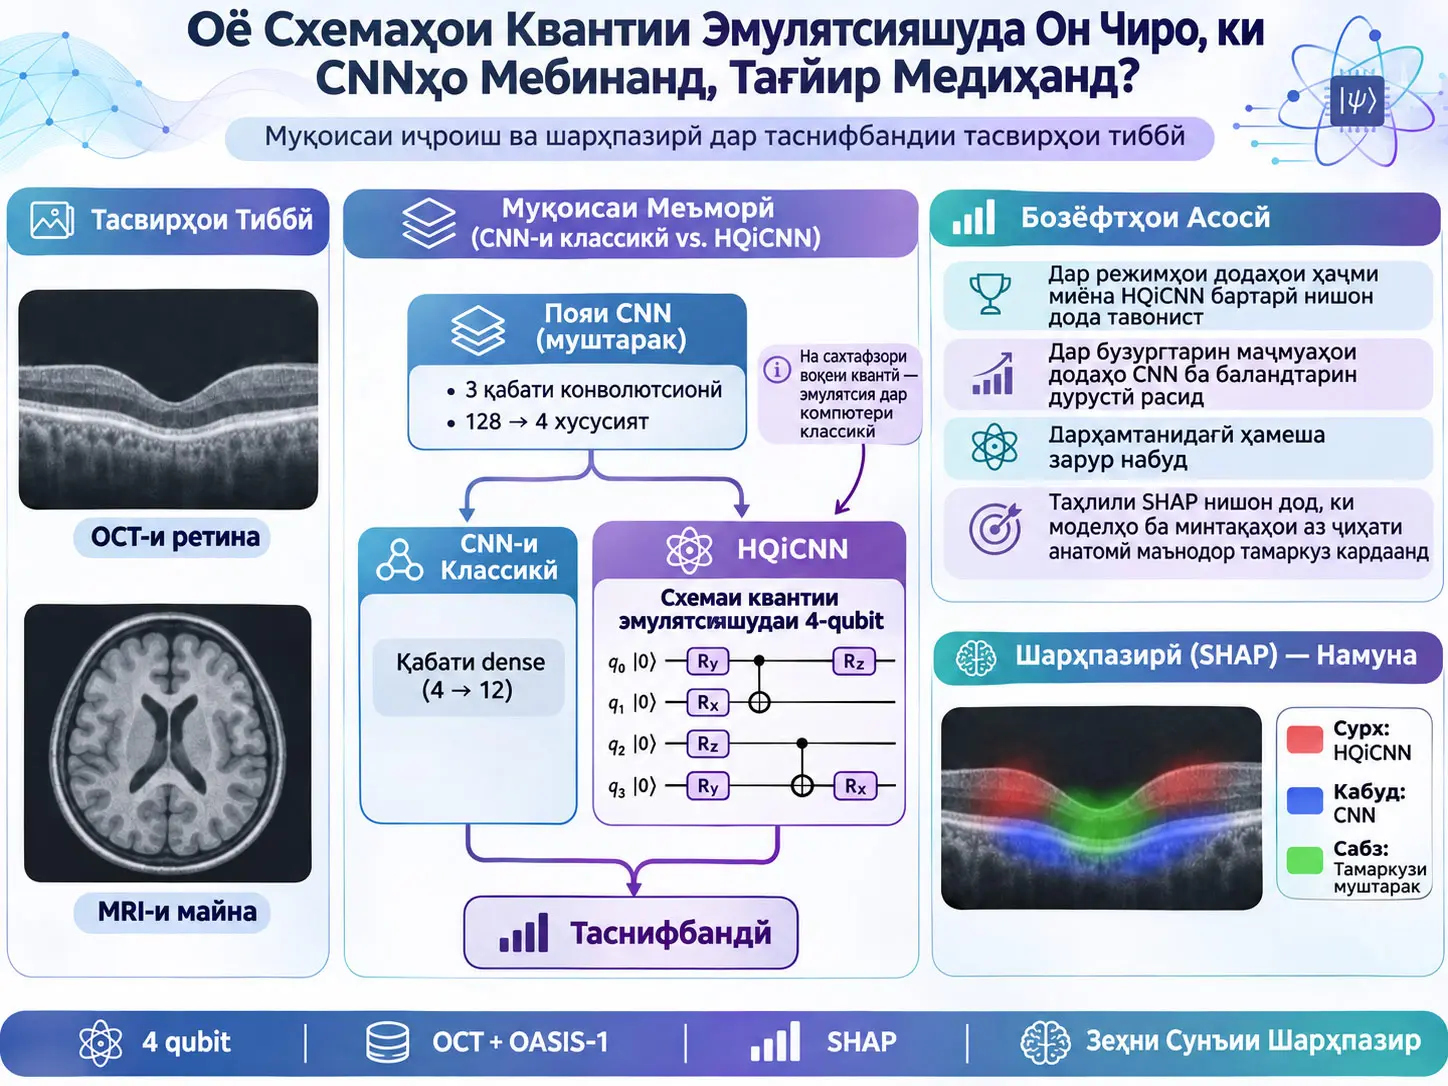
Шабакаи Гибридии Конволютсионии Нейронии Илҳомгирифта аз Квант (Hybrid Quantum-inspired Convolutional Neural Network, HQiCNN) модели таснифбандии тасвир аст, ки сохтори классикии CNN барои истихроҷи хусусиятҳои тасвирро нигоҳ дошта, ба ҷойи dense layer-и классикӣ дар қабати намоиши мобайнӣ схемаи параметрии квантии чор-qubit-аро, ки дар компютери классикӣ эмулятсия мешавад, истифода мебарад. Таҳқиқот HQiCNN-ро бо CNN-и классикӣ, ки ҳамон convolutional backbone-ро истифода мебарад, дар тасвирҳои томографияи когерентии оптикии ретина (OCT) ва тасвирҳои MRI-и майна барои марҳилабандии деменсия муқоиса мекунад. Саволи асосии таҳқиқот ин аст, ки оё схемаи хурди квантӣ, ки ба таври классикӣ эмулятсия мешавад, бе ниёз ба сахтафзори воқеии квантӣ метавонад намоиши мобайнии аз ҷониби CNN омӯхташуда ва минтақаҳои тасвиреро, ки модел ба онҳо аҳамият медиҳад, ба таври маънодор тағйир диҳад ё не.
Ду модел барои муқоисаи ҳарчи бештар назоратшавандаи меъморӣ аз як convolutional backbone истифода мебаранд. Тасвир аввал тавассути convolutional block-и сеқабата ба feature vector-и 128-андоза табдил дода мешавад; баъд linear reduction ин векторро то 4 андоза кам мекунад. Дар шохаи CNN-и классикӣ ин чор хусусият ба \(4\rightarrow12\) dense layer бо фаъолсозии ReLU ворид мешаванд, дар шохаи HQiCNN бошад чор feature бо angle encoding ба схемаи квантии чор-qubit-и эмулятсияшуда дода мешаванд. Дар схема \(R_Y\) input encoding, trainable \(R_X\) ва \(R_Z\) rotations ва CNOT entanglement-и ихтиёрӣ мавҷуд аст. Бо хондани \(X\), \(Y\) ва \(Z\) Pauli observables дар чор qubit дар маҷмӯъ 12 classical output feature ба даст меояд. Баромади 12-андозаи ҳар ду шоха ба ҳамон навъи classical output layer меравад.
Ин схема дар quantum processor-и воқеӣ иҷро нашудааст. Азбаски ҷузъи квантӣ бо амалҳои математикии маҳаллии PyTorch дар компютери классикӣ эмулятсия мешавад, маҳдудиятҳои воқеии компютери квантӣ ба монанди hardware noise, decoherence, finite-shot measurement uncertainty ва physical qubit connectivity ба benchmark дохил нестанд. Сохтори эмулятсияшуда инчунин метавонад ба ҷойи parameter-shift gradient estimation, ки дар quantum hardware лозим мешуд, ordinary backpropagation истифода барад.
Барои OCT training size, learning rate, batch size, circuit entanglement ва андозаи observable-set ба таври системавӣ тағйир дода шудаанд. Барномаи асосии OCT hyperparameter, ки нӯҳ training size, се learning rate, се batch size, entangled/non-entangled circuit, се observable set ва 10 random seed-ро дар бар мегирад, дар маҷмӯъ 640 execution гузориш шудааст. Максимум training 100 epoch, early-stopping patience ҳашт epoch, learning-rate-scheduler patience се epoch ва reduction factor 0.3 аст.
Натиҷаҳо нишон медиҳанд, ки як меъморӣ дар ҳамаи шароитҳо бартарӣ надорад. Дар OCT CNN-и классикӣ барои бузургтарин training set ба баландтарин арзиши умумии test accuracy дар таҳқиқот, яъне %93.7, расидааст. HQiCNN бошад махсусан дар training sets-и миёнаҳаҷм, дар бисёр configuration-ҳои тақрибан 800–2000 намуна, mean test accuracy-и баландтар аз CNN-и классикӣ додааст. Тамоюли монанд дар OASIS dementia robustness test низ дида шудааст; дар training sizes-и хурдтар HQiCNN бартарӣ дошт, бо зиёд шудани маълумот фарқ кам шуд ва дар training size-и калон CNN каме пеш гузашт.
Entanglement дар маҷмӯъ бартарии ҳатмӣ надодааст. Non-entangled circuit ба ҳисоби миёна дар аксари configuration-ҳо натиҷаи монанд ё беҳтар додааст, танҳо дар баъзе training sizes, махсусан дар сатҳи 1000 ва 1200 намуна, entanglement натиҷаҳои дақиқтар ва устувортар додааст. Манбаъ ин натиҷаро муҳим мешуморад, зеро separable circuits дар эмулятсияи классикӣ осонтар масштаб мешаванд, дар ҳоле ки хароҷоти simulation-и entangled circuits бо шумораи qubit хеле зудтар меафзояд.
Дар бахши Explainability муҳаққиқон ду абзори асосёфта ба SHAP пешниҳод мекунанд. \(|SHAP|IoU\) ҳампӯшии минтақаҳои тасвирро, ки барои ду модел ба %10-и баландтарини арзишҳои мутлақи SHAP дохил мешаванд, визуалӣ мекунад. \(EMD_{pos}\) бошад фарқи фазоии байни тақсимоти мусбати SHAP-и ду моделро бо усули Earth Mover's Distance/Wasserstein миқдорӣ мекунад. Дар OCT миёнаи \(EMD_{pos}\) барои 1000 training sample \(0.066\pm0.019\), барои 30000 sample \(0.045\pm0.018\) ёфт шудааст. Кам шудани арзиш бо зиёд шудани маълумот нишон медиҳад, ки минтақаҳои мусбати attribution-и ду модел бештар ба ҳам монанд мешаванд.
Аммо ин таҳқиқот тасдиқи системаи ташхиси клиникӣ нест. Гарчанде мутамарказ шудани харитаҳои SHAP дар retinal pigment epithelium ва минтақаҳои анатомии вобаста ба беморӣ аз ҷиҳати анатомӣ аломати маънодор аст, муаллифон ошкоро мегӯянд, ки ин минтақаҳо biomarker-и клиникии тасдиқшуда нестанд. Ҳамчунин independent external clinical validation, clinician reader study, full 3D MRI analysis ва training/inference computational-cost comparison анҷом дода нашудаанд.
HQiCNN Чист ва Оё Дар Ин Таҳқиқот Компютери Воқеии Квантӣ Истифода Мешавад?
HQiCNN модели таснифбандии hybrid quantum-inspired аст, ки dense representation layer-и мобайнии сохтори классикии CNN-ро бо схемаи параметрии квантии чор-qubit-и эмулятсияшуда иваз мекунад; дар ин таҳқиқот протсессори физикии квантӣ истифода нашудааст ва схемаи квантӣ дар PyTorch дар компютери классикӣ ба таври математикӣ эмулятсия шудааст.
“Quantum-inspired” дар ин ҷо маҳз чӣ маъно дорад?
Дар ин таҳқиқот “quantum-inspired” танҳо як тамғаи умумии маркетингӣ нест. Қабати мобайнии HQiCNN сохтори parameterized circuit-и чор-qubit дорад, ки математикаи воқеии quantum-circuit-ро истифода мебарад:
- classical features дар шакли qubit rotation angles encode мешаванд,
- qubit states бо unitary rotation matrices табдил дода мешаванд,
- trainable \(R_X\) ва \(R_Z\) rotations истифода мешаванд,
- дар entangled configuration CNOT gates татбиқ мешаванд,
- аз state-и ниҳоӣ classical outputs-и монанд ба expectation-value барои \(X\), \(Y\) ва \(Z\) Pauli observables гирифта мешаванд.
Аммо ҳамаи ин амалҳо на дар physical qubits, балки бо tensor/matrix operations дар компютери классикӣ ҳисоб карда мешаванд. Ин фарқият бисёр муҳим аст: манбаъ намегӯяд, ки “мо бо истифода аз компютери квантӣ тасвирҳои тиббиро тасниф кардем”.
Qubit чист?
Qubit воҳиди иттилооти квантӣ аст, ки дар Hilbert space-и комплексии дуандоза муайян мешавад. Манбаъ qubit state-и асосиро:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle = \begin{bmatrix} \alpha\\ \beta \end{bmatrix} \]
ба ин шакл медиҳад.
Шарти Normalization:
\[ |\alpha|^2+|\beta|^2=1 \]
бояд иҷро шавад.
Дар ин ҷо:
- \(|0\rangle\) ва \(|1\rangle\): computational basis states,
- \(\alpha\) ва \(\beta\): complex probability amplitudes,
- \(|\alpha|^2\) ва \(|\beta|^2\): арзишҳои Born-rule probabilities барои basis outcome-ҳои мувофиқ ҳангоми ideal measurement мебошанд.
Superposition маънои онро дорад, ки qubit пеш аз ченкунӣ маҷбур нест танҳо \(|0\rangle\) ё танҳо \(|1\rangle\) бошад ва метавонад ҳамчун normalized linear combination-и ин basis states ифода шавад.
Дар ин мақола qubit state дар дастгоҳи физикӣ омода намешавад; ҳамон state vector-и математикӣ дар ҳисобкунии классикӣ нигоҳ дошта мешавад.
Hilbert space чист?
Hilbert space як complex inner-product vector space аст, ки quantum state vectors дар он муайян мешаванд. Барои як qubit space-и асосӣ дуандоза аст. Ҳангоми пайваст кардани чанд qubit бо tensor product, state-space dimension меафзояд. Барои чор qubit pure-state vector-и умумӣ:
\[ 2^4=16 \]
complex amplitude дорад.
Ин рақам дар ин ҷо натиҷаи нави таҳқиқот нест; шарҳи иттилооти асосии квантӣ барои маънои математикии сохтори state-space-и чор-qubit аст.
Quantum gate чист?
Quantum gate unitary operator аст, ки дар quantum state acting мекунад. Азбаски шарти unitary:
\[ U^\dagger U=I \]
аст, нормаи state нигоҳ дошта мешавад.
Circuit gates-и асосии таҳқиқот \(R_X\), \(R_Y\), \(R_Z\) ва CNOT мебошанд.
Гардишҳои \(R_X\), \(R_Y\) ва \(R_Z\), ки дар манбаъ дода шудаанд
Манбаъ дар Муодилаи (1):
\[ R_X(\theta) = \begin{bmatrix} \cos(\theta/2) & -i\sin(\theta/2)\\ -i\sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Y(\theta) = \begin{bmatrix} \cos(\theta/2) & -\sin(\theta/2)\\ \sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Z(\theta) = \begin{bmatrix} e^{-i\theta/2} & 0\\ 0 & e^{i\theta/2} \end{bmatrix}. \tag{1} \]
ин matrices-ро истифода мебарад.
Ин matrices unitary transformations мебошанд, ки qubit state-ро дар Bloch sphere мутаносибан атрофи меҳварҳои \(x\), \(y\) ва \(z\) ба кунҷи \(\theta\) rotate мекунанд.
\(\theta\) параметри кунҷии беандоза аст ва бо radians шарҳ дода мешавад. Вобаста ба он ки input-dependent ё trainable parameter дар circuit ба кадом gate татбиқ мешавад, \(\theta\) метавонад encoded classical feature ё model parameter-и дар ҷараёни optimization омӯхташаванда бошад.
Pauli observables чистанд?
Манбаъ дар Муодилаи (2) се Pauli matrix-и асосиро медиҳад:
\[ X= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix}, \qquad Y= \begin{bmatrix} 0&-i\\ i&0 \end{bmatrix}, \qquad Z= \begin{bmatrix} 1&0\\ 0&-1 \end{bmatrix}. \tag{2} \]
Pauli matrices ҳам дар сохтани quantum gates/rotations ва ҳам дар баровардани classical information аз quantum state ҳамчун observables нақши марказӣ доранд.
Дар configuration-и асосии HQiCNN барои ҳар яке аз чор qubit се local observable:
\[ X,\ Y,\ Z \]
баҳо дода мешавад, бинобар ин:
\[ 4\ \text{qubit}\times3\ \text{observable}=12 \]
classical feature ҳосил мешавад.
Entanglement чист?
Entanglement шакли quantum correlation аст, ки дар он state-и системаи бисёрқисмии квантиро ба tensor product-и subsystem states-и мустақил ҷудо кардан мумкин нест.
Масалан, агар state-и умумии ду-qubit:
\[ |\psi\rangle \neq |\psi_A\rangle\otimes|\psi_B\rangle \]
бошад, state метавонад entangled бошад.
Дар версияи entangled-и HQiCNN байни qubits linear CNOT layer татбиқ мешавад. Дар версияи non-entangled ин coupling хориҷ карда мешавад.
Натиҷаи муҳими ин таҳқиқот ин аст, ки entanglement барои иҷрои умумӣ ҳатмӣ нест. Ин натиҷа маънои онро надорад, ки “entanglement дар ҳеҷ quantum machine-learning model фоида надорад”; он танҳо барои HQiCNN-и чор-qubit, datasets ва measurement scheme-и дар ин ҷо истифодашуда гузориш шудааст.
Parameterized Quantum Circuit чист?
Parameterized Quantum Circuit (PQC) сохтори quantum circuit аст, ки дар он баъзе gate angles trainable parameters мебошанд. Classical machine-learning optimizer ин parameters-ро барои кам кардани training loss нав мекунад.
Дар манбаъ HQiCNN circuit:
- 4-dimensional classical vector-ро мегирад,
- ҳар component-ро ба як qubit бо \(R_Y\) angle encoding ҷойгир мекунад,
- trainable \(R_X\) ва \(R_Z\) rotations татбиқ мекунад,
- дар версияи entangled CNOT gates истифода мебарад,
- аз ченкунии Pauli observables 12-dimensional classical representation мебарорад.
Муқоисаи CNN ва HQiCNN Чӣ Гуна Назорат Карда Шуд?
Ду модел як convolutional feature extractor, як 128→4 linear reduction ва қабати ниҳоии якхелаеро, ки аз representation-и 12-андоза ба classification output меравад, муштарак истифода мебаранд; тағйирёбандаи асосии меъморӣ иваз шудани \(4\rightarrow12\) ReLU dense layer дар CNN-и классикӣ бо circuit-и параметрии чор-qubit-и эмулятсияшуда дар HQiCNN мебошад.
Convolutional backbone-и муштарак
Medical image-и воридотӣ ба block-и муштарак, ки аз се convolutional layer иборат аст, ворид мешавад. Манбаъ барои ҳар layer:
- Conv2D,
- kernel size 3,
- Batch Normalization,
- Max Pooling,
- ReLU
ҷузъҳоро нишон медиҳад.
Дар охири ин block тасвир ба:
\[ 128 \]
feature vector-и андозадор табдил дода мешавад.
Linear reduction
Linear reduction layer, ки Activation истифода намекунад:
\[ 128\rightarrow4 \]
табдилро иҷро мекунад.
Ҳамин тавр, ҳар ду модел як four-dimensional latent representation-ро мегиранд.
Шохаи CNN-и классикӣ
Classical branch:
\[ 4\rightarrow12 \]
dense layer ва ReLU activation истифода мебарад.
Шохаи HQiCNN
HQiCNN ҳамон four-dimensional vector-ро ба чор qubit angle-encode мекунад ва пас аз quantum-circuit representation:
\[ 4\ \text{qubit} \times 3\ \text{local Pauli observable} = 12 \]
output feature тавлид мекунад.
Classification layer-и ниҳоӣ
Representation-и 12-dimensional-и ҳар ду branch ба output layer-и муштарак меравад. Output dimension ба шумораи label дар dataset баробар аст:
- OCT: 4 синф,
- OASIS robustness task: 3 синф.
Чаро input бо \(2\pi\cdot\mathrm{sigmoid}(v)\) табдил дода мешавад?
Parameterized rotation gates input-и кунҷиро истифода мебаранд. Манбаъ барои four-dimensional vector:
\[ v \]
се preprocessing strategy-ро муқоиса кардааст.
Варианти якум:
\[ \widetilde v = 2\pi\cdot\operatorname{sigmoid}(v). \]
Азбаски Sigmoid ба:
\[ (0,1) \]
фишурда мекунад, ҳангоми зарб ба \(2\pi\) angle range:
\[ (0,2\pi) \]
мешавад.
Варианти дуюм:
\[ \operatorname{remainder}(v,2\pi) \]
барои periodic wrapping истифода мешавад.
Варианти сеюм истифодаи raw \(v\) values бе татбиқи ягон explicit transform мебошад.
Манбаъ мегӯяд, ки scaled sigmoid transformation дар байни ин се вариант consistently better performance додааст ва дар озмоишҳои боқимонда ҳамин усул истифода шудааст. Дар матни асосӣ ҳамаи арзишҳои ададии ин preprocessing comparison дар ҷадвали ҷудогона дода нашудаанд.
Чаро parameter-shift rule дар ин ҷо истифода намешавад?
Дар physical ё black-box quantum circuit gradient-и trainable rotation parameter-ҳоро бо parameter-shift rule ҳисоб кардан мумкин аст. Тибқи шарҳи манбаъ, барои \(p\) trainable parameter ин усул:
\[ 2p \]
forward circuit evaluation талаб мекунад.
Азбаски circuit дар ин ҷо пурра бо differentiable PyTorch operations эмулятсия шудааст, automatic differentiation/backpropagation истифода мешавад. Муаллифон таъкид мекунанд, ки ҳамаи gradients метавонанд дар як backward pass якҷоя ҳисоб шаванд ва gradient-computation evaluation scaling аз талаботи \(O(p)\) circuit passes ба як backward pass коҳиш меёбад.
Ин натиҷаи quantum-hardware speedup нест. Бартарӣ аз истифодаи differentiable software graph-и classical emulation ба вуҷуд меояд.
Barren plateau чист ва оё дар ин таҳқиқот чен шудааст?
Barren plateau мушкили optimization дар parameterized quantum circuits аст, ки дар он cost-function gradient-ҳо бо афзоиши circuit size/depth бисёр хурд шуда, training-ро душвор карда метавонанд.
Мақола barren plateau-ро ҳамчун яке аз маҳдудиятҳои умумии масштабшавии QML муаррифӣ мекунад; аммо барномаи асосии таҷрибавӣ дар shallow circuit-и чор-qubit-и эмулятсияшуда анҷом дода шудааст ва барои barren-plateau scaling ченкунии алоҳидаи таҷрибавӣ ё exponent fitting анҷом намедиҳад.
Аз ин рӯ хулосаи “ин таҳқиқот мушкили barren plateau-ро ҳал кард” баровардан мумкин нест.
Маҷмуаи додаҳои OCT
Маҷмуаи додаҳои retinal optical coherence tomography дар маҷмӯъ:
\[ 84\,495 \]
JPEG image дорад ва дар манбаъ чор синф бо standard training/test splits нишон дода шудааст:
- NORMAL,
- CNV — choroidal neovascularization,
- DME — diabetic macular edema,
- DRUSEN.
Манбаъ мегӯяд, ки тасвирҳои маҷмуаи додаҳо дар солҳои 2013–2017 дар чанд clinical center-и байналмилалӣ бо дастгоҳҳои Spectralis OCT ҷамъоварӣ шудаанд ва барои label quality раванди бисёрмарҳилавии ophthalmologist review татбиқ шудааст.
Ин маълумот хусусияти original OCT dataset аст; маънои онро надорад, ки таҳқиқоти ҳозираи HQiCNN беморони нав ҷамъ кардааст.
Маҷмуаи додаҳои OASIS-1 MRI
Барои robustness analysis OASIS-1 structural MRI истифода шудааст. Тибқи манбаъ dataset:
\[ 416 \]
subject дорад ва диапазони синну сол:
\[ 18-96 \]
сол аст.
Занҷири Preprocessing:
- табдил додани 3D image files ба формати NIfTI,
- reorientation ба standard anatomical orientation,
- bias-field correction,
- field-of-view cropping,
- skull stripping,
- 12-degree-of-freedom affine registration ба MNI152 template бо 2 mm resolution,
- trilinear interpolation,
- tissue segmentation,
- эҷоди white-matter partial-volume mask,
- ҳисоб кардани white-matter mean intensity,
- Shinohara normalization,
- баровардани axial 2D slices аз registered 3D volume
тавзеҳ дода мешавад.
Ҳамаи model inputs:
\[ 64\times64 \]
ба pixel resolution resize шуда ва ба:
\[ [0,1] \]
диапазон normalize шудаанд.
Чаро синфҳои OASIS набояд ҳамчун ташхиси воқеии CDR хонда шаванд?
Манбаъ OASIS-derived labels-ро ба се гурӯҳ табдил медиҳад:
- Non Demented,
- Very Mild Dementia,
- Mild/Moderate Dementia.
Муаллифон ошкоро мегӯянд, ки ин labels formal clinical CDR assessment нестанд.
Танҳо аз рӯи severity descriptions мувофиқати тахминӣ анҷом шудааст:
- Non Demented ≈ CDR 0,
- Very Mild Dementia ≈ CDR 0.5,
- Mild/Moderate Dementia ≈ CDR ≥ 1.
Азбаски синфи Moderate Dementia камтар аз 500 sample дошт, бо Mild Dementia якҷо карда шуд. Majority class низ то андозаи дигар classes downsample карда шуда, task-и се-синфа мувозинат шуд.
Аз ин рӯ таҳқиқот мустақиман formal CDR clinical scoring algorithm-ро омӯзондааст, гуфтан дуруст нест.
EMDpos Чиро Месанҷад?
\(EMD_{pos}\) метрикаи explainability аст, ки normalized positive SHAP pixel distributions-и HQiCNN ва CNN-и классикиро бо Earth Mover's Distance-и дуандоза муқоиса мекунад; ҳар қадар арзиш хурд бошад, тақсимоти фазоии минтақаҳои тасвир, ки барои таснифи дуруст саҳм мегузоранд, дар ду модел бештар ба ҳам наздик мешавад.
SHAP чист?
SHAP model-agnostic explainability framework аст, ки бо равиши Shapley-value нишон медиҳад input features ба model prediction дар кадом самт ва бо чӣ бузургӣ саҳм гузоштаанд.
Дар image model feature метавонад ҳамчун pixel ё pixel region шарҳ дода шавад. Positive SHAP value маънои онро дорад, ки pixel-и мувофиқ contribution-и дастгирӣкунандаи output-и арзёбишавандаро нишон медиҳад.
Ин шарҳ feature attribution аст; худ аз худ далели biological causality ё clinical biomarker нест.
\(|SHAP|IoU\) чӣ гуна истифода мешавад?
Манбаъ барои ҳар модел қисми баландтарини:
\[ 10\% \]
absolute SHAP values-ро интихоб карда, ду region-of-interest mask:
\[ R_A,\ R_B \]
месозад.
Дар Figure 6-и манбаъ:
- сурх: минтақаҳое, ки танҳо HQiCNN attribution-и қавӣ медиҳад,
- кабуд: минтақаҳое, ки танҳо CNN attribution-и қавӣ медиҳад,
- сабз: минтақаҳои муштараки ду модел
нишон дода мешаванд.
Манбаъ барои \(|SHAP|IoU\) формулаи алоҳидаи scalar Intersection-over-Union-ро ҳамчун муодилаи рақамдор намедиҳад; усул асосан барои намоён кардани spatial intersection байни top-%10 masks истифода мешавад.
Формулаи \(EMD_{pos}\)
Аввал positive SHAP values-и ду модел normalize шуда, ду-dimensional probability distributions ба даст меоянд.
Манбаъ Муодилаи (3):
\[ EMD_{pos} = \min_{\gamma\in\Pi(\omega_{HQiCNN}\mid\omega_{CNN})} \sum_{i,j} \gamma_{i,j} \left\| p_i-p_j \right\|_2. \tag{3} \]
Дар ин ҷо:
- \(\omega_{HQiCNN}\) ва \(\omega_{CNN}\): normalized positive SHAP spatial distributions,
- \(\gamma_{i,j}\): миқдори probability mass, ки аз pixel location \(i\) ба location \(j\) интиқол дода мешавад,
- \(p_i,p_j\): normalized pixel coordinates,
- \(\|\cdot\|_2\): Euclidean distance,
- \(\Pi\): ифодаи манбаъ барои маҷмуаи admissible transport plans, ки marginals-и ду distributions-ро нигоҳ медорад.
Манбаъ pixel coordinate-ро:
\[ p= \left( \frac{y}{64}, \frac{x}{64} \right) \]
normalize мекунад.
64×64 image:
\[ 64\times64=4096 \]
grid point дорад.
EMD воҳиди физикии метр, миллиметр ё pixel надорад; бинобар coordinate normalization дар ин ҷо ҳамчун spatial-distance metric-и беандоза истифода мешавад.
Ҳадди поёнӣ ва болоии \(EMD_{pos}\)
Барои Identical distributions:
\[ EMD_{pos}=0. \]
Манбаъ ҷудошавии максималии геометриро аз рӯи corners-и муқобили image grid ҳисоб мекунад:
\[ D = \sqrt{ \left(\frac{63}{64}\right)^2 + \left(\frac{63}{64}\right)^2 } = \frac{63}{64}\sqrt2 \approx1.3921. \tag{4} \]
Аз ин рӯ:
\[ 0 \le EMD_{pos} \le \frac{63}{64}\sqrt2 \approx1.3921. \tag{5} \]
дода мешавад.
Арзиши паст нишон медиҳад, ки positive-SHAP spatial distribution-и ду модел монанд аст; арзиши баланд бошад, probability mass бояд ба масофаи дуртар интиқол дода шавад.
Усул ва Натиҷаҳои Таҳқиқот
Тарҳи таҷрибавии OCT hyperparameter
| Hyperparameter | Арзишҳо | Шумораи вариантҳо |
|---|---|---|
| Training size | 200, 400, 800, 1000, 1200, 1600, 2000, 12000, 30000 | 9 |
| Learning rate | 10−2, 10−3, 10−4 | 3 |
| Batch size | 8, 16, 32 | 3 |
| Quantum circuit | Entangled, Not Entangled | 2 |
| Observable set | O1, O2, O3 | 3 |
| Random seed | 10 randomly selected seeds | 10 |
Манбаъ шумораи умумии OCT hyperparameter executions-ро:
\[ 9\times3\times10 + 3\times10 + 2\times8\times10 + 3\times6\times10 = 640 \]
медиҳад.
Ин рақами 640 ба барномаи OCT hyperparameter дар Table 1 тааллуқ дорад. OASIS robustness experiment ба ин маҷмӯъ бо формулаи алоҳидаи ошкор илова нашудааст.
Танзимоти Training
| Танзим | Арзиш / усули дар манбаъ додашуда |
|---|---|
| Framework | PyTorch |
| Quantum emulation | Native PyTorch functions |
| Loss | Cross-entropy |
| Output softmax | Истифода намешавад; cross-entropy дар unnormalized logits кор мекунад |
| Gradient handling | GradScaler |
| Максимум epoch | 100 |
| Early-stopping patience | 8 epoch |
| Learning-rate scheduler patience | 3 epoch |
| Learning-rate reduction factor | 0.3 |
| Random repetitions | 10 seed |
Table 2: натиҷаҳои learning rate ва training size
Арзишҳои зер mean test accuracy ± standard deviation мебошанд, ки дар Table 2-и манбаъ барои 10 random seed гузориш шудаанд.
| Model | LR | 200 | 400 | 800 | 1000 | 1200 | 1600 | 2000 | 12000 | 30000 |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN | 0.01 | 0.436 ± 0.104 | 0.495 ± 0.135 | 0.575 ± 0.049 | 0.670 ± 0.082 | 0.698 ± 0.098 | 0.749 ± 0.083 | 0.843 ± 0.020 | 0.929 ± 0.015 | 0.930 ± 0.010 |
| CNN | 0.001 | 0.467 ± 0.098 | 0.535 ± 0.125 | 0.633 ± 0.058 | 0.661 ± 0.074 | 0.734 ± 0.055 | 0.751 ± 0.076 | 0.774 ± 0.127 | 0.924 ± 0.010 | 0.937 ± 0.006 |
| CNN | 0.0001 | 0.311 ± 0.069 | 0.358 ± 0.078 | 0.550 ± 0.092 | 0.518 ± 0.132 | 0.628 ± 0.068 | 0.643 ± 0.049 | 0.672 ± 0.042 | 0.885 ± 0.011 | 0.919 ± 0.006 |
| HQiCNN | 0.01 | 0.325 ± 0.094 | 0.468 ± 0.105 | 0.551 ± 0.099 | 0.638 ± 0.092 | 0.714 ± 0.078 | 0.800 ± 0.032 | 0.818 ± 0.066 | 0.930 ± 0.009 | 0.929 ± 0.012 |
| HQiCNN | 0.001 | 0.448 ± 0.082 | 0.559 ± 0.076 | 0.688 ± 0.051 | 0.745 ± 0.074 | 0.769 ± 0.028 | 0.795 ± 0.055 | 0.828 ± 0.034 | 0.920 ± 0.008 | 0.931 ± 0.008 |
| HQiCNN | 0.0001 | 0.347 ± 0.089 | 0.414 ± 0.085 | 0.542 ± 0.080 | 0.582 ± 0.053 | 0.600 ± 0.051 | 0.653 ± 0.037 | 0.684 ± 0.058 | 0.897 ± 0.008 | 0.920 ± 0.008 |
Натиҷаи Training size
Дар ҳар ду модел тамоюли умумӣ ин аст, ки бо зиёд шудани training data test accuracy баланд мешавад.
Манбаъ махсусан пас аз тақрибан:
\[ 12\,000 \]
sample суст шудани gains ва оғози рафтори saturation/diminishing-returns-ро қайд мекунад.
Бартариҳои нисбии барҷастаи HQiCNN дар миёнаи small-to-intermediate data regime дида мешаванд. Баръакс, барои бузургтарин training set CNN-и классикӣ:
\[ 0.937\pm0.006 \]
ба баландтарин global OCT accuracy дар таҳқиқот расидааст.
Арзиши HQiCNN барои 30000 sample, learning rate 0.001:
\[ 0.931\pm0.008 \]
гузориш шудааст.
Пас, таҳқиқот хулосаи “HQiCNN дар ҳама ҳаҷми маълумот аз CNN беҳтар аст”-ро дастгирӣ намекунад.
Натиҷаи Learning rate
Манбаъ:
\[ 10^{-3} \]
learning rate-ро дар маҷмӯъ ҳамчун интихоби мутавозинтарини accuracy ва optimization stability тавсиф мекунад.
\(10^{-2}\) дар баъзе configurations натиҷаи баланд медиҳад, аммо seed/configuration variation бештар аст.
\[ 10^{-4} \]
дар аксари ҳолатҳо accuracy-и пасттар додааст ва манбаъ инро бо он мепайвандад, ки optimization дар allocated training budget аз ҳад conservative мондааст.
Ин натиҷа танҳо барои architectures, datasets ва training budget-и дар ин ҷо истифодашуда дуруст аст; universal optimum learning rate барои ҳамаи neural networks нест.
Огоҳии interpolation дар Figure 3
Манбаъ HQiCNN–CNN mean-accuracy difference-ро дар минтақаи small/intermediate training-size бо heatmap нишон медиҳад.
Воридоти heatmap discrete measured configurations мебошанд; caption-и манбаъ ошкоро мегӯяд, ки барои smooth кардани визуал interpolation истифода шудааст.
Аз ин рӯ Verianla аз interpolated color field numeric values-и нави дақиқ нахондааст ва discrete values-и воқеии Table 2-ро ҳамчун source-of-truth нигоҳ доштааст.
Натиҷаи Batch size
Барои training size 1000 batch sizes:
\[ 8,\ 16,\ 32 \]
муқоиса шудаанд.
Шарҳи Figure 4(a)-и манбаъ мегӯяд, ки HQiCNN дар ҳамаи се batch size аз рӯи mean accuracy ва stability аз CNN-и классикӣ беҳтар аст.
Азбаски individual box-plot values дар Figure 4(a) ҳамчун numeric table-и алоҳида дода нашудаанд, Verianla аз bar/box positions рақамҳои нави дақиқ истеҳсол намекунад.
Натиҷаи Entanglement
Entangled circuit CNOT layer дорад, non-entangled model бошад бе ҳамон entangling gates кор мекунад.
Натиҷаи манбаъ:
- ба ҳисоби миёна non-entangled configuration натиҷаи беҳтар медиҳад,
- барои 1000 ва 1200 training samples entangled configuration accurate ва stable менамояд,
- барои иҷрои умумии қавӣ entanglement ҳатмӣ нест.
Манбаъ инчунин эҳтимол медиҳад, ки local будани output observables метавонад ҳамаи higher-order correlations-и тавлидшудаи entanglement-ро намоён накунад.
Ин механизми исботшуда нест; тафсири натиҷаи муаллифон аст.
Чаро non-entangled circuit аз ҷиҳати масштабшавӣ муҳим аст?
Манбаъ мегӯяд, ки separable circuit classical emulation complexity метавонад бо шумораи qubit linear масштаб шавад, дар ҳоле ки entangled circuit simulation дар ҳолати умумӣ exponential complexity ба вуҷуд оварда метавонад.
Аз ин рӯ, агар classification accuracy-и монанд бе entanglement ба даст ояд, гузариш ба emulated circuit-ҳои калонтар аз ҷиҳати computational қобили амалтар буда метавонад.
Ин натиҷа барои quantum hardware-и воқеӣ тавсияи мустақими “entanglement истифода набаред” нест.
Observable sets
Манбаъ се nested observable set муайян мекунад.
Бо нишондиҳии манбаъ:
\[ O_1 = \{\Gamma_i\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i\in\{1,4\}. \]
\[ O_2 = O_1 \cup \{\Gamma_i\Gamma_j\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j\in\{1,4\}, \quad i\neq j. \]
\[ O_3 = O_1 \cup O_2 \cup \{\Gamma_i\Gamma_j\Gamma_k\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j,k\in\{1,4\}, \quad i\neq j\neq k. \]
Огоҳии нотация: Матни манбаъ ошкоро мегӯяд, ки дар circuit-и чор-qubit local, pairwise ва triple observables муайян шудаанд, аммо маҷмуаҳои индексро literal ҳамчун \(\{1,4\}\) чоп мекунад. Азбаски ин нишондиҳӣ танҳо ду индекс дорад, бо контекст пурра мувофиқ наменамояд. Verianla нишондиҳиро пинҳонӣ ба \(\{1,\ldots,4\}\) табдил надодааст.
Натиҷаи Observable-set
Дар small ва intermediate training sizes байни \(O_1\), \(O_2\) ва \(O_3\) фарқи равшани performance дида намешавад.
Манбаъ инро чунин шарҳ медиҳад, ки дар low-data regime модел пеш аз feature-space expressivity бо ҳаҷми training data маҳдуд мешавад.
Дар large-data regime, махсусан барои:
\[ 12\,000 \quad\text{ve}\quad 30\,000 \]
training samples, observable sets-и бойтар slightly higher accuracy медиҳанд.
Манбаъ ин натиҷаро аз ҷиҳати hardware низ баррасӣ мекунад: non-commuting observables-и иловагӣ дар hardware-и воқеӣ measurement budget-и иловагӣ талаб мекунанд. Дар emulated setting бошад ин physical shot overhead вуҷуд надорад.
Хатои caption дар манбаи Figure 4(c)
График ва матни атрофи Figure 4(c) муқоисаи \(O_1,O_2,O_3\) observable-set-ро нишон медиҳанд.
Бо вуҷуди ин, subfigure caption дар манбаъ боз ибораи:
“Accuracy comparison ... for different batch sizes”
бо маънои муқоисаи batch size-ро истифода мебарад.
Аз ин рӯ Verianla Figure 4(c)-ро ҳамчун observable-set experiment, мувофиқ ба шарҳи матни асосӣ ва graph legend тавсиф мекунад ва номувофиқии caption-и манбаъро низ намоён нигоҳ медорад.
Натиҷаи OASIS robustness
Good-performing hyperparameters-и дар OCT experiments муайяншуда ба масъалаи OASIS dementia classification интиқол дода шудаанд.
Манбаъ дар Figure 5 се training size нишон медиҳад:
\[ 999,\ 3000,\ 12000. \]
Рақами 999 бинобар зарурати сохтани balanced dataset байни се classes истифода шудааст.
Шарҳи манбаи Figure 5:
- дар training size-и хурд HQiCNN аз CNN-и классикӣ беҳтар аст,
- бо зиёд шудани training size фарқ кам мешавад,
- дар training size-и калонтарин CNN-и классикӣ каме пеш мегузарад.
Азбаски raw box-plot observations-и Figure 5 ҳамчун numeric table нашр нашудаанд, дар ин ҷо аз график accuracy-и нави дақиқ бароварда нашудааст.
Ин experiment бо ибораи худи муаллифон robustness check аст; барои тавлиди clinical conclusion тарҳрезӣ нашудааст.
Натиҷаҳои SHAP explainability
Барои OCT explainability experiment дар ҳар модел аз 10 seeds seed-е интихоб шудааст, ки accuracy-и он ба mean accuracy-и модел наздиктарин аст.
Манбаъ мегӯяд, ки дар attribution maps ҳар ду модел махсусан ба минтақаҳои анатомии атрофи:
- retinal pigment epithelium (RPE),
- retinal layers,
- disease-associated elevations/deformations
тамаркуз мекунанд.
Дар шароити 1000 training sample HQiCNN attribution maps бештар localized ва anatomically coherent менамоянд, дар ҳоле ки classical CNN attribution distribution-и fragmented-тар нишон медиҳад.
Ҳангоми расидан ба 30000 sample attribution overlap-и ду модел ба таври назаррас меафзояд.
Ин мушоҳидаҳо дар сатҳи attribution pattern ҳастанд; тасдиқи сабабии механизми ташхиси клиникӣ нестанд.
Натиҷаҳои \(EMD_{pos}\)
| Training size | EMDpos | Шарҳ |
|---|---|---|
| 1000 | 0.066 ± 0.019 | Фарқи spatial байни ду модел паст, аммо нисбат ба ҳолати 30000-sample калонтар |
| 30000 | 0.045 ± 0.018 | SHAP-spatial agreement баландтар |
Ҳар ду арзиш нисбат ба theoretical upper bound:
\[ 1.3921 \]
хеле пастанд.
Манбаъ инчунин гузориш медиҳад, ки same-image EMD distributions аз cross-image reference distribution байни тасвирҳои гуногун пасттаранд.
Ин натиҷа бо он мувофиқ аст, ки ду модел дар як тасвир ба regions-и анатомии монанд positive attribution медиҳанд.
Аммо \(EMD_{pos}\)-и паст маънои онро надорад, ки:
- модел шарҳи клиникии сабабии дуруст медиҳад,
- минтақаи ёфтшуда validated biomarker аст,
- модел патофизиологияи бемориро омӯхтааст
.
Оё Ин Таҳқиқот “Бартарии Квантӣ”-ро Нишон Медиҳад?
Не; таҳқиқот quantum advantage-ро ба маънои бартарии компютери квантии воқеӣ бар компютери классикӣ ё аз ҷиҳати мураккабии ҳисоббарорӣ нишон намедиҳад. Қабати мобайнии HQiCNN дар компютери классикӣ эмулятсия шудааст ва натиҷаҳо танҳо нишон медиҳанд, ки дар баъзе режимҳои дода/оптимизатсия ин намоиши илҳомгирифта аз квант метавонад алтернатива ба CNN-и классикии parameter-controlled бошад.
Яке аз муҳимтарин ҷумлаҳои бахши хулосаи таҳқиқот мегӯяд, ки бартарии HQiCNN танҳо аз “илова шудани quantum operations” барнамеояд.
Performance бо:
- ҳаҷми training data,
- learning rate ва optimization dynamics,
- интихоби entanglement,
- observable set
ҳамзамон тағйир меёбад.
Аз ин рӯ хулосаи умумии “quantum layer ҳамеша representation-и беҳтар меомӯзад” аз ҷониби манбаъ дастгирӣ намешавад.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Quantum circuit-и чор-qubit-и эмулятсияшуда метавонад ҳамчун representation layer-и алтернативӣ ба dense layer-и мобайнии CNN-и классикӣ истифода шавад.
- HQiCNN дар баъзе training-data regimes-и миёнаҳаҷм test accuracy-и баландтар аз CNN-и классикӣ додааст.
- CNN-и классикӣ дар бузургтарин OCT training set ба баландтарин accuracy-и умумии таҳқиқот расидааст.
- Таъсири мутақобилаи learning rate ва training size ба фарқи байни ду меъморӣ таъсири назаррас мерасонад.
- 10−3 learning rate дар шароити таҳқиқот ҳамчун интихоби мутавозин/устувор гузориш шудааст.
- Дар batch sizes 8, 16 ва 32 дар 1000-sample OCT experiment бартарии HQiCNN нигоҳ дошта шудааст.
- Entanglement барои performance-и қавии умумӣ ҳатмӣ нест.
- Дар large-data regime observable sets-и бойтар беҳбудии хурд, аммо ченшаванда додаанд.
- Дар OASIS robustness test тамоюли монанди small-data → бартарии HQiCNN ва large-data → бартарии CNN дида шудааст.
- \(|SHAP|IoU\) ва \(EMD_{pos}\) барои муқоисаи attribution patterns-и ду модел истифода шудаанд.
- Дар 1000 sample HQiCNN SHAP maps localized-тар менамоянд, дар 30000 sample бошад attribution distributions-и моделҳо бештар монанд мешаванд.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад
- Нишон дода нашудааст, ки компютери квантии воқеӣ таснифи тасвири тиббиро беҳтар аз CNN анҷом медиҳад.
- Quantum computational advantage ё asymptotic quantum speedup нишон дода нашудааст.
- Нишон дода нашудааст, ки HQiCNN барои ҳамаи datasets ва ҳамаи training sizes аз CNN беҳтар аст.
- Нишон дода нашудааст, ки entanglement барои муваффақияти таснифбандӣ ҳатмист.
- SHAP regions biomarker-и клиникии тасдиқшуда нестанд.
- OASIS labels formal CDR clinical assessments нестанд.
- Модел барои истифодаи беморхона prospective validation нагузаштааст.
- Independent multicenter external clinical validation анҷом дода нашудааст.
- Clinician reader study анҷом дода нашудааст.
- MRI classification дар full 3D volume анҷом дода нашудааст; 2D slices истифода шудаанд.
- Training time, inference speed, memory use ва general computational efficiency benchmark нашудаанд.
- Real quantum-hardware noise, decoherence ва finite-shot measurement error санҷида нашудаанд.
Маҳдудиятҳои асосӣ
- Quantum circuit танҳо чор qubit ва shallow emulated сохтор дорад.
- Real quantum hardware истифода нашудааст.
- Hardware connectivity constraint вуҷуд надорад.
- Finite-shot measurement uncertainty вуҷуд надорад.
- Decoherence ё gate noise вуҷуд надорад.
- OASIS robustness task ба 2D slices кам карда шудааст.
- Independent external clinical dataset validation вуҷуд надорад.
- Clinician reader study вуҷуд надорад.
- Computational-cost comparison анҷом дода нашудааст.
- Code ҳамчун public repository дода нашудааст; гуфта мешавад, ки бо reasonable request аз corresponding authors дастрас шуда метавонад.
- Ҳарчанд ибораи “Parameter-matched” истифода шудааст, manuscript шумораи умумии trainable-parameter-и ду моделро дар numeric comparison table-и равшан намедиҳад.
Қайдҳои муҳими гузоришдиҳии дохили манбаъ
- Дар Figure 3 caption ба ҷойи “red areas” “read areas” навишта шудааст; минтақаҳои сурхи heatmap ҷойҳое мебошанд, ки HQiCNN беҳтар аст.
- Figure 3 аз discrete configurations сохта шудааст, аммо барои visual smoothness interpolation истифода мебарад.
- Figure 4(c) муқоисаи observable-set аст, аммо subfigure caption ҳамчун batch-size comparison навишта шудааст.
- Observable indices дар контексти чор-qubit ҳамчун \(i,j,k\in\{1,4\}\) чоп шудаанд; манбаъ шарҳ намедиҳад, ки ин literal set аст ё навишти кӯтоҳ/хато барои диапазони 1–4.
- Ибораи “Parameter-matched” дар манбаъ истифода мешавад, аммо total trainable-parameter counts дар ҷадвали ададии алоҳида дода нашудааст.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: Do emulated quantum circuits change what CNNs look at? Performance and explainability comparison in medical image classification
Муаллифон: Guillermo Rubiños Rodríguez; Martín Ottavianelli; Mateo Alonso; Gonzalo Blázquez Gil; Boris-Stephan Rauchmann; Pablo Díez-Valle; Sergio Altares-López.
Тартиби муаллифон: Тартиби манбаъ айнан нигоҳ дошта шудааст.
Саҳми баробар: Pablo Díez-Valle ва Sergio Altares-López дар манбаъ ҳамчун муаллифони саҳми баробар ишора шудаанд.
Corresponding author: Sergio Altares-López.
Corresponding-author e-mail: slopez@med.lmu.de
Муассиса 1: Instituto Tecnológico de Galicia, Cantón Grande 9, Planta 3, 15003 A Coruña, Spain.
Муассиса 2: Centro Singular de Investigación en Tecnoloxías Intelixentes (CiTIUS), Universidade de Santiago de Compostela, Santiago de Compostela, 15782, Spain.
Муассиса 3: Department of Neuroradiology, LMU University Hospital, Ludwig Maximilian University of Munich, Marchioninistraße 15, 81377 Munich, Germany.
Муассиса 4: Department of Psychiatry and Psychotherapy, LMU University Hospital, LMU Munich, Nussbaumstraße 7, 80336 Munich, Germany.
Навъи манбаъ: Preprint-и ҳисоббарорӣ дар соҳаи Quantum machine learning / medical image classification.
Платформа: arXiv.
arXiv: arXiv:2607.21186v1 [quant-ph].
Санаи ирсол: 23 июл 2026.
DOI: 10.48550/arXiv.2607.21186.
Ҳолати peer review: Манбаи баррасишуда версияи arXiv preprint аст. Ҳангоми санҷиши библиографӣ версияи алоҳида ва тасдиқшудаи ниҳоии мақолаи рецензияшуда барои ҳамин таҳқиқот муайян нашуд.
Литсензия: Дар metadata-и сабти arXiv arXiv non-exclusive distribution license нишон дода шудааст; Creative Commons license буданаш фарз карда нашудааст.
Шумораи саҳифаҳо: 17.
Шумораи шаклҳо: 6.
Шумораи ҷадвалҳо: 2.
Навъи асосии таҳқиқот: Supervised machine-learning benchmark ва explainability analysis дар datasets-и мавҷудаи medical-image.
Навъи quantum study: Real quantum hardware нест; classical emulation-и circuit-и параметрии чор-qubit.
Quantum implementation: Native PyTorch operations; dedicated quantum-computing framework истифода нашудааст.
Усули Gradient: Automatic differentiation/backpropagation барои emulated circuit; physical-circuit parameter-shift measurement истифода нашудааст.
Classical baseline: Convolutional backbone-и муштарак + \(4\rightarrow12\) ReLU dense layer.
HQiCNN branch: Convolutional backbone-и муштарак + 4-qubit emulated parameterized quantum circuit + 12 observable output.
Input preprocessing: 2π·sigmoid(v), remainder(v,2π) ва no-transform муқоиса шудаанд; дар қисми боқимондаи таҳқиқот scaled sigmoid интихоб шудааст.
Маҷмуаи додаҳои асосии OCT: 84,495 JPEG retinal OCT image; синфҳои NORMAL, CNV, DME ва DRUSEN.
Маҷмуаи додаҳои Robustness: OASIS-1-derived structural MRI; манбаъ 416 subject ва диапазони синни 18–96-ро гузориш медиҳад.
Синфҳои OASIS task: Non Demented, Very Mild Dementia, Mild/Moderate Dementia.
Маҳдудияти CDR: OASIS labels formal clinical CDR assessment нестанд; манбаъ танҳо approximately corresponding CDR stages-ро нишон медиҳад.
Input resolution: 64 × 64 pixel.
Input normalization: [0,1].
OCT hyperparameter executions: 640.
Random seeds: 10.
Maximum epochs: 100.
Early stopping patience: 8 epoch.
LR scheduler patience: 3 epoch.
LR reduction factor: 0.3.
Loss: Cross-entropy.
OCT highest reported accuracy: CNN, learning rate 0.001, 30000 training samples: \(0.937\pm0.006\).
Усулҳои Explainability: \(|SHAP|IoU\) ва \(EMD_{pos}\).
EMDpos: барои 1000 samples \(0.066\pm0.019\); барои 30000 samples \(0.045\pm0.018\).
EMDpos theoretical range: \(0\le EMD_{pos}\le(63/64)\sqrt2\approx1.3921\).
External clinical validation: Нест.
Clinician reader study: Нест.
MRI dimensionality: Ба ҷойи full 3D classification processed 2D axial slices истифода шудаанд.
Computational-cost analysis: Training time, inference efficiency ва memory requirements ба таври системавӣ benchmark нашудаанд.
Data availability: OCT data ба dataset-и мавҷуда дар истиноди манбаъ; OASIS1-derived images ва preprocessing data ба манбаъҳои dataset-и дар манбаъ зикршуда асос меёбанд.
Code availability: Гуфта шудааст, ки бо reasonable request аз corresponding authors дастрас шуда метавонад; манбаъ public code repository намедиҳад.
Маблағгузорӣ: PESL-Stiftung-Alzheimer 2026, Bayern, Germany, registered project 80765114 Pesl-Alzheimer-Stift; Principal Investigator Dr.-Ing. Sergio Altares-López. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Gonzalo Blázquez Gil ва Pablo Díez-Valle ҳамчунин дастгирии ARQADE (CER-20251019)-ро, ки аз ҷониби CDTI CERVERA Research Programme маблағгузорӣ шудааст, эътироф мекунанд.
Саҳми муаллифон: Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle ва Sergio Altares-López experiments-ро тарҳрезӣ ва банақшагирӣ кардаанд. Guillermo Rubiños Rodríguez ва Martín Ottavianelli experiments-ро иҷро кардаанд. Gonzalo Blázquez Gil, Sergio Altares-López ва Boris-Stephan Rauchmann funding таъмин кардаанд. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle ва Sergio Altares-López ба results interpretation саҳм гузоштаанд. Guillermo Rubiños Rodríguez ва Sergio Altares-López дар manuscript writing нақши пешбар доштанд. Ҳамаи муаллифон critical feedback дода, ба ташаккули таҳқиқот, таҳлил ва manuscript саҳм гузоштаанд.
Бархӯрди манфиатҳо: Муаллифон изҳор мекунанд, ки competing financial interests надоранд.
Ethics statement-и алоҳида: Дар preprint-и боршуда бахши алоҳидаи institutional-review/ethics-approval statement дида намешавад. Таҳқиқот ба ҷойи patient recruitment-и нав дар datasets-и мавҷуда computational analysis анҷом медиҳад; берун аз ин, ҳолати approval-и этикӣ аз номи манбаъ бо фарзия пур карда нашудааст.
Санҷиши такрорӣ: Азбаски барои ин exact title ва arXiv:2607.21186 сабти қаблии коркарди Verianla ёфт нашуд, ҳамчун мақолаи нав омода шудааст.
Қайдҳои гузоришдиҳии дохили манбаъ: Figure 4(c) caption observable-set graph-ро ҳамчун batch-size comparison нишон медиҳад; истифодаи \(\{1,4\}\) дар observable-index notation аз ҷиҳати контекст номуайян аст; Figure 3 interpolation истифода мебарад; total model parameter counts ҳамчун numeric table-и алоҳида дода нашудаанд.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд