


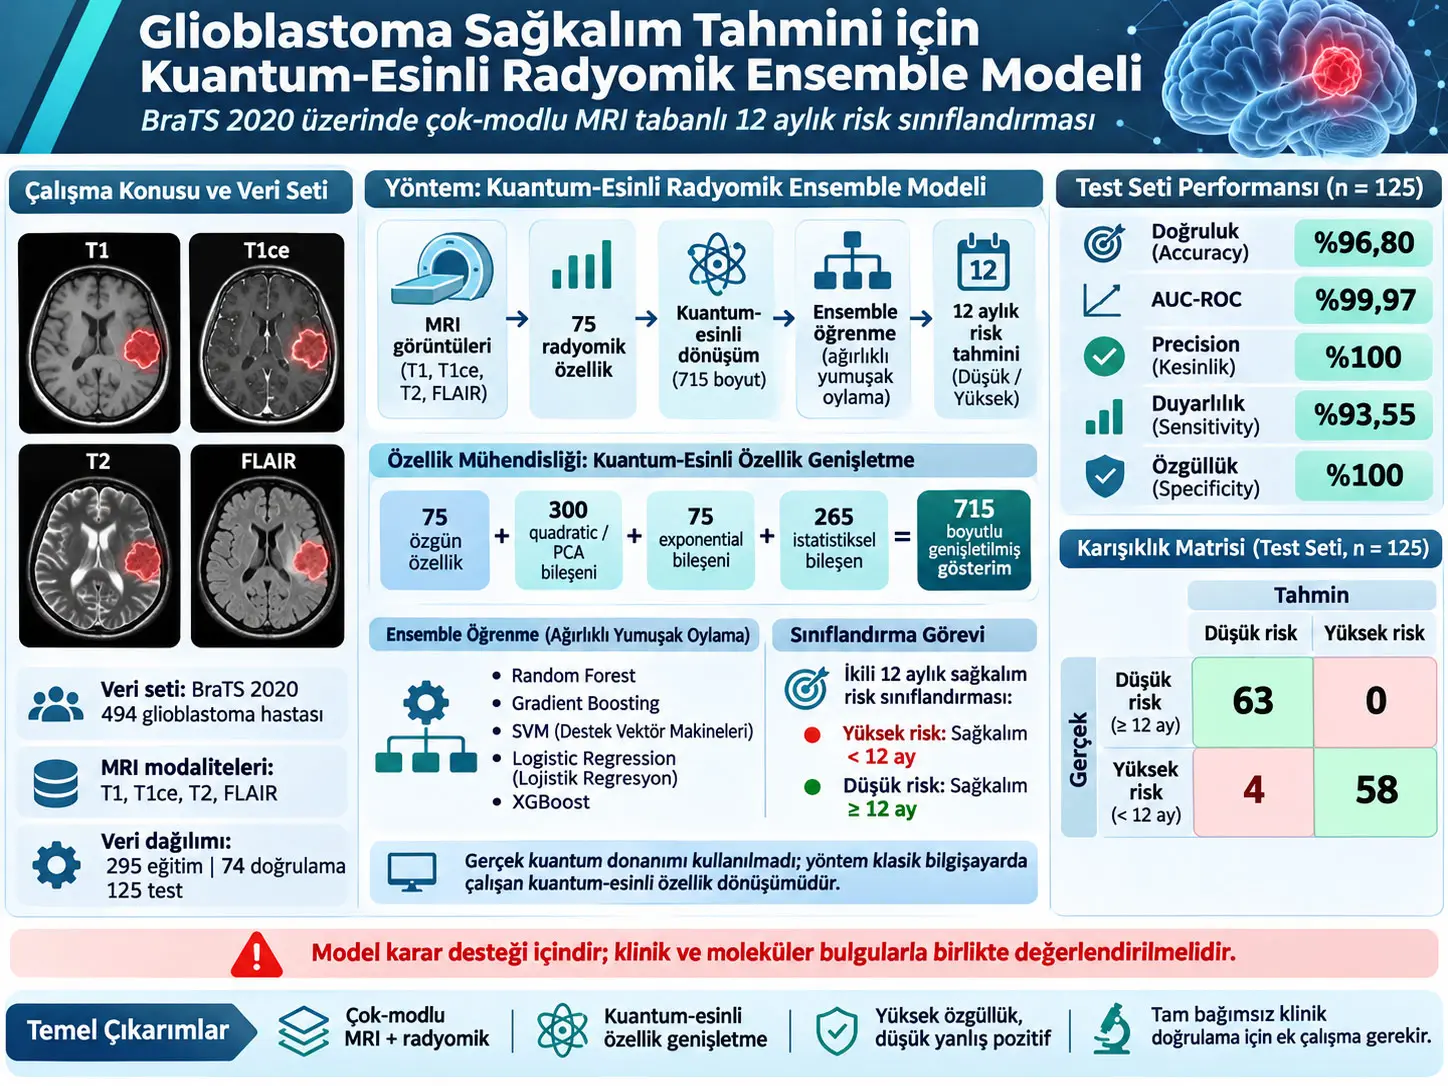
Kuantum-esinli radyomik, tıbbi görüntülerden çıkarılan klasik sayısal radyomik özellikleri gerçek kuantum donanımı kullanmadan, kuantum hesaplamadan esinlenen doğrusal olmayan özellik dönüşümleriyle genişleten bir makine öğrenmesi yaklaşımıdır. Bu çalışma, glioblastoma hastalarının çok-modlu manyetik rezonans görüntülerinden çıkarılan 75 radyomik özelliği 715 boyutlu genişletilmiş bir özellik uzayına dönüştürmekte ve bu gösterimi bir ensemble sınıflandırıcıyla birleştirerek 12 aylık sağkalım eşiğine göre yüksek-risk ve düşük-risk sınıflandırması yapmaktadır.
Çalışma Brain Tumor Segmentation 2020 (BraTS 2020) veri kümesindeki 494 glioblastoma hastasını kullanmıştır. Her hasta için T1, kontrastlı T1 (T1ce), T2 ve FLAIR MRI dizileri değerlendirilmiştir. Veri kümesi 295 hasta eğitim (%60), 74 hasta doğrulama (%15) ve 125 hasta test (%25) olmak üzere ayrılmıştır. Çalışmanın ana sonlanım noktası 12 aylık overall survival'dır: sağkalımı 12 aydan kısa hastalar yüksek riskli, 12 ay veya daha uzun hastalar düşük riskli olarak sınıflandırılmıştır.
Kaynakta Quantum Feature Transform (QFT) adı verilen dönüşüm:
\[ \Phi(x)=[x;Q(x);E(x);S(x)] \]
şeklinde verilmektedir. Başlangıç vektörü:
\[ x\in\mathbb{R}^{75} \]
olup dönüşüm sonrasında:
\[ \Phi(x)\in\mathbb{R}^{715} \]
boyutlu bir gösterim elde edilmektedir. Burada \(x\) özgün radyomik özellikleri, \(Q(x)\) özellik çiftlerinin quadratic interactions'ını, \(E(x)\) Gaussian exponential encoding'i ve \(S(x)\) statistical aggregates bileşenini temsil etmektedir.
Bu yaklaşım gerçek bir quantum computer üzerinde çalıştırılmamıştır. Yazarlar yöntemin quantum-inspired olduğunu ve standart klasik bilgisayarlarda NumPy ile scikit-learn kullanılarak uygulanabildiğini açıkça belirtmektedir. Bir hastanın özellik dönüşümünün standart CPU üzerinde yaklaşık 2–3 dakika sürdüğü raporlanmıştır.
Test setinde kaynak tarafından raporlanan performans:
- Accuracy: %96,80,
- 95% confidence interval: %94,92–%98,68,
- AUC-ROC: %99,97,
- Precision: %100,
- Sensitivity: %93,55,
- Specificity: %100,
- F1-score: %96,67.
125 hastalık test grubunda 63 düşük-risk hastasının tamamı doğru sınıflandırılmış, 62 yüksek-risk hastasının 58'i doğru sınıflandırılmış ve 4 yüksek-risk hastası yanlış biçimde düşük-risk olarak tahmin edilmiştir. Dolayısıyla çalışma sıfır false-positive bildirirken dört false-negative içermektedir.
Bu sonuçlar yüksek ayırt etme performansına işaret etse de klinik yorum sınırı önemlidir. Çalışmanın kendi Tartışma bölümünde modelin mutlak bir klinik karar verici olarak kullanılmaması, sonuçların diğer klinik ve moleküler bilgilerle birlikte değerlendirilmesi gerektiği belirtilmektedir. Ayrıca “external validation” ifadesine rağmen 125 hastalık nihai test grubu BraTS 2020 veri kümesinin kendi içindeki ayrımdan gelmektedir; tamamen bağımsız non-BraTS hastane kohortunda prospective veya gerçek yaşam doğrulaması yapılmamıştır.
Bu makaledeki “kuantum” ifadesi gerçek kuantum bilgisayar kullanıldığı anlamına mı geliyor?
Hayır. Çalışmada kuantum işlemci, qubit, quantum gate veya gerçek quantum circuit çalıştırılmamıştır; yazarların “Quantum Feature Transform” adını verdiği yöntem, kuantum hesaplamadaki yüksek boyutlu ve doğrusal olmayan temsil fikrinden esinlenen fakat bütünüyle klasik bilgisayar üzerinde hesaplanan bir özellik mühendisliği yöntemidir.
Bu ayrım makalenin doğru anlaşılması için temel önemdedir.
Gerçek quantum machine learning uygulamasında bazı hesaplamalar qubit'ler üzerinde quantum gates kullanılarak gerçekleştirilebilir. Bu çalışmada ise dönüşüm:
- NumPy ile vektör işlemleri,
- scikit-learn ile Principal Component Analysis (PCA),
- klasik machine-learning sınıflandırıcıları
kullanılarak gerçekleştirilmiştir.
Dolayısıyla çalışmanın gösterdiği şey:
“Kuantum bilgisayar glioblastoma sağkalımını %96,80 doğrulukla tahmin etti.”
değildir.
Kaynağa sadık ifade:
“Kuantum-esinli bir klasik özellik dönüşümüyle genişletilen radyomik veriler üzerinde çalışan ensemble model, çalışmanın BraTS 2020 test ayrımında %96,80 accuracy elde etti.”
Radyomik nedir?
Radyomik, MRI, CT veya PET gibi tıbbi görüntülerdeki tümörün şekli, yoğunluk dağılımı ve doku heterojenliği gibi görsel özellikleri sayısal değişkenlere dönüştüren hesaplamalı görüntü analizi yaklaşımıdır.
Bir radyolog MRI görüntüsüne baktığında tümörün:
- büyüklüğünü,
- şeklini,
- sınır düzensizliğini,
- kontrastlanmasını,
- nekrotik alanlarını,
- ödemi
gözle değerlendirebilir.
Radyomik ise benzer özellikleri matematiksel değişkenlere dönüştürmeye çalışır.
Örneğin:
- tumor volume → hacim,
- sphericity → tümörün küresel biçime ne kadar yakın olduğu,
- surface area → yüzey alanı,
- entropy → voxel yoğunluk dağılımındaki düzensizliğin ölçüsü,
- GLCM özellikleri → komşu voxel yoğunluklarının uzamsal ilişkileri
gibi nicelikler makine öğrenmesi modeline giriş verisi olabilir.
Glioblastoma neden zor bir tahmin problemidir?
Glioblastoma, yetişkinlerde en agresif primer beyin malignitelerinden biridir. Kaynak, mevcut tedavi koşullarında median survival'ın yaklaşık 12–15 ay olduğunu belirtmektedir. Ancak bütün hastalar aynı klinik seyri göstermez.
Hastalar arasında:
- tümör hacmi,
- lokalizasyon,
- infiltrasyon düzeyi,
- kontrast enhancement,
- moleküler biyoloji,
- tedavi yanıtı
açısından önemli heterojenlik bulunabilir.
Bu nedenle yalnız ortalama sağkalım değil, bireysel risk sınıflandırması klinik açıdan önem taşımaktadır.
Model hangi klinik soruyu cevaplamaya çalışıyor?
Çalışmanın sınıflandırma problemi:
\[ \text{Survival}<12\ \text{ay} \Rightarrow \text{yüksek risk} \]
ve:
\[ \text{Survival}\geq12\ \text{ay} \Rightarrow \text{düşük risk} \]
şeklinde tanımlanmıştır.
Bu nedenle model exact survival time tahmini yapmamaktadır. Örneğin “hasta 17,3 ay yaşayacak” şeklinde continuous survival prediction üretmez.
Model yalnız 12 aylık eşik çevresinde binary risk classification yapmaktadır.
BraTS 2020 veri kümesi çalışmada nasıl kullanıldı?
Çalışmada 494 glioblastoma hastasının çok-merkezli BraTS 2020 görüntüleri kullanılmış; hastalar ham özellik aşamasında 295 eğitim, 74 doğrulama ve 125 test hastası olarak ayrılmış ve model ayarlarının test grubuna bilgi sızdırmaması amaçlanmıştır.
| Özellik | Kaynak değeri |
|---|---|
| Toplam hasta | 494 |
| Tümör tipi | Glioblastoma, WHO Grade IV olarak kaynakta belirtilmiştir |
| Katkı sağlayan kurum | 19, çok uluslu |
| MRI dizileri | T1, T1ce, T2, FLAIR |
| Görüntü çözünürlüğü | 1 mm³ isotropic |
| Eğitim | 295 hasta (%60) |
| Doğrulama | 74 hasta (%15) |
| Test | 125 hasta (%25) |
| Ana sonlanım | 12 aylık sağkalım eşiği |
| Segmentasyon | Uzman manuel segmentasyon, üç alt bölge |
Dört MRI dizisi neden birlikte kullanılıyor?
T1, T1ce, T2 ve FLAIR aynı biyolojik bilgiyi tekrar eden dört görüntü değildir. Farklı doku özelliklerini vurgularlar.
| MRI dizisi | Çalışmadaki temel rol |
|---|---|
| T1 | Anatomik yapı |
| T1ce | Kontrastlanan aktif tümör ve blood-brain barrier bozulması |
| T2 | Vasogenic edema ve infiltrative disease |
| FLAIR | Cerebrospinal-fluid sinyalini baskılayarak tümör ve ödem sınırlarının daha görünür hale gelmesi |
Çalışmanın temel yaklaşımı, bu dört modalitenin tamamındaki complementary information'ı tek radyomik feature representation içinde birleştirmektir.
Segmentasyon hangi bölgeleri içeriyor?
Kaynakta uzmanlar tarafından üç temel tumor sub-region tanımlanmıştır:
- enhancing tumor,
- peritumoral edema,
- necrotic core.
Kaynak Şekil 2 bu bölgeleri farklı renklerle göstermektedir. Bu radyolojik görüntüler gerçek hastalara ait kaynak verisinin görsel kanıtı olduğu için Verianla tarafından yapay MRI görüntüsü üretilmemiştir.
Kaynak içindeki MRI-modality tutarsızlığı
Makalenin ana yöntem tanımı ve Table 3 dört MRI dizisini:
T1, T1ce, T2 ve FLAIR
olarak vermektedir.
Ancak inclusion-criteria paragrafında “full multimodal MRI data” açıklaması içinde T1 post-contrast, T2-weighted, FLAIR ve diffusion-weighted imaging ifadesi bulunmaktadır.
Diffusion-weighted imaging çalışmanın ana dört-modalite QFT pipeline'ında yeniden kullanılmamaktadır. Kaynak bu farklılığın nedenini açıklamamaktadır. Bu nedenle diffusion-weighted imaging'i modelin doğrulanmış beşinci giriş kanalı olarak kabul etmek doğru değildir.
75 radyomik özellik nasıl oluşturuldu?
Kaynağın ana özellik listesinde 75 değişken beş aileye ayrılmaktadır: shape, first-order statistics, GLCM, GLRLM ve GLSZM; bu gruplar tümör geometrisini, voxel yoğunluk dağılımlarını ve dokusal heterojenliği nicel olarak temsil etmeyi amaçlamaktadır.
| Özellik ailesi | Sayı | Temel anlam |
|---|---|---|
| Toplam | 75 | QFT giriş vektörü |
| Shape | 14 | Hacim, yüzey alanı, sphericity, compactness, maksimum 3B çap gibi geometrik özellikler |
| First-order | 18 | Mean, median, variance, skewness, kurtosis, energy, entropy gibi yoğunluk istatistikleri |
| GLCM | 22 | Komşu voxel yoğunluklarının uzamsal birlikteliği |
| GLRLM | 16 | Aynı yoğunluk değerlerinin ardışık voxel run yapılarını ölçen özellikler |
| GLSZM | 5 | Benzer yoğunluktaki bağlı voxel zones yapısını ölçen özellikler |
GLCM nedir?
Gray Level Co-occurrence Matrix (GLCM), belirli uzamsal ilişkideki iki voxel'in yoğunluk değerlerinin birlikte ne sıklıkta görüldüğünü sayan bir texture representation'dır.
GLCM tabanlı özellikler tümörün yalnız ortalama parlaklığını değil, görüntü içindeki spatial heterogeneity'yi ölçmeye çalışır.
GLRLM nedir?
Gray Level Run Length Matrix (GLRLM), belirli bir doğrultuda aynı veya benzer gri-seviyedeki ardışık voxel kümelerinin uzunluklarını analiz eder.
Bu nedenle görüntünün daha homojen veya daha parçalı doku yapısına sahip olup olmadığına ilişkin bilgi üretebilir.
GLSZM nedir?
Gray Level Size Zone Matrix (GLSZM), aynı gri seviyedeki bağlı voxel bölgelerinin büyüklüklerini değerlendirir.
GLRLM yönlü run yapılarını incelerken GLSZM connected zones üzerine odaklanır.
Özellik sayısındaki kaynak içi tutarsızlık
Kaynak önce 75 özelliği:
\[ 14+18+22+16+5=75 \]
şeklinde tanımlamaktadır.
Ancak birkaç paragraf sonra 75-dimensional vector:
“63 texture/first-order features across modalities + 12 shape features”
şeklinde ifade edilmektedir.
Bu açıklama önceki 14 shape sayısıyla uyuşmamaktadır.
Kaynak bu farkın feature-selection, modality aggregation veya farklı bir sayım yönteminden kaynaklanıp kaynaklanmadığını açıklamamaktadır. Bu nedenle Verianla bu farklılığı kendi varsayımıyla çözmemektedir.
Görüntüler model öncesinde nasıl ön işlendi?
Kaynak, scanner ve acquisition farklılıklarını azaltmak için tumor ROI içinde z-score normalization, N4 bias-field correction ve intensity discretization uygulandığını; dört MRI modalitesinin feature vectors'ının daha sonra birleştirildiğini bildirmektedir.
Z-score normalization
Z-score normalization genel olarak bir özelliğin ortalamasını sıfıra, standard deviation'ını bire yaklaştırmak için kullanılır.
Kavramsal form:
\[ z=\frac{x-\mu}{\sigma} \]
şeklindedir.
Bu denklem çalışmanın yeni bulgusu değil, kaynakta “mean = 0, standard deviation = 1” olarak belirtilen preprocessing adımının matematiksel açıklamasıdır.
Burada:
- \(x\): özgün değer,
- \(\mu\): ilgili dağılımın ortalaması,
- \(\sigma\): standard deviation,
- \(z\): normalize edilmiş değerdir.
N4 bias-field correction
MRI'da coil sensitivity ve başka acquisition etkileri görüntü boyunca yavaş değişen intensity inhomogeneity oluşturabilir. N4 bias correction bu düşük-frekanslı intensity variation'ı azaltmak için kullanılmaktadır.
Intensity discretization
Kaynak:
- T1/T1ce için fixed bin width: 25 HU,
- T2/FLAIR için fixed bin width: 5 HU
bildirmektedir.
Burada dikkat edilmesi gereken kaynak sadakati noktası şudur: MRI intensity değerleri fiziksel olarak CT'deki Hounsfield Unit gibi standart HU ölçeğine sahip değildir. Ancak makale bu birimi “HU” olarak yazmaktadır. Verianla bunu sessizce farklı bir birimle değiştirmemektedir; kaynakta aynen böyle raporlandığını belirtmektedir.
Quantum Feature Transform 75 özelliği 715 boyuta nasıl çıkarıyor?
QFT, özgün 75 özellik vektörünü korurken feature-feature quadratic products, her özelliğin Gaussian exponential dönüşümü ve kaynakta statistical aggregates olarak tanımlanan ek özellikleri birleştirerek 715 boyutlu klasik bir feature representation üretmektedir.
Kaynağın temel denklemi:
\[ \Phi(x)=[x;Q(x);E(x);S(x)] \]
şeklindedir.
Burada:
- \(x\): 75 özgün radyomik özellik,
- \(Q(x)\): quadratic interaction representation,
- \(E(x)\): exponential encoding,
- \(S(x)\): statistical aggregates.
Kaynak tarafından verilen boyut dağılımı:
| Bileşen | Boyut | İşlev |
|---|---|---|
| Toplam | 715 | \(\Phi(x)\) |
| \(x\) | 75 | Özgün özelliklerin değiştirilmeden korunması |
| \(Q(x)\) | 300 | Pairwise quadratic interactions'ın PCA ile sıkıştırılmış gösterimi |
| \(E(x)\) | 75 | Gaussian exponential dönüşüm |
| \(S(x)\) | 265 | Kaynakta statistical aggregates olarak tanımlanan ek representation |
Toplam:
\[ 75+300+75+265=715. \]
Quadratic encoding ne yapıyor?
75 özelliğin farklı çiftleri:
\[ x_i x_j \]
şeklinde çarpılarak ikinci-mertebe interactions oluşturulur.
75 farklı özelliğin kendisiyle değil, birbirinden farklı ikililerinin sayısı:
\[ \binom{75}{2} = \frac{75\times74}{2} = 2775. \]
Kaynak da 2.775 unique feature pair bildirmektedir.
Bu quadratic terms örneğin iki özelliğin tek başına zayıf, birlikte güçlü prognostic information taşıdığı nonlinear ilişkileri modellemeye yardımcı olabilir.
Ancak 2.775 yeni değişkeni doğrudan kullanmak 295 training patient bulunan bir veri kümesinde aşırı yüksek dimensionality yaratabilir.
Bu nedenle PCA uygulanmıştır.
PCA neden kullanıldı?
Principal Component Analysis, correlated high-dimensional variables'ı variance'nın büyük bölümünü koruyan daha az sayıda orthogonal component'e dönüştürür.
Kaynak quadratic feature space'ten:
\[ 300 \]
principal component korumuştur.
Bu 300 bileşenin quadratic feature space'teki cumulative variance'ın:
\[ 95\% \]
oranını açıkladığı belirtilmektedir.
PCA yalnız training data üzerinde fit edilmiştir. Validation veya test verilerinin PCA parametrelerini etkilememesi data leakage riskini azaltmak açısından önemlidir.
Exponential encoding nedir?
Her özellik için kaynakta:
\[ E_i(x) = \exp\left( -\frac{x_i^2}{2\sigma^2} \right) \]
formu kullanılmaktadır.
Burada:
- \(x_i\): normalize edilmiş ilgili feature,
- \(\sigma\): Gaussian bandwidth,
- \(E_i(x)\): exponential-encoded feature'dır.
Kaynakta optimum:
\[ \sigma=1.5 \]
olarak verilmiştir.
Bu değer training-set içindeki nested cross-validation ile validation AUC-ROC'u maksimize edecek biçimde seçilmiştir.
Fonksiyon \(x_i=0\) yakınında en yüksek değere sahiptir. \(|x_i|\) büyüdükçe exponential değer nonlinear biçimde küçülür.
Dolayısıyla dönüşüm, feature magnitude ile output arasında lineer olmayan bir ilişki oluşturur.
Statistical aggregate bileşeninde ne var?
Kaynak \(S(x)\) için mean, standard deviation, skewness ve kurtosis gibi feature-family statistics hesaplandığını ve toplam 265 boyut ayrıldığını belirtmektedir.
Ancak yalnız dört statistics × belirtilen feature families hesabıyla 265 sayısının nasıl üretildiğini ayrıntılı olarak göstermemektedir.
Bu nedenle Verianla:
- 265 değerini kaynakta raporlandığı şekilde korur,
- fakat kaynakta bulunmayan alt-bileşen dağılımını uydurmaz.
Bu dönüşüm neden “quantum-inspired” olarak adlandırılıyor?
Yazarlar dönüşümü feature interactions'ı higher-order ve nonlinear channel space içinde temsil eden “quantum-like representation” olarak tanımlar.
Ancak matematiksel işlemler:
- pairwise multiplication,
- PCA,
- Gaussian exponential functions,
- classical statistics
olduğu için, performans artışını gerçek bir quantum computational advantage kanıtı olarak yorumlamak mümkün değildir.
Çalışmanın gösterdiği şey, bu belirli quantum-inspired feature engineering pipeline'ının bu veri setindeki classification performance ile ilişkili olduğudur.
Ensemble model nasıl kurulmuş?
Methods Section 2.3'e göre 715 boyutlu feature space üzerinde Random Forest, Gradient Boosting, Support Vector Machine, Logistic Regression ve XGBoost olmak üzere beş base learner eğitilmiş ve model olasılıkları optimize edilmiş ağırlıklarla soft voting yöntemiyle birleştirilmiştir.
Random Forest
| Hiperparametre | Değer |
|---|---|
| Ağaç sayısı | 500 |
| Maximum depth | 15 |
| Minimum samples per leaf | 5 |
| Split kriteri | Gini impurity |
Gradient Boosting
| Hiperparametre | Değer |
|---|---|
| Iterations | 300 |
| Learning rate | 0,01 |
| Maximum depth | 6 |
| Ek yöntem | Validation loss tabanlı early stopping |
Support Vector Machine
| Hiperparametre | Değer |
|---|---|
| Kernel | RBF |
| C | 10 |
| Gamma | 0,001 |
| Optimizasyon | Grid search |
Logistic Regression
| Hiperparametre | Değer |
|---|---|
| Penalty | L2 |
| Penalty strength \(\alpha\) | 0,01 |
| Solver | SAGA |
XGBoost
| Hiperparametre | Değer |
|---|---|
| Boosting rounds | 400 |
| Learning rate | 0,05 |
| Maximum depth | 7 |
| Subsample | 0,8 |
Ensemble ağırlıkları
| Model | Ağırlık |
|---|---|
| Random Forest | 0,25 |
| Gradient Boosting | 0,22 |
| XGBoost | 0,21 |
| SVM | 0,18 |
| Logistic Regression | 0,14 |
Ağırlıkların toplamı:
\[ 0.25+0.22+0.21+0.18+0.14=1.00. \]
Soft voting nasıl çalışır?
Her model bir hastanın yüksek-risk olasılığı için:
\[ P_m(\mathrm{high}\mid x) \]
üretir.
Ensemble probability kavramsal olarak:
\[ P_{\mathrm{ens}} = \sum_{m=1}^{M} w_mP_m \]
şeklinde ifade edilebilir.
Burada:
- \(M\): model sayısı,
- \(w_m\): ilgili modelin ensemble weight'i,
- \(P_m\): ilgili modelin predicted probability'sidir.
Kaynakta non-negative weights'in toplamı 1 olacak biçimde validation set üzerinde optimize edildiği belirtilmektedir.
Model mimarisiyle ilgili kaynak içi tutarsızlık
Burada ciddi bir kaynak-tutarlılığı sorunu vardır:
- Section 2.3: Random Forest, Gradient Boosting, SVM, Logistic Regression ve XGBoost olmak üzere 5 model tanımlar.
- Section 2.3 ensemble weights de aynı beş modele ağırlık verir.
- Figure 4 görseli ise “4 models” ifadesi altında XGBoost, Random Forest, Extra Trees ve Gradient Boosting gösterir.
- Figure 6'da Extra Trees, Gradient Boosting, Random Forest, XGBoost ve calibrated SVM görünür.
- Figure 6'da Logistic Regression yoktur.
Kaynak bu farklı model listelerinin ayrı deney aşamalarına mı ait olduğunu yoksa şekil/metin uyumsuzluğu mu olduğunu açıklamamaktadır.
Bu nedenle Verianla ana model mimarisini Methods Section 2.3'ün explicit tanımına göre anlatmaktadır; Extra Trees'i final ensemble'ın doğrulanmış altıncı veya alternatif üyesi olarak eklememektedir.
Karar eşiği nasıl seçildi?
Methods metnine göre validation set üzerinde 0,30 ile 0,70 arasında 0,01 adımlarla karar eşikleri taranmış ve accuracy'yi maksimize ederken specificity'yi %95'in üzerinde tutan eşik 0,48 olarak seçilmiş; daha sonra bu eşik test setinde değiştirilmeden kullanılmıştır.
Taranan aralık:
\[ 0.30,0.31,\ldots,0.70 \]
şeklindedir.
Kaynak metninde seçilen threshold:
\[ t=0.48 \]
olarak raporlanır.
Ancak PDF'nin Figure 4 pipeline görselinde:
“Optimal threshold: 0.85”
yazmaktadır.
Bu iki değer aynı anda doğru olamaz ve kaynak çelişkinin nedenini açıklamamaktadır.
Dolayısıyla Verianla:
- ana yöntem metninde Section 2.4'teki 0,48 değerini kullanır,
- Figure 4'teki 0,85 değerini görmezden gelmez,
- hangi değerin final uygulamada gerçekten kullanıldığını kaynak dışında tahmin etmez.
Accuracy, sensitivity, specificity ve AUC-ROC ne anlama geliyor?
Bu metrikler modelin farklı hata türlerini ölçer; özellikle glioblastoma risk sınıflandırmasında sensitivity yüksek-risk hastalarını yakalama kapasitesini, specificity ise gerçekten düşük-risk olan hastaları yüksek-risk diye yanlış etiketlememe kapasitesini gösterir.
True Positive ve False Negative
Bu çalışmanın sınıf tanımında “positive” sınıf yüksek-risk olarak düşünülebilir.
Dolayısıyla:
- True Positive (TP): gerçekten yüksek-risk ve model de yüksek-risk dedi,
- False Negative (FN): gerçekten yüksek-risk ama model düşük-risk dedi.
Test setinde:
\[ TP=58 \]
ve:
\[ FN=4. \]
True Negative ve False Positive
- True Negative (TN): gerçekten düşük-risk ve model de düşük-risk dedi,
- False Positive (FP): gerçekten düşük-risk ama model yüksek-risk dedi.
Test setinde:
\[ TN=63 \]
ve:
\[ FP=0. \]
Accuracy
\[ \mathrm{Accuracy} = \frac{TP+TN}{TP+TN+FP+FN}. \]
Bu test setinde:
\[ \frac{58+63}{125} = \frac{121}{125} = 0.968 = 96.80\%. \]
Sensitivity
\[ \mathrm{Sensitivity} = \frac{TP}{TP+FN}. \]
Bu çalışmada:
\[ \frac{58}{58+4} = \frac{58}{62} \approx93.55\%. \]
Yani 62 gerçek yüksek-risk hastasının 58'i doğru bulunmuştur.
Specificity
\[ \mathrm{Specificity} = \frac{TN}{TN+FP}. \]
Burada:
\[ \frac{63}{63+0} = 100\%. \]
Bu nedenle kaynak %100 specificity raporlamaktadır.
Precision
\[ \mathrm{Precision} = \frac{TP}{TP+FP}. \]
Burada:
\[ \frac{58}{58+0} = 100\%. \]
False-negative rate
\[ \mathrm{FNR} = \frac{FN}{TP+FN} = \frac{4}{62} \approx6.45\%. \]
Klinik açıdan bu hata özellikle önemlidir; çünkü yüksek-risk bir hastanın düşük-risk olarak değerlendirilmesi undertreatment riski doğurabilir.
AUC-ROC
ROC curve, classification threshold değiştirilirken sensitivity ile false-positive rate arasındaki ilişkiyi gösterir.
AUC-ROC ise bu eğrinin altında kalan alanı ifade eder.
Kaynak test için:
\[ \mathrm{AUC}=99.97\% \]
raporlamaktadır.
Bu değer modelin test setindeki yüksek-risk ve düşük-risk gruplarını çok güçlü biçimde sıraladığını göstermektedir.
Ancak yüksek AUC tek başına prospective clinical utility, treatment benefit veya calibration garantisi değildir.
Modelin olasılık kalibrasyonu nasıl değerlendirilmiş?
Çalışma yalnız classification accuracy değerlendirmemiş; validation setinde reliability diagrams ve Brier score kullanarak predicted probabilities'nin gözlenen sonuçlarla ne kadar uyumlu olduğunu da incelemiştir.
Kaynakta validation-set Brier score:
\[ 0.12 \]
olarak verilmiştir.
Binary classification için Brier score kavramsal olarak:
\[ \mathrm{Brier} = \frac{1}{N} \sum_{i=1}^{N} (p_i-y_i)^2 \]
şeklindedir.
Burada:
- \(p_i\): modelin predicted probability'si,
- \(y_i\): gerçek binary outcome,
- \(N\): örnek sayısıdır.
Düşük Brier score daha iyi probabilistic calibration anlamına gelir; ancak Brier score'un mutlak yorumunda sınıf prevalence ve karşılaştırılan model önemlidir.
Çalışmanın Yöntemi ve Bulguları
Train, validation ve test ayrımı bilgi sızıntısını nasıl önlemeye çalışıyor?
Kaynağa göre PCA, exponential bandwidth, model hyperparameters ve feature transformation'a ilişkin öğrenilen parametreler yalnız training set üzerinde belirlenmiş; validation set threshold ve ensemble weight kalibrasyonu için kullanılmış, 125 hastalık test seti ise final değerlendirmeye kadar tutulmuştur.
Dağılım:
\[ 494=295+74+125. \]
Training oranı:
\[ \frac{295}{494}\approx59.7\%. \]
Validation:
\[ \frac{74}{494}\approx15.0\%. \]
Test:
\[ \frac{125}{494}\approx25.3\%. \]
Kaynak bunları yuvarlatılmış olarak 60/15/25% şeklinde raporlamaktadır.
Nested 5-fold cross-validation
Base-model hyperparameter optimization training set üzerinde nested 5-fold cross-validation ile gerçekleştirilmiştir.
Ayrıca model robustness değerlendirmesi training + validation birleşimi:
\[ n=370 \]
üzerinde stratified 5-fold cross-validation ile yapılmıştır.
Ensemble cross-validation sonucu
Kaynakta quantum-radiomics yaklaşımı için mean cross-validation accuracy:
\[ 97.32\%\pm1.24\% \]
ve range:
\[ 95.89\%-98.65\% \]
olarak verilmiştir.
Beş fold:
| Fold | Accuracy |
|---|---|
| 1 | 98,65% |
| 2 | 97,30% |
| 3 | 96,76% |
| 4 | 95,89% |
| 5 | 98,24% |
Kaynağın verdiği coefficient of variation:
\[ 1.27\% \]
olarak raporlanmıştır.
Cross-validation AUC
Ortalama:
\[ 99.12\%\pm0.58\% \]
range:
\[ 98.23\%-99.76\%. \]
Figure 6 neyi gösteriyor?
Kaynak Figure 6 quantum ensemble'ın yukarıdaki 97,32% ortalamasını değil, ayrı individual base-model cross-validation accuracies değerlerini göstermektedir:
| Model | Accuracy |
|---|---|
| Extra Trees | 95,25% |
| Gradient Boosting | 94,92% |
| Random Forest | 94,83% |
| XGBoost | 95,08% |
| Calibrated SVM | 93,5% |
Figure 6 üzerinde mean:
\[ 94.72\% \]
standard deviation:
\[ 0.62\% \]
ve range:
\[ 1.75\% \]
olarak gösterilmiştir.
Bu değerler ensemble cross-validation sonucu olan 97,32% ile aynı metrik grubu değildir.
Validation ve test performansı
| Metrik | Validation n=74 | Test n=125 | Test için 95% CI |
|---|---|---|---|
| Accuracy | 98,65% | 96,80% | 94,92–98,68% |
| AUC-ROC | 99,78% | 99,97% | 99,89–100,0% |
| Precision | 100,00% | 100,00% | 100,0–100,0% |
| Sensitivity | 97,30% | 93,55% | 86,31–100,0% |
| F1-score | 98,63% | 96,67% | 93,94–99,40% |
| Specificity | 100,00% | 100,00% | 100,0–100,0% |
| False-positive rate | 0,00% | 0,00% | 0,0–0,0% |
| False-negative rate | 2,70% | 6,45% | 0,0–13,69% |
Validation confusion matrix
Validation setinde:
- 37 gerçek düşük-risk → 37 doğru düşük-risk,
- 0 false positive,
- 36 gerçek yüksek-risk → 36 doğru yüksek-risk,
- 1 false negative
bulunmaktadır.
Test confusion matrix
Test setinde:
- 63 true negative,
- 0 false positive,
- 58 true positive,
- 4 false negative
bulunmaktadır.
Threshold sensitivity
Kaynak, threshold 0,30–0,70 arasında değiştirildiğinde özellikle:
\[ 0.40-0.55 \]
aralığında:
- accuracy'nin %92'nin üzerinde,
- specificity'nin %95'in üzerinde
kaldığını bildirmektedir.
Bu analiz model performansının yalnız tek bir eşik noktasında ortaya çıkan tesadüfi sonuç olmadığını desteklemek amacıyla yapılmıştır.
Subgroup sonuçları
| Alt grup | Accuracy | Karşılaştırma p değeri |
|---|---|---|
| Tümör hacmi <40 cm³ | 95,8% | p=0,43 |
| Tümör hacmi ≥40 cm³ | 97,4% | |
| Frontal lobe | 96,2% | p=0,52 |
| Diğer lokalizasyonlar | 97,1% | |
| Yaş <60 | 96,5% | p=0,68 |
| Daha ileri yaş | 97,0% |
Bu p değerleri kaynakta alt gruplar arasında anlamlı performance difference gözlenmediğini desteklemek amacıyla sunulmuştur.
Ancak test seti toplam 125 hasta olduğundan alt-grup analizlerinin daha büyük demografik veya klinik popülasyonlarda eşit performansı garanti ettiği sonucu çıkarılmamalıdır.
McNemar ve DeLong testleri
Kaynak quantum ensemble ile baseline karşılaştırmasında:
\[ p<0.001 \]
McNemar testi ve:
\[ p<0.001 \]
DeLong testi bildirmektedir.
McNemar testi paired classification errors arasındaki farkı değerlendirirken DeLong testi ROC AUC değerlerinin karşılaştırılmasında kullanılabilir.
Burada bu testlerin sonucu “quantum mechanics nedeniyle üstünlük kanıtlandı” anlamına gelmez. Testler yalnız karşılaştırılan prediction outputs arasındaki istatistiksel performans farkını değerlendirmektedir.
Ablasyon çalışması quantum-inspired feature transform'un katkısını gerçekten ayırabiliyor mu?
Ablasyon çalışmasında aynı veri ayrımı kullanılarak 75 özgün radyomik özellik üzerinde quantum expansion olmadan modeller yeniden eğitilmiş ve performans düşüşü gözlenmiştir; fakat kaynak “en iyi baseline” tanımında accuracy açısından kendi içinde bir tutarsızlık içermektedir.
Kaynak:
| Model | Accuracy | AUC-ROC |
|---|---|---|
| XGBoost | 81,36% | 0,695 |
| Random Forest | 83,05% | 0,631 |
| SVM | 72,88% | 0,681 |
| Logistic Regression | 81,36% | 0,647 |
Quantum-enhanced ensemble:
\[ 96.80\%\ \mathrm{accuracy} \]
ve:
\[ 99.97\%\ \mathrm{AUC} \]
raporlamaktadır.
Kaynak içindeki “best baseline” sorunu
Metin XGBoost'u:
“best baseline model”
olarak nitelendirip accuracy 81,36% ve AUC 0,695 vermektedir.
Ancak aynı paragrafta Random Forest accuracy:
\[ 83.05\% \]
olarak verilmiştir.
Bu nedenle:
- AUC bakımından XGBoost, verilen modeller arasında en yüksek değere sahiptir.
- Accuracy bakımından ise verilen sayıların en yükseği Random Forest'ın %83,05 değeridir.
Kaynak “yaklaşık 15 percentage-point accuracy improvement” hesabını 81,36% → 96,80% üzerinden yapmaktadır:
\[ 96.80-81.36=15.44 \]
percentage point.
Fakat en yüksek raporlanan baseline accuracy olan 83,05% esas alınırsa:
\[ 96.80-83.05=13.75 \]
percentage point olur.
Bu ikinci hesap Verianla'nın yeni deneysel sonucu değildir; yalnız kaynakta yan yana verilen iki accuracy değerinin aritmetik farkıdır ve kaynak içindeki “best baseline” terminolojisinin neden belirsiz olduğunu göstermek için verilmiştir.
Modelin hata analizi ne gösterdi?
Beş cross-validation fold'unda üç veya daha fazla kez yanlış sınıflandırılan 23 hasta belirlenmiş; kaynak bu zor vakaların önemli bölümünü 12 aylık karar sınırına yakın sağkalım, atipik görüntüleme görünümü veya eksik tedavi bilgisiyle ilişkilendirmiştir.
Kaynak:
- 23 consistently misclassified patient → toplam veri kümesinin %6,2'si,
- 15 hasta → 12 aylık eşikten ±1 ay uzaklıkta borderline outcome,
- 5 hasta → aggressive disease'e rağmen minimal contrast enhancement gibi atypical imaging,
- 3 hasta → incomplete treatment information
bildirmektedir.
Bu analiz model hatalarının tamamen rastgele olmadığını düşündürmektedir; fakat bu ilişki causal proof değildir.
Feature-importance stabilitesi
Cross-validation folds arasında feature-importance ranking için correlation coefficient:
\[ r=0.92 \]
olarak raporlanmıştır.
Kaynak tüm fold'larda önemli görülen değişkenler arasında:
- tumor volume,
- sphericity,
- surface area
gibi shape features'i vurgulamaktadır.
Tartışma bölümünde ayrıca tumor-volume, shape irregularity ve enhancement heterogeneity gibi özelliklerin biyolojik plausibility taşıdığı belirtilmektedir.
Kaynağın “external validation” iddiası nasıl yorumlanmalıdır?
Çalışma önceki brain-metastasis quantum-radiomics yaklaşımını farklı bir tümör türü olan GBM'ye aktararak cross-domain metodolojik transfer göstermektedir; ancak bu makalenin GBM modelinin train, validation ve test hastalarının tamamı BraTS 2020 içinden geldiği için bağımsız non-BraTS kurum kohortunda gerçek dış doğrulama yapılmamıştır.
Bu ayrım önemlidir.
Yazarlar 125 hastalık grubu “external test set” olarak adlandırmaktadır.
Fakat aynı çalışmada:
\[ 494\ \mathrm{BraTS\ hastası} \rightarrow 295+74+125 \]
şeklinde tek BraTS cohort split'i yapılmıştır.
Dolayısıyla test hastaları training patients'tan bağımsızdır; fakat veri kaynağı aynı benchmark ekosistemidir.
Tartışma bölümü bunu açık biçimde sınırlar ve:
non-BraTS datasets from institutions independent of research groups
üzerinde doğrulamanın yapılmadığını belirtir.
Yazarlar gerçek external validation için:
- BraTS katkıcılarından farklı hastane merkezleri,
- farklı görüntüleme protokolleri,
- yeni patient cohorts,
- prospective validation
gerektiğini ifade etmektedir.
Cross-domain iddiası neye dayanıyor?
Yazarların önceki çalışması brain metastasis survival prediction üzerine geliştirilmiş quantum-radiomics metodolojisidir.
Bu çalışmada aynı temel transform konseptinin glioblastoma radiomics'e aktarılabilmesi “cross-domain” olarak yorumlanmaktadır.
Ancak mevcut makale önceki brain-metastasis cohort'un quantitative results'ını yan yana yeniden sunmamaktadır.
Kaynağın kendisi de cross-domain claim'in:
methodological transfer
üzerine kurulduğunu ve iki cohort'un side-by-side performance reporting'inin gelecek çalışmalarda yapılması gerektiğini kabul etmektedir.
Yayımlanmış yöntemlerle karşılaştırmalar ne kadar güvenilir?
Kaynak kendi %96,80 test accuracy'sini geleneksel radyomik ve deep-learning çalışmalarındaki daha düşük raporlanmış performanslarla karşılaştırmaktadır; ancak endpoint, veri kümesi büyüklüğü, preprocessing, train/test ayrımı ve validation rigor farklı olduğu için bu karşılaştırmalar doğrudan head-to-head deney değildir.
| Çalışma | Yöntem | Cohort | Test accuracy | Specificity |
|---|---|---|---|---|
| Kickingereder | Radiomics + Random Forest | 170 | 73,0% | 69% |
| Lao | 3D CNN | 181 | 76,0% | 72% |
| Nie | Multi-channel CNN | 163 | 79,0% | 78% |
| Isensee | nnU-Net + Radiomics | 285 | 82,0% | 85% |
| Feng | Multi-task CNN | 209 | 88,0% | 89% |
| Bu çalışma | Quantum Radiomics + Ensemble | 494 | 96,80% | 100% |
Kaynağın kendisi doğrudan numerical comparison yapılırken dikkatli olunmasını istemektedir.
Çünkü çalışmalar arasında:
- 12-month survival versus median survival endpoint,
- patient number,
- image preprocessing,
- train/test splitting,
- cross-validation versus held-out testing,
- model complexity
farklıdır.
Dolayısıyla “bu yöntem diğer bütün yöntemlerden bilimsel olarak kesin biçimde üstündür” sonucu yalnız bu tabloyla kanıtlanmış değildir.
Dört false-negative klinik açıdan neden önemli?
Dört false-negative, gerçekten yüksek-risk olan dört hastanın model tarafından düşük-risk olarak etiketlendiğini gösterir; bu hata türü tedavi yoğunluğunu azaltma gibi bir klinik karar otomatikleştirilirse ciddi sonuç doğurabileceği için modelin yalnız decision-support düzeyinde ele alınması gerekir.
Kaynağın test setinde:
\[ 4/62=6.45\% \]
yüksek-risk hastası yanlışlıkla düşük-risk sınıfına verilmiştir.
Yazarlar Section 3.1'de açıkça bunun “significant clinical concern” olduğunu belirtmektedir.
Bu nedenle %100 specificity ifadesini tek başına öne çıkarmak yanıltıcı olabilir.
%100 specificity:
“Düşük-risk hastalar yüksek-risk diye yanlış işaretlenmedi.”
anlamına gelir.
Şu anlama gelmez:
“Bütün yüksek-risk hastalar bulundu.”
Çünkü sensitivity %93,55'tir.
Discussion bölümündeki false-negative tutarsızlığı
Kaynağın Discussion bölümünde dört false-negative için “all but one case borderline survival” benzeri bir açıklama yapılırken bir vakada:
survival = 16 months
ifadesi kullanılmaktadır.
Fakat çalışmanın kendi binary endpoint tanımında:
\[ \mathrm{high\ risk}<12\ \mathrm{months} \]
olduğundan, gerçekten 16 ay yaşayan bir hasta yüksek-risk true class olarak false-negative olamaz.
Kaynak bu mantıksal tutarsızlığı açıklamamaktadır.
Bu nedenle Verianla bu 16 aylık ifadeyi false-negative klinik analizinin kanıtı olarak kullanmamaktadır.
Çalışmanın desteklediği sonuçlar
- BraTS 2020'deki 494 GBM hastasının çok-modlu MRI radyomik özellikleriyle 12 aylık binary survival-risk classification yapılmıştır.
- Kaynakta kullanılan quantum-inspired transformation klasik bilgisayarda çalışmaktadır.
- 75 radyomik özellik kaynak yönteminde 715 boyutlu representation'a genişletilmiştir.
- Pairwise quadratic interaction space 2.775 feature pair içermekte ve 300 PCA component'e indirgenmektedir.
- 300 component quadratic variance'nın %95'ini korumaktadır.
- Gaussian exponential bandwidth \(\sigma=1.5\) olarak seçilmiştir.
- Methods Section 2.3 beş klasik machine-learning learner içeren weighted soft-voting ensemble tanımlar.
- Test n=125 üzerinde accuracy %96,80 raporlanmıştır.
- Test AUC-ROC %99,97 raporlanmıştır.
- Specificity %100 ve sensitivity %93,55'tir.
- Dört false-negative ve sıfır false-positive bulunmaktadır.
- Five-fold cross-validation ensemble accuracy %97,32 ± %1,24'tür.
- Ablation çalışması quantum-inspired feature expansion olmadan daha düşük performance raporlamaktadır.
- Çalışma multi-institutional BraTS data üzerinde yapılmıştır.
Çalışmanın desteklemediği sonuçlar
- Çalışma gerçek quantum computer'ın glioblastoma sağkalımını tahmin ettiğini göstermemektedir.
- Quantum supremacy veya quantum computational advantage gösterilmemiştir.
- Model prospective clinical trial'da denenmemiştir.
- Modelin treatment decisions'i güvenle otomatikleştirebileceği kanıtlanmamıştır.
- Bağımsız non-BraTS hastane cohort'unda doğrulama yapılmamıştır.
- Model continuous survival time tahmini yapmamaktadır; 12 aylık binary endpoint kullanır.
- %100 specificity, bütün yüksek-risk hastaların doğru tanındığı anlamına gelmez.
- Yayımlanmış deep-learning yöntemleriyle yapılan karşılaştırmalar aynı cohort üzerinde head-to-head retraining değildir.
- Farklı kanserler, CT, PET veya ultrasound için aynı performance gösterilmemiştir.
- Model rare GBM subtypes veya underrepresented demographic groups için eşit performans göstermiş sayılmaz.
- Clinical cost-effectiveness formal health-economic study ile kanıtlanmamıştır.
- Manual/expert tumor segmentation gereksiniminin gerçek klinikte tamamen otomatik çözüldüğü gösterilmemiştir.
Çalışmanın başlıca sınırlılıkları
Kaynak tarafından belirtilen ve sonuç yorumunu sınırlandıran noktalar:
- BraTS 2020 curated ve preprocessed bir benchmark dataset'tir.
- Clinical deployment için reliable automatic segmentation gerekir.
- 12 aylık binary cutoff continuous survival information'ı kaybeder.
- Rare GBM subtypes ve underrepresented demographic groups için genellenebilirlik sınırlıdır.
- Non-BraTS independent institutional validation yapılmamıştır.
- Prospective validation yapılmamıştır.
- Brain metastasis → GBM cross-domain claim side-by-side quantitative comparison içermez.
Gelecek çalışma önerileri
Kaynak gelecekte:
- Cox proportional-hazards regression,
- accelerated failure-time models,
- independent institutional datasets,
- prospective newly diagnosed cohorts,
- clinical/treatment variables integration,
- genomic ve molecular markers integration,
- longitudinal treatment-response monitoring
gibi doğrulama ve geliştirme yönleri önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Quantum Radiomics Ensemble Model for Glioblastoma Survival Prediction and External Validation on BraTS 2020
Yazarlar: Damiana Teliti; Olsi Shehu; Bekir Karlik; Jasmin Kevrić.
Yazar sırası: Kaynaktaki sıra korunmuştur.
Corresponding author: Damiana Teliti.
Kurum 1: Department of Information Technology, Faculty of Engineering, Natural and Medical Sciences, International Burch University, Sarajevo, Bosnia and Herzegovina.
Kurum 2: Department of Electrical and Electronics Engineering, Faculty of Engineering and Architecture, Istanbul Esenyurt University, Istanbul, Türkiye.
Kurum 3: Department of Electrical and Electronics Engineering, Faculty of Engineering, Natural and Medical Sciences, International Burch University, Sarajevo, Bosnia and Herzegovina.
Dergi: The Open Neuroimaging Journal.
Yayınevi: Bentham Open / Bentham Science.
Kaynak türü: Research Article.
Hakemlik durumu: The Open Neuroimaging Journal hakemli bir dergidir; çalışma yayımlanmış araştırma makalesidir.
Cilt: 19.
E-location ID: e18744400478846.
DOI: 10.2174/0118744400478846260616061026.
Received: 14 Ocak 2026.
Revised: 6 Nisan 2026.
Accepted: 8 Nisan 2026.
Published: 2 Temmuz 2026.
Resmî bağlantı: https://doi.org/10.2174/0118744400478846260616061026
Lisans: Creative Commons Attribution 4.0 International, CC BY 4.0.
Anahtar kelimeler: Quantum machine learning; Radiomics; Glioblastoma; Multi-modal MRI; Ensemble learning; Neuroimaging.
Çalışma tasarımı: Publicly available de-identified BraTS 2020 data üzerinde retrospective secondary analysis ve machine-learning classification.
Örneklem: 494 glioblastoma hastası.
Veri ayrımı: 295 train / 74 validation / 125 test.
Ana klinik endpoint: 12-month overall survival threshold.
Ana yöntem: PyRadiomics tabanlı feature extraction → quantum-inspired feature transformation → weighted ensemble classification → validation-threshold calibration → held-out test evaluation.
Quantum donanımı: Kullanılmamıştır. Dönüşüm klasik CPU'da NumPy ve scikit-learn ile uygulanmıştır.
PyRadiomics sürümü: v3.0.
Radyomik standardizasyon: IBSI tanımları esas alınmıştır.
Özellik sayısı: Başlangıç 75; QFT sonrası 715.
Quadratic pair sayısı: 2.775.
Quadratic PCA component: 300.
PCA cumulative variance: %95.
Exponential encoding bandwidth: \(\sigma=1.5\).
QFT hesaplama süresi: Kaynağa göre standart CPU üzerinde yaklaşık 2–3 dakika/hasta.
Methods Section 2.3 ensemble: Random Forest, Gradient Boosting, Support Vector Machine, Logistic Regression, XGBoost.
Ensemble ağırlıkları: Random Forest 0,25; Gradient Boosting 0,22; XGBoost 0,21; SVM 0,18; Logistic Regression 0,14.
Threshold kaynağı: Section 2.4 metni 0,48 bildirir.
Threshold tutarsızlığı: Kaynak Figure 4 görselinde “Optimal threshold: 0.85” yazmaktadır. Kaynak bu 0,48/0,85 çelişkisini açıklamamaktadır. Verianla yöntem metnindeki 0,48'i ana açıklamada kullanmış, Figure 4 değerini gizlememiştir.
Model-listesi tutarsızlığı: Section 2.3 beş learner olarak RF, Gradient Boosting, SVM, Logistic Regression ve XGBoost tanımlar. Figure 4 dört model olarak XGBoost, Random Forest, Extra Trees ve Gradient Boosting gösterir. Figure 6 ise Extra Trees, Gradient Boosting, Random Forest, XGBoost ve calibrated SVM sunmaktadır. Kaynak farkı açıklamamaktadır.
Feature-count tutarsızlığı: Section 2.2 önce 14 shape + 18 first-order + 22 GLCM + 16 GLRLM + 5 GLSZM = 75 verir; daha sonra 75-vector'ı 63 texture/first-order + 12 shape olarak tarif eder. Kaynak farkı açıklamamaktadır.
MRI-modality tutarsızlığı: Ana pipeline T1, T1ce, T2 ve FLAIR kullanmaktadır. Inclusion-criteria paragrafı ise diffusion-weighted imaging'i de saymaktadır. Kaynak DWI'nin QFT girişinde kullanıldığını daha sonra göstermemektedir.
Ablation tutarsızlığı: Kaynak XGBoost'u “best baseline model” olarak 81,36% accuracy ve 0,695 AUC ile adlandırır; aynı paragrafta Random Forest 83,05% accuracy raporlanır. Dolayısıyla “best” ifadesi accuracy açısından metinle tam uyumlu değildir.
False-negative Discussion tutarsızlığı: High-risk sınıfı survival <12 ay olarak tanımlanmasına rağmen Discussion bölümünde false-negative açıklamasında 16 aylık survival ifadesi bulunmaktadır. Bu değer kendi binary class tanımıyla uyumlu görünmediği için Verianla bunu klinik çıkarımın kanıtı olarak kullanmamıştır.
External-validation sınırı: 125 hastalık test grubu training ve validation'dan hasta düzeyinde ayrılmıştır; ancak 494 hastanın tamamı BraTS 2020'den gelmektedir. Kaynağın kendi Discussion bölümü non-BraTS bağımsız institution dataset doğrulamasının yapılmadığını açıkça belirtmektedir.
Klinik kullanım sınırı: Model prospective clinical trial'da doğrulanmamıştır ve treatment decision algorithm olarak test edilmemiştir. Yazarlar Section 3.1'de çıktının probabilistic decision support olarak görülmesini önermektedir.
Etik: Çalışma publicly available, fully de-identified BraTS 2020 verisinin retrospective secondary analysis'idir. International Burch University Ethics Committee formal ethics approval gerekmediğine karar vermiş; approval reference number verilmemiştir.
Human/animal rights: Yeni insan veya hayvan deneyi yapılmamıştır. Orijinal görüntüleme çalışmaları ilgili contributing institutions'ın etik standartları altında gerçekleştirilmiştir.
Consent: Orijinal görüntüleme ve data sharing için ilgili contributing institutions'da consent alınmıştır; bu de-identified secondary analysis için ek consent gerekmemiştir.
Veri erişilebilirliği: BraTS 2020 veri kümesi CBICA/University of Pennsylvania BraTS repository üzerinden açık olarak erişilebilirdir. Trained ensemble model ve analysis code corresponding author'dan reasonable request üzerine istenebilir.
Finansman: None.
Çıkar çatışması: Yazarlar mali veya başka çıkar çatışması olmadığını bildirmiştir.
Acknowledgements: Declared none.
Yazar katkıları: Kaynak ayrıntılı CRediT rol dağılımı vermemektedir. Tüm yazarların final manuscript'i okuyup onayladığı, yazım ve revizyona katıldığı ve çalışmanın doğruluğuna ilişkin sorumluluk kabul ettiği belirtilmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir